π0.5: Cómo el entrenamiento conjunto favorece la generalización en mundos abiertos
π0.5: un modelo Visión-Lenguaje-Acción con generalización en mundos abiertos
- Generalización en mundos abiertos
- Datos heterogéneos
- Control jerárquico
- Entrenamiento conjunto
Requisitos previos
Cómo aprenden los robots a partir de demostraciones
Explicación: El aprendizaje por imitación utiliza operaciones humanas grabadas para aprender cómo moverse en una escena concreta bajo una instrucción.
Un VLA recibe imágenes, texto de la tarea y el estado del robot, y produce acciones de control. Para “pon el plato en el fregadero”, las imágenes localizan el plato, el estado describe el brazo, la instrucción define el objetivo y las acciones controlan el agarre y la colocación.
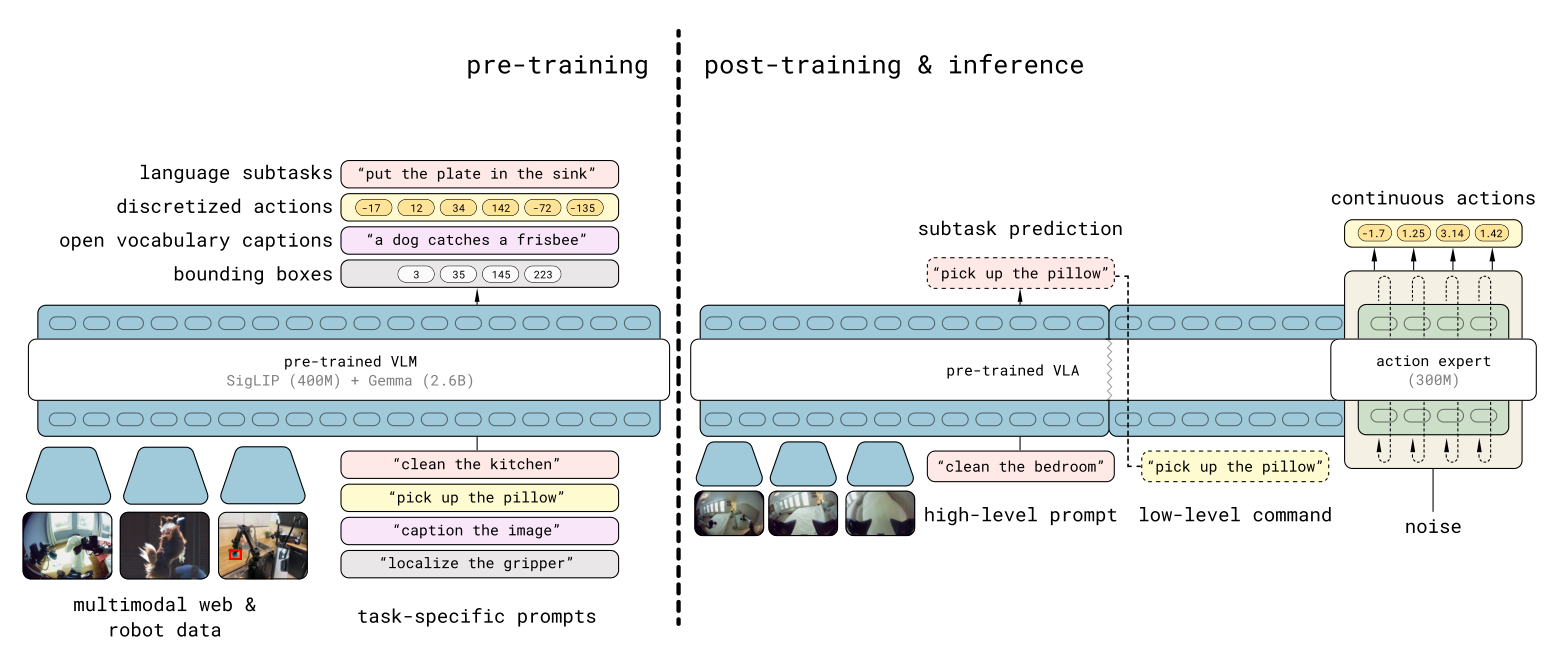
π0.5 también predice una subtarea corta, como “recoger el plato”, que luego condiciona la generación de acciones.
De acciones directas a selección de subtareas
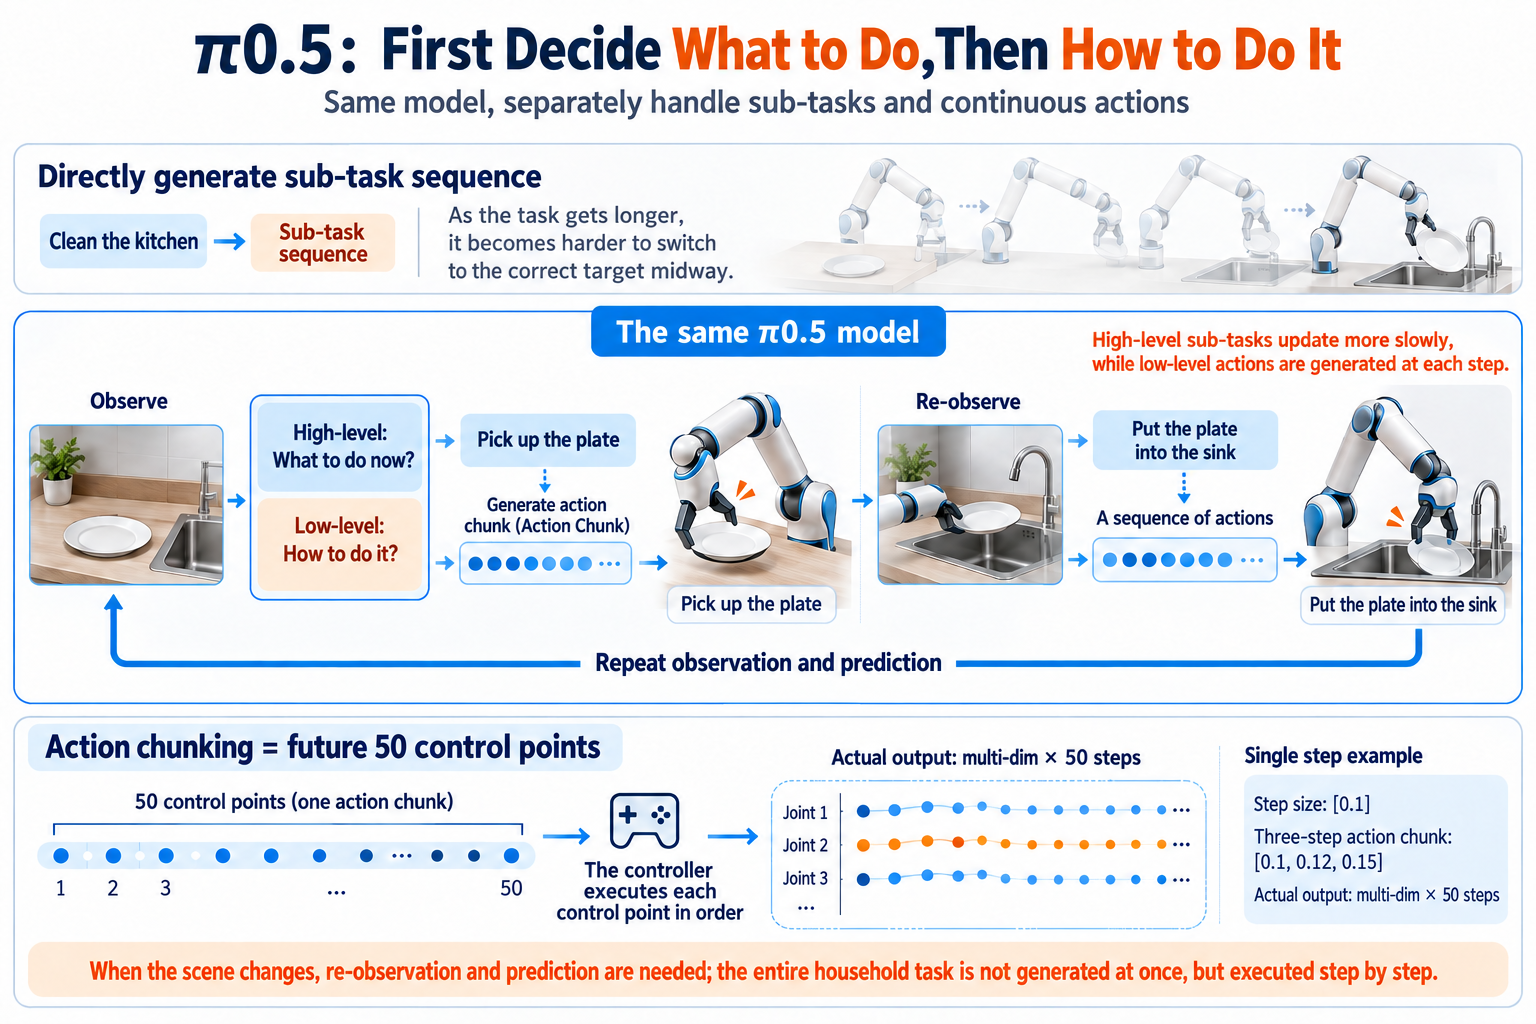
Mapear “limpia la cocina” directamente a movimientos articulares combina decidir qué hacer con decidir cómo moverse. Las tareas más largas hacen que las transiciones sean más difíciles.
π0.5 separa estas decisiones dentro del mismo modelo: seleccionar la subtarea actual y luego generar acciones continuas. Por ejemplo:
Clean the kitchen → Pick up the plate → Grasping action chunk
Observe again → Put the plate in the sink → Transport action chunk
Artículo: Cada predicción cubre 50 puntos de control futuros, un bloque de acción. Las subtareas de alto nivel se actualizan más lentamente; el nivel bajo genera bloques condicionados en ellas, y el controlador ejecuta los puntos secuencialmente.
Ejemplo: Una articulación podría tener un objetivo de un solo paso [0.1] o un bloque de tres pasos [0.1, 0.12, 0.15]. Las salidas reales son multidimensionales y de 50 pasos. El robot aún necesita nuevas observaciones y predicciones; no se genera toda una tarea doméstica de una vez para ejecutarla a ciegas.
Entrenamiento, inferencia y evaluación
| Etapa | Qué sucede |
|---|---|
| Entrenamiento | Aprende salidas de texto y acción a partir de demostraciones, anotaciones de subtareas y datos imagen-texto, y luego se adapta a la manipulación móvil en el hogar. |
| Inferencia | Selecciona una subtarea a partir de las imágenes actuales y la instrucción global, y luego genera acciones continuas a partir de la subtarea y el estado. |
| Evaluación | Ejecuta en habitaciones reservadas y puntúa los pasos completados; prueba por separado si se seleccionan el objeto y el destino solicitados. |
Un error de entrenamiento bajo no garantiza un trabajo doméstico exitoso; eso requiere pruebas con robots reales.
Resumen
Traducción
Los robots útiles deben realizar tareas reales más allá del laboratorio. Los VLA muestran fuertes capacidades de control directo, pero la adaptación a entornos reales desconocidos sigue siendo una cuestión abierta.
Basándose en π0, π0.5 mejora la capacidad de adaptación mediante entrenamiento conjunto en tareas y fuentes heterogéneas: múltiples robots, predicción semántica de alto nivel y datos web. Las muestras combinan imágenes, instrucciones, detección de objetos, predicción de subtareas y acciones de bajo nivel.
Los experimentos sugieren que la transferencia entre estas fuentes de conocimiento es importante para la generalización. Los autores describen un sistema aprendido de extremo a extremo que realiza tareas largas y diestras de limpieza de cocina y dormitorio en hogares completamente inéditos, y lo presentan como el primer sistema con esta combinación de capacidades.
Comentario
-
La cuestión central es si el robot funciona en otro hogar. Recoger un plato en una habitación de entrenamiento difiere de encontrar uno, elegir el siguiente paso y colocarlo en el fregadero de una cocina desconocida.
-
Las fuentes cumplen funciones diferentes. Otros robots aportan experiencia de manipulación, los datos imagen-texto aportan conocimiento de objetos y escenas, y las anotaciones de subtareas enseñan organización de tareas.
-
“Primero” es la afirmación de los autores. Evalúa el alcance de la evaluación y las comparaciones en lugar de tratar la formulación como una solución para todas las tareas domésticas.
Introducción
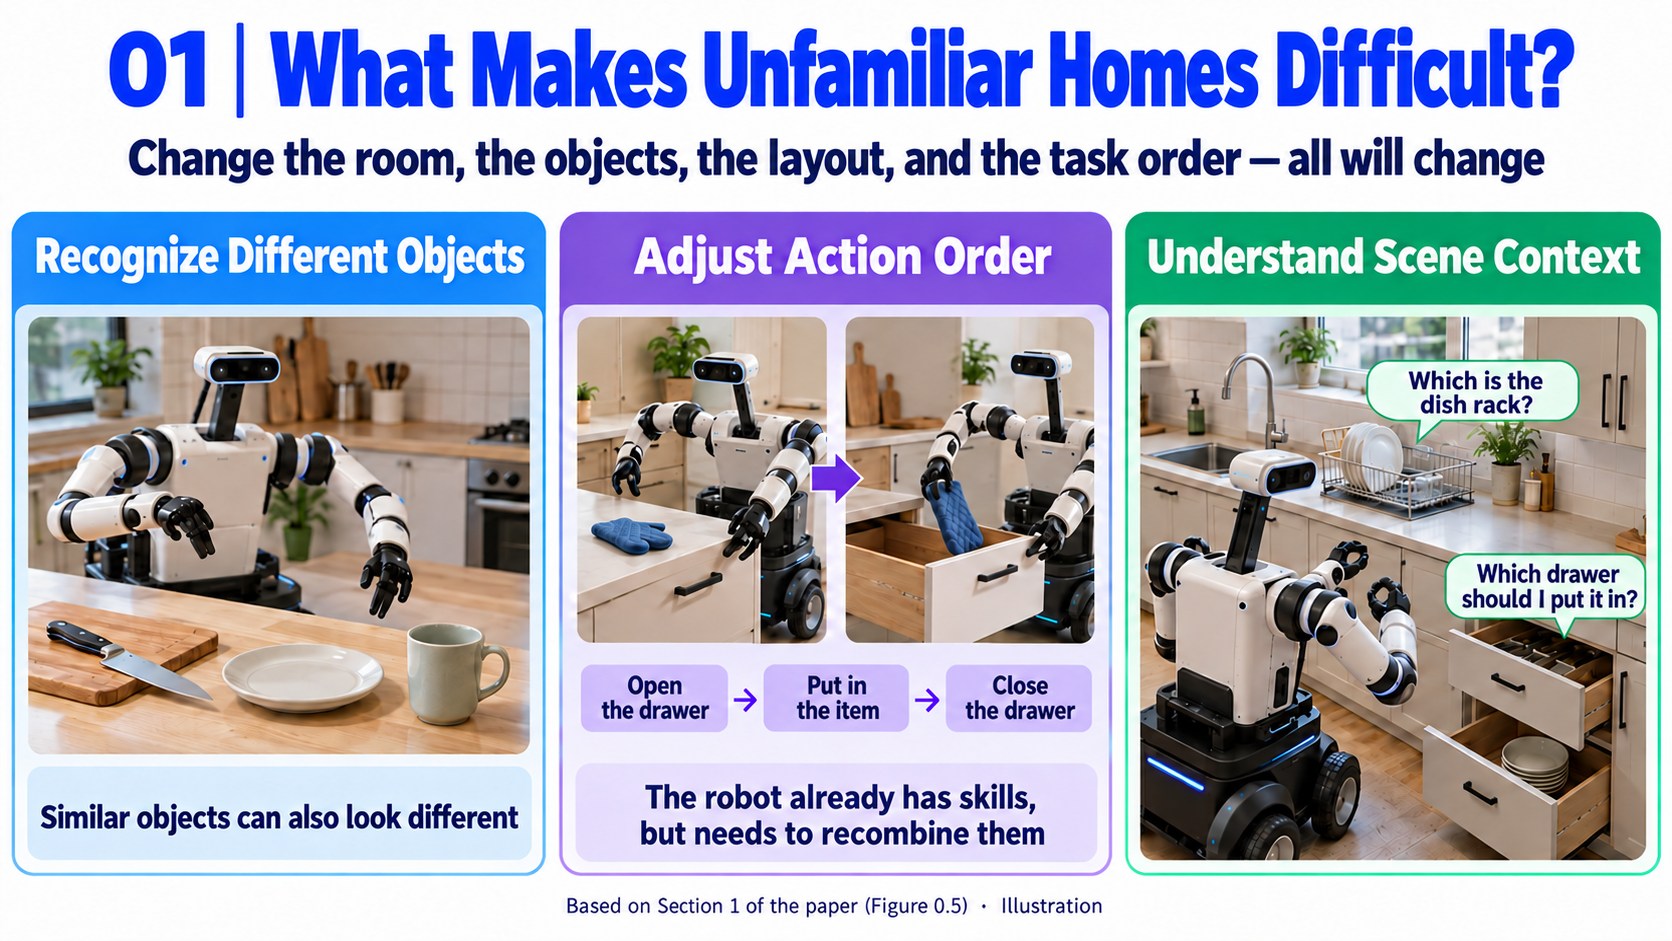
Párrafo 1: Los entornos desconocidos son difíciles
-
Contenido: Fuera del laboratorio, los robots se enfrentan a objetos diferentes, órdenes de habilidades distintos y propósitos de escena diferentes.
-
Problema: El éxito en una escena fija es insuficiente para el mundo real.
-
Planteamiento: La receta de entrenamiento debe abarcar varios niveles de capacidad.
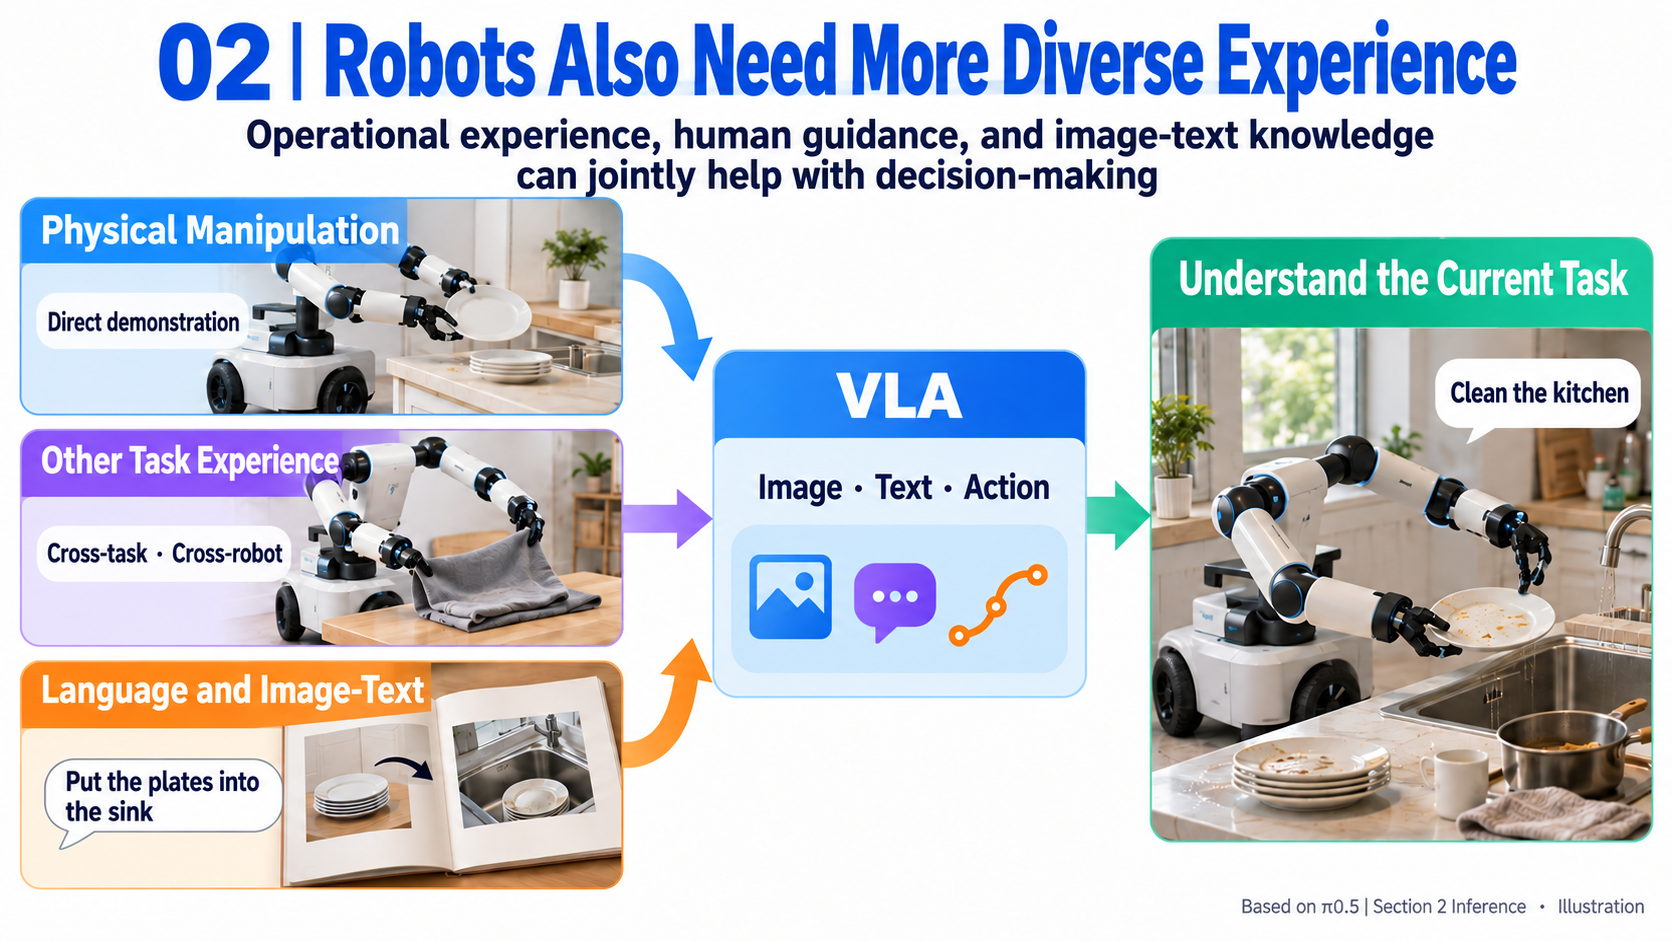
Párrafo 2: ¿Por qué usar experiencias diferentes?
-
Contenido: Las personas combinan experiencia directa, conocimiento de otros y lecciones de otras tareas. Los robots también deberían usar múltiples fuentes.
-
Problema: Las demostraciones en el robot objetivo no pueden cubrir todas las situaciones del mundo real.
-
Planteamiento: Los VLA proporcionan una interfaz compartida para imágenes, texto y acciones.
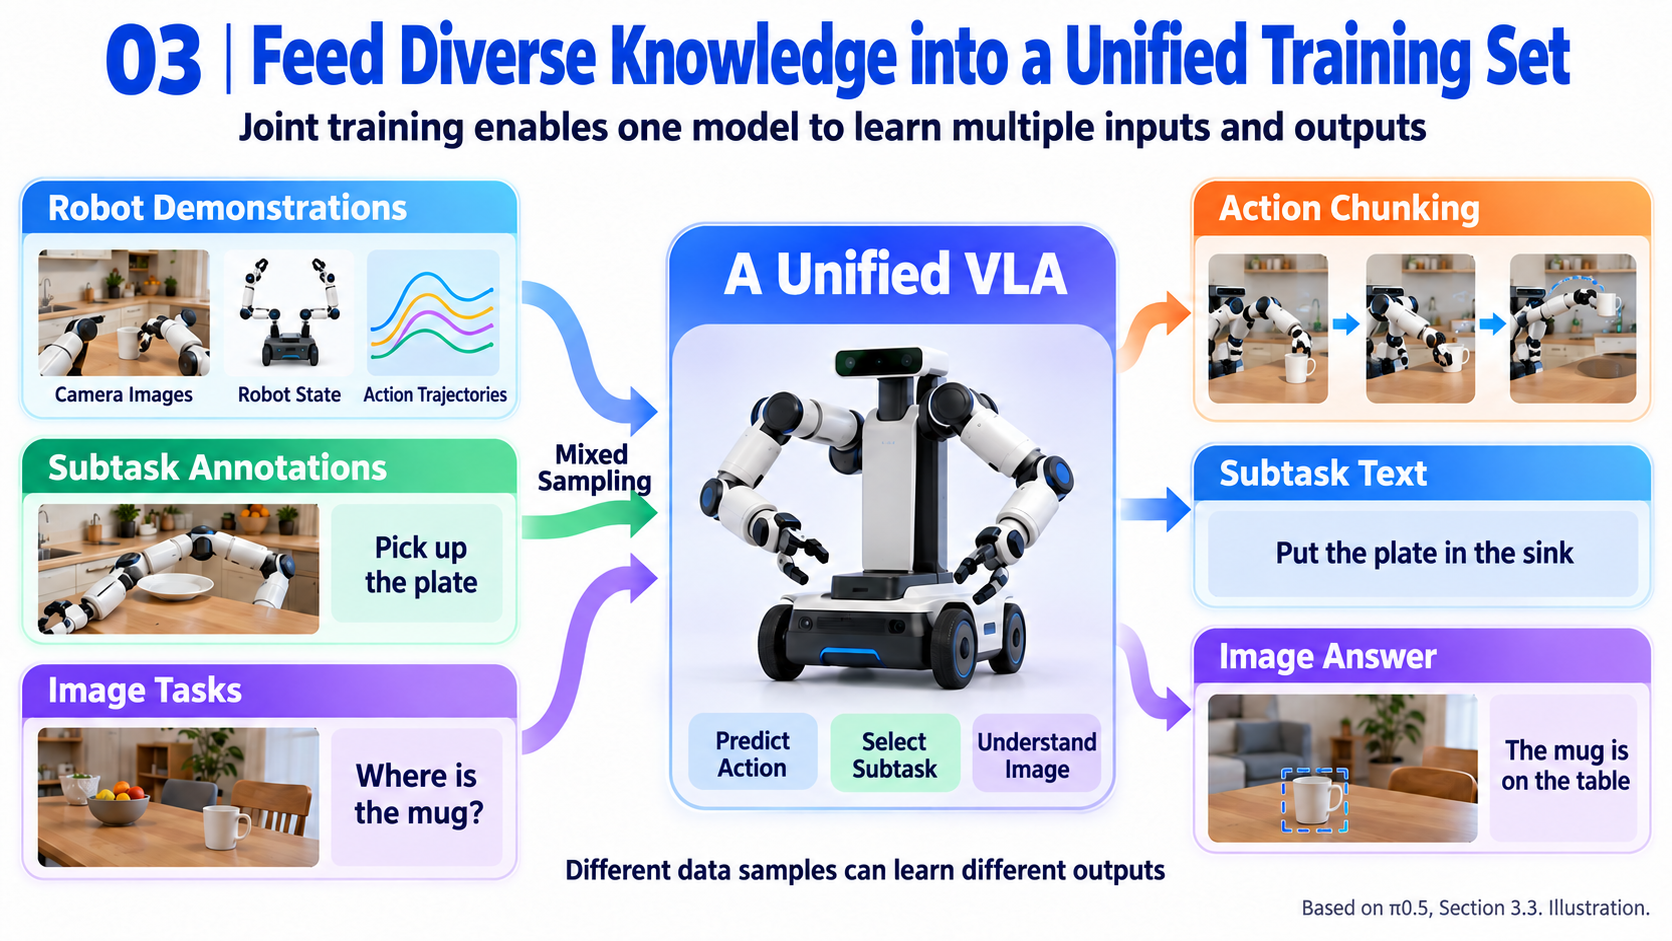
Párrafo 3: Un marco de entrenamiento conjunto
-
Contenido: Los autores proponen entrenar conjuntamente un VLA con distintos tipos y fuentes de conocimiento.
-
Problema: Convertir la motivación anterior en un enfoque de investigación concreto.
-
Planteamiento: Presentar π0.5 y la composición de sus datos.
Párrafo 4: La receta de datos
-
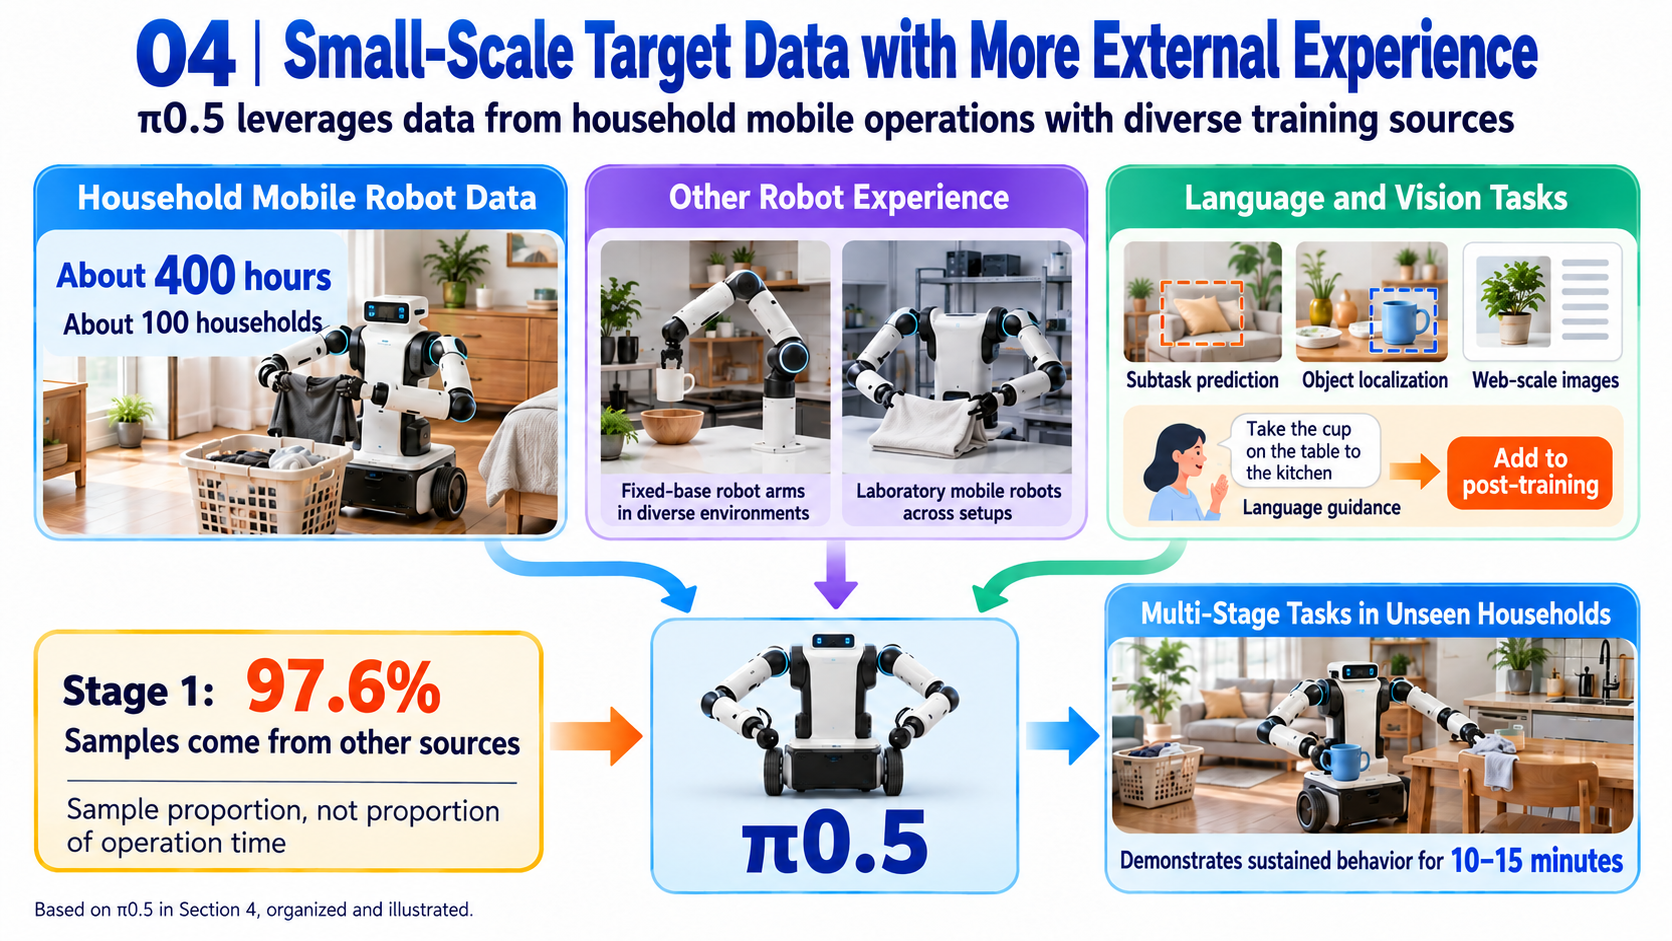
Contenido: Ampliar π0 con unas 400 horas de datos de robots móviles domésticos más otros robots y tareas imagen-texto. En la etapa 1, el 97,6% de las muestras de entrenamiento provienen de fuera de los datos objetivo de manipulación móvil en el hogar.
-
Problema: ¿Cómo pueden estas fuentes ayudar conjuntamente al robot objetivo?
-
Planteamiento: Demostrar comportamientos de 10–15 minutos en hogares desconocidos y luego eliminar fuentes. La cifra del 97,6% es una proporción de muestras, no una proporción de duración.
Párrafo 5: Ejecución jerárquica
-
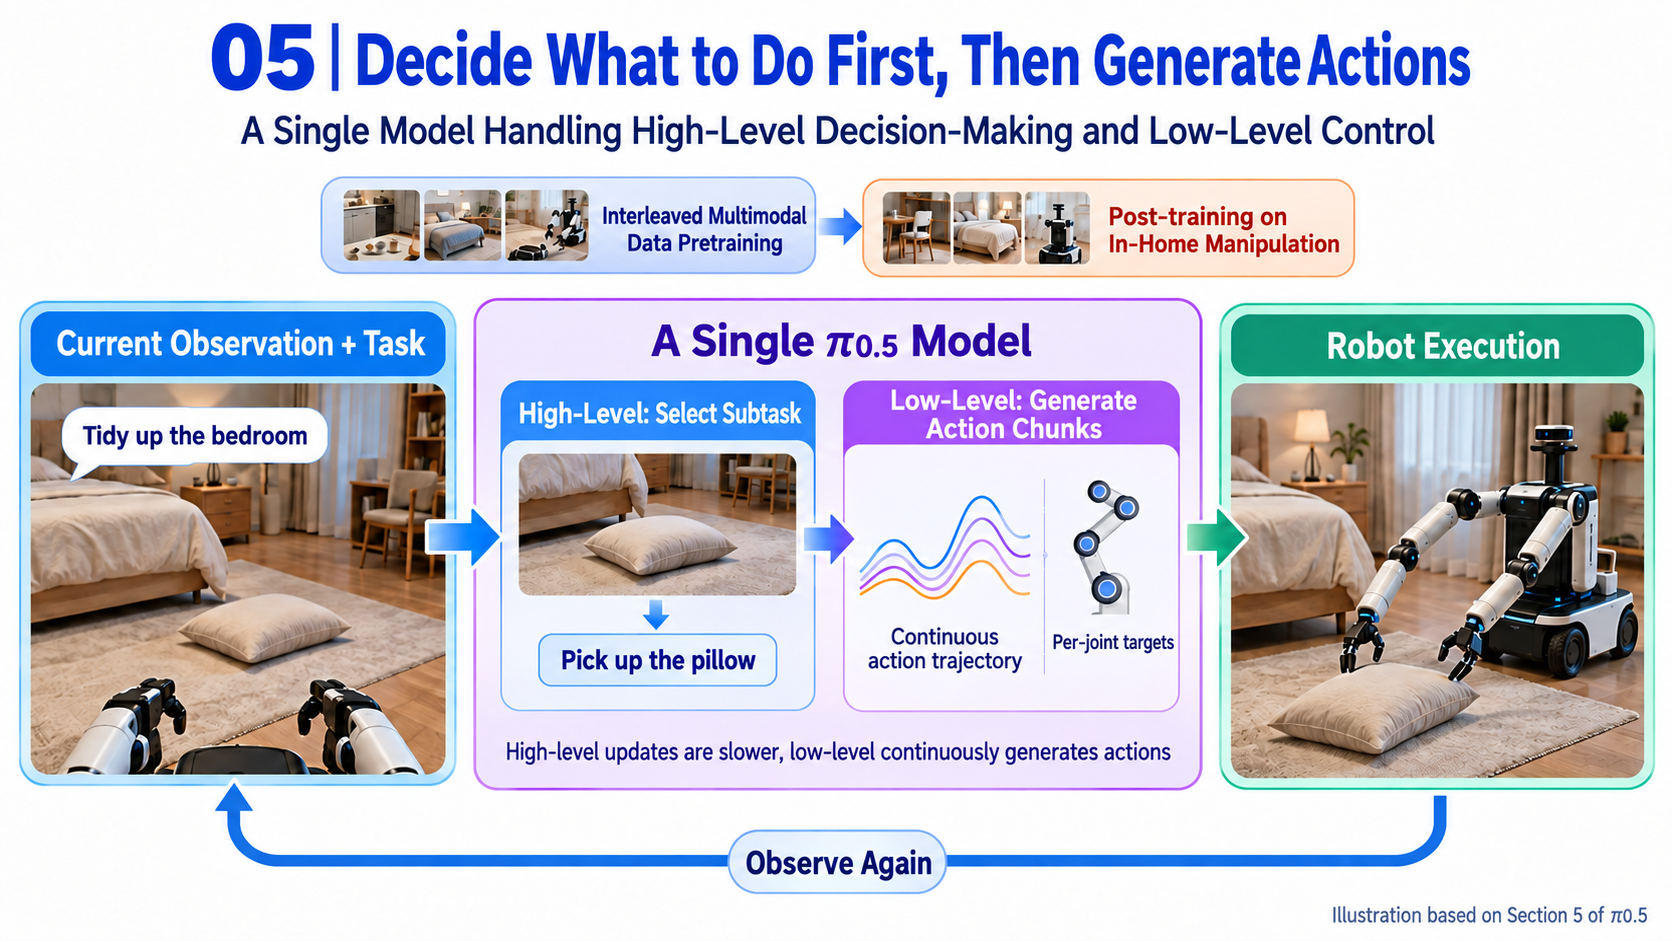
Contenido: Tras el preentrenamiento heterogéneo, se realiza un post-entrenamiento para la manipulación móvil. El mismo modelo selecciona subtareas y produce acciones, con actualizaciones de alto nivel menos frecuentes.
-
Problema: Las tareas largas requieren tanto elecciones correctas del siguiente paso como una ejecución precisa.
-
Planteamiento: Explicar cómo distintas fuentes respaldan el juicio de la escena y el control.
Párrafo 6: Contribuciones y validación
-
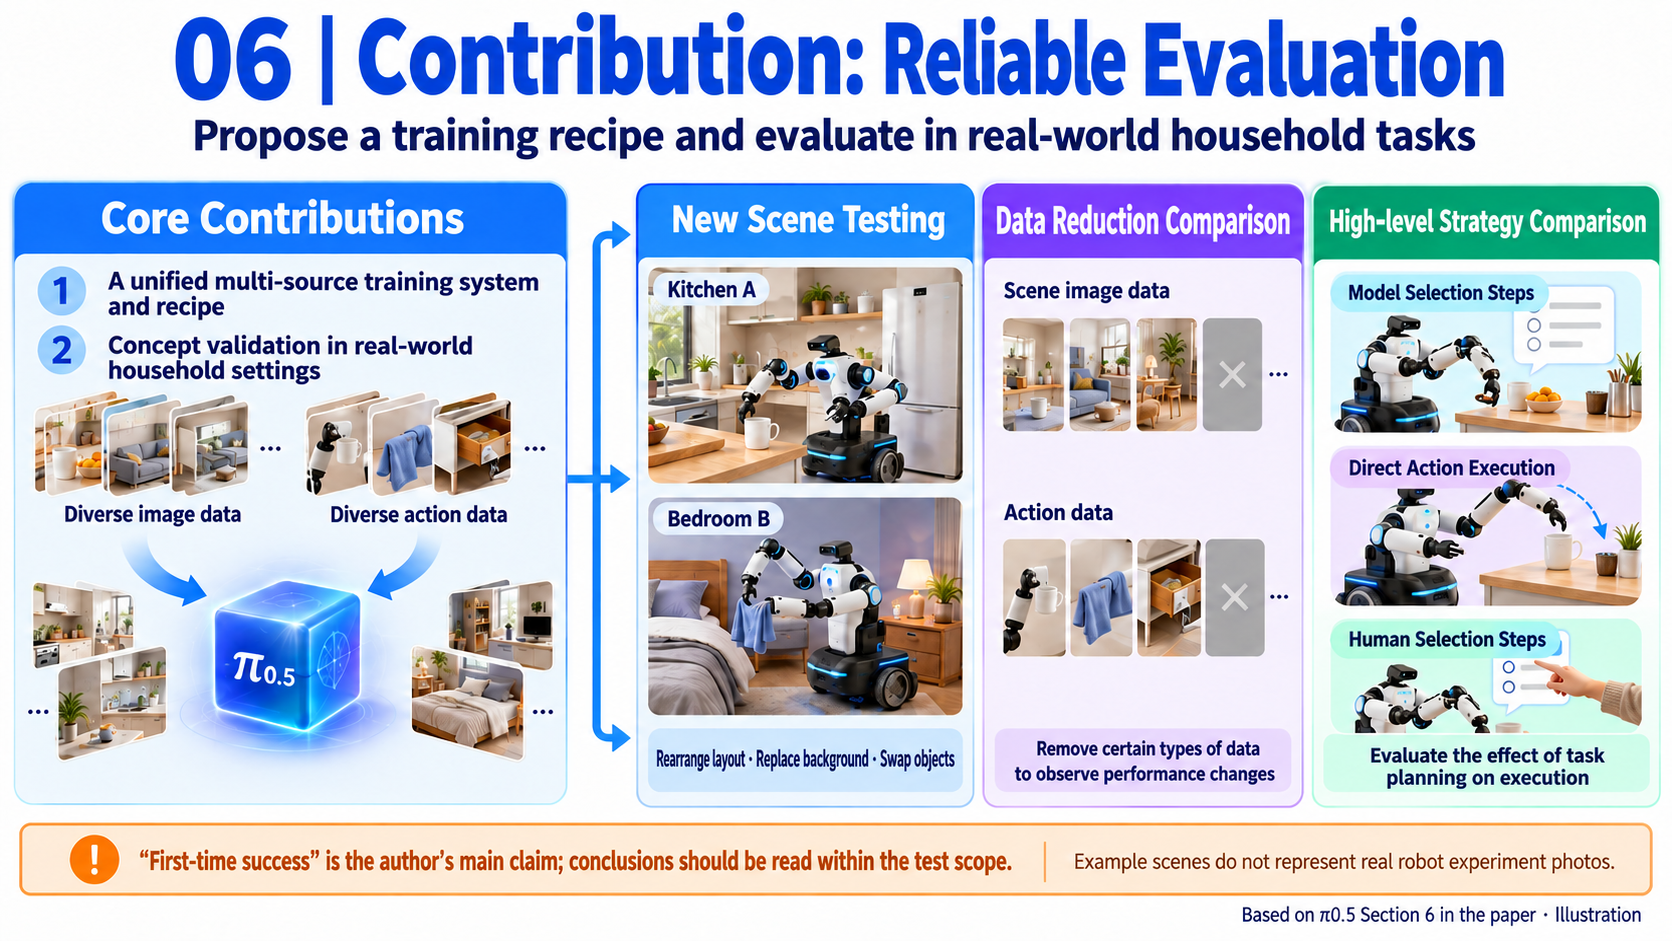
Contenido: La contribución es el sistema π0.5 y la receta de entrenamiento, con una prueba de concepto en hogares inéditos.
-
Problema: Los experimentos deben establecer si el entrenamiento conjunto realmente mejora la capacidad de adaptación.
-
Planteamiento: Probar nuevas escenas, eliminar fuentes de datos y comparar políticas de alto nivel. La formulación de “primero” sigue siendo una afirmación de los autores.
Trabajo relacionado
-
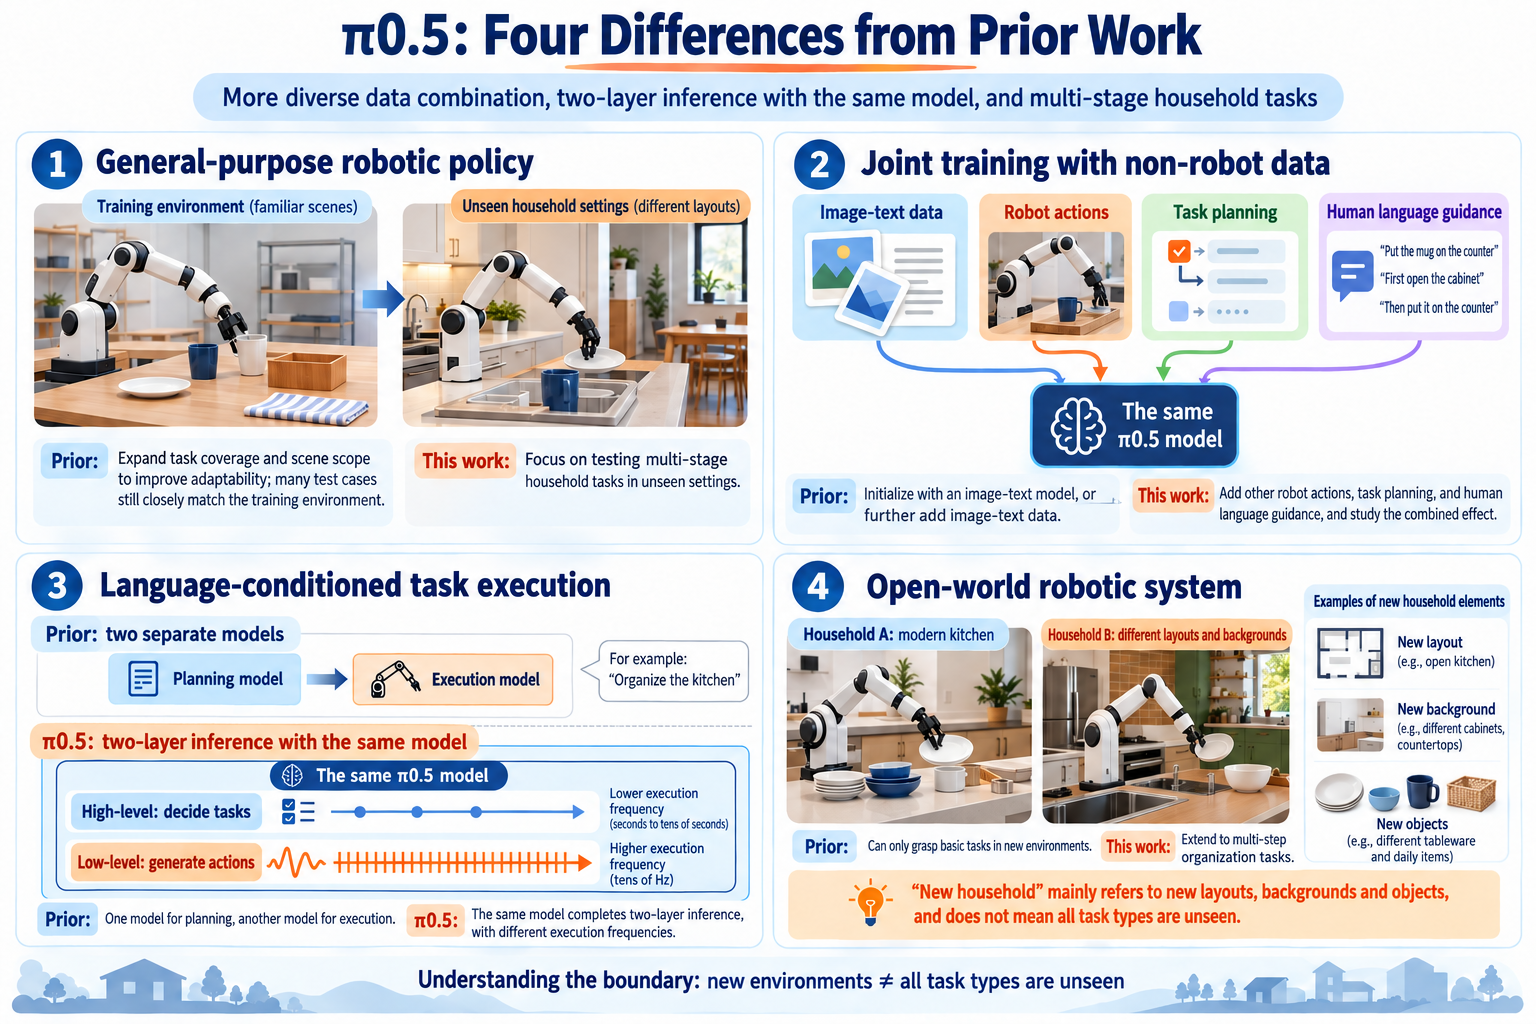
Políticas generalistas de robots: Trabajos anteriores amplían la cobertura de tareas y escenas, pero muchas pruebas siguen estando cerca de las condiciones de entrenamiento. Este artículo enfatiza tareas domésticas de múltiples etapas en hogares desconocidos.
-
Entrenamiento conjunto con datos no robóticos: Trabajos previos inicializan o continúan el entrenamiento con datos imagen-texto. Aquí se combinan y evalúan acciones de otros robots, predicción de subtareas y guía mediante lenguaje humano.
-
Organización de tareas basada en lenguaje: Un diseño común separa los modelos de planificación y ejecución. π0.5 usa un solo modelo para ambos niveles, aunque se ejecutan a frecuencias diferentes.
-
Sistemas de mundo abierto: Robots anteriores realizan tareas básicas como el agarre en entornos nuevos. Este trabajo se extiende al ordenamiento en múltiples pasos; los nuevos hogares significan principalmente nuevas distribuciones, fondos y objetos, no categorías de tareas completamente inéditas.
Plataformas de Robots y Datos
Objetivos y Componentes
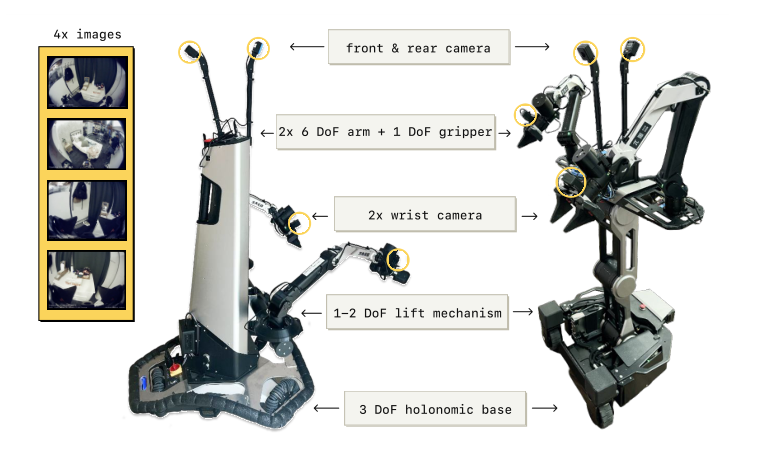
Artículo: Se utilizan dos plataformas móviles bimanuables, con el objetivo de un único modelo que pueda ordenar y limpiar diferentes hogares.
| Componente | Configuración y función |
|---|---|
| Brazos y pinzas | Seis grados de libertad de movimiento más un control de pinza por brazo, 14 dimensiones en total. |
| Base móvil | Dos velocidades de traslación y una de rotación, tres dimensiones en total. |
| Mecanismo de elevación | Una o dos dimensiones para el ajuste de altura o de avance-retroceso. |
| Estado y acción | 18 o 19 dimensiones, según la plataforma. |
| Cámaras | Cuatro vistas RGB: frontal, trasera y dos muñecas. |
Las salidas son posiciones objetivo para brazos, pinzas y elevador, más velocidades de la base. Un controlador PD sencillo las sigue; el sistema descrito no tiene un módulo adicional de planificación de trayectorias ni de detección de colisiones.
Explicación: Los brazos manipulan, mientras que la movilidad y la elevación amplían el alcance. El hardware por sí solo no establece la capacidad de la tarea; lo hacen los experimentos.
Conectar Operación y Registro
Las demostraciones registran imágenes, estados y acciones. Las tareas de varios pasos también reciben anotaciones humanas de subtareas y ubicación de objetos. Tras el entrenamiento se añaden demostraciones en lenguaje: un experto selecciona la siguiente instrucción y una política de bajo nivel ya entrenada la ejecuta.
Expert selects “pick up the pillow” → Low-level policy executes → Record the images and chosen instruction
Explicación: Estos registros supervisan directamente qué hacer a continuación, en lugar de solo cómo se mueven las articulaciones. Suponen que la política de bajo nivel ya puede ejecutar la subtarea. En despliegue, el modelo selecciona los pasos por sí mismo.
Sensores, Recopilación y Capacidades
Las decisiones de alto nivel usan las cuatro vistas; las acciones de bajo nivel usan la frontal y las dos de muñeca. Los objetivos de control se ejecutan a 50 Hz, lo que no significa volver a ejecutar el modelo completo 50 veces por segundo.
Unas 400 horas de demostraciones móviles provienen de aproximadamente 100 hogares. Otras fuentes incluyen brazos domésticos estacionarios, robots de laboratorio y OXE. Las resoluciones de imagen, las frecuencias de muestreo por fuente y las duraciones de las demostraciones no se especifican de forma uniforme; la frecuencia de control de 50 Hz no puede rellenar esas lagunas.
Los comportamientos demostrados incluyen recogida de ropa, colocación de platos, organización de cajones, hacer la cama y colgar toallas. Las pruebas cuantitativas en hogares reales cubren tres hogares no vistos, centrándose en tareas de carga de cajones, ropa a la cesta y platos al fregadero; las comparaciones controladas también incluyen hacer la cama.
Entrenamiento Conjunto Heterogéneo y Acciones Jerárquicas
Seleccionar Primero la Subtarea Actual
“Limpia el dormitorio” no especifica qué agarrar ahora. El modelo debe inspeccionar la escena, elegir el siguiente paso y condicionar la generación de acciones en él.
Dos relaciones condicionales lo resumen:
Current images + state + overall task → Subtask s
Current images + state + subtask s → Action chunk A
Aquí, s es texto como “recoge la almohada”, y A es una secuencia de control. En la factorización del artículo, las acciones de bajo nivel dependen de la subtarea en lugar de depender directamente de la instrucción global.
Una almohada en el suelo puede dar lugar a “recógela”, seguido de “ponla en la cabecera de la cama”. Si la elección de alto nivel es errónea, unos movimientos precisos aún pueden ejecutar la tarea equivocada. Abrir y cerrar cajones repetidamente es un fallo observado.
Acciones Codificadas para Entrenamiento, Acciones Continuas para Ejecución
El modelo necesita aprendizaje eficiente y control preciso y oportuno, por lo que las etapas usan representaciones diferentes.
-
Preentrenamiento: FAST comprime acciones continuas en símbolos discretos, aprendidos junto con texto mediante predicción del siguiente token.
-
Postentrenamiento: Se añade un experto en acciones entrenado con flow matching manteniendo la predicción de texto y de acciones discretas.
-
Ejecución: Generar texto de subtarea de forma autoregresiva y luego usar diez actualizaciones desde una inicialización aleatoria para obtener un fragmento continuo.
Para 50 pasos futuros y 18 controles por paso, el controlador en última instancia necesita un arreglo numérico de 50 × 18, no texto. El entrenamiento codificado seguido de control continuo es una distinción importante entre etapas.
Explicación: La longitud del fragmento controla el horizonte de predicción; el número de actualizaciones controla el refinamiento interno. La predicción de un solo paso carece de planificación dentro del fragmento, mientras que los horizontes largos encuentran más cambios de escena. El artículo usa 50 puntos de control y diez actualizaciones sin establecer sistemáticamente que sean óptimos para cada robot.
La generación conjunta de fragmentos no elimina la necesidad de retroalimentación. El artículo no da una fracción de ejecución universal para todas las plataformas, y el ensamblado temporal al estilo ACT no es su mecanismo central.
Qué Aporta Cada Fuente de Datos
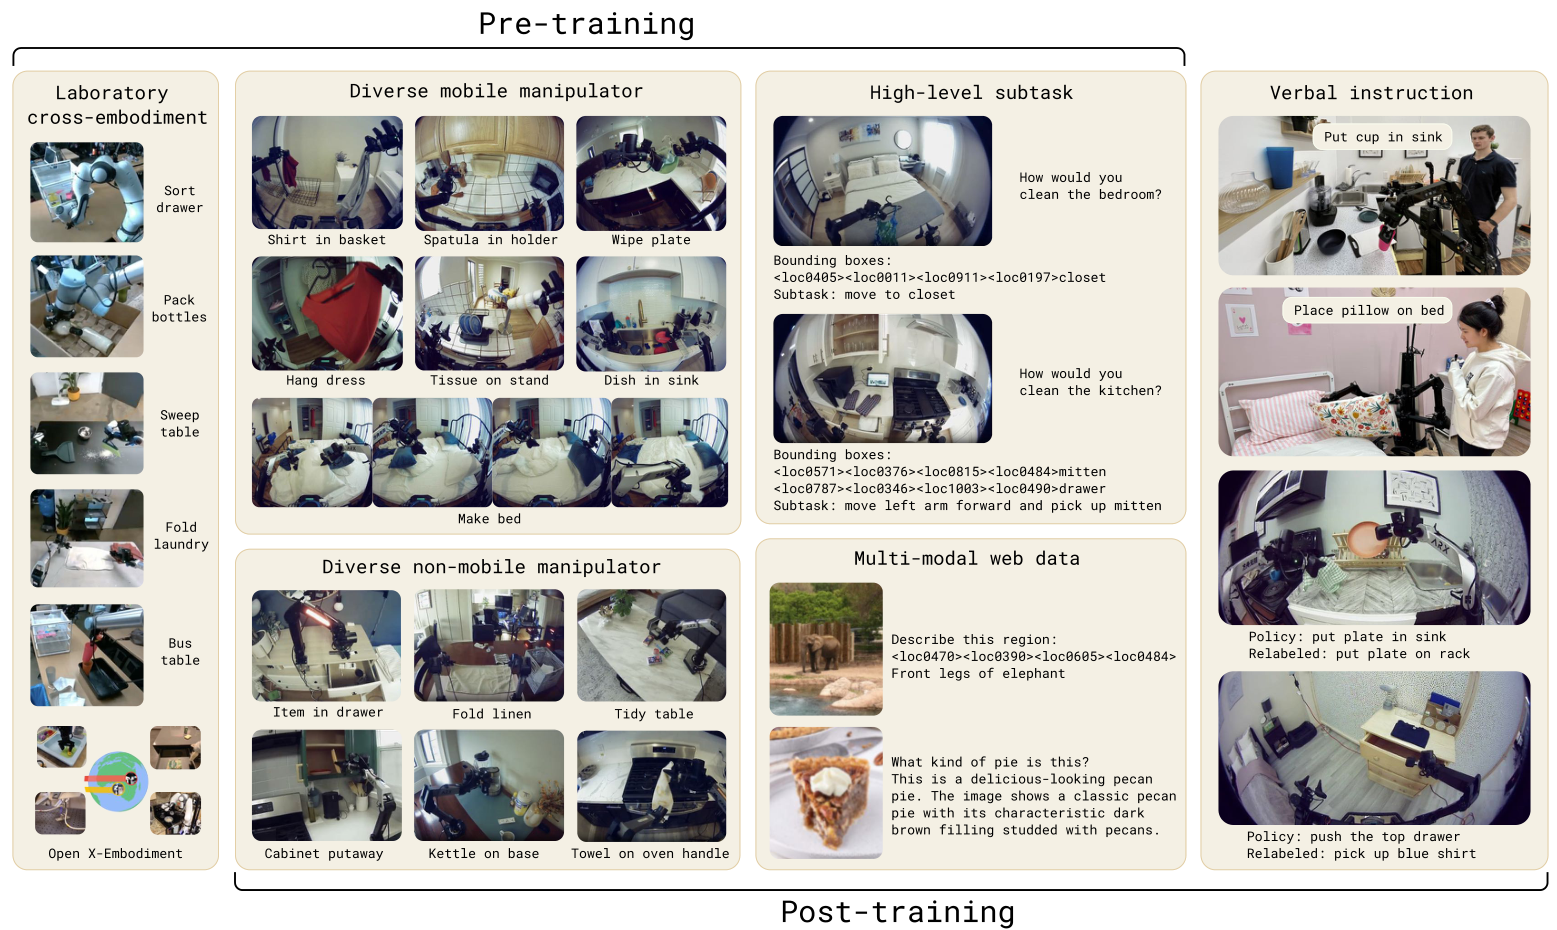
| Datos | Oportunidad de aprendizaje |
|---|---|
| Datos de robots móviles domésticos | Combinar movimiento, elevación y manipulación bimanuable en hogares reales. |
| Brazos estacionarios en distintos entornos | Más hogares, objetos y escenas de manipulación. |
| Datos de laboratorio entre robots | Más habilidades y tareas. |
| Anotaciones de subtareas | Elegir el siguiente paso y localizar los objetos relevantes. |
| Datos web de imagen-texto | Conservar capacidades de reconocimiento, comprensión de escenas y lenguaje. |
| Demostraciones de lenguaje de expertos | Dirigir una política de bajo nivel existente a través de tareas de varios pasos. |
Estas fuentes entrenan un único modelo; la ejecución no recorre los conjuntos de datos en ciclo. Muestras diferentes solicitan salidas diferentes: un par imagen-pregunta-respuesta no necesita acciones de robot inventadas.
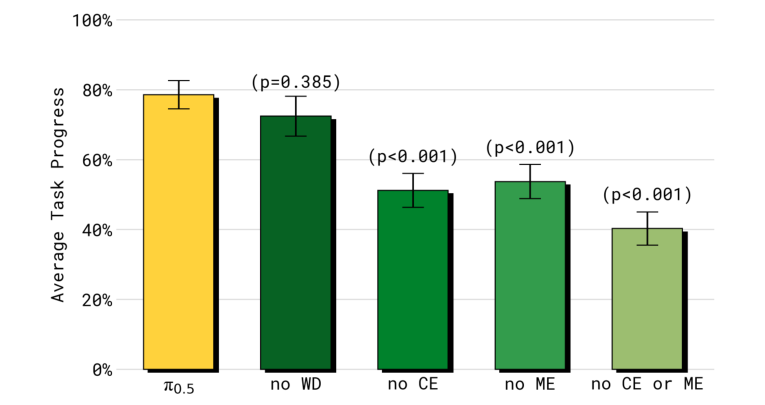
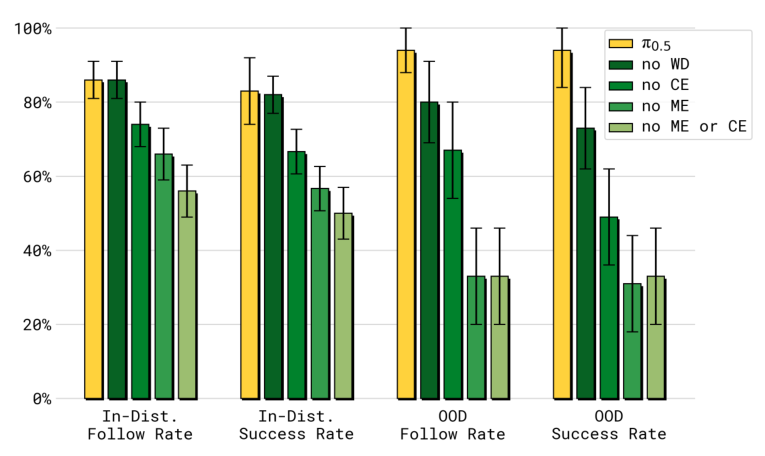
Límite de evidencia: Eliminar datos de otros robots reduce el rendimiento en tareas domésticas controladas. Eliminar datos web no causa una caída estadísticamente significativa en ese grupo de prueba, pero empeora el seguimiento de instrucciones con objetos desconocidos y el juicio de alto nivel. Las distintas fuentes no son igual de importantes en cada prueba.
Conectar las Dos Etapas de Entrenamiento
Preentrenamiento: Partir de PaliGemma y mezclar acciones de robot, subtareas, ubicaciones de objetos y tareas de imagen-texto durante 280.000 pasos. En esta etapa no se usa pérdida de entrenamiento del experto continuo.
Normalizar acciones a [−1, 1] usando los percentiles 1 y 99 de cada dimensión del conjunto de datos, y rellenar con ceros los robots de menor dimensionalidad. Etiquetas de modo de control en las instrucciones distinguen objetivos de articulaciones de objetivos de efector final.
Postentrenamiento: Añadir un experto en acciones de aproximadamente 300M parámetros, inicializado aleatoriamente, y entrenar durante 80.000 pasos. Mantener demostraciones exitosas y sin timeout de robots móviles domésticos y brazos estacionarios y eliminar datos de acciones de robots de laboratorio cruzados. Conservar subtareas y datos web relevantes y añadir demostraciones de lenguaje de expertos.
El objetivo puede resumirse como:
Pérdida total = pérdida de predicción de tokens + 10 × pérdida de acciones continuas.
El primer término es entropía cruzada para texto y tokens FAST; el segundo es error cuadrático en las direcciones de actualización de acciones. Su peso es diez durante el postentrenamiento y cero durante el preentrenamiento. La atención separa las representaciones de acciones para que el experto continuo no pueda leer las respuestas de acciones FAST.
El entrenamiento con flow matching mezcla acciones reales A con ruido gaussiano estándar ε: noisy action = τA + (1−τ)ε, con τ entre cero y uno. La ecuación (1) escribe el objetivo como ε−A. Para A=0.6, ε=−0.2 y τ=0.5, la entrada es 0.2 y el objetivo −0.8. Esta es una convención de signo de campo vectorial, no una orden para mover el robot hacia atrás.
τ es el progreso interno de generación; ε y A son arreglos normalizados de 50 × d, donde d es la dimensionalidad de la acción. No son segundos. El ejemplo escalar explica la ecuación; el entrenamiento usa arreglos completos. La inferencia parte de ruido y no requiere una A real de referencia.
Red Completa, Experimentos y Límites
Artículo: Las imágenes se convierten en características visuales, y las instrucciones y el estado entran en el VLM. A diferencia de π0, π0.5 discretiza el estado como tokens de texto. La columna vertebral predice subtareas y proporciona características de observación al experto más pequeño, que genera acciones continuas a partir de entradas ruidosas.
| Entrada o módulo | Forma o procesamiento |
|---|---|
| Imágenes | Cuatro vistas de alto nivel, tres vistas de bajo nivel; codificadas como secuencias de características visuales. |
| Instrucción global, subtarea y estado | Secuencias de tokens que forman el prefijo de observación junto con las características visuales. |
| VLM backbone | Ancho 2048, 18 capas; predice texto y, durante el preentrenamiento, tokens FAST. |
| Experto en acciones | Ancho 1024, 18 capas, unos 300M de parámetros; incrusta linealmente acciones ruidosas de 50 × d. |
| Progreso de generación τ | Codificado por separado e inyectado en las capas del experto; la atención lee el prefijo de observación. |
| Salida continua | Proyectar de vuelta a actualizaciones de 50 × d; diez actualizaciones generan un fragmento. |
El experto lee observaciones y sus propias características de acción, pero no tokens FAST. La columna vertebral no lee características del experto. La atención comparte información de observación sin sumar directamente anchos 2048 y 1024. El artículo no especifica de forma uniforme la longitud de la secuencia visual ni una dimensión máxima de acción en todos los conjuntos de datos.
Precaución: La Figura 3 etiqueta Gemma como 2.6B, mientras que el Apéndice E la llama un “VLM de 2B”. Se conservan los recuentos de capas y anchos verificables sin inventar un número total exacto de parámetros.
El apéndice da 50 puntos de control. La convención de extremo inclusivo escribe H=49; “50 pasos” evita confusiones. Las dos plataformas generan matrices de 50 × 18 o 50 × 19, con relleno para entrenamiento entre robots.
Training: heterogeneous data → backbone predicts text / action tokens
          post-training adds noisy actions → expert learns continuous updates

Inference: observations + overall task → subtask text
           observations + subtask + random actions → ten updates → continuous chunk → execute and observe again
Tres puntos a tener en cuenta en los experimentos:
-
Más ubicaciones de entrenamiento generalmente ayudan. Las comparaciones usan 3, 12, 22, 53, 82 y 104 ubicaciones. El modelo con 104 ubicaciones se aproxima a un modelo que ha visto el entorno de evaluación en estas tareas; esto no es una garantía para cada nuevo hogar.
-
La receta completa supera cambiar solo el entrenamiento de acciones. Con el mismo conjunto de datos de robots y pasos similares, π0.5 supera a π0 y a π0-FAST+Flow. FAST por sí solo no puede explicar la ganancia; también difieren el coentrenamiento de subtareas y de imagen-texto.
-
El razonamiento de alto nivel ayuda, y los datos de entrenamiento de alto nivel también importan. Una variante que conserva todos los datos de entrenamiento pero omite la selección explícita de subtareas en el momento de la inferencia es la segunda mejor. Eliminar demostraciones en lenguaje o datos web reduce el rendimiento. Decir una subtarea antes de actuar no es toda la explicación.
La mayoría de las figuras principales informan puntuaciones de finalización de tareas, no tasas de éxito de la tarea completa. Normalmente hay alrededor de diez ensayos por política por tarea, o aproximadamente 40 en las cuatro tareas controladas; se excluyen algunos ensayos cancelados. Dishes-to-sink tiene ocho puntos posibles, otorgados por separado para recoger y colocar. La mitad de la puntuación no significa que la mitad de los ensayos hayan tenido éxito completo.
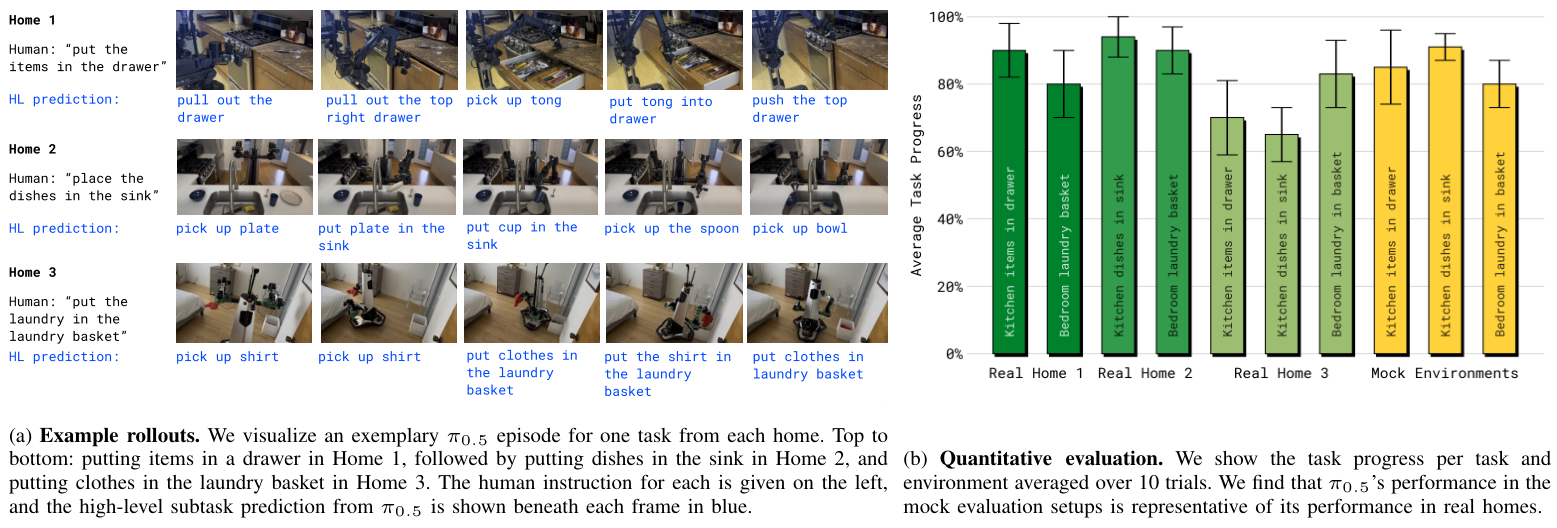
El artículo demuestra comportamientos de 10–15 minutos, mientras que muchas tareas evaluadas cuantitativamente en hogares reales duran alrededor de 2–5 minutos. No las confundas. Manijas desconocidas, puertas difíciles, oclusión, decisiones repetidas de alto nivel, preferencias complejas y memoria entre habitaciones siguen siendo desafíos. El trabajo valida comportamientos útiles en nuevos hogares más que la finalización fiable de todas las tareas domésticas.
Ubicaciones de referencia: resumen e introducción; Secciones II, IV-A–IV-E, V-A–V-E y VI; Figuras 3, 5 y 7–13; Apéndices B y E. Esta guía no añade suposiciones específicas de transferencia de hardware del proyecto.
Comparando π0 y π0.5
Cambios principales
Explicación: π0 estudia el control generalista y diestro entre robots y tareas. π0.5 amplía esto hacia la comprensión de hogares desconocidos y la organización de trabajo doméstico de múltiples etapas.
| Aspecto | π0 | π0.5 |
|---|---|---|
| Enfoque | Manipulación general entre robots y tareas. | Manipulación de múltiples etapas en nuevos hogares, con nuevos objetos y distribuciones. |
| Datos | Inicialización VLM, principalmente demostraciones entre robots y etiquetas de lenguaje para el entrenamiento de la política. | Coentrenamiento continuo en acciones, subtareas, localización y datos web; demostraciones de lenguaje de expertos en el post-entrenamiento. |
| Entrenamiento de acciones | Experto continuo tanto en preentrenamiento como en post-entrenamiento. | Tokens FAST durante el preentrenamiento; se añade el experto durante el post-entrenamiento manteniendo ambas representaciones. |
| Acciones ejecutadas | Fragmentos continuos de flow matching. | También fragmentos continuos de flow matching; FAST mejora principalmente el entrenamiento. |
| Organización de tareas largas | Seguir instrucciones de una persona o de un VLM externo de alto nivel cuando se necesita planificación semántica explícita. | El mismo modelo selecciona subtareas de la tarea global y genera acciones para ellas. |
| Entrada de estado | Estado continuo proyectado en el experto de acciones. | Estado discretizado como tokens en el VLM. |
| Objetivo del post-entrenamiento | Mejorar la competencia en tareas con demostraciones más limpias y consistentes. | Adaptar tanto la ejecución de acciones como la selección de subtareas para la manipulación móvil en el hogar. |
Ambos usan PaliGemma y un experto de acciones de aproximadamente 300M parámetros, con 50 puntos de control y diez actualizaciones de flujo. π0.5 cambia principalmente la receta de entrenamiento y la organización de tareas; sus ganancias no se deben simplemente a un modelo más grande o a fragmentos más largos.
Ejemplo: Poner un plato en el fregadero
π0:
Images + state + “put the plate in the sink” → continuous chunk → execute
A person or external high-level model can supply intermediate instructions for an explicitly decomposed kitchen-cleaning task.

π0.5:
Images + state + “clean the kitchen” → model selects “pick up the plate”
Images + state + “pick up the plate” → continuous chunk → execute and observe again
Then select another subtask, such as “put the plate in the sink,” from the updated scene.
Precaución: Esto compara vías de ejecución. El π0 original también demuestra tareas largas; no se limita a operaciones de un solo paso. π0.5 añade selección explícita de subtareas dentro del mismo modelo.
¿Qué respaldan los experimentos?
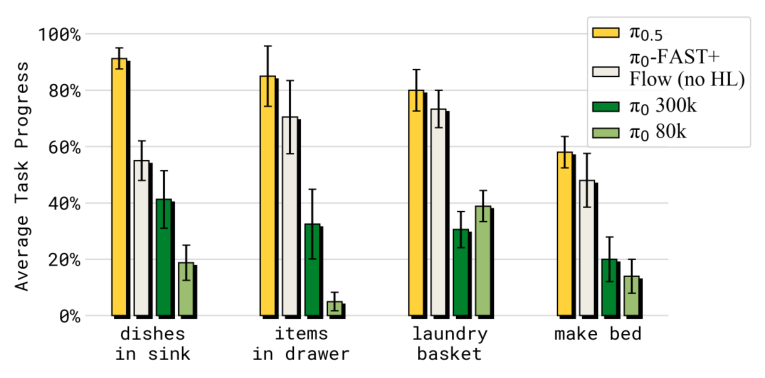
Artículo: Con el mismo conjunto de datos de robots y pasos similares, la receta completa de π0.5 supera a π0 y a π0-FAST+Flow en los hogares controlados desconocidos probados. Este último ya combina FAST y flow matching, pero usa solo datos de acciones de robots y carece de razonamiento de alto nivel. Cambiar solo el entrenamiento de acciones es insuficiente para igualar al π0.5 completo.
Precaución: Estas son líneas base reentrenadas dentro del artículo de π0.5, no puntuaciones empalmadas de publicaciones separadas. Respaldan mejoras en estas tareas y condiciones, no una ganancia fija en todas partes.
Compara cuidadosamente los alcances de los datos: el “más de 10.000 horas” de π0 se refiere al total de demostraciones de robots, mientras que las “alrededor de 400 horas” de π0.5 se refieren solo a la manipulación móvil en el hogar y excluyen una cantidad sustancial de datos de otros robots e imagen-texto. Los números no muestran que π0.5 gane universalmente con menos datos totales.
Fuentes de comparación: π0, 2410.24164v4, Secciones III–V y experimentos de instrucciones de alto nivel; π0.5, 2504.16054v1, Secciones IV, V-D, V-E, Figura 12 y Apéndice E.