FAST y π0-FAST: Cómo la tokenización eficiente de acciones acelera el aprendizaje de robots
FAST: Tokenización eficiente de acciones para modelos Visión-Lenguaje-Acción
- Tokenización de acciones
- DCT
- Compresión BPE
- Políticas autoregresivas
Relación con π0: El artículo se titula FAST; π0-FAST es la política entrenada usándolo. FAST es un método de tokenización, FAST+ un tokenizador de acciones universal preentrenado, y π0-FAST un VLA autoregresivo que usa esta representación. Comparte el enfoque de backbone PaliGemma con π0 pero cambia la generación de acciones; no es simplemente un preprocesador de compresión añadido al experto de flow matching de π0.
Fuente de lectura: El PDF original, Secciones I–VII y Apéndices A–E, siguiendo la estructura del análisis detallado de π0 anterior. Los números de página se refieren a las páginas físicas del PDF de 19 páginas, del cual se extraen las figuras. Las derivaciones adicionales y los ejemplos numéricos se marcan como explicaciones en lugar de atribuirse al artículo.
Requisitos previos
VLAs y tokenización de acciones
Explicación: Un VLA convierte una escena visible y una tarea en lenguaje en controles de robot. Para doblar una camiseta, las imágenes localizan la camiseta y las pinzas, el lenguaje define el objetivo, el estado describe los brazos y el modelo predice las futuras acciones de brazos y pinzas.
Este artículo usa segmentación de acciones: predecir pasos futuros en lugar de solo uno. Definimos:
Aquí es el tiempo de control del robot, una acción de dimensión , y el horizonte. es la vista de imagen , el número de cámaras, la instrucción y la propiocepción. La política aprende , donde denota los parámetros de la red.
Artículo: Los bloques son principalmente de un segundo de duración. Así, depende de la frecuencia de control: 15 a 15 Hz, 20 a 20 Hz y 50 a 50 Hz. No asumas que el de π0 se usa para cada conjunto de datos aquí.
La tokenización de acciones mapea un bloque continuo a símbolos discretos:
es el tokenizador, un ID de token de acción, el tamaño del vocabulario y la longitud de la secuencia comprimida. Bloques con la misma forma pueden producir diferentes , igual que frases de la misma longitud pueden tener diferentes recuentos de subpalabras.
Precaución: Un ID de token no es un ángulo articular. Un token FAST no tiene por qué corresponder a un instante de tiempo, una articulación o una acción completa. Primero genera la secuencia y luego decódifícala a un bloque continuo.
Binning puntual, flow matching de π0 y FAST
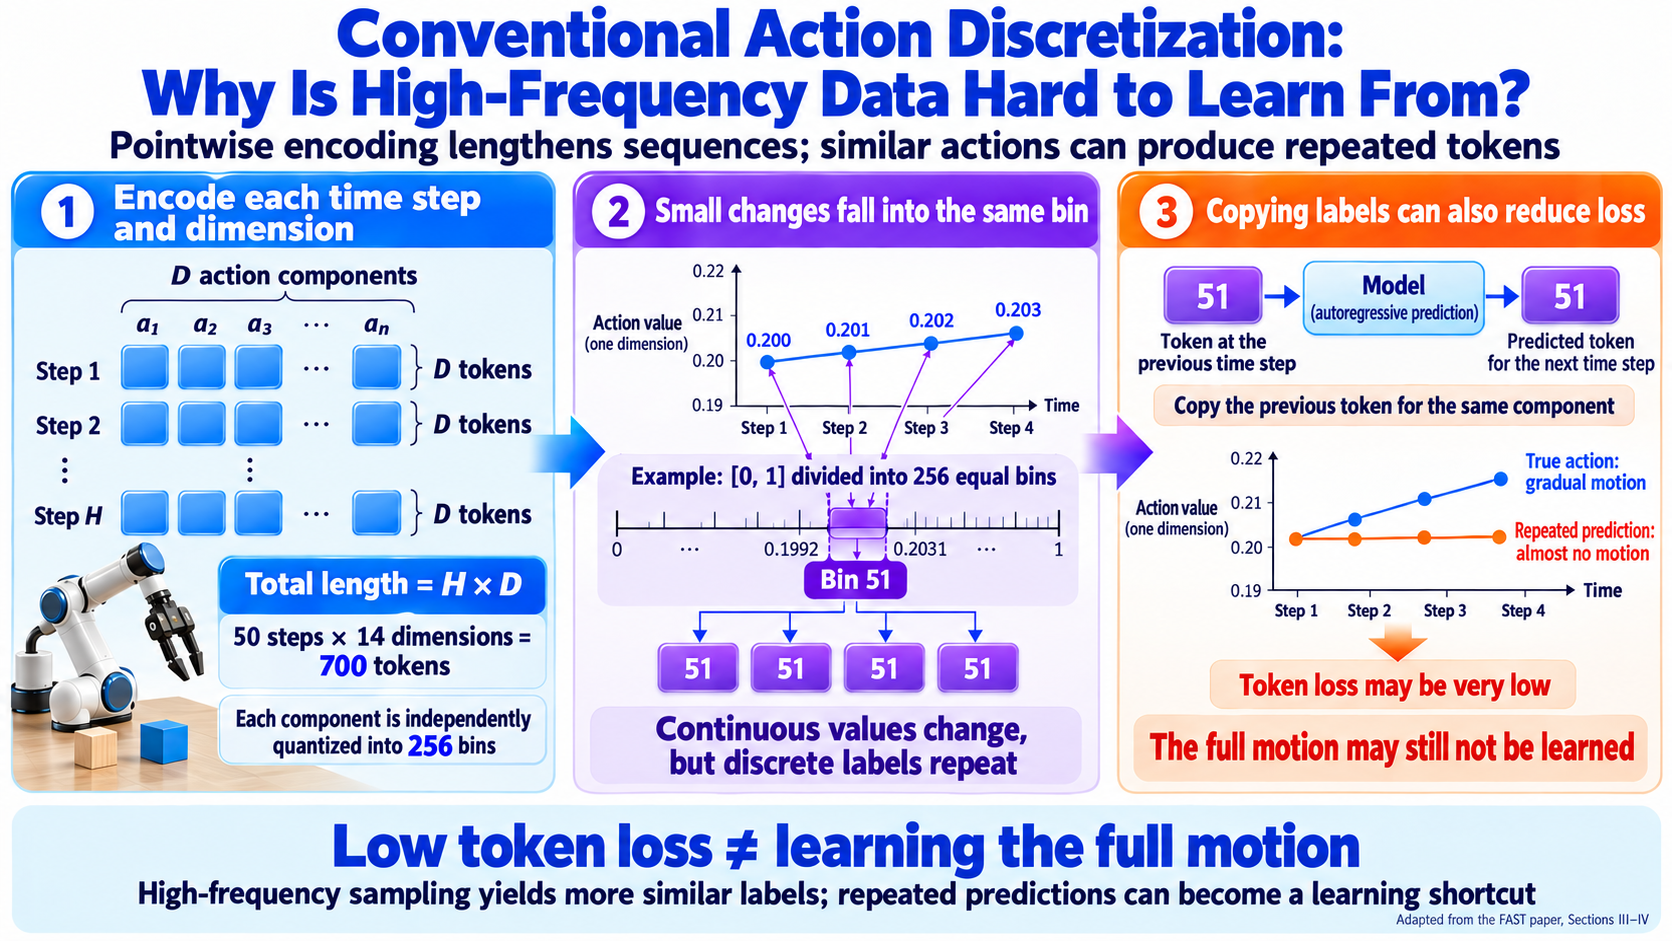
El binning convencional cuantiza de forma independiente cada instante de tiempo y dimensión de acción. Una configuración común comentada en el artículo usa 256 bins uniformes:
D action components at step 1 → D tokens
D action components at step 2 → D tokens
……
D action components at step H → D tokens
Total: H × D tokens
Los datos de alta frecuencia producen entonces secuencias largas con valores vecinos muy similares. Copiar tokens repetidos puede reducir la pérdida sin aprender el movimiento global.
Ejemplo mínimo: Los valores pueden caer todos en un mismo bin grueso. Repetir el token anterior predice muchas etiquetas correctamente pero no logra expresar la trayectoria que cambia de forma constante.
FAST usa:
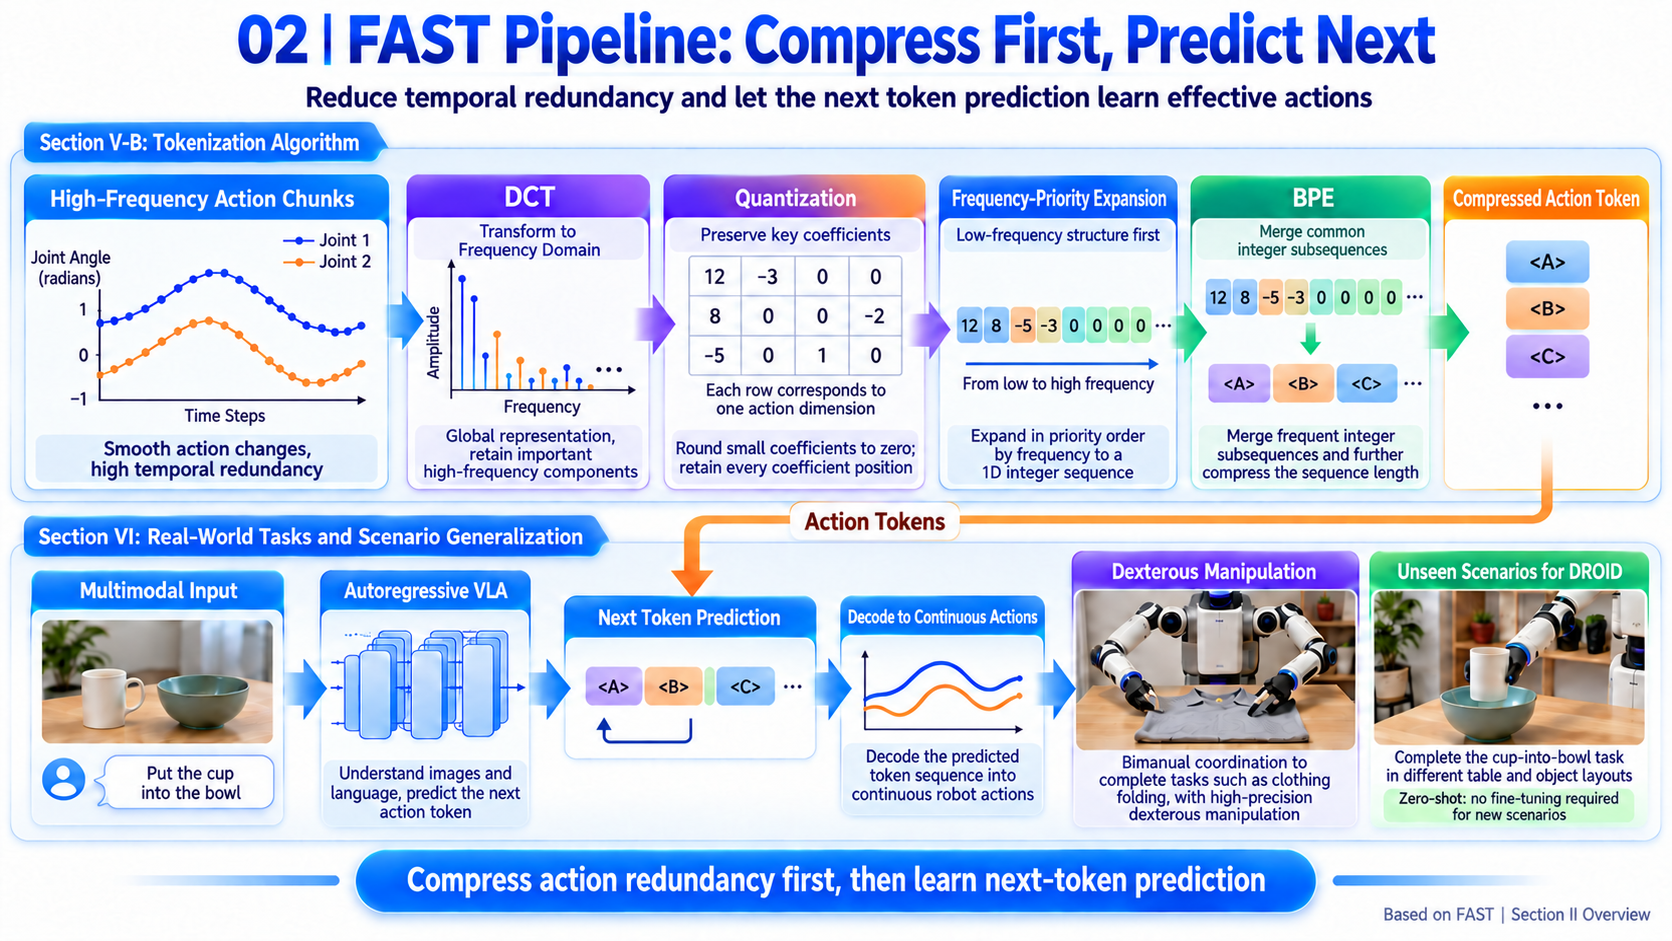
Continuous chunk → frequency coefficients → quantization → frequency-first flattening → BPE
          → fewer action tokens → autoregressive VLA prediction → continuous-chunk decoding
La transformada discreta del coseno (DCT) expresa una trayectoria como componentes cosenoidales a diferentes frecuencias; el byte-pair encoding (BPE) fusiona subsecuencias enteras comunes. Predecir esta representación comprimida de la trayectoria elimina supervisión redundante.
| Aspecto | VLA autoregresivo puntual | π0 original | π0-FAST |
|---|---|---|---|
| Representación | Valor discreto por instante de tiempo y dimensión | Bloque continuo | Tokens discretos comprimidos para un bloque |
| Objetivo | Predicción del siguiente token | Flow matching condicional | Predicción del siguiente token |
| Generación | Generar secuencialmente tokens | Actualizar iterativamente el bloque completo con un experto | Generar tokens comprimidos y luego decodificar |
| Datos de alta frecuencia | Más tokens y repetición | La generación continua evita la decodificación dimensión por dimensión | Comprime la redundancia temporal y acorta la salida |
| Limitación principal | La destreza de alta frecuencia puede ser difícil de aprender | Requiere un experto continuo dedicado | Cuantización con pérdida; la inferencia autoregresiva aún puede ser lenta |
Artículo: La Tabla I reduce un bloque de camiseta de un segundo, 50 Hz, 14D de 700 tokens puntuales a una media de 53 tokens FAST. La decodificación sigue produciendo 50 × 14 acciones; el control del robot no pasa a ser “53 tokens por segundo”.
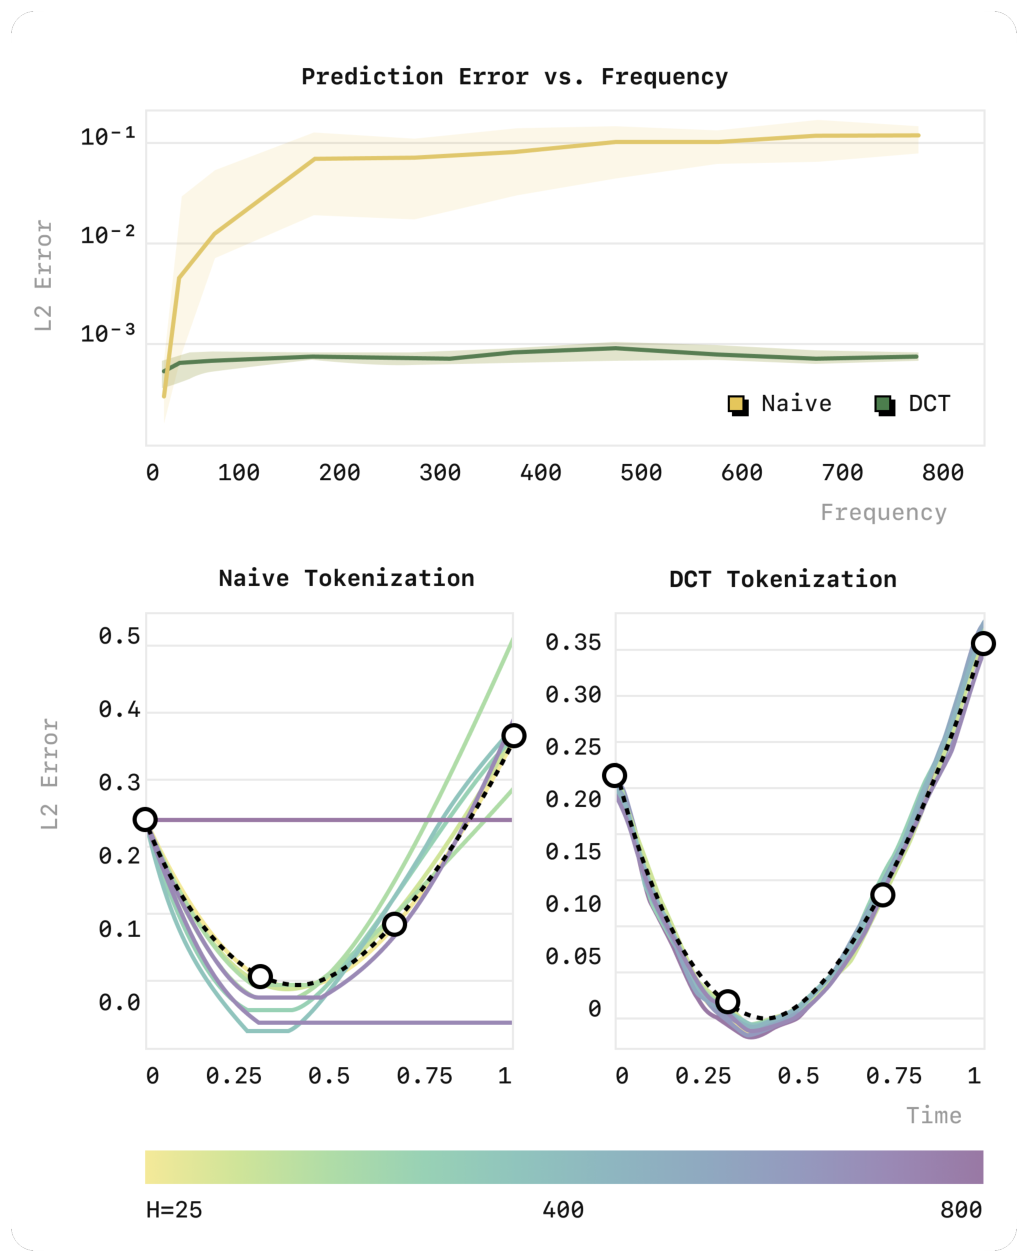
Figura 2: predicciones de la misma spline cúbica a diferentes densidades de muestreo. Amarillo es binning puntual; verde es DCT. La escala de color inferior va de amarillo claro a morado a medida que el número de muestras aumenta de 25 a 800. De la Figura 3 original, página 3 del PDF.
Lectura de la figura: Cuatro puntos de entrada definen el mismo tipo de objetivo de interpolación mientras aumenta la densidad. El error de la tokenización puntual crece, acercándose finalmente a una predicción constante; el error de DCT se mantiene bajo. El aprendizaje puede fallar por la representación y no por una tarea más difícil. Los valores 25–800 son muestras sintéticas por secuencia, no frecuencias reales de control de robot.
Entrenamiento, inferencia y evaluación
| Etapa | Entradas y operaciones | Salida y criterio |
|---|---|---|
| Entrenamiento del tokenizador | Normalizar acciones, aplicar DCT y cuantización, y aprender BPE a partir de secuencias enteras. | Reglas de codificación/decodificación; error de compresión y reconstrucción. |
| Entrenamiento de la política | Condicionar en imágenes, lenguaje y estado; codificar las futuras acciones demostradas como etiquetas FAST. | Optimización de entropía cruzada y pesos del VLA. |
| Inferencia de la política | Generar tokens, invertir BPE, des-cuantizar y aplicar la DCT inversa. | Bloques continuos para el controlador. |
| Evaluación en robot | Ejecutar tareas y condiciones iniciales especificadas. | Éxito de la tarea o progreso normalizado. |
Artículo: La evaluación incluye seis tareas/configuraciones de robot real y un benchmark en simulación, además de pruebas offline separadas de compresión FAST+ en distintos cuerpos. Comprimir datos de humanoides no es lo mismo que entrenar y validar físicamente una política humanoide.
Precaución: La pérdida de tokens, el error de reconstrucción y la puntuación de la tarea son distintos. Un hallazgo clave es que etiquetas repetitivas pueden producir una pérdida de entrenamiento baja mientras que las trayectorias y el comportamiento del robot siguen siendo pobres.
Resumen
Traducción
Los modelos de secuencia autoregresivos, incluidos los VLA tipo Transformer, pueden representar comportamientos robóticos complejos y generalizables, pero requieren un tokenizador para mapear predicciones discretas a acciones continuas. Los autores encuentran que un binning simple por dimensión y por instante de tiempo funciona mal en datos de alta frecuencia y alta destreza.
Proponen Frequency-space Action Sequence Tokenization (FAST), usando compresión basada en DCT para permitir que los VLA autoregresivos aprendan tareas de alta destreza y alta frecuencia donde la discretización estándar falla.
FAST+ es un tokenizador universal entrenado en un millón de secuencias de acciones de robots reales, utilizable como tokenizador de caja negra en distintos espacios de acción y frecuencias de control.
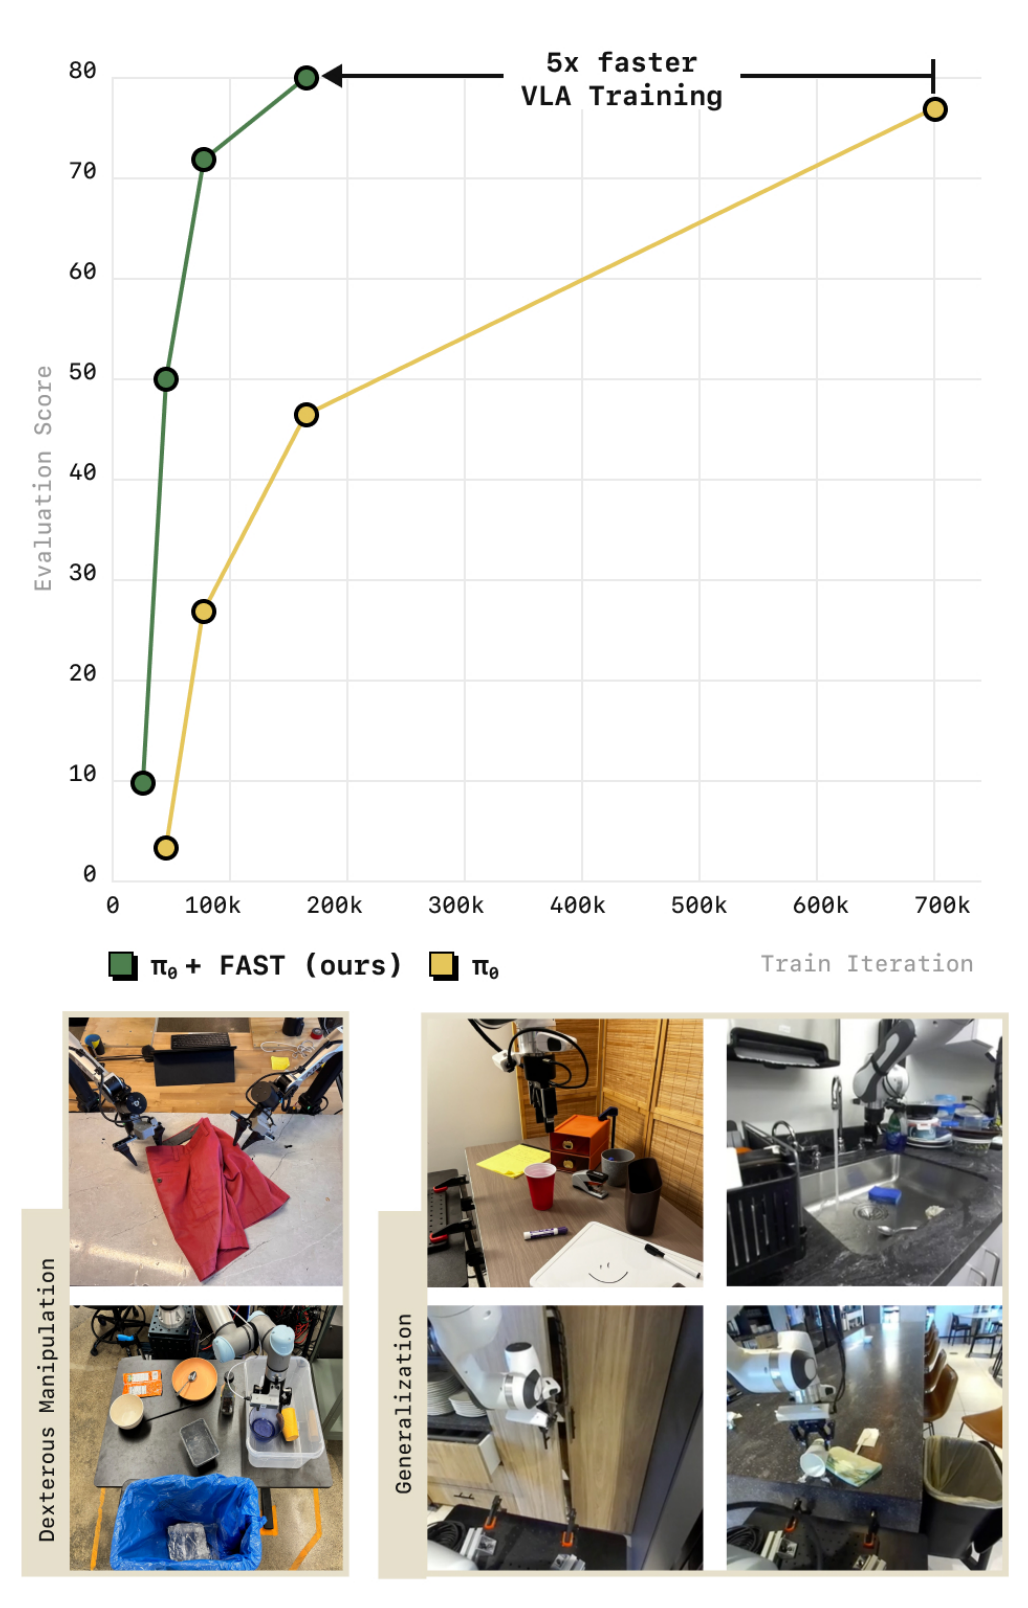
Combinado con el enfoque VLA de π0, FAST escala a 10 000 horas de datos de robots, iguala el rendimiento de los VLA tipo difusión y reduce el tiempo de entrenamiento hasta cinco veces.
Comentario
-
Motivación: Las acciones de alta frecuencia contienen información repetida. Los tokens puntuales gastan esfuerzo de predicción en etiquetas con poca supervisión de movimiento nueva.
-
Cambio principal: Cambiar la representación del objetivo de aprendizaje antes de entrenar la política. FAST comprime la información de la trayectoria sin reducir la frecuencia de ejecución ni descartar puntos de control.
-
Por qué puede funcionar: La DCT concentra la forma de la trayectoria, la cuantificación crea coeficientes comprimibles y BPE acorta combinaciones frecuentes. Los tres contribuyen a los tokens finales.
-
Significado de “universal”: FAST+ evita reentrenar un vocabulario BPE específico de cada conjunto de datos, pero aún requiere normalización, dimensiones y horizontes compatibles. Sus millones de muestras de entrenamiento son principalmente fragmentos de un segundo, no un millón de episodios completos de tareas.
-
Alcance de “cinco veces”: Los experimentos de políticas a gran escala reducen las horas de GPU requeridas hasta alrededor de cinco veces. Esto no es inferencia más rápida: v1 informa alrededor de 750 ms por fragmento π0-FAST frente a normalmente menos de 100 ms para π0.
Introducción
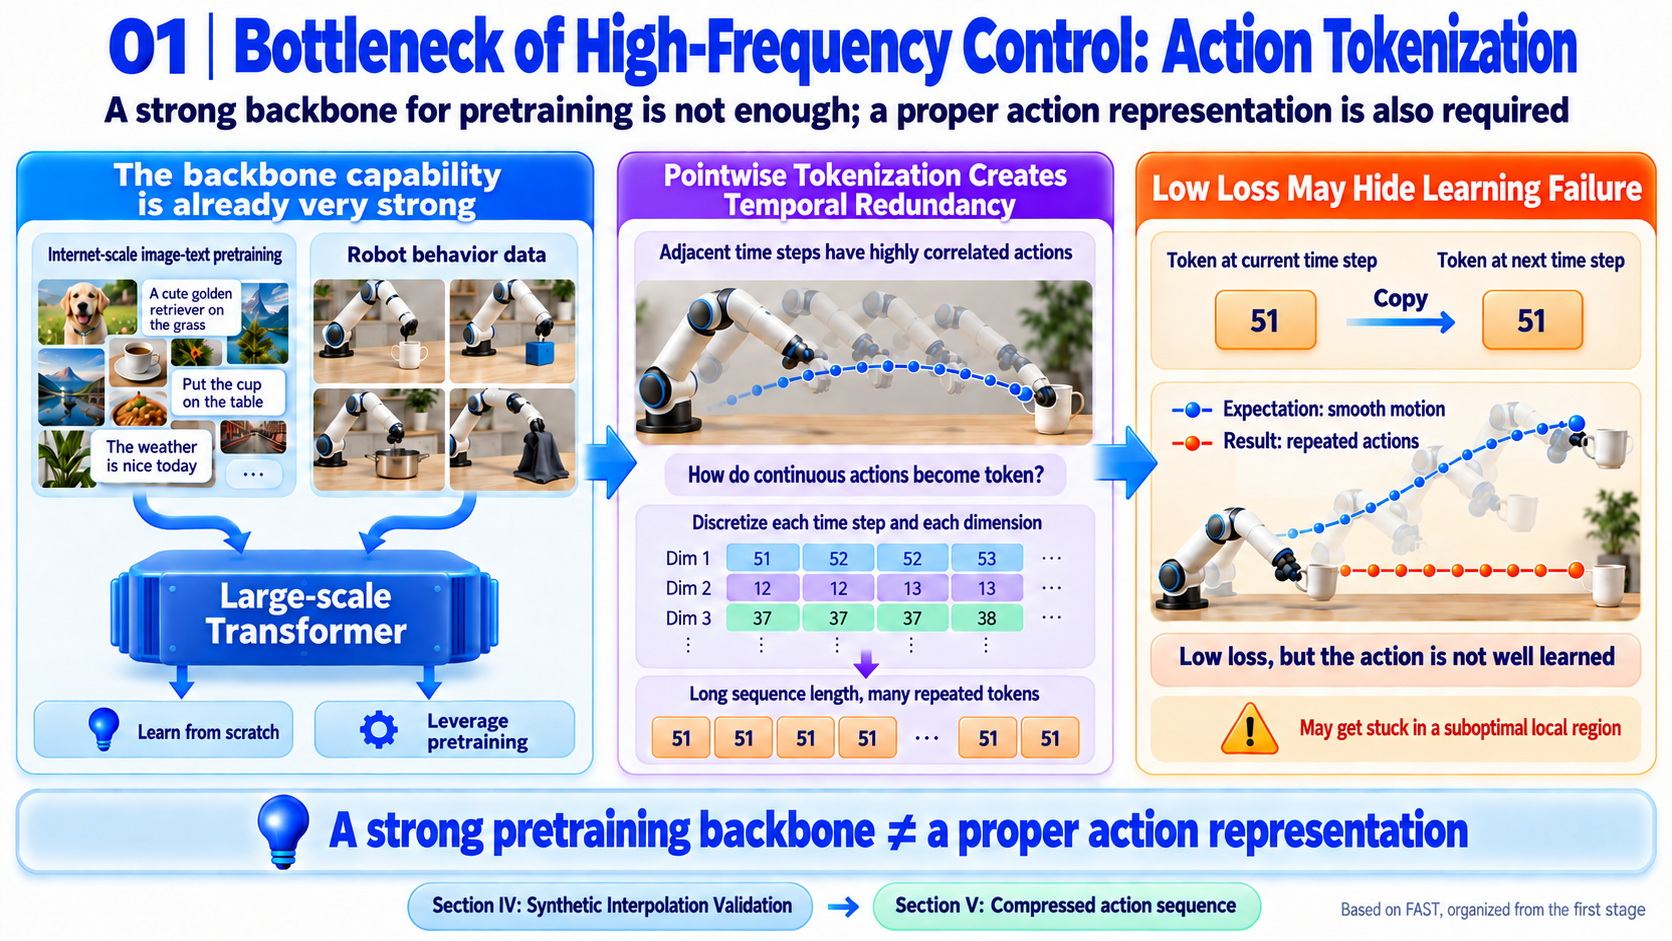
Párrafo 1: Localizar el cuello de botella en la tokenización
-
Idea principal: Los Transformers grandes pueden aprender el comportamiento del robot desde cero o usar preentrenamiento imagen-texto, pero las acciones deben tokenizarse. El binning punto a punto tiene dificultades en tareas hábiles de alta frecuencia porque copiar valores recientes correlacionados logra una pérdida baja y puede atrapar el aprendizaje en un óptimo local pobre.
-
Problema: Un backbone potente no garantiza un aprendizaje útil de acciones; la representación del objetivo puede limitar la supervisión.
-
Configuración: La Sección IV estudia la densidad de muestreo con interpolación sintética; la Sección V propone compresión.
Párrafo 2: Comprimir primero, predecir después
-
Idea principal: Inspirado por la tokenización de lenguaje, FAST usa DCT para señales continuas de robots. La predicción estándar del siguiente token entonces aprende tareas que antes fallaban y admite una política DROID usada mediante lenguaje en entornos no vistos.
-
Problema: Si la redundancia temporal es el obstáculo, reduce la redundancia de las etiquetas en lugar de solo aumentar la capacidad de la red.
-
Configuración: La Sección V-B presenta el algoritmo y la Sección VI evalúa tareas reales y la generalización de DROID.
Párrafo 3: Tokenización universal y políticas a gran escala
-
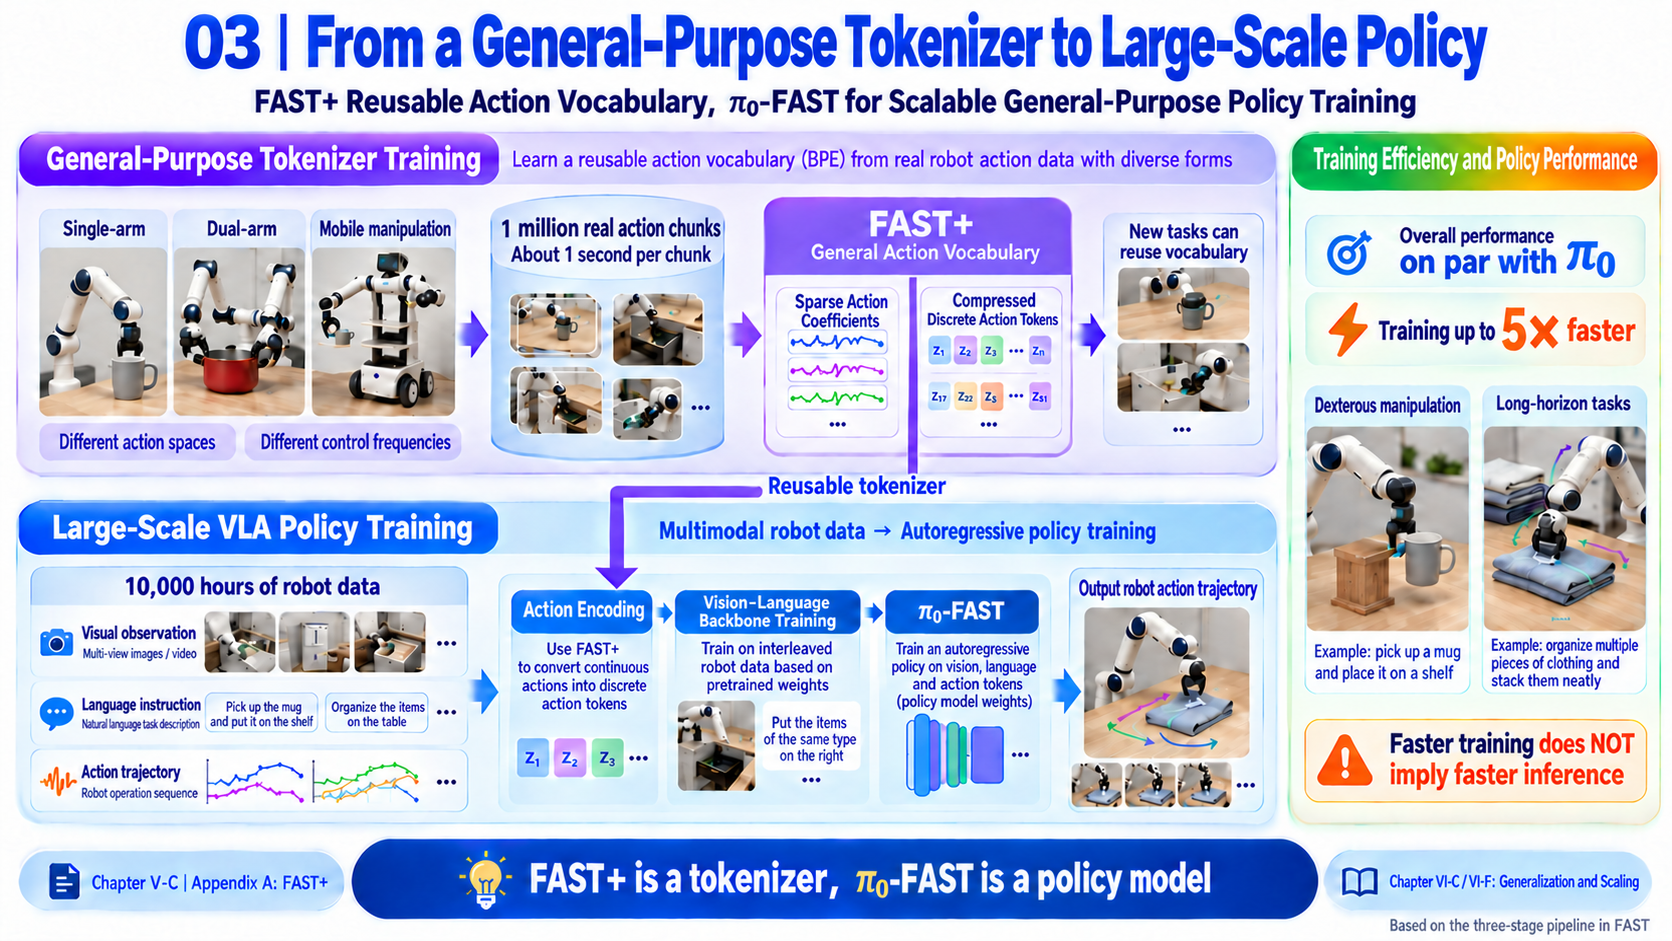
Idea principal: FAST+ aprende un vocabulario a partir de un millón de secuencias que abarcan brazos simples, bimanuales, móviles y diversas interfaces y frecuencias de control. π0-FAST escala la autorregresión a 10 000 horas con menos tiempo de entrenamiento que la comparación de estilo difusión.
-
Problema: Reentrenar un tokenizador para cada robot añade sobrecarga, y el método debe escalar más allá de conjuntos de datos individuales.
-
Configuración: La Sección V-C y el Apéndice A describen FAST+; VI-C prueba la universalidad y VI-F las políticas a gran escala.
Precaución: La introducción contiene tres párrafos principales, con el primero abarcando las páginas 1–2. Los saltos de página y los pies de figura no son párrafos adicionales. Las afirmaciones sobre el “primer” resultado de DROID reflejan la evaluación de los autores en el momento de la publicación, no una revisión de trabajos posteriores.
Trabajos relacionados
-
Tokenización de texto, imagen y audio: El BPE de texto fusiona subsecuencias frecuentes; otros tipos de datos usan cuantificación aprendida o representaciones en frecuencia. FAST aplica el principio de representación y compresión a fragmentos de acciones continuas. La DCT es analítica; solo se aprende el vocabulario BPE.
-
VLA: RT-2 y OpenVLA transfieren conocimiento imagen-texto al control pero comúnmente usan bins de acción punto a punto. FAST cambia las salidas para que un backbone autorregresivo pueda aprender destreza de alta frecuencia; π0 de flujo continuo es una comparación clave.
-
Representaciones de acción: Las subtareas semánticas y los puntos clave pueden depender de controladores diseñados a mano; el binning representa directamente los controles pero tiene redundancia temporal; las cabezas de regresión y difusión cambian los mecanismos de salida. FAST mantiene la predicción de secuencias discretas. La comparación de compresión aprendida usa cuantificación escalar finita (FSQ). FAST no necesita un codificador neuronal y rinde mejor en las reconstrucciones de alta fidelidad y tareas hábiles probadas, no necesariamente en todos los tokenizadores aprendidos.
Sistema de políticas π0-FAST y plataformas experimentales
Objetivos y componentes
FAST es un método de procesamiento de acciones, no un nuevo hardware de teleoperación. Esta sección del sistema explica cómo encajan la tokenización, el VLA, el control y la evaluación.
Los objetivos son comprimir acciones de alta frecuencia manteniendo trayectorias finas, reutilizar el entrenamiento autorregresivo de VLM, admitir espacios de acción variados, permitir un entrenamiento/reutilización sencillo del tokenizador y escalar entre encarnaciones.
| Componente | Configuración en el artículo | Función |
|---|---|---|
| FAST / FAST+ | DCT, cuantificación, aplanado frecuencia-primero, BPE | Codificar fragmentos como símbolos predecibles y decodificarlos. |
| Backbone π0-FAST | PaliGemma-3B | Codificar imágenes/lenguaje y generar tokens de acción de forma autorregresiva. |
| Comparación de transferencia de backbone | OpenVLA basado en Prismatic 7B | Probar si los beneficios se extienden más allá de PaliGemma. |
| Imágenes | Dos o tres vistas de | Una vista externa más una vista de muñeca por brazo. |
| Propiocepción | Discretización en 256 bins, luego tokenización de enteros a texto | Proporcionar el estado actual del robot. |
| Ejecución | Controladores de bajo nivel específicos de la plataforma | Enviar valores continuos decodificados a articulaciones, pinzas y otros controles. |
Artículo: Todos los pesos de la política se afinan. Cada imagen se codifica por separado y luego los tokens visuales se concatenan. El tamaño de imagen y la codificación del estado textual se especifican en el Apéndice C en lugar de inferirse de π0.
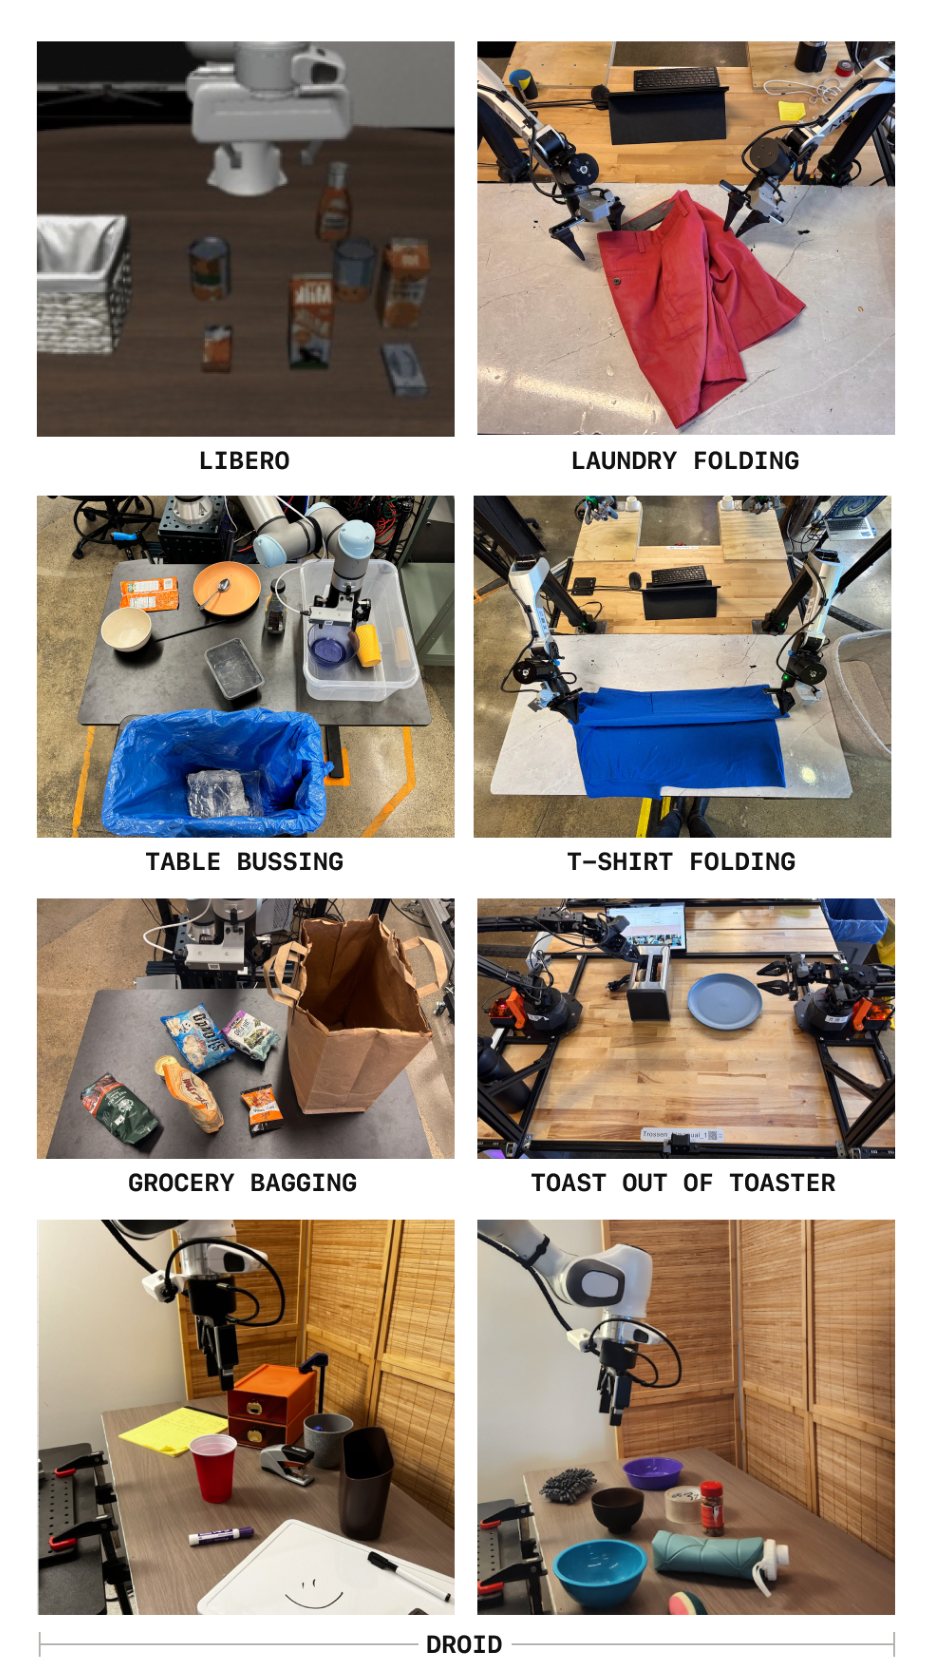
| Tarea / entorno | Plataforma y frecuencia de control | Capacidad evaluada |
|---|---|---|
| LIBERO | Simulación | Generalización espacial, de objetos, de objetivos y de largo horizonte. |
| Recogida de mesa | UR5/UR5e simple, 20 Hz | Agarrar, clasificar y guardar 12 objetos. |
| Doblado de camiseta | ARX bimanual, 50 Hz | Agarrar y doblar con precisión una camiseta plana. |
| Empaquetado de compras | UR5/UR5e simple, 20 Hz | Embolsar siete objetos sin colapsar ni rasgar la bolsa. |
| Sacar tostadas de la tostadora | Trossen Viper-X bimanual, 50 Hz | Sacar dos rebanadas de pan tostado y colocarlas en un plato. |
| Doblado de ropa | ARX bimanual, 50 Hz | Recuperar, extender, doblar y apilar prendas de una cesta. |
| Tareas de sobremesa DROID zero-shot | Datos y despliegue en Franka, 15 Hz | Seguir lenguaje para colocación, limpieza, operaciones con cajones y tareas relacionadas en nuevas escenas. |
Precaución: Una alta frecuencia de control significa muchos puntos de control por segundo; una alta frecuencia en DCT significa variación rápida a lo largo de una trayectoria. Un movimiento suave a 50 Hz aún puede estar dominado por coeficientes de baja frecuencia. Ninguna de las dos es la tasa de inferencia del modelo completo.
Conectando codificación, predicción y ejecución
El flujo de trabajo completo es:
Demonstrations → one-second future chunks → normalization and FAST → action-token labels
Current images + language + state → VLM prefix → learn action-token prediction
                                      ↓ after training
New observations → autoregressive tokens → FAST decoding → continuous chunk → execute
                                                                  ↓
                                                          observe and predict again
FAST codifica solo objetivos de acción; no interpreta imágenes ni aplica DCT a la propiocepción actual. Durante el entrenamiento, el modelo ve tokens de acción previos de verdad de terreno; en inferencia, ve sus propios tokens generados.
Artículo: Los símbolos de acción reemplazan ranuras raramente usadas en el vocabulario del VLM, reutilizando salidas discretas sin un experto de flujo al estilo π0. Los experimentos con OpenVLA aún modifican entradas de múltiples imágenes y salidas por fragmentos. La compatibilidad con backbones autorregresivos no significa que cada base de código robótica existente no necesite adaptación.
Temporización de la ejecución: DROID predice 15 pasos y ejecuta ocho o 15 en lazo abierto antes de actualizar observaciones. A 15 Hz, estos cubren alrededor de 0,53 o un segundo de puntos de control, no el total de ciclos de tiempo real incluyendo inferencia y comunicación. v1 no especifica una longitud de ejecución única para cada plataforma.
Justificación: Los fragmentos conservan la coherencia de la trayectoria; la compresión hace que las etiquetas de alta frecuencia sean aprendibles; las salidas autorregresivas permiten que los pesos imagen-texto preentrenados participen directamente. Los controladores reciben valores continuos, no IDs de BPE.
Datos, capacidades y resultados
Escala y configuración del conjunto de datos
| Uso | Alcance | Distinción |
|---|---|---|
| Entrenamiento del tokenizador FAST+ | Alrededor de un millón de fragmentos de acciones reales de un segundo | Aprende BPE, no la comprensión visual del VLA. |
| Cobertura de FAST+ | Brazo simple, bimanual, móvil; controles de articulaciones, efector final en marco mundial y efector final en marco de cámara; frecuencias variadas | Un robot puede aportar múltiples parametrizaciones de acción. |
| Política a gran escala | Mezcla π0: 903M pasos internos de tiempo, con datos abiertos recibiendo un peso de muestreo de mezcla del 9,1 % | Las fuentes abiertas incluyen Bridge v2, DROID y OXE; el 9,1 % no es una fracción del volumen bruto de datos. |
| Política específica de DROID | 75k episodios exitosos, alrededor de 21M muestras | Filtrado ligero y eliminación de acciones inactivas todo-cero; aún se requiere entrenamiento de la política. |
| Entrenamiento de DROID | Lote 256, 240k iteraciones, alrededor de tres épocas | El Apéndice D informa alrededor de cuatro días en ocho H100 para esta configuración. |
Artículo: El entrenamiento de FAST+ rellena acciones hasta 32 dimensiones. Esto alinea los datos del tokenizador, no el tamaño de salida de cada política, y difiere de la interfaz 18D de π0. Las nuevas plataformas aún necesitan definir sus dimensiones efectivas de acción.
DROID utiliza una imagen externa y una de muñeca. El entrenamiento elige aleatoriamente entre dos cámaras externas disponibles y tres anotaciones de lenguaje por episodio, sin información de calibración de cámara. Los controles son velocidades articulares y posición absoluta de la pinza. El despliegue en nuevas vistas no elimina la necesidad de configurar coordenadas e interfaces de control.
Compresión: Menos tokens, el mismo horizonte de acción
Estos resultados de un segundo reproducen la Tabla I. La compresión es el conteo puntual de tokens dividido por el conteo FAST promedio con error de reconstrucción similar.
| Conjunto de datos / tarea | Dimensión | Frecuencia y horizonte | Tokens puntuales | Tokens FAST promedio | Compresión |
|---|---|---|---|---|---|
| BridgeV2 | 7 | 5 Hz, 5 pasos | 35 | 20 | 1.75 |
| DROID | 7 | 15 Hz, 15 pasos | 105 | 29 | 3.6 |
| Recogida de mesa | 7 | 20 Hz, 20 pasos | 140 | 28 | 5.0 |
| Doblado de camiseta | 14 | 50 Hz, 50 pasos | 700 | 53 | 13.2 |
Interpretación: Aumentar los puntos de control no añade necesariamente de forma proporcional nueva información de movimiento. Alrededor de 30 tokens por brazo por segundo es una observación empírica aquí, no una longitud fija.
Comprobación de versión: La Tabla III del apéndice usa algunos conjuntos de datos offline de distinta dimensión, incluyendo DROID Joint 8D y recogida de mesa, mientras que la Tabla I lista 7D. Se mantiene la convención de la Tabla I en lugar de fusionar diferentes parametrizaciones en una sola especificación.
Evaluación: Éxito y progreso son diferentes
| Tarea | Evaluación |
|---|---|
| LIBERO | Éxito binario por episodio; cuatro suites entrenadas conjuntamente con unas 270k muestras durante 40k iteraciones. |
| Recogida de mesa | Fracción de 12 objetos colocados correctamente en la basura o en el contenedor de almacenamiento. |
| Doblado de camiseta | Éxito de doblado juzgado por humanos en cinco camisetas vistas. |
| Embolsado de comestibles | Fracción de siete objetos colocados en la bolsa. |
| Retirada de tostadas | Un punto por rebanada retirada y uno por rebanada servida en el plato; cuatro puntos en total, luego normalizados. |
| Doblado de ropa | Doblado y apilado de prendas juzgado por humanos, con cinco prendas aleatorias en la cesta. |
| Pruebas cuantitativas de DROID | 44 ensayos por política, con puntos de progreso específicos de la tarea como agarre y destino correctos. |
Comprobación de versión: El texto principal llama a la cuarta suite de LIBERO Libero-10; el apéndice la llama Libero-Long. Aquí se describe como la suite de horizonte largo. El Apéndice E indica 16 tareas DROID, mientras que la Tabla II lista 17 nombres; los conteos de ensayos siguen sumando 44. La discrepancia se conserva en lugar de resolverse silenciosamente.
Límite de evidencia: Los despliegues en Berkeley, Stanford y la Universidad de Washington son demostraciones cualitativas adicionales sin tasas de éxito reportadas. Zero-shot significa sin entrenamiento adicional para la nueva escena de despliegue, no sin entrenamiento de DROID. El entrenamiento del vocabulario FAST+ también incluye datos de tareas de evaluación reales, por lo que la Figura 6 no muestra tanto al tokenizador como a la política completamente desconocedores de cada tarea.
Comparación de tokenizadores
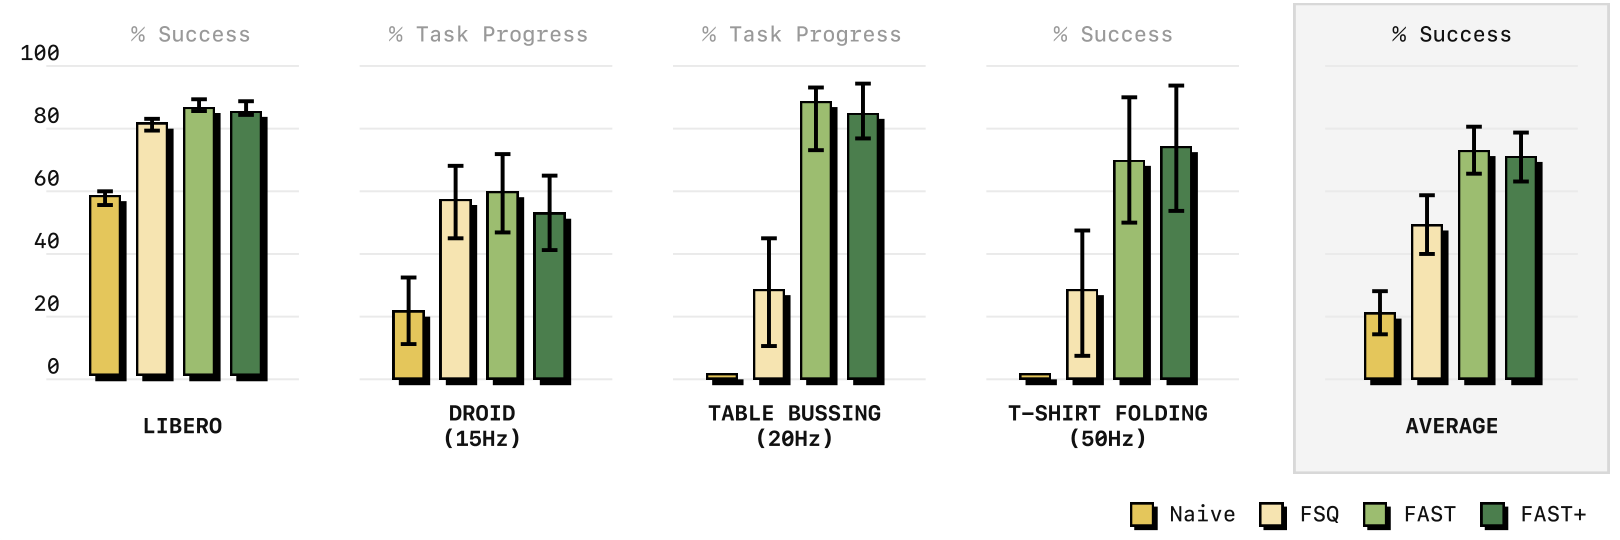
En la recogida de mesa a 20 Hz y el doblado de camiseta a 50 Hz, el binning puntual avanza poco, mientras que FAST y FAST+ aprenden políticas útiles. FSQ respalda el valor de la compresión pero generalmente queda por detrás de FAST en estas tareas de destreza. FAST+ universal está cerca de FAST específico del conjunto de datos, lo que respalda su uso como opción predeterminada.
Precaución: La figura promedia diferentes puntuaciones de tareas, por lo que no es una tasa de éxito promedio uniforme. Las barras de error también limitan las conclusiones sobre pequeñas diferencias entre barras similares.
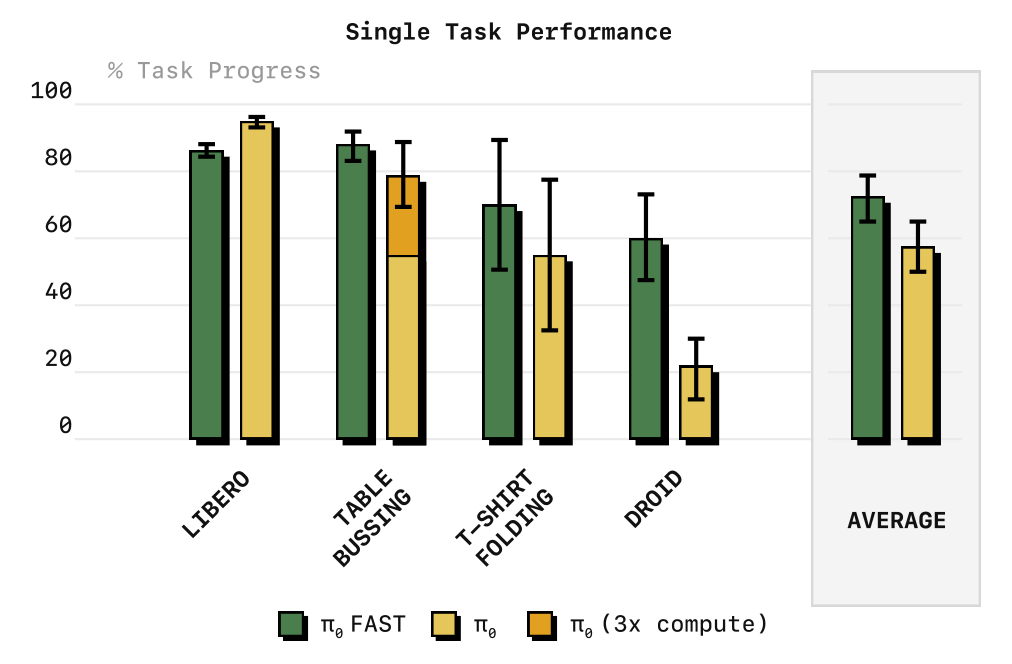
Comparación de un solo conjunto de datos con π0
-
En conjuntos de datos más pequeños como LIBERO y doblado de camiseta, los autores juzgan el rendimiento como comparable.
-
En datos grandes de recogida de mesa, FAST alcanza un rendimiento sólido antes; π0 necesita aproximadamente tres veces más pasos para acercarse.
-
En DROID, π0-FAST sigue el lenguaje de forma más fiable mientras que π0 con flow-matching a menudo lo ignora; el artículo no establece la causa subyacente.
Explicación: El teacher forcing calcula las pérdidas para posiciones de salida en paralelo durante el entrenamiento; la inferencia autoregresiva sigue siendo secuencial. El entrenamiento más rápido y la inferencia más lenta pueden coexistir. Estos resultados no establecen una superioridad autoregresiva universal.
Generalistas a gran escala y comparación con cómputo igualado
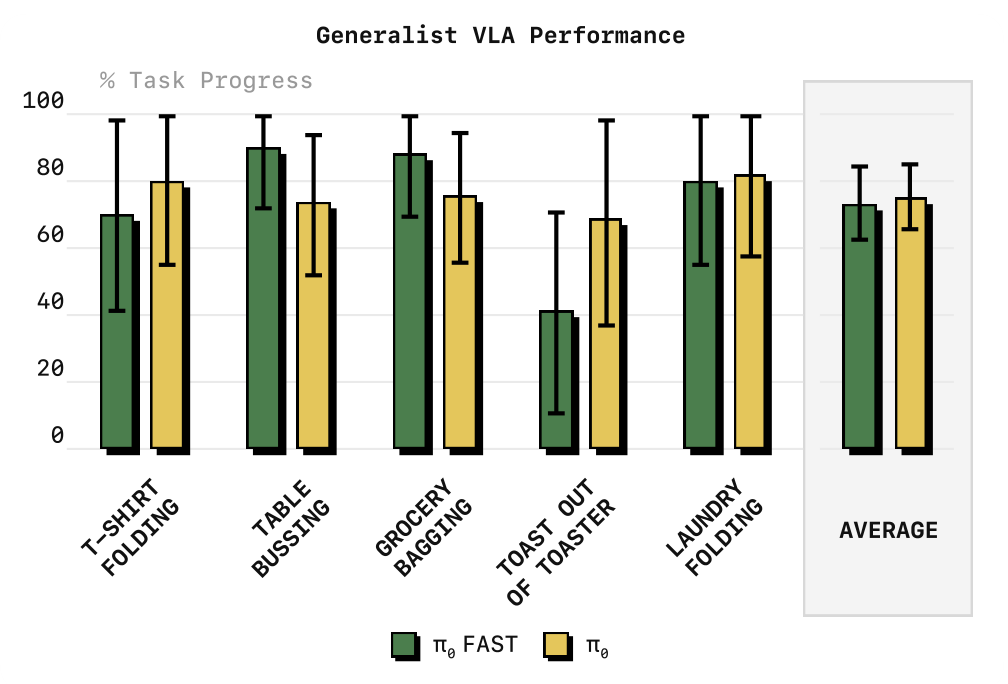
π0-FAST tiene un rendimiento global similar a π0 en doblado, recogida, embolsado, tostadas y ropa. Las tareas individuales varían; las tostadas no respaldan una afirmación de superioridad universal de FAST. El π0-FAST evaluado utiliza aproximadamente una quinta parte de las horas de GPU.
Precaución: VI-F describe en términos generales la comparación zero-shot, pero el Apéndice E especifica un ajuste fino de tareas de alta calidad para ropa después del preentrenamiento a gran escala. Embolsado y tostadas usan directamente modelos preentrenados. No todas las tareas de la Figura 6 están libres de ajuste fino específico de la tarea.
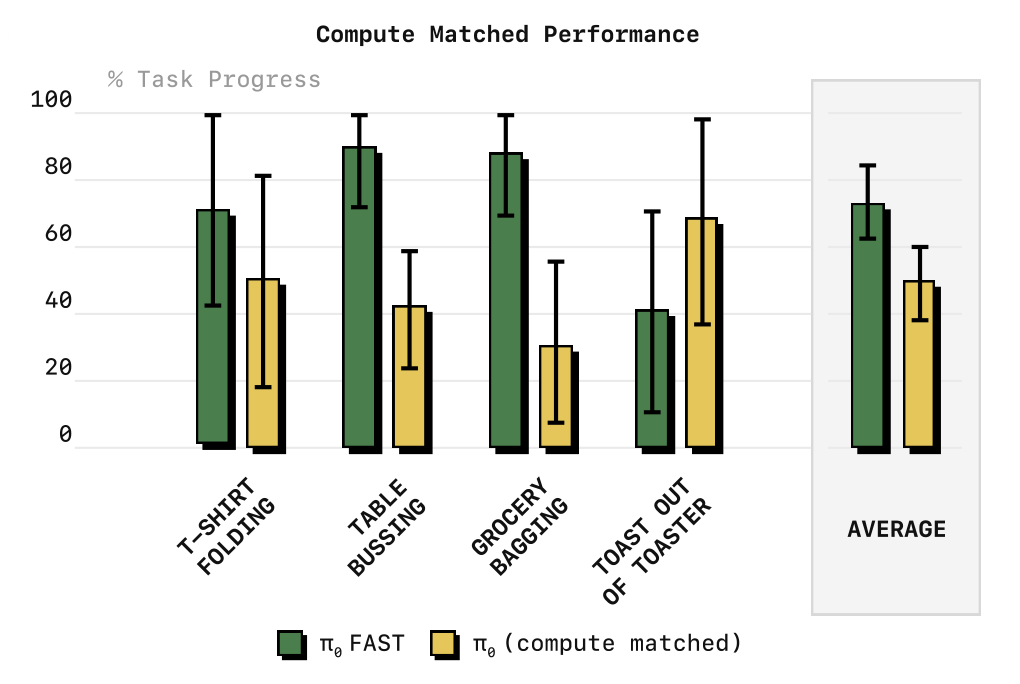
El emparejamiento de cómputo respalda más directamente una convergencia más rápida: FAST tiene una media global más alta y ganancias claras en recogida/embolsado, aunque sigue quedando por detrás en tostadas. Esto es evidencia de eficiencia de entrenamiento, no de una capacidad final más fuerte en cada tarea.
Límite de despliegue: En una RTX 4090, VI-E informa normalmente menos de 100 ms para π0 y alrededor de 750 ms para π0-FAST por fragmento de un segundo. FAST decodifica aproximadamente 30–60 tokens a través de todo el backbone de lenguaje; π0 repite principalmente su experto más pequeño de 300M para diez actualizaciones de flujo. Las tareas estáticas toleran esta latencia, pero las tareas dinámicas y la optimización de la inferencia siguen siendo trabajo futuro.
Tokenización en el espacio de frecuencias y modelado de políticas autoregresivas
Mecanismo 1: Expresar una trayectoria con DCT
Problema e intuición
Los puntos de control vecinos en trayectorias suaves son similares. Los objetivos independientes crecen con la frecuencia de muestreo sin añadir mucha información. DCT en cambio describe qué formas de coseno se combinan, y con qué amplitudes, para formar la trayectoria.
Unos pocos coeficientes de baja frecuencia a menudo describen la forma global suave; las frecuencias más altas representan cambios rápidos y detalle. DCT en sí no descarta las altas frecuencias ni impone un filtro paso-bajo fijo. La DCT completa y la DCT inversa son reversibles; la cuantización introduce la pérdida.
Expresión formal
Explicación: El artículo aplica DCT de forma independiente a lo largo de cada dimensión de acción. Se usa a continuación una convención DCT-II ortonormal para mayor claridad, sin afirmar que el pseudocódigo especifique esa normalización.
Para un fragmento normalizado :
indexa el tiempo dentro del fragmento, las dimensiones de acción, y la frecuencia. es la matriz de coeficientes. es constante; los más altos varían más rápido. DCT actúa a lo largo del tiempo, no entre articulaciones.
La inversa correspondiente es:
Cada instante de tiempo depende de múltiples frecuencias; un coeficiente de frecuencia normalmente afecta a todo el fragmento.
Ejemplo numérico mínimo
Explicación: Sea , con acciones normalizadas ilustrativas:
La primera dimensión constante solo necesita un coeficiente constante distinto de cero. La segunda dimensión creciente se representa principalmente por el componente constante y el primer componente variable, con un pequeño coeficiente de la frecuencia más alta. Siguen existiendo cuatro pasos de tiempo y dos dimensiones; solo cambia la representación de coordenadas.
Por qué ayuda: Las muestras densas de movimiento suave añaden puntos similares sin añadir necesariamente frecuencias importantes. Concentrar la información compartida hace posible la compresión en menos tokens informativos.
Escala y límites: Los fragmentos suelen ser de alrededor de un segundo. no ofrece redundancia temporal; los fragmentos cortos limitan la compresión, mientras que los fragmentos largos aumentan el horizonte y, si se ejecutan en lazo abierto, retrasan la retroalimentación. Los contactos bruscos o las transiciones de la pinza pueden requerir frecuencias más altas; unas pocas frecuencias bajas no pueden representar con precisión cada acción.
Mecanismo 2: Cuantización, ordenación por frecuencia primero y BPE
Por qué DCT por sí sola es insuficiente
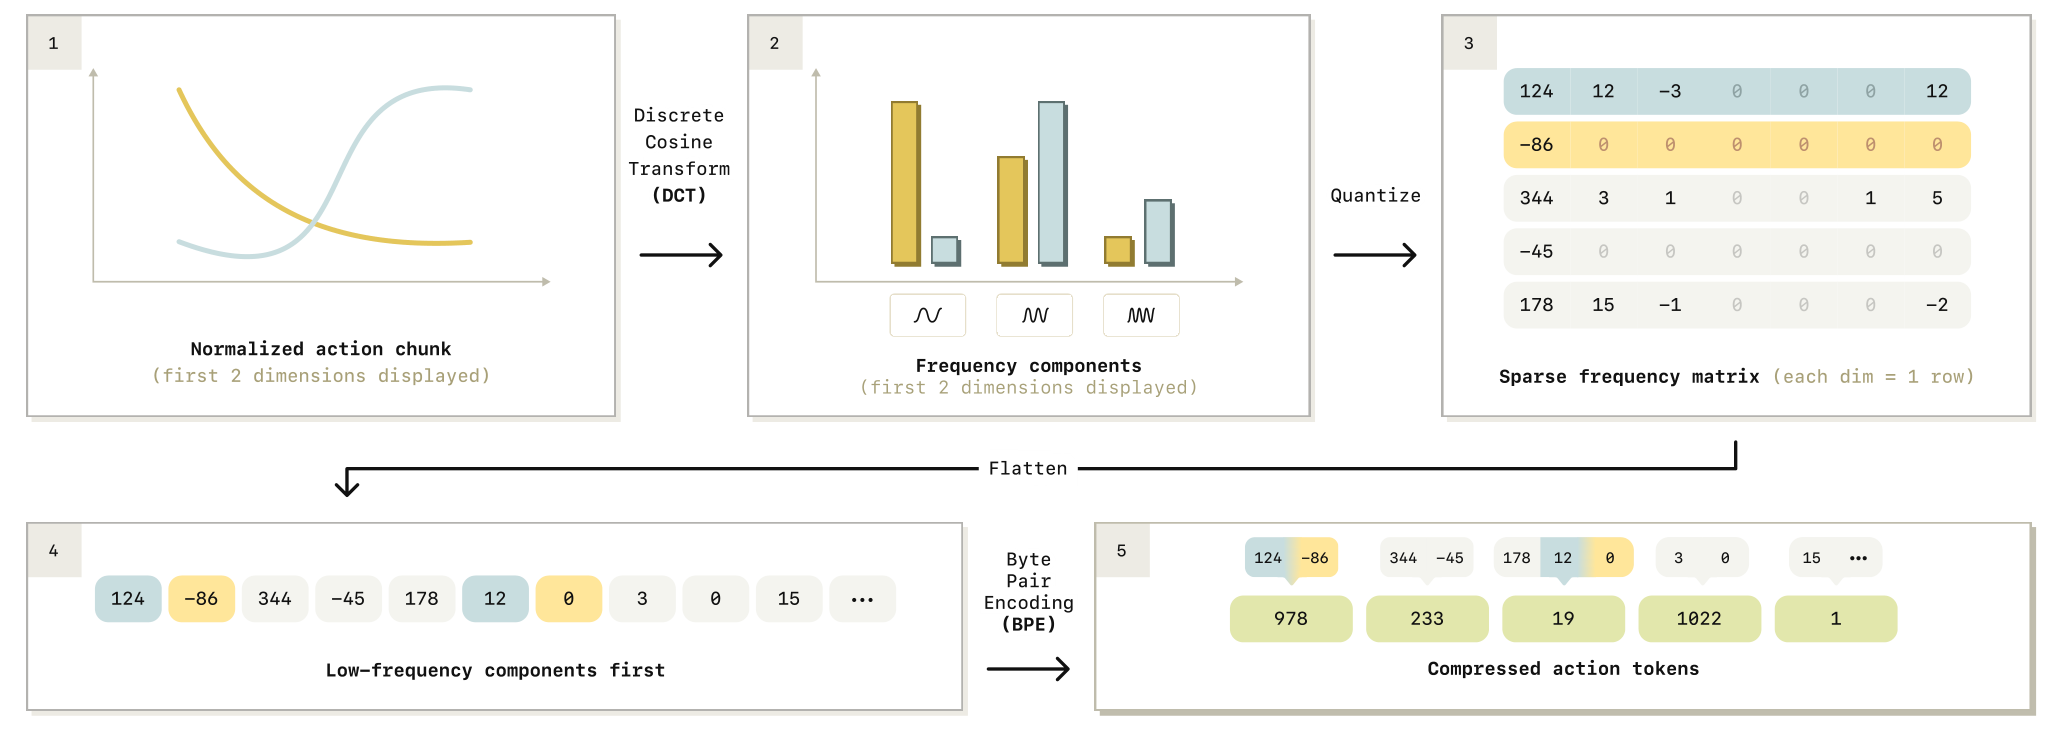
DCT sigue produciendo coeficientes reales. Tokenizar cada uno por separado no acorta la secuencia, y los coeficientes casi cero crean etiquetas repetidas. FAST por lo tanto añade cuantización y BPE.
Normalización por percentil por dimensión
Artículo: Mapear los percentiles 1 y 99 de cada dimensión de los datos de entrenamiento a y , reduciendo las diferencias de escala y la influencia de valores atípicos.
Explicación: Para una dimensión no degenerada:
y son los percentiles 1 y 99, respectivamente; es el componente de acción física, y su valor normalizado sin unidades. Si para una articulación, las acciones físicas se mapean a .
Precaución: Mapear percentiles no fuerza cada valor a estar en . Siga la implementación para el recorte y el caso degenerado ; la v1 no los detalla. Guarde las estadísticas de entrenamiento para el despliegue en lugar de volver a calcular los percentiles en cada fragmento predicho.
Escalar y redondear para crear enteros comprimibles
es la matriz entera, la escala, y los coeficientes reconstruidos. Un mayor hace la rejilla más fina, normalmente mejorando la reconstrucción pero potencialmente aumentando los tokens; valores más pequeños anulan más coeficientes pequeños y comprimen más a costa de un mayor error.
Artículo: Los experimentos específicos de cada conjunto de datos usan y vocabulario , con sensibilidad limitada en el rango probado. Estos no son ajustes universales para espacios de acción arbitrarios.
Continuando el ejemplo con :
La componente de mayor frecuencia se convierte en cero, mientras que se convierte en . Ninguna regla mantiene solo las dos primeras frecuencias; cualquier coeficiente suficientemente grande puede permanecer distinto de cero.
Explicación: El redondeo ordinario da . Esto acota el error de un coeficiente, no el error de la articulación física directamente, que también depende de la transformación inversa, la escala de acción y el recorte.
El ordenamiento por frecuencia prioriza la forma global
Antes de BPE, FAST ordena los coeficientes por frecuencia creciente, luego por dimensión de acción dentro de cada frecuencia:
contiene enteros. En el ejemplo:
Frequency 0, two dimensions: 4, 3
Frequency 1, two dimensions: 0, -2
Frequency 2, two dimensions: 0, 0
Frequency 3, two dimensions: 0, 0
Flattened: 4, 3, 0, -2, 0, 0, 0, 0
Artículo: El ordenamiento por frecuencia produce rollouts más estables que el ordenamiento por dimensión al predecir primero la forma global de baja frecuencia. La matriz original llama a esto por columnas; la convención de esta guía lo hace por filas. Lo que importa es el orden semántico, no la etiqueta de fila/columna.
BPE fusiona subsecuencias de enteros comunes
BPE aprende combinaciones adyacentes de símbolos frecuentes y las añade a un vocabulario finito. Un vocabulario ilustrativo podría fusionar o en tokens individuales, acortando el ejemplo de ocho enteros.
Explicación: Las reglas de fusión reales y los IDs dependen de los datos de entrenamiento; estos no son el vocabulario literal del artículo. Un token puede abarcar dimensiones o frecuencias vecinas, y la decodificación lo expande de nuevo en enteros.
Distinción clave: El redondeo de coeficientes es con pérdida; BPE es sin pérdida sobre la secuencia de enteros cuantizados. Las posiciones de cero se preservan y comprimen, no se eliminan. De lo contrario, la transformación inversa perdería sus ubicaciones de frecuencia y dimensión.
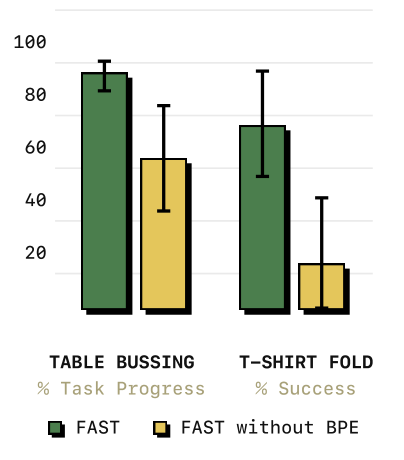
Lectura de la ablación: Sin BPE, DCT aún concentra información y supera al binning punto a punto, pero los tokens de cero repetidos diluyen la supervisión y añaden pasos de decodificación. El rendimiento cae en ambas tareas reales, lo que respalda contribuciones separadas de DCT y BPE.
Modelado de demostraciones y reutilización de FAST+ entre cuerpos
Una observación puede tener varias acciones válidas
Una persona puede agarrar cualquiera de las esquinas de la camisa o desplegarla de forma diferente. La regresión directa de error cuadrático medio puede promediar alternativas válidas en una trayectoria intermedia no válida. π0 modela una distribución continua; π0-FAST modela probabilidades sobre tokens comprimidos.
Factorización autoregresiva:
es la secuencia FAST y su prefijo antes del token . Cada paso predice probabilidades sobre el vocabulario en lugar de promediar valores físicos de acción; la secuencia completa se decodifica en una trayectoria.
Precaución: FAST no tiene codificador CVAE, bloque de acción gaussiano ruidoso ni entrada de tiempo de flujo como π0. Esta sección explica el modelado de demostraciones sin importar módulos de ACT o π0. La cobertura aún depende de los datos, la fidelidad de cuantización y el aprendizaje.
Por qué las etiquetas repetidas de alta tasa debilitan el aprendizaje
Explicación: Cuando los valores adyacentes apenas cambian, la entropía condicional del siguiente token puede ser baja:
es un token de acción aleatorio y la entropía condicional, distinta del horizonte . Un prefijo predecible explica gran parte de la siguiente etiqueta, por lo que la repetición puede obtener buena puntuación sin suficiente dependencia de la imagen o la tarea.
Esta perspectiva de información explica los resultados sintéticos y de alta tasa; no es prueba de que toda política discretizada falle o de que menos tokens siempre ayuden. Una pérdida de compresión severa aún puede producir un comportamiento incorrecto.
Un vocabulario universal con FAST+
Los pasos analíticos de FAST se transfieren entre conjuntos de datos, pero un vocabulario BPE específico de un conjunto de datos no necesariamente lo hace. FAST+ aprende una cobertura más amplia a partir de alrededor de un millón de fragmentos entre cuerpos:
Multiple robots, action spaces, and control rates
→ Normalize for each data configuration
→ Pad training actions to 32 dimensions
→ DCT, quantization, frequency-first flattening
→ Train BPE on the pooled integer sequences
→ Reusable FAST+ tokenizer
El vocabulario aprende patrones comunes de coeficientes y ceros, no la semántica de la cámara ni el controlador cinemático completo de un robot. Una nueva política aún necesita datos de imagen, lenguaje, estado y acción para aprender qué hacer. La tokenización universal y el control generalista son niveles diferentes.
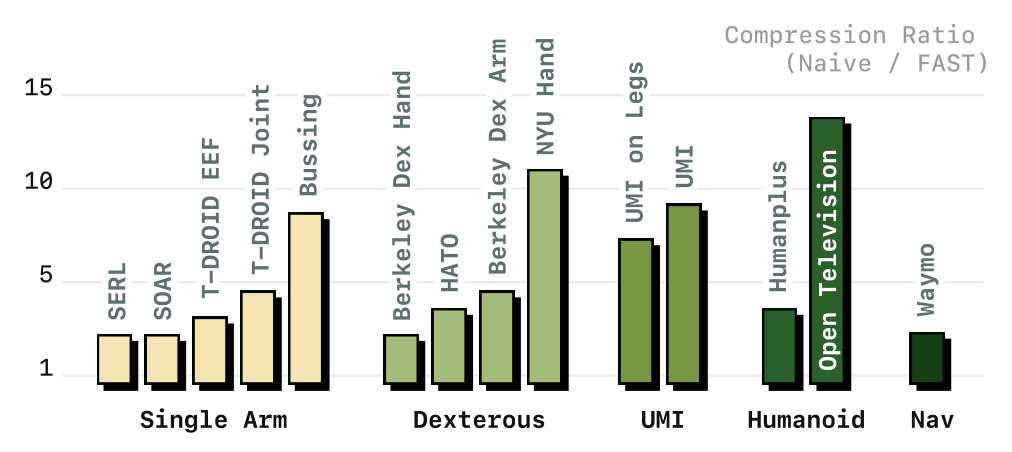
Lectura de la figura: FAST+ comprime formas, dimensiones y frecuencias variadas. VI-C llama a las pruebas datos no vistos, mientras que la Tabla III incluye versiones de plataformas/tareas también nombradas en el entrenamiento. “No visto” se mantiene por tanto al nivel de la partición de datos del artículo, no se extiende a cada categoría de robot.
Límite: La Figura 10 es compresión offline, no éxito de políticas de locomoción humanoide, mano diestra o conducción. La Sección VII señala que las políticas físicas se validan principalmente en manipuladores estacionarios. La Tabla III incluye datos humanoides de 40D, por lo que el relleno de entrenamiento de 32D no es un máximo matemático para el método.
Entrenamiento, codificación y decodificación del tokenizador
Entrenamiento del tokenizador
Para fragmentos de demostración , con índice de muestra :
-
Calcular y guardar estadísticas de percentiles por dimensión para cada configuración de datos.
-
Normalizar a y aplicar DCT a lo largo del tiempo de forma independiente por dimensión.
-
Cuantizar a entero usando fijo.
-
Aplanar en orden de frecuencia primero a .
-
Entrenar BPE de tamaño fijo en todas las secuencias de enteros para obtener el vocabulario y las reglas de fusión .
Artículo: BPE es el único componente aprendido del tokenizador. Un vocabulario específico normalmente se entrena en minutos, no en los días o más necesarios para un VLA. DCT y la cuantización no tienen pesos neuronales y no necesitan un codificador/decodificador VQ separado.
Codificación: convertir futuras demostraciones en etiquetas
La codificación completa es:
es la normalización, el aplanado por frecuencia primero, y las reglas BPE fijas. DCT actúa a lo largo del tiempo por dimensión. La codificación necesita acciones futuras reales, por lo que crea etiquetas de entrenamiento en lugar de asumir conocimiento futuro durante el despliegue.
Precaución: El Algoritmo 1 comienza en DCT, omitiendo la normalización explícita, mientras que V-B la especifica en prosa. Esta guía sigue la canalización completa. El redondeo no puede invertirse exactamente, por lo que la decodificación reconstruye una aproximación de las acciones pre-cuantizadas.
Decodificación: convertir predicciones en acciones ejecutables
Después de generar :
es el número de tokens generados; reconstruye la matriz de coeficientes y es la inversa correspondiente. El final es continuo. El despliegue aún necesita objetivo; la longitud variable de tokens no sustituye la definición de la interfaz de control.
Para la normalización lineal anterior, la desnormalización es:
Explicación: La transformación inversa del ejemplo con da aproximadamente:
La segunda dimensión original es ; la reconstrucción preserva su forma creciente con pequeños errores. La decodificación BPE no añade cambios a : la cuantización causa el error. Estos son valores normalizados, no directamente radianes o milímetros.
Comprobar compresión y reconstrucción conjuntamente
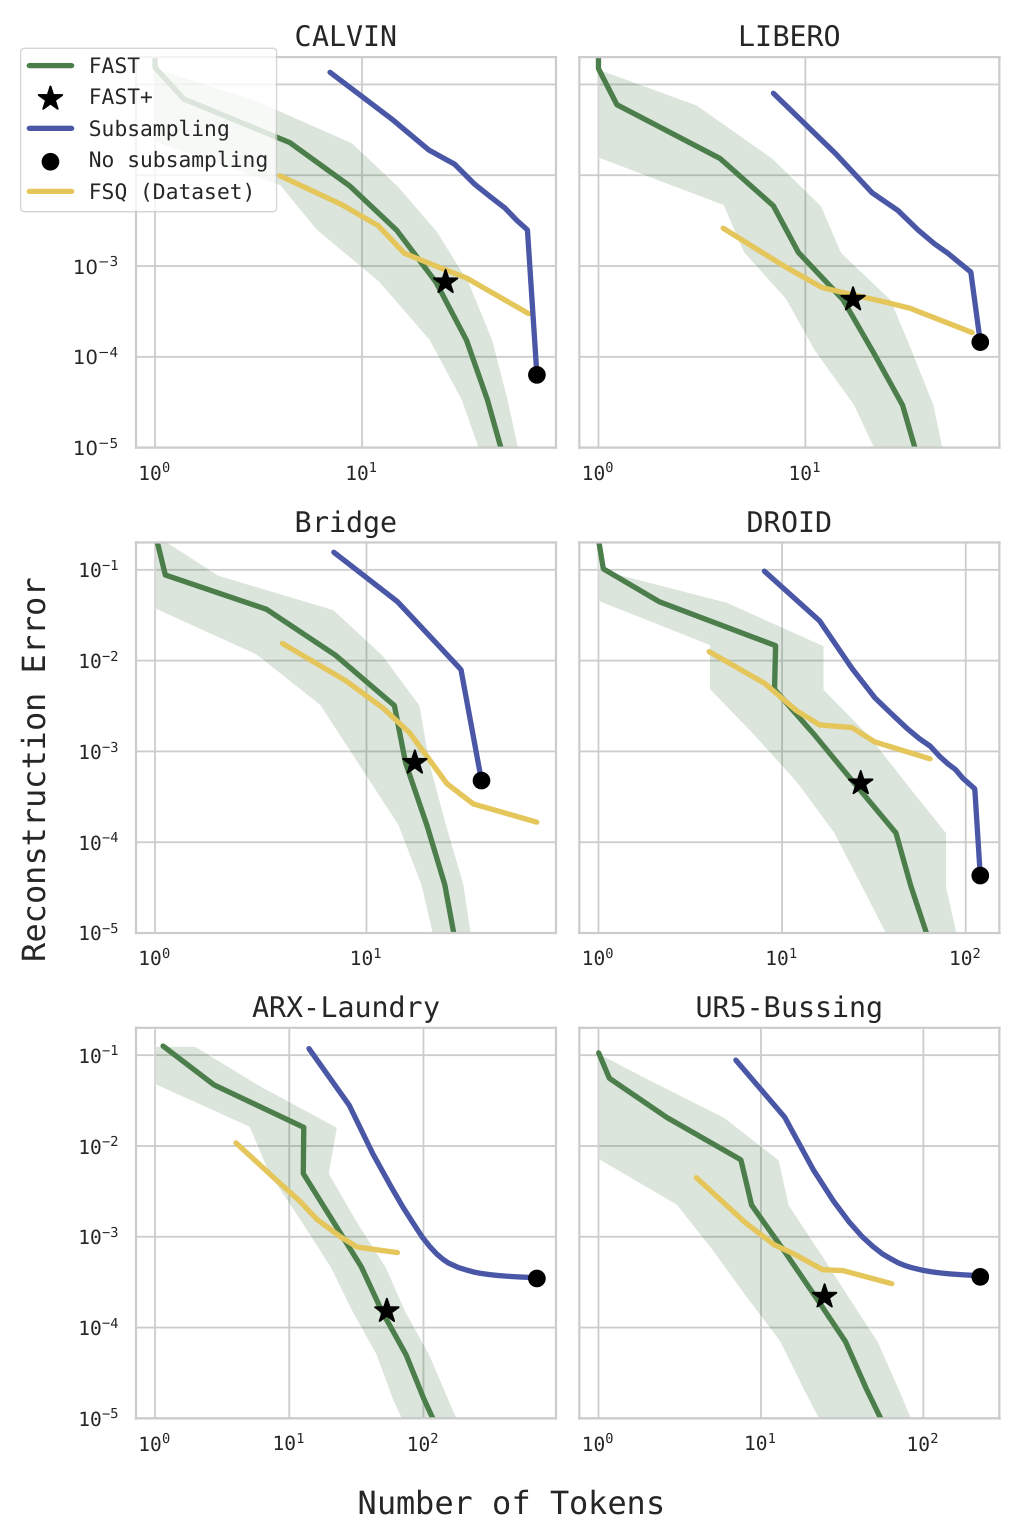
Lectura de la figura: FSQ aprendido puede ser efectivo con baja precisión y muy pocos tokens. A mayor precisión, el error de FAST disminuye más con el número de tokens y se adapta mejor a las tareas de control fino probadas. La secuencia más corta no es automáticamente la mejor representación de trayectoria.
Límites: Escalas de cuantización muy pequeñas pueden borrar coeficientes y producir movimiento casi constante; escalas grandes mejoran la fidelidad pero crean menos ceros comprimibles y enteros más complejos. Vocabularios más grandes representan más combinaciones pero consumen más ranuras de salida. El rango probado no establece ganancias de rendimiento monótonas.
Nota de ingeniería: Los tokens predichos o las longitudes expandidas pueden ser inválidos. Comprueba la forma del fragmento, las dimensiones efectivas y los límites de control antes de la ejecución. La v1 no especifica completamente las reparaciones, por lo que el relleno o truncado no debe presentarse como una implementación documentada del artículo.
La red π0-FAST completa
Entradas y formas
Cada predicción se condiciona en:
-
Dos o tres imágenes RGB de .
-
Instrucción en lenguaje natural .
-
Propiocepción , con dimensiones dependientes de la plataforma.
-
Solo durante el entrenamiento, acciones futuras reales para la supervisión FAST.
El ajuste de camisa de la Tabla I usa , dando etiquetas de ; su ajuste DROID usa , dando . Usa el espacio de acción efectivo para la versión real del conjunto de datos.
Diferencia con π0: π0 proyecta continuamente el estado y acciones ruidosas en un experto. FAST v1 discretiza el estado actual en 256 niveles y tokeniza los enteros como texto, mientras que las acciones futuras usan FAST. El estado es una condición actual en lugar de una salida larga de alta frecuencia, por lo que los autores consideran que una simple discretización es suficiente ahí.
Características de imagen y texto en un solo backbone
Un codificador preentrenado produce tokens visuales por cámara; las cadenas de tarea y estado producen tokens de texto. Juntos forman el prefijo de observación. PaliGemma-3B es el backbone principal, con OpenVLA/Prismatic 7B como comparación de transferencia.
Explicación: Con tokens por imagen y tokens de lenguaje/estado, la longitud del prefijo es:
es el número de cámaras y la longitud del prefijo, ignorando algunos separadores/tokens especiales. Para una anchura de incrustación , la representación es . Esto explica las dimensiones, no una especificación completa de la v1; los conteos visuales, la anchura, los separadores y las codificaciones de posición no se dan todos.
Sufijo de acción y atención
FAST codifica las acciones demostradas como tokens, asignados a ranuras de VLM raramente usadas y suministrados como un sufijo de predicción después del prefijo de observación.
Explicación: La predicción del token usa las observaciones y los tokens de acción precedentes, nunca etiquetas futuras. Esto es autorregresión causal, sin codificador CVAE ni decodificador de flujo continuo.
Los estados ocultos del backbone se convierten en logits de vocabulario y probabilidades de clasificación. es el vocabulario de acción en experimentos específicos del conjunto de datos, no el vocabulario completo de lenguaje.
Función de pérdida de la política
Explicación: La log-verosimilitud negativa estándar expresa el objetivo declarado de siguiente token:
es la pérdida autorregresiva, los pesos de la política, y la esperanza promedia demostraciones; varía por muestra. La v1 no especifica completamente el promedio de tokens ni el tratamiento de símbolos de fin.
El teacher forcing usa de verdad de terreno durante el entrenamiento. Una máscara causal permite pérdidas en todas las posiciones en una sola pasada hacia adelante, mientras que la inferencia depende de prefijos generados y procede secuencialmente. Objetivos más cortos reducen la sobrecarga sin eliminar la dependencia serial de la inferencia.
Configuración del artículo: 1.000 pasos lineales de calentamiento, luego tasa de aprendizaje ; AdamW con , sin decaimiento de pesos, recorte de gradiente en 1 y coeficiente de media móvil exponencial 0.999. Todos los pesos de la política se ajustan finamente.
Muestreo y salidas continuas
La mayoría de las tareas usan decodificación codiciosa. El doblado bimanual de camisa, la extracción de tostadas y la colada usan temperatura 0.7, que los autores consideran que ayuda a escapar de comportamientos casi estacionarios alrededor de las poses iniciales.
Explicación: Para logits y temperatura :
indexan candidatos y es la probabilidad de muestreo. La guía usa para distinguir la temperatura de los del optimizador; el artículo escribe la temperatura como . Difiere de la escala de cuantización .
FAST decodifica tokens a en las unidades físicas del conjunto de datos. DROID usa velocidad articular y posición absoluta de la pinza; otras tareas usan sus configuraciones de plataforma. Los controladores ejecutan acciones válidas, luego nuevas observaciones generan el siguiente fragmento.
Ablación: Tras añadir entrada multi-imagen y fragmentos de un segundo a OpenVLA, reemplazar la discretización por FAST+ mejora sustancialmente el doblado de camisa. Los beneficios se extienden más allá del backbone π0, pero la prueba no establece ganancias iguales para cada VLM.
Flujo completo comparado con π0
Training:
Demonstration images + task language + current state + real next-second actions
→ Encode images as visual tokens
→ Tokenize language and discretized state text as the observation prefix
→ Normalize actions; DCT; quantize; frequency-first flatten; BPE
→ Map action tokens to VLM output slots
→ Compute teacher-forced next-token cross-entropy
→ Fine-tune all policy weights to obtain π0-FAST

Inference:
Current images + task language + state
→ Construct observation prefix
→ Greedily decode or sample action tokens at the specified temperature
→ Reverse BPE and restore integer coefficient ordering
→ Dequantize, inverse DCT, denormalize
→ Obtain an H × D continuous chunk
→ Execute the configured steps with the low-level controller
→ Observe and predict again

In one sentence:
The VLM selects actions from the scene and task;
DCT concentrates shared information from densely sampled trajectories;
quantization and BPE turn coefficients into shorter token sequences;
autoregressive training models their conditional distribution, and FAST decoding restores continuous control.
The main benefits are action representation and training efficiency; v1 inference latency remains a major limitation.