SmolVLA: Cómo los modelos ligeros aprenden acciones de robots de forma eficiente
SmolVLA: Un modelo de visión-lenguaje-acción para robótica asequible y eficiente
- VLA ligero
- Datos de la comunidad
- Flow matching
- Inferencia asíncrona
Requisitos previos
VLM y VLA
Acciones de un solo paso y fragmentos de acción
¿Qué es el Flow Matching?
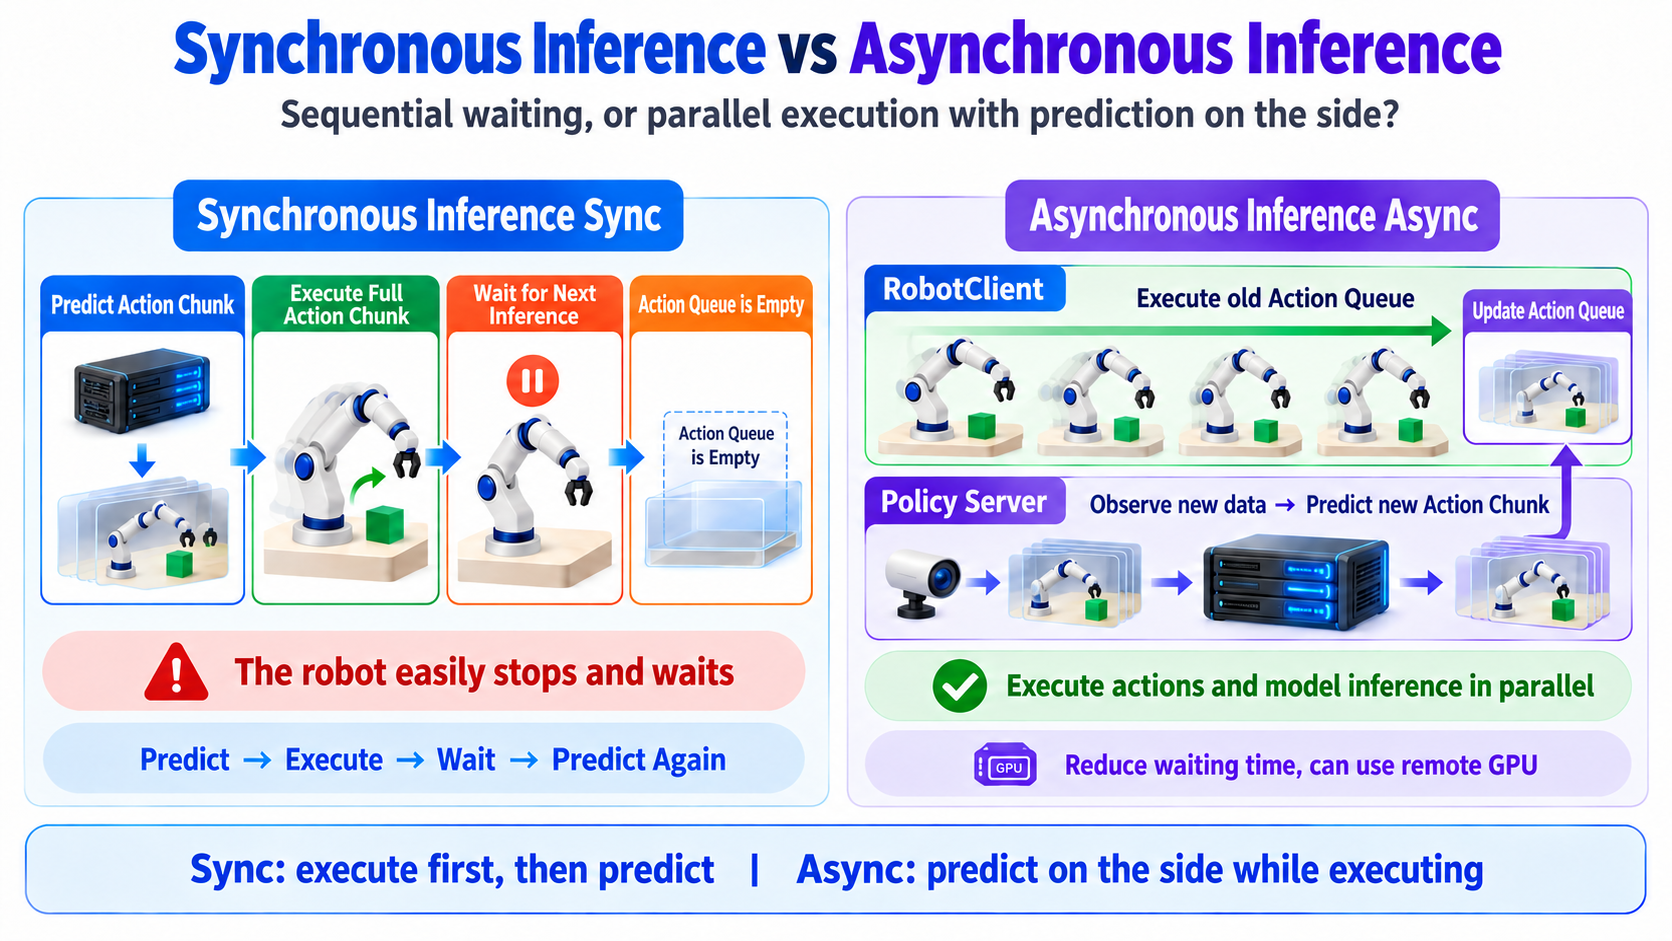
Inferencia síncrona y asíncrona
Resumen
Los modelos de visión-lenguaje preentrenados adquieren un conocimiento visual y lingüístico sustancial a partir de grandes datasets multimodales, lo que los convierte en bases útiles para políticas de robots. Trabajos recientes adaptan VLM en VLA que perciben y controlan robots a partir de instrucciones en lenguaje natural en lugar de entrenar políticas desde cero.
Sin embargo, muchos VLA contienen miles de millones de parámetros, son costosos de entrenar y difíciles de desplegar en robots reales. También dependen principalmente de datasets académicos e industriales, dejando infrautilizados los crecientes datos públicos de comunidades de robots de bajo coste.
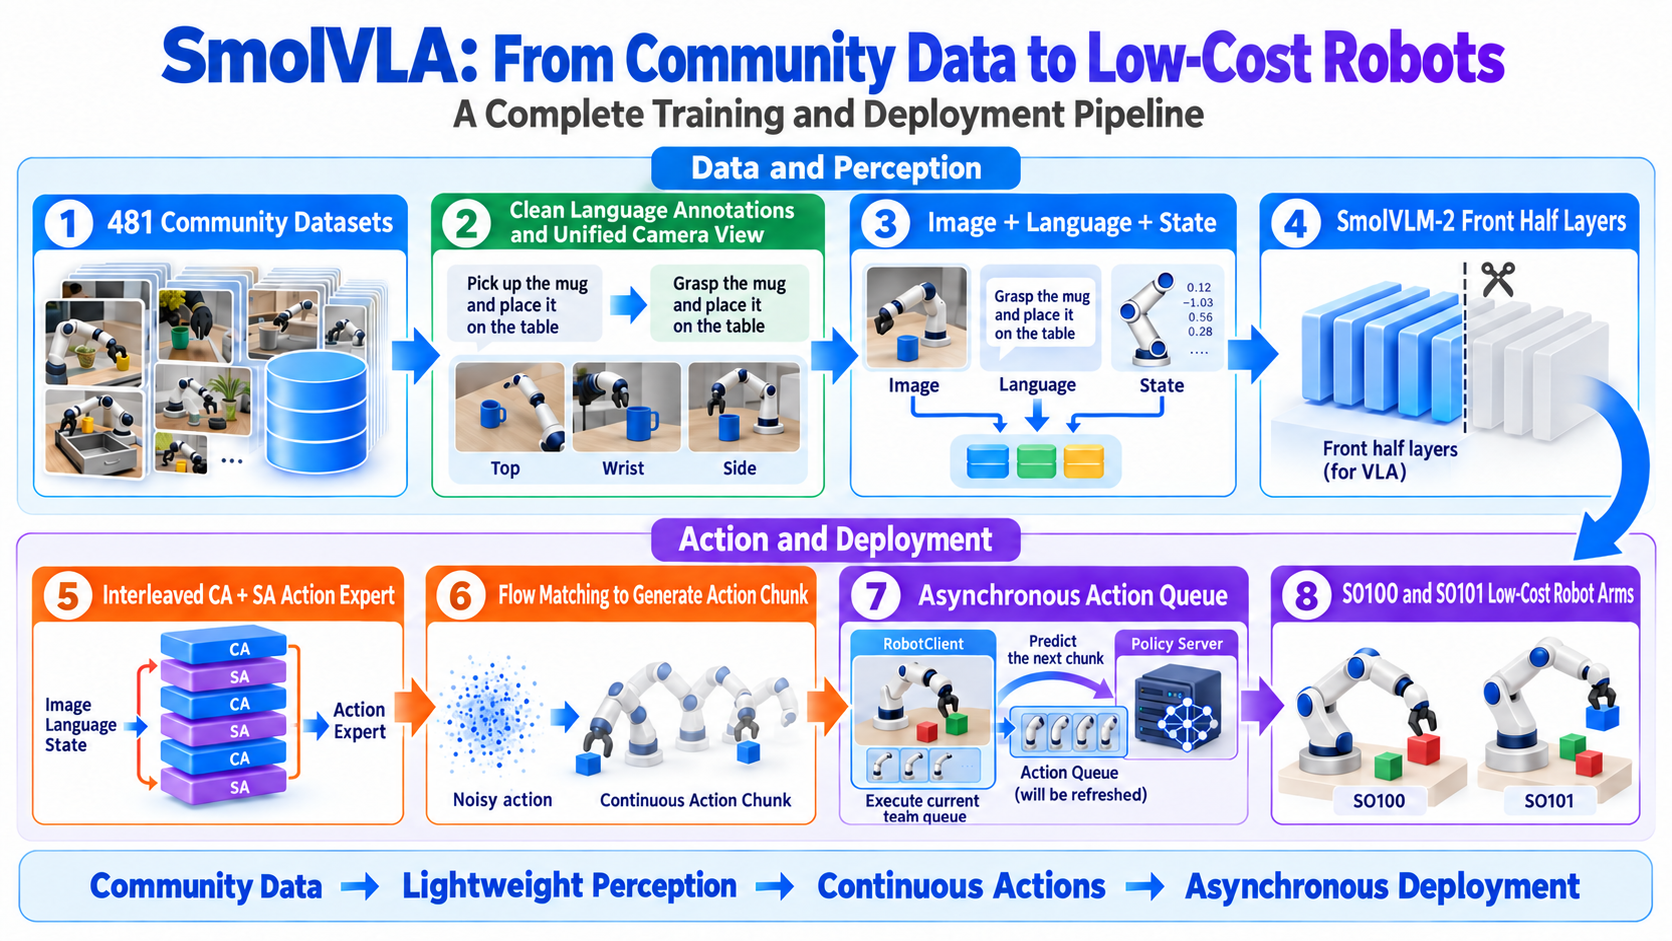
SmolVLA es un VLA pequeño, eficiente y basado en datos de la comunidad. Reduce los costes de entrenamiento e inferencia manteniendo un rendimiento competitivo. Puede entrenarse en una sola GPU y desplegarse en GPUs de consumo o incluso en una CPU.
El artículo también introduce una pila de inferencia asíncrona que separa la percepción y la predicción de acciones de la ejecución. El robot predice su siguiente fragmento mientras ejecuta el actual. A pesar de su tamaño, SmolVLA compite con VLA aproximadamente diez veces más grandes. Los autores evalúan tareas en simulación y en robots reales y publican el código, los modelos preentrenados y los datos de entrenamiento.
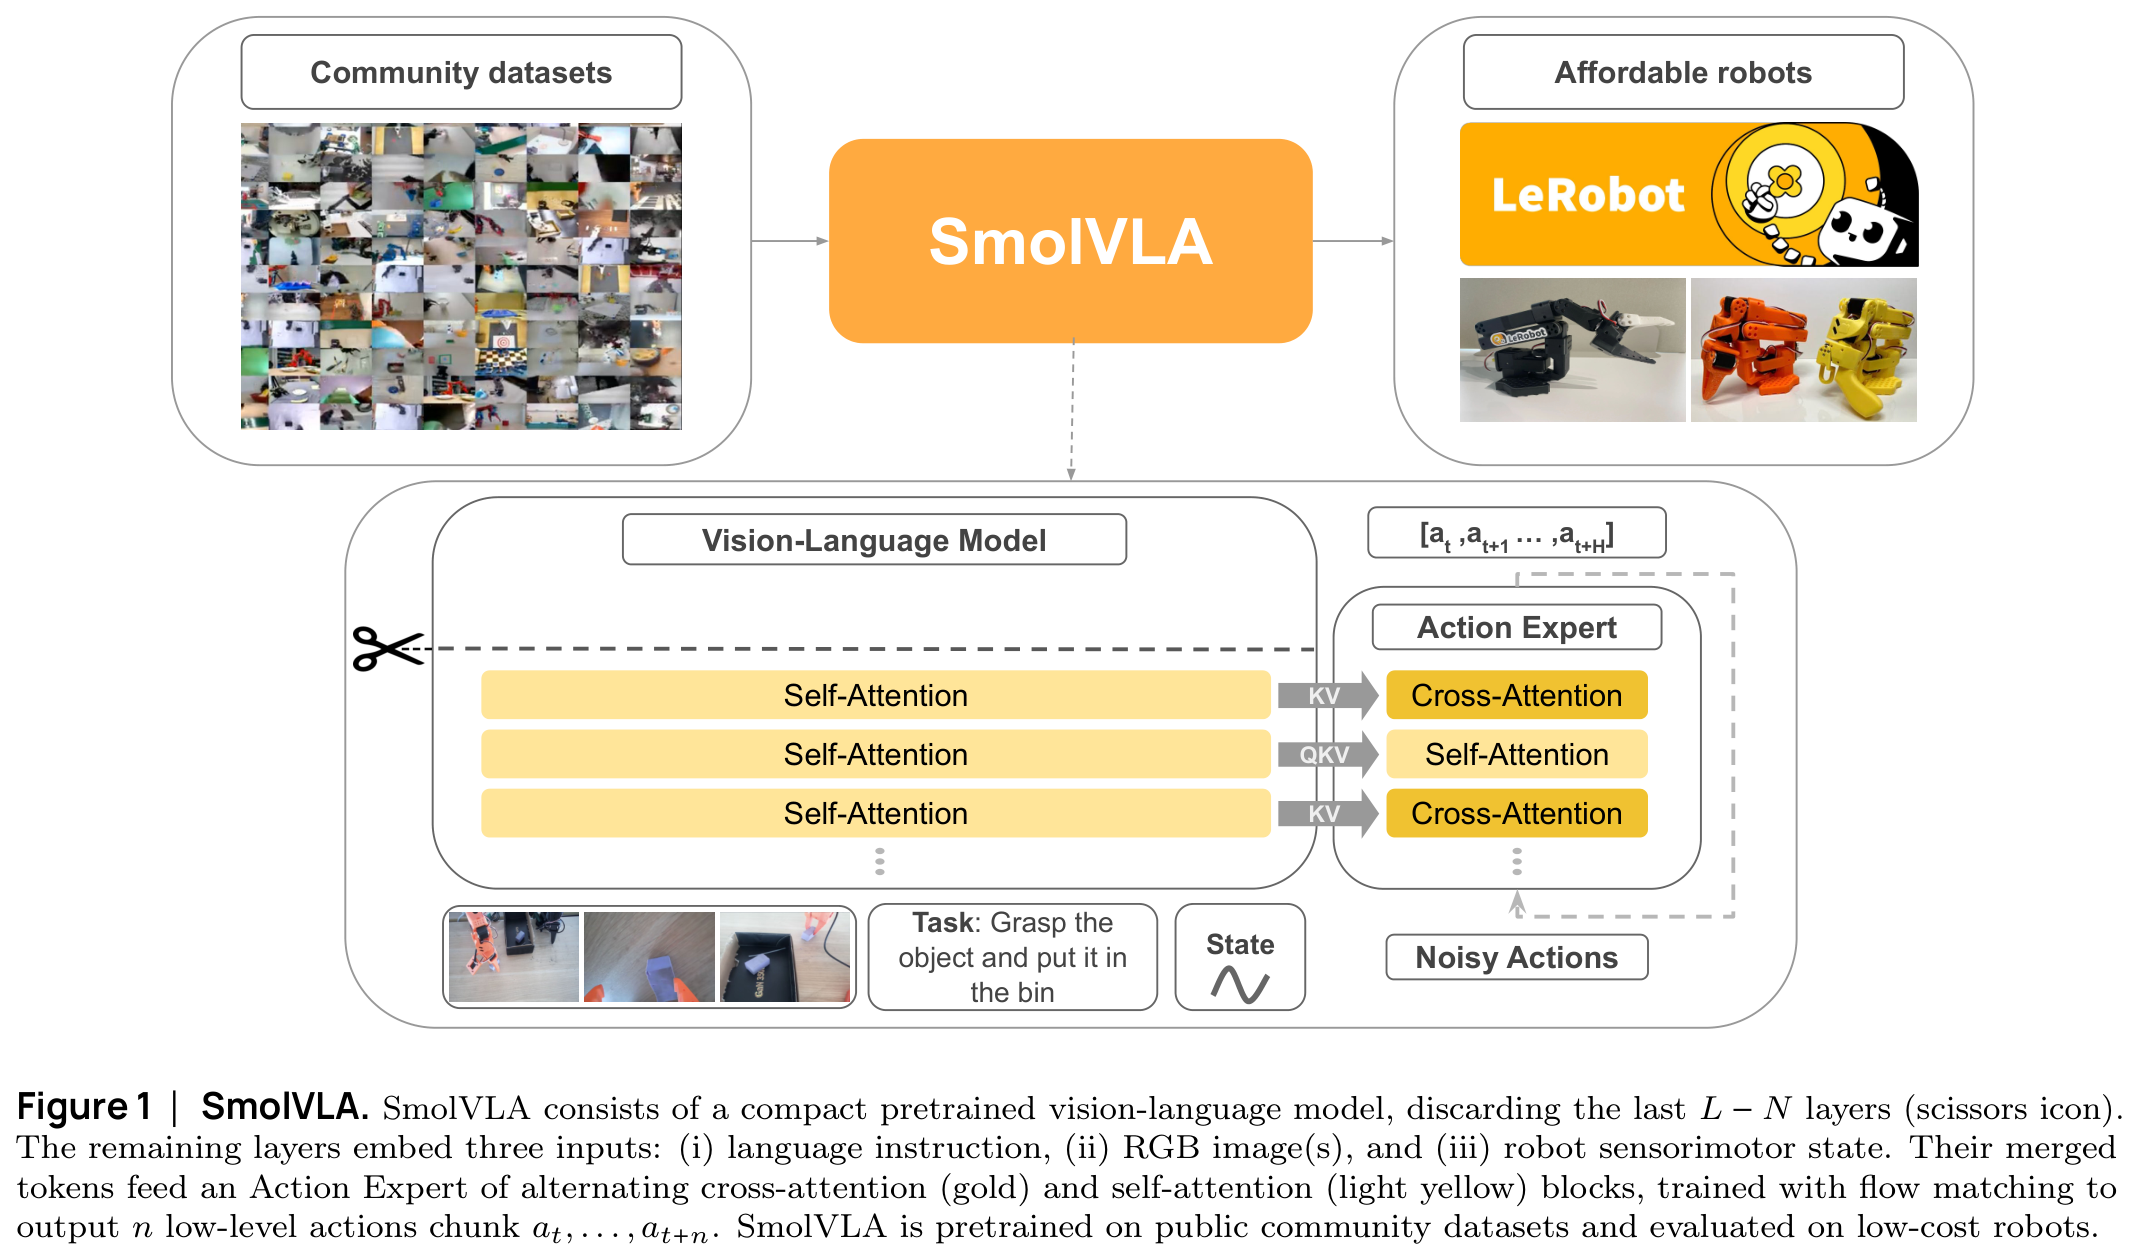
Arquitectura ligera y red completa de SmolVLA
Flujo general de datos
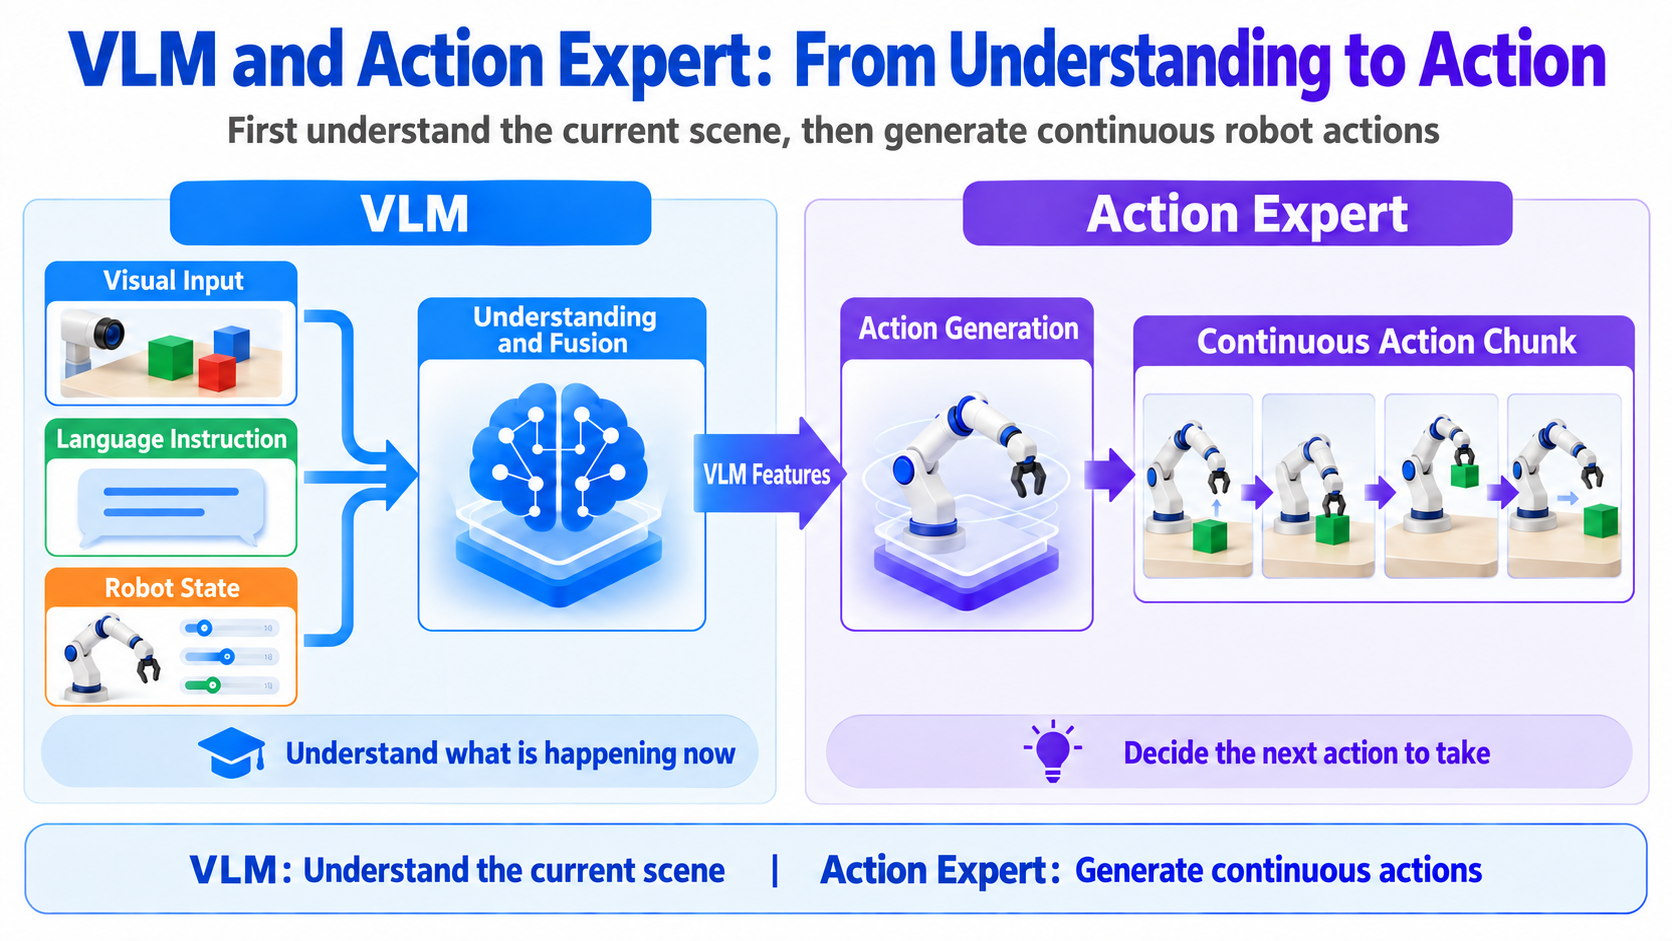
- SmolVLA consta de un VLM y un experto en acciones.
Multi-view RGB images
Language instruction
Robot state
      ↓
    VLM
      ↓
Scene-conditioning features
      ↓
Action Expert + Noisy Actions
      ↓
Flow Matching
      ↓
Action Chunk
- El VLM interpreta el entorno; el experto en acciones convierte esa representación en acciones continuas. El modelo de lenguaje aporta características de condicionamiento en lugar de especificar directamente los ángulos de las articulaciones.
Cómo entran las imágenes, el lenguaje y el estado en el VLM
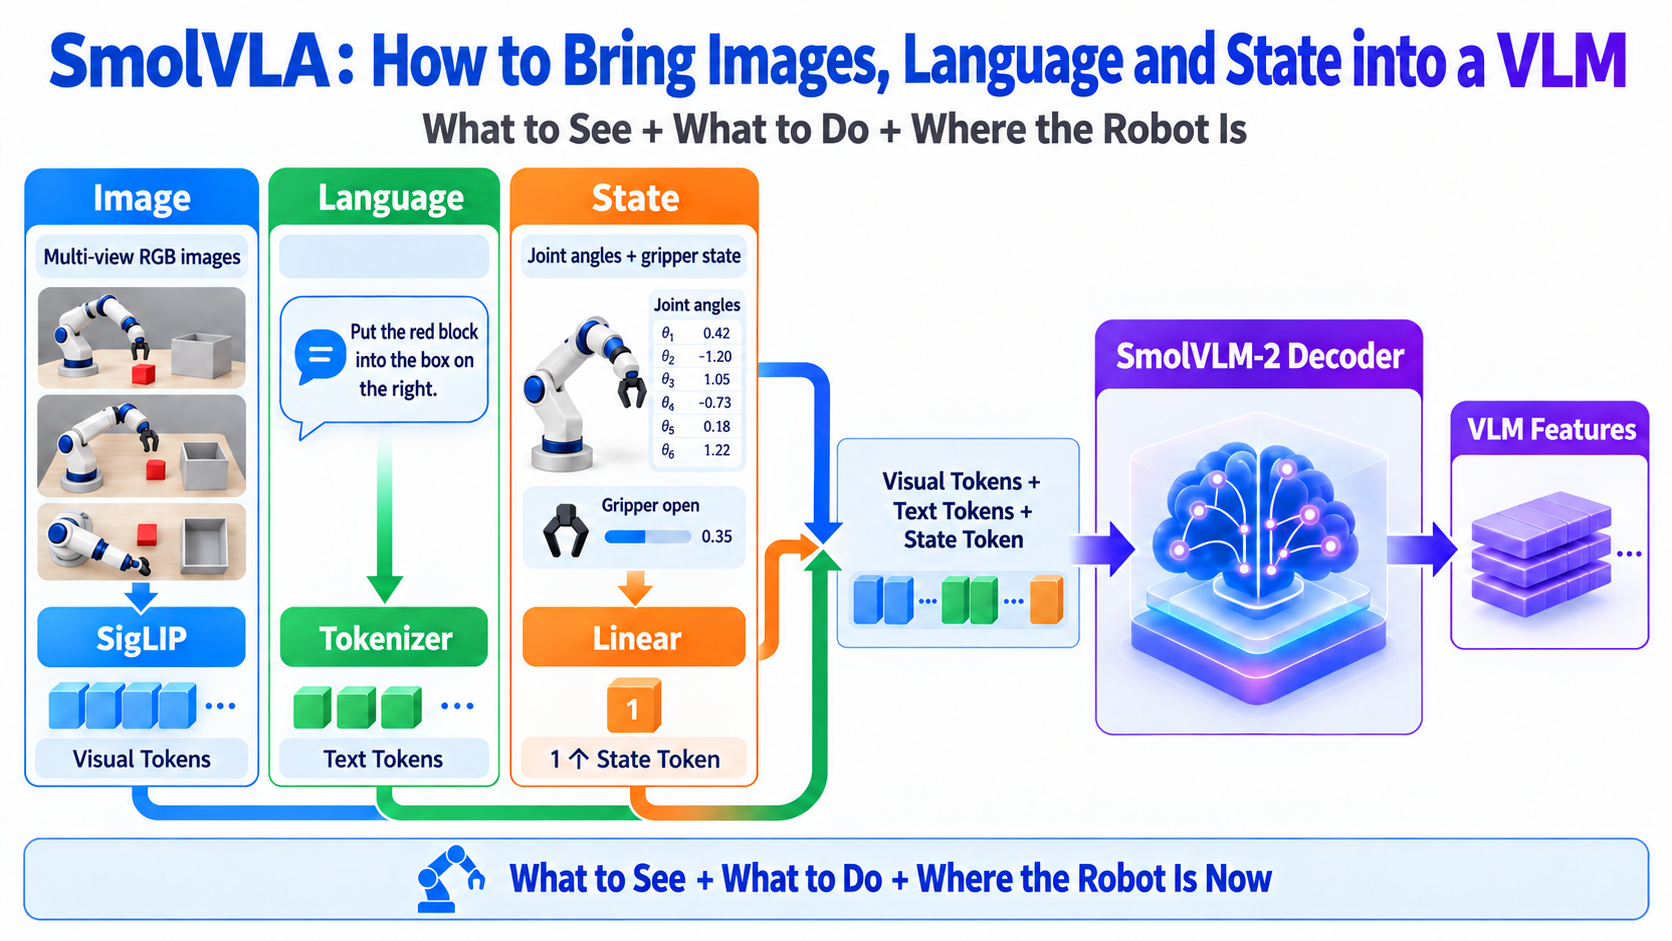
¿Por qué conservar solo 64 tokens visuales por fotograma?
-
Las imágenes de alta resolución producen muchos tokens visuales. Más tokens aumentan el cómputo de atención y ralentizan la inferencia.
-
SmolVLM-2 admite el mosaico de imágenes, que codifica múltiples regiones locales de la imagen. SmolVLA desactiva el mosaico para ganar velocidad, mantiene la imagen global y usa pixel shuffle para limitar cada fotograma a 64 tokens visuales.
-
Esto puede sacrificar detalles de objetos pequeños y texturas finas, pero reduce sustancialmente el cómputo.
¿Por qué usar solo la primera mitad del VLM?
-
Para un VLM con L capas, SmolVLA extrae características en la capa N y descarta las L−N capas restantes.
-
Los autores encuentran que
N = L/2equilibra velocidad y rendimiento. El modelo principal usa las primeras 16 capas del modelo de lenguaje.
Full VLM: Layer 1 → 2 → ... → L

SmolVLA:Layer 1 → 2 → ... → N → Action Expert
                               × Remaining layers are not computed
- Esto conserva la primera mitad en lugar de saltarse capas alternas. Los estudios de ablación sugieren que suele ser mejor que sustituir la columna vertebral por un VLM más pequeño, porque las capas conservadas mantienen la anchura y la capacidad de representación del modelo grande.
Cómo el experto en acciones genera acciones
-
El experto en acciones recibe:
-
Características de condicionamiento del VLM.
-
Un fragmento de acción ruidoso.
-
-
Alterna atención cruzada y autoatención causal.
La atención cruzada lee la tarea actual
- Los tokens de acción actúan como consultas, leyendo claves y valores de las características del VLM para responder:
What is visible now?
What does the instruction request?
What is the robot's current configuration?
La autoatención relaciona las acciones
- La autoatención entre tokens de acción hace que la secuencia futura sea coherente, por ejemplo “acercarse → cerrar la garra → levantar → transportar → colocar”.
¿Por qué usar una máscara causal?
-
La máscara permite que la acción i atienda a tokens de acción anteriores pero no a posteriores.
-
La atención bidireccional rinde peor en los estudios de ablación del artículo. Los autores sugieren que evitar la fuga de acciones futuras ayuda a aprender una estructura temporal más adecuada.
-
La estructura final es:
VLM Features ───────┐
                    ↓
Noisy Actions → Cross-Attention
                    ↓
              Self-Attention
                    ↓
              Cross-Attention
                    ↓
              Self-Attention
                    ↓
               Action Chunk
Flow matching en SmolVLA
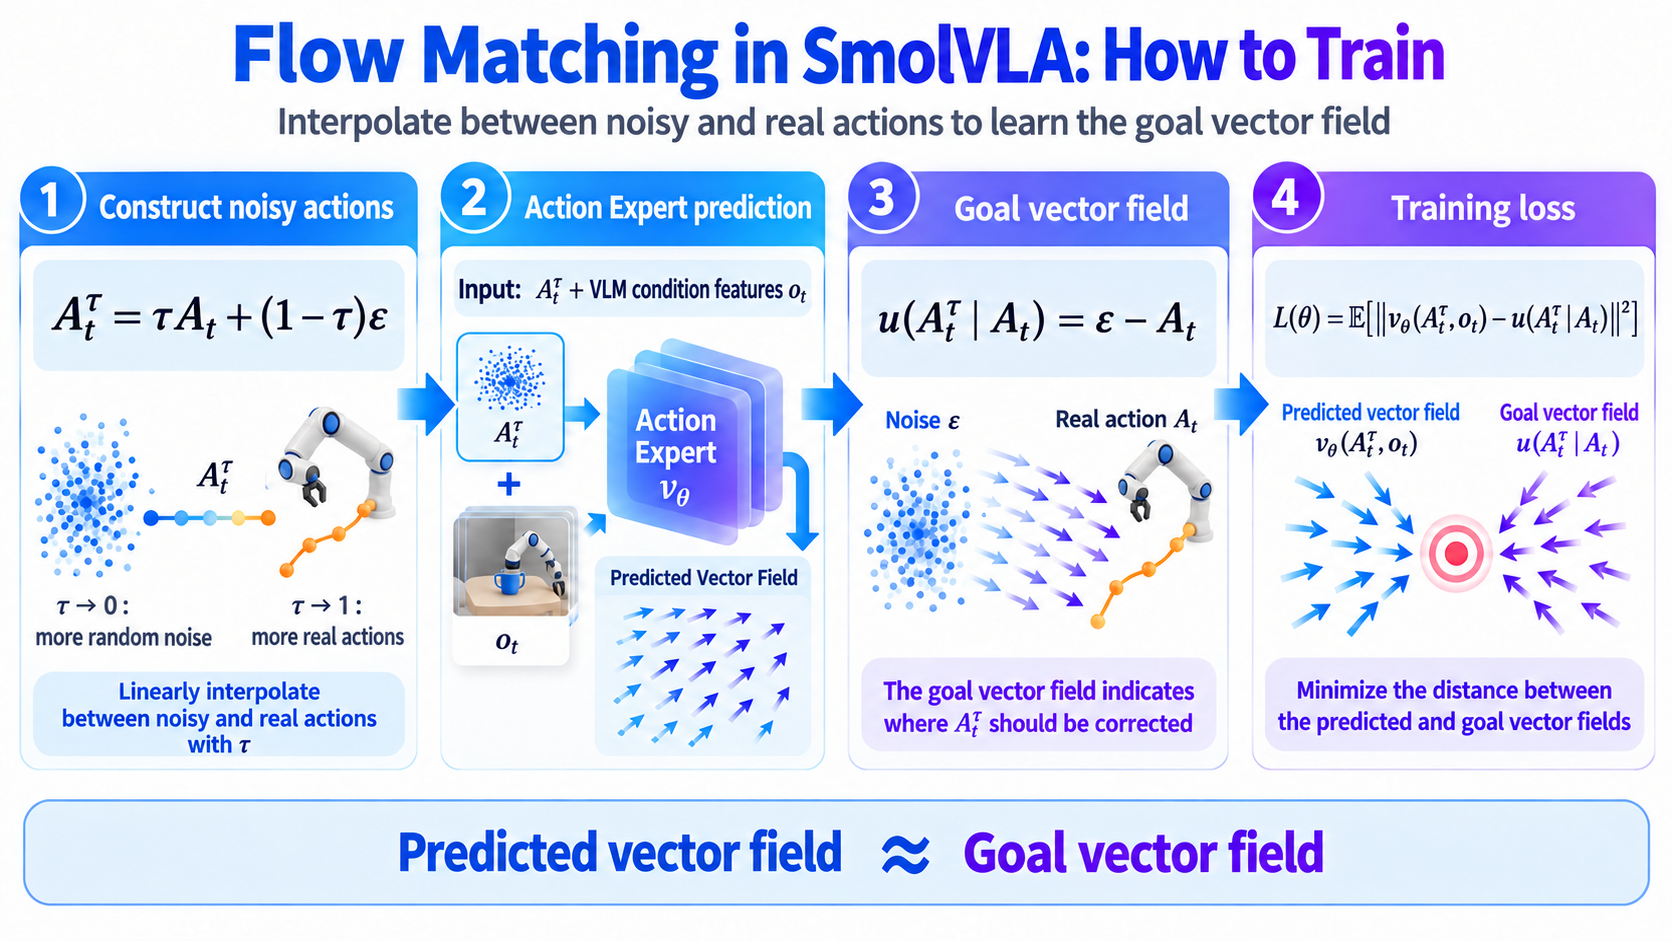
Flujo completo de entrenamiento e inferencia
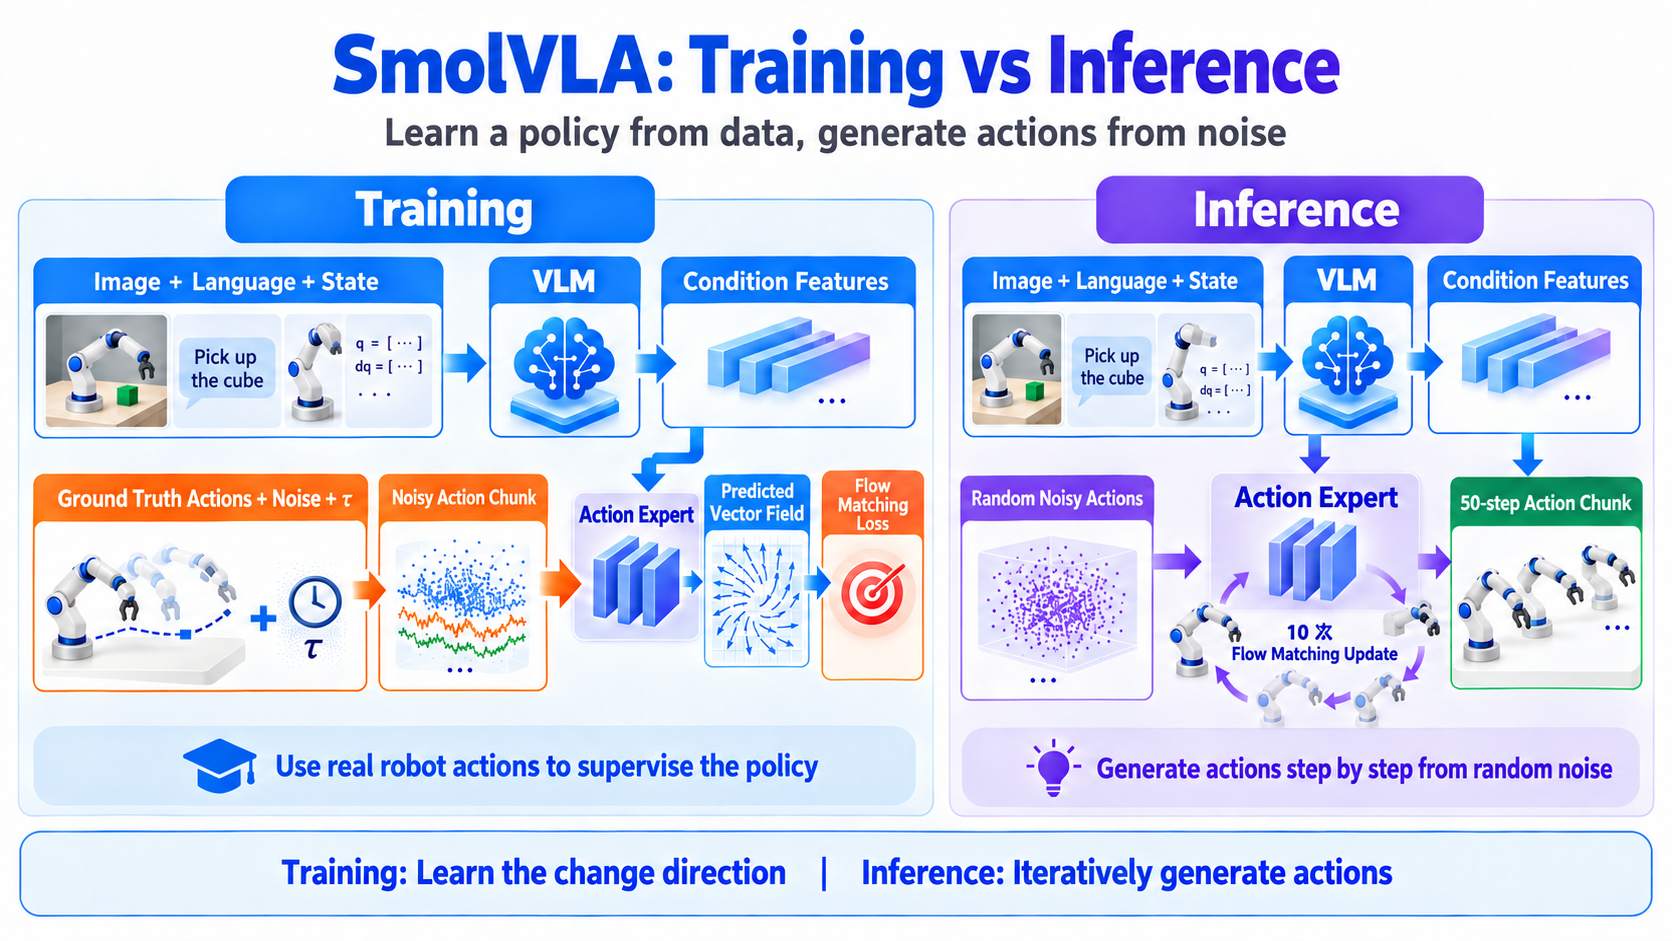
- El modelo principal tiene unos 450 millones de parámetros, incluidos aproximadamente 100 millones en el experto en acciones. Durante el entrenamiento, el VLM se congela y se entrena el experto en acciones.
Preentrenamiento con datos de la comunidad
Por qué los datos de robots forman islas
-
A diferencia del texto e imágenes de internet, las demostraciones de robots requieren hardware físico y teleoperación. Los datasets pueden diferir en:
-
Estructura del robot.
-
Frecuencia de control.
-
Definiciones de articulaciones.
-
Número y colocación de cámaras.
-
Descripciones de tareas.
-
Formato de archivo.
-
-
Estas colecciones desconectadas son “islas de datos”. Concatenar archivos por sí solo no las hace utilizables para el preentrenamiento.
¿Cuántos datos de la comunidad se usan?
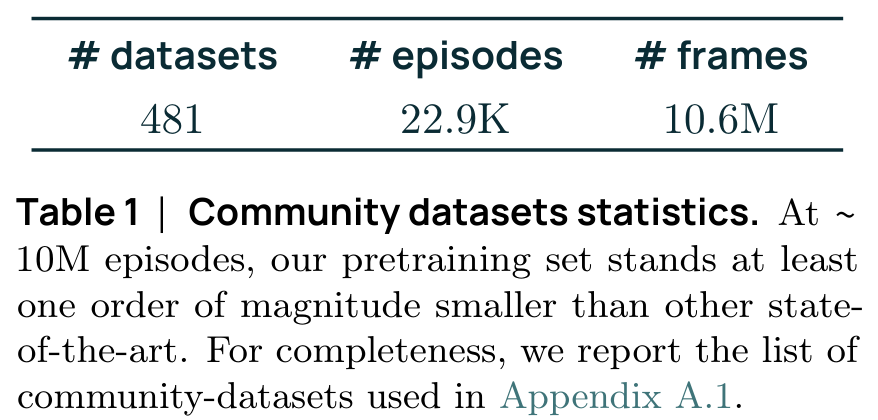
-
La selección tiene en cuenta el tipo de robot, el número de episodios, la calidad general y la cobertura de fotogramas.
-
Esto es aproximadamente un orden de magnitud menos datos de los que usan muchos VLA grandes. El objetivo es mostrar que los datos de la comunidad cuidadosamente depurados pueden aportar beneficios de preentrenamiento significativos a menor escala.
Limpiar el lenguaje de las tareas con un VLM
Las etiquetas de tareas de la comunidad suelen ser vagas, por ejemplo:
task desc
Hold
Up
Una persona podría deducir la tarea a partir del vídeo, pero esas etiquetas no dan a un VLA una descripción estable del objetivo.
Los autores usan Qwen2.5-VL-3B-Instruct para generar descripciones mejoradas:
-
Muestrear imágenes representativas del dataset.
-
Proporcionar la etiqueta de tarea original.
-
Pedir una frase corta y completa que comience con un verbo de acción.
Vague original label + representative images
             ↓
     Qwen2.5-VL-3B
             ↓
Clear action-oriented instruction
Estandarizar los puntos de vista de las cámaras
-
Los nombres de cámaras varían entre los datasets de la comunidad.
images.laptoppuede describir una cámara cenital en un dataset y una cámara de muñeca en otro. -
Tratar los nombres como semántica fija asignaría repetidamente vistas diferentes a la misma ranura de entrada, confundiendo el entrenamiento.
-
Los autores asignan manualmente las cámaras a un orden estándar, priorizando:
Top → Wrist → Side
- Luego las renombran de forma coherente:
OBS_IMAGE_1
OBS_IMAGE_2
OBS_IMAGE_3
- Las vistas adicionales más allá de las requeridas se descartan.
Inferencia asíncrona
El problema con los chunks síncronos
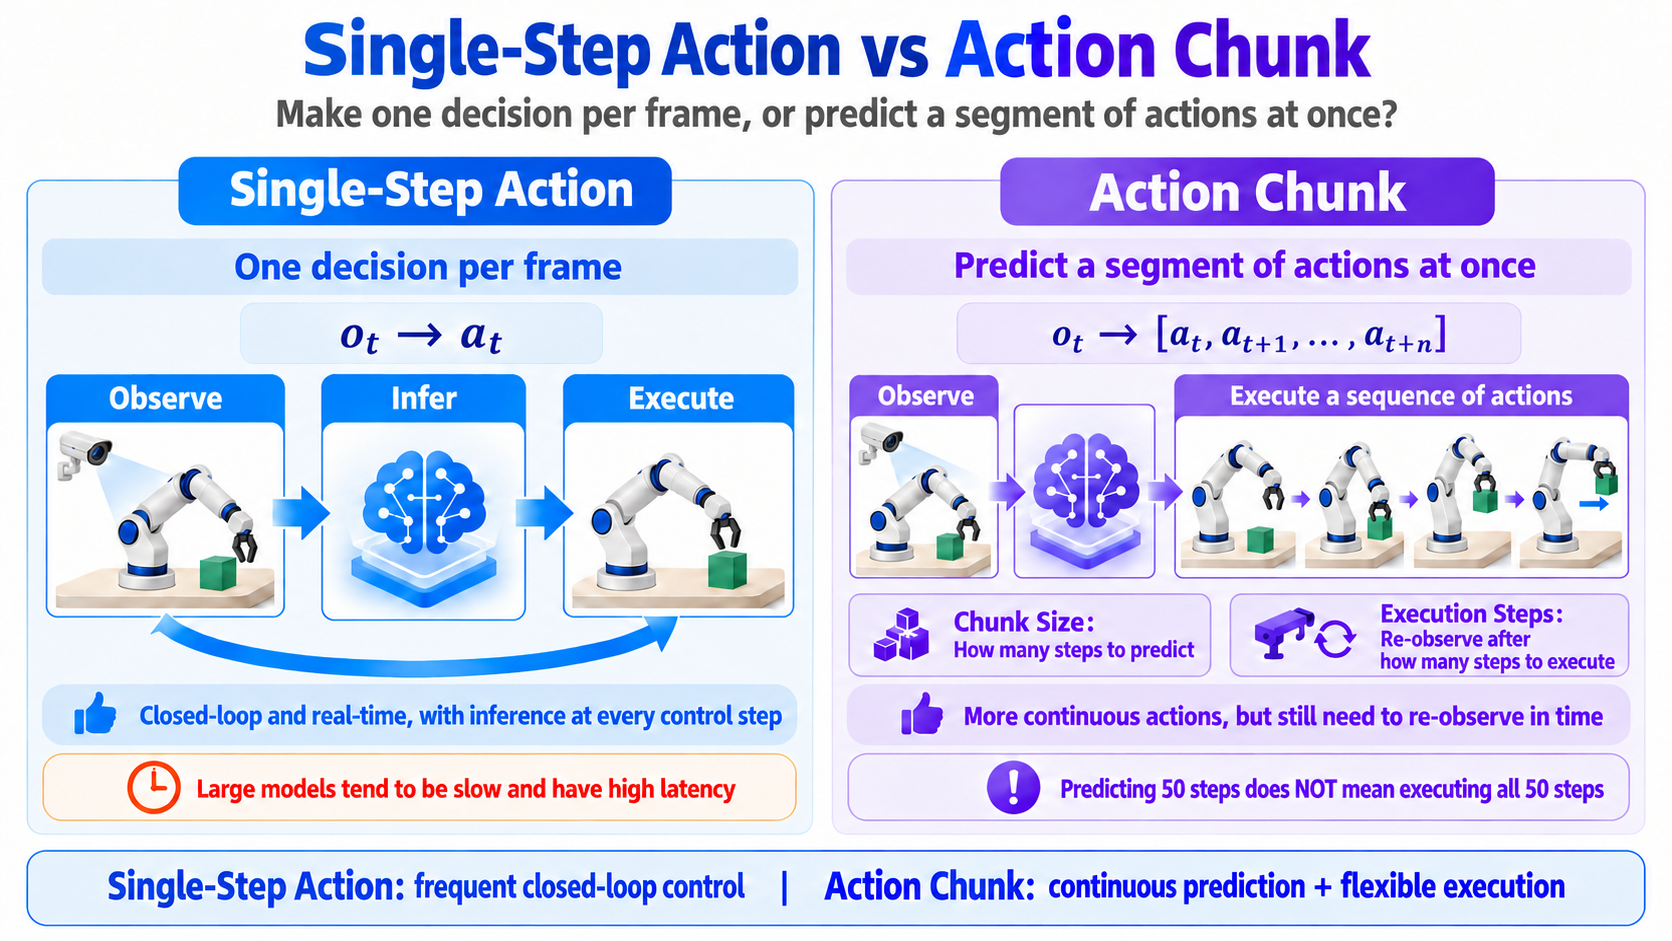
- Deja que el modelo prediga un chunk de acciones a partir de la observación
o_t:
A_t = [a_t, a_t+1, ... , a_t+n]
-
Un sistema síncrono eficiente en cómputo ejecuta todo
A_tantes de observar y predecir de nuevo. Esto causa dos problemas:-
La ejecución no usa imágenes nuevas durante el chunk, creando un intervalo en lazo abierto.
-
Una vez que el chunk se agota, el robot espera a la inferencia.
-
RobotClient y PolicyServer
- SmolVLA separa dos roles:
| Componente | Responsabilidad |
|---|---|
| RobotClient | Capturar imágenes, leer el estado, mantener la cola de acciones y ejecutar acciones. |
| PolicyServer | Recibir observaciones, ejecutar SmolVLA y devolver un nuevo chunk de acciones. |
- RobotClient solicita nuevas acciones antes de que la cola actual se vacíe, activando la inferencia de forma asíncrona.
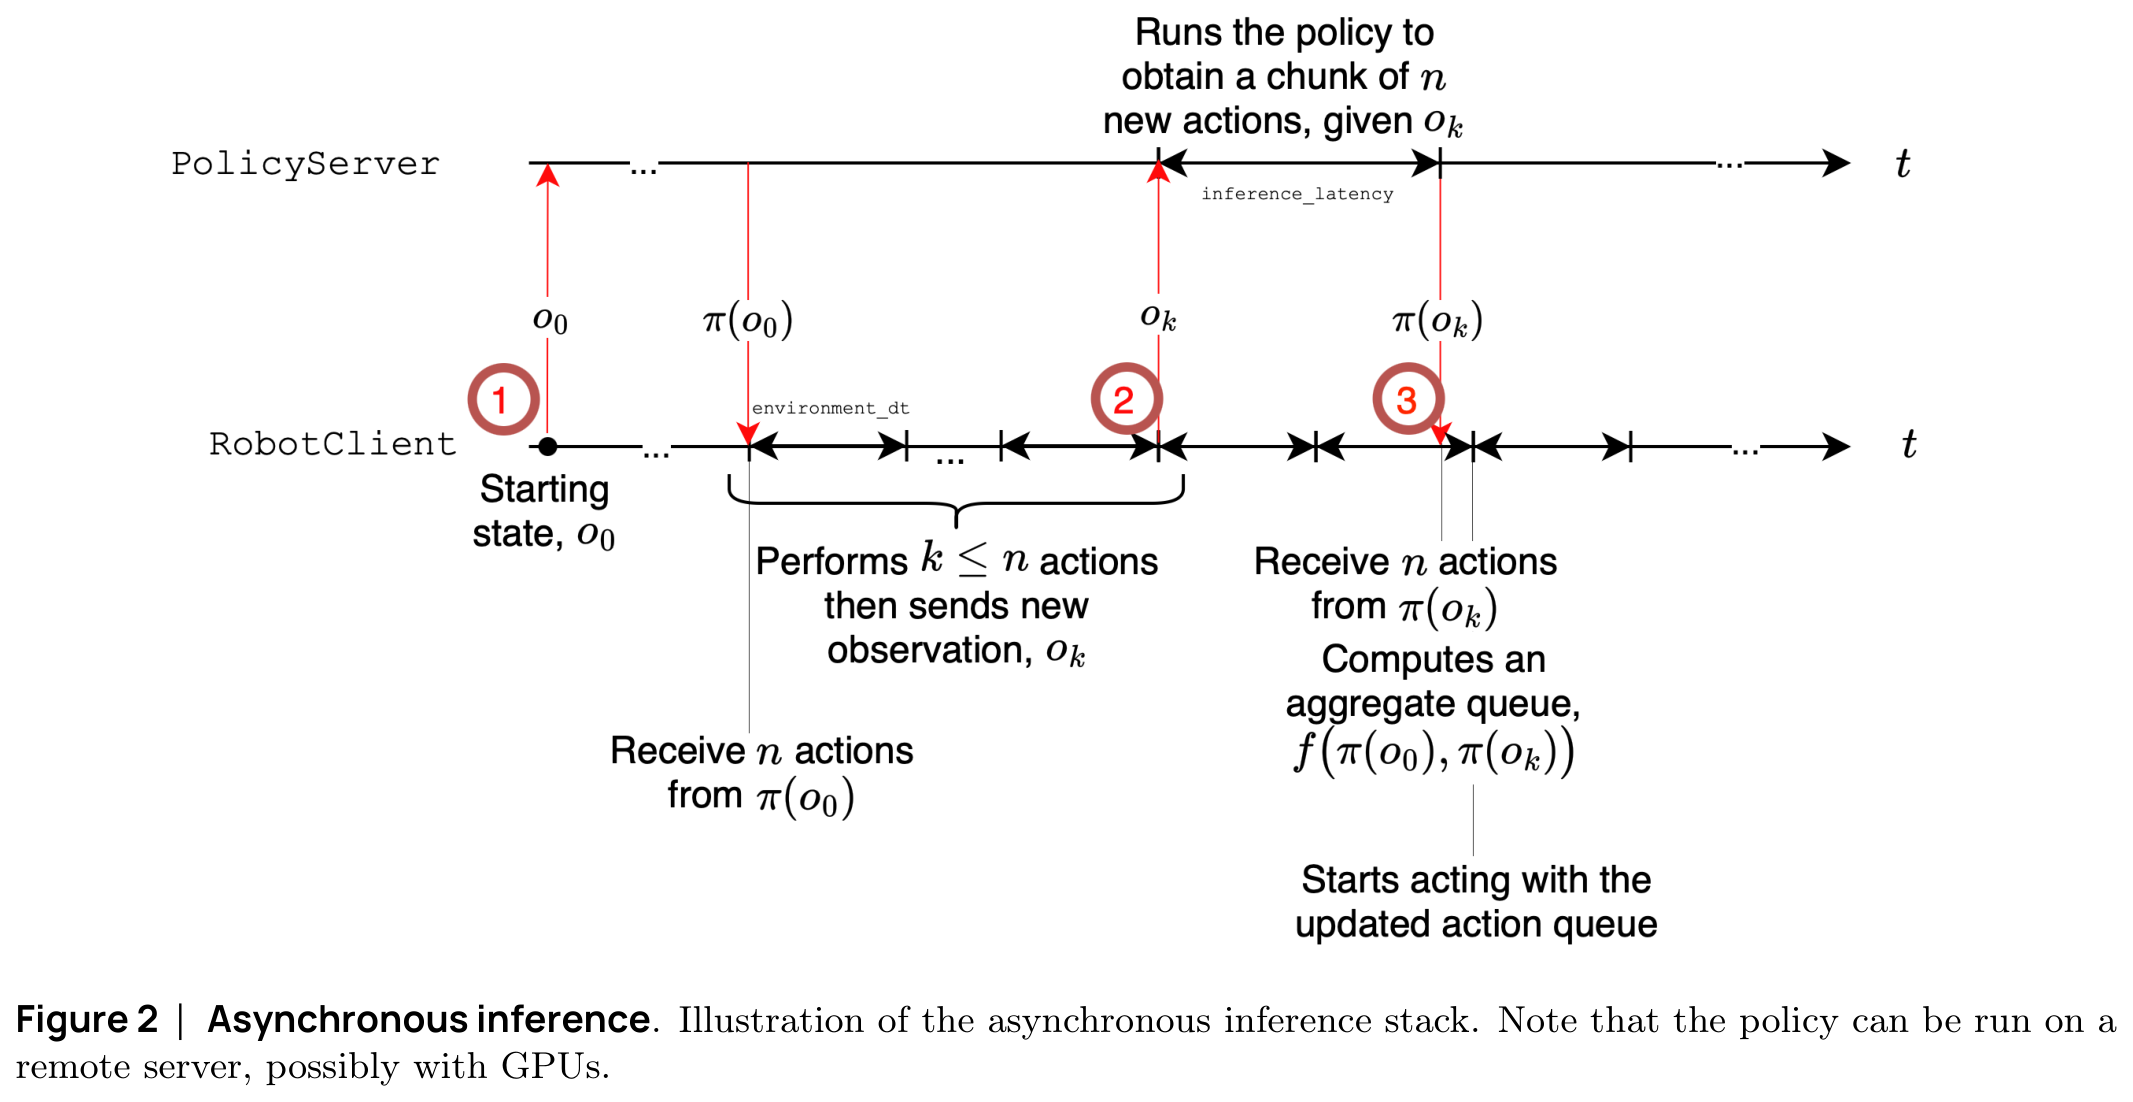
- La secuencia es:
Robot executes the old chunk
        ↓
Queue falls below the threshold
        ↓
Capture a new observation and request PolicyServer asynchronously
        ↓
Robot continues executing the old queue
        ↓
New chunk arrives
        ↓
Merge or update the action queue
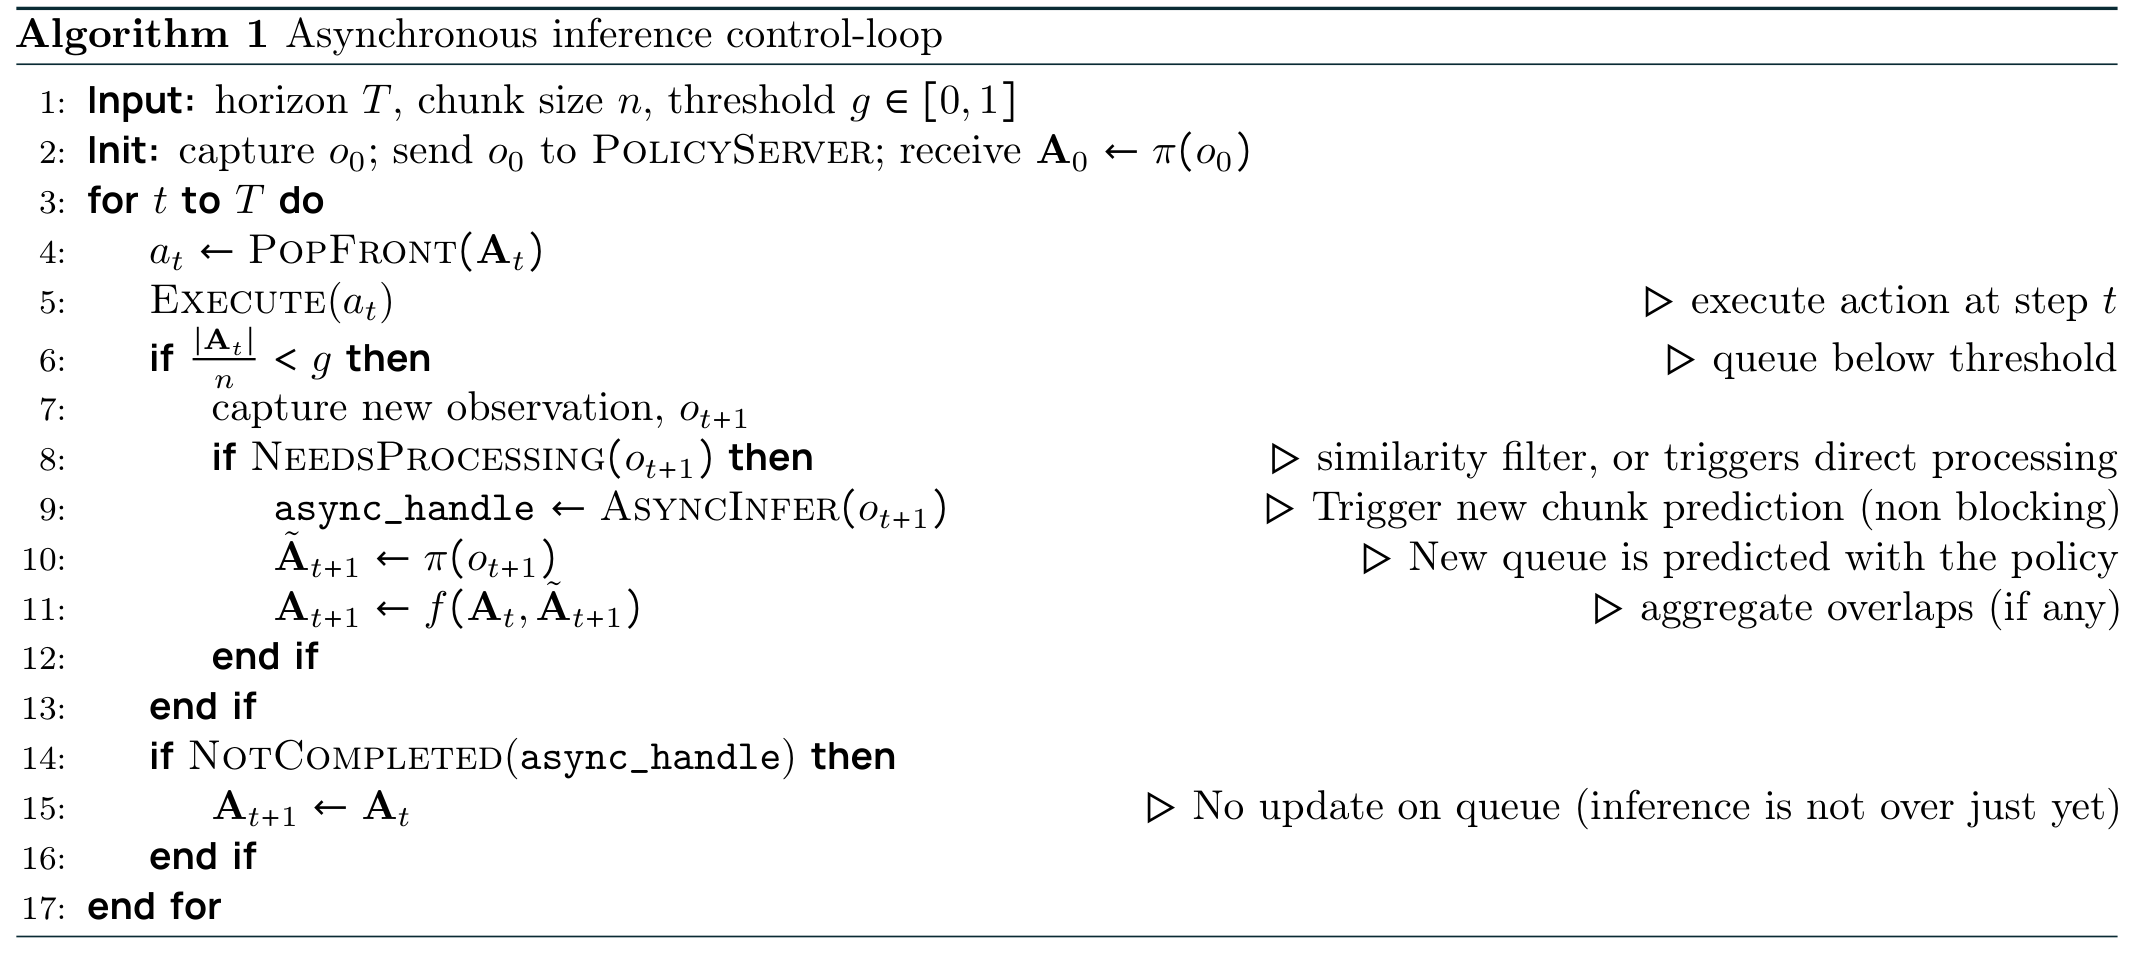
El umbral g controla cuándo predecir
- El artículo usa
g ∈ [0,1]. RobotClient solicita otro chunk cuando la proporción de acciones restantes cae por debajo deg:
|A_t| / n < g
g = 0
- Esperar hasta que la cola esté vacía, aproximando la inferencia síncrona y creando un mayor riesgo de pausas.
g = 1
- Solicitar nuevas acciones casi en cada ciclo de control, maximizando la capacidad de respuesta pero también el coste de cómputo.
0 < g < 1
- El artículo ilustra el compromiso con
g = 0.7: consumir parte de la cola antigua y luego solicitar el siguiente chunk pronto. Esto reduce los huecos sin ejecutar el modelo en cada paso.
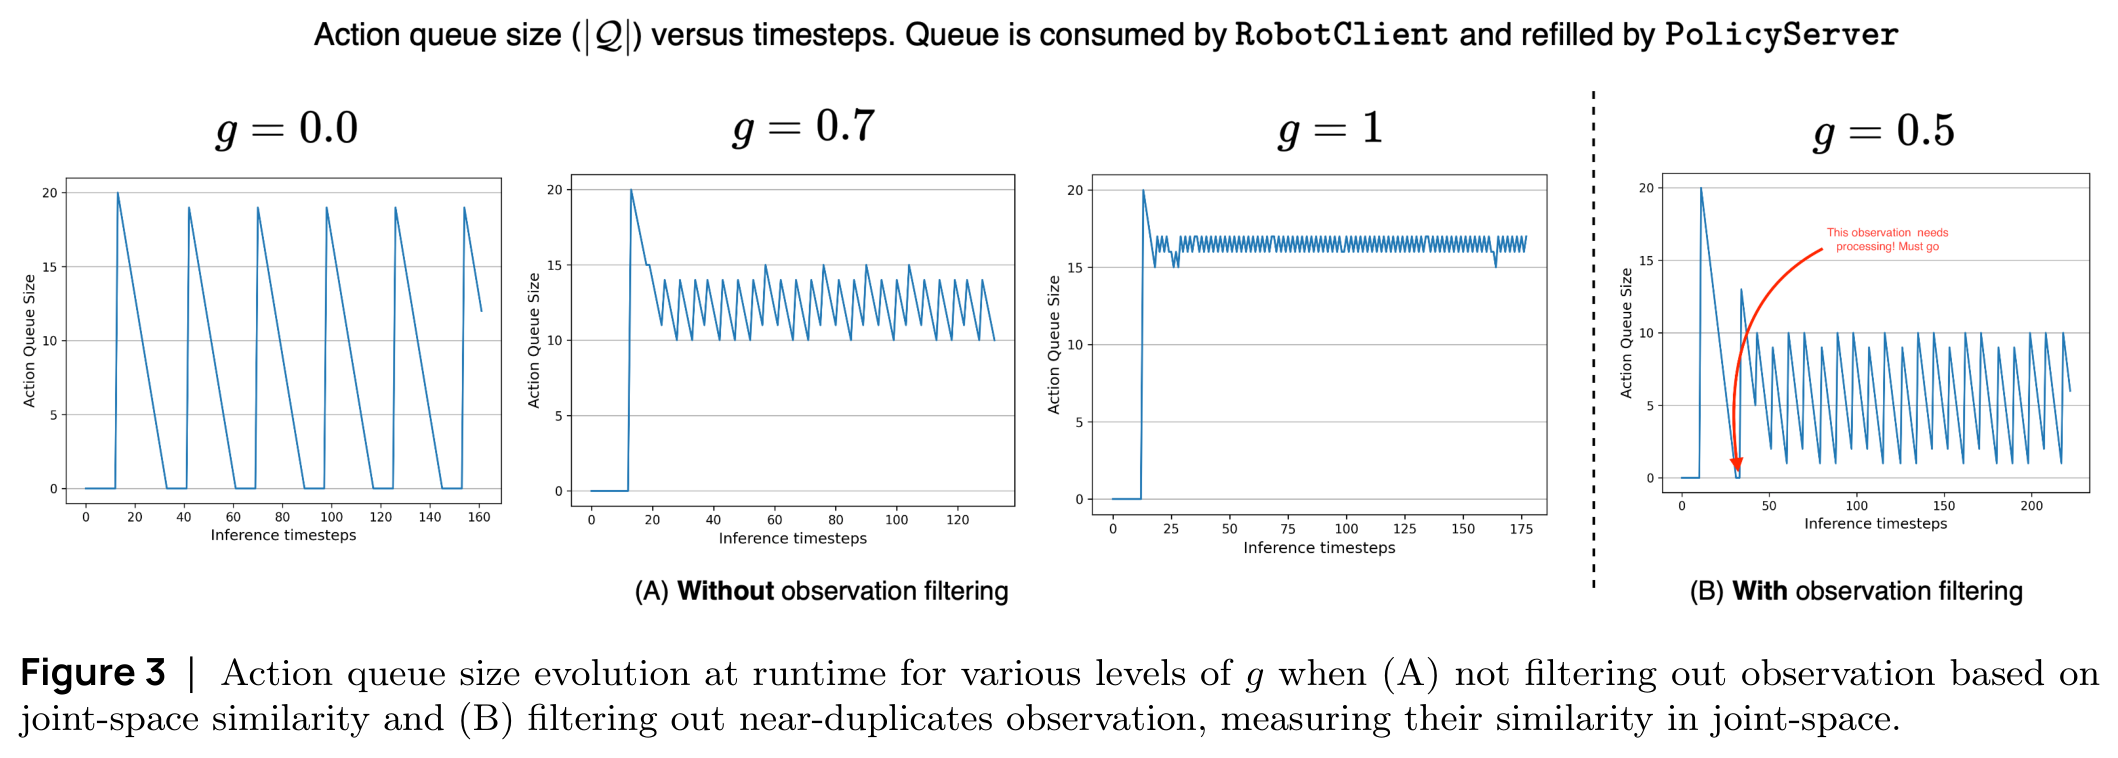
- En efecto,
greserva tiempo de inferencia. Los modelos más lentos o mayores retardos de red requieren solicitudes más tempranas.
¿Por qué filtrar observaciones repetidas?
-
Si el brazo apenas se mueve, las observaciones consecutivas pueden ser casi idénticas. Enviar todas ellas desperdicia cómputo y puede fusionar repetidamente chunks casi idénticos.
-
Los autores comparan observaciones usando distancia en el espacio articular y omiten casi duplicados cuando la distancia está por debajo de
ε. -
Si la cola está vacía, sin embargo, la última observación debe procesarse incluso si es similar; de lo contrario el robot podría permanecer detenido indefinidamente.
Configuración experimental
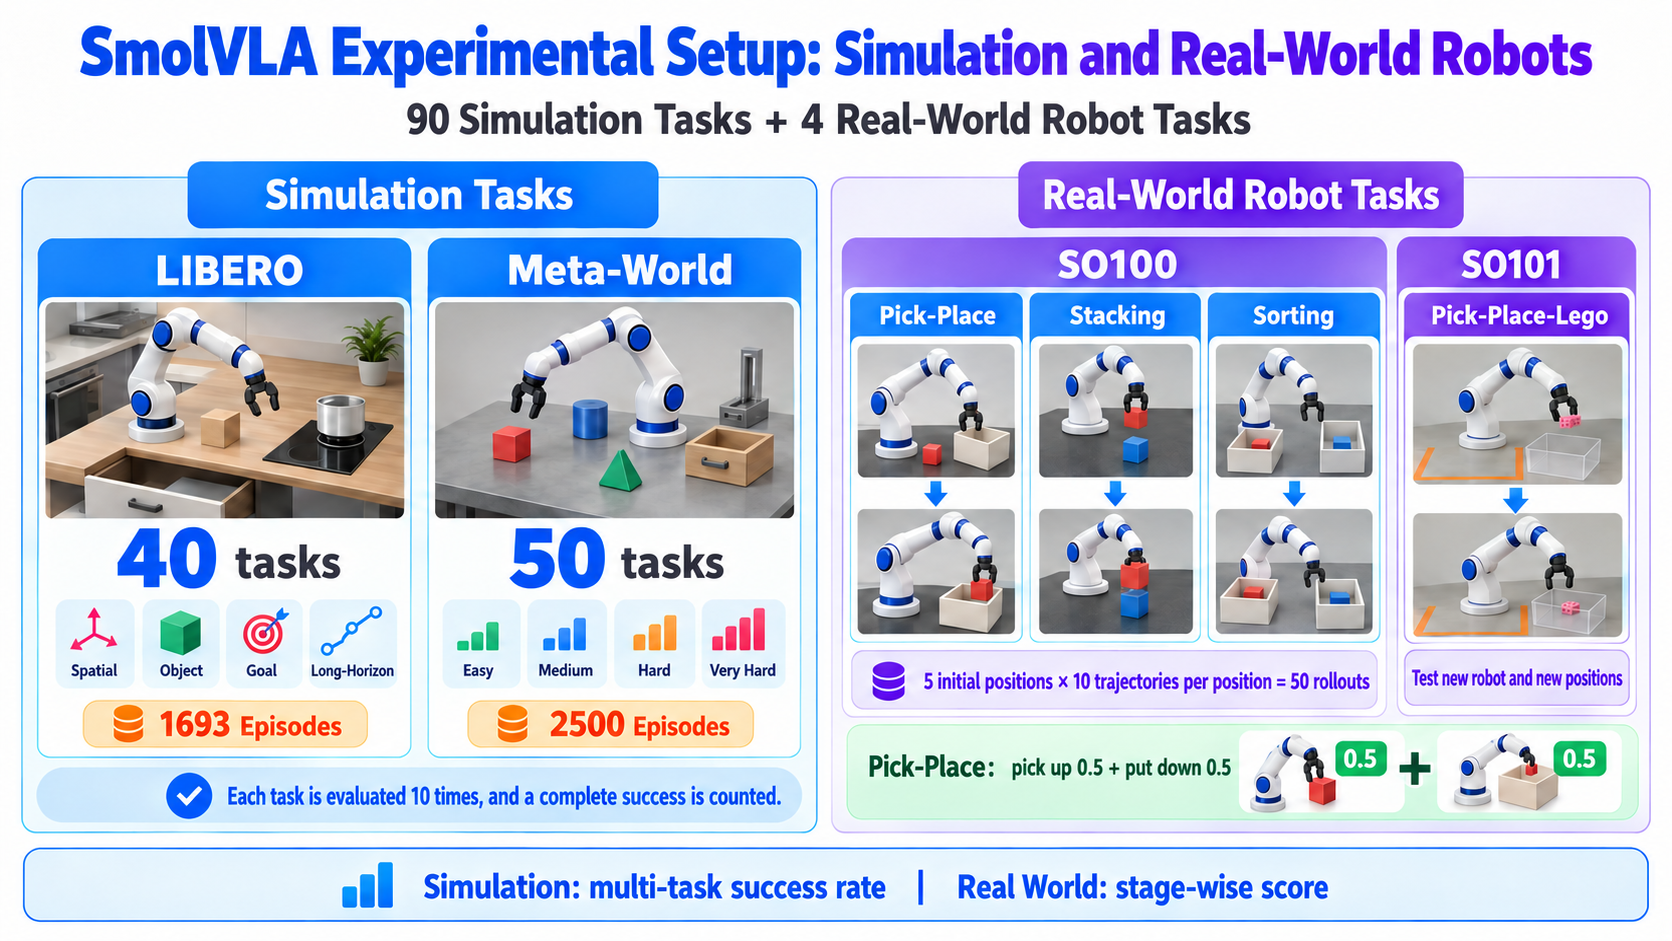
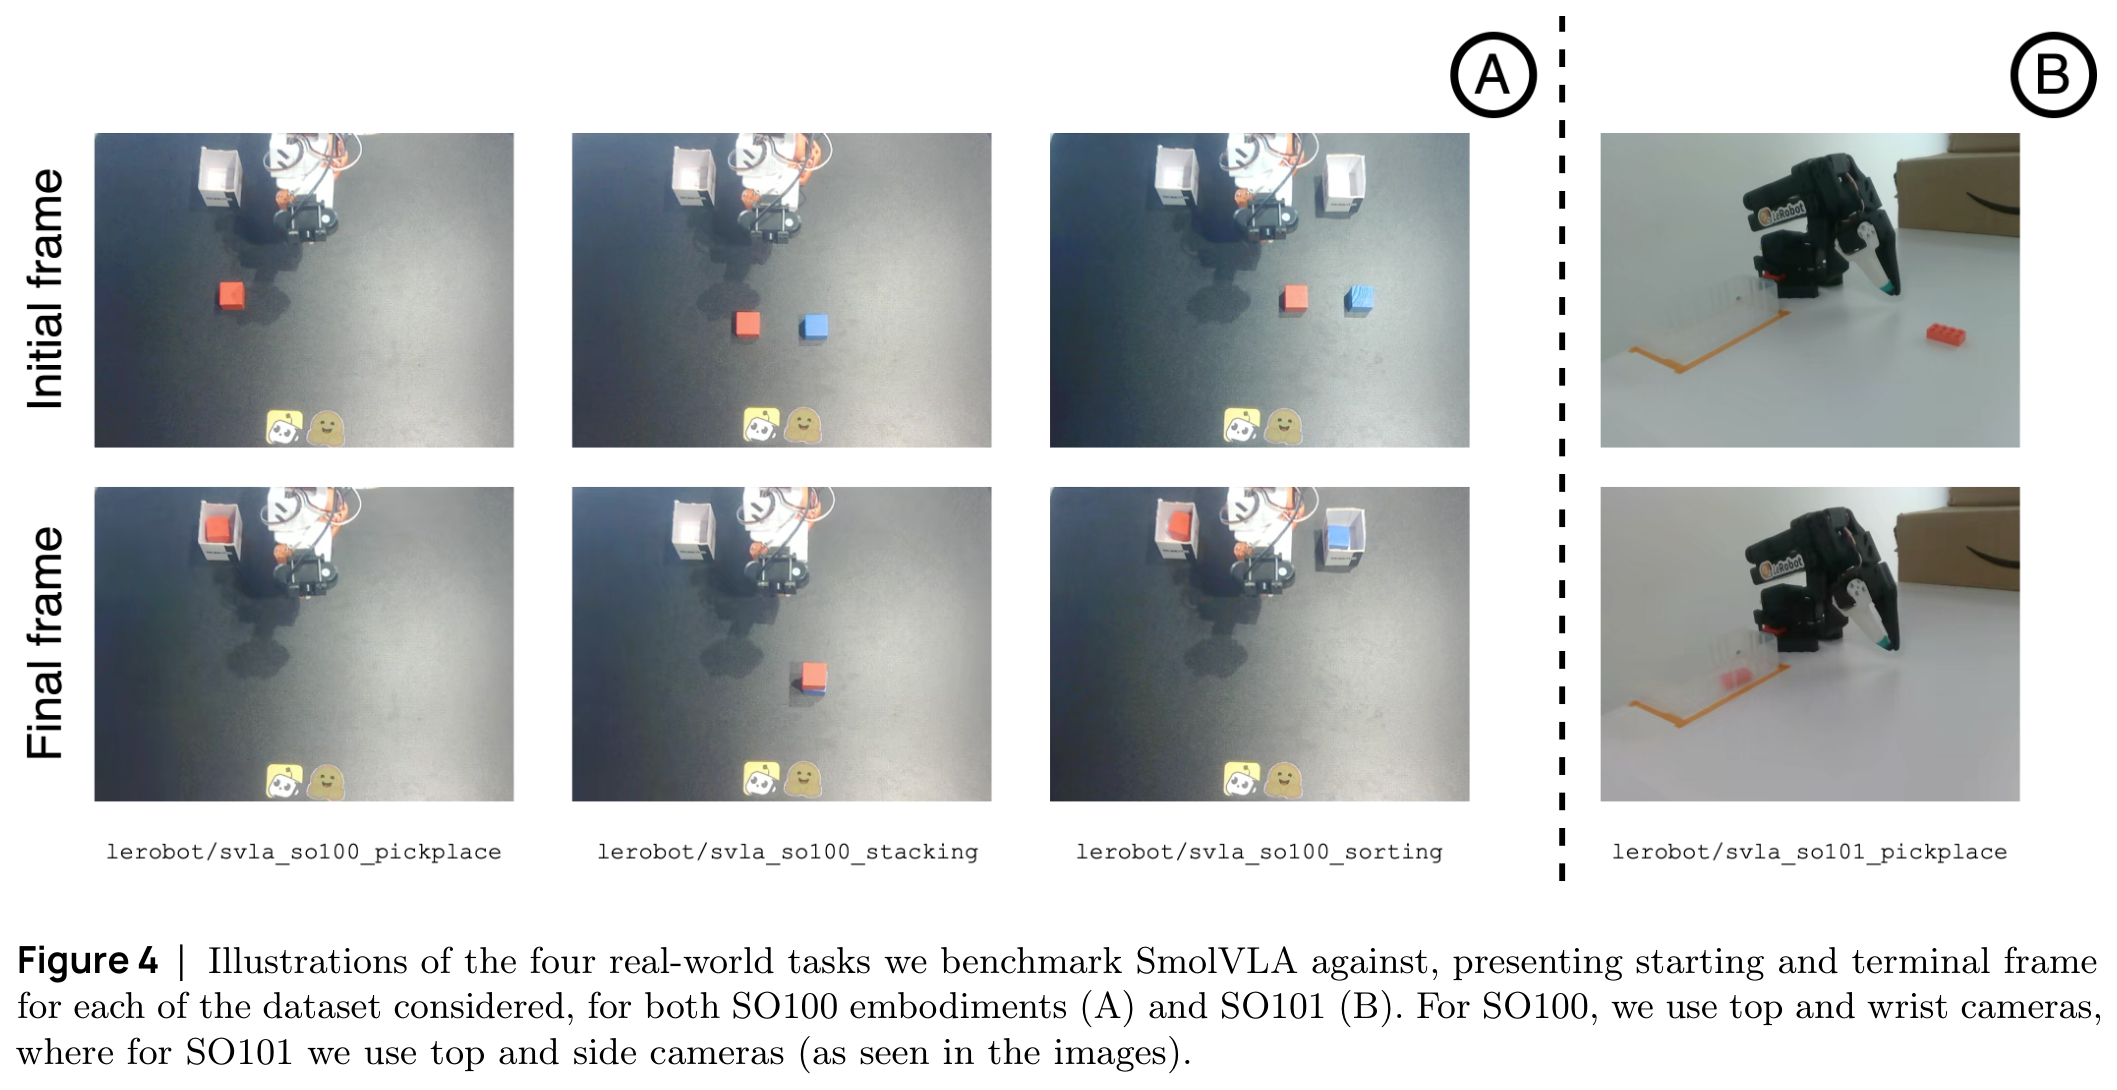
Configuración de entrenamiento
| Elemento | Configuración |
|---|---|
| Resolución de imagen | 512 × 512 |
| Pasos de preentrenamiento | 200K |
| Tamaño de batch global | 256 |
| Optimizador | AdamW |
| Tasa de aprendizaje | Decae de 1e-4 a 2.5e-6 |
| Tamaño del chunk de acción | 50 |
| Pasos de Flow Matching | 10 |
| Parámetros del modelo principal | 450M |
| Parámetros del experto en acciones | Alrededor de 100M |
| Cómputo total del proyecto | Alrededor de 30K horas de GPU |
- El preentrenamiento usa cuatro GPU para obtener un tamaño de batch mayor, mientras que los autores señalan que el modelo en sí puede entrenarse en una sola GPU.
Resultados
Simulación
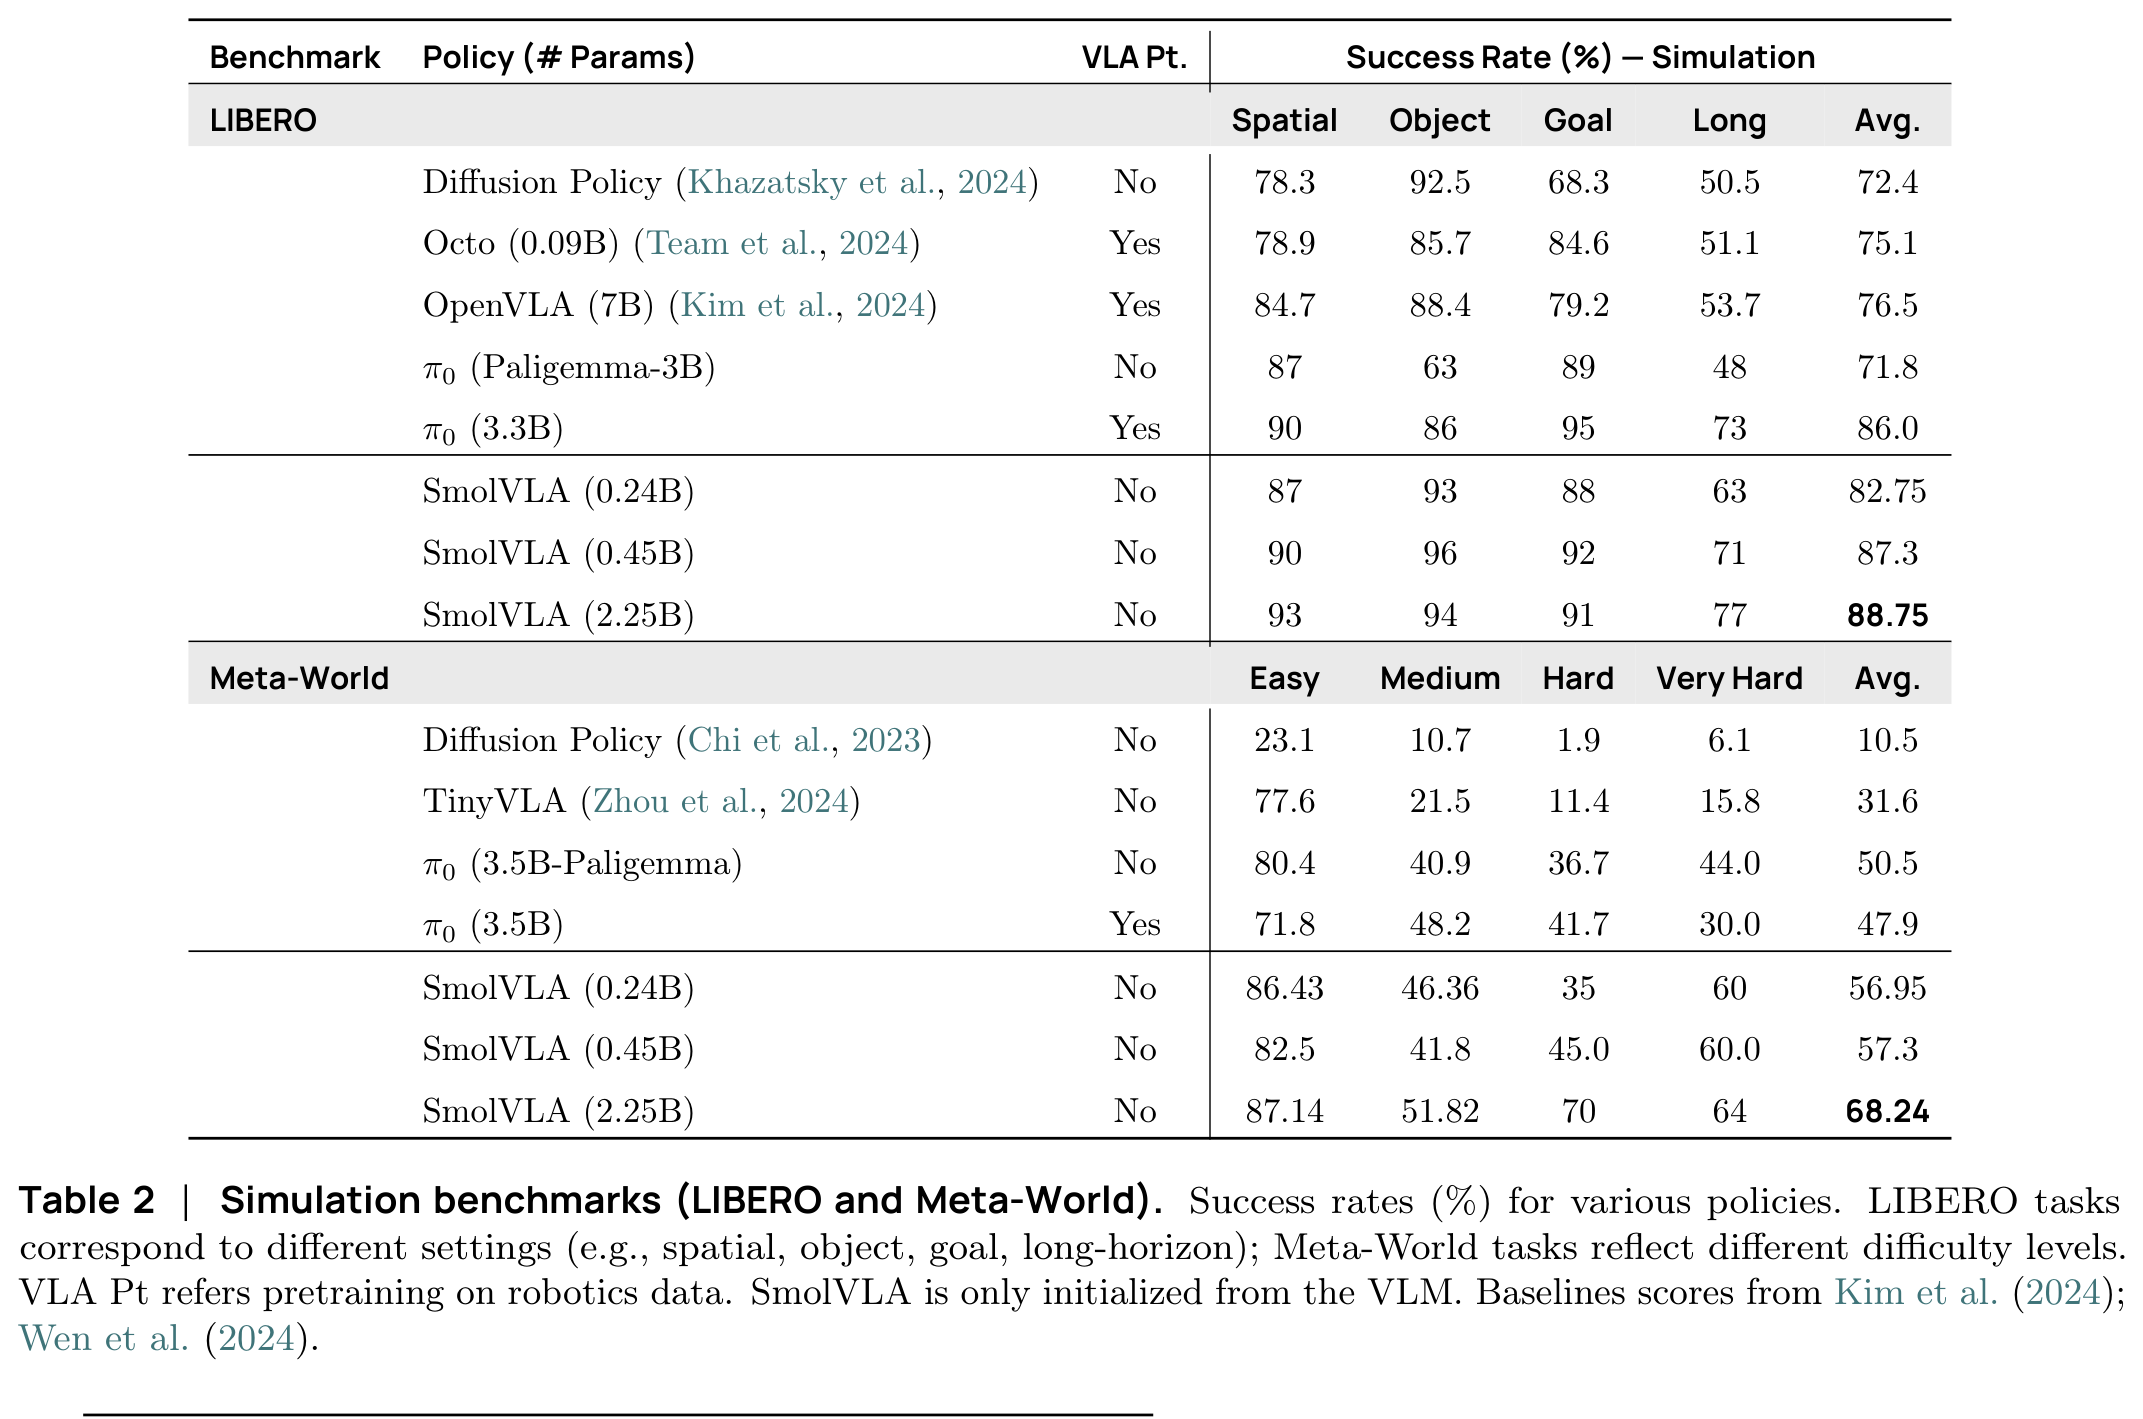
En LIBERO:
-
El SmolVLA de 0.45B tiene una tasa de éxito promedio más alta que π0 de 3.3B y OpenVLA de 7B. Escalar a 2.25B mejora aún más el rendimiento, pero la ganancia sobre 0.45B es menor.
-
En Meta-World, el éxito promedio es 57.3 para el modelo de 0.45B y 68.24 para el de 2.25B. El tamaño del modelo por sí solo no determina el rendimiento: la arquitectura, los datos y los objetivos de entrenamiento también importan.
Resultados en el robot real SO100
-
π0 alcanza 100 en la tarea de pick-and-place más sencilla, pero SmolVLA rinde sustancialmente mejor en apilado y clasificación y logra el mejor promedio general.
-
SmolVLA tiene aproximadamente una séptima parte de los parámetros de π0.
Resultados de transferencia en SO101
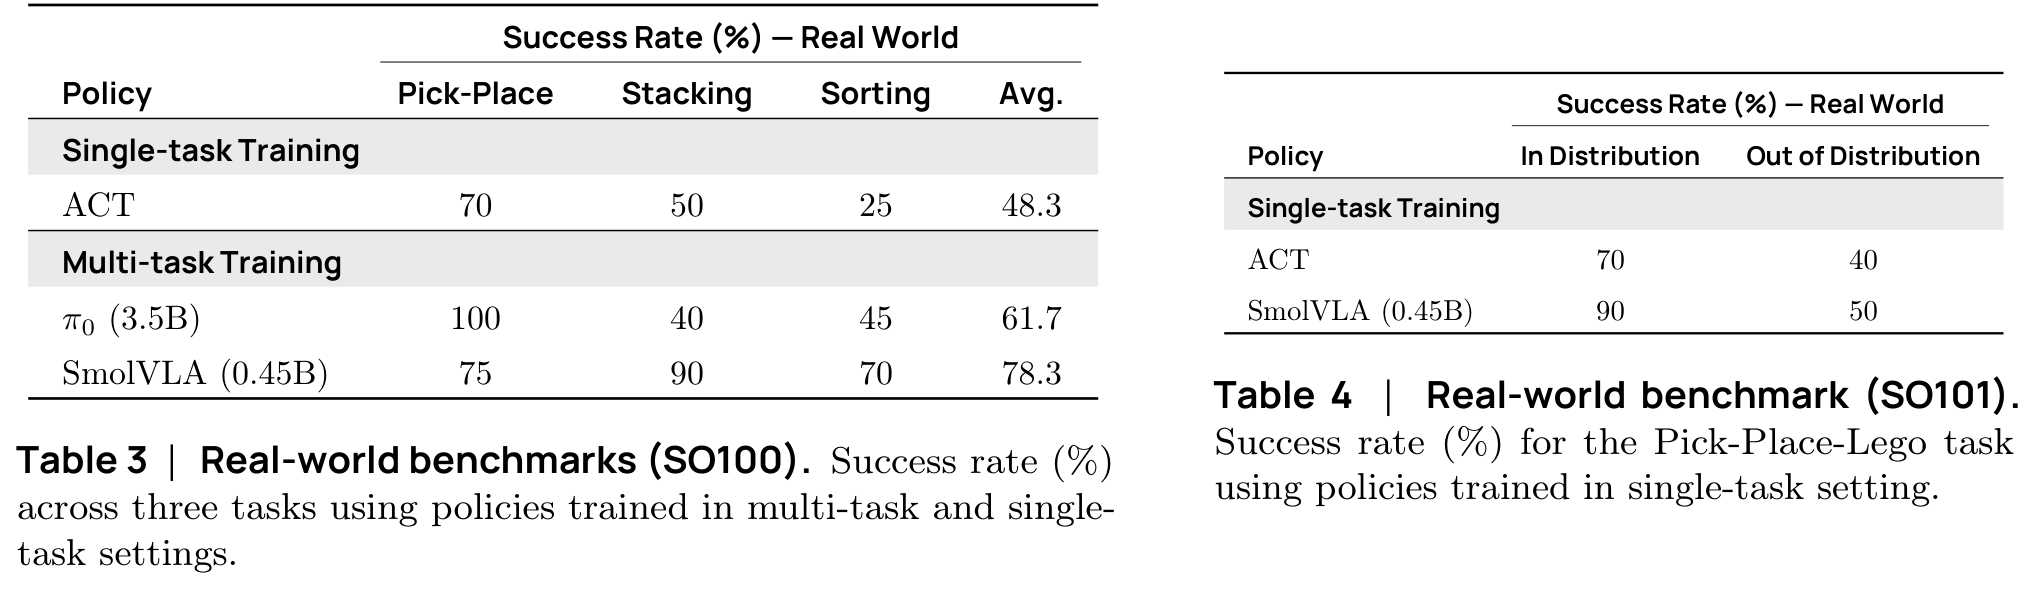
- El preentrenamiento comunitario usa principalmente datos de SO100, sin datos de SO101. Tras el ajuste fino en tareas de SO101, SmolVLA sigue superando a ACT, demostrando adaptación a otra plataforma.
Qué aporta el preentrenamiento comunitario
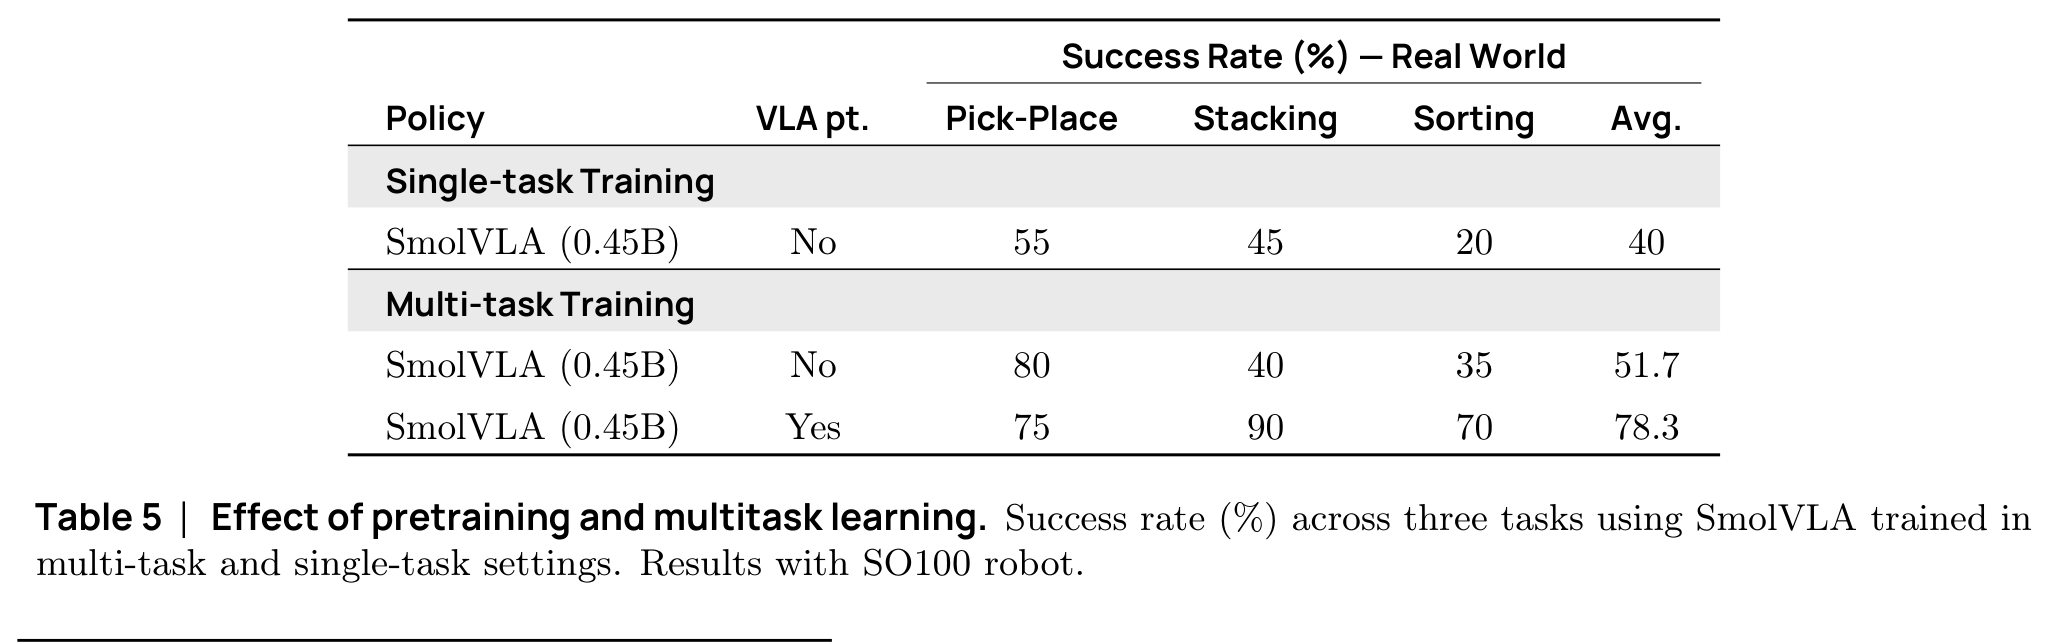
-
Pasar de entrenamiento de una sola tarea a multitarea eleva el éxito promedio de 40.0 a 51.7.
-
Añadir preentrenamiento comunitario lo eleva a 78.3.
-
Una conclusión importante es que los datos de preentrenamiento pueden importar más que simplemente aumentar el número de parámetros.
Inferencia síncrona y asíncrona
| Inferencia | Pick-Place | Apilado | Clasificación | Promedio |
|---|---|---|---|---|
| Sync | 75 | 90 | 70 | 78.3 |
| Async | 80 | 90 | 50 | 73.3 |
-
La asincronía no mejora todas las tareas: la clasificación cae de 70 a 50. No debe describirse como universalmente más precisa.
-
Su principal beneficio es la velocidad y el rendimiento:
Average completion time: 13.75 seconds → 9.70 seconds
Tasks completed in a fixed time: 9 → 19
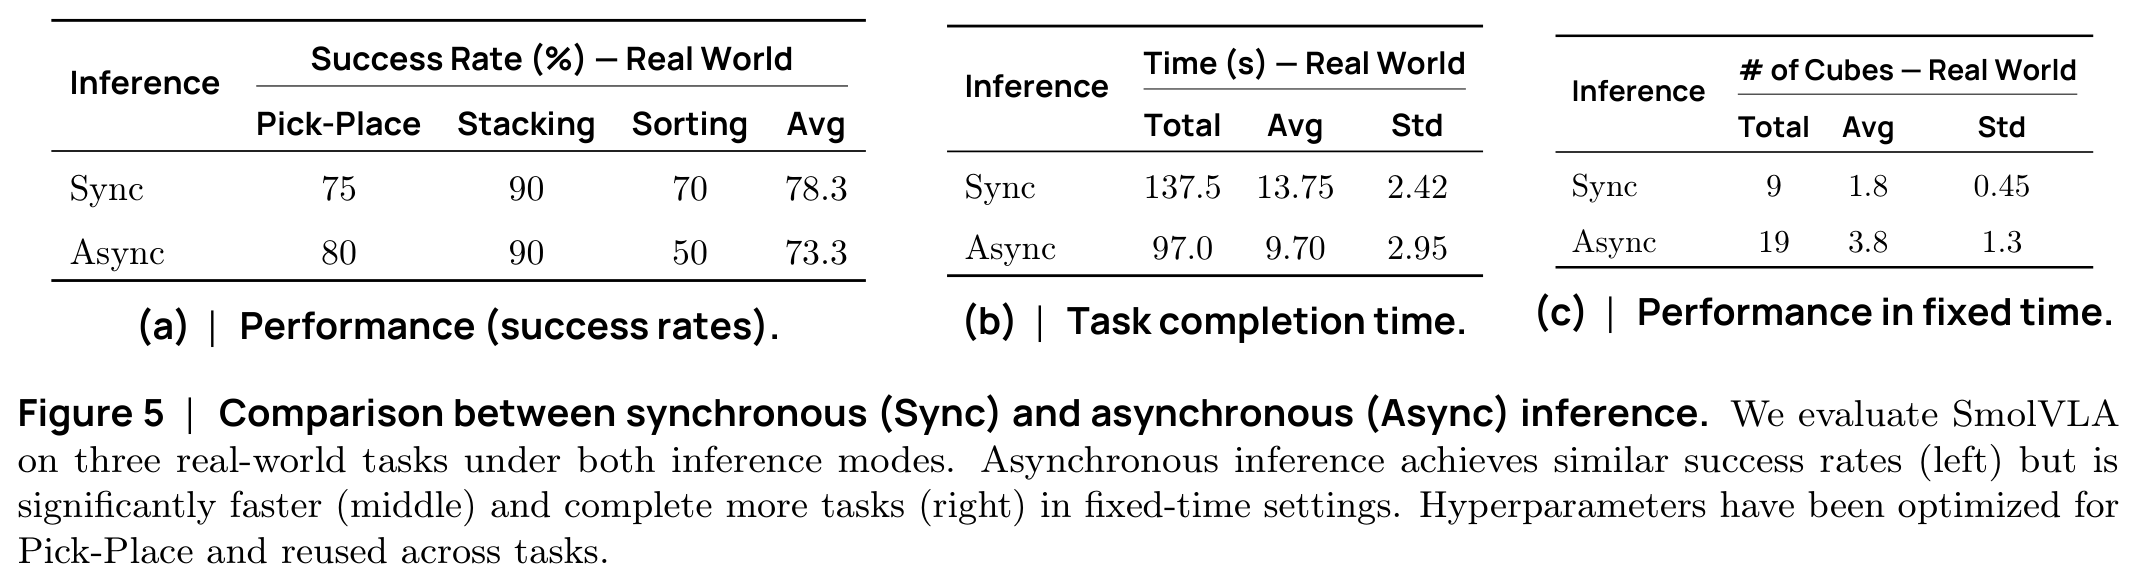
- Con tasas de éxito promedio similares, la inferencia asíncrona completa pick-and-place aproximadamente un 30% más rápido y más que duplica las tareas completadas dentro de un intervalo fijo.
Ablaciones
Cross-Attention y Self-Attention
| Atención | Éxito promedio en LIBERO |
|---|---|
| Cross-Attention | 79.0 |
| Self-Attention | 74.5 |
| Alternando CA + SA | 85.5 |
- Leer solo características de VLM o modelar solo relaciones entre acciones es insuficiente. Alternarlas funciona mejor, lo que respalda los roles complementarios del condicionamiento por tarea y la coherencia temporal.
Atención causal y bidireccional
| Máscara | Éxito promedio en LIBERO |
|---|---|
| Bidireccional | 67.5 |
| Causal | 74.5 |
- Impedir que los tokens de acción vean acciones futuras mejora el rendimiento en este experimento, lo que sugiere que una dirección temporal explícita es útil.
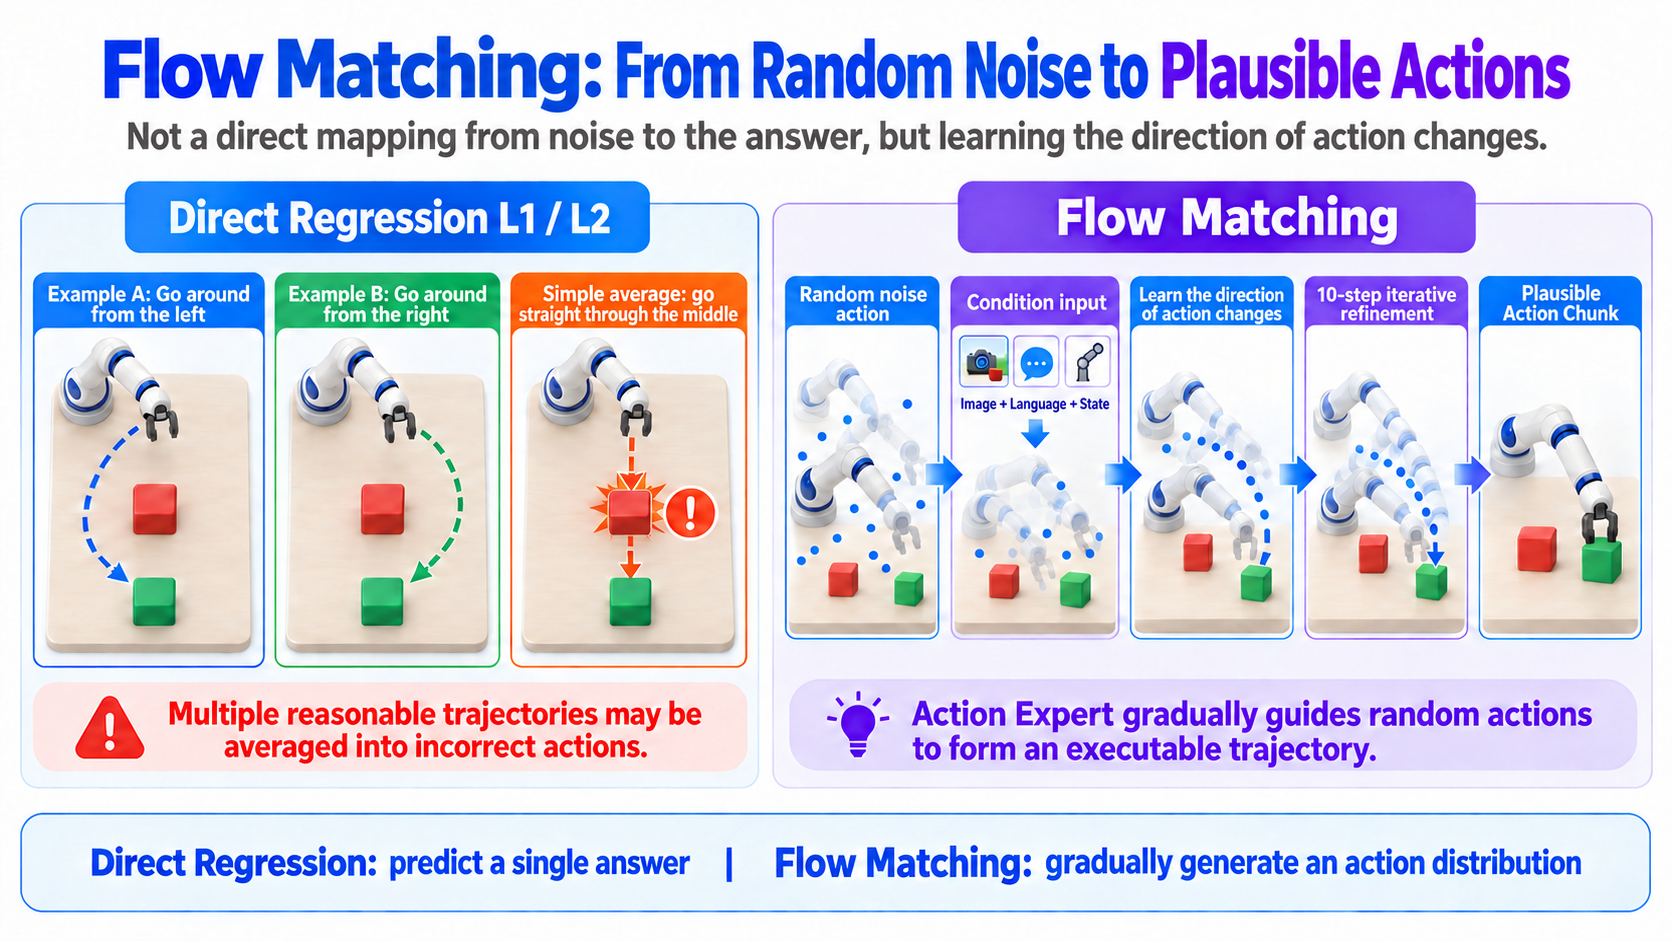
Flow Matching y regresión directa
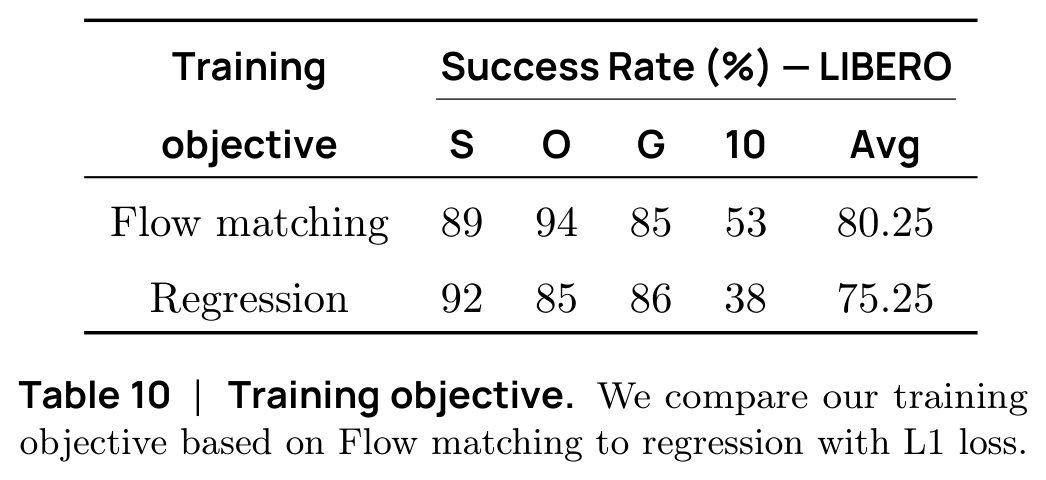
-
La principal ventaja de flow matching aparece en tareas de horizonte largo, donde el éxito aumenta de 38 a 53.
-
Esto respalda la opinión de los autores de que los objetivos generativos modelan mejor distribuciones de acciones complejas y multimodales.
¿Dónde debería entrar el estado?
Los autores comparan:
-
Sufijo: alimentar el estado directamente al experto en acciones.
-
Prefijo: alimentar el estado primero al VLM.
Con cross-attention, el prefijo alcanza 80.3 de éxito promedio frente a 73.3 para el sufijo. Por lo tanto, el modelo final suministra el estado al VLM junto con imágenes y lenguaje.
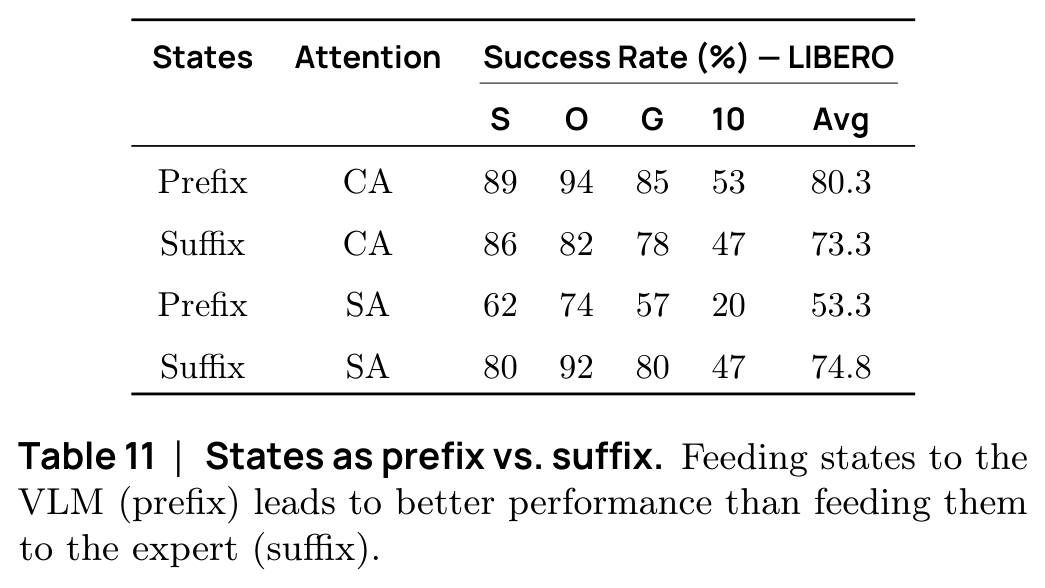
La variante de self-attention pura no muestra la misma tendencia. La conclusión respaldada es que el estado como prefijo funciona mejor en el diseño condicionado por VLM elegido, en lugar de ser universalmente superior para toda arquitectura de atención.
¿Qué tan largo debería ser un chunk de acción?
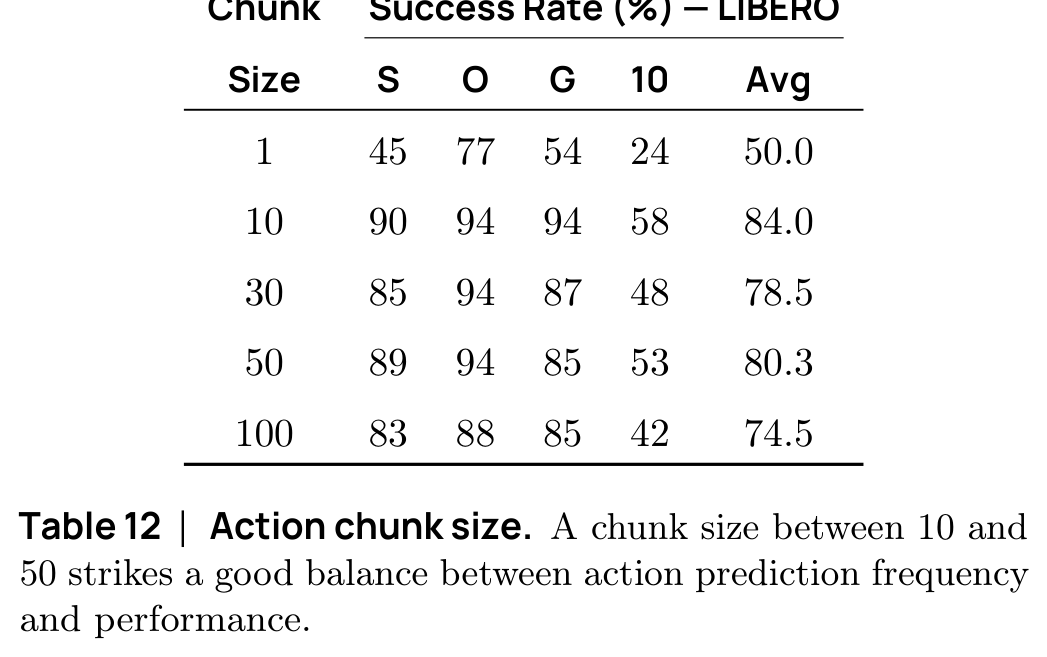
-
Los chunks muy cortos infrautilizan la estructura de secuencia. Los chunks muy largos son más difíciles de predecir y pueden fomentar una ejecución en lazo abierto excesivamente larga.
-
El artículo identifica 10–50 como un equilibrio útil, en lugar de tratar lo más largo como siempre mejor.
Predecir 50 pasos no significa ejecutar 50
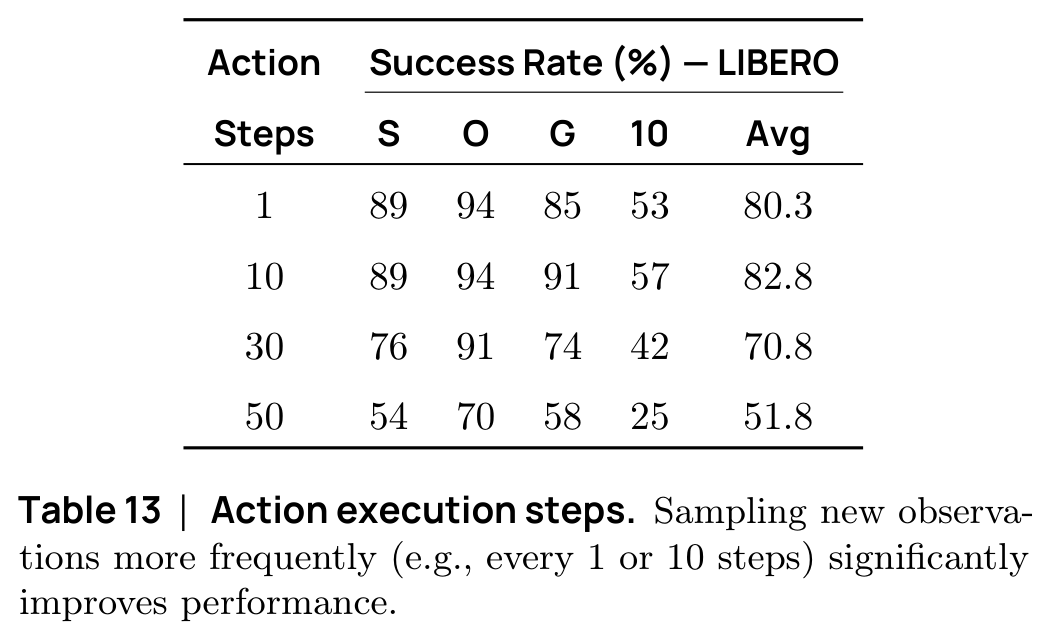
-
El modelo puede predecir 50 pasos pero ejecutar solo 10 antes de observar de nuevo, combinando coherencia de secuencia con retroalimentación del entorno.
-
Ejecutar los 50 antes de observar produce solo 51.8 de éxito promedio.
-
Esto motiva la inferencia asíncrona: observar a menudo sin hacer que el robot espere al modelo.
Limitaciones
-
Diversidad de embodiment limitada. El preentrenamiento comunitario es principalmente SO100. La transferencia a SO101 se demuestra mediante ajuste fino, pero esto no es un preentrenamiento amplio entre distintos embodiments.
-
Escala de datos limitada. SmolVLA usa alrededor de 23,000 trayectorias, mientras que modelos como OpenVLA pueden usar cerca de un millón. La eficiencia a escalas mayores de datos comunitarios aún debe probarse.
-
La idoneidad del backbone sigue abierta. Gran parte del preentrenamiento de SmolVLM-2 se refiere a documentos y OCR. Si es ideal para relaciones espaciales, affordances e interacción física sigue sin resolverse.
-
Las tareas reales siguen siendo relativamente cortas. Recoger, colocar, apilar y clasificar no cubren comportamientos verdaderamente de horizonte largo, que pueden requerir políticas jerárquicas o planificación multinivel.
-
Principalmente aprendizaje por imitación. El rendimiento sigue limitado por la cobertura de las demostraciones. Los autores sugieren combinar aprendizaje por refuerzo para mejorar tareas de horizonte largo y manipulación diestra.
Resumen