VLA-JEPA: Aprendizaje de acciones latentes a partir de vídeo
VLA-JEPA: Mejora del modelo Visión-Lenguaje-Acción con un modelo latente del mundo
- Preentrenamiento con vídeos humanos
- Modelo latente del mundo
- Head de acción con flow matching
- Robustez frente a perturbaciones
Los vídeos humanos muestran cómo colocar una manzana en un cuenco, pero no contienen comandos de control para un robot concreto. VLA-JEPA primero aprende cómo cambian los objetos a partir del vídeo y luego aprende cómo actuar a partir de demostraciones de robots. Un modelo del mundo conecta ambas señales de aprendizaje.
Requisitos previos
Hay tres magnitudes importantes. Considera colocar una manzana en un cuenco:
- Características del estado del mundo describen la escena y el estado de los objetos, tal como las extrae un codificador de vídeo.
- Acciones latentes son características ocultas que ayudan a predecir cambios de estado, como que la manzana pase de la mesa a estar sobre el cuenco. No tienen unidades físicas predefinidas.
- Acciones del robot contienen valores enviados al controlador, como traslación y rotación del efector final, y comandos de la pinza.
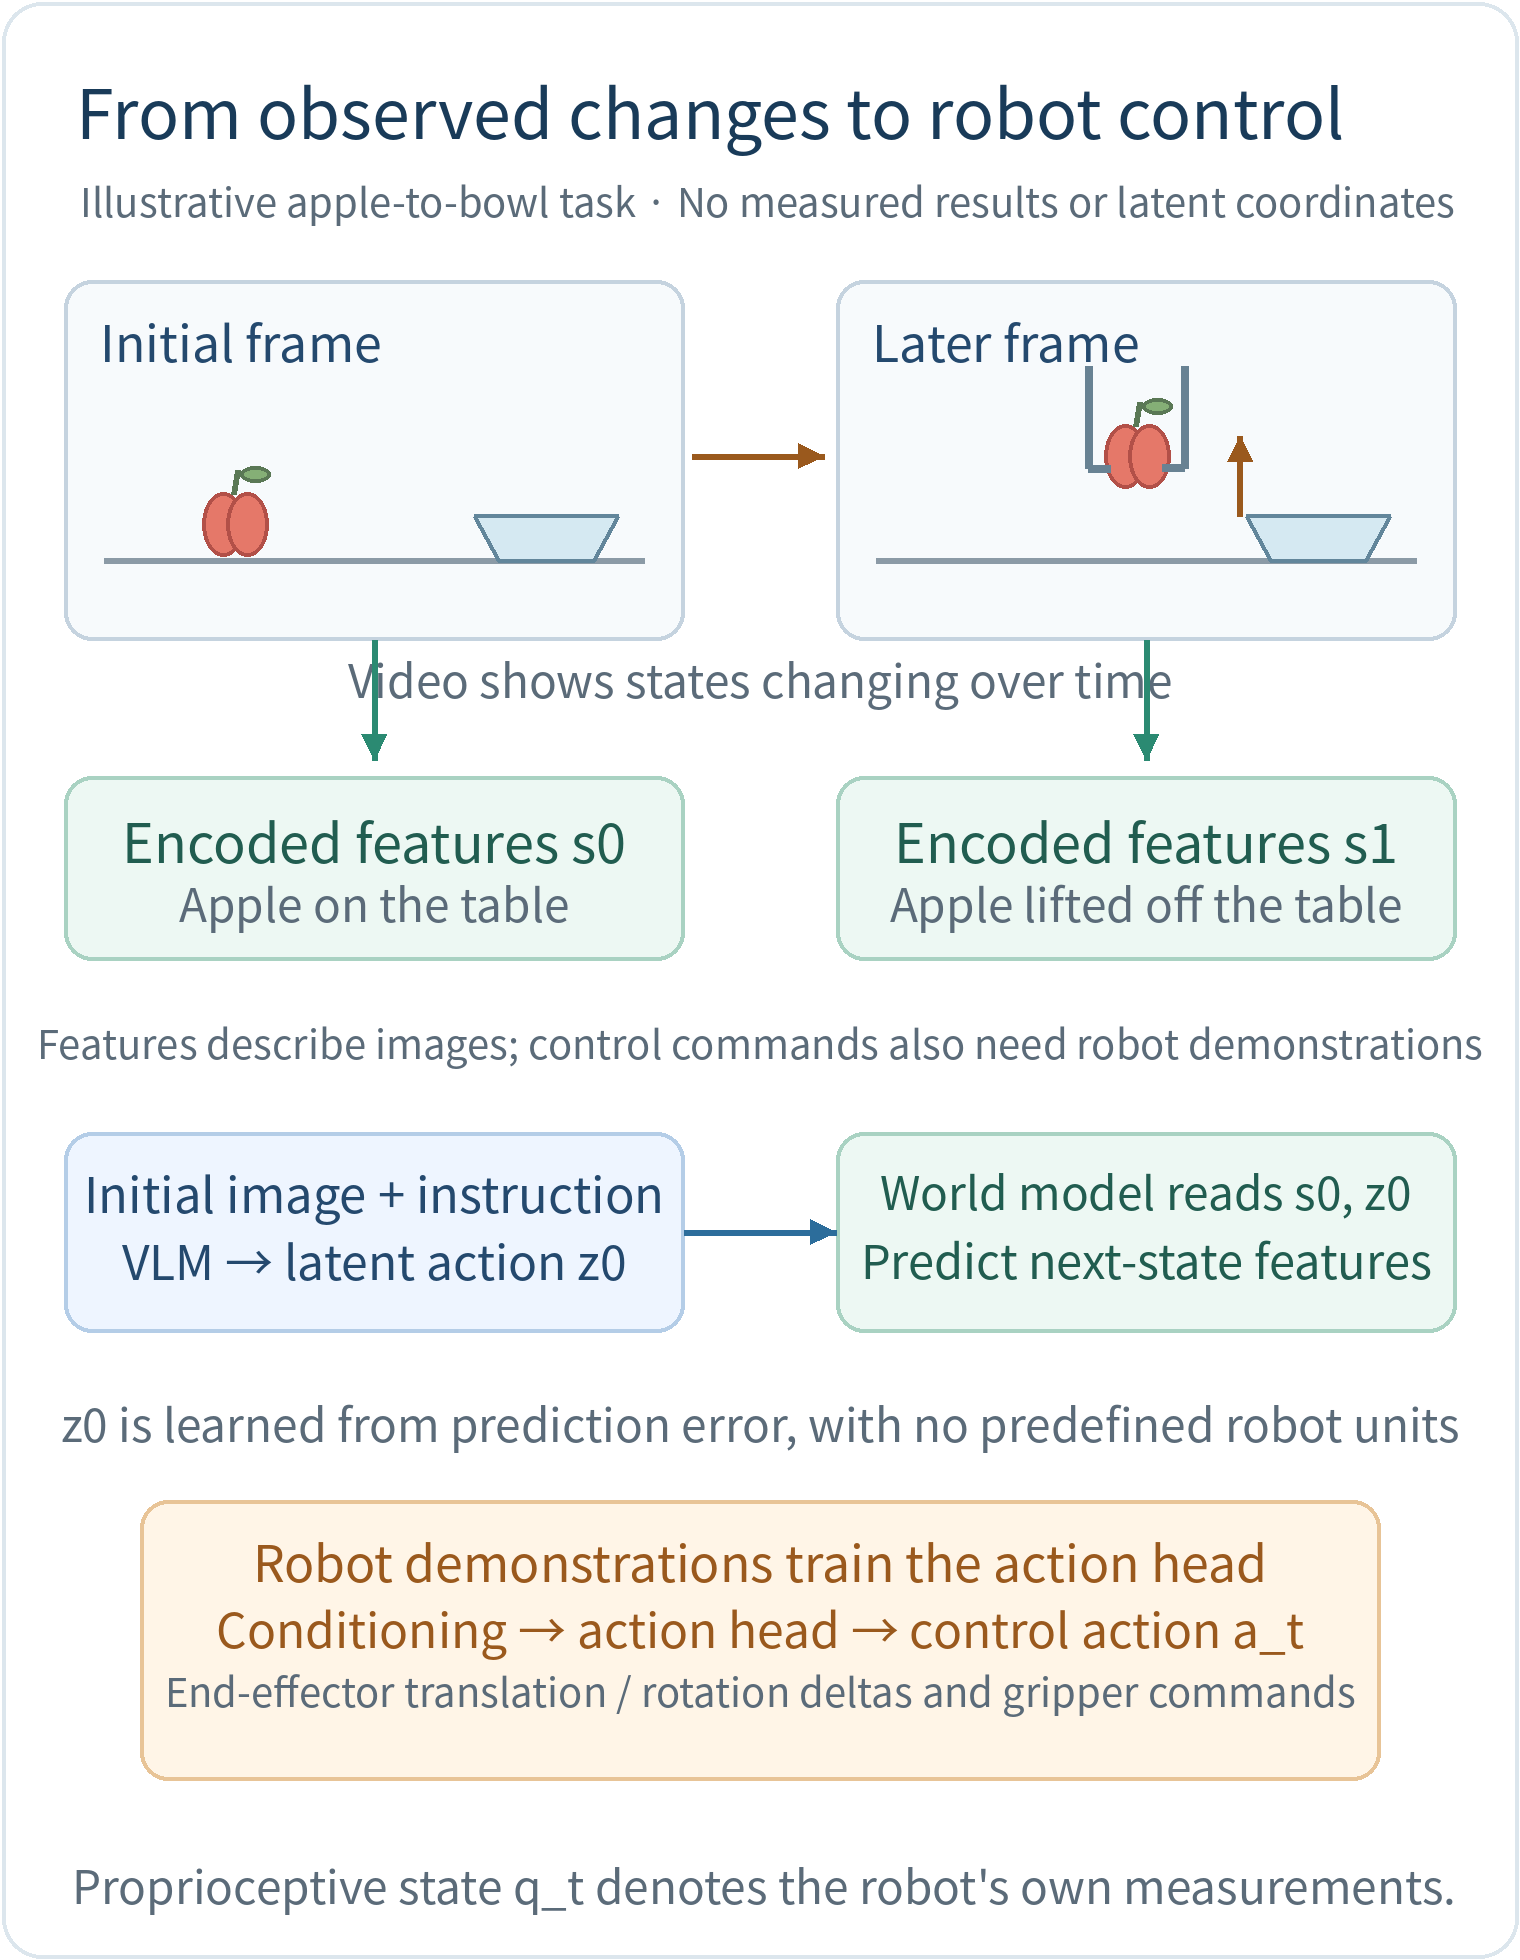
JEPA (Joint-Embedding Predictive Architecture) predice características futuras. Compara características predichas con características codificadas a partir de imágenes futuras reales, sin reconstruir cada píxel. VLA-JEPA usa este objetivo para enseñar a un modelo de visión-lenguaje (VLM) cambios relacionados con la manipulación.
Resumen
Paráfrasis: El vídeo de Internet puede ayudar a abordar la escasez de datos de robots para los modelos visión-lenguaje-acción (VLA). Sin embargo, los métodos existentes de acciones latentes pueden aprender cambios de apariencia, movimiento irrelevante o atajos a partir de imágenes futuras. VLA-JEPA genera acciones latentes a partir de observaciones y lenguaje actuales, y luego predice características de estado futuras. Las imágenes futuras proporcionan supervisión sin entrar directamente en el VLM que genera las acciones latentes. El preentrenamiento conjunto con vídeo y datos de robots, seguido de adaptación en tareas downstream, produce resultados competitivos en simulación y hardware.
Nota de lectura: La ausencia de etiquetas de acción se aplica a los vídeos humanos. Los vídeos enseñan cambios; las demostraciones de robots siguen enseñando valores de control. Las ablaciones muestran beneficios más claros para la robustez frente a perturbaciones que una mejora consistente en todas las tareas.
Introducción y trabajos relacionados
Empezar por el problema de los datos. Las demostraciones de robots son caras, mientras que los vídeos humanos son abundantes. Por tanto, los autores buscan transferir la experiencia de vídeo al aprendizaje de robots (Sección 1 del artículo). Más vídeo por sí solo no basta: la predicción de píxeles puede centrarse en textura, iluminación y movimiento de cámara en lugar de en cambios útiles para el control.
Luego examinar la supervisión. Si un extractor de acciones latentes ve imágenes actuales y futuras, puede codificar la respuesta futura. Extraer acciones latentes antes de alinear por separado una política también añade etapas de entrenamiento. Los autores cambian tanto el objetivo de predicción como la fuente de información: predecir características futuras y generar acciones latentes solo a partir de observaciones iniciales.
La Sección 2 analiza dos grupos principales: los VLA como la serie RT que dependen de demostraciones etiquetadas con acciones, y métodos como LAPA, UniVLA y MotoGPT que extraen acciones latentes del vídeo antes de conectarlas al control del robot. VLA-JEPA, en cambio, deja que el error de predicción de estado entrene directamente el VLM que genera las acciones latentes, mientras que la supervisión de acciones de robot entrena la misma red base. Esto forma un proceso de preentrenamiento unificado, seguido aún de fine-tuning en tareas downstream.
Cómo aprende VLA-JEPA acciones a partir de vídeo
La red completa
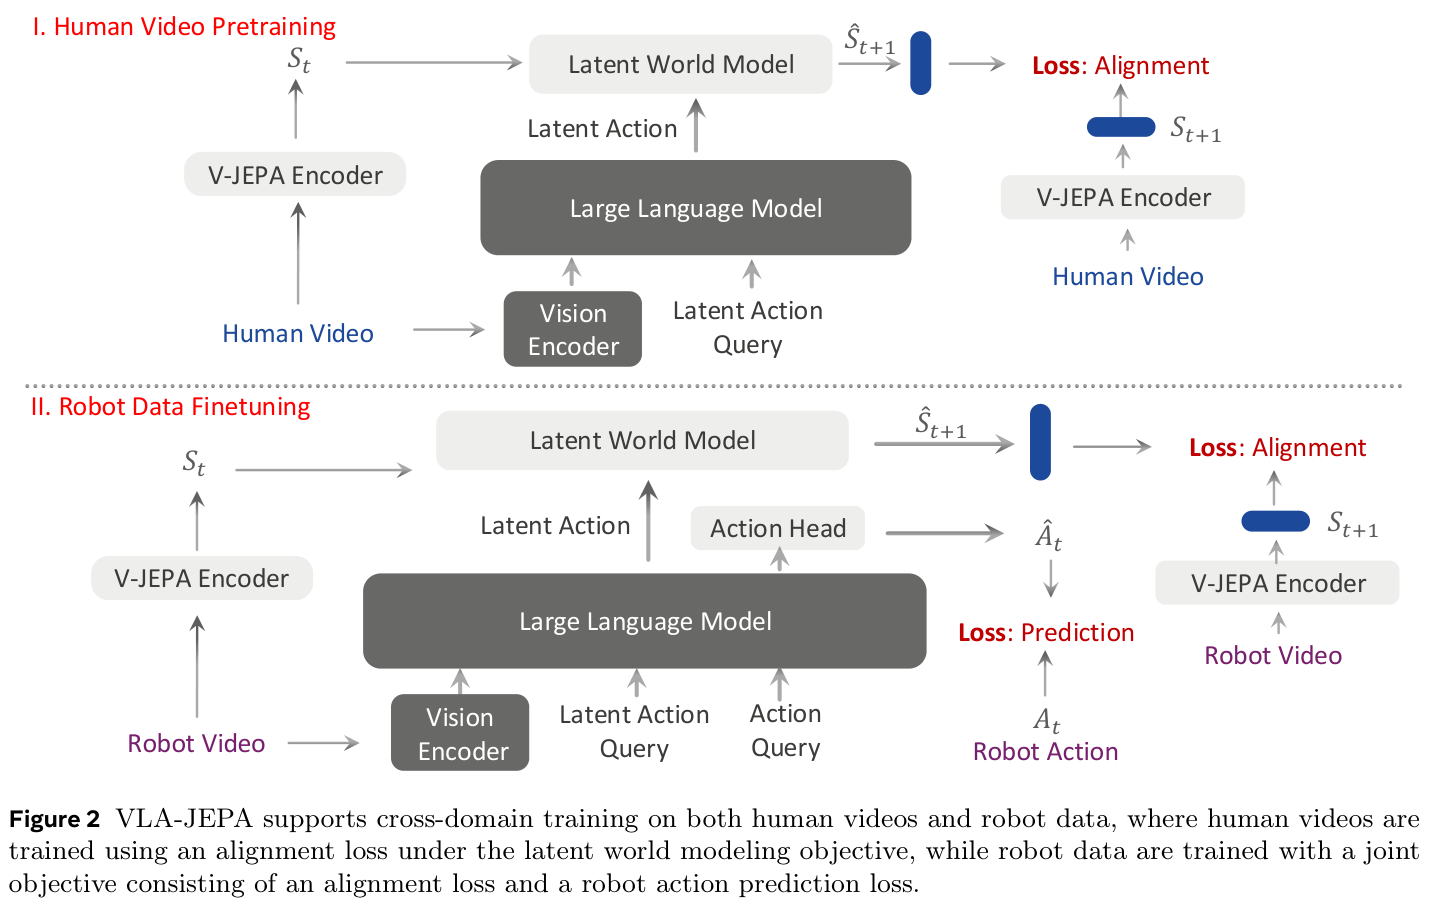
Cada uno de los cuatro módulos tiene un papel: Qwen3-VL-2B lee imágenes e instrucciones actuales para producir acciones latentes y condicionamiento de acción; V-JEPA2 congelado codifica el vídeo en características de estado; el modelo del mundo predice estados posteriores; y el head de acción genera secuencias de control del robot.
La ruta superior entrena la predicción de estado con vídeo humano. La ruta inferior entrena la predicción de estado y la generación de acciones con datos de robots. Ambas comparten el VLM, lo que permite que la experiencia de vídeo influya en el control posterior.
Entrenamiento de acciones latentes mediante predicción de estado
Un codificador fijo extrae características de cada vista y las concatena a lo largo de la dimensión de características (Ecuación (1) del artículo):
es la imagen de la vista en la posición temporal . En la interfaz de la Tabla 5, dos arrays de características de se convierten en : el número de tokens visuales permanece igual y cada token combina dos vistas.
Consultas de acciones latentes aprendibles siguen a las imágenes e instrucciones iniciales. Sus características VLM se convierten en . El modelo del mundo predice el siguiente estado a partir de los estados históricos y las acciones latentes. Las ecuaciones (2)–(3) pueden abreviarse como:
es la instrucción, y es un token de consulta aprendible. Todas las acciones latentes usan las mismas observaciones iniciales en lugar de sus imágenes futuras correspondientes. El entrenamiento usa teacher forcing: predecir puede usar el historial real , pero predecir no puede usar como entrada.
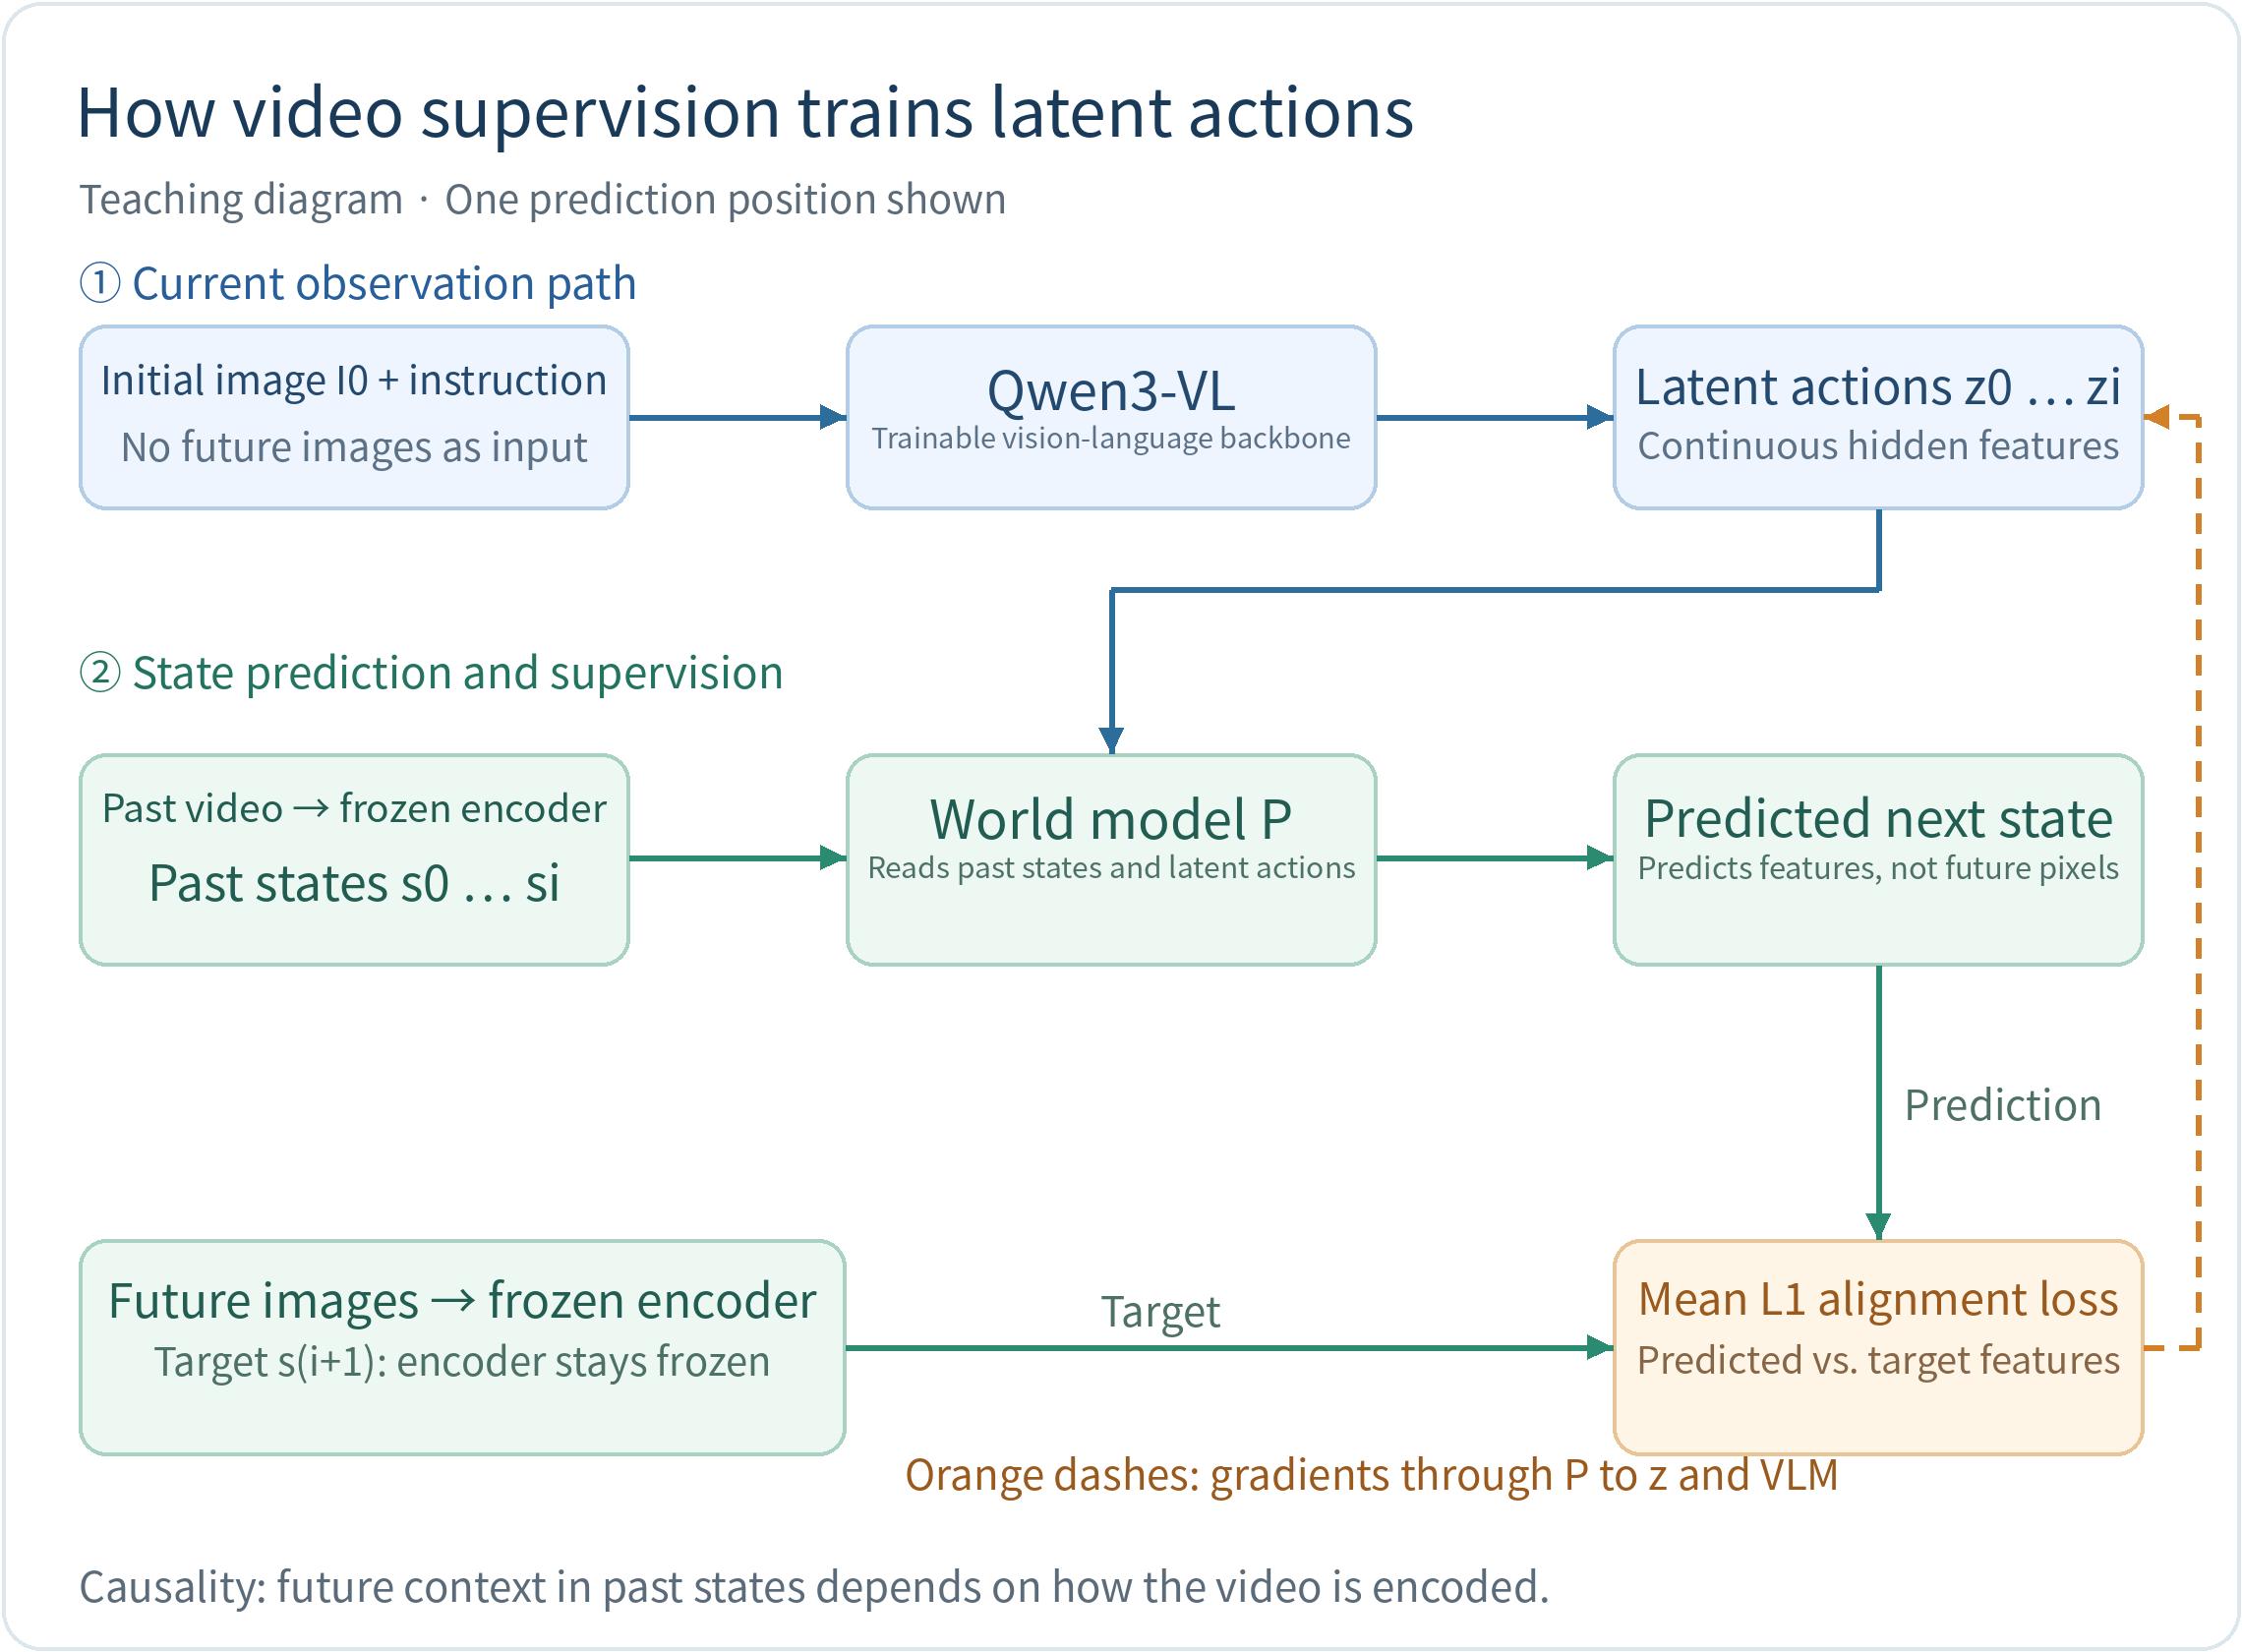
La conexión crucial es la ruta del gradiente. Las imágenes futuras pasan por el codificador fijo para formar los objetivos. El error de predicción se propaga a través del modelo del mundo hasta el VLM, animando a que las acciones latentes transporten información útil para predecir cambios. Para predecir que una manzana abandona la mesa, por ejemplo, la acción latente debe ayudar a explicar esa transición sin una etiqueta semántica manual para cada característica oculta.
La implementación de los autores usa error L1 medio. Lo siguiente desarrolla esa pérdida implementada; la Ecuación (5) en sí no especifica la norma del error:
recoge las características objetivo, cuenta los elementos, y denota stop-gradient; el codificador permanece fijo. En un ejemplo didáctico, el objetivo y la predicción dan un error medio de .
Esto restringe la entrada de imágenes futuras al VLM. La máscara temporal del predictor por sí sola no garantiza causalidad estricta de las características históricas del codificador de vídeo.
De acciones latentes a acciones del robot
Las características de estado aún necesitan una conexión con el control. Un segundo conjunto de consultas de acción sigue a las consultas de acciones latentes, leyendo imágenes, lenguaje y acciones latentes precedentes para formar el condicionamiento (Ecuación (6)). Un head de acción DiT (Diffusion Transformer) genera entonces una secuencia de acción continua.
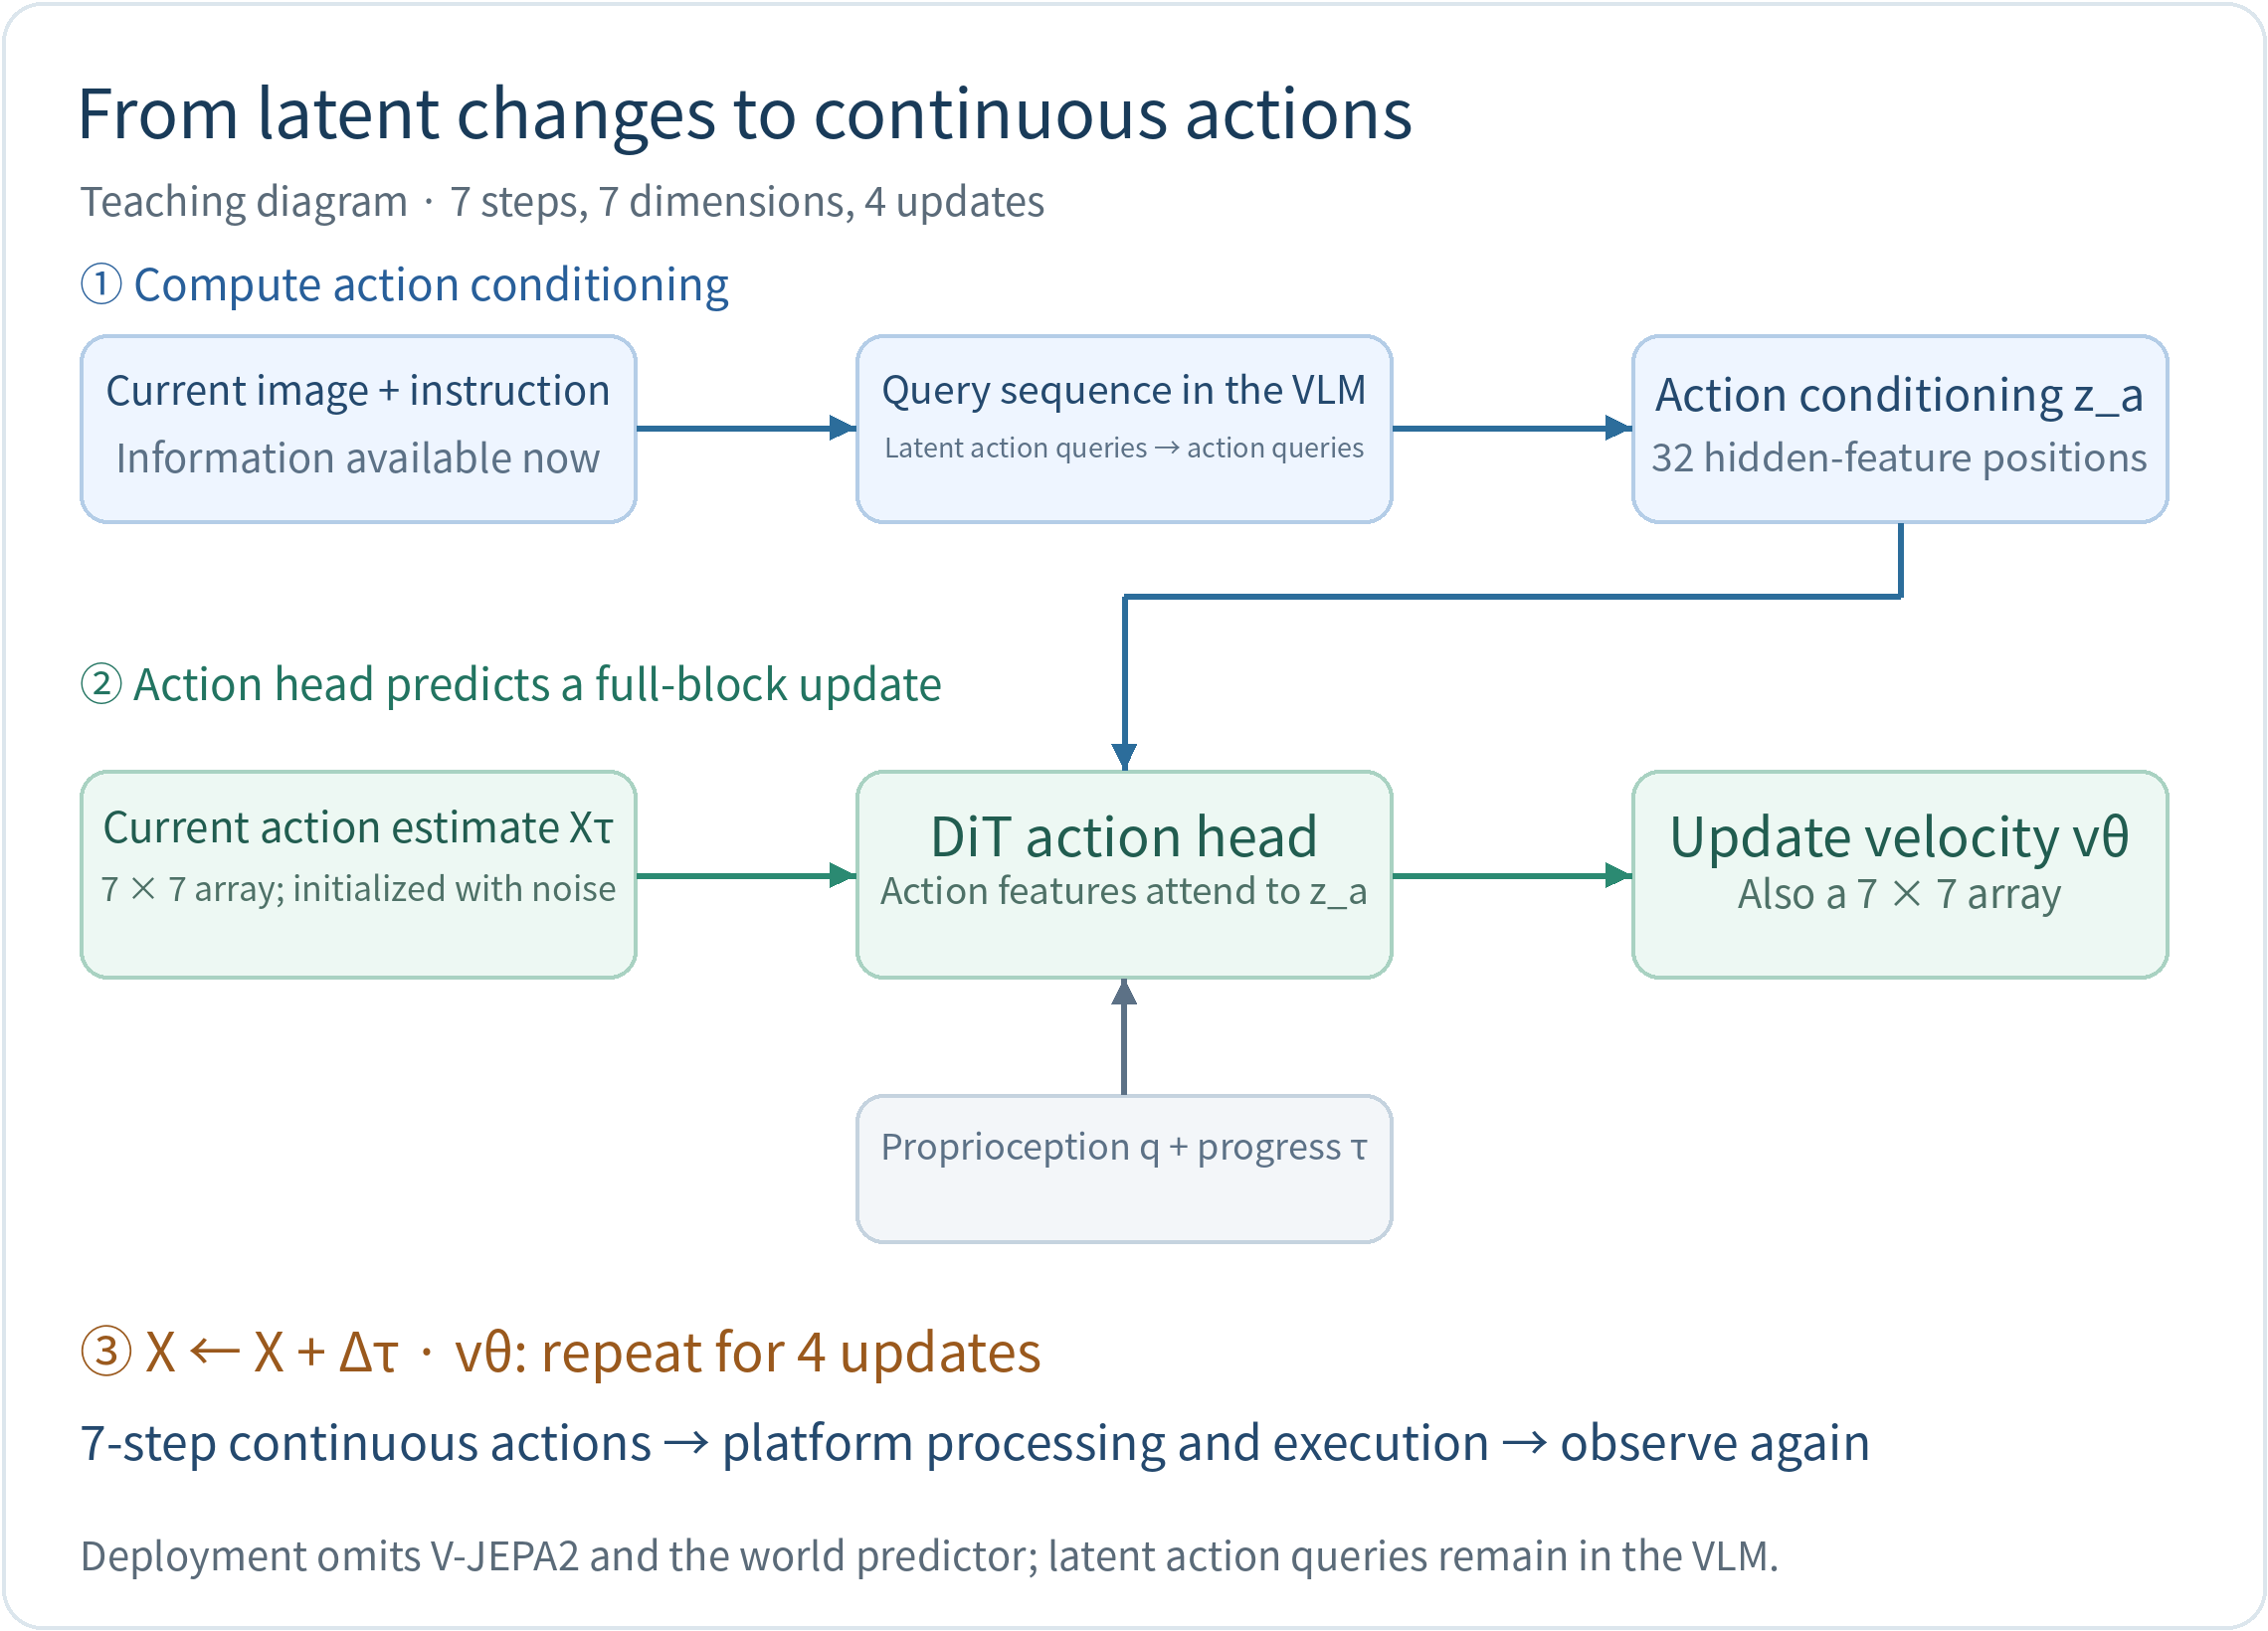
El head usa conditional flow matching. Mezcla un bloque de acción demostrada con ruido gaussiano de la misma forma, y luego aprende la dirección desde el ruido hacia las acciones. Las ecuaciones (7)–(8) pueden escribirse como:
es el progreso de la generación, distinto del tiempo del robot. devuelve actualizaciones con la forma del bloque de acción. Para un elemento, , y dan un valor intermedio de 0.2 y una dirección objetivo de 0.8. Predecir 0.5 da un error cuadrático de 0.09.
La inferencia comienza desde ruido nuevo y sigue las direcciones predichas. La implementación fijada usa actualizaciones de Euler:
Cuatro actualizaciones generan un fragmento de acción de : siete pasos de control con siete valores cada uno. Las cuatro actualizaciones ocurren dentro de la cabeza de acción, en lugar de representar cuatro pasos del robot. La implementación también proporciona el estado propioceptivo y el progreso de la generación a la cabeza, que lee mediante cross-attention. El artículo usa muestreo temporal uniforme, mientras que la implementación fijada usa muestreo Beta, una diferencia en la configuración de entrenamiento.
Entrenamiento e inferencia
El preentrenamiento conjunto utiliza aproximadamente 220.000 vídeos humanos de Something-Something-v2 y 76.000 trayectorias de robot DROID. Los vídeos humanos proporcionan imágenes y lenguaje para la predicción de estado. Los datos de robot además suministran etiquetas de acción para la optimización conjunta (Ecuación (9)):
pondera las dos pérdidas. Tanto la implementación del autor como la versión fijada de LeRobot usan 0.1. Tras 50.000 pasos de preentrenamiento, ramas separadas continúan desde ese checkpoint para entrenamiento en simulación (30.000 pasos) y ajuste fino en hardware (20.000 pasos).
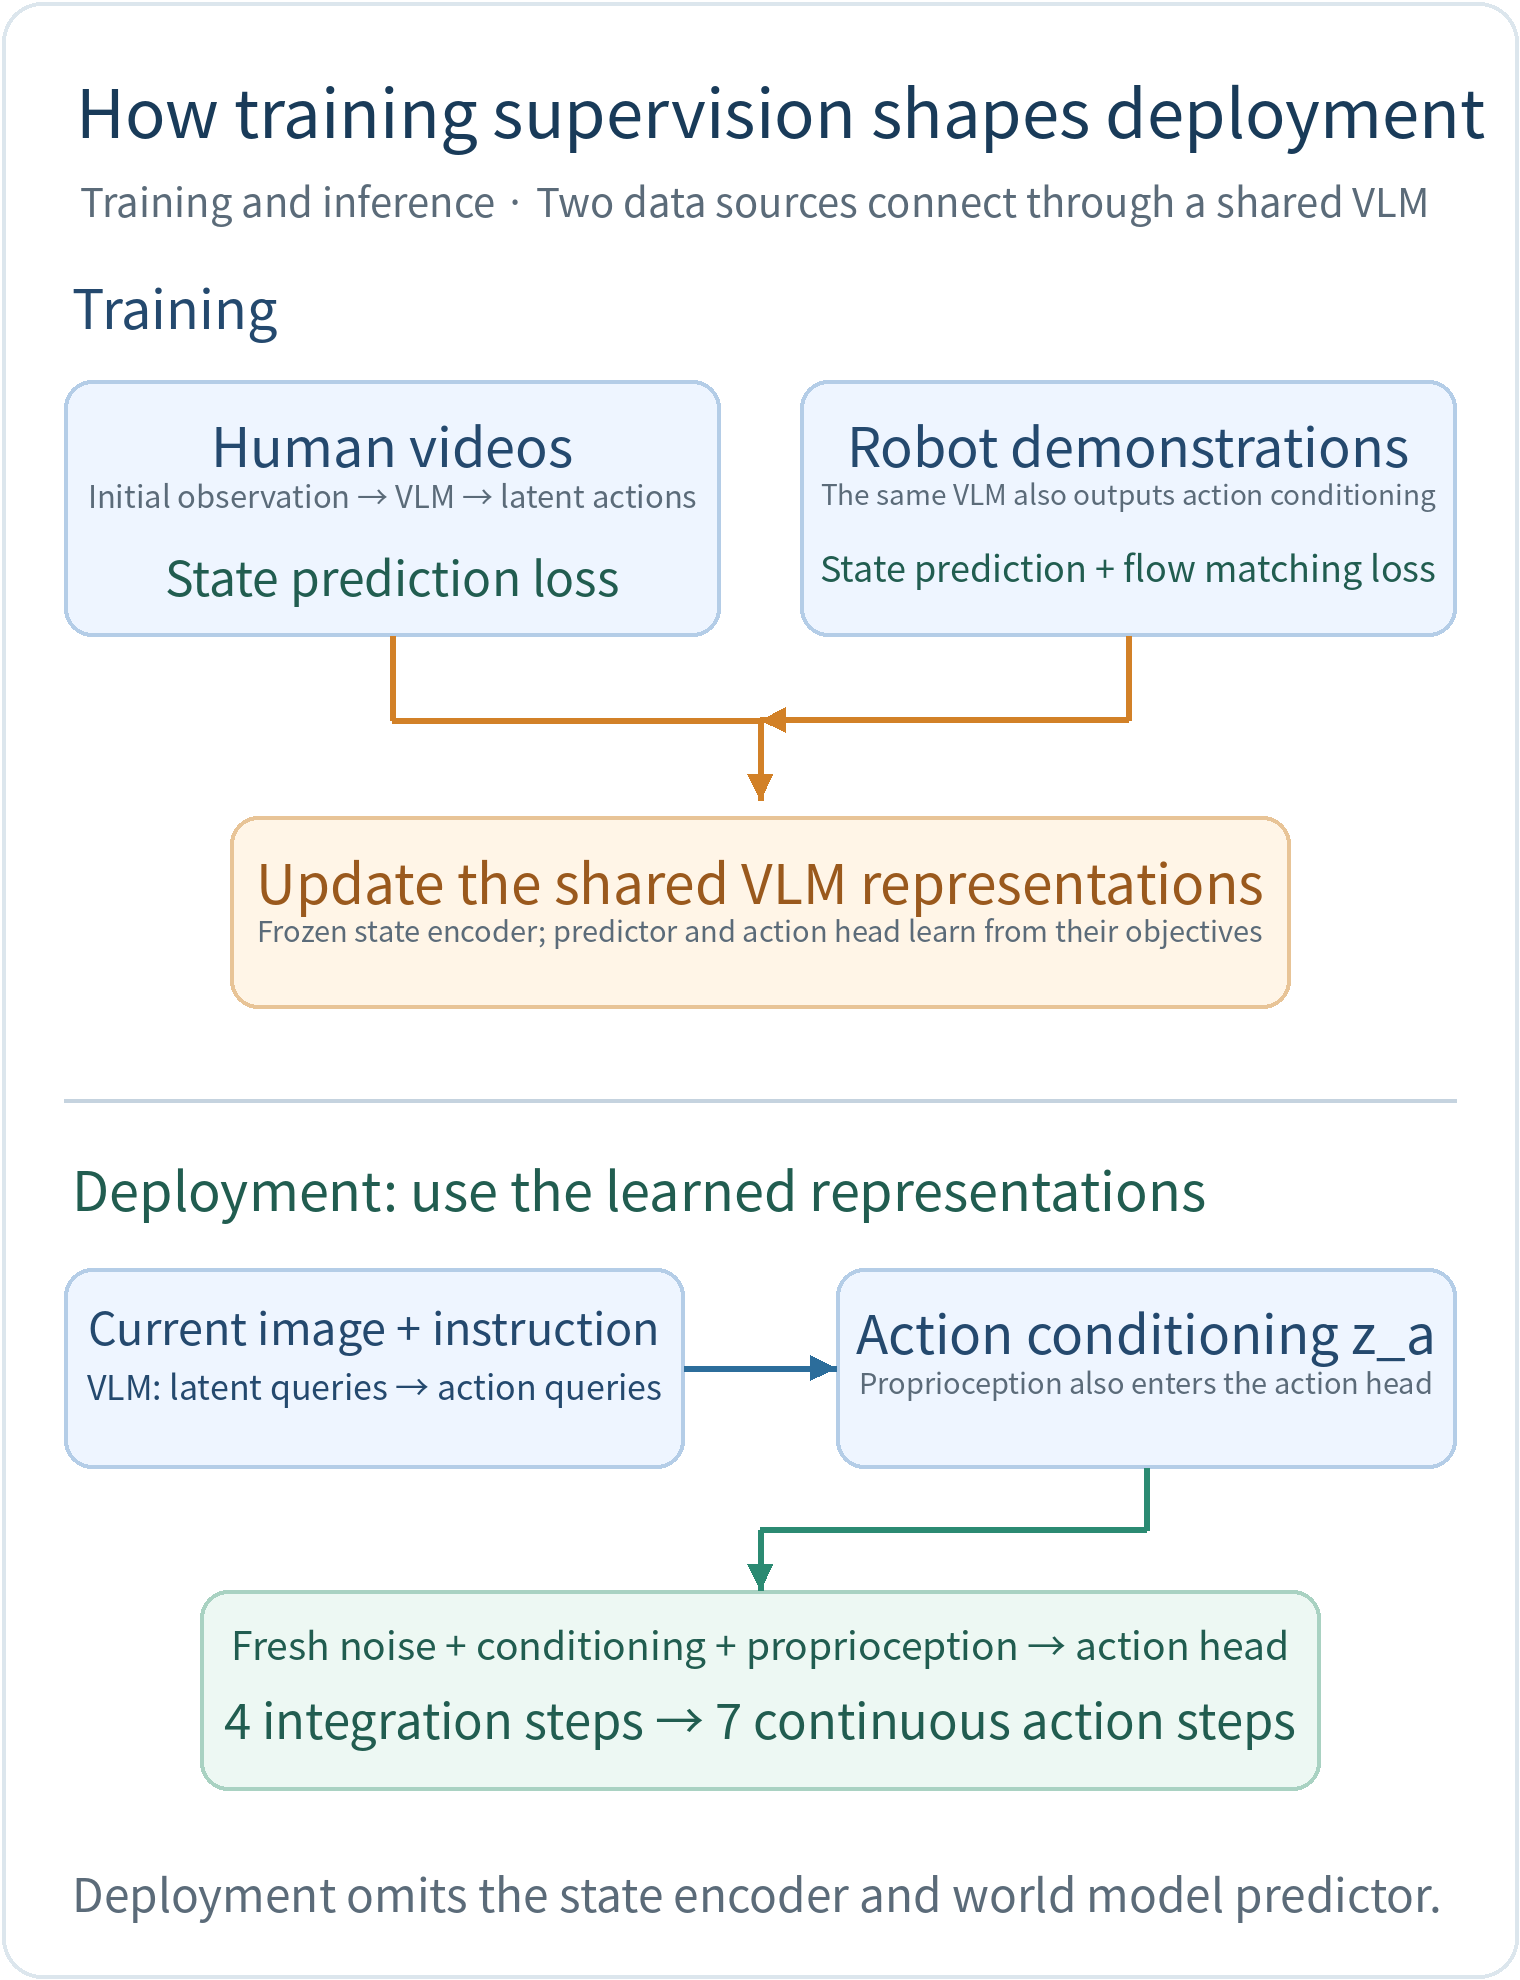
Durante el entrenamiento, el codificador de vídeo proporciona historial y objetivos; el error del modelo del mundo entrena el VLM, y las demostraciones de robot añaden supervisión de control. Durante el despliegue, bastan las imágenes actuales, las instrucciones y las entradas de estado requeridas por la cabeza de acción. Se mantienen el cálculo de acciones latentes y la cabeza de acción; se omiten el codificador de vídeo y el predictor del modelo del mundo. El controlador ejecuta acciones y luego nuevas observaciones permiten otra predicción.
Así, el modelo del mundo actúa principalmente como un maestro en tiempo de entrenamiento. Fomenta representaciones que expliquen los cambios, sin buscar vídeos futuros para elegir acciones durante el despliegue.
Resultados experimentales
Tareas estándar y perturbaciones
El ajuste fino en LIBERO utiliza demostraciones de expertos. Cuatro conjuntos contienen cada uno diez tareas, evaluadas 50 veces por tarea: 2.000 ensayos en total. La Tabla 1 compara métodos completos e incluye la ablación de vídeo humano en sus dos últimas filas:
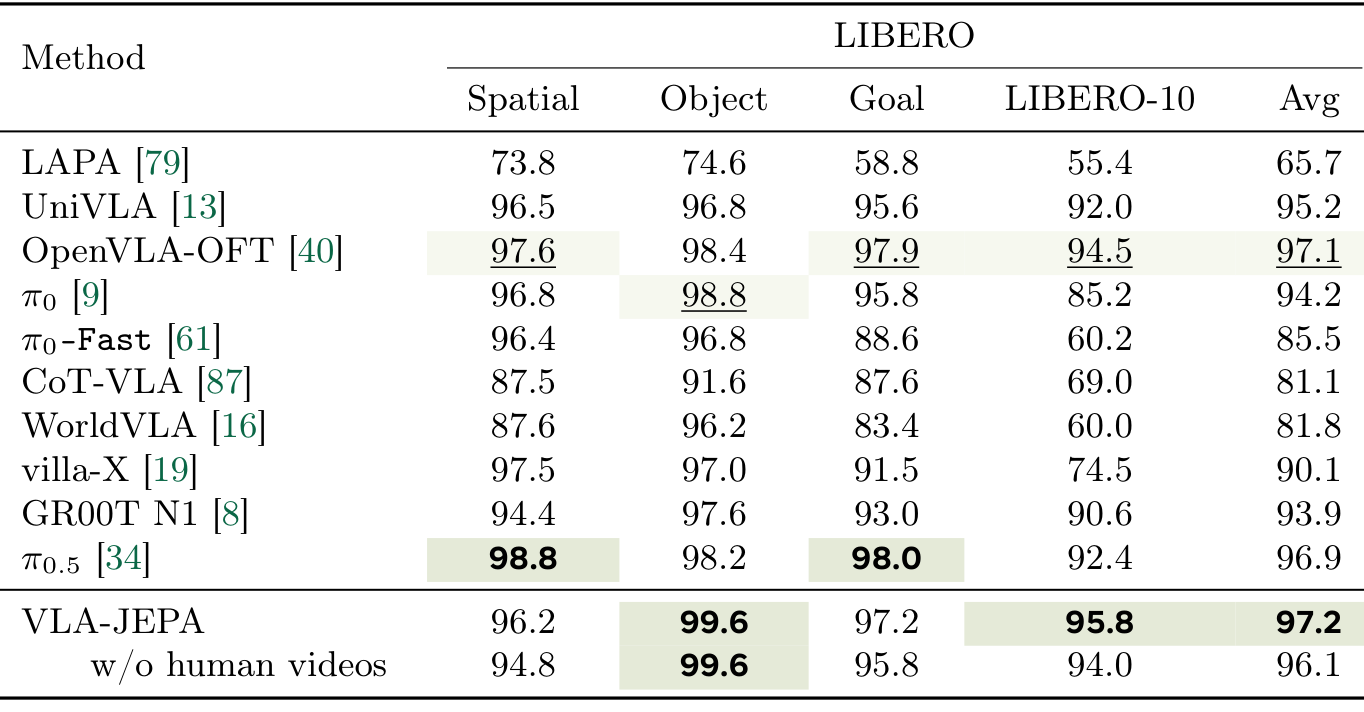
El éxito medio es 97,2%, frente a 96,1% sin vídeo humano. El modelo completo lidera los métodos listados, pero está cerca del 97,1% de OpenVLA-OFT. La tabla principal carece de barras de error entre ejecuciones de entrenamiento independientes, por lo que no deben exagerarse diferencias pequeñas.
LIBERO-Plus añade siete tipos de perturbación manteniendo los datos de entrenamiento originales de LIBERO:
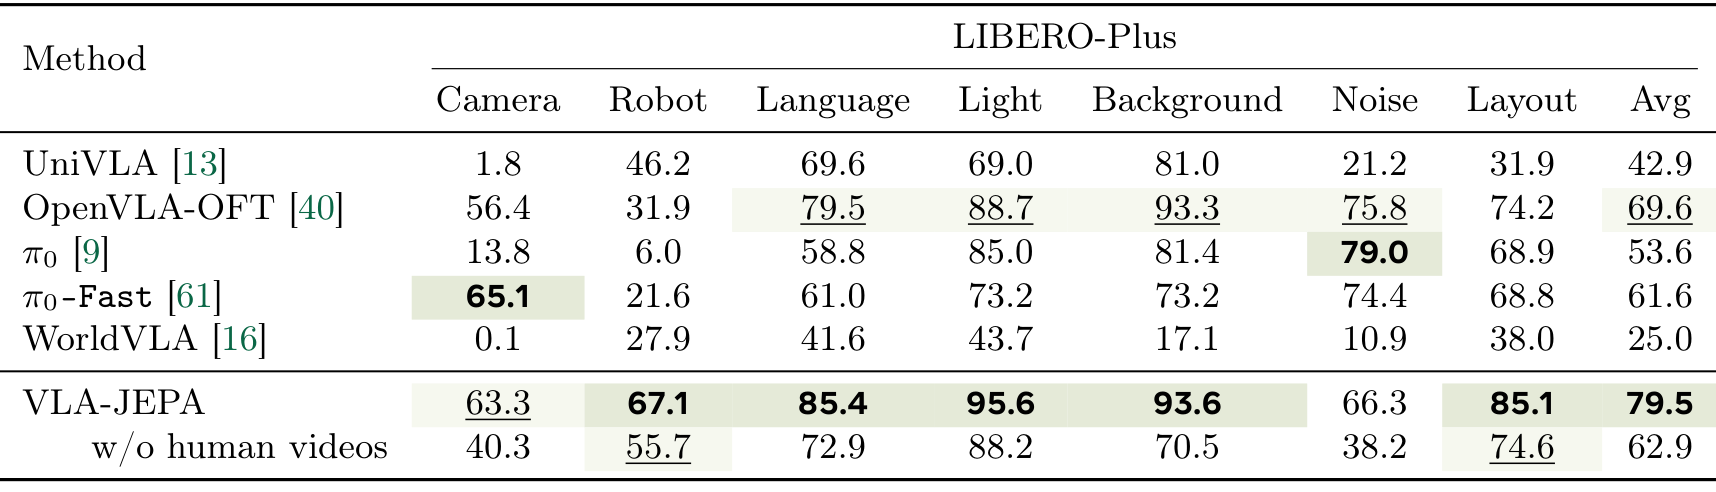
El vídeo humano eleva el éxito medio de 62,9% a 79,5%, mejorando las siete categorías. Esta ganancia de 16,6 puntos porcentuales es mayor que la ganancia de 1,1 puntos en tareas estándar, proporcionando evidencia más clara de beneficios bajo perturbaciones.
Transferencia y rendimiento en hardware
SimplerEnv evalúa la transferencia de datos de entrenamiento de robot real a simulación:
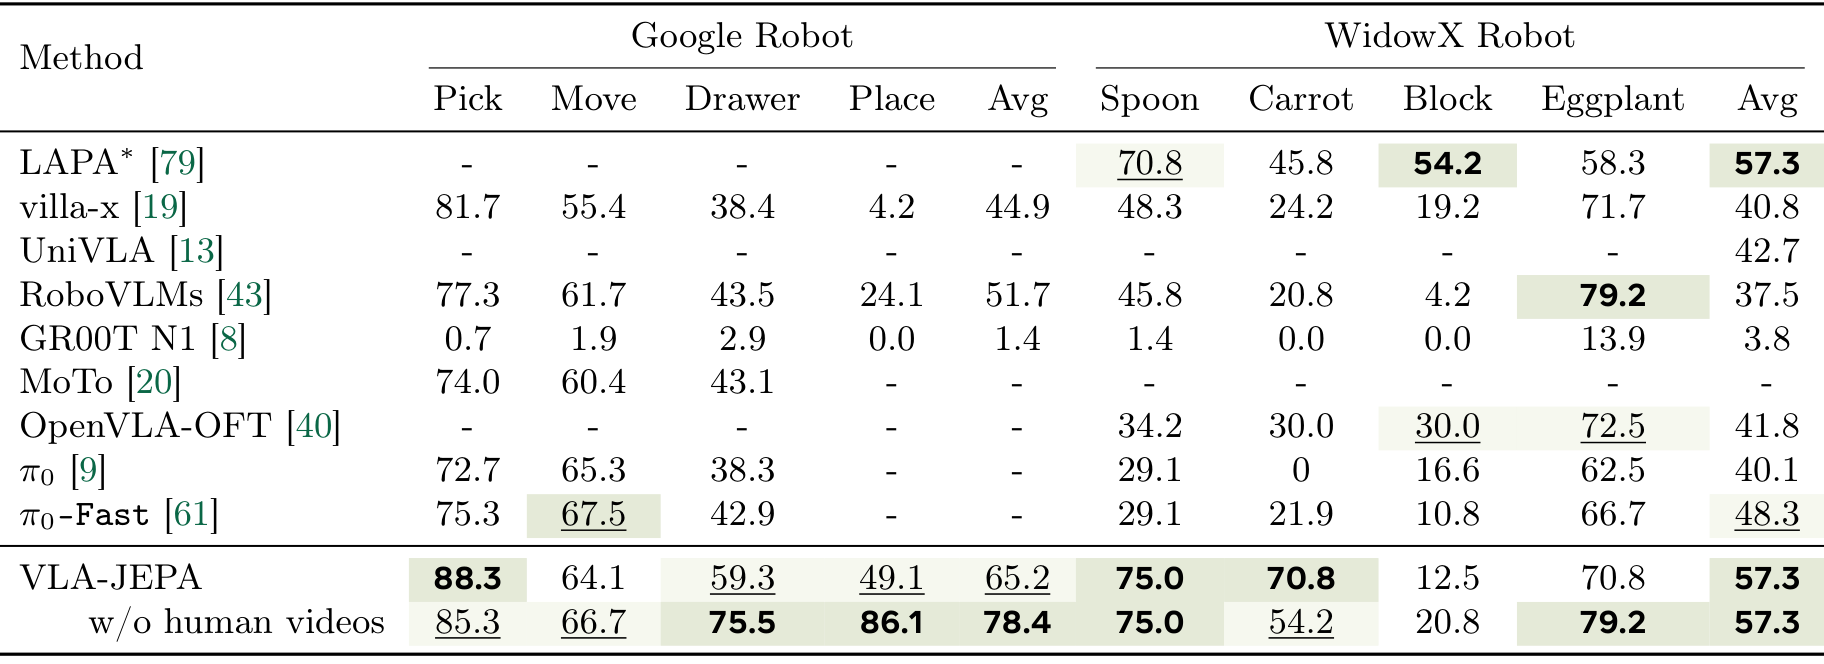
Los beneficios no son universales. Añadir vídeo humano reduce el éxito medio de Google Robot de 78,4% a 65,2%; WidowX se mantiene en 57,3%. La experiencia en vídeo no sustituye las demostraciones de robot para tareas de control específicas. Algunas medias de referencia y clasificaciones textuales son inconsistentes, por lo que la conclusión aquí se basa en la ablación del modelo.
Las pruebas en hardware usan un Franka Research 3, una pinza Robotiq y tres cámaras D435, con diez ensayos por tarea. La Figura 4 presenta los resultados:
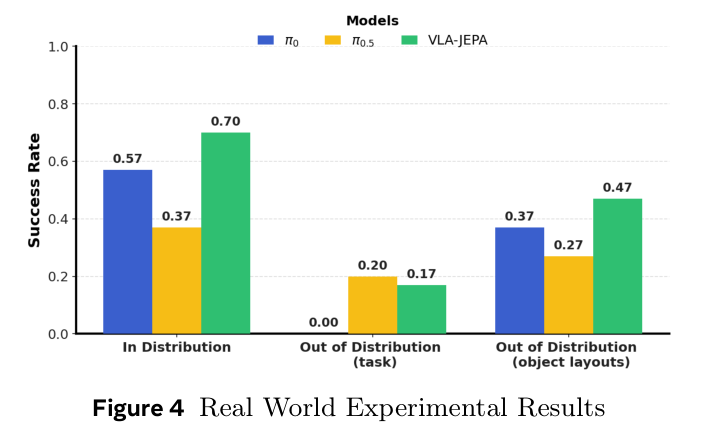
VLA-JEPA alcanza 0,70 en condiciones dentro de la distribución y 0,47 tras cambios de disposición, superando a las dos líneas base. Su puntuación en tareas no vistas es 0,17, por debajo de 0,20 de π0.5. Ninguno de los tres modelos completa la tarea de colocar uvas en el nivel superior de una estantería no vista, y VLA-JEPA aún puede seleccionar el objeto equivocado.
Estos experimentos respaldan la competitividad del método general y la contribución del vídeo humano a la robustez frente a perturbaciones. No aíslan por separado los efectos del objetivo JEPA, el acceso a la información y las etapas de entrenamiento.
Conclusión
VLA-JEPA convierte los cambios de estado en vídeo en supervisión para las representaciones del robot. Las acciones latentes explican los cambios, la cabeza de acción produce valores de control y las demostraciones de robot conectan ambos. Este diseño de supervisión mejora el rendimiento bajo las perturbaciones evaluadas, mientras que la ejecución fiable y la generalización a tareas no vistas siguen sin resolverse.
Referencias
- Artículo VLA-JEPA v2 y PDF del artículo. Introducción y trabajos relacionados: Secciones 1–2; método: Sección 3; experimentos: Sección 4; configuración y protocolo de hardware: Apéndices A–B.
- Página del proyecto del autor y repositorio del modelo.
- Código del autor en el commit ec90777: modelo y pérdidas, configuración de preentrenamiento.
- LeRobot en el commit f5c9bc0: modelo, cabeza de acción y configuración. Las diferencias de implementación complementan los detalles de flujo de datos y entrenamiento; no son fuentes para los resultados del artículo.