WALL-OSS: Cómo la comprensión visión-lenguaje se conecta con las acciones encarnadas
Impulsando los VLM hacia el espacio encarnado
- Semántica de acciones
- Control continuo
- Uni-CoT
- VQA encarnado
Requisitos previos: Conectar objetivos con ejecución
De VLM a VLA
Explicación: Un VLM interpreta imágenes y texto; un VLA además genera controles numéricos. Este artículo aprende el mapeo a partir de demostraciones, VQA visual y anotaciones de proceso en lugar de enviar una respuesta verbal directamente a los motores.
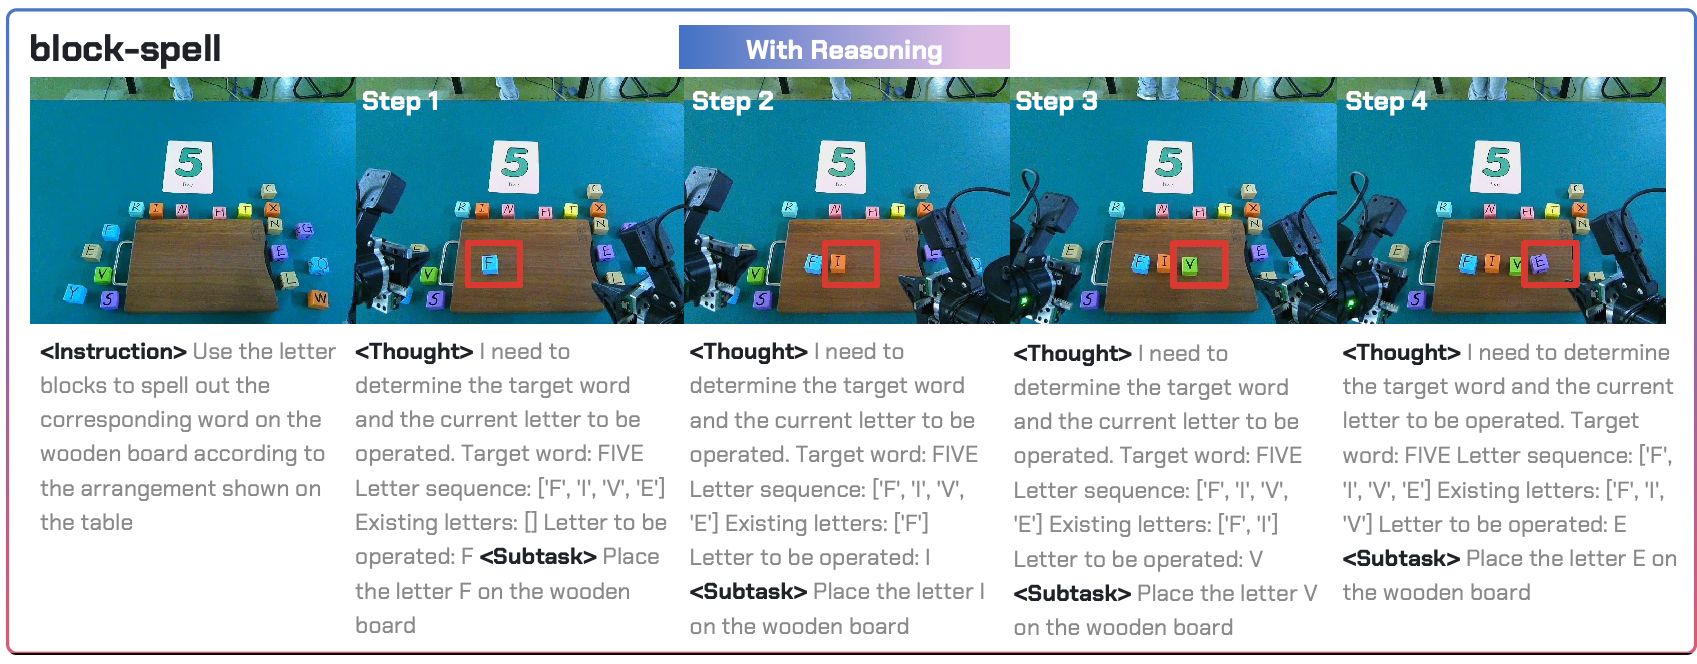
La tarea de bloques con letras requiere reconocer el objetivo, elegir el orden de las letras y localizar y colocar los bloques. Responder “spell FIVE” completa solo la parte de comprensión.
| Concepto | Intuición | Ejemplo en este artículo |
|---|---|---|
| Observación | Información externa sobre la escena | Imágenes en vista ego y de la cámara montada en el brazo. |
| Estado del robot | Configuración numérica del robot | Estado que entra en la rama continua en la Figura 3; los campos y dimensiones no se reportan. |
| Acción | Objetivos numéricos para la interfaz de control | Una trayectoria de T pasos y d dimensiones; las posiciones se estandarizan a metros y los ángulos a radianes entre fuentes. |
| Preguntas-respuestas visuales (VQA) | Responder preguntas de texto a partir de imágenes | Localizar un bloque, describir la escena o predecir una subtarea. |
| Chain of thought (CoT) | Razonamiento intermedio explícito | El objetivo es FIVE; F e I están colocadas; V es la siguiente. |
Precaución: La entrada de estado de la Figura 3 no debe omitirse porque la prosa abrevia el condicionamiento como visión e instrucción. Las plataformas incluyen brazos simples, bimanuales, móviles y humanoides con ruedas, por lo que no todas pueden compartir un mismo recuento supuesto de DoF, número de cámaras o especificación de acciones.
Acciones directas y decisiones entre niveles
Una política directa mapea imágenes e instrucciones a acciones; una canalización jerárquica usa un planificador separado antes de un controlador. WALL-OSS aprende “instrucción → razonamiento → subtarea → acciones continuas” en un solo modelo, permitiendo omitir niveles intermedios innecesarios.
Direct: image + “spell FIVE” → action sequence
Full: image + instruction → goal/progress reasoning → “place V third” → actions

Illustrative timeline:
First decision: empty board → place F
Later decision: F is present → place I
Next decision: F and I are present → place V
Explicación: Las subtareas aclaran el objetivo actual y pueden reducir acciones repetidas o confusión entre etapas. El razonamiento correcto sigue requiriendo una ejecución de bajo nivel precisa. Esta línea temporal explica el progreso, no un calendario fijo de replanificación reportado.
El modelado de acciones discretas (DAM) codifica trayectorias numéricas como tokens; el modelado de acciones continuas (CAM) genera trayectorias numéricas directamente. Esta es una distinción de representación/objetivo, no otro nombre para control de un solo paso frente a múltiples pasos.
Entrenamiento, inferencia y evaluación
| Etapa | Operación | Resultado |
|---|---|---|
| Entrenamiento | Usar VQA visual, acciones demostradas y anotaciones limitadas de razonamiento/subtareas para optimizar objetivos de texto y acción. | Parámetros; las pérdidas miden el ajuste a la supervisión. |
| Inferencia | Leer imágenes, instrucciones y estado para la ruta continua; generar razonamiento opcional, subtareas y acciones. | Trayectorias enviadas al control. |
| Evaluación | Ejecutar tareas especificadas y evaluar manualmente el VQA encarnado. | Calidad de QA, progreso, éxito o precisión de la instrucción, interpretados por separado. |
No se reportan tasas de control completas, latencia de inferencia ni planificación de la ejecución. “Acciones de alta frecuencia” o “control asíncrono” no establecen rendimiento en tiempo real, y la pérdida no es éxito en la tarea.
Resumen: traducción y comentarios
Traducción
A pesar del progreso en lenguaje y visión, la comprensión espacial y encarnada de los VLM sigue siendo limitada. Avanzar hacia la interacción física expone desajustes en modalidades, distribuciones de preentrenamiento y objetivos, lo que convierte la comprensión y generación de acciones en un gran desafío hacia la inteligencia general.
Presentamos WALL-OSS, un modelo fundacional encarnado de extremo a extremo que usa preentrenamiento multimodal a gran escala para (1) comprensión visión-lenguaje sensible a características encarnadas, (2) fuerte asociación lenguaje–acción y (3) manipulación robusta. Una arquitectura estrechamente acoplada y un plan de entrenamiento multi-estrategia permiten el Unified Cross-Level CoT, que unifica el razonamiento sobre instrucciones, la descomposición en subobjetivos y la síntesis de acciones de grano fino en un único marco diferenciable.
Los autores reportan un fuerte seguimiento de instrucciones, razonamiento y manipulación de largo horizonte en comparación con las líneas base, presentando una ruta escalable desde los VLM hasta modelos fundacionales encarnados.
Comentarios
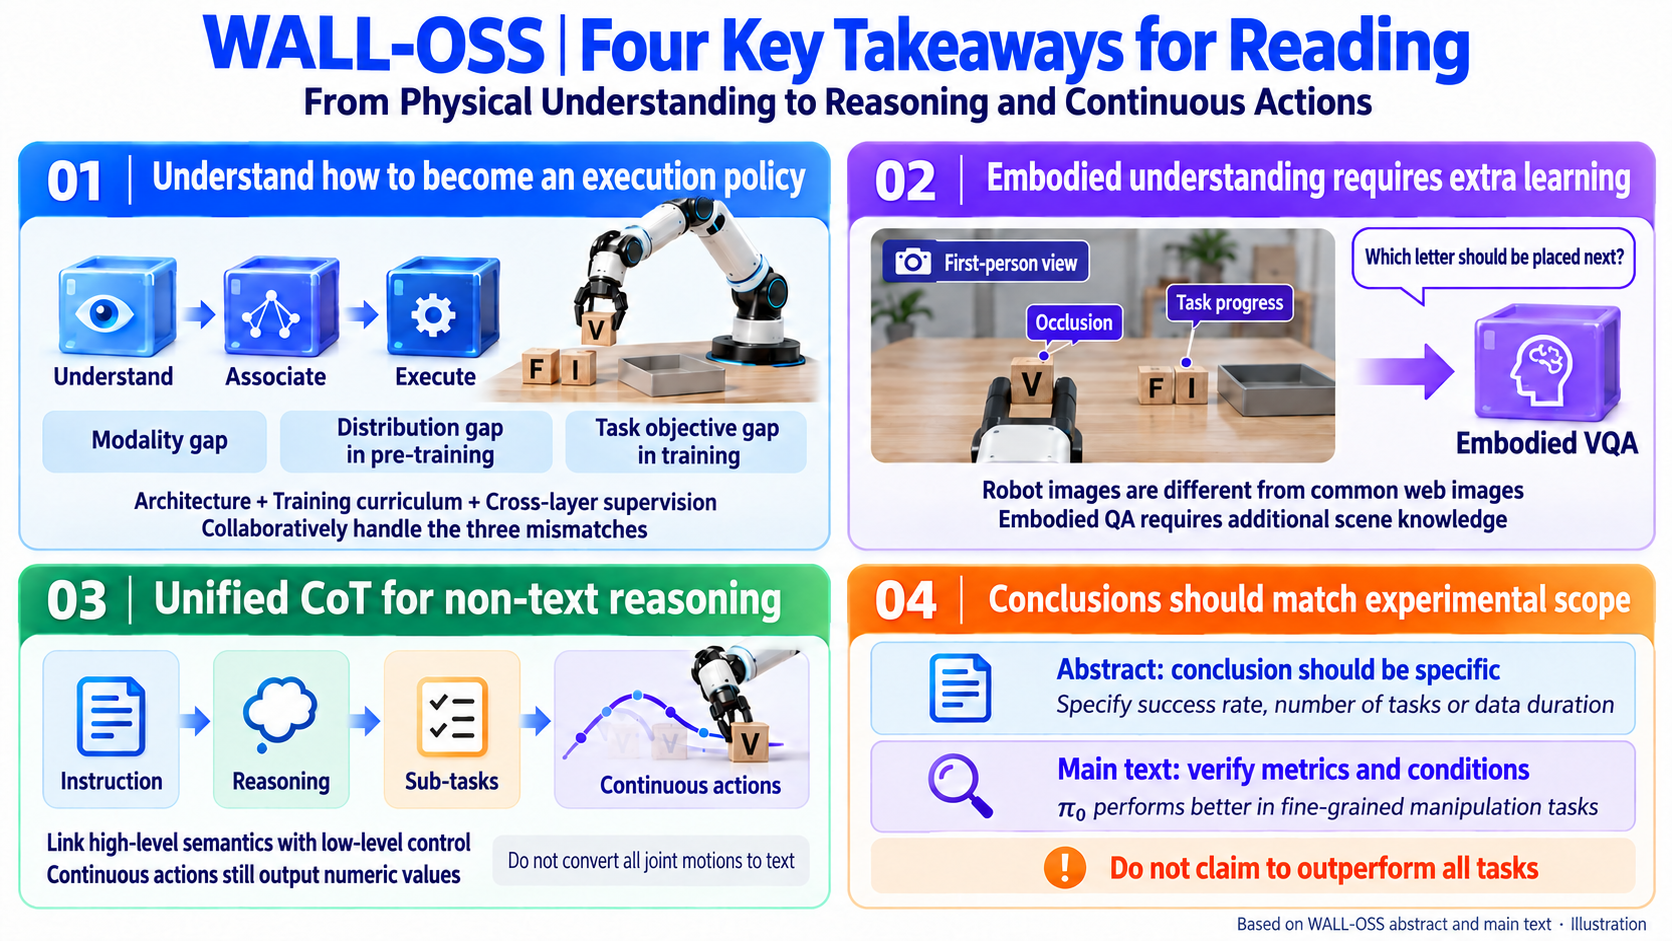
Introducción y trabajos relacionados: tres desajustes
Los ocho párrafos principales de la introducción
Estos corresponden a las páginas 1–3. Tres párrafos tienen subtítulos Gap; el párrafo 7 abarca las páginas 2–3. El pie de figura de la Figura 1 no se cuenta como prosa de introducción.
Párrafo 1: el destino. Los modelos de lenguaje/visión entienden entradas multimodales pero carecen de retroalimentación física y acciones ejecutables, lo que motiva la comprensión y generación de acciones.
Párrafo 2: por qué transferir desde VLM. Los datos imagen-texto son abundantes, los datos emparejados de robots son escasos y heterogéneos. Los priors preentrenados motivan la transferencia en lugar de entrenar desde cero, pero por sí solos no prueban la efectividad.
Párrafo 3: el dilema de la transferencia. Un ajuste fino directo de la cabeza de acciones puede desviar los parámetros preentrenados; un aislamiento fuerte puede debilitar el acoplamiento semántica–control. Esto motiva tres brechas.
Párrafo 4: brecha de modalidad y escala de datos. El texto y la visión comprimida están ampliamente alineados, mientras que las acciones son señales espaciotemporales continuas y las instrucciones de alto nivel omiten subtareas. La discusión de errores de planificador/controlador y enfoques 3D motiva el trabajo en lugar de rechazar experimentalmente todas las alternativas.
Párrafo 5: brecha de distribución. Las vistas ego, imágenes ojo de pez y auto-oclusión difieren de las imágenes de internet. La vinculación espacial y la evaluación del progreso necesitan supervisión encarnada. La Figura 1 ilustra esto, no un benchmark a gran escala.
Párrafo 6: brecha de objetivo. El texto usa predicción discreta del siguiente token; las acciones continuas se adaptan mejor a diffusion o flow matching. Simplemente unir objetivos puede no vincular estrechamente semántica y control, lo que motiva el entrenamiento de discreto a continuo.
Párrafo 7: la respuesta propuesta. Expertos acoplados y entrenamiento por etapas abordan los objetivos; VQA encarnado y priors discretos abordan las distribuciones; el CoT unificado vincula la semántica con acciones finas a través de niveles.
Párrafo 8: contribuciones y recursos abiertos. El artículo no da una lista fija y numerada de tres contribuciones. Resume el acoplamiento de la arquitectura y el diseño del plan de estudios; experimentos sobre seguimiento de instrucciones, razonamiento composicional y control de largo horizonte; y una ruta más amplia a través de la brecha semántica–sensorimotora, mientras anuncia código de entrenamiento y checkpoints abiertos. Frases como “state of the art” e “insights teóricos” son afirmaciones de los autores; la evidencia se evalúa mediante experimentos específicos y descripciones formales publicadas.
Tres áreas de trabajos relacionados y en qué difiere este trabajo
-
Fundamentos de lenguaje, visión y manipulación: Los VLA existentes usan tokens de acción o cabezas continuas. WALL-OSS primero aprende priors de acciones discretas en el espacio de salida de lenguaje y luego optimiza flow matching con encaminamiento estático. Su agrupación amplia de ACT con métodos discretos no debe leerse como si hiciera de ACT un tokenizador FAST/BPE.
-
Entrenamiento conjunto multimodal/robótico: Métodos anteriores usan imágenes, vídeo y datos de robots para retener la comprensión y mejorar la transferencia. Aquí, la supervisión encarnada unifica instrucciones, razonamiento, subtareas y acciones, con cuotas y un plan de estudios por etapas para limitar el desvío.
-
Razonamiento y descomposición: Los planificadores separados simplifican el entrenamiento pero pueden tener errores de interfaz y acumulativos. Uni-CoT aprende mapeos entre niveles en un solo modelo con razonamiento intermedio opcional. La superioridad universal frente a canalizaciones aún requiere evidencia.
Método central: semántica de acciones antes que control continuo
Atención compartida, procesamiento de características separado
Problema: Conservar el conocimiento visual-lingüístico mientras se condicionan fuertemente las acciones implica compensaciones entre parámetros totalmente compartidos e independientes. Intuición: Intercambiar información mediante atención compartida y luego procesar las categorías de características con redes feed-forward separadas.
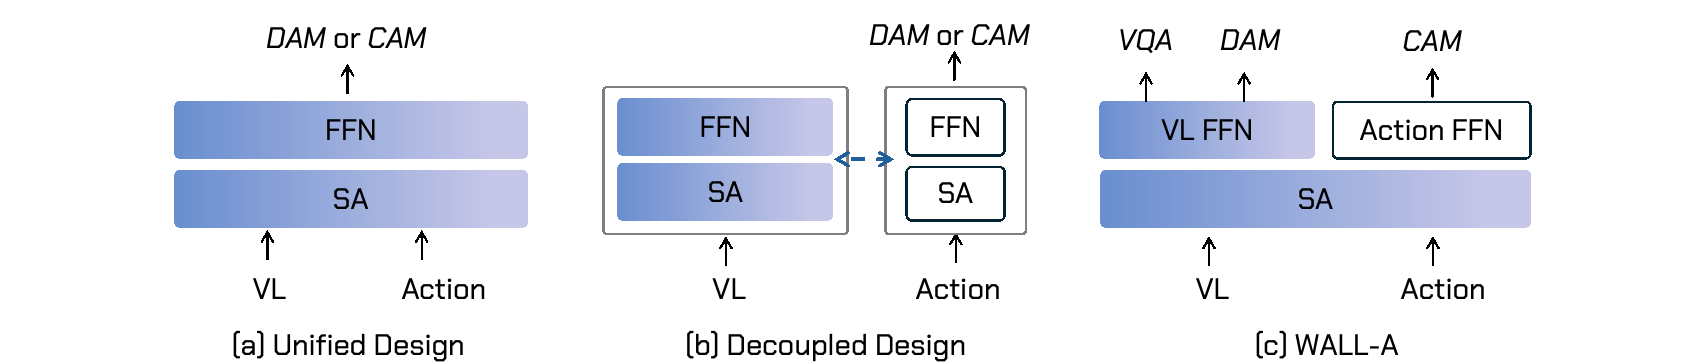
Artículo: Qwen2.5-VL-3B es la columna vertebral. Un diseño de mezcla de expertos enruta estáticamente las características visual-lingüísticas a un FFN de visión-lenguaje y las características de acción a un FFN de acción. La auto-atención intercambia información entre modalidades; los FFN especializan el procesamiento.
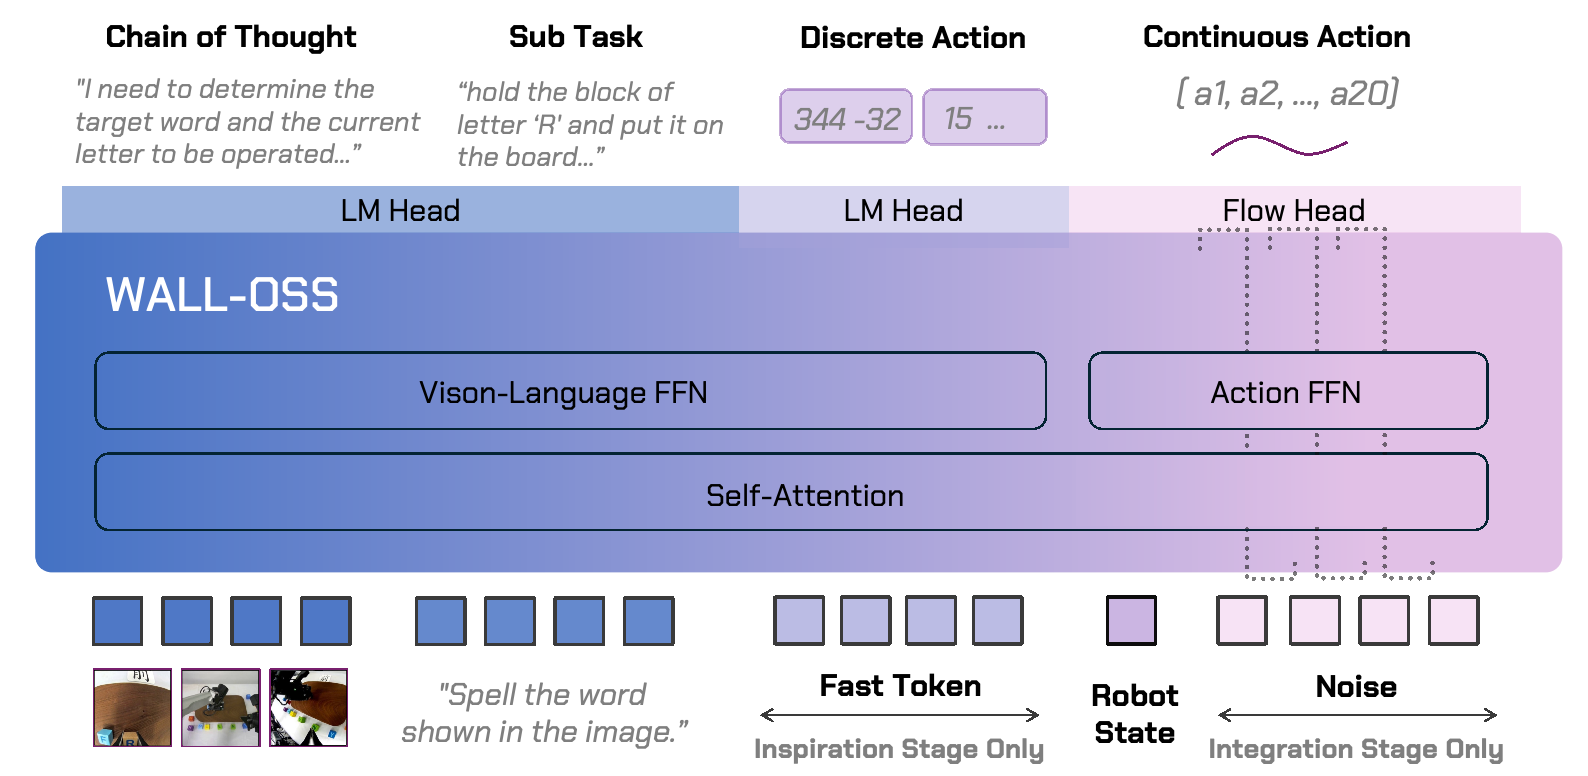
| Ruta | Entrada y procesamiento | Salida y forma |
|---|---|---|
| Imágenes/lenguaje | Vistas ego/brazo e instrucción → codificación → atención compartida y VL FFN | Características h; el número de tokens y el ancho oculto no se especifican. |
| Texto | Condiciones visual-lingüísticas → cabeza LM | Tokens de razonamiento/subtarea con probabilidades sobre el vocabulario. |
| Acciones discretas | Demostraciones → FAST; predecir tokens posteriores a partir de prefijos | K tokens de acción; K difiere de los pasos de trayectoria T. |
| Acciones continuas | Características imagen-texto, estado del robot, ruido de misma forma, progreso → atención → FFN de acción y cabeza de flujo | Campo de velocidad T × d; la integración da una trayectoria de la misma forma. |
Formalización ilustrativa de enrutamiento estático, no un algoritmo adicional del artículo:
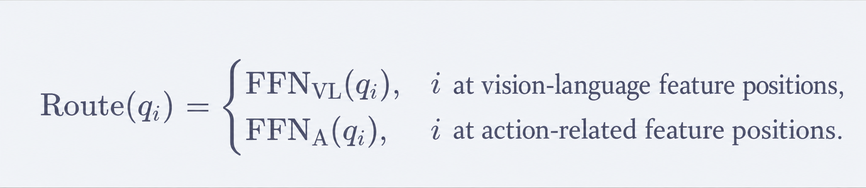
qᵢ es la característica posterior a la atención en la posición i, de ancho D. Ambas ramas necesitan representaciones posteriores compatibles, pero no se informan anchos/proyecciones. i es un índice de secuencia y D un conteo de características sin unidades. A diferencia del gating aprendido con softmax/top-k, la rama se elige por categoría de característica, no por una probabilidad de experto recién estimada.
Ejemplo mínimo: En [image, image, instruction, action, action], enrutar las tres primeras posiciones al VL FFN y las dos últimas al FFN de acción, mientras la atención compartida aún las conecta. Esto no completa la codificación de estado o el enrutamiento no especificados.
Frontera de dimensión: Un bloque ilustrativo con T=3, d=2 contiene seis valores, o forma 4 × 3 × 2 para B=4. Estos conteos no son frecuencias. El (a₁,…,a₂₀) de la Figura 3 es esquemático, no confirmación de un horizonte universal de 20 pasos. Las interfaces completas de acción, el ancho de relleno y el total de parámetros no se especifican; “3B” nombra la columna vertebral, no todo el modelo.
Inspiración: acciones discretas y QA encarnado
Problema: El VLM carece de conocimiento de la escena del robot y de correspondencias texto–trayectoria. Intuición: Usar predicción de secuencias familiar tanto para QA encarnado como para códigos discretos de demostración, creando una interfaz de aprendizaje común.
Ecuaciones de la página 5, con símbolos renombrados para evitar colisiones:
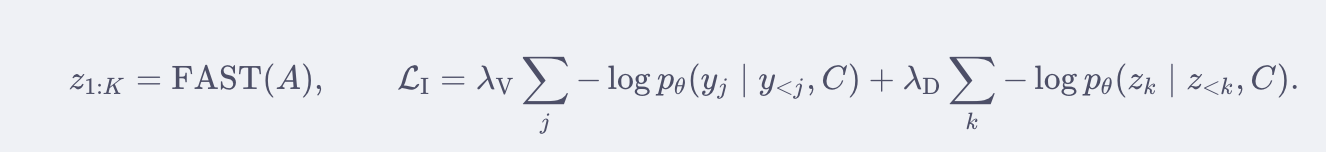
A∈ℝᵀˣᵈ es la trayectoria demostrada; C=(V,L) contiene visión e instrucción. yⱼ es el token de texto j, zₖ el token de acción k, y <j/<k los prefijos existentes. θ parametriza la ruta VL; pθ es la probabilidad del siguiente token. λᵥ y λᴅ son pesos sin unidades. K es longitud codificada, no un valor fijo reportado.
FAST es un método eficiente de tokenización de acciones. El diagrama muestra transformada discreta del coseno (DCT) → cuantización → codificación por pares de bytes (BPE). Explicación: Transformar trayectorias del dominio temporal a coeficientes de frecuencia, luego cuantizarlos y comprimirlos en tokens; esto no asigna simplemente una palabra a cada ángulo articular. El artículo no informa la configuración de FAST, la precisión de cuantización ni el tamaño del vocabulario, por lo que no se deben insertar valores predeterminados de otros artículos.
Ejemplo mínimo: Si los tokens de texto/acción correctos reciben probabilidades 0.8 y 0.5, con pesos unitarios, su pérdida es −ln(0.8)−ln(0.5)≈0.916. Esto recompensa secuencias correctas en lugar de medir directamente el error de colocación.
Las secuencias QA y FAST de verdad terreno supervisan la ruta VLM reutilizada, que en esta etapa puede producir razonamiento, subtareas y acciones discretas. La supervisión discreta construye priors; el despliegue final pasa a generación continua y no necesariamente predice primero tokens FAST.
Precaución: El texto menciona modelado enmascarado, aprendizaje contrastivo de imagen/video, seguimiento de instrucciones y modelado temporal/causal, pero su ecuación muestra explícitamente solo términos de texto y acción discreta. Otras pérdidas, pesos y calendarios no se especifican completamente.
Integración: generar acciones continuas a partir de ruido
Problema: Los priors discretos alinean la semántica pero la ejecución necesita valores continuos. Intuición: Aprender una dirección a lo largo de una ruta de ruidificación de acciones y luego integrar hacia atrás desde el ruido. Esto es flow matching.
Ecuaciones de la página 5, renombrando el progreso τ mientras se preserva la dirección:
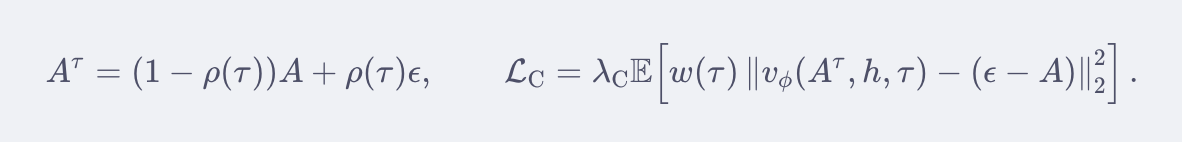
A es la acción limpia, ε ruido gaussiano de misma forma, y A^τ el arreglo ruidoso T × d. h es la codificación VL, φ los parámetros de la ruta continua, y vφ el campo. τ es el progreso de generación sin unidades, ρ el calendario, w una función de ponderación, y λᴄ el peso de la pérdida. Las esperanzas cubren datos, ruido y tiempo. La “velocidad” del campo es dirección en el espacio de generación, no automáticamente velocidad del motor.
Ejemplo mínimo: En unidades normalizadas, A=0.6, ε=−0.2, y una ρ(τ)=τ lineal ilustrativa en τ=0.5 dan A^τ=0.2 y objetivo ε−A=−0.8. Predecir −0.7 da error cuadrático 0.01 con pesos unitarios. Las unidades físicas requieren las reglas de decodificación del conjunto de datos.
La dirección importa: En este ejemplo lineal, τ=0 es limpio y τ=1 es ruido. Generar integrando desde uno hacia cero, no ejecutando en el robot la dirección de ruidificación.
Actualización inversa de Euler ilustrativa, no un solucionador especificado en el artículo:
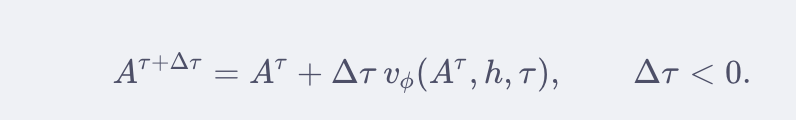
Δτ no tiene unidades. Empezar en 0.2 con dirección −0.8 y Δτ=−0.1 da 0.28, más cerca de 0.6. El arreglo completo se actualiza junto; una actualización interna no es un paso de robot.
Precaución: Una ρ no lineal general introduciría ρ′(τ) en la derivada de la ruta, mientras que el artículo escribe directamente ε−A. El ejemplo se restringe a una ruta lineal; no se infiere ningún calendario inédito, distribución temporal, solucionador ni conteo de iteraciones. La ecuación también abrevia el estado del robot de la Figura 3, lo que no significa que el estado esté ausente.
Dos etapas principales, con dos fases de integración
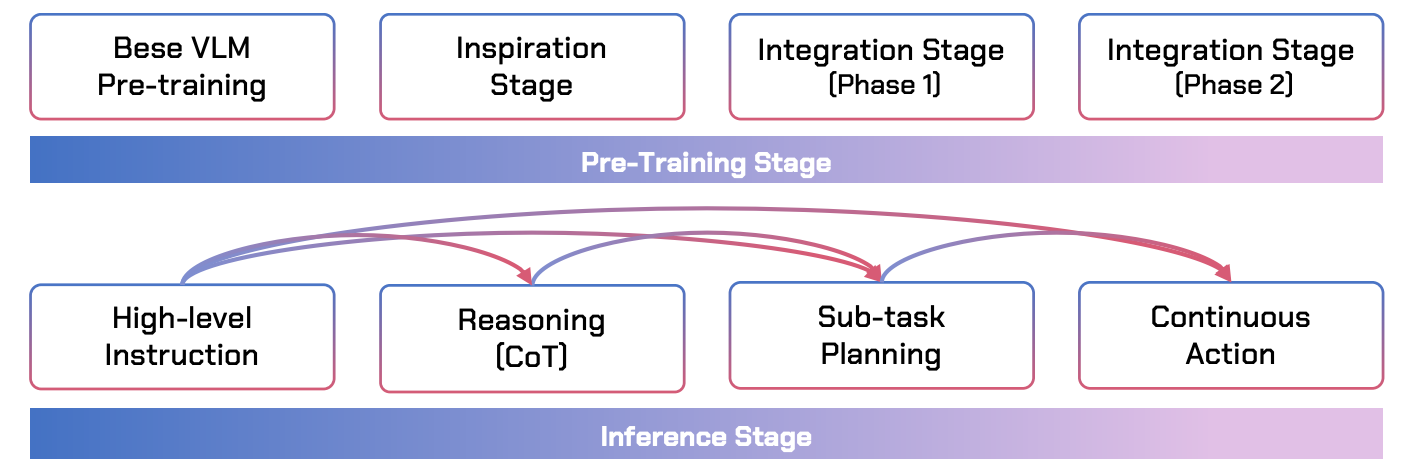
Artículo: Tras el preentrenamiento VLM existente, WALL-OSS usa Inspiración e Integración. Integración tiene fases de congelar y descongelar; el preentrenamiento original de la columna vertebral no es una tercera etapa de nuevo diseño.
| Etapa | Supervisión/salida | Actualizaciones | Propósito |
|---|---|---|---|
| Inspiración | VQA encarnado, texto/subtareas/CoT, tokens FAST | Reutilizar/entrenar la ruta VLM; los detalles completos de congelación no se especifican. | Comprensión escena-robot y semántica de acciones. |
| Fase de integración 1 | Flow matching continuo | Congelar VLM y entrenar la ruta de acción continua/cabeza de flujo; los límites exactos no se especifican. | Permitir que la nueva rama use priors establecidos. |
| Fase de integración 2 | Flow matching continuo y optimización conjunta | Descongelar VLM; actualizar θ y φ. | Alinear mejor visión, lenguaje y acciones. |
Ejemplo: El error de acción de la fase 1 actualiza solo la rama continua; en la fase 2 también puede actualizar la columna vertebral. Congelar no es aislamiento permanente, y descongelar no descarta el aprendizaje previo.
Las etapas cambian representación, objetivo y parámetros entrenables en lugar de empalmar modelos de robot independientes. La Sección 4 describe mezcla de fuentes y cuotas; la Sección 5 informa mezclas de acciones/VQA downstream. La v1 no da recetas, pasos ni pesos de objetivos completos, por lo que la Figura 4 por sí sola no puede reproducir el entrenamiento.
Uni-CoT: razonamiento completo o ejecución directa
Problema: Imágenes similares pueden representar diferentes progresos, mientras que planificadores separados pueden desconectarse del control. Intuición: Aprender relaciones entre niveles en un solo modelo e incluir muestras sin razonamiento intermedio, admitiendo tanto comportamiento complejo como directo.
Objetivo de la página 6, con símbolos renombrados para evitar colisiones de ruido:
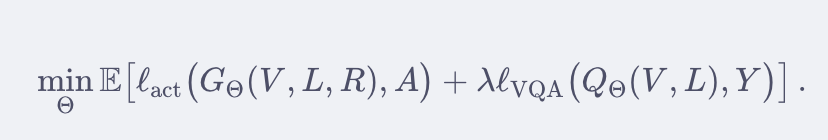
Θ contiene parámetros del modelo unificado; G predice acciones y Q respuestas encarnadas. V es visión, L instrucción, R razonamiento opcional, A∈ℝᵀˣᵈ acciones objetivo, Y etiquetas de QA, y λ un equilibrio sin unidades. La pérdida de acción sigue el objetivo de la etapa; la pérdida de VQA evalúa respuestas. El condicionamiento interno de G en ruido/tiempo se abstrae aquí.
Los autores llaman a esto path-drop: entrenar ambas rutas completas con razonamiento y rutas directas sin R. Ejemplo: una muestra de “spell FIVE” incluye “F and I are present, V next”; otra solo proporciona imágenes y la tarea. Pérdida de acción 0.2 más pérdida de QA 0.4 ponderadas por λ=0.5 dan 0.4. La tasa de descarte, el algoritmo de muestreo y las reglas de selección en inferencia no se reportan.
El fine-tuning de horizonte largo genera subtareas antes de las acciones; las tareas de color-palabra y deletreo también usan CoT. El artículo describe el entrelazado pero no el calendario completo de llamadas de inferencia, la planificación asíncrona ni los costos. El razonamiento opcional no establece un clasificador de dificultad publicado.
Precaución: El entrenamiento compartido de extremo a extremo es una afirmación arquitectónica. La pérdida combinada no muestra cómo pasan los gradientes de acción a través del texto discreto muestreado, por lo que no prueba la diferenciación a través de cada palabra generada. Establece aprendizaje compartido multiobjetivo, no todos los detalles de gradiente.
Entrenamiento e Inferencia Completos
Training:
  Images + instructions + QA/process labels → VL path → text, reasoning, subtask supervision
  Inspiration: demonstrations → FAST → discrete next-token loss
  Integration: actions + noise + progress → noisy actions
               VL context + state + noisy actions → continuous path → field loss
               freeze VLM first, then unfreeze for joint updates
  Uni-CoT: learn cross-level mappings with and without intermediate reasoning

Inference:
  Current images + task → VL representation
  Generate or skip CoT/subtasks according to the task path; use generated text as context
  VL context + state + fresh noise → continuous field → integration → trajectory
  Decode to the platform interface and execute; later observations condition the next decision
Explicación: La arquitectura conecta la información; la etapa discreta establece priors; la etapa continua genera valores; Uni-CoT vincula objetivos y progreso. Las longitudes de ejecución y la mezcla por solapamiento no se especifican. ACT temporal ensembling y CVAEs no deben añadirse al mecanismo de WALL-OSS.
Datos y Plataformas: Comprensión y Ejecución
Tres Fuentes
| Fuente | Proporción en Figura 5 | Contenido y función |
|---|---|---|
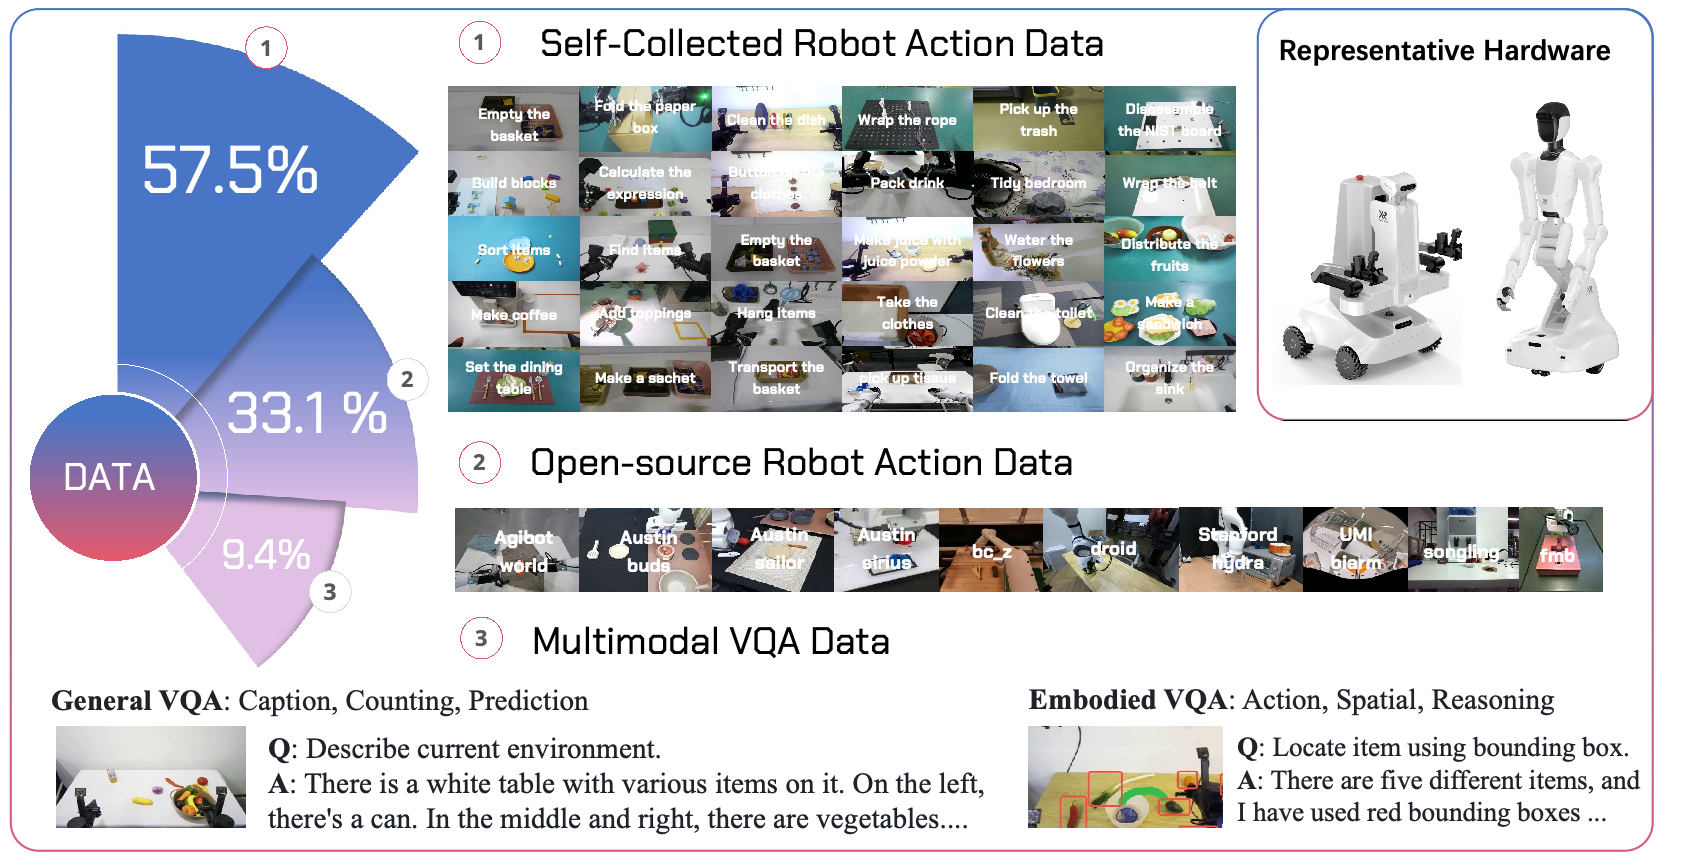
| Acciones internas del robot | 57.5% | Manipulación cotidiana, trayectorias complejas y etiquetas de proceso, incluyendo cocina, ropa/almacenamiento, pick-and-place móvil y ensamblaje. |
| Acciones abiertas de robots | 33.1% | DROID, BC-Z, BridgeData V2 y otros; plataformas, escenas y estilos variados. Lista completa en la Tabla 1. |
| VQA multimodal | 9.4% | El QA general conserva habilidades de imagen-texto; el QA encarnado añade espacio, tiempo, progreso y affordances. |
Precaución: Las proporciones suman 100%, pero su denominador—horas, muestras o pesos de mezcla—no está claro, por lo que no se infieren horas. La Sección 4 primero dice más de 10,000 horas, mientras que 4.4 dice más de decenas de miles. v1 no ofrece un desglose unificado que resuelva esto.
Los datos internos incluyen tareas cortas con instrucciones explícitas que enfatizan precisión/generalización y tareas largas con pasos implícitos que requieren descomposición y seguimiento del progreso. La anotación combina modelos y verificaciones humanas. Los controles de calidad incluyen marcas de tiempo sincronizadas, filtrado de valores atípicos/inactividad/baja calidad, revisión manual/reglada y aumento de iluminación/fondo.
El VQA encarnado cubre planificación, razonamiento espacial/temporal, atributos, cognición y affordances. Las etiquetas incluyen cajas, puntos, máscaras opcionales y QA en lenguaje natural. <point>[x,y]</point> es una ubicación 2D en la imagen, no un objetivo de agarre 3D; la normalización de coordenadas no se especifica de forma uniforme.
Alineación Multiplataforma y Detalles Faltantes
Artículo: Las fuentes incluyen brazos de sobremesa, monturas móviles, robots bímanos con ruedas y humanoides con vistas ego/externa/brazo. Las posiciones usan metros y ángulos en radianes. Una plantilla de máximo DoF con máscaras/espacios reservados maneja articulaciones faltantes, mientras que la calibración de cámaras, marcas de tiempo, canales y rejillas de acción se alinean.
Explicación: Una interfaz común no hace que los DoF sean idénticos ni que las políticas sean intercambiables sin adaptación. El relleno no debe ejecutarse como controles físicos.
v1 no reporta modelos completos de plataformas, recuentos/resoluciones de cámaras, tasas de control/recolección, dimensiones unificadas, duraciones de tareas, configuraciones de GPU, tamaño de lote, tasas de aprendizaje ni pasos por etapa. Las fotos del hardware no pueden proporcionar esas especificaciones.
Los autores describen particiones estratificadas de validación/prueba por escena, objeto, tarea y embodiment, con sobremuestreo de habilidades largas/raras y mezclas por cuotas. Los recuentos completos, temperaturas de muestreo y desduplicación no están publicados, lo que limita la reproducción exacta.
Experimentos: Comprensión, Razonamiento y Acciones
Tareas, Fine-Tuning y Condiciones de Evaluación
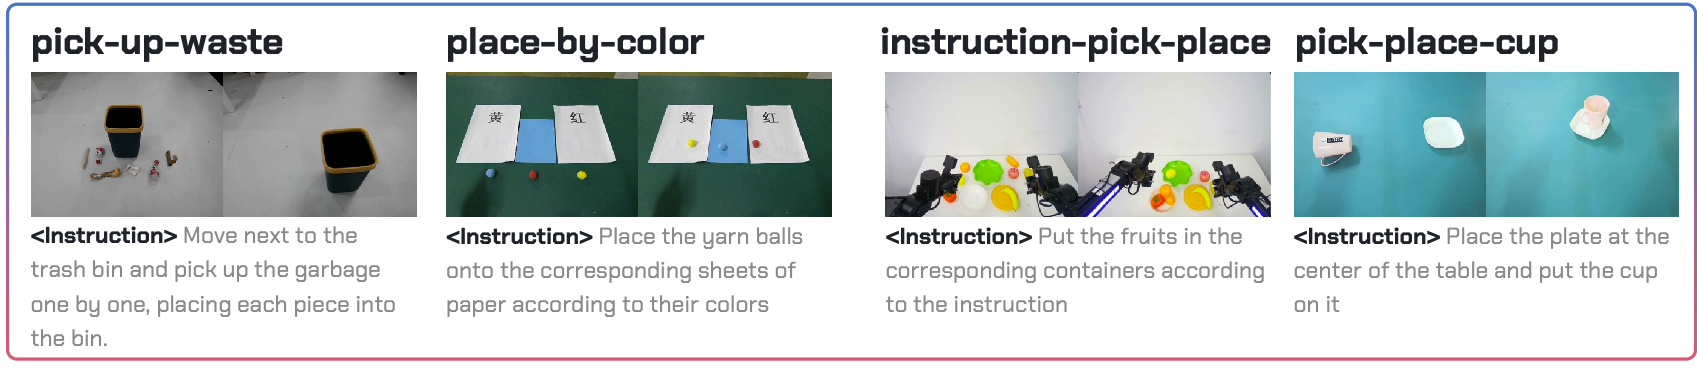
| Tarea | Prueba principal | Demostraciones en 5.1.1 | Frontera de pre-entrenamiento / fine-tuning |
|---|---|---|---|
| Instruction-Pick-Place | Seleccionar objeto y destino a partir del lenguaje. | Sin fine-tuning de tarea | Evaluación de tarea zero-shot después del pre-entrenamiento del robot. |
| Place-by-Color | Emparejamiento directo de color o palabra de color. | 500 episodios | Declarado ausente del pre-entrenamiento. |
| Block-Spell | Reconocer/calcular una palabra y colocar letras. | 1,600 episodios | Fine-tuning de tarea, no deletreo zero-shot. |
| Set-Table | Disponer platos, cuchillos y tenedores para dos. | 1,500 episodios | Declarado ausente del pre-entrenamiento, luego con fine-tuning. |
| Tidy-Bedroom | Recoger ropa y colocar almohadas. | 1,000 episodios | Declarado ausente del pre-entrenamiento, luego con fine-tuning. |
| Collect-Waste | Ir a un contenedor, recoger y desechar residuos. | 900 episodios | La sección de Resultados en cambio dice 1,000 demostraciones. |
| Pick-Place-Cup | Ajustar configuraciones de taza/plato y colocarlos. | 500 episodios | Tazas invertidas, direcciones del asa y variación de posición del plato. |
Precaución: La Sección 5.1 menciona seis tareas de manipulación, mientras que 5.1.1 y la Figura 6 listan siete. La Figura 7 resume seis tareas con fine-tuning; el seguimiento de instrucciones zero-shot es separado en el texto. No visto en el pre-entrenamiento no es no visto en el fine-tuning, y los recuentos conflictivos de residuos siguen sin resolverse.
Los baselines son π0 y Diffusion Policy (DP). El entrenamiento plano mapea instrucciones de alto nivel directamente a acciones; GPT4-Subtask entrena con subtareas anotadas y llama a GPT-4 en inferencia. El progreso de Flat Block-Spell es casi cero, por lo que la Figura 7 usa sus baselines GPT-subtask. No todas las barras comparten configuraciones de instrucción idénticas.
Los autores describen supervisión de tarea igual, pero WALL-OSS además coentrena VQA: el muestreo de QA sin subtareas se escribe 1:15 y el de subtareas 1:100. Las unidades y el orden de las proporciones están insuficientemente explicados para inferir proporciones de frames. Supervisión de tarea igual no implica datos o cómputo globales idénticos.
Una tercera parte independiente evalúa a ciegas usando documentos de entorno, estado inicial y puntuación; el VQA se juzga manualmente. Los recuentos de ensayos, reglas completas de puntuación, barras de error e intervalos de confianza no se publican por completo. Las pruebas ciegas reducen el sesgo pero no sustituyen a la estadística.
VQA Encarnado: Mayores Ganancias en Grounding
Tabla 2, página 11:
| Categoría | Qwen2.5-VL-3B | WALL-OSS | Ganancia en puntos porcentuales |
|---|---|---|---|
| Object grounding | 46.1% | 91.6% | +45.5 |
| Scene captioning | 57.7% | 87.6% | +29.9 |
| Action planning | 59.8% | 69.0% | +9.2 |
Interpretación: Las mayores mejoras son en localizar objetos y describir escenas de robots. La planificación mejora menos; ambos modelos pueden juzgar mal el progreso. La tabla respalda la comprensión encarnada, no la retención completa de QA general ni un 91.6% de éxito en agarre.
Instrucciones Zero-Shot: Progreso No Es Tasa de Éxito
Páginas 11–12: Sin fine-tuning de tarea, Instruction-Pick-Place promedia 85% de progreso para instrucciones de objetos/contenedores vistos y 61% para objetos nuevos. Los autores atribuyen muchos fallos a pequeños errores de pose más que a seleccionar el objetivo semántico equivocado.
Precaución: Zero-shot excluye el fine-tuning específico de tarea, no el pre-entrenamiento del robot/multimodal. Son puntuaciones medias de progreso, no fracciones de éxito completo. La Figura 7 no muestra estos dos grupos por separado, a pesar de la cita en el texto, por lo que los números se atribuyen a la prosa.
Precisión y Horizontes Largos: Ganancias Dependientes de la Tarea
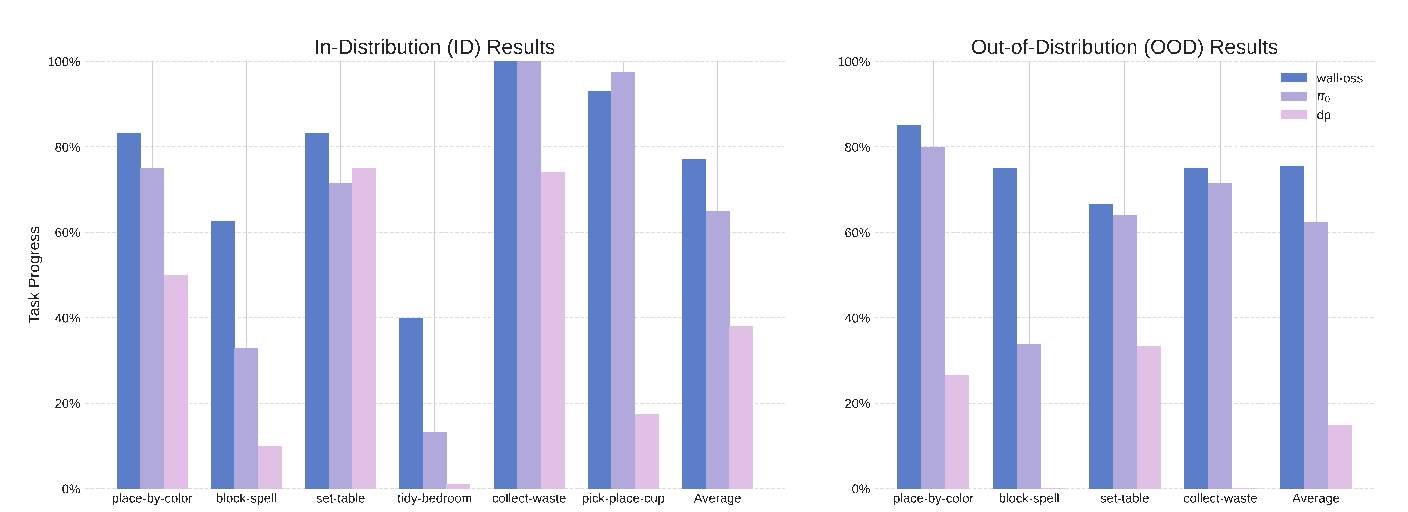
Interpretación de la figura: WALL-OSS lidera los baselines mostrados en deletreo, puesta de mesa y ordenado de dormitorio. Su barra de residuos ID y la de π0 alcanzan la parte superior, mientras que π0 es mayor en colocación de tazas. Los valores exactos de las barras no están impresos y no se infieren visualmente.
Informes de tasa de éxito en la página 12: La recolección de residuos ID es 100% para WALL-OSS y π0, 80% para DP; la colocación de tazas supera el 90% para ambos modelos pre-entrenados y está por debajo del 20% para DP. En una nueva escena de residuos, se informa que DP cae del 80% a cero, mientras que ambos modelos pre-entrenados permanecen por encima del 80%.
Precaución: Las tasas de éxito en prosa y el progreso de tareas en la Figura 7 están etiquetados de forma diferente y no son directamente intercambiables. El progreso de residuos ID de DP y el progreso de residuos OOD de WALL-OSS parecen aproximadamente tres cuartos en la figura. v1 no explica la relación, por lo que no se infiere ningún éxito promedio combinado.
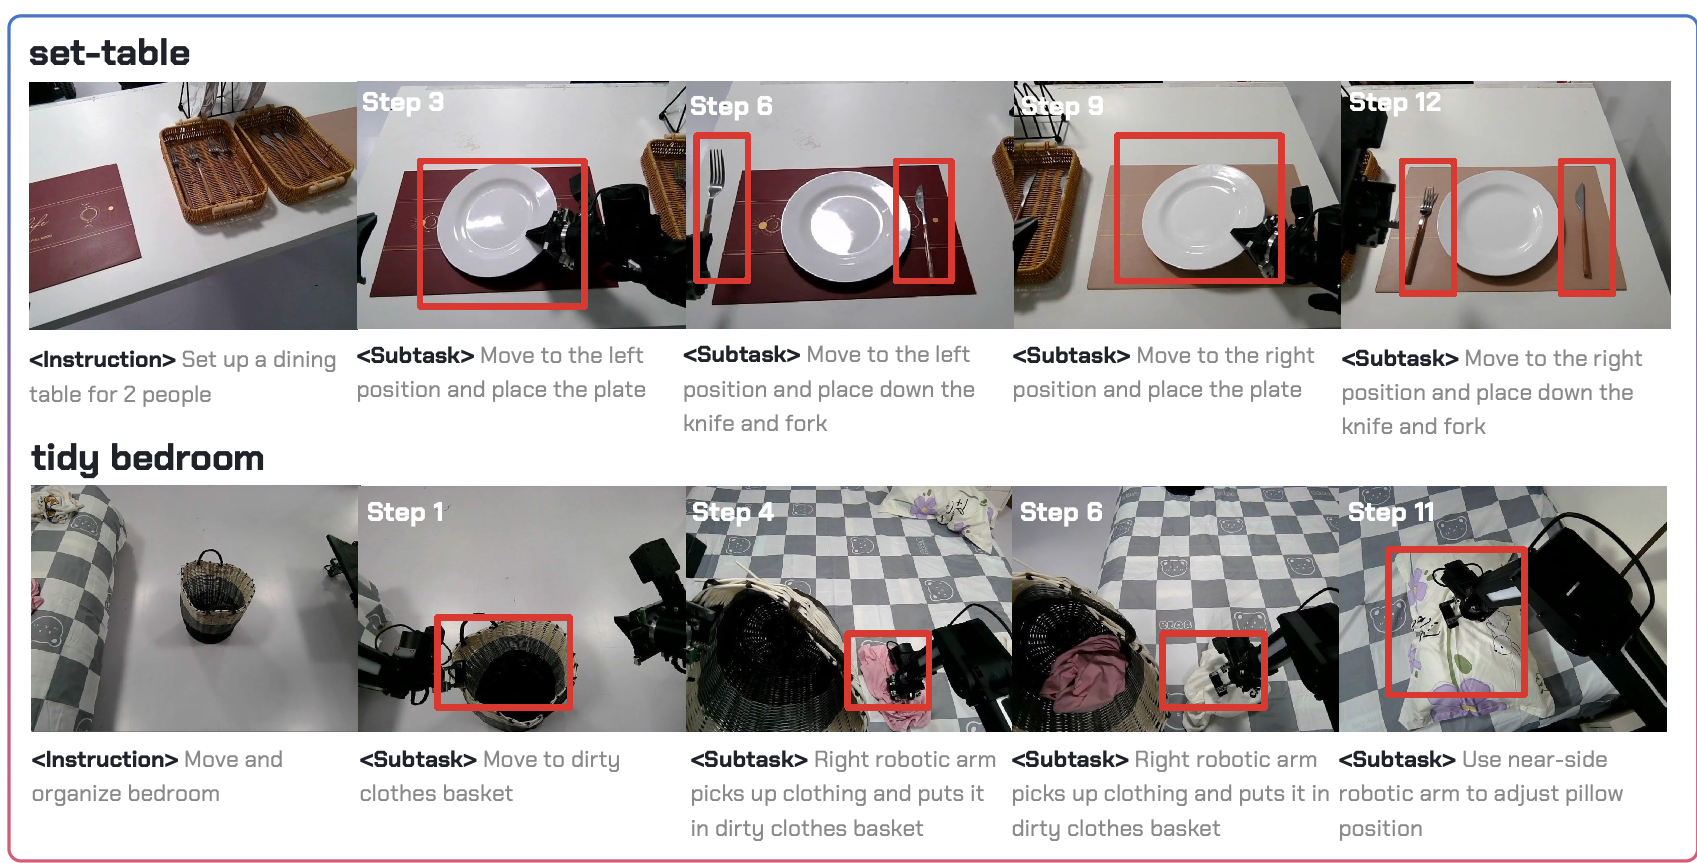
Artículo: Poner la mesa y ordenar el dormitorio superan las cinco etapas, con duraciones medias superiores a tres y cinco minutos. El ajuste fino combina acciones/subtareas, con solo un 1% de los datos de entrenamiento de tareas largas etiquetados a nivel de subtarea; en inferencia se generan subtareas antes de actuar. Las líneas base repiten cubiertos, omiten el otro servicio de mesa o entran en bucle cuando la ropa sale del campo de visión.
Interpretación: Estas observaciones respaldan el progreso explícito y las subtareas. Tres/cinco minutos son duraciones de tarea, no latencia de inferencia. Que los modelos preentrenados superen a DP respalda el preentrenamiento en este entorno, pero también difieren la inicialización, el tamaño y la arquitectura.
Razonamiento y coentrenamiento: instrucciones de grano fino
CoT aporta poco para la coincidencia directa de color visual, pero ayuda al colocar una pelota sobre un papel que lleva una palabra de color. Block-Spell primero reconoce o calcula una respuesta y luego coloca letras. La página 13 indica que el 1% de los fotogramas de entrenamiento supervisan CoT/subinstrucciones; esto difiere en unidad del “1% de los datos de entrenamiento” de tareas largas y no se reescribe como 1% de episodios.
Tabla 3, página 14: exactitud al seleccionar el bloque de letra/número indicado.
| Tipo de bloque | Coentrenamiento multimodal WALL-OSS | WALL-OSS solo acción | π0 solo acción |
|---|---|---|---|
| Letras | 87% | 26% | 9% |
| Números | 95% | 80% | 35% |
El ajuste fino multimodal combina acciones, CoT/subtareas y anclaje 2D. WALL-OSS solo acción entrena los controles a partir de subtareas. Esto cambia el ajuste fino posterior; no elimina todo el preentrenamiento multimodal.
Interpretación: Dentro de WALL-OSS, la exactitud en letras gana 87−26=61 puntos y la exactitud en números 95−80=15, lo que respalda la supervisión multimodal continua para objetivos precisos. Varios objetivos cambian a la vez, por lo que el anclaje, CoT y las subtareas no se aíslan individualmente. La medida es la exactitud de selección del objetivo, no el éxito de deletrear palabras completas.
Conclusiones y límites
Lección principal: En lugar de añadir una cabeza de acción como una ocurrencia tardía, añade comprensión encarnada, construye priors semánticos mediante entrenamiento de discreto a continuo y conecta objetivos, razonamiento, progreso y ejecución en un solo modelo. El anclaje y la selección de objetivos finos tienen un respaldo cuantitativo claro; el razonamiento y las tareas largas también mejoran respecto a las líneas base comparadas.
Mantén estos límites:
-
No es uniformemente el mejor en precisión. La Sección 6.1 reconoce que π0 sigue siendo mejor en manipulación fina; las afirmaciones generales no deben convertirse en primer lugar en cada métrica.
-
No todos los componentes están aislados. La Tabla 3 respalda el efecto combinado del ajuste fino multimodal, pero la v1 carece de ablaciones independientes completas para Inspiration, enrutamiento estático y path-drop.
-
Estadísticas y detalles de reproducción limitados. El número de tareas, las duraciones, el número de demostraciones y las métricas varían; los recuentos de ensayos y los intervalos de confianza están incompletos. Esas discrepancias se identifican en lugar de descartarse con conjeturas.
-
La validación en tiempo real y la transferencia amplia siguen pendientes. La asincronía y el entrenamiento multiplataforma se describen sin latencia, tasa, interfaces ni pruebas de transferencia completas, por lo que no se garantizan tiempos específicos de hardware ni transferencia sin adaptación.
-
3D y vídeo siguen siendo direcciones futuras. Los fotogramas predichos, la percepción 3D y el modelado del mundo se proponen, no se demuestran como componentes actuales de WALL-OSS ni como una solución para la IA Física general.
No se añade ninguna configuración de transferencia específica de producto. Otro robot necesita su propia interfaz de cámara/estado, unidades, dimensiones, ciclo de control y configuración de ejecución segura, separada de los resultados del artículo.