27. Visión robótica y percepción 3D
Capítulo 27 del Curso de Introducción a la IA Física de Seeed: cómo un robot convierte píxeles en 3D: la canalización de visión robótica, sensado RGB-D, mapas de profundidad, cámaras de profundidad estéreo / de luz estructurada / TOF, el modelo de cámara de orificio con parámetros intrínsecos y extrínsecos, conversión de píxeles a 3D y nubes de puntos.
Hardware necesario para esta etapa
Qué preparar para esta etapa. La lista completa para cada etapa está en el Capítulo 3.
Unidad de control principal
| Ítem | Comprar | Cant. |
|---|---|---|
| reComputer Robotics J4012 | 🛒 | 1 |
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
También se requiere un ordenador de sobremesa o portátil: Ubuntu 22.04, GTX 4080 o superior con 12GB+ de VRAM, 16GB+ de RAM.
Para esta etapa
| Ítem | Comprar | Cant. |
|---|---|---|
| reBot Arm B601 DM/RS | 🛒 | 1 |
| Realsense 435i o Orbbec Gemini2 Depth Camera o Realsense 405 Stereo Camera | 🛒 | 1 |
| Camera Wrist Mount | 🛒 | 1 |
27.1 Resumen del capítulo
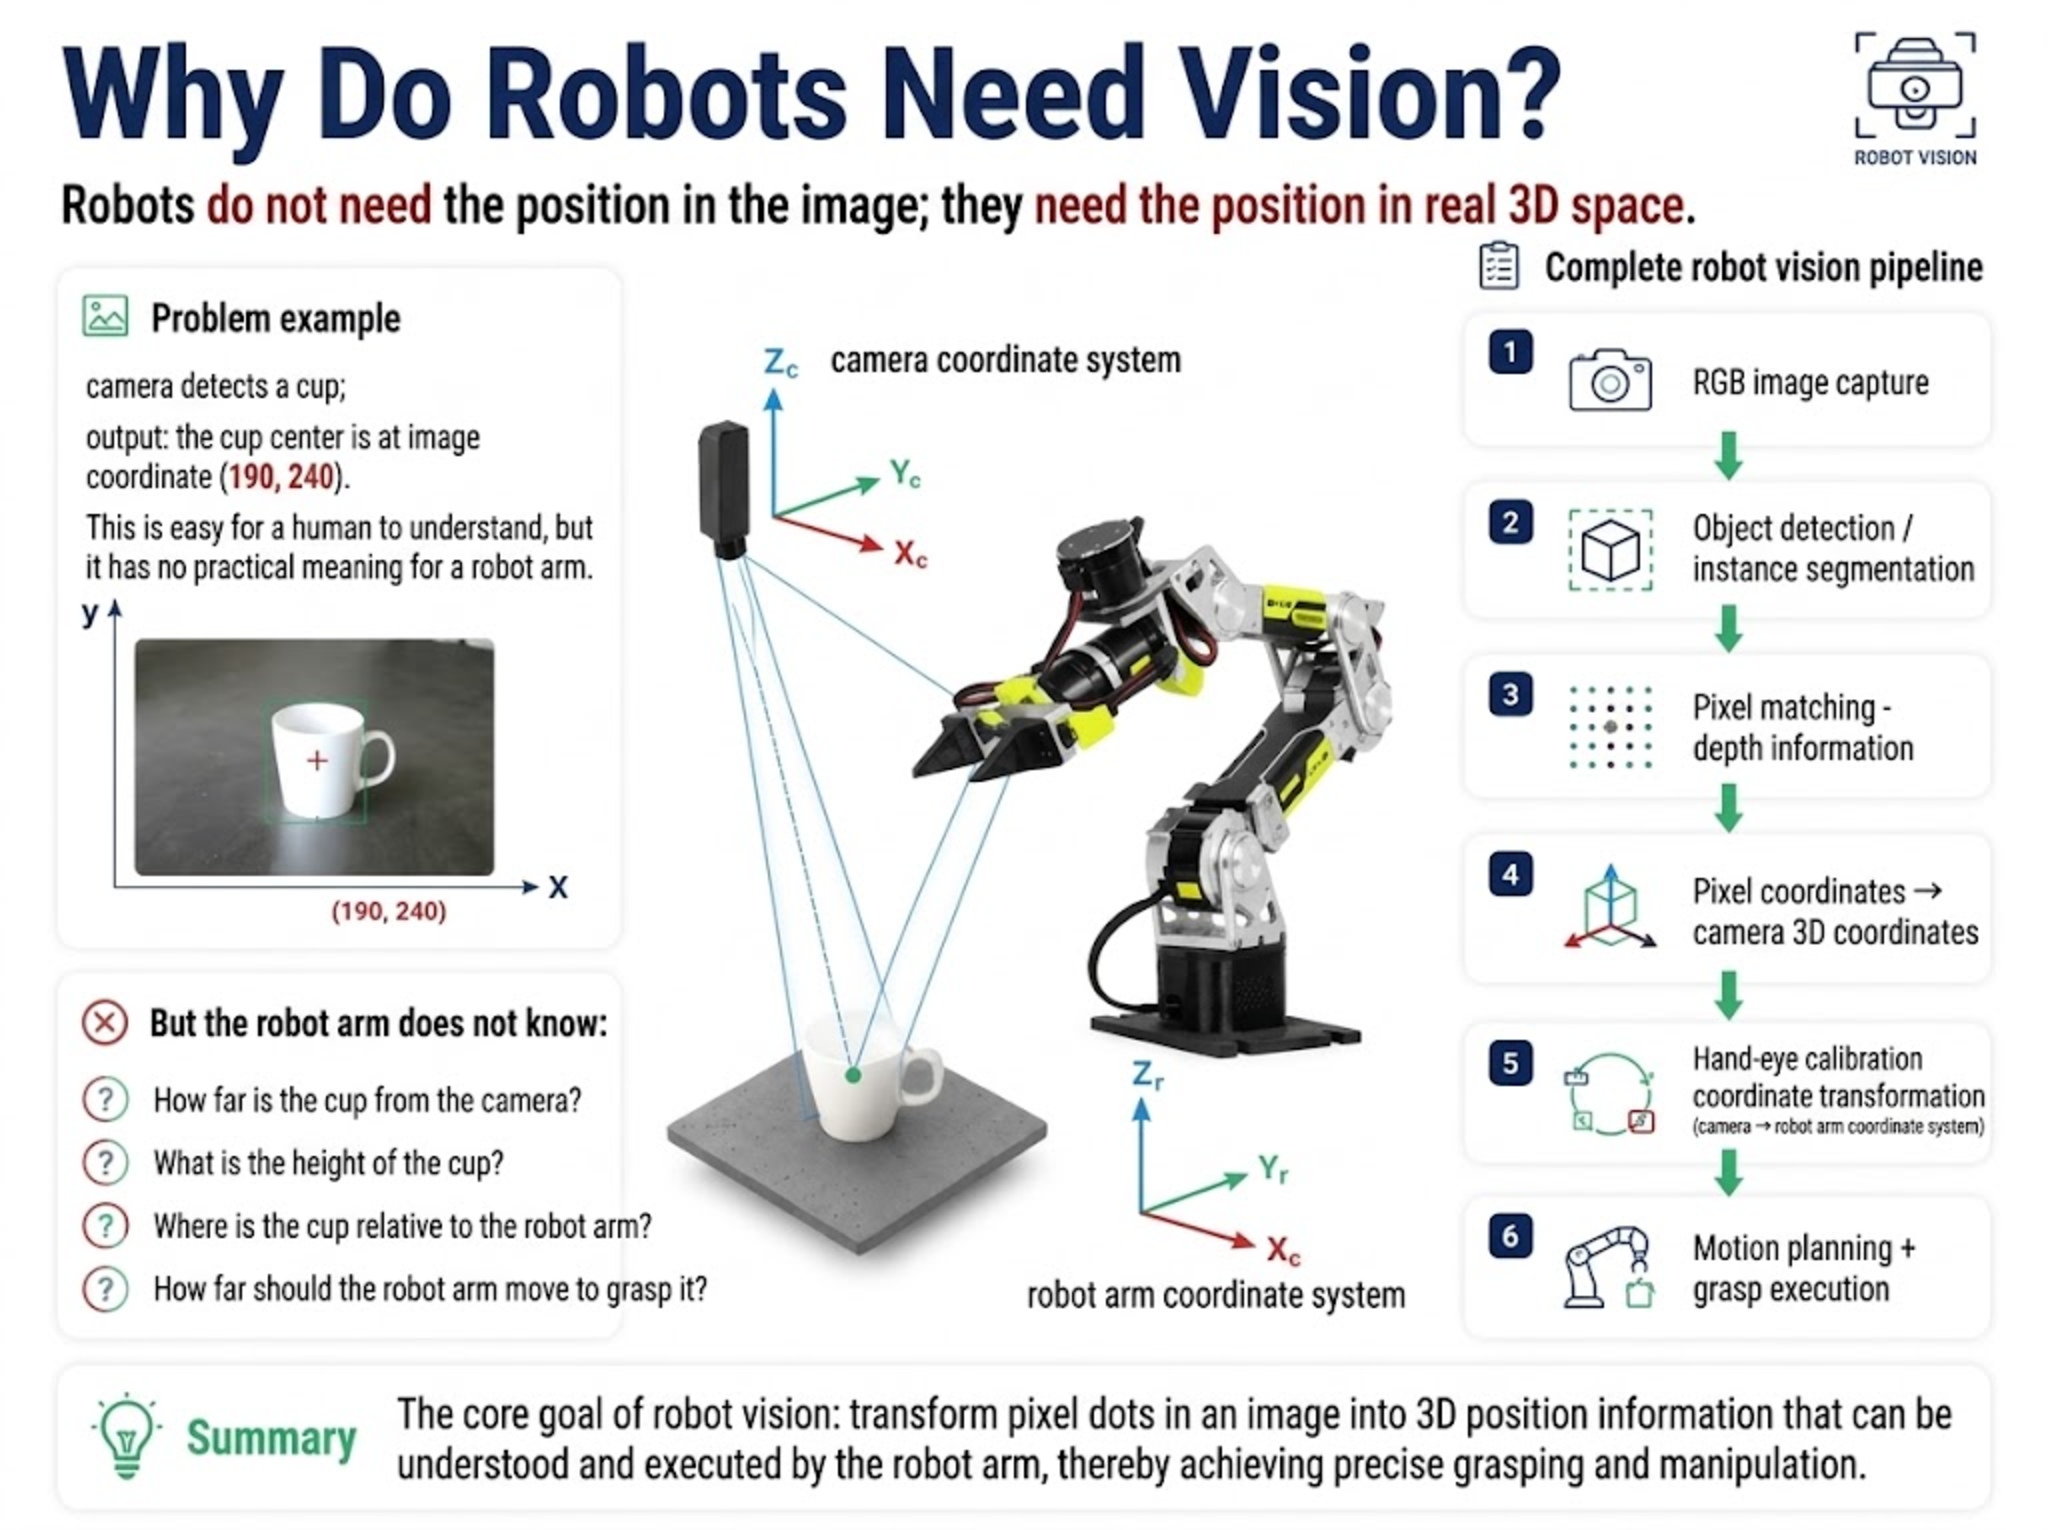
La visión robótica es una forma clave en que los robots perciben el entorno externo. Para un brazo robótico, simplemente saber "dónde está el objeto en la imagen" no es suficiente; lo que el robot realmente necesita es la posición del objeto en el espacio tridimensional real.
Por ejemplo: la cámara detecta una taza y produce: el centro de la taza está en las coordenadas de imagen (190, 240). Esto es fácil de entender para un humano, pero no tiene un significado real para el brazo robótico.
Porque el brazo no sabe:
- A qué distancia está la taza de la cámara;
- A qué altura está la taza;
- Dónde está la taza con respecto al brazo;
- Cuánto debe moverse el brazo para agarrarla.
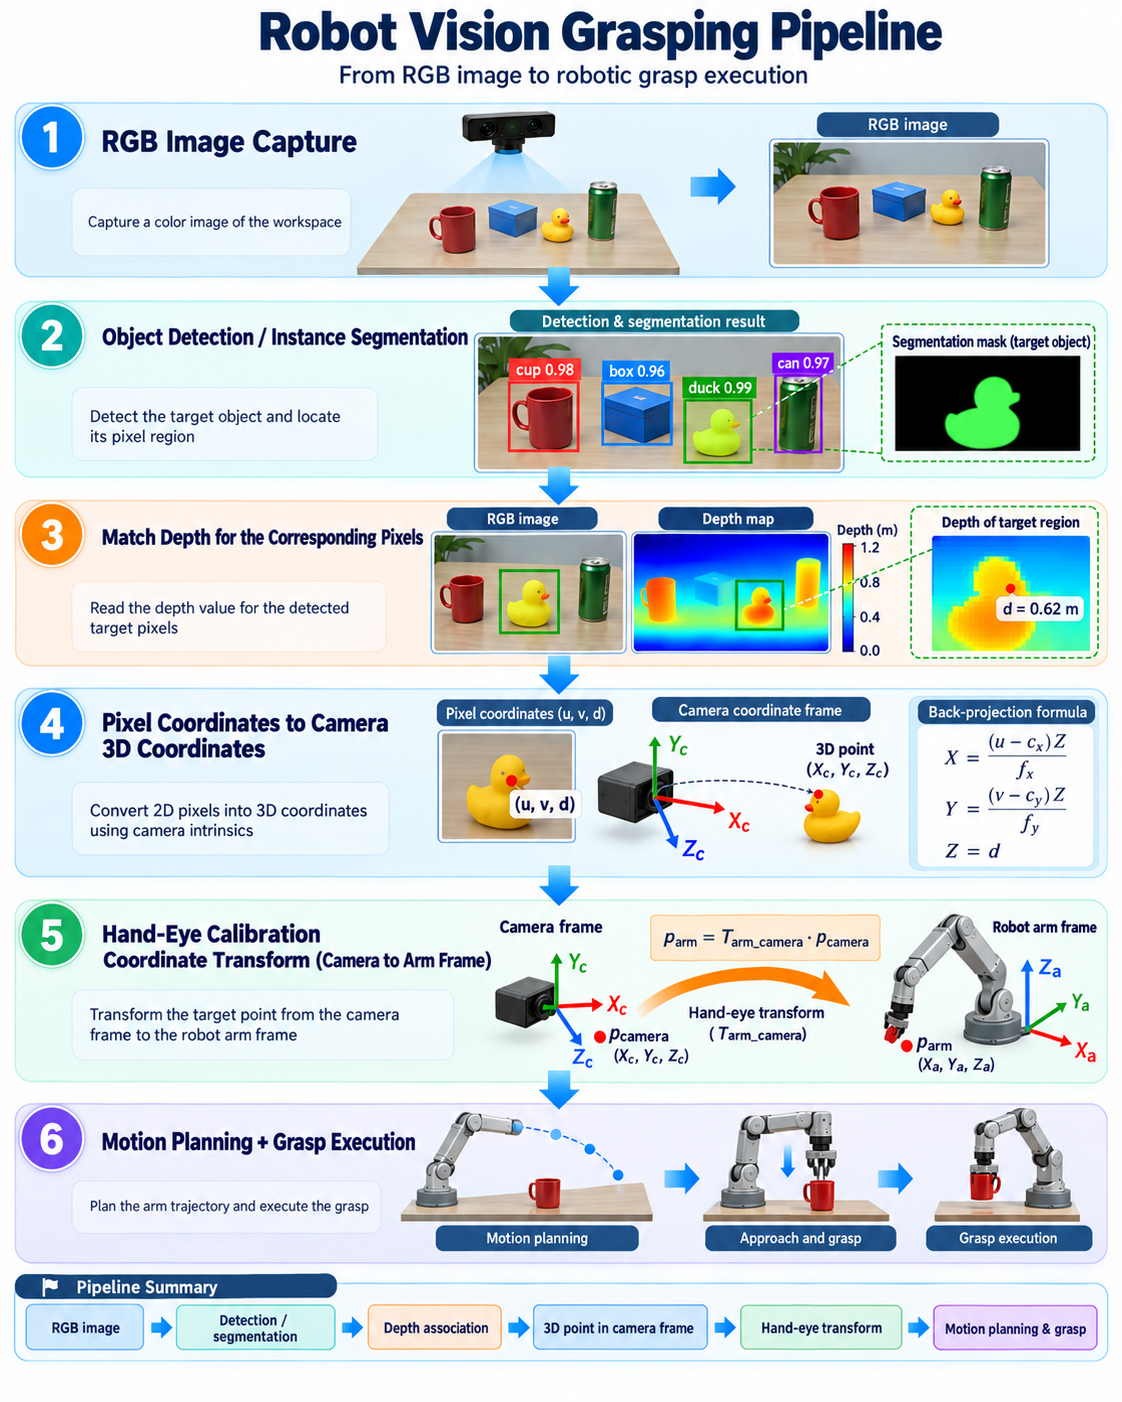
Por lo tanto, la visión robótica debe completar un proceso completo:
27.2 Introducción a los sistemas de visión robótica
Qué es la visión robótica
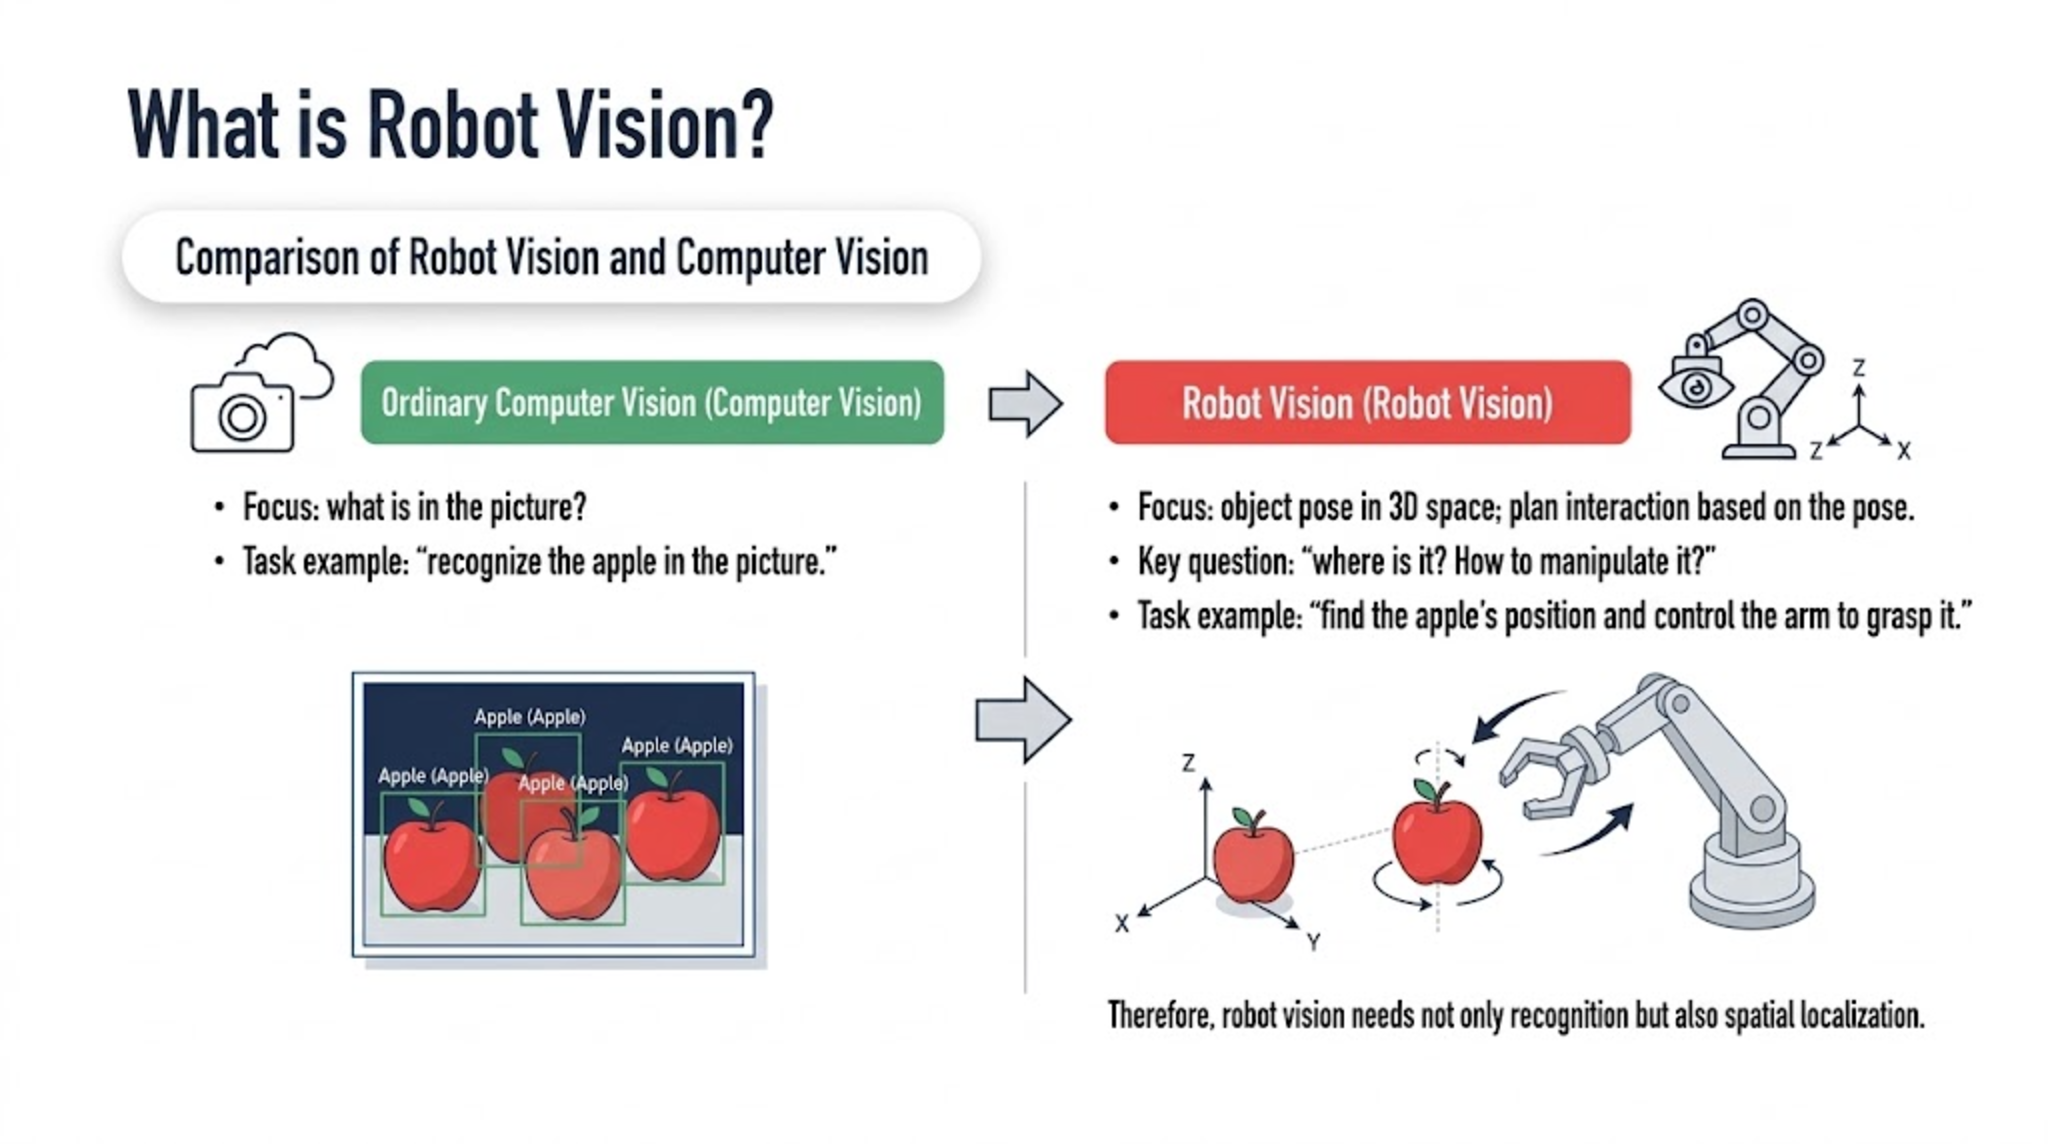
Visión robótica significa que el robot utiliza cámaras y otros sensores para adquirir información del entorno y la entiende mediante algoritmos, para así completar tareas como localización, reconocimiento y agarre. A diferencia de la visión por computador ordinaria:
- La visión por computador ordinaria pregunta: ¿qué hay en la imagen?
- La visión robótica se centra en dos problemas: la pose del objeto en el espacio 3D y planificar la acción del robot desde esa pose para completar la interacción; es decir, ¿dónde está esta cosa? ¿Cómo debería el robot manipularla?
Por ejemplo:
- Tarea de visión por computador: "reconocer la manzana en la imagen".
- Tarea de visión robótica: "encontrar la posición de la manzana y controlar el brazo para agarrarla".
Así que la visión robótica necesita no solo reconocimiento, sino también localización espacial.
Canalización de agarre visual del brazo
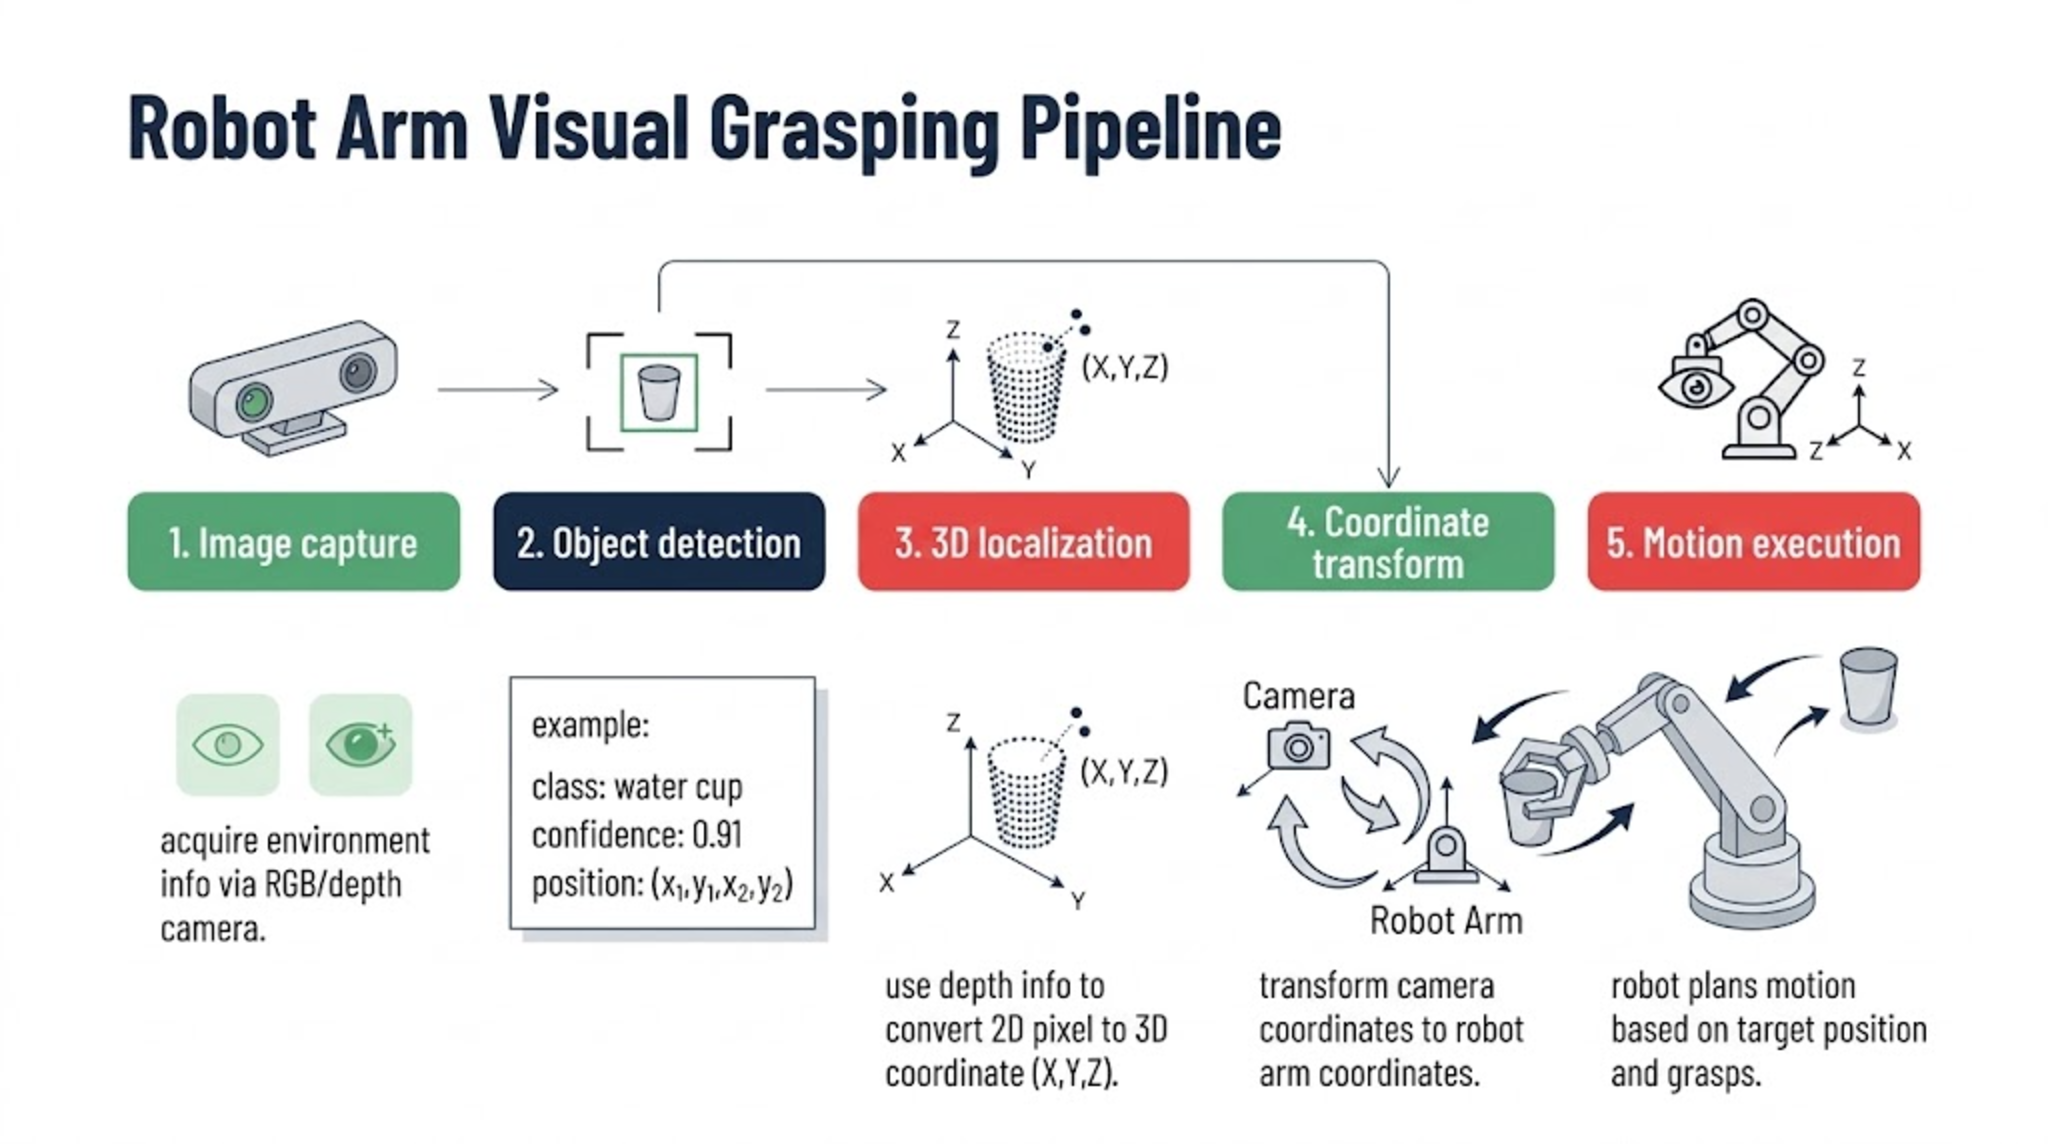
Un sistema completo de agarre visual suele incluir:
- Paso 1: Captura de imagen
- Adquirir información del entorno mediante una cámara RGB o de profundidad.
- Paso 2: Detección de objetos
- Encontrar el objeto objetivo, clasificarlo, obtener su posición
- Por ejemplo:
- Clase: vaso de agua
- Confianza: 0.91
- Posición: (x1,y1,x2,y2)
- Paso 3: Localización 3D
- Usar información de profundidad para convertir píxeles 2D en coordenadas 3D.
- Paso 4: Transformación de coordenadas
- Convertir coordenadas de cámara en coordenadas del brazo.
- Paso 5: Ejecución del movimiento
- El robot planifica el movimiento desde la posición objetivo y realiza el agarre.
Imágenes RGB y detección de objetos
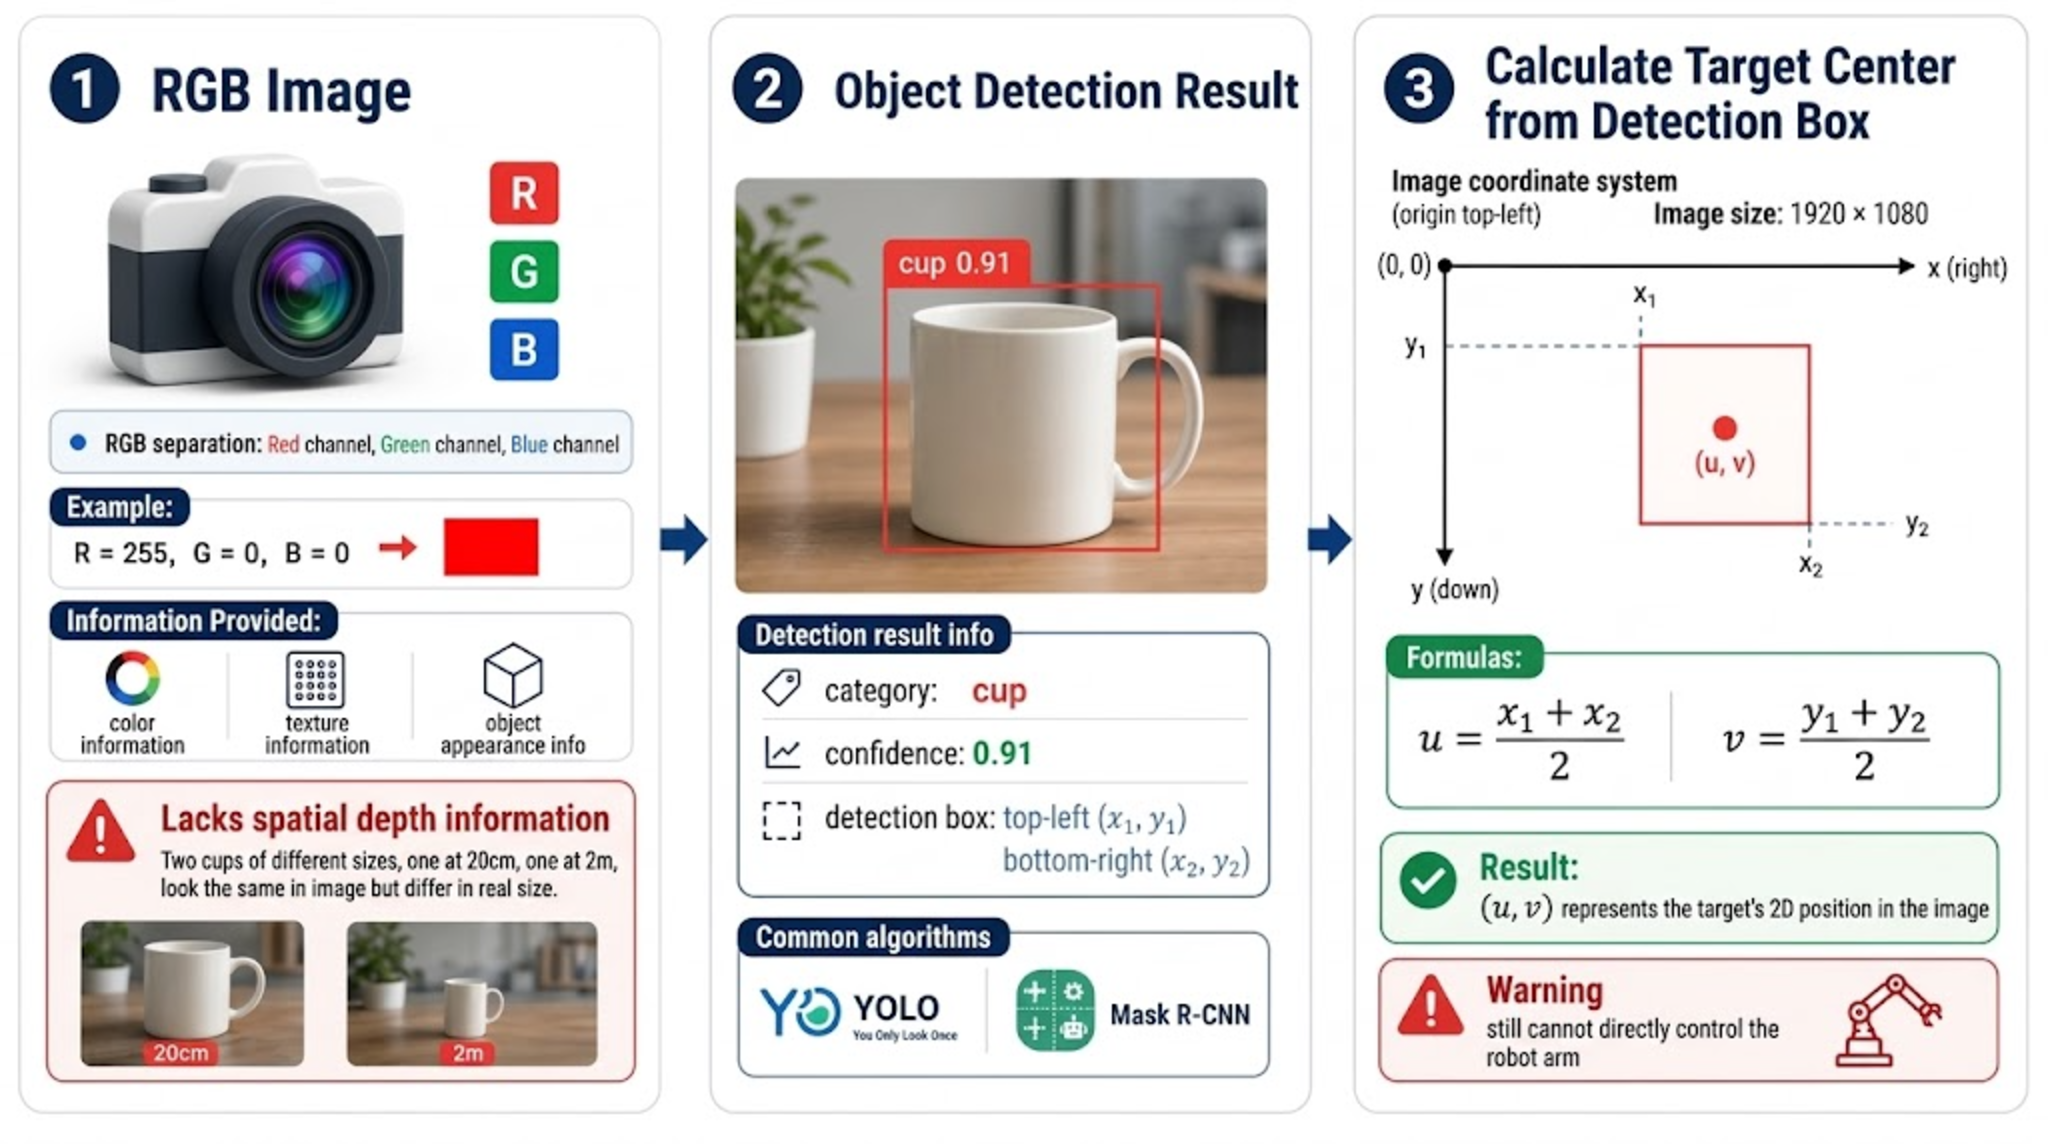
(1) Imágenes RGB
Las imágenes RGB son los datos visuales más comunes utilizados por los robots. RGB significa:
- R: Rojo
- G: Verde
- B: Azul
Cada píxel se compone de tres valores: , , .
Las imágenes RGB proporcionan principalmente: información de color, información de textura, información de apariencia del objeto. Pero las imágenes RGB tienen un problema importante: carecen de información de distancia espacial.
- Por ejemplo: dos tazas, una a 20 cm de la cámara, otra a 2 m. Si son del mismo tamaño, pueden verse muy similares en una imagen 2D. RGB solo puede decirle al robot "dónde está la taza en la imagen", pero no "a qué distancia está la taza de mí".
(2) Resultados de detección de objetos
El robot normalmente no utiliza directamente la imagen completa; primero ejecuta detección de objetos.
Los algoritmos de detección (YOLO, Mask R-CNN) producen:
| Campo | Significado |
|---|---|
| Class | cup — se detectó una taza |
| Confidence | 0.91 — el modelo está seguro al 91% de esa clase |
| Bounding box | Esquina superior izquierda (x1, y1), esquina inferior derecha (x2, y2) |
(3) Cálculo del centro del objetivo a partir de la caja
El robot normalmente necesita el centro del objetivo. La imagen que ve el ordenador es esencialmente una cuadrícula de píxeles. Para una imagen de 1920x1080, cada píxel tiene su propia coordenada: esquina superior izquierda (0,0), esquina inferior derecha (1920,1080); x aumenta hacia la derecha, y aumenta hacia abajo. Así que la salida de detección (u,v) son esencialmente coordenadas de imagen. Se calcula:
Resultado: (u,v). Este punto es la posición 2D del objetivo en la imagen. Pero aún no puede controlar directamente el brazo.
27.3 Por qué los robots necesitan información de profundidad
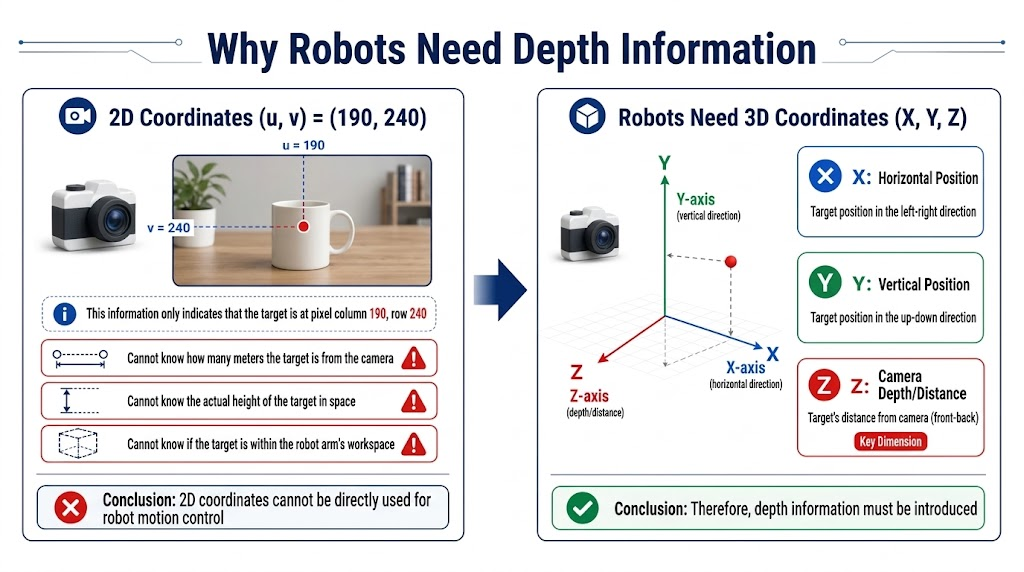
Supongamos que el centro del objetivo es:
(u,v)=(190,240)
Esto solo dice: el objetivo está en la columna 190, fila 240 de la imagen.
Pero el robot no sabe: a qué distancia está el objetivo de la cámara; su altura en el espacio; si está dentro del espacio de trabajo del brazo. Así que: las coordenadas 2D no pueden impulsar directamente el movimiento del robot.
El robot necesita las coordenadas 3D del objeto: x, posición horizontal; Y, posición vertical; Z, profundidad desde la cámara. Por lo tanto, se necesita información de profundidad.
27.4 Mapas de profundidad y datos RGB-D
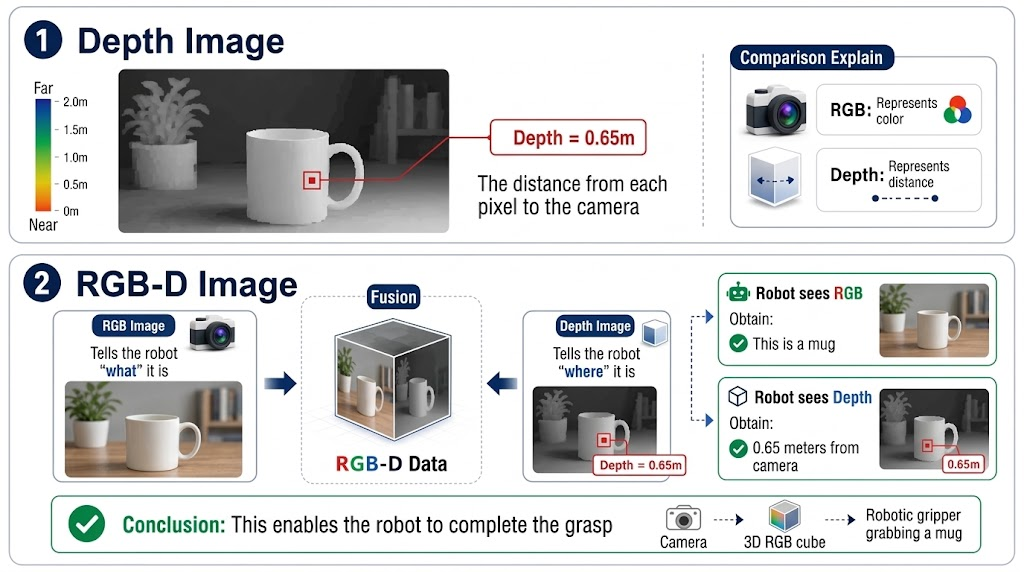
Mapa de profundidad
Un mapa de profundidad representa: la distancia de cada píxel a la cámara.
Por ejemplo: algún píxel, Depth=0.65 m.
Significado: esa ubicación está a unos 65 cm de la cámara. A diferencia de RGB (que representa color), Depth representa distancia.
Imagen RGB-D
Fusionar la imagen RGB y la imagen de profundidad para obtener datos RGB-D. RGB-D contiene:
- Parte RGB: le dice al robot "qué es"
- Parte de profundidad: le dice al robot "dónde está"
Por ejemplo:
- El robot ve la imagen RGB y aprende que esto es una taza; ve la imagen de profundidad y aprende que la taza está a 0.65 m de la cámara. Solo entonces el robot puede agarrarla.
27.5 Principios de las cámaras de profundidad
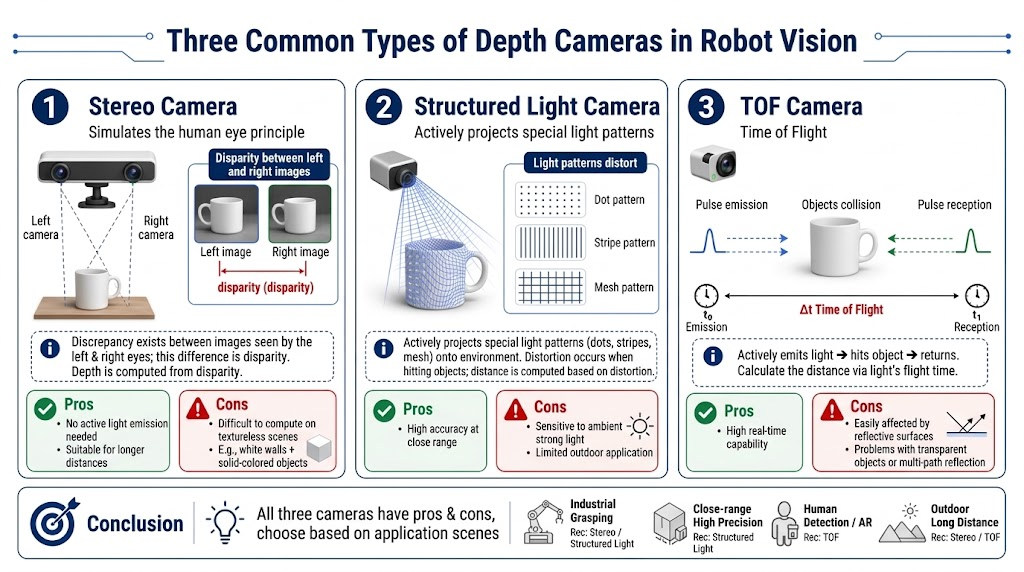
Las tres cámaras de profundidad comunes en visión robótica son cámaras estéreo, cámaras de luz estructurada y cámaras TOF.
| Cámara | Principio | Ventajas | Desventajas |
|---|---|---|---|
| Estéreo | Imita los ojos humanos: dos cámaras comparan dónde aparece el mismo objeto en la vista izquierda y derecha, y la profundidad se obtiene a partir de esa disparidad | No necesita iluminación activa; funciona a mayor distancia | Falla en objetos sin textura: una pared blanca y un objeto de color sólido se ven casi idénticos para ambas cámaras |
| Luz estructurada | Proyecta activamente un patrón conocido (matriz de puntos, franjas, rejilla) y lee cómo se deforma el patrón sobre el objeto | Alta precisión a corta distancia | Se ve afectada fácilmente por luz intensa y condiciones en exteriores |
| TOF (Time Of Flight) | Emite luz, espera la reflexión y mide el tiempo de ida y vuelta | Alto rendimiento en tiempo real | Afectada por superficies reflectantes, objetos transparentes y reflexión multitrayectoria |
27.6 Modelo de coordenadas de cámara y parámetros intrínsecos
Sistemas de coordenadas
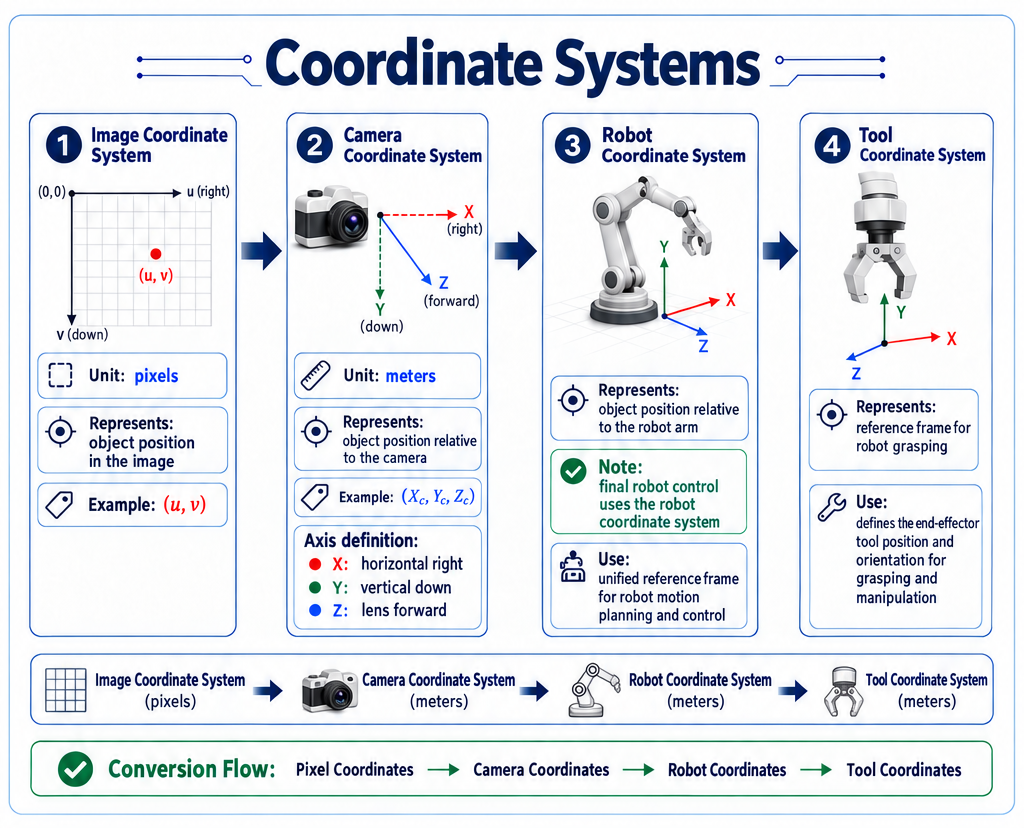
La visión robótica implica cuatro marcos de coordenadas:
| Marco | Unidad | Significado | Ejemplo |
|---|---|---|---|
| Marco de imagen | Píxeles | Dónde está el objeto en la imagen | (u, v) |
| Marco de cámara | Metros | Dónde está el objeto con respecto a la cámara | (Xc, Yc, Zc) — X hacia la derecha, Y hacia abajo, Z hacia fuera de la lente |
| Marco del robot | Metros | Dónde está el objeto con respecto al brazo; el brazo se controla finalmente en coordenadas del robot | — |
| Marco de herramienta (marco del efector final) | Metros | El marco que usa el brazo para ejecutar una sujeción | — |
Parámetros intrínsecos de la cámara
¿Por qué se necesitan los parámetros intrínsecos?
- Porque una imagen 2D no es el espacio real. La cámara proyecta el espacio 3D en una imagen 2D; esto se llama proyección, y los parámetros intrínsecos describen esa proyección. Con los intrínsecos puedes calcular a la inversa los píxeles 2D de vuelta al espacio 3D; es decir, los intrínsecos describen cómo la cámara forma una imagen.
| Parámetro | Significado |
|---|---|
fx, fy | Longitud focal en x e y (píxeles) |
cx, cy | Punto principal en x e y — el centro de la imagen (píxeles) |
k1, k2, k3, p1, p2 | Coeficientes de distorsión |
- La distorsión de la lente desplaza las posiciones de los píxeles cerca de los bordes de la imagen. Sin corrección de distorsión, las propias coordenadas de píxel (u,v) tienen error y la conversión 3D se desvía. En la práctica, primero corrige la distorsión de la imagen y luego usa las coordenadas de píxel.
27.7 Conversión de píxeles a coordenadas 3D
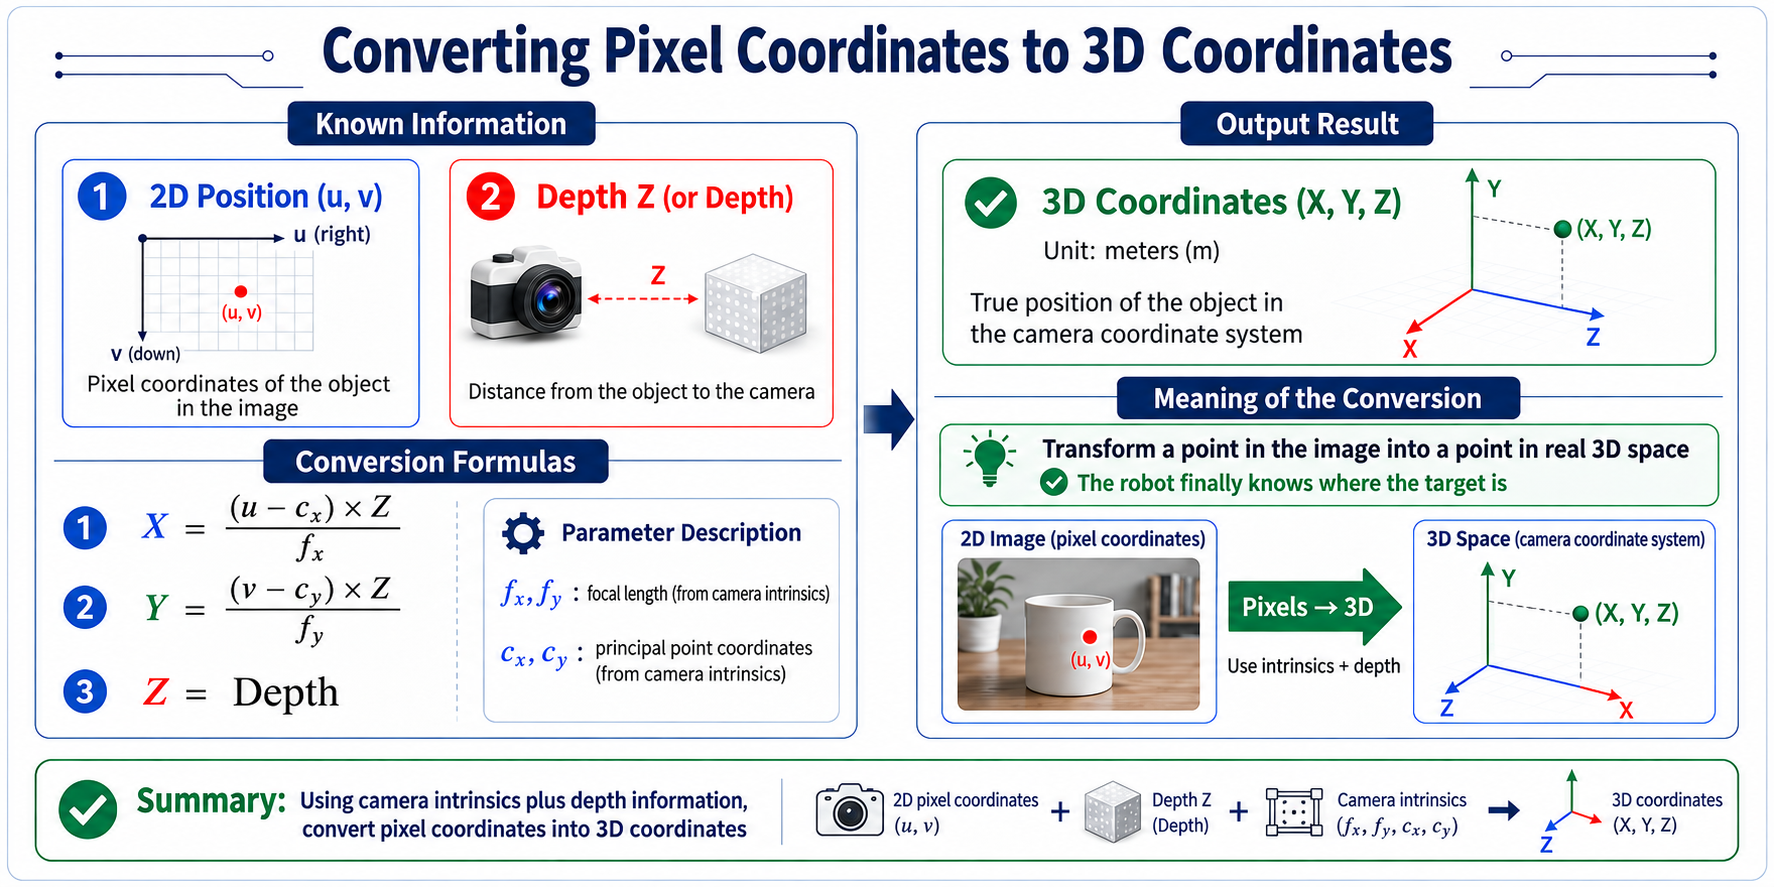
Dada la siguiente información sobre el objeto:
- Posición 2D: (u,v)
- Profundidad: Z
Usando los parámetros intrínsecos, obtén del objeto:
- (X,Y,Z)
Fórmulas:
Significado: convertir un punto en la imagen en un punto en el espacio real, para que el robot finalmente sepa dónde está el objetivo.
27.8 Parámetros extrínsecos de la cámara y transformación de coordenadas
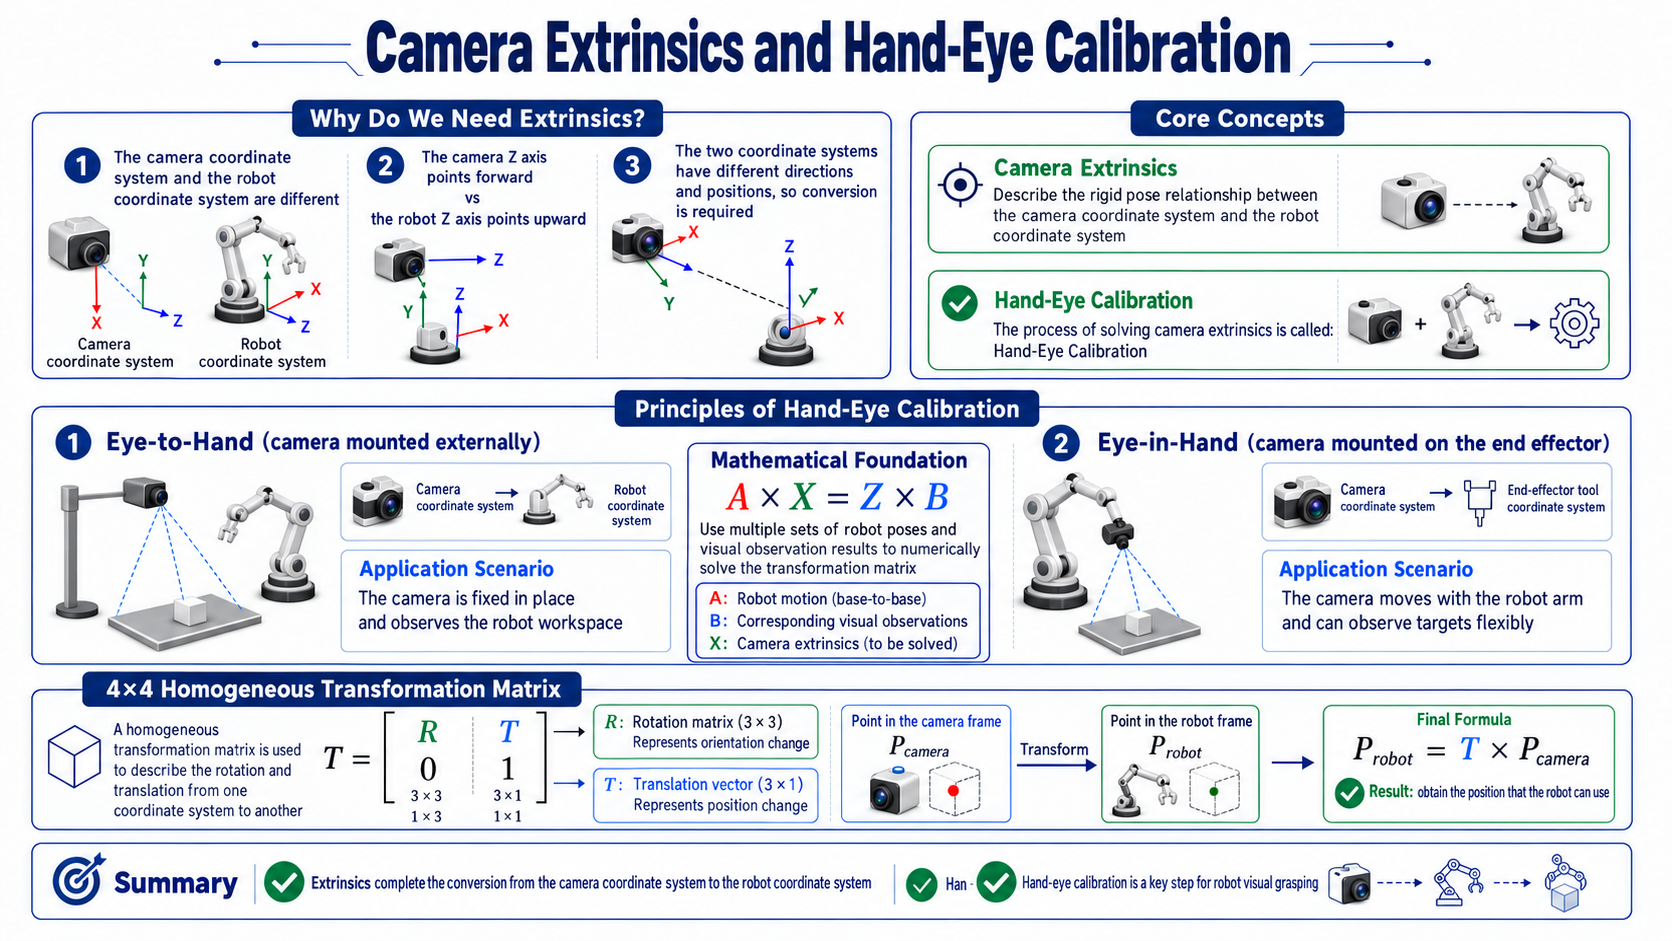
¿Por qué se necesitan los parámetros extrínsecos?
- Porque el marco de la cámara y el marco del robot son diferentes. Por ejemplo, el eje Z de la cámara apunta hacia adelante, mientras que el eje Z del robot apunta hacia arriba. Los dos marcos difieren tanto en orientación como en posición, por lo que se necesita una transformación. Los parámetros extrínsecos de la cámara describen la relación de pose de cuerpo rígido entre el marco de la cámara y el marco del robot; resolverlos se llama calibración mano-ojo.
Principios de la calibración mano-ojo
- Eye-to-Hand: resolver la transformación del marco de la cámara al marco base del brazo
- Eye-in-Hand: resolver la transformación del marco de la cámara al marco de la herramienta en el extremo del brazo
- La base matemática es : recopilando múltiples pares de poses del brazo y observaciones visuales, se resuelve numéricamente la transformación X.
Matriz de calibración
Error de calibración y punto de sujeción, transformación homogénea X
- Los robots suelen usar una matriz 4x4 para representar transformaciones de coordenadas.
- La matriz contiene:
- Matriz de rotación R, que representa el cambio de orientación.
- Vector de traslación T, que representa el cambio de posición.
- Finalmente: , dando la posición que el robot puede usar.
27.9 Nubes de puntos
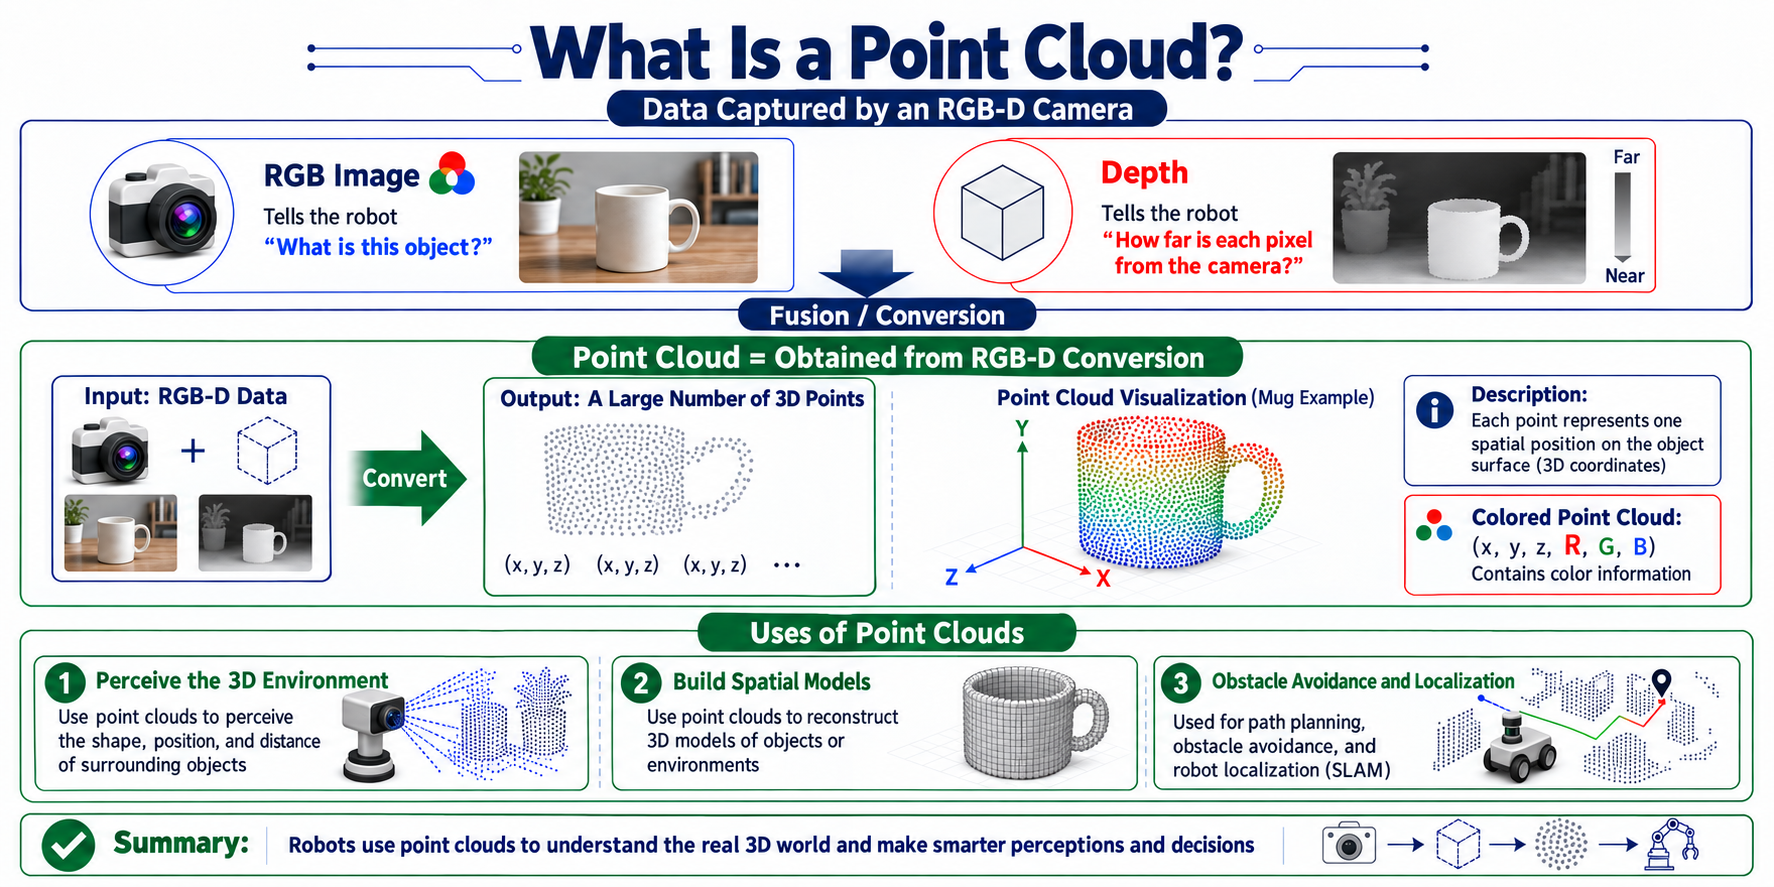
¿Qué es una nube de puntos?
- Los datos de una cámara RGB-D normalmente incluyen
- Imagen RGB: le dice al robot qué es este objeto
- Profundidad: le dice al robot a qué distancia está cada píxel de la cámara
- Se obtiene una nube de puntos convirtiendo RGB-D:
Usos de las nubes de puntos
- Los robots pueden usar nubes de puntos para percibir el entorno 3D, construir modelos espaciales, evitar obstáculos y localizarse.