28. Detección de Objetos y Calibración Mano-Ojo
Capítulo 28 del Curso de Introducción a la IA Física de Seeed — detección de objetos y calibración mano-ojo: taxonomía de tareas de visión, YOLO y detección de vocabulario abierto, cajas delimitadoras orientadas, NMS y mAP, marcadores ArUco con solvePnP, calibración mano-ojo AX = XB y estimación de pose de agarre 6-DoF con GraspNet.
28.1 Resumen del Capítulo
En el último capítulo aprendimos el flujo básico de la visión robótica: entorno -> captura de la cámara -> imagen 2D -> información de profundidad -> coordenadas espaciales 3D -> coordenadas del robot, pero no profundizamos en los principios algorítmicos ni en los detalles de implementación de cada eslabón. Este capítulo baja un nivel más en cada eslabón para que el lector entienda las matemáticas y los compromisos de ingeniería detrás de los algoritmos.
En un sistema robótico real, el robot no se enfrenta a una posición objetivo ya anotada. Así que hay que resolver en profundidad cuatro preguntas clave:
- Pregunta 1: ¿Por qué el algoritmo de detección es YOLO? ¿Cómo permite YOLOE definir clases personalizadas?
- Ver: principios de algoritmos de detección de objetos (28.3)
- Pregunta 2: ¿Por qué usar ArUco en lugar de un tablero de ajedrez para la calibración de la cámara?
- Ver: principios de los marcadores ArUco (28.4)
- Pregunta 3: ¿Por qué las cámaras de profundidad activas pueden producir directamente un mapa de profundidad? ¿Cómo se alinean la profundidad y el RGB?
- Ver: principios de cámaras de profundidad activas (Capítulo 27, sección 27.5)
- Pregunta 4: ¿Cómo se estima una pose de agarre 6-DoF a partir de una imagen?
- Ver: estimación de pose de agarre 6-DoF (28.6)
- Este capítulo construye una comprensión más profunda:
- Algoritmos de detección (YOLOE / OBB) -> calibración de cámara con ArUco -> principios de cámaras de profundidad activas -> estimación de pose de agarre 6-DoF
28.2 Taxonomía de Tareas Visuales
La Cadena de Tareas en Visión Robótica
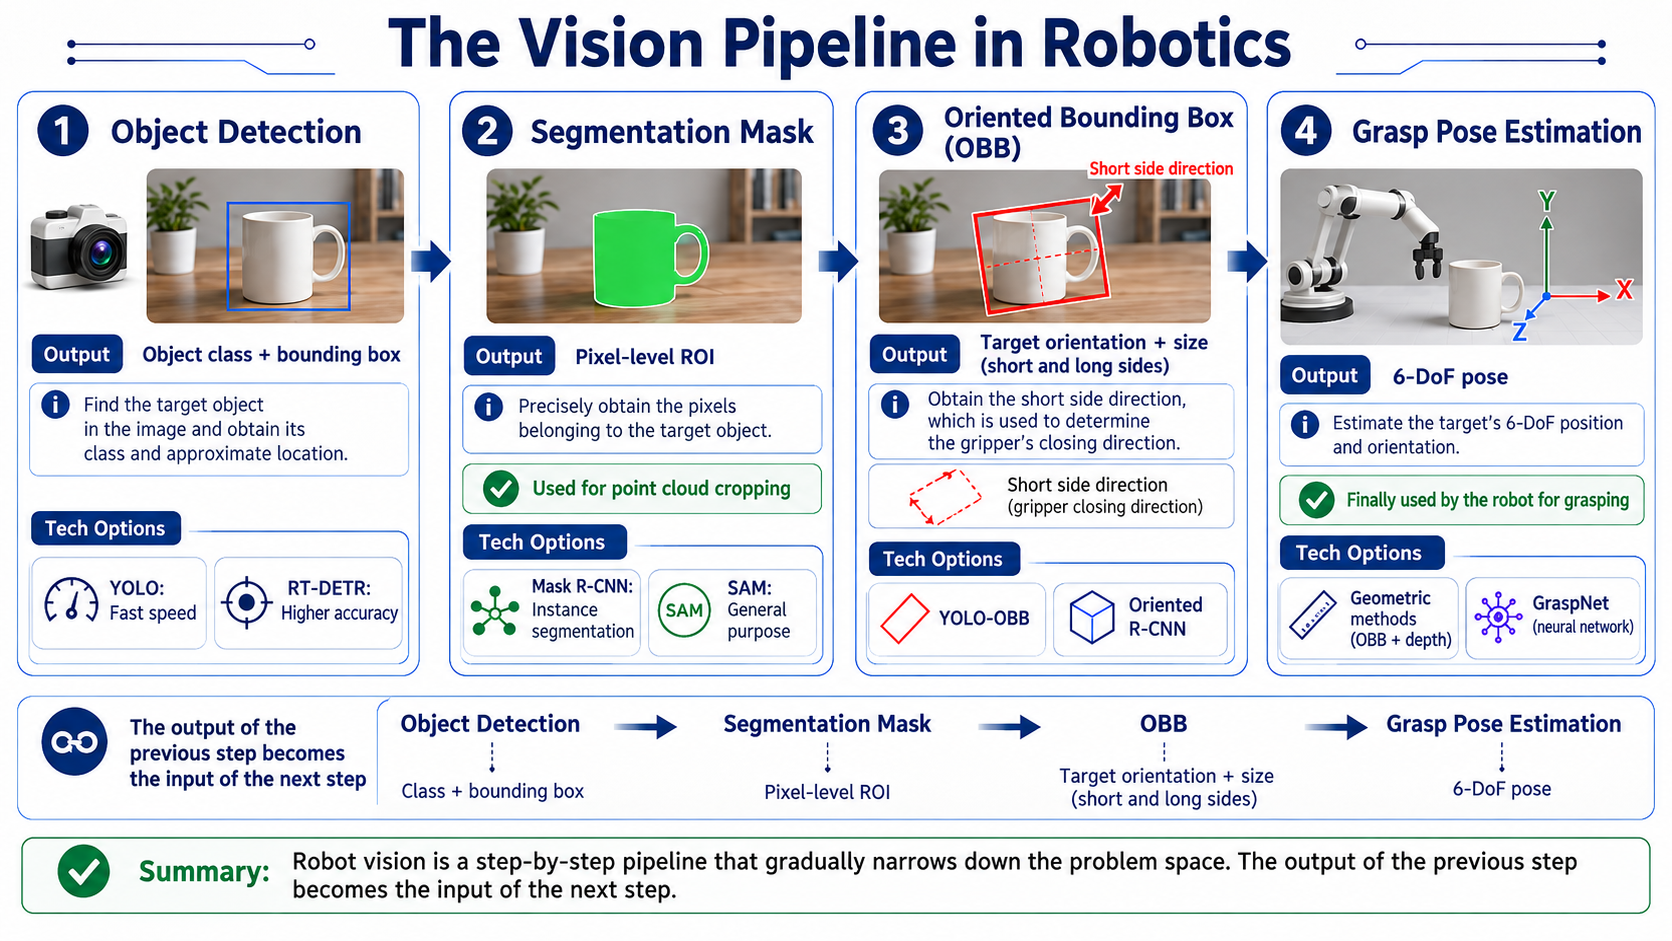
Cada etapa tiene sus propias opciones técnicas:
| Etapa | Salida | Algoritmos típicos |
|---|---|---|
| Detección de objetos | Clase + posición aproximada | YOLO (velocidad) o RT-DETR (precisión) |
| Segmentación | ROI a nivel de píxel, usada para recortar la nube de puntos | Mask R-CNN (instancia) o SAM (zero-shot) |
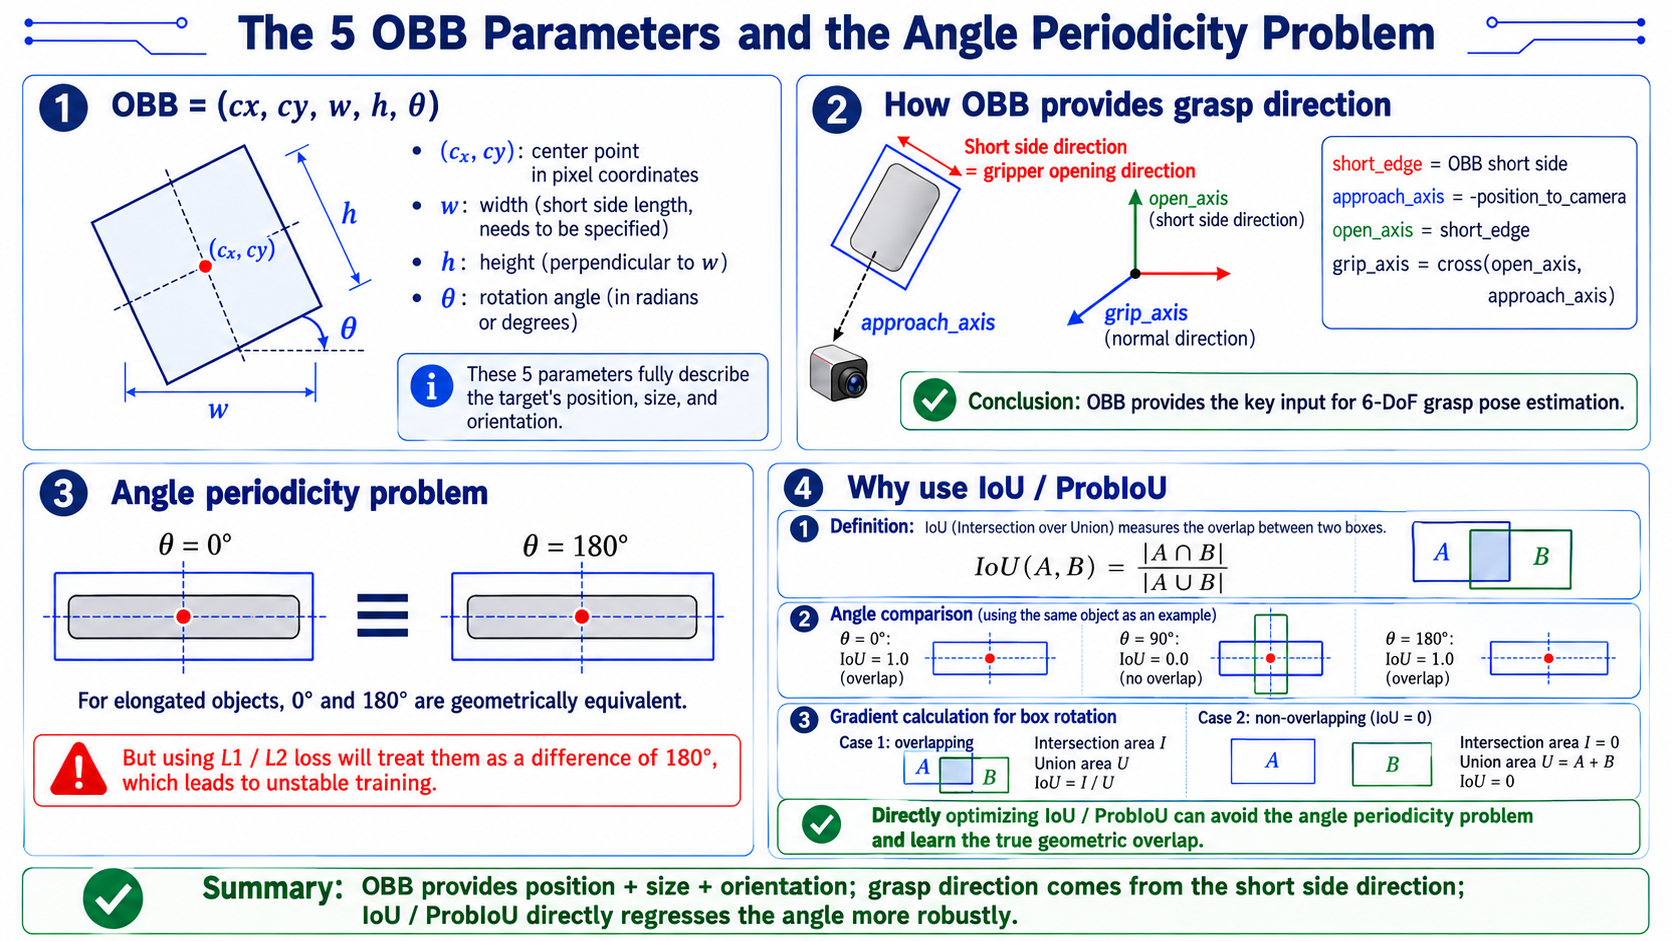
| Caja delimitadora orientada | Dirección del lado corto = dirección de apertura/cierre del efector final | YOLO-OBB u Oriented R-CNN |
| Estimación de pose de agarre | Pose 6-DoF | Método geométrico (OBB + profundidad) o GraspNet (red neuronal) |
Comparación de Cuatro Tareas Visuales
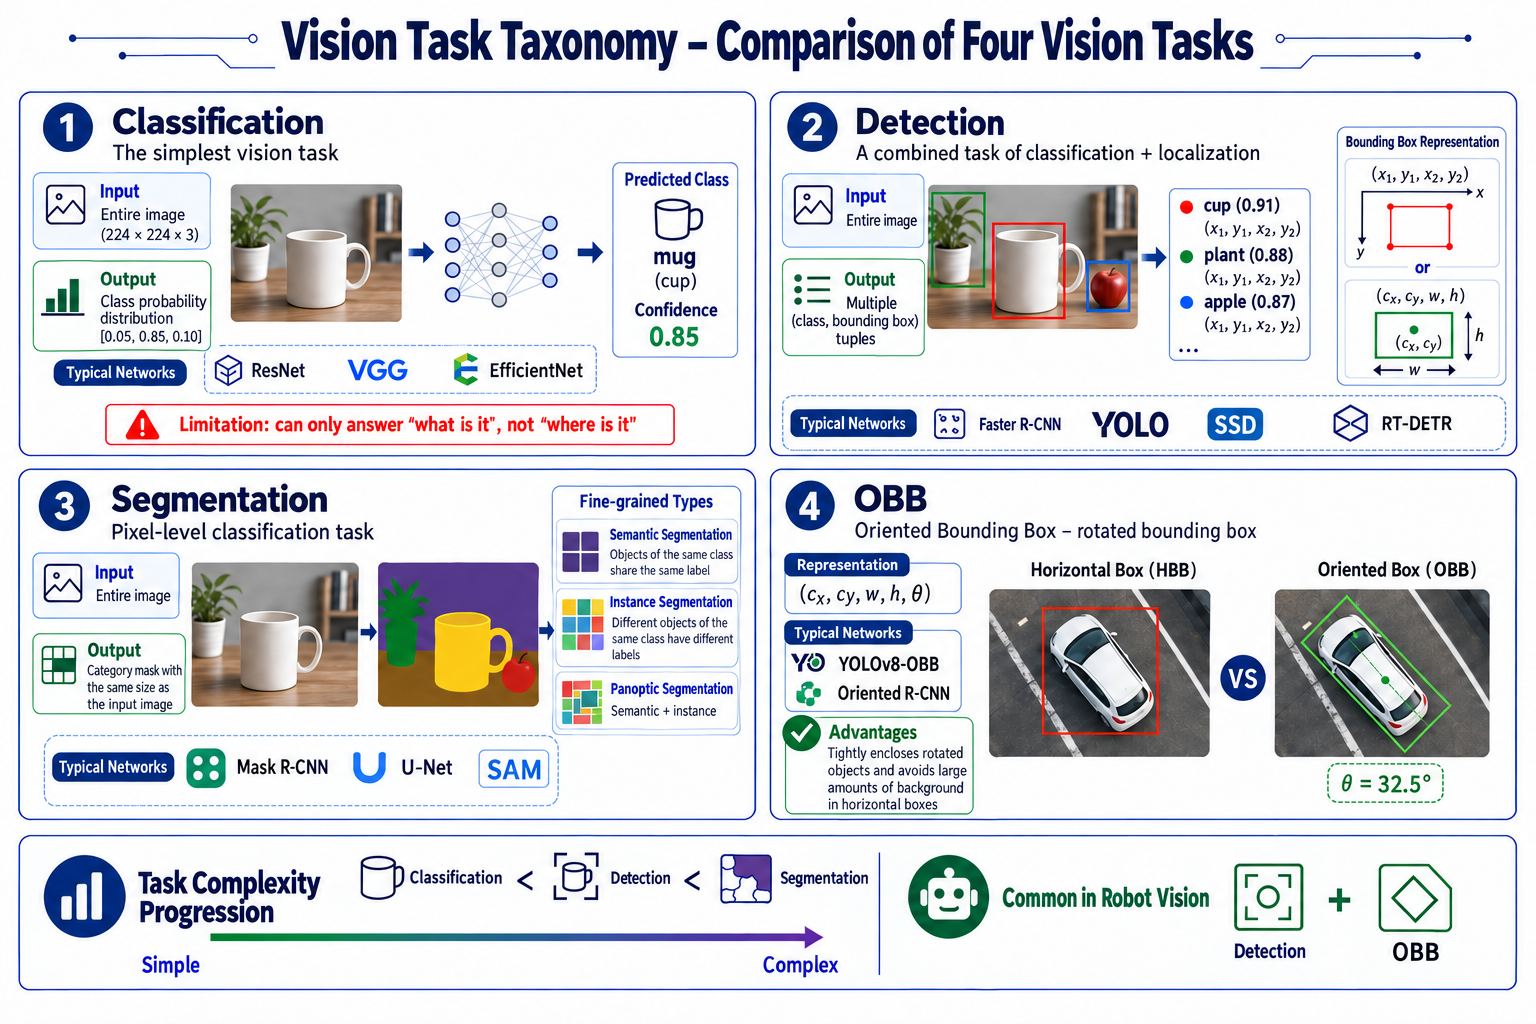
Las cuatro tareas se construyen unas sobre otras; difieren en lo que toman y en lo que devuelven:
| Tarea | Qué hace | Entrada | Salida | Redes típicas |
|---|---|---|---|---|
| Clasificación | Tarea más simple: imagen de entrada, etiqueta de clase de salida | Imagen completa (p. ej. 224x224x3) | Distribución de probabilidad de clases (p. ej. [0.05, 0.85, 0.10]) | ResNet, VGG, EfficientNet |
| Detección | Clasificación + localización | Imagen completa | Una tupla (clase, caja delimitadora) por objeto; caja como (x1, y1, x2, y2) o (cx, cy, w, h) | Faster R-CNN, YOLO, SSD, RT-DETR |
| Segmentación | Clasificación a nivel de píxel: una etiqueta de clase por píxel | Imagen completa | Una máscara de clases del mismo tamaño que la entrada | Mask R-CNN (instancia), U-Net (semántica), SAM |
| Caja delimitadora orientada (OBB) | Caja delimitadora con un ángulo de rotación | Imagen completa | (cx, cy, w, h, theta) | YOLOv8-OBB, Oriented R-CNN |
Tres cosas que vale la pena recordar: la clasificación solo puede responder "qué hay", no "dónde"; la segmentación viene en tres sabores — semántica (la misma clase comparte una etiqueta), por instancia (objetos diferentes de la misma clase obtienen etiquetas distintas) y panóptica (semántica + instancia); y la OBB abraza un objeto rotado de forma ajustada en lugar de arrastrar el fondo que incluiría una caja horizontal.
28.3 Profundizando en los Algoritmos de Detección
Por Qué YOLO para Visión Robótica en Tiempo Real
El requisito central de los algoritmos de visión robótica es el rendimiento en tiempo real. Considera un escenario típico:
- Un objeto se mueve en una cinta transportadora a 0,1 m/s; el campo de visión es de 0,5 m; el tiempo de cruce es de 5 segundos. Suponiendo un control a 20 Hz (intervalo de fotograma de 50 ms). Si la detección tarda 200 ms por fotograma (5 Hz), el robot no puede seguir el ritmo y fallará con frecuencia el agarre.
- La idea de "mirar una sola vez" de YOLO: divide la imagen en una cuadrícula SxS, cada celda de la cuadrícula predice directamente B cajas + clase y produce resultados en una sola pasada hacia adelante.
Detección de Vocabulario Abierto (YOLOE / YOLO-World)
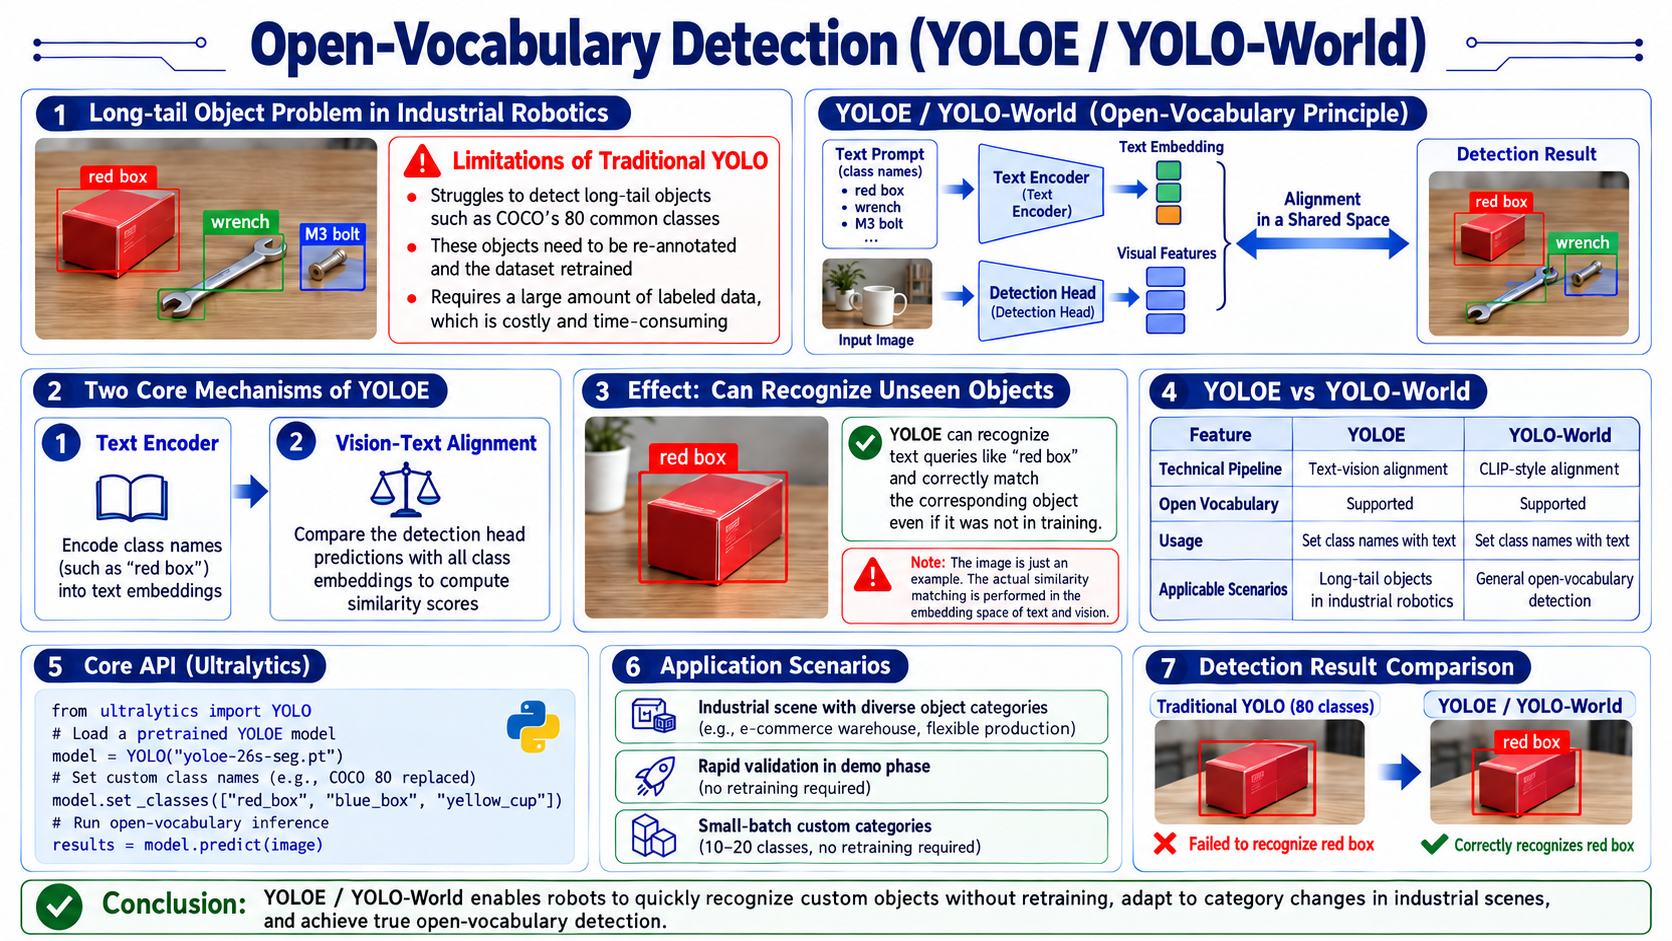
Los robots industriales a menudo se encuentran con objetos que no están cubiertos por las 80 clases de COCO: cajas de un color específico ("red box"), piezas personalizadas ("M3 bolt"), herramientas colocadas temporalmente ("wrench"). El YOLO tradicional debe reentrenarse en un conjunto de datos (cientos de anotaciones) para reconocer estos objetos, lo cual es costoso.
YOLOE (YOLO with Extended vocabulary) logra vocabulario abierto mediante dos mecanismos:
- Codificador de texto: codifica nombres de clases (p. ej. "red box") en vectores semánticos;
- Alineación visión-texto: la cabeza de detección compara las cajas predichas con todas las similitudes vector-clase.
- El codificador de texto conoce el concepto visual detrás de la frase "red box". Incluso si nunca vio una red box durante el entrenamiento, puede hacer coincidir el texto "red box" con la red box en la imagen. Ten en cuenta que realiza una coincidencia de similitud texto-visual, no una comprensión real del lenguaje; y si el codificador de texto nunca ha visto una palabra, no puede entenderla.
YOLO-World utiliza un enfoque similar
- YOLO-World utiliza una alineación imagen-texto al estilo CLIP para vocabulario abierto; su principio de funcionamiento es el mismo que el de YOLOE.
API principal
from ultralytics import YOLO

# load pretrained YOLOE model
model = YOLO("yoloe-26s-seg.pt")

# set custom classes (replace default 80)
model.set_classes(["red_box", "blue_box", "yellow_cup"])

# now the model detects only these three classes
results = model.predict(image)
Escenarios adecuados
- Escenarios con brazo robótico con muchos cambios de categoría (almacenamiento de comercio electrónico, producción flexible)
- Validación rápida de demos (probar sin entrenamiento)
- Personalización de pequeños lotes (10-20 clases, sin reentrenamiento)
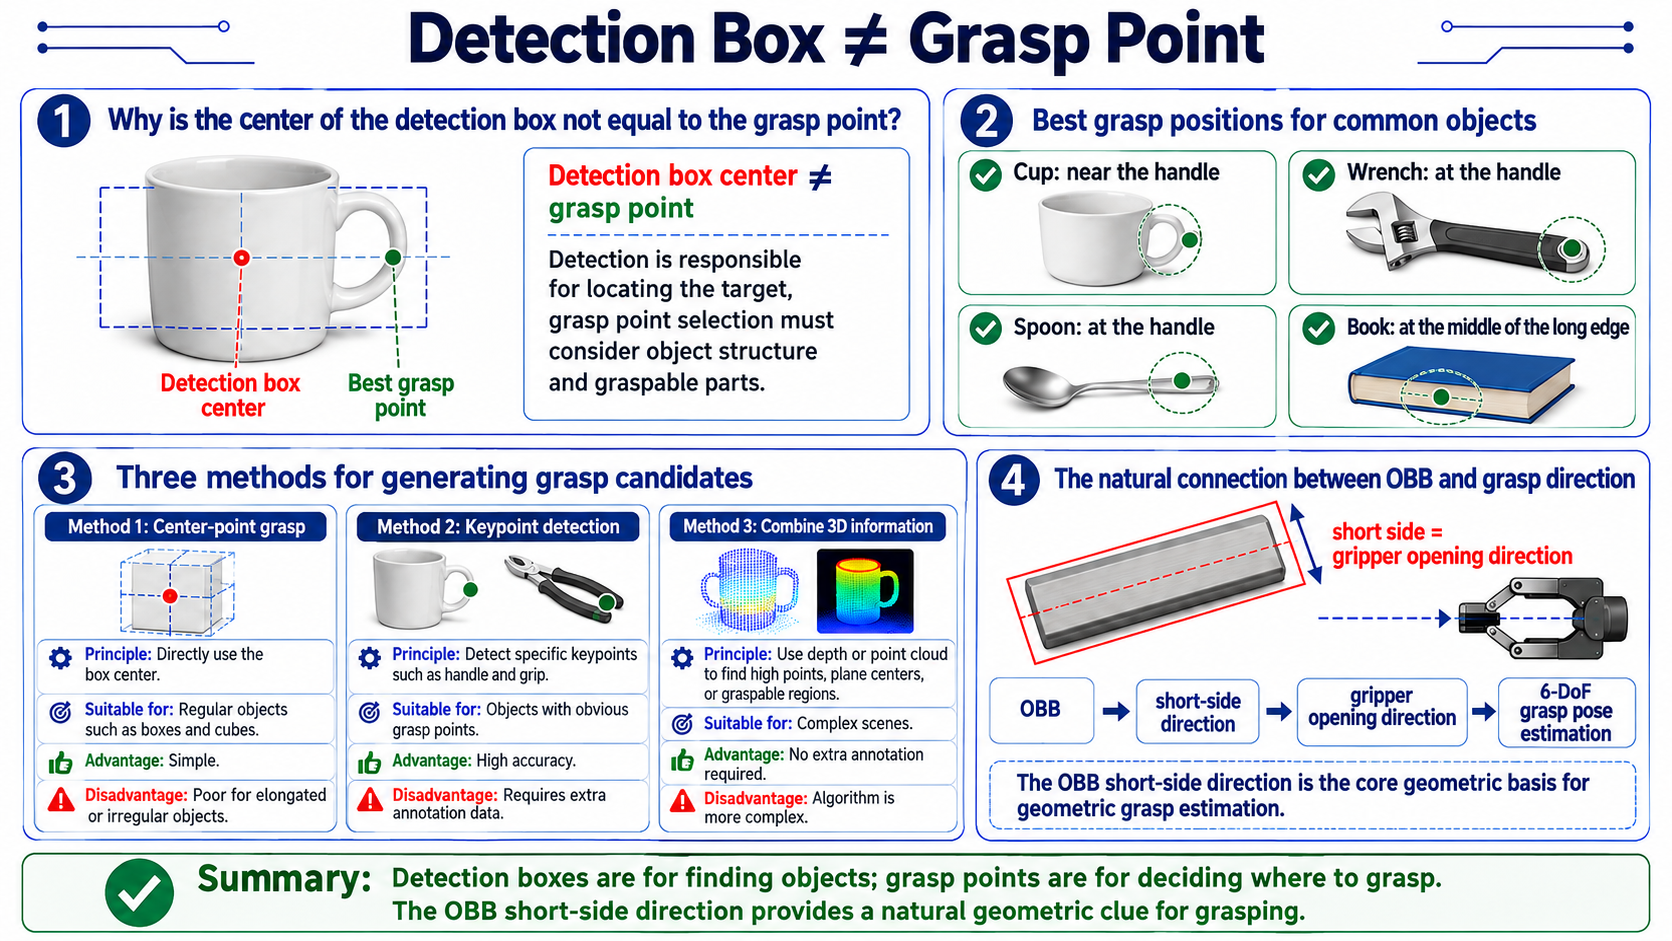
Por Qué la Visión Robótica Usa a Menudo OBB
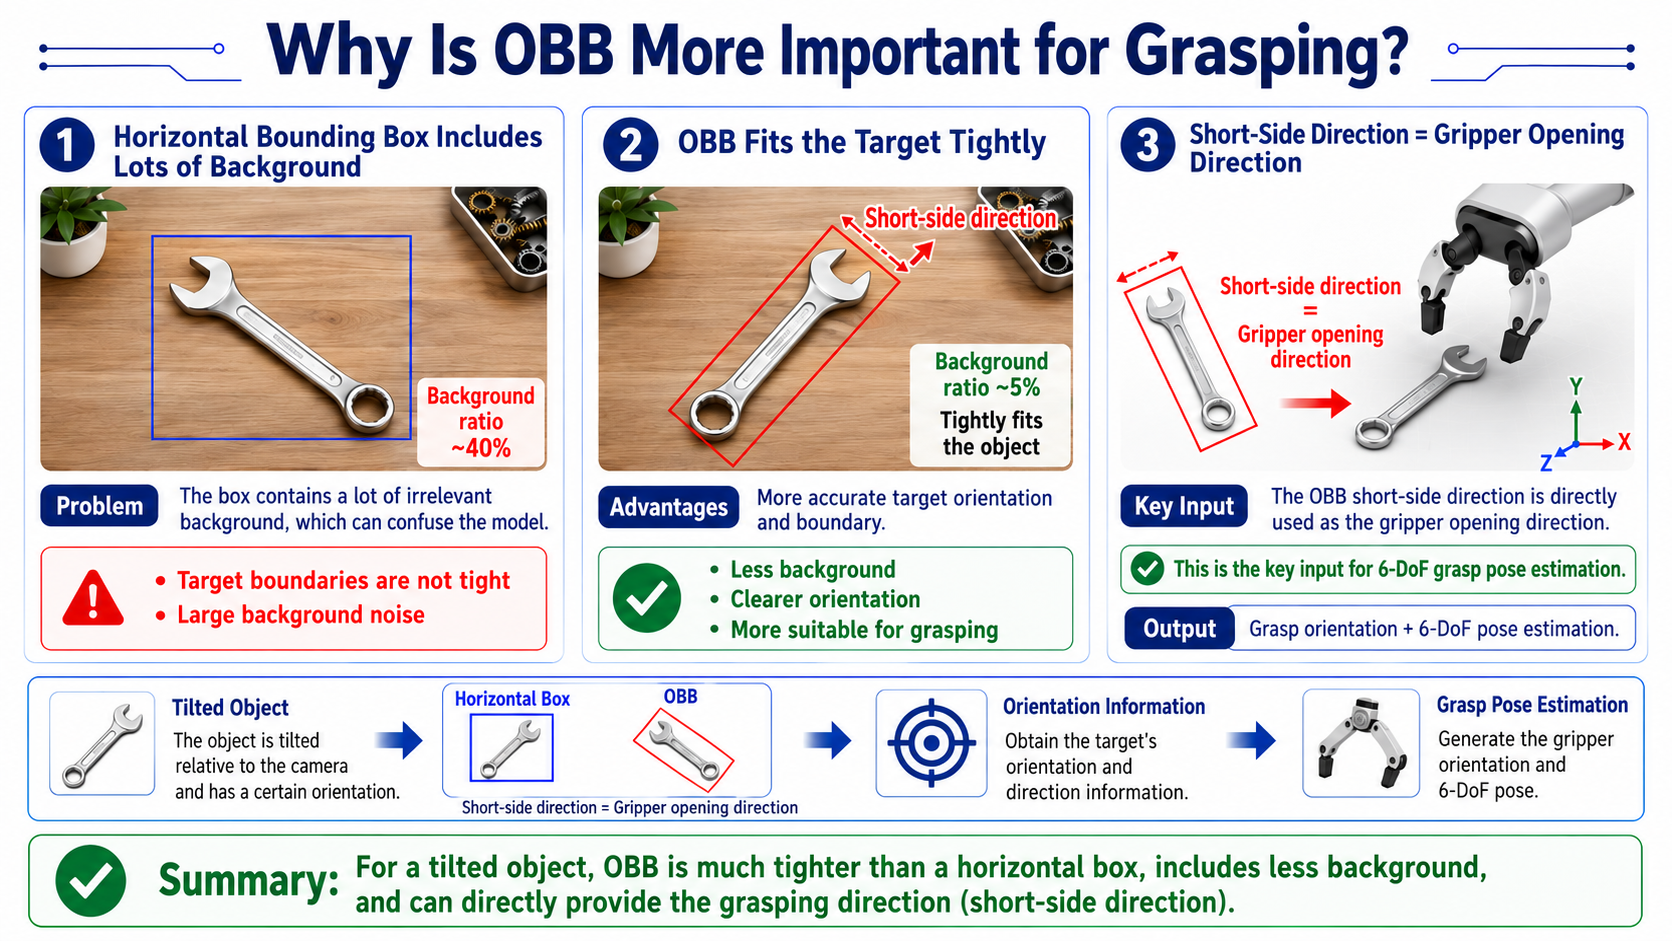
La dirección del lado corto de la OBB proporciona directamente la dirección de apertura/cierre del efector final: la entrada clave para la estimación de agarre 6-DoF posterior.
Principios de la Caja Delimitadora Orientada (OBB)
Postprocesado: NMS
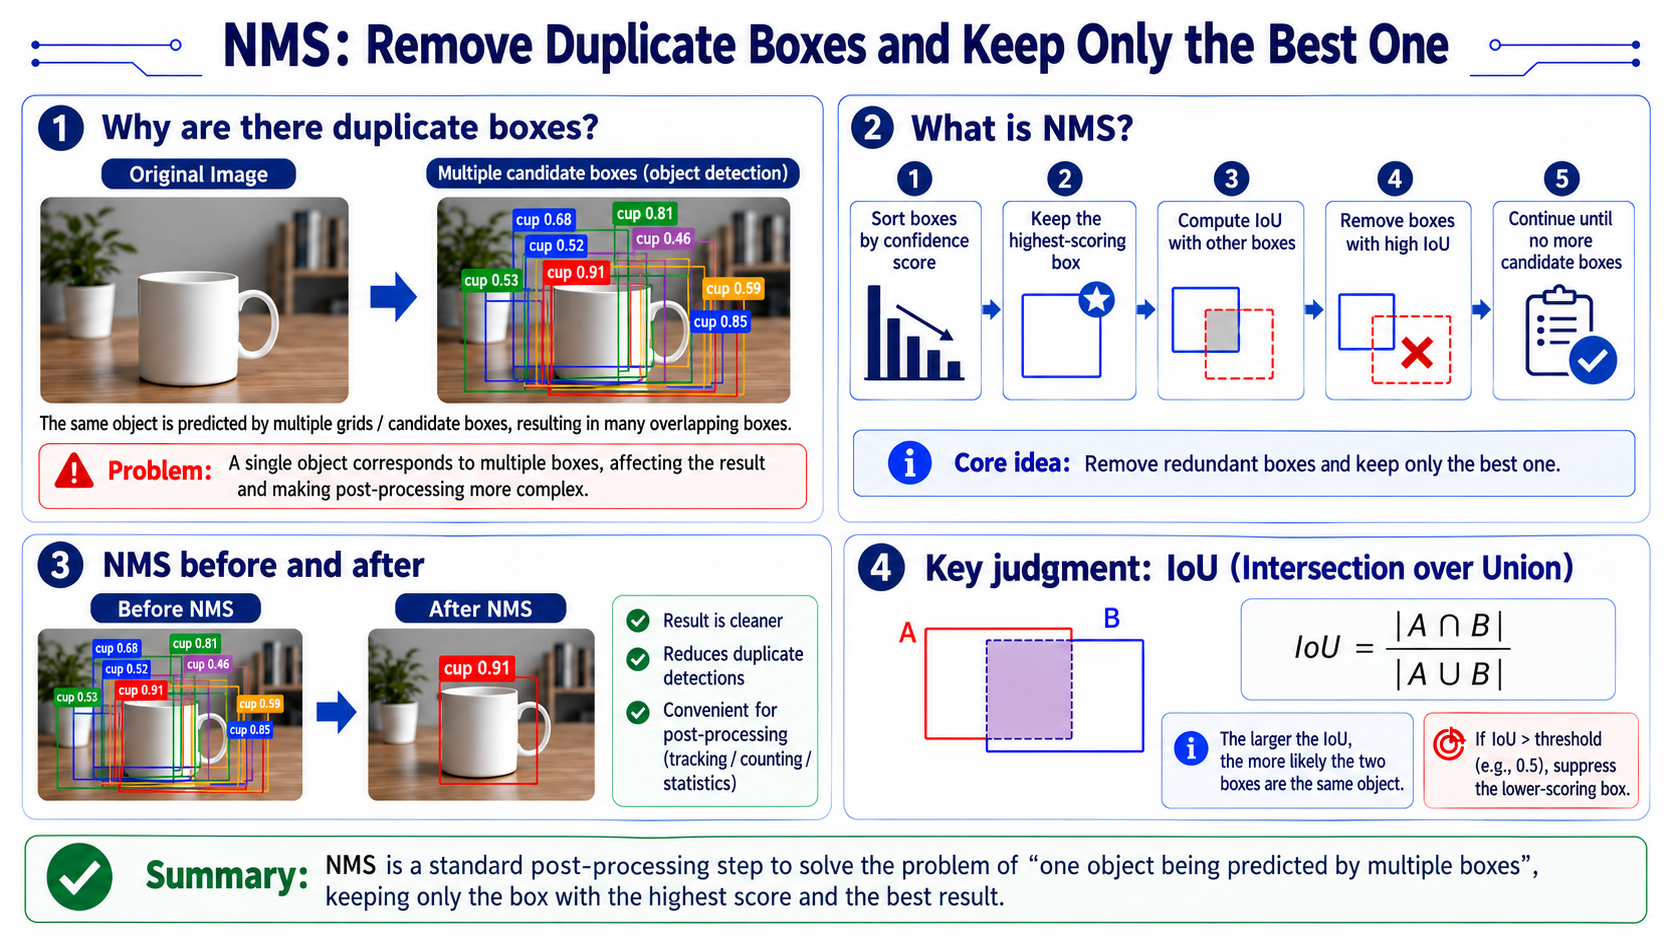
NMS es el paso estándar posterior a la detección. Después de que YOLO detecta una imagen, el mismo objeto puede ser predicho "repetidamente" por múltiples celdas de la cuadrícula como varias cajas superpuestas. NMS elimina estos duplicados, conservando solo la mejor.
-
Código de ejemplo
def nms(boxes, scores, iou_threshold):
    """
    boxes: [(x1, y1, x2, y2), ...]
    scores: [confidence, ...]
    returns: list of kept indices
    """
    # 1. sort by confidence descending
    order = sorted(range(len(scores)), key=lambda i: scores[i], reverse=True)

    keep = []
    while order:
        # 2. pick the highest-scoring box
        i = order[0]
        keep.append(i)

        # 3. compute IoU with other boxes
        rest = order[1:]
        ious = [compute_iou(boxes[i], boxes[j]) for j in rest]

        # 4. keep boxes with IoU < threshold (remove redundant)
        order = [rest[j] for j, iou in enumerate(ious) if iou < iou_threshold]

    return keep
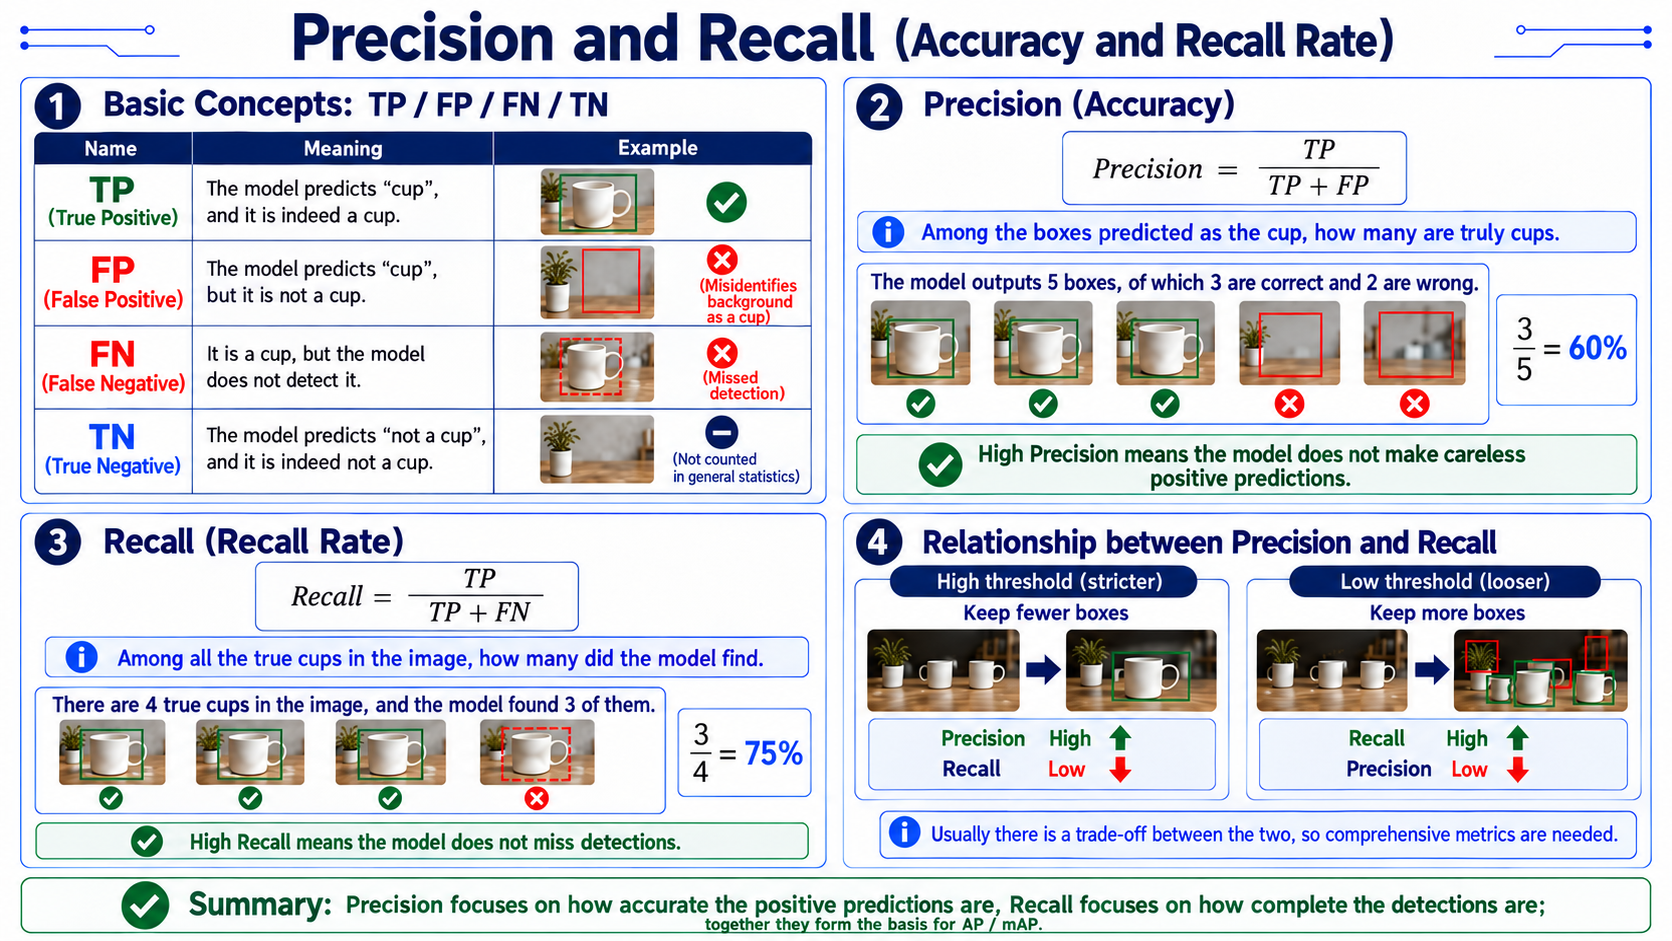
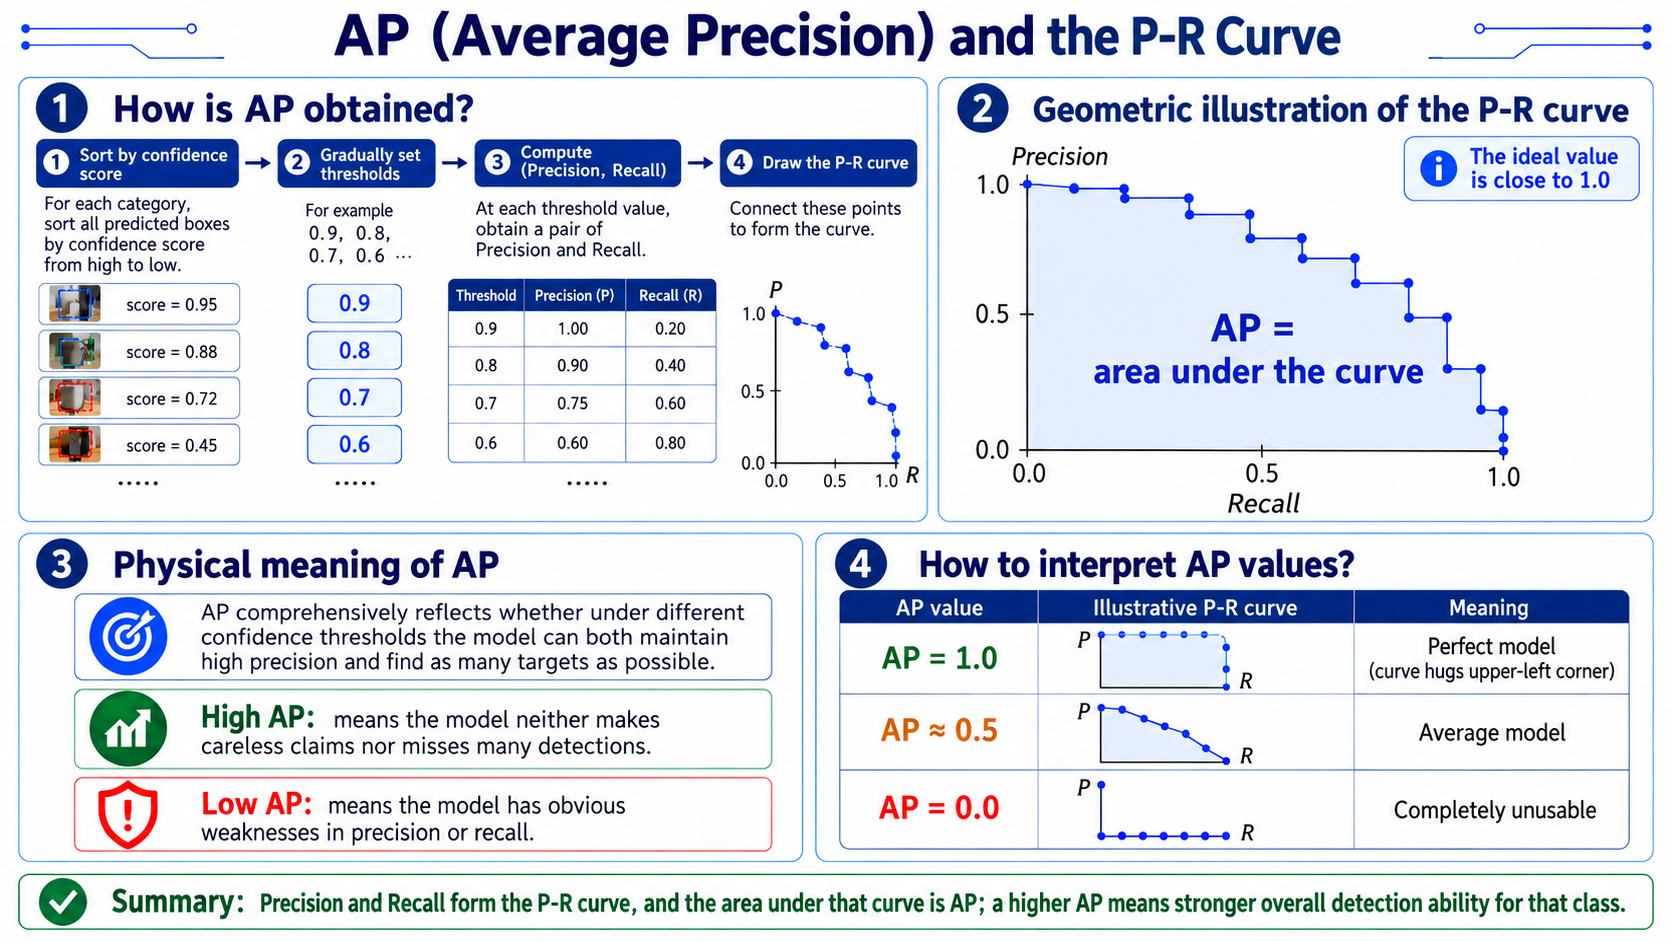
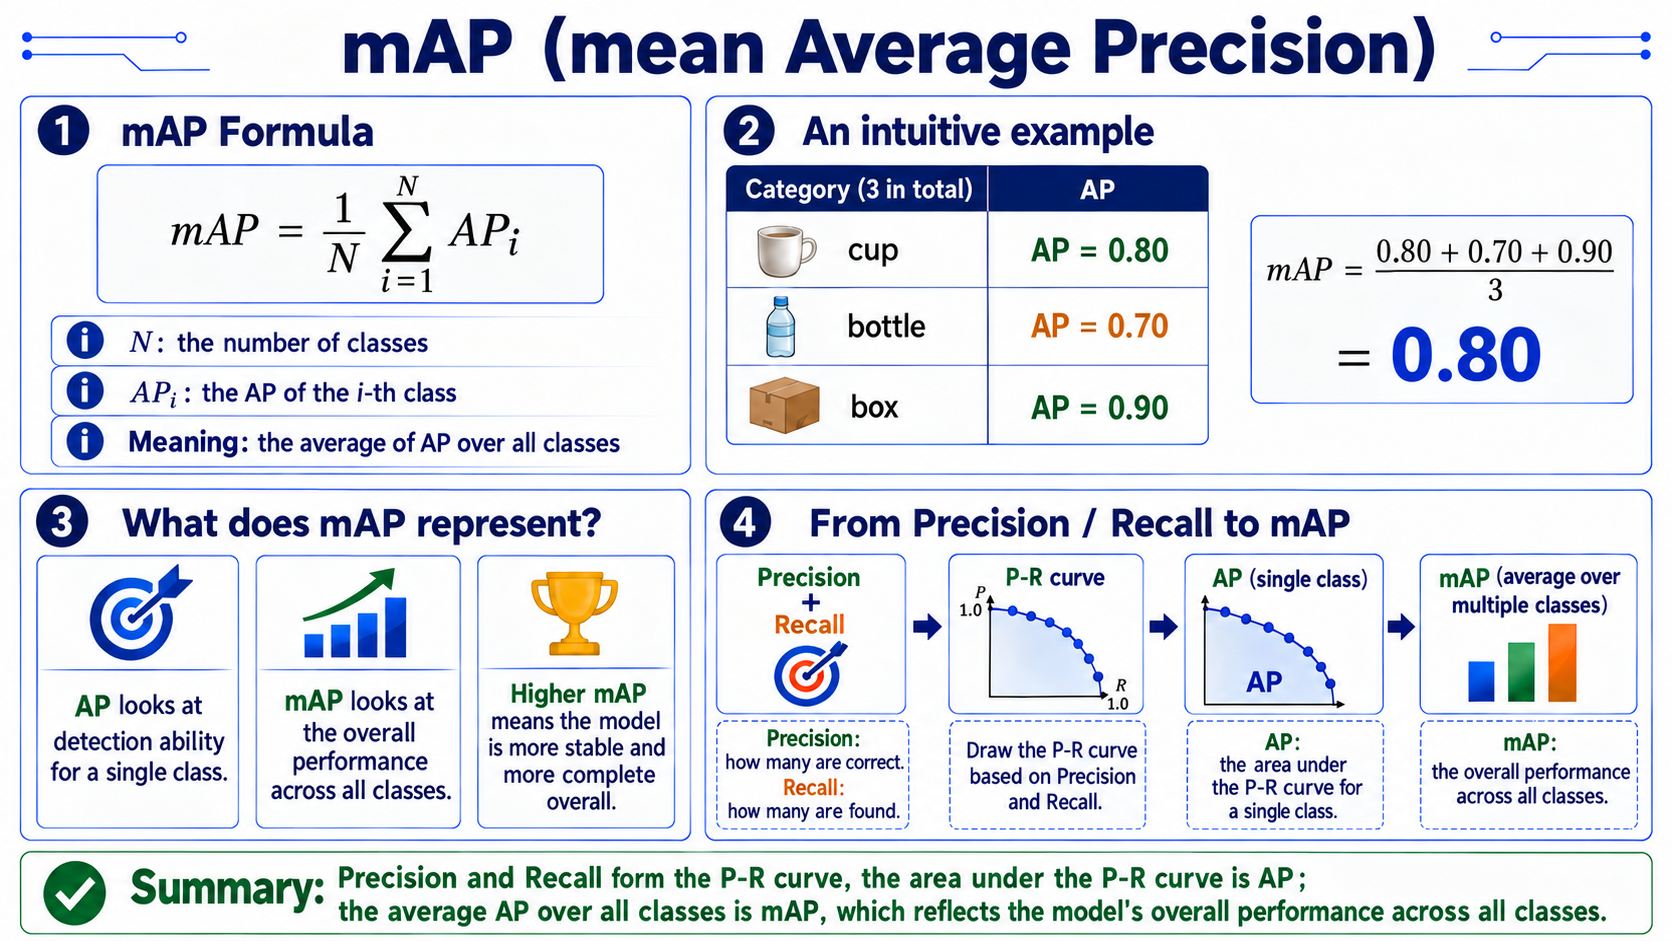
mAP (Métrica de Evaluación)
De Resultado de Detección a Dirección de Agarre
28.4 ArUco y Calibración de Cámara
Derivación Completa: de Píxeles a Coordenadas 3D
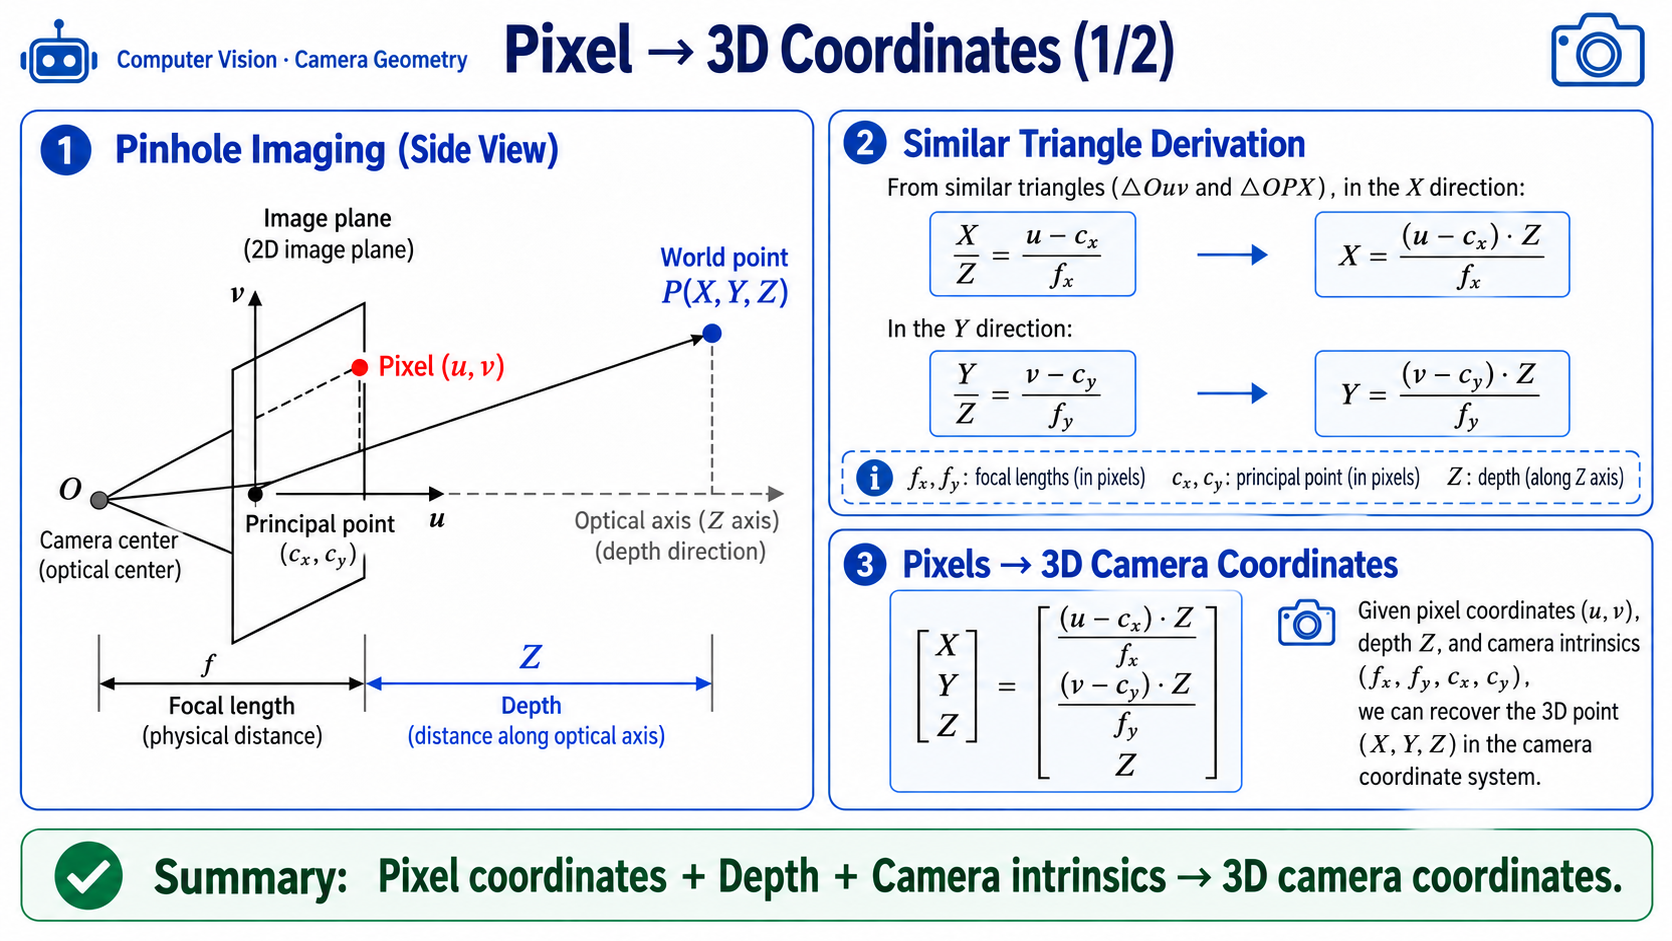
Deducción por triángulos similares
-
A partir de triángulos similares (eje X del plano de imagen):
-
Reordenado:
Análisis de propagación de error
-
Sea el error de profundidad ; a partir de la fórmula de X:
- Es decir: cuanto más lejos está un píxel del centro óptico (cx, cy), más se amplifica el error de profundidad.
- Significado físico: los objetos cerca del borde de la imagen tienen un gran ángulo de disparidad, por lo que un pequeño error de profundidad afecta significativamente las estimaciones de posición X, Y.
-
Ejemplo numérico: sea , , , , m y el píxel .
-
La posición del objeto en el marco de la cámara: (0.217, 0, 0.65) m
-
Referencia de implementación:
# ordinary_grasp.py L398-403 implementation reference
def _backproject(u, v, z_m, K):
    fx, fy = float(K[0, 0]), float(K[1, 1])
    cx, cy = float(K[0, 2]), float(K[1, 2])
    x = (u - cx) * z_m / fx
    y = (v - cy) * z_m / fy
    return np.array([x, y, z_m], dtype=np.float32)
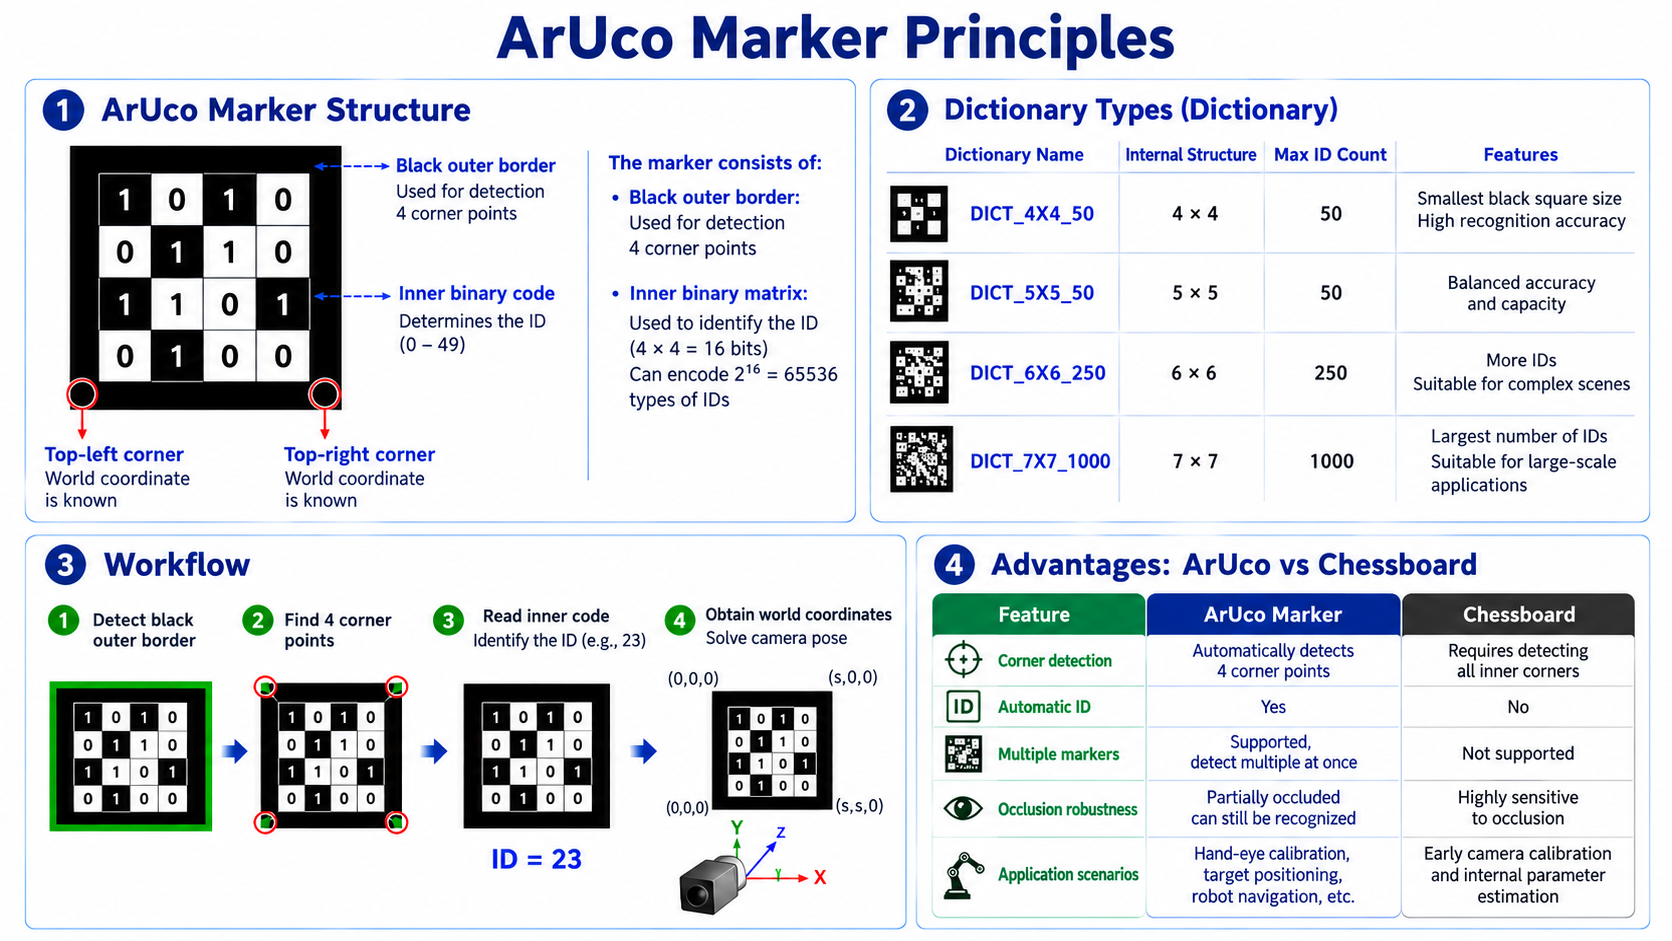
Principios de los marcadores ArUco
Estructura del marcador ArUco
Estimación de pose con ArUco (solvePnP)
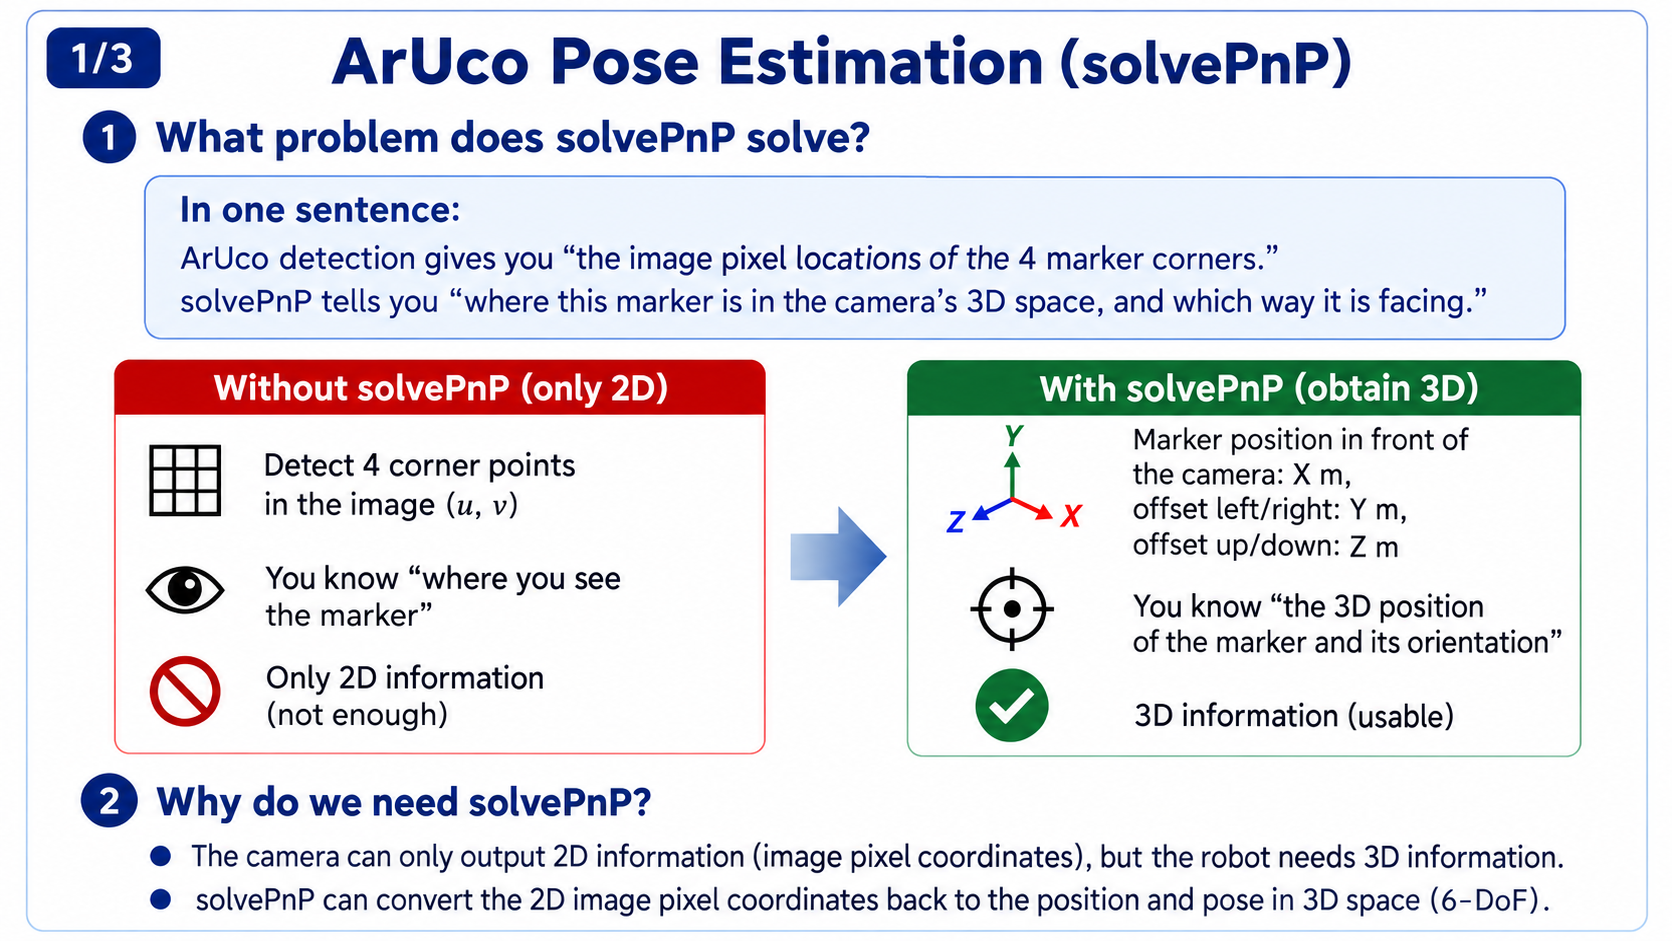
Qué problema resuelve solvePnP
- En una frase: la detección ArUco te dice "dónde están en píxeles las 4 esquinas del marcador"; solvePnP te dice "dónde está este marcador en el espacio 3D de la cámara y cómo está orientado".
Por qué se necesita solvePnP
- La cámara solo entrega información 2D (coordenadas de píxeles), pero el robot necesita información 3D:
- Recuerda la calibración mano-ojo. Su ecuación es AX = XB, donde B es la transformación de marcador a cámara, T_marker2cam—y B se obtiene exactamente mediante la detección de esquinas ArUco seguida de solvePnP. Sin solvePnP no hay B; sin B no puedes resolver X; la calibración mano-ojo no puede continuar.
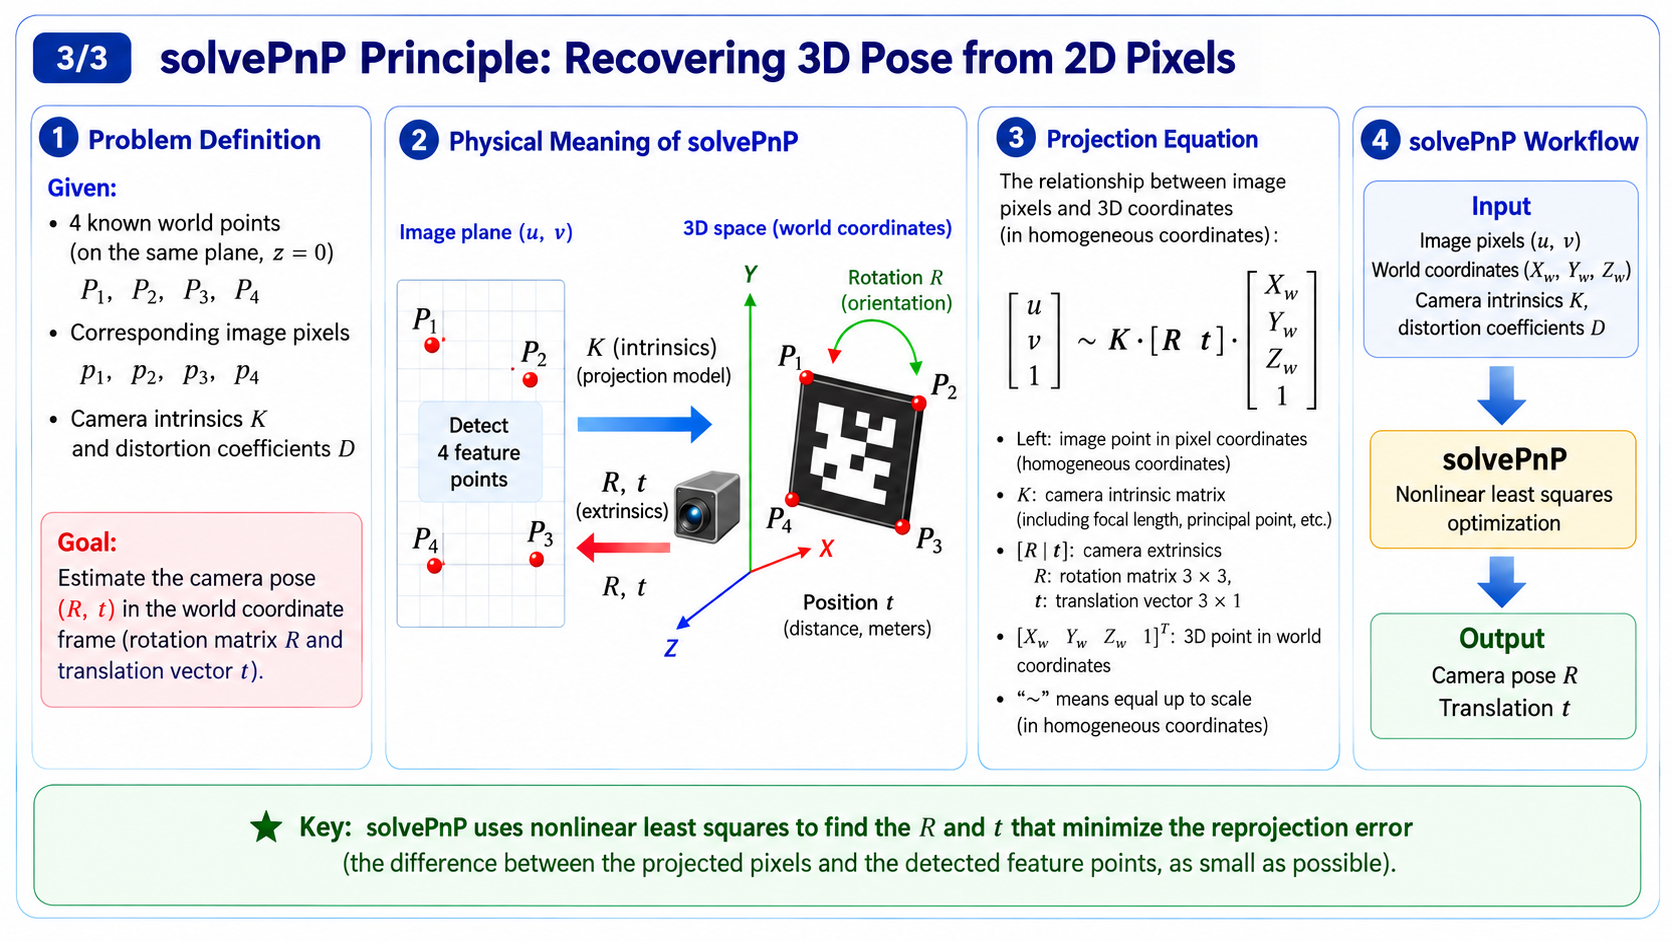
Significado físico de solvePnP
- Dadas coordenadas 3D en el mundo (un marco 3D fijo que describe "dónde está la esquina del marcador en el espacio real" con 3 números (X, Y, Z), en unidades reales de longitud cm/m), las correspondientes coordenadas de píxel 2D (un marco de imagen 2D que describe "dónde cayó esa esquina en la imagen" con 2 números (u, v)), y las intrínsecas de la cámara K, solvePnP deduce hacia atrás la rotación R y la traslación t de la cámara. Internamente usa optimización de mínimos cuadrados, minimizando el error de proyección; la salida es la pose del marcador relativa a la cámara.
28.5 Análisis en profundidad: Calibración Mano-Ojo
Significado geométrico de AX = XB
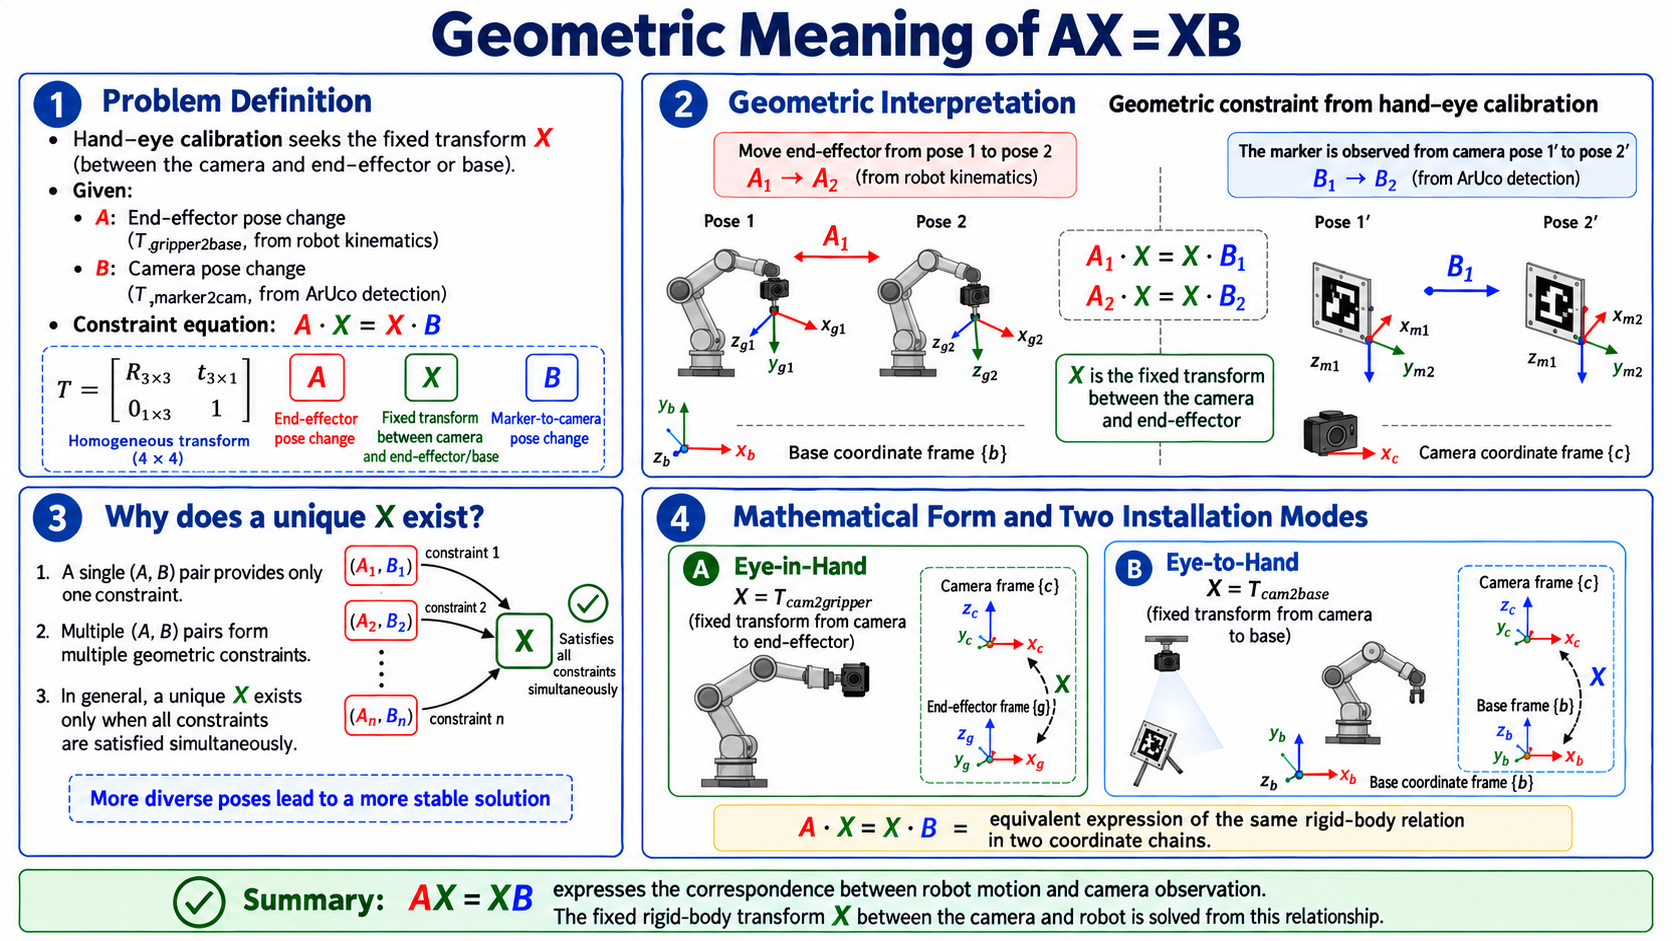
Definición del problema
-
La calibración mano-ojo resuelve X (la transformación fija entre la cámara y el extremo o la base), dado:
- A: transformación de extremo a base (T_gripper2base, a partir de la cinemática directa del brazo)
- B: transformación de marcador a cámara (T_marker2cam, a partir de la detección ArUco)
-
Ecuación de restricción:
-
X es la matriz mano-ojo—una transformación homogénea 4x4 que describe la pose fija (orientación + posición) del marco de la cámara respecto al marco del extremo del brazo.
- Contiene una matriz de rotación 3x3 R_X (orientación) y una traslación 3x1 t_X (posición);
- Los ángulos de Euler son solo otra "lectura" de R_X—la misma orientación puede ser una matriz de rotación o ángulos de Euler, y se convierten de ida y vuelta.
Interpretación geométrica
Geométricamente la restricción es sencilla. El extremo se mueve de la pose 1 a la pose 2, (registrado por el brazo), mientras que la cámara ve al marcador moverse de a , (detección ArUco). es la transformación fija entre la cámara y el extremo (cámara en el extremo), por lo que la misma relación rígida debe mantenerse en cada pose:
Múltiples pares (A, B) dan múltiples restricciones; geométricamente solo una X las satisface todas.
Forma matemática
- Eye-in-Hand: resolver X = T_cam2gripper (pose fija de la cámara respecto al extremo)
- Eye-to-Hand: resolver X = T_cam2base (pose fija de la cámara respecto a la base)
- En la implementación, cada (A, B) muestreado se almacena; una vez que se han recopilado suficientes, un solucionador de calibración los resuelve conjuntamente.
Fundamentos matemáticos de las transformaciones de cuerpo rígido
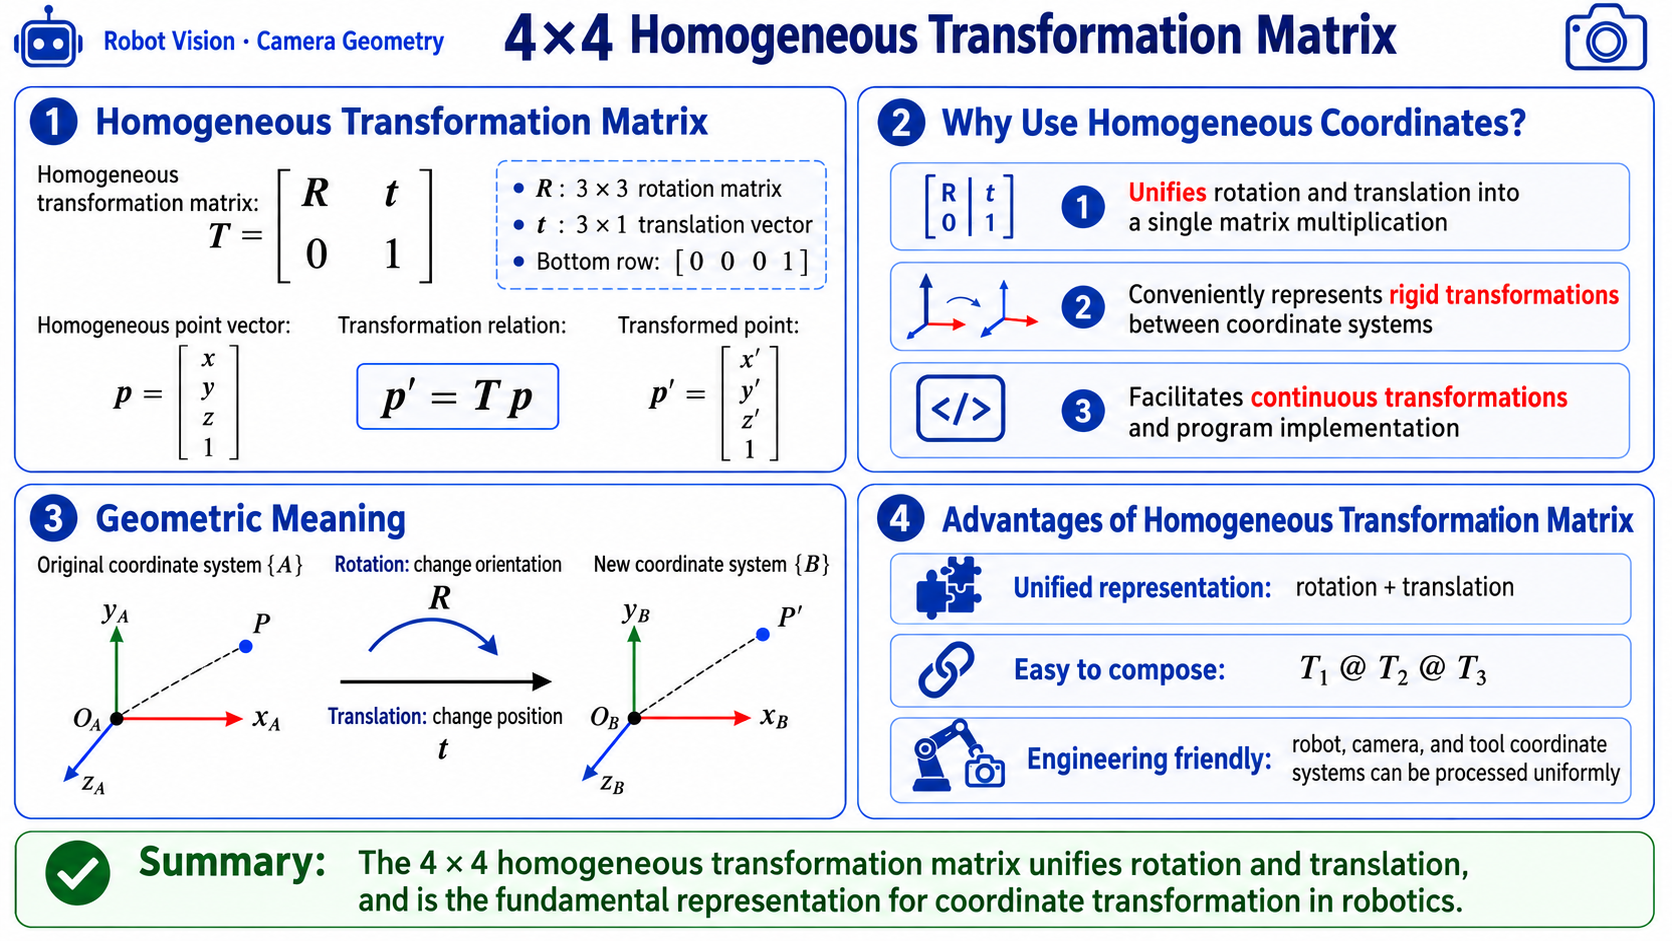
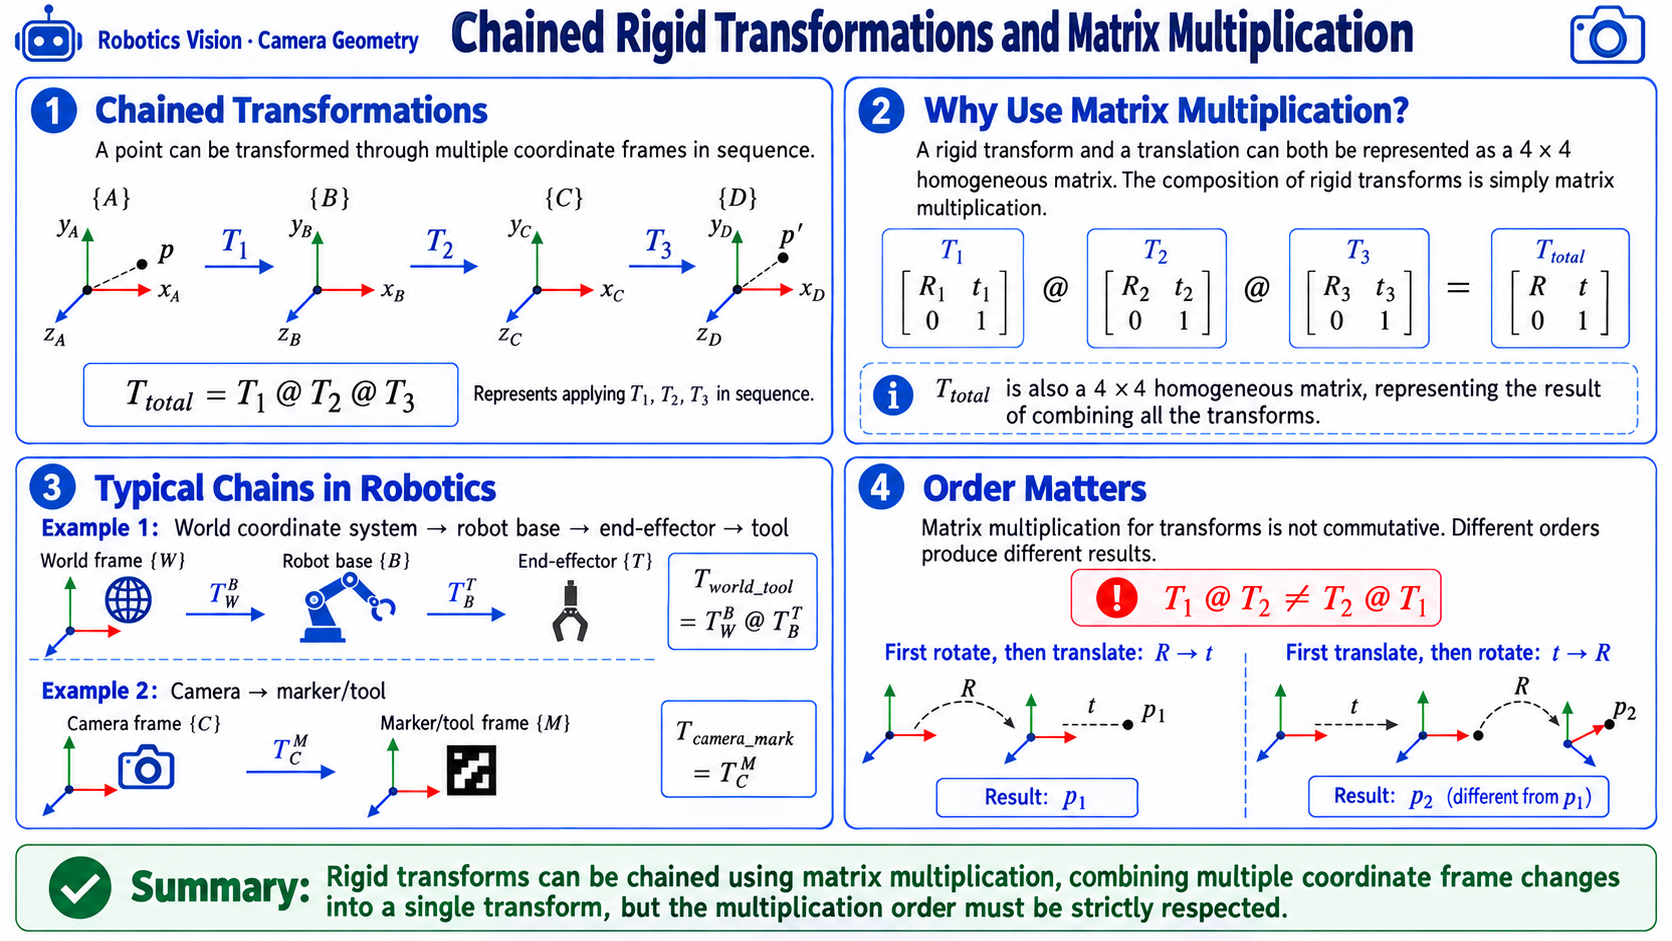
Matriz de transformación homogénea 4x4
T = [ R   t ]    R: 3x3 rotation matrix
    [ 0   1 ]    t: 3x1 translation vector
Ventajas de las transformaciones homogéneas:
- Unifican rotación y traslación en una sola multiplicación de matrices
- Se pueden encadenar: T1 @ T2 @ T3 significa transformaciones sucesivas a través de T1, T2, T3. Pero ten en cuenta: la multiplicación de matrices no es conmutativa—un orden diferente da resultados completamente distintos—"rotar 90 grados y luego trasladar" no es lo mismo que "trasladar y luego rotar 90 grados".
Tres representaciones de rotación
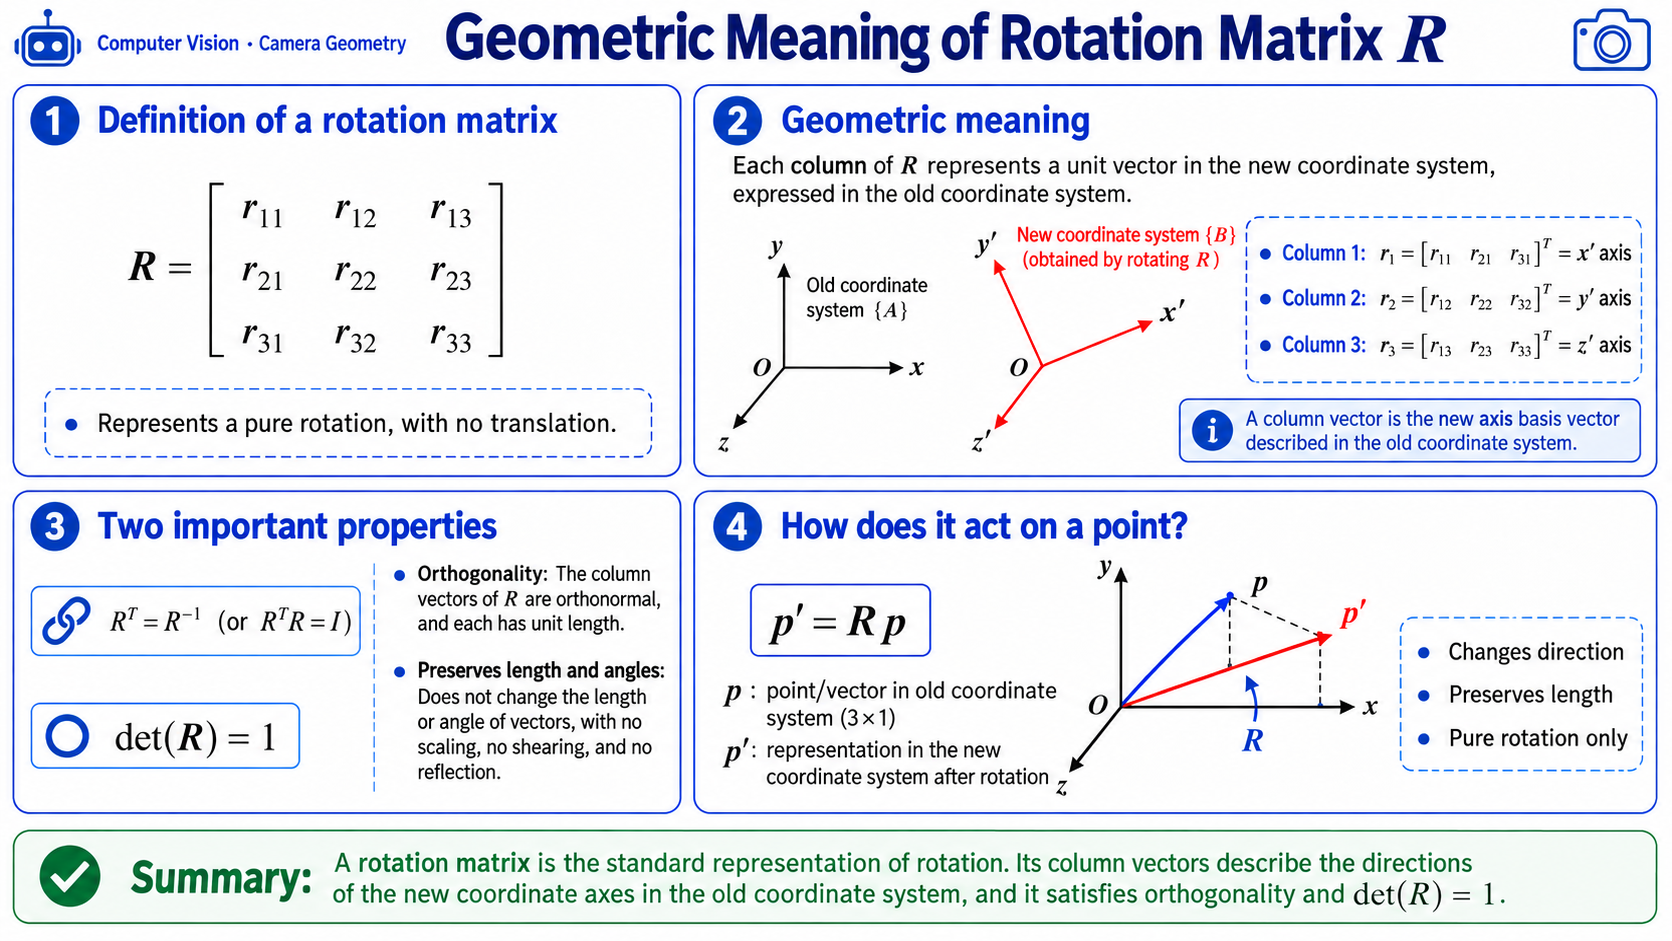
- Matriz de rotación R
-
Propiedades:
- R^T = R^(-1) (ortogonalidad)
- det(R) = 1
[diagram: geometric meaning of R]

R = [ r11 r12 r13 ]    each column is a basis vector
    [ r21 r22 r23 ]    expressed in the new frame
    [ r31 r32 r33 ]
-
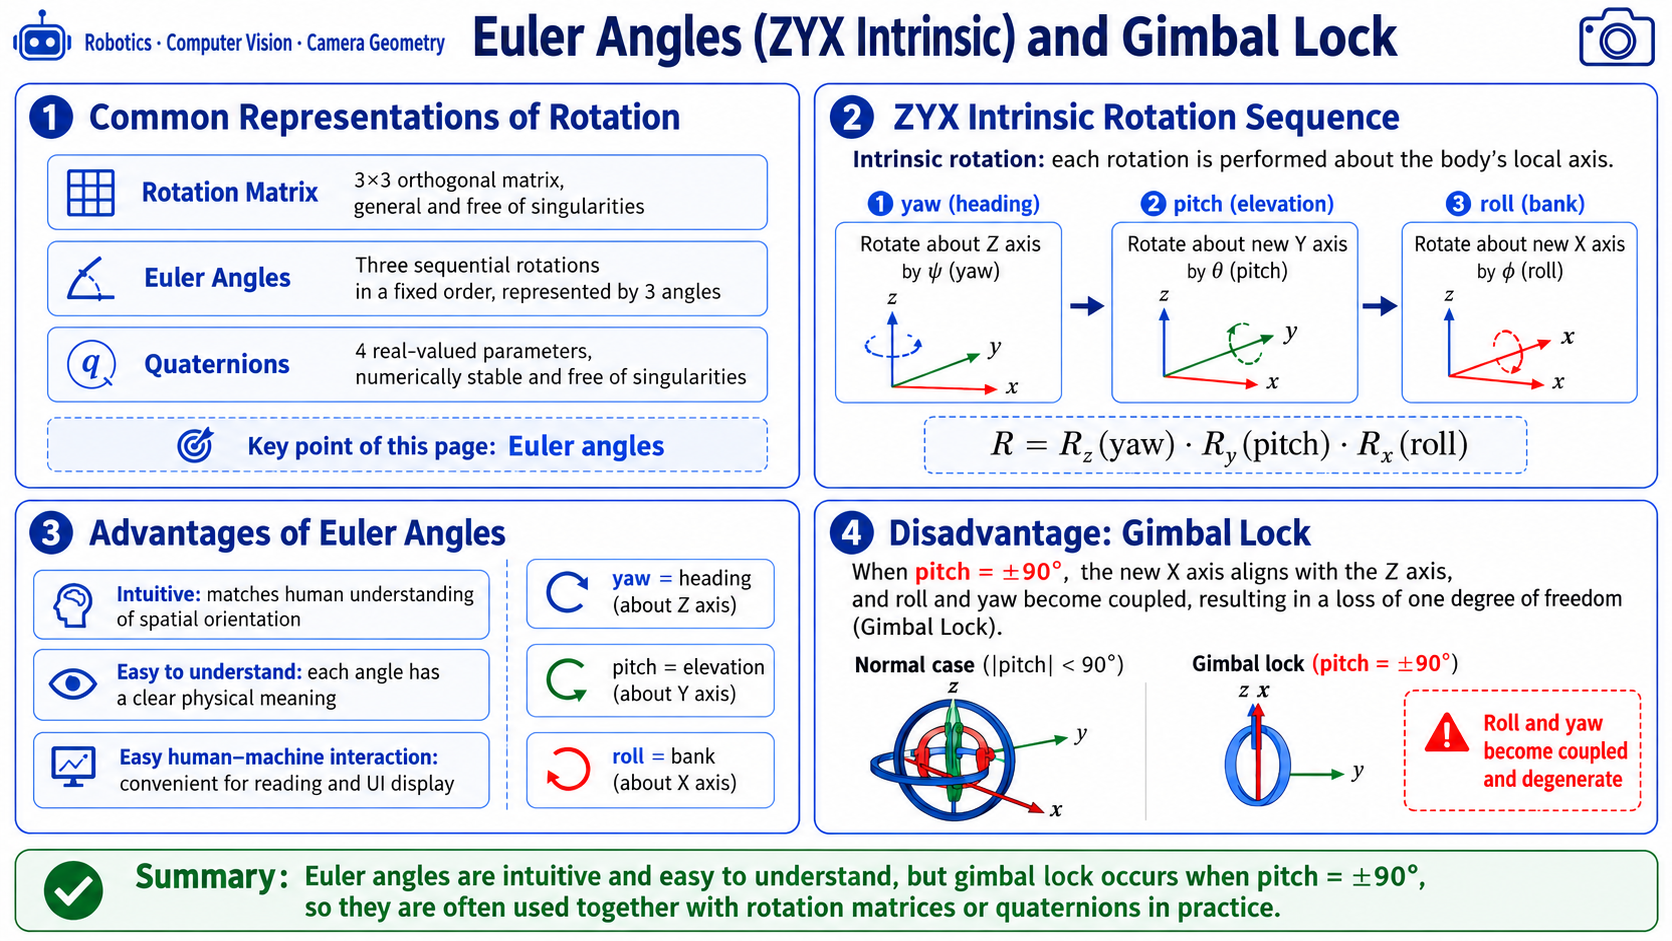
-
Ángulos de Euler (intrínsecos ZYX)
-
Implementación: rotar alrededor de Z (yaw) -> alrededor del nuevo Y (pitch) -> alrededor del nuevo X (roll):
# transforms.py L32-72 implementation reference
def pose6d_to_mat4(x, y, z, rx, ry, rz, degrees=False):
    if degrees:
        rx, ry, rz = np.radians(rx), np.radians(ry), np.radians(rz)

# Rotation around X (roll)
    Rx = np.array([
        [1,          0,           0],
        [0,  np.cos(rx), -np.sin(rx)],
        [0,  np.sin(rx),  np.cos(rx)],
    ])
# Rotation around Y (pitch)
    Ry = np.array([
        [ np.cos(ry), 0, np.sin(ry)],
        [          0, 1,          0],
        [-np.sin(ry), 0, np.cos(ry)],
    ])
# Rotation around Z (yaw)
    Rz = np.array([
        [np.cos(rz), -np.sin(rz), 0],
        [np.sin(rz),  np.cos(rz), 0],
        [         0,           0, 1],
    ])

# Intrinsic ZYX rotation: R = Rz @ Ry @ Rx
    R = Rz @ Ry @ Rx

    T = np.eye(4, dtype=np.float64)
    T[:3, :3] = R
    T[:3, 3] = [x, y, z]
    return T
-
-
Singularidad (bloqueo de cardán):
-
Los ángulos de Euler tienen una famosa trampa llamada "bloqueo de cardán": cuando el pitch es +/-90 grados, los ejes X y Z coinciden, roll y yaw se degeneran, los grados de libertad bajan de 3 a 2, y la representación de la pose deja de ser única. Así que cerca de singularidades el código usa una fórmula alternativa—por eso en ingeniería los ángulos de Euler suelen ir acompañados de matrices de rotación o cuaterniones.
# transforms.py L110-122 implementation (handling singularities)
def rotation_matrix_to_euler_zyx(R):
    R = _nearest_rotation_matrix(R)
    sy = np.sqrt(R[0, 0] ** 2 + R[1, 0] ** 2)
    if sy > 1e-6:
        rx = np.arctan2(R[2, 1], R[2, 2])
        ry = np.arctan2(-R[2, 0], sy)
        rz = np.arctan2(R[1, 0], R[0, 0])
    else:
# near singularity, use fallback formula
        rx = np.arctan2(-R[1, 2], R[1, 1])
        ry = np.arctan2(-R[2, 0], sy)
        rz = 0.0
    return np.array([rx, ry, rz], dtype=np.float64)
-
Eye-in-Hand vs Eye-to-Hand
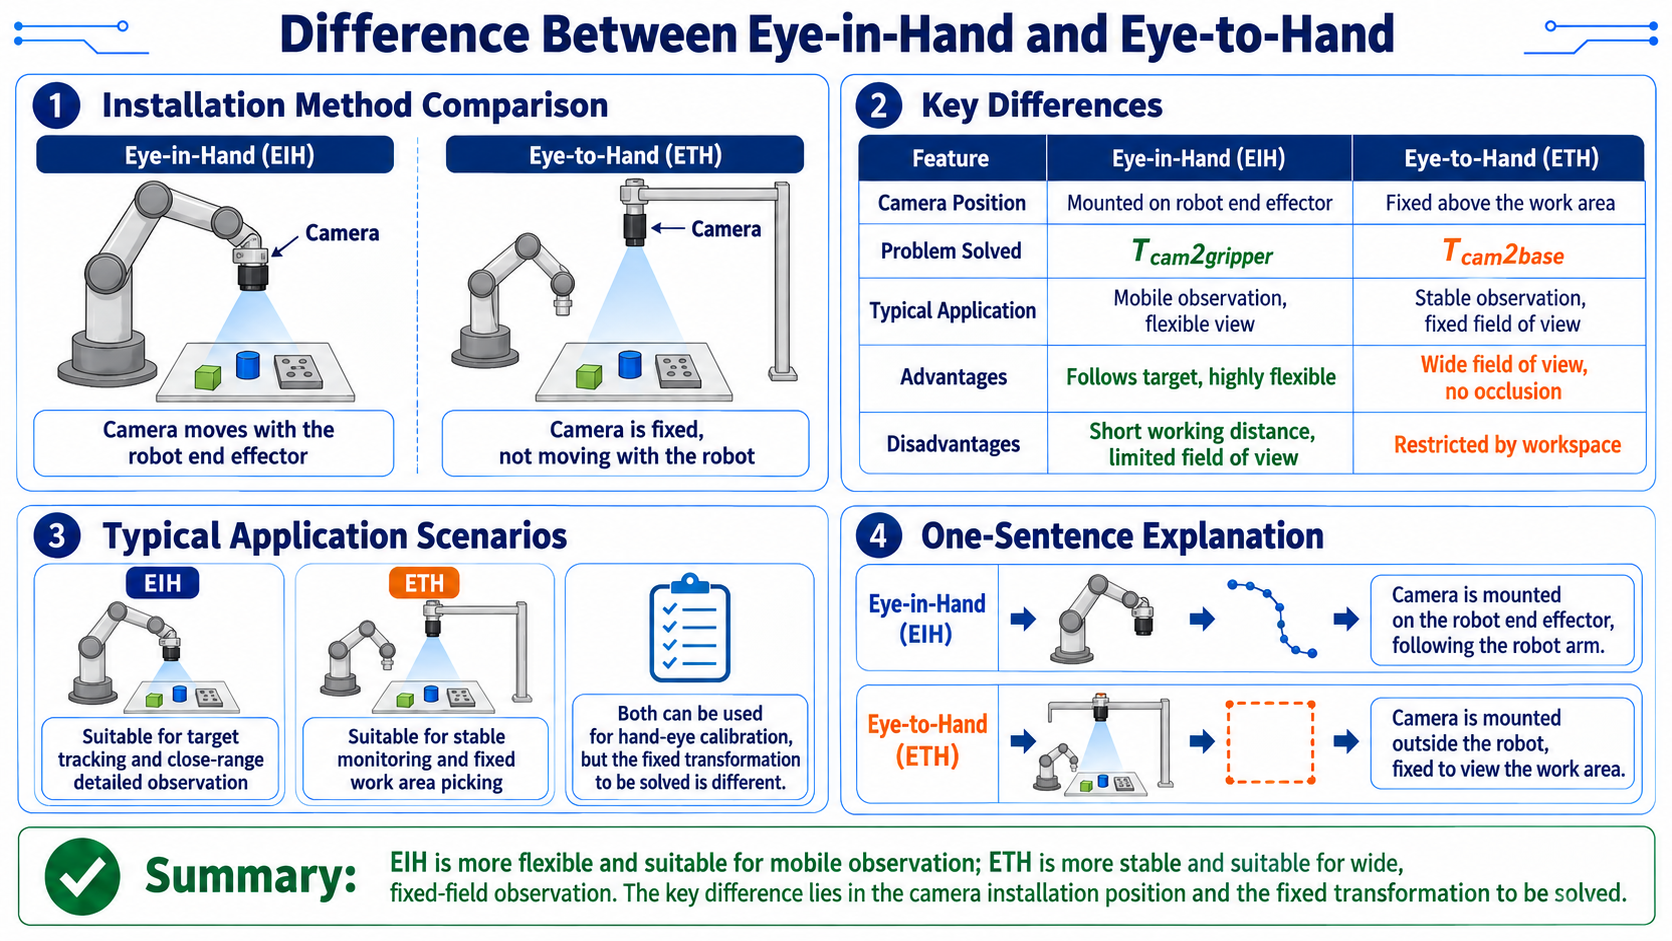
[diagram: EIH vs ETH mounting]

Eye-in-Hand:
  arm end -- camera -- looking at workspace
  camera moves with the end

Eye-to-Hand:
  above workspace -- camera -- looking down
  camera fixed, does not move with the end
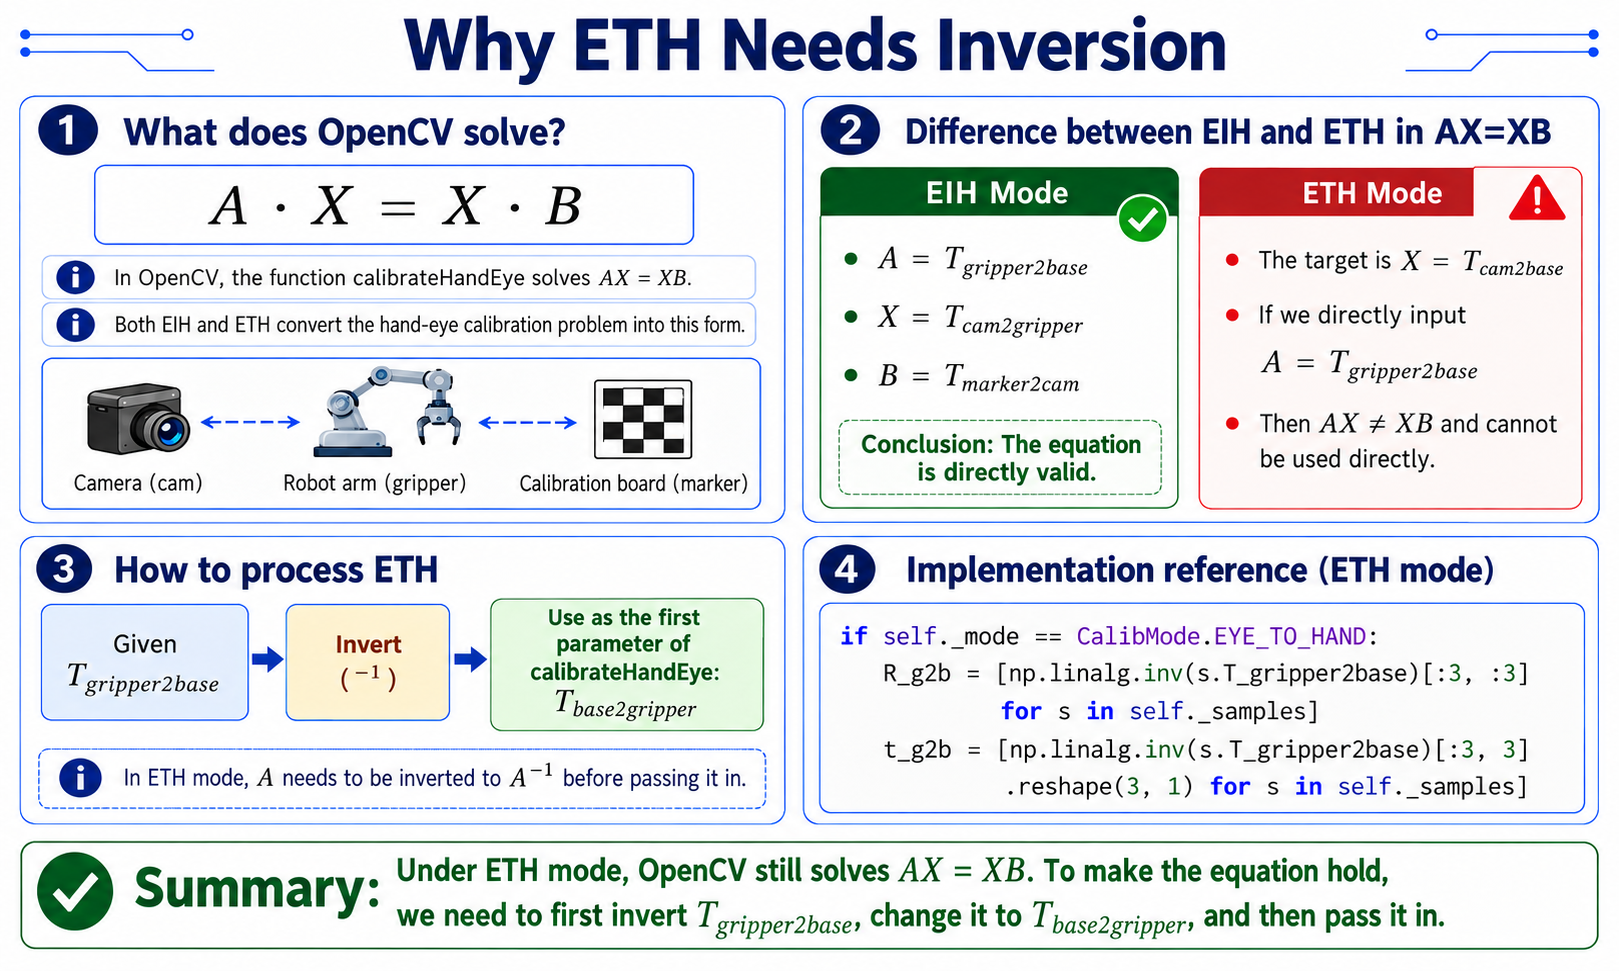
Manejo especial para ETH (tomar la inversa)
Implementación:
# hand_eye.py L110-114 implementation (ETH mode: invert A)
if self._mode == CalibMode.EYE_TO_HAND:
# OpenCV calibrateHandEye solves AX=XB; in ETH mode, invert
# T_gripper2base and pass it as the first argument; it returns T_cam2base.
    R_g2b = [np.linalg.inv(s.T_gripper2base)[:3, :3] for s in self._samples]
    t_g2b = [np.linalg.inv(s.T_gripper2base)[:3, 3].reshape(3, 1) for s in self._samples]
Por qué ETH necesita la inversa:
calibrateHandEyede OpenCV resuelve AX=XB internamente.- Modo EIH: A es T_gripper2base (movimiento del extremo), X es T_cam2gripper (cámara-extremo fija), B es T_marker2cam. La ecuación se cumple directamente.
- Modo ETH: A sigue siendo T_gripper2base, pero X es T_cam2base (cámara-base fija). Entonces AX != XB directamente; debes invertir A antes de pasarlo.
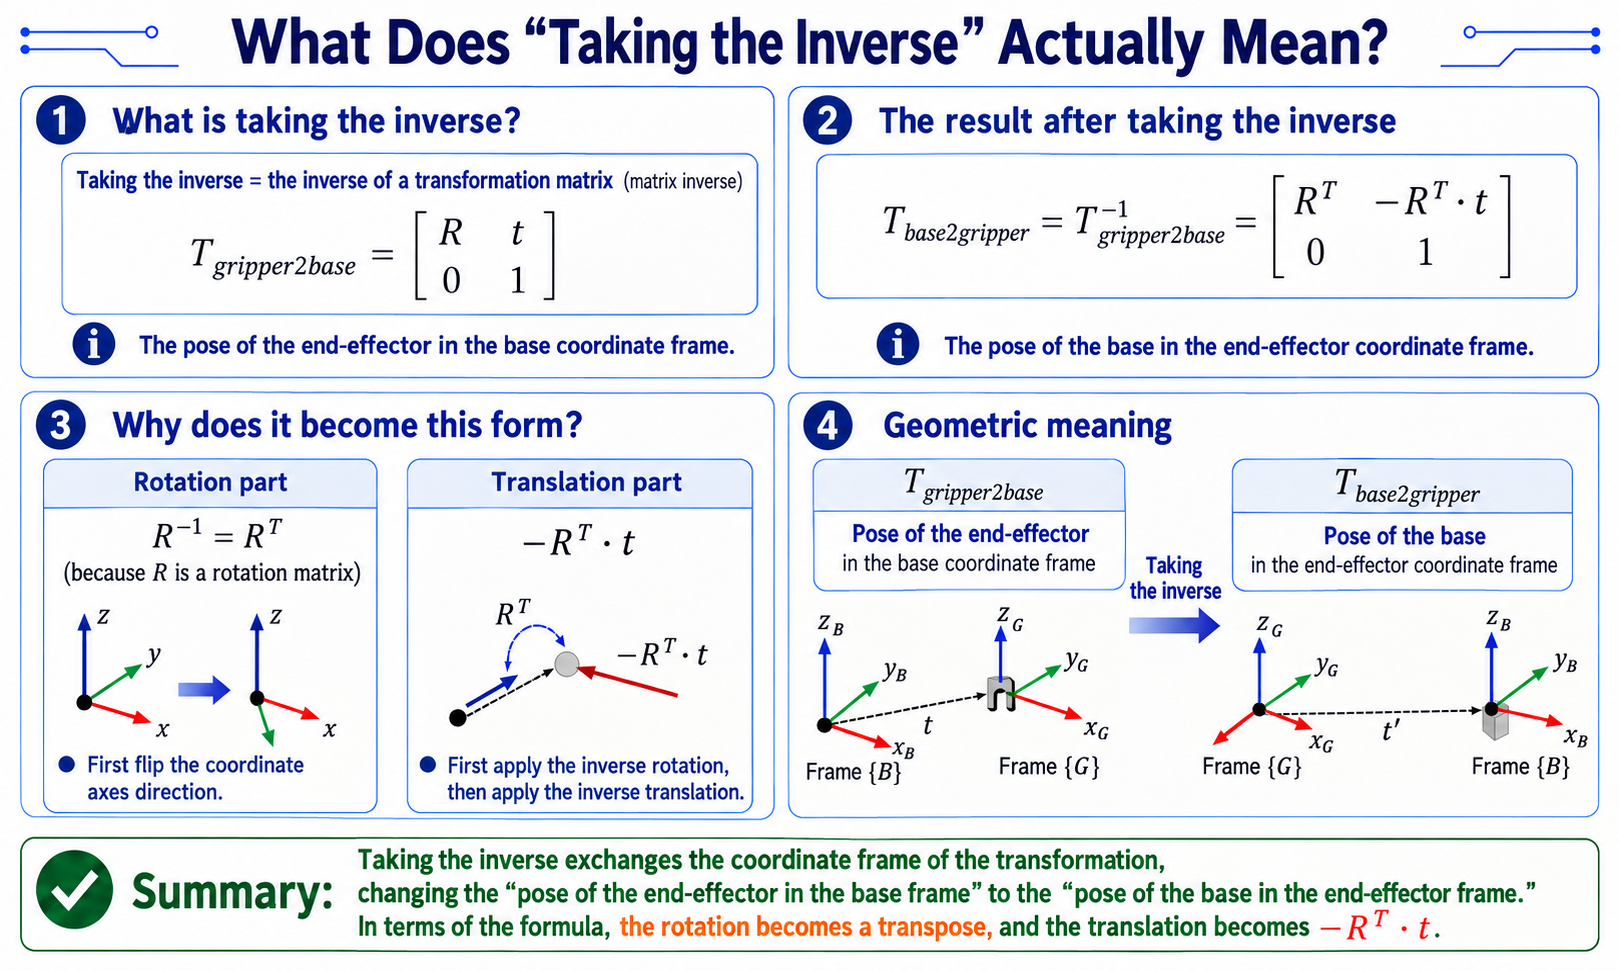
Qué significa "tomar la inversa"
-
"Tomar la inversa" = inversa de la matriz. En modo ETH, OpenCV no acepta
T_gripper2base; quiereT_base2gripper, así que tomas la inversa de la matriz.# what we have (arm FK output)
T_gripper2base = [R t] # end pose (in base frame)
[0 1]
# what OpenCV ETH mode wants (after inversion)
T_base2gripper = T_gripper2base^-1 = [R^T -R^T.t] # base in end frame
[0 1 ] -
Parte de rotación: inversa de R = traspuesta de R (R es ortogonal)
-
Parte de traslación: -R^T . t (primero des-rotar, luego des-trasladar)
-
Significado geométrico: la "pose del extremo en el marco base" se convierte en la "pose de la base en el marco del extremo" después de la inversión.
Principios de diseño de poses de calibración
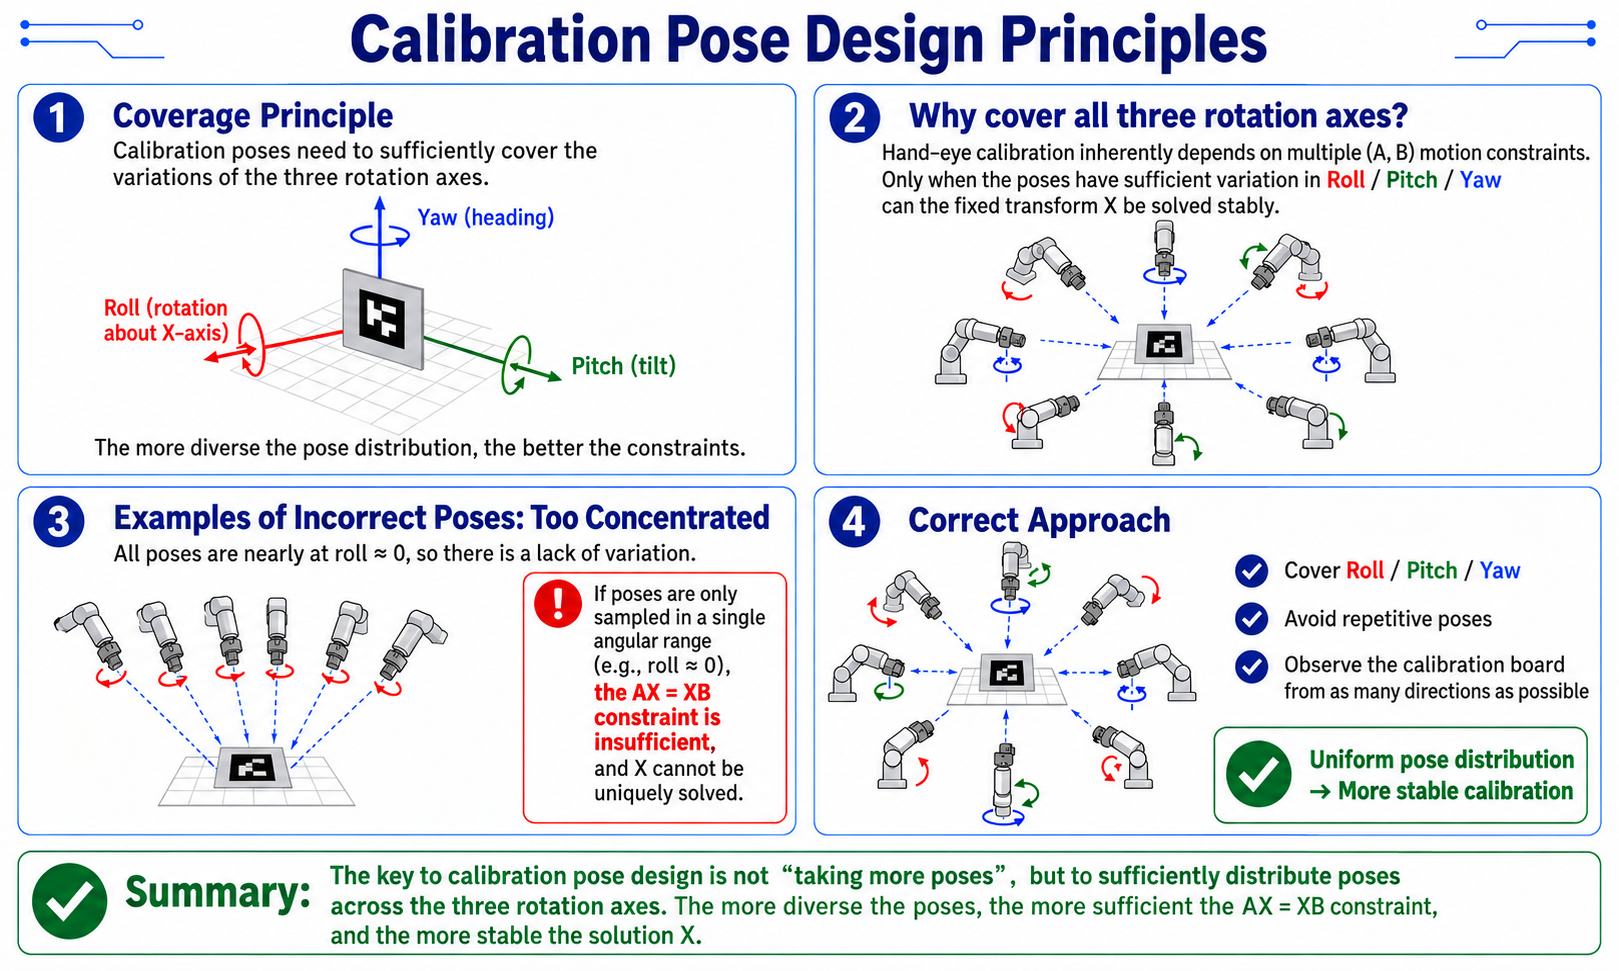
Principio de cobertura
-
Las poses de calibración deben cubrir cambios en los tres ejes de rotación:
[diagram: calibration pose distribution]

      Roll ^
           |
   +-------+-------+
   |       |       |
   |  Yaw -+-->    |
   |       |       |
   +-------+-------+
           |
v Pitch -
Si las poses se limitan a un solo rango angular (por ejemplo, todo el roll ~ 0), AX=XB queda subdeterminado y X no es único. Así que durante la calibración las poses del brazo deben implicar cambios de Roll, Pitch y Yaw.
Cadena de transformaciones de coordenadas después de la calibración
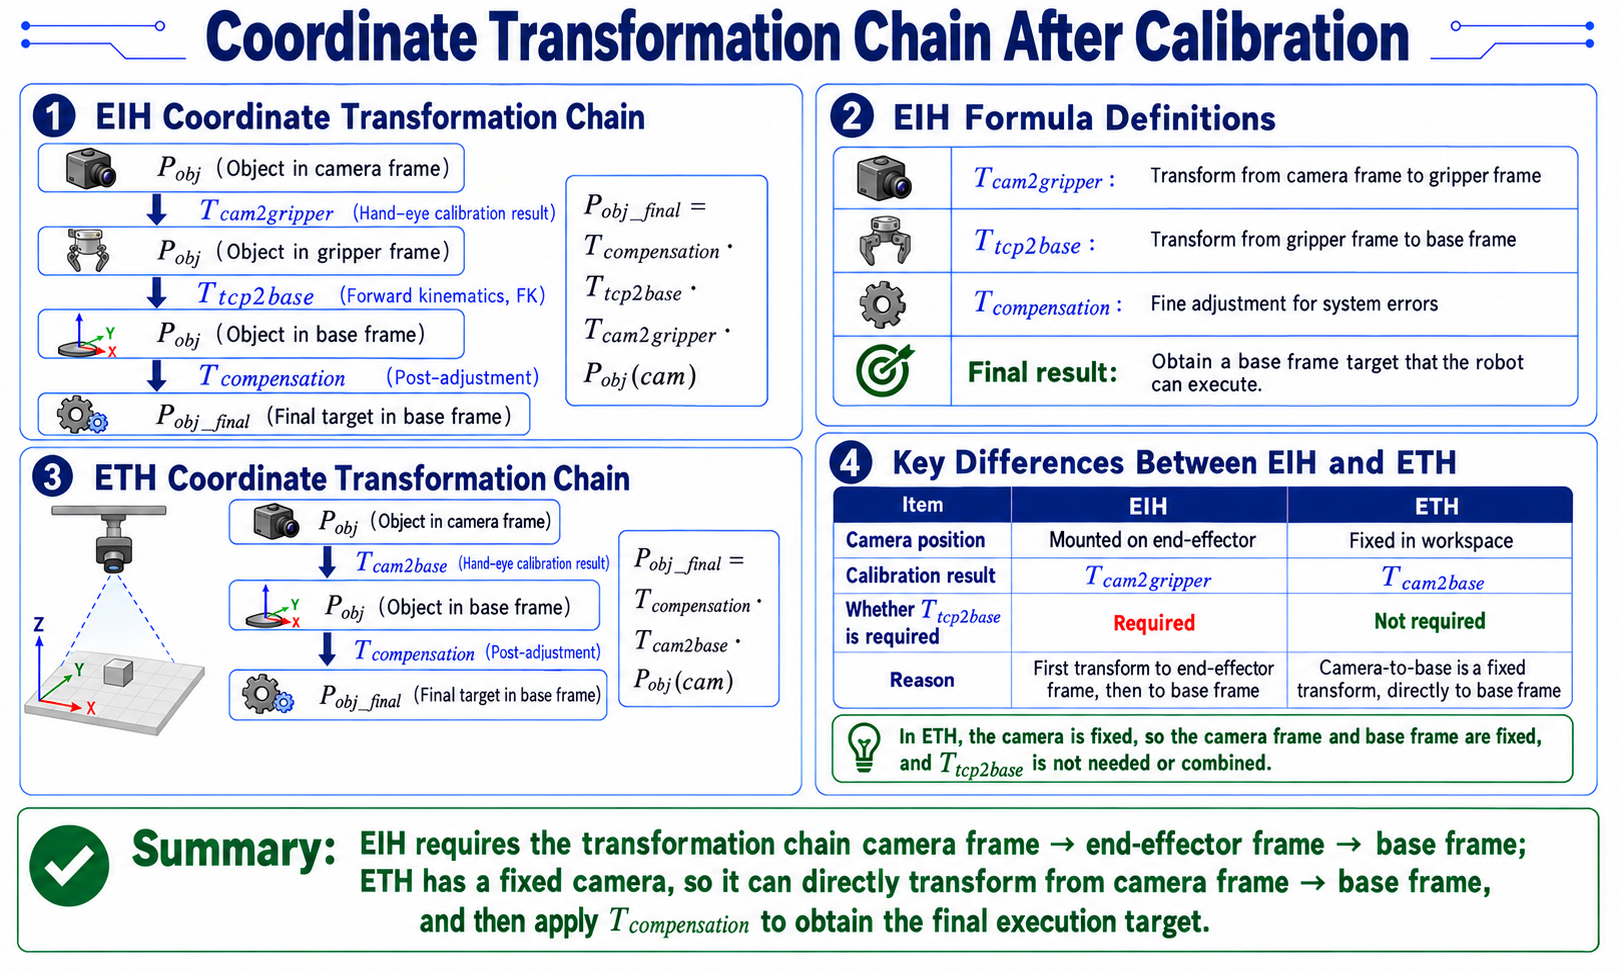
Implementación:
"""Transform a camera-observed pose into the arm base frame"""
    T_compensation = hand_eye_compensation_matrix(cfg)
    T_he = np.asarray(T_hand_eye, dtype=np.float64)

    if hand_eye_mode == "eye_in_hand":
# EIH: T_cam2base = T_comp x T_tcp2base x T_hand_eye
        return T_compensation @ np.asarray(T_tcp2base, dtype=np.float64) @ T_he
    if hand_eye_mode == "eye_to_hand":
# ETH: T_cam2base = T_comp x T_hand_eye
        return T_compensation @ T_he
Significado de la fórmula EIH
[diagram: EIH transform chain]

  P_obj (target in camera frame)
       |
       | T_cam2gripper (hand-eye result)
       v
  P_obj (target in end frame)
       |
       | T_tcp2base (forward kinematics)
       v
  P_obj (target in base frame)
       |
       | T_compensation (post-hoc fine tune)
       v
  P_obj_final (final target in base frame)
-
Implementación:
"""Read compensation matrix from config"""
    calibration = cfg.get("calibration") or {}
    compensation = calibration.get("hand_eye_compensation_m") or {}
    T = np.eye(4, dtype=np.float64)
    T[:3, 3] = [
        float(compensation.get("x", 0.0)),
        float(compensation.get("y", 0.0)),
        float(compensation.get("z", 0.0)),
    ]
    return T
Fórmula ETH
- Debido a que la cámara está fija, la transformación base-cámara es fija; T_tcp2base no entra en la composición.
Error de calibración y análisis de reproyección
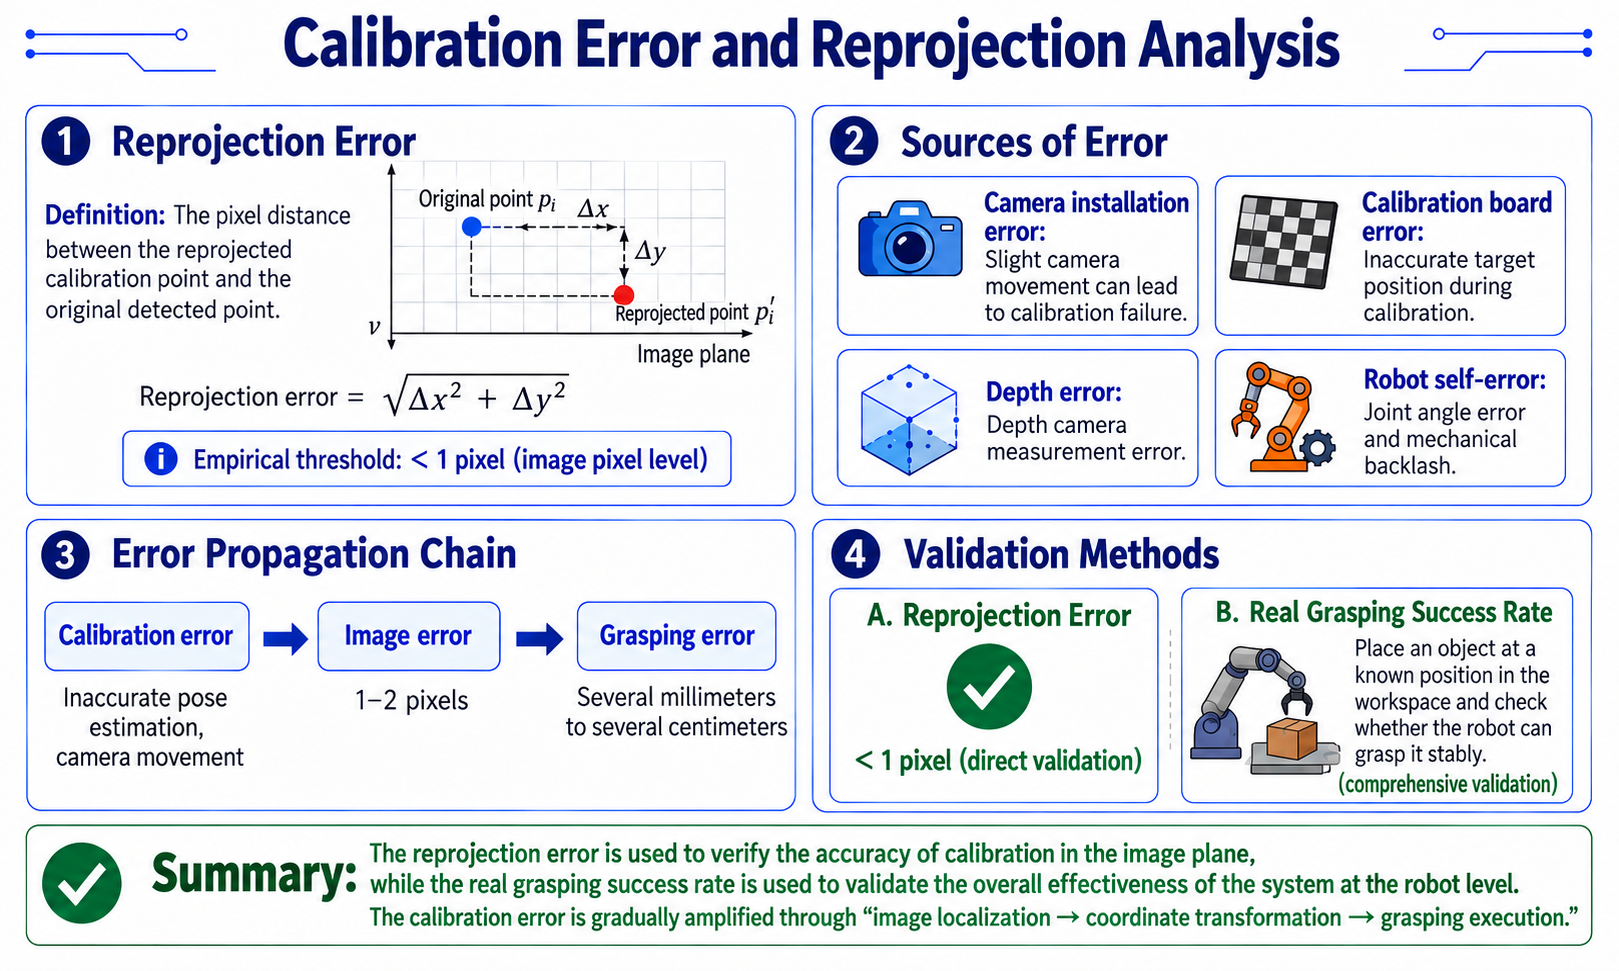
Error de reproyección
-
Definición: reproyectar los puntos de calibración en la imagen y calcular la distancia en píxeles a los puntos detectados originalmente.
[diagram: reprojection error]

  original point p_i      reprojected point p_i'
       |                    |
       +---- dx, dy -------+

reprojection error = sqrt(dx^2 + dy^2)-
Umbral empírico: < 1 píxel (subpíxel).
-
Fuentes de error
Fuente Efecto Error de montaje de la cámara Un ligero movimiento de la cámara invalida la calibración Error de la placa de calibración Posición objetivo inexacta durante la calibración Error de profundidad Error de medición de la cámara de profundidad Error del robot Error articular y holgura mecánica
-
Cadena de propagación del error
calibration error -> pixel error -> grasp deviation
   ^                  ^              ^
   |                  |              |
   |            1-2 pixels     a few mm to cm
   |
   +-- poor calibration poses, camera moved
Métodos de validación
- Error de reproyección: < 1 píxel (validación directa)
- Tasa real de éxito de agarre: colocar objetos en posiciones conocidas en el espacio de trabajo y ver si el robot agarra de forma fiable (validación integrada)
28.6 Estimación de pose de agarre de 6 GDL
Convenciones de coordenadas para agarre de 6 GDL
Marco de agarre de visión (convención de GraspNet)
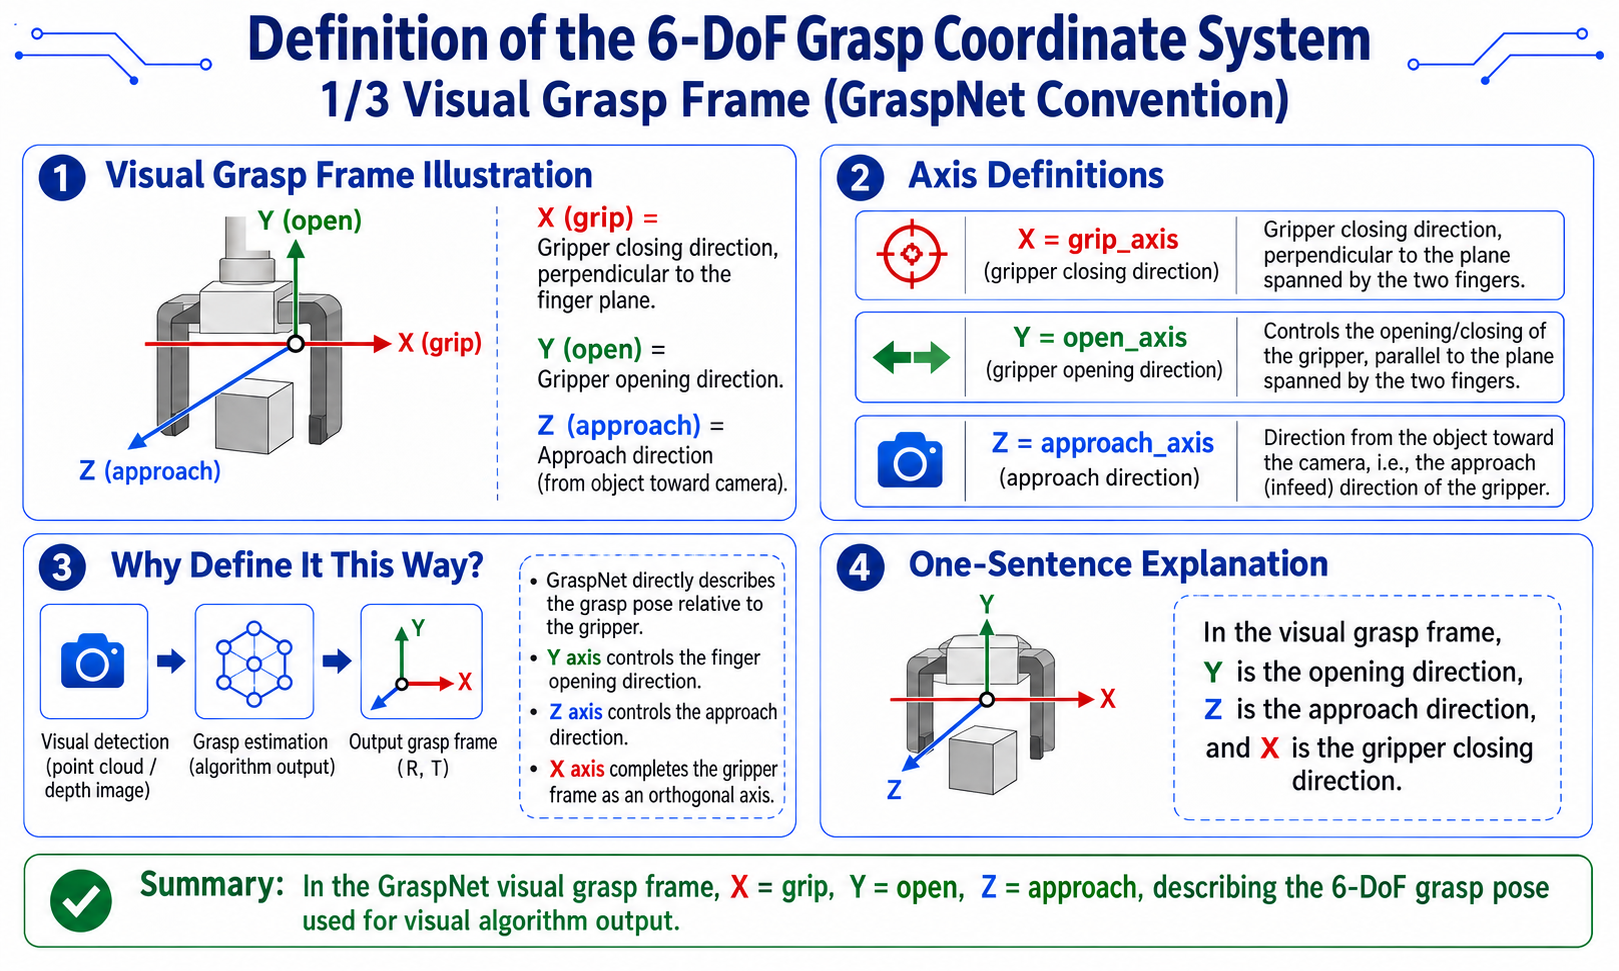
[diagram: vision grasp frame]

Y (open)
|
|   gripper open/close direction
|
+------ X (grip) -> gripper axis (grasp direction)
/
Z (approach)
v approach direction (object toward camera)
- X = grip_axis (eje del gripper, perpendicular al plano de los dedos)
- Y = open_axis (dirección de apertura/cierre)
- Z = approach_axis (dirección de aproximación, desde el objeto hacia la cámara)
Marco TCP del robot (convención de reBotArm)
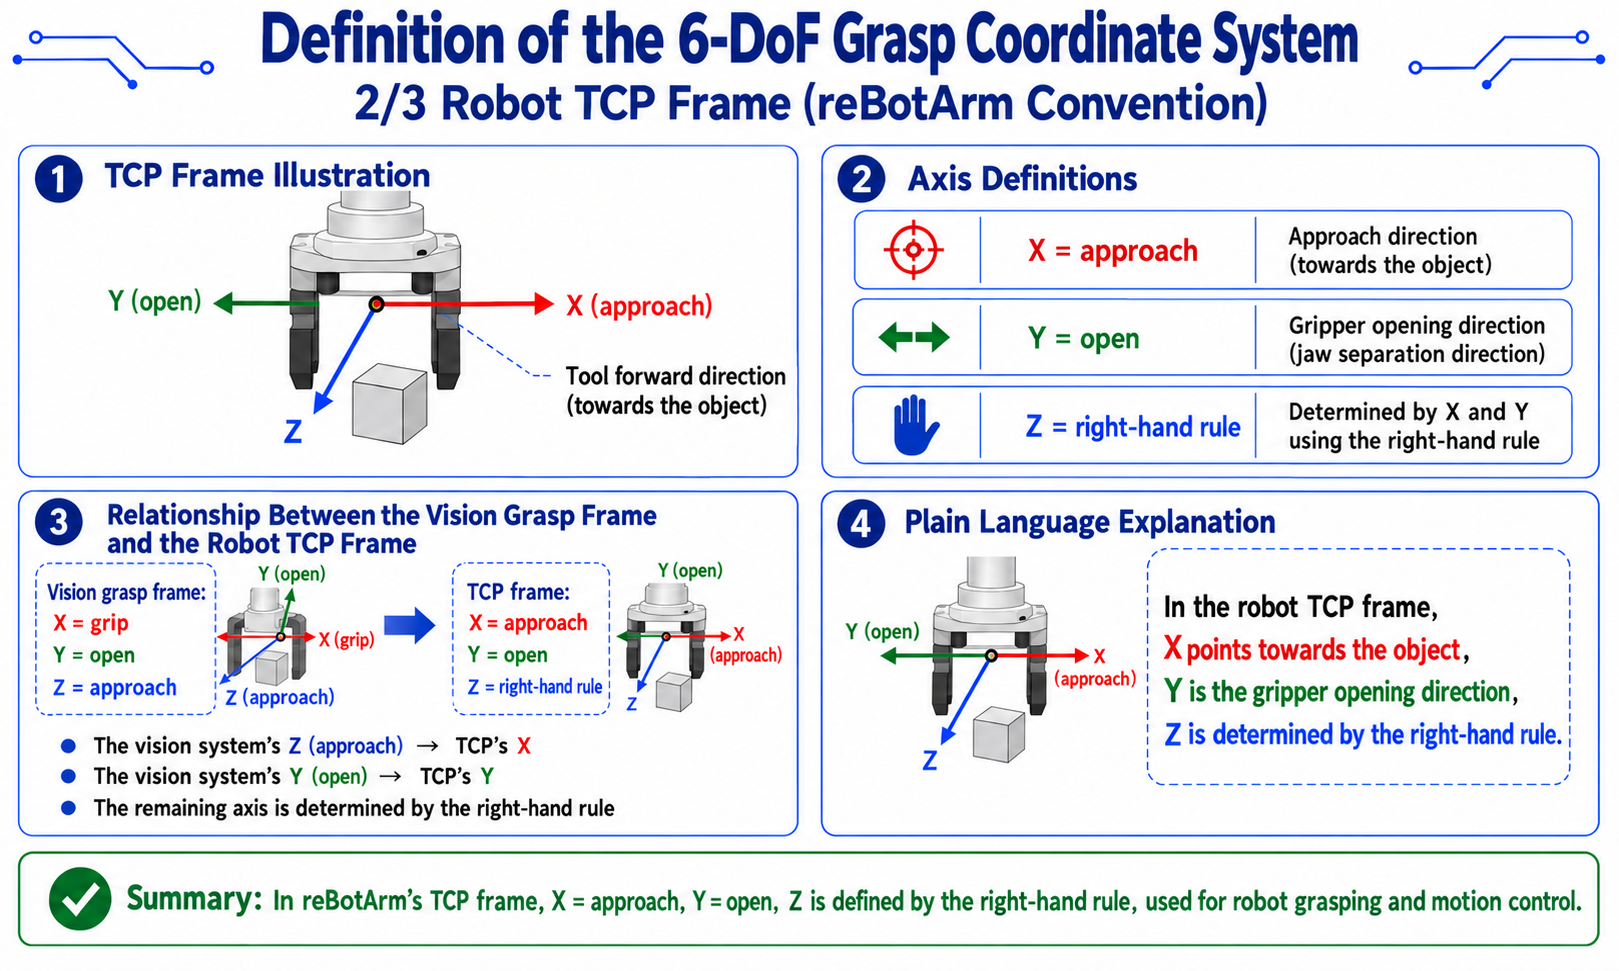
[diagram: TCP frame]

Z
|  / Y (open)
| /
+------ X (approach) -> tool forward direction (approach object)
- X = aproximación
- Y = apertura
- Z = completado por la regla de la mano derecha
Conversión entre los dos marcos
-
Implementación:
# transforms.py L141-182 implementation reference
def grasp_axes_to_rebot_tcp_rotation(grip_axis, open_axis, approach_axis):
    """Map grasp-frame axes to the reBotArm TCP frame."""
    grip = grip_axis / norm(grip_axis)
    open_vec = open_axis / norm(open_axis)
    approach = approach_axis / norm(approach_axis)

# tcp_x = tool forward = approach direction (negate, since plane normal faces camera)
    tcp_x = -approach
# tcp_y = open direction, subtract approach component to make orthogonal
    tcp_y = open_vec - dot(open_vec, tcp_x) * tcp_x
    tcp_y = tcp_y / norm(tcp_y)
# tcp_z = right-hand cross product
    tcp_z = cross(tcp_x, tcp_y)
    tcp_z = tcp_z / norm(tcp_z)

# keep tcp_z aligned with grip_axis
    if dot(tcp_z, grip) < 0:
        tcp_y = -tcp_y
        tcp_z = -tcp_z

    R = np.column_stack([tcp_x, tcp_y, tcp_z]).astype(np.float64)
    if np.linalg.det(R) < 0.0:
        R[:, 2] *= -1.0
    return R
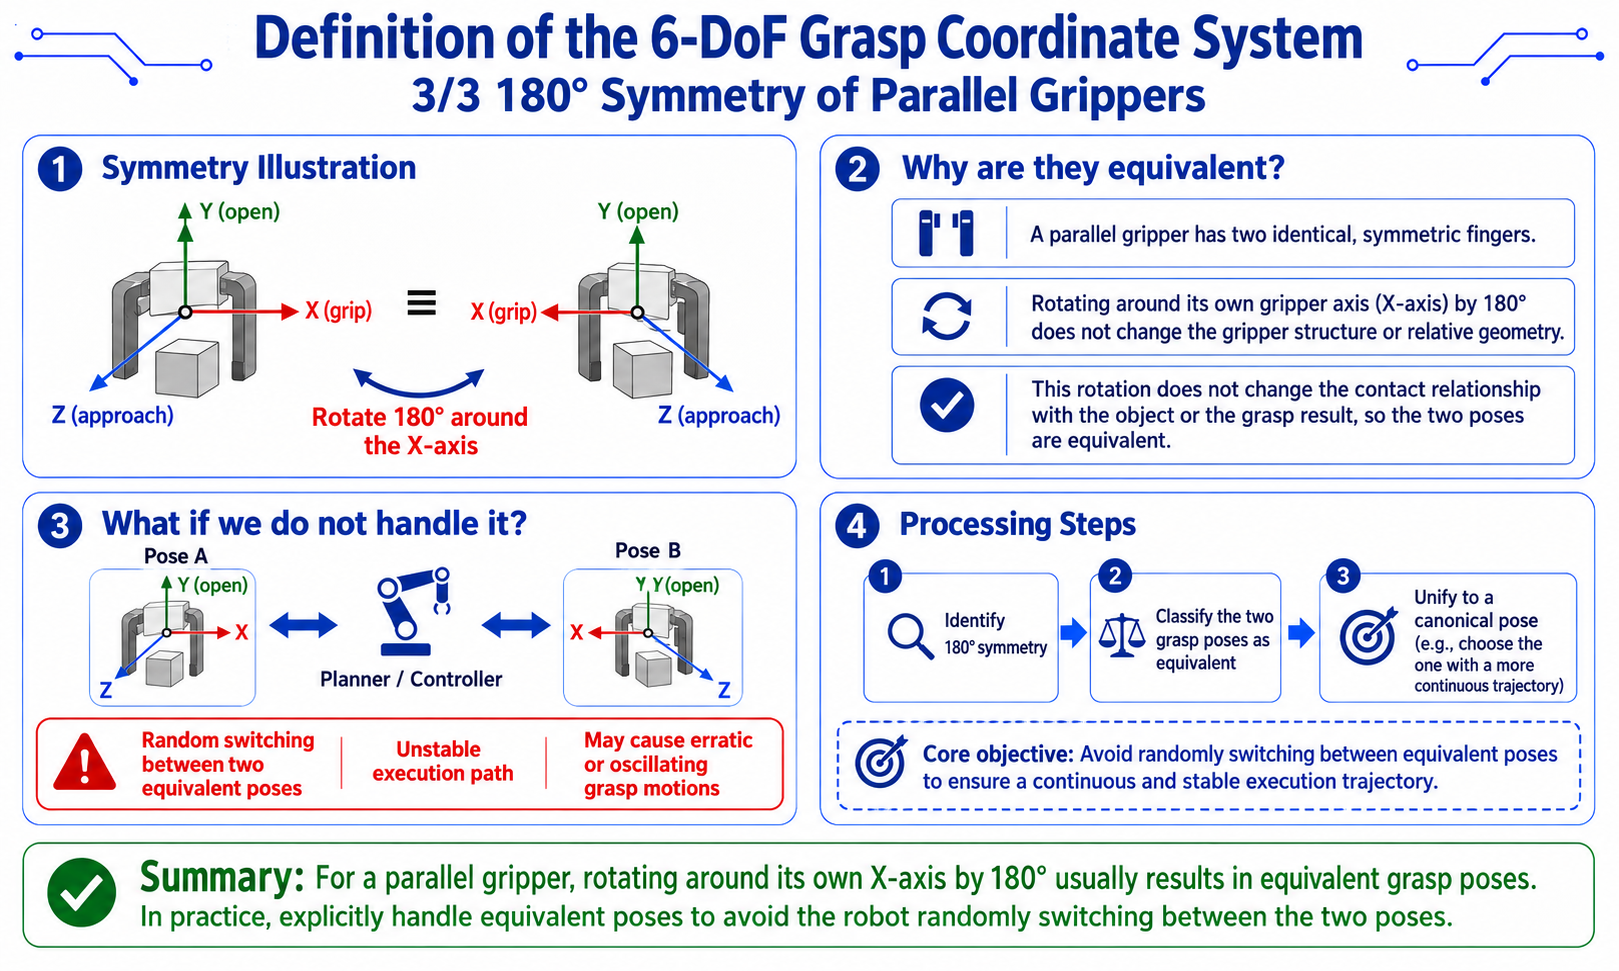
Simetría de 180 grados de un gripper paralelo
-
Un gripper paralelo (de dos dedos) tiene una simetría especial: rotar 180 grados alrededor de su propio eje X (eje del gripper) es equivalente.
[diagram: parallel-gripper symmetry]

   X (grip)     X (grip)
   |            |
   +-+    <=>    +-+
   | |   rotate  | |
   +-+  180 deg  +-+
| | -
Si no se maneja, el robot cambia aleatoriamente entre poses equivalentes y la trayectoria de ejecución se vuelve inestable.
-
Implementación:
# transforms.py L125-138 implementation reference
def canonicalize_parallel_gripper_tcp_rotation(R):
    """Pick a stable equivalent pose."""
    alt = R @ Rx(pi)  # rotate 180 deg about X

    roll = rotation_matrix_to_euler_zyx(R)[0]
    alt_roll = rotation_matrix_to_euler_zyx(alt)[0]

# pick the branch with smaller |roll| (roll~0 is usually more stable)
    return alt if abs(alt_roll) < abs(roll) else R
-
Estimación geométrica de agarre a partir de OBB + cuantil de profundidad
Flujo completo
-
Implementación:
# ordinary_grasp.py L98-219 core pseudocode
def estimate_grasp(result, index, depth_mm, K, depth_quantile=0.75):
# 1. get OBB
    rect_points = _rect_points(result, index, depth_mm.shape, bbox_xyxy)
    center = rect_points.mean(axis=0).astype(np.float32)

# 2. short edge = grasp direction
    short_vec_uv, short_len_px = _short_edge(rect_points)
    short_dir_uv = _normalize(short_vec_uv)

# 3. mask refinement (for curved objects)
    if short_dir_uv is not None:
        refined = _refine_grasp_line_from_mask(mask, center, short_dir_uv, long_len_px)
        if refined is not None:
            center, short_edge_points, grasp_span_px = refined

# 4. depth sampling (75th quantile within mask)
    depth_values = depth_mm[mask > 0]
    depth_values = depth_values[depth_values > 0]
    if len(depth_values) == 0:
        center_depth = get_depth_mm(depth_mm, center_px[0], center_px[1], 5)
        if center_depth > 0:
            depth_values = np.array([center_depth], dtype=np.float32)

    z_m = float(np.quantile(depth_values, depth_quantile) / 1000.0)

# 5. backproject center to 3D
    position = _backproject(float(center[0]), float(center[1]), z_m, K)

# 6. build three axes
    approach = _normalize(-position)       # Z axis: object toward camera
    open_axis = _pixel_vec_to_3d(short_dir_uv, z_m, K)
    open_axis = open_axis - float(np.dot(open_axis, approach)) * approach  # Gram-Schmidt
    open_axis = _normalize(open_axis)

# ensure open_axis[0] >= 0 (avoid symmetry ambiguity)
    if open_axis[0] < 0:
        open_axis = -open_axis

    grip_axis = _normalize(np.cross(open_axis, approach))
    open_axis = _normalize(np.cross(approach, grip_axis))

# 7. assemble rotation matrix
    rotation = np.column_stack([grip_axis, open_axis, approach]).astype(np.float32)

# 8. convert to reBotArm TCP rotation
    tcp_rotation = grasp_axes_to_rebot_tcp_rotation(
        rotation[:, 0], rotation[:, 1], rotation[:, 2]
    ).astype(np.float32)

# 9. estimate grasp width
    jaw_width_m = float(np.linalg.norm(
        _pixel_vec_to_3d(short_dir_uv * grasp_span_px, z_m, K)
    ))

    return grasp_pose
Ortogonalización de tres ejes en detalle
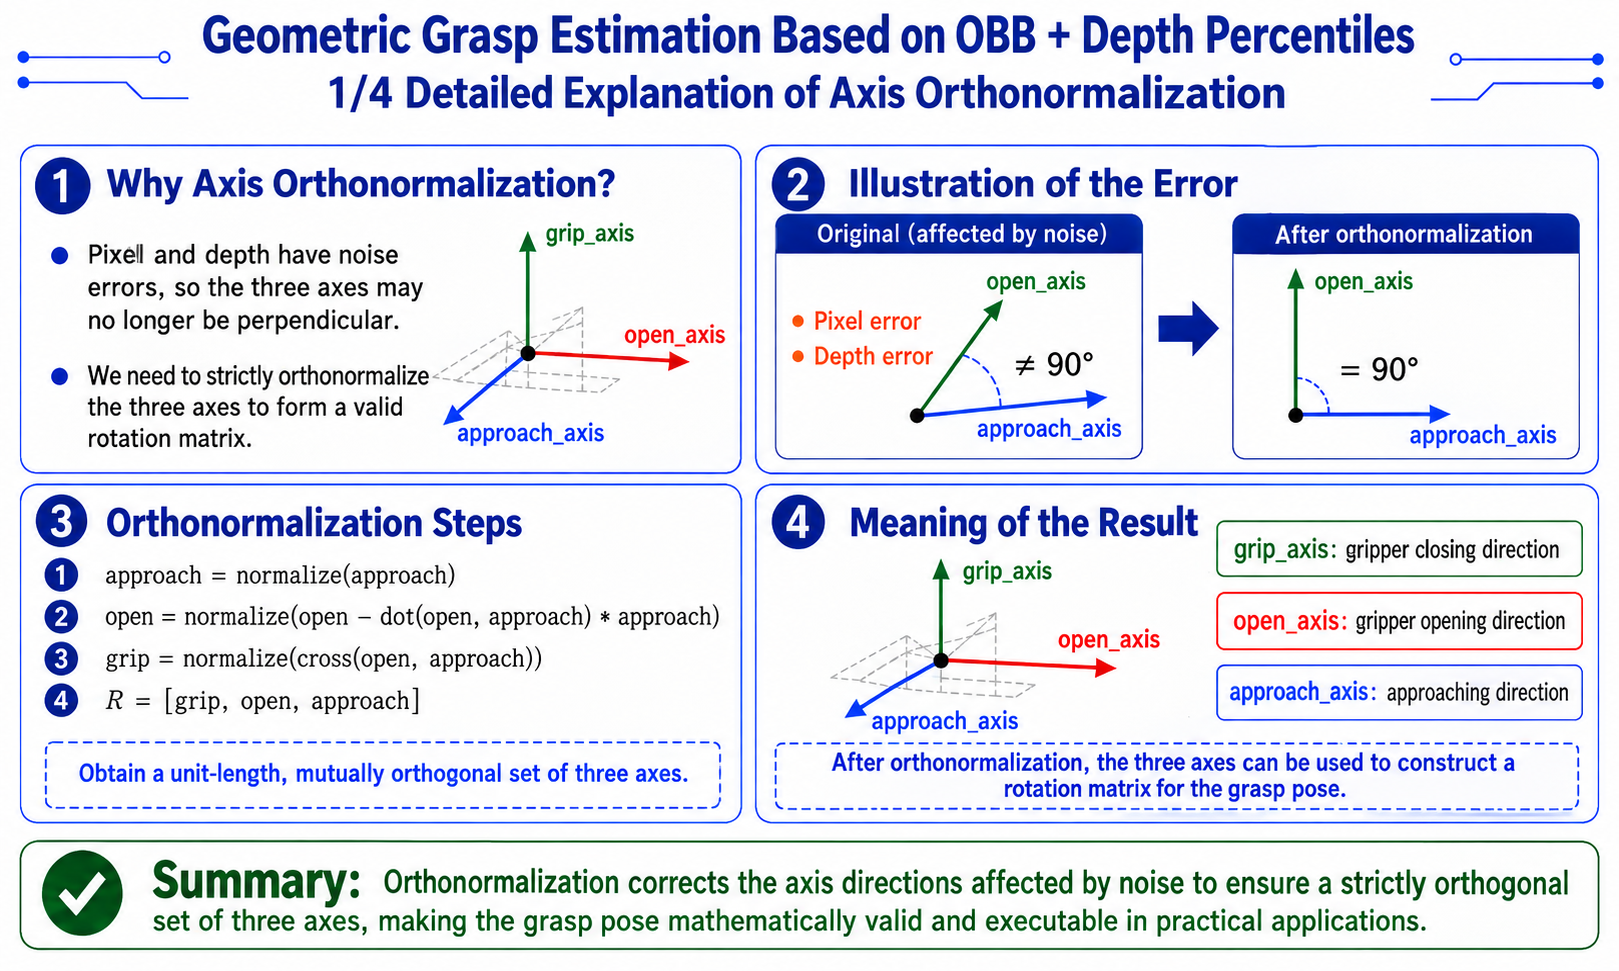
- Por qué ortogonalizar:
-
En el cálculo numérico, los vectores de píxeles y la profundidad ambos tienen error, por lo que
open_axisyapproachpueden no ser ortogonales. La ortogonalización de Gram-Schmidt garantiza una tríada estrictamente ortogonal que forma una matriz de rotación válida.# key steps
approach = -position / norm(position) # object toward camera
open_3d = pixel_to_3d(short_dir_uv, z_m, K) # short-edge direction in 3D
open_axis = open_3d - dot(open_3d, approach) * approach # Gram-Schmidt
open_axis = normalize(open_axis)
grip_axis = normalize(cross(open_axis, approach))
open_axis = normalize(cross(approach, grip_axis)) # re-orthogonalize for numerical stability
-
Función de retroproyección
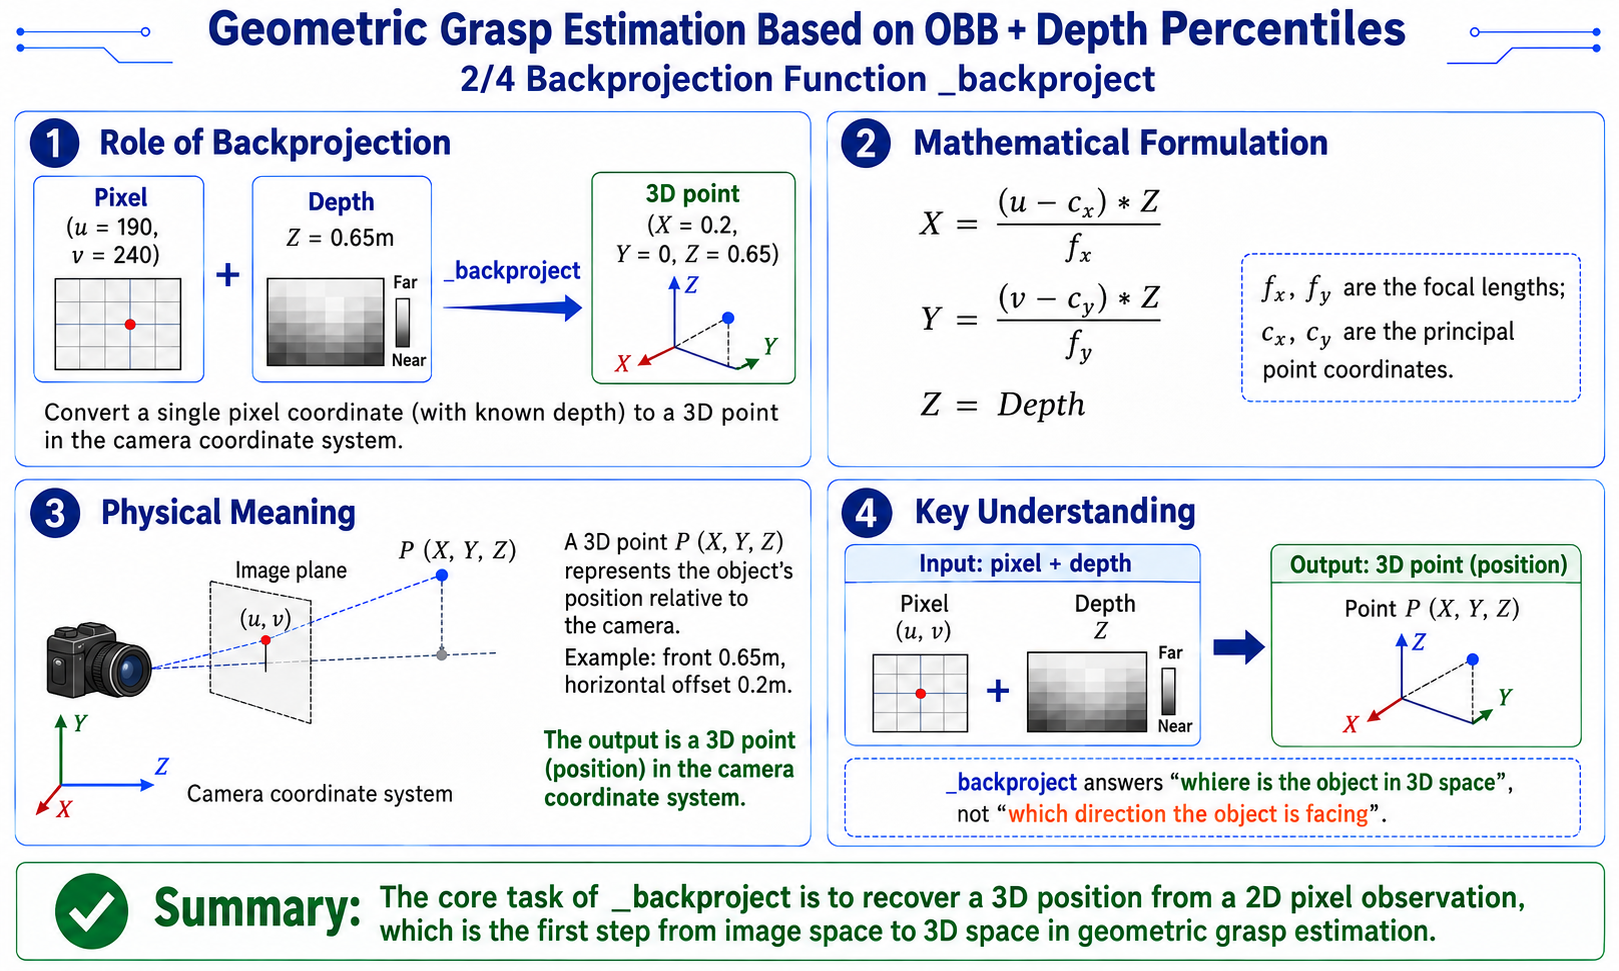
-
Función: convertir una única coordenada de píxel (con profundidad conocida) en un punto 3D (posición) en el marco de la cámara.
[diagram: physical meaning of backprojection]

  pixel (u=190, v=240) + depth Z=0.65m
           v _backproject
  3D point (X=0.2, Y=0, Z=0.65)
           v
"object is 0.65m ahead, 0.2m to the right" -
Implementación:
# ordinary_grasp.py L398-403 implementation
def _backproject(u, v, z_m, K):
    fx, fy = float(K[0, 0]), float(K[1, 1])
    cx, cy = float(K[0, 2]), float(K[1, 2])
    x = (u - cx) * z_m / fx
    y = (v - cy) * z_m / fy
    return np.array([x, y, z_m], dtype=np.float32)
Vector de píxel a vector 3D
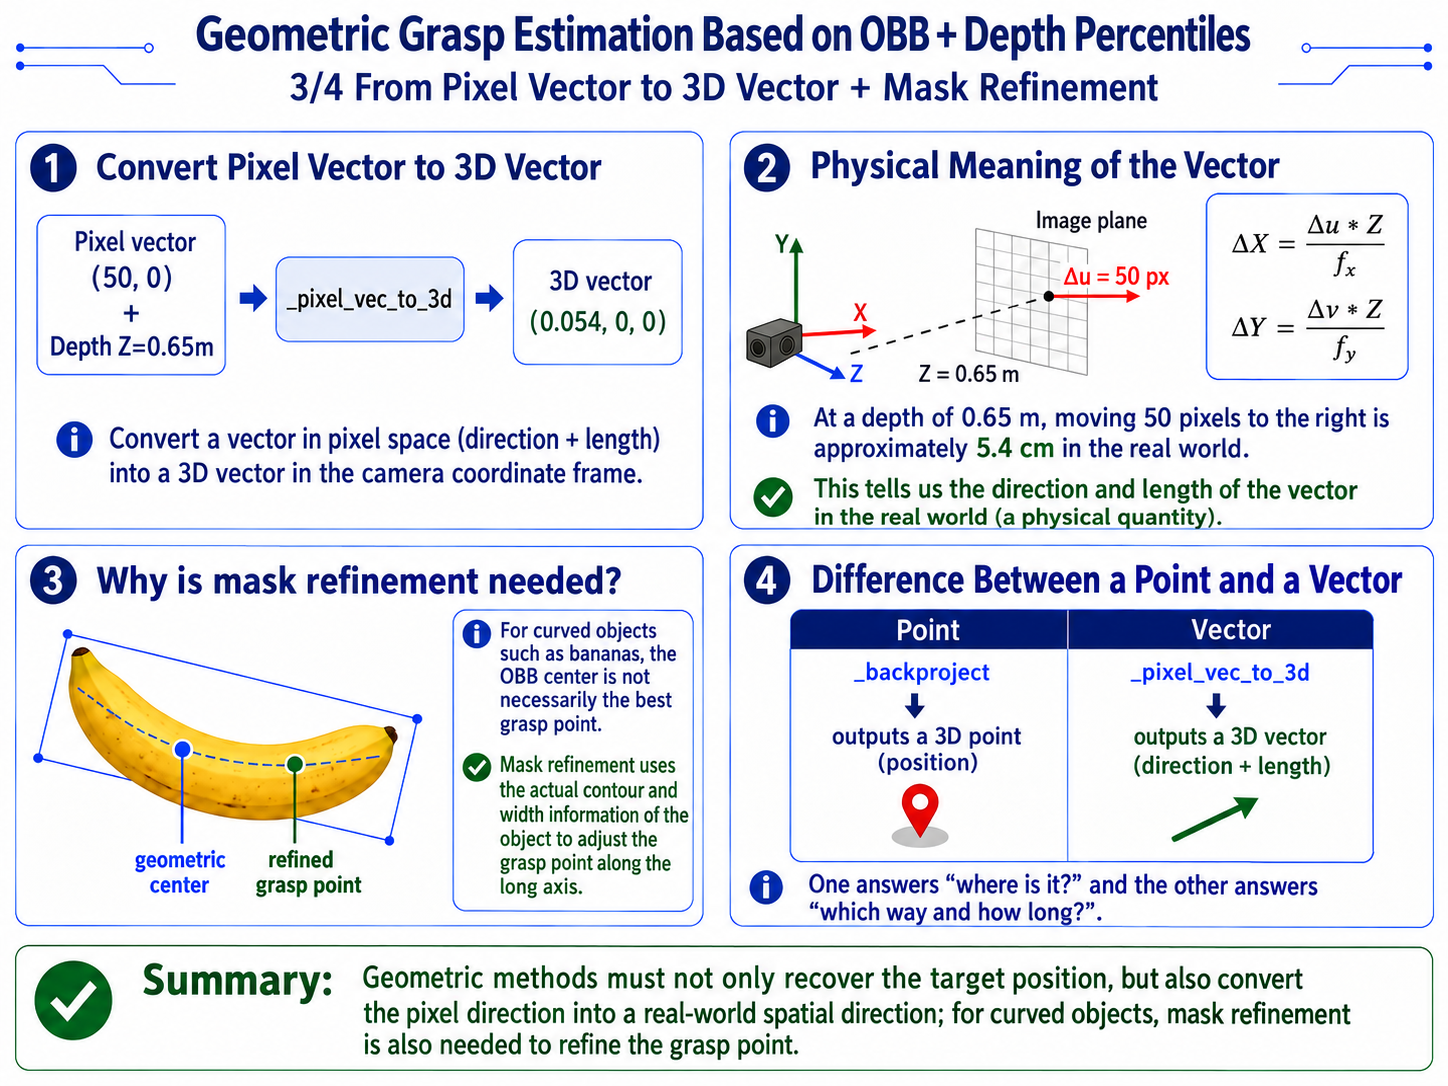
-
Función: convertir un vector en el espacio de píxeles (dirección + longitud) en un vector 3D en el marco de la cámara (dirección + longitud).
[diagram: physical meaning of a pixel vector]

  pixel vector (50, 0) + depth Z=0.65m
           v _pixel_vec_to_3d
  3D vector (0.054, 0, 0)
           v
"at depth 0.65m, 50 pixels right = 5.4 cm physical" -
Implementación:
# ordinary_grasp.py L406-408 implementation
def _pixel_vec_to_3d(vec_uv, z_m, K):
    fx, fy = max(float(K[0, 0]), 1e-6), max(float(K[1, 1]), 1e-6)
    return np.array([
        float(vec_uv[0]) * z_m / fx,
        float(vec_uv[1]) * z_m / fy,
        0.0
    ], dtype=np.float32)
Refinamiento de máscara (objetos curvos)
- Por qué se necesita el refinamiento de máscara:
-
El centro del OBB es el centro geométrico del objeto, pero para objetos curvos como un plátano, el mejor punto de agarre es una ubicación específica a lo largo del eje largo (normalmente cerca del medio). El refinamiento utiliza el ancho real de la máscara para ajustar el punto de agarre.
-
Implementación:
utils/ordinary_grasp.py_refine_grasp_line_from_mask()(L233-275)# ordinary_grasp.py L233-275 implementation
def _refine_grasp_line_from_mask(mask, center, short_dir_uv, long_len_px):
"""Refine the short-axis grasp point using the mask's central cross-section."""
ys, xs = np.nonzero(mask > 0)
if len(xs) < 32:
return None # mask too small, skip refinement
points = np.column_stack([xs, ys]).astype(np.float32)
grip_dir_uv = np.array([-short_dir_uv[1], short_dir_uv[0]], dtype=np.float32)
rel = points - center.reshape(1, 2)
grip_coord = rel @ grip_dir_uv # coordinate along short axis
open_coord = rel @ short_dir_uv # coordinate along long axis
grip_center = float(np.median(grip_coord))
band_half_width = clip(long_len_px * 0.04, 2.0, 12.0)
band_mask = np.abs(grip_coord - grip_center) <= band_half_width
if count(band_mask) < 24:
band_half_width = clip(long_len_px * 0.08, 4.0, 18.0)
band_mask = np.abs(grip_coord - grip_center) <= band_half_width
if count(band_mask) < 24:
return None
# within the band, take 5%/95% quantiles along open direction
open_min = np.percentile(open_coord[band_mask], 5.0)
open_max = np.percentile(open_coord[band_mask], 95.0)
open_center = 0.5 * (open_min + open_max)
# recombine center
refined_center = center + grip_center * grip_dir_uv + open_center * short_dir_uv
short_edge_points = _line_from_center(refined_center, short_dir_uv * (open_max - open_min))
return refined_center, short_edge_points, float(open_max - open_min)
-
Cuándo funciona el método geométrico—y sus límites
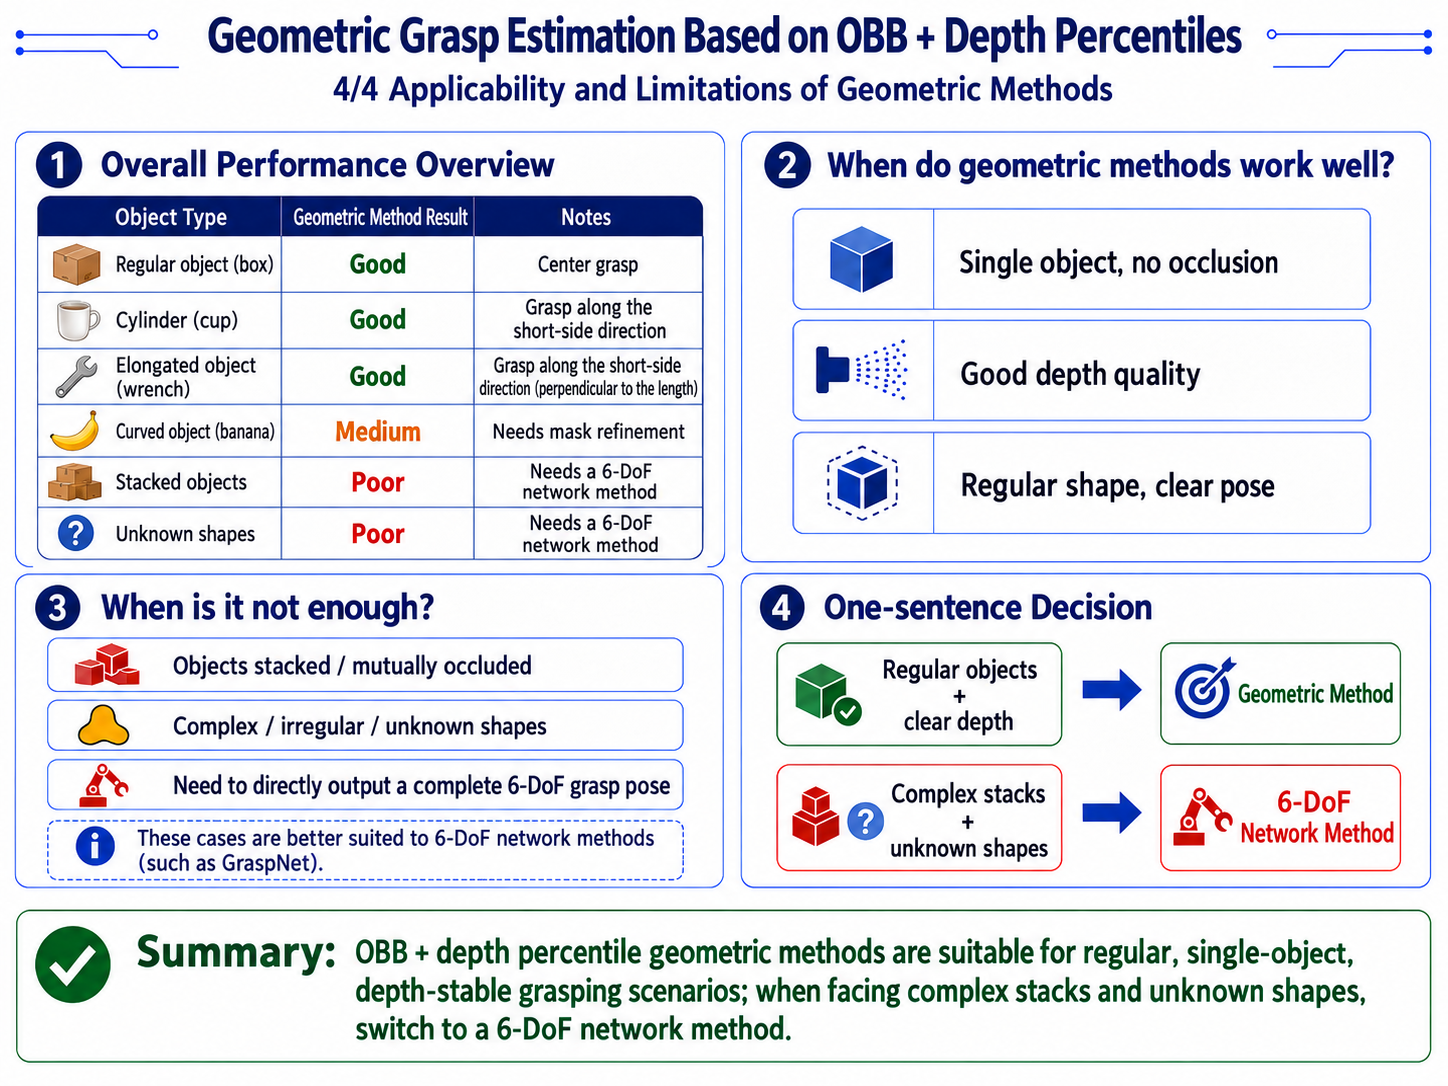
Estimación de agarre 6-DoF con redes de nubes de puntos (GraspNet)
Implementación:
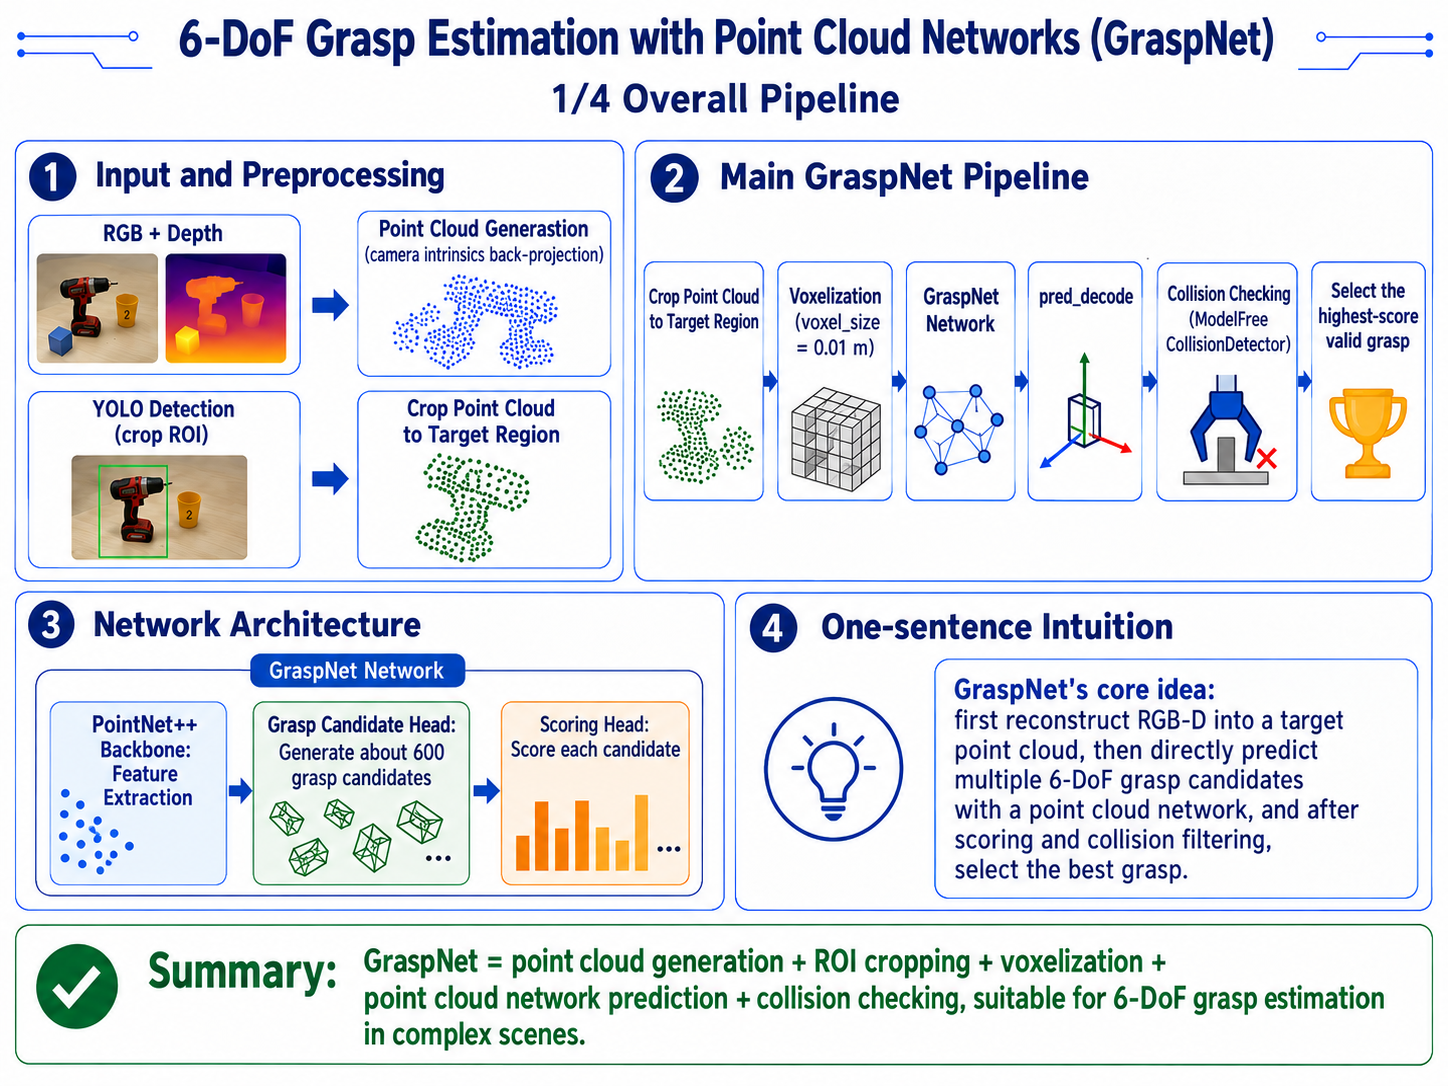
[diagram: GraspNet pipeline]

RGB + depth
  |
  +-> point cloud generation (backproject with camera intrinsics)
  |
  +-> YOLO detection (crop ROI)
       |
       +-> crop point cloud to target region
            |
            +-> voxelize (voxel_size = 0.01 m)
                 |
                 +-> GraspNet network
                      |
                      +-> PointNet++ backbone (feature extraction)
                      |
                      +-> grasp candidate head (~600 candidates)
                      |
                      +-> scoring head (scores each candidate)
                           |
                           +-> pred_decode (parse into Grasp objects)
                                |
                                +-> collision detection (ModelFreeCollisionDetector)
                                     |
                                     +-> pick the highest-scoring valid grasp
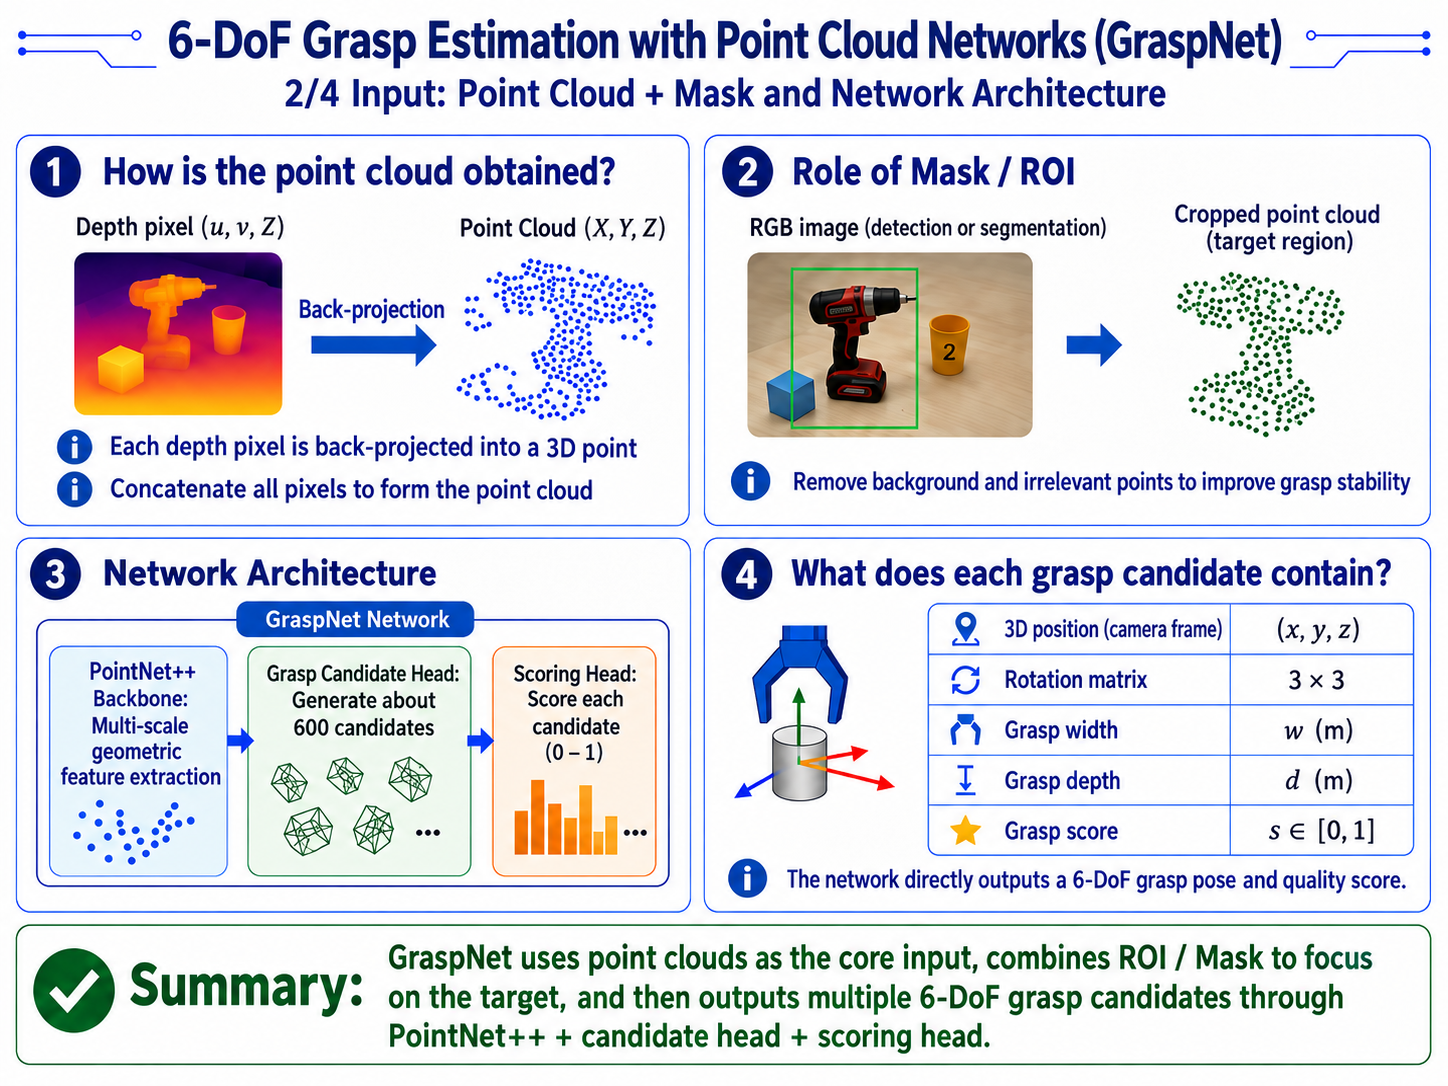
Entrada: nube de puntos + máscara
-
Implementación:
# graspnet_utils.py L21-25 implementation
PROJECT_ROOT = Path(__file__).resolve().parents[1]
GRASPNET_ROOT = PROJECT_ROOT / "sdk" / "graspnet-baseline"
DEFAULT_NUM_VIEW = 300
DEFAULT_VOXEL_SIZE = 0.01              # 1 cm voxel
DEFAULT_WARMUP_FRAMES = 20
DISPLAY_FLIP_X = np.diag([1.0, -1.0, -1.0, 1.0]).astype(np.float64) -
Nube de puntos retroproyectada desde el mapa de profundidad:
- Cada píxel de profundidad (u, v, Z) se retroproyecta a (X, Y, Z)
- Concatenar todos los píxeles en la nube de puntos
-
Estructura de la red
- Backbone PointNet++
- Backbone de características de nube de puntos que extrae características geométricas multi-escala desde lo local a lo global.
- Cabeza de candidatos de agarre
- Produce muchos candidatos de agarre 6-DoF (~600), cada uno conteniendo: posición 3D (marco de la cámara), matriz de rotación, ancho de agarre, profundidad de agarre.
- Cabeza de puntuación
- Puntúa cada candidato (0-1); una puntuación más alta significa mayor probabilidad de éxito.
- Backbone PointNet++
Formato de salida
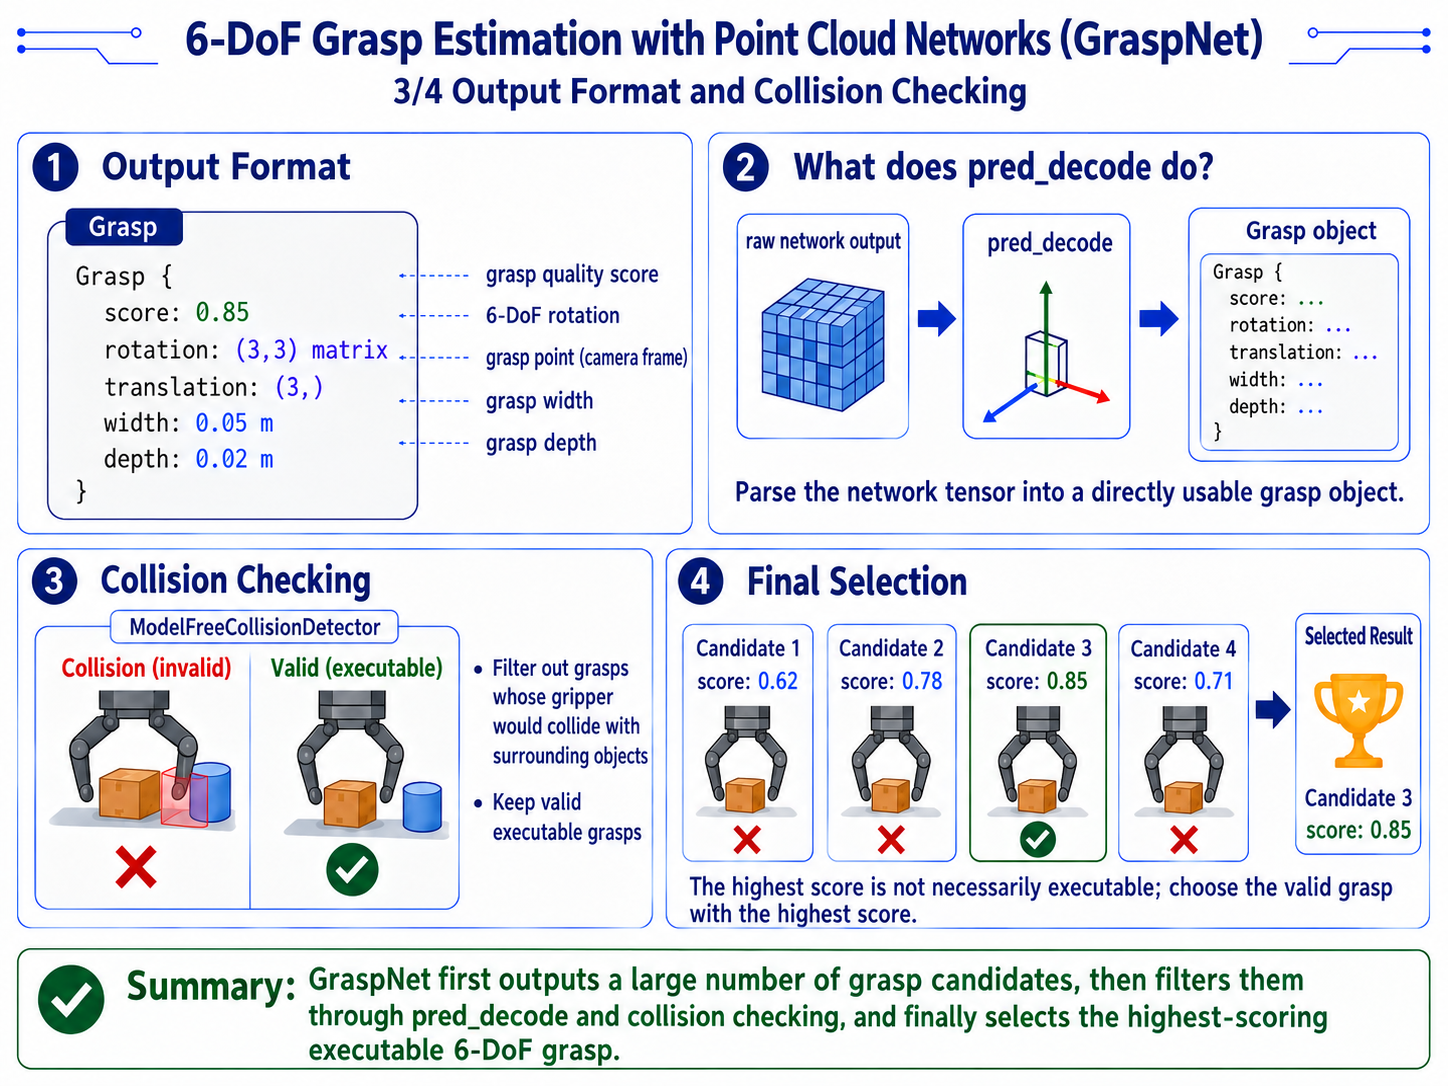
Grasp {
  score: 0.85              # grasp quality score
  rotation: (3, 3) matrix  # 6-DoF rotation
  translation: (3,)        # grasp point (camera frame)
  width: 0.05              # grasp width (m)
  depth: 0.02              # grasp depth (m)
}
Detección de colisiones
-
Implementación:
# graspnet_utils.py L45 implementation
from collision_detector import ModelFreeCollisionDetector # noqa -
El detector de colisiones comprueba si la pinza chocaría con objetos circundantes al ejecutar el agarre y filtra los agarres con colisión.
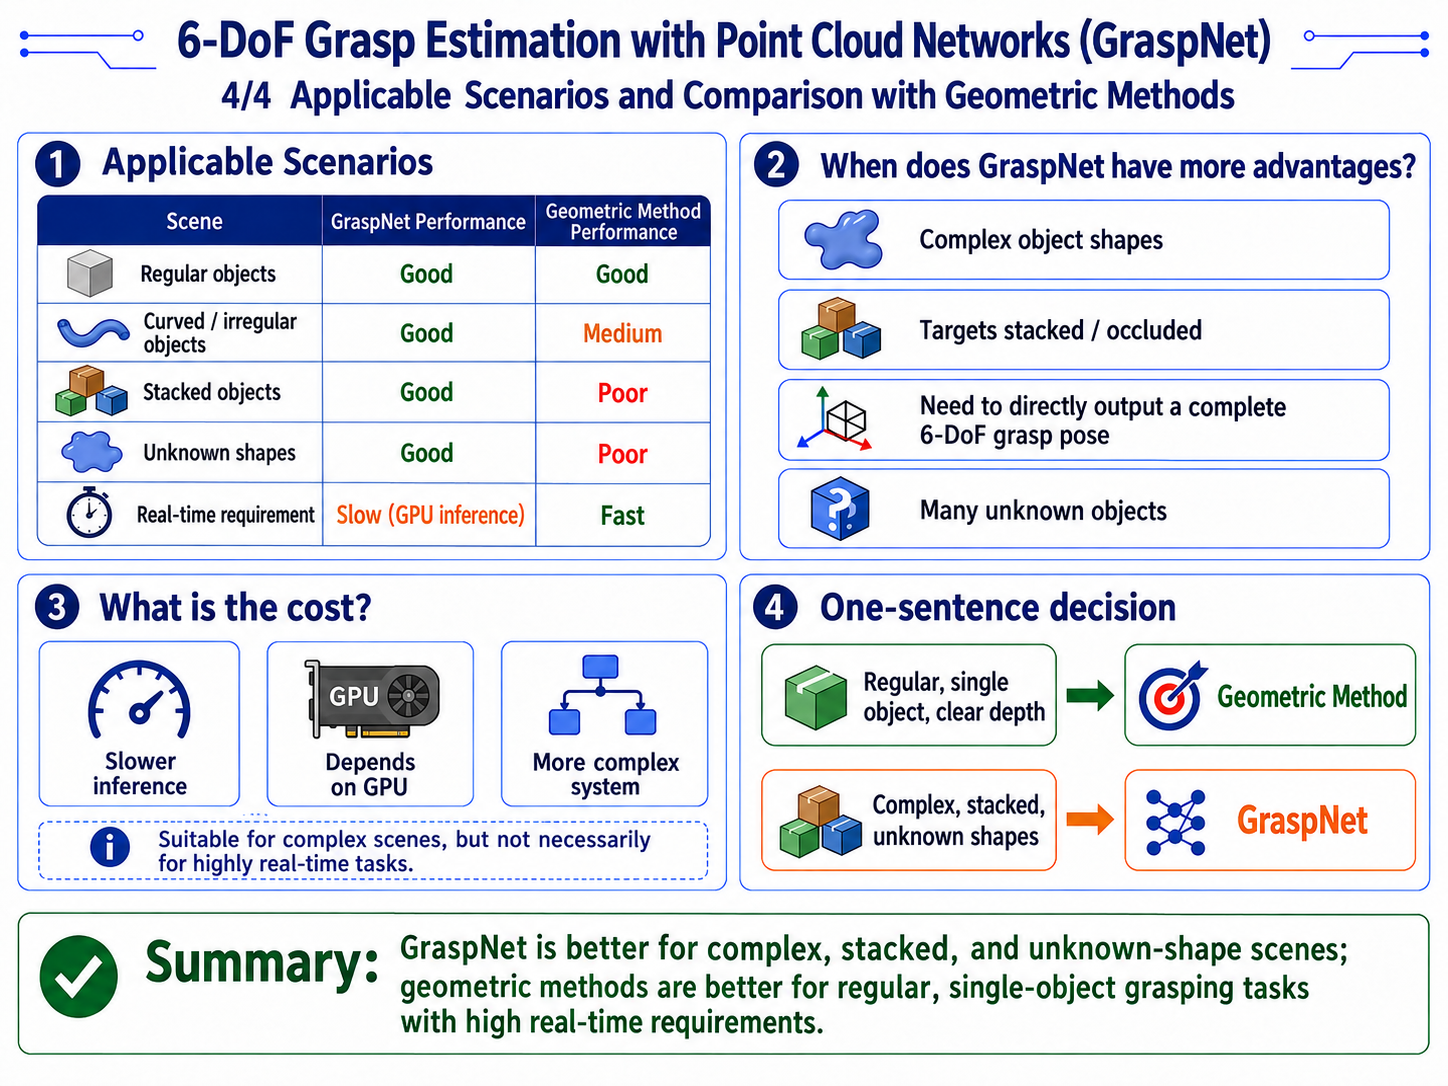
Escenarios adecuados
Conversión de la pose de agarre al marco base
-
Implementación:
# transforms.py L227-240 implementation
def transform_grasp_pose_to_base_with_retreat(
    position_cam,           # grasp point (camera frame)
    tcp_rotation_cam,       # TCP rotation (camera frame)
    T_cam2base,             # hand-eye camera->base matrix
    pregrasp_offset_m,      # pregrasp retract distance
    retreat_offset_m,       # retreat distance
    insertion_depth_m=0.0,
):
# 1. transform grasp point to base frame
    T_grasp_cam = make_T(position_cam, tcp_rotation_cam)
    T_grasp_base = T_cam2base @ T_grasp_cam

# 2. canonicalize parallel-gripper symmetry
    T_grasp_base[:3, :3] = canonicalize_parallel_gripper_tcp_rotation(T_grasp_base[:3, :3])

# 3. offset along TCP X to get pregrasp and retreat
    T_grasp_base = offset_along_tool_x(T_grasp_base, -insertion_depth_m)
    T_pregrasp_base = offset_along_tool_x(T_grasp_base, pregrasp_offset_m)
    T_retreat_base = offset_along_tool_x(T_grasp_base, retreat_offset_m)

# 4. convert back to 6D pose
return mat4_to_pose6d(T_grasp_base), mat4_to_pose6d(T_pregrasp_base), mat4_to_pose6d(T_retreat_base)-
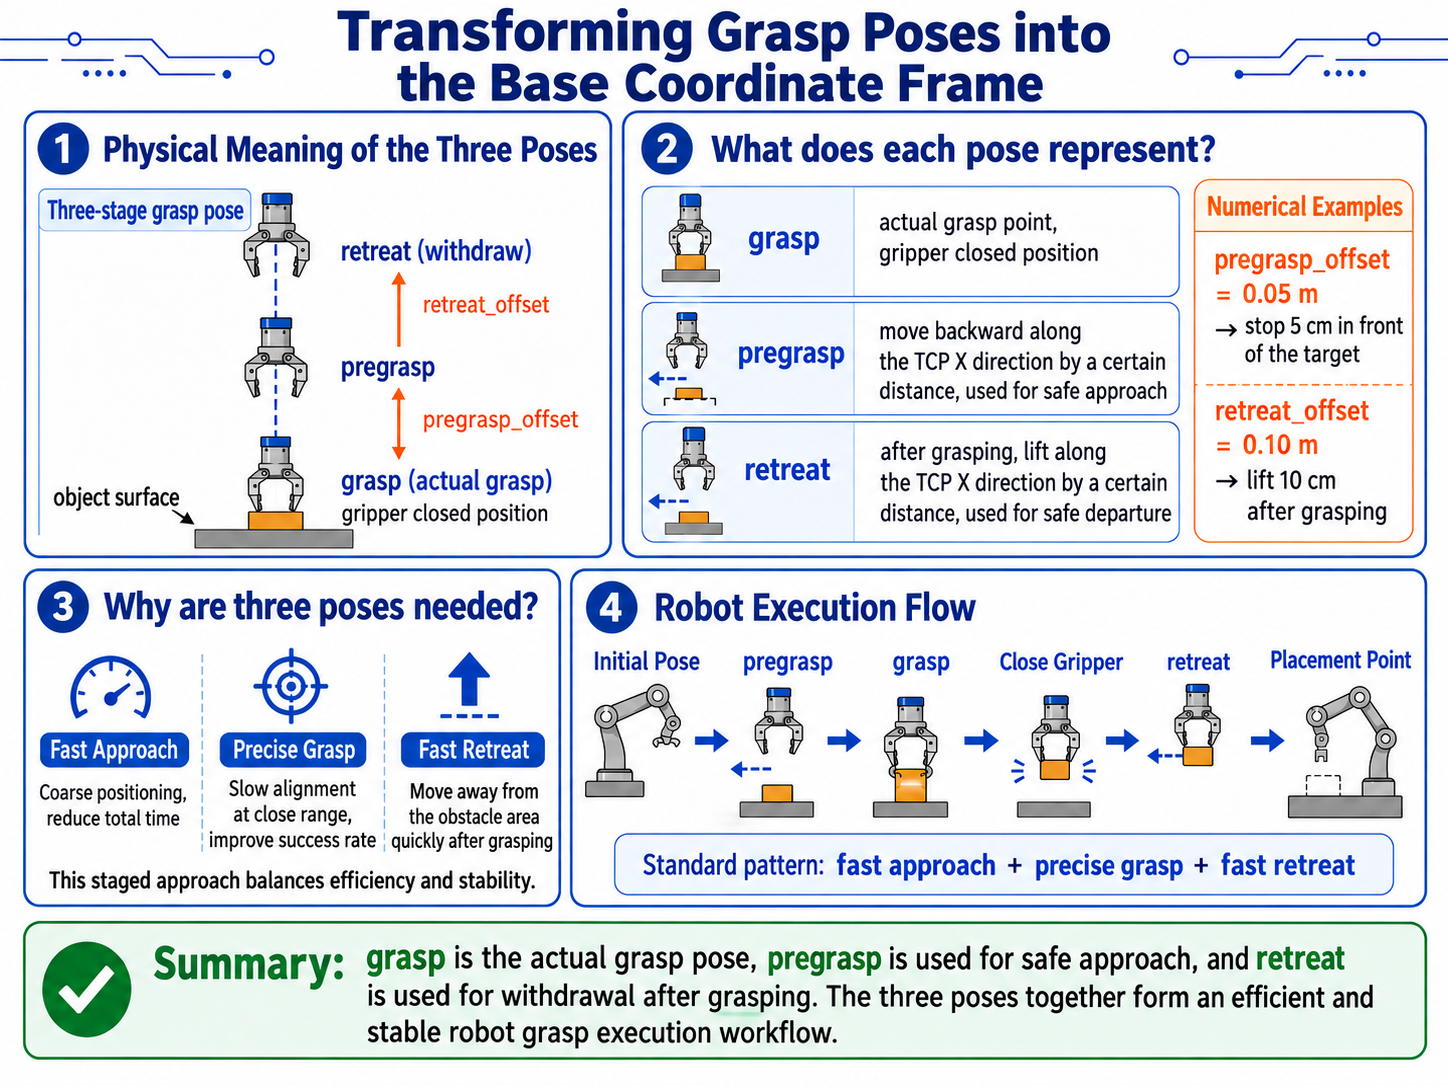
Significado físico de las tres poses
[diagram: three grasp-pose stages]

       retreat
         ^
         | retreat_offset
         |
       pregrasp
         ^
         | pregrasp_offset
         |
       grasp
v object surface- grasp: el punto de agarre real, donde se cierra la pinza
- pregrasp: punto de pre-agarre, retraído a lo largo del eje X del TCP cierta distancia, para una aproximación libre de obstáculos
- retreat: punto posterior al agarre, elevado a lo largo del eje X del TCP cierta distancia después de agarrar
- Por ejemplo:
- pregrasp_offset = 0.05 m -> detenerse 5 cm antes de aproximarse
- retreat_offset = 0.10 m -> elevar 10 cm después de agarrar
-
Por qué se necesitan tres poses
- Flujo estándar de agarre del robot:
- Moverse desde la posición inicial hasta pregrasp (rápido, posicionamiento grueso)
- Moverse lentamente desde pregrasp hasta grasp (alineación precisa)
- Cerrar la pinza
- Elevar desde grasp hasta retreat (retirada rápida)
- Moverse desde retreat hasta el punto de colocación
Este patrón de "aproximación rápida + agarre preciso + retirada rápida" garantiza la precisión del agarre mientras mejora la eficiencia general.