14. Modelo ACT y acción por bloques
Capítulo 14 del curso para principiantes de SO-ARM Physical AI — entrada y salida de ACT, la estructura ResNet y Transformer, la intuición de la atención, CVAE, bloque de acción vs. horizonte de acción, las dos defensas contra el error acumulado y los límites de ACT.
14.1 De la clonación de comportamiento a ACT
14.1 De la clonación de comportamiento a ACT: solo falta "un buen modelo"
El Capítulo 8 cubrió la clonación de comportamiento: grabar demos de teleoperación como dataset y dejar que el modelo aprenda "hacer lo que ve". Quedó una pregunta — ¿qué modelo merece esos datos? Una política desplegable debe cruzar al menos tres vallas:
- Entender imágenes.
- Pensar con coherencia.
- Resistir el error acumulado.
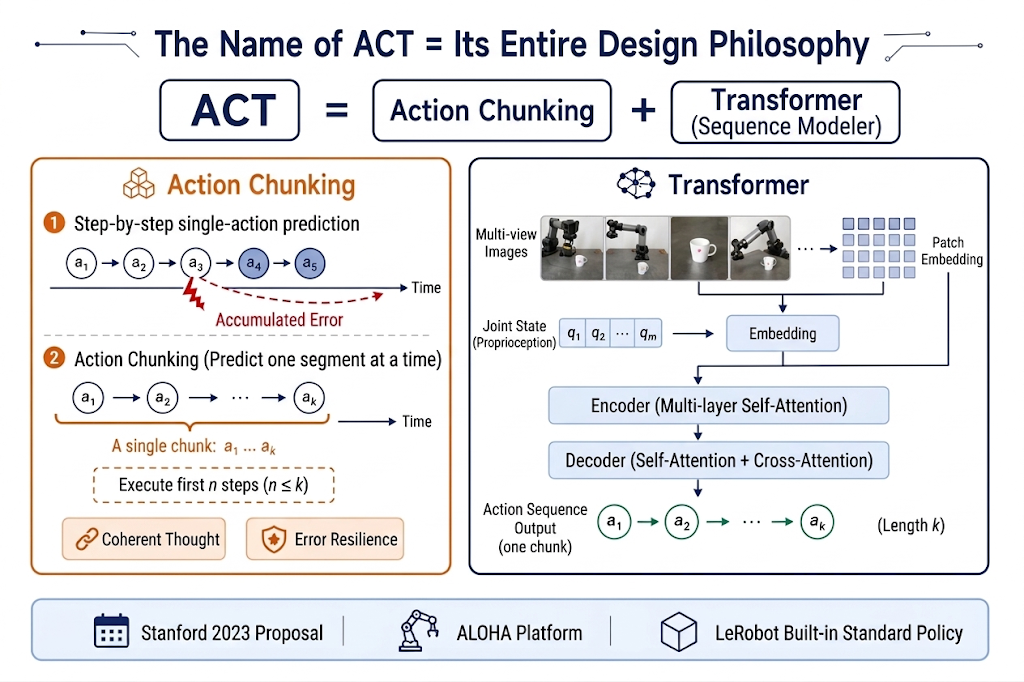
ACT (Action Chunking with Transformers) es el modelo construido para cruzarlas. Propuesto por un equipo de Stanford en 2023, se hizo famoso en la plataforma de doble brazo ALOHA de bajo costo con tareas delicadas como abrir tapas y sellar bolsas; después, Mobile ALOHA mostró tareas complejas como cocinar camarones. Hoy es una de las políticas estándar de LeRobot — y el modelo que entrenarás y desplegarás en esta etapa.
El nombre de ACT ES toda su filosofía de diseño: Action Chunking + Transformer (modelador de secuencias). El resto del capítulo desarma estos dos términos.
14.2 Entrada y salida de ACT
14.2 Entrada y salida de ACT: mira primero los dos extremos
La forma más fiable de entender un modelo es mirar su "interfaz" — qué recibe y qué devuelve.
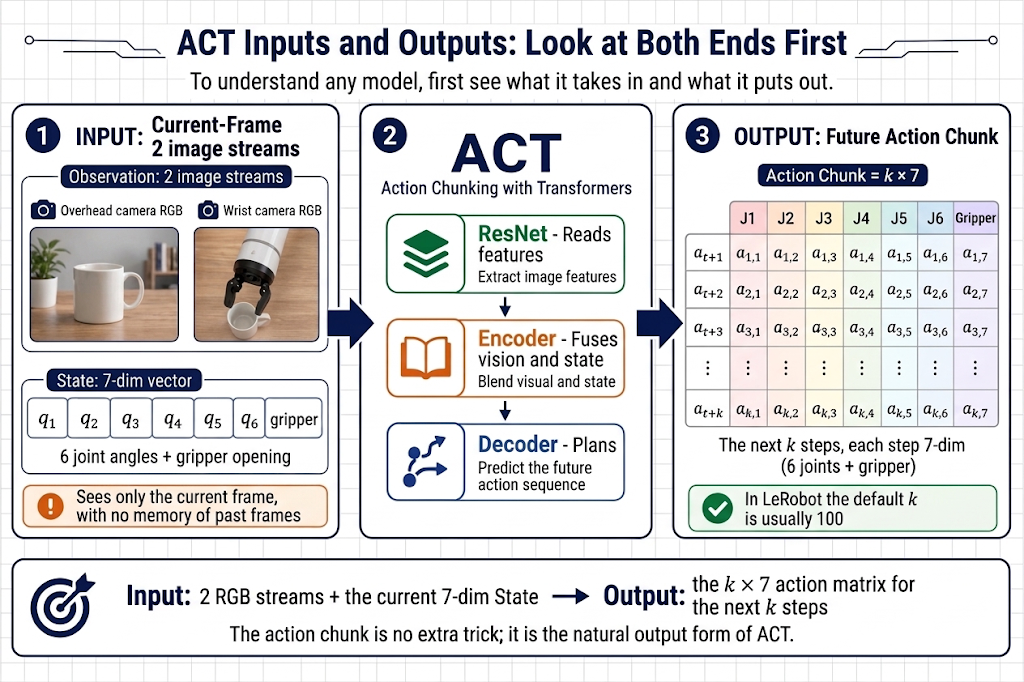
Entrada: la observación actual
En la inferencia, ACT recibe un fotograma con dos tipos de información:
| Entrada | En el SO-ARM | Dimensionalidad |
|---|---|---|
| Imágenes (observación) | Vistas RGB frontal + lateral | 2 × imágenes |
| Estado articular (estado) | 5 ángulos + apertura de pinza | vector de 6 |
Nota que ACT es de un solo fotograma: no recuerda fotogramas pasados; cada decisión se basa en "lo que ve ahora + dónde están las articulaciones ahora".
Salida: bloque de acciones para una ventana corta de futuro
La salida de ACT no es la siguiente acción, sino un bloque completo (Action Chunk):
Entrada: 2 flujos de imagen + estado articular de 6 (fotograma actual)
Salida: secuencia de acciones de los próximos k pasos, cada paso de 6 (5 articulaciones + pinza)
      es decir, una matriz de acciones k × 6
En la configuración por defecto de LeRobot, k (chunk size) suele ser 100 — una inferencia entrega el plan completo de unos 100 pasos futuros. Esto responde al planteado en el Capítulo 8: el bloque de acciones no es un truco abstracto; es la forma natural de salida de ACT.
14.3 Estructura interna de ACT
14.3 Estructura interna de ACT: tres talleres en una línea
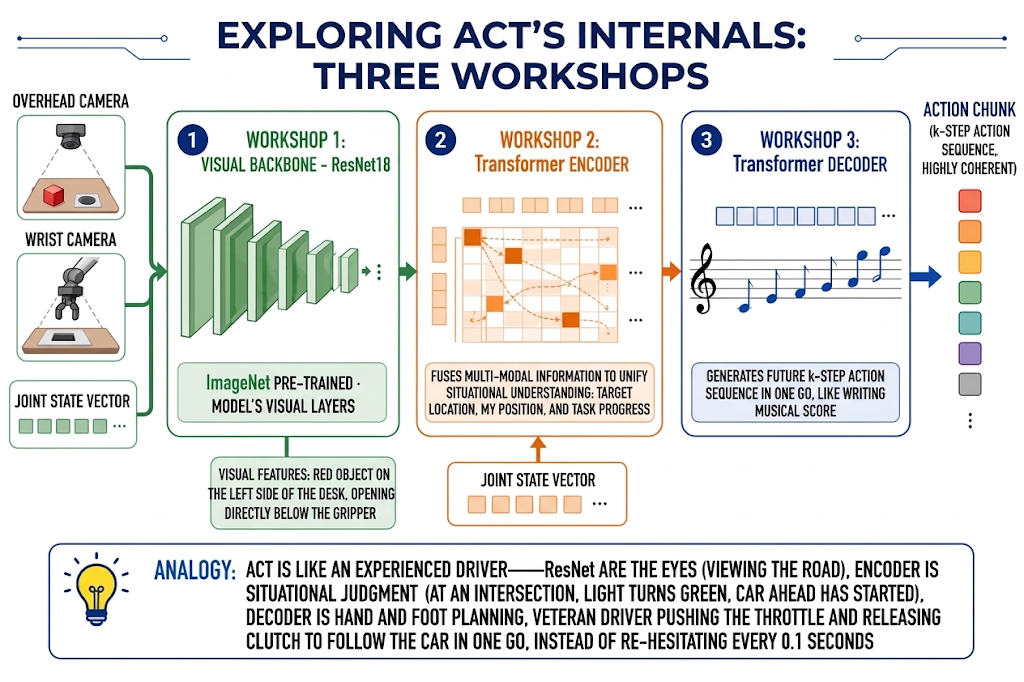
Taller 1: columna visual (ResNet) — de píxeles a características
Las imágenes frontal y lateral pasan cada una por un ResNet18 (CNN preentrenado en ImageNet), comprimidas en un conjunto de características visuales. Piensa en ResNet como la "corteza visual" del modelo: los píxeles crudos no le dicen nada; extrae información estructurada como "hay un objeto rojo a la izquierda" o "hay una apertura justo debajo de la pinza".
Taller 2: codificador Transformer — entender "el presente"
Las características visuales + el vector de estado se funden y entran al codificador Transformer. Su trabajo es fusionar los flujos en un entendimiento unificado de la situación: "dónde está el objetivo, dónde estoy, en qué punto de la tarea voy".
Taller 3: decodificador Transformer — planificar "el futuro"
El decodificador toma ese entendimiento y genera de una vez la secuencia de los próximos k pasos. No escupe acciones una a una; como quien escribe una partitura, compone de un aliento todo el "movimiento futuro" — esa es la razón profunda de que los bloques sean internamente tan coherentes.
14.4 Qué es un Transformer
14.4 Qué es un Transformer: la intuición de la atención
Los talleres 2 y 3 de ACT son Transformer, pero ¿qué ES un Transformer?
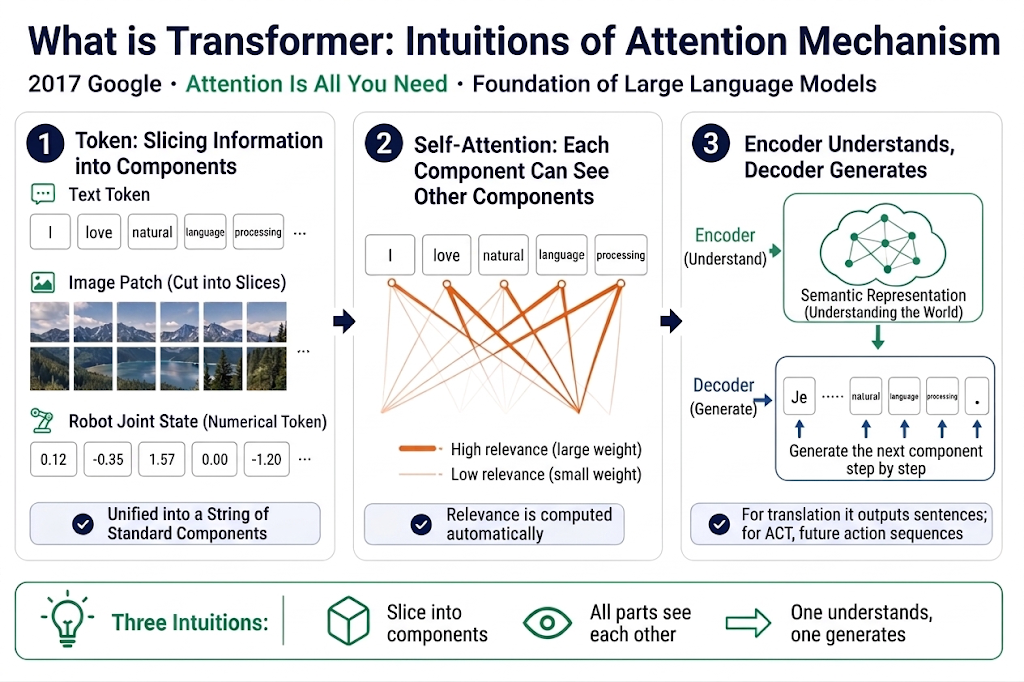
Lo propuso Google en 2017 para traducción automática; el paper se titula "Attention Is All You Need", y luego se volvió la arquitectura base de los grandes modelos de lenguaje. Sin fórmulas — tres intuiciones bastan:
- Token: cortar la información en "piezas". Los Transformer no procesan frases o píxeles crudos; primero cortan la entrada en piezas estandarizadas (tokens) — una frase en palabras, una imagen en parches, un vector de estado también puede ser un token. Unificada la información en "secuencia de piezas", el mismo mecanismo la procesa toda.
- Auto-atención: cada pieza puede "ver" a todas las demás. Es el núcleo del Transformer. Al procesar cada pieza, calcula su relevancia con todas las otras y se concentra en absorber de las más relevantes — "qué mirar" no lo prescribe un humano; lo aprende el modelo.
- Codificador y decodificador: uno entiende, otro genera. El codificador funde una secuencia de entrada en "un entendimiento de la situación"; el decodificador toma ese entendimiento y genera una nueva secuencia — en traducción, la frase en el idioma destino; en ACT, la secuencia de acciones futuras.
14.5 Cómo se usa el Transformer en ACT
14.5 Cómo se usa el Transformer en ACT
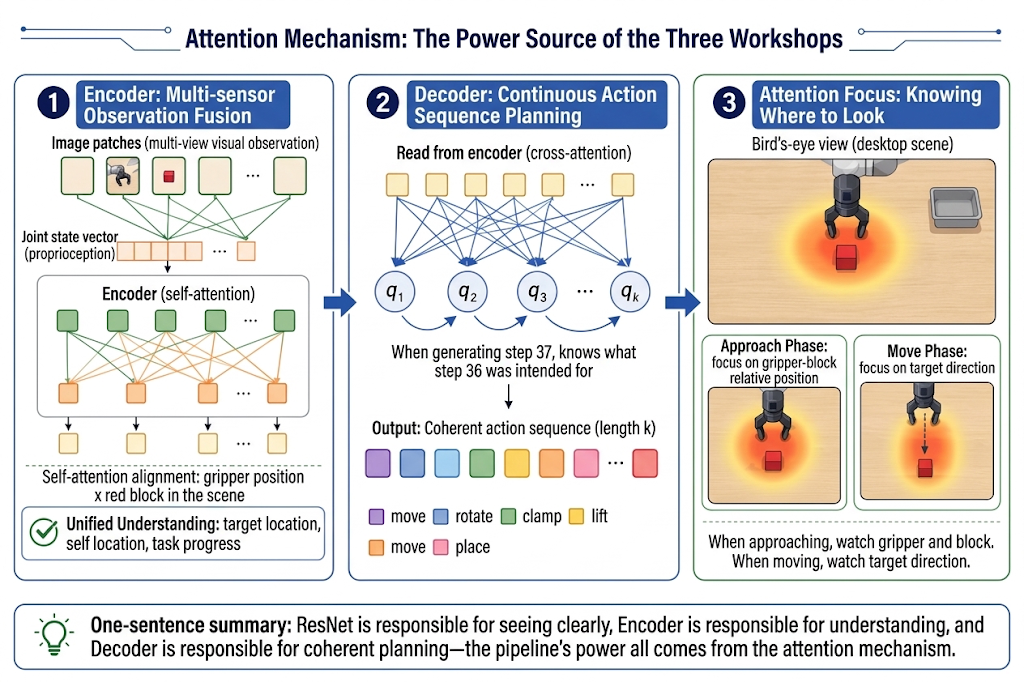
- En el codificador: fusionar múltiples observaciones. Los parches visuales de ambas imágenes (vía ResNet) más el vector de estado se vuelven tokens del codificador. La auto-atención los alinea — "la posición actual de la pinza" y "ese bloque rojo de la imagen" quedan unidos en un solo entendimiento: dónde está el objetivo, dónde estoy, cómo voy.
- En el decodificador: planificar toda la secuencia de golpe. El decodificador usa k vectores de consulta correspondientes a los k pasos futuros; estas consultas extraen del entendimiento del codificador y se coordinan entre sí por auto-atención — la acción del paso 37 "sabe" qué pretende el paso 36. Todo el bloque es un todo orgánico, no 100 decisiones aisladas.
- En el foco atencional: saber "qué mirar". Al generar cada acción, el modelo se concentra automáticamente en las regiones más relevantes — al acercarse al objetivo, en la posición relativa pinza-objeto; en movimiento, en la dirección del objetivo — y no trata todas por igual.
En una frase: ResNet "ve claro", el codificador Transformer "entiende", el decodificador Transformer "planifica con coherencia" — todo impulsado por la atención.
14.6 Qué es CVAE
14.6 Qué es CVAE
CVAE (autoencoder variacional condicional). El ACT de LeRobot realmente entrena con esto, aunque no lo veas en la línea lerobot-train --policy.type=act.
El pozo que evita: el fallo del promedio
El trabajo del CVAE no es "reducir al humano a una única respuesta correcta", sino admitir: dada la observación, las acciones pueden tener varios estilos; durante el entrenamiento identifica primero cuál es, y luego reproduce esa secuencia.
El paper comparó (en tareas simuladas):
- Si las demos son scripted (una sola forma), quitar el CVAE apenas afecta al éxito.
- Con datos humanos, quitarlo cae de ~35% a 2%.
Así que el CVAE no está para adornar fórmulas, sino para que el modelo aguante datos donde "el humano cambia de enfoque y le tiembla la mano".
"Condicional" significa: las acciones generadas deben fundarse en lo que se ve — haya un bloque o un bolígrafo en la mesa, no puede inventar. El CVAE es "dado lo que ves, componer cómo moverse".
14.7 Bloque de acción vs. horizonte de acción
14.7 Bloque de acción vs. horizonte de acción
Los dos conceptos mejor diferenciados del capítulo; dos parámetros ajustables de forma independiente:
- Bloque de acción (Action Chunk): el largo de la secuencia que el modelo predice en una pasada, es decir, las filas k de la matriz de salida. En LeRobot, ACT usa por defecto 100.
- Horizonte de acción (Action Horizon): tras predecir esos 100 pasos, cuántos se ejecutan realmente en lazo abierto antes de reobservar y repredecir.
La relación: el bloque predicho puede ser largo, pero cada vez solo se confía en el primer segmento.
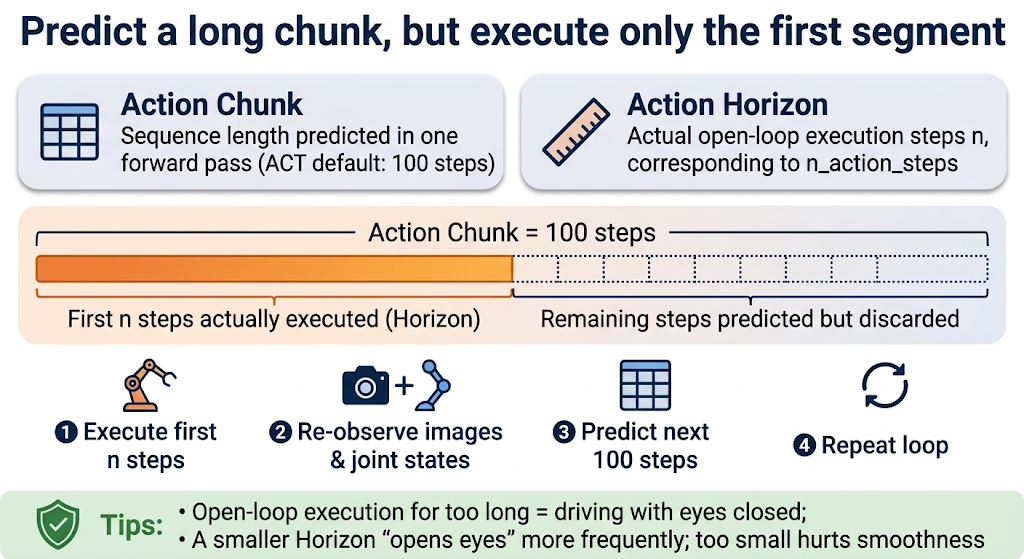
¿Por qué no ejecutar los 100? Porque predecir lejos es menos fiable — el entorno cambia, los objetos se mueven, y en la segunda mitad la "situación asumida" ya se desvió de la realidad. Un lazo abierto demasiado largo = conducir con los ojos cerrados. Cuanto menor el horizonte, más "abre los ojos" el modelo y más robusto ante perturbaciones; pero demasiado pequeño pierde la suavidad del chunking.
Es como navegar con el móvil mientras conduces. El navegador (el modelo) calcula la ruta completa (bloque) de una vez, pero no bloqueas el volante — cada pocos kilómetros miras el tráfico (reobservas) y el navegador replanifica (repredecir). La distancia que "confías en la ruta vieja" es el horizonte.
14.8 Continuidad y error acumulado: las dos defensas de ACT
14.8 Continuidad y error acumulado: las dos defensas de ACT
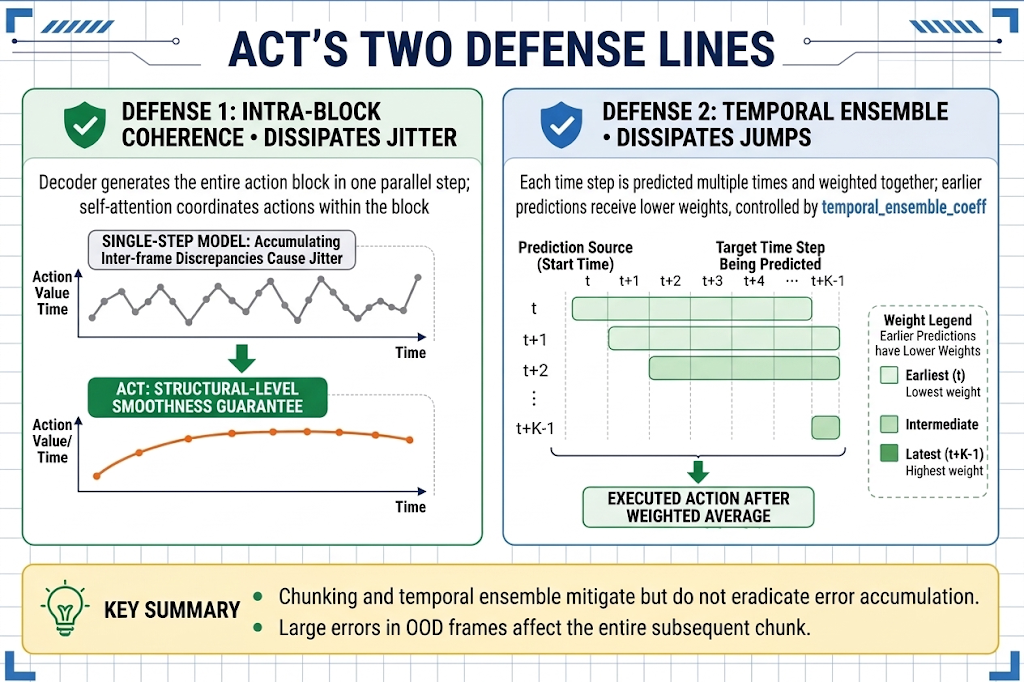
El Capítulo 8 dejó dos amenazas a la estabilidad real: el temblor de acción y el error acumulado. Veamos cómo las aborda ACT de forma estructurada.
- Defensa 1: la coherencia intra-bloque corrige el temblor.
- Defensa 2: el ensamble temporal corrige las discontinuidades.
14.9 ¿Para qué tareas sirve ACT?
14.9 ¿Para qué tareas sirve ACT?
Dado su diseño, su "zona de confort" es clara — y el SO-ARM está justo dentro:
| Apto para | Razón |
|---|---|
| Manipulación de mesa (agarrar, colocar, ordenar, enchufar) | ACT nació de estas tareas; necesidades de datos y tamaño encajan |
| Una o pocas tareas | La clonación aprende mapeos específicos; más tareas = más datos |
| Tareas cortas (segundos a ~1 minuto) | El error se acumula con el tiempo |
| Escenas con información visual suficiente | Vistas frontal + lateral cubriendo la clave |
| Hardware limitado | ACT tiene pocos parámetros; GPUs de consumo entrenan e infieren; la CPU también infiere |
14.10 Los límites de capacidad de ACT
14.10 Los límites de capacidad de ACT
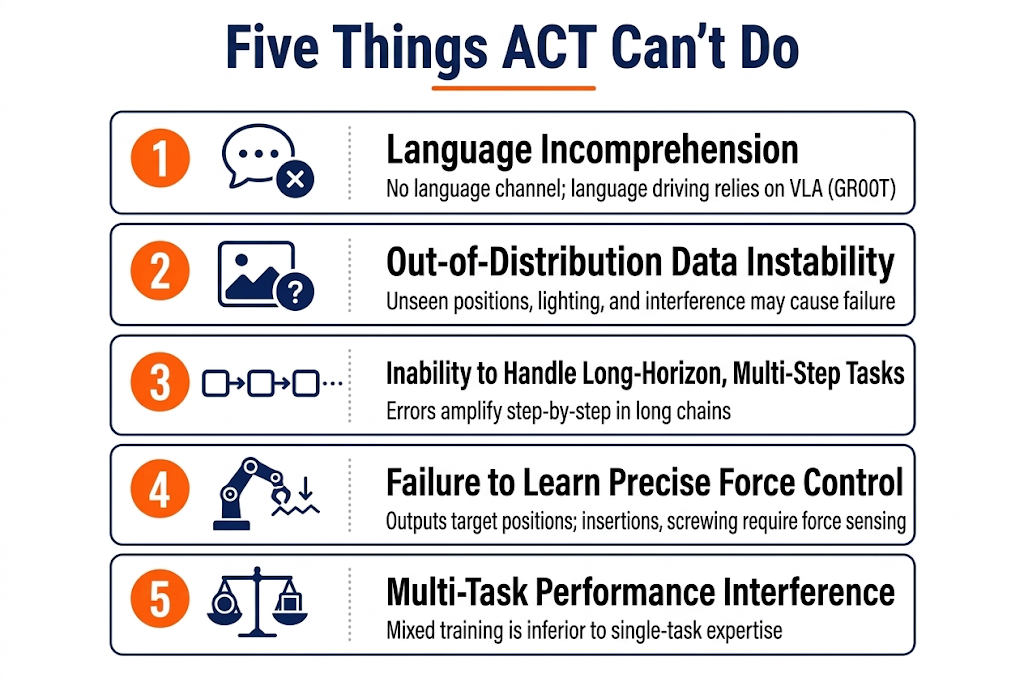
Igual de importante es saber lo que no puede hacer: