18. Aprendizaje multimodal y fundamentos de VLA
Capítulo 18 del curso para principiantes de SO-ARM Physical AI — visión/lenguaje/acción, VLM vs. VLA, ACT vs. VLA, tareas condicionadas al lenguaje, niveles de generalización, acciones continuas vs. tokens, y capacidades y límites de VLA.
Hardware necesario para esta etapa
La lista completa de cada etapa está en el Capítulo 3.
Unidad de control principal
| Artículo | Comprar | Cant. |
|---|---|---|
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
También un PC de escritorio o portátil: Ubuntu 22.04, GPU de 12GB+ (para el ajuste fino de GR00T, ~25GB de VRAM — ver 18.8) y 16GB+ de RAM.
Para esta etapa
| Artículo | Comprar | Cant. |
|---|---|---|
| Kit SO-ARM101 (líder + seguidor) | 🛒 | 1 |
| Cámara USB de 32 × 32 mm | - | 2 |
En los capítulos anteriores usaste políticas como ACT (Action Chunking with Transformers) en el SO-ARM para completar un aprendizaje por imitación que "mira una imagen y emite acciones de articulación". Esos métodos suelen entrenarse para una tarea única: el modelo solo aprende "poner el cubo rojo en la caja", y cambiar de tarea exige recolectar y reentrenar.
Este capítulo introduce la idea central de VLA (Visión-Lenguaje-Acción): que el robot no solo "vea", sino que también "entienda" instrucciones en lenguaje natural, y comparta una sola red de política entre múltiples tareas.
18.1 Qué es un modelo multimodal
18.1 ¿Qué es un modelo multimodal?
Un modelo multimodal funde más de un tipo de información — imágenes, texto y estado del robot — en una decisión unificada. En el contexto VLA se combinan y decodifican en acciones de robot las tres modalidades siguientes.
18.2 Visión, lenguaje y acción
18.2 Visión, lenguaje y acción
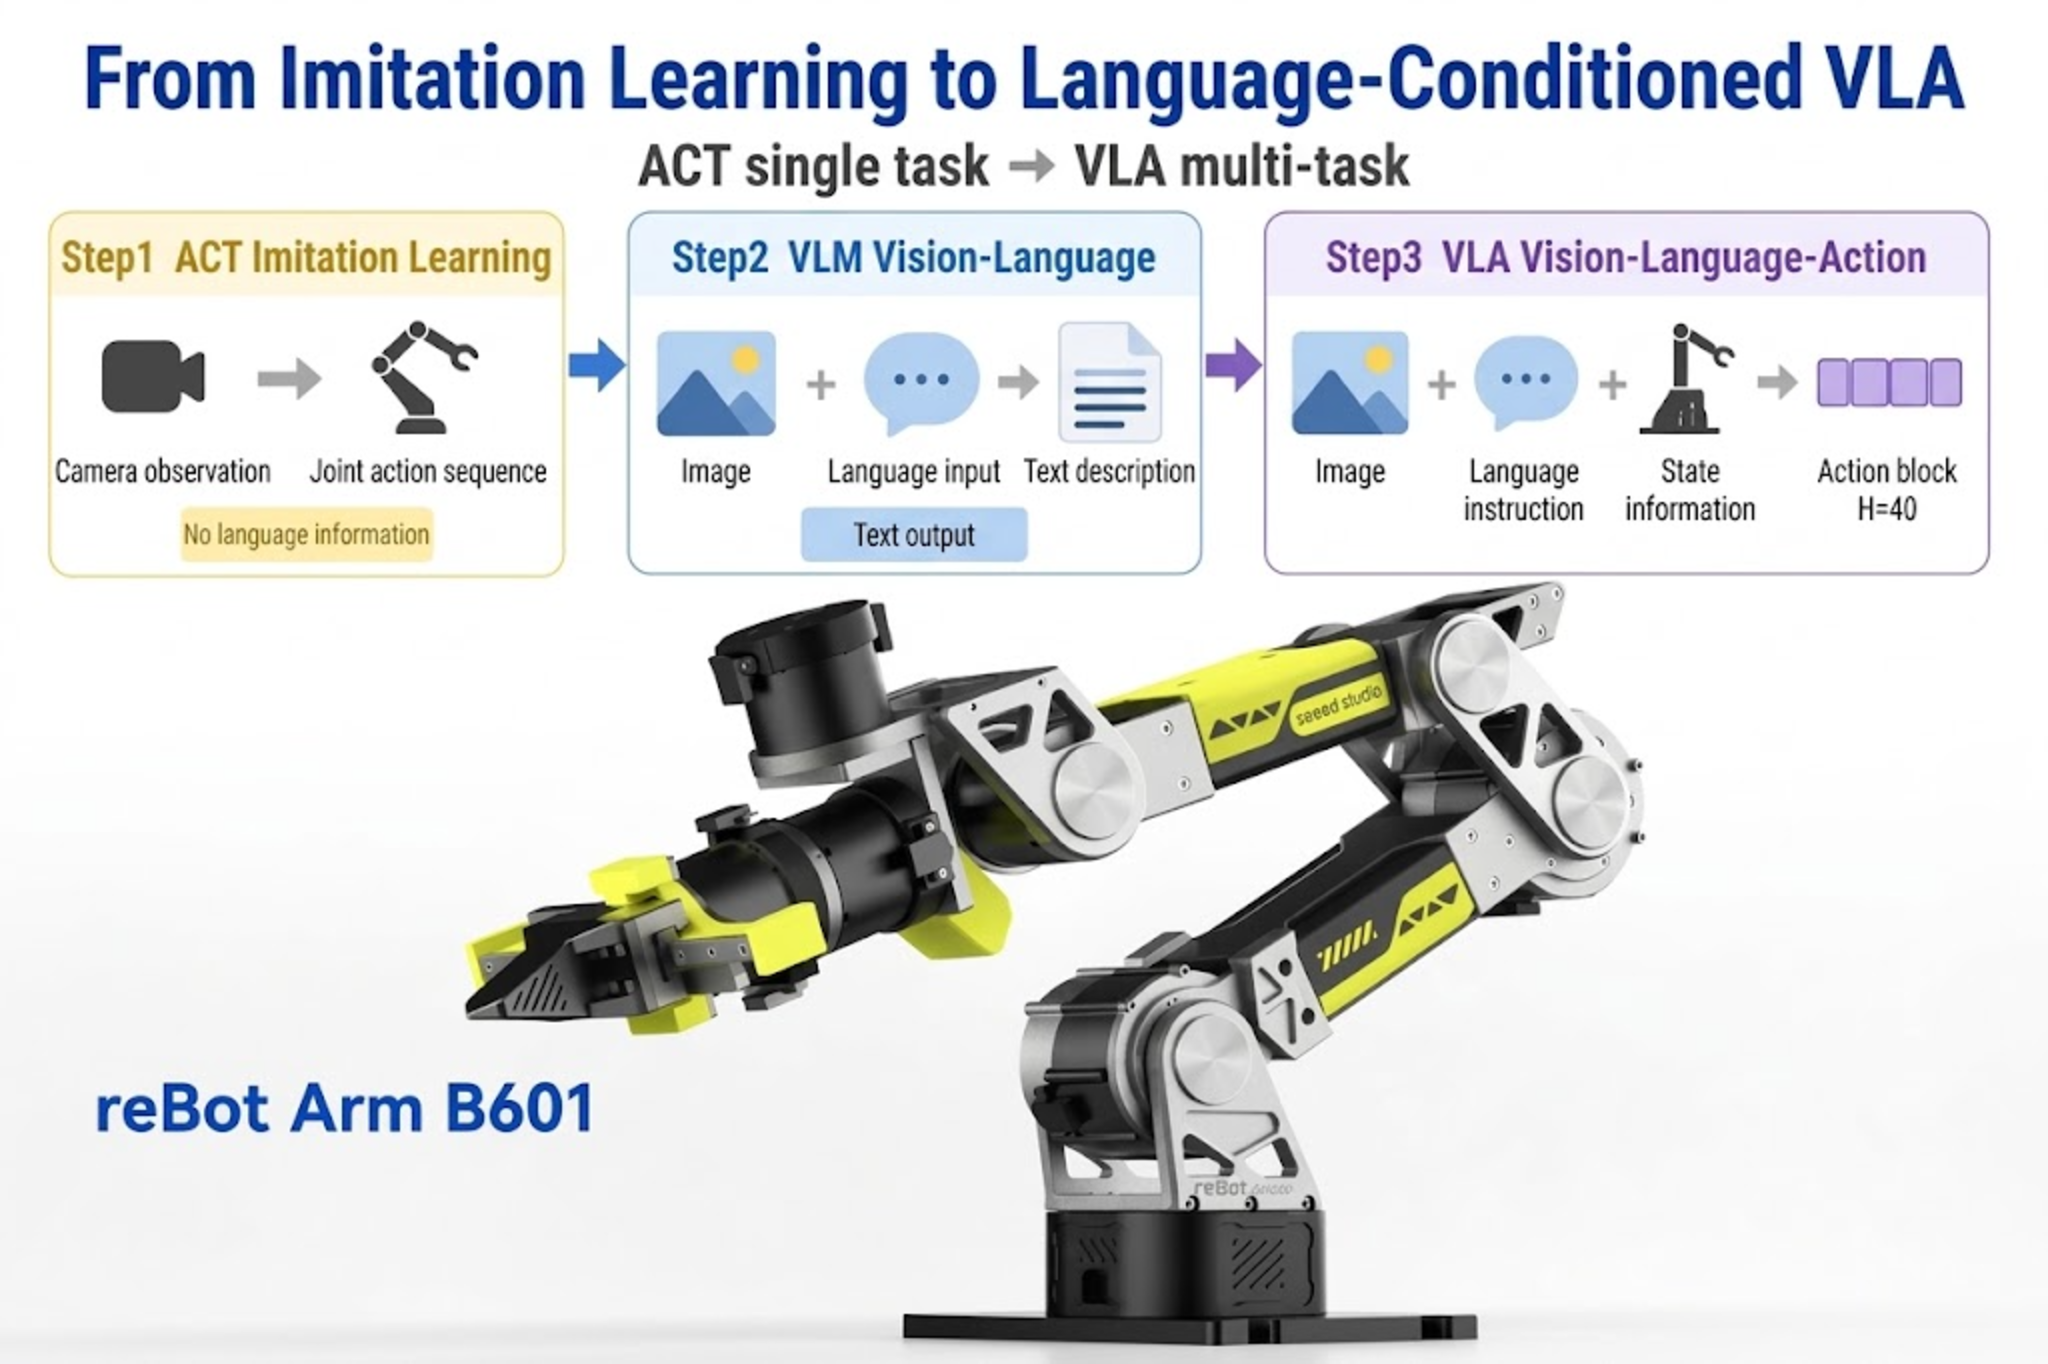
En el marco VLA, cada modalidad tiene un papel claro:
| Modalidad | Significado | Fuente típica en SO-ARM |
|---|---|---|
| Visión | Imágenes RGB de cámaras | Cámaras USB frontal y lateral |
| Lenguaje | Descripción natural de la tarea | "Pon el destornillador en la caja de herramientas" |
| Acción | Comandos de control del robot | Ángulos objetivo de las 5 articulaciones + apertura de pinza |
El Estado suele aparecer en pareja con la Acción: el Estado describe "dónde está el robot ahora" y la Acción "a dónde va después". En los datasets LeRobot se guardan en observation.state y action; en GR00T se dividen vía meta/modality.json en subclaves como state.single_arm y state.gripper.
La diferencia clave entre VLA y políticas puramente visuales: el lenguaje se vuelve variable de condicionamiento. En el entrenamiento, cada trayectoria de demostración se liga a una descripción de tarea; en la inferencia basta cambiar el texto de la instrucción, sin cambiar los pesos (dentro de la cobertura de datos).
18.3 Diferencia entre VLM y VLA
18.3 Diferencia entre VLM y VLA
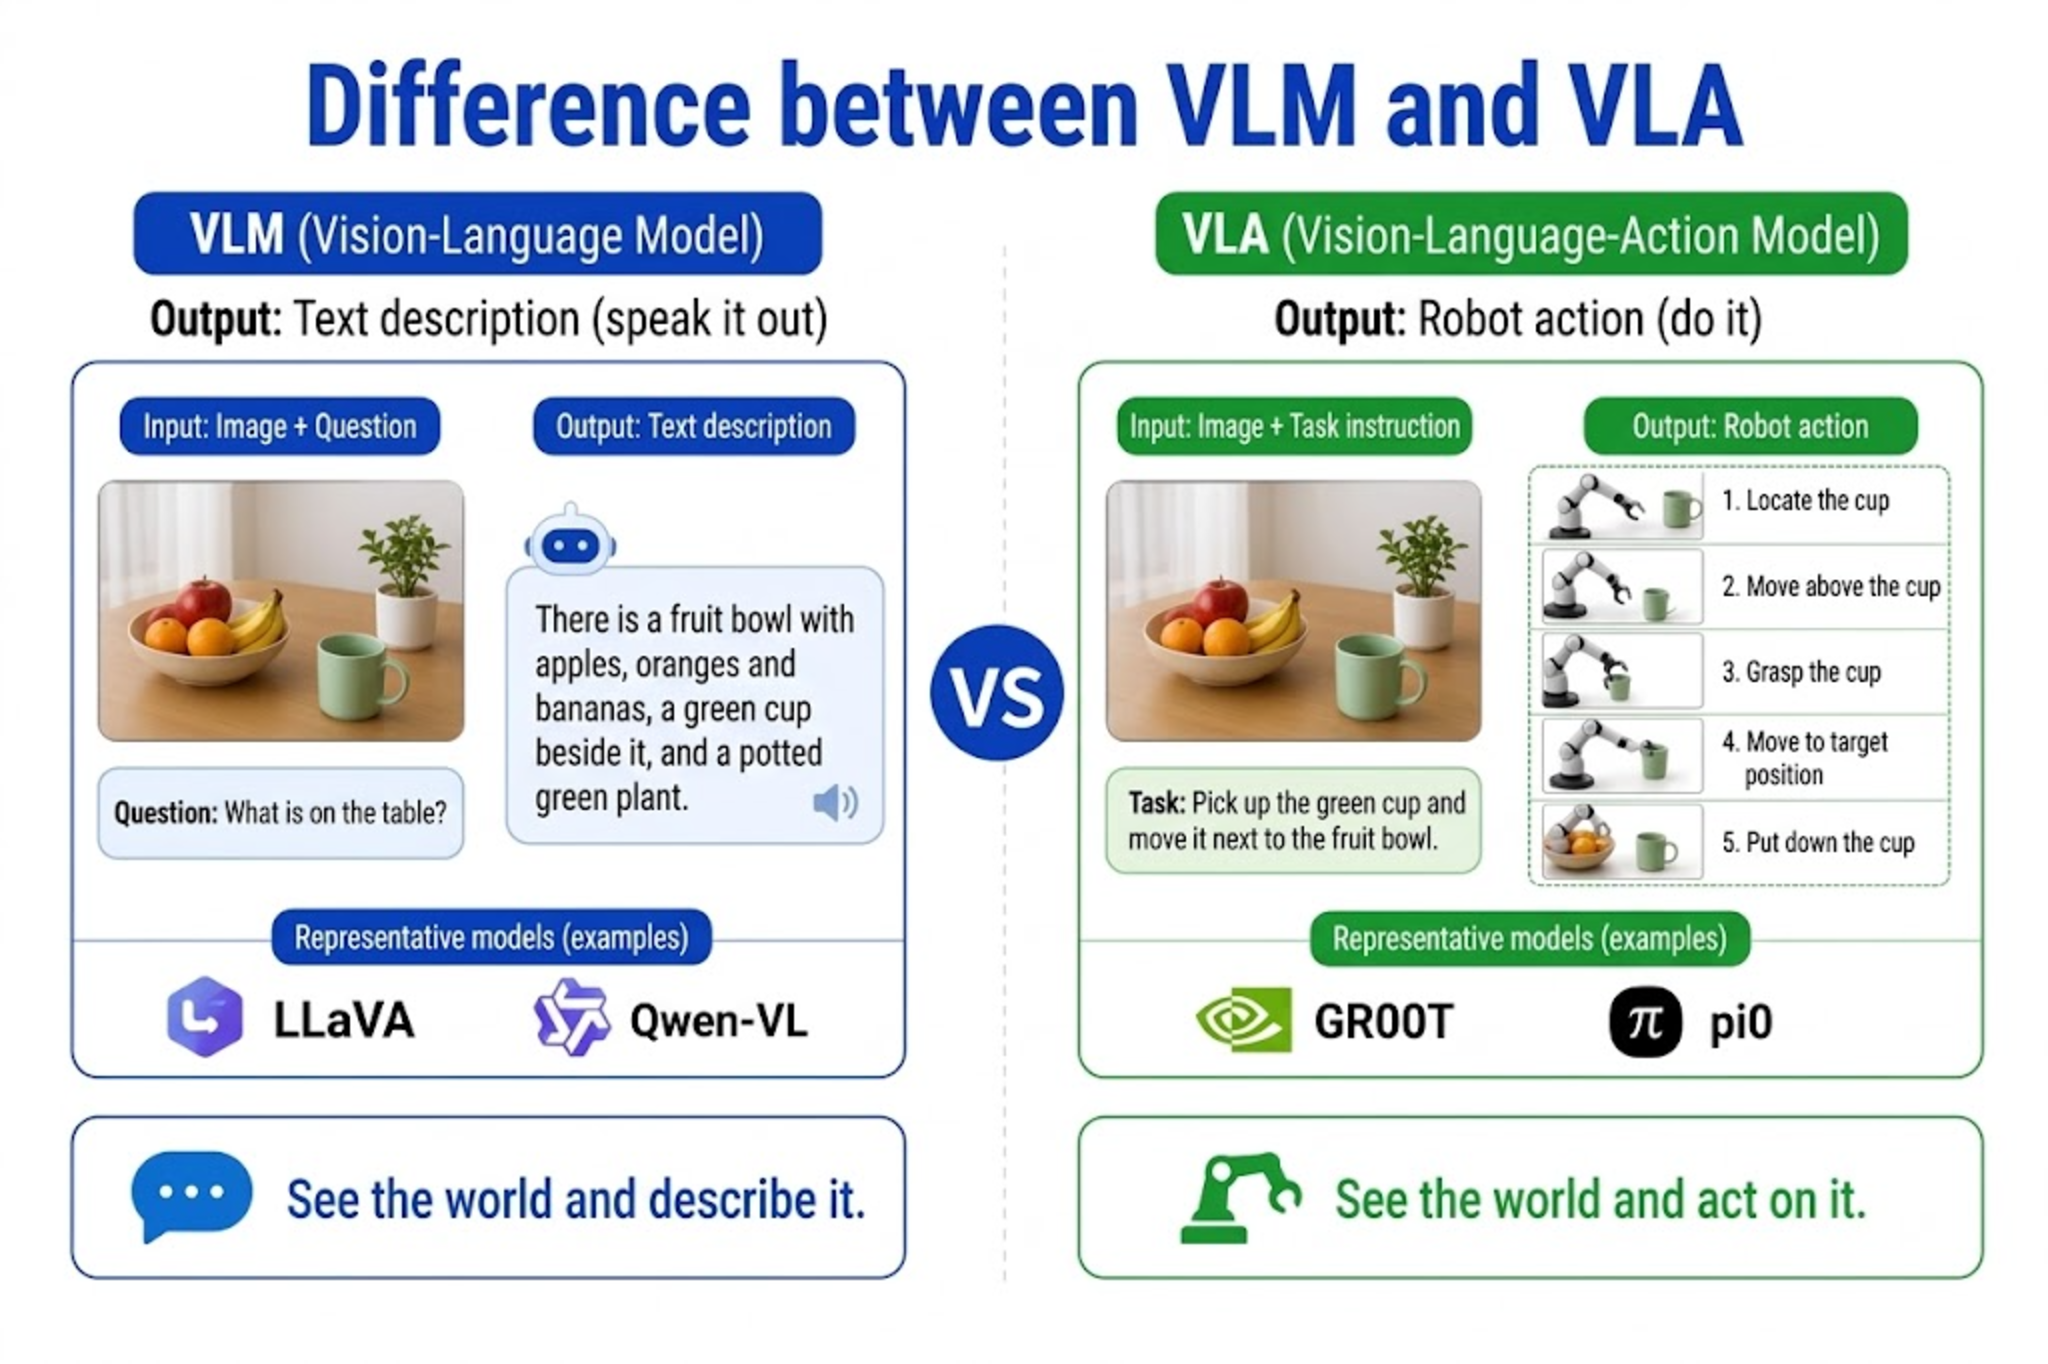
| Aspecto | VLM (Vision-Language Model) | VLA (Vision-Language-Action) |
|---|---|---|
| Salida | Texto, descripciones, razonamiento | Secuencia de acciones del robot |
| Uso típico | QA de imagen, comprensión de escena, descripción | Agarre, colocación, apertura/cierre y otras manipulaciones |
| Modelos representantes | LLaVA, Qwen-VL, Cosmos-Reason | GR00T, pi0, OpenVLA |
| Relación con el robot | Puede ayudar a planificar; no conduce motores | Emite comandos de control de extremo a extremo |
Se entiende simplemente como: el VLM se encarga de "entender el mundo y hablar de él"; el VLA de "entender el mundo y actuar".
Isaac GR00T reutiliza capacidades VLM en su arquitectura: un backbone VLM codifica imágenes y lenguaje, seguido de una cabeza de acción Diffusion Transformer (DiT) que decodifica las representaciones semánticas en bloques continuos de acción. GR00T es por tanto un VLA que además incorpora una potente representación VLM.
18.4 Diferencia entre ACT y VLA
18.4 Diferencia entre ACT y VLA
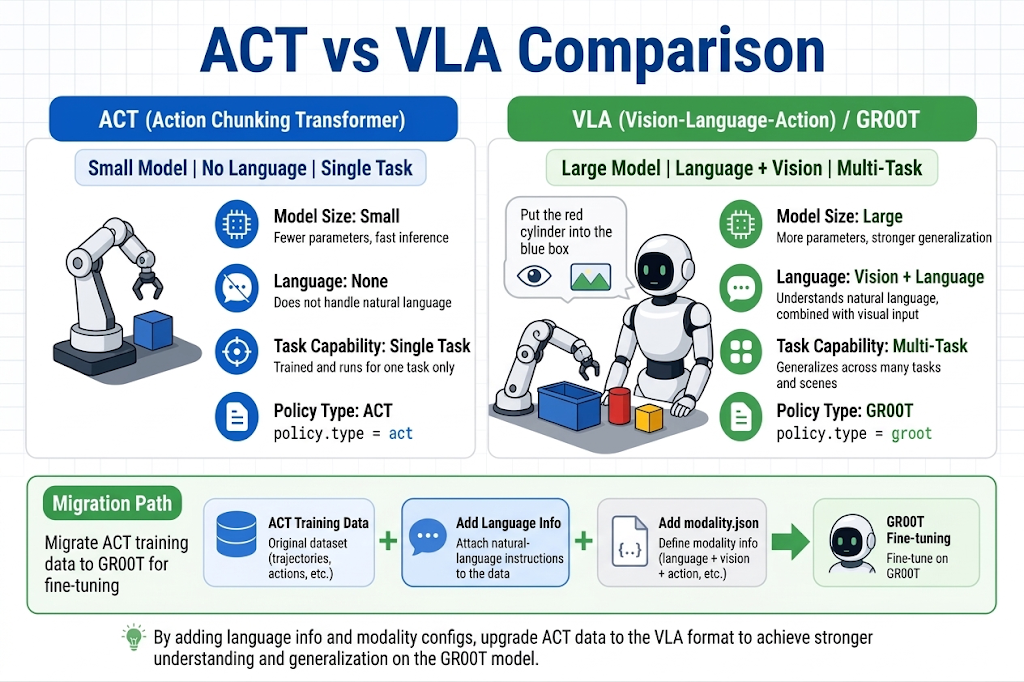
El ACT de los capítulos previos y el VLA de este pertenecen a la familia del aprendizaje por imitación (clonación de comportamiento), pero difieren en objetivos:
| Aspecto | ACT | VLA (GR00T como ejemplo) |
|---|---|---|
| Condición de tarea | Normalmente sin lenguaje, tarea única implícita | Lenguaje + visión, multitarea explícita |
| Tamaño del modelo | Menor (decenas de millones de parámetros) | Mayor (modelo fundacional de miles de millones) |
| Entrenamiento | Desde cero o ajuste ligero | Preentrenamiento fundacional + ajuste fino |
| Representación de acción | Bloque de acciones | Bloque de acciones + denoising Flow Matching |
| Generalización | Buen rendimiento en distribución; reentrenar al cambiar tarea | El condicionamiento lingüístico apoya transferencia cero/pocos disparos |
| Tipo de política LeRobot | act | groot |
La técnica central de ACT es el bloque de acciones: predecir de una vez varios pasos futuros para reducir el error acumulado de la inferencia paso a paso. GR00T también predice bloques (la longitud de ventana varía por versión — N1.5: action_horizon = 16).
Ruta de migración: si ya tienes un dataset ACT del SO-ARM (formato LeRobot), el Capítulo 20 solo requiere añadir anotaciones de lenguaje y la configuración de Modality para usarlo en el ajuste fino de GR00T, sin volver a recolectar todas las demos.
GR00T N1.5 corre en el SO-ARM mediante la configuración de datos so100_dualcam oficialmente soportada y la etiqueta new_embodiment — el SO-ARM es uno de los embodiments de bajo costo mejor soportados del ecosistema GR00T, con una guía oficial de ajuste para SO101 de NVIDIA.
18.5 Tareas robóticas condicionadas al lenguaje
18.5 Tareas robóticas condicionadas al lenguaje
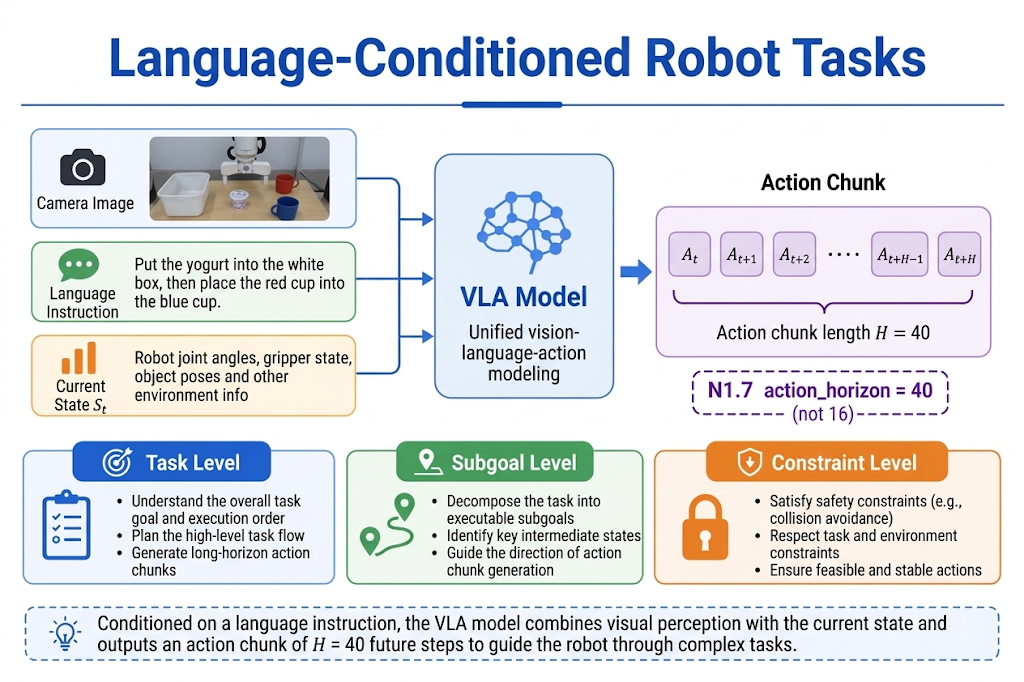
La forma estándar de una tarea condicionada:
Entrada: imagen I_t + instrucción L + estado actual S_t
Salida: acciones A_{t:t+H} (bloque de los próximos H pasos)
La granularidad de la instrucción puede variar:
- Nivel tarea: "pon el cubo rojo en la caja azul" (una frase compartida por toda la trayectoria)
- Nivel subobjetivo: "primero acércate al objeto" -> "luego cierra la pinza" (anotación por segmentos, avanzado)
- Nivel restricción: "colócalo suavemente", "evita obstáculos" (modifica cómo se ejecuta)
En LeRobot, el lenguaje suele escribirse en meta/tasks.jsonl o el campo annotation. GR00T lo lee por la clave annotation de modality.json; dos formas comunes:
| Clave | Datasets típicos | Recomendación SO-ARM |
|---|---|---|
human.task_description | SO-100 / SO101, cube_to_bowl y tareas de mesa simples | Recomendada: coincide con el ejemplo del Capítulo 20 |
human.action.task_description | LIBERO, SimplerEnv y benchmarks de simulación | Solo si tus datos vienen de ahí |
Ambas claves son válidas, pero deben coincidir con los campos reales del dataset; no las mezcles entre entrenamiento e inferencia.
Consejos prácticos (SO-ARM):
- Al grabar cada demo, describe la tarea en una frase corta que empiece por verbo, en chino o inglés.
- Mantén la redacción consistente en tareas similares, p. ej. siempre "pon X en Y".
- Evita que un mismo dato corresponda a varias redacciones; cuanto más consistente al inicio del ajuste, mejor.
18.6 Tarea única, multitarea y generalización
18.6 Tarea única, multitarea y generalización
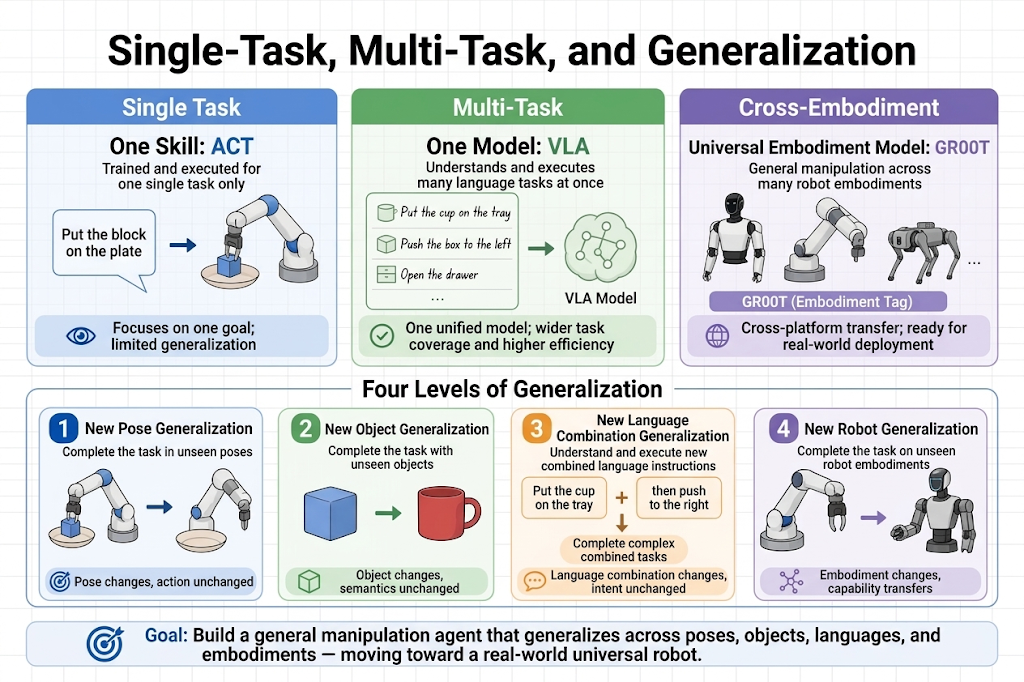
| Paradigma | Descripción | Escenarios |
|---|---|---|
| Tarea única | Aprende una sola habilidad | Predeterminado de ACT; pocos datos, objetivo claro |
| Multitarea | El mismo modelo aprende varias habilidades, distinguidas por lenguaje | Ajuste fino VLA; ordenar, clasificar |
| Generalización entre embodiments | Robots distintos comparten un modelo fundacional | Preentrenamiento GR00T; adaptación vía embodiment_tag |
La "generalización" en VLA tiene varios niveles — no los confundas:
- Misma tarea, pose inicial nueva: sigue agarrando con el objeto movido — ACT suele lograrlo.
- Objetos y contenedores nuevos: depende de la generalización visual — exige diversidad suficiente.
- Combinaciones nuevas de instrucción: "pon A en B" no vista pero de patrón conocido — la ventaja del condicionamiento lingüístico.
- Nuevo embodiment: sigue sirviendo al cambiar de brazo — requiere la capa de proyección de GR00T más una pequeña cantidad de datos de ajuste.
Para usuarios del SO-ARM, la expectativa realista es: tras el ajuste, conmutar entre las tareas de lenguaje ya recolectadas; para objetos o patrones de frase totalmente nuevos siguen haciendo falta demos adicionales.
18.7 Acciones continuas y tokens de acción
18.7 Acciones continuas y tokens de acción
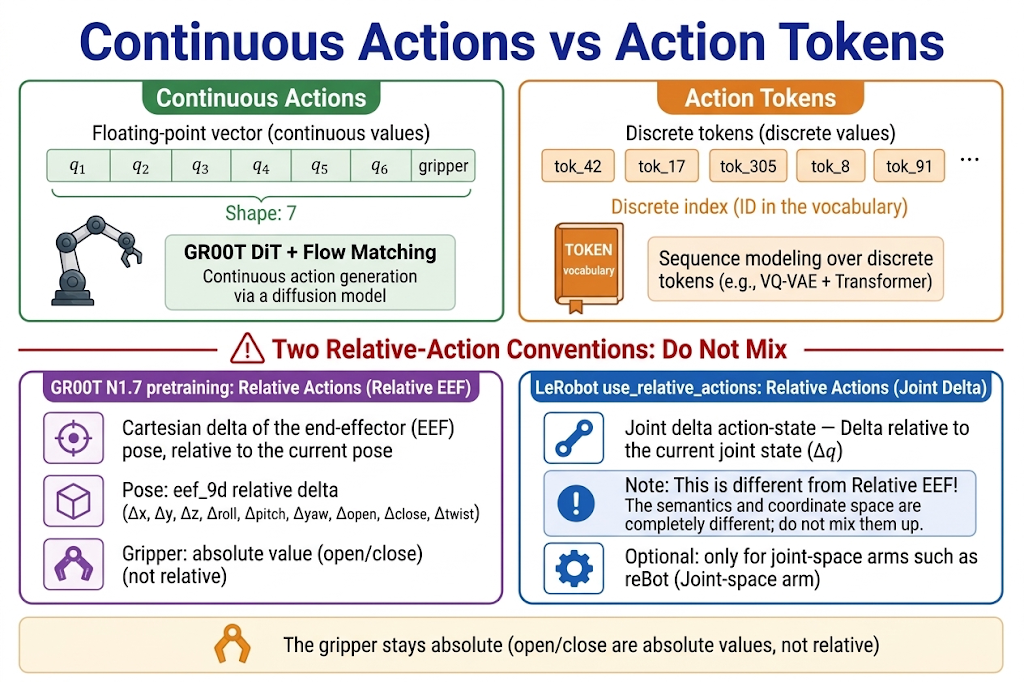
Hay dos representaciones principales para los comandos del robot:
Acciones continuas
Devuelve directamente un vector de coma flotante, p. ej. 5 ángulos + 1 pinza:
action = [q1, q2, q3, q4, q5, gripper] # shape: (6,)
- Ventaja: precisión alta, coherente con la interfaz real de motores.
- Desventaja: la regresión en espacio de alta dimensión es difícil.
- GR00T usa: DiT + Flow Matching para denoise en espacio continuo, emitiendo bloques.
Tokens de acción (acciones discretizadas)
Cuantiza los valores continuos en símbolos discretos, como un modelo de lenguaje prediciendo el siguiente token:
action_tokens = [tok_42, tok_17, tok_89, ...]
- Ventaja: reutiliza arquitecturas LLM autorregresivas; lo usan VLAs como pi0-FAST.
- Desventaja: pérdida de cuantización, diseño de vocabulario complejo.
Relativas vs. absolutas: el espacio preentrenado de GR00T usa acciones relativas (incrementos respecto al estado actual) para algunos grupos de embodiment y posiciones articulares absolutas para otros; la pinza permanece absoluta. Las trayectorias relativas son más suaves, pero la ejecución prolongada puede derivar. En el ajuste del SO-ARM te apoyas sobre todo en los valores por defecto de so100_dualcam — la moraleja es una: no edites a mano transformaciones del espacio de acciones que no entiendes.
18.8 Capacidades y límites de VLA
18.8 Capacidades y límites de VLA
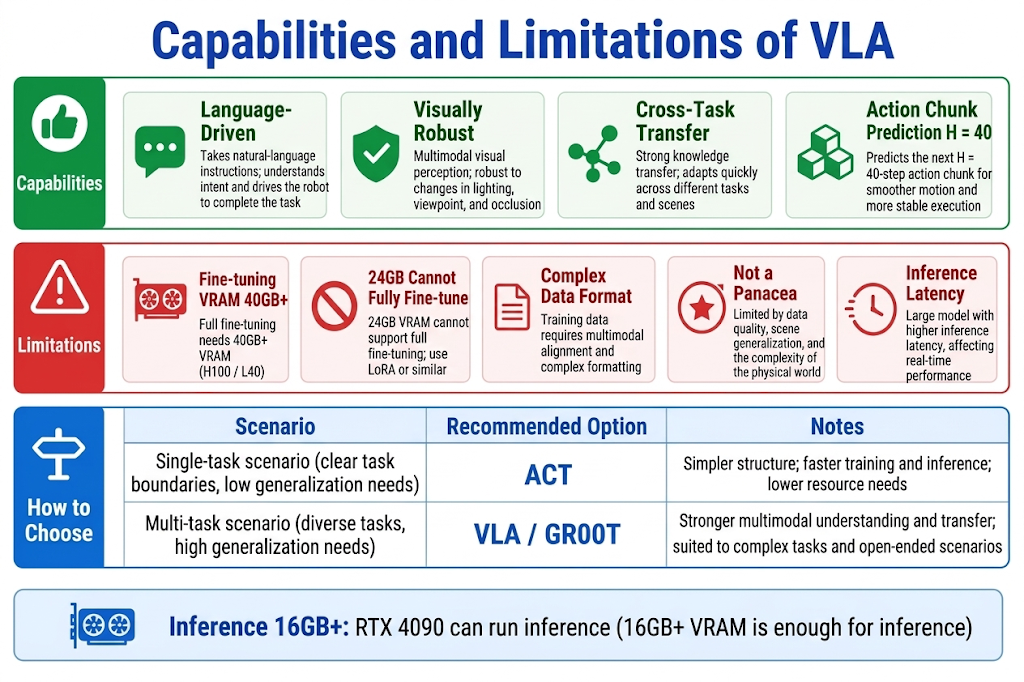
Capacidades
- Guiado por lenguaje: un modelo, muchas tareas; cambia la instrucción y cambia el comportamiento.
- Robustez visual: el preentrenamiento a gran escala aporta mejor comprensión de escena que un ACT pequeño.
- Transferencia entre tareas: representaciones compartibles entre patrones y objetos similares.
- Predicción por bloques: una inferencia emite varios pasos, apta para control en tiempo real.
Límites
- Alta demanda de cómputo: el ajuste de GR00T N1.5-3B necesita unos 25GB de VRAM (Ampere o superior — p. ej. RTX 4090 / A6000; V100 no está soportado), reducibles con
--no-tune_diffusion_model. La inferencia es más ligera y corre en Jetson AGX Thor (Capítulo 21) — y el Capítulo 22 no necesita GPU en absoluto. - Formato de datos más complejo: más allá de los campos LeRobot estándar, requiere
modality.jsony etiqueta de embodiment. - No es una panacea: objetos, instrucciones y puestos no cubiertos por el entrenamiento pueden fallar.
- Latencia: inferir un modelo grande es más lento que ACT; ajusta bien la ventana de acciones y los parámetros de inferencia.
- Brecha simulación-real: el preentrenamiento domina en plataformas concretas; los brazos de mesa requieren ajuste suficiente.
¿Cuándo elegir ACT y cuándo VLA?
| Escenario | Recomendación |
|---|---|
| Tarea repetitiva única, dispositivo de borde, baja latencia | ACT |
| Multitarea, interacción por lenguaje, dispuesto a invertir GPU y anotación | VLA / GR00T |
| Ya tienes datos ACT y quieres multitarea | Añade lenguaje a los datos LeRobot -> ajuste GR00T (Capítulo 20) |
| Sin GPU de entrenamiento | VLA sin código en SenseCraft Robotics (Capítulo 22) |
18.9 Resumen del capítulo
18.9 Resumen del capítulo
- Los modelos multimodales funden visión, lenguaje y estado en decisiones unificadas.
- VLA añade salida de acción sobre VLM, apoyando manipulación condicionada al lenguaje.
- ACT es la solución ligera de tarea única; GR00T la VLA de preentrenamiento masivo + ajuste.
- El SO-ARM está soportado oficialmente en GR00T vía
so100_dualcam+new_embodiment. - El próximo capítulo explica cómo aterrizar la VLA general en este embodiment concreto, el SO-ARM.