8. Fundamentos del aprendizaje en robótica e imitación
Capítulo 8 del curso para principiantes de SO-ARM Physical AI — por qué el brazo necesita aprender, control basado en reglas vs. en aprendizaje, observación/estado/acción, bloques de acción, distribución de datos y las tres fases de entrenamiento, inferencia y evaluación.
Hardware necesario para esta etapa
La lista completa de cada etapa está en el Capítulo 3.
Unidad de control principal
| Artículo | Comprar | Cant. |
|---|---|---|
| reComputer Robotics J4012 | 🛒 | 1 |
También se necesita un PC de escritorio o portátil: Ubuntu 22.04, CUDA 12+ y, para entrenar, GPU NVIDIA con 12GB+ de VRAM y 16GB+ de RAM.
Para esta etapa
| Artículo | Comprar | Cant. |
|---|---|---|
| Kit SO-ARM101 (líder + seguidor) | 🛒 | 1 |
| Cámara USB de 32 × 32 mm | - | 2 |
| Alfombrilla / tapete | - | 1 |
8.1 ¿Por qué los brazos robóticos necesitan aprender?
8.1 ¿Por qué los brazos robóticos necesitan aprender?
En la Etapa 2 ya puedes leer y escribir cada servo del SO-ARM: consultar posiciones de articulación, enviar ángulos objetivo, abrir y cerrar la pinza. Así que es natural pensar — basta escribir un programa que haga que el brazo recoja automáticamente los bloques de la mesa, ¿no?
Escribes ese programa. En la primera demo del laboratorio funciona de maravilla. Pero al día siguiente las cosas cambian — y para manejar esos cambios, el programa acumula cada vez más sentencias "if", hasta convertirse en un catálogo gigante de casos especiales que nadie puede mantener.
Este es el dilema fundamental del control programático tradicional: el mundo real cambia de forma continua, mientras que el if-else es discreto. No puedes enumerar cada estado posible del mundo.
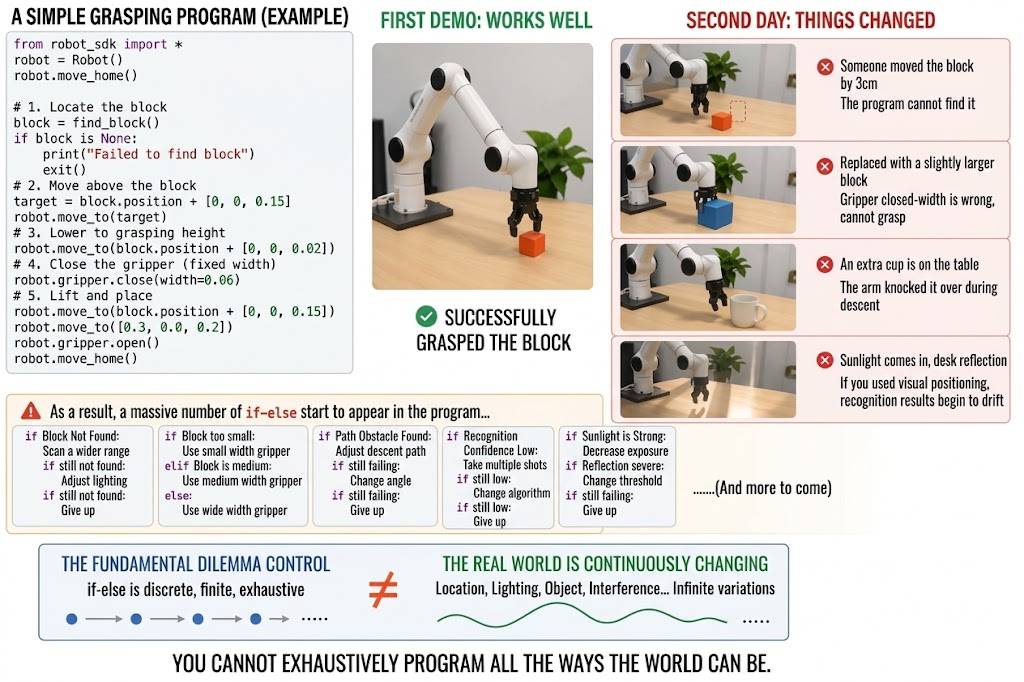
Dotar a los brazos robóticos de habilidades de esta manera es precisamente lo que Robot Learning se propone resolver. Y el aprendizaje por imitación de esta etapa es el enfoque más maduro y más fácil de desplegar en hardware real.
8.2 Control basado en reglas vs. basado en aprendizaje
8.2 Control basado en reglas vs. basado en aprendizaje
Antes de continuar, pongamos los dos enfoques lado a lado.
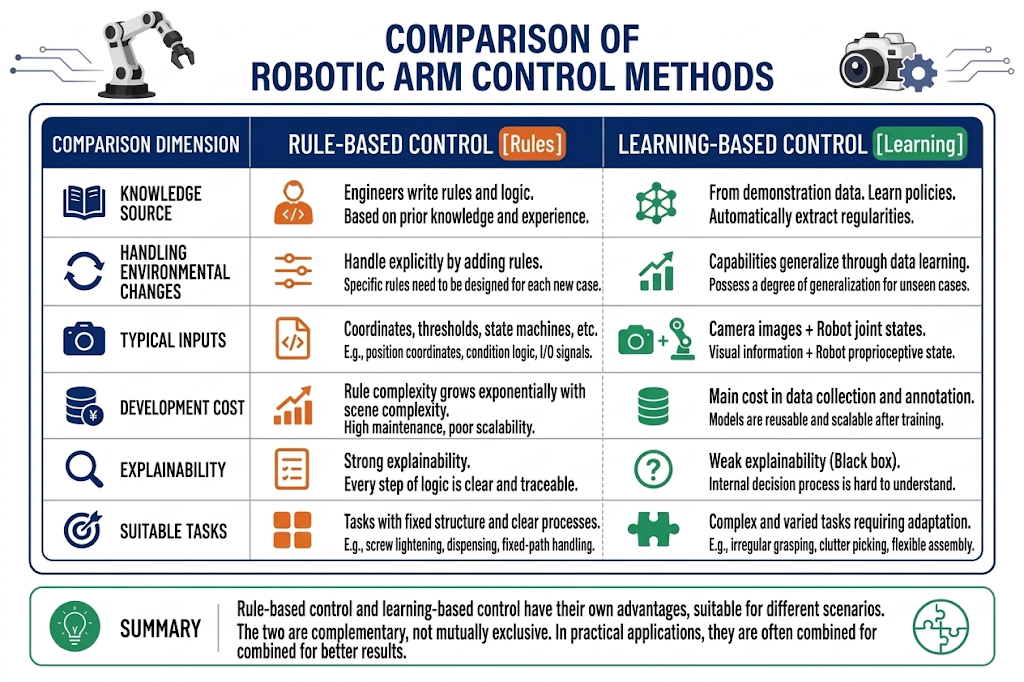
Las Etapas 3 y 4 de este curso siguen el camino del "control basado en aprendizaje". Pero recuerda: incluso en el futuro, tus sistemas de aprendizaje seguirán conteniendo numerosas reglas — límites de articulación y restricciones de velocidad segura. Aprendizaje y reglas son complementarios.
8.3 Aprendizaje por imitación y clonación de comportamiento
8.3 Aprendizaje por imitación y clonación de comportamiento
Qué es el aprendizaje por imitación
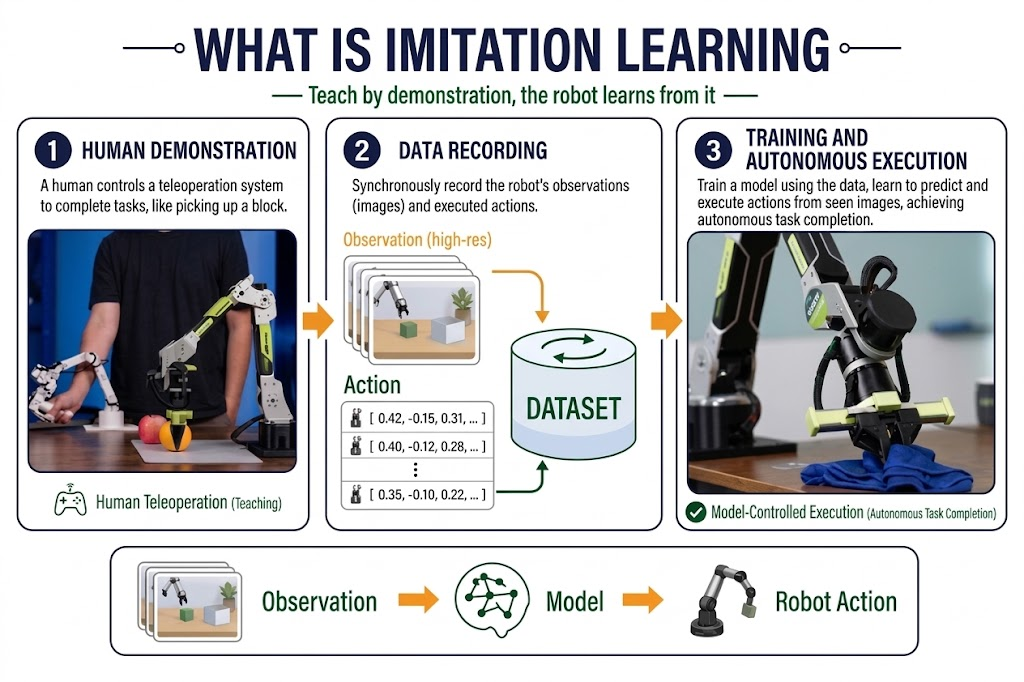
Qué es la clonación de comportamiento
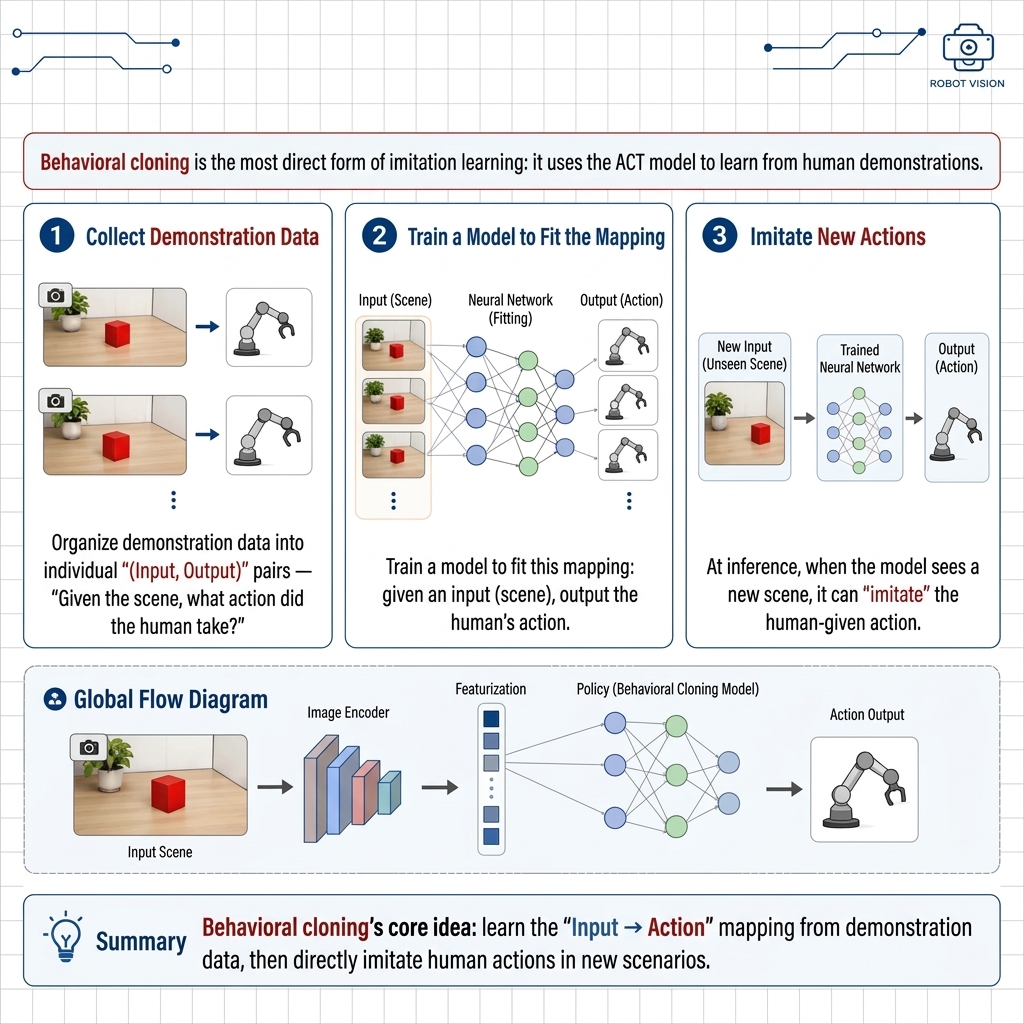
8.4 Observación, estado y acción
8.4 Observación, estado y acción
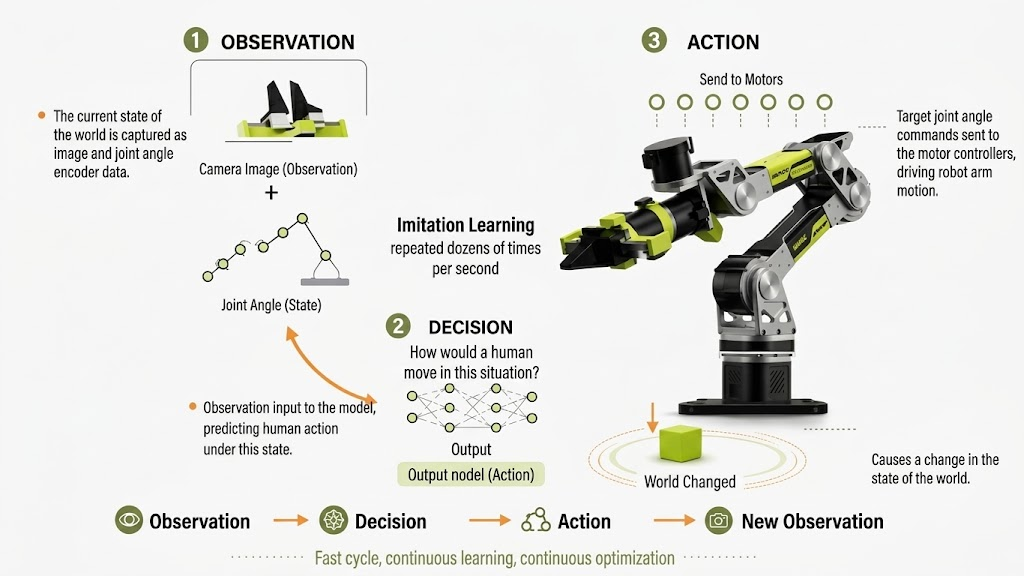
Todos los datos del aprendizaje por imitación se clasifican en tres conceptos. Estos términos aparecerán en cada capítulo posterior, así que construye aquí una intuición precisa.
- Observación: el mundo que el robot "ve";
- Estado: la condición "propia" del robot;
- Acción: lo que el robot "hará".
En el SO-ARM: la observación son las dos imágenes de cámara, el estado son las 6 lecturas de articulación del seguidor (5 articulaciones + pinza), y la acción son los 6 valores objetivo siguientes.
8.5 Acciones de un paso vs. bloques de acción
8.5 Acciones de un paso vs. bloques de acción
- Acción de un paso: una decisión por fotograma;
- Bloque de acción: predecir de golpe una secuencia de acciones.
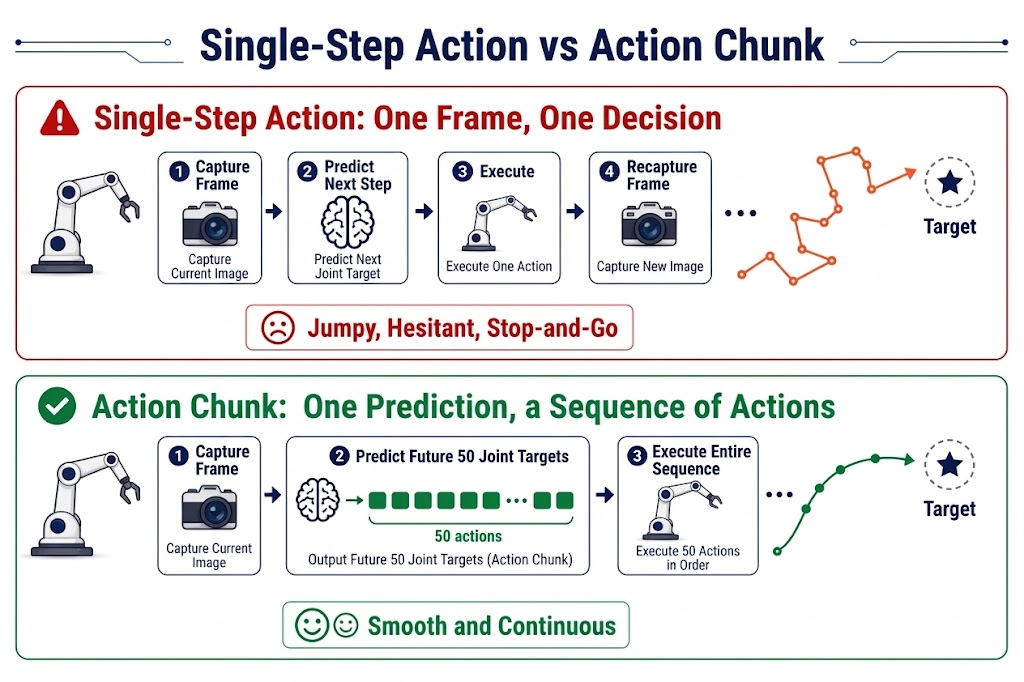
Por supuesto, los bloques más largos no siempre son mejores. Predecir demasiado lejos significa que el entorno puede cambiar a mitad de ejecución (p. ej. un objeto recibe un golpe) mientras el brazo aún ejecuta acciones "obsoletas". Los sistemas reales usan un compromiso: ejecutar en lazo abierto un tramo corto, y luego reobservar y repredecir.
8.6 Distribución de datos y generalización del modelo
8.6 Distribución de datos y generalización del modelo
Esta es la sección más importante del capítulo, la que los principiantes más pasan por alto, y la que decide el éxito o el fracaso en la práctica. Recuerda primero esta frase:
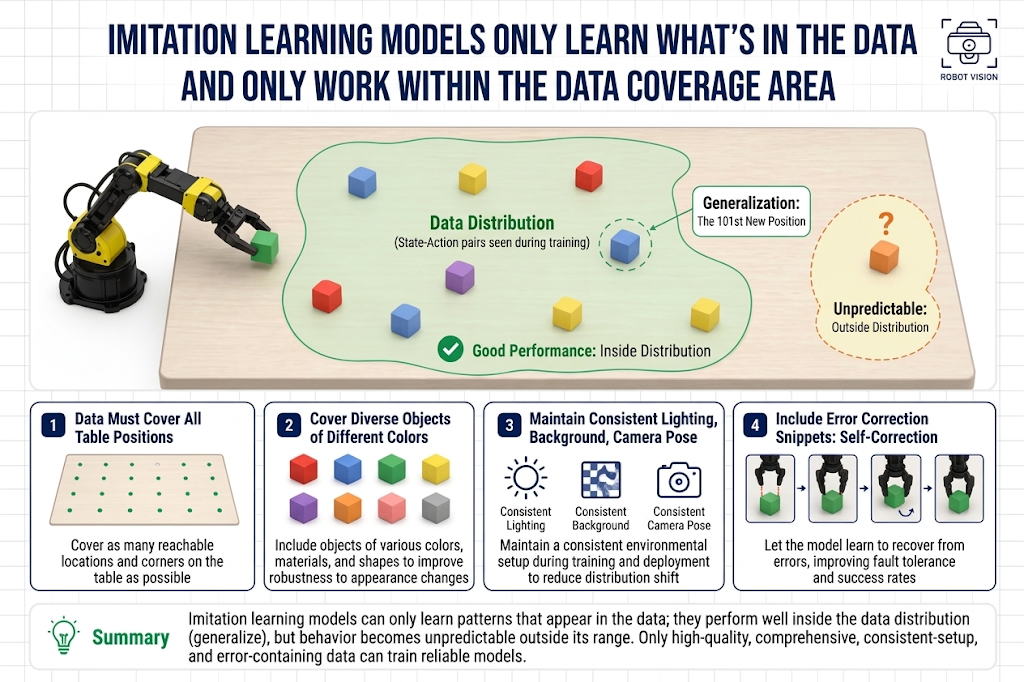
Un modelo de aprendizaje por imitación solo puede aprender lo que hay en los datos, y solo puede funcionar en el rango cubierto por los datos.
- Todos los pares (observación, acción) vistos durante el entrenamiento constituyen una distribución de datos. En la inferencia, si las imágenes y estados que encuentra el brazo caen dentro de esa distribución, el modelo suele rendir bien; al salirse de ella, la salida del modelo pierde fundamento y el comportamiento se vuelve impredecible.
De ahí se derivan implicaciones muy prácticas:
- Si quieres que agarre bloques en cualquier posición de la mesa, los datos deben cubrir toda la mesa — si solo recolectas en el centro, el modelo solo agarrará en el centro;
- Si quieres que agarre objetos de distintos colores, los datos deben contener esos colores — si no, un color nuevo es un mundo desconocido para él;
- Iluminación, fondo y posición de cámara deben mantenerse lo más consistentes posible con la recolección — un modelo entrenado con datos de la tarde puede fallar por completo bajo la luz de la noche.
Y la generalización es la capacidad del modelo de aplicar a situaciones nuevas dentro de la distribución que no ha visto una por una. Si el entrenamiento vio bloques en 100 posiciones y en la inferencia aparece en la 101 (sigue en la mesa), el modelo aún lo agarra — eso es generalización. La generalización no es magia; proviene de la diversidad de los datos: cuanto más rica y continua la cobertura, menores son los "huecos" y mejor la generalización.
El techo del aprendizaje por imitación queda esencialmente decidido en el momento de la recolección. El entrenamiento solo se acerca a ese techo.
8.7 Entrenamiento, inferencia y evaluación
8.7 Entrenamiento, inferencia y evaluación
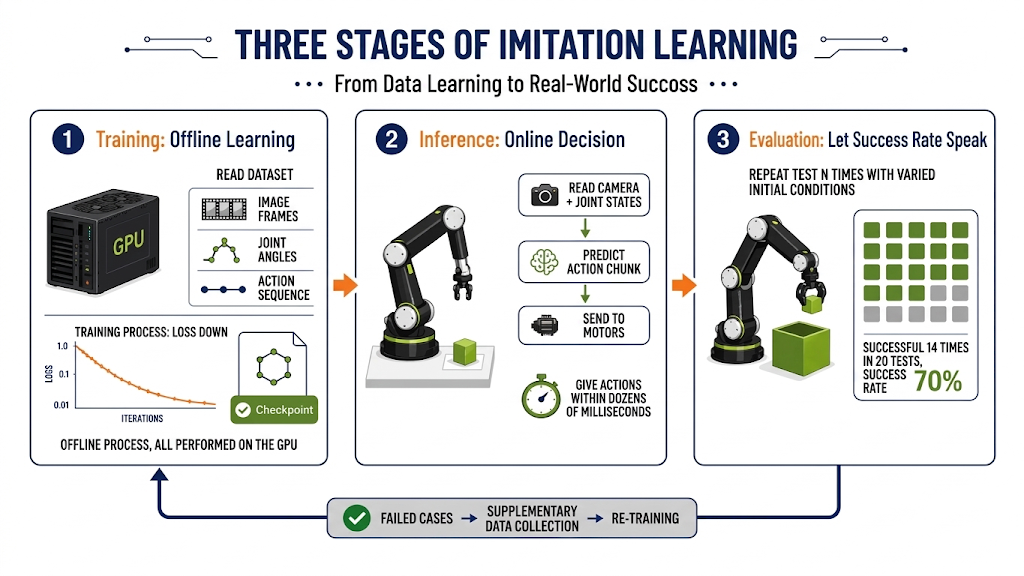
Entrenamiento: aprendizaje offline
Ocurre tras completar la recolección; es un proceso offline: el brazo puede apagarse y apartarse; todo el trabajo ocurre en la GPU.
- Entrada: el dataset recolectado (series temporales de imágenes, estado y acción);
- Proceso: el modelo lee los datos repetidamente, ajustando sus parámetros para que sus acciones predichas se parezcan cada vez más a las demostraciones humanas;
- Salida: un archivo de modelo entrenado.
La calidad del entrenamiento se observa principalmente con la Loss: al disminuir, las acciones predichas se asemejan más a las demostraciones.
Inferencia: toma de decisiones online
La inferencia es el proceso en que el modelo se despliega en el robot real y trabaja en tiempo real: leer cámaras y estados → el modelo predice un bloque de acciones → enviarlo a los servos. La inferencia tiene requisitos de tiempo real — el modelo debe emitir acciones en decenas de milisegundos, o el brazo se trabará.
Evaluación: juzgada por la tasa de éxito
El modelo está entrenado, la Loss es baja — ¿puede realmente hacer el trabajo? No necesariamente.
Una Loss baja solo significa que el modelo es "parecido a un humano", no que "pueda completar la tarea". El único método fiable es la prueba en robot real:
- Definir criterios claros de éxito (p. ej. "el bloque termina dentro de la caja");
- Variar condiciones iniciales (posición del bloque, iluminación), repetir N veces;
- Calcular la tasa de éxito — p. ej. 14 éxitos de 20 pruebas = 70%.
Los fallos encontrados en la evaluación no son finales; son insumo de la siguiente ronda de recolección — donde haya fallos, se recolecta más allí, y se reentrena. Ese es el bucle de iteración de datos, la rutina diaria de los proyectos reales.
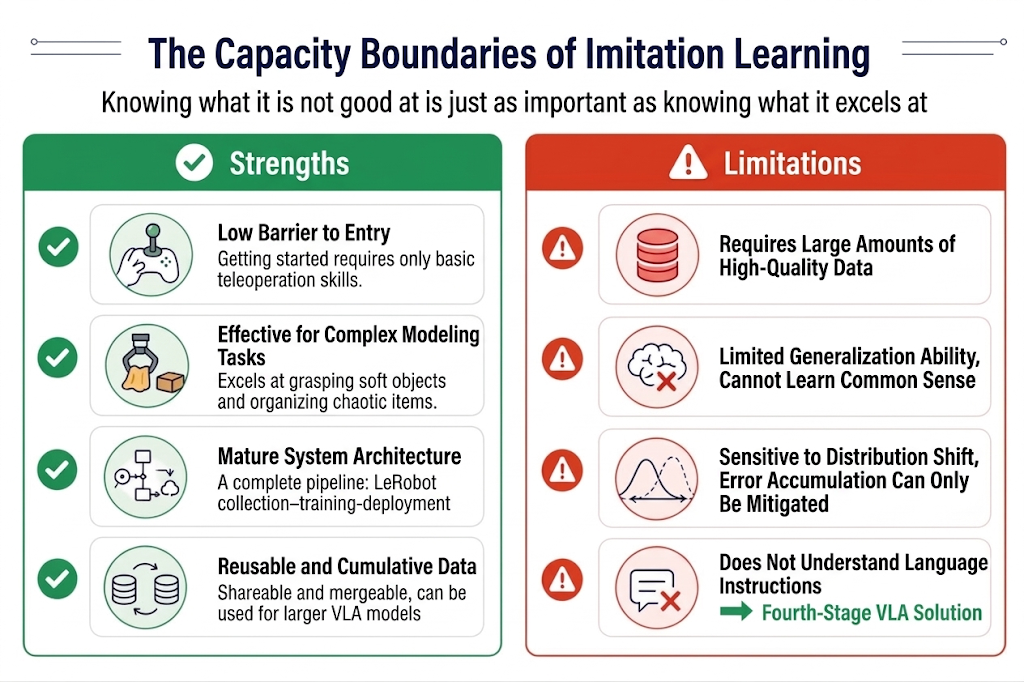
8.8 Ventajas y limitaciones del aprendizaje por imitación
8.8 Ventajas y limitaciones del aprendizaje por imitación