Transcripción privada local para reSpeaker Clip — Selección, despliegue y datos medidos
Un Clip se empareja solo con este host y no puede emparejarse con la app del teléfono al mismo tiempo. Si los resúmenes de IA usan un servicio en la nube, el texto de la transcripción se envía a dicho servicio (el audio no).
Qué hace esta solución
Conversaciones, consultas y charlas en mostrador grabadas en un reSpeaker Clip se sincronizan por Bluetooth con tu propio host reComputer y se transcriben allí, cada turno con marca de tiempo y etiqueta de hablante, en chino, inglés o japonés. El audio no sale del sitio; los resultados se ven en la página web del host o se integran en tu propio sistema mediante MQTT y HTTP. Encaja en mostradores de tienda, entrevistas y reuniones, clínicas y trabajo legal: lugares donde las grabaciones no pueden salir de las instalaciones.
- Paquete de despliegue (Docker Compose y configuración): github.com/suharvest/sensecraft-solutions
- Código fuente del motor de voz: github.com/Seeed-Solution/openvoicestream
- Selección y despliegue: página de diseño de referencia
El audio se queda en el sitio
Las grabaciones se sincronizan desde el Clip al host por Bluetooth y se transcriben allí, sin servicio en la nube.
26 s de audio en 1,2 s
Medido con audio en chino de dos hablantes en un reComputer J40 Serie; consulta "Rendimiento y datos medidos".
Quién dijo qué
Cada turno lleva una marca de tiempo y una etiqueta de hablante; haz clic en una línea para reproducir desde ahí.
Dentro de tu propio sistema
Se publica un aviso MQTT cuando una transcripción está lista; tu programa recupera el texto completo por HTTP.
En un dispositivo real
La página de resultados en el host: la transcripción se divide por hablante con una marca de tiempo en cada turno; el panel de resumen de IA está a la derecha (apagado en esta ejecución).
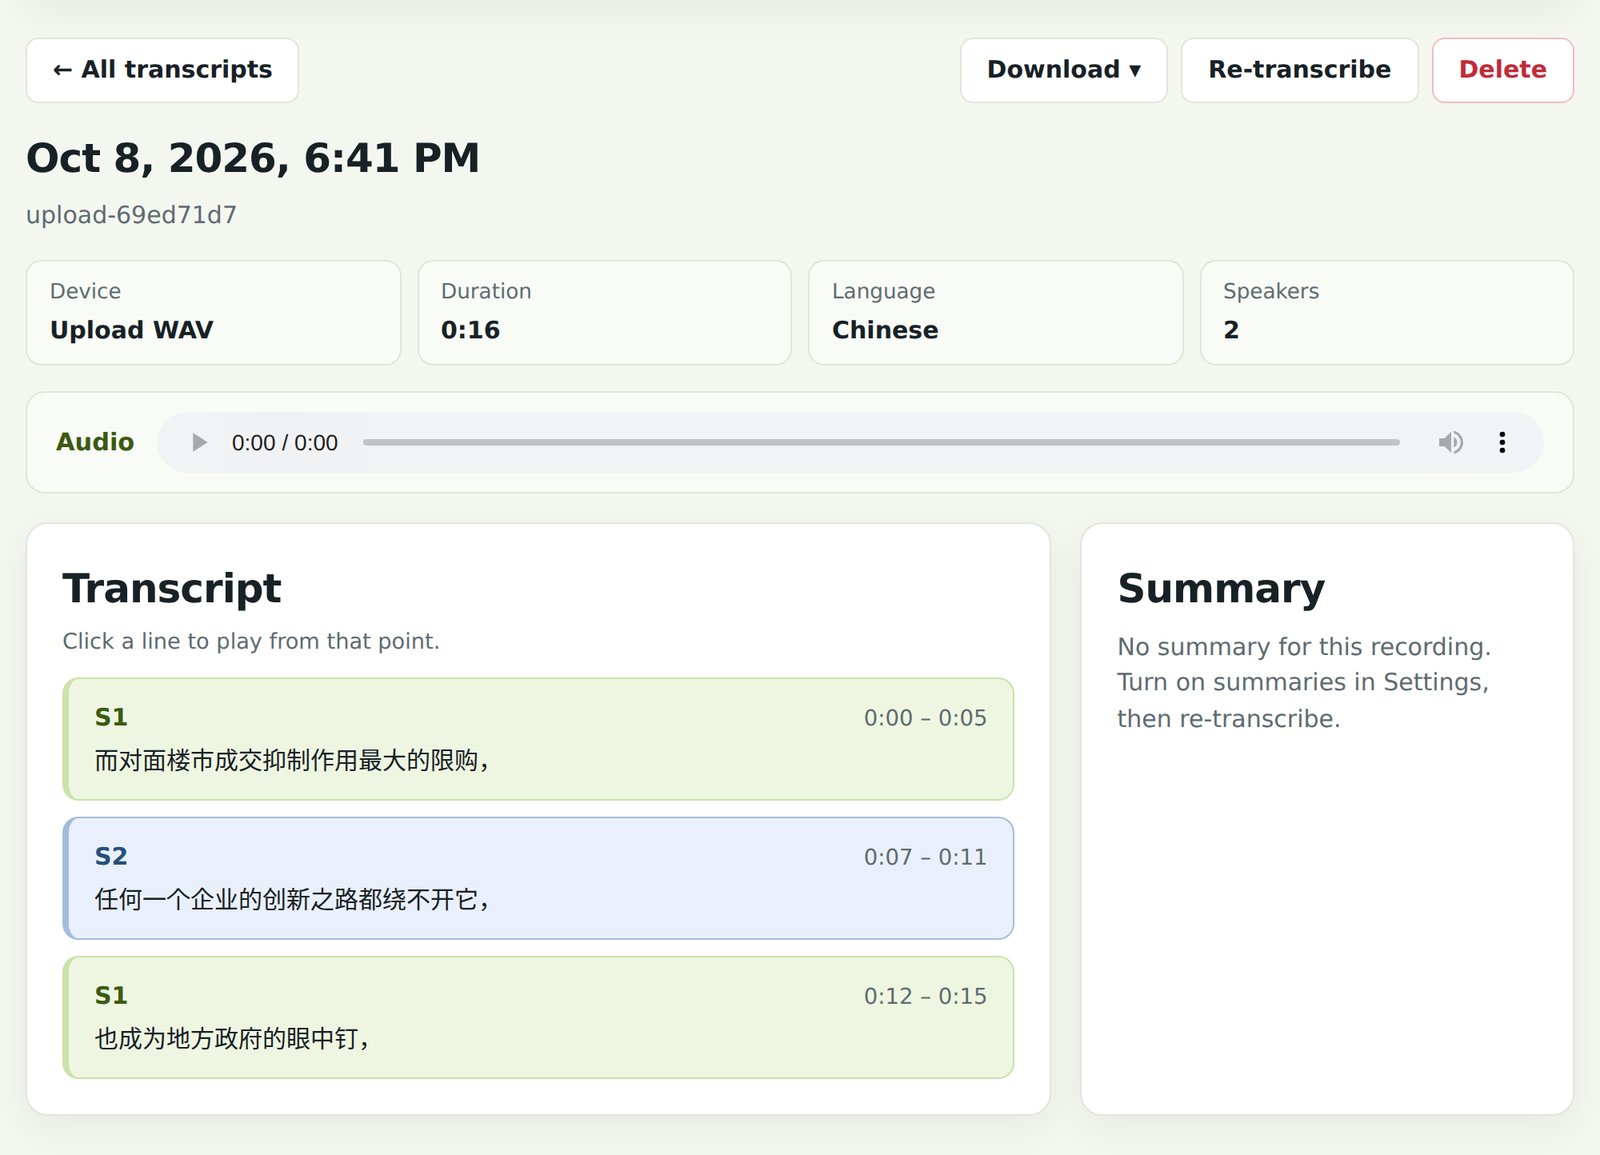
Esta grabación de 16 s combina dos hablantes de AISHELL-1 y se subió como WAV; se transcribió en 1,2 s. La primera línea tiene un carácter extra.
Hardware que necesitas
Dos elementos en el sitio: un reSpeaker Clip y un host de transcripción.
① reSpeaker Clip: una grabadora vestible que se sincroniza con el host por Bluetooth. Página de tienda
② Host de transcripción: elige uno según el tamaño del sitio y el volumen de insignias.
| Host de transcripción | Tiempo de respuesta de un solo audio (30 s en chino, dos hablantes) | Capacidad de lote al final del turno (10 insignias subiendo a la vez) | Elígelo cuando | |
|---|---|---|---|---|
 | reComputer J40 Serie (J4012) Jetson Orin NX 16GB, JetPack 6.2 | 1,2 s | ~3,5 s de tiempo total (espera en cola < 3,5 s) | Opción insignia para 10~50 insignias; los 16 GB de memoria unificada permiten resúmenes LLM 8B locales y auditoría de cumplimiento |
 | reComputer J30 Serie (J3011) Jetson Orin Nano 8GB, JetPack 6.2 | 1,3 s | ~4,1 s de tiempo total (espera en cola < 4,1 s) | Opción principal y rentable para 5~20 insignias; experiencia de usuario idéntica, huella de VRAM de solo 486 MB |
 | reComputer RK3588 Serie (8 GB) RK3588 NPU de 3 núcleos | 3,0 s | ~14,5 s de tiempo total (3 canalizaciones en paralelo) | Opción de estación de trabajo de tamaño medio para 5~15 insignias; 3 núcleos NPU independientes ejecutan 3 workers en paralelo |
 | reComputer RK3576 Serie (8 GB) NPU integrada | 4,6 s | ~46 s de tiempo total (cola de un solo worker) | Opción de bajo costo para 1~3 insignias; pico de RSS de solo 442 MB (W4A16), ideal para clínicas privadas y salas de asesoría |
- Serie Jetson: se requiere JetPack 6.2, al menos 15 GB de disco libre.
- RK3576: versión con 8 GB de memoria, ejecuta pesos cuantizados W4A16, usando ~442 MB de memoria; el host necesita Bluetooth.
- Sincronización rápida Wi‑Fi opcional: el host se une al hotspot propio del Clip para descargar grabaciones. Si el propio host está en Wi‑Fi, añade un adaptador Wi‑Fi USB.
Despliegue en el sitio
1. Coloca el host donde regresan los Clips
Un Clip solo se sincroniza dentro del alcance de Bluetooth del host, así que coloca el host donde el personal devuelve o carga sus Clips. El primer despliegue descarga los modelos de voz (unos 1,8 GB en Jetson, 155 MB en RK3576); después de eso la transcripción no necesita internet.
2. Instala el software: tres pasos
Los pasos por dispositivo están en la página de diseño de referencia; esto es el esquema general.
- Despliega el servicio de transcripción: elige el idioma de grabación y establece un token de acceso; para resúmenes, introduce una dirección de servicio compatible con OpenAI.
- Empareja el Clip: empareja el Clip con el host; las grabaciones se sincronizarán automáticamente.
- Comprueba: abre la página de resultados en el puerto 8631, sube un WAV o sincroniza una grabación y verás una transcripción separada por hablante.
Interfaces
La página de resultados y el API están en el puerto 8631 del host, y las solicitudes no autorizadas reciben 401; los avisos de finalización se envían por el broker MQTT del host.
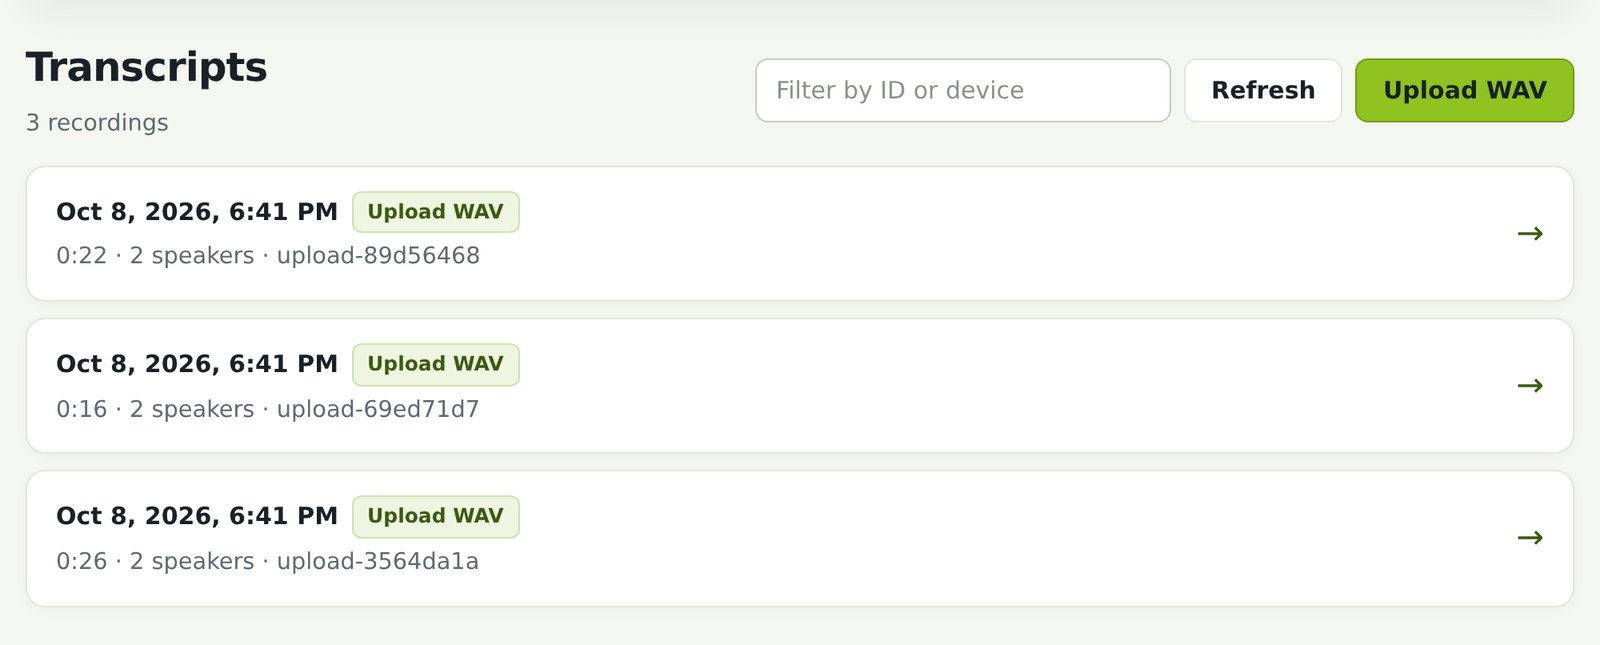
- Solo leer resultados: abre la página de resultados, filtra por ID o dispositivo, descarga, vuelve a transcribir o elimina.
- Archivado automático: suscríbete al aviso de finalización y luego recupera el texto completo por ID mediante HTTP dentro de un ticket o registro de cliente.
- Audio adicional: envía un WAV a través del endpoint de subida; pasa por la misma canalización.
| Tema / puerto | Contenido |
|---|---|
HTTP 8631 / | Página de resultados: lista y detalle de transcripciones |
HTTP 8631 POST /v1/transcribe | Subir un WAV para transcripción |
HTTP 8631 /healthz | Indica si el servicio está listo |
MQTT clip-pt/<host-id>/transcript/<transcript-id>/ready | Aviso de transcripción lista |
Rendimiento y datos medidos
El modelo principal es SenseVoice-Small de Alibaba DAMO Academy (multilingüe: chino, cantonés, inglés, japonés, coreano con salida de texto enriquecido / puntuación) combinado con CAM++ para diarización de hablantes y Silero VAD.
1. Interacción en tiempo real con una sola insignia (diálogo de 30 s)
Las grabaciones se subieron al host como WAV y se cronometraron desde la subida hasta la transcripción y diarización terminadas; no se incluye el tiempo de sincronización por Bluetooth desde el Clip.
| Dispositivo y modelo | Idioma y muestra | Duración del audio | Tiempo de procesamiento | Hablantes / segmentos | Experiencia en el sitio |
|---|---|---|---|---|---|
| reComputer J40 Serie (Orin NX 16GB) | Diálogo largo en chino (FLEURS-A) | 30,5 s | 1,17 s (medido) | 2 / 4 turnos (medido) | Velocidad 175x en tiempo real, el texto aparece de inmediato |
| reComputer J40 Serie | Atención al cliente en chino (FLEURS-B) | 26,1 s | 1,21 s (medido) | 2 / 5 turnos (medido) | Casi instantáneo: etiquetado como S1 / S2 |
| reComputer J40 Serie | Consulta clínica en chino (AISHELL-1) | 16,5 s | 1,17 s (medido) | 2 / 3 turnos (medido) | Sin tiempo de espera apreciable |
| reComputer J30 Serie (Orin Nano 8GB) | Atención al cliente en chino (FLEURS-B) | 26,1 s | 1,32 s (medido) | 2 / 5 turnos (medido) | Opción principal, experiencia idéntica a J40 |
| reComputer J40 Serie | Audio de mostrador en japonés (FLEURS) | 34,0 s | 1,71 s (medido) | 2 segmentos (medido) | Gestión multilingüe rápida para revisión |
| reComputer J40 Serie | Dos frases en inglés (LibriSpeech) | 6,3 s | 1,24 s (medido) | 2 / 2 turnos (medido) | Tiempo de respuesta rápido |
| reComputer RK3588 Serie (8 GB) | Diálogo largo en chino (FLEURS-A) | 30,5 s | 3,0 s (medido) | 2 / 4 turnos (medido) | Velocidad 10x en tiempo real, paralelo multinúcleo |
| reComputer RK3576 Serie (8 GB) | Diálogo largo en chino (FLEURS-A) | 30,5 s | 4,61 s (medido) | 2 / 4 turnos (medido) | Termina en menos de 5 s, adecuado para archivado no urgente |
| reComputer RK3576 Serie | Atención al cliente en chino (FLEURS-B) | 26,1 s | 4,67 s (medido) | 2 / 5 turnos (medido) | Ejecución estable con un solo worker |
2. Concurrencia de carga por lotes al final del turno (10 insignias cargando 10 min de audio total)
El escenario más exigente en el sitio es la devolución al final del turno (por ejemplo, 10 miembros del personal devolviendo las insignias a los cargadores simultáneamente). Gestión de concurrencia y latencia máxima de espera en cola entre plataformas:
| Opción de hardware | Insignias recomendadas | Tiempo total para 10 insignias | Latencia máxima de espera en cola | Mecanismo de planificación y fiabilidad | Sitio recomendado |
|---|---|---|---|---|---|
| reComputer J40 Series (Orin NX 16GB) | 10 ~ 50 insignias | ~3.5 s | < 3.5 s (imperceptible) | Vaciado de cola sub-segundo: El bloqueo de CUDA Graph de un solo contexto protege contra OOM y 429 | Supermercados, tiendas de cadena, salas de servicio |
| reComputer J30 Series (Orin Nano 8GB) | 5 ~ 20 insignias | ~4.1 s | < 4.1 s (imperceptible) | Misma arquitectura, rendimiento de GPU de 29.5 QPS, solo 486 MB de VRAM | Tiendas minoristas estándar con 8~15 empleados |
| reComputer RK3588 Series (RK3588 8GB) | 5 ~ 15 insignias | ~14.5 s | ~5.0 s (3 canalizaciones en paralelo) | Concurrencia multinúcleo por hardware: 3 núcleos NPU independientes ejecutan 3 trabajadores en paralelo | |
| reComputer RK3576 Series (RK3576 8GB) | 1 ~ 3 insignias | ~46 s | ~46 s (secuencial) | Trabajador único ligero: Pico de RSS de solo 442 MB (W4A16), procesamiento secuencial | Clínicas privadas, salas de asesoría, mostradores pequeños |
Por qué Jetson usa un bloqueo de cola de contexto único en lugar de concurrencia multiproceso:
En Orin Nano / NX, SenseVoice TensorRT FP16 con CUDA Graph ya satura el cómputo de la GPU (GR3D98%, solo inferencia pura 3033 ms, 175x en tiempo real). Abrir múltiples contextos de ejecución solo añade 200~300 MB de VRAM y provoca contención de encolado en la CPU, degradando la latencia por flujo a 135 ms. Un bloqueo de cola de contexto único vacía los fragmentos de audio enviados concurrentemente en milisegundos, gestionando docenas de conexiones concurrentes mientras elimina el agotamiento de memoria y los errores 429.
3. Comparación de huella de recursos
| Plataforma host | Formato y precisión del modelo | Tamaño de peso y motor | Memoria pico / VRAM | Arquitectura del trabajador |
|---|---|---|---|---|
| reComputer J40 Series | TensorRT 10.3 FP16 | Motor de 470 MB | 483 MB de VRAM / 1.1 GB de RAM | Bloqueo de cola de contexto único (a salvo de OOM) |
| reComputer J30 Series | TensorRT 10.3 FP16 | Motor de 469 MB | 486 MB de VRAM / 1.1 GB de RAM | Bloqueo de cola de contexto único (alta estabilidad) |
| reComputer RK3588 Series | RKNPU2 FP16 | 505 MB RKNN | ~1.2 GB de RAM / trabajador | 3 trabajadores en núcleos de hardware independientes |
| reComputer RK3576 Series | RKNPU2 W4A16 | 155 MB RKNN | 442 MB de RSS pico (medido) | Trabajador único (se ajusta al presupuesto de 8 GB) |
4. Un Clip real
Un reSpeaker Clip descargó 3 sesiones de grabación por Bluetooth; se ensamblaron en WAV de 16 kHz y se transcribieron en un reComputer J40 Series, el reconocimiento SenseVoice tomó 534 ms y la separación de hablantes 706 ms (medido).
- Reproducción: Los benchmarks de rendimiento y concurrencia se encuentran en el repositorio
benchmarks/eval_transcription.py; ejecutapython3 benchmarks/eval_transcription.py --device j40 --batch 10.
5. Modelos y runtimes
| Dispositivo | Reconocimiento de voz | Diarización | Runtime |
|---|---|---|---|
| reComputer J40 / J30 Series | SenseVoice-Small (texto enriquecido) | CAM++ | TensorRT 10.3 FP16, GPU |
| reComputer RK3588 Series | SenseVoice-Small (multilingüe) | CAM++ | RKNPU2 FP16, NPU, 3 trabajadores |
| reComputer RK3576 Series | SenseVoice-Small (multilingüe) | CAM++ | RKNPU2 W4A16, NPU, 1 trabajador |
Parámetros que afectan los resultados:
- Idioma de grabación: se elige en el despliegue y se aplica tanto a las grabaciones del Clip como a los archivos WAV cargados; "auto" deja que el modelo decida.
- Hablantes esperados: 0 (automático) por defecto. Establécelo cuando conozcas el número para una separación más estable.
- Resumen de IA: desactivado por defecto; cuando está activado, el texto de la transcripción se envía al servicio que configures.
6. Degradación conocida y condiciones límite
- Límite de concurrencia de lotes al final del turno: Debido al límite de 8 GB de memoria del sistema en RK3576, solo se despliega 1 trabajador SenseVoice (~442 MB de RSS). 10 insignias devueltas a la vez se pondrán en cola durante ~45 s. Para despliegues con más de 5 insignias devueltas a la vez, se recomienda encarecidamente reComputer J30 o J40 Series.
- Pérdidas de palabras al inicio de la frase: SenseVoice puede omitir ocasionalmente palabras iniciales en audio largo debido a los umbrales de segmentación VAD.
- Habla superpuesta: Cuando 2 o más personas hablan simultáneamente, la precisión de la diarización disminuye y los turnos pueden fragmentarse o fusionarse.
- Ruido ambiental y distancia de uso: En entornos extremadamente ruidosos (por ejemplo, sistemas de megafonía minorista), el habla puede ser filtrada por la supresión de ruido; lleva la insignia a 20–40 cm del hablante.
Fuentes de datos y recursos
- FLEURS (Conneau et al., 2022): huggingface.co/datasets/google/fleurs, partición dev cmn_hans_cn, CC BY 4.0.
- AISHELL-1 (Bu et al., 2017): openslr.org/33, Apache 2.0.
- LibriSpeech: openslr.org/12, CC BY 4.0 (muestra en inglés).