IA de voz conversacional interrumpible en el Edge: creación, despliegue y resultados medidos
Esta es una implementación de referencia de código abierto, no un producto certificado. La precisión del habla solo se ha medido en RK3576 y en Orin NX (Qwen3-ASR int4).
Qué hace esta solución
Alguien se acerca a un dispositivo y le habla. El dispositivo responde en voz alta; si la persona empieza a hablar de nuevo a mitad de la respuesta, el dispositivo se detiene de inmediato en lugar de terminar la frase.
Diseñada para lugares donde una persona habla con una máquina con las manos ocupadas: mostradores de servicio, exposiciones y quioscos, frontends de voz para robots, terminales de hogar inteligente y de habitaciones.
- Implementación de código abierto: github.com/Seeed-Solution/openvoicestream
- Elegir una configuración y desplegar: página de diseño de referencia
El habla permanece en el dispositivo
El reconocimiento (Qwen3-ASR) y la síntesis (Matcha-TTS) se ejecutan en el host perimetral. Con un preset totalmente local, el modelo de conversación también se ejecuta allí y el dispositivo funciona sin conexión después del primer arranque.
Conecta el micrófono e interrumpe
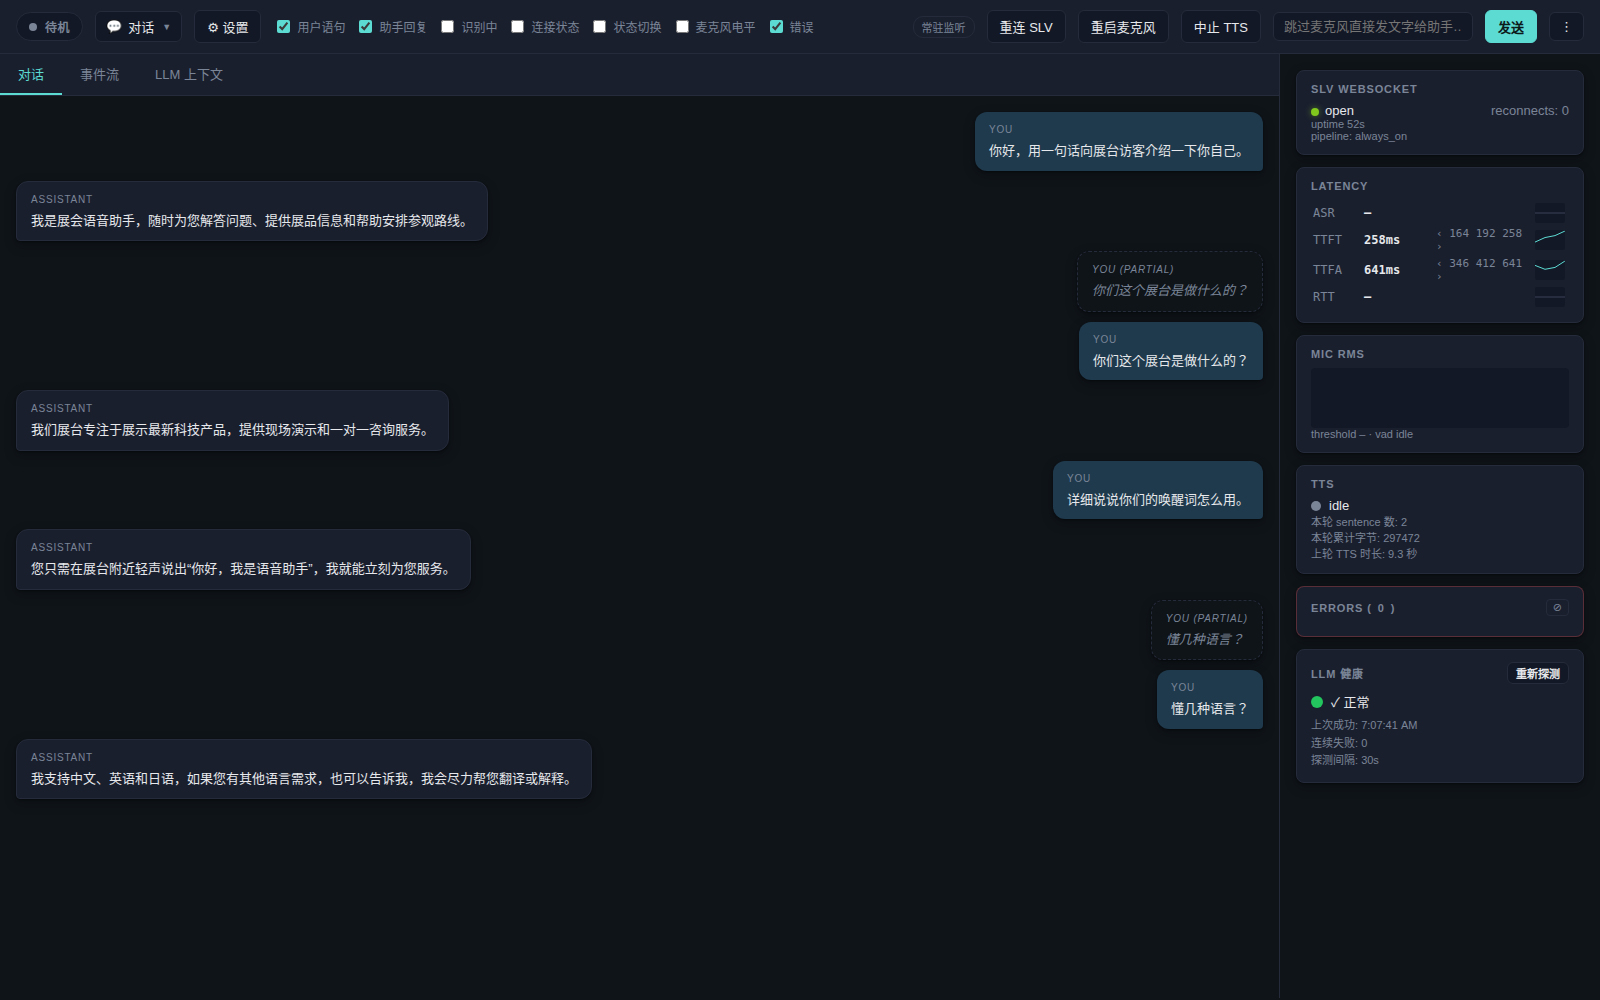
El reSpeaker XVF3800 realiza la cancelación de eco en hardware y se detecta automáticamente por USB, incluido el hot-plug. Habla mientras se reproduce la respuesta y el dispositivo se detiene.
Código abierto, funciona con tu backend
El código es abierto. La conversación pasa por una API compatible con OpenAI, así que apuntarla a tu propia base de conocimiento, agente o backend de pedidos es solo cambiar una URL; la capa de voz permanece igual.
Medido en chino e inglés
Medido en RK3576: 1,05 % de tasa de error de caracteres en enunciados cortos en chino, síntesis a 0,204× en tiempo real. Los hosts RK3588 y Jetson ofrecen 30 idiomas.
Qué hardware necesitas
Cuatro elementos en el sitio: una matriz de micrófonos, un altavoz y un host de voz; si el texto de la conversación no debe salir del sitio, también una tarjeta aceleradora o un host lo bastante grande para un modelo de 4B.
① La matriz de micrófonos debe realizar cancelación de eco acústico (AEC) en hardware.
| Micrófono | Notas | |
|---|---|---|
 | reSpeaker XVF3800 USB 4-Mic Array Matriz USB con AEC por hardware, supresión de ruido y conformación de haz | El valor predeterminado validado. Se reconocen tanto las disposiciones de firmware de 2 canales como de 6 canales y el canal procesado se selecciona automáticamente. Otras matrices vuelven a capturar el canal 1 y necesitan una prueba acústica en el sitio antes de entrar en producción. |
② Un altavoz: USB o jack de 3,5 mm, en el mismo dispositivo. No silencies el micrófono durante la reproducción para evitar eco; eso también desactiva la interrupción (barge-in).
③ El host de voz ejecuta el reconocimiento, la síntesis y el agente residente, y determina qué idiomas puedes ofrecer:
| Host de voz | Idiomas que puede servir | Cuándo elegirlo | |
|---|---|---|---|
 | reComputer RK3576 NPU Rockchip, Qwen3-ASR W8A8 + Matcha | Chino, inglés | Host de menor coste para toda la pila de voz local; los datos medidos en "Rendimiento y datos medidos" proceden de esta placa |
 | reComputer RK3588 NPU Rockchip, añade Kokoro RKNN para TTS | Los 30 | Necesitas los 28 idiomas más allá de chino e inglés, o planeas añadir una tarjeta RK1828 para conversación local más adelante |
 | reComputer J3011 (Orin Nano 8GB) Qwen3-ASR int4 + Matcha en la GPU | Los 30 | El host también ejecuta otras cargas de trabajo de IA y necesita margen en la GPU. No ejecutes un modelo local de 4B en él |
 | reComputer J4012 (Orin NX 16GB) Voz más Qwen3.5-4B en el mismo host | Los 30 | El texto de la conversación no debe salir del sitio |
La serie reComputer R2000 también ejecuta una pila de voz en CPU (sherpa-onnx, solo inglés); aún no se ofrece en el configurador de la página de diseño de referencia. No admite chino, y ASR y TTS comparten cuatro núcleos de CPU.
④ Conversación totalmente local en la ruta RK: añade una tarjeta NPU PCIe RK1828 / RM182X a un host RK3588 para ejecutar Qwen3-4B. La tarjeta necesita su propia alimentación de 12 V y el host necesita el controlador y el nodo de dispositivo. Solo un modelo grande puede residir en la tarjeta a la vez.
Además: el primer arranque necesita acceso a internet y espacio libre en disco (al menos 25 GB en Orin NX), y la herramienta de despliegue debe poder alcanzar el host a través de la red.
Límites de selección negativa
- Carga de trabajo de LLM local (On-Premise): RK3576 es ideal para streaming ligero de ASR/TTS, pero no para ejecutar localmente LLM conversacionales de clase 7B; elige la reComputer J40 Serie acelerada por GPU.
- Alto ruido acústico: En entornos ruidosos por encima de 75 dB, evita micrófonos omnidireccionales y usa matrices de micrófonos direccionales con cancelación de ruido dedicadas.
Cómo desplegar en el sitio
Instala primero el micrófono y el altavoz, luego ejecuta el asistente de despliegue.
1. Colocar el micrófono y el altavoz
La interrupción (barge-in), la detección de turnos y mantener el micrófono abierto durante la reproducción requieren un canal de captura con la salida del altavoz ya eliminada por hardware. Un micrófono sin AEC por hardware provoca interrupciones falsas o un bucle de eco, y ningún ajuste de software soluciona eso.
- Usa el reSpeaker XVF3800 de forma predeterminada. Si utilizas otra matriz, realiza primero una prueba acústica en el sitio; las matrices desconocidas se ajustan por defecto al canal 1.
- Realiza la aceptación con el altavoz al volumen normal de la sala. Un terminal que pasa la prueba a bajo volumen puede fallar al volumen de operación por razones acústicas no relacionadas con los modelos.
- El reSpeaker puede conectarse antes del despliegue o conectarse en caliente después de que el agente esté activo. El agente selecciona el dispositivo de captura por identidad de producto USB, ignora las pseudoentradas HDMI/DP y se recupera de desconectar/conectar de nuevo sin reiniciar el contenedor.
2. Instalar el software
La app SenseCraft Solution se despliega en el host a través de SSH (o localmente, si estás en un Jetson Orin con JetPack 6.2). Los pasos por dispositivo están en la guía de despliegue; el esquema general son cuatro pasos.
- Elige un preset: en la nube / compatible con OpenAI, o totalmente local. Con un preset en la nube, el texto de la conversación va a un endpoint externo; con un preset totalmente local, nada sale del sitio.
- Elige el idioma de la conversación: el despliegue resuelve
(language, device)a un único perfil de voz antes de iniciar los demás servicios. Un par no compatible, como chino en la serie reComputer R2000, sale con código 2 y detiene todo eldocker compose up; nada se inicia a medias. - Rellena el endpoint y la persona: URL base, clave e ID de modelo para el preset en la nube (valores predeterminados: el endpoint Qwen de la región de Pekín con
qwen3.5-flash), más el prompt del sistema. Puedes cambiar de Always listening a Wake word required y escribir cualquier frase corta en chino o inglés; el detector de vocabulario abierto sherpa-onnx de la imagen la compila localmente al inicio. - Verifica en el panel: el panel web en el puerto 18000 muestra escuchando / pensando / hablando / interrumpido.
Aceptación: tres turnos en la sala real con volumen real de altavoz, interrumpiendo 0,5–1 s después de que empiece cada respuesta. Comprueba que la respuesta anterior se detiene inmediatamente y que el enunciado que interrumpe no se pierde.
Tiempo: unos 30 minutos para un preset en la nube. Los presets totalmente locales tardan más porque el primer arranque descarga los archivos de modelo; después de un arranque en línea satisfactorio, las imágenes y los archivos de modelo se almacenan en caché y el dispositivo funciona sin conexión.
Interfaces disponibles
El agente llama a una API de Chat Completions en streaming compatible con OpenAI. Apunta LLM_BASE_URL a tu propio servicio para integrar: un endpoint RAG sobre tus documentos, un framework de agentes con llamadas a herramientas, una capa de comandos para robots, un backend de pedidos o de tickets. La capa de voz no cambia.
- Modelo alojado: mantén los valores predeterminados o sustituye la URL base, la clave y el ID de modelo. El endpoint debe admitir Chat Completions en streaming.
- Tu propio servicio: implementa la misma interfaz. El agente envía la transcripción como turno de usuario y hace streaming de la respuesta hacia la síntesis, de modo que la primera frase empieza a reproducirse antes de que tu servicio termine de generar.
- Solo capa de voz: para construir un agente diferente encima, llama directamente al WebSocket dúplex y a los endpoints offline de abajo.
Lista completa de puertos y endpoints
Todos los servicios usan red en modo host, así que <host> es la propia dirección del host de voz.
| Endpoint | Qué despliegue | Qué transporta |
|---|---|---|
ws://<host>:8621/v2v/stream | cada preset | La sesión dúplex: PCM de entrada, transcripción y PCM de TTS de salida, más el aborto que dispara una interrupción |
POST http://<host>:8621/asr | cada preset | Transcripción offline de archivo completo, sin VAD y sin streaming. Las cifras de precisión offline en "Rendimiento y datos medidos" se miden aquí |
POST http://<host>:8621/tts | cada preset | Síntesis; la cabecera de respuesta x-rtf transporta el factor en tiempo real |
GET http://<host>:8621/health | cada preset | Disponibilidad; se usa como healthcheck de Compose |
http://<host>:18000 | cada preset | Panel web: estado del turno y transcripción de cada turno |
http://<host>:1828/v1, /health | preset local RK3588 + RK1828 | Chat Completions compatibles con OpenAI para el Qwen3-4B en el dispositivo |
http://<host>:8000/v1, /health | preset local Orin NX | Chat Completions compatibles con OpenAI para el Qwen3.5-4B en el dispositivo |
LLM_BASE_URL (saliente) | preset en la nube | Cualquier endpoint compatible con OpenAI |
Ambas rutas locales exponen la misma interfaz que la ruta en la nube, así que al cambiar solo se modifica LLM_BASE_URL. A menos que apunte hacia fuera, no hay broker ni componente en la nube en la ruta de datos.
Rendimiento y datos medidos
Tiempos de ejecución y parámetros clave
El protocolo dúplex y el Agente son los mismos en cada host; solo cambian los backends que ejecutan ASR y TTS.
| Host de voz | Backend / modelo ASR | Backend / modelo TTS | Perfil resuelto |
|---|---|---|---|
| RK3576 | rk.asr — Qwen3-ASR, codificador RKNN + decodificador RKLLM, W8A8 | rk.tts — matcha-icefall-zh-en, acústico ORT + RKNN Vocos | rk3576-default |
| RK3588 (zh / en) | rk.asr — igual | rk.tts — matcha-icefall-zh-en | rk3588-default |
| RK3588 (otros 28) | rk.asr — igual | rk.tts — Kokoro v1.0 híbrido, decodificador RKNN INT8 frontal + prefijo/cola ONNX en CPU | rk3588-kokoro-rknn |
| Orin Nano 8GB / Orin NX 16GB (zh / en) | jetson.trt_edge_llm — Qwen3-ASR 0.6B, int4 | jetson.matcha_trt — matcha-icefall-zh-en, Vocos bf16/fp16 | jetson-edgellm-v091-matcha |
| Orin NX 16GB (otros 28) | jetson.trt_edge_llm — Qwen3-ASR 0.6B, int4 | jetson.trt_edge_llm — Qwen3-TTS CustomVoice, int4 | jetson-edgellm-v091-customvoice |
| reComputer R2000 series (inglés) | cpu.sherpa_asr — sherpa-onnx streaming zh-en, int8 CPU | cpu.sherpa — voz sherpa-onnx en CPU, int8 | rpi5-default |
El preset totalmente local de Orin NX usa la imagen TensorRT-Edge-LLM v0.9.1; no se cargan motores construidos para otras versiones de TensorRT / JetPack. En el lado RK, los archivos de modelo se descargan en el primer arranque.
Matriz idioma × dispositivo. El despliegue elige un perfil a partir de (idioma, dispositivo). De las 18 celdas, 15 son desplegables y 3 no son compatibles; de las celdas desplegables, 5 tienen mediciones de extremo a extremo y en las otras 10 cada componente tiene mediciones en el dispositivo. Las celdas no compatibles: chino en la serie reComputer R2000, y los "otros 28" idiomas en RK3576 y la serie reComputer R2000. El chino no recurre a Whisper: en todas las placas medidas, el CER de chino de Whisper es del 35–56%. RK3576 solo tiene la voz TTS Matcha zh-en, así que puede transcribir los otros 28 idiomas pero no puede sintetizar una respuesta.
Tres parámetros que afectan a los resultados del despliegue:
barge_in_min_speaking_ms500,barge_in_min_chars2: una interrupción solo cuenta una vez que la respuesta ha empezado a reproducirse y la interrupción dura más que una sílaba.playback_drain_enabledtrue: el Agente permanece en SPEAKING hasta que el búfer de reproducción local queda vacío. Con esto desactivado, el habla durante la cola de la respuesta se trata como un nuevo turno y la respuesta anterior sigue reproduciéndose.- Fin de turno en el servidor: silero, 400 ms de silencio +
QWEN3_ASR_FRONTEND_EOU_MIN_AUDIO_S=2.5, terminando el turno en la primera pausa natural; una frase larga con una pausa en medio obtiene respuesta solo a su primera cláusula.
Mediciones de la serie reComputer RK3576
Condiciones: Debian 12 + Rockchip BSP, perfil rk3576-default; el script de prueba y el contenedor de voz se ejecutan en el mismo dispositivo y se comunican por 127.0.0.1:8621, así que las cifras excluyen la transferencia de red.
ASR en el endpoint offline (POST /asr, archivo completo, sin VAD, sin streaming):
| Idioma | Conjunto | n | Tasa de error |
|---|---|---|---|
| Chino | corto | 5 | CER 1,05% |
| Chino | largo 10–20 s | 5 | CER 9,62% |
| Inglés | corto | 5 | WER 3,65% / CER 1,11% |
| Inglés | largo 10–20 s | 5 | WER 6,99% / CER 4,16% |
Cada archivo largo en inglés volvió como texto completo de varias cláusulas; los errores restantes son desviaciones de reconocimiento ("3:2" transcrito como "three to two"), no truncamiento.
ASR en una sesión en vivo (/v2v/stream, valores de fábrica ASR_MAX_NEW_TOKENS=64, ASR_FINAL_STOP_ON_PUNCT=1), evaluado frente al texto de referencia completo:
| Idioma | Conjunto | n | Tasa de error |
|---|---|---|---|
| Chino | corto | 5 | CER 29,09% |
| Chino | largo 10–20 s | 5 | CER 84,06% |
| Inglés | corto | 5 | WER 16,95% / CER 10,16% |
| Inglés | largo 10–20 s | 5 | WER 63,38% / CER 62,58% |
La alta tasa de error en sesión en vivo proviene de la decisión de fin de turno en el servidor, no de truncamiento del decodificador: con ASR_MAX_NEW_TOKENS elevado a 256 y ASR_FINAL_STOP_ON_PUNCT puesto a 0, las transcripciones en ambos idiomas son idénticas byte por byte.
TTS (POST /tts, leído de la cabecera de respuesta x-rtf, Matcha ORT acústico + RKNN Vocos, voz icefall zh-en):
| Idioma | n | Factor en tiempo real | Rango |
|---|---|---|---|
| Chino | 5 | 0,204 | 0,190–0,216 |
| Inglés | 5 | 0,194 | 0,158–0,216 |
El audio en inglés por frase dura entre 2,5 y 4,3 s.
Latencia en sesión en vivo (modo eco, sin LLM en la cadena):
| Métrica | Idioma | n | Valor |
|---|---|---|---|
Fin del habla → primer frame de TTS (stop_to_tts_audio) | Chino | 4 | 1575 / 1624 / 1596 / 1580 ms (unos 1,6 s) |
ASR final → primer frame de TTS (final_to_tts_audio) | Inglés | 5 | p50 1127 ms, media 1126 ms, 1021–1232 ms |
Fin del habla → ASR final (eos_to_final) | Inglés | 5 | media 2837 ms |
El valor medido de fin del habla → ASR final (stop_to_final) en chino llega más tarde que la respuesta hablada y no se cita.
Reproducir: docs/perf/rk3576-matrix-20260906.md y docs/known-issues/rk3576-v2v-multi-utterance-timeout.md en el repositorio openvoicestream; eos_to_final en inglés con asr_stream_ws_bench.py.
Mediciones de la serie reComputer J40
| Métrica | Valor | Condiciones |
|---|---|---|
| ASR en chino | CER 0 en el conjunto dorado, en streaming y offline | Qwen3-ASR 0.6B int4 |
Degradación conocida
- Micrófono sin AEC por hardware. Cada cifra anterior se tomó en un canal de captura con AEC por hardware. Sin él, el micrófono provoca interrupciones falsas o acople, y ningún valor de configuración lo compensa.
- Pausas a mitad de frase. Sobre el mismo audio, el endpoint offline da CER 9,62% y la sesión en vivo 84,06%; la diferencia proviene de la política de toma de turnos, y el contenido después de una pausa a mitad de frase no recibe respuesta.
- Volumen de aceptación por debajo del volumen de trabajo. Un terminal que pasa a bajo volumen puede fallar a volumen de trabajo por razones acústicas.
Próximos pasos
- Ajustar la detección de fin de turno del lado del servidor para que una pausa a mitad de frase ya no termine el turno antes de tiempo.
- Medir la latencia y la precisión de extremo a extremo para las otras 10 celdas desplegables de la matriz idioma × dispositivo.
Fuentes de datos y recursos
- FLEURS: el corpus de ASR para las mediciones con RK3576, CC BY 4.0, 5 clips cortos y 5 largos por idioma, verificados con sha256. TTS utilizó 5 oraciones redactadas por nosotros por idioma. La fuente para la comparación de Whisper entre dispositivos es
docs/perf/whisper-cross-device-20260827.mden el repositorio openvoicestream. - Registros de ejecución sin procesar:
docs/perf/rk3576-matrix-20260906.mden el repositorio openvoicestream; cada cifra de RK3576 anterior se corresponde con un registro allí. - Modelos de voz: Qwen3-ASR, Matcha-TTS (voz zh-en de icefall), Kokoro v1.0, Qwen3-TTS CustomVoice y sherpa-onnx mantienen cada uno sus términos de licencia originales. Revisa la licencia de cada modelo que realmente despliegues antes del envío comercial.
- Los corpus no se distribuyen con el repositorio; obténlos por separado.