Voz en Retail: Transcripción en Dispositivo o una Pila de Servidor Redactora y Borrable
Esta es una implementación de referencia, no un producto de transcripción certificado ni una herramienta de cumplimiento normativo. Las etiquetas de hablante son resultados de agrupamiento, no identidades.
Ambos modos escriben resultados en el backend de retail. Se diferencian en dónde se ejecuta el ASR: el dispositivo transcribe y solo sube JSON de texto, o un Clip sube audio a través de un teléfono y el servidor ejecuta el ASR.
- Transcripción en dispositivo: la caja ejecuta ASR y sube el JSON de texto final al backend de retail; opcionalmente se puede conservar el WAV localmente.
- Pila de servidor: un host arm64 añade redacción previa a la inserción, MySQL, MinIO, una consola de administración, exportación por sujeto y endpoints de eliminación definitiva. El audio proviene de una matriz de micrófonos en un colector perimetral o de una app de teléfono que ya tengas.
Un sitio que empieza con el preset en dispositivo puede pasar a la pila de servidor más adelante sin cambiar la matriz, el host ni el reconocedor.
Lo que hace esta solución
Preajuste: Transcripción en el dispositivo
Una matriz de micrófonos en el mostrador capta la conversación, y una pequeña caja junto a ella convierte el audio en texto y sube el JSON de la transcripción final al backend de retail para almacenamiento y visualización. En modo Clip, SenseCraft Voice App envía el audio a través de la pasarela a voice-service, que llama a OpenVoiceStream para ASR y escribe el resultado en el mismo backend.
Adecuado para: tiendas individuales o pilotos donde las grabaciones no deben salir del edificio; sitios con un enlace ascendente poco fiable; normas de adquisición que prohíben el procesamiento de voz de terceros; validar la ruta de audio y la calidad de reconocimiento en el sitio antes de pasar a la nube.
- Elegir una configuración y desplegar: página de diseño de referencia
Micrófono plug-and-play
El reSpeaker XVF3800 se enumera como un dispositivo de audio USB estándar. La cancelación de eco, la formación de haz y la supresión de ruido se ejecutan en el propio DSP de la matriz, no en la CPU del host.
El audio puede quedarse en la tienda
La transcripción en dispositivo solo sube JSON de texto. Los clips WAV se escriben solo cuando la salida a archivo está activada; con ella desactivada, el dispositivo conserva solo texto.
Redactado antes de insertar, borrable por persona
La pila de servidor sustituye nombres y números de teléfono por marcadores de posición antes de escribir en la base de datos. El borrado por sujeto devuelve un recuento de residuos; la exportación por sujeto también está disponible.
Funciona con tu app y tus sistemas de negocio
reSpeaker Clip con SenseCraft Voice App sube audio directamente; los sistemas de BI, CRM y ticketing leen texto redactado y llaman a borrar y exportar por HTTP.
Preajuste: Pila de Servidor
Llega el audio y la transcripción redactada se escribe en la base de datos; el contenido almacenado puede borrarse por sujeto, devolviendo un recuento de residuos. El paquete es un Docker compose con versiones fijadas: reconocimiento, huella de voz, el servicio que redacta y almacena, MySQL, MinIO y la consola de administración, además de un endpoint WebSocket de ASR para la ingesta de audio.
Hay dos rutas de captura. En el modo de subida de transcripción en el dispositivo, una matriz reSpeaker XVF3800 en la caja perimetral captura audio, ejecuta detección de actividad de voz y transcribe localmente con OpenVoiceStream; la app entonces solo sube JSON de texto al backend de retail, y el WAV puede quedarse opcionalmente en el dispositivo. En modo Clip, el reSpeaker Clip entrega audio a SenseCraft Voice App, la app lo sube al backend, y voice-service llama a OpenVoiceStream y almacena el resultado. La app usa la clave de operador del .env del host de despliegue; las credenciales de base de datos y el secreto JWT los genera el despliegue.
Casos de uso: el personal y los clientes hablan en el mostrador y el operador quiere saber qué se preguntó sin conservar quién lo preguntó; las solicitudes de eliminación deben responderse con prueba de que las filas de la base de datos, los objetos y las huellas de voz han desaparecido; una app ya captura audio y falta la cadena de backend; pilotos que requieren que el audio permanezca en el sitio.
Lo que muestra la consola
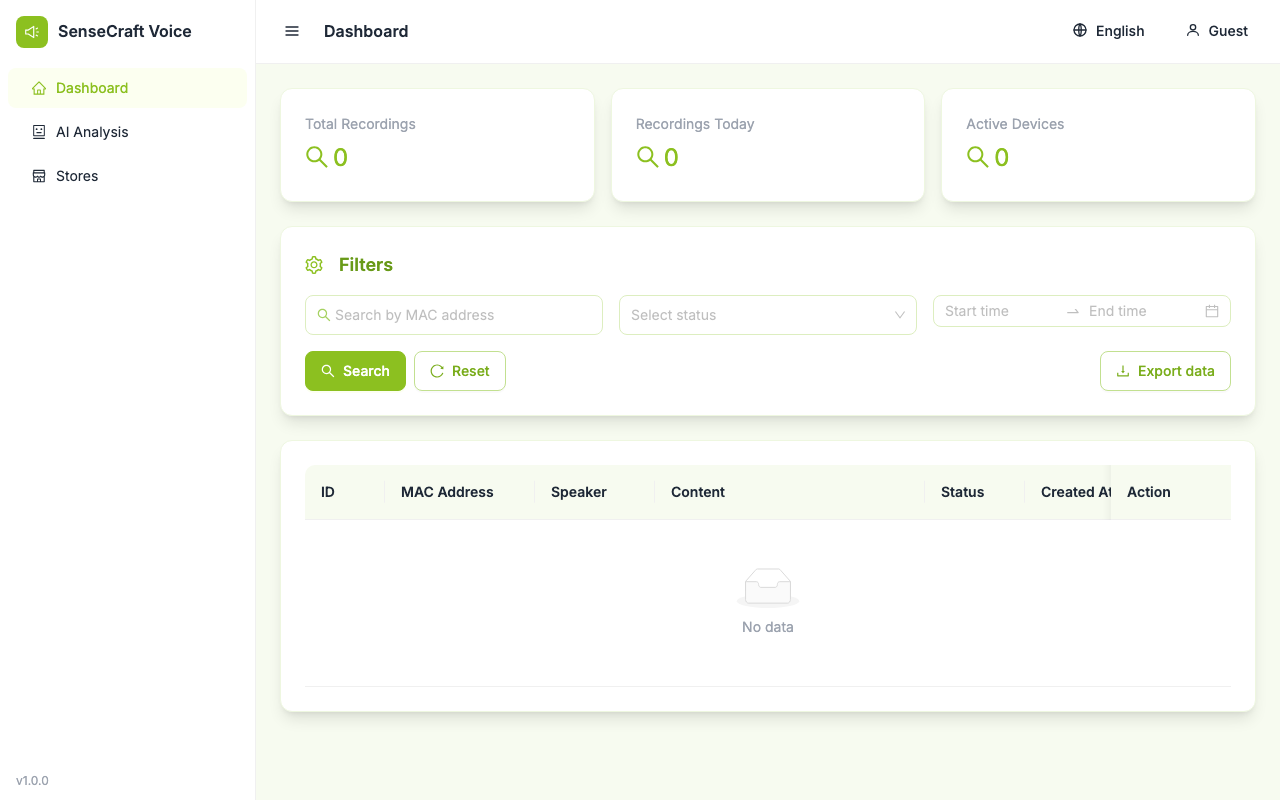
En el preset de Pila de Servidor, después de iniciar sesión en la consola de administración, la lista de grabaciones muestra la transcripción, la duración y el dispositivo de origen de cada enunciado en orden temporal.
El texto de la lista ya está redactado: los nombres y números de teléfono se sustituyen por marcadores de posición antes de la inserción, y el original nunca se almacena.
Qué hardware necesitas
Preajuste: Transcripción en el dispositivo
Dos dispositivos por zona de habla, más un directorio con permisos de escritura.
① Matriz de micrófonos: una reSpeaker XVF3800 en un puerto host USB. La cancelación de eco, la formación de haz y la supresión de ruido se ejecutan en el DSP XMOS de la matriz; el host recibe un flujo mono de 16 kHz, y el procesamiento de front-end no consume CPU del host. La matriz se enumera como un dispositivo de audio USB estándar.
② Host de transcripción: determina si dispones de datos medidos y si la puntuación y las etiquetas de hablante pueden ejecutarse junto al reconocimiento.
| Host | Dónde se ejecuta el ASR | Cuándo elegirlo | |
|---|---|---|---|
 | reRouter CM4 Caja solo CPU, BCM2711, 4 núcleos, 4 GB | 4 núcleos Cortex-A72, Paraformer en streaming | El presupuesto es lo primero y el primer sitio es un piloto |
 | reComputer RK3576-30 NPU de 6 TOPS, 8 GB | NPU RK3576, SenseVoice RKNN fp16 | Necesitas un host con datos medidos, o puntuación y etiquetas de hablante juntas |
Cobertura. Una matriz cubre una zona de habla: con ruido de fondo estable en o por debajo de 70 dB, la formación de haz del XVF3800 cubre a los hablantes dentro de 3 m. No hay modo multi-matriz; un segundo mostrador necesita una segunda matriz y una segunda caja.
También se necesita: un puerto host USB libre; un directorio con permisos de escritura para transcripciones (y audio opcional): el compose limita el tamaño del log de los contenedores y mantiene los modelos en volúmenes con nombre, así que solo el directorio de transcripciones crece con el uso; una red para la subida al backend y la descarga del modelo en el primer arranque.
Preajuste: Pila de Servidor
Como máximo dos cosas: el host que ejecuta la pila y una matriz de micrófonos en la ruta del colector perimetral.
① Host de la pila: cualquier host Linux arm64 con Docker y 20 GB libres. Las imágenes fijadas son solo arm64, y la imagen de reconocimiento incluida está compilada para la NPU RK3576; un host sin una NPU RKNN necesita la imagen de reconocimiento correspondiente.
| Host | Función | Cuándo elegirlo | |
|---|---|---|---|
| — | reComputer RK3576-30 (SKU 100052518) | Host de la pila; también el colector en la ruta del colector perimetral | Las imágenes incluidas están compiladas para esta placa, y el reconocimiento se ejecuta en la NPU |
| — | reRouter CM4 (SKU 110110110) | Solo colector | Ya tienes un CM4; el reconocimiento se ejecuta en la CPU, y el paquete no incluye ninguna imagen fijada para esta ruta, así que la aportas tú |
② Matriz de micrófonos (solo ruta del colector perimetral): reSpeaker XVF3800 USB 4-Mic Array (SKU 101991441). La supresión de ruido, la cancelación de eco y la formación de haz se ejecutan en el DSP de la matriz; el host recibe un flujo mono de 16 kHz por USB.
Inicia un host de stack con 1–2 flujos. La concurrencia solo de ASR está en la tabla de cinco dispositivos bajo "Rendimiento y datos medidos".
Otros requisitos previos: el colector debe poder alcanzar el puerto ASR del host de stack; coloca una terminación TLS delante al cruzar una red no confiable, porque el token puede viajar como un parámetro de consulta en la URL.
Límites de selección negativa
- Límite de canales de audio: reComputer RK3576 está evaluado para hasta 12 flujos de audio concurrentes. Para tiendas minoristas con más de 16 cajas, añade una segunda puerta de enlace o escala a un stack de servidor Jetson.
- Redacción de PII: las transcripciones conservan los números sin procesar de forma predeterminada. Para el cumplimiento financiero y de GDPR, habilita explícitamente la canalización de redacción local en la capa de servidor.
Cómo desplegar en sitio
Preajuste: Transcripción en el dispositivo
Coloca primero el array y luego levanta los dos contenedores.
Parte uno — colocar el array
Hablantes dentro de 3 m del array, ruido de fondo constante en 70 dB o menos (aproximadamente el nivel de una conversación normal). Más allá de eso, la supresión de ruido del array no puede separar al hablante de la sala, aumentan los errores de reconocimiento y un host más rápido no ayuda.
Coloca el array en el mostrador mirando hacia la zona de habla, no detrás de una pantalla ni bajo un voladizo. Se conecta a un puerto host USB de la caja, por lo que ambos deben estar dentro del alcance del cable.
Parte dos — levantar el software
Los pasos por dispositivo están en la página del diseño de referencia. El flujo:
- Elige una configuración: la página pregunta qué debe contener la transcripción (solo texto / texto con puntuación / más etiquetas de hablante) y si necesitas un host con datos medidos antes de la puesta en producción. El host y el array se derivan de esas dos respuestas.
- Despliega el paquete: ambos preajustes ejecutan los mismos dos contenedores, el servicio de voz y el cliente de voz. Cambiar de preajuste modifica la etiqueta de la imagen y el perfil, no el formato de salida.
- Rellena las entradas del dispositivo: directorio de salida, si se conservan los WAV, si se habilitan la restauración de puntuación y los vectores de huella de voz. Cada uno de los dos últimos carga un modelo; habilitar ambos en una placa solo CPU de 4 GB reduce el margen.
- Verifica: envía un WAV corto a
POST /asr. Texto correcto y un campobackendque nombra el runtime real significan que la cadena funciona. La página web local en el puerto 8090 muestra entonces transcripciones en vivo, estado del micrófono y el registro de huellas de voz.
Tiempo: unos 40 minutos por despliegue una vez descargados los modelos. Con el volumen de modelos ya poblado, el tiempo de reinicio a estado saludable en RK3576 fue de unos 25 s.
Preajuste: Pila de Servidor
Dos preajustes, ambos de nivel intermedio, unos 60 minutos, ambos terminan en un paso de aceptación manual. Las operaciones por dispositivo están en la página del diseño de referencia, donde eliges una configuración para tu sitio y descargas el paquete de aplicación correspondiente.
Server Stack + App móvil: despliega el stack en el host arm64 (Paso 1), configura la app con http://<deployment-device-IP>:18621 y la clave de operador del .env del host (Paso 2), abre la consola de administración (Paso 3) y luego verifica (Paso 4). Para la ruta Clip, SenseCraft Voice App recibe el audio del Clip y envía un archivo de audio compatible a POST http://<stt-host>:18621/v1/audio/transcriptions; el backend transcribe, redacta, almacena y muestra el resultado.
Server Stack + Edge Collector: despliega el colector (Paso 1); el compose fijado es una unidad, por lo que el colector trae todo el stack con él. Abre la consola de administración (Paso 2) y verifica (Paso 3).
Qué comprobar manualmente en la aceptación. Que el texto almacenado esté redactado y que no quede nada tras el borrado. Alguien dice una frase que contenga un número de teléfono en la app o en el array de micrófonos. Luego: lee la fila que llegó (el número debe aparecer como un marcador de posición), llama al endpoint de borrado para ese sujeto y lee el recuento de residuo que devuelve, y comprueba la exportación.
Antes de entrar en una tienda: elige la familia de dispositivos y ten listo el dispositivo y el acceso SSH. El despliegue genera credenciales de base de datos, secretos JWT y la clave de operador. La clave de operador se almacena como OPERATOR_TOKEN en el .env del directorio de despliegue; úsala con http://<deployment-device-IP>:18621 en la app.
Interfaces disponibles
Preajuste: Transcripción en el dispositivo
El modo dispositivo produce JSON de transcripción final y lo sube al backend de retail; el modo Clip envía audio a través del teléfono y la puerta de enlace a voice-service. Proporcionas la URL del backend cliente y la clave de acceso en el despliegue; la base de datos interna y los secretos JWT se generan automáticamente.
- Solo texto: lee los archivos JSON.
<output dir>/cache/asr/recibe un archivo por enunciado segmentado con transcripción, marcas de tiempo e idioma, más una etiqueta de hablante cuando la coincidencia de huella de voz está activada. - Texto en vivo: conéctate al WebSocket en 8621. Envía tramas PCM mono de 16 kHz y termina un enunciado con una trama vacía; cada resultado lleva transcripción, puntuación y un vector CAM++ de 192 dimensiones.
- Entrada de archivo completo: haz
POSTde un WAV a 8621. El paso de aceptación en la guía de despliegue llama a esto.
Tabla completa de interfaces y cargas útiles
| Interfaz / puerto | Contenido | ¿Sale del dispositivo? |
|---|---|---|
<output dir>/cache/asr/<id>.json | {"id","text","lang","start_ms","end_ms","speaker"}, un archivo por enunciado segmentado | No |
<output dir>/voice/*.wav | Clips WAV mono de 16 kHz, escritos solo cuando la salida a archivo está activada | No |
ws://<device-IP>:8621/asr/stream?vad=none&punctuate=true&speaker_embedding=true | ASR en streaming: PCM de entrada, transcripción, puntuación y vector CAM++ de 192 dimensiones de salida | No |
POST http://<device-IP>:8621/asr | Transcripción de archivo completo, p. ej. {"text":"这个多少钱","backend":"rk:sensevoice_rknn"} | No |
http://<device-IP>:8090/ | Página local: transcripciones en vivo, estado del micrófono, registro de huellas de voz; solo accesible en la LAN de la tienda | No |
El campo speaker solo aparece cuando la coincidencia de huella de voz está activada. Es una etiqueta de clúster del registro local y no identifica a una persona. El campo backend en la respuesta offline nombra el runtime que atendió la solicitud, para que puedas distinguir SenseVoice en la NPU de un fallback en CPU.
Preajuste: Pila de Servidor
Todos los datos se leen desde endpoints HTTP o WebSocket en el host de stack. Los tokens son entradas name:role:token en .env (VOICE_API_TOKENS, ASR_API_TOKENS), y el rol determina a qué rutas puede llegar un token.
- SenseCraft Voice App: la app convierte el audio de reSpeaker Clip a un formato compatible y lo sube con
POST /v1/audio/transcriptions; el JSON de transcripción vuelve al teléfono. - Cliente de streaming PCM: WebSocket en 8080, rol operator. Tramas binarias PCM sin procesar de entrada, mensajes JSON de salida.
- Sistema de BI o CRM:
GET /api/v1/recordingsen 8081, rol viewer. El texto ya está redactado; ningún endpoint devuelve el original. - Flujo de trabajo de privacidad o ticketing:
POST /api/v1/privacy/eraseyGET /api/v1/privacy/exporten 8081, rol admin. - Personas: la consola de administración en 3000.
Tabla completa de interfaces y cargas útiles
| Interfaz | Puerto | Ruta | Rol | Contenido |
|---|---|---|---|---|
| WebSocket | 8080 | /ws?token=<operator> | operator | Cliente→servidor: tramas binarias PCM sin procesar, 16 kHz, mono, entero con signo de 16 bits little-endian, ≤ 2 MiB cada una. Servidor→cliente: JSON con type de connection, vad, final, error |
| HTTP | 8081 | /api/v1/recordings | operator (POST), viewer (GET) | Carga y consulta de transcripciones; la redacción ocurre antes de la inserción |
| HTTP | 8081 | /api/v1/privacy/erase | admin | Borrado definitivo por sujeto / dispositivo / sesión |
| HTTP | 8081 | /api/v1/privacy/export | admin | JSON de texto redactado más un manifiesto de audio |
| HTTP | 3000 | / | viewer y superiores | Consola de administración: grabaciones, palabras clave, dispositivos, exportar, borrar |
| HTTP | 8621 | /health | — | Comprobación de estado de OpenVoiceStream para sondas de orquestación |
Un mensaje final:
{"type":"final","text":"我想找[[NAME]]咨询一下","timestamp":1757030400000,
 "textLength":12,"wordCount":2,"sessionID":"a1b2","audioID":"c3d4",
 "speaker":{"identified":true,"speaker_id":"spk-7","speaker_name":"staff-a","confidence":0.83}}
Qué significan tres campos:
textes el texto redactado. La base de datos almacena el propio marcador de posición[[NAME]]; el original no se escribe en ningún sitio y no hay copia cifrada.speaker.identifiedesfalseen el despliegue predeterminado. Elige el perfil de huella de voz si necesitas coincidencia de hablante; el endpoint y la clave se entregan después del despliegue.- Los tokens pueden ir en un encabezado. Se aceptan tanto
X-API-TokencomoAuthorization: Bearer; el parámetro de consulta?token=existe para clientes WebSocket en navegador que no pueden establecer encabezados personalizados.
La autenticación separa dos fallos: credenciales ausentes devuelven 401, rol insuficiente devuelve 403, de modo que un integrador sabe si debe cambiar el token o el rol. Las rutas sin una regla explícita requieren al menos viewer, por lo que los nuevos endpoints no son públicos de forma predeterminada; los tokens heredados sin rol se degradan a viewer.
Rendimiento y datos medidos
Preajuste: Transcripción en el dispositivo
Tiempos de ejecución y parámetros clave
El repositorio del servicio de voz OpenVoiceStream no es público, por lo que no hay enlace de GitHub.
| Host | Modelo de reconocimiento | Precisión | Runtime | Cómo llega el modelo al dispositivo |
|---|---|---|---|---|
| reRouter CM4 | Paraformer en streaming | CPU | ONNX / sherpa-onnx en 4 núcleos Cortex-A72 | Descargado en el primer arranque desde el mirror elegido en el despliegue |
| reComputer RK3576 series | SenseVoice | fp16 | RKNN en la NPU de 6 TOPS | Igual; el .rknn está compilado para este SoC |
La puntuación CT-Transformer y la huella de voz CAM++ se ejecutan en la CPU mediante sherpa-onnx en ambos hosts, por lo que habilitar ambos en una placa solo CPU de 4 GB compite con el reconocimiento por los mismos núcleos y memoria.
vad(parámetro de URL de stream): donde se divide un enunciado;vad=nonedeja la segmentación al llamador, que es el ajuste usado en las mediciones de abajo.punctuate=true: carga CT-Transformer y devuelve oraciones con puntuación.speaker_embedding=true: carga CAM++ y emite una etiquetaspeakertras comparar con el registro local con un umbral fijo. La comparación es heurística, sin procedimiento de registro, comprobación de vivacidad ni garantía de confianza; no lo uses para control de acceso, pagos ni ninguna decisión sobre una persona.
Mediciones de la serie reComputer RK3576
| Métrica | Valor | Condiciones |
|---|---|---|
| Latencia de transcripción offline | 3.0 s de audio → unos 780 ms en caliente (RTF 0.26) | SenseVoice RKNN fp16 en la NPU; POST /asr, contenedor en caliente |
| Memoria | RSS del contenedor 1.71 GiB | ASR + puntuación + huella de voz todo cargado |
| Reinicio hasta estado saludable | Unos 25 s | Volumen de modelos poblado |
| Transcripción de enunciados cortos | 5 enunciados cortos (3 zh + 2 en) devolvieron "backend":"rk:sensevoice_rknn" con texto correcto; p50 678 ms, p95 810 ms (n=5, incluye sobrecarga HTTP) | compose sin modificar de este paquete y perfil rk3576-sensevoice, entrada por archivo |
| Precisión de reconocimiento en streaming ▲ | CER chino 9.4%, WER inglés 34.6% | Conjunto corto bench/perf/corpus (5 zh + 5 en), codificador híbrido Paraformer RKNN + decodificador RKNN, ruta en vivo /asr/stream |
| Fin del habla a resultado final ▲ | 326 ms / 347 ms (media zh / en) | Misma ejecución, /asr/stream con 500 ms de adelanto de preparación |
| Vector de huella de voz | RTF 0.09–0.13 (1 s → 125 ms, 3 s → 255 ms, 5 s → 428 ms) | CAM++ vía sherpa-onnx en CPU, 2 hilos; clustering de 10 hablantes 1.45 ms |
| Vector de huella de voz, clase A72 * | RTF alrededor de 0.10 (1 s → 114 ms, 3 s → 303 ms, 5 s → 508 ms), carga en frío 1.66 s | reComputer serie R10 (Cortex-A72, 4 núcleos), misma generación de SoC que el CM4 en reRouter; CAM++ vía sherpa-onnx en CPU |
Reproducir: assets/docker/docker-compose.local-rk3576.yml (cabecera del archivo), openvoicestream/docs/perf/paraformer-rk3576-streaming-ab-20260608.md, openvoicestream/docs/specs/diarization-capability.md
▲ Estas dos filas provienen del perfil de streaming Paraformer, no del perfil SenseVoice desplegado aquí; su latencia no es la latencia de la canalización actual. Para las cifras de fin del habla a resultado final de la canalización actual, consulta la tabla de concurrencia de cinco dispositivos en la sección Server Stack.
* Placa diferente, misma generación de SoC, así que esta fila es derivada: muestra el coste de CPU de los vectores de huella de voz en núcleos de clase A72.
Degradación conocida
- Fuera del rango de captación. Más allá de unos 3 m, o con ruido constante por encima de unos 70 dB, la matriz no puede separar al hablante y aumentan los errores de reconocimiento; ajustar los parámetros anteriores no ayuda.
- El inglés es más débil que el chino en el perfil de streaming Paraformer. En el mismo conjunto corto: WER inglés 34.6%, CER chino 9.4%.
Preajuste: Pila de Servidor
Capacidad y latencia de ASR: comparación de cinco dispositivos
| Familia de dispositivos | Modelo | Streams concurrentes recomendados | p50 / p95 |
|---|---|---|---|
| reComputer J4012 | SenseVoice | 48 | 505 / 789 ms |
| reComputer J3011 | SenseVoice | 32 | 167 / 293 ms |
| reComputer RK3576 | SenseVoice | 12 | 583 / 1067 ms |
| reComputer RK3588 | SenseVoice | 8 | 659 / 902 ms |
| reComputer serie R2000 | SenseVoice | 6 | 625 / 1173 ms |
| reComputer J4012 | Whisper base | 16 | 584 / 1177 ms |
| reComputer J3011 | Whisper base | 8 | 492 / 837 ms |
| reComputer RK3576 | Whisper base | 2 | 809 / 1380 ms |
| reComputer RK3588 | Whisper base | 4 | 655 / 1380 ms |
| reComputer serie R2000 | Whisper base | 16 | 752 / 1465 ms |
Condiciones: cada clip por debajo de 4 s; SenseVoice con un corpus de concurrencia de 200 streams (Jetson) y 100 streams (RK), Whisper con 72 streams (Jetson/RK) y 100 streams (R2000). p50 / p95 se miden desde el fin del habla en ASR hasta el resultado final y excluyen VAD, huella de voz, puntuación, subida, redacción e inserción; esto es capacidad solo de ASR.
Precisión (en un corpus separado de 100 clips, no mezclado con el corpus de concurrencia): CER chino agregado 4.82%; WER inglés 7.62% en J4012, 7.62% en J3011, 8.51% en RK3576, 7.50% en RK3588, 8.39% en la serie R2000.
Reproducir: openvoicestream/bench/asr_bench/build_unified_report.py
Límites conocidos
- El texto original nunca se almacena. Números de móvil, números de identificación, nombres y direcciones se sustituyen por marcadores tipados antes de la escritura en MySQL; solo se enmascaran las entidades con confianza ≥ 0.85, y las que están por debajo del umbral se marcan para una cola de revisión sin enmascarar.
- La puntuación de redacción es a nivel de texto. En un conjunto de referencia de 114 ítems de texto escrito en chino e inglés: precisión 0.98, recall 0.95. La puntuación se calcula sobre texto escrito; en la salida de ASR, los errores de transcripción desplazan los límites de las entidades. Reproducir:
tools/pii_eval.py - Las cadenas de dígitos hablados tienen una brecha. La regla
cn_mobile_spokencubre números de móvil de 11 dígitos leídos en numerales chinos (incluido 幺); los números de identificación, números de línea fija y otros identificadores numéricos leídos como numerales chinos no están cubiertos. - El audio no se redacta. Se conserva 24 horas por defecto, con 6 horas o 1 hora seleccionables en el despliegue; la exportación contiene JSON de texto redactado más un manifiesto de audio, no el audio en sí.
- El borrado por sujeto deja 0 residuo en la base de datos, el almacén de objetos y el audio local; lo que queda es una lápida que contiene solo el SHA-256 del sujeto, más un registro de auditoría. Reproducir:
assets/tools/delete_proof.sh - La analítica fuera de la caja está desactivada por defecto. El contenedor
c4-cloud-analyticssolo se ejecuta cuando se elige el perfilcloud-analytics.
Próximos pasos
- Medir la cadena completa de ingesta del server stack en reComputer RK3576: 1 / 2 / 4 / 8 / 16 streams concurrentes, y latencia fin del habla → redacción → inserción (p50 / p95 / p99).
- Medir la precisión de transcripción en chino e inglés (WER) en el server stack, y captura continua durante 1 / 10 / 60 / 240 minutos y 24 horas.
- Construir la imagen de contenedor de huella de voz y luego medir la tasa de error de hablante.
Fuentes de datos y recursos
Preajuste: Transcripción en el dispositivo
- Modelos de reconocimiento, puntuación, endpointing y huella de voz: SenseVoice y Paraformer para reconocimiento, CT-Transformer para puntuación, CAM++ para huella de voz, Silero VAD para endpointing. Cada uno sigue su licencia upstream; revisa la licencia de cada modelo que uses antes de un despliegue comercial. Los modelos se descargan en el primer arranque desde el mirror elegido en el despliegue.
- Corpus de prueba: las filas de precisión usan el conjunto corto
bench/perf/corpus(5 zh + 5 en); la fila de enunciados cortos usa 5 enunciados (3 zh + 2 en). Ninguno se distribuye con el paquete. - Fuentes de datos de rendimiento:
openvoicestream/docs/perf/paraformer-rk3576-streaming-ab-20260608.md,openvoicestream/docs/specs/diarization-capability.md,openvoicestream/docs/perf-test-runbook.md. El repositorio de OpenVoiceStream no es público, por lo que estos documentos no tienen enlace público. - Diagrama de arquitectura: generado a partir del catálogo aprobado de pegatinas de producto. El nodo de micrófono usa un símbolo de rol genérico, no la carcasa real del XVF3800.
Preajuste: Pila de Servidor
- Conjunto de referencia PII: 114 muestras en chino e inglés detrás de las cifras de precisión y recall; no se distribuye con el paquete.
- Listas de palabras para redacción: los Cien apellidos y la lista de divisiones chinas a nivel provincial, ambos de dominio público. La redacción no usa ningún modelo de terceros.
- Servicios de la pila:
sensecraft-asr-service,sensecraft-voice-client,sensecraft-voice-serviceysensecraft-voice-webson propiedad de Seeed; el reconocimiento usa OpenVoiceStream. MySQL se obtiene bajo GPLv2 con la excepción FOSS, y la versión actual de MinIO es AGPLv3; revisa esa licencia antes de incrustar el almacén de objetos en un producto comercial. - El diagrama de arquitectura en la página de diseño de referencia se representa a partir de IR estructurado en este repositorio.