カスタム Microduck モーションを作成する
この章では、新しいモーションを構築するためのプロジェクトワークフローを紹介します。例としてフェーズベースの おじぎ 動作を使用しますが、同じ手順はうなずき、しゃがみ、ストレッチ、リカバリスキル、その他のロボットモーションにも適用できます。
ポリシーコントラクトを理解する
ホットスワップ可能なすべての Microduck ポリシーは、同じインターフェースを共有します:
- 61 次元のアクター観測:48 個の固有感覚値に、13 次元のコマンドブロック
[twist(3), head_pose(4), body_pose(6)]を加えたもの。 - アクティブなサーボ関節用の 14 次元のアクション出力。
- 未使用のコマンドスロットも存在し続け、ゼロ埋めされます。
- 受動ホイールおよびバックラッシュ関節は
passive_*という命名規則を使用し、駆動関節として選択してはいけません。 - 関節 ID はハードコードするのではなく、プロジェクトのヘルパーによって解決する必要があります。
- ONNX エクスポートは、観測正規化器が含まれるように
scripts/export.pyを経由しなければなりません。
このコントラクトを破ると、あるビューアでは動作しても、正しく切り替えやデプロイができないポリシーが生成される可能性があります。
最も近いテンプレートを選ぶ
| 望ましいモーション | 推奨テンプレート |
|---|---|
| 連続速度モーション | microduck_velocity_env_cfg.py |
| 特定状態からのリカバリ | microduck_standup_env_cfg.py |
| 2 状態コマンド遷移 | microduck_sitstand_env_cfg.py |
| 低速のフェーズベースモーション | microduck_ground_pick_env_cfg.py |
| 高速ダイナミックマヌーバ | microduck_roulade_env_cfg.py |
| ローラーモーション | microduck_velocity_rollers_env_cfg.py |
おじぎの場合、ground-pick タスクは、すでにフェーズコマンド、下降、ホールド、上昇、ポーズトラッキング、リカバリを実装しているため、有用な出発点になります。
テンプレートをコピーする
cd ~/microduck-jetson/microduck_rl

cp src/mjlab_microduck/tasks/microduck_ground_pick_env_cfg.py \
  src/mjlab_microduck/tasks/microduck_bow_env_cfg.py
編集する前に、タスクレジストリと共有 MDP 関数をバックアップします:
cp src/mjlab_microduck/tasks/__init__.py \
  src/mjlab_microduck/tasks/__init__.py.bak

cp src/mjlab_microduck/tasks/mdp.py \
  src/mjlab_microduck/tasks/mdp.py.bak
モーションタイムラインを設計する
シンプルなおじぎでは、0.0 から 1.0 までの正規化フェーズを使用できます:
| フェーズ | 挙動 |
|---|---|
0.00–0.25 | おじぎポーズに向かって下降する |
0.25–0.55 | おじぎを保持する |
0.55–0.85 | ホームポーズに戻る |
0.85–1.00 | 直立状態を安定させる |
2 つのポーズを直接切り替えるのではなく、スムーズな補間を使用してください。ターゲットが急激に変化すると、高いアクションレート、衝撃、不安定な報酬勾配を引き起こすことがよくあります。
ターゲットポーズを定義する
microduck_bow_env_cfg.py に関節名マッピングを作成します。控えめな角度から始め、学習前に Viewer で確認してください。
BOW_POSE = {
    "left_hip_pitch": -0.20,
    "left_knee": 0.30,
    "left_ankle": -0.10,
    "neck_pitch": 0.35,
    "head_pitch": 0.20,
    "right_hip_pitch": -0.20,
    "right_knee": 0.30,
    "right_ankle": -0.10,
}
上記の値はあくまで出発点にすぎません。実際の関節名と符号をロボット構成で確認してください。
報酬を構築する
有用なカスタムモーション報酬は、通常次の要素を組み合わせます:
- フェーズ条件付きターゲットポーズトラッキング。
- おじぎ中に頭を下げるなどのタスク結果に基づく報酬。
- シーケンス終盤の直立およびリカバリ報酬。
- 足接地および横方向安定性の項。
- 関節リミット、衝突、アクションレート、衝撃のペナルティ。
可能な限り、テンプレートの報酬と src/mjlab_microduck/tasks/mdp.py にある共有関数を再利用してください。望む計測が既に存在しない場合にのみ、新しい関数を追加します。
重みを割り当てる前に符号規約を確認してください。すでに負のペナルティを返す関数は、プロジェクトの規約と一致する場合にのみ、通常は正の重みを使用します。近くのタスク設定を確認し、TensorBoard で重み付けされたメトリクスを確認してください。
新しいタスクを登録する
src/mjlab_microduck/tasks/__init__.py で新しい設定をインポートし、既存のエントリに従って新しい ID を登録します:
register_mjlab_task(
    task_id="Mjlab-Bow-Flat-MicroDuck",
    env_cfg=microduck_bow_env_cfg,
    play_env_cfg=microduck_bow_play_env_cfg,
    rl_cfg=microduck_bow_rl_cfg,
)
新しいモジュールで実装した呼び出し可能名を正確に使用し、現在のレジストリシグネチャを踏襲してください。
登録を確認します:
uv run --no-sync list-envs | grep Mjlab-Bow
学習前に確認する
ランダムポリシーを起動して、モデル、リセット状態、センサー、コマンドマネージャ、終端条件設定を確認します:
export DISPLAY=:0
export MUJOCO_GL=glfw

uv run --no-sync play Mjlab-Bow-Flat-MicroDuck \
  --agent random \
  --num-envs 1 \
  --viewer native
不正な接触、スポーン時のめり込み、関節方向の誤り、即時終端、NaN 値、不可能なターゲットポーズがないか確認します。
スモークテストを実行する
export MUJOCO_GL=egl

uv run --no-sync train Mjlab-Bow-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
例外や NaN が発生せずに完了してから、長時間の学習を開始してください。
段階的に学習する
実用的なカリキュラムは次のとおりです:
- モーション探索:容易なスポーン状態、広いポーズ報酬、最小限の外乱。
- モーション完遂:ホールドとリカバリ項を強化し、結果ベースの報酬を追加する。
- ロバスト性:スポーン多様性、摩擦ランダム化、外力、バックラッシュバリアントを増やす。
長時間実行の例:
uv run --no-sync train Mjlab-Bow-Flat-MicroDuck \
  --env.scene.num-envs 2048 \
  --agent.logger tensorboard \
  --agent.max_iterations 2000
合計報酬だけでなく、メインのタスク報酬を注視してください。ポリシーが正則化メトリクスを改善しても、意図したモーションを一度も完遂しない場合があります。
可視化とエクスポート
export DISPLAY=:0
export MUJOCO_GL=glfw

uv run --no-sync play Mjlab-Bow-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --num-envs 1 \
  --viewer native
承認したチェックポイントをエクスポートします:
uv run --no-sync python3 scripts/export.py \
  Mjlab-Bow-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --onnx-file bow.onnx
キーボードトリガーを追加するには、既存の sit/stand、ground-pick、roulade、kick のポリシースイッチングパターンを使用して scripts/infer_policy.py を拡張します。新しいポリシーが期待するコマンドスロットに書き込み、61 次元の観測レイアウトは変更しないでください。
検証済み例:片脚バランス
次のカスタムタスクは、Jetson リファレンスシステム上で実装され、スモークテストが行われました。このモーションはロボットの重心を左足に移し、右足を持ち上げ、バランスポーズを保持してから、通常の両足立ちポーズに戻します。
登録されたタスク ID は次のとおりです:
Mjlab-OneLegBalance-Flat-MicroDuck
モーションタイムライン
このタスクは 6 秒周期のフェーズコマンドを使用します:
| 正規化フェーズ | 挙動 |
|---|---|
0.00–0.30 | 左足に荷重を移し、右脚を持ち上げる |
0.30–0.58 | 片脚バランスポーズを保持する |
0.58–0.78 | 右足を下ろし、直立姿勢に戻る |
0.78–1.00 | 両足ホームポーズで安定させる |
これらの境界は microduck_one_leg_balance_env_cfg.py で定義されています:
BALANCE_PERIOD = 6.0
LIFT_END = 0.30
HOLD_END = 0.58
RETURN_END = 0.78
ターゲットポーズを定義する
ターゲットは、生の MuJoCo 関節インデックスではなく関節名で表現されます。これにより意図が読みやすくなり、ロボットモデルが変更されたときのインデックスのずれを防げます。
ONE_LEG_POSE = {
    "left_hip_roll": -0.25,
    "left_hip_pitch": -0.40,
    "left_knee": -0.05,
    "left_ankle": 0.45,
    "right_hip_roll": -0.10,
    "right_hip_pitch": 0.95,
    "right_knee": -1.25,
    "right_ankle": 0.30,
    "neck_pitch": 0.30,
    "head_pitch": 0.30,
    "head_roll": -0.10,
}
左脚は立位構成に近い状態を保ちます。右股関節と膝は遊脚を前方に折りたたみ、わずかな頭のロールによって、どちらの脚が支持側かを伝えやすくします。
バランス報酬を構築する
この例では、5 つのタスク固有の目的を組み合わせています:
| 報酬 | 目的 |
|---|---|
one_leg_pose | 立位からバランスへの補間関節ポーズをトラッキングする |
support_foot_grounded | 左支持足を地形と接触させ続ける |
swing_foot_airborne | ホールドフェーズ中に右足が床に残らないようにする |
swing_foot_height | 地形上の所望の右足クリアランスをトラッキングする |
com_over_support | 水平な重心を左支持足の上に移動させる |
このタスクはまた、Microduck 学習環境から継承した関節リミット、自己衝突、角速度、アクションレート、アクチュエータ、エンコーダ、摩擦、質量、慣性、重心ランダム化の項も保持しています。
src/mjlab_microduck/tasks/mdp.py には、小さな再利用可能な計測が 2 つ追加されました:
phase_single_foot_airborne_reward()は、右足の空中報酬をアクティブなバランスフェーズに制限します。phase_site_height_track()は、右足の高さターゲットを立位状態と持ち上げた状態の間で補間します。
既存の phase_pose_track(), phase_pose_track_l1(), single_foot_grounded_reward(), com_over_support_foot() 関数はそのまま再利用します。
タスクを登録する
Mjlab-OneLegBalance-Flat-MicroDuck は MJLab のタスクレジストリで使用されるタスク ID です。これはファイル名ではなく、make_microduck_one_leg_balance_env_cfg() に関数引数として渡されるものでもありません。コマンドラインランチャーはこの文字列を使って、src/mjlab_microduck/tasks/__init__.py に登録された環境、プレイ設定、RL 設定、およびランナーを検索します。
定義と登録のパスは次のとおりです:
| 項目 | 位置 | 目的 |
|---|---|---|
| 環境設定 | src/mjlab_microduck/tasks/microduck_one_leg_balance_env_cfg.py | 片脚ポーズ、フェーズタイミング、報酬、シーン、および make_microduck_one_leg_balance_env_cfg() を定義します |
| RL 設定 | src/mjlab_microduck/tasks/microduck_one_leg_balance_env_cfg.py | MicroduckOneLegBalanceRlCfg と学習ハイパーパラメータを定義します |
| タスク登録 | src/mjlab_microduck/tasks/__init__.py | タスク ID を環境および RL 設定にバインドします |
| CLI エントリポイント | uv run --no-sync train <task-id> | 登録済みタスクを検索して学習を開始します |
関係は次のとおりです:
Mjlab-OneLegBalance-Flat-MicroDuck
        ↓ task_id lookup
register_mjlab_task(...)
        ↓
make_microduck_one_leg_balance_env_cfg()
+ MicroduckOneLegBalanceRlCfg
+ MicroduckOnPolicyRunner
したがって、カスタムタスクを選択するために使用する完全なコマンドは次のとおりです:
cd ~/microduck-jetson/microduck_rl
uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
もし list-envs にタスクが表示されない場合は、新しい設定ファイルが存在し、そのインポートと register_mjlab_task() 呼び出しの両方が src/mjlab_microduck/tasks/__init__.py に含まれているか確認してください。コマンド内のタスク ID は、大文字小文字やハイフンを含めて、task_id 文字列と完全に一致している必要があります。
タスク設定のインポートと登録を src/mjlab_microduck/tasks/__init__.py に追加します:
from .microduck_one_leg_balance_env_cfg import (
    make_microduck_one_leg_balance_env_cfg,
    MicroduckOneLegBalanceRlCfg,
)

register_mjlab_task(
    task_id="Mjlab-OneLegBalance-Flat-MicroDuck",
    env_cfg=make_microduck_one_leg_balance_env_cfg(),
    play_env_cfg=make_microduck_one_leg_balance_env_cfg(play=True),
    rl_cfg=MicroduckOneLegBalanceRlCfg,
    runner_cls=MicroduckOnPolicyRunner,
)
MJLab が新しいタスクを検出することを確認します:
cd ~/microduck-jetson/microduck_rl
uv run --no-sync list-envs | grep OneLegBalance
期待される出力:
Mjlab-OneLegBalance-Flat-MicroDuck
MuJoCo でポーズを編集してキャプチャする
この例には scripts/one_leg_pose_editor.py が含まれています。これは重力を無効にし、フローティングベースを固定して、学習前に個々の関節ターゲットを安全に調整できるようにします。
Jetson デスクトップ上のターミナルから直接実行します:
cd ~/microduck-jetson/microduck_rl
uv run --no-sync python scripts/one_leg_pose_editor.py
MuJoCo ウィンドウ右側の Control パネルを展開し、ジョイントスライダーを調整します。ウィンドウを閉じると、最終的な名前付き ONE_LEG_POSE 辞書がターミナルに出力されます。MuJoCo の Save XML および Save MJB ボタンはモデルファイルを保存しますが、このタスクで使用される Python のターゲットポーズ辞書は保存しません。
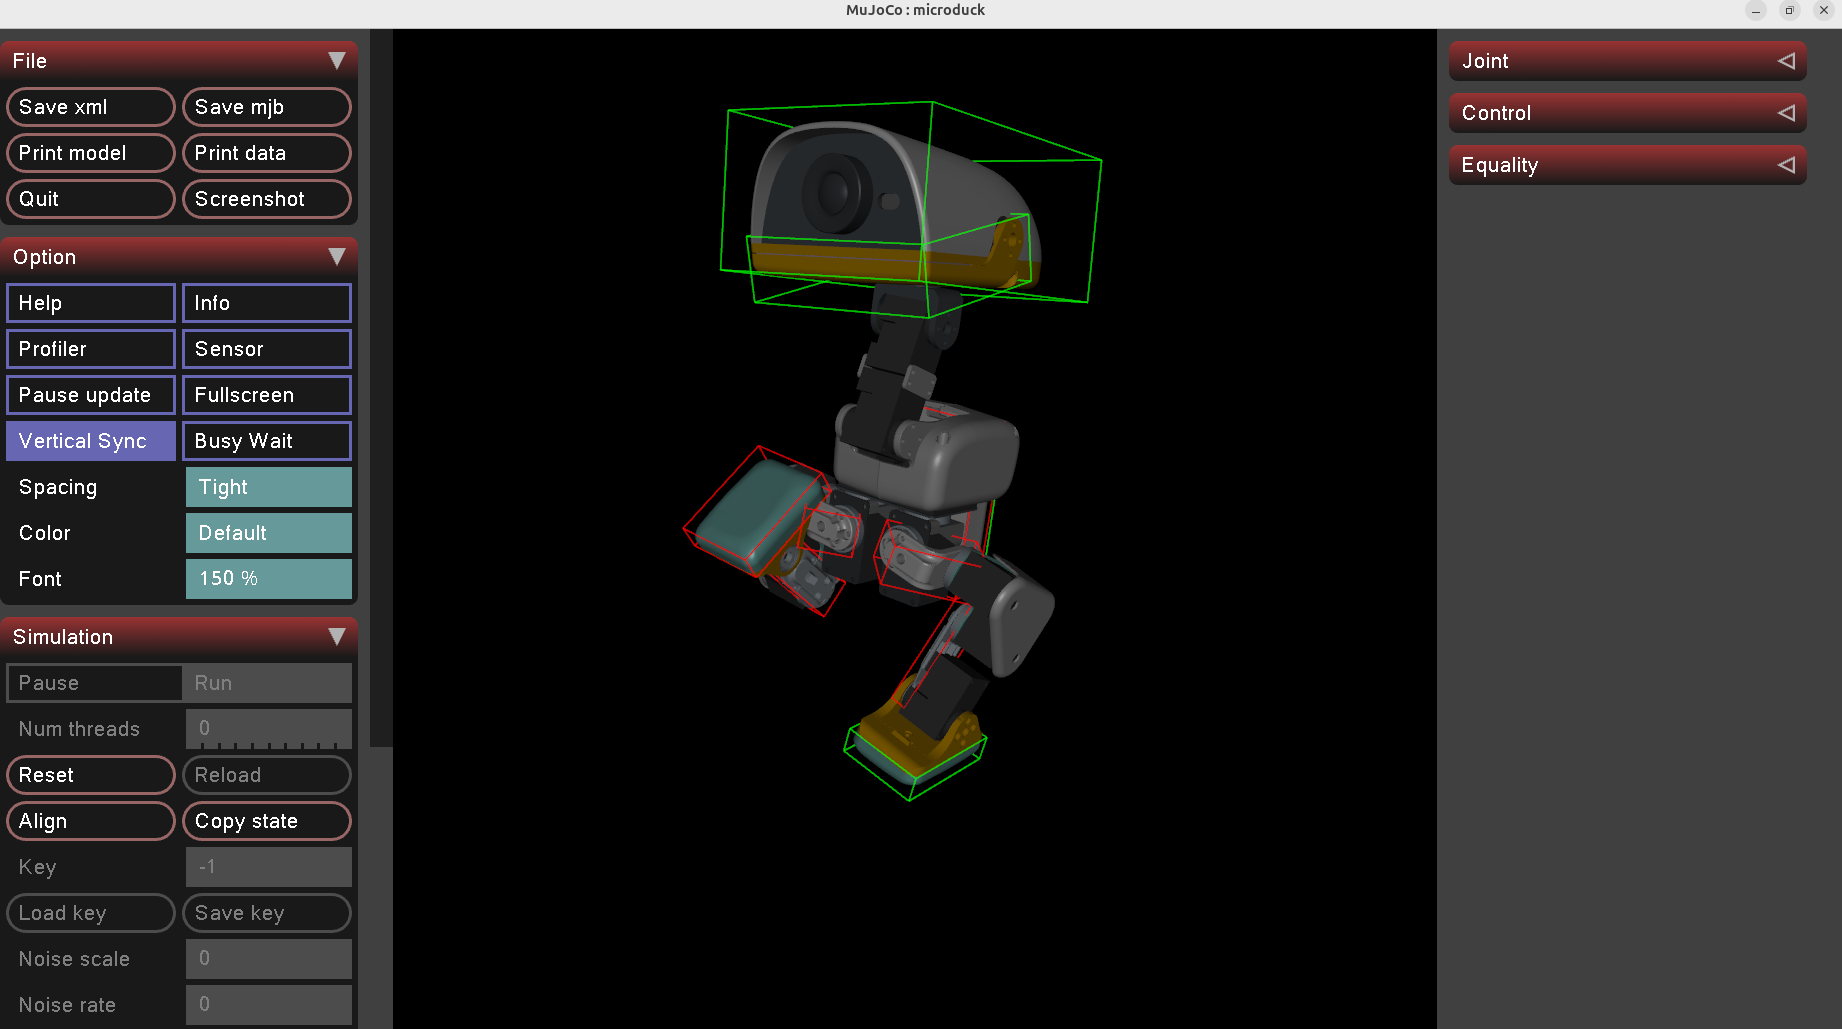
エディタを SSH 経由で起動し、Jetson にローカル接続されたモニタに表示させたい場合は、まずアクティブなデスクトップセッションをエクスポートします。検証済みの Jetson セッションでは DISPLAY=:1 を使用しました:
cd ~/microduck-jetson/microduck_rl

export DISPLAY=:1
export XAUTHORITY=/run/user/1000/gdm/Xauthority
export XDG_RUNTIME_DIR=/run/user/1000
export DBUS_SESSION_BUS_ADDRESS=unix:path=/run/user/1000/bus

~/.local/bin/uv run --no-sync python scripts/one_leg_pose_editor.py
ディスプレイ番号は、再起動後やデスクトップセッションが変わったときに変更されることがあります。Jetson デスクトップ上で直接開いたターミナルから echo $DISPLAY を実行すると、アクティブな値が表示されます。
検証済みスモークテストを実行する
まずは 64 環境と 5 イテレーションから始めます:
cd ~/microduck-jetson/microduck_rl

export MUJOCO_GL=egl

uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
このタスクは、16 GB Jetson 上で 4096 並列環境でもテストされました:
uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 4096 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
4096 環境のスモークテストは、メモリエラーや NaN による終了なしに完了し、およそ 4.6k steps/s に到達しました。アクターの観測は 61 次元のままで、アクション出力も 14 次元のままでした。
8 GB の Jetson Orin NX または Jetson Orin Nano では、まず --env.scene.num-envs 1024 から始めてください。jtop で利用可能メモリを確認した後にのみ増やしてください。
トレーニングビューアを開く
カスタムタスクの学習中に 1 つの環境を可視化するには、Jetson デスクトップから次のコマンドを実行します:
cd ~/microduck-jetson/microduck_rl

uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 1 \
  --agent.logger tensorboard \
  --agent.max_iterations 1000 \
  --env.viewer.distance 0.55 \
  --env.viewer.azimuth 145 \
  --env.viewer.elevation -12
ポーズエディタは、意図したターゲットをすぐに表示します。トレーニングビューアは最初は未学習のポリシーを表示するため、安定した片脚動作が現れるのは、ポリシーが移動、リフト、ホールド、リカバリのシーケンスを学習した後になります。
本格的なトレーニングを開始する
16 GB リファレンスシステムでは、次の設定を出発点として使用します:
uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 4096 \
  --agent.logger tensorboard \
  --agent.max_iterations 20000
スモークテストは、タスク設定、報酬項目、センサー、CUDA バックエンド、および多数の並列環境数が正しく動作することを確認するものです。それ自体ではポリシーの収束を証明するものではありません。保存したチェックポイントを MuJoCo で評価し、ロボットが重心を移動せずに足を持ち上げる、ホップする、あるいは立位に復帰できない場合は、ポーズ、報酬重み、フェーズタイミング、またはカリキュラムを調整してください。
開発チェックリスト
- 観測レイアウトは 61 次元のままである。
- ポリシー出力は 14 次元のままである。
- 受動関節はアクションおよびサーボ観測から除外されている。
- BAM 起動イベントとドメインランダム化は、必要な箇所で有効なままである。
- タスクが
list-envsに表示される。 - ランダムポリシービューアでの検査が成功する。
- 64 環境のスモークテストが成功する。
- TensorBoard でメインタスクのメトリクスが改善している。
- 最終 PT チェックポイントが MuJoCo で正しく動作する。
- ONNX がプロジェクトスクリプトでエクスポートされ、ロボット展開前にリハーサルされている。