公式 Microduck モーションの学習と実行
この章では、最短の学習および推論フローを扱います。利用可能なタスクの確認、公式タスクの学習、.pt チェックポイントの可視化、提供されている ONNX ポリシーの実行、そしてキーボードでシミュレーションロボットを操作する方法を説明します。
利用可能なタスクファミリー
cd ~/microduck-jetson/microduck_rl
uv run --no-sync list-envs | grep MicroDuck
| モーション | タスク ID |
|---|---|
| 歩行 | Mjlab-Velocity-Flat-MicroDuck |
| 歩行と転倒復帰 | Mjlab-VelStand-Flat-MicroDuck |
| 床からの立ち上がり | Mjlab-StandUp-Flat-MicroDuck |
| 着座と起立 | Mjlab-SitStand-Flat-MicroDuck |
| 地面からのピック | Mjlab-GroundPick-Flat-MicroDuck |
| 前方回転 | Mjlab-Roulade-Flat-MicroDuck |
| ボールキック | Mjlab-BallKick-Flat-MicroDuck |
| ローラー移動 | Mjlab-Velocity-Flat-MicroDuck-Rollers |
歩行ポリシーを学習する
長時間の実行の前に、まず 5 イテレーションのスモークテストから始めてください:
cd ~/microduck-jetson/microduck_rl
export MUJOCO_GL=egl

uv run --no-sync train Mjlab-Velocity-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
より長時間の実行の場合:
uv run --no-sync train Mjlab-Velocity-Flat-MicroDuck \
  --env.scene.num-envs 2048 \
  --agent.logger tensorboard
メモリと熱設計に余裕がある場合にのみ、環境数を増やしてください。実用的なフォールバックシーケンスは 4096 → 2048 → 1024 → 512 です。
PT チェックポイントを可視化する
チェックポイントを探します:
find logs/rsl_rl -type f -name 'model_*.pt' | sort
SSH 経由のブラウザビューア
export MUJOCO_GL=egl

uv run --no-sync play Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --num-envs 1 \
  --viewer viser
同じネットワーク上のコンピュータから http://<JETSON_IP>:8080 を開きます。
Jetson デスクトップ上でのネイティブビューア
export DISPLAY=:0
export MUJOCO_GL=glfw

uv run --no-sync play Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --num-envs 1 \
  --viewer native
公式マルチポリシー ONNX デモを実行する
このリポジトリには、pretrained/pollen-robotics/ に 9 個の公式 ONNX ポリシーが含まれています。
cd ~/microduck-jetson/microduck_rl
export DISPLAY=:0
export MUJOCO_GL=glfw

uv run --no-sync python3 scripts/infer_policy.py \
  --walking pretrained/pollen-robotics/alpha_walking.onnx \
  --standing pretrained/pollen-robotics/alpha_stand.onnx \
  --sitstand pretrained/pollen-robotics/alpha_sitstand.onnx \
  --ground-pick pretrained/pollen-robotics/alpha_ground_pick.onnx \
  --roulade pretrained/pollen-robotics/roulade.onnx \
  --kick-left pretrained/pollen-robotics/ball_kick_left.onnx \
  --kick-right pretrained/pollen-robotics/ball_kick_right.onnx \
  --front-back-split models/exports/front_back_split/front_back_split_model_999.onnx \
  --new-cmd-obs
キーボード操作
| キー | コマンド |
|---|---|
| 矢印キー | 前進、後退、横方向の速度 |
A / E | 左右への旋回 |
G | 地面からのピック動作 |
Y | 着座 / 起立の切り替え |
R | 前方回転 |
K / L | 左 / 右キック |
O | 6 秒間の前後スプリット、その後立位または歩行に復帰 |
Space | 速度コマンドのクリア |
Q | 終了 |
推論結果
以下の GIF は、Jetson 上の MuJoCo から直接キャプチャした ONNX 推論結果を示しています。
歩行
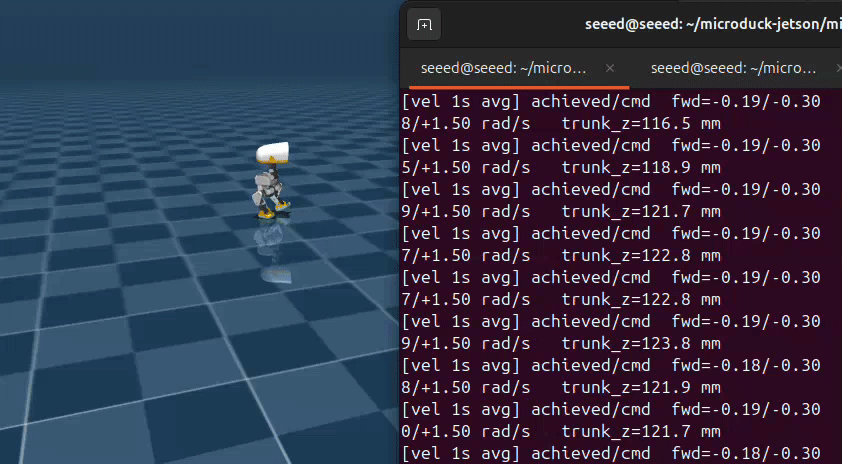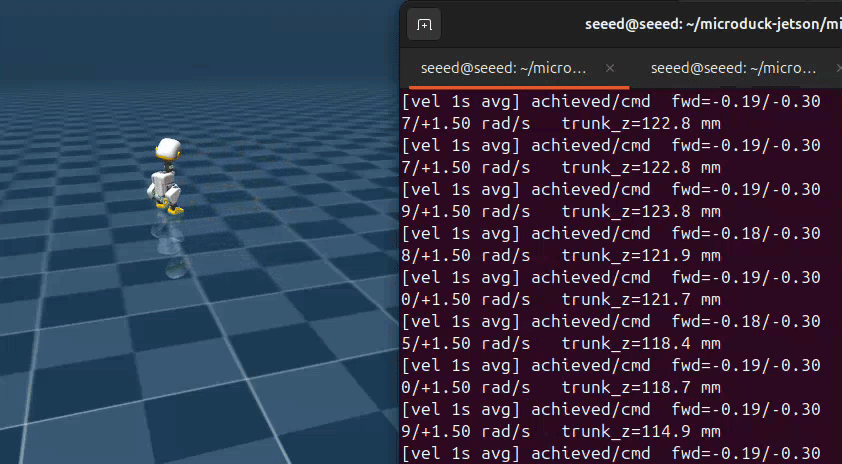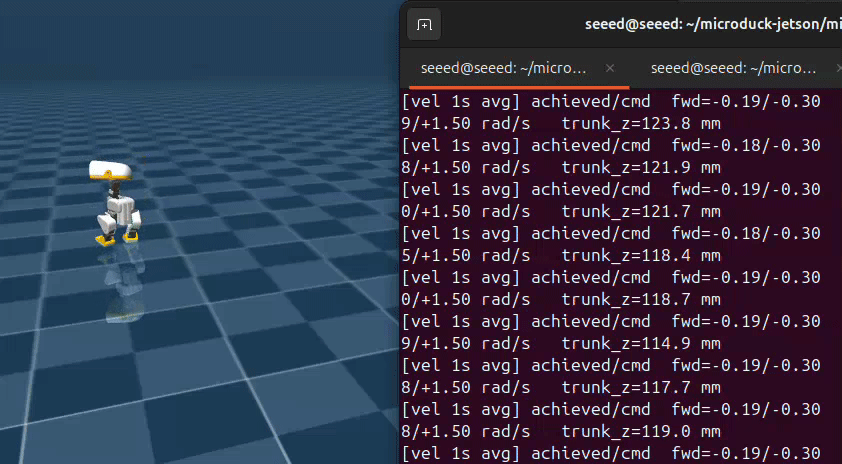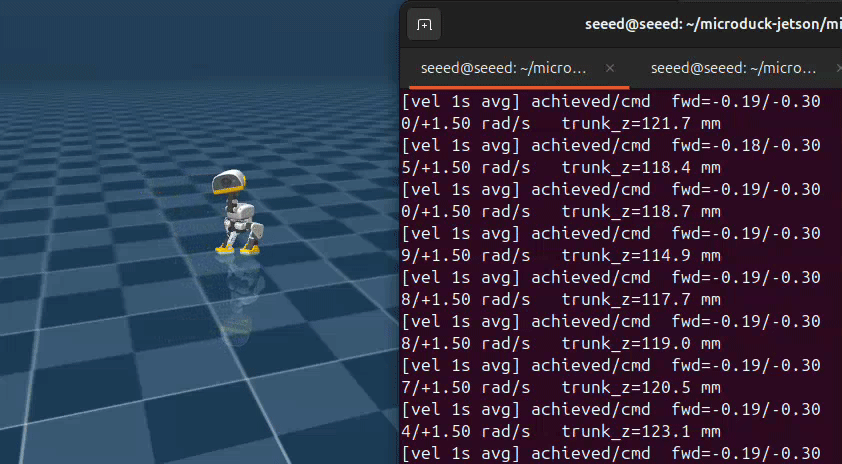
歩行ポリシーは、キーボードからの速度および旋回コマンドを継続的に追従します。
ローリング
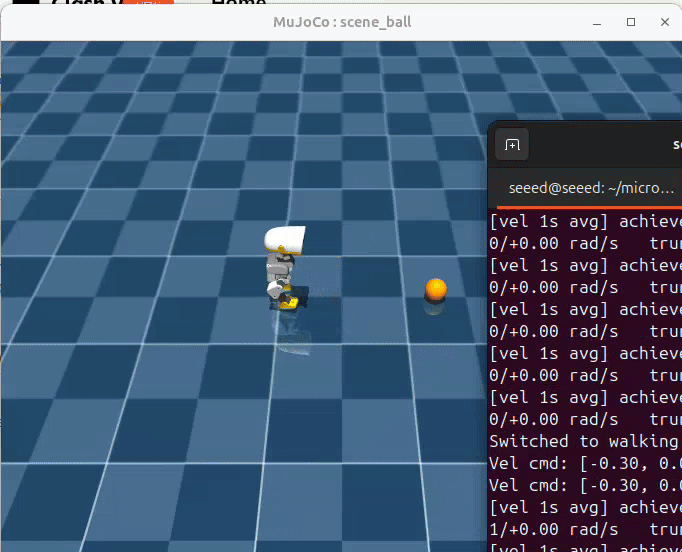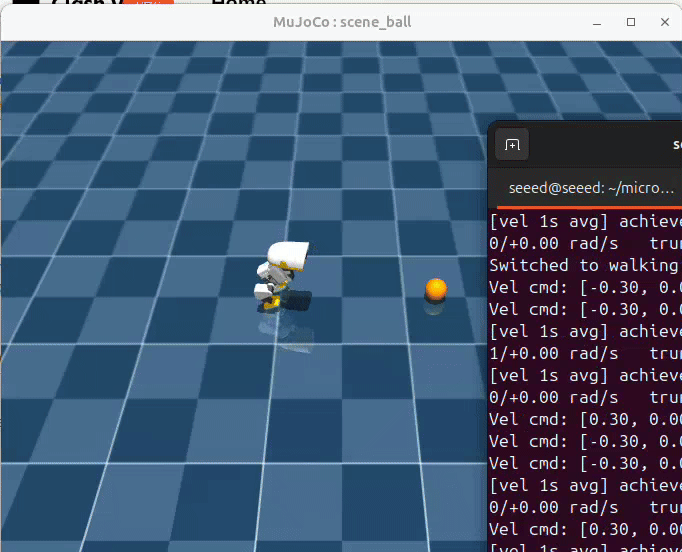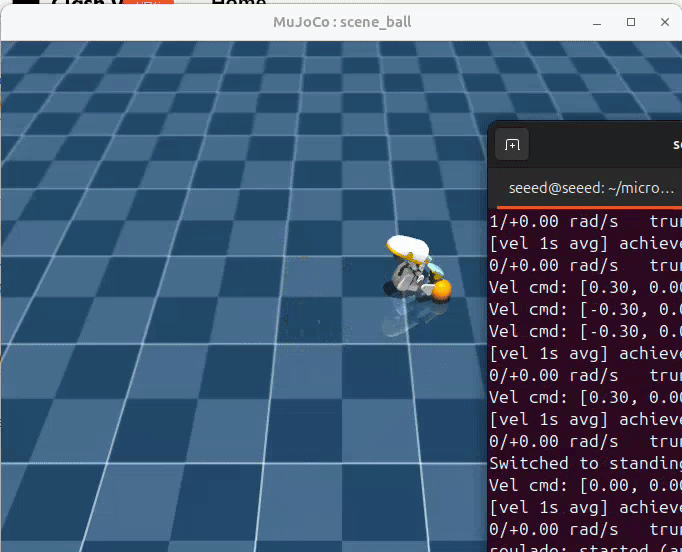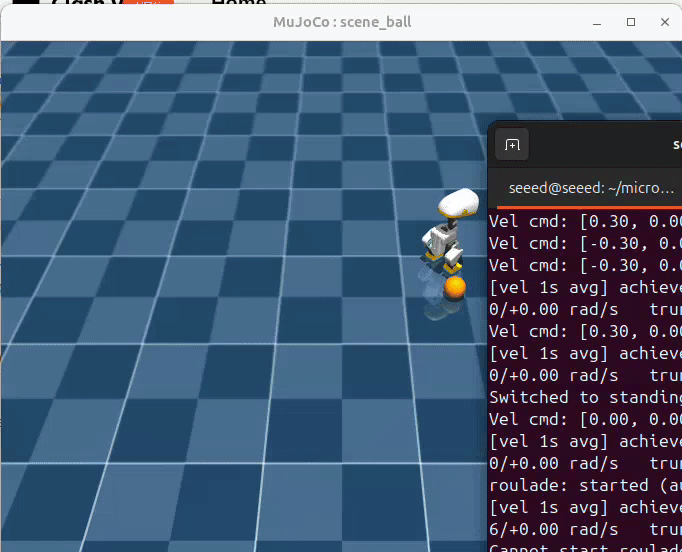
R を押すと、前方回転ポリシーに切り替わります。
ボールキック
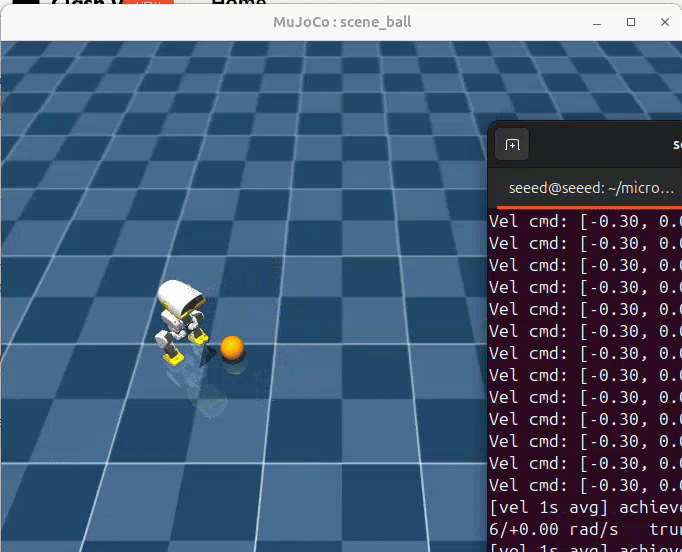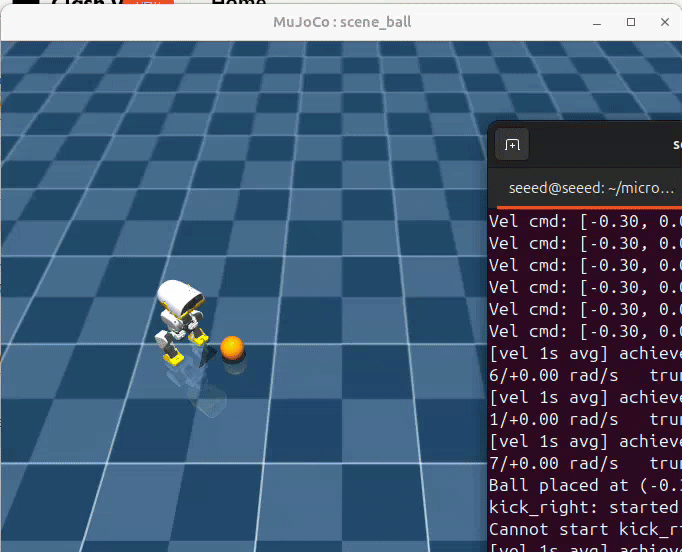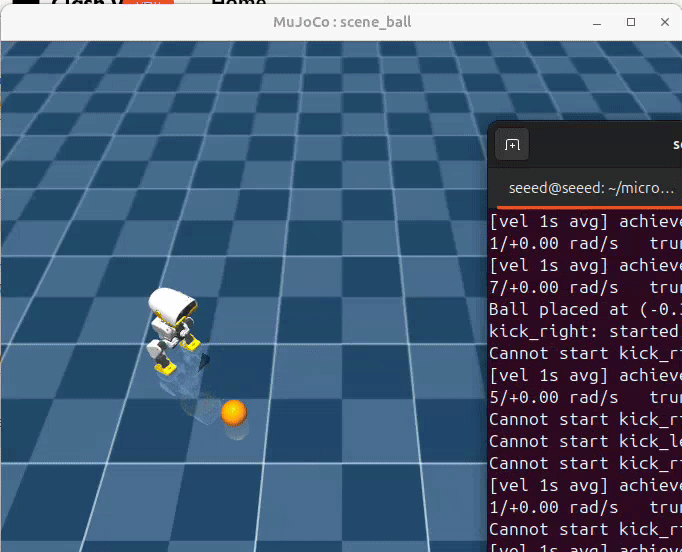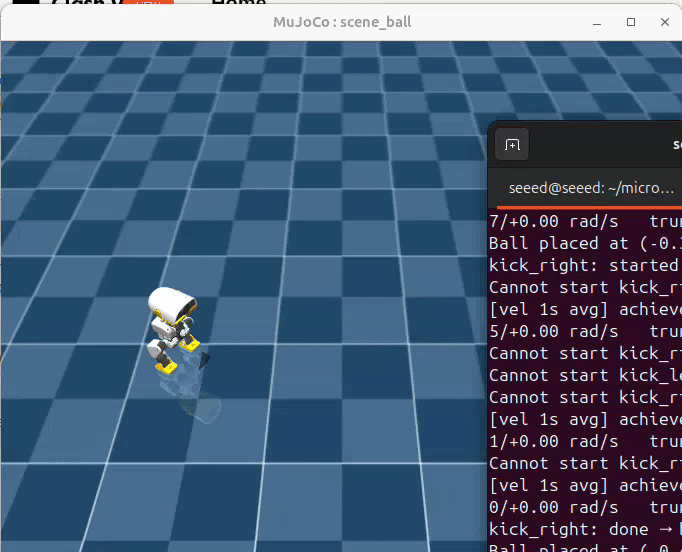
ボールシーンで K または L を押すと、左足または右足のキックポリシーがトリガーされます。
前後スプリット
以前の片脚バランスポリシーは、より安定した両脚支持モーションに置き換えられました。
O を押して学習済みポリシーを実行すると、左足が前方へ、
右足が後方へ動き、両足は地面に接地したまま、6 秒間のフェーズサイクル後に
ロボットは立位または歩行ポリシーへ戻ります。
含まれているアーティファクトは次のとおりです:
models/checkpoints/rsl_rl/front_back_split/2026-09-09_18-04-10_front_back_split_left_forward/model_999.pt
models/exports/front_back_split/front_back_split_model_999.onnx
PT と ONNX は用途が異なります
.ptチェックポイントには、アクター、クリティック、オプティマイザ、正規化器、および学習状態が含まれます。これらは学習の再開やplay評価に使用します。.onnxには、デプロイ可能な推論グラフが含まれます。公式 ONNX ファイルには PPO 学習状態は含まれておらず、再開可能なチェックポイントへ戻すことはできません。models/checkpoints/配下の PT ファイルは、このデモに同梱されている Jetson 上での歩行学習結果であり、Pollen Robotics による公式 PT リリースではありません。
自分の ONNX をエクスポートする
uv run --no-sync python3 scripts/export.py \
  Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --onnx-file walking_custom.onnx
必ず scripts/export.py を使用してください。プロジェクトのエクスポータは観測正規化器を ONNX グラフに焼き込みますが、これはランタイムで正しく動作させるために必要です。