Seeed reComputer Jetson デバイスに事前ビルド済み DEB パッケージで PREEMPT_RT リアルタイムカーネルをデプロイする
リアルタイムカーネル(PREEMPT_RT カーネルとも呼ばれます)は、リアルタイムスケジューリング機能を強化した Linux カーネルの一種です。スケジューリングレイテンシを低減し、タスク実行の決定性を高めることで、モータ制御、センサーデータ取得、産業用バス通信(CAN、EtherCAT)など、ロボティクス、産業オートメーション、エッジコンピューティングといったシナリオにおけるワークロードにとって重要な役割を果たします。
PREEMPT_RT カーネルをソースからビルドしたい場合は、このWiki を参照してください。本ガイドでは、はるかに簡単な方法を採用します。1つの事前ビルド済み DEB パッケージで約1分でリアルタイムカーネルをインストールし、元の標準カーネルはフォールバックとしてそのまま残し、いつでも2つのカーネルを切り替えられるようにします。
このWikiは、標準カーネルで JetPack 7.2(Jetson Linux R39.2.0)を実行している NVIDIA Orin(T234)モジュール搭載の Seeed reComputer および reServer Jetson デバイスに適用されます。1つの DEB パッケージで、すべての T234 ベースのキャリアボードをカバーします。このWikiは reComputer Super 上でテストおよび検証済みです。
前提条件
- 標準の JetPack 7.2 システムを実行している reComputer Super(または Orin T234 モジュール搭載の他の Seeed reComputer/reServer Jetson デバイス)
- リアルタイムカーネル DEB パッケージ: nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb
- DEB パッケージをデバイスへ転送するためのホスト PC
まだ JetPack 6.2(Jetson Linux R36.4.3)を実行しているデバイスでは、代わりに対応するパッケージ nvidia-l4t-kernel-rt-6.2-36.4.3-2026-08-26.deb を使用してください。このWikiでの手順は同一であり、異なるのはカーネルバージョン文字列(5.15.148-tegra / 5.15.148-rt-tegra)だけです。
デバイスがまだ標準システムを実行していない場合は、まず reComputer Super Getting Started Wiki を参照してください。
標準カーネルのバージョンを確認する
DEB パッケージを使用するには、デバイスがパッケージと一致する標準カーネルバージョンを実行している必要があります。デバイス上でターミナルを開き、次を実行します:
uname -r
次のような出力が表示されるはずです:
6.8.12-1021-tegra
もし出力が別のバージョン(たとえば古い JetPack リリースの 5.15.148-tegra や、リアルタイムカーネルの 6.8.12-1021-rt-tegra)であれば、まず対応する標準システムイメージを書き込み、その後で本ガイドを続行してください。
リアルタイムカーネル DEB パッケージをインストールする
ステップ 1. DEB パッケージをデバイスへ転送します(USB ドライブでも scp でも構いません):
scp nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb <username>@<device-ip>:~
ステップ 2. デバイスにログインし、パッケージをインストールします:
sudo dpkg -i ~/nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb
インストールには約1分かかり、完全に自動で行われます。リアルタイムカーネルイメージを /boot/Image.real-time に配置し、対応するモジュールを /lib/modules/6.8.12-1021-rt-tegra/ にインストールし、initrd を再生成し、デフォルトのブートエントリをリアルタイムカーネルに切り替えます。元の標準カーネル /boot/Image は変更されずに残るため、常にフォールバックとして利用できます。
ステップ 3. デバイスを再起動します:
sudo reboot
リアルタイムカーネルを確認する
再起動後、リアルタイムカーネルが動作していることを確認します:
uname -r
cat /sys/kernel/realtime
zcat /proc/config.gz | grep PREEMPT
次のような出力が表示されるはずです:
6.8.12-1021-rt-tegra
1
CONFIG_PREEMPT_RT=y
このパッケージに含まれるカーネルには、すでに Seeed キャリアボード向けパッチが適用されているため、すべての周辺機器は標準システムとまったく同じように動作するはずです。いくつかをスポットチェックしてみてください:
lsmod | grep nvgpu
ip -br addr
systemctl --failed
systemctl --failed は失敗したサービスがないことを報告するはずです。
リアルタイムカーネルと標準カーネルを切り替える
2つのカーネルはいつでも切り替えることができます。標準カーネルに戻すには:
sudo nv-update-extlinux generic && sudo reboot
再度リアルタイムカーネルへ切り替えるには:
sudo nv-update-extlinux real-time && sudo reboot
ブート中に、ブートメニューで 3 秒以内に 0(標準カーネル)または 1(リアルタイムカーネル)を押すことで、その起動時のみ使用するカーネルを選択できます。この操作ではデフォルトエントリは変更されません。
リアルタイムカーネルをアンインストールする
パッケージをアンインストールする前に、必ずデバイスを標準カーネルに戻しておいてください。
sudo nv-update-extlinux generic && sudo reboot
sudo apt remove nvidia-l4t-kernel-rt
性能比較: リアルタイムカーネル vs 標準カーネル
リアルタイムカーネルが実際に何をもたらすのかを示すために、同一デバイス上で、同一の干渉条件下、かつ CPU を常にフルロードに保った状態で、3つのワークロード(スケジューラレイテンシ(cyclictest)、GPIO 出力ジッタ、EtherCAT サーボモータ制御)について2つのカーネルを比較しました。
以下のすべての結果は、JetPack 7.2 を実行し、CPU をフルロードにした Seeed reComputer Super(Orin Nano Super)上で測定されたものです。
原理
実験では spinlock_holder と呼ばれるカーネルモジュールを使用します。これは、1つの CPU コアに固定されたカーネルスレッドで、spin_lock() を繰り返し取得し、設定された時間だけ保持します。
- 標準カーネルでは、
spin_lock()はカーネルプリエンプションを無効にします。その CPU 上のすべてのタスク — 最も優先度の高いSCHED_FIFOリアルタイムタスクも含めて — はロックが解放されるまで停止します。 - PREEMPT_RT カーネルでは、
spinlock_tは rt_mutex をバックエンドとするスリープ可能なロックに置き換えられるため、より高い優先度のタスクはいつでもロックホルダをプリエンプトできます。
実験で可視化しているのはこの違いです。標準カーネルでは、1秒間のロックはリアルタイムタスクにとって1秒間の停止を意味しますが、リアルタイムカーネルでは同じ干渉はほとんど見えなくなります。
なぜビジーループのユーザプロセスではなくカーネルスレッドなのか?ユーザ空間の負荷は常にスケジューリング可能であり、どちらのカーネルでも SCHED_FIFO タスクの方が優先されるため、興味深い現象は何も起こりません。プリエンプト不可能なカーネルクリティカルセクションだけが、2つのカーネルを分ける要素です。下記の対照群がデータでこれを証明しています。
テスト環境
| 項目 | 値 |
|---|---|
| デバイス | Seeed reComputer Super(Orin Nano Super, 6 コア) |
| システム | JetPack 7.2(Jetson Linux R39.2.0) |
| 標準カーネル | 6.8.12-1021-tegra |
| リアルタイムカーネル | 6.8.12-1021-rt-tegra(DEB パッケージでデプロイ) |
| 干渉 | spinlock_holder カーネルモジュール、CPU3 に固定された kthread |
| ワークロード | cyclictest、GPIO 矩形波(SCHED_FIFO)、IgH EtherCAT master 1 kHz(同一コア上の SCHED_FIFO 89) |
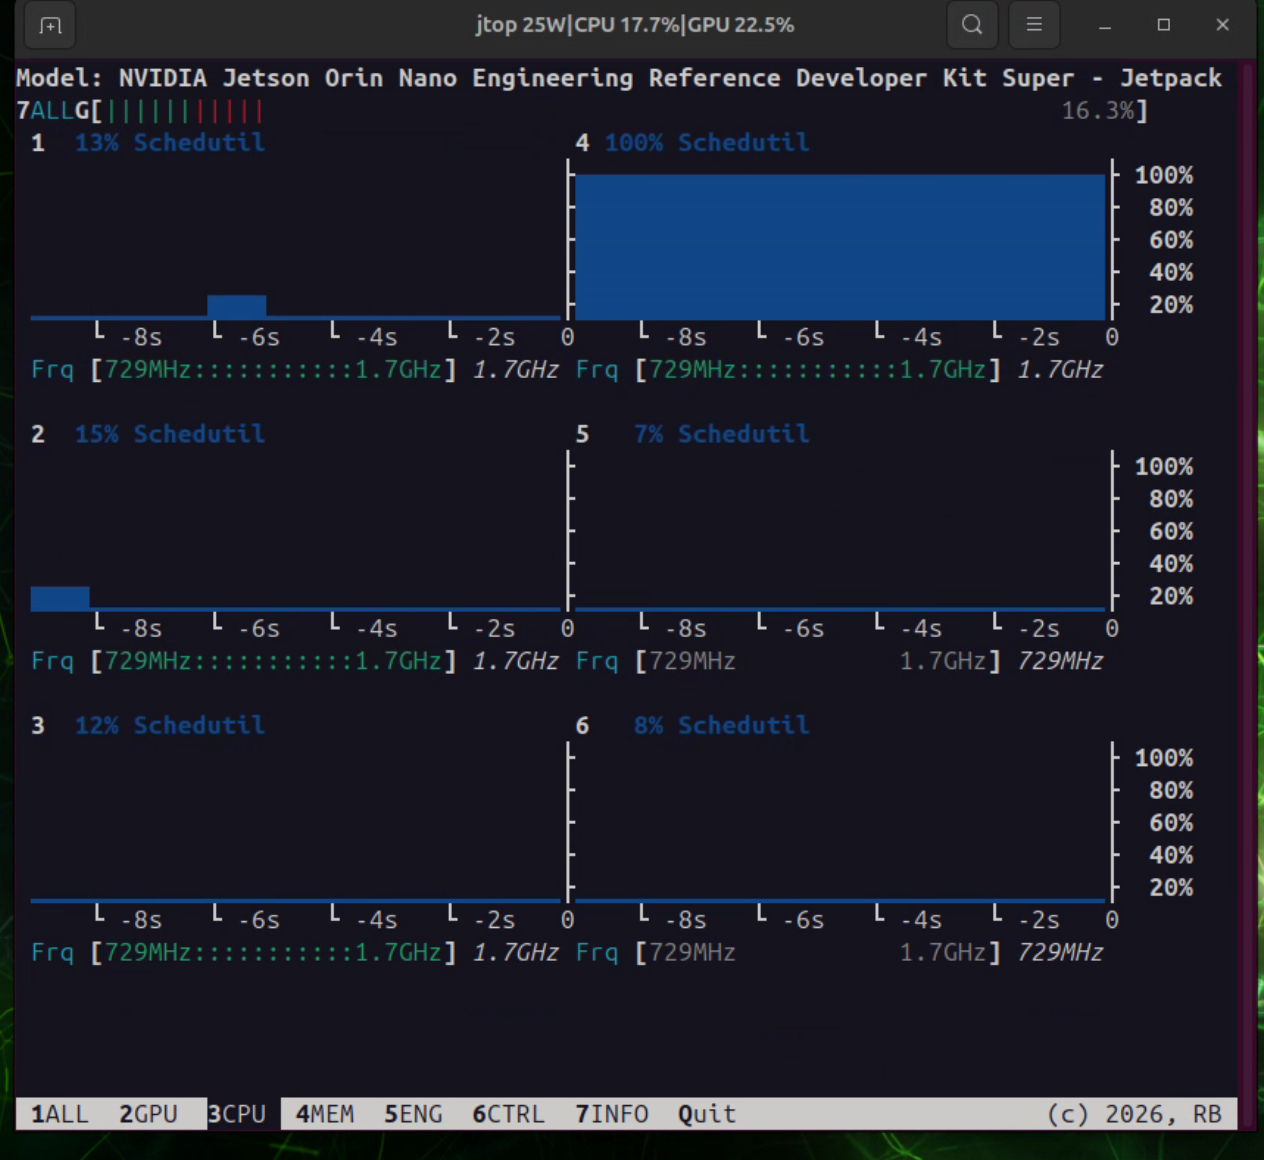
実験中、干渉スレッドは対象コアを jtop 上で常に 100% に張り付ける一方、他のコアはほぼアイドル状態のままです:
Cyclictest レイテンシ
まず rt-tests をインストールします:
sudo apt update && sudo apt install -y rt-tests
1つ目のターミナルでシステム全体にフルロードをかけます:
stress --cpu 6 --io 4 --vm 2 --vm-bytes 64M &
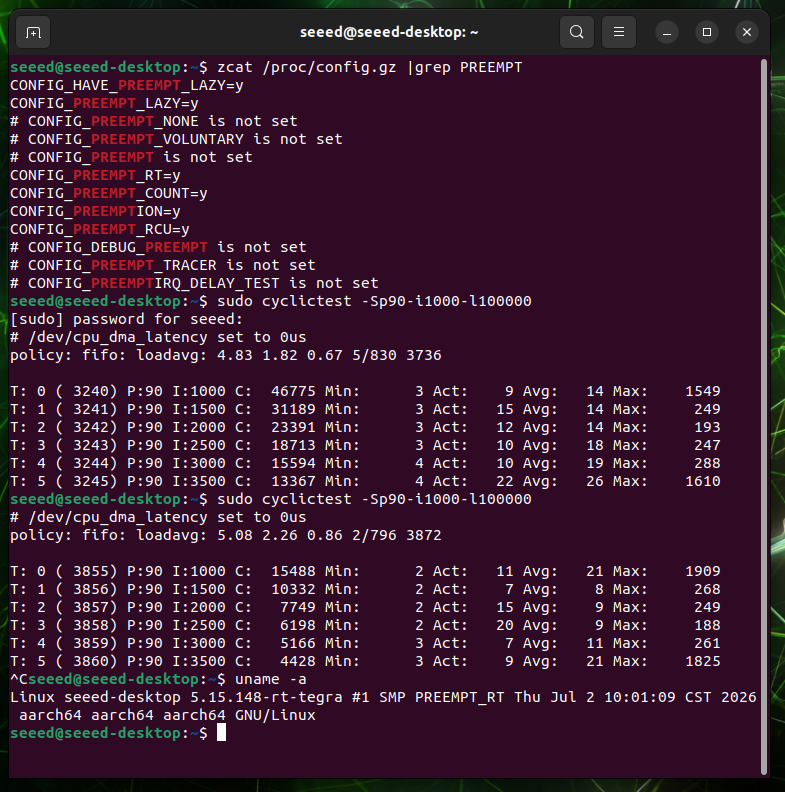
次に2つ目のターミナルで cyclictest を 30 秒間実行します(-S オプションは CPU コアごとに1つの計測スレッドを起動し、スレッドごとに間隔を 500 µs ずつ増加させます):
sudo cyclictest -m -S -p90 -i1000 -D30s
下の画像は標準カーネルでの一例です。各スレッドの平均レイテンシは 8〜21 µs の範囲に収まっており、一見するとリアルタイムカーネルとほとんど変わらないように見えます。しかし最大レイテンシは 1,909 µs までスパイクしており、リアルタイムカーネルの上限値の 60 倍以上 に達し、いつ発生するか予測することはできません:
リアルタイムカーネルには最大レイテンシのハードな上限があります。負荷がどれだけ重くなっても、制御不能に陥ることはありません。この決定性こそが、リアルタイムカーネルの目的です。
GPIO 矩形波ジッタ
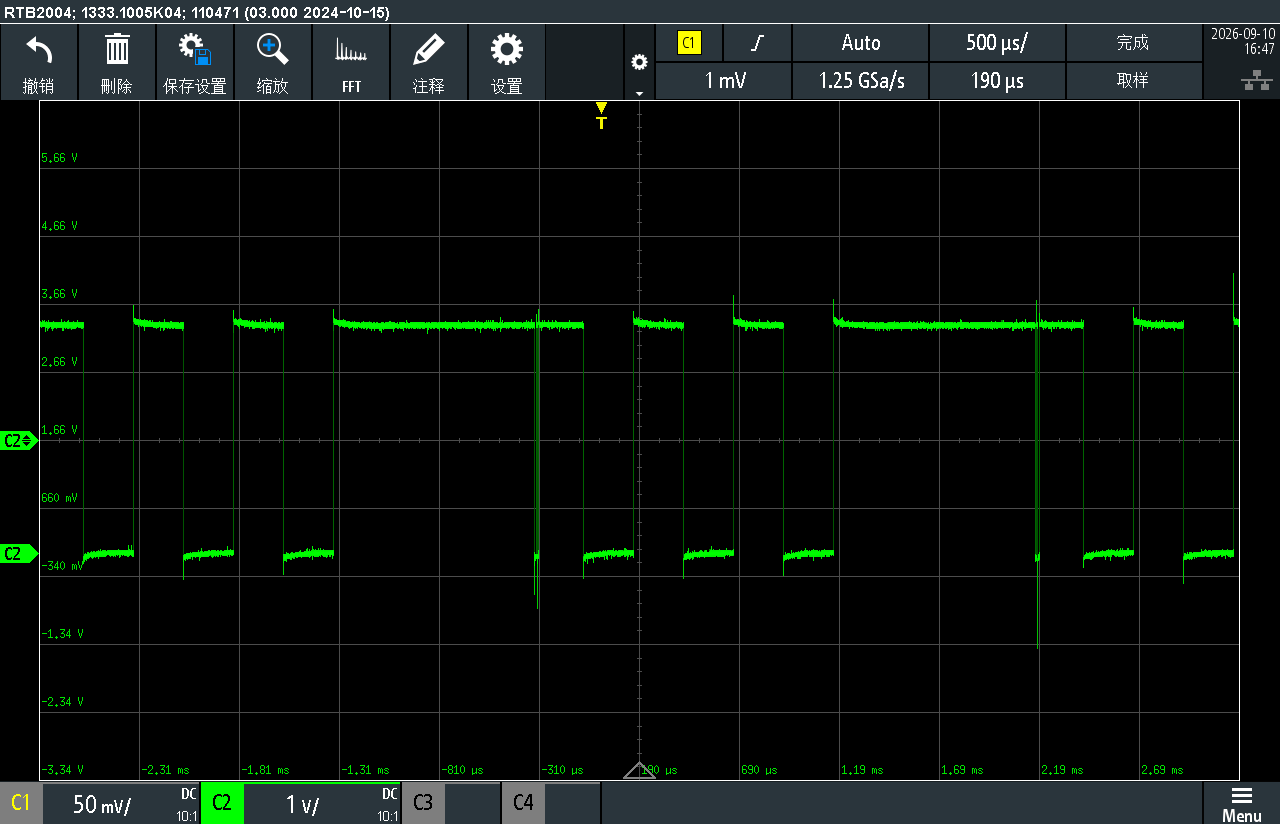
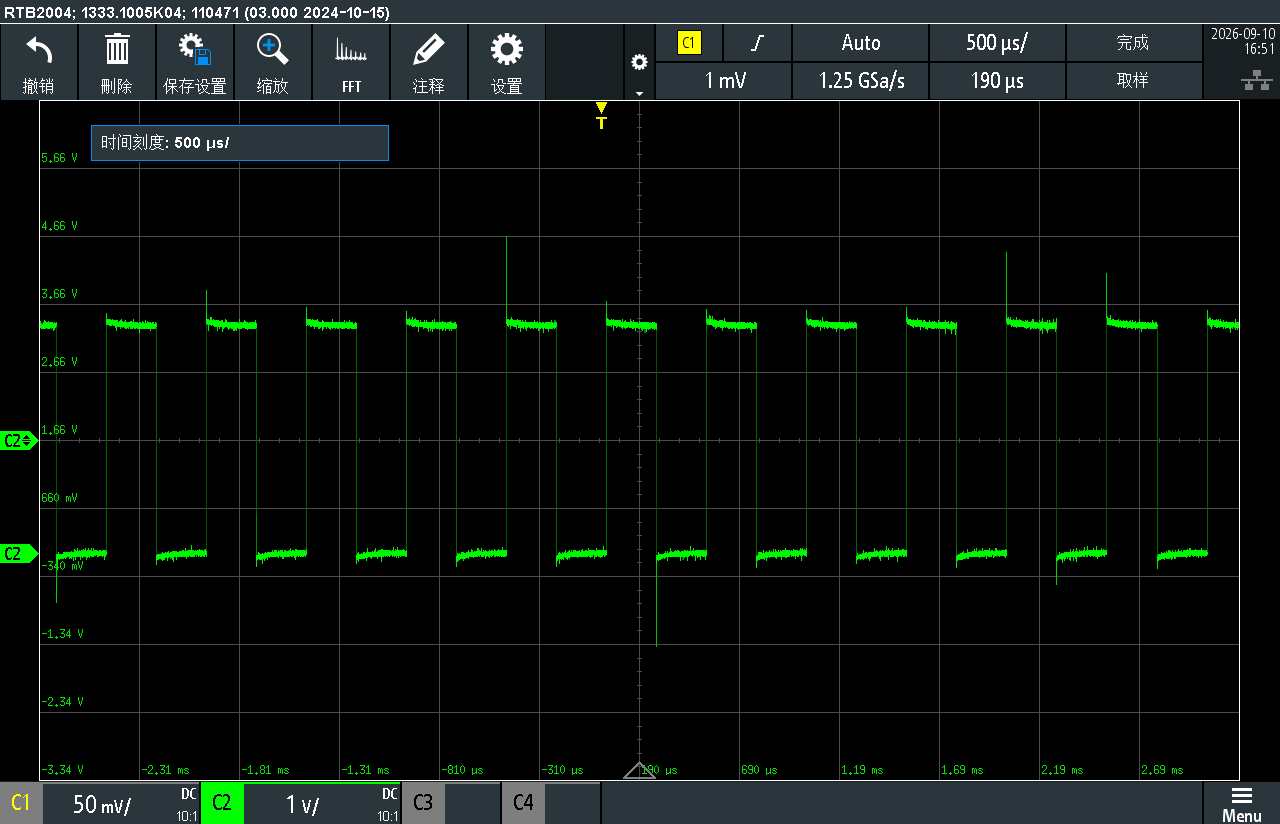
このテストも CPU フルロード下で実行します。カーネルスレッドが周期的に1つの CPU コア上でスピンロックを保持し、同じコア上の SCHED_FIFO タスクが GPIO ピンをトグルして 2 kHz の矩形波を出力します。エッジのタイムスタンプはリングバッファに記録され、終了時にログファイルへ書き出されるため、ログ処理自体がジッタを追加することはありません。エッジ間統計とオシロスコープの波形から、その違いが直接わかります(1 ms ごとに 300 µs ロックを保持):
| ロック保持 / 周期 | 指標 | 標準カーネル | リアルタイムカーネル |
|---|---|---|---|
| 300 µs / 1 ms | p99 / 最大 / σ | 306 / 325~547 / 40 µs | 251 / 257 / 0.56 µs |
| 500 µs / 1 ms | 欠落エッジ / 結合ペア | 25% / 25% | 0 / 0 |
| 500 µs / 1 ms | p99 / 最大 | 506 / 529 µs | 約 251 µs |
標準カーネルでは、スピンロックのウィンドウ内に入ったエッジは遅延したり失われたりするため、波形が目に見えて歪みます。リアルタイムカーネルでは波形はきれいなままです。
標準カーネル — スピンロックが保持されている間、矩形波が歪んだり停止したりします:
リアルタイムカーネル — 連続した矩形波(タイムベース 500 µs/div):
EtherCAT サーボモータ制御
このテストも CPU フルロード下で実行します。すべてのフェーズで対象コアは負荷状態に保たれます。Jetson デバイスは IgH EtherCAT master(1 kHz サイクル、SCHED_FIFO 89)を実行し、EtherCAT サーボモータを駆動します。EtherCAT ドライブには約 100 ms の通信ウォッチドッグがあり、プロセスデータフレームがそれ以上途切れると、ドライブは出力を遮断し、モータは停止します。干渉モジュールはマスタのコア上で 3 秒ごとに 1,000 ms のスピンロックを保持します。そのため、ウォッチドッグを超えるフリーズは標準カーネル上でバスを停止させるはずであり、実際にそうなります。
3 フェーズのデモでは、1 回の実行で全体の流れを確認できます:
| フェーズ | 干渉 | 標準カーネル | リアルタイムカーネル |
|---|---|---|---|
| 1 (10 s) | CPU 負荷のみ | モーターはスムーズに回転 | モーターはスムーズに回転 |
| 2 (15 s) | + spinlock (1,000 ms / 3 s) | CYCLE BROKEN — SAFE STOP、バスが OP からドロップしモーター停止 | モーターは回転を維持、アラームなし |
| 3 (15 s) | spinlock を除去、負荷は継続 | マスターは約 4 s で自己復旧し、モーター再始動 | 変化なし |
同一条件でのコア指標:
| 指標 | 標準カーネル | リアルタイムカーネル |
|---|---|---|
| セーフストップ発動 | 最初のロックウィンドウで発動 | 一度もなし |
| スレーブの OP からのドロップ | 25 s あたり 1~3 回 | 0 回 |
| マスターのウェイクアップ p50 / p99 / 最大 | 7 / 約 994,000 / 約 1,018,000 µs | 2 / 3 / 12 µs |
| 1 ms 超のサイクル数(5,000 あたり) | 約 2,000 | 0 |
| モーター挙動 | ロック中に停止し、解除後約 4 s で復旧 | 連続した正弦波運動 |
ロックが発生したときの標準カーネルの出力(マスターは 1 秒間完全にフリーズし、ロック解除後に復旧):
############ Phase 2: LOADING spinlock interference ############
*** CYCLE BROKEN (frozen >500ms) — SAFE STOP: disabling motor ***
!!! BUS DROPPED: slave left OP (AL 0x08 -> 0x4) — comm watchdog/error !!!
[STAT] cycles=15000 WKC0=2255 late>1ms=2084 drops(total)=1
       wake_us p50/p99/max=7/994615/1018037
############ Phase 3: REMOVING interference ############
+++ cycle restored — re-enabling motor +++
同じ干渉条件下でのリアルタイムカーネルの出力(全実行時間):
[STAT] cycles=5000  WKC0=131  late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/8
[STAT] cycles=10000 WKC0=0    late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/9
[STAT] cycles=15000 WKC0=0    late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/8
Running: Act=41268 Vel=29970 TgtV=29630 md=9 SW=1237
マスターにはサイクル健全性モニタリングが組み込まれており、ウェイクアップ遅延が 500 ms を超えると「フリーズ」と見なして制御されたセーフストップをトリガーします(産業用スタックでは標準的な手法)。モーターはフリーズなしで 4 s 後に再有効化されます。標準カーネルでは干渉が 3 s ごとに戻ってくるため、復旧のための時間窓が開きません。
標準カーネルでは、マスターは丸ごと 1 秒単位でスタールし、これは EtherCAT ドライブのウォッチドッグ(約 100 ms)の 10 倍以上 であるため、バスは OP 状態からドロップしモーターは無効化されます。一方リアルタイムカーネルでは、マスターのウェイクアップジッタは数マイクロ秒以内に収まり、バスもモーターも干渉の影響を受けません。
リアルタイムカーネルでは、EtherCAT サーボモーターは 30 秒間スムーズに回転します:
標準カーネルでは、ロックが保持されている間モーターは停止します(10 s 回転、15 s 停止、15 s 回転):
対照群:CPU 負荷が犯人ではない
ダメージが CPU 使用率ではなく、プリエンプト不可なクリティカルセクションから来ていることを証明するために、同じコアに対して spinlock モジュールの代わりに通常の SCHED_OTHER ユーザープロセス(1 s ビジー / 2 s アイドル、ピーク 100%)で負荷をかけました — 同じコア、同じリズムです:
| 指標 | 標準 + CPU 負荷 | リアルタイム + CPU 負荷 | 標準 + spinlock |
|---|---|---|---|
| モーター | 回転 | 回転 | 停止 |
| バスドロップ / セーフストップ | 0 / 0 | 0 / 0 | 1~3 / 発動 |
| wake p99 | 最大 1,879 µs | 11 µs | 約 994,000 µs |
| wake 最大 | 約 8,200 µs | 32 µs | 約 1,018,000 µs |
| 1 ms 超のサイクル数(5,000 あたり) | 28~56 | 0 | 約 2,000 |
ユーザ空間の負荷は、どちらのカーネルでも SCHED_FIFO タスクより優先されることはないため、両方の列でモーターは回り続けます — しかし標準カーネルは依然としてミリ秒スケールのジッタに引きずり込まれます(p99 はリアルタイムカーネルよりおよそ 170 倍 悪化)。カーネルの spinlock こそが、ジッタを 1 秒規模の停止に変えてしまう要因です。犯人は CPU 使用率ではなく、プリエンプト不可なカーネルクリティカルセクションです。
実験を再現する
GPIO 実験の完全なソースコード(干渉モジュール、矩形波タスク、Makefile)は以下に埋め込まれており、そのまま利用できます。EtherCAT デモはオープンソースの ethercat-myctor プロジェクト上に、カスタマイズしたデバイスコントローラを用いて構築されています。完全なデモパッケージ(コントローラのオーバーライド、実行スクリプト、CPU 負荷ジェネレータ)はここから入手できます: rt_ethercat_demo.zip。
2 つのカーネル間の切り替え方法は Switch Between the Real-Time and Standard Kernels に記載されています。切り替えのたびに uname -v で確認してください — 出力にはそれぞれ SMP PREEMPT_RT または SMP PREEMPT が含まれている必要があります。
リアルタイムカーネルのソースツリーを準備する(1 回のみ)
リアルタイム DEB パッケージにはカーネルイメージとモジュールは含まれますが、ヘッダーパッケージは含まれません。カーネルモジュールは、リアルタイムカーネルが動作している状態で準備されたソースツリーに対してビルドする必要があります。そうでない場合、insmod は module_layout disagrees というエラーで失敗します。
curl -sL -o ~/public_sources.tbz2 \
  https://developer.download.nvidia.cn/embedded/L4T/r39_Release_v2.0/sources/public_sources.tbz2
mkdir -p ~/nvsrc ~/rt-kernel-src
tar xf ~/public_sources.tbz2 -C ~/nvsrc Linux_for_Tegra/source/kernel_src.tbz2
tar xf ~/nvsrc/Linux_for_Tegra/source/kernel_src.tbz2 -C ~/rt-kernel-src --strip-components=1

cd ~/rt-kernel-src/kernel-noble
zcat /proc/config.gz > .config
sed -i 's/^CONFIG_LOCALVERSION=".*"/CONFIG_LOCALVERSION="-1021-rt-tegra"/' .config
make ARCH=arm64 olddefconfig
make ARCH=arm64 -j6 prepare modules_prepare
CONFIG_LOCALVERSION は uname -r の 6.8.12 以降のサフィックス(ここでは -1021-rt-tegra)と一致している必要があります。そうでないとモジュールの vermagic が一致しません。標準カーネルの場合は -1021-tegra を使用し、同じ手順でツリーを準備します。
デモソースコード(GPIO 実験)
作業ディレクトリを作成し、次の 3 つのファイルを配置します:
mkdir -p ~/rt_demo && cd ~/rt_demo
spinlock_holder.c — 干渉モジュール:
// spinlock_holder: PREEMPT_RT demo module (ms and us granularity)
//
// One-shot mode (period = 0): sysfs trigger makes the bound kthread hold a
// spinlock for the configured hold time, once. On a normal kernel
// spin_lock() disables preemption so every task on that CPU freezes for
// the duration; on PREEMPT_RT spinlock_t is a sleepable rt_mutex-backed
// lock and higher priority tasks preempt the holder instead.
//
// Periodic mode (period > 0): the kthread repeats hold/idle cycles.
// Writing any *_us parameter (or period) via sysfs wakes the kthread so
// changes take effect immediately.
#include <linux/module.h>
#include <linux/kernel.h>
#include <linux/slab.h>
#include <linux/kthread.h>
#include <linux/delay.h>
#include <linux/spinlock.h>
#include <linux/wait.h>
#include <linux/sysfs.h>
#include <linux/kobject.h>
#include <linux/sched.h>
#include <linux/ktime.h>

static int demo_cpu = 3;
module_param(demo_cpu, int, 0644);
MODULE_PARM_DESC(demo_cpu, "CPU to bind the holder kthread to (default 3)");

static int hold_ms = 3000;
module_param(hold_ms, int, 0644);
MODULE_PARM_DESC(hold_ms, "critical section length in ms (one-shot default 3000)");

static int period_ms = 0;
MODULE_PARM_DESC(period_ms, "0 = one-shot trigger; >0 = repeat every period_ms (ms mode)");

static int idle_ms = 400;
module_param(idle_ms, int, 0644);
MODULE_PARM_DESC(idle_ms, "ms mode: ms to idle between critical sections");

static int hold_us = 500;
MODULE_PARM_DESC(hold_us, "us mode: critical section length in us");

static int period_us = 1000;
MODULE_PARM_DESC(period_us, "us mode: full period in us (hold_us + idle). >0 selects us mode");

static int idle_us = 700;
module_param(idle_us, int, 0644);
MODULE_PARM_DESC(idle_us, "us mode: idle part of the period in us");

static DEFINE_SPINLOCK(test_lock);
static DECLARE_WAIT_QUEUE_HEAD(trigger_wq);
static atomic_t triggered = ATOMIC_INIT(0);

static struct task_struct *holder_task;
static u64 hold_count;

static void spin_for_ns(u64 ns)
{
	u64 end = ktime_get_ns() + ns;
	while (ktime_get_ns() < end)
		cpu_relax();
}

static void spin_for_ns_periodic(u64 ns)
{
	if (ns > (u64)50 * 1000)         /* > 50 us left: udelay in chunks */
		udelay(ns / 1000);
	else if (ns > 0)
		spin_for_ns(ns);
}

static void run_critical_section_us(void)
{
	u64 t0_ns = ktime_get_ns();
	u64 t1_ns;

	spin_lock(&test_lock);
	spin_for_ns((u64)hold_us * 1000);
	spin_unlock(&test_lock);

	t1_ns = ktime_get_ns();
	hold_count++;

	/* log only every 2000 holds to keep dmesg quiet at kHz rates */
	if (hold_count % 2000 == 1)
		pr_info("spinlock_holder: cpu %d hold #%llu wall %llu us (%s)\n",
			smp_processor_id(), hold_count,
			div_u64(t1_ns - t0_ns, 1000),
			(t1_ns - t0_ns) > (u64)hold_us * 1200
				? "stretched by preemption" : "clean");
}

static void run_critical_section_ms(void)
{
	u64 t0_ns = ktime_get_ns();
	u64 t1_ns;

	spin_lock(&test_lock);
	mdelay(hold_ms);
	spin_unlock(&test_lock);

	t1_ns = ktime_get_ns();
	hold_count++;

	pr_info("spinlock_holder: cpu %d hold #%llu wall %llu ms (%s)\n",
		smp_processor_id(), hold_count,
		div_u64(t1_ns - t0_ns, 1000000),
		(t1_ns - t0_ns) > (u64)hold_ms * 1200000 / 1000
			? "stretched by preemption" : "clean");
}

static int holder_fn(void *unused)
{
	while (!kthread_should_stop()) {
		if (period_us > 0) {
			u64 cycle_start = ktime_get_ns();
			s64 spent_ns;

			run_critical_section_us();
			/* busy-wait the remainder of the period for exact rate.
			 * s64: if hold overran the period, remainder clamps to 0
			 * instead of wrapping to ~2^64 ns (which would udelay forever). */
			spent_ns = (s64)(ktime_get_ns() - cycle_start);
			if (spent_ns < (s64)period_us * 1000)
				spin_for_ns_periodic((u64)period_us * 1000 - (u64)spent_ns);
		} else if (period_ms > 0) {
			run_critical_section_ms();
			msleep(max(idle_ms, 1));
		} else {
			wait_event_interruptible(trigger_wq,
						 atomic_read(&triggered) || kthread_should_stop());
			if (kthread_should_stop())
				break;
			if (atomic_read(&triggered)) {
				run_critical_section_ms();
				atomic_set(&triggered, 0);
			}
		}
	}
	return 0;
}

static int wake_holder(const char *val, const struct kernel_param *kp)
{
	int ret = param_set_int(val, kp);
	if (ret)
		return ret;
	atomic_set(&triggered, 1);
	wake_up(&trigger_wq);
	if (holder_task)
		wake_up_process(holder_task);
	return 0;
}

static const struct kernel_param_ops wake_ops = { .set = wake_holder, .get = param_get_int };
module_param_cb(period_ms, &wake_ops, &period_ms, 0644);
module_param_cb(period_us, &wake_ops, &period_us, 0644);
module_param_cb(hold_us, &wake_ops, &hold_us, 0644);

static ssize_t trigger_store(struct kobject *kobj, struct kobj_attribute *attr,
			     const char *buf, size_t count)
{
	if (period_us > 0 || period_ms > 0)
		return -EBUSY;
	atomic_set(&triggered, 1);
	wake_up(&trigger_wq);
	return count;
}

static struct kobj_attribute trigger_attribute =
	__ATTR(trigger, 0220, NULL, trigger_store);

static struct kobject *demo_kobj;

static int __init spinlock_holder_init(void)
{
	struct task_struct *t;
	int ret;

	/* create parked, bind while parked, then start — kthread_run()+bind()
	 * races and the bind gets rejected with a WARNING in dmesg */
	t = kthread_create(holder_fn, NULL, "spinlock_holder");
	if (IS_ERR(t))
		return PTR_ERR(t);
	kthread_bind(t, demo_cpu);
	wake_up_process(t);
	holder_task = t;

	demo_kobj = kobject_create_and_add("spinlock_holder", kernel_kobj);
	if (!demo_kobj) {
		kthread_stop(t);
		return -ENOMEM;
	}

	ret = sysfs_create_file(demo_kobj, &trigger_attribute.attr);
	if (ret) {
		kobject_put(demo_kobj);
		kthread_stop(t);
		return ret;
	}

	pr_info("spinlock_holder: loaded, cpu %d, us-mode: hold %d us / period %d us%s\n",
		demo_cpu, hold_us, period_us,
		period_us > 0 ? " [ACTIVE]" : " (inactive; set period_us>0)");
	return 0;
}

static void __exit spinlock_holder_exit(void)
{
	kthread_stop(holder_task);
	kobject_put(demo_kobj);
	pr_info("spinlock_holder: unloaded after %llu holds\n", hold_count);
}

module_init(spinlock_holder_init);
module_exit(spinlock_holder_exit);

MODULE_LICENSE("GPL");
MODULE_DESCRIPTION("PREEMPT_RT demo: spinlock critical section vs schedulable tasks (ms/us modes)");
gpio_pwm.c — SCHED_FIFO の矩形波タスク(sudo apt install -y libgpiod-dev が必要):
// gpio_pwm: toggle a GPIO line every half-period from a SCHED_FIFO task.
// Half period is configurable in microseconds (default 500000 = 1s square
// wave). Edges are timestamped (CLOCK_MONOTONIC) into a ring buffer and
// flushed to edges.log so logging itself never adds jitter.
#define _GNU_SOURCE
#define _DEFAULT_SOURCE
#include <gpiod.h>
#include <sys/mman.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <time.h>
#include <sched.h>
#include <unistd.h>
#include <errno.h>
#include <signal.h>

#define CHIP    "gpiochip0"
#define LINE    41
#define NBUF    (1 << 20)                      /* 1M edges ring buffer */

static volatile sig_atomic_t stop = 0;
static void on_sigint(int s) { (void)s; stop = 1; }

static double now_sec(void)
{
	struct timespec ts;
	clock_gettime(CLOCK_MONOTONIC, &ts);
	return ts.tv_sec + ts.tv_nsec / 1e9;
}

struct edge { int level; double t; };
static struct edge ring[NBUF];
static size_t nring;

int main(int argc, char **argv)
{
	int cpu = argc > 1 ? atoi(argv[1]) : 3;
	long half_us = argc > 2 ? atol(argv[2]) : 500000;
	struct gpiod_chip *chip;
	struct gpiod_line *line;
	struct sched_param sp = { .sched_priority = 80 };
	cpu_set_t set;
	FILE *log;
	double t0, target;
	int level = 0;
	struct sigaction sa = { .sa_handler = on_sigint };
	struct timespec req;

	sigaction(SIGINT, &sa, NULL);

	CPU_ZERO(&set);
	CPU_SET(cpu, &set);
	if (sched_setaffinity(0, sizeof(set), &set)) { perror("setaffinity"); return 1; }
	if (sched_setscheduler(0, SCHED_FIFO, &sp)) { perror("SCHED_FIFO (run as root)"); }
	mlockall(MCL_CURRENT | MCL_FUTURE);

	chip = gpiod_chip_open_by_name(CHIP);
	if (!chip) { perror("gpiod_chip_open"); return 1; }
	line = gpiod_chip_get_line(chip, LINE);
	if (!line) { perror("gpiod_chip_get_line"); return 1; }
	if (gpiod_line_request_output(line, "gpio_pwm", 0)) { perror("request_output"); return 1; }

	fprintf(stderr, "gpio_pwm: toggling %s line %d every %ld us on cpu %d (fifo %d). Ctrl-C to stop.\n",
		CHIP, LINE, half_us, cpu, sp.sched_priority);

	t0 = now_sec();
	target = t0;

	while (!stop) {
		level = !level;
		gpiod_line_set_value(line, level);

		if (nring < NBUF) {
			ring[nring].level = level;
			ring[nring].t = now_sec() - t0;
			nring++;
		} else {
			fprintf(stderr, "ring full, stopping\n");
			break;
		}

		target += half_us / 1e6;
		req.tv_sec = (time_t)target;
		req.tv_nsec = (long)((target - (time_t)target) * 1e9);
		clock_nanosleep(CLOCK_MONOTONIC, TIMER_ABSTIME, &req, NULL);
	}

	gpiod_line_release(line);
	gpiod_chip_close(chip);

	log = fopen("edges.log", "w");
	if (!log) { perror("fopen edges.log"); return 1; }
	for (size_t i = 0; i < nring; i++)
		fprintf(log, "%d %.6f\n", ring[i].level, ring[i].t);
	fclose(log);
	fprintf(stderr, "gpio_pwm: stopped, %zu edges written to edges.log\n", nring);
	return 0;
}
Makefile:
# Normal kernel:            make
# RT kernel (JP7.2, no headers pkg): make KDIR=~/rt-kernel-src/kernel-noble
obj-m += spinlock_holder.o

KDIR ?= /lib/modules/$(shell uname -r)/build

all: spinlock_holder.ko gpio_pwm

spinlock_holder.ko:
	KBUILD_MODPOST_WARN=1 $(MAKE) -C $(KDIR) M=$(CURDIR) modules

gpio_pwm: gpio_pwm.c
	$(CC) -O2 -Wall -o $@ $< $(shell pkg-config --cflags --libs libgpiod)

clean:
	$(MAKE) -C $(KDIR) M=$(CURDIR) clean
	rm -f gpio_pwm

.PHONY: all clean
別の GPIO ピンを使うには、gpio_pwm.c 内の CHIP / LINE マクロを変更してください。キャリアボード上で利用可能なラインは gpioinfo gpiochip0 で一覧表示し、40 ピンヘッダ上の未使用で出力可能なラインを選択します。
両方のカーネル向けに干渉モジュールをビルドする
# Standard kernel
make
# Real-time kernel
KBUILD_MODPOST_WARN=1 make KDIR=~/rt-kernel-src/kernel-noble
リアルタイムビルドには KBUILD_MODPOST_WARN=1 が必要です:modules_prepare だけを実行したツリーには Module.symvers が存在しないため、modpost はすべてのカーネルシンボルを未定義として報告します — これはすべて誤検出です。
デモを実行する
GPIO デモ(GPIO ピンにオシロスコープを接続)、CPU 負荷最大時:
stress --cpu 6 --io 4 --vm 2 --vm-bytes 64M &
sudo insmod spinlock_holder.ko demo_cpu=3 hold_us=300 period_us=1000
sudo ./gpio_pwm 3 250
EtherCAT デモ(3 フェーズ:負荷のみ、負荷 + スピンロック、負荷のみ):
sudo ./run_demo.sh 10 15 15
このスクリプトは EtherCAT マスタを起動し、バスを待ち、CPU 負荷を開始し、スケジュールに従ってスピンロックモジュールをロードおよび削除します(カーネルバージョンに応じて正しい .ko を選択)、最後にクリーンアップを行います。
既知の落とし穴
| 症状 | 原因 | 対処 |
|---|---|---|
パラメータ変更後に insmod: File exists | モジュールパラメータは最初のロード時にしか適用されない | /sys/module/spinlock_holder/parameters/ 経由で変更するか、rmmod してから再度 insmod する |
| 干渉がロードされているように見えるが波形がきれい | ホルダスレッドがエラーなしで停止した(「偽の実行」) | dmesg 内の hold # カウンタが進み続けているか確認し、進んでいなければ rmmod して再ロードする |
insmod: Invalid module format | 別のカーネル向けにビルドされたモジュール | 実行中のカーネルツリーに対して再ビルドする |
modpost: "kfree" ... undefined | 準備済みツリーに Module.symvers がない | KBUILD_MODPOST_WARN=1 を付けてビルドする |
openssl/opensslv.h: No such file | libssl-dev が不足している | sudo apt install libssl-dev |
EtherCAT ポートが Link: DOWN と表示される | ポートが NetworkManager によってつかまれている | sudo nmcli dev set <interface> managed no |
| ウォッチドッグが何度も動作した後、アクチュエータが起動を拒否する | 多数のバスドロップ後のドライブファームウェアのラッチアップ | アクチュエータの電源を入れ直す |
| デモスクリプトを中断した後にすべてが壊れる | スピンロックモジュールがロードされたままになっている | sudo rmmod spinlock_holder を実行し、必要であればアクチュエータの電源を入れ直す |
結論
標準カーネルでは、1 秒間保持されたカーネルスピンロックは、その CPU 上のすべてのタスクを 1 秒間フリーズさせます — 最優先の SCHED_FIFO EtherCAT マスタも含めてです。1 秒間のフレームロスはドライブウォッチドッグの 10 倍に相当するため、バスは OP からドロップしモータは停止し、干渉が繰り返されると復旧が妨げられます。PREEMPT_RT カーネルでは、同じ干渉によるリアルタイムタスクへのコストは数マイクロ秒台です。ハードリアルタイムのフィールドバスにおいて、リアルタイムカーネルは「より高速」なのではなく、カーネル内部の活動によって飢餓状態にされないという性質を持っています。この性質は、標準カーネルではどれだけチューニングしても保証できません。
参考文献
- https://wiki.seeedstudio.com/ja/flash_preempt_rt_kernel_on_recomputer_jetson_jetpack_6_2_1/
- https://gitlab.com/etherlab.org/ethercat
技術サポート & 製品ディスカッション
弊社製品をお選びいただきありがとうございます。私たちは、製品をできるだけスムーズにご利用いただけるよう、さまざまなサポートを提供しています。お好みやニーズに応じて選べる、複数のコミュニケーションチャネルをご用意しています。