JetPack 7.2 メモリ最適化
Jetson はユニファイドメモリを使用しているため、OS、GPU ワークロード、カメラおよびディスプレイのファームウェア、モデルの重み、TensorRT エンジン、KV キャッシュ、アプリケーションサービスが、同じ物理 DRAM を取り合います。したがってメモリ最適化は、プラットフォームと推論ワークロードの両方を対象にする必要があります。
このガイドは、このコレクション内で既に公開されている JetPack 7.2 関連資料を統合したものです:
- JetPack 7.2 Deep Dive(27B モデルをロードした後のメモリ削減量の実測値を含む)
- デバイス診断、メモリアudit、ヘッドレスデプロイのための NVIDIA Skills ワークフロー
- JetPack 7.2 上で FP16、INT8、INT4 推論を行うための TensorRT Edge-LLM ガイド
BSP レベルのメモリ回収は、ブートファームウェア、デバイスツリー、カーネルコマンドライン設定を変更します。検証済みの headless、no-camera、または SWIOTLB レシピのみを、リカバリ可能なテストデバイスに適用してください。元の BSP を保持し、これらの変更を行う前にデバイスを再フラッシュできることを確認してください。
これらの手順の「なぜ」を知りたい場合は、対応する JetPack 7.2 Memory Optimization Deep Dive を参照してください。そこでは、JetPack 6.2 と比較したプラットフォームのベースライン、LLM のメモリ予算、ランタイムの仕組み、フィールドでの観測結果など、どこからヘッドルームが生まれるのかを説明しています。
最適化レイヤー
問題を解決できる中で、最も侵襲性の低いレイヤーを使用してください。
| レイヤー | 典型的な操作 | リスク | 再起動または再フラッシュ |
|---|---|---|---|
| 計測 | 利用可能メモリとプロセスごとの使用量を記録 | 低 | 不要 |
| 推論設定 | 量子化、短いコンテキスト、バッチサイズ 1、低い同時実行数 | 低 | 不要 |
| サービス設定 | ヘッドレスターゲット、重複したモデルサーバーの停止、未使用ユーザーサービスの無効化 | 中 | 通常は再起動 |
| BSP メモリ回収 | 未使用のディスプレイまたはカメラのファームウェアと予約メモリを無効化 | 高 | 再ビルドと再フラッシュ |
| SWIOTLB チューニング | 実際の使用量を計測したうえで DMA バウンスプールを削減 | 高 | 再ビルドと再フラッシュ |
1. 再現可能なベースラインを記録する
アプリケーションを開始する前に、ソフトウェアリリースを確認しメモリを取得します:
cat /etc/nv_tegra_release
free -h
grep -E 'MemTotal|MemAvailable|SwapTotal|SwapFree|CmaTotal|CmaFree' /proc/meminfo
モデルのロードおよび実行中に、ユニファイドメモリ、GPU 使用率、温度、電力を監視します:
sudo tegrastats --interval 1000
別のターミナルで、最大のプロセスとコントロールグループを特定します:
ps -eo pid,comm,rss,vsz,%mem --sort=-rss | head -20
systemd-cgtop
少なくとも次の 4 つの状態を記録します:
- ブート後でアプリケーション開始前
- モデルまたは TensorRT エンジンのロード後
- プロンプトのプリフィル中、またはピーク時のビジョン前処理中
- 定常状態のトークン生成中、またはアプリケーション動作中
free の used 値だけを比較しないでください。MemAvailable、プロセスの RSS リスト、tegrastats が報告するピーク値を組み合わせて使用します。
2. BSP を編集する前に Skills で監査する
スキル駆動のワークフローは、すぐに設定変更を行うのではなく、まず観察から始めるべきです。
デバイスを診断する
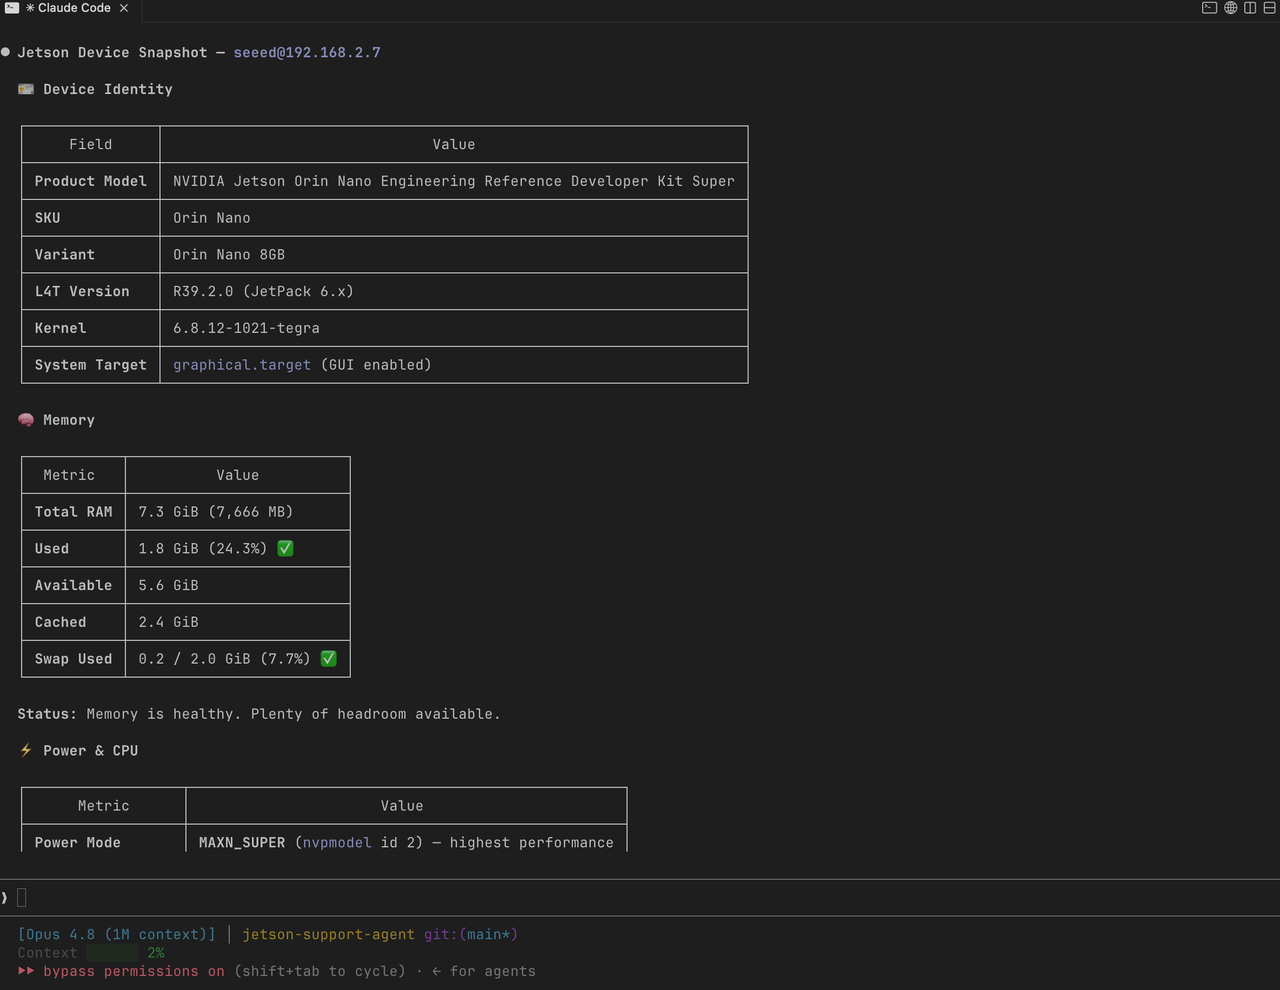
jetson-diagnostic を使用して、モジュール、JetPack/L4T リリース、メモリ状態、ストレージ、熱状態、サービス、および可視なハードウェアエンドポイントを収集します。
プロンプト例:
/jetson-diagnostic Confirm that this device is running JetPack 7.2 / L4T 39.2,
capture its idle memory baseline, and identify services or hardware subsystems
that consume memory before the inference application starts.
メモリプレッシャーを監査する
モデルのロードに失敗した場合、OOM キラーがプロセスを終了した場合、またはメモリ使用量が予期せず増加した場合は、jetson-memory-audit を使用します。
/jetson-memory-audit Compare idle, engine-load, prefill, and decode memory use.
Separate model weights, KV cache, application processes, filesystem cache,
desktop services, and reserved platform memory where possible.
監査は、変更を推奨する前に証拠を提示する必要があります。プロセスリストの上位にあるという理由だけでサービスを無効化しないでください。
アプライアンスデプロイをヘッドレスモードに変換する
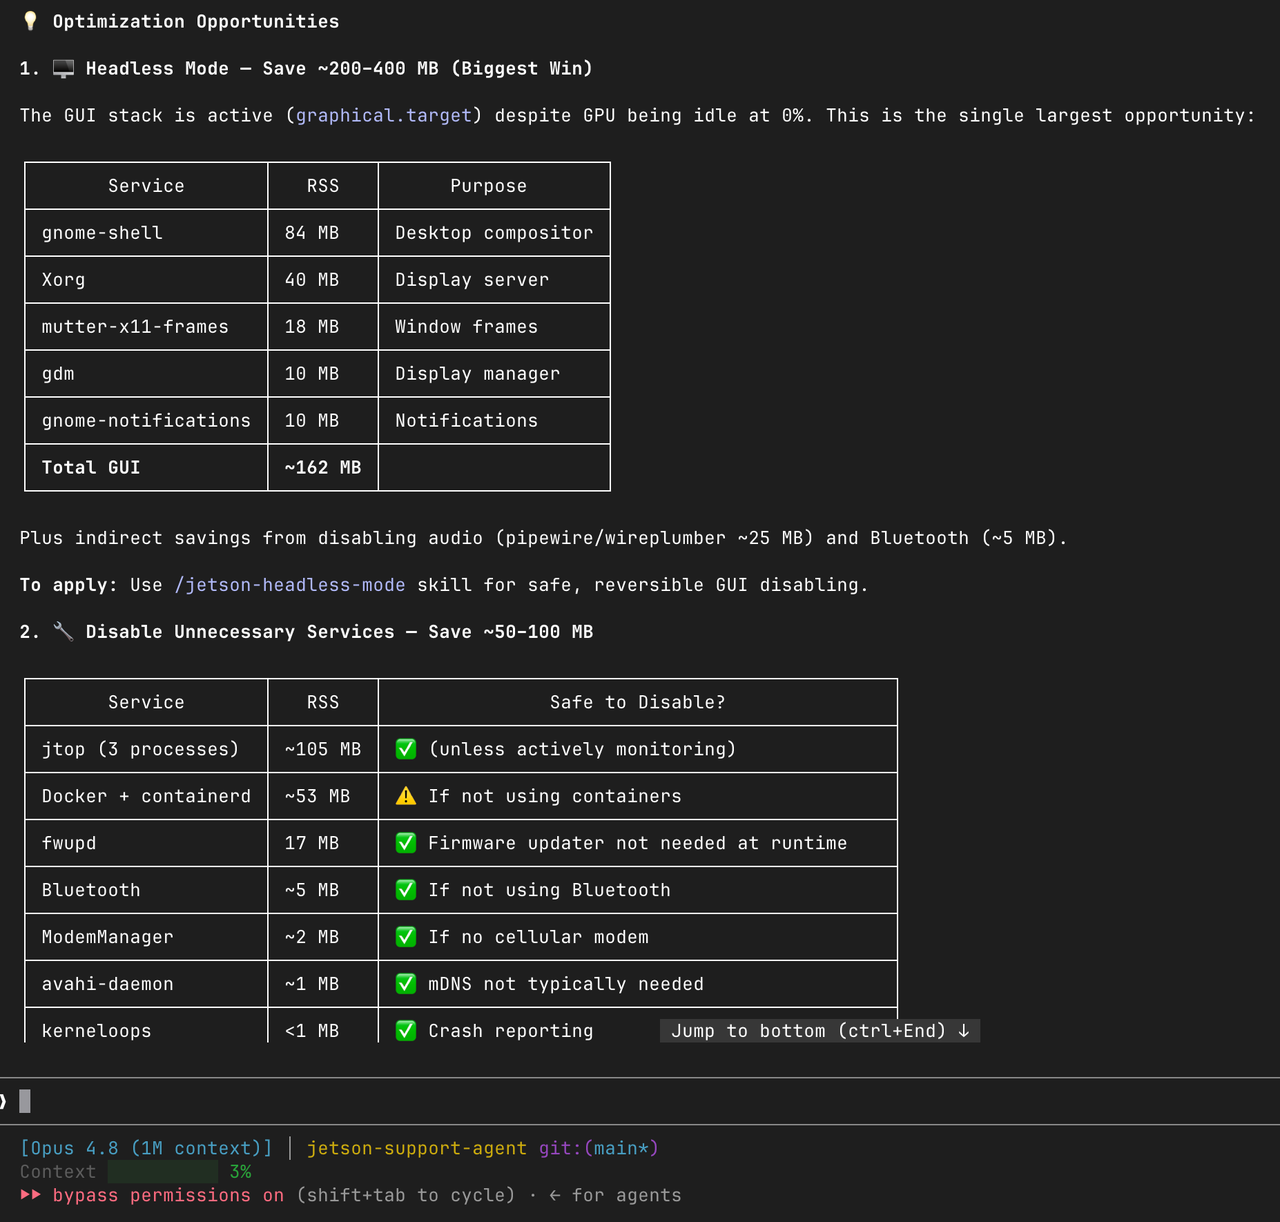
Jetson がローカルディスプレイなしで動作している場合は、jetson-headless-mode を使用して、サービスレベルでデスクトップのオーバーヘッドを削減します。
標準の systemd ターゲットは次のとおりです:
sudo systemctl set-default multi-user.target
sudo reboot
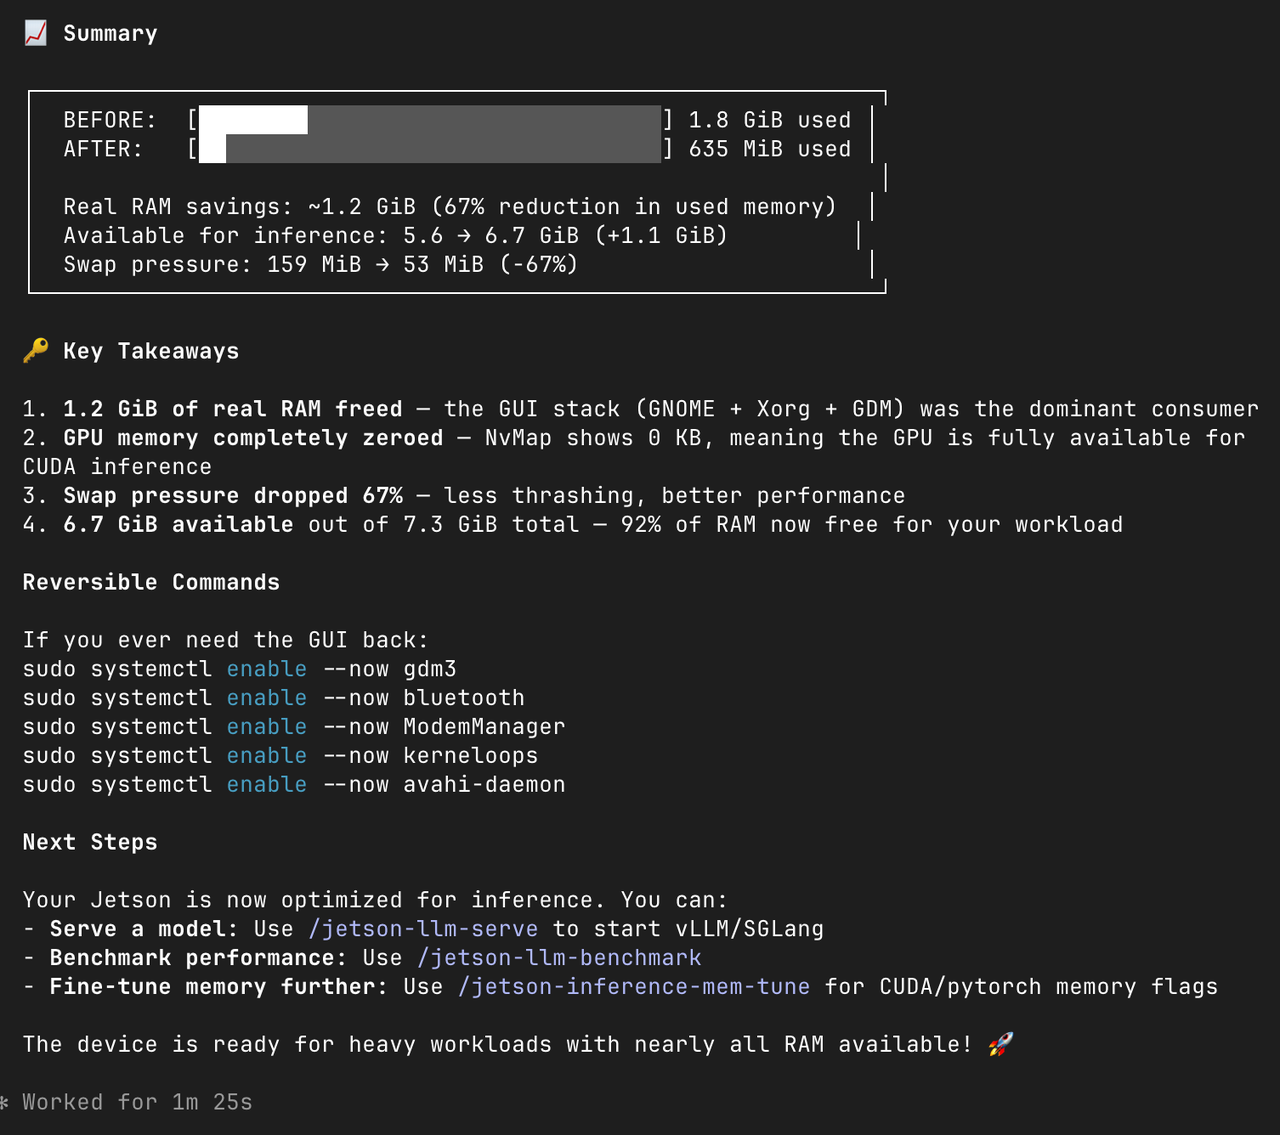
再起動する前に SSH アクセスを確認してください。このサービスレベルの変更は、BSP 内でディスプレイファームウェアの carveout を回収することとは別物です。
jetson-optimize-memory は検証済み BSP シナリオにのみ使用する
BSP レベルのスキルは、次の 3 つの限定されたワークフローをサポートします:
| シナリオ | 想定されるデプロイ | 回収されるプラットフォーム領域 |
|---|---|---|
headless | ローカルディスプレイ出力なし | DCE/ディスプレイファームウェア、初期フレームバッファ、および対応するカーネルノード |
no-camera | CSI、GMSL、その他のカメラパイプラインなし | RCE、VI、ISP、NVCSI、および対応するファームウェア carveout |
swiotlb | 測定された DMA バウンスプール使用量が予約プールを大きく下回る | より小さい非ゼロの SWIOTLB 割り当て |
リクエスト例:
/jetson-optimize-memory headless
/jetson-optimize-memory no-camera
/jetson-optimize-memory swiotlb
carveout を変更する場合、MB1 BCT、MB2 ローディング制御、MB2 AST 参照、およびカーネルデバイスツリーノードの整合性を保つ必要があります。1 つの carveout エントリだけをゼロにするのは有効な最適化ではありません。SWIOTLB については、プールサイズをゼロに設定してはならず、io_tlb_used が io_tlb_nslabs に近づいた場合は直ちに元に戻してください。
3. LLM と VLM のメモリ使用量を削減する
サポートされる中で最小の精度を選ぶ
JetPack 7.2 上の TensorRT Edge-LLM は、Jetson Orin で FP16、INT8、INT4 をサポートします。まず FP16 で正しさを検証し、その後、選択したモデルでサポートされている INT8 または INT4 チェックポイントを評価してください。
| 精度 | メモリの傾向 | 推奨される用途 |
|---|---|---|
| FP16 | Orin でサポートされるパスの中で最もメモリ使用量が多い | 機能ベースラインおよび精度重視のワークロード |
| INT8 | 重みのメモリ使用量が低く、精度トレードオフは中程度 | バランスの取れた本番評価 |
| INT4 | サポートされるパスの中で最も重みのメモリ使用量が少ない | DRAM が限られた大規模モデルやマルチサービスデプロイ |
エンジンフラグを変更するだけで、FP16 チェックポイントが正しく量子化されると想定しないでください。モデルでサポートされているチェックポイントとエクスポートパスを使用し、そのうえで JetPack 7.2 上で TensorRT エンジンを再ビルドします。
コンテキスト、KV キャッシュ、同時実行数を制御する
LLM のメモリは、モデルの重みだけで決まるわけではありません。KV キャッシュは、コンテキスト長、バッチサイズ、生成トークン数、および同時リクエスト数に応じて増加します。
まずは保守的なリクエストから始めます:
{
  "batch_size": 1,
  "max_generate_length": 128,
  "requests": [
    {
      "messages": [
        {
          "role": "user",
          "content": "Summarize the current device status."
        }
      ]
    }
  ]
}
その後、次の各次元を 1 つずつ増やしていきます:
- 入力コンテキスト長
- 生成長
- バッチサイズ
- 同時リクエスト数
- 追加のビジョンまたはロボティクスサービス
プリフィル中にメモリが急増する場合は、プロンプトまたはコンテキストウィンドウを短くしてください。セッションがアクティブなままの状態でメモリが増加する場合は、KV キャッシュの保持と同時リクエスト処理を確認します。
重複したモデルロードを避ける
複数のアプリケーションが同じモデルを必要とする場合は、1 つの長時間稼働するモデルサーバーを使用してください。個別の Python スクリプト、ノートブック、テストサーバー、本番サービスは、それぞれが重みやエンジンの別コピーをロードする可能性があります。
推論を開始する前に、既存のモデルプロセスを確認します:
ps -ef | grep -E 'llm|triton|python|ollama' | grep -v grep
重複であると確認できたプロセスのみを停止してください。名前が一致するという理由だけでシステムサービスを終了しないでください。
可能な限りエクスポートとエンジンビルドをターゲット外で行う
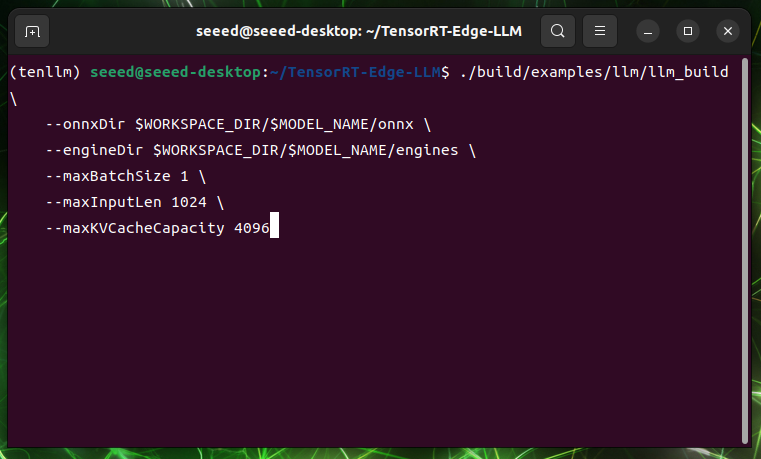
TensorRT Edge-LLM は、チェックポイントのエクスポートに x86 GPU ホストを使用し、ターゲットのエンジンビルドには Jetson を使用します。エクスポートには、RAM と VRAM でチェックポイントサイズの数倍が必要になる場合があるため、エクスポートをホスト側で行うことで、Jetson のメモリを検証と推論のために温存できます。
エンジンビルド中は、無関係なモデルサーバーを閉じ、ビルド時のピークメモリをランタイムメモリとは別に記録してください。ビルド時のメモリプレッシャーは、必ずしも定常状態のデプロイ要件を表すわけではありません。
スワップは DRAM の代わりではなくリカバリ手段として扱う
スワップは、一度きりのモデル変換やエンジンビルドを完了させるのには役立ちますが、継続的なスワップはレイテンシを悪化させ、ストレージの摩耗を増加させる可能性があります。リアルタイム推論では、スワップに頼る前に、より小さいまたは量子化されたモデル、短いコンテキスト、低い同時実行数、少ない重複サービスを優先してください。
4. 結果を検証する
各変更の前後で、同じプロンプト、入力、電力モード、アプリケーショントポロジを使用します。
| 指標 | 重要な理由 |
|---|---|
アイドル時の MemAvailable | システムおよびサービスのオーバーヘッドを測定 |
| エンジンロード後のメモリ | モデルとランタイムのフットプリントを示す |
| プリフィル時のピークメモリ | コンテキストと一時ワークスペースのプレッシャーを明らかにする |
| 定常デコード時のメモリ | KV キャッシュとセッション保持を示す |
| 最初のトークンまでの時間 | スワップや制約されたワークスペースによるリグレッションを検出 |
| デコードスループット | メモリ削減によって推論が実用的でないほど遅くなっていないことを確認 |
| 温度とボード電力 | 結果が短時間のバーストではなく安定していることを確認 |
Seeed の比較では、JetPack 7.2 Deep Dive において 27B モデルをロードした後のメモリ使用量が、JetPack 6.2 の約 24.6 GB から JetPack 7.2 では 14.7 GB まで低下したことが記録されています。この結果は特定のワークロードにおける参考値として扱い、すべてのモデルで同様の削減が保証されるものではないと考えてください。
推奨手順
- アイドル時、エンジン負荷時、プリフィル時、デコード時のメモリを計測します。
- 重複しているモデルプロセスや不要なアプリケーションサービスを削除します。
- コンテキスト、生成長、バッチサイズ、および同時実行数を削減します。
- TensorRT Edge-LLM がサポートする INT8 または INT4 チェックポイントを評価します。
- ディスプレイ不要のアプライアンス展開には
jetson-headless-modeを使用します。 - ハードウェアシナリオが完全に一致する場合にのみ
jetson-optimize-memory headlessまたはno-cameraを使用します。 - 実際の DMA バウンスプール使用量を測定した後にのみ SWIOTLB の削減を検討します。
- 変更を行うたびに、正しさ、レイテンシ、スループット、熱特性、および安定性テストを再実行します。
ロールバック
- グラフィカルデスクトップが再び必要になった場合は、元のサービスターゲットを復元します。
- カーブアウトまたはデバイスツリーの変更によってブートや周辺機器の障害が発生した場合は、初期状態の BSP ソースを復元して再フラッシュします。
- DMA エラーが発生した場合、または使用量が設定されたプールに近づいた場合は、SWIOTLB の変更を元に戻します。
- 最適化された構成が受け入れテストに合格するまで、最後に既知の正常な TensorRT エンジンとモデル構成を保持します。
テクニカルサポートと製品ディスカッション
Seeed Studio の製品をお選びいただきありがとうございます。技術サポートおよび製品に関するディスカッションには、以下のチャネルをご利用ください。