NVIDIA Jetson AGX Orin 上の llama.cpp を MTP で高速化する
はじめに
Multi-Token Prediction は、ステップごとに複数のトークン案を下書きし、ターゲットモデルがそれらを一度に検証することで、下書きがうまくいった場合に直列のデコードパスの回数を削減します。Jetson AGX Orin では、llama.cpp が Qwen3.5-4B に対して MTP を有効化できます。以下のセクションでは、デコードが遅い理由、MTP の有効化方法、そしてローカルの群衆監視デモで MTP オフと比較してどこで効果が出るのかを説明します。
まず、実際のテスト結果を見てみましょう。LLM にフィボナッチ数列を計算する Python スクリプトを生成させ、MTP モデルを有効にした場合と無効にした場合で生成速度を比較しました。
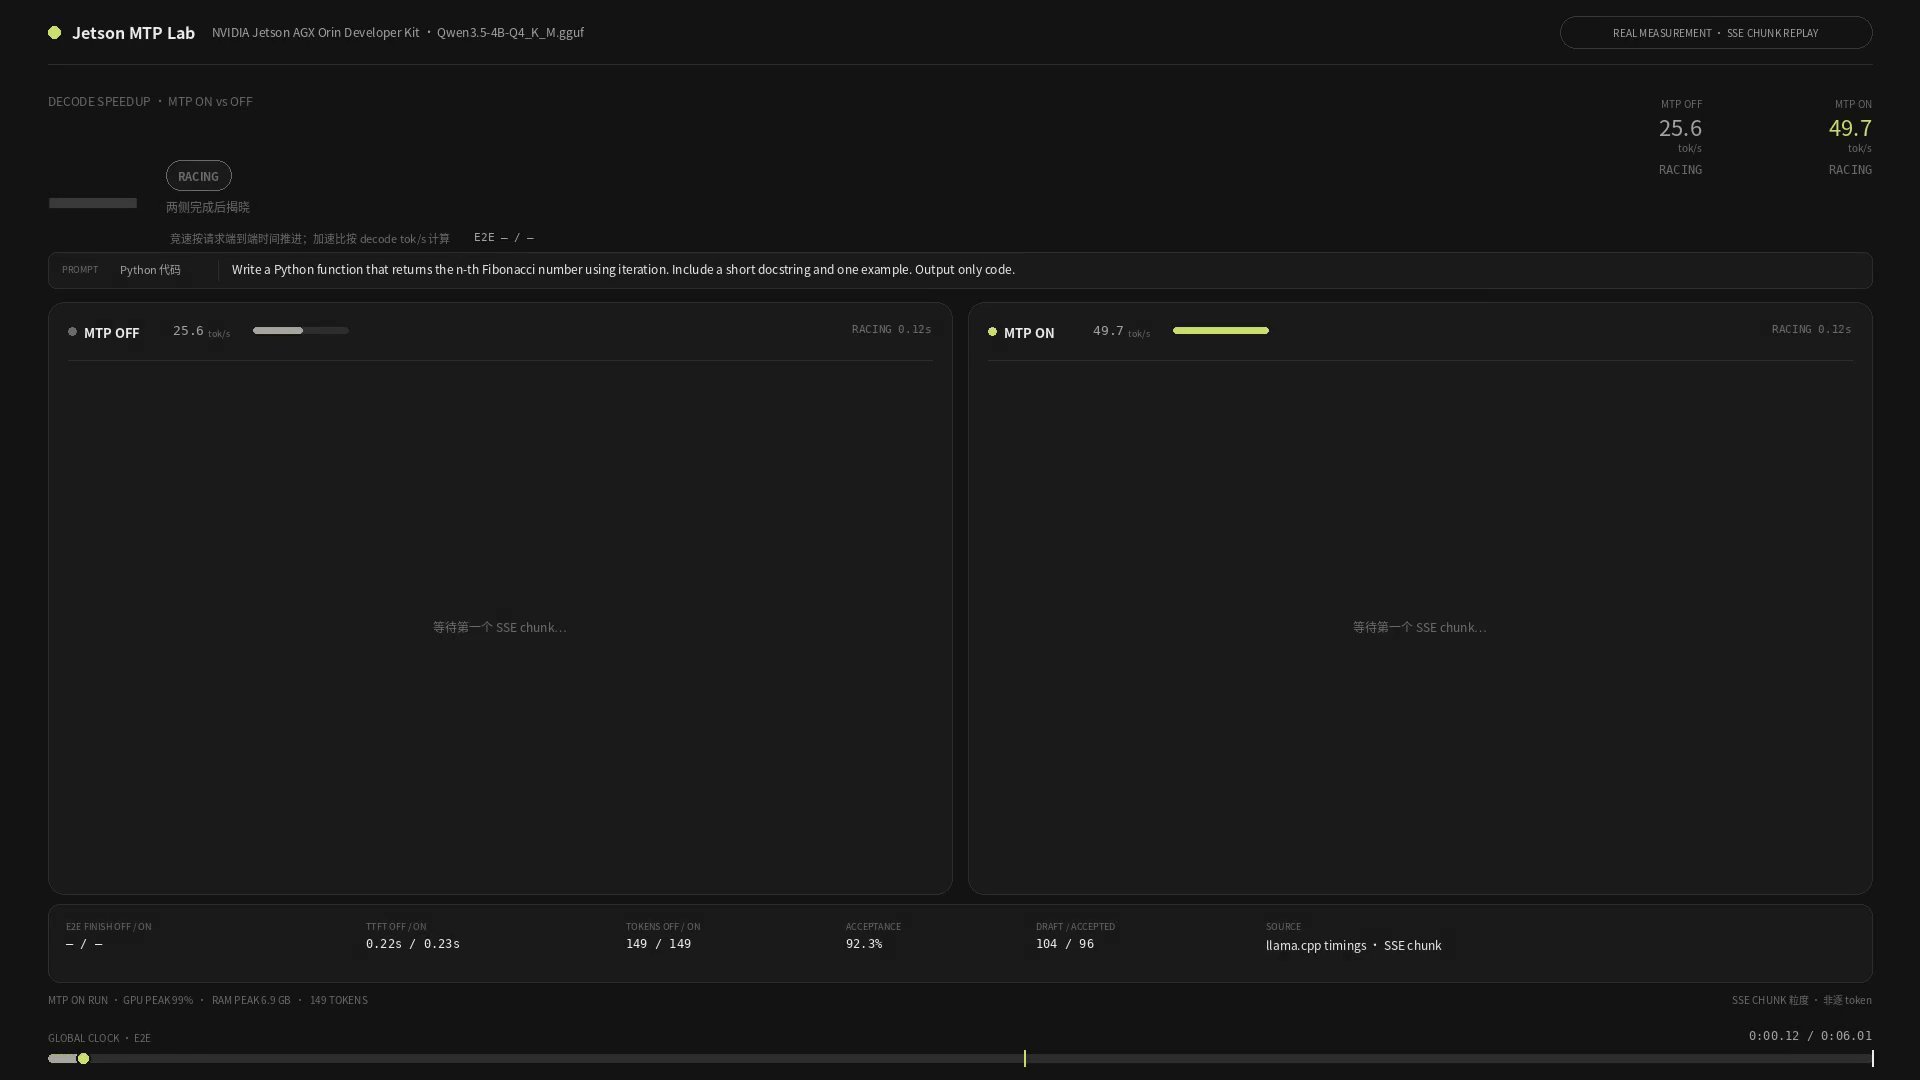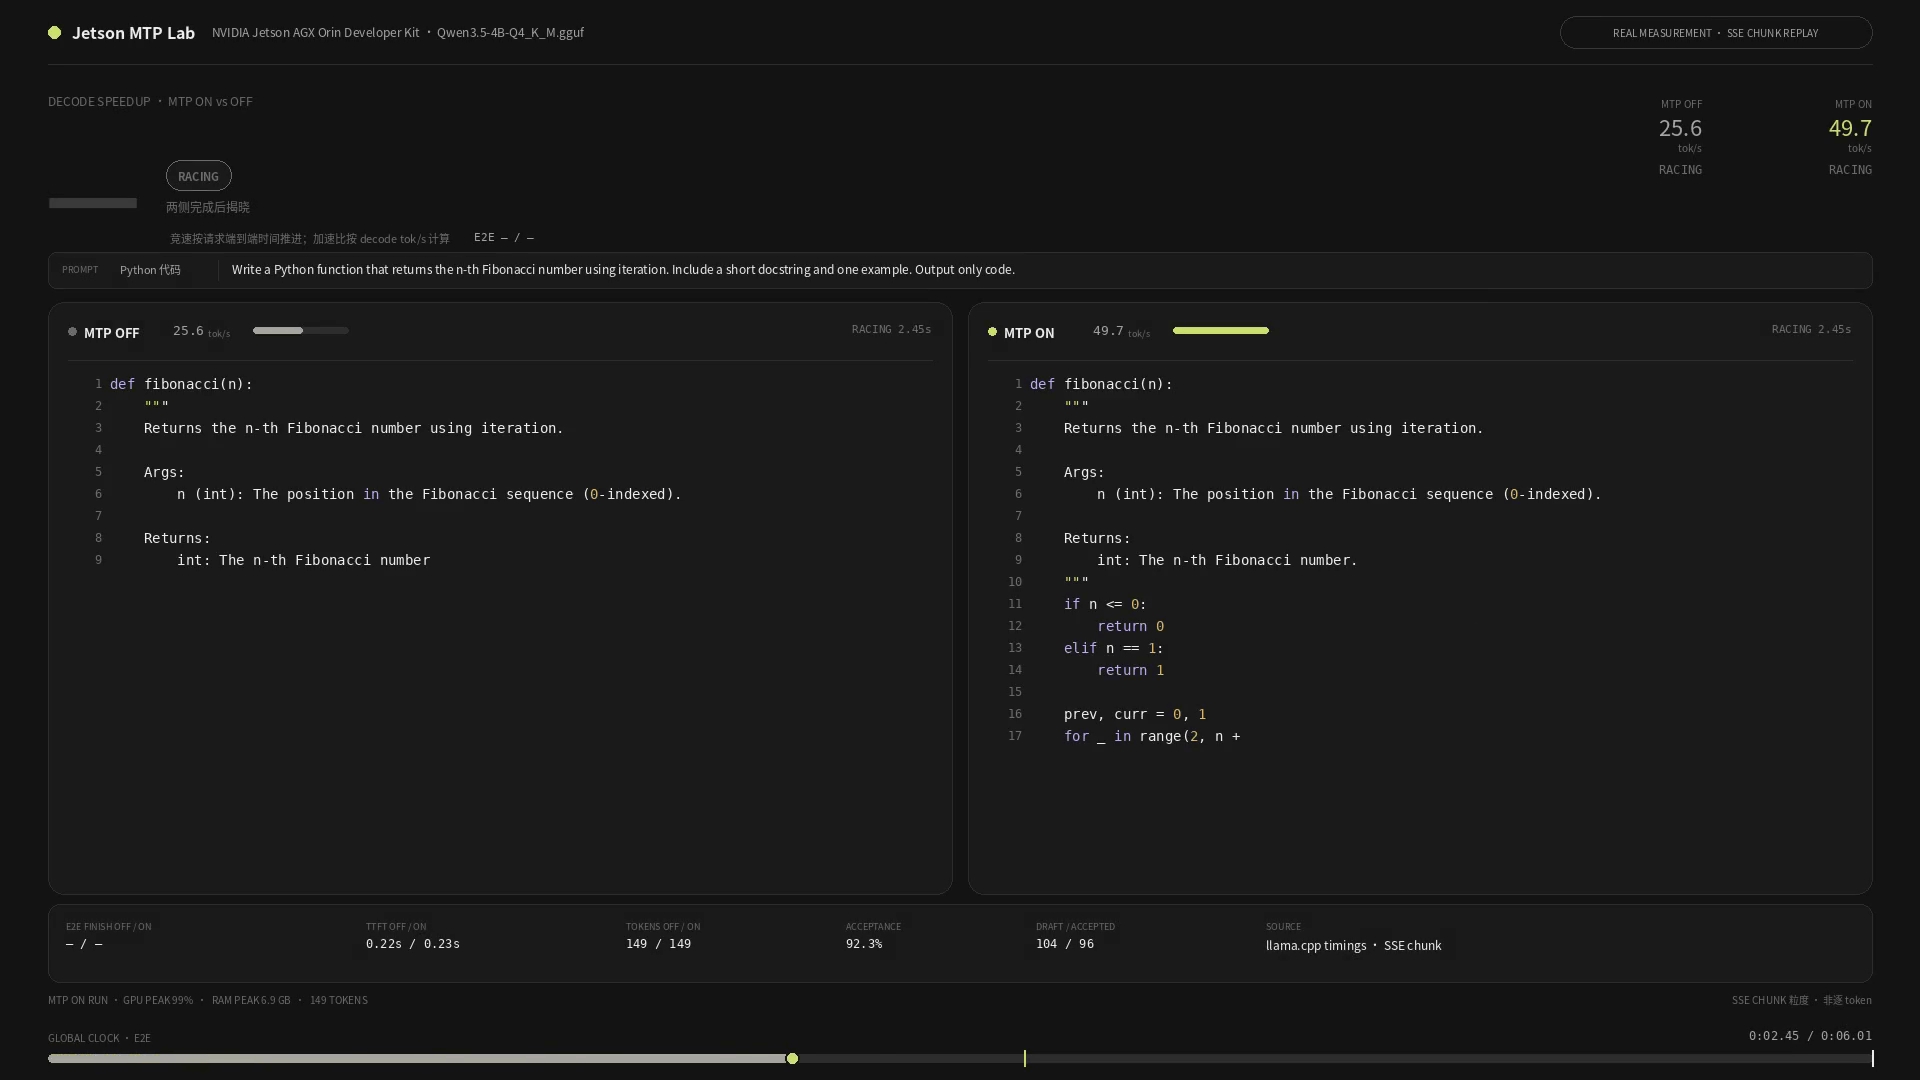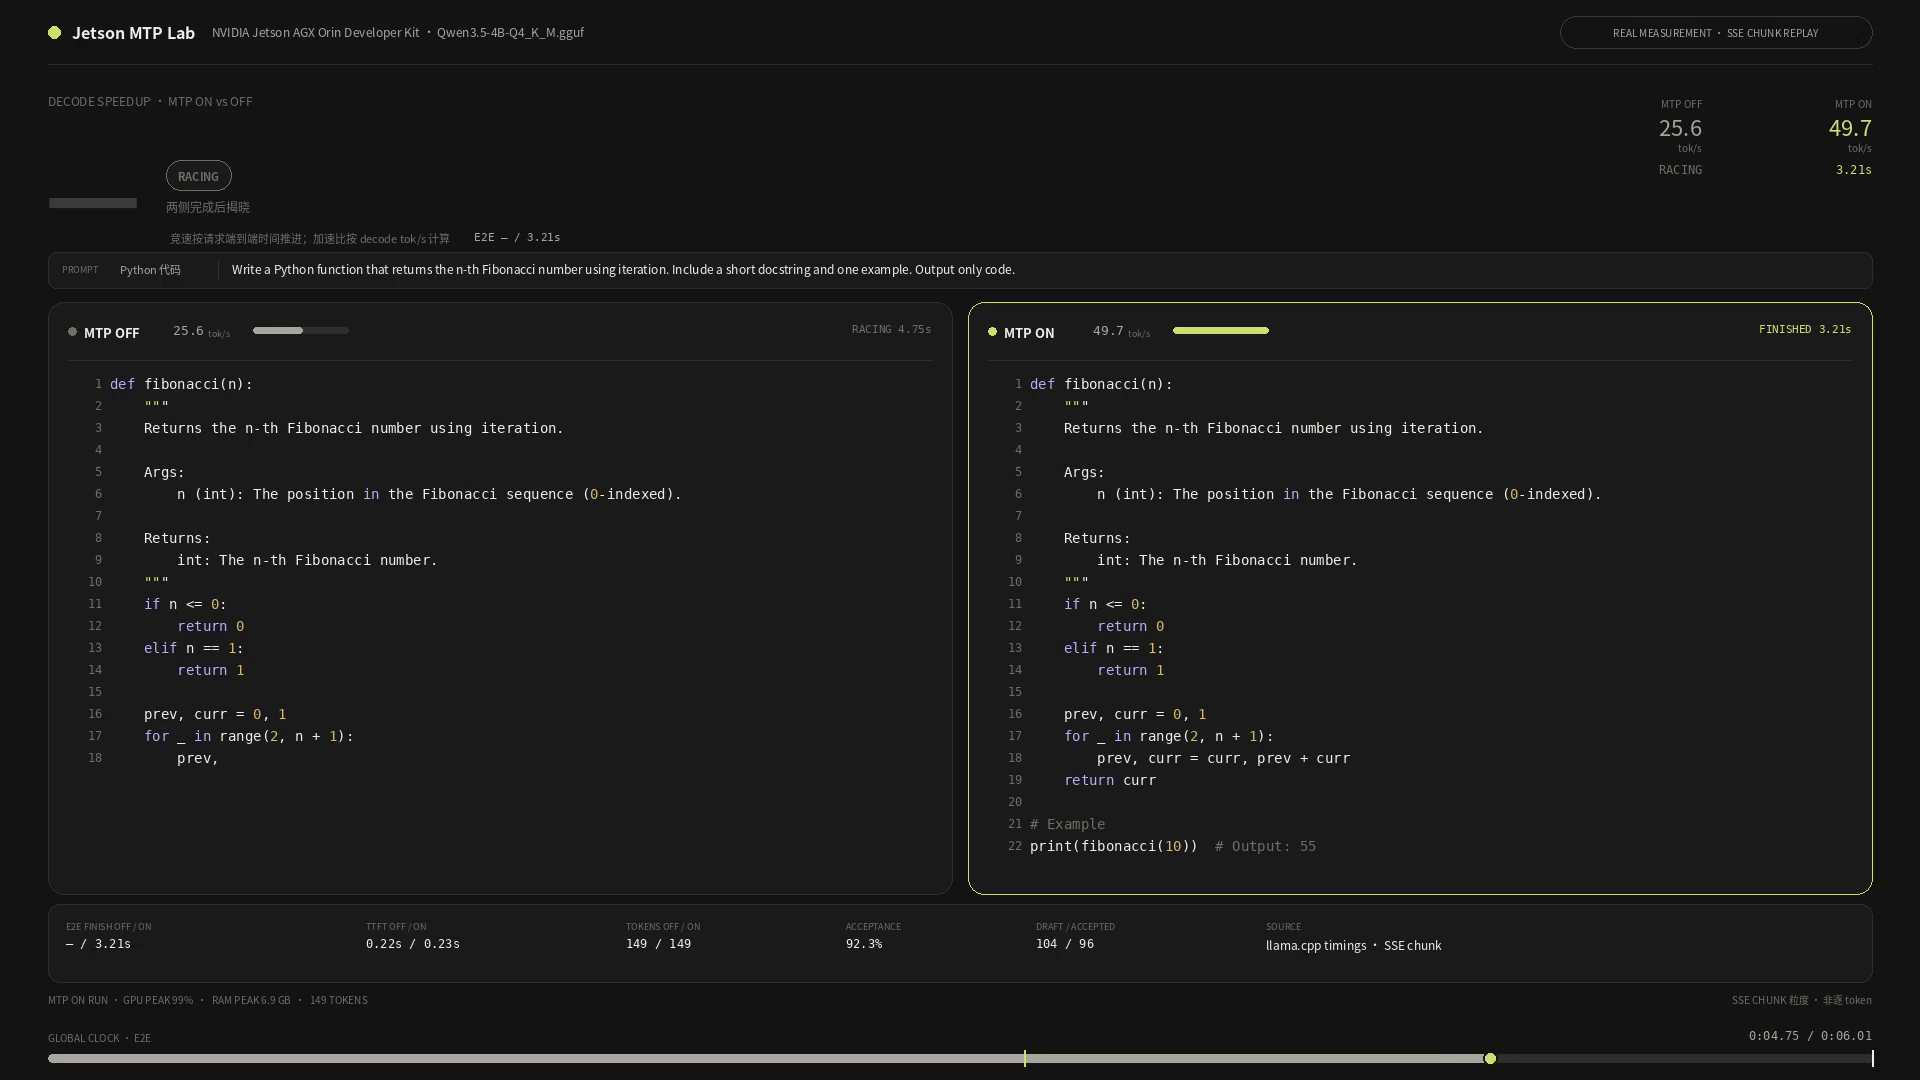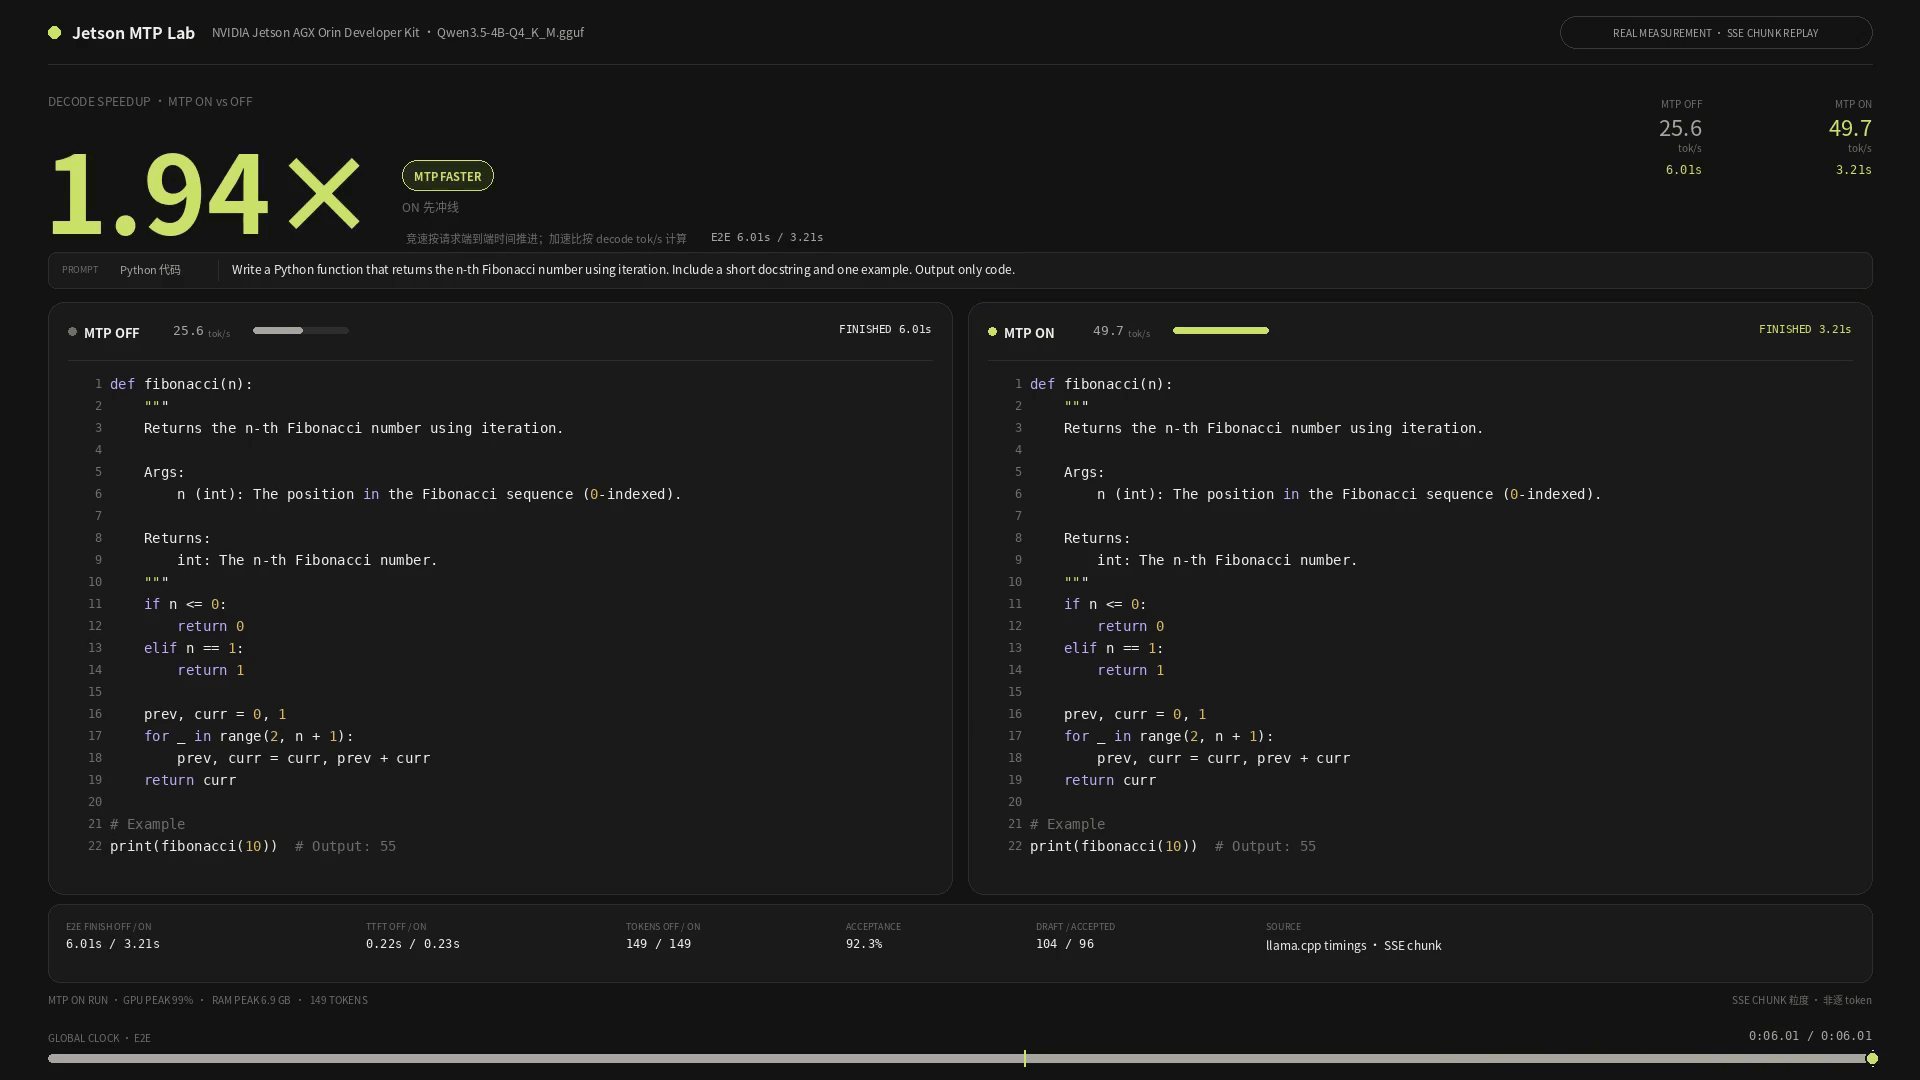
MTP モードを有効にしない場合、Qwen3.5 4B モデルは約 25.6 tokens/s のレートでトークンを出力しますが、MTP モードを有効にすると、同じデバイス上の同じモデルで 49.7 tokens/s の生成速度に達します。このような比較的決定的な内容では、モデルの生成速度がほぼ 2 倍になることが分かります。ここからいくつかの示唆が得られます。比較的ルーチンなタスクでは、MTP モードを有効にすることでかなりの性能向上が得られる可能性があります。
別のビジュアル解析シナリオも見てみましょう。ROI 領域を定義し、その ROI 内の人数が 1.5 秒間、常に 5 人以上であるかどうかを監視します。条件を満たした場合、LLM を呼び出して異常解析と診断を行います。ビジュアル解析シナリオにおいて、MTP モードを有効にするとどれだけ高速化されるか見てみましょう。
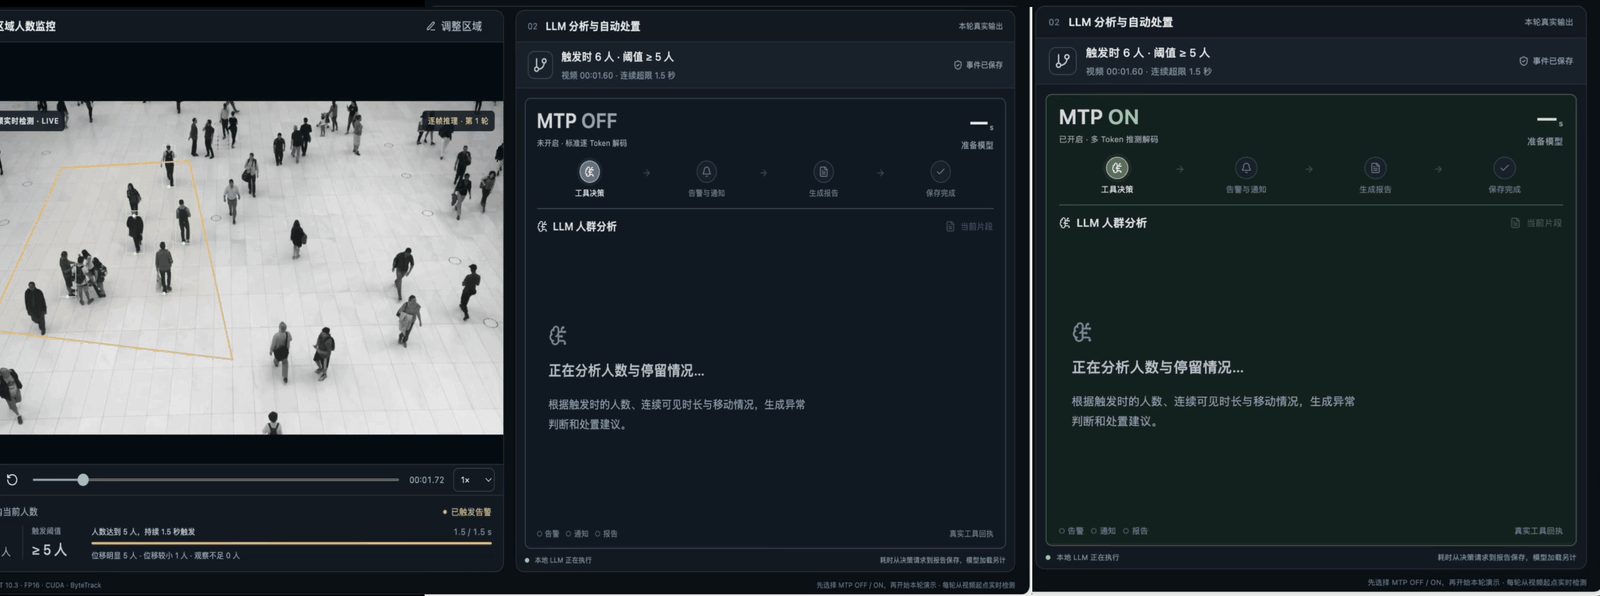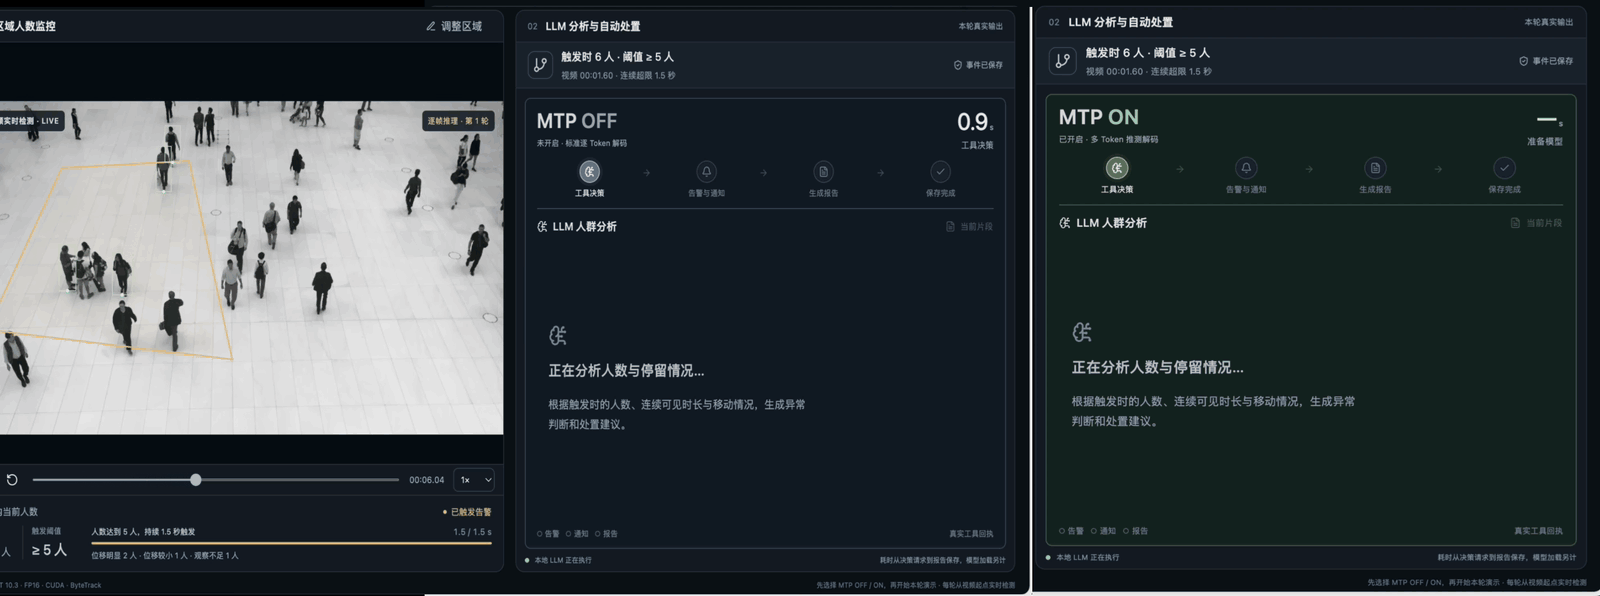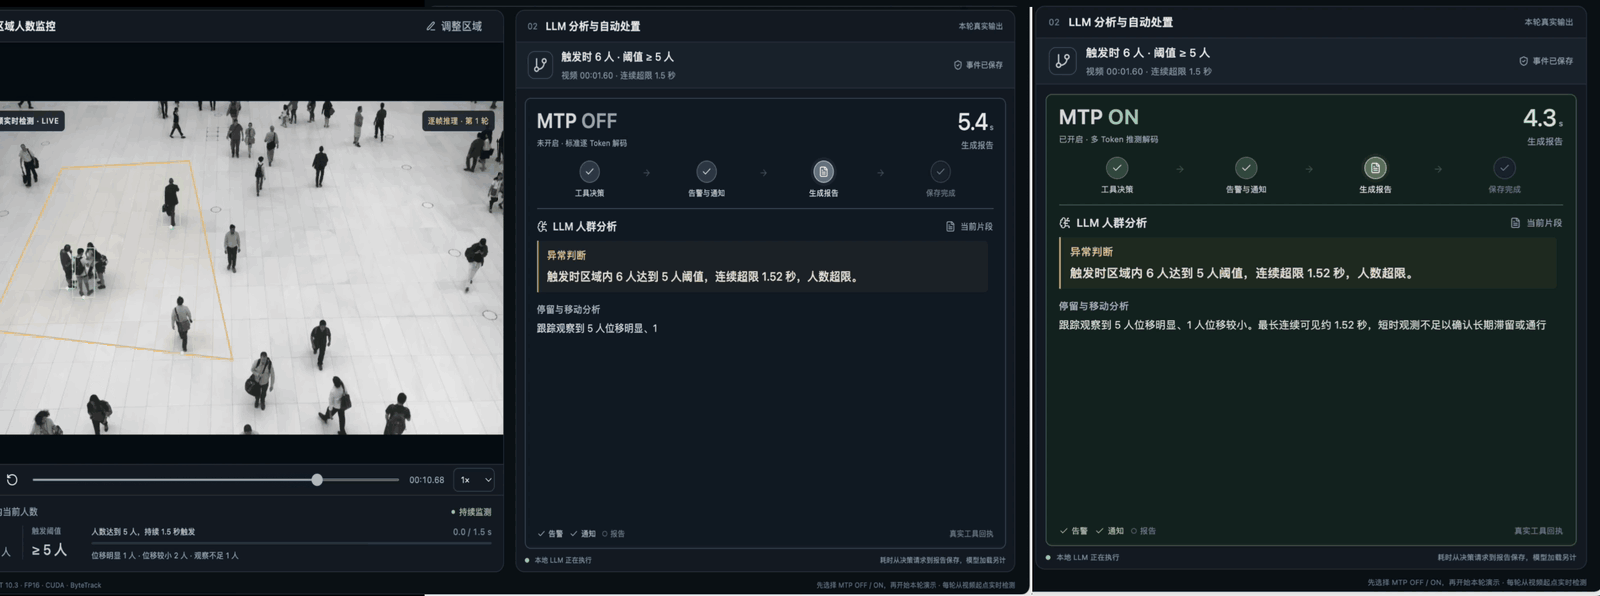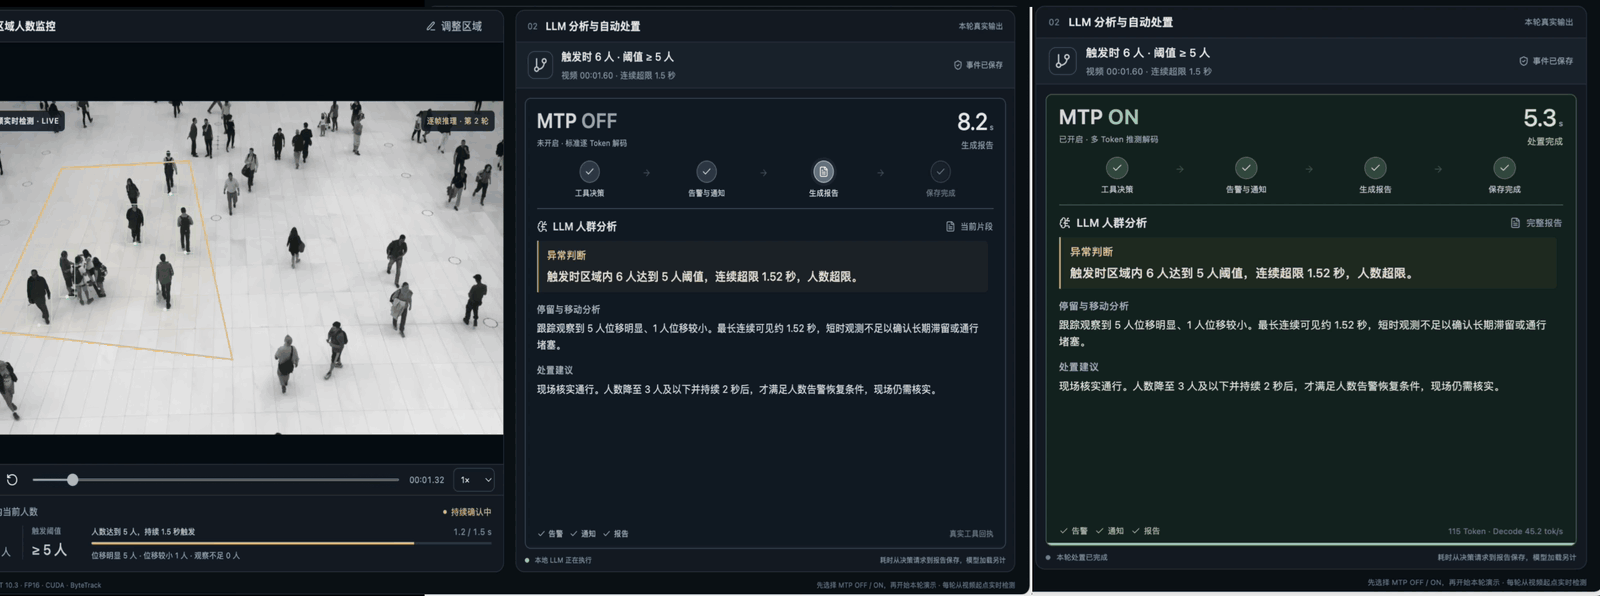
ご覧のとおり、上記のシナリオでは、MTP モードを有効にすることでタスク完了時間を約 3 秒短縮できます。この最適化はかなり大きな効果があります。
なぜ LLM のテキスト生成には時間がかかるのか?
1 トークンずつ生成する仕組み
NVIDIA Jetson がどこで使えるかモデルに尋ねると、ロボティクス、産業用ビジョン、エッジ監視などと答えるかもしれません。この文が徐々に表示されるのは、自己回帰型 LLM が 1 つのトークンを予測し、それをコンテキストに追加し、そのコンテキストを使って次のトークンを予測するからです。
トークンは単語、単語の一部、または句読点である場合があります。各新しい予測はそれ以前に出力された内容に依存するため、モデルは応答が完了するまでこのプロセスを繰り返します。
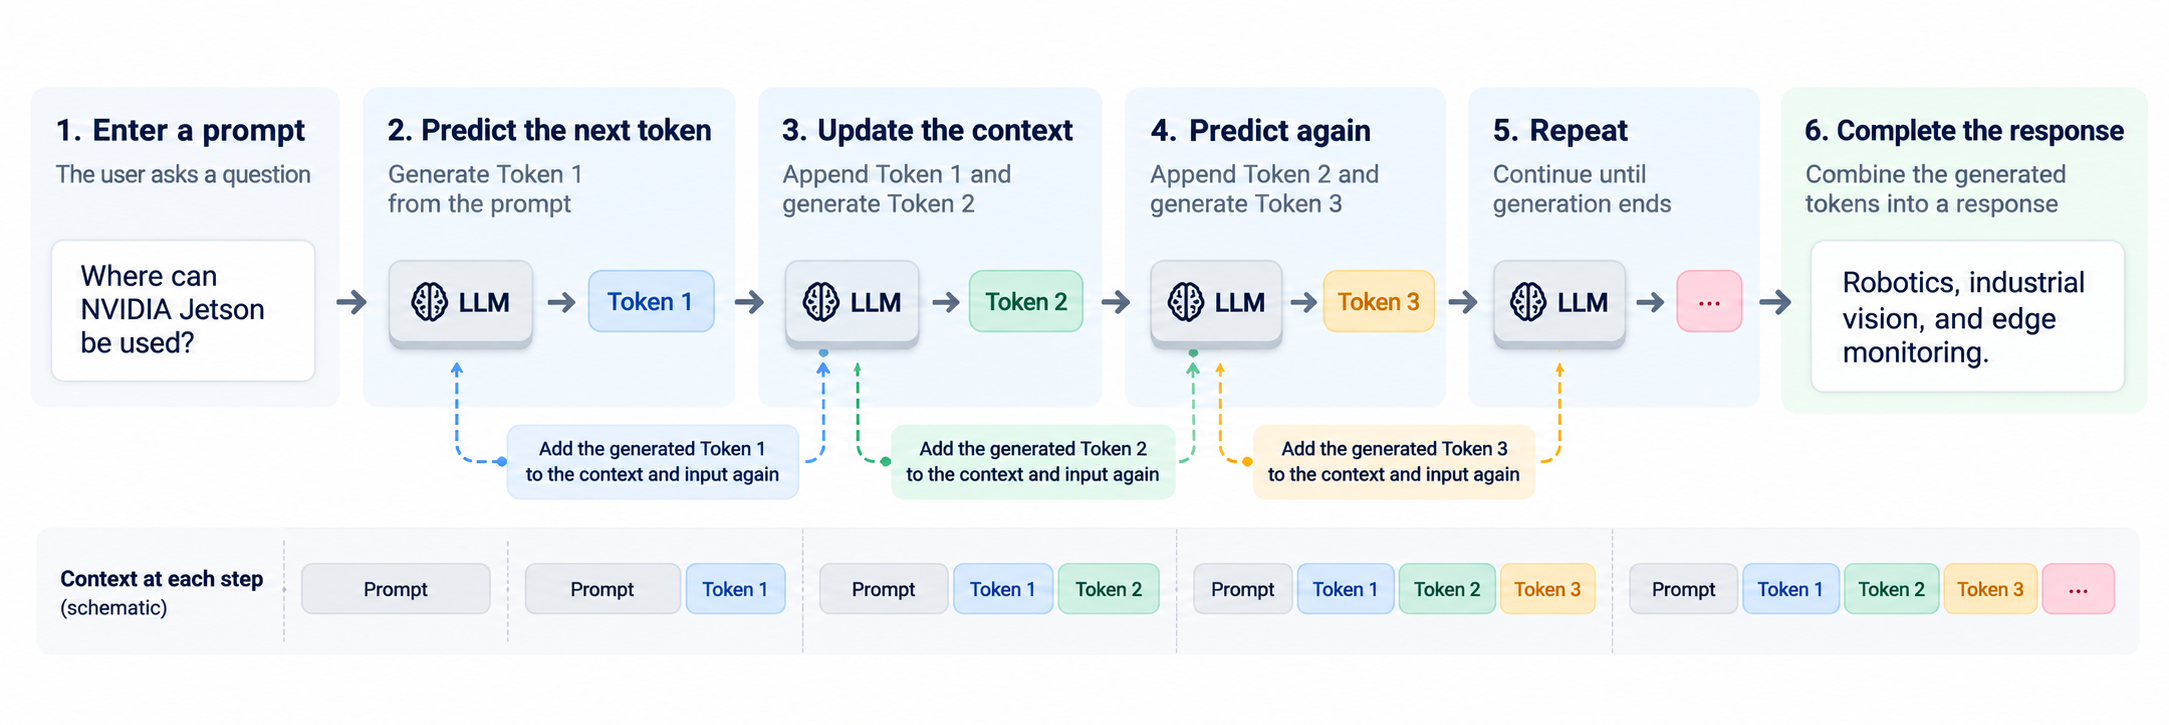
20 tokens/s の場合、500 トークンを生成するには約 25 秒のデコード時間が必要です。ローカルアシスタントがコードやレポートを書くときには、この待ち時間が気になるようになります。
プレフィルとデコード
LLM 推論には主に 2 つのステージがあります。
| ステージ | 主なタスク | 特徴 |
|---|---|---|
| プレフィル | プロンプトを読み込み、コンテキスト状態を構築する | 入力位置は並列に処理できる |
| デコード | 応答を生成する | 後続トークンは先に生成された出力に依存する |
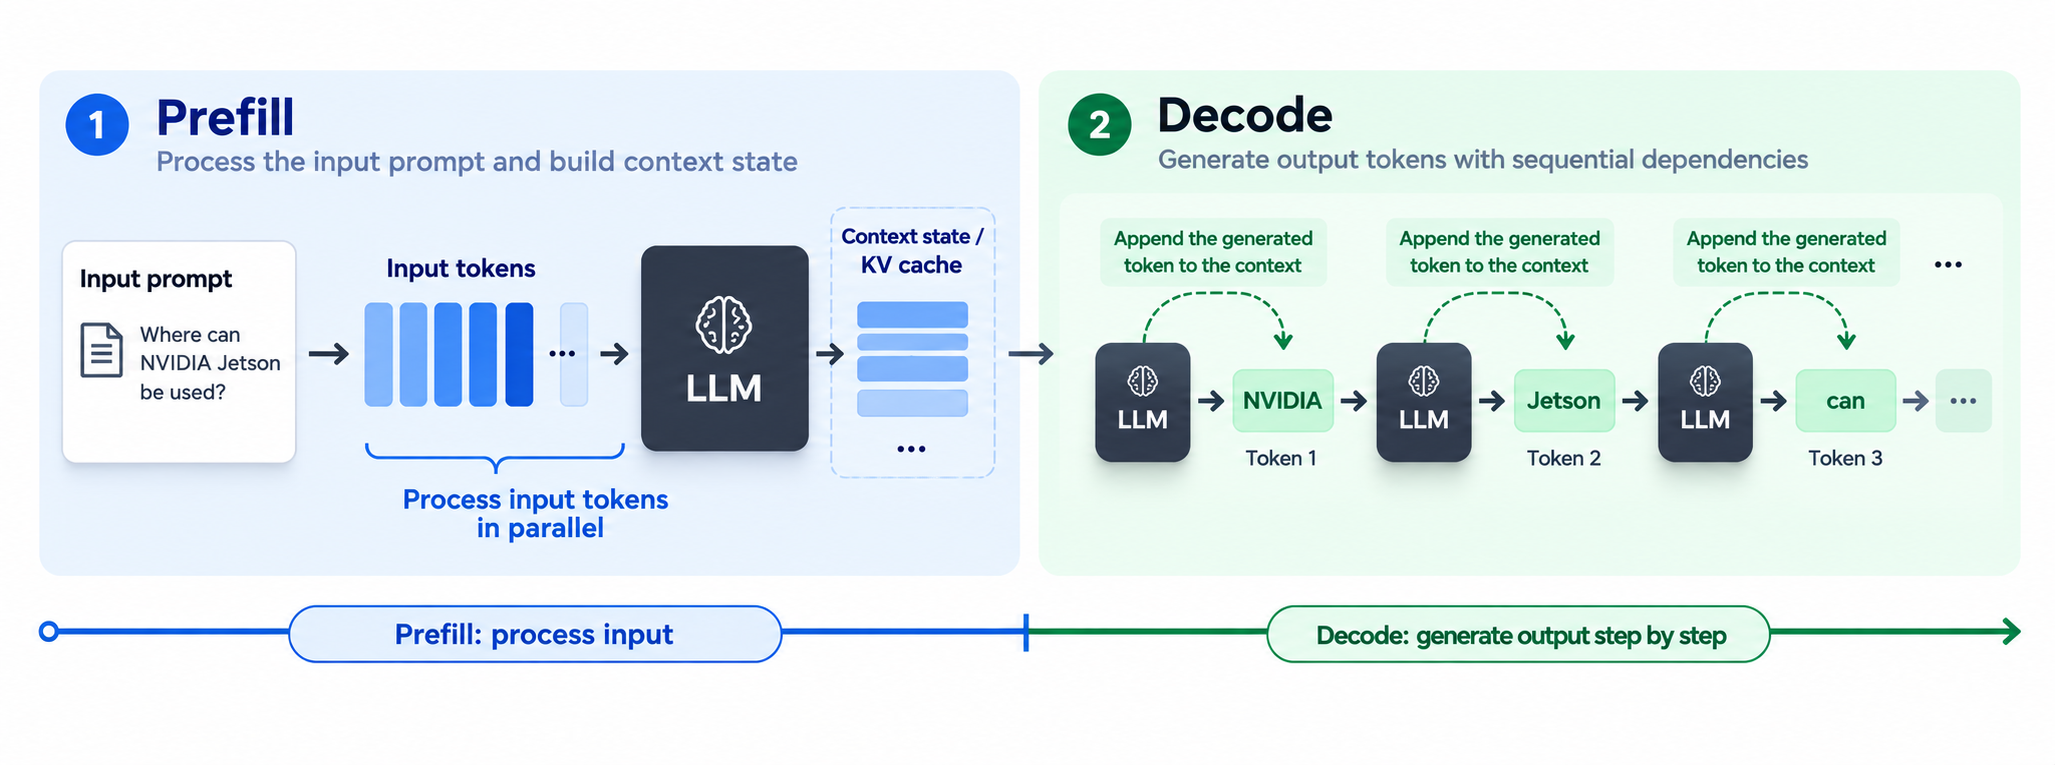
Jetson 上で単一ユーザー向けに LLM を動かす場合、デコードは多くの時間をモデルの重みやキャッシュされたコンテキストをメモリから読み出すことに費やしがちです。GPU には並列計算能力がありますが、1 トークンずつのステップが連続するワークロードでは、その能力を十分に活かせない場合があります。MTP は主にこのデコードステージを対象としています。
Multi-Token Prediction とは?
Multi-Token Prediction では、将来のトークンを提案するために追加の予測ヘッドやレイヤーを学習させます。これらの候補は speculative decoding で利用され、ターゲットモデルが複数の位置をまとめて検証してから出力を確定します。
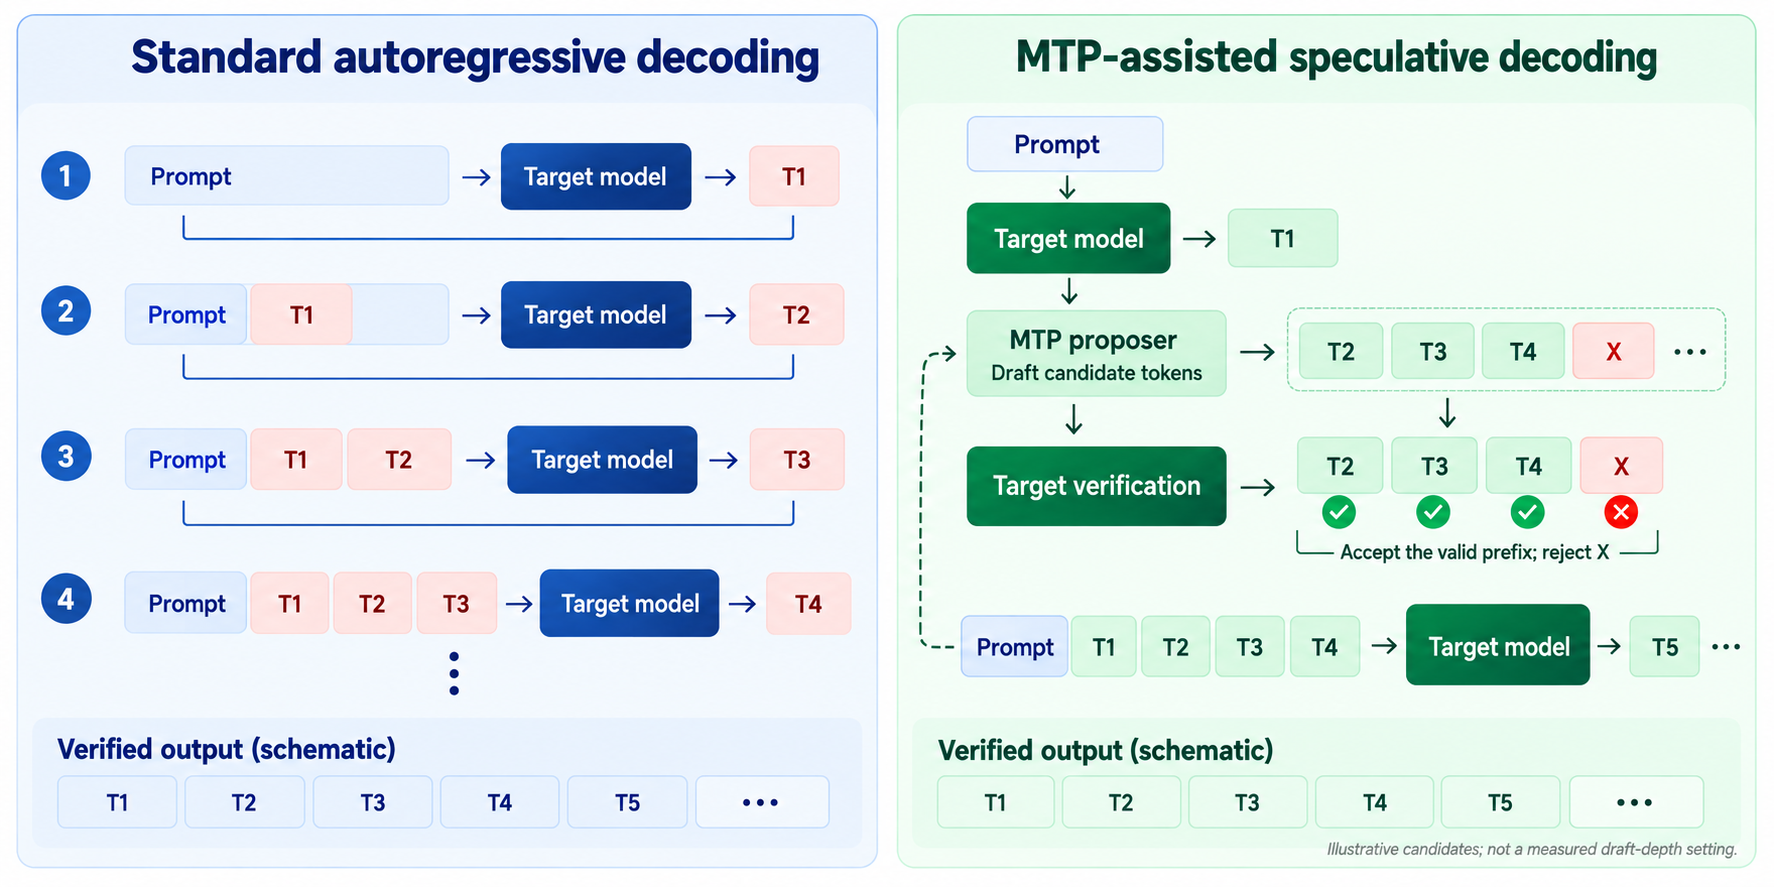
複数の候補が検証を通過すると、ターゲットモデルの 1 回のパスで応答が複数トークン分進みます。候補が失敗した場合、ランタイムは受理されたプレフィックスを保持し、拒否された候補と残りの下書きを破棄します。ターゲットモデルはその地点から処理を続行します。
提案が十分に正確であれば、直列デコードパスの回数を減らすことができます。ターゲットモデルは依然として出力を検査します。正しく損失のない speculative decoding であれば、貪欲デコードの結果やサンプリング分布は保たれますが、量子化やランタイムの数値的な違いが実際の挙動に影響する可能性があります。
multi-token prediction の論文では学習のアイデアが説明されています。llama.cpp の speculative decoding ドキュメントでは推論時の使い方が解説されています。
なぜ MTP は高速になり得るのか?
1 回の検証でより多くの有用な出力を得る
バッチ検証により、ターゲットモデルは複数の候補をまとめてチェックできます。メモリ帯域がボトルネックとなるワークロードでは、同じトークン数を個別の直列パスで生成するよりもコストを抑えられる場合があります。
下書きと検証にも時間はかかります。MTP が生成を高速化するのは、節約できる処理量がこの追加コストを上回る場合だけです。有用な診断指標として、受理された下書きトークン数を生成された下書きトークン数で割ったドラフト受理率があります。また、各検証で応答がどれだけ進むか、リクエスト全体にどれだけ時間がかかるかも測定してください。
ドラフトの深さは検証が必要
最大ドラフト長は --spec-draft-n-max で制御します。ドラフトを長くすると、ターゲットモデルが検証できる候補が増えますが、後半の候補は精度が低くなる可能性があります。それらを破棄するコストが、より大きなバッチの利点を上回ることもあります。
まずは浅い深さから始め、自分のプロンプトで比較してみてください。Edge Crowd Agent の比較では深さ 2 を使用しています。定型的なコードやレポート形式でうまく機能する設定でも、別のワークロードでは挙動が異なる場合があります。
Jetson 上の llama.cpp で MTP を有効化する
このデモでは、以下の構成を使用します。
| コンポーネント | 構成 |
|---|---|
| ハードウェア | NVIDIA Jetson AGX Orin 32GB |
| JetPack | 6.2.1 |
| ランタイム | CUDA 対応 llama.cpp |
| モデル | MTP テンソル付き Qwen3.5-4B |
| 量子化 | Q4_K_M GGUF |
| 比較 | MTP OFF / MTP ON |
公式ビルド手順に従って、CUDA 対応で llama.cpp をビルドします。MTP 対応 Qwen3.5-4B GGUF を選択し、ビルドしたバイナリのヘルプ出力に draft-mtp が含まれていることを確認してください。
ランタイムの準備ができたら、MTP の起動コマンドは短くて済みます。
llama-server \
  -hf unsloth/Qwen3.5-4B-MTP-GGUF:Q4_K_M \
  -ngl 99 -c 8192 -np 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
ビルドした中の llama-server バイナリを使用します。モデルをダウンロード済みの場合は、-hf を -m とローカル GGUF パスの組み合わせに置き換えてください。
--spec-type draft-mtp で MTP を有効化し、--spec-draft-n-max でその深さを制御します。OFF との比較を行う場合は、--spec-type none を使用し、モデルと共通設定は変更しないでください。
生成後、起動ログで読み込まれた MTP テンソルとサーバーのドラフト受理統計を確認してください。この構成ではスロットを 1 つにし、テキストのみのリクエストを使用します。最新の互換性制限については、モデル公開者の説明を参照してください。
MTP が有効なユースケース
点検・監視レポート
Jetson は検出結果、センサー値、装置ログを収集し、ローカル LLM に点検レポートの作成を依頼できます。繰り返し現れる項目や記述があるため、候補受理率をテストするのに適したワークロードです。利点は、書面レポートの待ち時間が短くなることです。リアルタイム制御や保護は別系統のまま維持されます。
ローカルのコーディングアシスタント
Python スクリプト、シェルコマンド、デバイス設定ファイルなどは、規則的な構文を持つ比較的長い応答を生成することがよくあります。イントロダクションのフィボナッチの例は、このデバイスでの可能性を示しています。生成されたコードは依然として確認とテストが必要です。
オフライン音声アシスタントとロボット
音声アシスタントは、認識した音声をローカル LLM に渡し、その応答をテキスト読み上げに送ります。
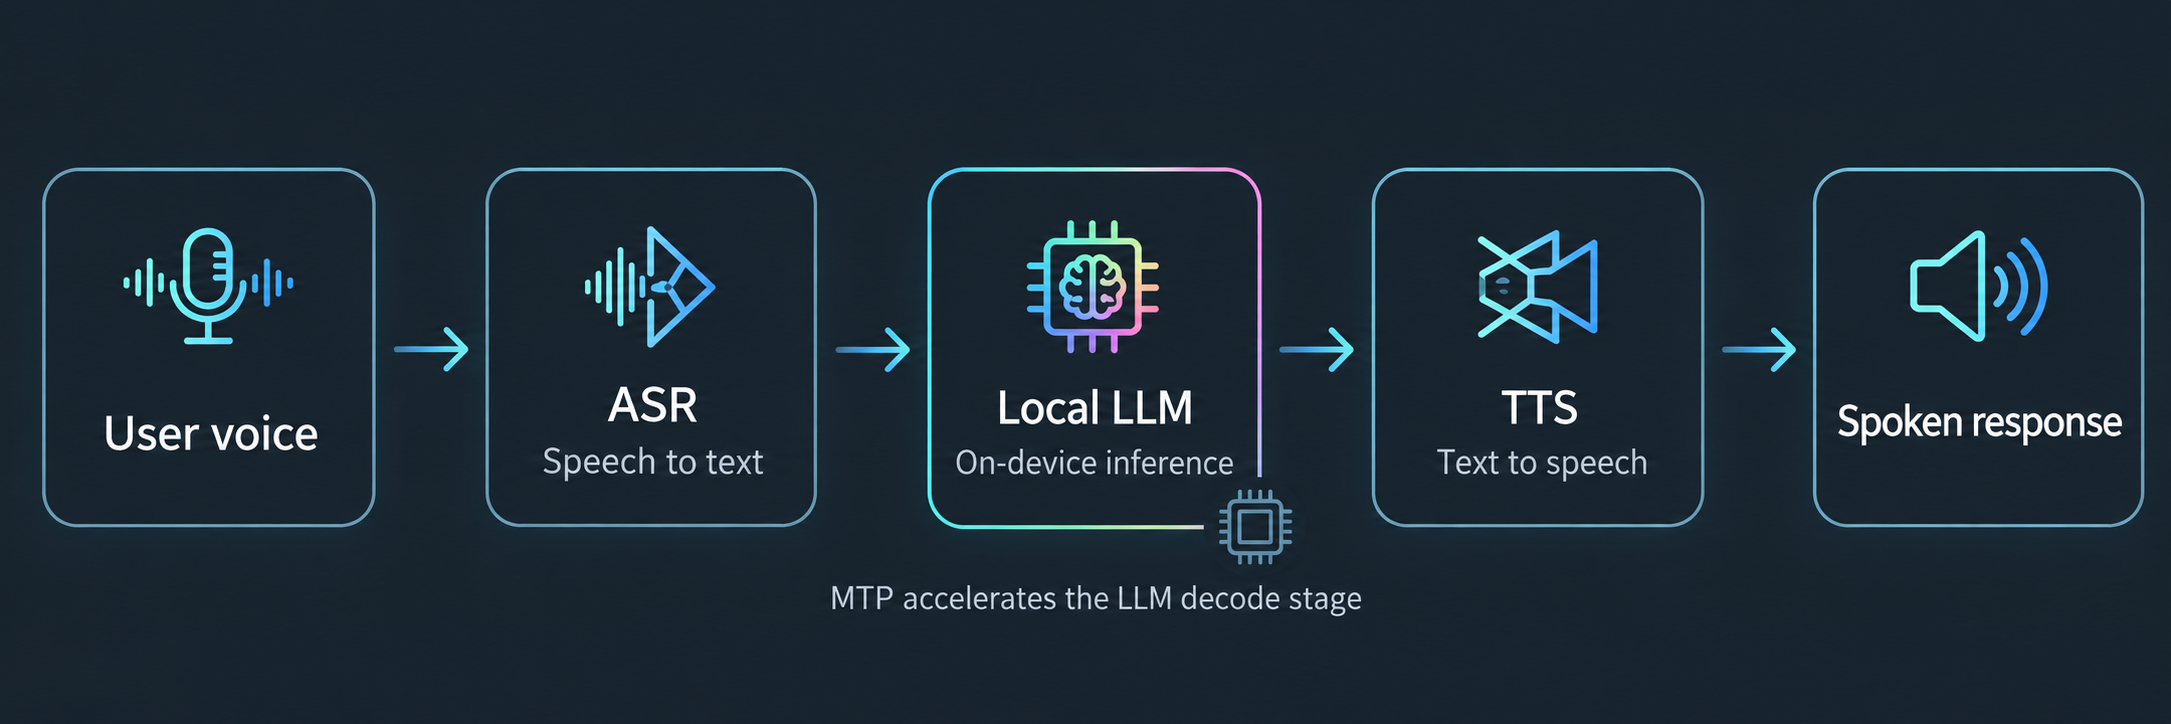
MTP は、長めの応答に対して LLM のデコードステージを短縮できます。音声認識、音声合成、ストリーミングは、ユーザーが実際に回答を聞くタイミングを決定するため、完全な応答時間だけでなく、最初の有用な音声が出るまでの時間も測定してください。
ローカルナレッジと技術的な説明
トラブルシューティング手順や、デバイスログに基づく長い回答では、出力生成にかなりの時間を費やすことがあります。これらはテストする価値があります。一行の回答だけが必要な長文ドキュメントの場合、プロンプト処理が支配的となり、節約できるデコード時間がほとんどないこともあります。
MTP を有効にする価値があるのはいつか?
まず必要なのは互換性のあるモデルです。ランタイムがその予測コンポーネントをサポートしている必要があり、追加の下書き処理が、使用しているハードウェアとプロンプト上で十分な効果を発揮しなければなりません。受理率が高く出力が長いほど有利になることが多い一方で、受理率が低い場合や非常に短い応答では、MTP の方が遅くなることもあります。
実際にアプリケーションが必要とする時間を比較してください。デコードが高速になっても、画像処理、ツールの実行、モデルの読み込みが同じ割合で短縮されるわけではありません。モデル、入力、出力の制限、およびサンプリング設定を揃えたうえで、計測結果から判断してください。
群衆モニタリングデモを試す
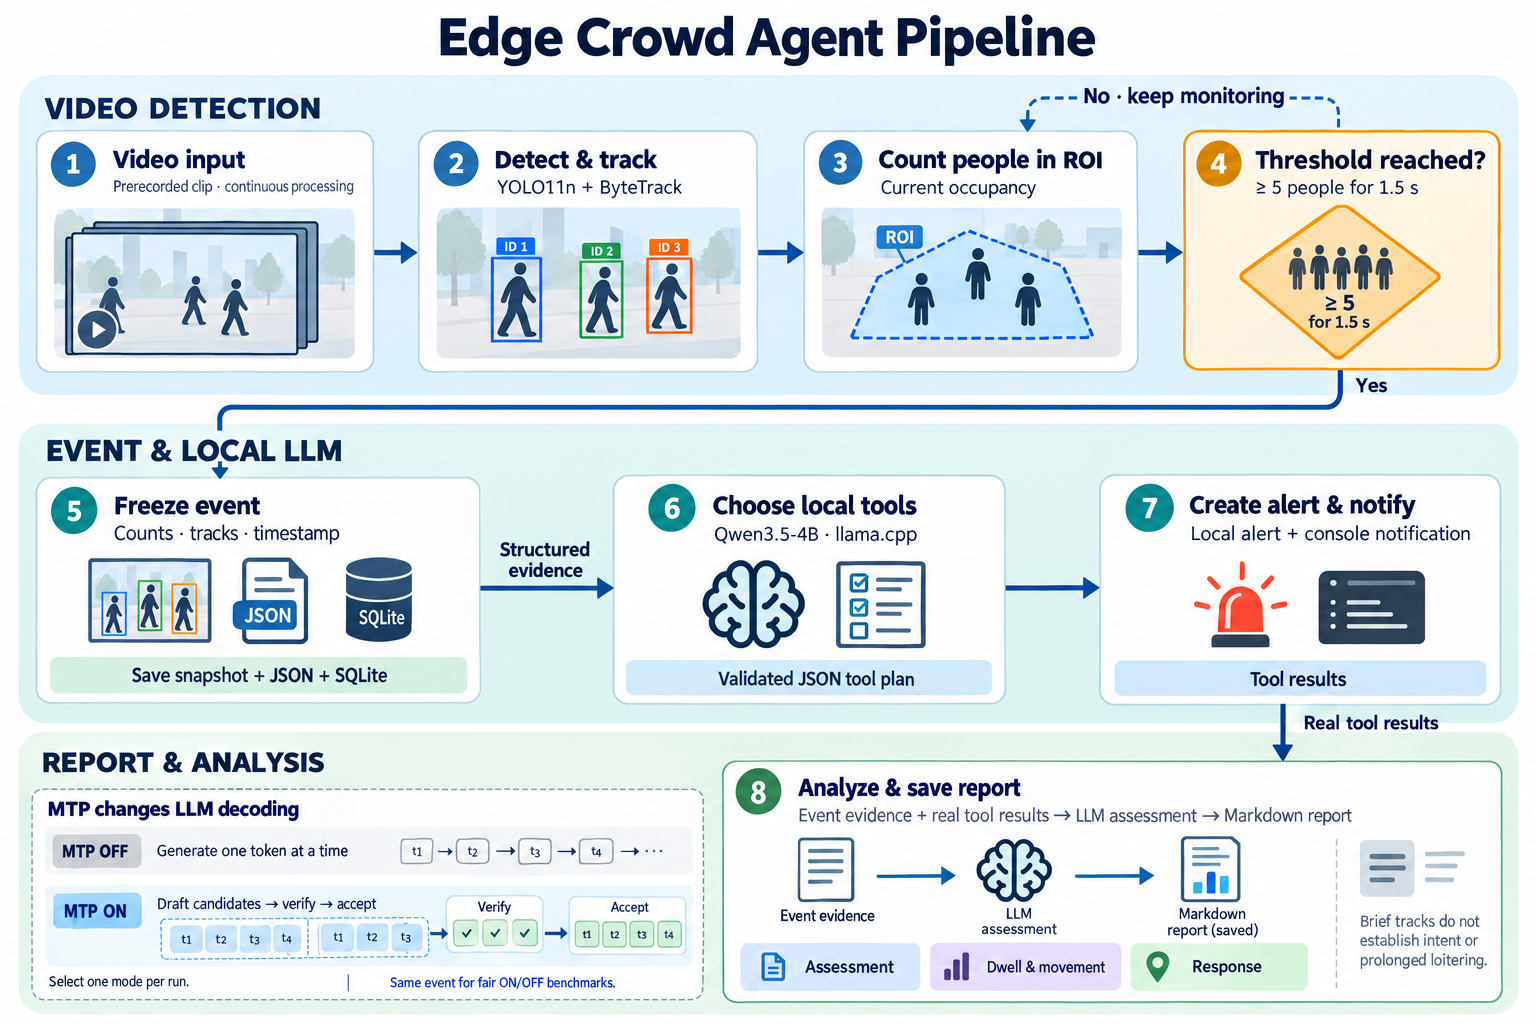
冒頭のデモンストレーションのソースは Edge Crowd Agent です。YOLO11n と ByteTrack が現在の ROI 占有状況を計測し、イベントがトリガーされるとローカル LLM が保存された人数と動きの証拠を説明します。
依存関係、モデルとビデオパス、環境チェック、起動方法については、README の Start on Jetson に従ってください。このプロジェクトは、JetPack の TensorRT バインディングへのアクセスを維持するために、システムの Python 3.10 とともに uv を使用します。
起動後、MTP OFF または ON を選択し、Start demo を選びます。ビデオ検出は左側に表示され、右側に解析とツールの進行状況が表示されます。recording guide では、両方のデモンストレーションを実行する方法を説明しています。
デフォルトのイベント条件は、ROI 内に少なくとも 5 人が 1.5 秒間連続して存在することです。LLM はビデオピクセルではなく構造化された証拠を受け取ります。短いトラックは占有状況の評価には役立ちますが、意図や長時間の滞留を立証することはできません。
制御された比較を行うには、2 つの別々の録画ではなく、同じ固定されたイベントを使用してください。README の benchmark セクション には、テスト方法と計測結果が記載されており、モデルの読み込み時間は別途一覧化されています。
参考文献
- Edge Crowd Agent のソースコードと使用方法
- Edge Crowd Agent のベンチマーク記録
- Jetson AI Lab による speculative decoding チュートリアル
- llama.cpp の speculative decoding ドキュメント
- llama.cpp SPEED-Bench
- Qwen3.5-4B MTP GGUF モデル
- Better & Faster Large Language Models via Multi-token Prediction
関連リソース
- JetPack 7.2 による LLM デプロイ向けメモリ最適化
- Jetson 上で Laya と Qwen を使ってローカル AI エージェントを構築する
- reComputer Super と Classic の AI 性能比較
- Edge Crowd Agent リポジトリ
技術サポートと製品ディスカッション
弊社製品をお選びいただきありがとうございます。弊社は、製品をできるだけスムーズにご利用いただけるよう、さまざまなサポートを提供しています。お好みやニーズに応じて選べる複数のコミュニケーションチャネルをご用意しています。