15. ACTモデルとアクションチャンク
Seeed Physical AI Beginner's Course 第15章 — ACTの入出力、 ResNetとTransformer構造、Attentionの直感、CVAE、アクションチャンクとアクションホライズン、 誤差蓄積への防御、そしてACTの能力の境界について解説します。
15.1 ビヘイビアクローンからACTへ
15.1 ビヘイビアクローンからACTへ:「良いモデル」さえあれば
第9章ではビヘイビアクローンを扱いました:テレオペレーションのデモをデータセットとして記録し、モデルに「見たとおりにやる」ことを学習させる手法です。そこで残った疑問は——このデータを託すに値するモデルとは何か?ということでした。実運用可能なポリシーモデルは、少なくとも3つのハードルを越えなければなりません:
- 画像を理解できること。
- 一貫した思考ができること。
- 蓄積する誤差に耐えられること。
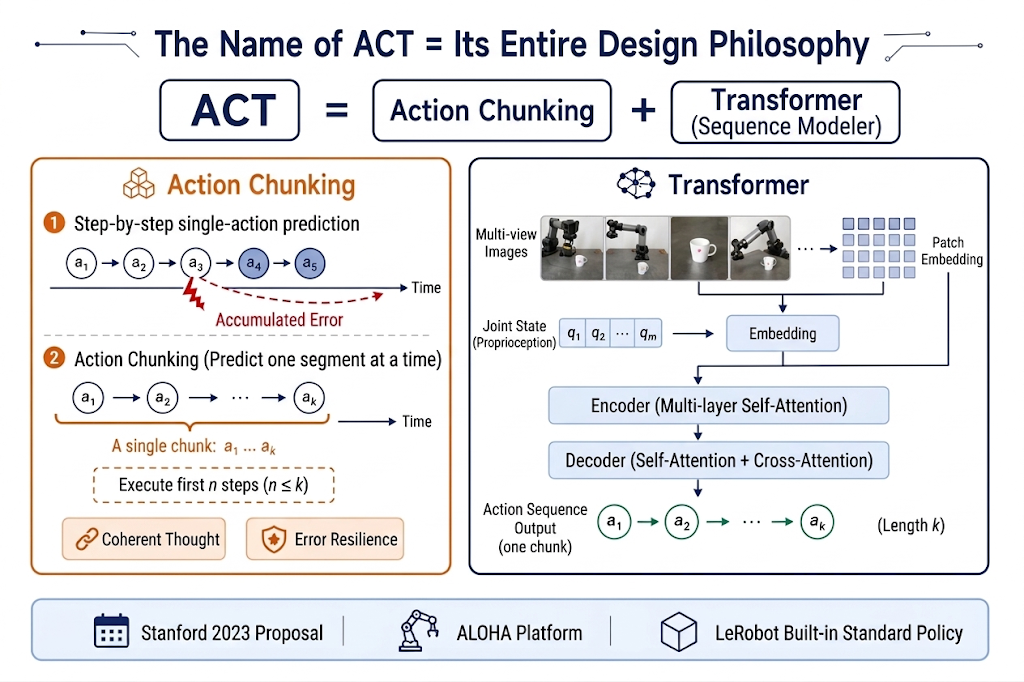
ACT(Action Chunking with Transformers) は、これら3つのハードルを越えるために作られたポリシーモデルです。2023年にスタンフォードのチームによって提案され、まず低コストなALOHA双腕プラットフォーム上で、カップのフタ開けや袋の封止といった繊細なタスクをこなすことで注目を集めました。その後、Mobile ALOHAではエビを調理するような複雑なタスクも実演されました。現在ではLeRobotに標準ポリシーの1つとして組み込まれており、このステージで実際に自分の手で学習・デプロイするモデルがまさにACTです。
ACTという名前自体が、その設計思想のすべてを表しています:Action Chunking + Transformer(系列モデラー)。この章の残りでは、この2つの用語を順に分解していきます。
15.2 ACTの入力と出力
15.2 ACTの入力と出力:まず両端を見る
どんなモデルでも、最も確実な理解の仕方は、まずその「インターフェース」を見ることです——何を入力として受け取り、何を出力するのか。
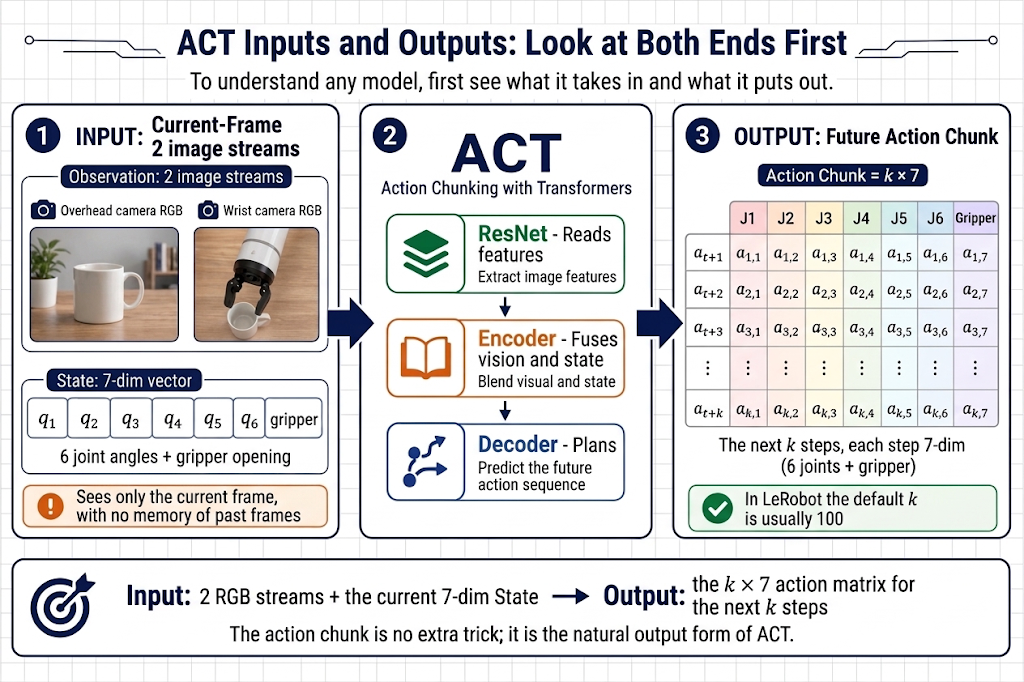
入力:現在の観測
推論時、ACTは1フレームの観測を受け取り、その中には2種類の情報が含まれます:
| 入力 | reBot Arm 上で | 次元数 |
|---|---|---|
| 画像(Observation) | オーバーヘッド + 手首のRGBデュアルフィード | 2 × 画像 |
| 関節状態(State) | 6つの関節角度 + グリッパー開度 | 7次元ベクトル |
ACTはフレーム単体のみで動作することに注意してください:過去フレームを記憶せず、各決定は「今見えているもの + 今の関節状態」に基づいて行われます。
出力:短い未来ウィンドウのアクションチャンク
ACTの出力は次の1ステップのアクションではなく、アクション系列のブロック全体(Action Chunk)です:
Input: 2 image streams + 7-dim joint state (current frame)
Output: action sequence for next k steps, each step 7-dim (6 joints + gripper)
      i.e., a k × 7 action matrix
LeRobotのACTデフォルト設定では、k(チャンクサイズ)は典型的には100です——1回の推論で、およそ100タイムステップ先までの完全なアクションプランが得られます。これは第9章での伏線への答えでもあります:Action Chunkは抽象的な最適化テクニックではなく、ACTにとって自然な出力形式なのです。
15.3 ACTの内部構造
15.3 ACTの内部構造:1本のライン上にある3つの作業場
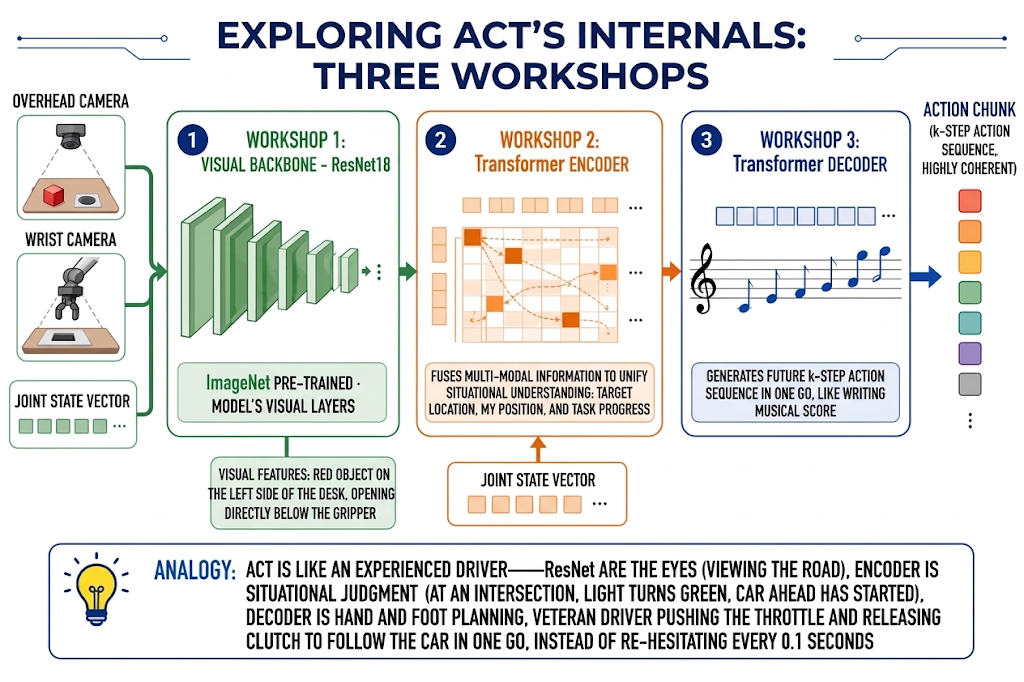
作業場1:ビジュアルバックボーン(ResNet)——ピクセルから特徴へ
オーバーヘッドカメラと手首カメラの画像はそれぞれResNet18(ImageNetで事前学習されたCNN)を通り、視覚特徴の集合へと圧縮されます。ResNetはモデルの「視覚野」と考えてください:生のピクセル自体には意味がなく、「テーブルの左側に赤い物体がある」「グリッパーの真下に開口部がある」といった構造化された情報を抽出します。
作業場2:Transformerエンコーダ——「現在」を理解する
視覚特徴 + 関節状態ベクトルが結合され、Transformerエンコーダに入力されます。エンコーダの役割は、複数の情報ストリームを統合して現在の状況の一貫した理解を作ることです:「ターゲットはどこか、自分はどこにいて、タスクはどこまで進んでいるか」。
作業場3:Transformerデコーダ——「未来」を計画する
デコーダはエンコーダが得た理解を受け取り、次のkステップ分のアクション系列を一度に生成します。アクションを1つずつ吐き出すのではなく、楽譜を書くように、ひと息で「未来の動き」全体を作曲します——これこそが、アクションチャンク内部の一貫性が非常に高い根本的な理由です。
15.4 Transformerとは何か
15.4 Transformerとは何か:Attentionの直感
ACTの作業場2と3はいずれもTransformerですが、そもそもTransformerとは何でしょうか?
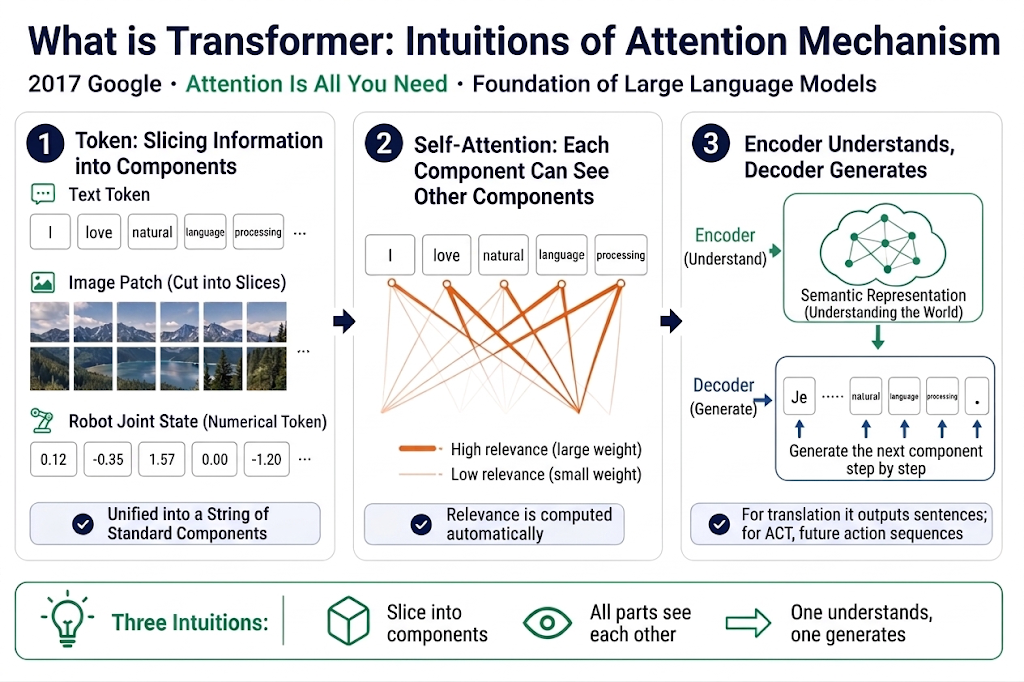
これは2017年にGoogleが機械翻訳のために提案したもので、論文タイトルは「Attention Is All You Need」です。その後、大規模言語モデルの基盤アーキテクチャとなりました。数式は不要で、3つの直感だけ押さえれば十分です:
- トークン:情報を「部品」に切り分ける。 Transformerは生の文章や生のピクセルを直接処理するのではなく、まず入力を標準化された部品(トークン)に切り分けます——文章なら単語、画像ならパッチ、関節状態ベクトルも1つのトークンになり得ます。すべての情報を「部品の列」に統一してしまえば、同じメカニズムで一括して処理できます。
- 自己Attention:各部品が他のすべての部品を「見られる」。 これがTransformerの中核です。各部品を処理するとき、その部品は他のすべての部品との関連度を計算し、最も関連の高いものから重点的に情報を取り込みます——「どこを見るべきか」は人間が決めるのではなく、モデル自身が学習します。
- エンコーダとデコーダ:片方が理解し、片方が生成する。 エンコーダは入力された部品列を統合して「現在の状況の理解」を作り、デコーダはその理解を受け取って新しい出力部品列を生成します——翻訳ではターゲット言語の文、ACTでは未来のアクション系列です。
15.5 ACTにおけるTransformerの使われ方
15.5 ACTにおけるTransformerの使われ方
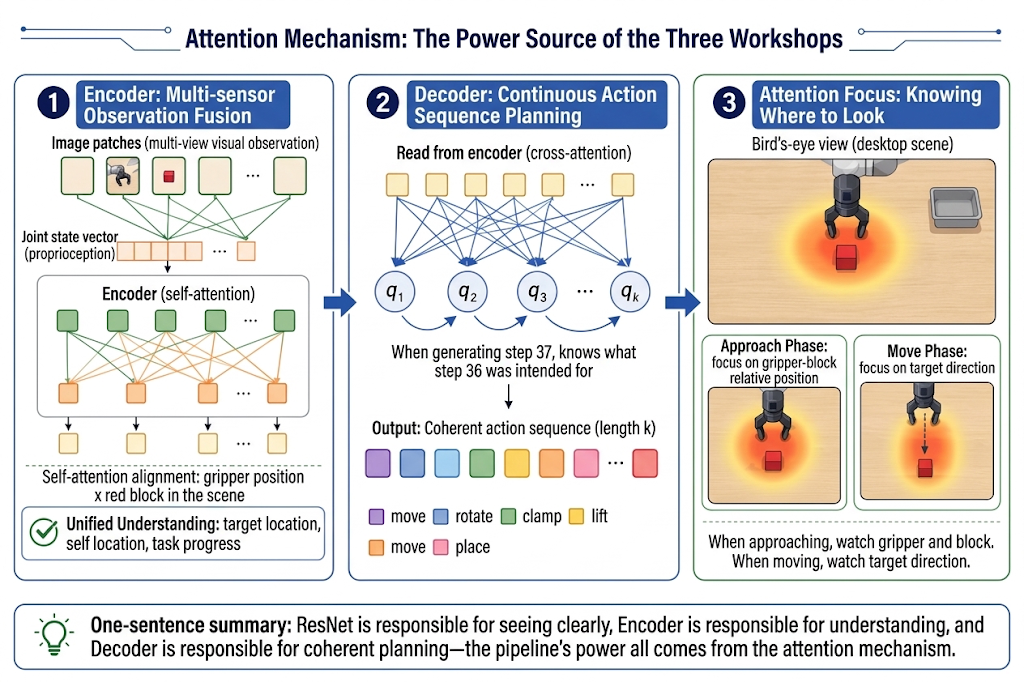
- エンコーダ内:複数の観測の統合。 両方の画像(ResNet経由)の視覚特徴パッチと関節状態ベクトルはすべてトークンとなり、エンコーダに入力されます。自己Attentionによってそれらが整合され——「グリッパーの現在位置」と「画像中の赤いブロック」が結び付けられ——ターゲットはどこか、自分はどこにいて、タスクはどこまで進んでいるかという統一的な理解が形成されます。
- デコーダ内:アクション系列全体を一度に計画。 デコーダは、k個の未来アクションステップに対応するk個のクエリベクトルを使います。これらのクエリはエンコーダの理解から情報を引き出すと同時に、自己Attentionを通じて互いに調整し合います——ステップ37のアクションは、ステップ36が何をしようとしているかを「知っている」のです。その結果、アクションブロック全体は100個の孤立した決定ではなく、一貫したまとまりになります。
- Attentionによるフォーカス:何を「見るか」を知る。 各アクションを生成するとき、モデルは自動的にその時点のアクションに最も関係の深い画像領域にフォーカスします——ターゲットへ接近するときはグリッパーとブロックの相対位置に、移動中はターゲット方向に——すべての領域を一様に扱うのではありません。
一文でまとめると:ResNetは「はっきり見る」、Transformerエンコーダは「理解する」、Transformerデコーダは「一貫して計画する」——そのすべてを支えているのがAttentionです。
15.6 CVAEとは何か
15.6 CVAEとは何か
CVAE(Conditional Variational Autoencoder、条件付き変分オートエンコーダ)。LeRobotのACTは実際にはこれを用いて学習されていますが、lerobot-train --policy.type=act というコマンドライン上にはその姿は現れません。
防いでいる落とし穴:平均は外す
CVAEの役割は、「人間の行動を1つの正解に押し込める」ことではなく、こう認めることです:現在の観測が同じでも、アクションには複数のスタイルがあり得る。学習時には、まずそのデモがどのスタイルかを特定し、そのスタイルのアクション系列を再現します。
論文では(シミュレーションタスクで)比較実験が行われています:
- デモがスクリプト(やり方が1通りだけ)の場合、CVAEを外しても成功率はほとんど変わりません。
- 人間のデータでは、CVAEを外すと成功率が約35%から2%にまで落ち込みます。
つまり CVAE は数式を見栄えよくするためのものではなく、「人間がやり方を切り替えたり、手元が不安定になったりする」ようなデータをモデルに扱わせるためのものです。
「Conditional(条件付き)」とは、「今見えているもの」に基づいて行動を生成しなければならない、という意味です — それがザリガニであれ、テーブル上のブロックであれ、でっち上げてはいけません。CVAE は「見えているものを前提に、次にどう動くかを構成する」ものです。
15.7 Action Chunk と Action Horizon
15.7 Action Chunk と Action Horizon
この章で最も厳密に区別される 2 つの概念であり、互いに独立に調整可能な 2 つのパラメータです:
- Action Chunk: モデルが1 回のフォワードパスで予測する行動列の長さ、すなわち出力行列の行数 k。LeRobot では、ACT のデフォルトのチャンクサイズは 100 です。
- Action Horizon: これら 100 ステップを予測したあと、再観測と再予測を行う前に、実際にオープンループで実行するステップ数。
両者の関係はこうです:予測されたチャンクは長くてもよいが、そのたびに最初の小さな区間だけを信頼する。
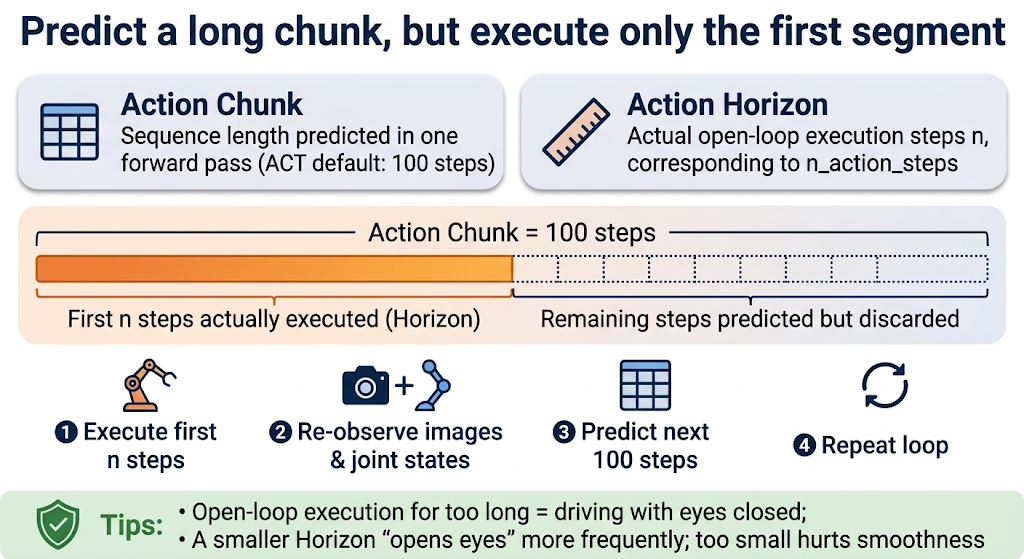
なぜ 100 ステップすべてを実行しないのでしょうか?予測は先に行くほど信頼性が下がるからです — 環境は変化し、物体はぶつかって動くかもしれず、後半に入るころにはモデルの「想定している状況」はすでに現実からずれています。**オープンループで長く実行しすぎる = 目を閉じて運転するようなものです。**Horizon が小さいほど、モデルはより頻繁に「目を開けて確認」することになり、外乱に対して頑健になりますが、小さすぎるとチャンクによる滑らかさが失われます。
車の運転中にスマホのナビを使うようなものです。ナビ(モデル)は一度にルート全体(チャンク)を計算しますが、ハンドルを固定してしまうわけではありません — 数キロごとにリアルタイムの交通状況を確認し(再観測)、ナビはそれに応じて再計画します(再予測)。「古いルートを信じてそのまま走り続ける」距離が Horizon です。
15.8 行動の連続性と誤差蓄積
15.8 行動の連続性と誤差蓄積:ACT の 2 つの防御ライン
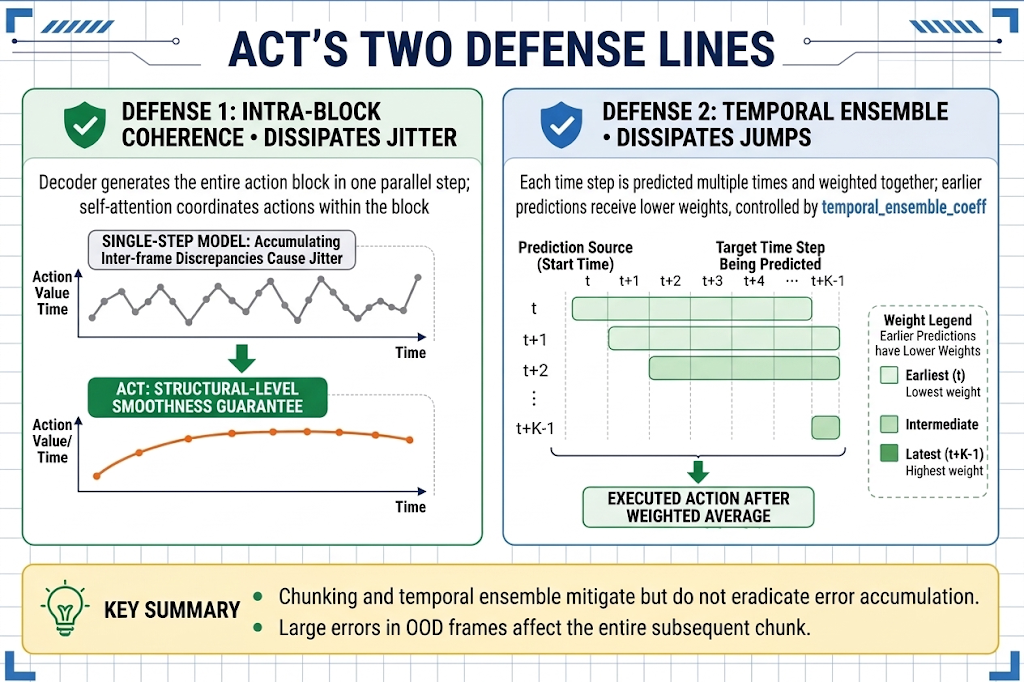
第 9 章では、実ロボットの安定性に対する 2 つの脅威として、行動のジッタと誤差の蓄積が残されていました。ここでは、ACT がそれらに対してどのように構造化された方法で対処しているかを見ていきます。
- 防御 1:チャンク内の一貫性でジッタを抑える。
- 防御 2:時間方向のアンサンブルで不連続性を抑える。
15.9 ACT に向いているタスクは?
15.9 ACT に向いているタスクは?
ACT の設計上の特徴から、その「得意分野」はかなり明確です:
| 向いているタスク | 理由 |
|---|---|
| テーブルトップ操作(把持、配置、整理、プラグの抜き差し) | ACT はこれらのタスクから生まれており、データ要求とモデルサイズが適合している |
| 単一または少数のタスク | 行動クローンはタスク固有の写像を学習するため、タスクが増えるほど必要なデータも増える |
| 短いタスク(数秒〜約 1 分) | 誤差は時間とともに蓄積するため、短いタスクの方が安定する |
| 十分な視覚情報があるタスク | 俯瞰カメラ + 手首カメラの 2 台で重要情報をカバーできるシーン |
| リソース制約のあるハードウェア | ACT はパラメータ数が比較的少なく、コンシューマー向け GPU で学習・推論でき、CPU でも推論可能 |
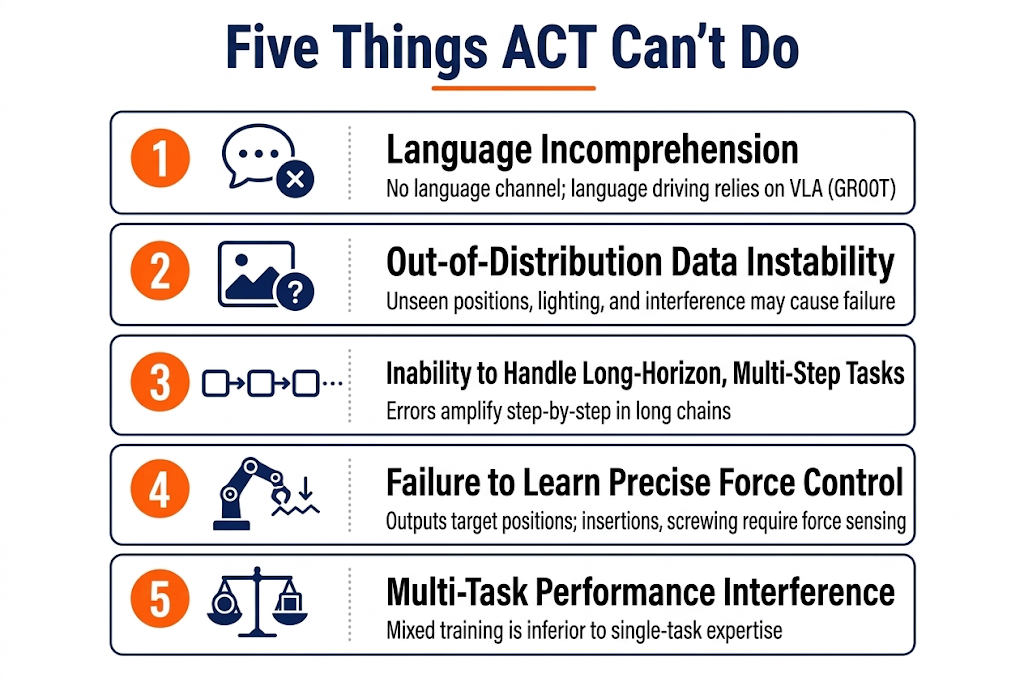
15.10 ACT の能力の境界
15.10 ACT の能力の境界
同じくらい重要なのは、「できないこと」を知ることです: