ステージ 3 · 第17章 · 理論と実践
17. 実機推論・評価・データ反復
Seeed Physical AI Beginner's Course の第17章 — 推論データフロー、 前処理と逆正規化、推論の開始、アクションチャンクの実行、安全性、 成功率評価、汎化テスト、失敗分析、および失敗駆動のデータ 収集について解説します。
この章で学ぶこと17.1 推論データフロー17.2 前処理と逆正規化17.3 実機推論の開始17.4 アクションチャンクの実行17.5 安全性:リミット・速度制限・非常停止17.6 評価:成功率と完了時間17.7 汎化テスト17.8 失敗タイプ分析17.9 データ反復:失敗駆動のデータ収集
17.1 推論データフロー
フロー
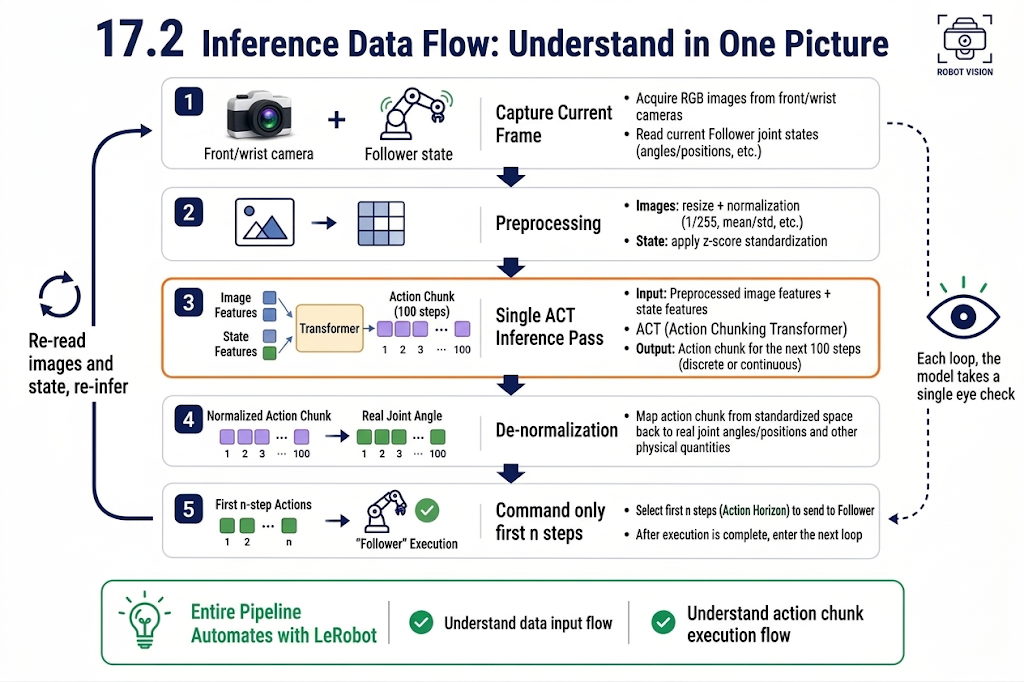
17.1 推論データフロー:1枚の図で理解する
17.2 前処理と逆正規化
前処理
17.2 前処理と逆正規化
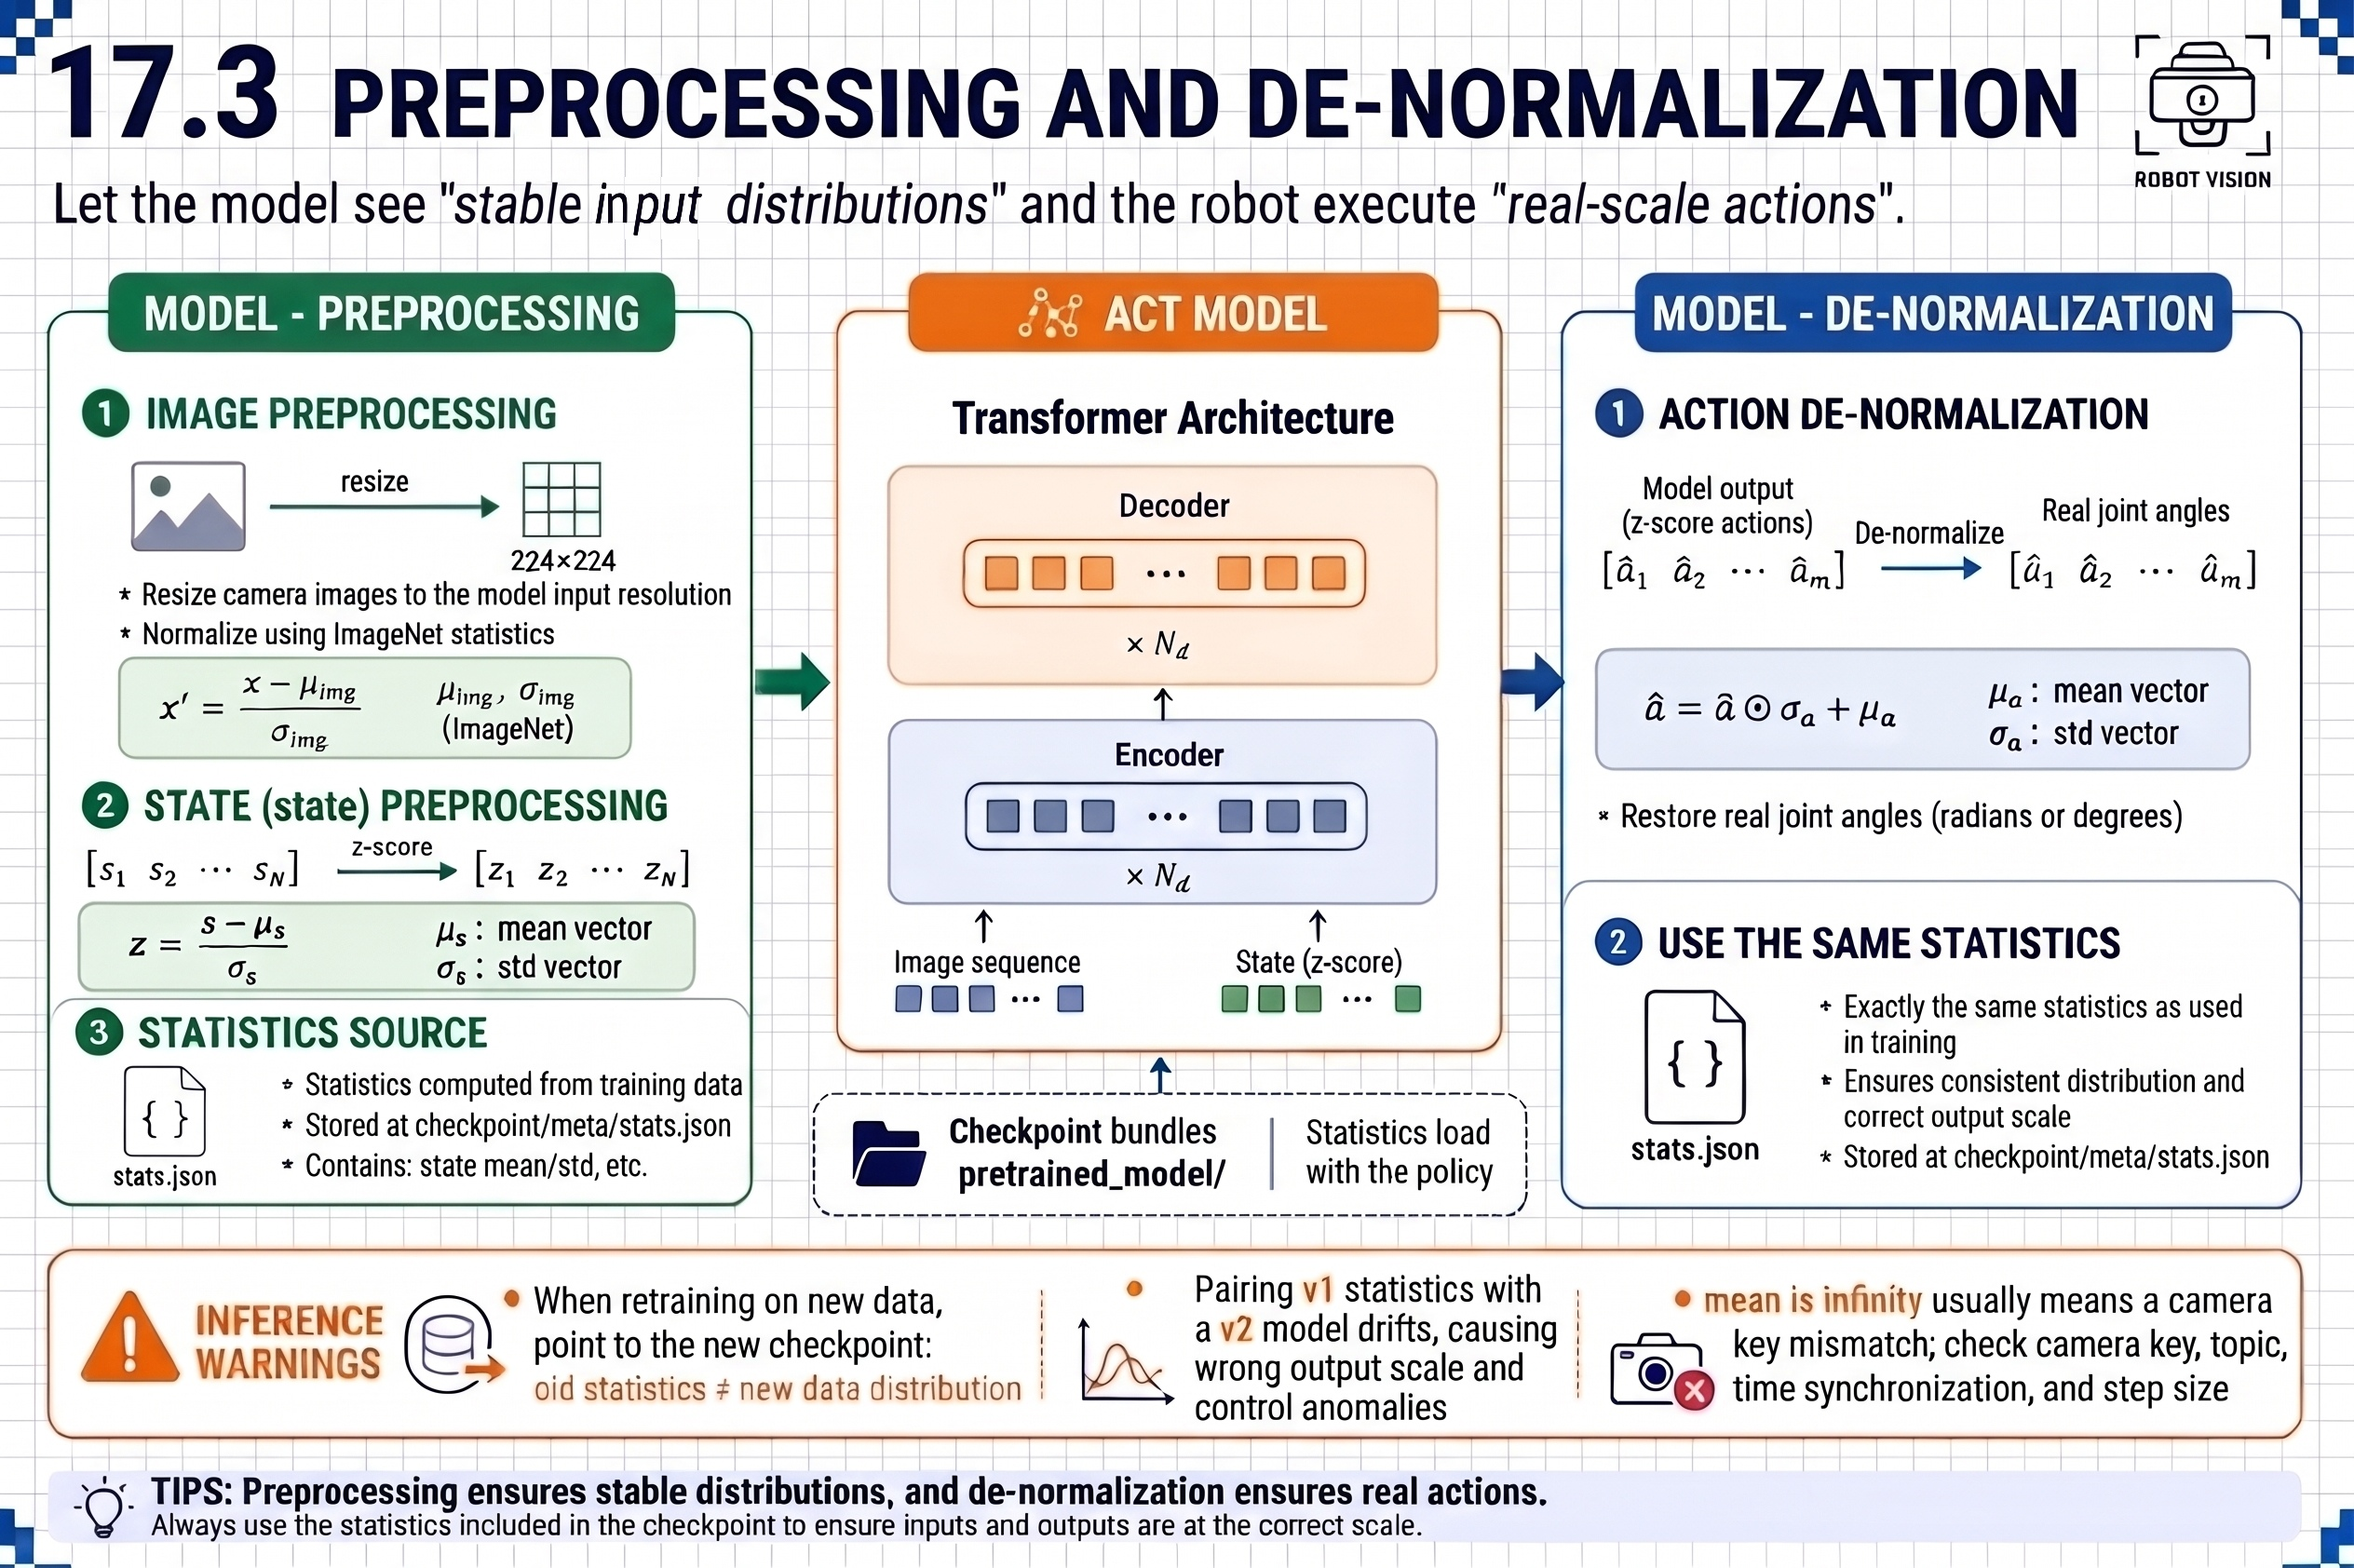
学習時にはモデルは正規化されたデータを入力として受け取ります。推論時も、入力と出力の両方について同じルールに従う必要があります:
| 方向 | 処理 | 使用する統計量 |
|---|---|---|
| モデルへの入力 | 画像リサイズ + ImageNet の mean/std;状態から平均を引き、標準偏差で割る(zスコア) | 学習データセットの meta/stats.json |
| モデルからの出力 | アクションに標準偏差を掛けて平均を足し、実際の関節角度に戻す | 上と同じ |
17.3 実機推論の開始
推論
17.3 実機推論の開始
lerobot-record を使ってポリシーを読み込みます。ロボットとカメラのパラメータはデータ収集時と同一です:
RS バージョン:
lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.can_adapter=socketcan \
  --robot.cameras='{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"} }' \
  --robot.id=follower1 \
  --display_data=false \
  --dataset.repo_id=seeed/eval_test18 \
  --dataset.single_task="Grab the crayfish into the box" \
  --dataset.num_episodes=10 \
  --dataset.episode_time_s=60 \
  --dataset.reset_time_s=10 \
  --policy.path=outputs/train/act_rebot_test/checkpoints/last/pretrained_model \
  --policy.push_to_hub=false
DM バージョン:
lerobot-record \
  --robot.type=seeed_b601_dm_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.can_adapter=damiao \
  --robot.cameras='{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"} }' \
  --robot.id=follower1 \
  --display_data=false \
  --dataset.repo_id=seeed/eval_test18 \
  --dataset.single_task="Grab the crayfish into the box" \
  --dataset.num_episodes=10 \
  --dataset.episode_time_s=60 \
  --dataset.reset_time_s=10 \
  --policy.path=outputs/train/act_rebot_test/checkpoints/last/pretrained_model \
  --policy.push_to_hub=false
--dataset.num_episodes=10: 10エピソード実行します。--dataset.episode_time_s=60: 1エピソードあたり最大60秒。タスクの所要時間に基づいて設定します — 例えばザリガニを箱に掴んで入れるタスクは約20〜30秒なので、余裕を見て30〜40秒に設定します。待たずにモデルをテストしたい場合は、エピソード間にギャップがあるため、300のようにかなり長く設定して構いません。--dataset.reset_time_s=10: エピソード間に10秒取り、物体をリセットします(評価時は初期状態をできるだけ一定に保ちます)。
17.4 アクションチャンクの実行
実行
17.4 アクションチャンクの実行
- 1回の推論で100ステップ分のアクションチャンクを出力しますが、オープンループで実行するのは最初の n ステップのみです(
n_action_steps)。その後再観測します — 先のステップほど予測の信頼性は低くなります。 - 時間的アンサンブル(
temporal_ensemble_coeff)を有効にすると、各タイムステップのアクションは複数予測の重み付き平均となり、ジッタはほぼゼロになります。 - 実機ロボットが「カクカク」動く場合、多くはチャンク間の計算ギャップが原因です — 古いチャンクが終わったのに新しいチャンクがまだ計算中という状態です。
n_action_stepsを増やすと改善しますが、その分外乱への強さは弱くなります。
17.5 安全性:リミット・速度制限・非常停止
安全性
17.5 安全性:リミット・速度制限・非常停止
- 必ず ESC で停止し、Ctrl+C は使わないでください。停止前に、アームが現在のアクションチャンクを完了するか、手動で安全な姿勢に戻してから止めてください。荷重がかかった中空姿勢のまま停止するのを避けるためです。
- いつでも電源を切れるように準備しておき、アームが異常な挙動をした場合は緊急電源オフが必要です。
17.6 評価:成功率と完了時間
評価
17.6 評価:成功率と完了時間
開始条件を固定し、連続して20回テストし、それぞれを記録します。
- 成功率 = 成功回数 ÷ 20。 最初に学習したモデルとしては、50%以上なら普通のスタート、80%以上なら非常に優秀です。
- 完了時間: 安定性を確認します — 成功した試行の所要時間は似通っていますか?速度がバラバラなら、そのポリシーは「ためらっている」状態です。
- 失敗した試行については、単に ✗ を付けるだけでなく、失敗モードも記録します。
17.7 汎化テスト
汎化
17.7 汎化テスト
標準条件でのテストが終わったら、条件を1つずつ変化させ、成功率がどの程度落ちるかを確認します(50 Episodes の ACT では汎化性能はそれほど高くないため、データ追加を推奨します)。
| テスト | 方法 | 期待される結果 |
|---|---|---|
| 位置の汎化 | ブロックを5つの鉛筆ポイントの外だが学習カバー範囲内に置く | ほとんど低下しないはず;低下するなら位置の多様性が不足 |
| 軽微な外乱 | 関係ない物体をテーブル上に置く | 視覚的にクリーンな環境で学習したモデルなら影響を受けないはず |
| 大きな分布シフト | 全く新しい物体、鏡面反射する面 | 失敗して当然であり、無理に直す必要はない |
汎化テストの目的は、モデルの強さを誇示することではなく、能力の境界をマッピングすることです — その境界内では自由に使い、境界の外側はデータを追加して徐々に広げていきます。
17.8 失敗タイプ分析
失敗
17.8 失敗タイプ分析
| 失敗タイプ | 最もありそうな原因 | 対策 |
|---|---|---|
| 到達できない:誤った位置に向かって動く | その位置でのデータカバーが不足(分布外) | その領域でデモを追加収集する |
| 把持が不安定:触れるが保持できない/落とす | グリッパーを閉じるタイミングの学習が不正確;把持瞬間のデモが少なすぎる | 把持瞬間の高品質なデモを追加する |
| 全体的にランダムな動きで、行動が支離滅裂 | 学習がまったく収束していない、またはシーン/照明が大きく変化した | データ収集時のシーンと照明が推論時と一致しているか確認する |
ヒント
まず設定ミスを疑い、その次にデータ問題を疑う — ランダムな動きは設定の病気、到達不能はデータの病気です。
17.9 データ反復:失敗駆動のデータ収集
反復
17.9 データ反復:失敗駆動のデータ収集
ループの最終ステップは、失敗をデータに変換することです:
- 分類: 失敗タイプと対応するシーンを特定します。
- 補強: その失敗シーンについて新たに10〜20本のデモを記録します — 到達できない?その位置で記録する;把持が不安定?把持瞬間を記録する。把持境界を意識的に徐々に広げていきます — 例えば、元の十字から5〜10 cm 外側のポイントにブロックを置き、データセットを拡張します。
- 再学習: 新しいデータセットで再学習します。
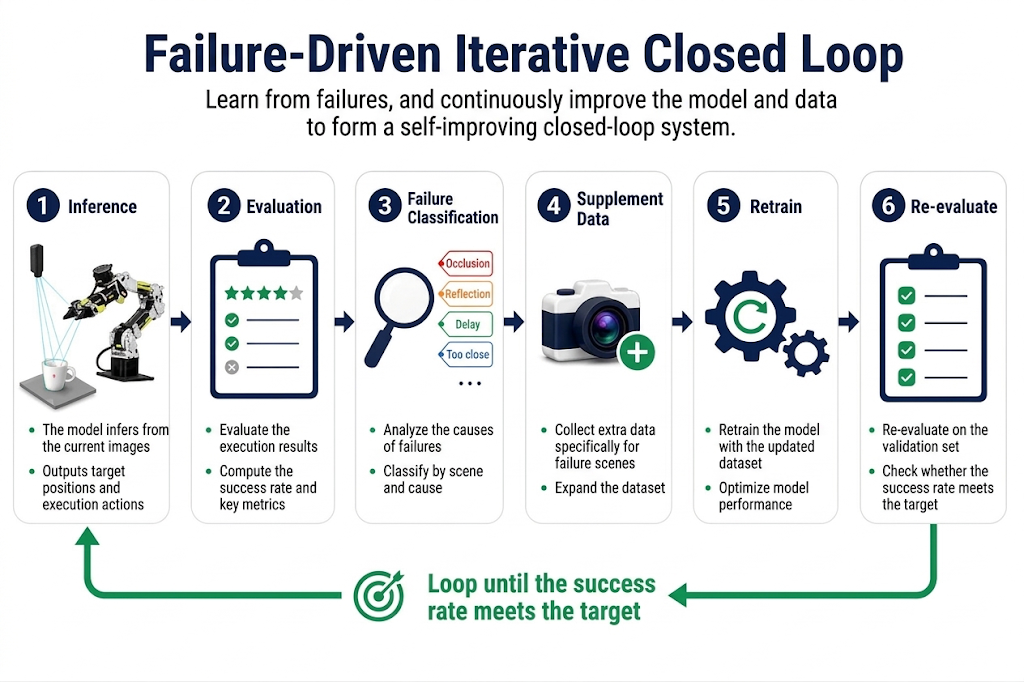
これにより、本章の冒頭で示したクローズドループが完全に完成します。遠隔操作、収集、検査、学習、推論、評価、反復 ―― このパイプラインは、新しいタスクごとにそのまま再利用されます。これこそがステージ3の中核となる成果物です。