9. ロボット学習と模倣学習の基礎
Seeed Physical AI初心者コース第9章 — なぜアームに学習が必要なのか、 ルールベース制御と学習ベース制御の違い、観測/状態/行動、アクションチャンク、データ 分布、および学習・推論・評価という3つのフェーズについて解説します。
9.1 なぜロボットアームに学習が必要なのか
9.1 なぜロボットアームに学習が必要なのか
ステージ2では、Python SDK を使ってすでにロボットアームを制御できます:関節角度の読み取り、目標位置の送信、グリッパーの開閉などです。そうすると自然にこう考えるでしょう — テーブル上のブロックをアームが自動で拾うプログラムを書けばいいだけでは?と。
そこでそのようなプログラムを書きます。研究室での最初のデモでは、プログラムはうまく動作しました。しかし翌日になると状況が変わり — それらの変化に対応しようとすると、プログラムにはどんどん「if」文が追加されていき、最終的には誰も保守できない巨大な特殊ケース集になってしまいます。
これが従来型のプログラム制御が抱える根本的なジレンマです:現実世界は連続的に変化する一方で、if-else は離散的です。 世界のあらゆる状態を列挙することはできません。
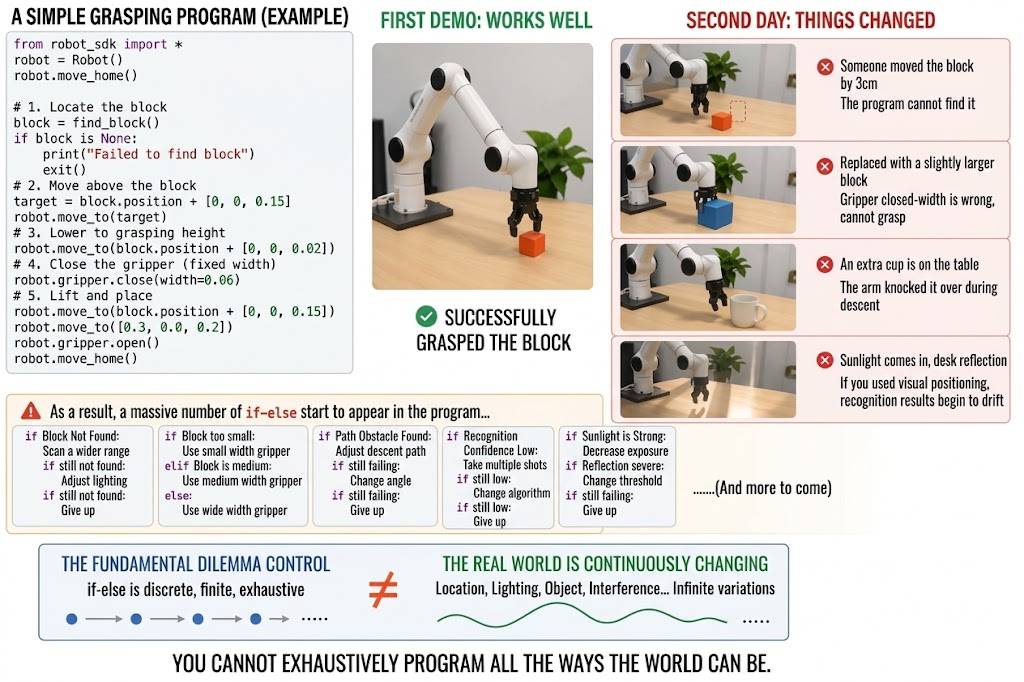
このような形でロボットアームにスキルを獲得させることこそが、ロボット学習が解決しようとしている課題です。 そして本ステージで扱う模倣学習は、最も成熟しており、実機への導入が最も容易なアプローチです。
9.2 ルールベース制御 vs 学習ベース制御
9.2 ルールベース制御 vs 学習ベース制御
先へ進む前に、この2つの制御アプローチを並べて、違いをはっきりさせましょう。
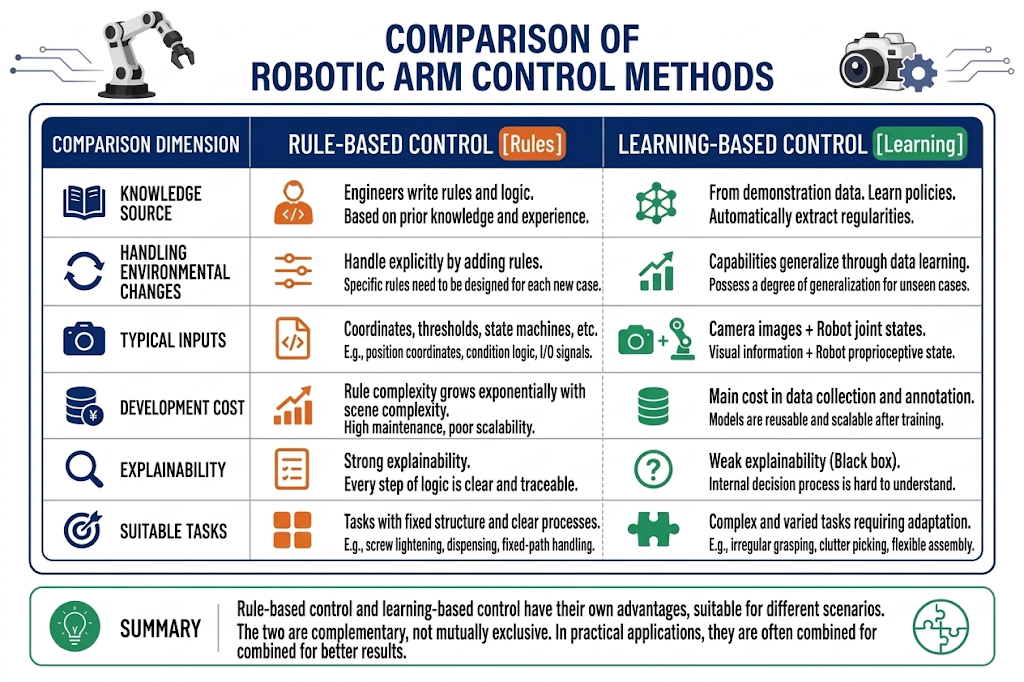
本コースのステージ3と4は、「学習ベース制御」の道筋に沿っています。ただし覚えておいてください:将来においても、あなたの学習システムには依然として多くのルールが残ります — 例えば関節リミットや安全な速度制約などです。学習とルールは相補的な関係にあります。
9.3 模倣学習と Behavioral Cloning
9.3 模倣学習と Behavioral Cloning
模倣学習とは
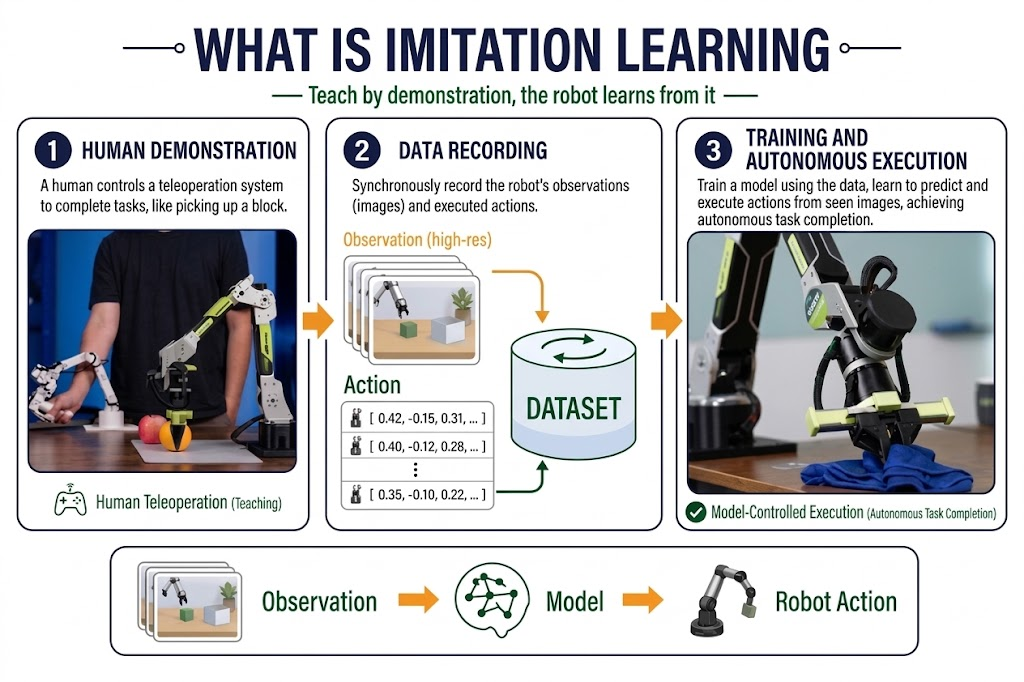
Behavioral Cloning とは
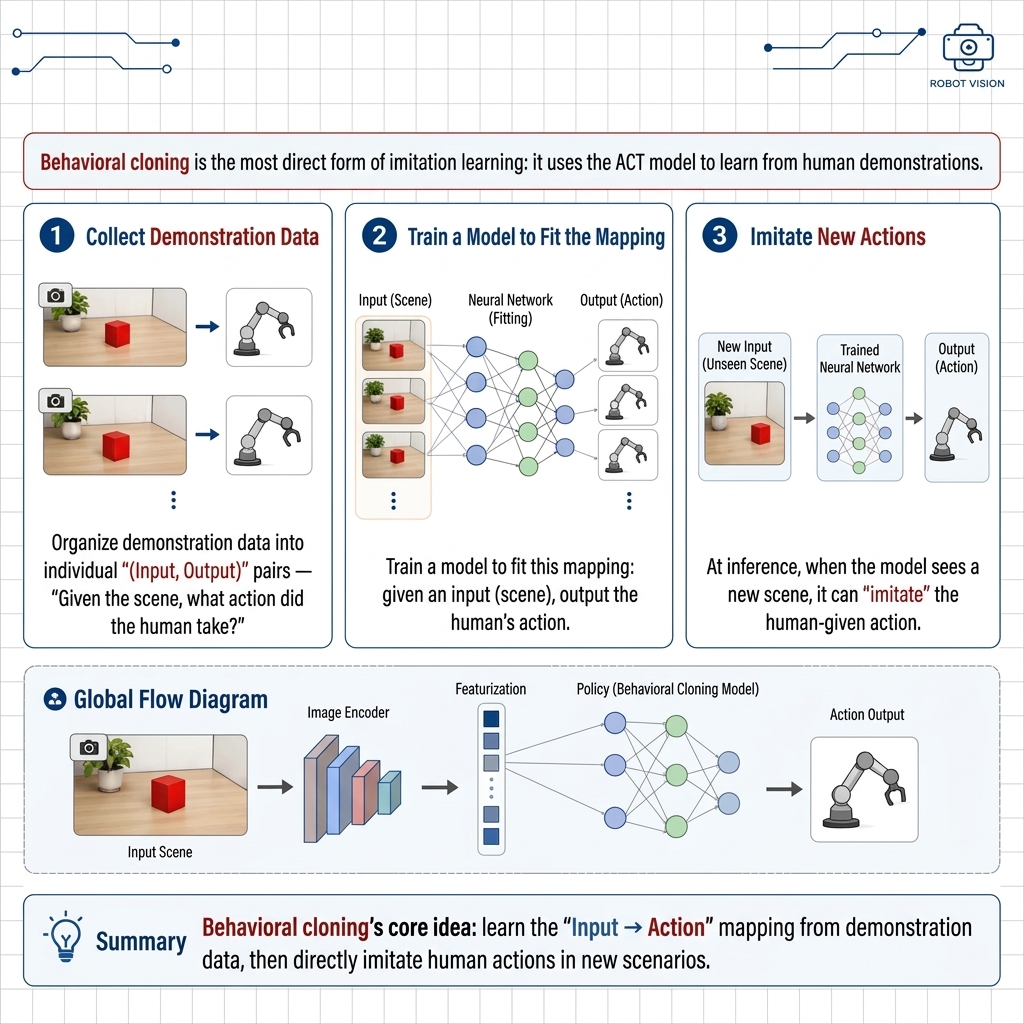
9.4 観測・状態・行動
9.4 観測・状態・行動
模倣学習におけるすべてのデータは、3つの概念に分類できます。これら3つの用語は、この先のすべての章で繰り返し登場するので、ここで正確な直感を身につけておきましょう。
- 観測 (Observation): ロボットが「見ている」世界。
- 状態 (State): ロボット自身の「いまの状態」。
- 行動 (Action): ロボットが「これから行うこと」。
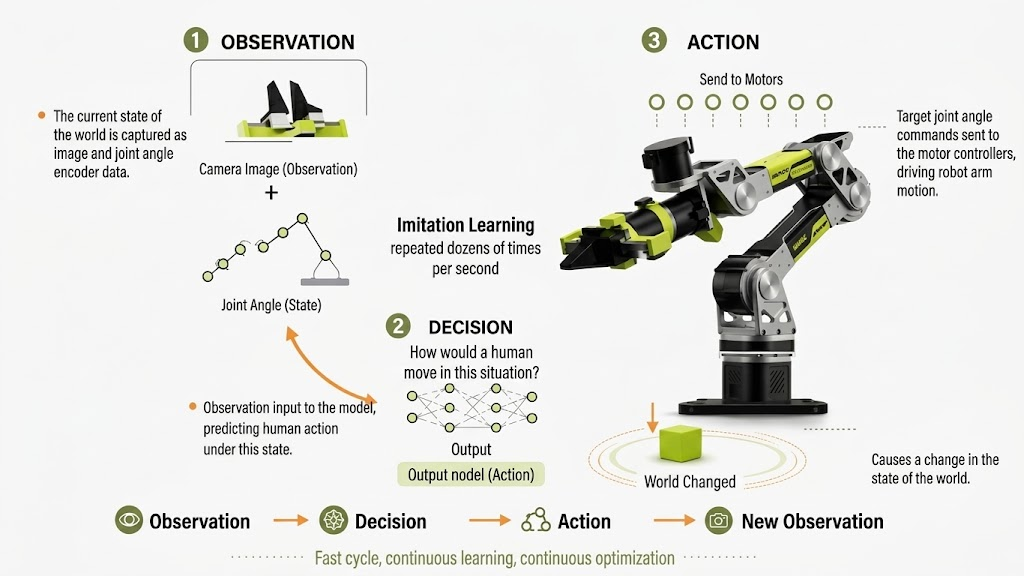
9.5 単一ステップ行動 vs アクションチャンク
9.5 単一ステップ行動 vs アクションチャンク
- 単一ステップ行動: 1フレームごとに1回の意思決定を行う。
- アクションチャンク: 一度に一連の行動シーケンスを予測する。
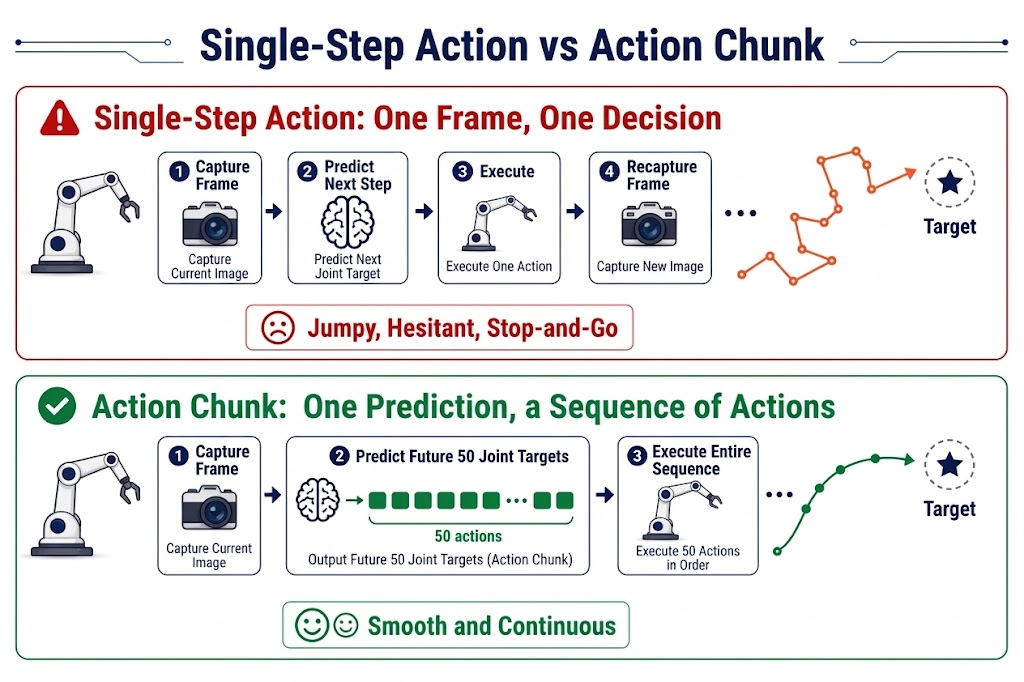
もちろん、アクションチャンクは長ければ長いほど良いというわけではありません。先のことを予測しすぎると、その実行の途中で環境が変化してしまうかもしれません(例:物体がぶつかって動く)、その一方でアームは依然として「古くなった」行動を実行し続けてしまいます。実際のシステムでは折衷案が取られます:短い区間だけオープンループで実行し、その後もう一度観測して再予測します。
9.6 データ分布とモデルの汎化
9.6 データ分布とモデルの汎化
ここは本章で最も重要なセクションであり、初心者が最も見落としやすい部分ですが、実運用での成否を左右します。まずは次の一文を覚えてください:
模倣学習モデルは、データに含まれているものだけを学習でき、データがカバーしている範囲の中でしか機能しません。
- 学習中にモデルが見たすべての(観測, 行動)の組が データ分布 を構成します。推論時に、アームが遭遇する画像や状態がこの分布の範囲内に収まっていれば、モデルは概ね良好に動作しますが、一度分布の外に出てしまうと、モデルの出力は根拠を失い、その振る舞いは予測不能になります。
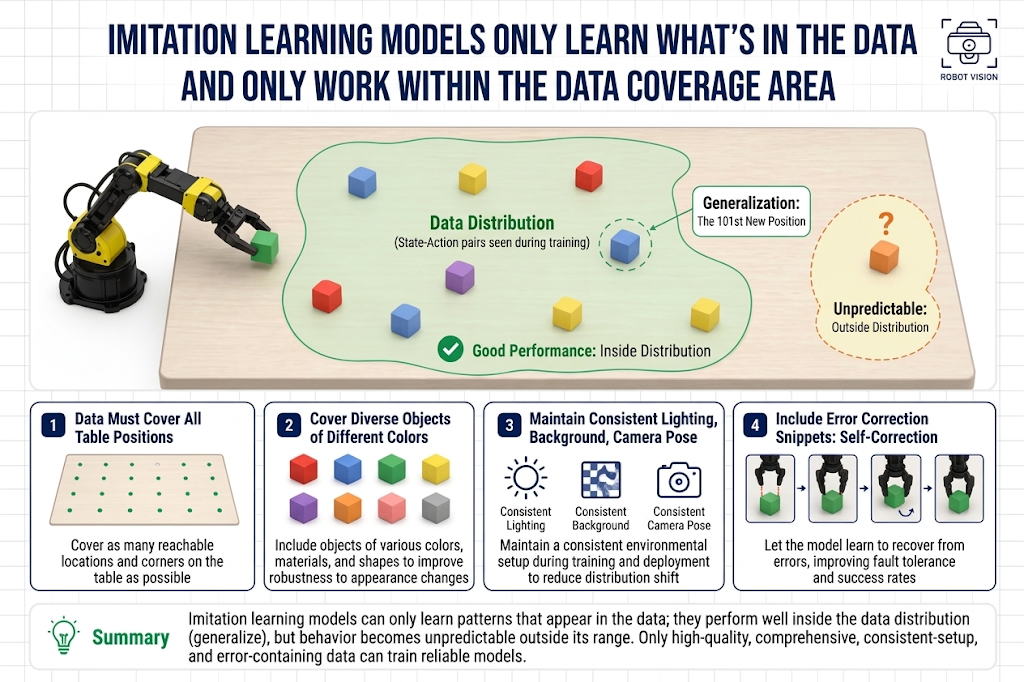
ここから、非常に実践的な含意がいくつか導かれます:
- テーブル上の任意の位置にあるブロックをつかませたいなら、データはテーブル上のすべての位置をカバーしていなければなりません — もしテーブル中央のデータだけを集めたなら、モデルは中央でしかつかめません。
- 異なる色の物体をつかませたいなら、データには異なる色が含まれていなければなりません — そうでなければ、新しい色はモデルにとって未知の世界です。
- 照明、背景、カメラ位置は、データ収集時とできるだけ一貫させる必要があります — 午後に集めたデータで学習したモデルが、夜の室内照明の下ではまったく機能しない、ということもあり得ます。
そして 汎化 とは、モデルがデータから学んだパターンを、分布の範囲内にあるが個別には見たことのない新しい状況に適用する能力のことです。例えば、学習時にブロックが100通りの位置にあるデータを見ていて、推論時に101番目の位置(依然としてテーブル上)にブロックが現れたとしても、モデルがそれをつかめる — これが汎化です。汎化は魔法ではなく、データの 多様性 から生まれます:データのカバー範囲が豊かで連続的であればあるほど、分布内の「すき間」は小さくなり、汎化性能は高まります。
模倣学習の上限は、本質的にはデータを収集した瞬間に決まっています。学習はその上限を実現しているに過ぎません。
9.7 学習・推論・評価
9.7 学習・推論・評価
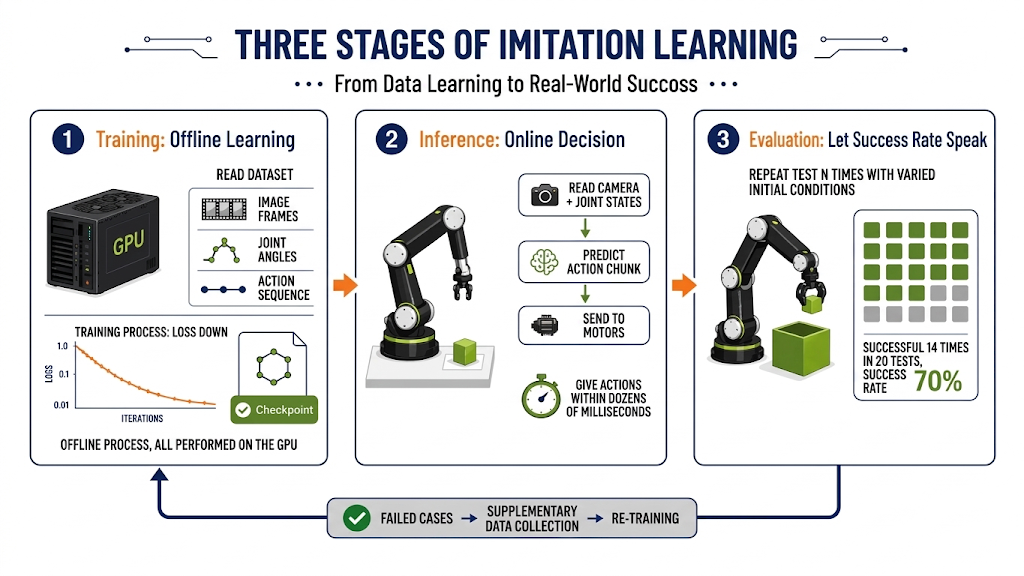
学習:オフライン学習
学習はデータ収集が完了した後に行われる、オフライン のプロセスです:アームの電源は切って脇に置いておけます;作業はすべて GPU 上で行われます。
- 入力: 収集したデータセット(画像・状態・行動の時系列);
- 処理: モデルがデータを繰り返し読み込み、その内部パラメータを継続的に調整して、人間のデモンストレーションに対する予測行動が徐々に一致するようにする;
- 出力: 学習済みモデルファイル。
学習の質は主に Loss を通して観察します:Loss が下がるほど、モデルの予測行動は人間のデモンストレーションに近づいていきます。
推論:オンライン意思決定
推論とは、モデルを 実際のロボットにデプロイし、リアルタイムに動作させる プロセスです:カメラ画像と関節状態を読み取る → モデルが Action Chunk を予測する → それをモーターに送って実行させる。推論にはリアルタイム性の要求があります — モデルは数十ミリ秒以内に行動を出力しなければならず、そうでないとアームがカクついてしまいます。
評価:成功率で判断する
モデルは学習され、Loss も低い — では本当にタスクをこなせるのでしょうか?必ずしもそうとは限りません。
Loss が低いということは、モデルが「人間らしい」というだけであり、「タスクを完遂できる」ことを意味しません。 唯一信頼できる評価方法は、実機ロボットでのテストです:
- 明確なタスク成功基準を設定する(例:「ブロックが箱の中に入る」など);
- 初期条件(ブロックの位置、照明)を変え、テストを N 回繰り返す;
- タスク成功率を計算する — 例:20 回のテストのうち 14 回成功 = 成功率 70%。
評価中に見つかった失敗ケースは終着点ではなく、次のデータ収集ラウンドの入力です — 失敗が発生したところで追加データを収集し、その後再学習します。これがデータ反復ループであり、実際のロボット学習プロジェクトの日常業務です。
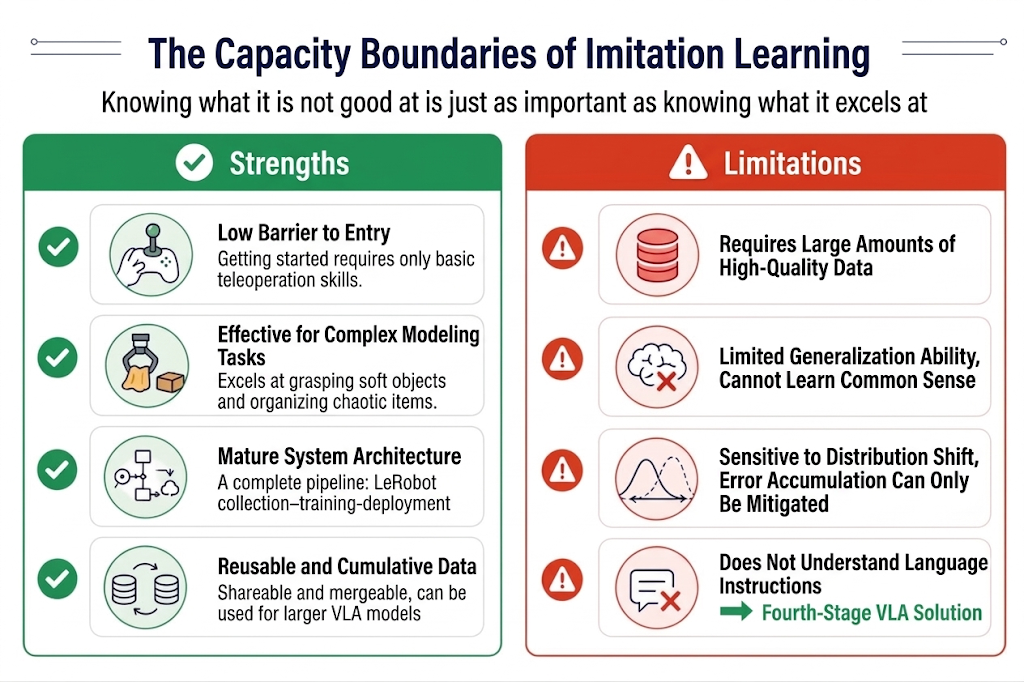
9.8 模倣学習の利点と限界
9.8 模倣学習の利点と限界