reBot Arm で ACT をデプロイして評価する方法
ACT を実ロボット上で動かし、前処理とアクションチャンクの実行を理解し、成功を測定し、失敗を分析してデータを改善します。
- オンロボット推論
- アクションチャンクの実行
- 評価
- データ反復
推論データフローの概要
前処理と非正規化
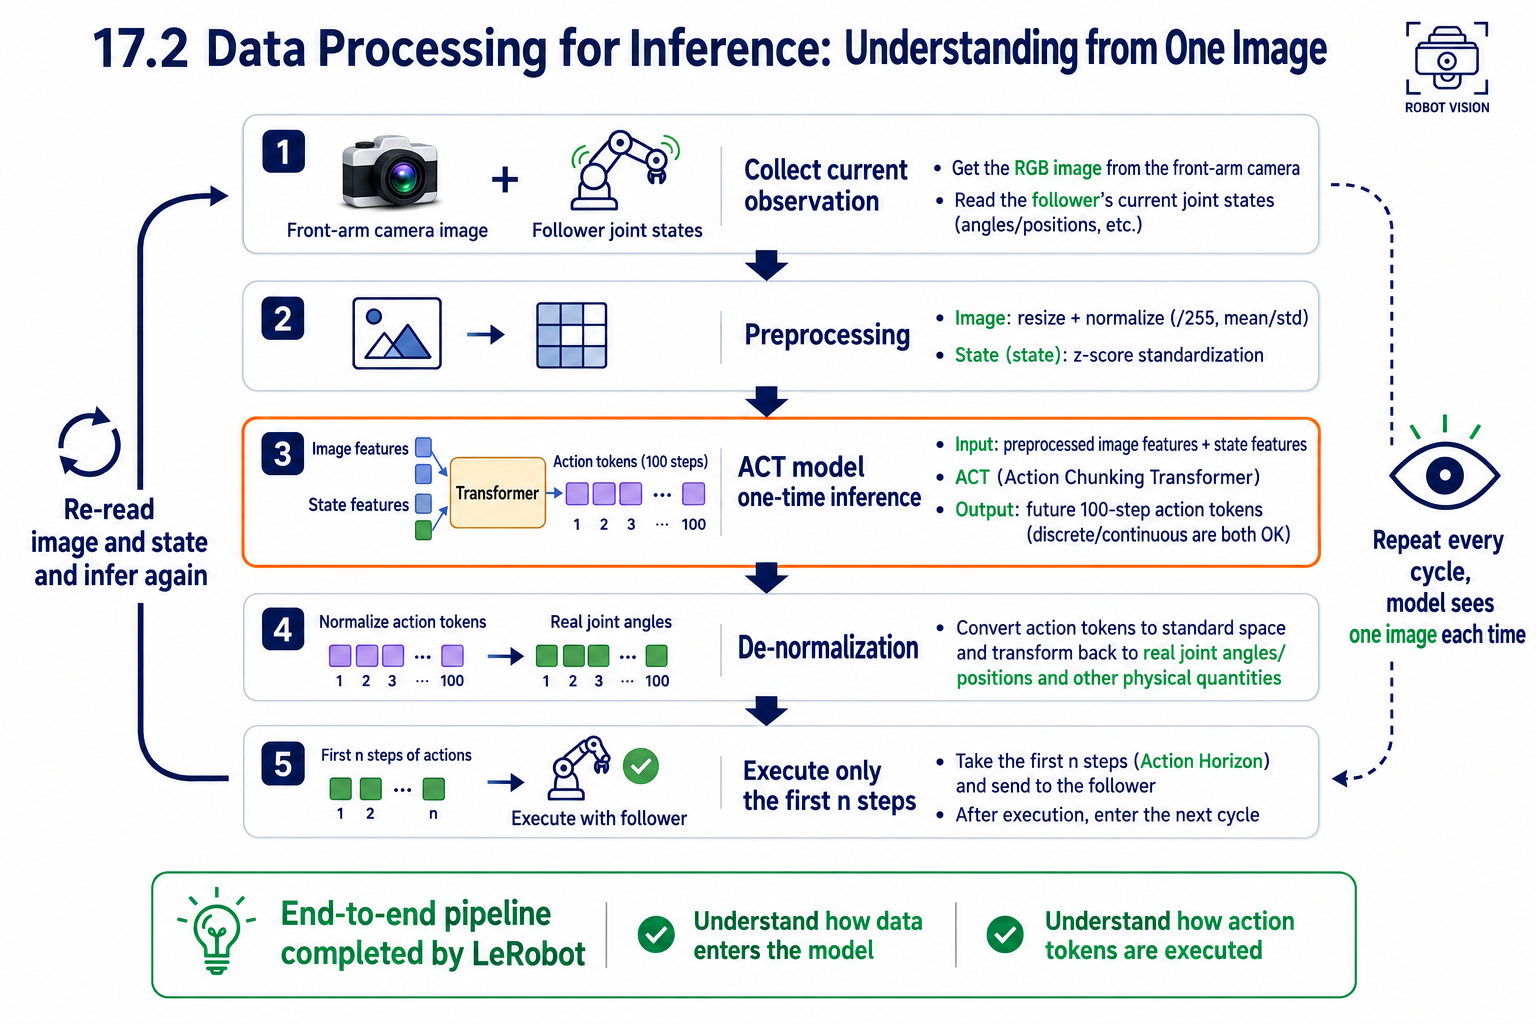
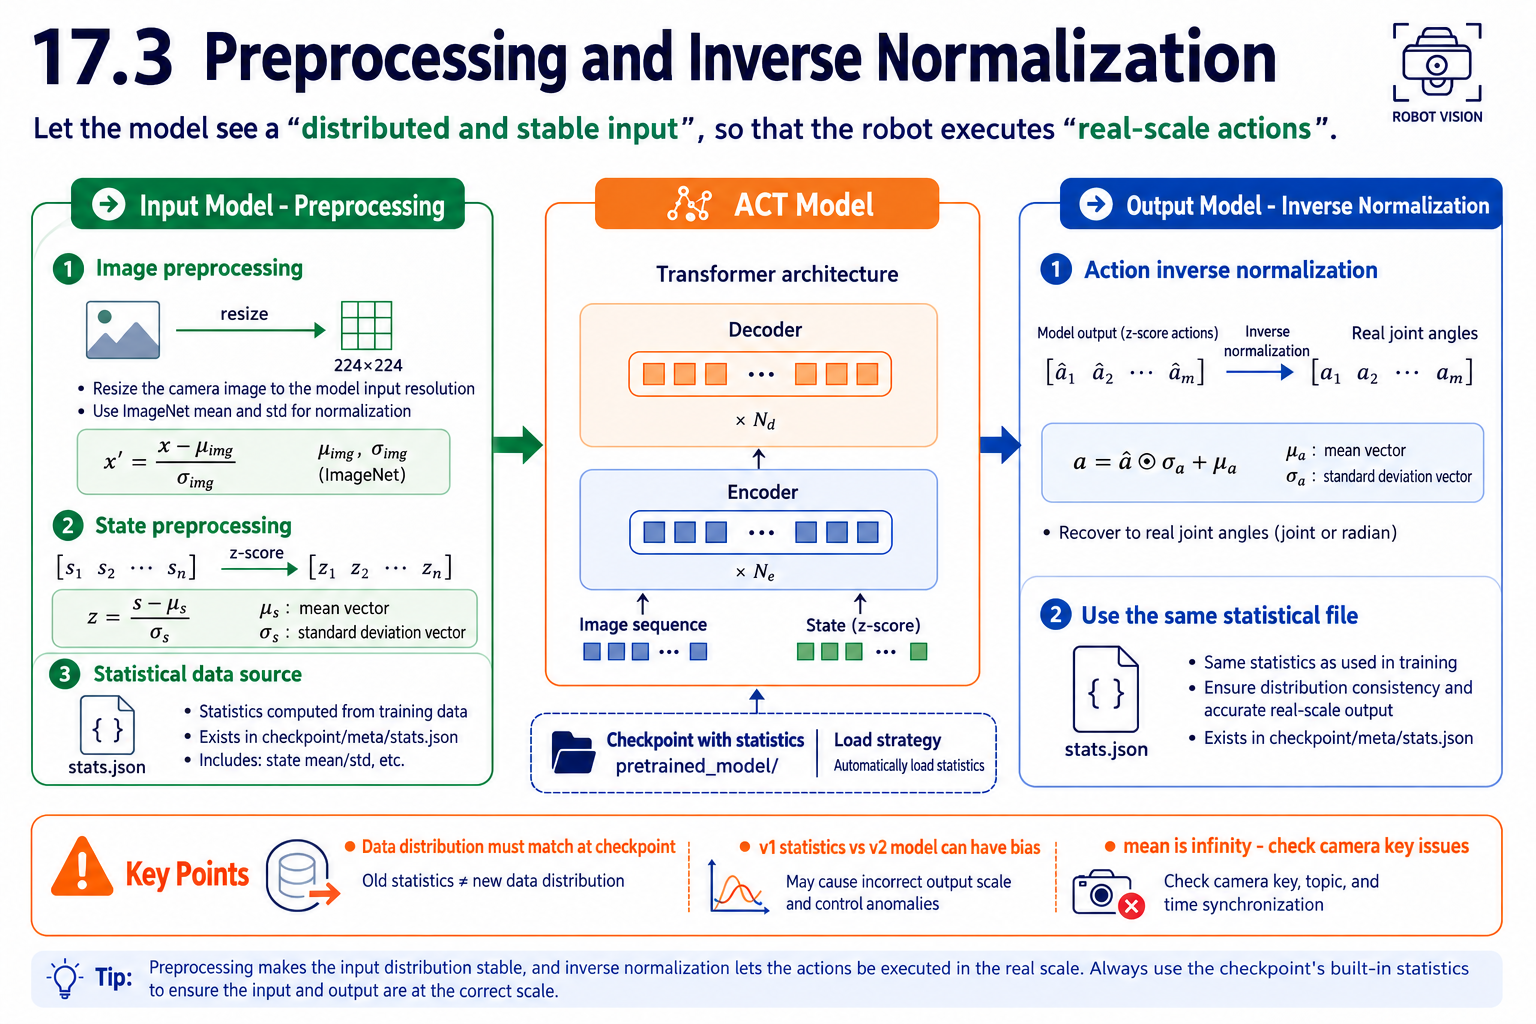
このモデルは正規化されたデータで学習されているため、推論時にも同じ入出力ルールを適用する必要があります:
| 方向 | 処理 | 統計量 |
|---|---|---|
| モデルへの入力 | 画像をリサイズし ImageNet 正規化を適用する;状態の平均を引き、標準偏差で割る(z スコア)。 | 学習データセット meta/stats.json |
| モデルからの出力 | 物理的な関節角度を復元するため、アクションに標準偏差を掛けて平均を足す。 | 同じ統計量 |
オンロボット推論を開始しデータを反復する
lerobot-record でポリシーを読み込みます。収集時とまったく同じロボットおよびカメラパラメータを使用してください:
RS バージョン:
lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.can_adapter=socketcan \
  --robot.cameras='{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"} }' \
  --robot.id=follower1 \
  --display_data=false \
  --dataset.repo_id=seeed/eval_test18 \
  --dataset.single_task="Grab the crayfish into the box" \
  --dataset.num_episodes=10 \
  --dataset.episode_time_s=60 \
  --dataset.reset_time_s=10 \
  --policy.path=outputs/train/act_rebot_test/checkpoints/last/pretrained_model \
  --policy.push_to_hub=false
DM バージョン:
lerobot-record \
  --robot.type=seeed_b601_dm_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.can_adapter=damiao \
  --robot.cameras='{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"} }' \
  --robot.id=follower1 \
  --display_data=false \
  --dataset.repo_id=seeed/eval_test18 \
  --dataset.single_task="Grab the crayfish into the box" \
  --dataset.num_episodes=10 \
  --dataset.episode_time_s=60 \
  --dataset.reset_time_s=10 \
  --policy.path=outputs/train/act_rebot_test/checkpoints/last/pretrained_model \
  --policy.push_to_hub=false
-
--dataset.num_episodes=10: 10 エピソードの評価を記録します。 -
--dataset.episode_time_s=60: 1 エピソードあたり最大 60 秒を許可します。これはタスクの所要時間に合わせて設定します:ザリガニを箱に入れるのに 20〜30 秒かかるなら、30〜40 秒を許可します。エピソード間の待ち時間なしで長時間観察したい場合は、300 秒などの長い時間を使用できます。 -
--dataset.reset_time_s=10: エピソード間で物体の位置を戻すために 10 秒を確保します。評価中は開始条件をできるだけ一定に保ってください。
アクションチャンクの実行
-
1 回の推論で 100 ステップ分のアクションチャンクを予測します。最初の n ステップだけをオープンループで(
n_action_steps)実行し、その後再度観測します:将来のステップほど予測は信頼性が低くなります。 -
時間的アンサンブル(
temporal_ensemble_coeff)を用いると、各タイムステップのアクションは重なり合う予測の加重平均となり、より滑らかな軌道になります。 -
チャンクが終わってから次の推論が準備できるまでの間に、目に見える一時停止が発生することがよくあります。
n_action_stepsを増やすとこれらの一時停止を減らせますが、その代わり外乱への応答は遅くなります。
安全性:リミット、速度、非常停止
-
セッションを終了するには ESC を使用し、Ctrl+C は使用しないでください。 停止する前に、アームが現在のアクションチャンクを完了するか、手動で安全な姿勢に戻してください(現在 Ctrl+C でもロボットはゼロ姿勢に戻りますが)、負荷がかかったまま宙吊り状態で止まらないようにします。
-
アームが異常な動きをした場合、すぐに電源を切れるよう準備しておいてください。
成功率と完了時間を評価する
開始条件を固定し、20 回の試行を行ってそれぞれの結果を記録します。
-
成功率 = 成功した試行 ÷ 20。 最初に学習したモデルでは、50% を超えれば一般的な出発点であり、80% を超えれば非常に優秀です。
-
完了時間は一貫性を示します。成功した試行は似た時間で完了するはずであり、大きなばらつきはためらいがあることを示唆します。
-
失敗については、単にバツ印を付けるのではなく、失敗モードを記録します。
汎化性能をテストする
標準条件でのテスト後、条件を 1 つずつ変更し、そのたびに成功率の低下を測定します。50 エピソードで学習した ACT モデルの汎化は限定的であり、より広いカバレッジにはより多くのデモが必要です。
| テスト | 方法 | 期待される挙動 |
|---|---|---|
| 位置の汎化 | ブロックを 5 つのマーク位置から外しつつ、デモされた領域内に配置する。 | 劣化はわずかなはず;低下が大きい場合は位置の多様性が不十分であることを示唆します。 |
| 軽度の撹乱 | 関係のない物体をテーブルに追加する。 | 視覚理解がしっかりしたモデルであれば影響を受けないはずです。 |
| 明確な分布シフト | まったく新しい物体や反射するテーブルトップを使用する。 | 学習分布の外では失敗が予想されます。 |
目的は、モデルの能力境界をマッピングし、その後データを増やして徐々に拡張していくことです。
失敗タイプを分析する
| 失敗 | 最もありそうな原因 | 対応 |
|---|---|---|
| 誤った位置に向かって到達する | その位置でのデータカバレッジ不足、または分布シフト。 | その領域でより多くのデモを収集する。 |
| 物体に接触するが保持できない、または落としてしまう | 閉じるタイミングの学習が不十分、または把持例が少なすぎる。 | 把持の瞬間に焦点を当てた高品質なデモを追加する。 |
| 全体的に挙動が不安定 | 学習が収束していない、またはシーンや照明が大きく変化している。 | 収集時のシーンと照明が推論時と一致しているか確認する。 |
データのせいにする前に、設定の問題を除外してください。 不安定な動きは多くの場合設定の確認が必要であり、不正確な到達はより良いカバレッジが必要であることが多いです。
データ反復:失敗ケースのために収集する
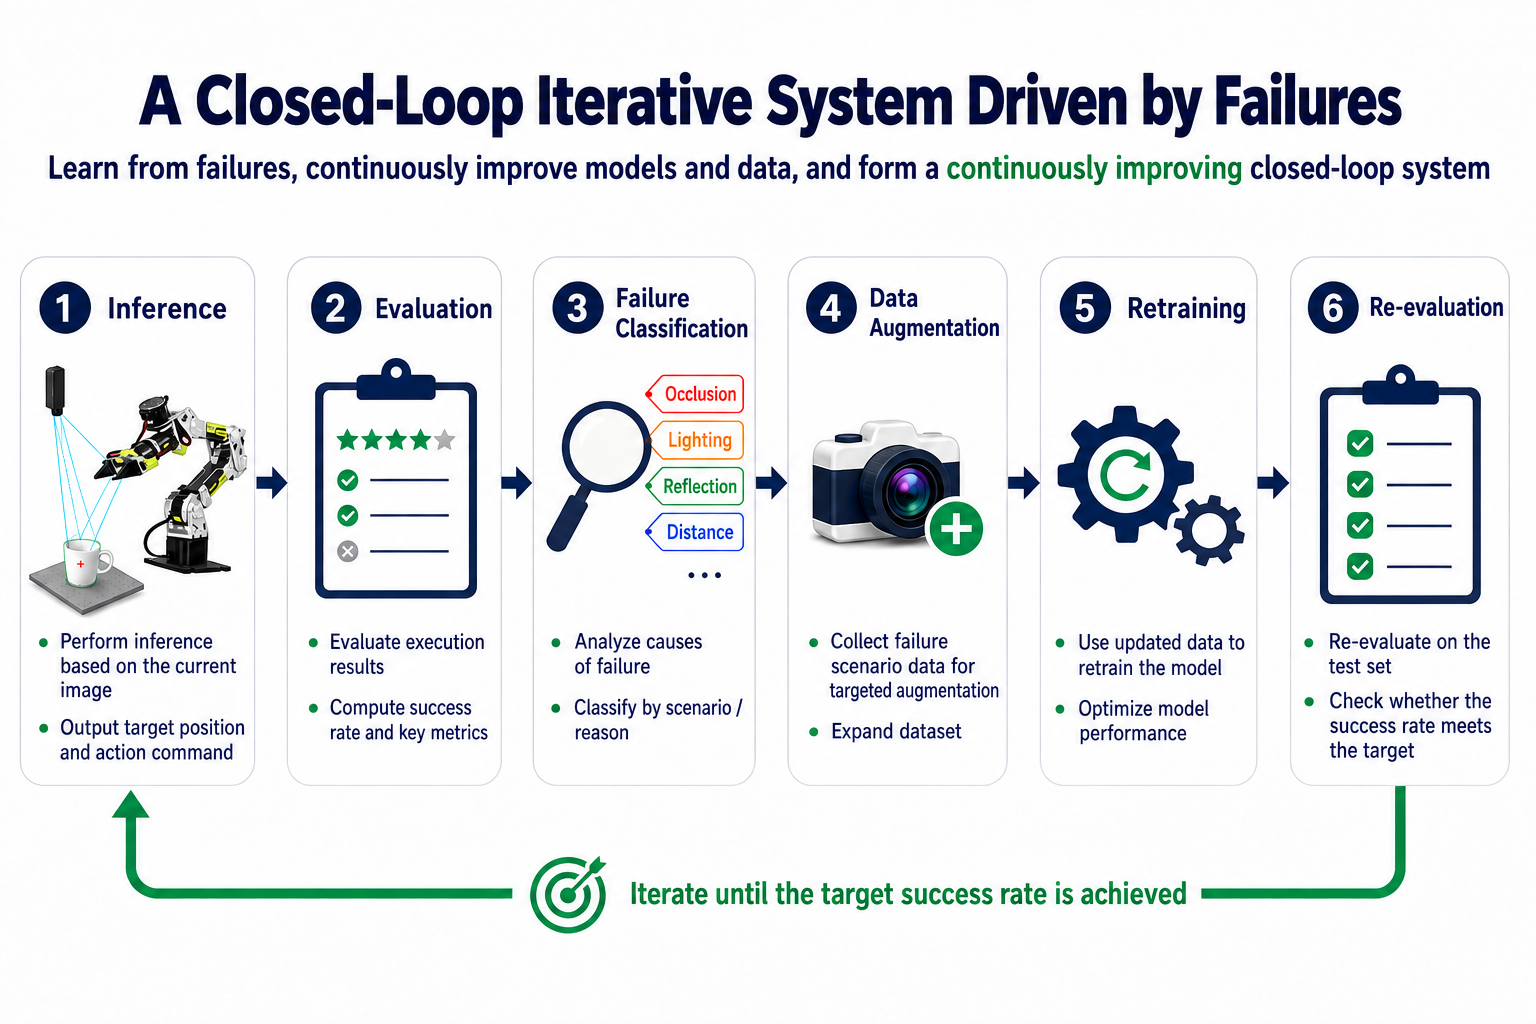
失敗をデータに変換することでループを閉じます:
-
失敗とそれが発生したシーンを分類します。
-
そのケースを対象にした新しいデモを 10〜20 個収集します。到達ミスの場合は問題の位置を記録し、不安定な把持の場合は閉じる動作を強調します。元の十字マークの周囲 5〜10 cm 間隔で新しい点を追加するなど、カバーする領域を徐々に広げます。
-
更新されたデータセットを使って再学習します。