reBot Arm で ACT を訓練する方法
ACT の学習を設定し、ジョブを起動して、loss と GPU 使用率をモニタリングし、中断した学習を再開し、チェックポイントを管理します。
- 学習設定
- Loss と GPU 使用率
- 学習の再開
- チェックポイント
3 つの重要な設定:バッチサイズ、学習率、ステップ数
GPU と VRAM を確認するには nvidia-smi を実行します。RTX 3050 を含むコンシューマー向け GPU でもモデルを学習できます。
バッチサイズ:メモリに余裕があれば増やして構いませんが、利用可能な VRAM を超えないようにしてください。
| 設定 | ガイダンス |
|---|---|
| VRAM 8 GB 以下 | 小さいバッチを使用:例として、8 GB なら 4、4 GB なら 2。 |
| VRAM 12 GB 超 | デフォルトのバッチサイズを使うのに十分な余裕があります。メモリに余裕があれば 16 を使用します。 |
| 統合グラフィックスのみ / NVIDIA GPU なし | クラウドサーバーで学習します。 |
学習率:
これは各更新の大きさです。ACT にはプリセットが用意されています:AdamW オプティマイザ、学習率 1e-5、weight decay 1e-4、およびビジョンバックボーン用の別の学習率 1e-5 です。lerobot-train はデフォルトでポリシー学習プリセット(use_policy_training_preset)を有効にしているため、追加設定なしでこれらの値が自動的に適用されます。更新が大きすぎると loss が振動したり発散したりし、小さすぎると学習に 2 倍の時間がかかることがあります。最初の実行ではプリセットのままにしておきましょう:これらの値は論文と豊富な実践に基づいています。
-
バッチサイズや学習ステップ数を変更する場合、学習率は変更しないことを推奨します。
-
既存のチェックポイントをファインチューニングする場合は、
1e-6から3e-6を検討してください。これはおよそ 3~10 倍低い値です。 -
学習 loss がほとんど下がらず横ばいのままでも、最初に学習率を上げないでください。ステップ数を増やすかデータを追加し、それでも動かない場合に
2e-5を試します。次の設定をまとめて追加し、両方に同じ値を使用します:
--policy.optimizer_lr=1e-6 \
--policy.optimizer_lr_backbone=1e-6
学習ステップ数:
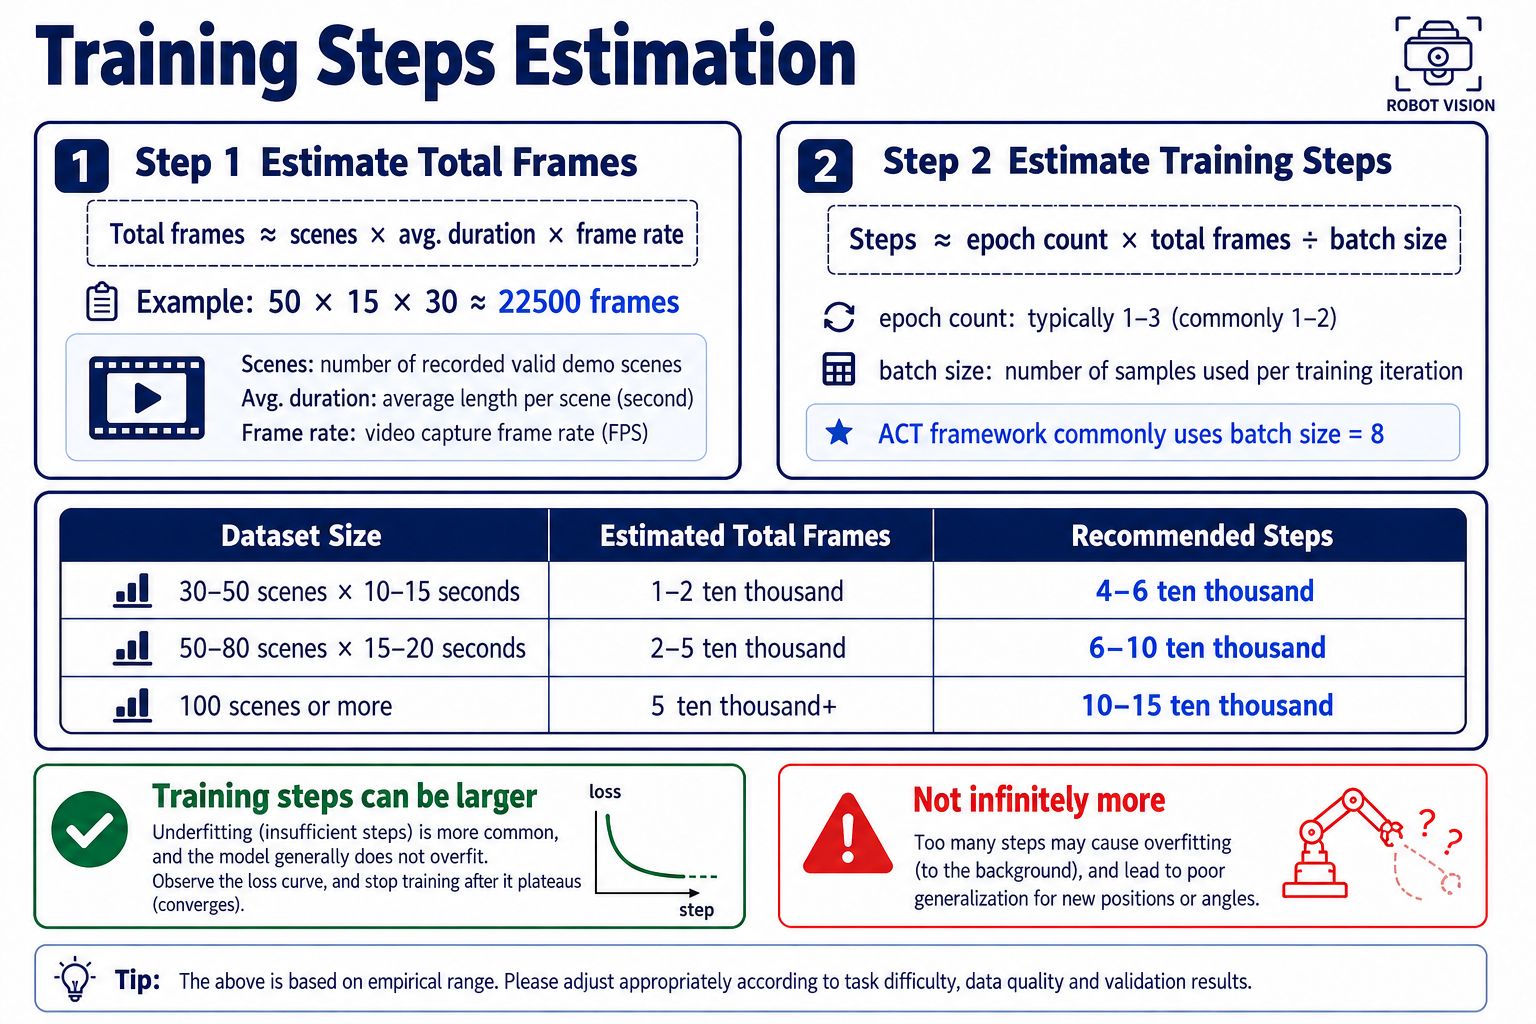
50 エピソードの場合、シンプルな出発点は 80,000 ステップ です。
バッチサイズに合わせてステップ数をスケーリング:
バッチサイズを半分にすると、1 回の更新で見るサンプル数も半分になります。おおよそ同じエポック数を維持するにはステップ数を 2 倍にします。batch_size=8 と steps=80000 から始める場合、バッチサイズ 4 では 160000 ステップ、バッチサイズ 2 では 4 倍のステップ数、バッチサイズ 16 では半分のステップ数を使用します。
学習ステップ数を多めに設定しても構いません。学習中は、loss やその他の指標を見ながら Ctrl+C で中断できます。その時点までに生成された対応するモデルは自動的に保存されています。
-
総フレーム数 は、おおよそ記録された総時間に対応します。
-
1 エポック は、記録済みデータセット全体を 1 回見たことを意味します。
-
ステップ数 は、ミニバッチ更新の回数を数えます。
学習を開始する
すべてのチェックが通ったら、lerobot の conda 環境で次を実行します:
lerobot-train \
    --dataset.repo_id=rebot_b601/grab_cube_v1 \
    --policy.type=act \
    --output_dir=outputs/train/act_grab_cube_v1 \
    --job_name=act_grab_cube_v1 \
    --policy.device=cuda \
    --wandb.enable=false \
    --policy.push_to_hub=false \
    --steps=100000
RTX 50 シリーズ GPU の場合は、--dataset.video_backend=pyav を追加して、このセットアップで使用している torchvision プレビュー版に欠けている API を回避します。
VRAM が不足している場合や、一度により多くのサンプルを処理したい場合は、--batch_size を追加してバッチサイズを設定します。
パラメータの参考:
| パラメータ | 意味 |
|---|---|
--dataset.repo_id | 第 13 章で扱ったデータセット名。ローカル名をそのまま入力するか、Hub 上のデータセットには ${HF_USER}/xxx を使用します。 |
--policy.type=act | ポリシーの種類。他の選択肢として diffusion や smolvla があります。ここでは ACT を使用します。 |
--output_dir | この実行からのすべての出力を保存するディレクトリ。 |
--job_name | ログを区別するための実行名。 |
--policy.device=cuda | GPU 上で学習します。 |
--wandb.enable=false | 任意の W&B オンラインダッシュボードを無効にします。 |
--policy.push_to_hub=false | 第 17 章での評価に満足するまで、モデルを Hub に公開しません。 |
--steps | 学習ステップ数。 |
--batch_size | バッチサイズを設定します。 |
おおよその目安として、100,000 ステップは、GPU とバッチサイズにもよりますが、コンシューマー向け GPU で数時間かかることが多いです。
Loss と GPU 使用率をモニタリングする
学習を開始するとログが表示されます。LeRobot はデフォルトで 200 ステップごとにサマリを出力しますが、これは --log_freq で制御できます。例:
step: 10000 smpl: 80K ep: 35.6 loss: 1.832 grdn: 12.4 lr: 1.0e-05 updt_s: 0.21 data_s: 0.003 eta: 3:42:10
各フィールドは次のように読み取ります。名称はバージョンによって多少異なる場合があります:
| フィールド | 意味 | 確認すること |
|---|---|---|
step | 現在の学習ステップ | 進捗を追跡するために --steps と比較します。 |
ep | 完了したエポック数 | モデルが記録を何回見たか。第 16.5 節で説明しています。 |
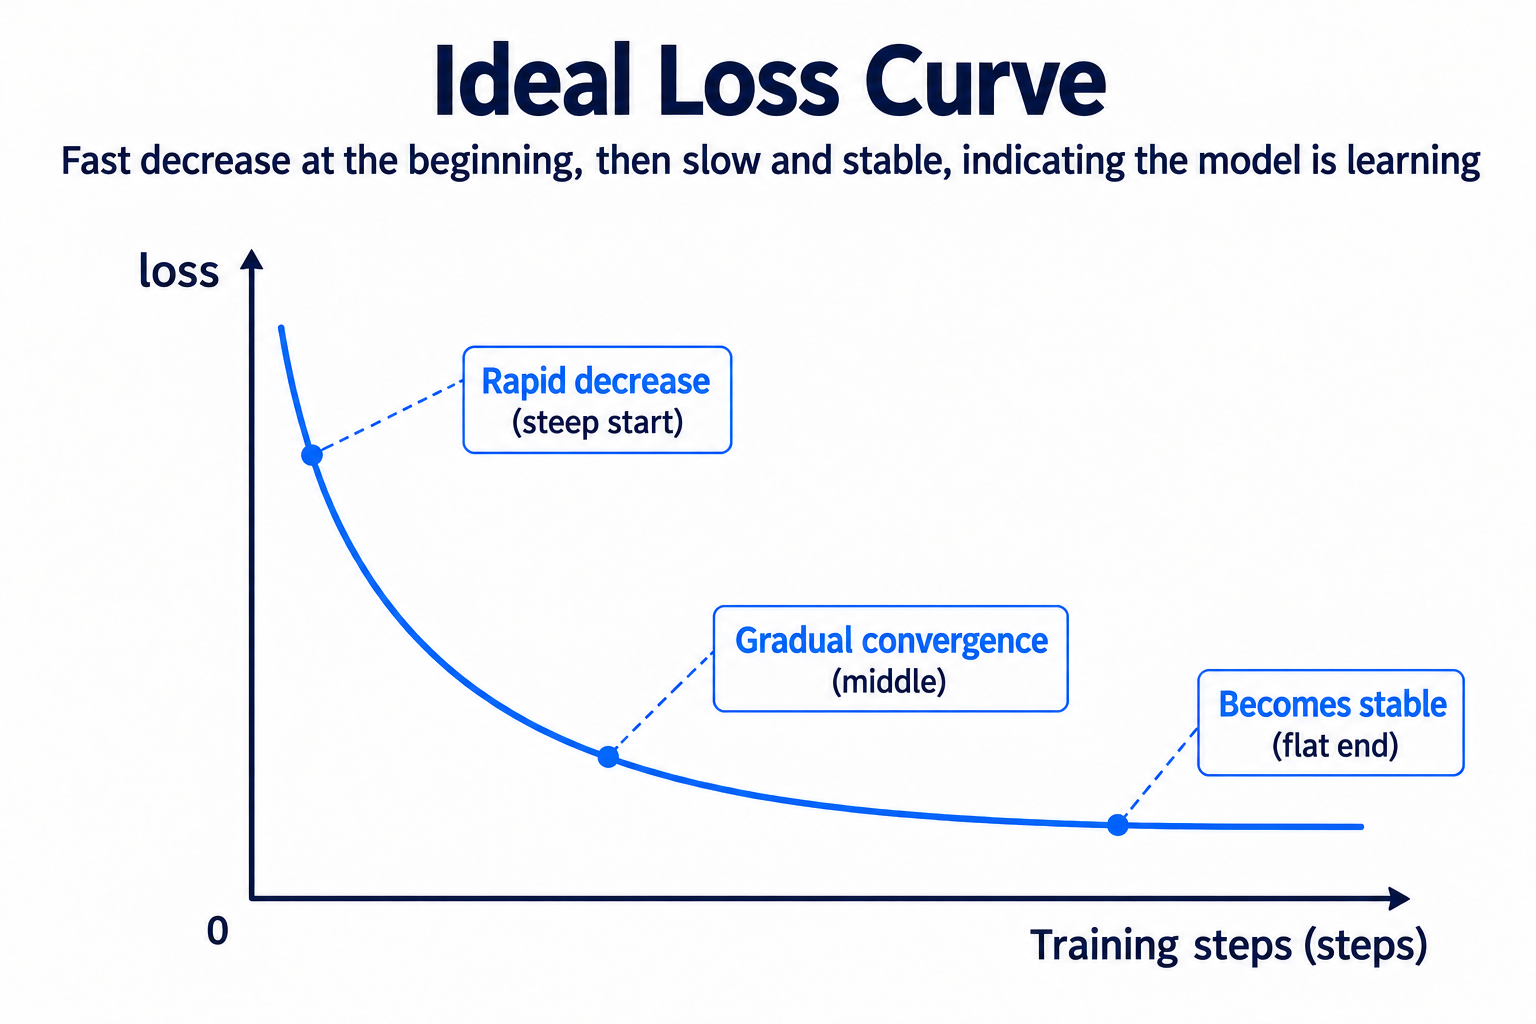
loss | 学習 loss | 最初は急速に減少し、その後はゆるやかに減少し、小さな変動があるのが通常です。 |
grdn | 勾配ノルム | 数百から数千への急激なジャンプは不安定性を示すことがあります。 |
lr | 現在の学習率 | 期待どおりの値になっているか確認します。 |
updt_s / data_s | ステップごとの更新時間 / データ読み込み時間 | data_s が大きい場合は、データ読み込みがボトルネックになっている可能性があります。 |
eta | 残り時間の推定値 | 実行計画を立てるのに使います。 |
期待される傾向は次の 3 つのグループに分かれます:
-
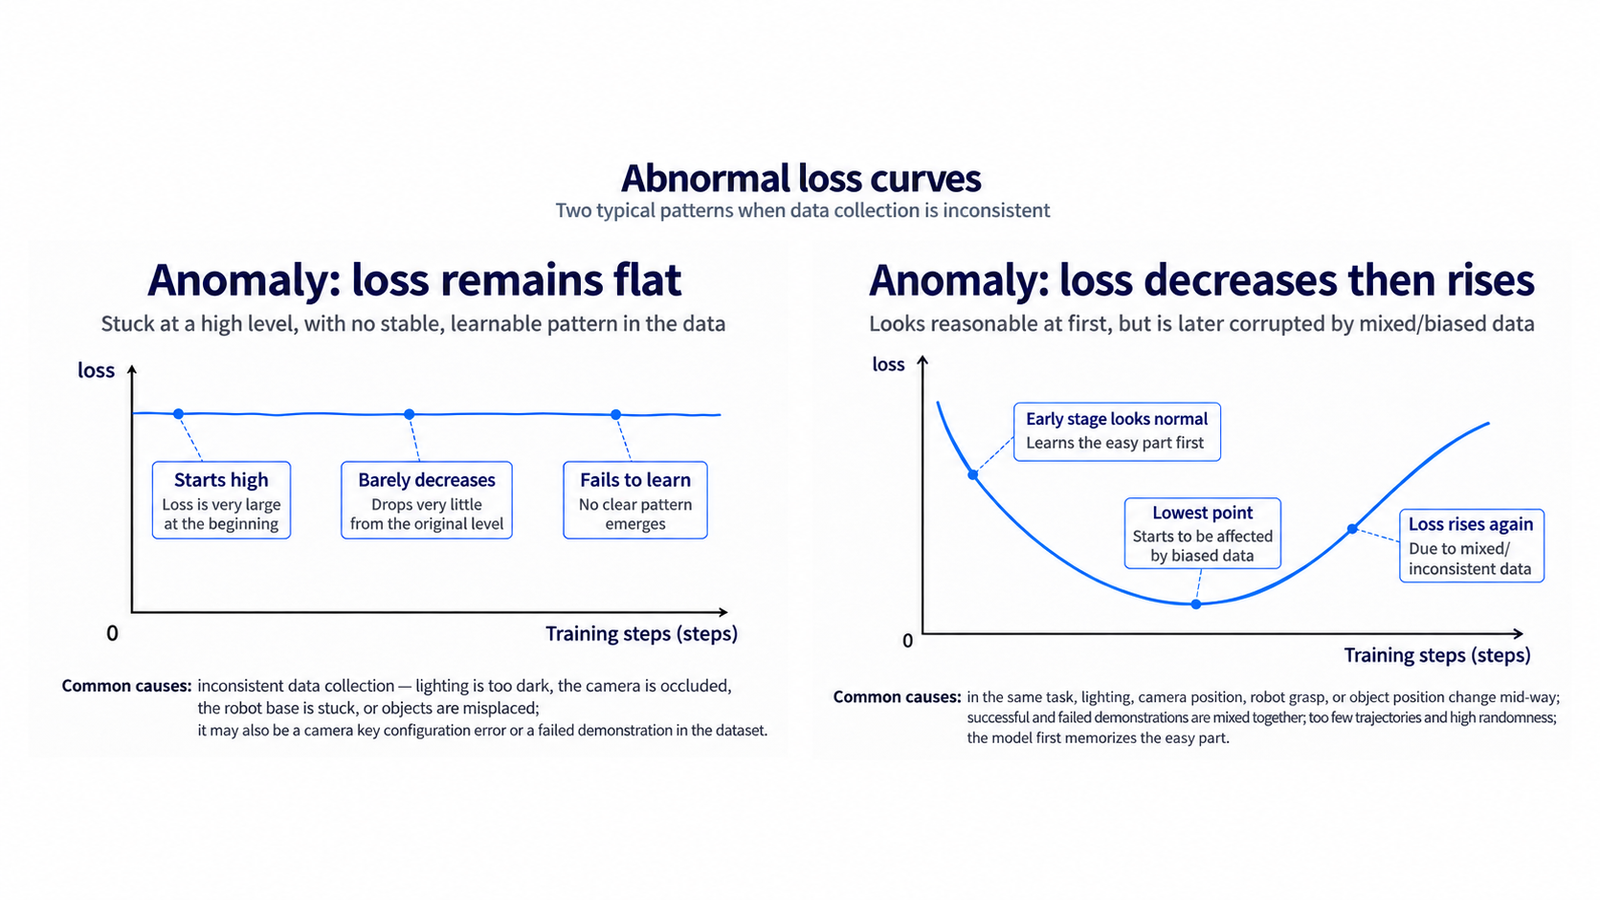
lossは全体として減少していくはずです。 健全な収束には 3 つのフェーズがあります:初期の急激な減少、中盤のゆるやかな減少、そして 低い水準での小さな変動を伴うほぼ横ばい です。2 つの異常なパターンに注意してください:まったく減少しない(データまたは設定の問題。第 14.6 節に戻ってカーブとカメラキーを確認します)、あるいは減少した後に再び増加する(学習の発散。学習率を半分にして再学習します)。 -
grdnは概ね安定し、ときどきスパイクがあっても構いません。 多くの場合、loss とともに低下します。単発のスパイクで元に戻る場合は、連続して増大するスパイク列よりも問題は小さいことが多いです。後者は発散の前兆になり得るため、その場合は学習率を下げます。 -
lr、updt_s、data_s、および GPU 使用率は、このセットアップでは概ね安定しているはずです。lrが設定と一致していることを確認します。watch -n 1 nvidia-smiでのステップ時間と GPU 使用率が安定していることが望ましいです。使用率が一貫して低い、または不規則な場合は、GPU がデータ待ちになっている可能性があります。
中断した学習を再開する
停電やネットワーク切断、学習中に誤ってターミナルを閉じてしまった場合でも、少なくとも 1 つのチェックポイントが保存されていれば(つまり 20,000 ステップ以上学習していれば)、最初からやり直す必要はありません:
lerobot-train \
    --config_path=outputs/train/act_grab_cube_v1/train_config.json \
    --resume=true
-
再開時は保存された設定が優先されます。 再開では
train_config.jsonが使用され、追加のコマンドラインパラメータは無視されます。ステップ数やバッチサイズを変更したい場合は、再開ではなく新しい実行を開始してください。 -
最新のチェックポイントから続行します。 オプティマイザの状態とステップカウンタが復元され、loss カーブをそのまま継続できます。
チェックポイントを保存・管理する
チェックポイントは 20,000 ステップごと(save_freq)と学習終了時に自動的に保存されます。そのため、ステップ数の予算を多めに取ることも現実的です。最終モデルだけを使うのではなく、後半のチェックポイントの性能が低かったり過学習している場合は、より前のチェックポイントを評価します。
outputs/train/act_grab_cube_v1/
├── train_config.json              ← Full configuration used for resuming
└── checkpoints/
    ├── 0020000/pretrained_model/  ← Model saved at this step
    ├── 0040000/pretrained_model/
    ├── ...
    └── last/pretrained_model/     ← Final checkpoint, used in Chapter 17
-
ディスク使用量:各チェックポイントにはモデル重み一式が含まれるため、多数のチェックポイントはかなりの容量を消費する可能性があります。学習が安定したら、不要な初期のチェックポイントを削除し、
lastと直近 1~2 個のチェックポイントだけを残します。 -
推論時には、
--policy.pathをcheckpoints/last/pretrained_modelに向けます。