reBot Arm でポリシーを切り替える方法
動作中の ACT プラットフォームとそのデータセットを再利用して新しいポリシーを学習・デプロイし、その性能をロボット上で比較します。reBot-RS、reBot-DM、SO-ARM 101 向けのコマンドを用意しています。
- Diffusion
- SmolVLA
- π ポリシー
- ロボット上での評価
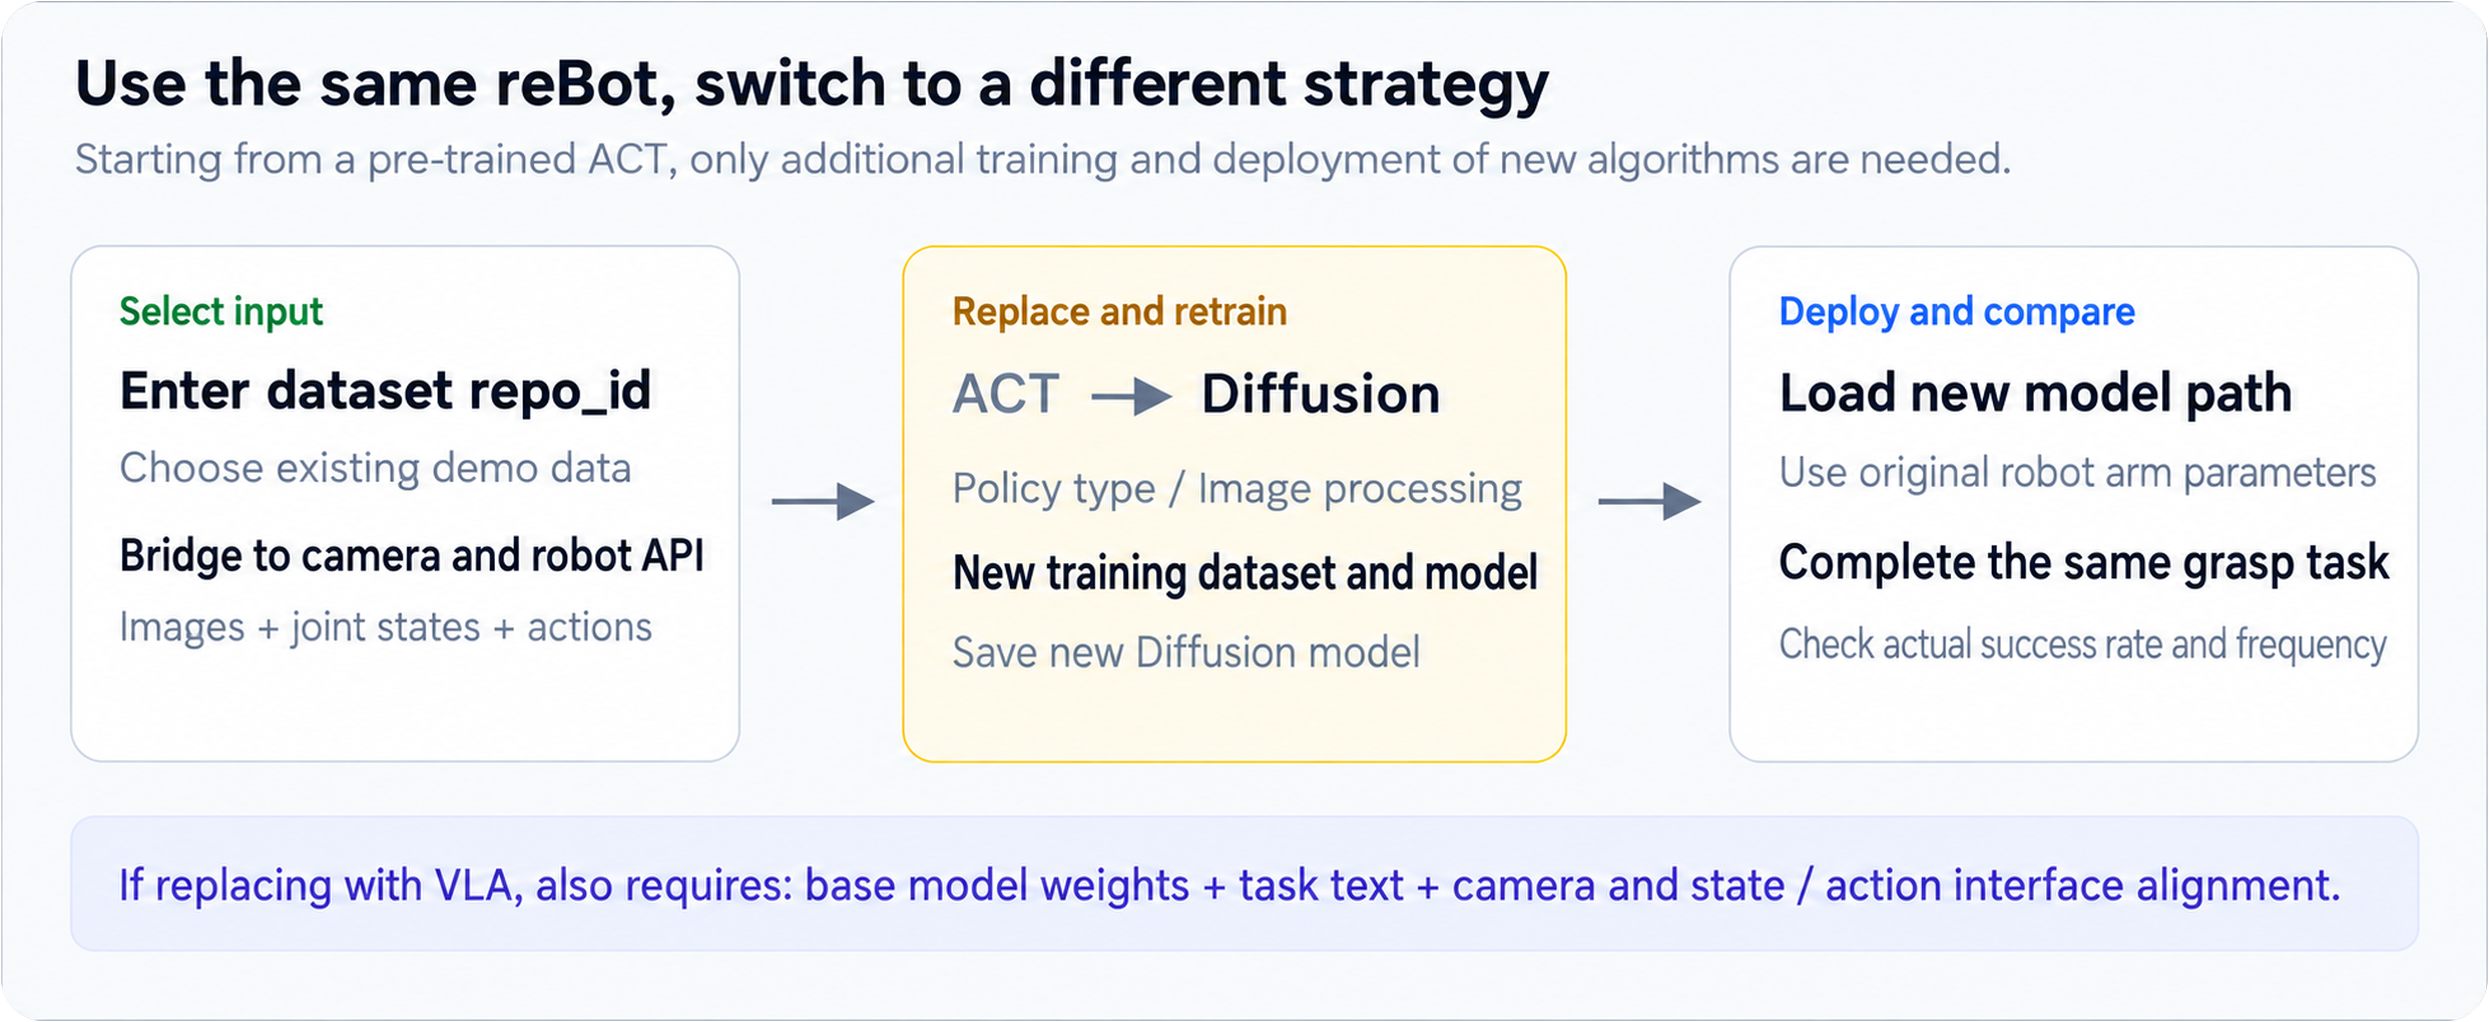
ポリシーを選ぶ → 設定して学習 → 新しいモデルを読み込む → ロボット上で評価する。
このガイドでは、例として ACT → 黒いブロック把持の Diffusion を使用します。まず、組み立て、キャリブレーション、テレオペレーション、ACT の学習とデプロイを完了してください。動作しているハードウェア構成を維持し、同じプラットフォームのデータセットで新しいポリシーを学習します。
環境とプラットフォーム
使用しているアームのタブを選択してください。以下の学習およびデプロイ用コマンドはタブに合わせて切り替わります。
- reBot-RS
- reBot-DM
- SO101
ACT で使用している Seeed LeRobot 環境と B601-RS プラグイン設定を再利用します。コマンドは Seeed LeRobot 0.4.4 シリーズを対象としています。ハードウェアのセットアップについては、LeRobot を用いた reBot-RS を参照してください。
ACT で使用している Seeed LeRobot 環境と B601-DM プラグイン設定を再利用します。コマンドは Seeed LeRobot 0.4.4 シリーズを対象としています。ハードウェアのセットアップについては、LeRobot を用いた reBot-DM を参照してください。
すでに ACT が動作している LeRobot v0.4.4 環境を再利用します。Feetech モーターのサポートがインストールされていない場合は、LeRobot のソースディレクトリから次を実行してください:
pip install -e ".[feetech]"
ハードウェアの準備については、公式 SO-ARM 101 ドキュメントを参照してください。
各ポリシーに必要なこと
| 対象ポリシー | 必要な作業 |
|---|---|
| Diffusion | policy.type=diffusion と画像クロップのオプションを設定し、新しいモデルを学習して、デプロイ先パスを更新します。 |
| SmolVLA | .[smolvla] をインストールし、lerobot/smolvla_base をファインチューニングし、タスク文、カメラ名、状態/アクション次元を整合させます。 |
| π₀ / π₀.₅ | .[pi] をインストールし、適切なベースモデルをファインチューニングし、タスク文、画像、アクション、正規化統計を整合させ、VRAM に合わせてバッチサイズを調整します。 |
VLA データには正確なタスク記述が必要です。カメラ名や台数がベースモデルと異なる場合は、入力名のマッピングと欠損ビューを設定してください。SmolVLA · π₀ · 入力マッピング
既存データセットで Diffusion を学習する
既存の ACT 環境で、LeRobot のソースディレクトリから次のコマンドを実行します。dataset.repo_id は自分のデータセットに置き換えてください。データの保存場所をカスタマイズしている場合は、元の学習コマンドから --dataset.root とデコード設定を引き継ぎます。この例では front カメラ 1 台、640×480 画像、30 FPS のデータを使用します。
- reBot-RS
- reBot-DM
- SO101
lerobot-train \
  --dataset.repo_id=your_username/rebot_rs_cube \
  --policy.type=diffusion \
  --policy.crop_shape=null \
  --policy.device=cuda \
  --policy.push_to_hub=false \
  --output_dir=outputs/train/diffusion_rebot_rs_cube \
  --job_name=diffusion_rebot_rs_cube \
  --batch_size=8 \
  --steps=100000 \
  --wandb.enable=false
lerobot-train \
  --dataset.repo_id=your_username/rebot_dm_cube \
  --policy.type=diffusion \
  --policy.crop_shape=null \
  --policy.device=cuda \
  --policy.push_to_hub=false \
  --output_dir=outputs/train/diffusion_rebot_dm_cube \
  --job_name=diffusion_rebot_dm_cube \
  --batch_size=8 \
  --steps=100000 \
  --wandb.enable=false
lerobot-train \
  --dataset.repo_id=your_username/so101_cube \
  --policy.type=diffusion \
  --policy.crop_shape=null \
  --policy.device=cuda \
  --policy.push_to_hub=false \
  --output_dir=outputs/train/diffusion_so101_cube \
  --job_name=diffusion_so101_cube \
  --batch_size=8 \
  --steps=100000 \
  --wandb.enable=false
| パラメータ | 必須設定 |
|---|---|
policy.type | 新しいポリシーを作成・学習するために diffusion を使用します。 |
policy.crop_shape | null は画像全体を保持します。ビュー全体を処理するとメモリと推論コストが増加します。 |
output_dir / job_name | 新しい名前を使用します。デプロイ時の policy.path は対応する出力先を指す必要があります。 |
batch_size / steps | まず 8 / 100000 から始め、その後 VRAM とロボット上での性能に合わせて調整します。 |
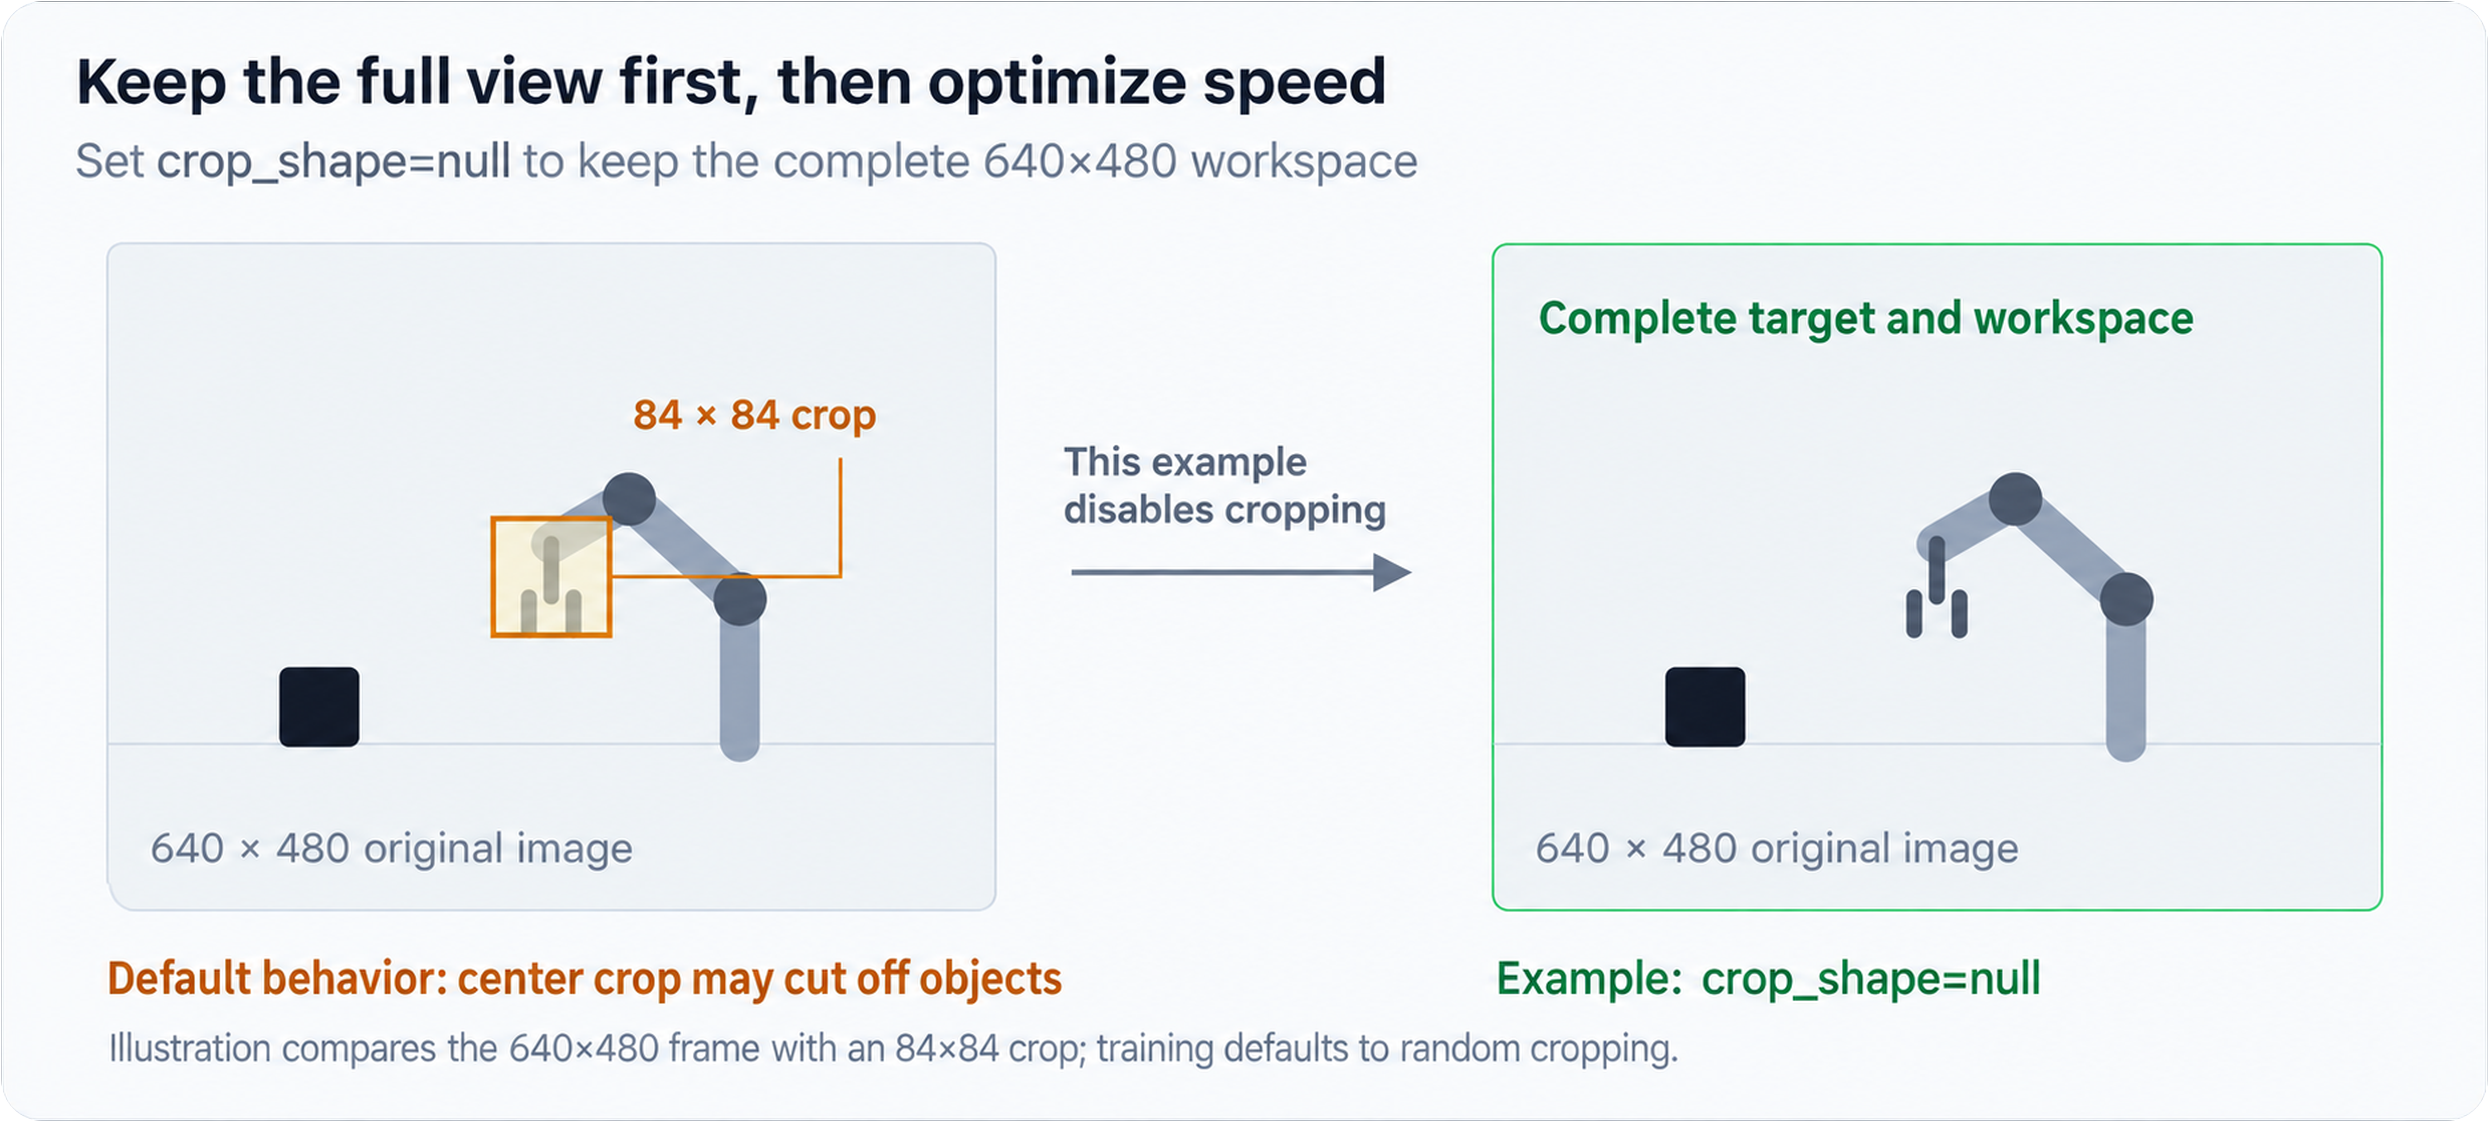
クロップやリサイズを最適化する際は、学習とデプロイの間で画像処理を一貫させてください。設定の参考: Seeed Diffusion · LeRobot v0.4.4 Diffusion。
新しいモデルを実行する
policy.path を新しく学習した Diffusion モデルに向け、新しい評価用データセット名を選びます。以下のポート、robot.id、カメラ設定、タスク記述は例ですので、実際に動作している ACT の設定に置き換えてください。キャリブレーション時に使用した robot.id は維持します。
- reBot-RS
- reBot-DM
- SO101
lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras='{"front":{"type":"opencv","index_or_path":0,"width":640,"height":480,"fps":30,"fourcc":"MJPG"}}' \
  --policy.path=outputs/train/diffusion_rebot_rs_cube/checkpoints/last/pretrained_model \
  --policy.device=cuda \
  --dataset.repo_id=local/eval_diffusion_rebot_rs_cube_01 \
  --dataset.single_task="Grab the black cube" \
  --dataset.fps=30 \
  --dataset.num_episodes=1 \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=10 \
  --dataset.push_to_hub=false \
  --display_data=true
lerobot-record \
  --robot.type=seeed_b601_dm_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.id=follower1 \
  --robot.can_adapter=damiao \
  --robot.cameras='{"front":{"type":"opencv","index_or_path":0,"width":640,"height":480,"fps":30,"fourcc":"MJPG"}}' \
  --policy.path=outputs/train/diffusion_rebot_dm_cube/checkpoints/last/pretrained_model \
  --policy.device=cuda \
  --dataset.repo_id=local/eval_diffusion_rebot_dm_cube_01 \
  --dataset.single_task="Grab the black cube" \
  --dataset.fps=30 \
  --dataset.num_episodes=1 \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=10 \
  --dataset.push_to_hub=false \
  --display_data=true
lerobot-record \
  --robot.type=so101_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.id=my_awesome_follower_arm \
  --robot.cameras='{"front":{"type":"opencv","index_or_path":0,"width":640,"height":480,"fps":30}}' \
  --policy.path=outputs/train/diffusion_so101_cube/checkpoints/last/pretrained_model \
  --policy.device=cuda \
  --dataset.repo_id=local/eval_diffusion_so101_cube_01 \
  --dataset.single_task="Grab the black cube" \
  --dataset.fps=30 \
  --dataset.num_episodes=1 \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=10 \
  --dataset.push_to_hub=false \
  --display_data=true
- reBot-RS: 検証済みの CAN インターフェースと
socketcan設定を維持します。 - reBot-DM: 検証済みのシリアルポートと
damiaoアダプタ設定を維持します。 - SO-ARM 101: 検証済みのシリアル設定を維持し、使用していた場合は以前の
--robot.use_degreesの値も含めます。
カメラ名、設置位置、画像サイズ、アクションの単位、フレームレートは学習時と一貫させてください。評価ごとに新しい eval_… データセット名を使用します。
設定の参考: Seeed プラグイン設定 · LeRobot v0.4.4 評価ワークフロー。
ロボット上での評価とポリシー比較
アームを安全に固定し、作業空間を片付けてください。まず 1 エピソードだけ実行し、動作方向、可動範囲、実際の制御レートを確認します。これらが正しければ、ACT と同じタスク、物体配置、試行回数で Diffusion を評価し、成功回数と完了時間を記録します。
次に SmolVLA や π ポリシーへ切り替えるには、ドキュメントに記載された依存関係をインストールし、ベースモデルをファインチューニングし、タスク文、カメラ入力、状態/アクション次元、正規化統計を整合させ、policy.path を更新します。