模倣学習のタスクとデモを設計する方法
エピソード、開始および終了条件、一貫したデモンストレーションを定義し、その後、5 点サンプリングを用いて完全なピック・アンド・プレースタスクを収集します。
- エピソード
- タスク設計
- 5 点サンプリング
- デモンストレーション収集
エピソードとは?
エピソードとは、1 回分の完全なタスクデモンストレーションです。 アームの初期姿勢とタスク開始からタスク完了まで、連続して記録されたすべてのデータを含みます。
エピソードには何が含まれるか?
エピソードは、タイムラインに沿った多数のフレームで構成されます。各フレームは通常 30 Hz(1 秒あたり 30 サンプル)で記録され、システムが見たり感じたりするもの、アームの現在の構成、人やポリシーがアームに指示する行き先という 3 種類の情報を組み合わせます。これらが観測、状態、アクションです。
タスク設計:開始条件と終了条件
記録を始める前に、タスク定義を書き出します。良い定義は 2 つの問いに答えます。どこから始まり、何をもって完了とみなすのか?
開始条件:モデルに明確に定義された初期状態を与える
- 固定された初期アーム姿勢を使う。 各エピソードを、ゼロ位置付近の標準姿勢など、同じ安全な姿勢から開始します。開始姿勢が大きくばらつくと、モデルはまず任意の姿勢からタスクに入る方法を学ばなければならず、不要な難しさが加わります。
終了条件:エピソードに明確なゴールラインを与える
-
成功による終了:タスク目標が達成されたとき。例えば「ブロックが箱の中に完全に入り、グリッパがそれを放し、アームが持ち上がって離れている」状態です。
-
失敗による終了:物体を落とす、容器を倒す、安全でないアーム姿勢に達するなど、回復不能な事象が発生した場合は、すぐに記録を停止します。
一貫性と多様性:データ設計の中心的なトレードオフ
これは本章の要点です。高品質なデモンストレーションは、一見すると相反する 2 つの要件を満たさなければなりません。
一貫性:タスクのやり方を 1 つ教える
-
一貫した操作スタイル:右側からブロックに近づき、把持し、上から箱の中に移動させる、といった同じ戦略をエピソード間で用います。データが限られている状態で、左側と右側の把持を混在させると、モデルはどちらの経路でも成功しない「平均的な」経路を学習してしまう可能性があります。
-
一貫したタイミング:動作速度や一時停止を大まかに一定に保ちます。エピソードを 20 秒と決めたなら、20 秒以内に終えるようにします。デモンストレーションのタイミングが不規則だと、モデルの実行も不規則になり得ます。
-
一貫したシーケンス:すべてのエピソードに、「接近 → 把持 → 搬送 → 配置 → 退避」という一連の流れを完全に含めます。
-
制御された初期シーン:ターゲットを定義された領域内に配置します。領域は広くても構いませんが、その境界は明確でなければなりません。作業空間から無関係な物体は取り除きます。
-
固定カメラ:収集中にカメラを動かさないでください。モデルにとって、カメラを 5 cm 動かすだけでも、見えている世界が変わってしまいます。
多様性:十分に異なる状況をカバーする
-
ターゲット位置を変える:物体を適当にばらまくのではなく、グリッドで作業空間を系統的にカバーします。
-
初期物体姿勢を変える:ブロックの向きや障害物との位置関係を変えます。
成功と失敗の基準
記録に失敗した区間が含まれている場合は、そのエピソードを録り直してください。 モデルが意図した挙動を学んでくれることを期待して失敗したデモンストレーションを残してはいけません。失敗も同様に学習されてしまいます。
タスク完了は「だいたいできた」ではなく、客観的に観測可能でなければなりません。成功を明確な最終状態で定義します。
データ量とデータ品質
以下は、コレクション用サンドボックスのような、きれいに制御された環境における 1 つの卓上タスクに対する実践的な目安です。環境の制御が不十分な場合は、より多くのデータを収集してください。
| データセット規模 | 期待される結果 |
|---|---|
| 50 エピソード | ワークフローを動かし始め、デモンストレーションされた領域内で動作するのに十分。初心者向けタスクの出発点となる規模です。 |
| 50~100 エピソード | 単一タスク実験で、実用的な成功率を得られることが多い範囲です。 |
| 100 エピソード以上 | タスクが複雑であるか、非常に高い成功率が求められる場合を除き、追加の効果は薄れていく可能性があります。 |
複数タスクの場合は、複雑さに応じてデータセットを増やします。初回の学習後、評価で弱点が見つかったら、デモンストレーションを追加できます。
数値よりも、次の原則を優先してください。
-
質の高い 50 個のデモンストレーションは、雑に作られた 200 個よりも優れています。
-
記録に問題があれば、そのエピソードを録り直してください。
-
強い汎化には、数百から数千のエピソードが必要になることがあります。
単一タスクデータセットとマルチタスクデータセット
-
単一タスクデータセット:ブロックを箱に入れるなど、1 つのタスクのみを含みます。目的が絞られているため、必要なデータ量は少なく、高い成功率を達成しやすくなります。最初のモデルは 1 つのタスクから始めてください。
-
マルチタスクデータセット:ブロックをつかむ、引き出しを開ける、ブロックを中に入れる、など複数のタスクを含みます。各エピソードは、自身のタスクを識別するために
task_indexを使用します。これによりデータの再利用性が高まり、汎用ポリシーに近づきますが、タスク同士でモデルの容量を共有するため、各タスクが十分に学習されるにはより多くのデータが必要になります。
データ収集を反復する
バッチで収集と検証を行います:50 エピソード → 学習 → ロボット上で評価 → 失敗ケースの例をさらに収集 → 再学習。全体の挙動は正しいが精度が低い場合には、データを増やすことが役立ちます。挙動そのものが根本的に間違っている場合は、さらに収集する前にタスクやデータセット設計を見直してください。
デモンストレーション収集の例
シーンのセットアップ:
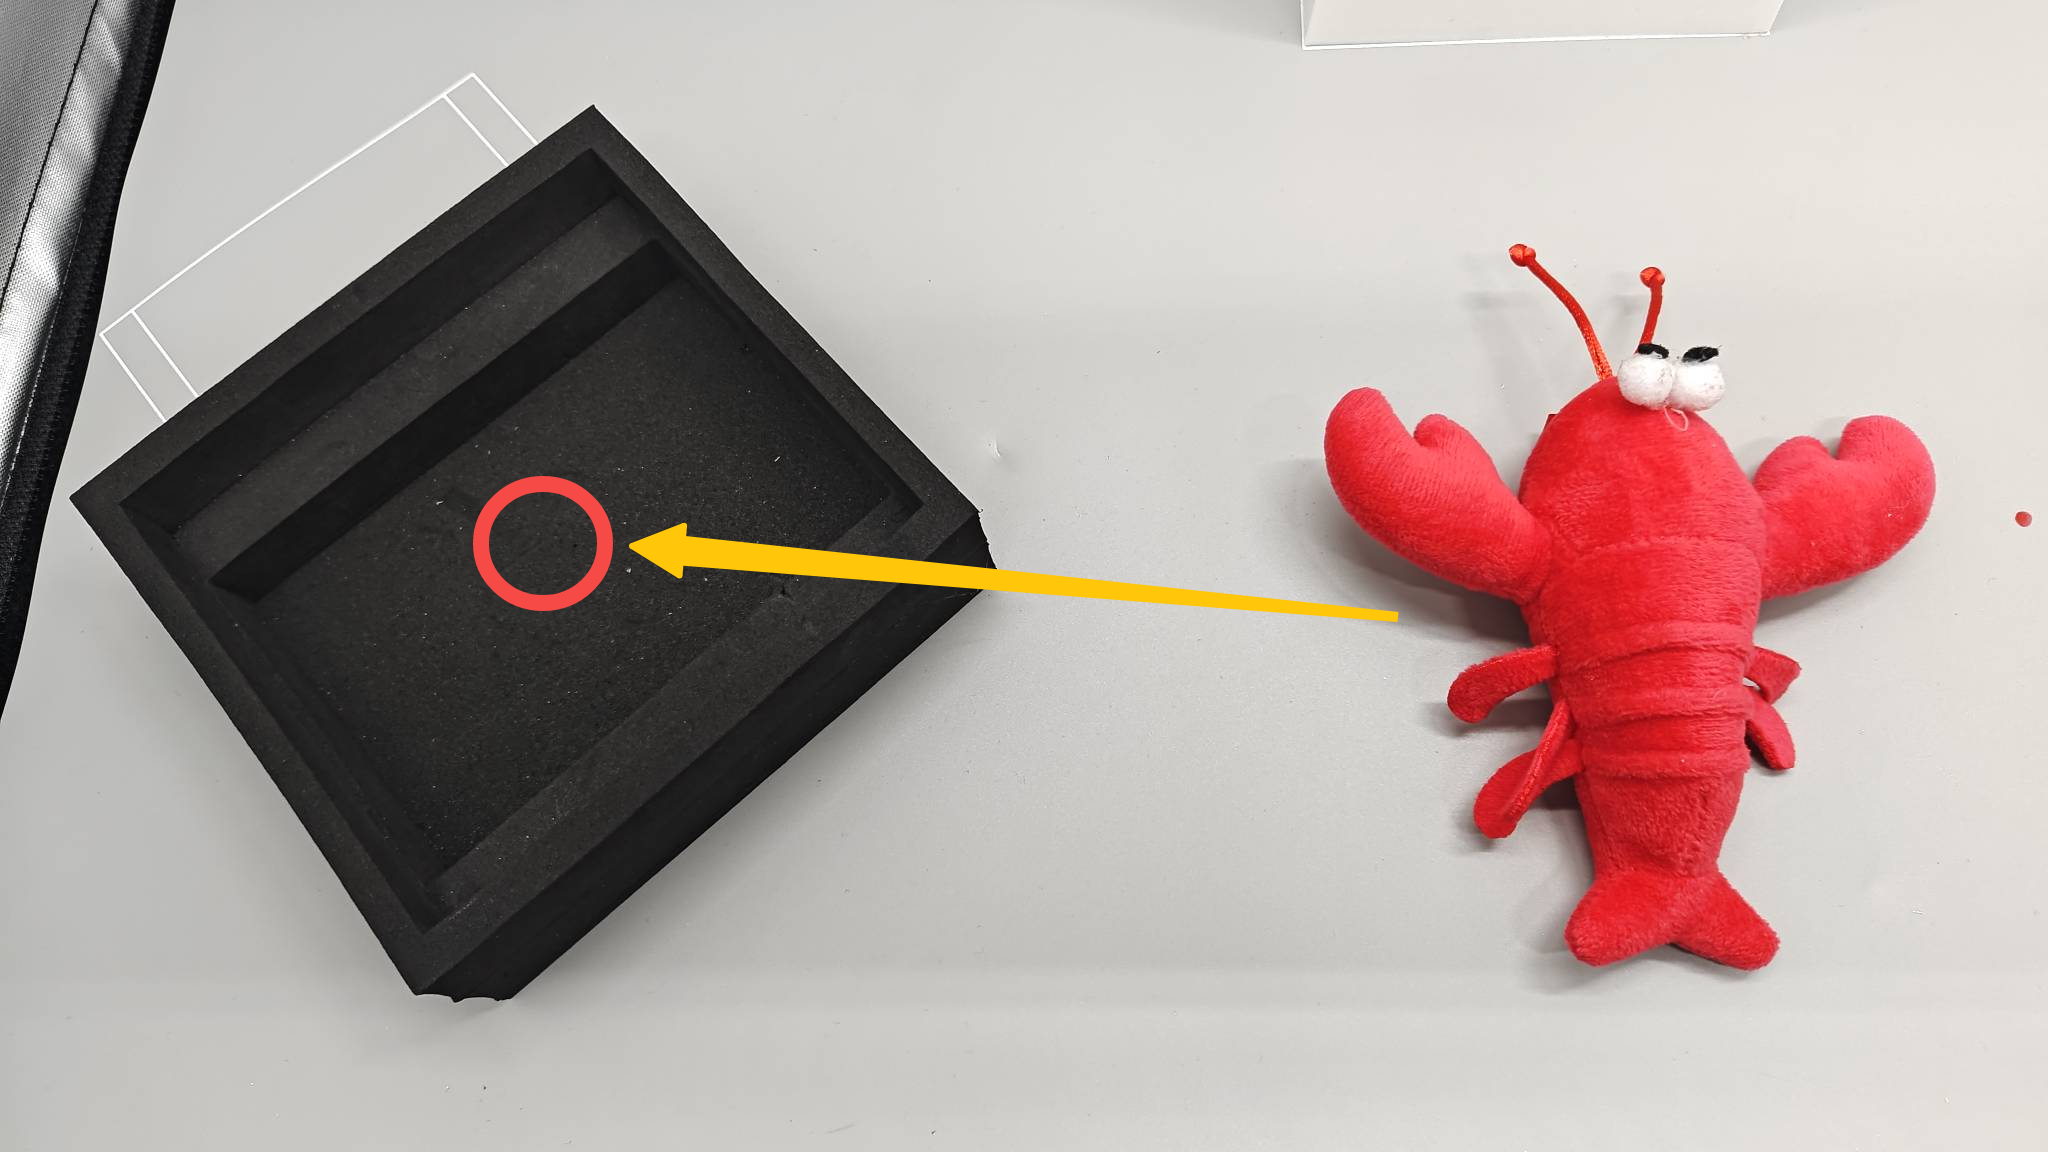
- ザリガニを黒い箱の中に置きます。箱の底を両面テープで固定し、動かないようにします。カメラとアームは固定し、照明も変えないでください。
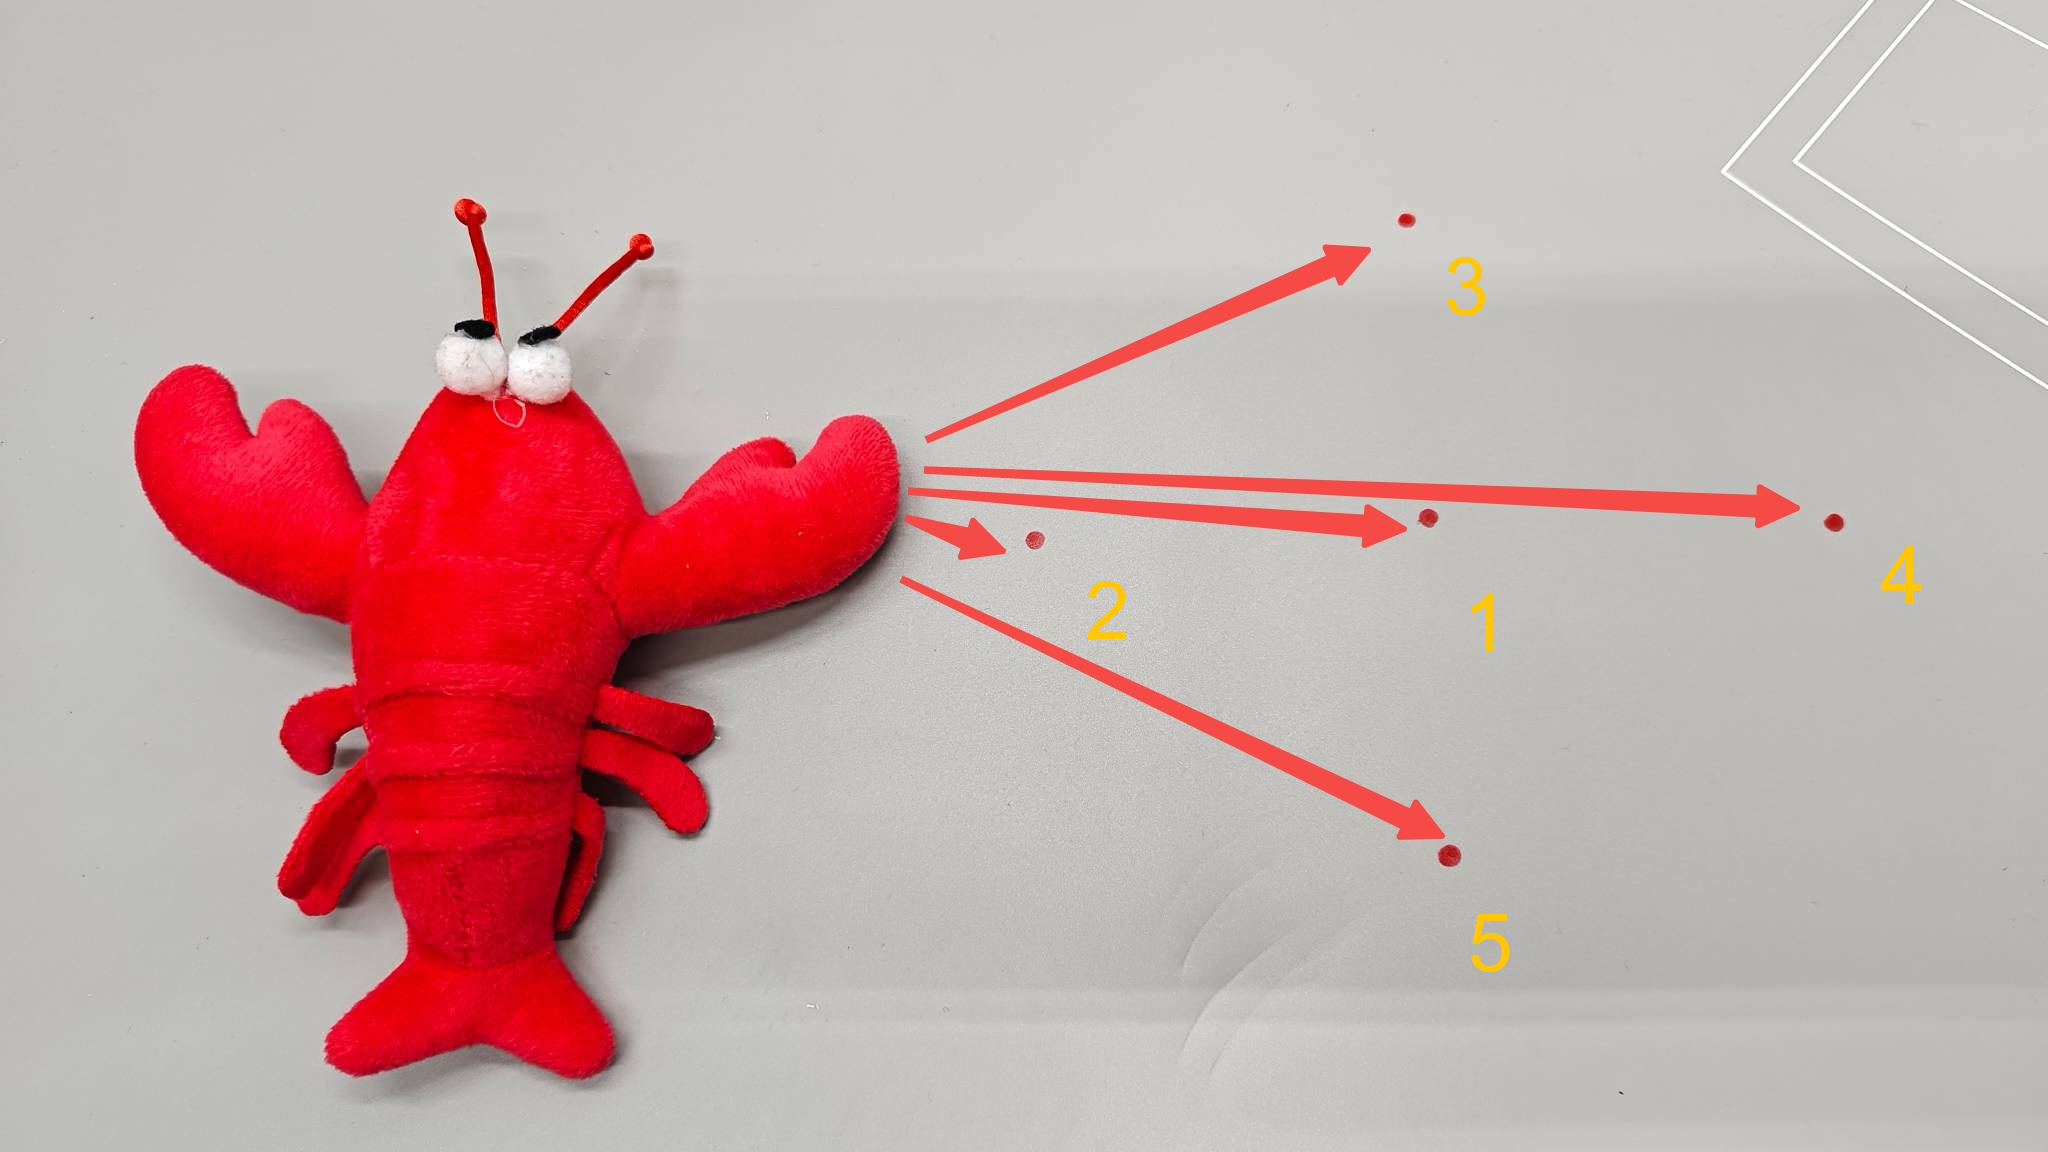
- 図示された 5 つのポイントにザリガニを置いてデモンストレーションを収集します。1 → 2 → 3 → 4 → 5 の順に 1 周し、10 周行います。
- 初心者は、十分な練習のために物体をどこに置けばよいかで悩みがちです。ランダムに配置すると、すべての例が小さな領域に集中してモデルが他の場所を把持できなくなったり、練習が偏って一部の位置だけ頻繁に練習され、他の位置は一度も見られなかったりします。これは、見慣れた試験問題だけを復習して、問題が変わった途端に迷子になるようなものです。または、ロボットに 1 種類のスナックだけを見せておいて、いきなりビュッフェに連れて行くようなものです。次のような、簡単で体系的な方法を使いましょう。
-
ポイントをマークする:収集エリアまたはデスクマットの内側に、十字形に 5 つのポイントを描きます。中央に 1 つ、その上・下・左・右に 1 つずつです。
-
間隔を設定する:隣り合うポイント同士を 5~10 cm 程度離します。5 つすべてがアームの可動範囲内にあり、かつ 2 つのカメラビューの両方で明確に見えるようにします。
-
デモンストレーションを割り当てる:各ポイントにつき 10 エピソード収集し、5 × 10 = 50 エピソードとします。1 つのポイントで 10 個すべてを終えてから次に進んではいけません。1 周につき 5 つのポイントそれぞれで 1 つずつ収集し、それを 10 周繰り返します。
ピック・アンド・プレースのシーケンスを設計する:
- 初期姿勢
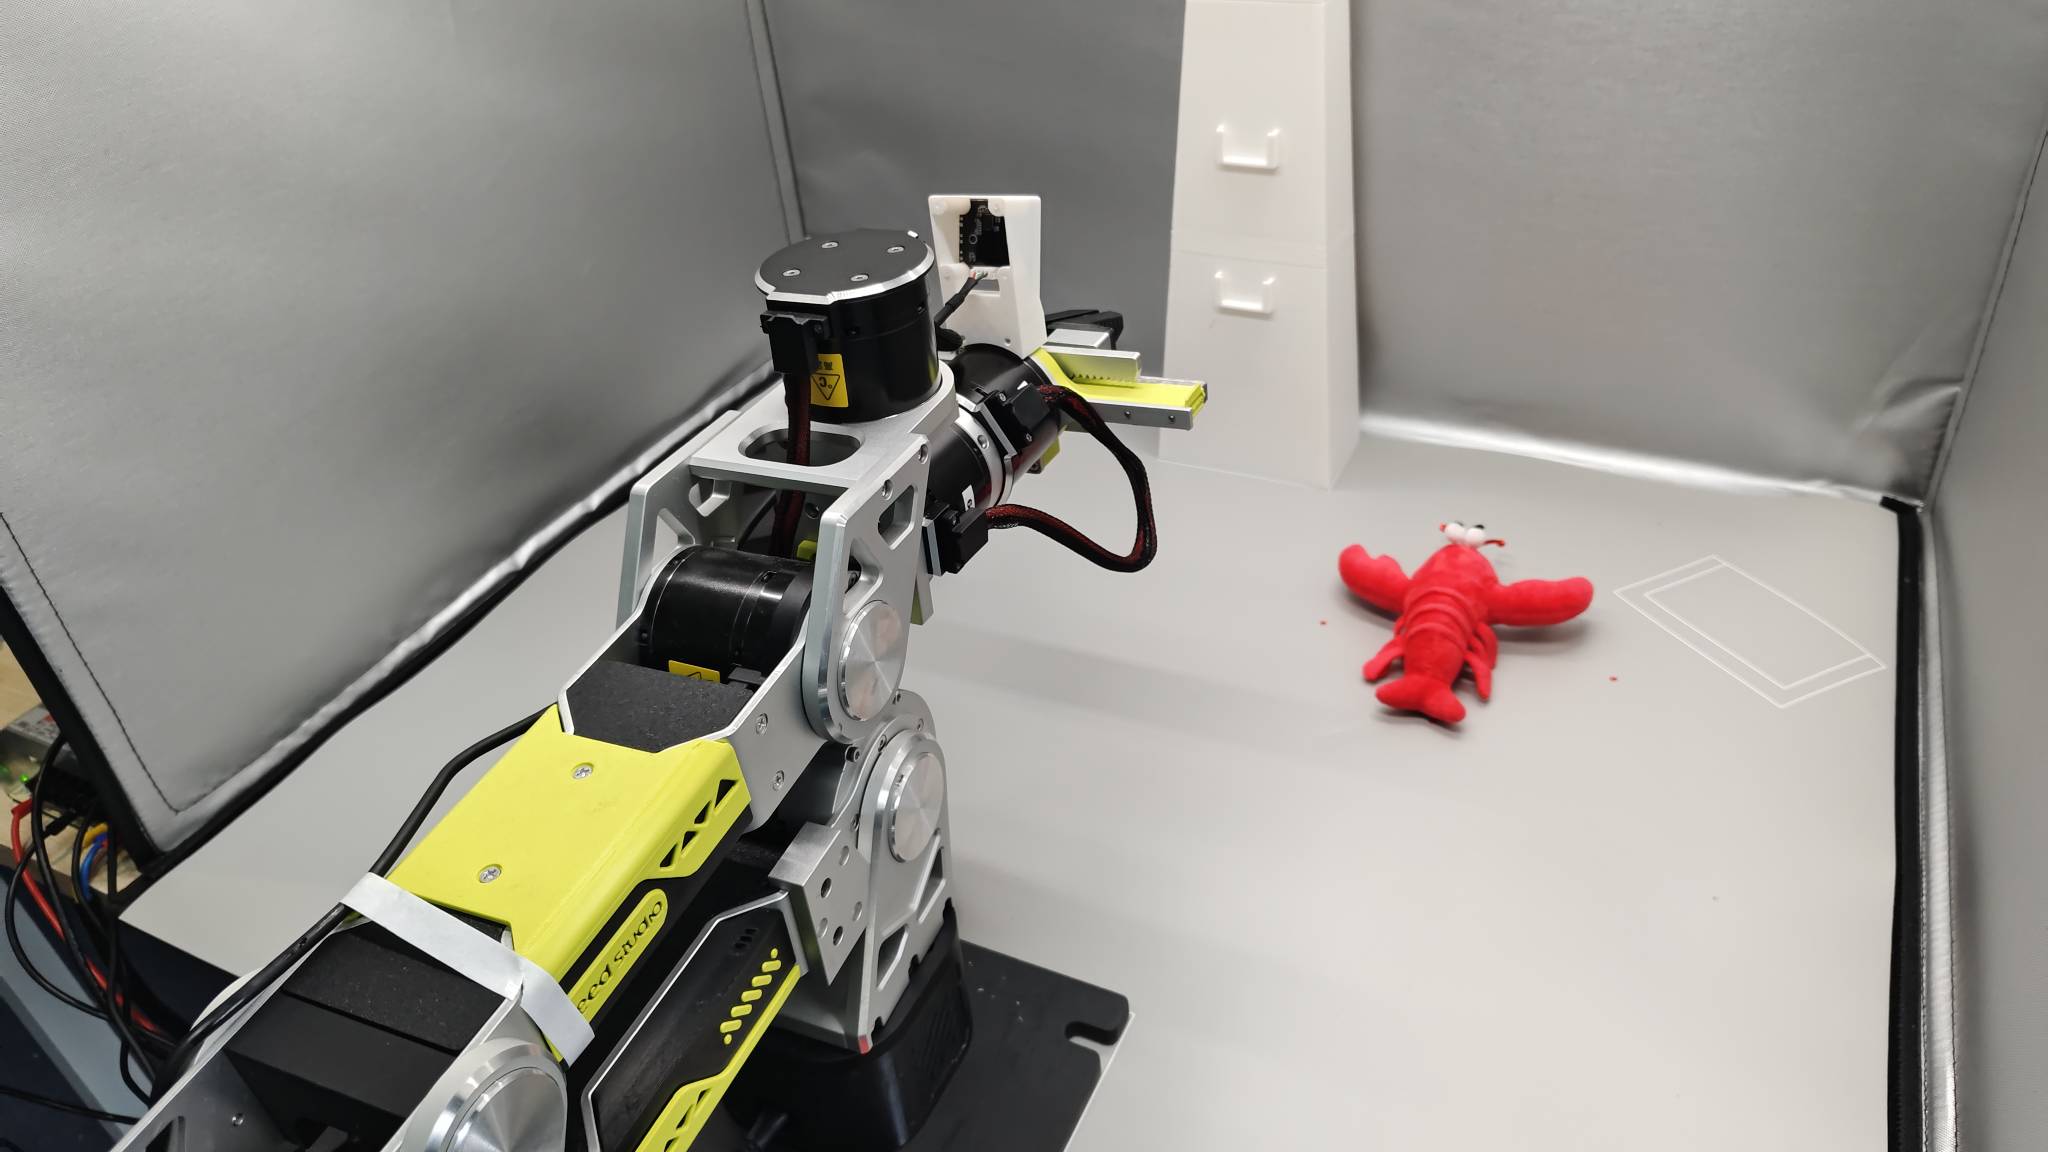
- 物体を把持する
- ザリガニの真上に移動します。中心に合わせ、毎回同じ接近高さを保ちます。
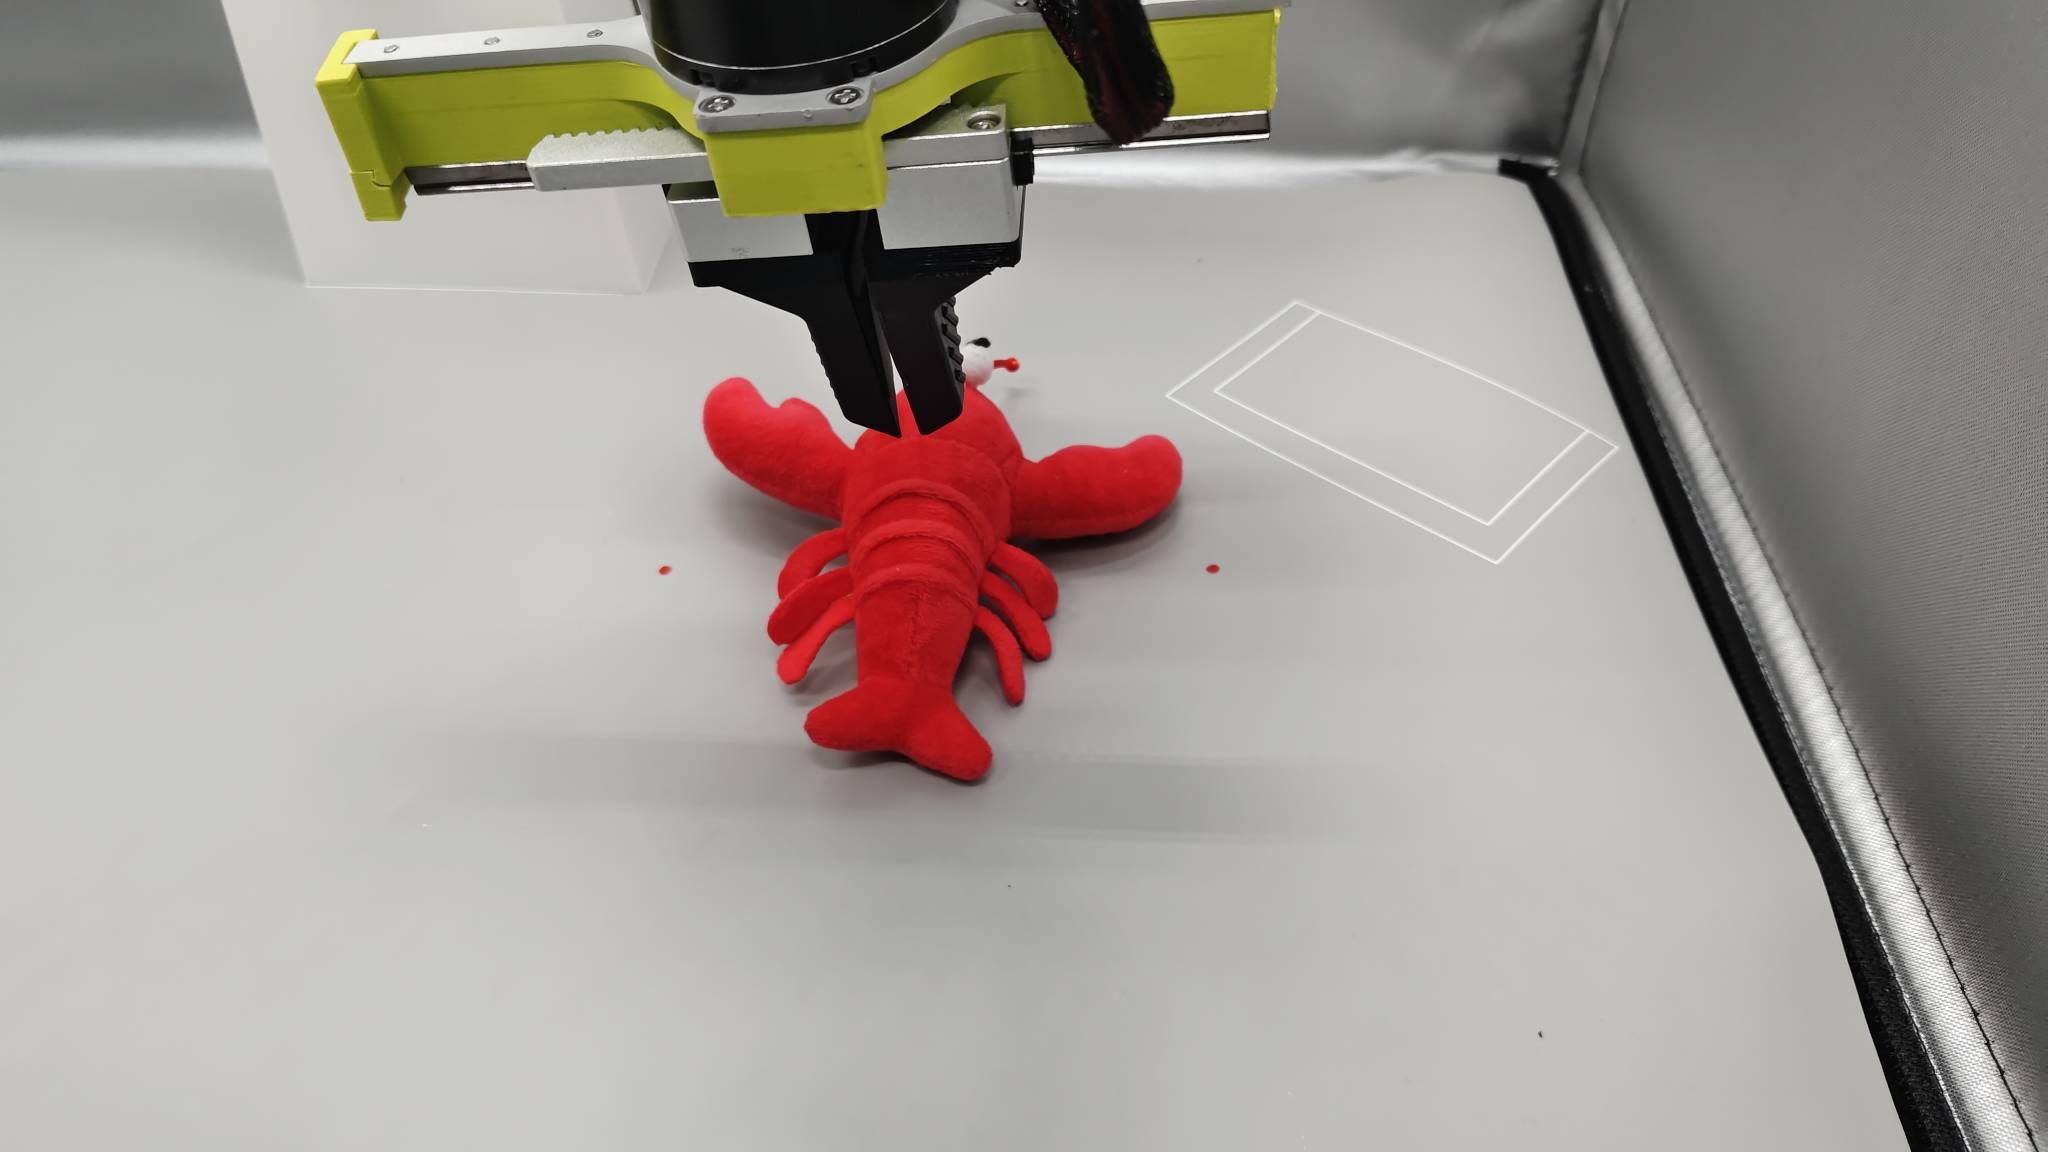
- グリッパを開きます。ザリガニの上に十分なクリアランスを確保することで、指を開く際にザリガニに当たって位置がずれるのを防ぎます。
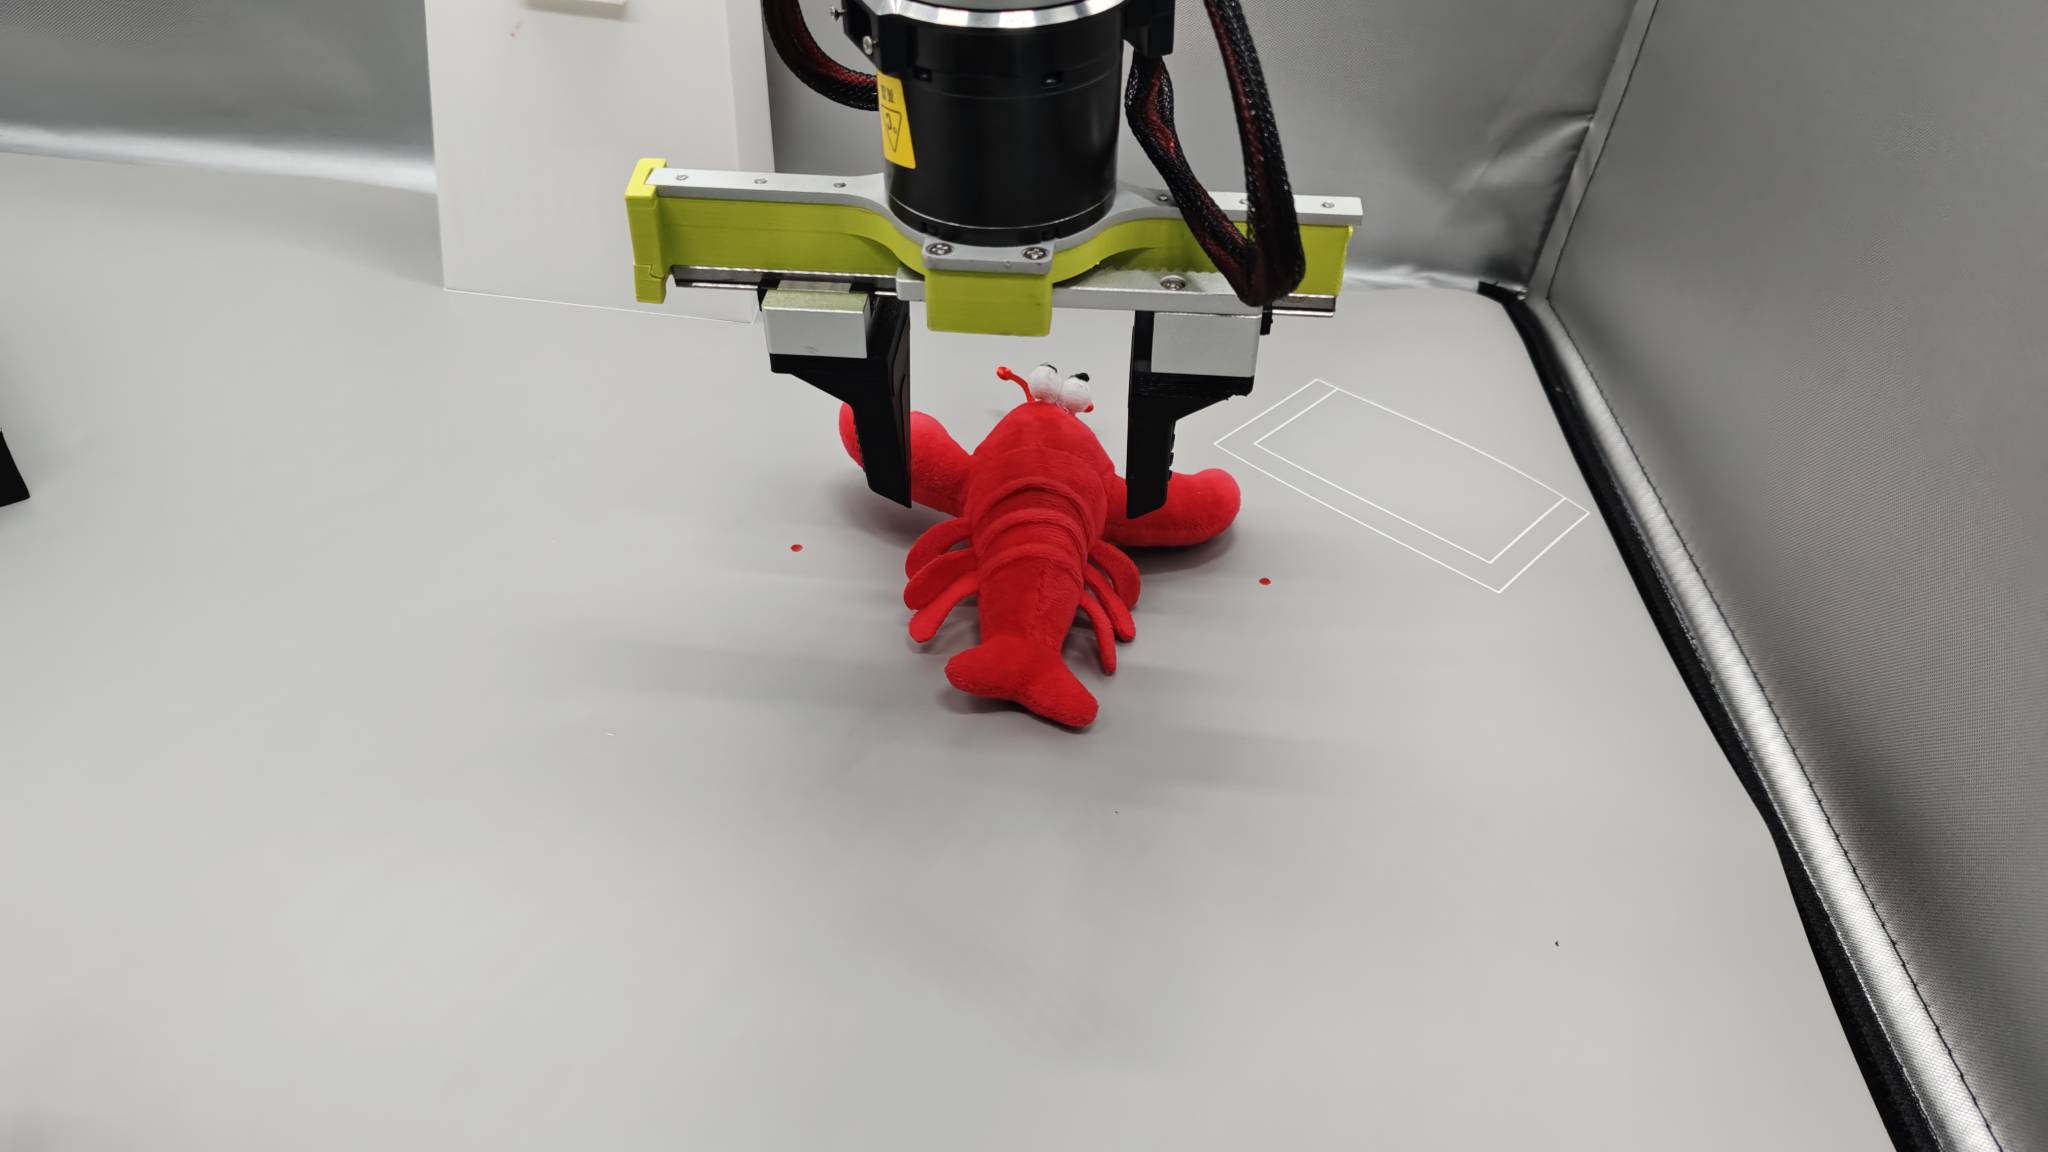
- 一定の力と速度で把持します。
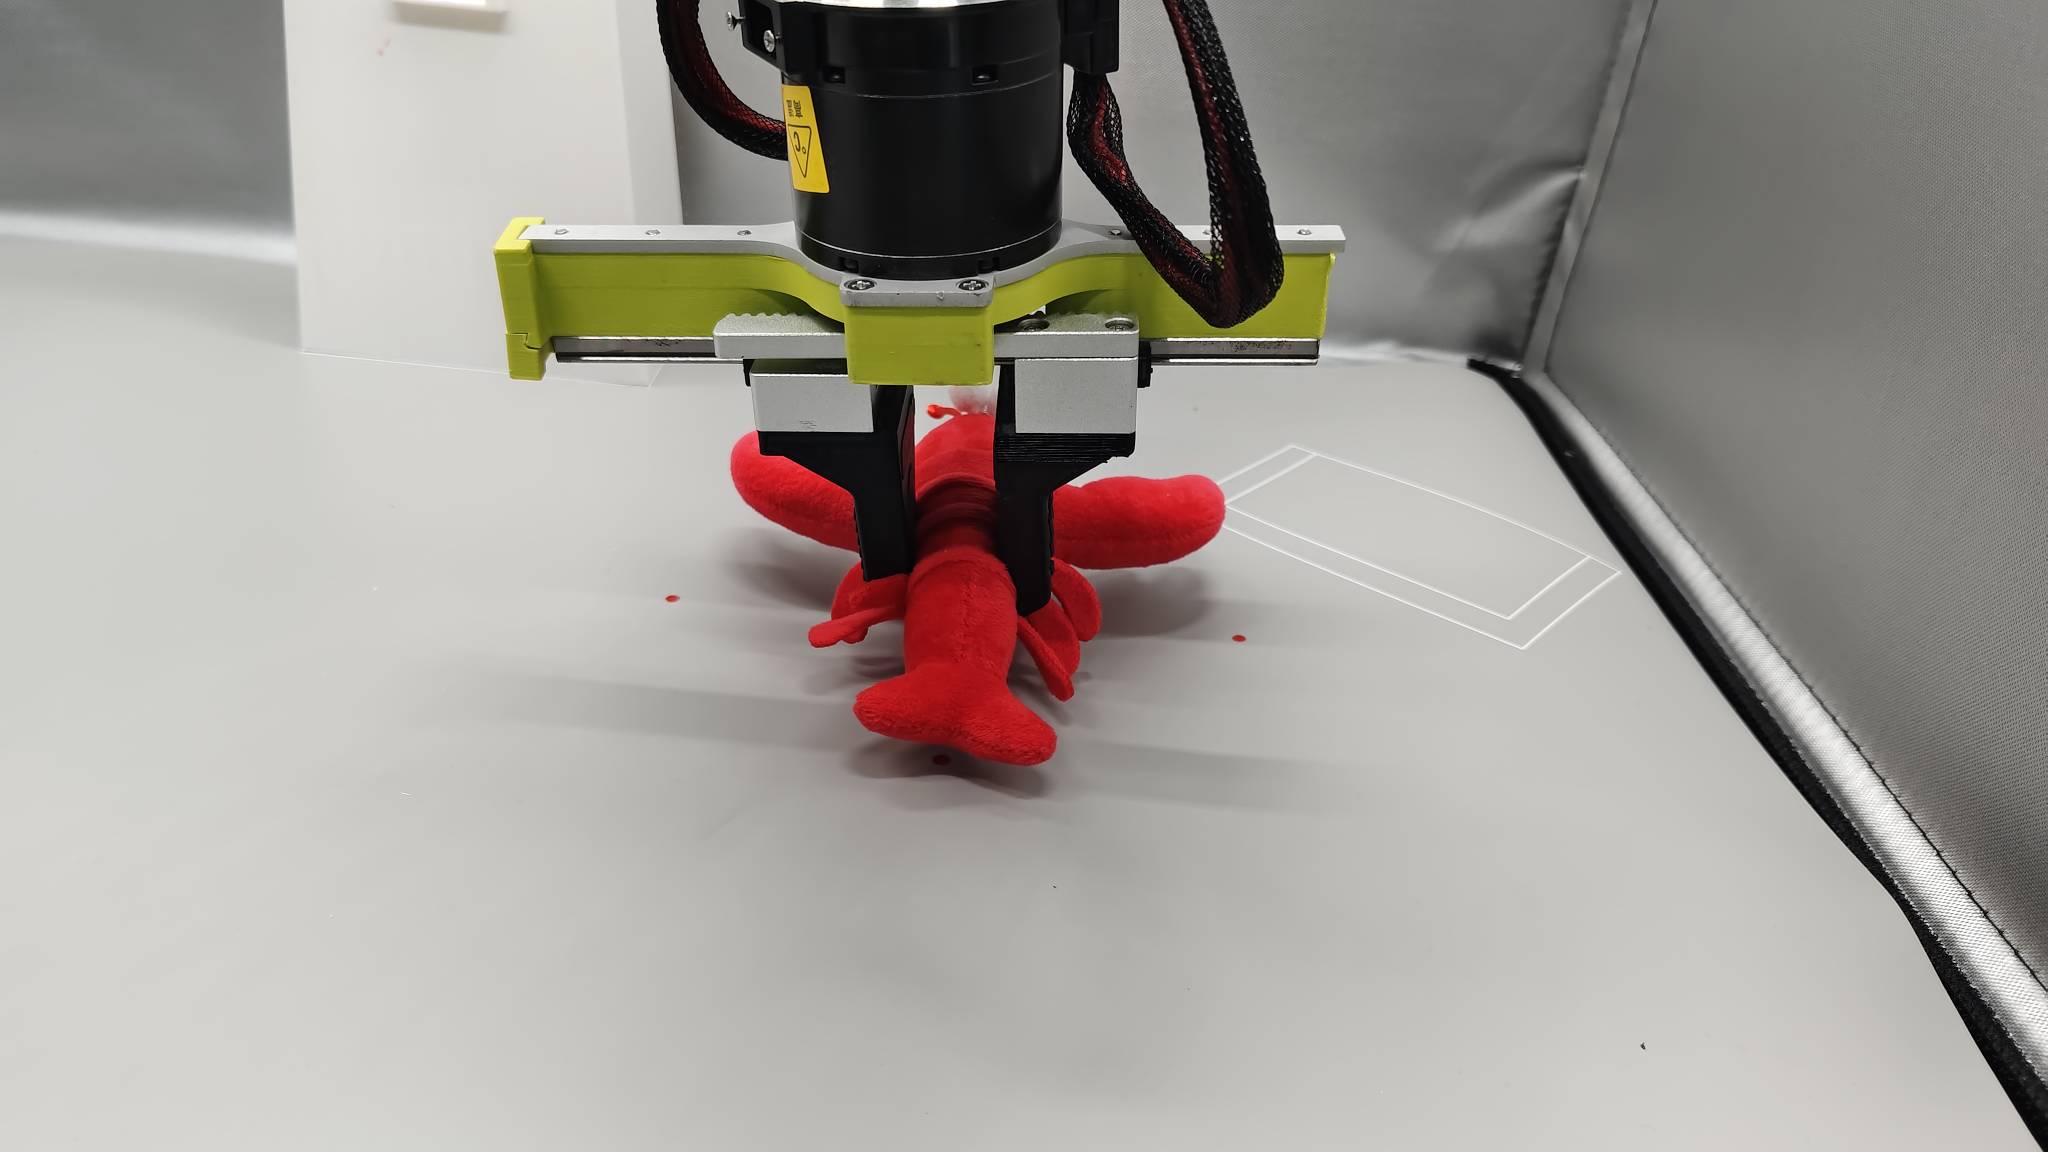
- 物体を配置する
- 黒い箱の中心の真上に移動します。
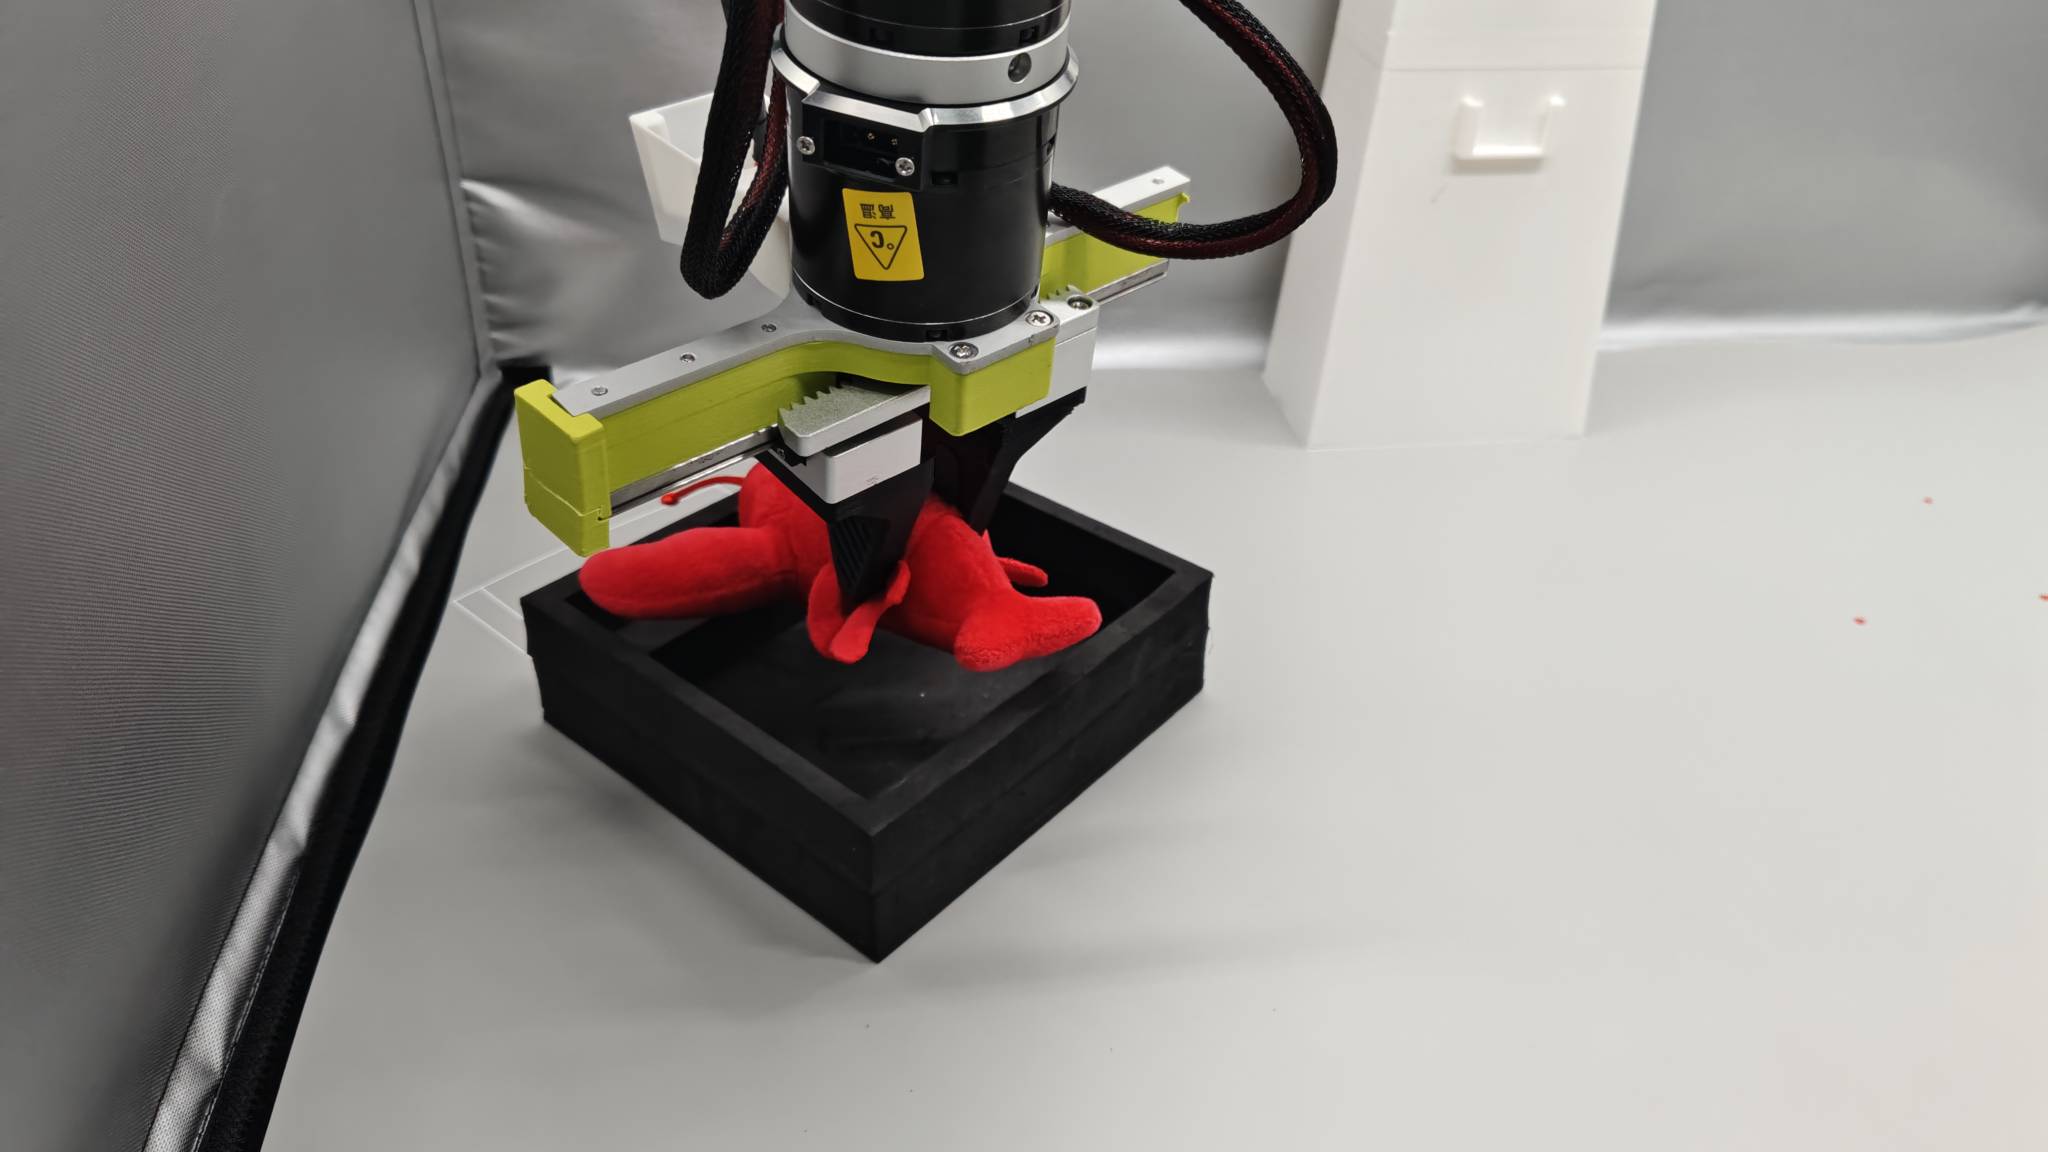
- グリッパを一定の速度で開き、アームを持ち上げます。ザリガニは箱の中に収まるはずです。
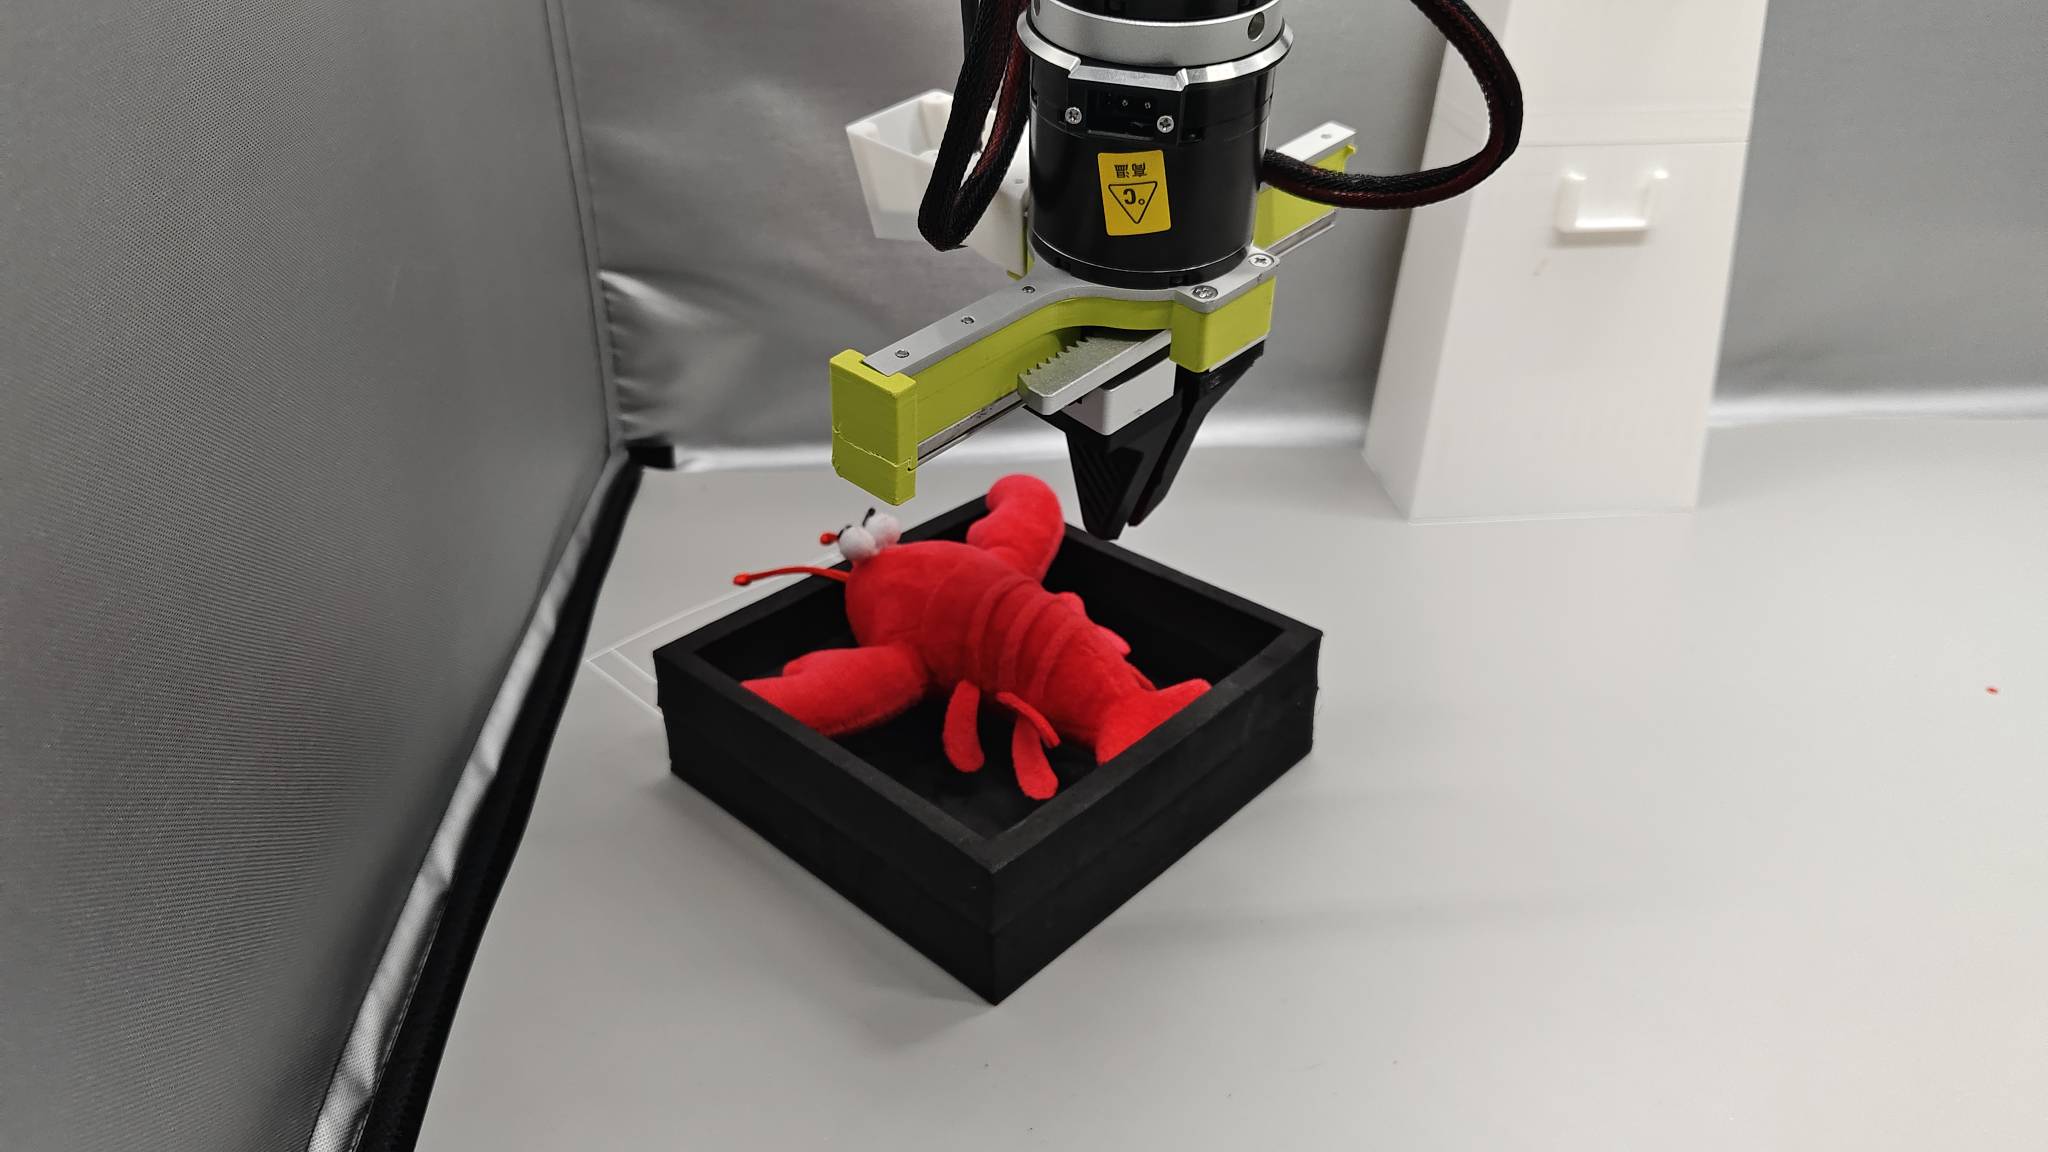
- 配置後、アームを初期姿勢に戻します。
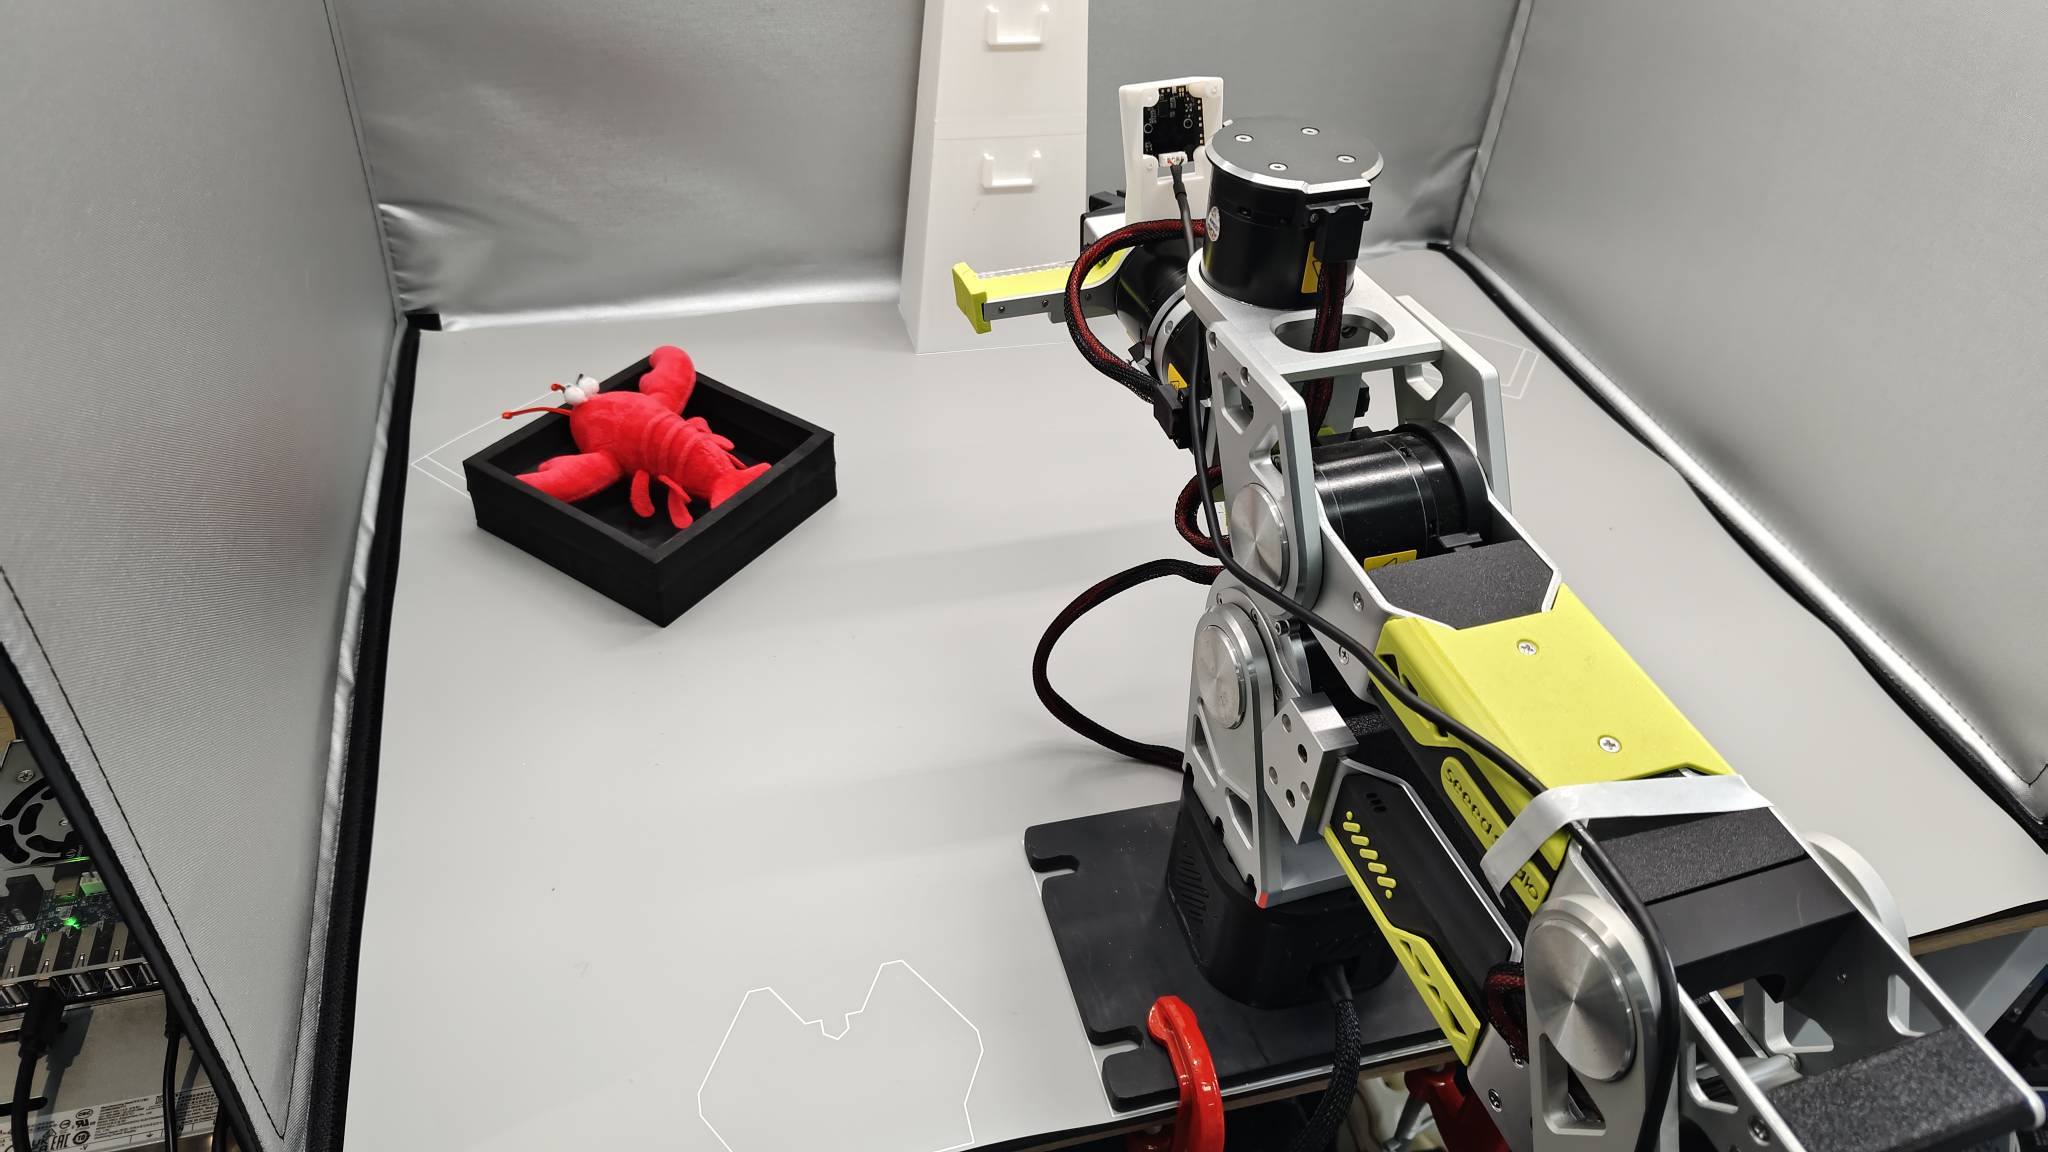
- これで 1 つのエピソード全体が記録されました。この手順を繰り返して 50 個のデモを収集します。
セットアップに関する質問
なぜブラックボックス、カメラの配置、物体配置の方式、および照明を制御された状態に保つのでしょうか?
-
誤解を正す:すべてを任意に変えると、有用な多様性ではなくノイズが増えるだけです。
-
一般化の予算と考える:データが限られている場合、モデルはそのデータを費やした変動だけを学習します。ターゲット位置を変えると、さまざまな位置での把持を学習しますが、カメラを変えると、把持だけでなく視点の変化も学習させることになり、はるかに多くのデータが必要になり、性能が低下する可能性があります。
-
より広いバリエーションが必要な場合:記録中のセットアップを制御しないままにしておくのではなく、後の収集と評価のラウンドで、カバレッジを意図的に拡大します。