ACT: アクションチャンクが低コストな両腕マニピュレーションを可能にする仕組み
低コストハードウェアで精密な両腕マニピュレーションを学習する
- 模倣学習
- ALOHA
- アクションチャンク
- 時間アンサンブル
前提知識
模倣学習とは?
-
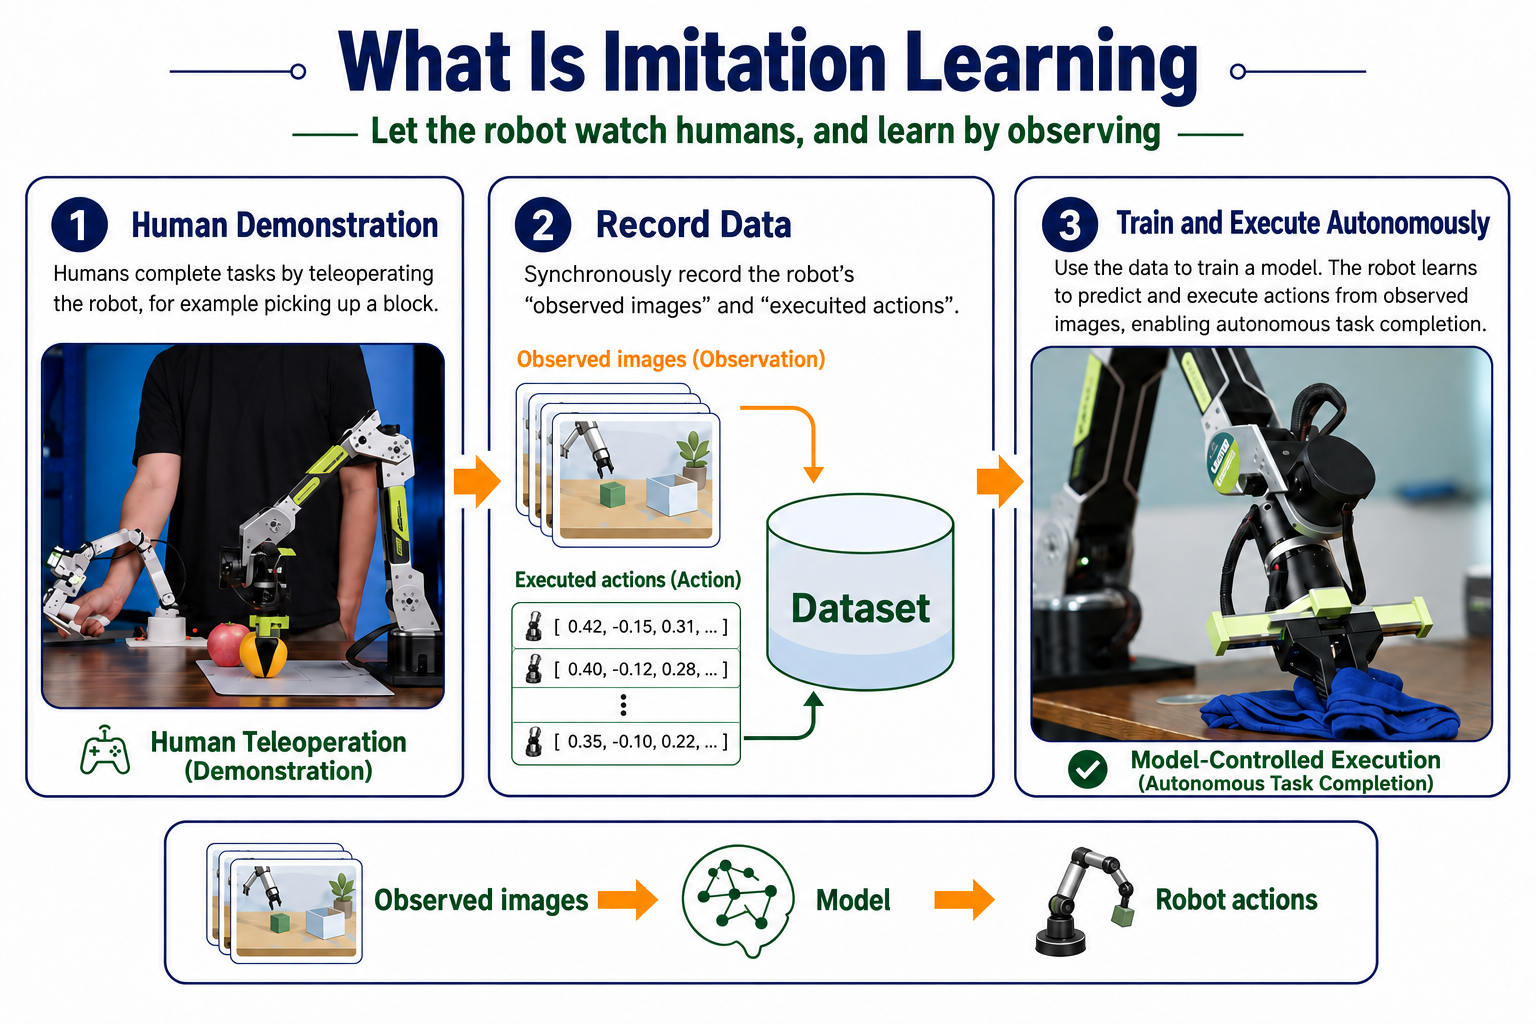
模倣学習 はシンプルな発想から始まります。タスクを実演し、その動きをロボットに真似させて学習させるというものです。
- 人間がアームをテレオペレーションし、その間にシステムがカメラ観測と実行されたアクションを記録します。これらのデモを使ってモデルを学習させることで、後から人間オペレータなしで画像だけを入力として動作できるようになります。
観測:ロボットが見ている世界
-
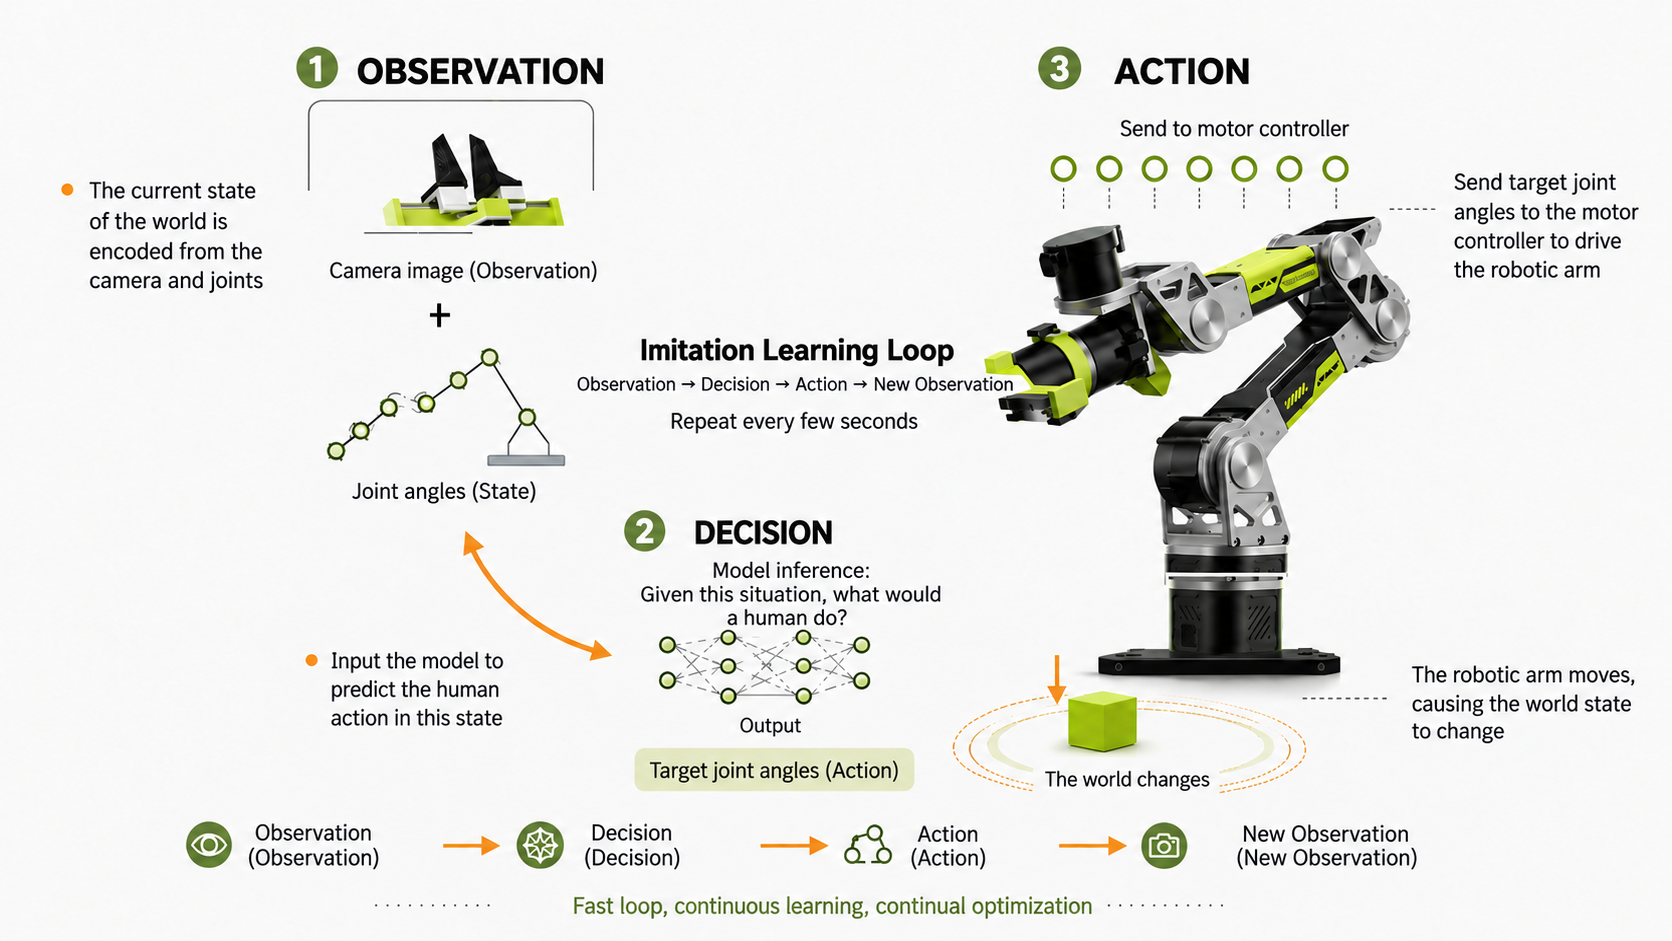
観測とは、センサを通じて得られる環境に関する情報、つまりロボットの「目」にあたるものです。reBot Arm の場合、これには次が含まれます:
-
前面/俯瞰カメラ による、テーブル上の物体とその位置のグローバルなビュー。
-
手首カメラ による、グリッパとターゲットとの関係のクローズアップビュー。
-
状態:ロボット自身の構成
-
状態は、周囲ではなくロボット自身を表します。これは固有感覚(目を閉じていても自分の手の位置や肘の曲がり具合がわかる感覚)に相当します。reBot Arm では、状態には次が含まれます:
-
6 つの関節の現在角度。
-
グリッパの現在の開き具合。
-
アクション:ロボットに与えられる指令
-
アクションは、アームに対するモデルの出力コマンドです。reBot Arm では、状態とアクションは同じ次元数(6 関節+ 1 グリッパ)を持ちます。状態は現在の構成を表し、アクションは目標構成を指定します:
-
6 つの関節の目標角度。
-
グリッパの目標開き具合。
-
単一ステップアクションとアクションチャンク
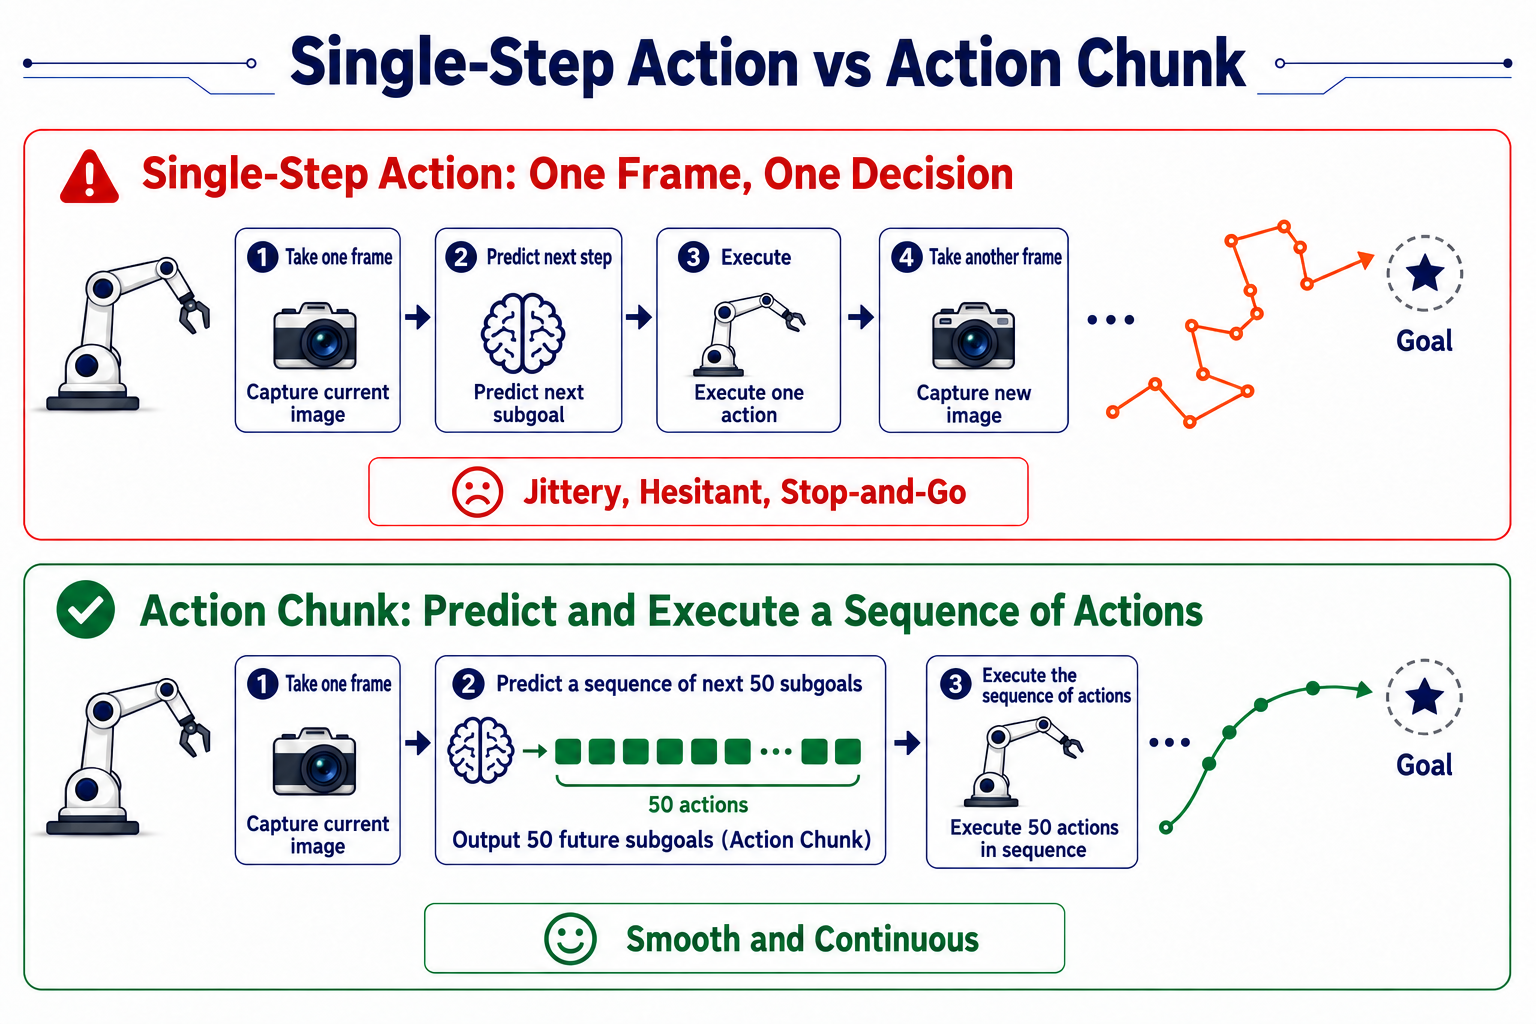
単一ステップアクション:1 フレームごとに 1 回の決定
-
各画像に対して次の関節目標を予測し、それを実行して、次の予測のために別の画像を取得します。
- 小さな予測誤差でもアームの位置を変えてしまい、その後の観測が訓練データ分布から外れていく可能性があります。その結果、後の誤差が増大します。ロボット上では、これがジッタやためらい、繰り返し立ち止まる動きとして現れます。ちょうど、一歩ごとに途中で次の足の運びを考え直しているような状態です。
アクションチャンク:一度にシーケンスを予測する
-
次のアクション 1 つだけでなく、例えば次の 1 秒間にわたる 50 個の関節目標といった短い未来のシーケンスを予測します。
-
推論レート要件の低減。 1 回の予測で短い時間区間をカバーできるため、推論が比較的遅くても滑らかな動作が可能になり、控えめなハードウェアでの運用において重要です。
-
より豊かな時間構造。 複数の将来アクションを予測することで、モデルが意図されたシーケンスを表現するよう促され、一時的な乱れによって軌道が大きく外れる可能性を下げます。
-
より滑らかで一貫した動き。
-
チャンクは長ければよいというものではありません。実行中に物体が動くと、遠い将来の予測は古くなってしまいます。実用的なシステムでは、チャンクの一部をオープンループで実行し、その後で観測して再度予測することでバランスを取ります。
学習、推論、評価
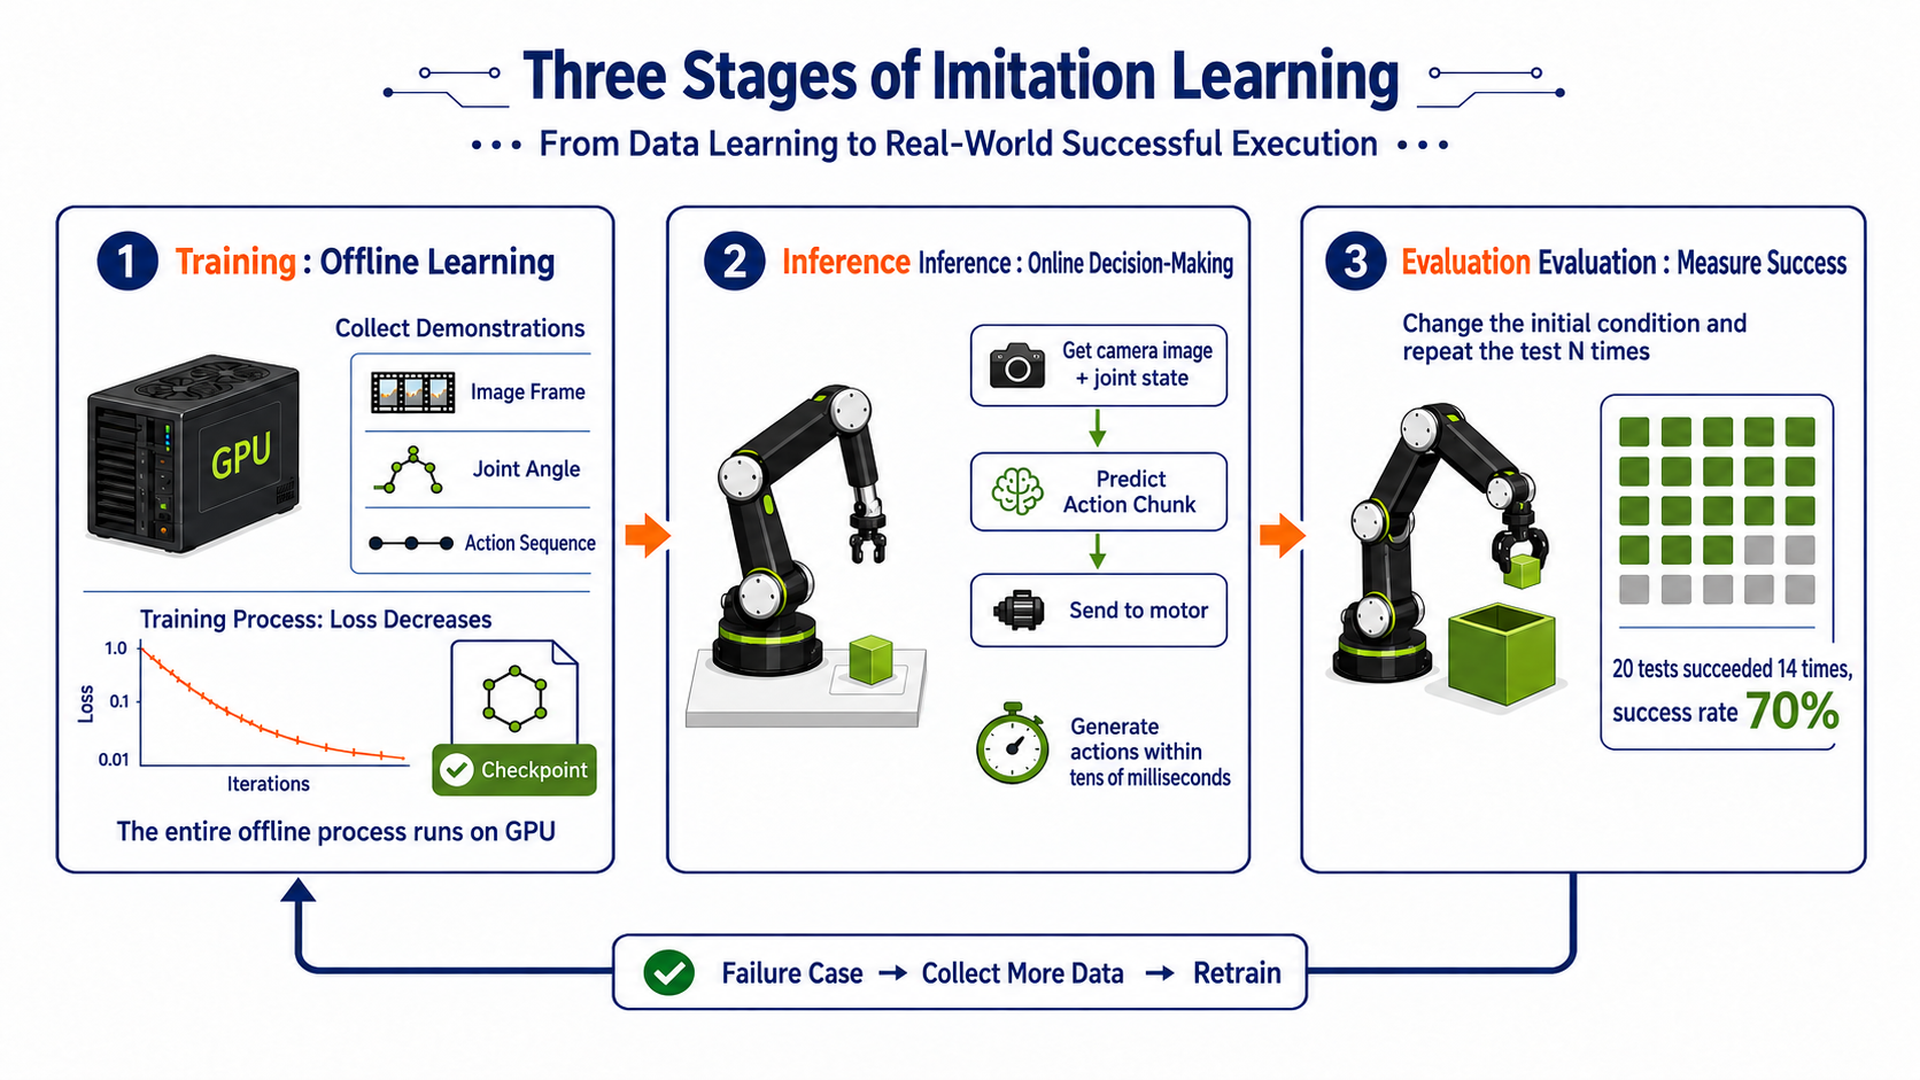
学習:オフライン学習
学習は、データ収集後に行う オフライン プロセスです。GPU が計算している間、アームの電源は切っておけます。
-
入力:記録された画像、状態、アクションのシーケンス。
-
プロセス:モデルパラメータを繰り返し調整し、予測アクションが人間のデモに近づくようにします。
-
出力:学習済みモデルの重み。
損失(Loss) は学習の適合度を追跡します。損失が減少するということは、予測がデモにより近づいていることを意味します。
推論:オンラインでの意思決定
- 推論とは、実ロボット上でモデルを動かし、リアルタイムに動作させること です。カメラ画像と関節状態を読み取り → アクションチャンクを予測し → それをモータに送ります。予測は数十ミリ秒以内に届く必要があり、間に合わないとアームがぎくしゃく動いてしまいます。
評価:タスク成功度の測定
損失が低い学習済みモデルでも、タスクに失敗することがあります。低い損失が測っているのは模倣の正確さであり、タスク完遂ではありません。 実ロボット上で評価します:
-
例えば「ブロックが箱の中で止まる」といった、明確な成功条件を定義します。
-
物体位置や照明などの初期条件を変えながら、N 回の試行を行います。
-
成功率を測定します。20 回中 14 回成功なら 70% です。
失敗例は次のデータ収集ラウンドの入力になります。失敗した状況に対するデモを追加し、再学習します。これにより、実用的なロボット学習で用いられる「データ収集 → 学習 → 評価」のループが閉じます。
論文の背景
著者:Tony Z. Zhao¹, Vikash Kumar³, Sergey Levine², Chelsea Finn¹。所属:¹ スタンフォード大学、² UC Berkeley、³ Meta。
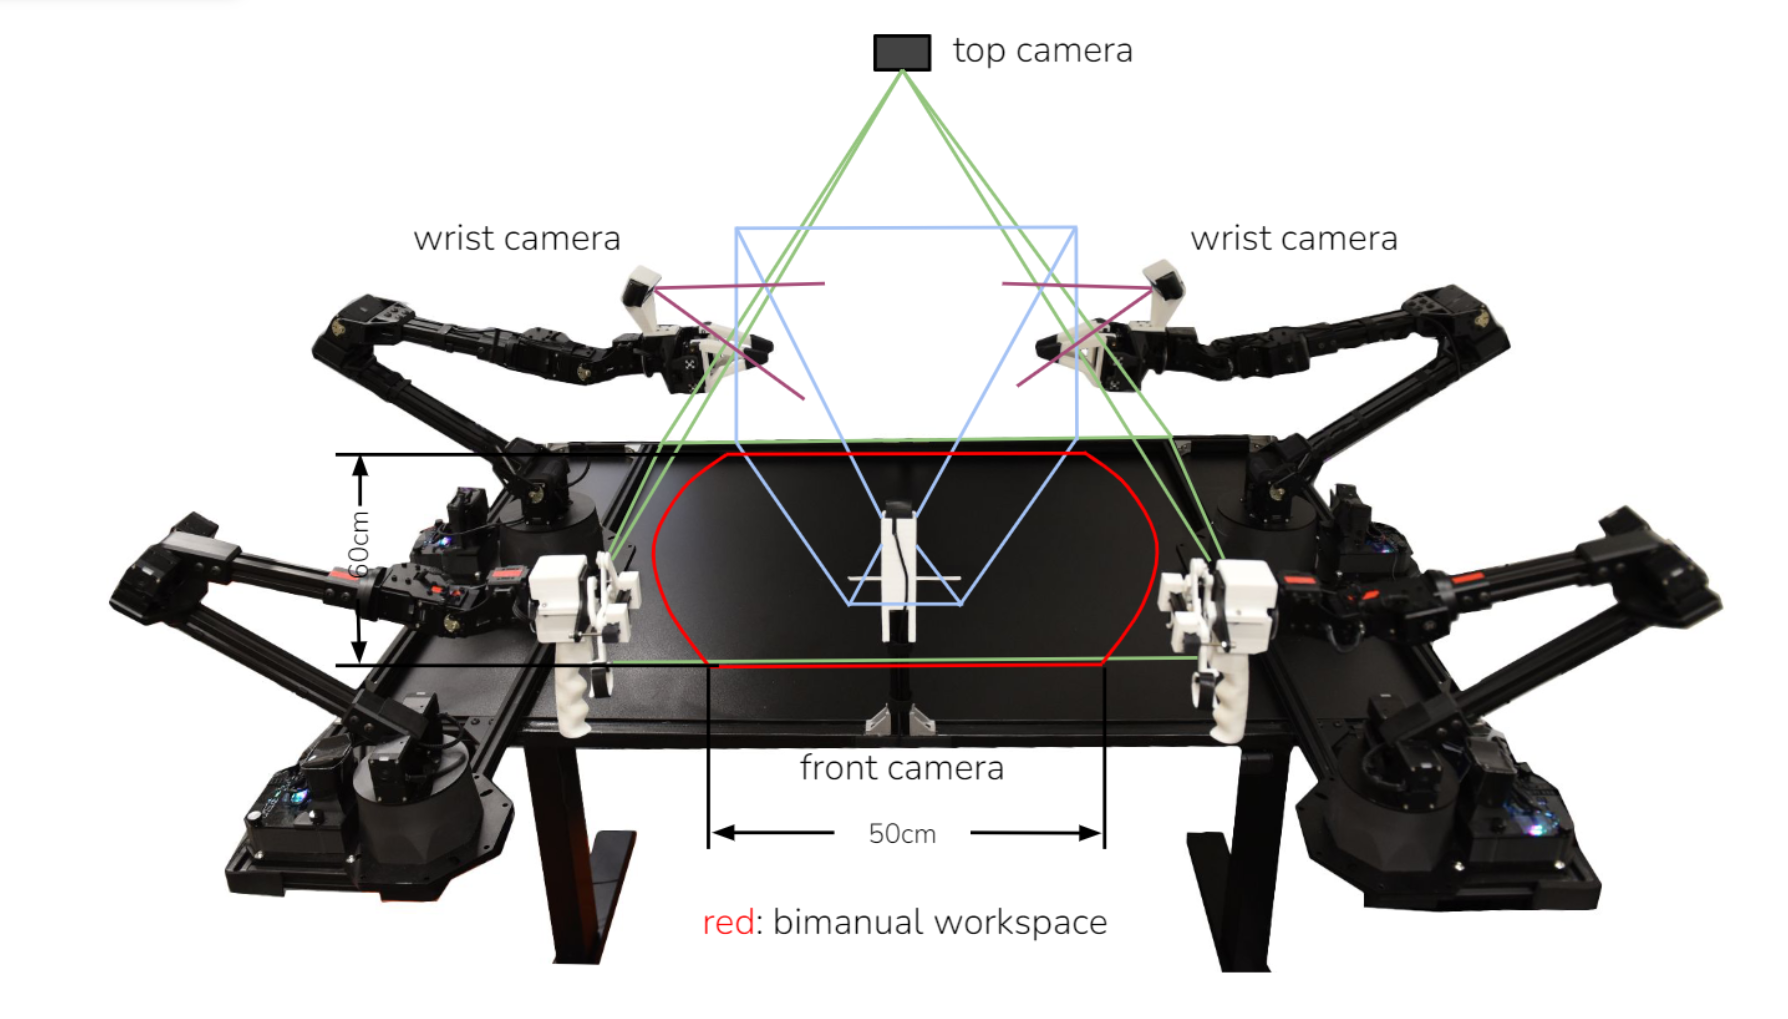
論文の背景:この軽量な模倣学習アルゴリズムは、畳み込みネットワークと Transformer を組み合わせたもので、2023 年にスタンフォード大学と UC Berkeley の共同チームによって発表されました。実験プラットフォームは 6 自由度の ALOHA 両腕テレオペレーションシステムで、2 つのグリッパに単眼カメラ、さらに俯瞰の単眼カメラが 1 台設置されています。
要約
- 解説:
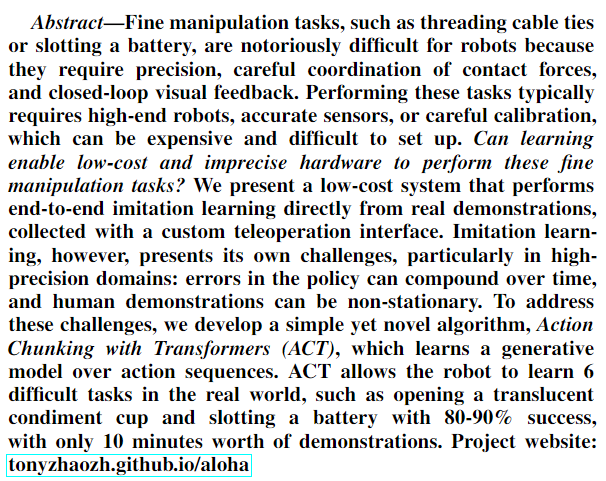
結束バンドを通す、電池を挿入する、といった精密な操作はロボットにとって難しいタスクです。そこでは高い精度、接触力の協調制御、そしてクローズドループの視覚フィードバックが求められます。従来の解法は、高価なロボットや高精度センサ、綿密なキャリブレーションに依存しがちです。学習によって、安価で精度の低いハードウェアでもこれらのタスクをこなせるようにできるでしょうか?
本論文は、カスタムテレオペレーションインターフェースを通じて実世界のデモを収集し、エンドツーエンドの模倣学習を直接行う低コストシステムを提案します。特に高精度タスクでは、ポリシー誤差の累積や、人間デモの非定常性が課題となります。提案手法である Action Chunking with Transformers (ACT) アルゴリズムは、アクションシーケンスの生成モデルを学習します。わずか 10 分間のデモだけで、ロボットは半透明のソースカップを開ける、電池を挿入するといった 6 つの難しい実世界タスクをこなせるようになり、成功率は 80〜90% に達します。
- コメント:
従来の模倣学習はしばしば「観測 → アクションを 1 つ予測 → 実行 → 再び観測」というサイクルを繰り返します。精密タスクでは、わずかな誤差でもロボットをデモに含まれていない状態へと押し出してしまい、その後の予測がさらにずれていきます。これが 誤差の累積(compounding error) です。
ACT の中心的なアイデアは アクションチャンク です。1 回に 1 つのアクションではなく、連続した未来のシーケンスを生成します。これにより時間的な連続性が保たれ、誤差が蓄積する有効な意思決定ホライズンを短くできます。
Transformer はシーケンス間の関係を扱うのに適しており、「今この瞬間に何をすべきか」だけでなく、時間を通じてアクション同士がどう関係するかを学習できます。
ACT によって、ロボットは短いアクションシーケンスを一度に予測できるようになります。
序論
-
第 1 段落:問題設定。 カップを開ける、電池を挿入する、といったつまむ・こじる・引き裂くような繊細なタスクには、環境の変化に応じてアクションを調整できるような高精度の視覚フィードバックと手と目の協調が必要です。
-
第 2 段落:従来の制約と提案手法。 Grasping with Chopsticks や Goal-conditioned dual-action imitation learning のような研究は、高価なハードウェアや綿密なキャリブレーションに依存しています。著者らは代わりに、手頃で、アクセスしやすく、再現性の高い システムを目指します。すなわち、通常の RGB 画像 → ニューラルネットワーク → ロボットアクションという流れです。
-
パラグラフ 3:プラットフォーム。 実験用ハードウェアの費用は 20,000 米ドル未満です。
-
パラグラフ 4:ACT は模倣学習における誤差の累積を扱います。
良いデモンストレーションがあっても,行動予測には小さな誤差が含まれ得ます。精密作業では,誤差によってロボットが訓練時とは異なる状態に移動し,その後の予測が徐々に信頼できなくなります。
著者らは心理学における action chunking から着想を得ています。人間は連続した動きを,あらゆる瞬間を独立した行動として扱うのではなく,一貫した単位としてまとめて組織化します。
従来の模倣学習:現在の観測 → 次の行動。
ACT:現在の観測 → 次の k タイムステップ分の行動。
短いシーケンスを予測することで,実質的な意思決定のホライズンを k 倍だけ短縮し,個々の意思決定にまたがって誤差が蓄積する影響を軽減します。
チャンク化は,ポーズなど,人間のデモンストレーションに見られる不規則性を説明するのにも役立ちます。シーケンスモデルは,一瞬の観測だけで説明しようとするのではなく,その前後の動きの文脈の中でポーズを解釈できます。
より滑らかな実行のために,temporal ensembling は異なる時刻に予測された重なり合うチャンクを組み合わせます。現在の瞬間に対して 1 つの予測だけを選ぶのではなく,ACT はそれらを重み付きでブレンドし,ジッタを減らします。
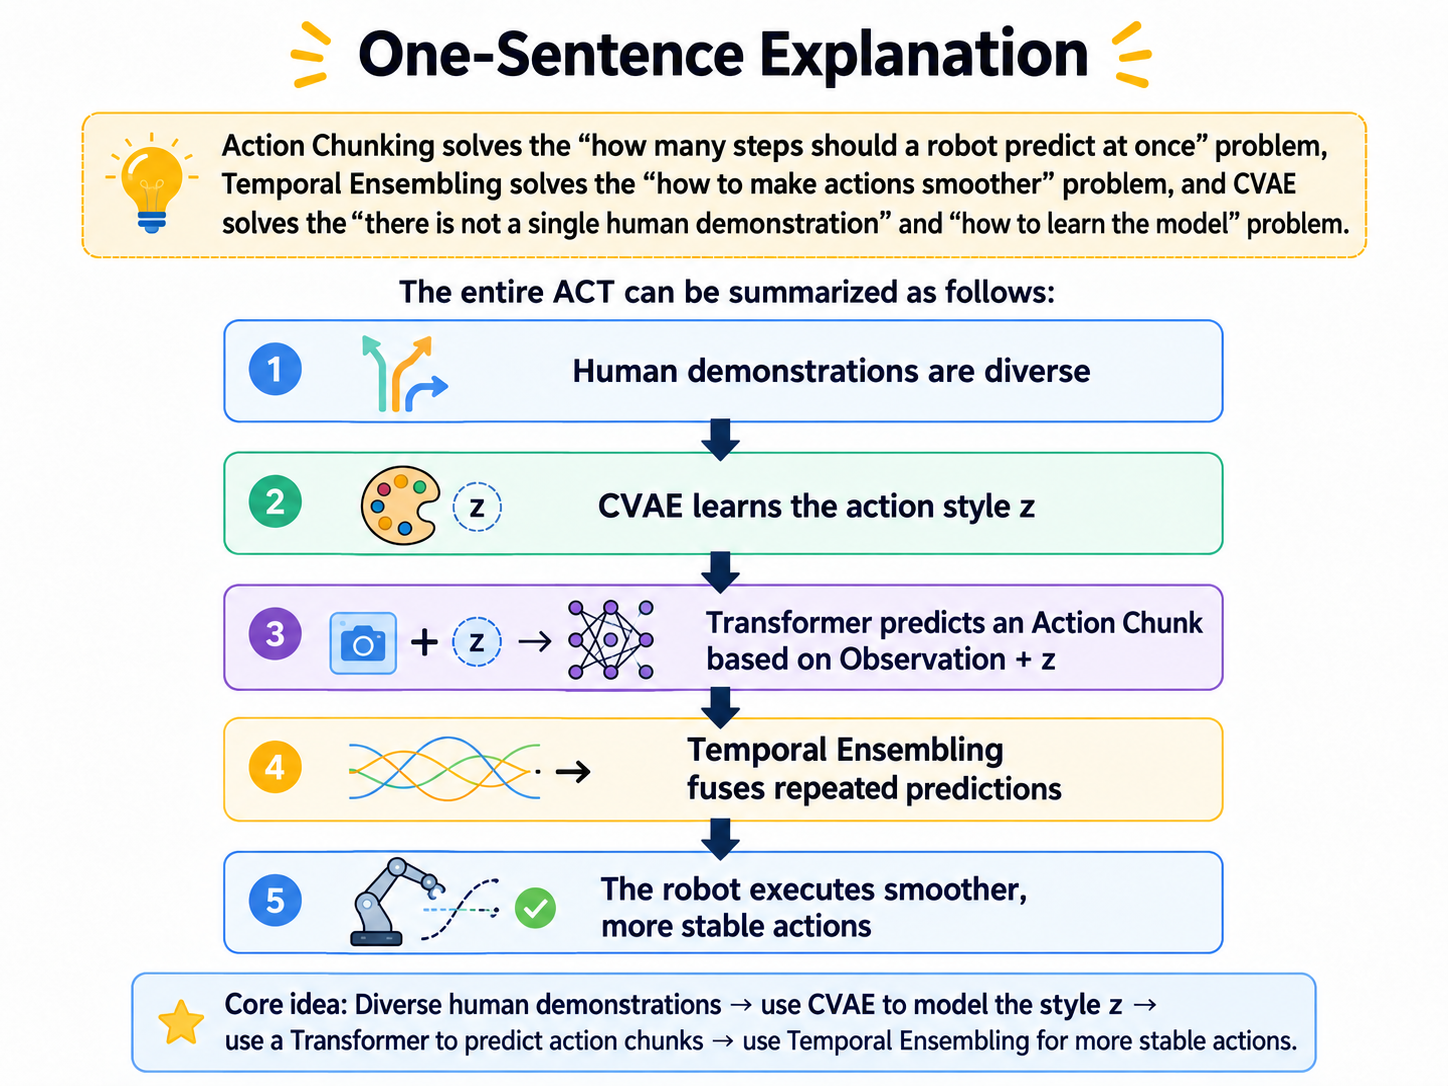
このアーキテクチャは,行動シーケンスに Transformer を,デモンストレーションの多様性に conditional VAE (CVAE) を用います。タスクには複数の妥当な軌道,速度,行動順序があり得ます。CVAE は唯一正しいシーケンスが 1 つだけ存在すると仮定するのではなく,その分布をモデル化します。
Action Chunking with Transformers: ACT。
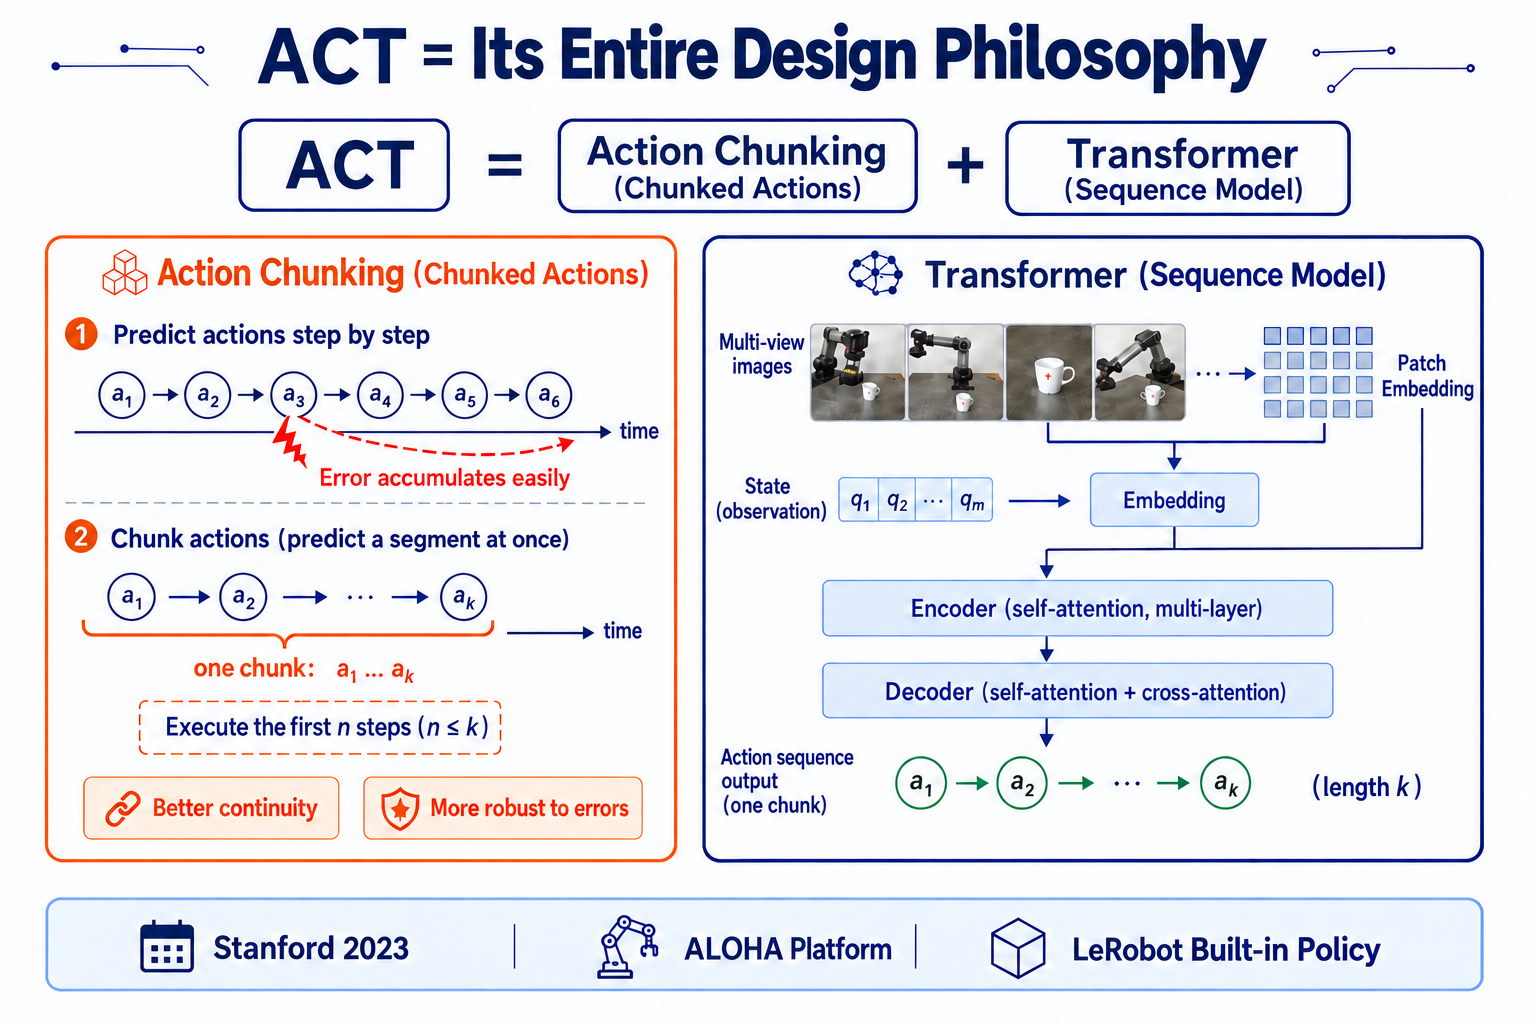
- パラグラフ 5:2 つの貢献は,低コストのテレオペレーションプラットフォームと ACT アルゴリズムです。
この論文は,2 つの関連したロボット学習の問題に取り組みます:
1. デモンストレーションはどこから得るのか?
低コストのテレオペレーションシステムにより,人が直接精密操作を行い,高品質なデモンストレーションを効率的に収集できます。
2. ロボットはそれらからどのように学習するのか?
ACT は action chunk,Transformer,CVAE,temporal ensembling を組み合わせて,視覚フィードバック付きの精密操作を学習します。貢献は ハードウェアと学習の組み合わせ にあります:人間のテレオペレーション → デモンストレーション → ACT の学習 → ロボットの自律実行。
およそ 10 分間,約 50 本の人間の軌道で,このシステムは調味料カップを開ける,電池を挿入するなど,6 つの実世界の精密操作タスクを学習します。タスクによっては 80–90% の成功率を達成します。
関連研究
このセクションでは,従来の行動クローン手法とその限界を概観します。背景理解のために読むとよいですが,本ガイドの実践的な学習目標にとっては必須ではありません。
ALOHA: 低コスト両腕テレオペレーションシステム
設計目標とハードウェア
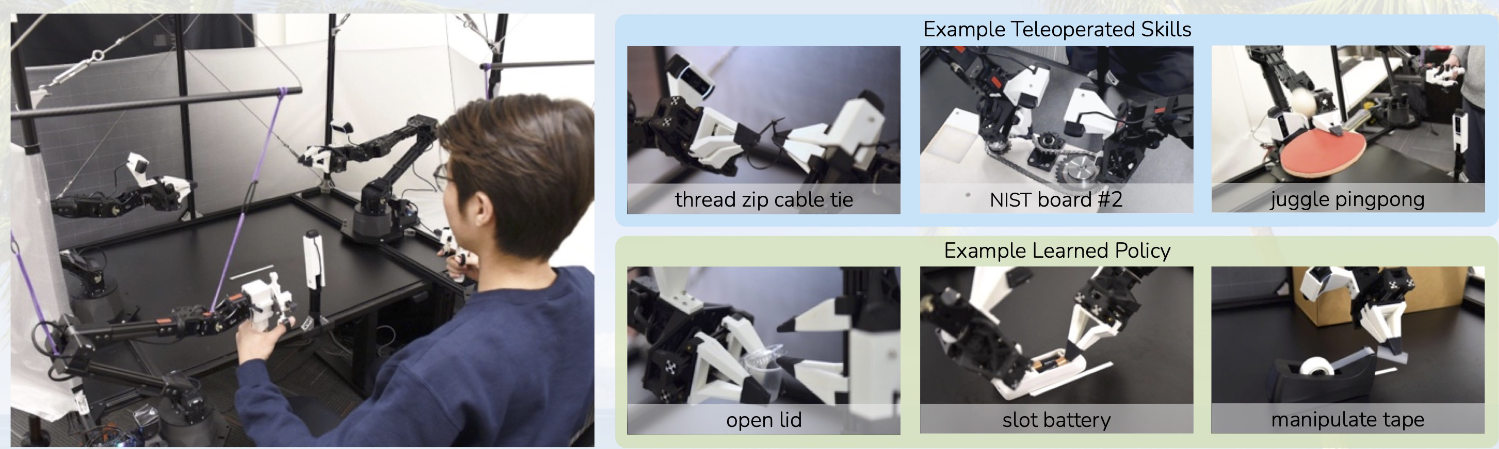
著者らは,精密操作を支援しつつ,一般的な研究室での再現のハードルを下げるために,5 つの設計原則を定義しています。
ALOHA は高価な産業用アームの代わりに,フォロワーロボットとして 2 本の ViperX 6-DoF アームを使用します。各 ViperX の価格は約 5,600 米ドルで,位置決め精度はおよそ 5–8 mm です。
リーダ・フォロワー型テレオペレーション
中心となる設計選択は リーダ・フォロワー 型テレオペレーションです。オペレータは手でリーダを動かし,ViperX フォロワーがその関節運動を追従します。
リーダを動かす → その関節角を読み取る → フォロワーを同期して動かす → タスクを実行する。
これは 関節空間マッピング であり,いくつかの利点があります:
-
頻繁な逆運動学計算が不要。
-
運動学的特異点付近でより安定した挙動。
-
低い制御レイテンシ。
-
オペレータの動きからロボットへの直接的なマッピング。
カメラ,データ収集,および能力
ALOHA は 4 台の一般的な RGB カメラを用いてデモンストレーションを記録します:
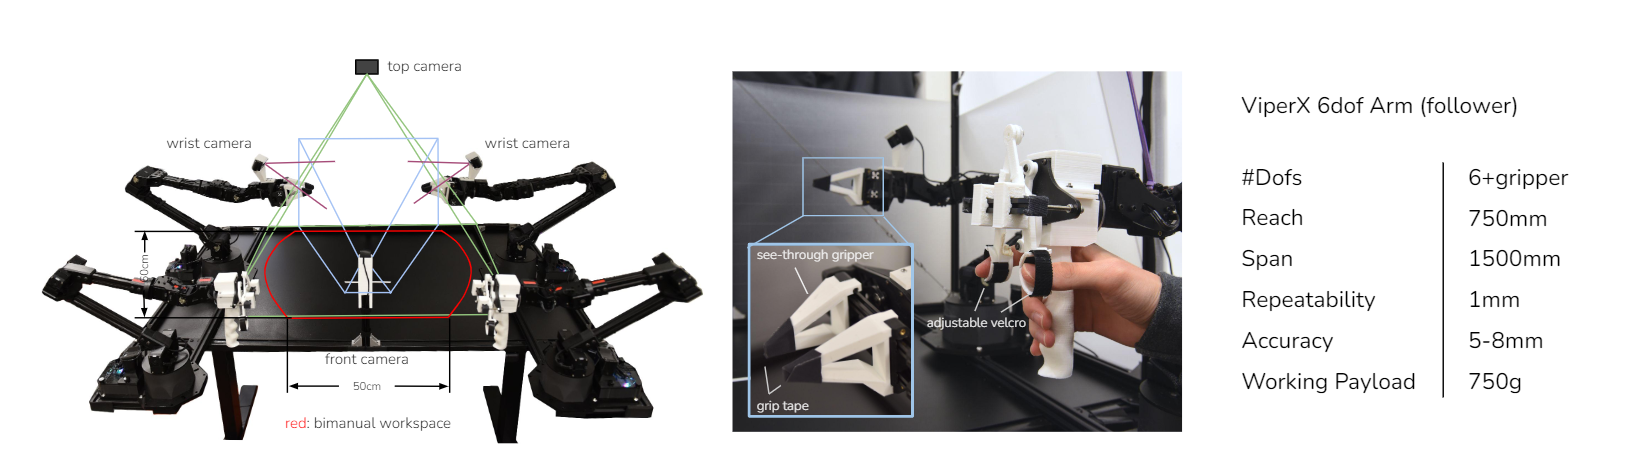
著者らはタスクを大きく 3 つのカテゴリに分類しています:
Action Chunking と Temporal Ensembling
Action Chunking:短いシーケンスを予測する
従来の模倣学習では,現在の状態から次の 1 つの行動を予測します:少し前進し,次に少し下げる,といった具合です。小さな誤差でも次の観測を変化させ,タスクが失敗するまで誤差が累積する可能性があります。Action chunking はこの問題に対する ACT の中核的な応答です。
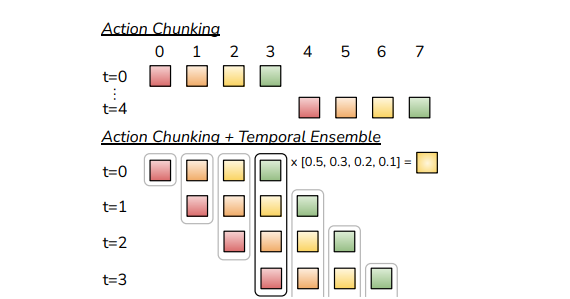
1 つの行動ではなく,連続した将来シーケンスを予測します。 chunk_size = 4 の場合,単一ステップ方策は t=0→a0, t=1→a1, t=2→a2, t=3→a3 で意思決定しますが,ACT は t=0 において [a0,a1,a2,a3] を予測します。このシーケンスが action chunk です。方策は πθ(at|st) から,チャンク長を k として πθ(at:t+k|st) へと変わります。
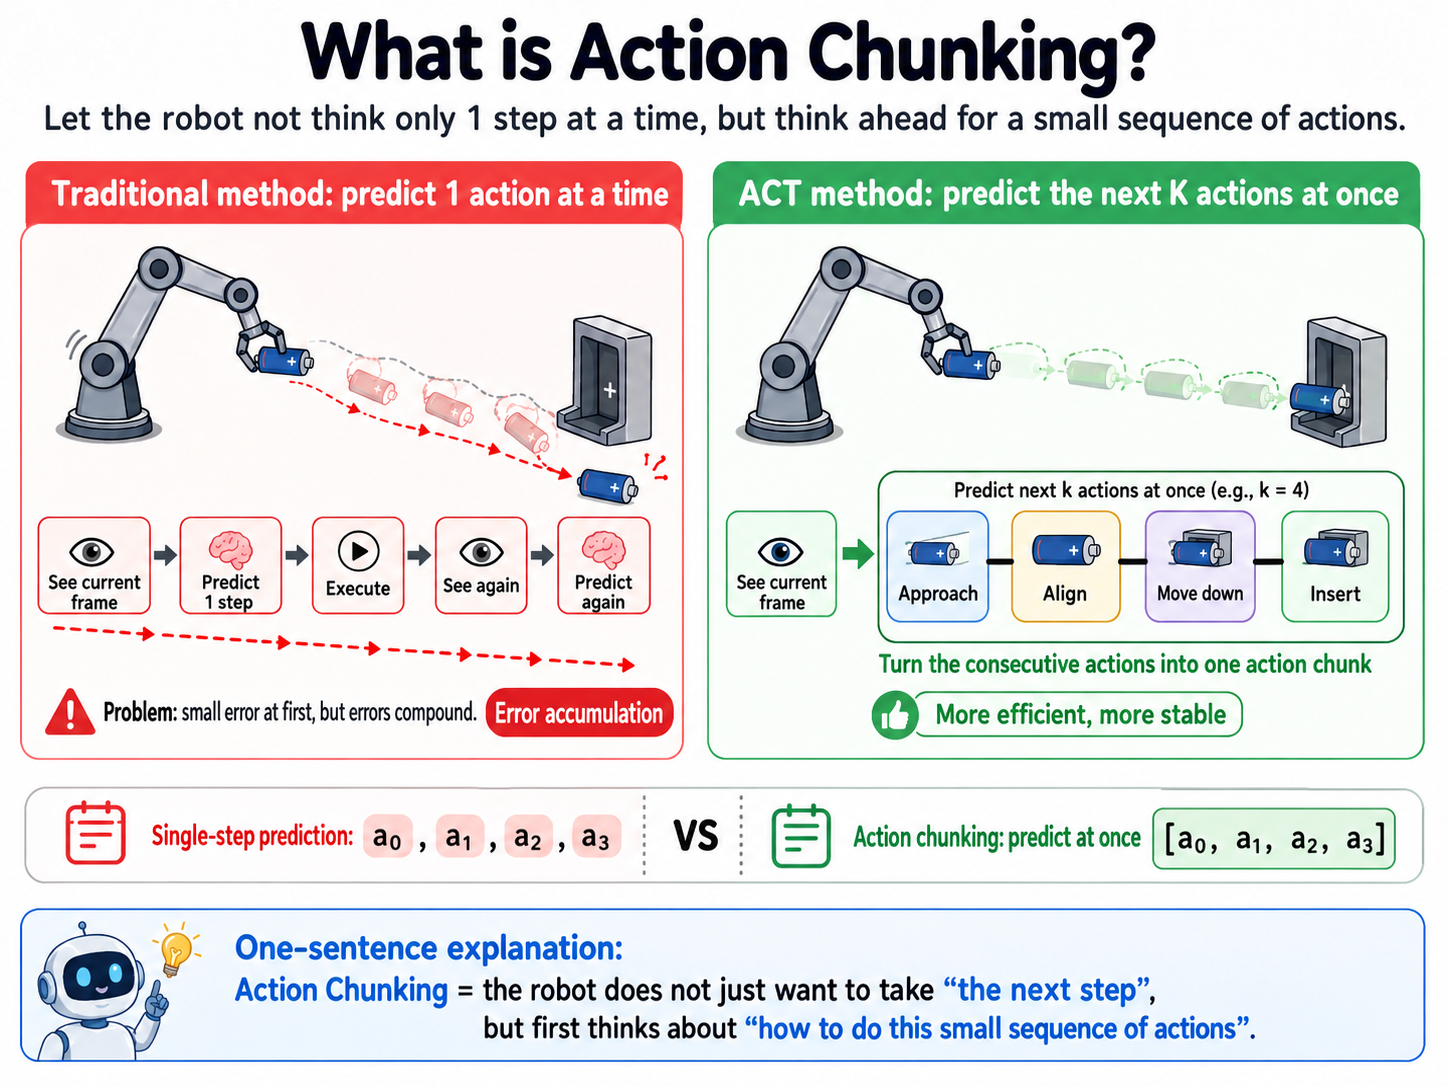
直感的には,あらゆる瞬間を即興で決めるのではなく,短いシーケンスとして考えるということです。電池を挿入するとき,人は自然に「近づく → 整列させる → 挿入する」という一貫した動きとして組織化し,1 ミリごとの修正の長いリストとしては捉えません。チャンク化はその構造をロボットに教えます。
また,有効なホライズンを k 倍だけ短縮します。100 タイムステップのタスクは 100 回の単一ステップ決定を必要としますが,chunk_size=10 なら,より少ない連続セグメントとして捉えられます。数ステップ先まで見通すことで,孤立した小さな誤差が直ちに残りのシーケンスを脱線させる可能性を低くします。
人間のデモンストレーションには,ポーズ,ためらい,速度変化も含まれます。「近づく → ポーズ → 調整 → 挿入」というシーケンスとして学習することで,これらの関係性は,孤立した瞬間として学習するよりも表現しやすくなります。
https://github\.com/huggingface/lerobot/blob/main/src/lerobot/policies/act/modeling\_act\.py
Temporal Ensembling
ACT は短い将来シーケンスを予測しますが,その実行中に環境が変化したらどうなるでしょうか?
temporal ensembling では,ACT はチャンク全体を盲目的に実行するのではなく,あらゆるタイムステップで観測し,新しいチャンクを予測します。chunk_size = 4 の場合,予測は次のようになるかもしれません:
t=0 → [a0, a1, a2, a3]
t=1 → [a1', a2', a3', a4']
t=2 → [a2'', a3'', a4'', a5'']
したがって,同じ将来の瞬間に対して複数の予測が与えられます。例えば t=2 では:
a2 は t=0 に予測されたもの。
a2' は t=1 に予測されたもの。
a2'' は t=2 に予測されたもの。
1 つだけを選ぶ代わりに,ACT は 同じタイムステップに対する予測の重み付き結合を取り,実行される行動を得ます。これが temporal ensembling です。
モデルは異なる観測を用いて,異なる時刻に同じ将来の行動を再検討し,それらの推定値を統合します。
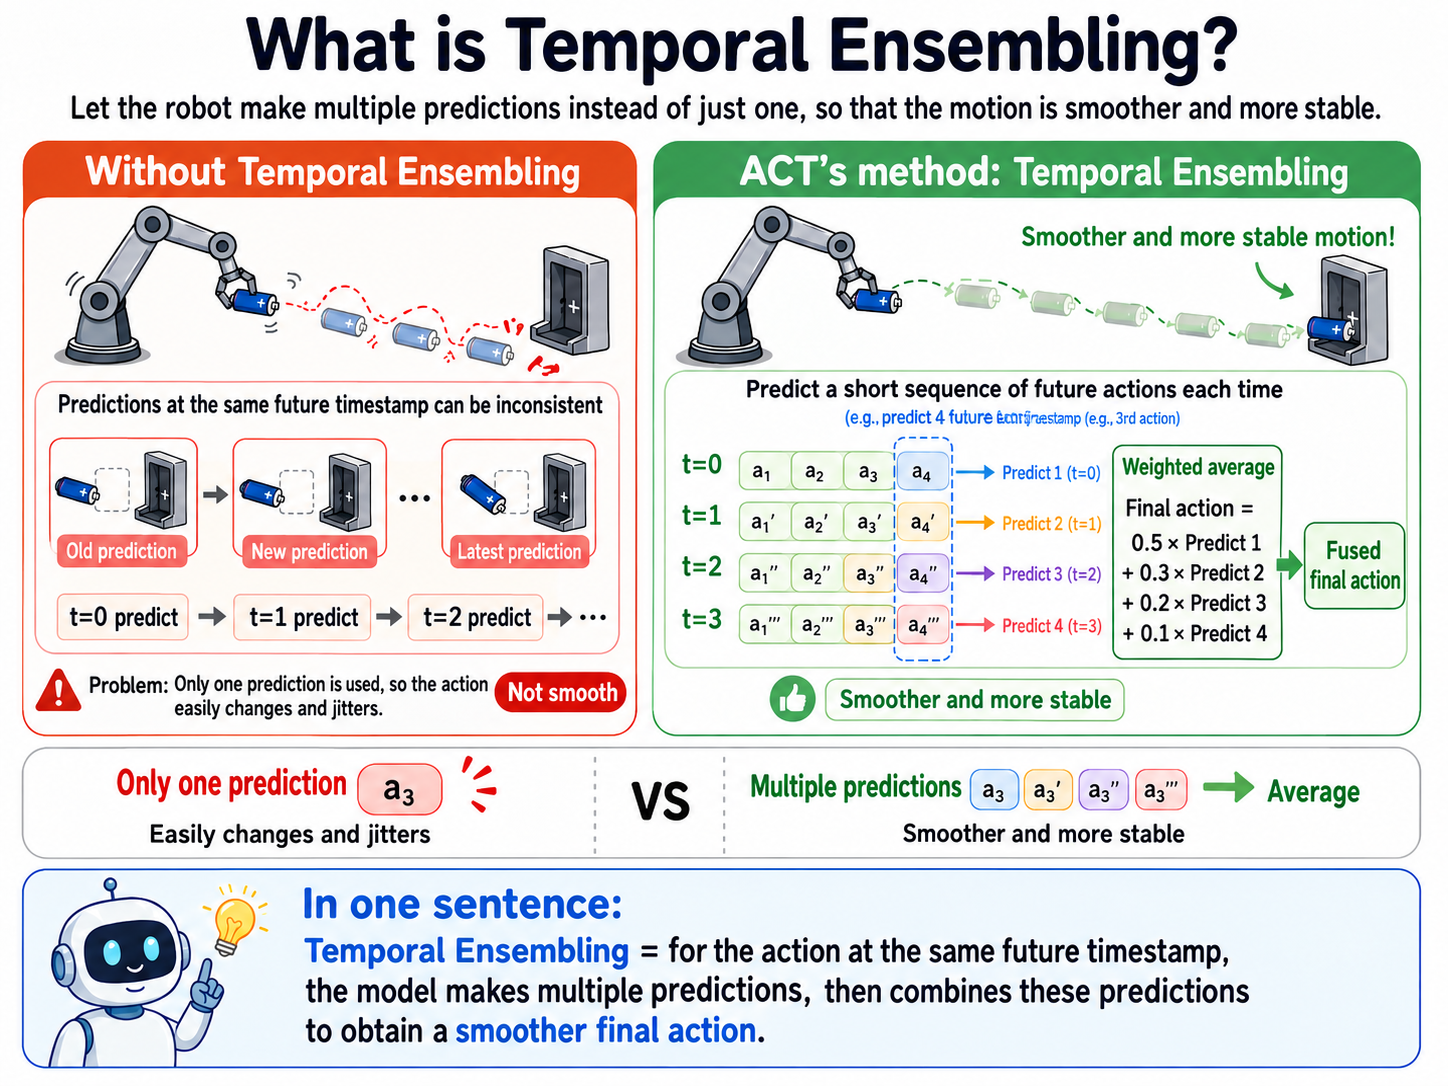
最新の予測だけに従うと,急激なジャンプが生じることがあります。重み付き平均は実行を滑らかにします。これは主に 2 つの問題に対処します:
この論文では指数重みを用いています:
Action chunking は数ステップ先を見通します。Temporal ensembling は繰り返し観測と予測を行い,重なり合う推定値を滑らかに結合します。
CVAE による人間デモンストレーションのモデリング
Action chunking はシーケンスを予測し,temporal ensembling は実行を滑らかにしますが,別の問題が残っています:人間のデモンストレーションは同一ではないということです。
電池を挿入するとき,異なるオペレータは次のようにするかもしれません:
-
異なる角度から近づく。
-
異なる速度で動く。
-
挿入前に左側へ調整する。
-
直接整列させて挿入する。
同じ人であっても,繰り返し試行すると異なる軌道を生成します。したがって,ある観測に対して正しい行動シーケンスは 1 つだけではありません。次のように仮定すると,
「この画像からは,ただ 1 つの行動軌道だけが生成されなければならない」
異なる戦略間の平均化を促してしまう可能性があります。2 つのデモンストレーションを考えてみましょう:
Demonstration A: go around the left → insert
Demonstration B: go around the right → insert
単純な平均は次のようになるかもしれません:
Go straight through the middle
しかし,中間には障害物があるかもしれません。
目標は次のことを学習することです:
現在の状態で,人が取り得る妥当な行動シーケンスはどれか。
これが conditional variational autoencoder (CVAE) を導入する動機となります。
ACT における CVAE の動作
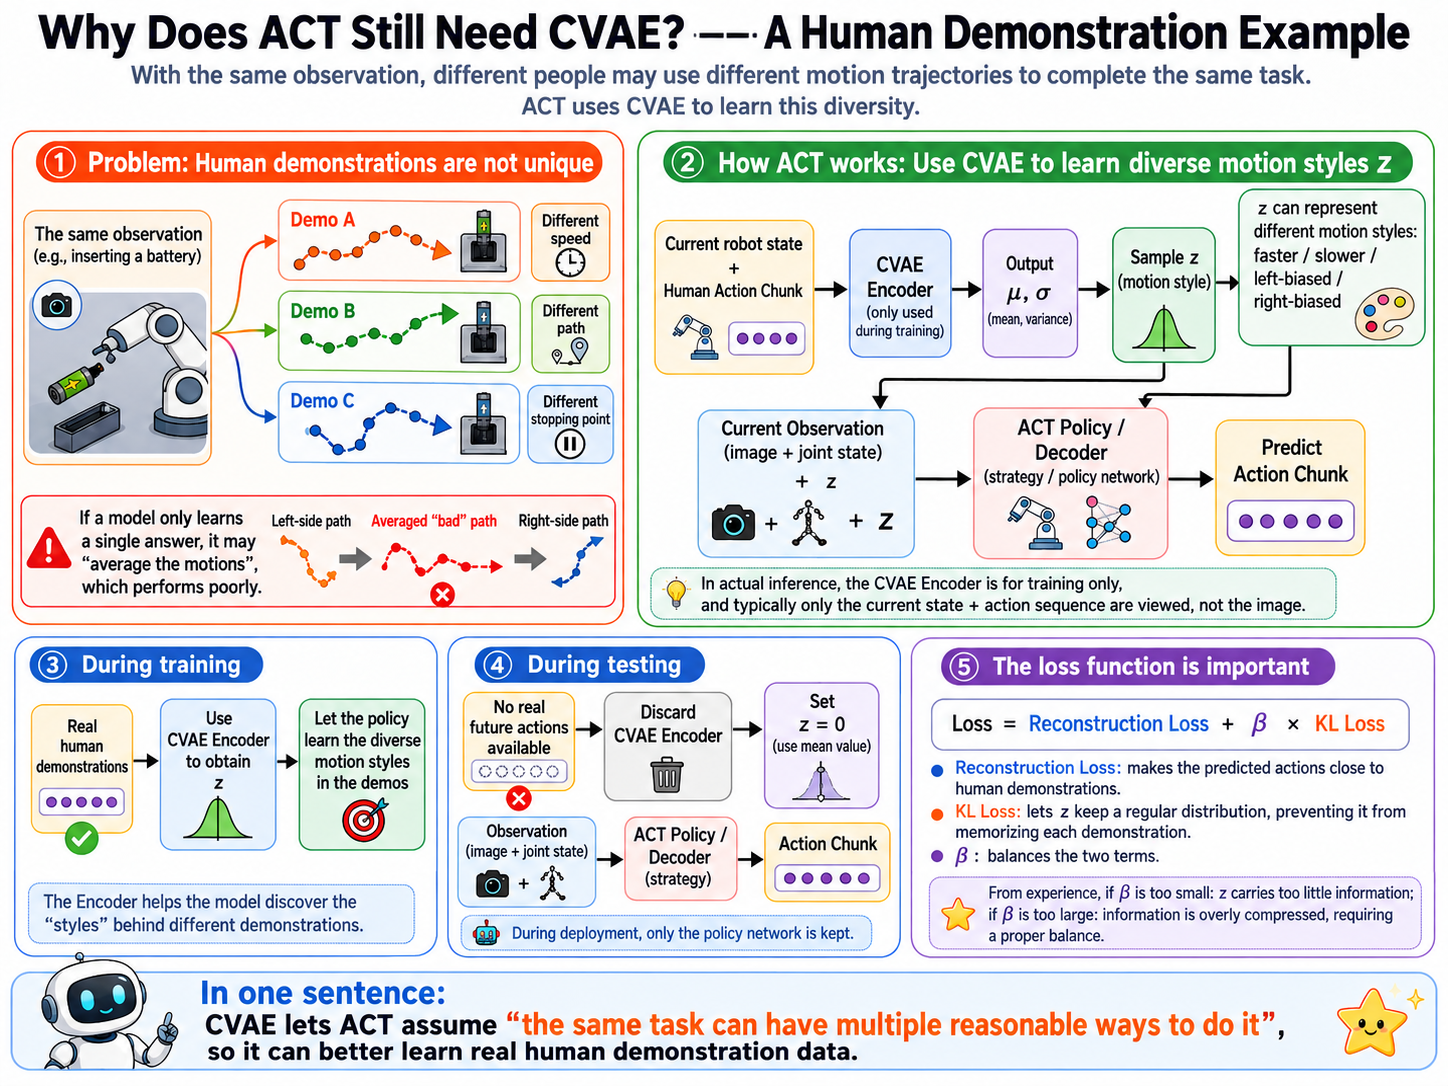
CVAE には 2 つの主要なコンポーネントがあります:
エンコーダは次の情報を使用します:
-
現在のロボット状態。
-
デモンストレーションされた行動シーケンス。
これにより潜在的な「動きのスタイル」を推定します。単一の固定された を出力するのではなく,ガウス分布のパラメータ を予測します:
-
平均。
-
分散。
その分布から をサンプリングすることで,モデルはデモンストレーションのスタイルに関する不確実性を,1 つの硬直した値を割り当てるのではなく表現できます。これは VAE の中心的なアイデアです。
原理的には,学習時の CVAE エンコーダは次の情報を受け取ることができます:
Image + Robot State + Action Sequence
学習を高速化するため,著者らは CVAE エンコーダから画像を省いています。
実際の入力は次のとおりです:
Robot State + Action Sequence
        ↓
   CVAE Encoder
画像は依然として行動を予測する ACT 方策に入力されます。したがって:
CVAE エンコーダはデモンストレーションのスタイルを抽出し,行動予測ポリシーは依然としてカメラ画像を用いてロボットが何をすべきかを判断します。
完全な ACT ネットワーク
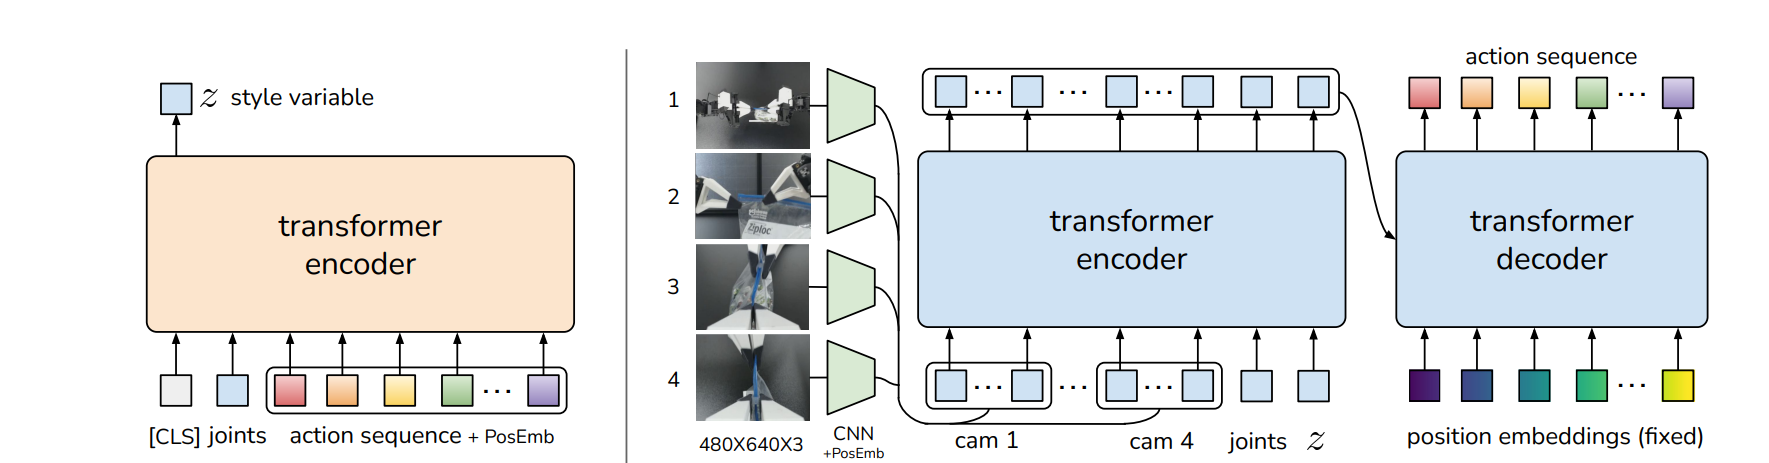
関節位置と提示されたアクションチャンクはまず CVAE エンコーダに入力され、デモンストレーションスタイルの違いを表現し、ガウス分布のパラメータ と潜在スタイル変数 を生成します。このエンコーダはカメラ画像ではなく、関節状態とアクション系列を処理します。
生の RGB 画像を Transformer に入力するのは計算コストが高くなります。ResNet18 はまず各カメラ画像を の特徴マップに変換し、それを の特徴系列にフラット化します。したがって ALOHA の 4 台のカメラからは のビジュアルトークンが得られます。
モデルは 14 次元の関節位置 と潜在スタイル をそれぞれ 512 次元に射影し、これを視覚特徴と連結します。Transformer エンコーダは次のものを受け取ります:
1200+1+1=1202
これにより の系列が得られます。エンコーダは次の 3 種類の情報を統合します:ロボットが見ているもの、現在の構成、デモンストレーションの動きのスタイル。
次に Transformer デコーダ が 個の位置クエリ(各未来タイムステップにつき 1 つ)を用います。クロスアテンションによりエンコーダ出力から環境情報を取得し、すべての 個のアクションをまとめて予測します。ALOHA の 2 本のアームには合計 14 個の制御される関節/グリッパ次元があり、次のようになります:
chunk_size = 100 の場合、1 回の推論で 100 タイムステップ × 14 関節位置、すなわち完全なアクションチャンクを予測します。
学習では、予測されたチャンクを人間のデモンストレーションと比較し、L1 再構成損失と、潜在分布を正則化する CVAE の KL 損失を用います。
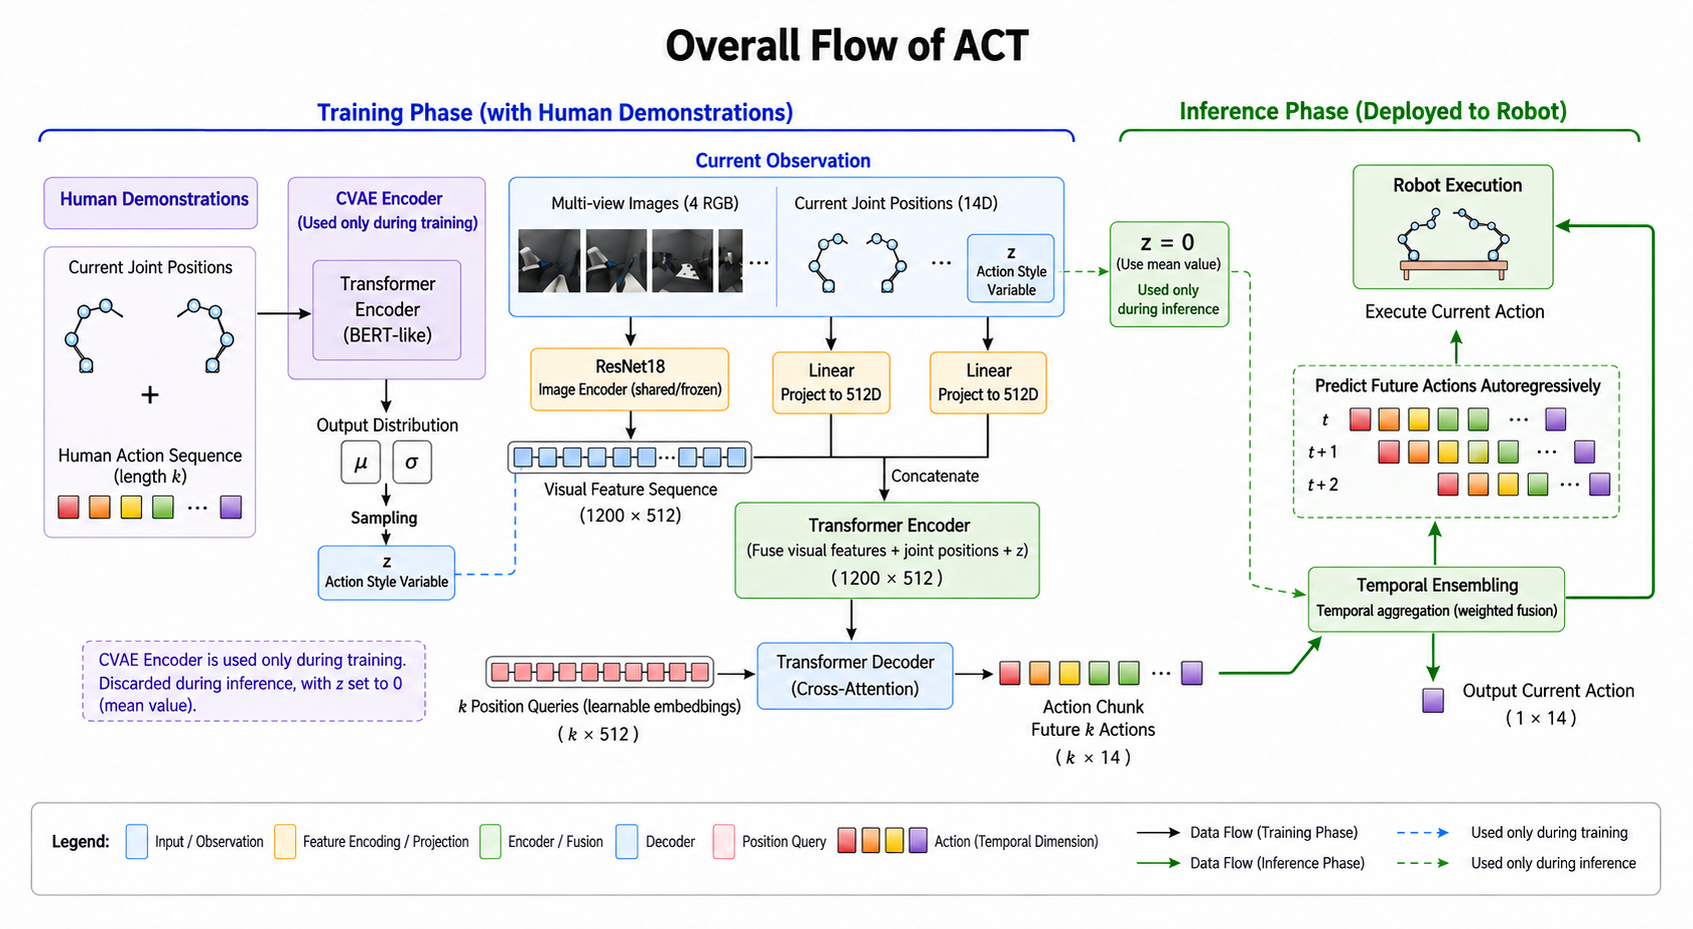
運用時には将来の提示アクションチャンクが存在しないため、CVAE エンコーダは取り除かれ、 とします。画像と現在の関節位置から新しいチャンクを生成し、時間的アンサンブルで重なり合う予測を統合し、現在のアクションをロボットに送ります。
全体のフローは次のとおりです:
学習:デモンストレーション → CVAE が を学習 → 画像 + 関節 + → Transformer → アクションチャンク
推論:画像 + 関節 + → Transformer → アクションチャンク → 時間的アンサンブル → ロボット
それぞれの役割を区別して覚えておきましょう:
アクションチャンク化は、いくつの将来アクションをまとめて予測するかを決め、時間的アンサンブルは実行を平滑化し、CVAE は同じタスクに対して複数のデモンストレーションが妥当であり得るという事実をモデル化します。
これで ACT パイプラインが一体として理解できます: