EO-1: どのようにしてエンボディド推論とロボット制御を統一するか
EO-1: 汎用ロボット制御のためのオープンな統一エンボディド基盤モデル
- 統一フィジカル AI モデル
- インタリーブ学習
- エンボディド推論
- ロボット制御
前提知識:入力と出力
説明: 模倣学習は、人間の操作を記録したデータから動き方を学習します。VLA は言語理解を追加し、通常は画像、タスクテキスト、ロボット状態を入力として受け取ります。
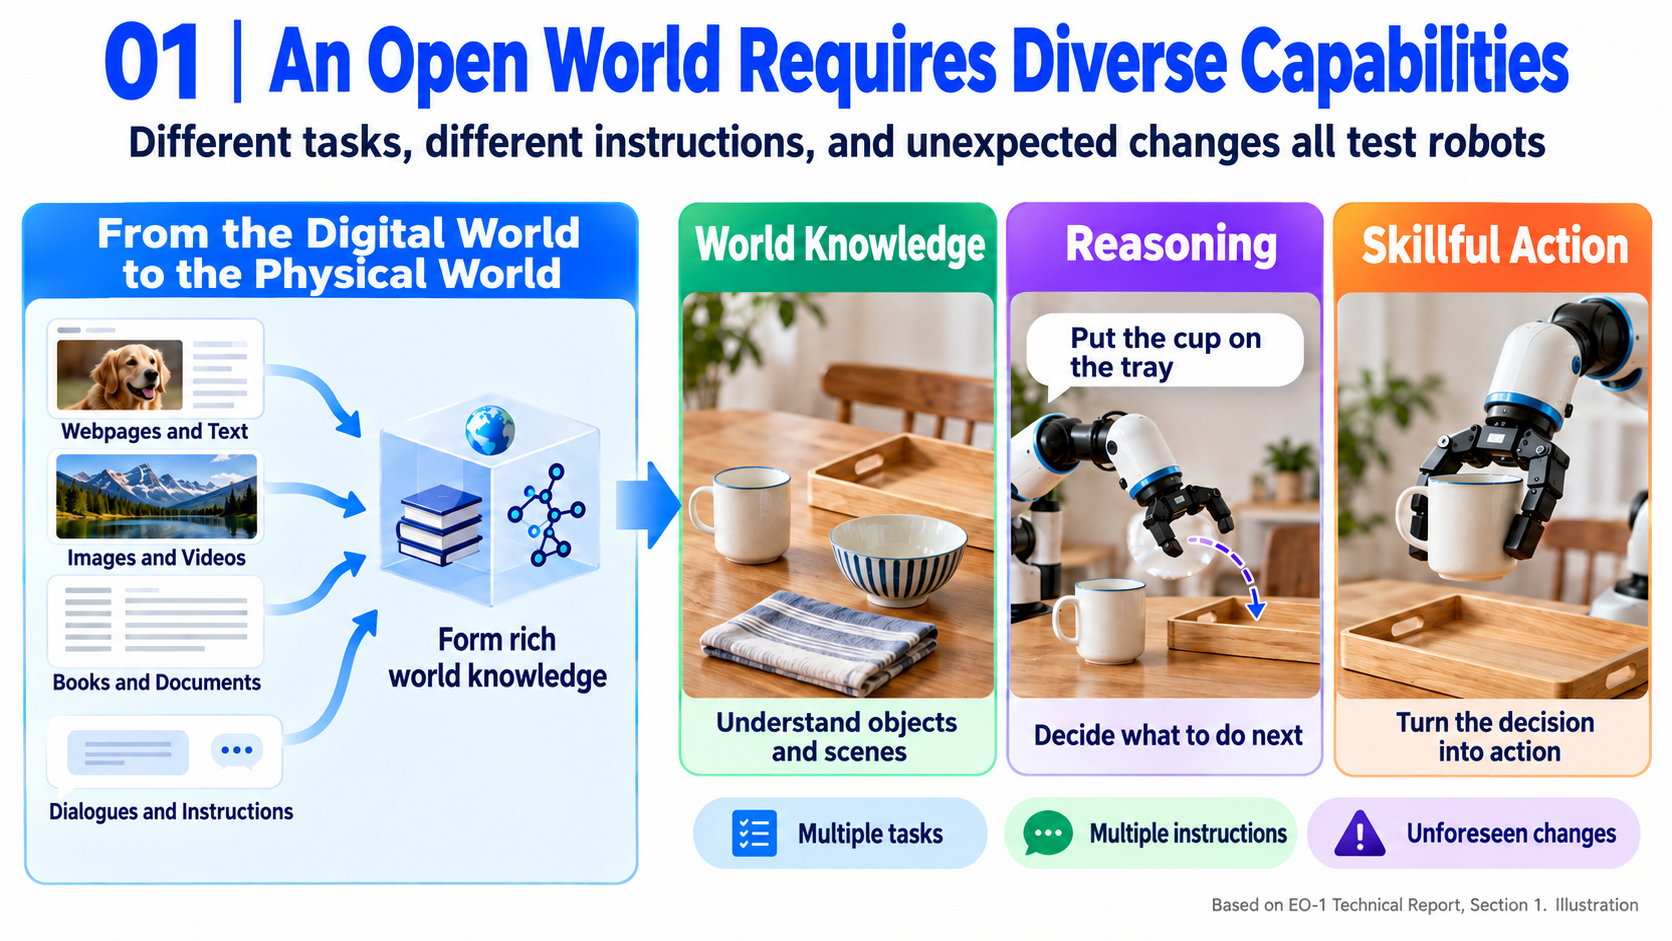
「トマトを買い物袋に入れて」といった指示では、画像が物体の位置を特定し、状態がアームを記述し、テキストが目標を定義し、アクションが把持と配置を制御します。EO-1 は「次は何をするべきか?」「終わったか?」にも答えることができ、アクションの前後の判断をつなぎます。
| 概念 | ここでの意味 |
|---|---|
| 観測 | マルチビュー画像とロボット状態。新しい画像はカメラから取得される。 |
| 状態 | 関節などの低次元ロボット値。次元数はプラットフォームによって異なる。 |
| アクション | 連続制御であり、その物理的な意味はプラットフォームとデータセットに依存する。 |
| アクションチャンク | 複数の将来アクションをまとめて予測するもの。EO-1 では 16 ステップを使用。 |
| エンボディド推論 | 物体、空間、進捗、物理的相互作用に関する判断。 |
単一ステップ予測は current observation → aₜ、チャンク化は current observation → [aₜ, aₜ₊₁, …, aₜ₊₁₅] です。例示: ある 1 次元のアクション成分が [0.1, 0.12, 0.15] となる場合があります。実際の EO-1 は多次元の 16 ステップ配列を出力します。
アクションチャンクにより、モデルは動きの一部分をまとめて配置できますが、チャンク長はモデル呼び出し間隔そのものではありません。論文では、すべてのプラットフォームに共通する実行割合、再計画レート、制御レートは示されていないため、チャンク長から 1 秒あたりのモデル呼び出し回数を推定することはできません。
要約:翻訳とコメント
翻訳
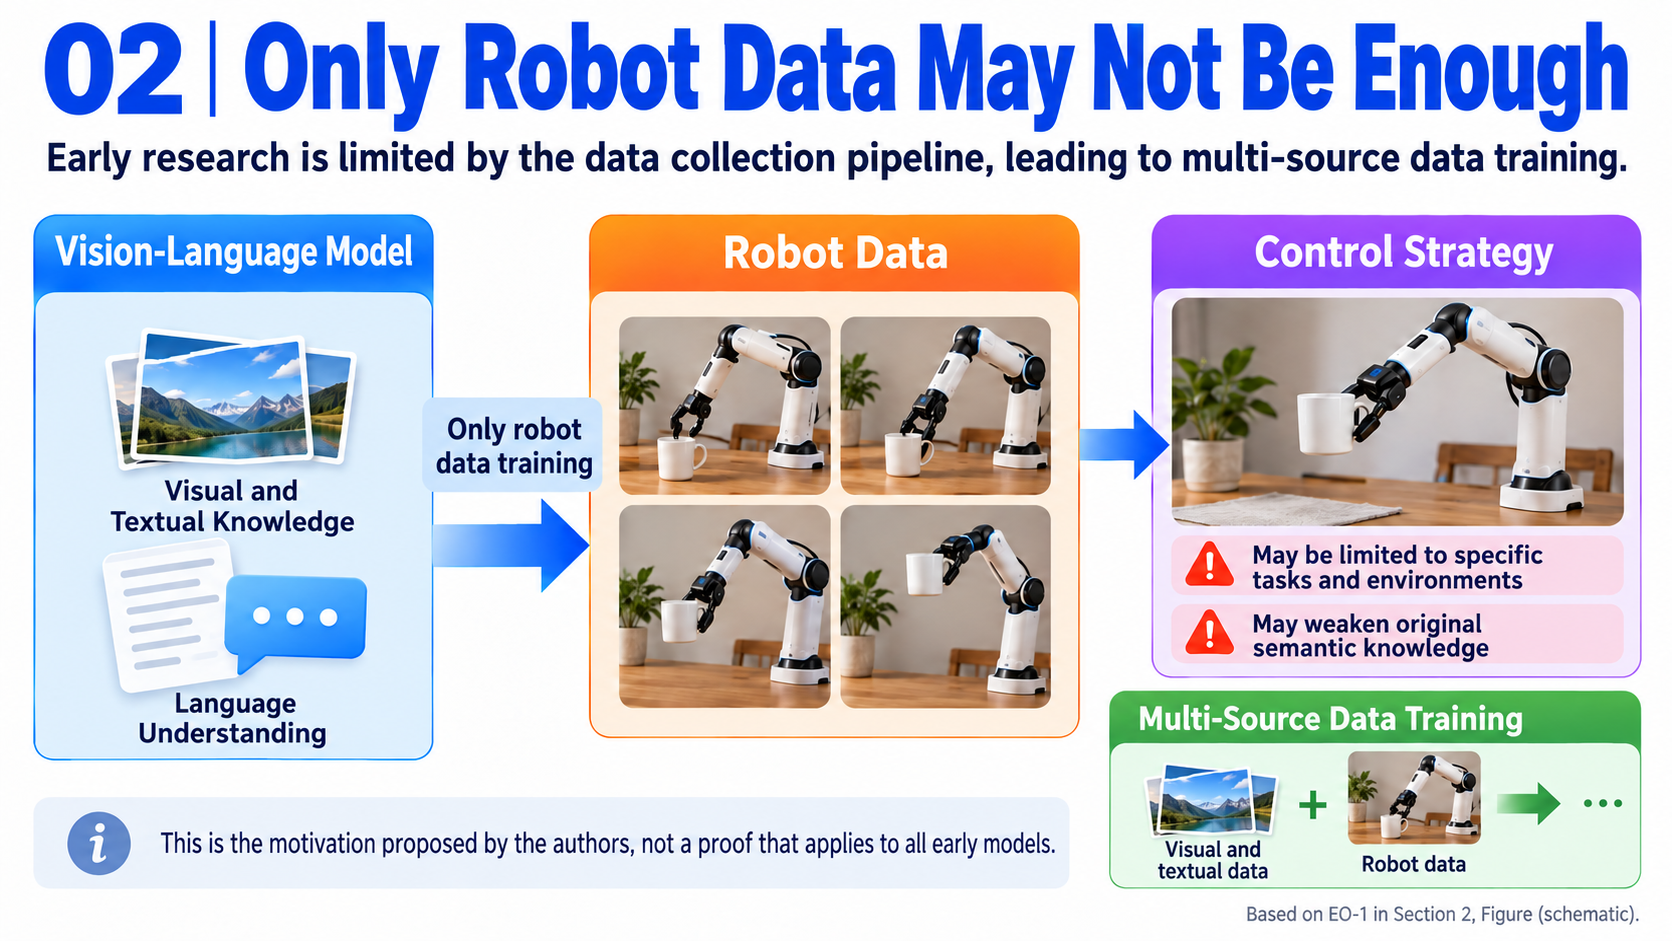
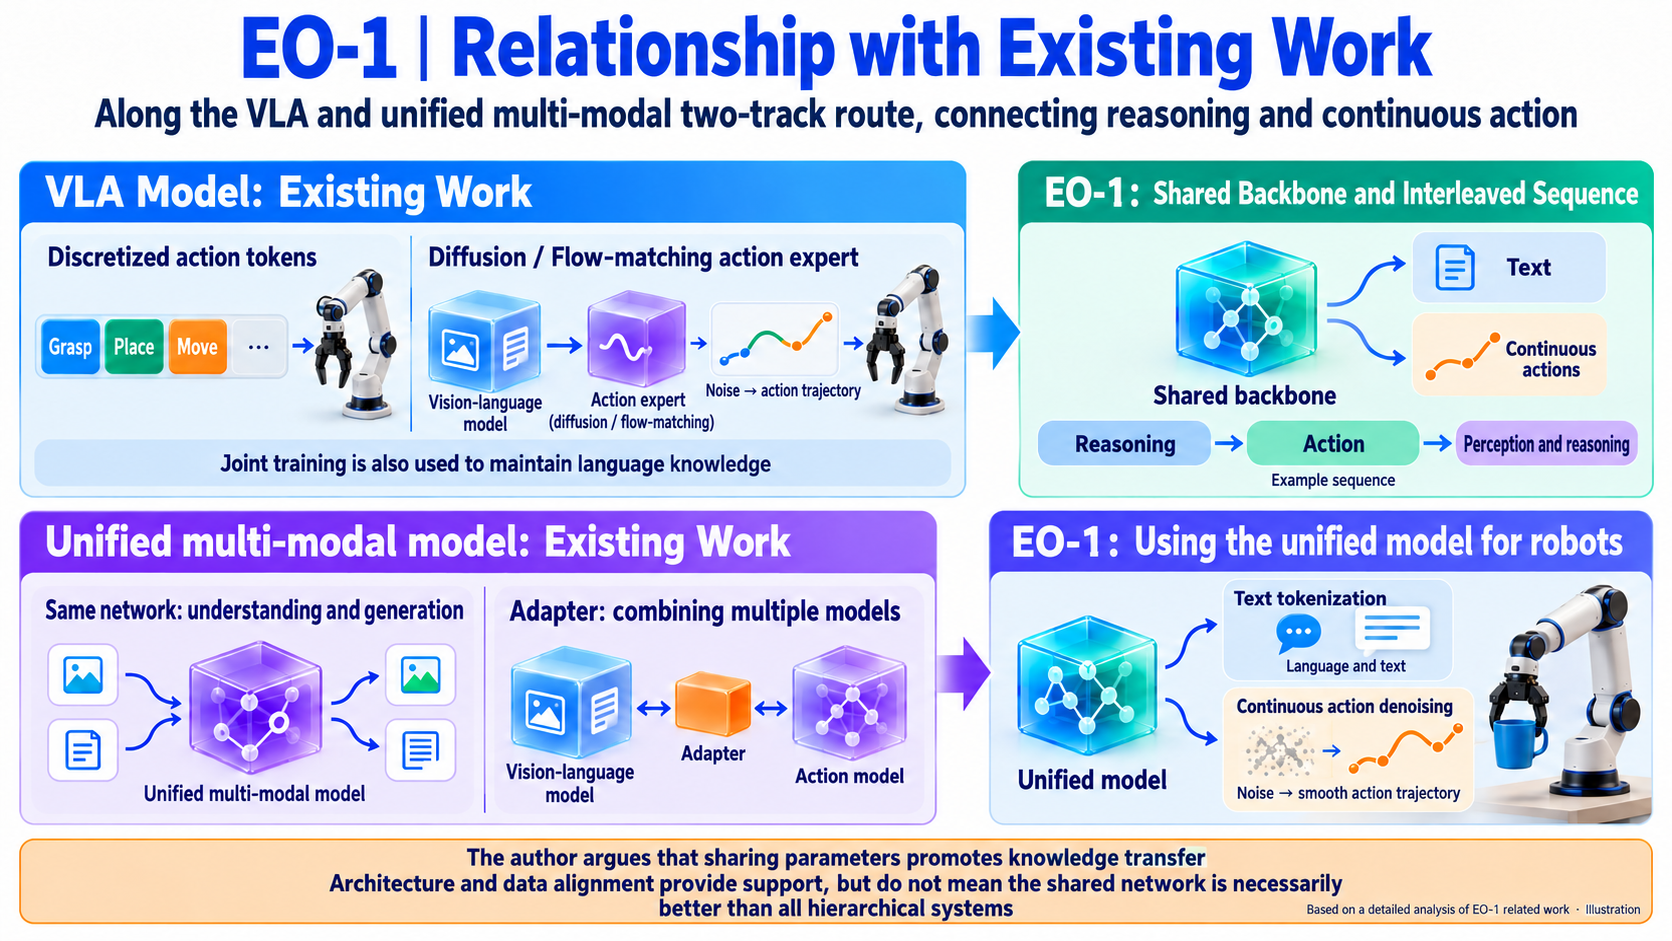
人間は、オープンな世界において自然にマルチモーダルな推論と物理的な相互作用を交互に行います。VLA はロボットと画像テキストの共同学習によって汎用的な制御を前進させてきましたが、推論と相互作用を結びつける柔軟性は依然として限定的です。
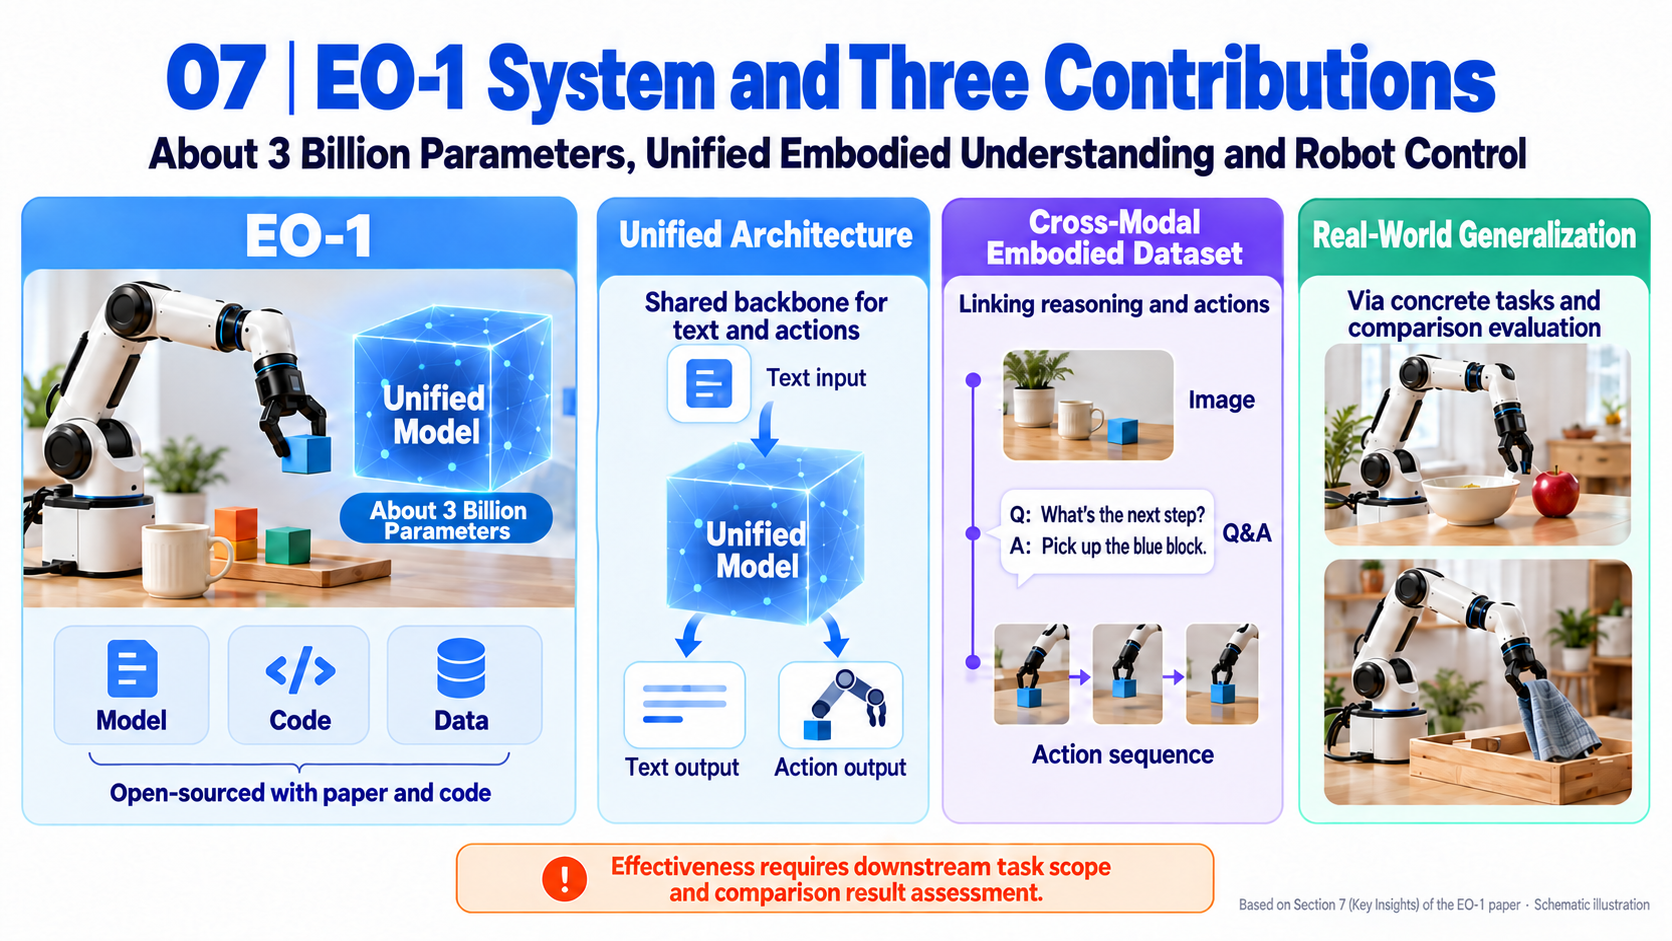
EO-Robotics は EO-1 と EO-Data1.5M から構成されます。EO-1 は、インタリーブされた視覚・テキスト・アクションの事前学習を通じて、エンボディド推論と制御を学習します。画像、テキスト、動画、アクションを受け取るアーキテクチャと、インタリーブされた理解を重視した 150 万件超の高品質なエンボディド推論サンプルを組み合わせています。
EO-1 は EO-Data1.5M 上で自己回帰デコーディングとフローマッチングによるノイズ除去を用いて学習され、ロボットアクション生成をマルチモーダルなエンボディド推論と結びつけます。複数のロボット形態や長期・巧緻な操作タスクにわたる広範な実験により、オープンワールドの理解と汎化に対するインタリーブ学習の有効性が検証されます。本論文は、エンボディド基盤モデルの参考として、アーキテクチャ、データ構築、学習手法を記述しています。
コメント
-
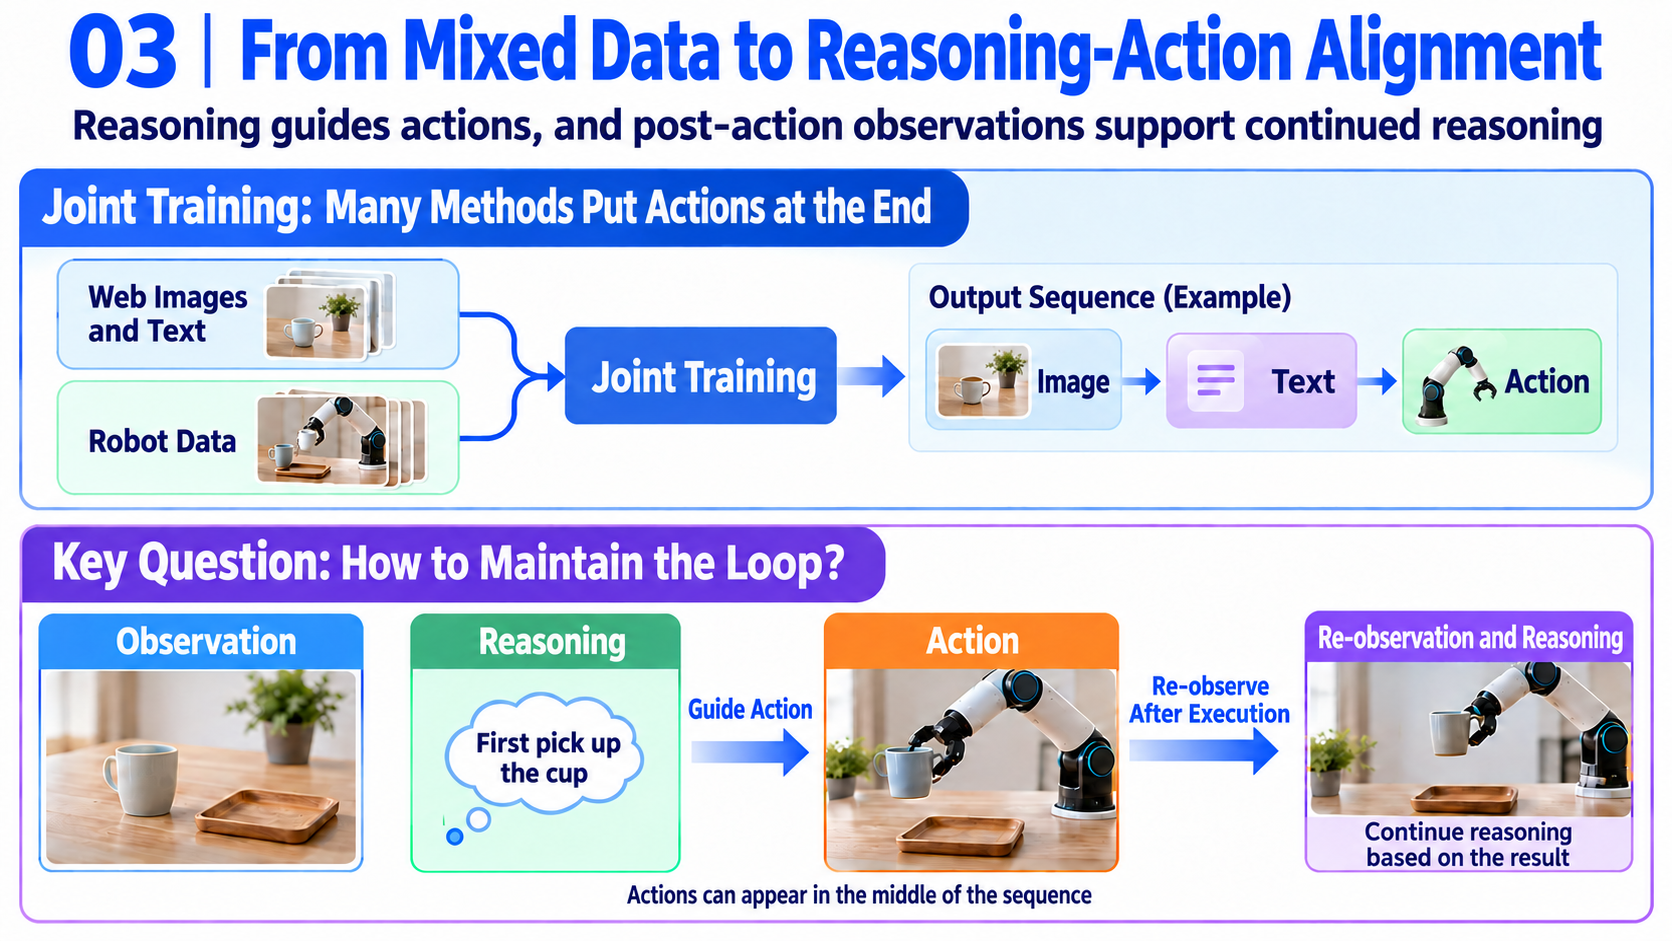
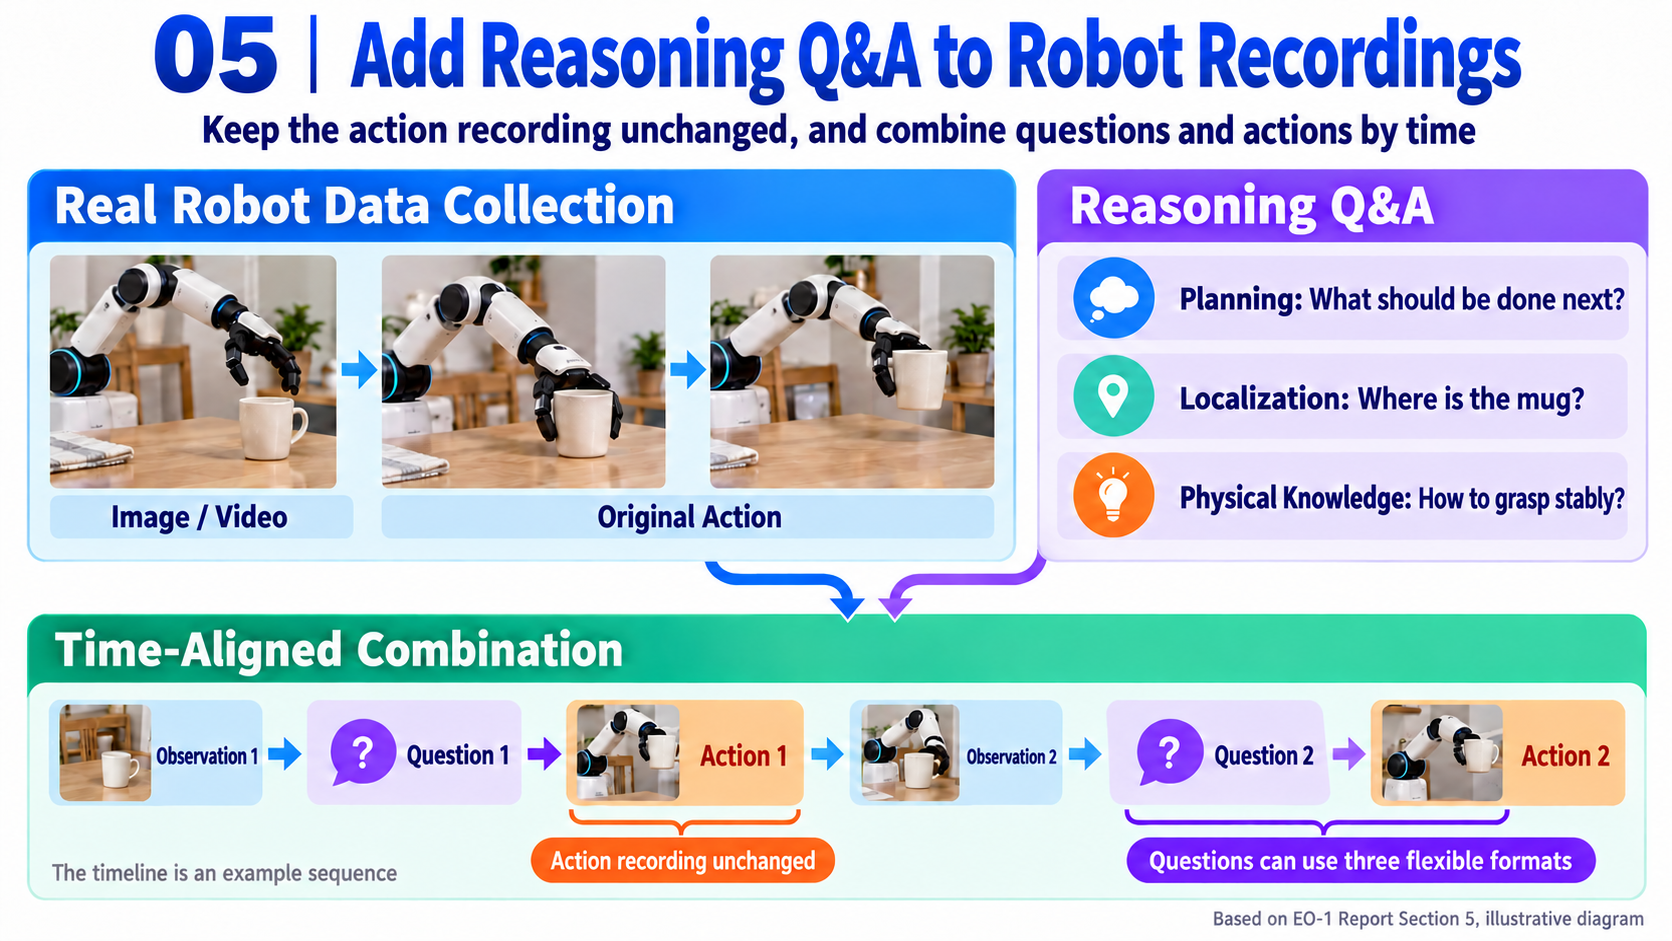
推論とアクションの結びつきが変化する。 画像と指示からアクションを生成するだけでなく、アクション後に新しい画像を用いて再評価することを学習します。
-
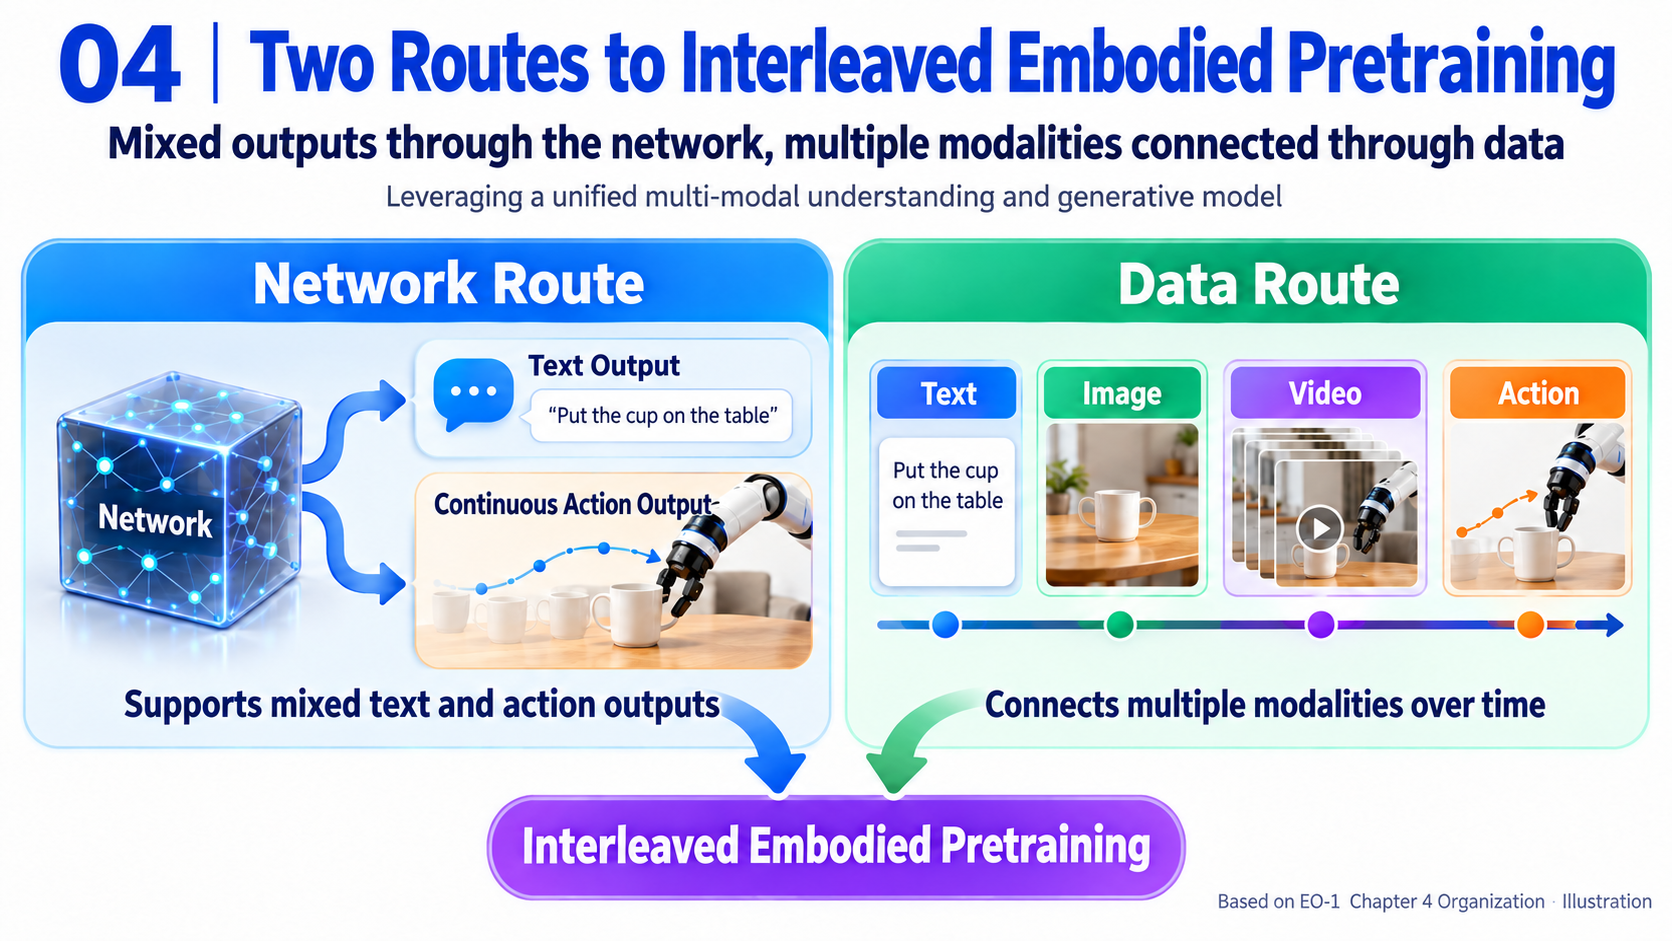
アーキテクチャとデータの両方が必要。 ネットワークはテキストと連続アクションを扱えなければならず、サンプルはそれらを時間的に結びつけていなければなりません。
-
150 万件超というのはデータセット全体を指す。 すべてのサンプルが完全なインタリーブアクションを含むわけではなく、インタリーブされた視覚・テキスト・アクション例は約 12.2 万件と別途記載されています。
-
有効性は実験範囲に制約される。 複数プラットフォームでの結果は、人間レベルや任意シーンでの汎用性を確立するものではありません。
序論と関連研究:なぜインタリーブするのか?
序論の 7 つの主要パラグラフ
先行研究との関係
中核手法:1 つのバックボーン、2 つの出力
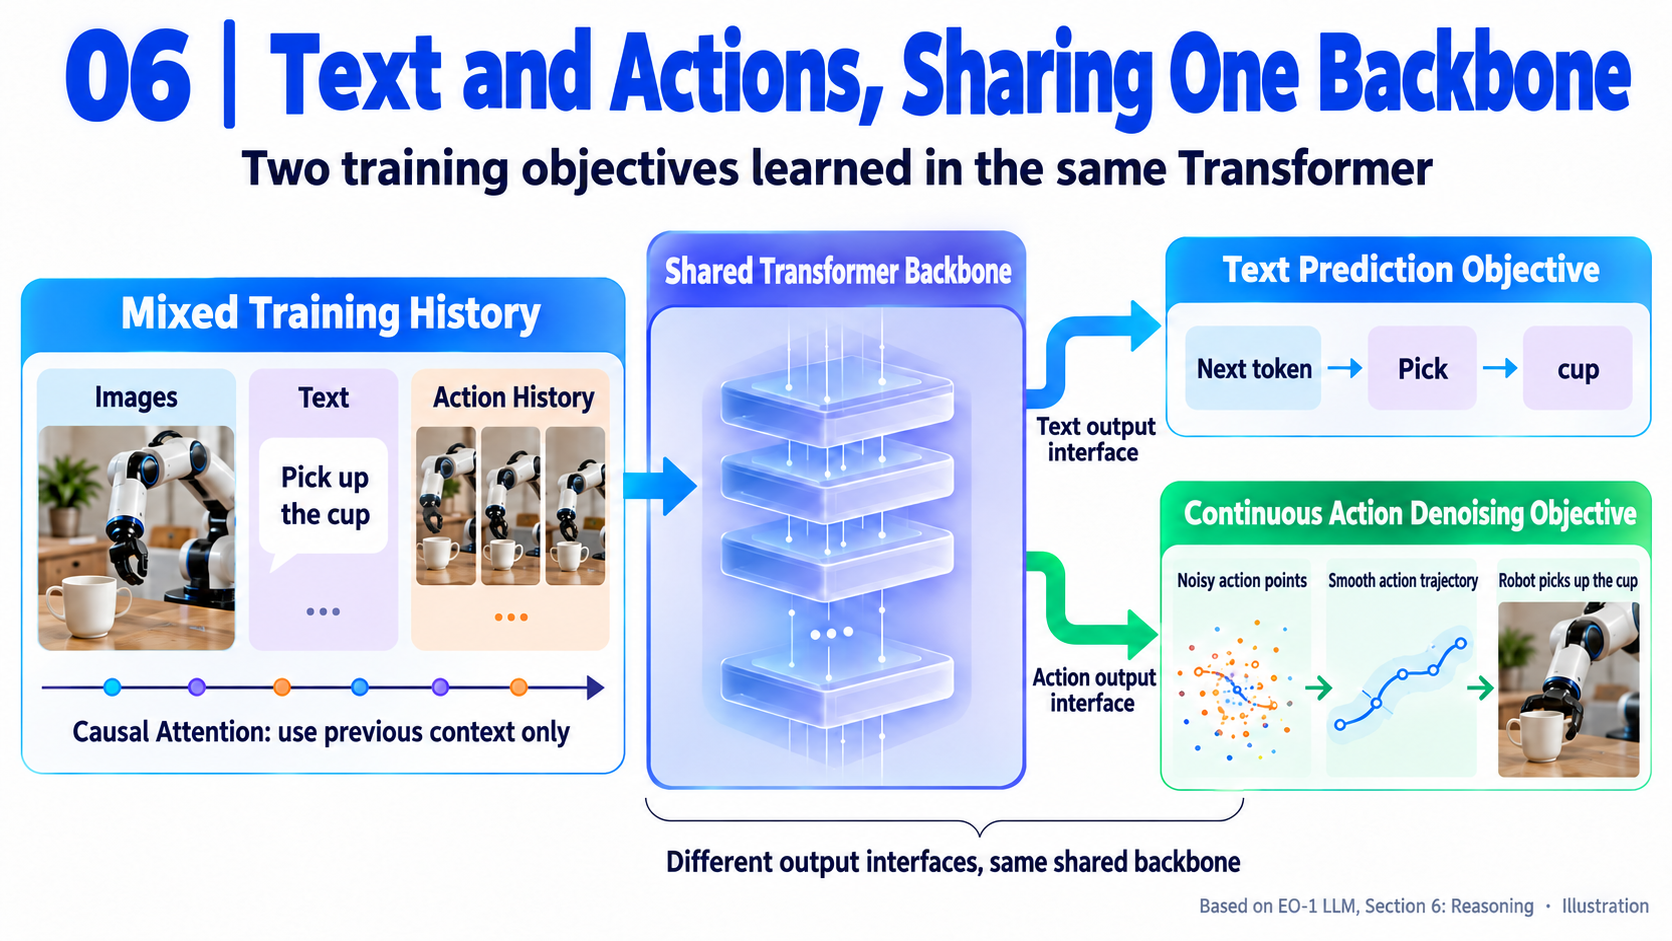
モダリティ固有インターフェースを持つ共有処理
テキストは「何を」「なぜ」を扱い、アクションは動きを指定します。どちらも同じ物体、目標、進捗に依存しています。EO-1 は事前学習済みバックボーンを共有することで、プランニングと制御の分離を小さくします。
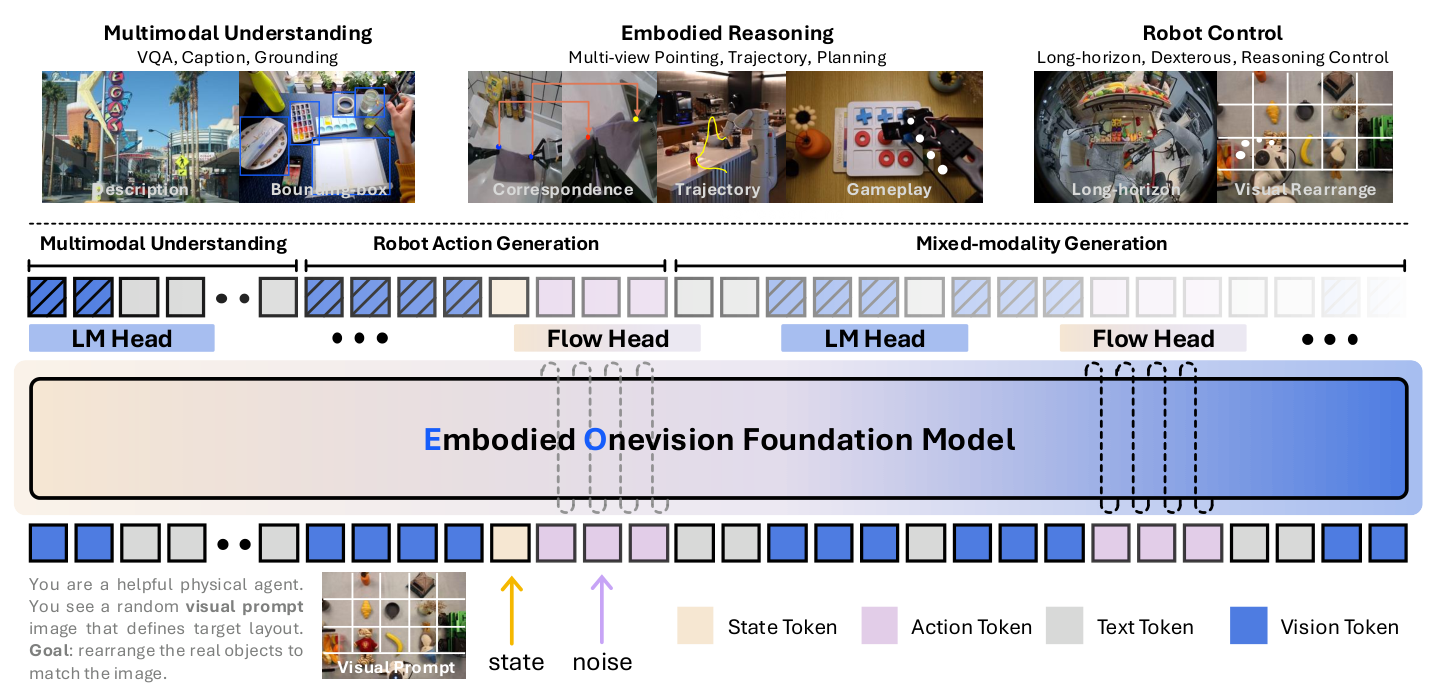
論文: Qwen2.5-VL から初期化されたデコーダ専用 Transformer は、画像・動画用の視覚エンコーダとテキスト用のトークナイザを保持します。状態とノイズ付きアクションは共有特徴空間へ射影されます。
トークンは系列要素であり、必ずしも離散的な単語とは限りません。視覚・状態・アクショントークンは連続値の特徴ベクトルでもかまいません。
| 生入力 | エンコーディング | バックボーン表現 |
|---|---|---|
| マルチビュー画像と動画フレーム | 事前学習済み視覚エンコーダ | 幅 D の視覚系列。 |
| 指示と推論 QA | トークナイザと埋め込み層 | 幅 D のテキスト系列。 |
状態 qₜ | 状態射影 | d_q 次元の状態を幅 D に写像。 |
ノイズ付きチャンク Xτ と進捗 τ | アクション入力射影 | 幅 D のアクション系列。 |
D はバックボーンの幅、d_q はプラットフォームの状態次元です。状態・アクションの次元数や完全なトークン数はプラットフォーム間で一様には指定されていないため、記号のままにしてあります。
出力は LM ヘッド(テキストトークンを予測)と フローヘッド(隠れ特徴を連続アクション更新に写像)に分岐します。最終チャンクは 16 × d_a であり、d_a はプラットフォーム固有のアクション次元です。
形状例: 仮に 7 次元インターフェースであれば、出力は 16 × 7、すなわち 112 個の値になります。これは普遍的な構成ではありません。射影により幅 D から d_a へ戻すのであり、幅を直接足し合わせるわけではありません。
注意: 「アクション固有パラメータの追加なし」は、アクション専用の別バックボーンがない、という意味で読むべきです。状態・アクション射影や出力ヘッドには依然としてパラメータが含まれます。
テキストは逐次生成し、アクションはチャンクとしてノイズ除去
自己回帰は、既存のコンテキストから次のテキストトークンを予測します:
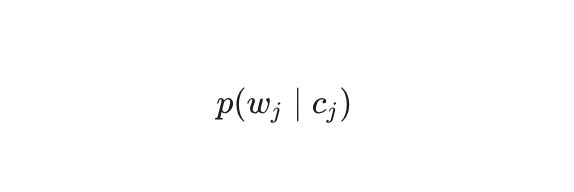
w_j はトークン j、c_j はその前にあるマルチモーダルコンテキストです。例: 「next, pick up」の後に、モデルは「the tomato」を予測し、その際に過去の画像やアクション履歴も利用します。
アクションにはフローマッチングを用います。制御をテキストとして逐語的に綴るのではなく、ランダムな配列を完全な軌道へ近づける更新量を繰り返し予測します。
学習では、真のアクションとガウスノイズを混ぜ合わせます:
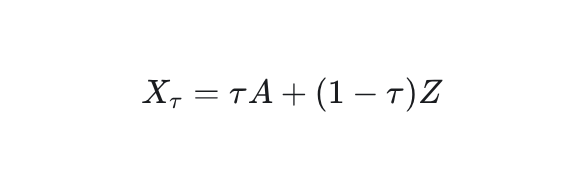
A と標準ガウス Z はどちらも形状が 16 × d_a です。τ∈[0,1] は内部のノイズ除去進行度であり、秒ではありません。0 ではノイズ、1 ではデータになります。論文では、よりノイズの大きい段階を強調する Beta 分布からサンプリングします。
最小例: 1 要素の場合、A=0.6、Z=−0.2、τ=0.5 から Xτ=0.2 となります。これは完全な答えではなく、中間値です。
式 (2) を保ったままの学習目的:
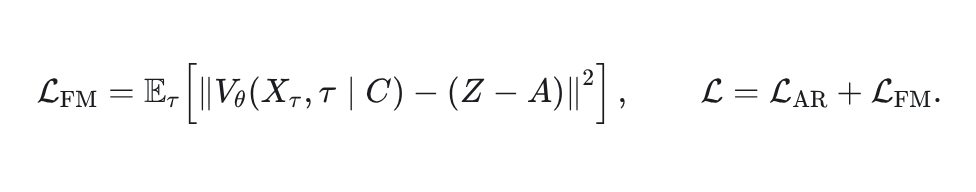
Vθ は共有モデルと flow head によって予測される更新ベクトル場であり、θ は学習可能パラメータ、C は先行するマルチモーダルコンテキストです。ノルムは配列全体を比較し、期待値はサンプリングされた進行度にわたって平均します。L_AR はテキストのクロスエントロピーであり、両項の重みは 1 です。この例で書かれている行動ターゲットは Z−A=−0.8 です。
式 (1) を保ったままの推論:
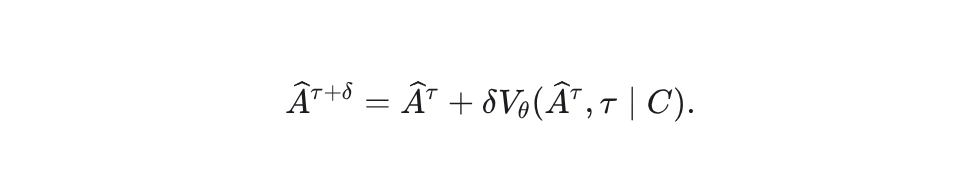
Âτ は新しいノイズから初期化される推定値であり、δ は積分ステップです。本文では 0 から 1 まで積分し、10 回の更新を用います。説明: 10 個の等しい更新であれば δ=0.1 となり、実行時間ではなく内部ステップを表します。
注意:記述上の指示には不整合があります。 線形経路の導関数は A−Z ですが、式 (2) は Z−A を用い、式 (1) は正の更新を用います。文字通りに両方を同時に取ると整合しません。この例の前向き方向は 0.8 ですが、書かれているターゲットは −0.8 です。ここでは式をそのまま残し、再現時には実際の学習が誤っていると結論するのではなく、実装の時間/符号の取り扱い規約を確認する必要があります。
インタリーブされたシーケンス:行動後に再び推論する
標準的な行動の例は次のように書けます:
Image → Task text → State → Action chunk
EO-1 はこの時間構造も学習します:
Current image → Planning QA → State → Action chunk
→ New image → Completion QA → Next-step planning → Next chunk
論文: 各モダリティには境界マーカーがあり、画像には [BOI]/[EOI]、状態には [BOR]/[EOR]、行動には [BOA]/[EOA] が含まれます。因果的アテンションは未来の答えではなく、先行するコンテキストに条件付けされます。
例: トマトを袋に入れようとした後、新しい画像にトマトがまだグリッパにある様子が写っているかもしれません。モデルは配置が完了していないと判断し、さらに行動を生成できます。これはフィードバック構造を示すものであり、確実なリカバリを保証するものではありません。
EO-1 はテキストと行動を生成し、将来のカメラ画像や状態は生成しません。環境側が新しい観測を提供します。また、インタリーブはすべての制御点の前に必ず言語的な答えを要求するわけではありません。
インタリーブされた Rectifying Sampling:履歴はクリーン、現在の行動はノイズ付き
現在の行動を学習するにはノイズが必要ですが、その後のテキストは完了した行動に条件付けされるべきです。過去の行動をノイズ付きのままにすると、実際に実行された履歴とのミスマッチが生じます。
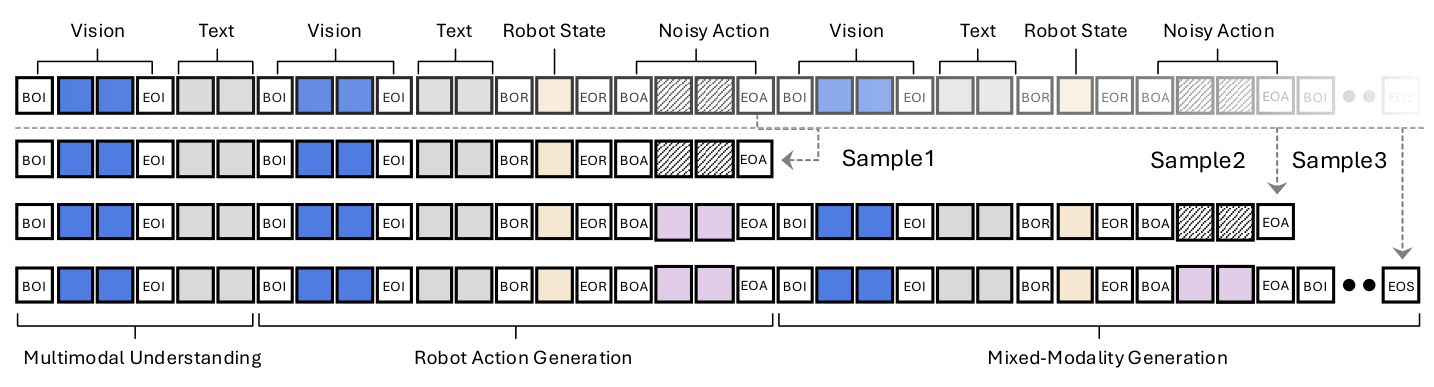
論文: インタリーブされた rectifying sampling は、N 個の行動セグメントを持つシーケンスを、行動境界で N+1 個の学習用プレフィックスに分割します。履歴の行動はクリーンであり、現在生成中の行動のみがノイズ付きです。
最小例: 2 つの行動を持つシーケンス:
Image₁ / Text₁ → Action₁ → Image₂ / Text₂ → Action₂ → Image₃ / Text₃
N=2 の場合、3 つのプレフィックスを構成します:
| サンプル | コンテキストとターゲット |
|---|---|
| Sample1 | Image₁ / Text₁ → ノイズ付き action₁;action₁ のノイズ除去を学習。 |
| Sample2 | Image₁ / Text₁ → クリーンな action₁ → Image₂ / Text₂ → ノイズ付き action₂;後続テキストと action₂ を学習。 |
| Sample3 | 2 つの行動はいずれもクリーンな履歴;最終テキスト text₃ を学習。 |
行動は生成時にノイズ除去の教師信号を受け、後続の予測に対してクリーンなコンテキストとして勾配に寄与します。モデルは行動生成と、行動履歴に基づく推論の両方を学習します。
制約とコスト: プレフィックスを再処理することで、別途は計測されていない計算量が追加されます。単独の除去アブレーションもありません。クリーンな学習履歴は記録から得られますが、デプロイ時の履歴にはモデルの誤りが含まれる可能性があります。Rectifying sampling はそのミスマッチを取り除くものではなく、ACT の時間アンサンブルや行動スムージングでもありません。
学習と推論の全体像
学習: 画像テキストソース、ロボット記録、インタリーブされた例 → モダリティをエンコード → 現在の行動にノイズを加え、履歴はクリーンに保持 → 共有バックボーン → テキストのクロスエントロピーと flow 損失 → 共同更新。QA のみのサンプルは、作り物の行動なしでテキストの教師信号を提供します。
推論: 画像、指示、状態、履歴 → 必要なテキストを生成 → 新しいノイズを 10 回の更新で 16 ステップのチャンクに洗練 → 実行 → 新しい観測をコンテキストに追加。KV キャッシングはコンテキスト計算を再利用しますが、再観測の代わりにはなりません。
実装では、事前学習 5 エポック、平均パック長 16,384、バッチサイズ 1 が報告されています。言語/マルチモーダル射影の学習率は 5×10⁻⁵、ビジュアルエンコーダは 1×10⁻⁵ です。これらは実験設定であり、普遍的な最適値ではありません。
EO-Data1.5M:推論と制御のための共有データ
3 つのデータグループ
| カテゴリ | 本文 Table 1 の規模 | 教師信号 |
|---|---|---|
| Web マルチモーダル | 570 万サンプル、71 億トークン | 画像 QA、動画理解、グラウンディングなど関連タスク。 |
| ロボット制御 | 120 万軌跡、1,273 億トークン | ロボット間にわたる連続動作。 |
| EO-Data1.5M エンボディドデータ | 150 万サンプル、10 億トークン | 空間・時間・物理・タスク推論とインタリーブされた動作。 |
注意: 軌跡、QA サンプル、トークンは異なる単位であり、動作回数として加算することはできません。EO-Data1.5M は学習コーパス全体ではなく、完全なインタリーブシーケンスもその一部にすぎません。
パイプライン:多様なシーンを保持し、その後に推論を追加
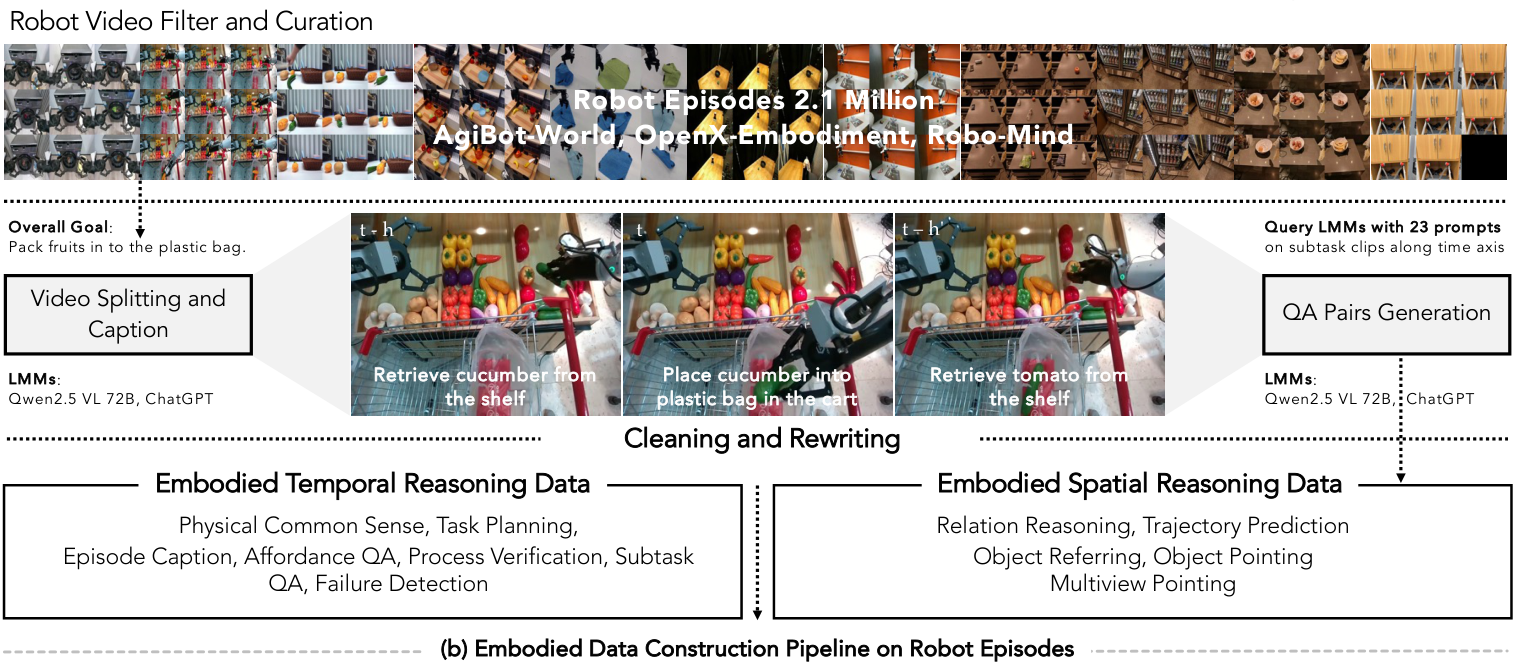
論文: まず視覚的な動画特徴をクラスタリングし、クラスタごとにサンプリングして、繰り返しシーンを減らすために手動で確認します。動画をサブタスクに分割し、モデルと人手で行動記述を作成し、テンプレートベースの質問を構築し、候補回答を生成し、それらを手動で選択または書き換え、最後にルールと文言をクリーンアップします。
時間的タスクには、物理的コモンセンス、プランニング、動画記述、アフォーダンス QA、検証、サブタスク QA、失敗検出が含まれます。空間的タスクには、関係、軌跡予測、バウンディングボックス、指さし、およびマルチビュー指さしが含まれます。
説明: 1 つの把持記録から、「何をつかむか」「どこにアプローチするか」「配置が成功したか」を答えることができます。これらのアノテーションはあらゆる可能な行動の探索ではなく、デモンストレーションから得られます。
3 つのインタリーブ形式が QA と行動をどのようにつなぐか
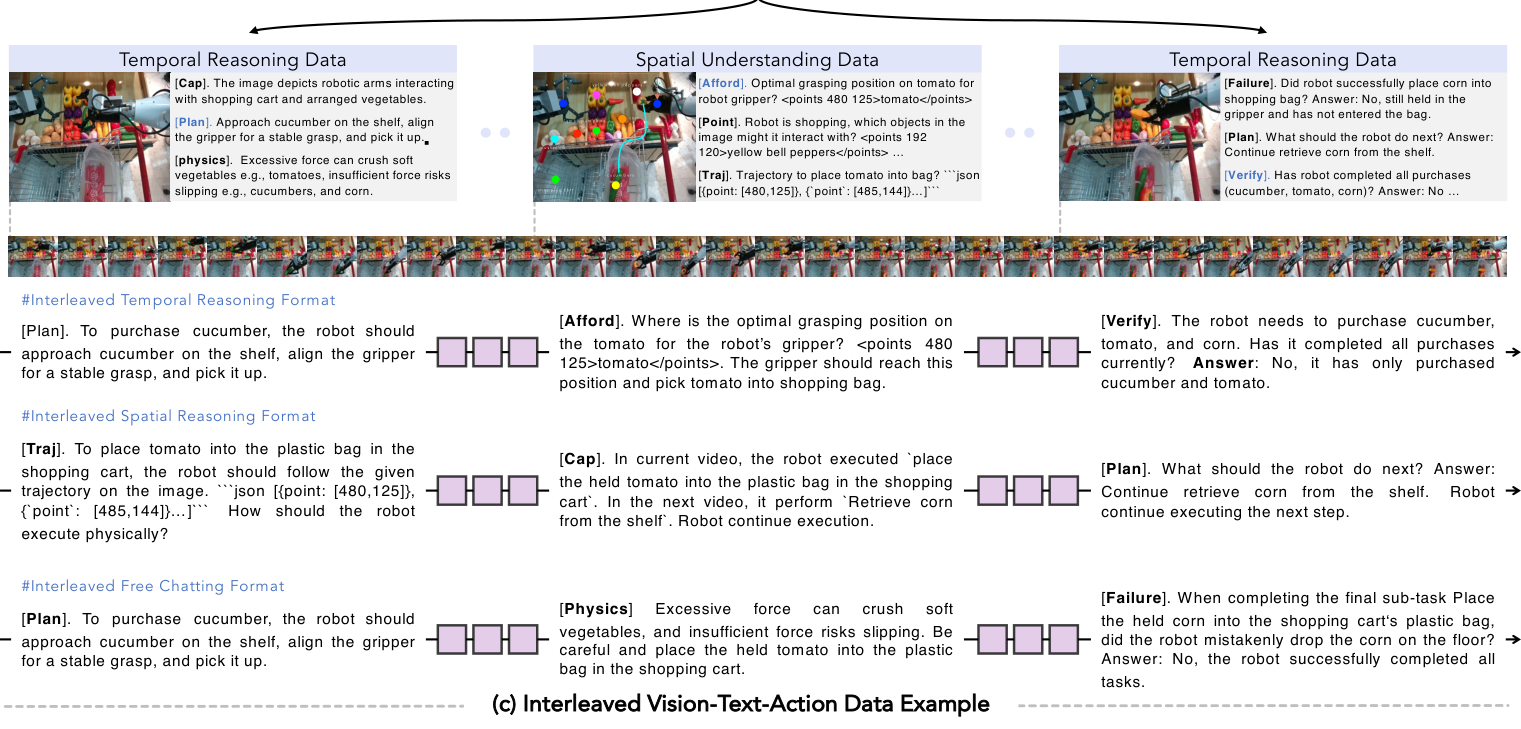
| 形式 | 接続 | 学習の焦点 |
|---|---|---|
| 時間的推論 | 画像 → 次サブタスク QA → 答えを指示文に挿入 → 行動 → 新しい画像と検証。 | 何をすべきか、完了しているか。 |
| 空間的推論 | 画像 → 軌跡 QA → 軌跡を指示文に挿入 → 行動 → 新しい画像と検証。 | 空間的な目標を動きに変換する。 |
| 自由形式 QA | 画像 → その他の推論 QA → 元のタスク指示 → 行動 → 検証。 | 制御コンテキスト内で多様な推論を保持する。 |
空間的軌跡は関節コマンドではなく、画像平面上の [x,y] 座標です。(480,125) → (485,144) は画像上の経路を表し、連続行動生成は依然として実際の動きを学習します。
本文では約 12.2 万件のインタリーブ例が報告されています。注意: カウントには不一致があります。Table 1 では Web サンプル 570 万件、付録 Table 6 では 620 万件、Figure 3(a) は空間理解を 37.6 万件としつつ、Section 3.2.1 は 150 万件と述べています。ここでは各数値をその掲載箇所に帰属させ、未検証の合計に統合しません。
実験:主張を裏付ける証拠
推論と制御を別々に評価する
学習損失、QA スコア、シミュレーション成功率、実タスク完了率は異なる能力を測っており、互いの代わりにはなりません。
| 評価 | EO-1 の結果 | 比較と解釈 |
|---|---|---|
| RoboVQA, BLEU-4 | 58.5 | Qwen2.5-VL 3B: 55.9;参照回答とのテキスト一致。 |
| ERQA, accuracy | 45.5% | Qwen2.5-VL 3B: 35.3%;Gemini 1.5 Flash: 46.3%。EO-1 はすべてのベースラインを上回るわけではない。 |
| EO-Bench, spatial / temporal | 36.4 / 38.9 | Qwen2.5-VL 3B: 20.0 / 22.6;多くの誤りを残しつつタスク推論が改善。 |
| LIBERO, mean success | 98.2±0.3% | π0: 94.2±0.9%;OpenVLA-OFT: 97.1±0.6%。 |
| SimplerEnv, WidowX / Google VM / Google VA | 72.7% / 76.5% / 63.0% | π0: 69.2% / 71.4% / 54.7%;それぞれ 3.5 / 5.1 / 8.3 ポイントの向上。 |
出典:Table 2–4、13–14 ページ。モデル名とバージョンは論文に従います。これらの指標は、交換可能な 1 つのロボット能力スコアにはなりません。
注意: EO-Bench のカウントにも矛盾があります。Section 3.3 は 648 問と述べていますが、その 4 カテゴリの合計は 642 問であり、4.2 では 700 問が均等に分布していると述べています。ここではこれらを有意性やカテゴリ別カウントを推定するためには用いません。
実ロボットでは何がテストされたか?
28 のタスク設定は、7 つの Franka Panda ピック&プレースタスク、13 の WidowX 250 S の out-of-the-box テスト、4 つの AgiBot G-1 長期巧緻タスク、4 つの推論+制御タスクから構成されます。SO100 も関与しています。
モデルは視点、状態、指示を受け取り、制御信号を出力します。付録 Table 6 の学習データ構成には、AgiBot の ego/左/右ビュー(30 FPS)、DROID の左/右/手首ビュー(15 FPS)、SO100 の第三者視点/手首ビュー(30 FPS)、IPEC-Franka の第三者視点/手首ビュー(10 FPS)が含まれます。これらのソース設定は、評価時のカメラ台数や制御レートの普遍的な値ではありません。
長期ホライズンのファインチューニングでは、各タスクにつき150個のデモを用いて25エポック学習し、サブタスクとフルタスクのデータを9:1で混合し、その後に各タスクを10回評価します。約50万フレームと8ステップがスイートごとに報告されていますが、これはタスク時間の一律な長さを意味するものではありません。
注意: 長期ホライズンスコアはサブタスク指示の下での完了率の平均であり、単一の包括的な指示からのフルタスク自律成功を意味しません。「Out of the box」も、具現化(エンボディメント)が事前学習から完全に除外されていたことを意味するわけではありません。
推論は行動を改善するか?
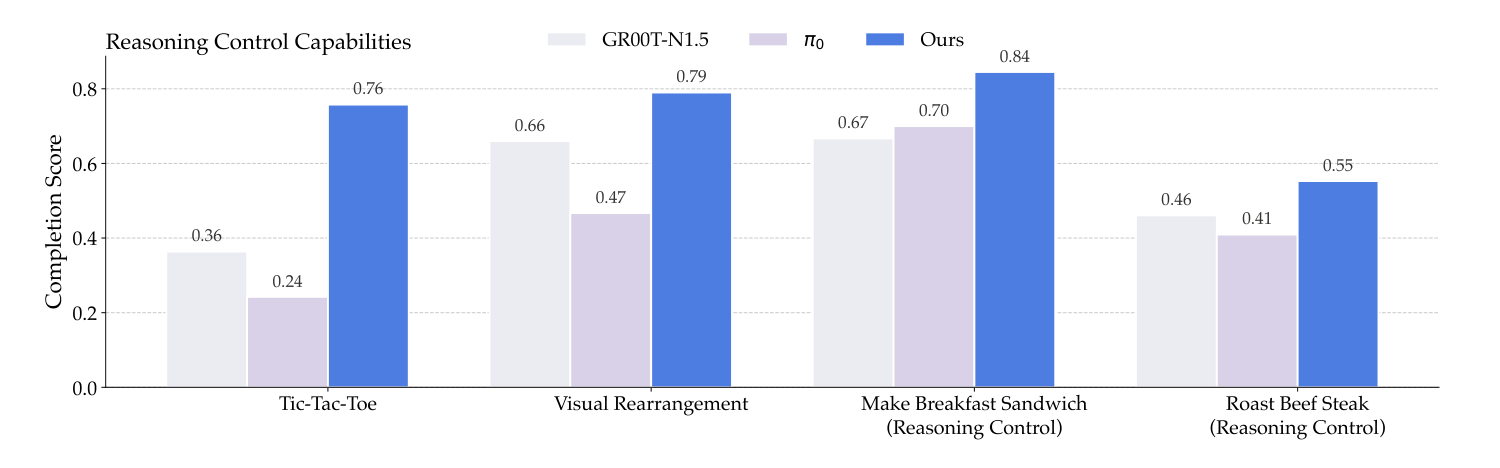
EO-1 は三目並べ、画像参照に基づく再配置、サンドイッチ作り、ステーキ調理でそれぞれ 0.76, 0.79, 0.84, 0.55 のスコアを示します。三目並べのベースラインは π0 が 0.24、GR00T-N1.5 が 0.36 であり、この設定において盤面判断と駒の配置の統合がより優れていることを裏付けています。
これらのタスクには特化したデータとファインチューニングが用いられています:再配置デモ800件と三目並べサンプル450件です。ベースラインは外部の GPT-4o プランナーとコントローラを組み合わせる一方で、EO-1 は統一されたデコーダを使用します。結果は、個々のコンポーネント単体やゼロショットの新タスク学習ではなく、システム全体/トレーニング手法を支持するものです。
汎化とデータの役割
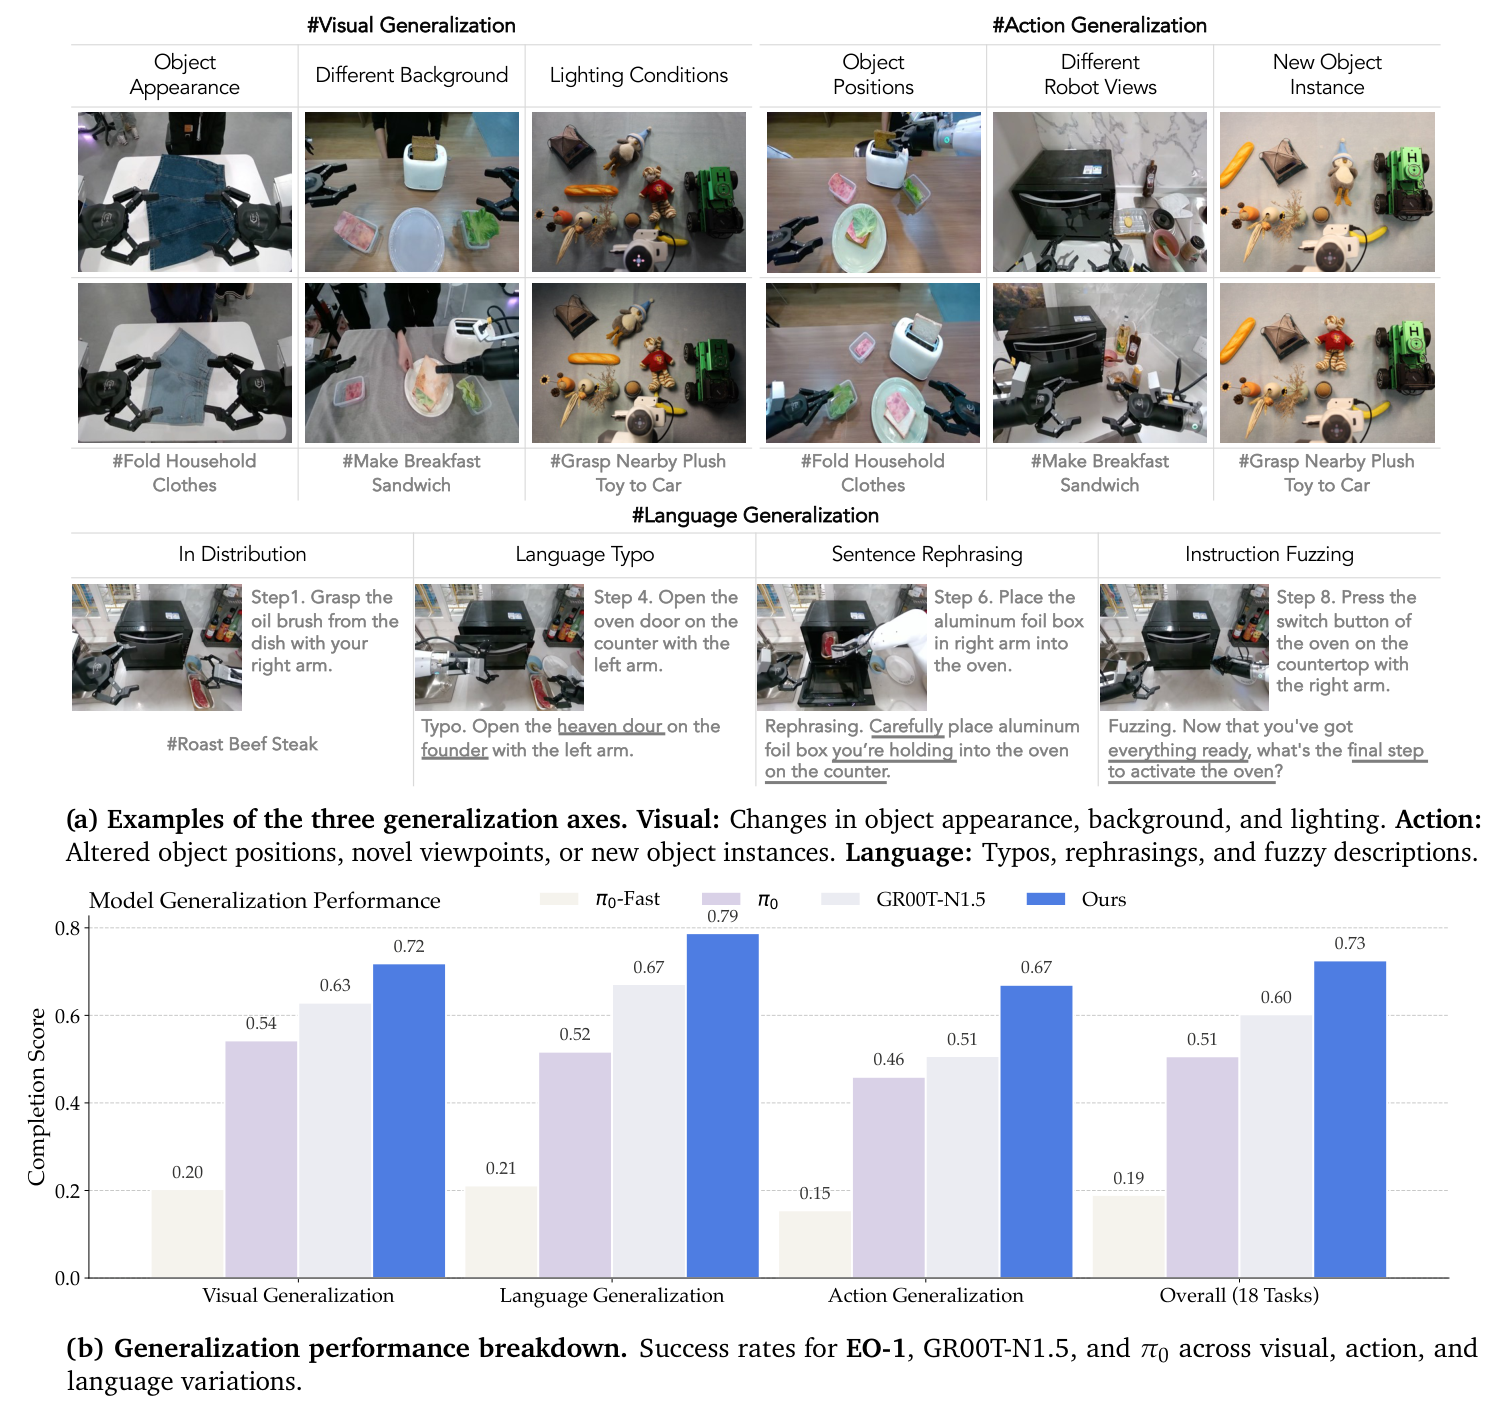
視覚・言語・行動の変動条件下での完了スコアはそれぞれ 0.72, 0.79, 0.67、全体で 0.73 です。行動の変動は主に物体位置、ロボット視点、物体インスタンスを変えるものであり、任意の未知スキルを要求するものではありません。テキストと図版の間でタスク総数に食い違いがあるため、図9の「18 Tasks」は論文全体の試行回数としては扱いません。
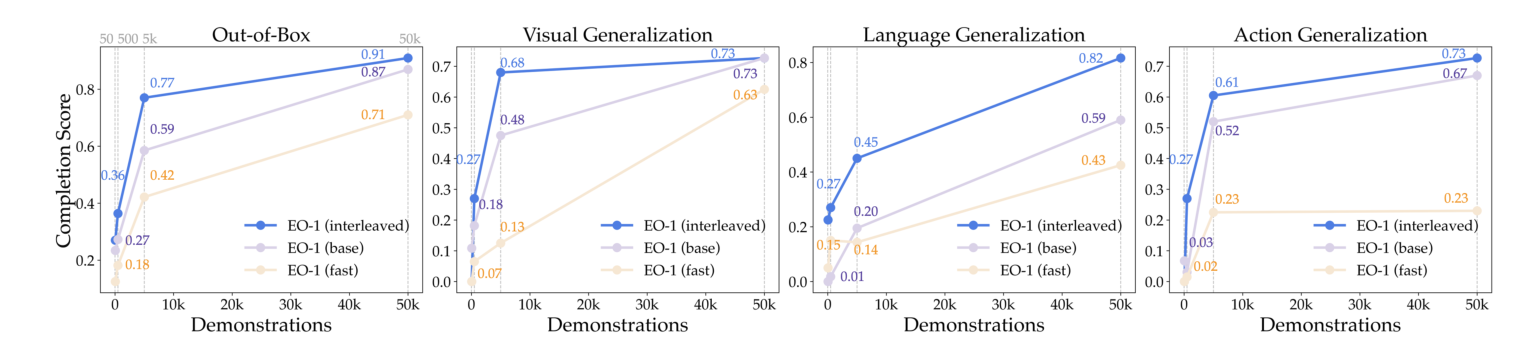
4つの構成が比較されています:fast は完全自己回帰的な FAST 行動、base は制御データのみで学習された連続フローマッチング付きの共有バックボーン、llava は汎用的な画像‐テキスト指示を追加したもの、interleaved は関連するインタリーブドデータを追加したものです。
表5からは2つの重要な観察が得られます:
-
連続生成は有利に働く: LIBERO の
baseはfastの 88.0% に対して 98.2% に到達します。これは、この設定におけるハイブリッドデコーディングを支持するものであり、離散行動が普遍的に劣るという意味ではありません。 -
単にモダリティを増やすより関連性が重要: WidowX の全体完了率は
baseの0.71からinterleavedの0.80に上昇する一方で、汎用データであるllavaは0.34にとどまります。タスクとの整合性が重要であり、ウェブデータが常に有害というわけではありません。
利得には限界があります:AgiBot のサンドイッチにおける行動汎化スコアは、base と interleaved の両方で 0.75 のままです。インタリーブドラベルは、デモに存在しない動作多様性を自動的に供給するわけではありません。
結論の解釈
支持される結論: これらの設定において、インタリーブドなエンボディドデータを用いた共有バックボーンは、タスク関連の推論と連続制御を改善します。これは、行動の前の推論と行動後の再評価のための学習可能なインターフェースを提供します。
次の3つの境界を保ちましょう:
-
統一されていても完全に信頼できるわけではない。 ステーキ調理のような複雑なタスクは依然として弱く、EO-Bench も完璧には程遠く、ナビゲーション、回避、失敗解析、協調といった課題は今後の研究対象として残っています。
-
推論と動作は恣意的に同時進行するわけではない。 効率的なアーキテクチャと非同期推論は依然として今後の課題です。インタリービングは時間的依存関係を表現するものであり、人間のような思考と行動の同時性を意味するものではありません。
-
再現には実装の詳細が必要である。 カウントやフローの符号に矛盾があり、状態/行動の次元や実行スケジュールは図から推測できません。RTX 4090 1枚で約6 GB の推論メモリが報告されていますが、普遍的なレイテンシや制御レートの測定はなく、任意のプラットフォームでのリアルタイム実行が保証されているわけではありません。
説明: EO-1 は意味的判断と制御を同時に学習するためのルートを提供します。共有ネットワークは結合情報を処理し、インタリーブドデータは時間的関係を与え、rectifying sampling は過去の行動と現在のノイズ除去を区別します。実際の成果は依然としてデモのカバレッジ、タスク、および実行システムに依存します。