Evo-1: 軽量 VLA モデルはどのようにセマンティックアラインメントを維持するか
Evo-1: セマンティックアラインメントを維持した軽量 Vision-Language-Action モデル
- 軽量 VLA
- セマンティックアラインメント
- クロスアテンション
- 2 段階学習
前提知識:インストラクションからアクションへ
VLA は何を学習するのか?
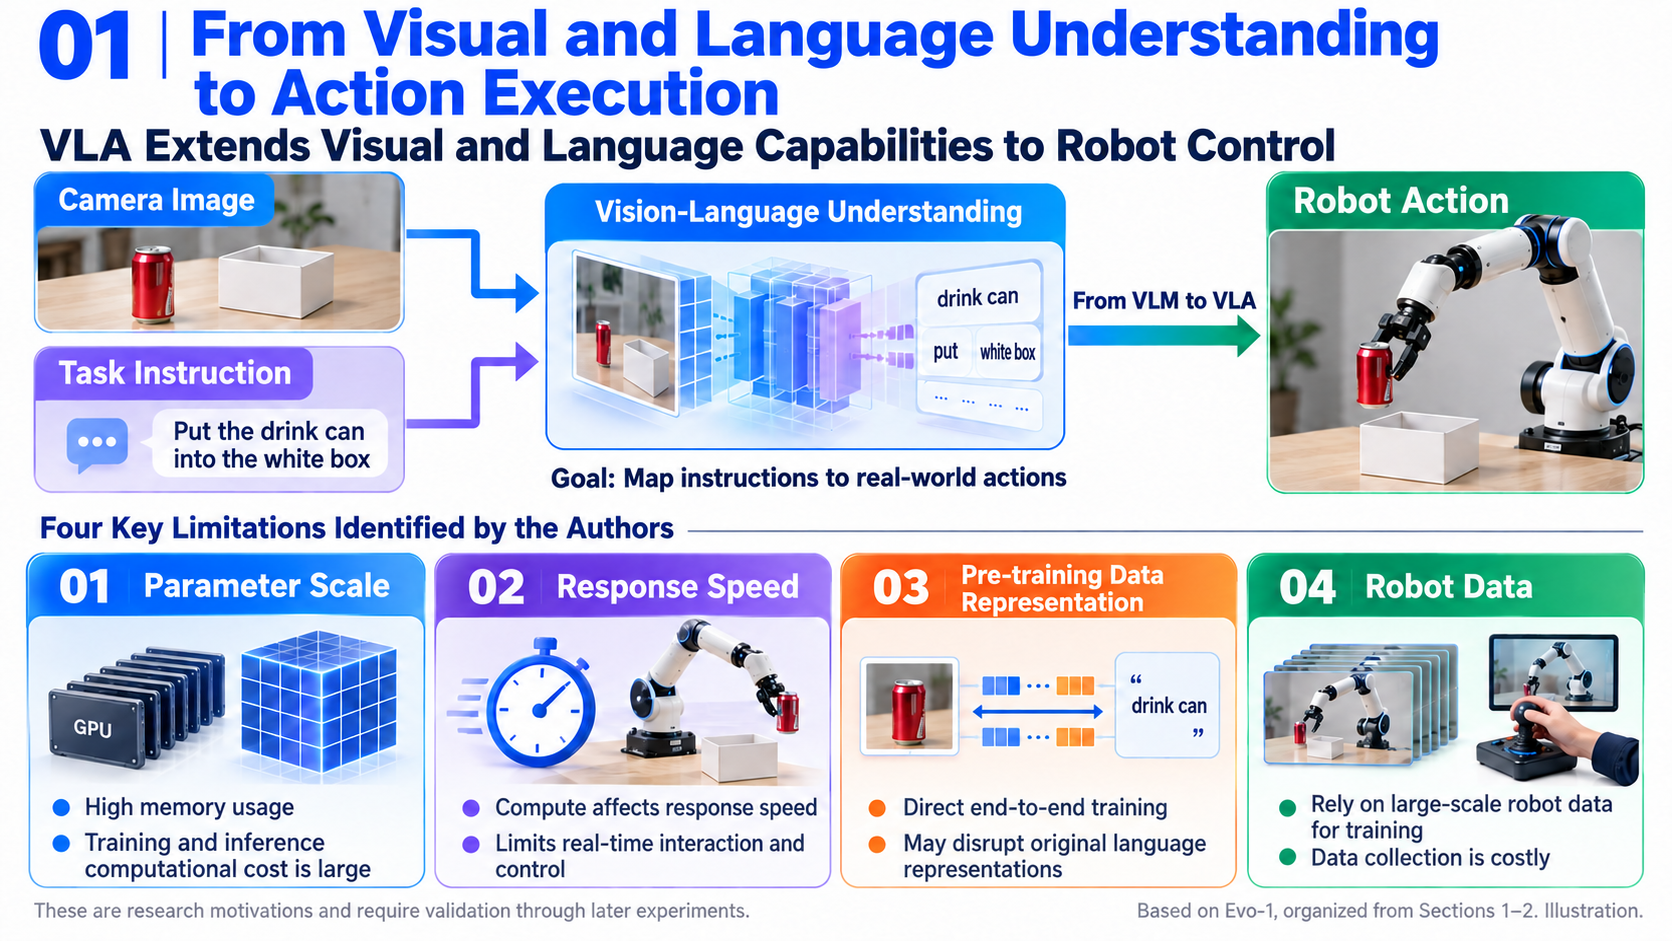
説明: 模倣学習は、提示された状況でロボットがどのように動くかを教えます。Vision-Language-Action モデルはタスクテキストを追加し、画像とインストラクションの両方に条件付けされた制御アクションを学習します。
論文中の「飲料缶を白い箱に入れる」タスクでは、テレオペレーションによってカメラ画像、ロボットの状態(コンフィギュレーション)、それに対応するアクションが与えられます。モデルはそれらとタスクテキストとの関係を学習します。デプロイ時には、現在の画像、インストラクション、状態から将来のアクションを生成し、単に「缶を拾え」という言語指示だけを出すのではありません。
| 概念 | 意味 | Evo-1 における例 |
|---|---|---|
| 観測 | 環境を評価するために用いる情報 | マルチビュー RGB 画像。実機の xArm6 では固定カメラと手首カメラを使用。 |
| 固有感覚状態(プロプリオセプション) | ロボット自身を数値で表現したもの | 実ロボットデータセットでは絶対関節角。 |
| アクション | 制御インターフェースへの数値コマンド | 実システムでは絶対関節角として記録。他のプラットフォームはそれぞれ独自のアクションインターフェースを使用。 |
| Vision-language model (VLM) | 画像と言語を共通の特徴として変換し処理する | InternVL3-1B バックボーン。 |
| セマンティックアラインメント | 画像内容と言語の意味の対応を保つこと | 「飲料缶」は、無関係な背景ではなく、画像中の缶と結び付くべき。 |
注意: アラインメントの維持は、アテンションの可視化とタスク結果によって裏付けられた設計目標です。すべての言語知識を包括的に評価したものではありません。
単一ステップアクションとチャンク
単一ステップ予測は現在のアクションだけを出力します。アクションチャンクでは、複数の将来アクションをまとめて予測します。Evo-1 のデフォルトのホライゾンは 50 ステップです。
Single-step: current images, instruction, state → aₜ
Action chunking: current images, instruction, state → [aₜ, aₜ₊₁, …, aₜ₊₄₉]
例示: ある 1 つの関節について、3 つの目標角度が [0.10, 0.12, 0.15] ラジアンだとします。単一ステップ予測ではこれらを別々に生成しますが、チャンクではこの系列をまとめて予測します。実際の Evo-1 は多次元の 50 ステップチャンクを出力します。
チャンクは連続した軌道をモデル化しますが、実行中に環境が変化する可能性があります。論文では、再観測までに何ステップ実行するのか、オーバーラップのブレンディングや各プラットフォームでの再計画について、完全には仕様が示されていません。したがって 50 ステップを予測することは、50 ステップすべてをオープンループで実行することを意味せず、チャンク長が最終的な制御周波数を決めるわけでもありません。
3 つのステージを区別する
| ステージ | 入力と処理内容 | 結果または基準 |
|---|---|---|
| 学習(Training) | デモの画像、インストラクション、状態、アクション。アクションにノイズを加え、生成方向を学習する。 | モデルパラメータ。損失は方向予測誤差を測る。 |
| 推論(Inference) | 現在の画像、インストラクション、状態、および新たにサンプリングしたノイズ付きアクションチャンク。 | 実行用の連続した将来アクションを生成。 |
| 評価(Evaluation) | 指定されたタスクと初期条件の下で実行。 | タスク成功率に加え、指定 GPU 上での VRAM 使用量と推論レートを測定。 |
学習損失が低いことは、実タスクでの成功率が高いことを直接意味しません。学習メカニズムと評価のエビデンスは、この後で別々に議論します。
要約:翻訳とコメント
翻訳
VLA は知覚、言語、制御を統合し、マルチモーダルな理解を通じて多様なタスクを可能にします。しかし、多くのモデルはパラメータ数が大きく、大規模なロボットデータによる事前学習に大きく依存しており、学習コストを増大させ、リアルタイムデプロイを制限します。いくつかの学習手法はバックボーンの知覚表現を弱めてしまい、過学習や下流タスクでの汎化性能の低下を招くこともあります。
Evo-1 は、ロボットデータによる事前学習なしでデプロイ効率を高める軽量 VLA です。ネイティブにマルチモーダルな VLM を基盤とし、クロス変調された拡散 Transformer と最適化された統合モジュールを備えています。2 段階の学習プロセスにより、有用な VLM 表現を保持しつつ、知覚とアクションの整合性を段階的に高めます。
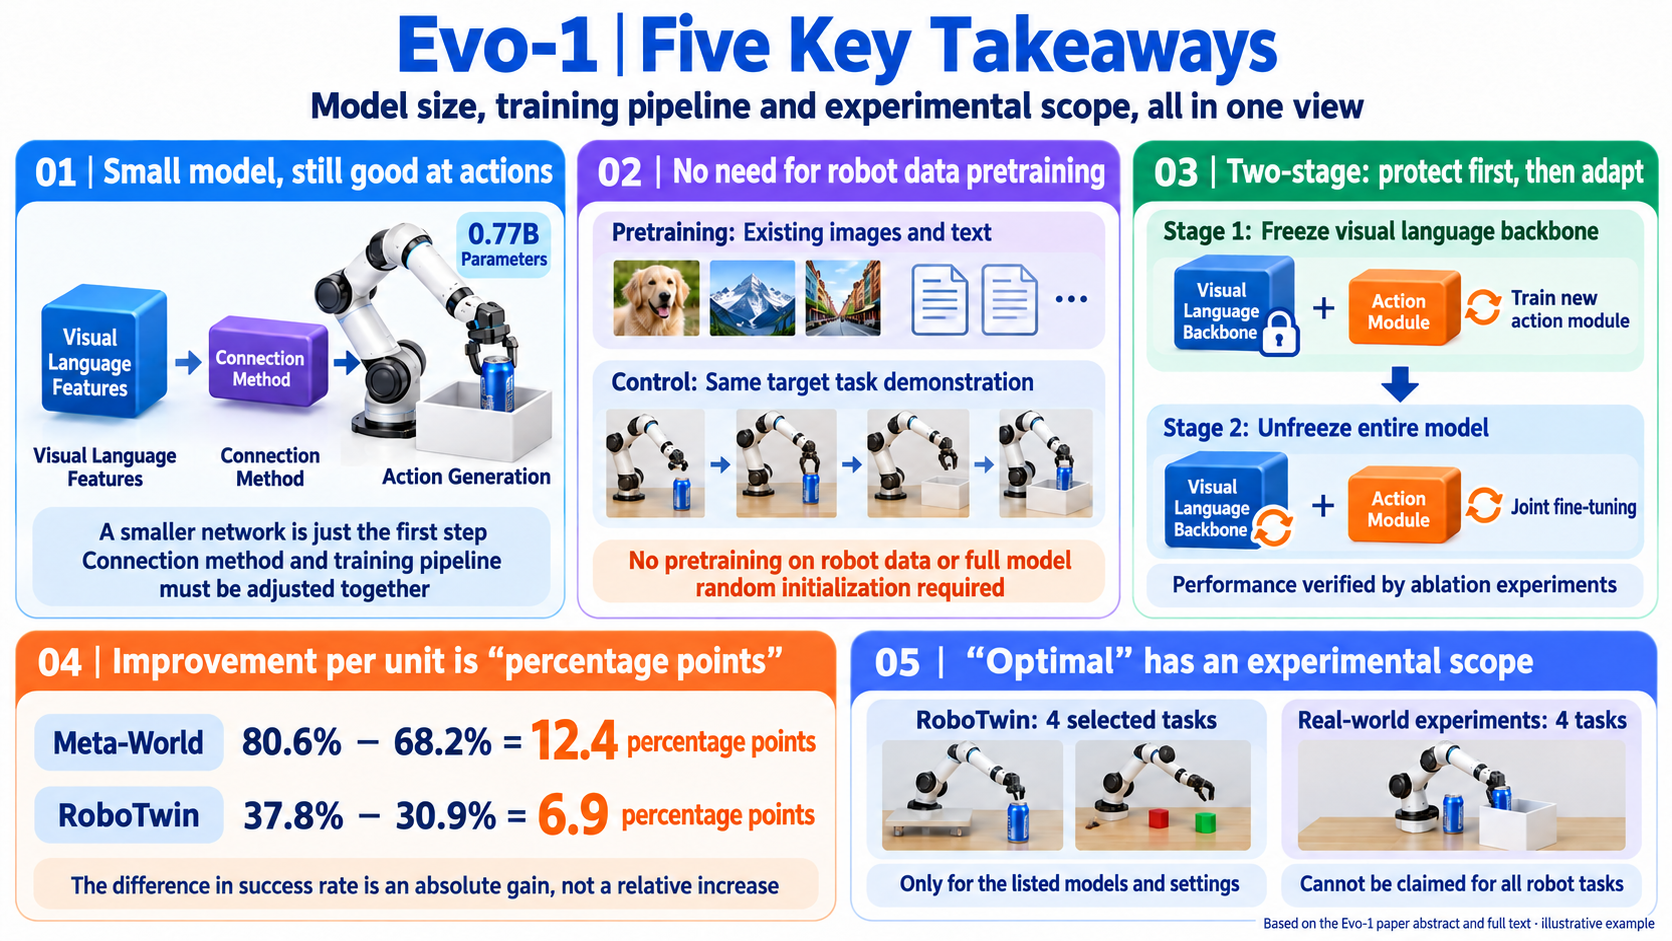
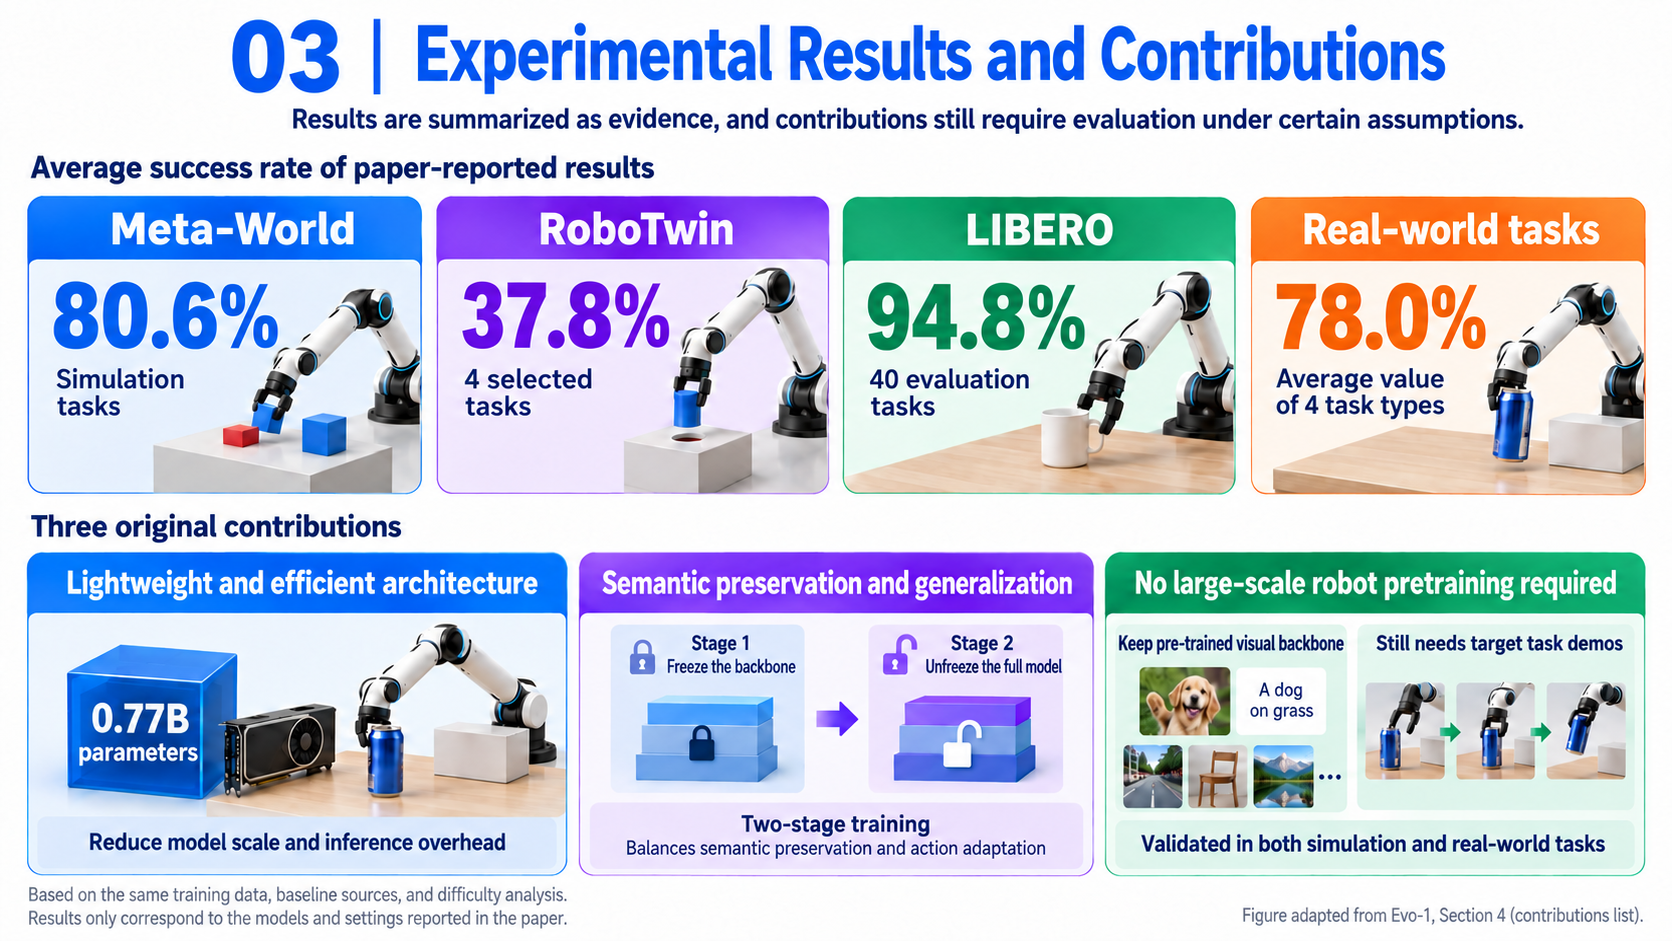
Evo-1 は 7 億 7,000 万パラメータで、Meta-World と RoboTwin において発表時点での最先端の結果を報告しており、比較対象のベスト結果をそれぞれ 12.4 および 6.9 ポイント上回り、LIBERO でも競争力のある 94.8% を達成しています。実世界評価では、高速な推論と低メモリ使用で平均 78% の成功率を報告しており、比較ベースラインを上回ります。コード、データ、重みは公開されています。
コメント
序論と関連研究:なぜアーキテクチャと学習を変えるのか?
序論の 4 つの主要パラグラフ
先行研究との関係
-
大規模 VLA: OpenVLA は離散アクションをモデル化し、π0 は連続アクションエキスパートを用い、Hi-Robot は階層的推論を探究しています。これらの手法はしばしば数十億パラメータのバックボーンを使用します。これに対し Evo-1 は、Vision-Language バックボーンを圧縮し、下流アクションのために異なる統合および学習設計を採用しています。
-
軽量で効率的な VLA: TinyVLA は小さな VLM と拡散型アクションデコーダを組み合わせます。SmolVLA はコンパクトなフローマッチングエキスパート、層の削減、トークン削減、非同期推論を用います。Evo-1 は、InternVL3、スタックされたクロスアテンション、そして凍結から解凍へと進む学習シーケンスによって、同様の効率目標を追求します。
注意: これらは元論文における 2 つの関連研究グループです。すべての大規模モデルがロボット事前学習を必須とすることや、コンパクトな設計があらゆるタスクで優位に立つことを示すものではありません。
中核手法:連続アクションのための安定したコンテキスト
アーキテクチャ、入力、出力
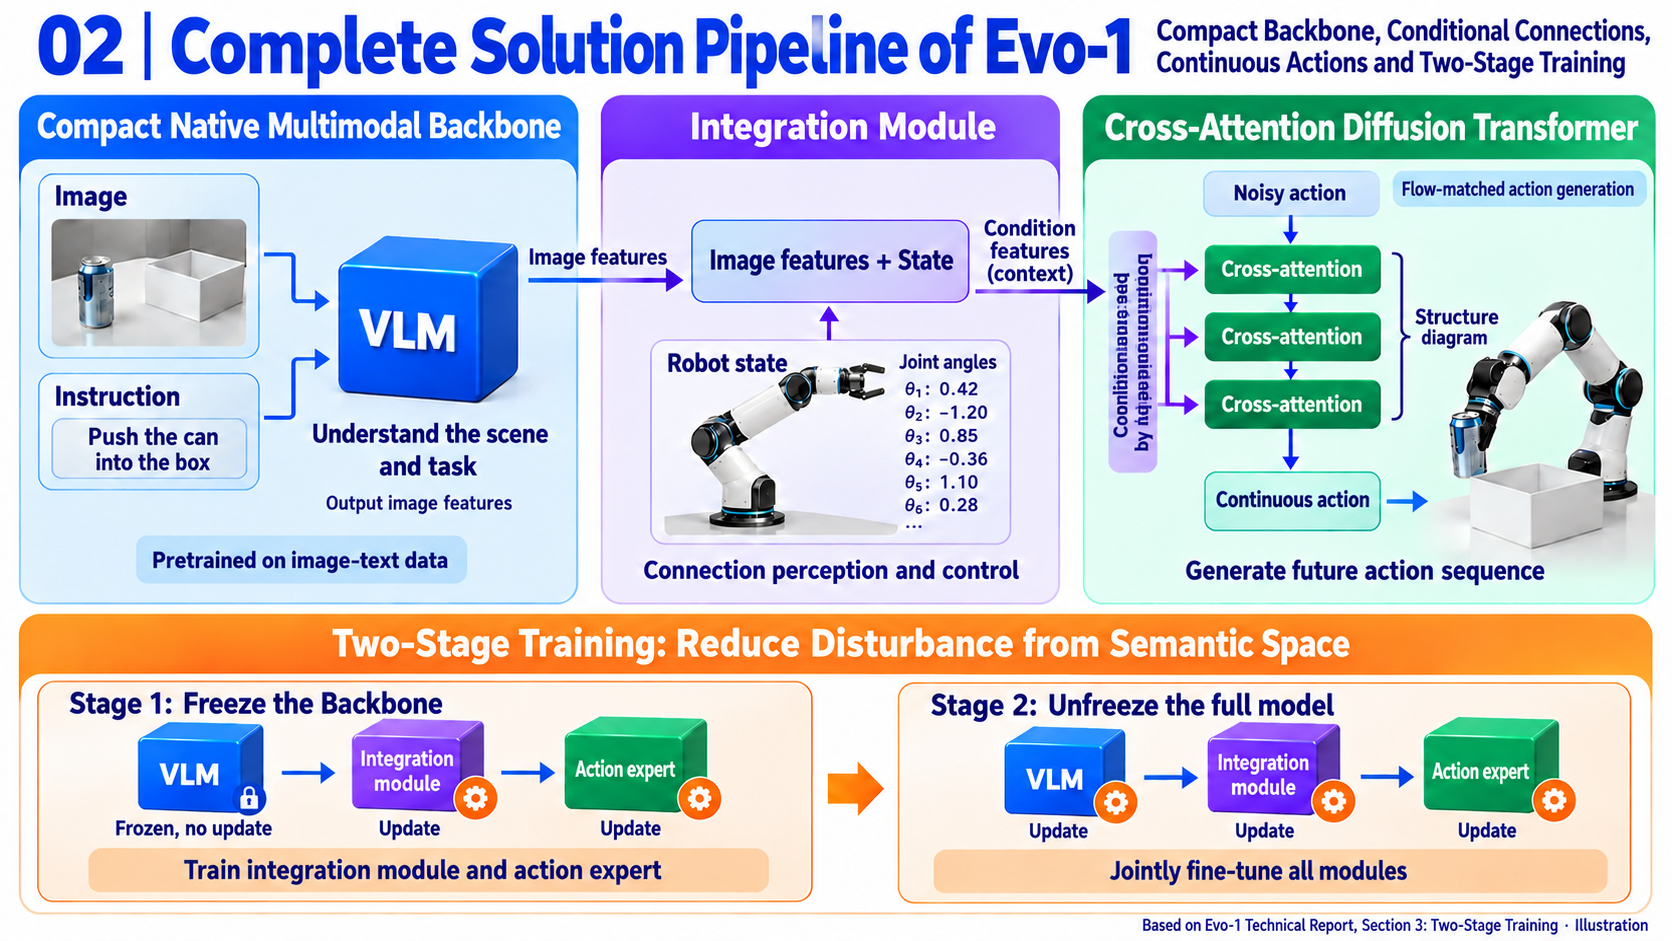
このモデルは、「何が見えているか」と「何をすべきか」をエンコードし、それをロボットの現在状態と組み合わせ、ノイズから将来のアクションを生成します。
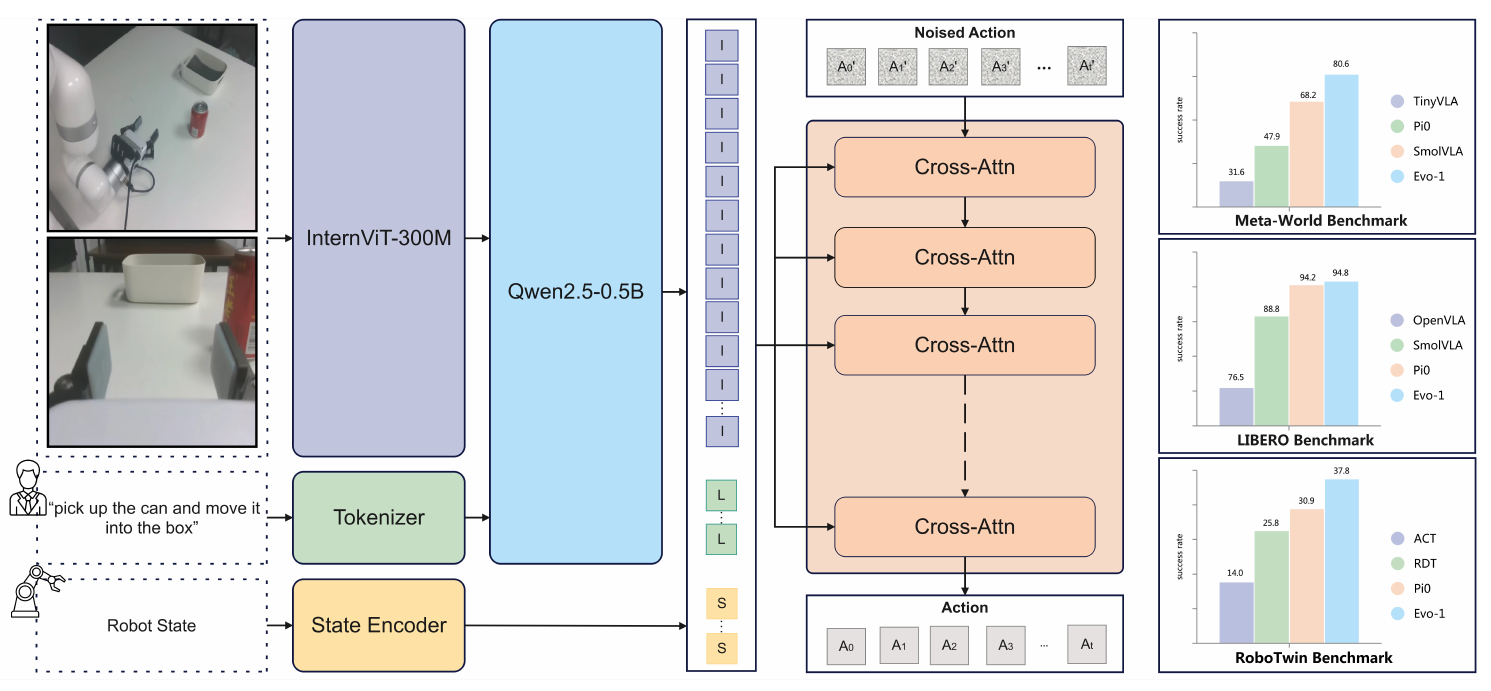
論文: 3 つのコンポーネントは VLM バックボーン、統合モジュール、クロス変調された拡散 Transformer です。完全なモデルは 7.7 億パラメータであり、InternVL3-1B という名前の「1B」を、切り詰めた後に合計へ足してはいけません。
| 経路 | 生の入力 | エンコードと処理 | 出力または役割 |
|---|---|---|---|
| ビジョン | 現在の RGB ビュー N 枚 | 各画像を 448 × 448 × 3 にリサイズし、InternViT-300M 特徴を抽出。pixel-unshuffle により視覚トークン数を 1/4 に削減。 | 視覚埋め込みは画像と言語のシーケンスに入る。 |
| 言語 | 自然言語によるインストラクション | Qwen2.5-0.5B ブランチの最初の 14 層でトークン化・処理。 | 第 14 層での画像と言語の融合特徴。 |
| 状態 | ロボットの固有感覚情報 | デフォルトで 24 次元にパディング。図 1 には状態エンコーダが含まれる。 | アクションエキスパートの条件付けコンテキスト。 |
| アクション | ノイズ付き将来アクションチャンク | デフォルト形状は 50 × 24。8 層の Transformer エキスパートで処理。 | 同じ形状の生成更新を行い、最終的に連続アクションチャンクとなる。 |
N はカメラ台数であり、プラットフォームによって異なります。実機の xArm6 では 2 台です。トークンはシーケンス要素であり、視覚トークンは単語ではなく連続値の特徴です。pixel-unshuffle によるトークン数の削減は、画像の幅と高さをそれぞれ 1/4 に縮小することを意味しません。
論文: InternVL3 はネイティブなマルチモーダル事前学習中に、画像‐テキスト表現とテキスト表現を同時に学習します。InternViT-300M は InternViT-6B から蒸留されています。視覚埋め込みは、共有デコーダでテキストと共同処理される前に、指定された <img> プレースホルダを置き換えます。Evo-1 は第14層の特徴を読み取り、その後の言語層を削除します。
図示的な形状: 1つのアクションチャンクには 50 × 24 = 1,200 個の数値が含まれ、バッチサイズ16の場合は形状が 16 × 50 × 24 になります。24次元のインターフェースにはパディングが含まれており、xArm6 に24個の関節があることを意味しません。有効な次元数と単位は、各プラットフォームのデータインターフェースに従って解釈してください。
注意: この論文では、視覚トークン数、画像‐テキストの隠れ幅、アクションエキスパートの隠れ幅、あるいは状態エンコーディングの詳細が完全には指定されていません。これらの実装上の境界は、コンポーネント名から値を推測することなく、そのまま保持されます。図1の状態エンコーダについて、24次元の生ベクトルがすべての画像‐テキスト特徴に直接加算されると主張して省略してはなりません。
統合: すべての層で同じコンテキストを読む
問題: 画像‐テキスト特徴はシーンとタスクを記述し、状態は現在の構成を記述します。アクション生成はタスクに沿ったままでいるために、これらの条件へのアクセスを維持しなければなりません。
直感: マルチモーダル特徴と状態を、各アクション層がその時点のアクション表現を使って読み出す共有情報源として扱います。最終的な設計は、中間層でのクロスアテンションであり、論文中のモジュールAに相当します。
クロスアテンションでは、クエリ Q はアクションが知る必要のある内容を表し、キー K はそのクエリにマッチし、値 V は取得された内容を提供します。論文: 第14層の画像‐テキスト特徴と状態を連結して K と V とし、ノイズを含むアクション表現を Q とします。すべてのアクション層が同じ条件付けソースを読み出します。
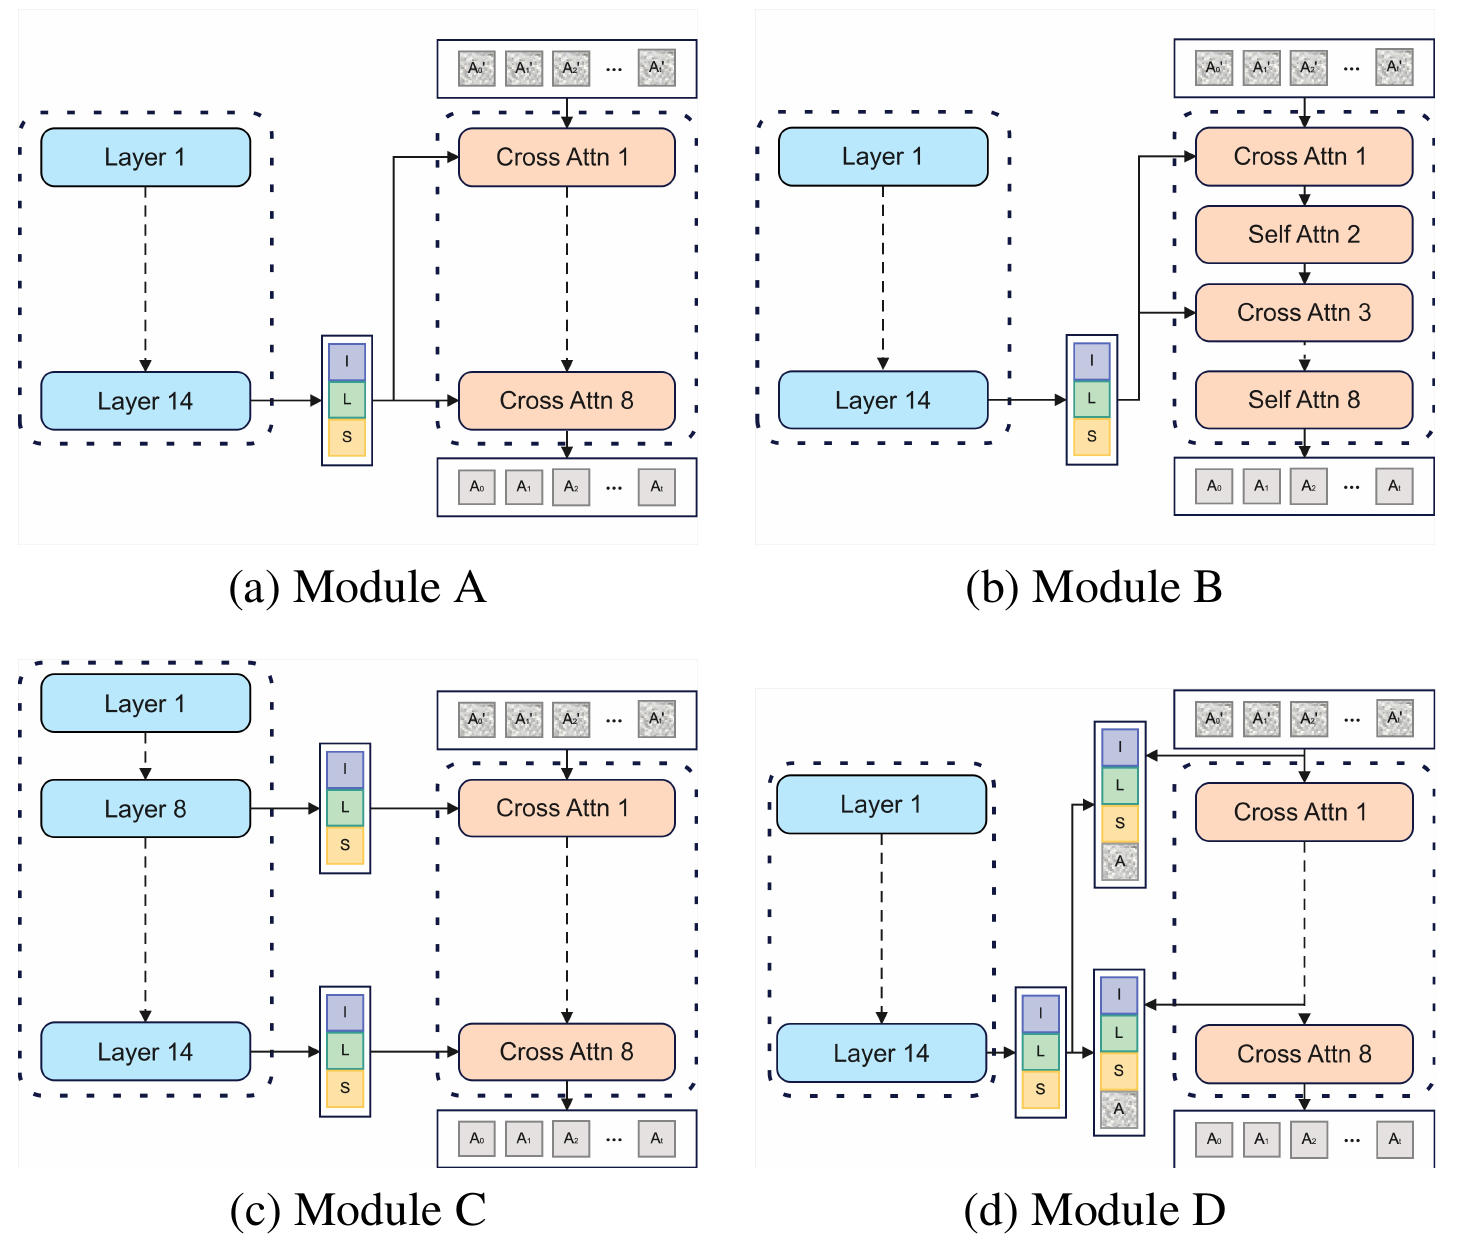
| 設計 | 接続 | 最終設計との差分 |
|---|---|---|
| A: 中間層クロスアテンション | 第14層の画像‐テキスト特徴と状態が、すべてのアクション層に K と V を供給する。 | 採用された設計。層をまたいで条件が一貫する。 |
| B: 中間層でクロス/自己アテンションを交互に挿入 | 条件を読んだ後に自己アテンションを追加する。 | アクション系列内の相互作用が増える。 |
| C: 層ごとのクロスアテンション | 異なるアクション層が、異なる深さの VLM 特徴と状態を読み出す。 | 条件がアクション層の深さによって変化する。 |
| D: Joint-KV クロスアテンション | 画像‐テキスト、状態、ノイズ付きアクションがすべて K と V に入る。 | アクションも取得されるコンテキストになる。 |
説明用の標準的なアテンション方程式であり、論文が提案する追加の損失ではありません:
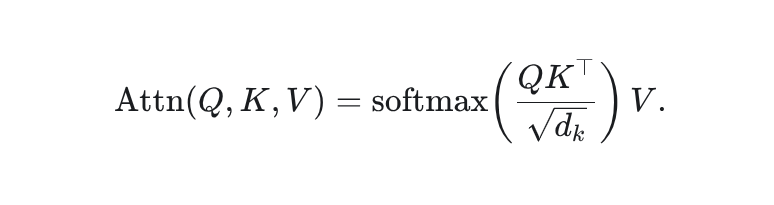
アクション位置が50、条件付けトークンが M 個あるとき、1つのヘッドは Q: 50 × d_k、K: M × d_k、V: M × d_v を持ち、その出力は 50 × d_v になります。d_k と d_v はヘッド幅です。Softmax は各クエリに対する M 個のマッチを正規化します。これらは説明用の記号であり、論文ではその具体的な値が完全には報告されていません。
最小例: ある1つのアクション位置が2つのトークンに重み [0.75, 0.25] を割り当て、それらの選択された値次元が [6, 2] であるとします。取得結果は 0.75 × 6 + 0.25 × 2 = 5 になります。これは指令角度ではなく内部特徴です。次の層は、更新されたアクション表現を用いて再びコンテキストを読むことができます。
注意: テキストでは、共有埋め込み空間への射影ではなく連結を強調している一方で、図1には状態エンコーダが含まれています。これは、連結前に別々の条件付けを保持していると解釈すべきであり、ネットワーク全体に射影やエンコーダが存在しない証拠として解釈すべきではありません。正確な連結軸とエンコーディング幅には実装の詳細が必要です。
アクションエキスパート: Flow Matching でチャンクを生成する
問題: 画像‐テキスト特徴は、そのまま関節角として使うことはできません。将来の軌道には多数の連続値が含まれ、それらをタスク条件の下で生成する必要があります。
直感: ランダムノイズのチャンクから開始し、その値を実演されたアクションへ向けてどの方向に動かすべきかを学習します。“Diffusion Transformer” (DiT) はネットワークアーキテクチャを表し、flow matching は学習目的を表します。これらの名称は両立します。
論文の式 (3):
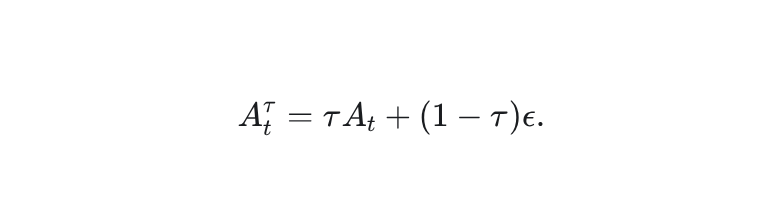
t は観測時刻、A_t はその時刻から始まる実演チャンク、ε は同じ形状のノイズ、τ はロボット時間とは異なる内部生成進行度です。両方の配列はデフォルトで 50 × 24 です。無次元の τ は Beta 分布からサンプリングされ、[0.02, 0.98] に制限されますが、Beta 分布のパラメータは指定されていません。
最小例: 1要素について、アクションを 0.6、ノイズを −0.2、τ=0.5 とすると、補間値は 0.2 になります。この線形経路上では、τ=0 がノイズ、τ=1 がデータですが、学習では切り詰められた区間のみがサンプリングされます。
式 (4)(サンプリング元を省略表記):
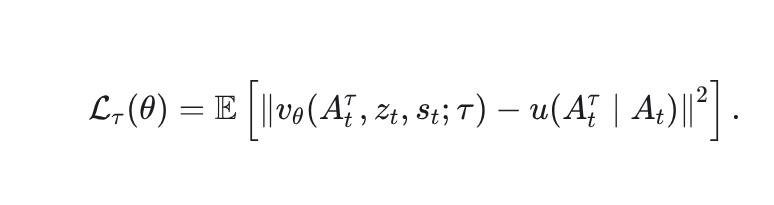
θ は学習可能パラメータ、z_t は画像‐テキスト特徴、s_t は固有感覚状態を表します。v_θ は時間条件付きの予測速度場、u は目標生成方向であり、どちらもアクションチャンクと同じ形状です。二乗ノルムは、実演アクションとノイズ付きサンプルに対する期待値の下で、すべての要素にわたる方向誤差を比較します。元の式ではネットワークの引数から時間条件が省略されていますが、ここではテキスト中の「時間条件付き速度場」という記述に合わせて τ を明示しています。
説明: 式 (3) の線形経路を微分すると A_t−ε になり、これは論文中で u を明示的に展開したものではなく、その式の解釈です。この例では、目標方向は 0.8 であり、0.7 を予測すると二乗誤差は 0.01 になります。モデルは最終解を直接ノイズ付き値から回帰するのではなく、推定値をどのように動かすかを学習します。
推論では、画像‐テキストと状態による条件付けの下で、新しいノイズに対して方向を繰り返し予測し更新することで、[âₜ, âₜ₊₁, …, âₜ₊₄₉] を生成します。エキスパートは、自己アテンションを交互に挿入するのではなく、クロスアテンションを積み重ねた8層の Transformer を使用します。
離散更新の例示:
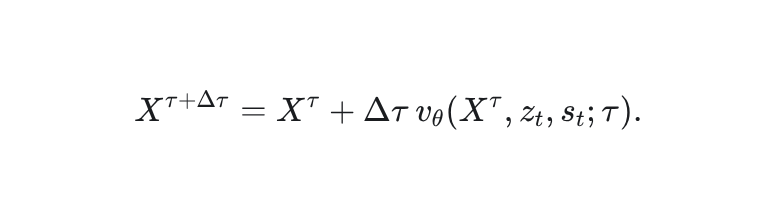
X^τ は現在の推定値、Δτ は無次元の内部ステップサイズです。このオイラー更新は速度場を説明するものであり、論文に記載された完全な推論アルゴリズムではありません。例: 値が 0.2、予測方向が 0.8、ステップが 0.1 の場合、更新後は 0.28 になります。
注意: 内部更新回数、数値解法、および実行スケジュールは完全には報告されていません。8層の Transformer だからといって8ステップのデノイジングを意味するわけではなく、τ はロボットの動作時間ではありません。チャンクをまとめて生成することも、アクションが互いに独立していることを意味しません。
2段階学習: 既存の特徴に新モジュールをまず適応させる
問題: バックボーンはすでに画像‐テキスト能力を持っていますが、アクションエキスパートは新たに初期化されます。すべてをいきなり学習すると、新モジュールの勾配が有用な表現を限られた実演セットへと歪めてしまう可能性があります。
直感: まずアクションモジュールに既存の特徴の使い方を教え、その後で共同適応を許可します。具体的な仕組みは、どのパラメータに更新を許可するかを制御することです。
| 段階 | VLM バックボーン | 統合モジュールとアクションエキスパート | 目的 |
|---|---|---|---|
| 1: アクションエキスパートの整合 | 完全に凍結 | 学習可能 | 固定された知覚特徴をアクションに結び付ける。 |
| 2: 全モデルのファインチューニング | 凍結解除して学習可能 | 学習を継続 | ステージ1のチェックポイントから下流制御を共同で適応させる。 |
論文: すべての実験は 8 枚の NVIDIA A100 GPU 上で分散学習を用いています。Meta-World ではステージ1が 10,000 ステップ、ステージ2が 65,000 ステップであり、どちらも学習率 1×10⁻⁵、バッチサイズ16、ウォームアップ 1,000 ステップ、勾配クリッピング 1.0、weight decay 0.001 を使用します。エキスパートドロップアウトはデフォルトで 0.2、データ拡張は有効のままです。他のベンチマークも同じ2段階アプローチを用い、ステップ数はデータセットサイズに合わせて調整されます(11ページ、表4および表5)。
例: 予測誤差はステージ1では新モジュールのみに更新を与えますが、ステージ2ではバックボーンも変更し得ます。これらのステージは2種類のロボットを意味するものではなく、ロボットデータによる事前学習とタスク学習の組み合わせを意味するものでもありません。
明示的な意味保持損失は追加されておらず、報告されているアクション目的は flow matching です。意味の保持は主に初期化と学習順序に依存しており、ステージ2でもバックボーンは変化します。論文は経過時間や学習コスト全体を示していないため、低コストだからといって、すべての学習が1枚のコンシューマーGPU上で完了したと解釈してはなりません。
学習と推論をエンドツーエンドで行う
Training: demonstration images + instruction → VLM layer-14 image-text features
          demonstrated state → state encoding / integration context
          action chunk + random noise + generation progress → noisy chunk
          context + noisy chunk → action expert → direction prediction → flow-matching loss
          update new modules in stage 1; update the full model in stage 2

Inference: current images + instruction → image-text features
           current state → conditioning context
           fresh noisy chunk → repeated time-conditioned expert updates
           → 50-step continuous prediction → platform control interface → later observations
一文要約: コンパクトなバックボーンがシーンとゴールを解釈し、統合部が永続的なコンテキストを供給し、flow matching がノイズを軌道へと変換し、二段階学習が知覚と行動の適応の仕方を制御する。
実験:どこで性能向上が現れるか
シミュレーション:個々の結果はばらつくが平均は高い
| ベンチマークと範囲 | 学習と評価 | Evo-1 の平均成功率 | 主な比較対象 |
|---|---|---|---|
| Meta-World、50 タスク | タスクごとに 50 デモ、合計 2,500;タスクごとに 10 評価を 5 回の独立実行で平均。 | 80.6% | SmolVLA 68.2%;+12.4 ポイント。 |
| LIBERO、4 スイートで 40 タスク | Spatial / Object / Goal / Long;タスクごとに 10 評価を 5 回の実行で平均。 | 94.8% | π0 94.2%;+0.6 ポイント。 |
| RoboTwin 2.0 の 4 つの選択タスク | タスクごとに 50 デモ;easy と hard 設定;本文では 100 評価試行を報告。 | 37.8% | π0 30.9%;+6.9 ポイント。 |
出典:PDF 5 ページ、表 1;実験設定は 5–6 ページ;補足は 12–13 ページ。RoboTwin の「100 試行」が難易度設定間でどう分配されているかは不明なため、追加の合計値は推定していない。この版では LIBERO のタスクごとのデモ数は明示されていない。
論文: Meta-World の難易度グループは 89.2%、76.8%、77.2%、79.2% を記録し、いずれも記載されたベースラインを上回る。LIBERO グループは 92.7%、97.7%、96.3%、92.3%。Object、Goal、Long はリードしているが、Spatial は π0 の 96.8% を下回る。平均で勝っていても、すべてのカテゴリで勝つとは限らない。
RoboTwin の利得は Click Alarmclock に集中しており、easy / hard で 77% / 58%、π0 の 63% / 11% と比較される。難しい失敗も残っており、Place Can Basket hard は 1% にしか達せず、π0 の 5% を下回る。これらの結果は、選択された両腕タスクに対する有効性を支持するが、難しいシーンに対する包括的な解決策を示すものではない。
注意: Meta-World と LIBERO のベースラインは論文や既存の再現から、RoboTwin のベースラインは公式論文から取得されており、すべての手法がここで一様に再学習されているわけではない。表 1 では SmolVLA を 2.25B としている一方で、効率の表 2 では 0.45B を用いている。この不一致は完全には説明されていないため、同一構成として扱うべきではない。
実機システム:2 つの RGB ビューと絶対関節角
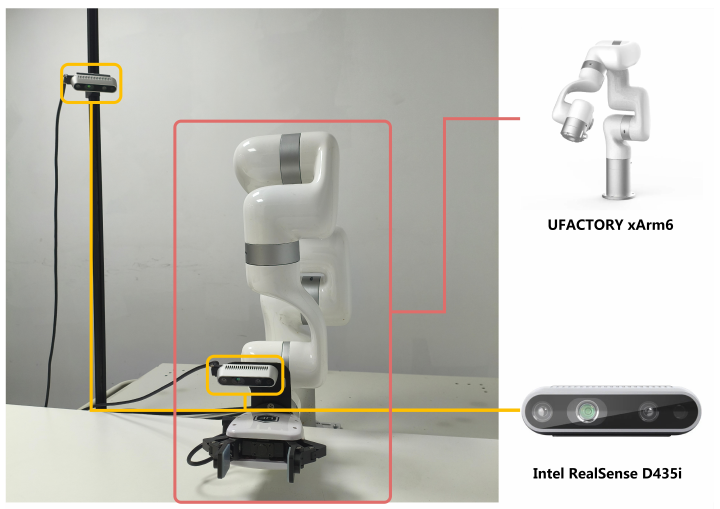
| 項目 | 論文での設定 |
|---|---|
| ロボット | 6 自由度の xArm6 とパラレルグリッパ、公式 xArmAPI により制御。 |
| ビジョン | 固定環境カメラと手首 RGB カメラ;デバイスの深度機能は入力として扱われない。 |
| 記録 | LeRobot v2.1 形式;同期された観測を 30 Hz で記録。 |
| 状態と行動 | 教師あり学習とリプレイと整合した絶対関節角;パディングされたモデルインターフェースは 24 次元。 |
| デモと評価 | 4 タスクそれぞれに 100 個のテレオペレートデモ、合計 400;タスクごとに 20 試行、合計 80。 |
出典:6 ページおよび 14–15 ページ。生のカメラ解像度、デモの長さ、完全なグリッパーフィールドのマッピングは明示的には報告されていない。448 × 448 はモデルの入力サイズである。
実世界での性能と推論効率
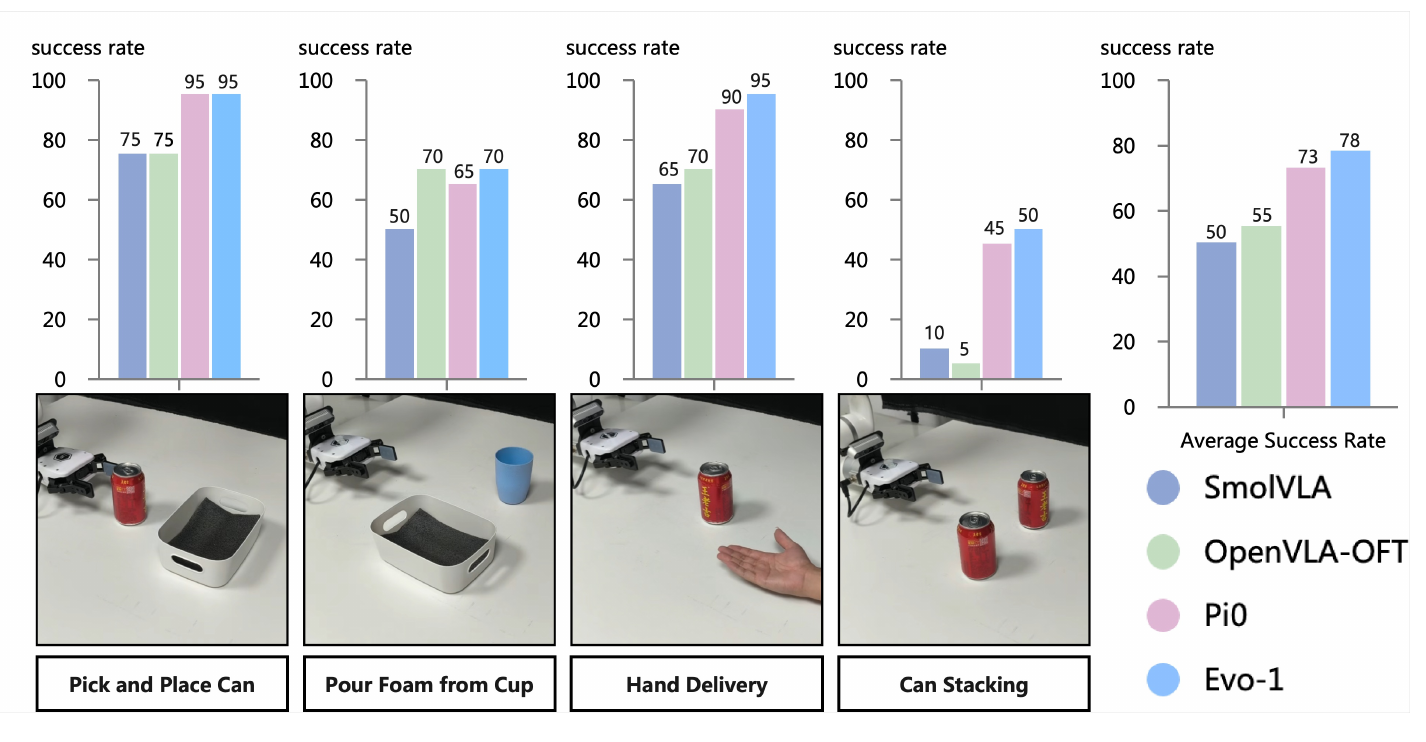
| タスク | 論文での成功基準 | Evo-1 の成功率 |
|---|---|---|
| 缶をピック&プレース | 完全に白い箱の内側にあり、安定していて、転がり出ないこと。 | 95% |
| カップから泡を注ぐ | 泡の大部分が白い箱に入り、目に見える蓄積があり、こぼれが少ないこと。 | 70% |
| 缶を人に手渡す | 人が追いかけたり調整して受け取ることなく、手の中にしっかりと置かれること。 | 95% |
| 缶を積み重ねる | 上の缶が少なくとも 2 秒間、滑ったり落ちたりせず安定していること。 | 50% |
出典:図 4 と 15 ページの成功基準。4 タスクの平均は 77.5% で、78% と報告されている;これは各タスクが 78% という意味ではない。スタッキングは依然として弱点である。
表 2:指定された RTX 4090d GPU 上での測定値。
| モデル | パラメータ数 | 推論時平均 VRAM | 推論時平均レート | 実タスク平均成功率 |
|---|---|---|---|---|
| SmolVLA | 0.45B | 2.0 GB | 12.7 Hz | 50.0% |
| OpenVLA | 7.0B | 15.1 GB | 7.9 Hz | 55.0% |
| π0 | 3.5B | 17.9 GB | 11.5 Hz | 73.0% |
| Evo-1 | 0.77B | 2.3 GB | 16.4 Hz | 78.0% |
出典:7 ページ、表 2。図 4 と結果の本文では、あるベースラインを OpenVLA-OFT と呼んでいる一方で、表 2 では OpenVLA としている。実装設定が同一であると仮定せず、名称をそのまま保持している。
Evo-1 はこの比較の中で最も高速な推論と最高の平均成功率を持つが、SmolVLA よりわずかに VRAM 使用量が多い。2.3 GB の値は推論時の平均メモリであり、学習メモリでもなければ、任意の 2.3 GB デバイスでそのレートが保証されるという意味でもない。
注意: 30 Hz はデモ記録の周波数、16.4 Hz は GPU 推論の周波数、50 は予測ホライズンである。これは異なる段階を表している。完全な知覚–通信–実行のレイテンシは報告されていないため、16.4 Hz を最終的なロボット制御レートとして説明してはならない。
汎化:1 つのタスクにおける撹乱要因と位置変化
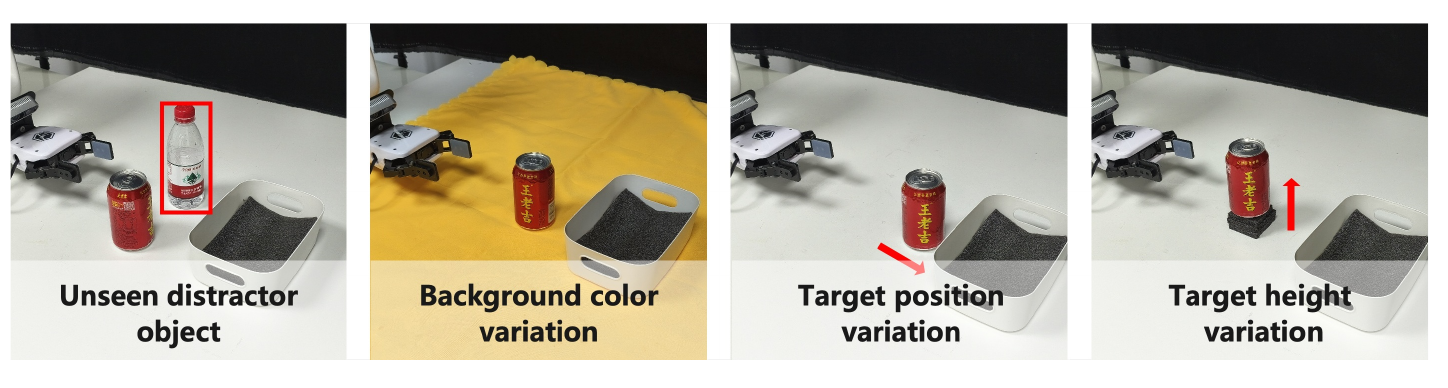
汎化テストでは、缶から箱への配置タスクを用い、撹乱ごとに 20 試行を行う。著者らは、これらの変化を学習分布の外側として定義している。
| 条件 | SmolVLA | Evo-1 |
|---|---|---|
| 基本シーン | 75% | 95% |
| 未見のボトルを追加 | 65% | 80% |
| 黄色いテーブルクロスを追加 | 60% | 75% |
| ターゲットを奥に 10 / 20 / 30 mm 移動 | 75% / 60% / 60% | 95% / 85% / 80% |
| ターゲットを上に 10 / 20 / 30 mm 上昇 | 75% / 65% / 60% | 100% / 90% / 70% |
出典:7 ページ、表 3。変位と高さはミリメートル単位で測定されている。
解釈: 結果は、これらの局所的な変化への適応を支持しており、各条件で Evo-1 が比較対象の SmolVLA を上回っている。ターゲットを 30 mm 上げると成功率は 70% に低下する。20 試行では、1 回の成功がスコアを 5 ポイント変化させるため、小さな差を普遍的な法則として扱うべきではない。これは任意の物体、タスク、ロボットへのゼロショット汎化をテストしてはいない。
補足では、SO-100 が小さなブロックをピックして固定コンテナに配置する様子も示されている(15 ページと 19 ページ)。比較可能な成功率、デモ数、効率の測定がないため、これは適応不要のクロスロボット転移の定量的証拠というより、デプロイのデモンストレーションである。
アブレーションと証拠の境界
永続的コンディショニングは有効か?
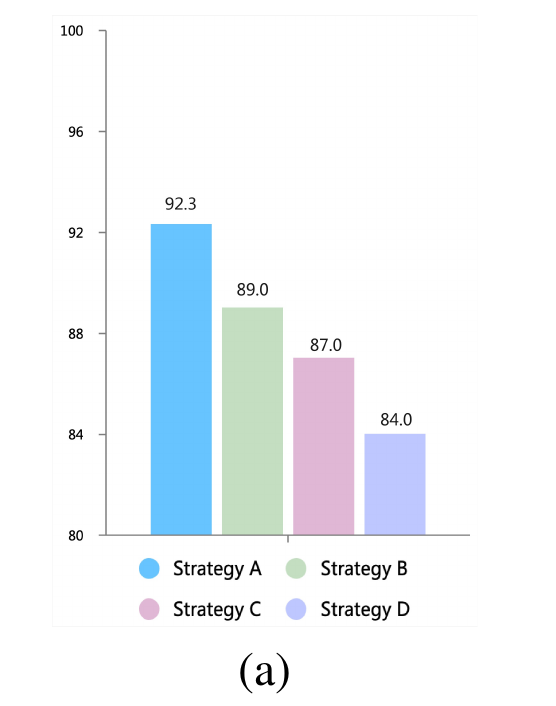
論文: モジュール A、B、C、D はそれぞれ 92.3%、89.0%、87.0%、84.0% を達成する。A は B を 3.3 ポイント上回り、最終モデルとして選択される。
解釈: これは、同じ中間の画像テキスト特徴と状態を繰り返し読み出すことを支持している。著者らは、この利得をより連続的なコンディショニングに帰しているが、実験は 4 つの完全な設計を比較しており、すべての要因を切り分けているわけではない。自己注意が一般的に有害であるとか、多層特徴融合が常に劣ることを示すものではない。
二段階学習は有効か?
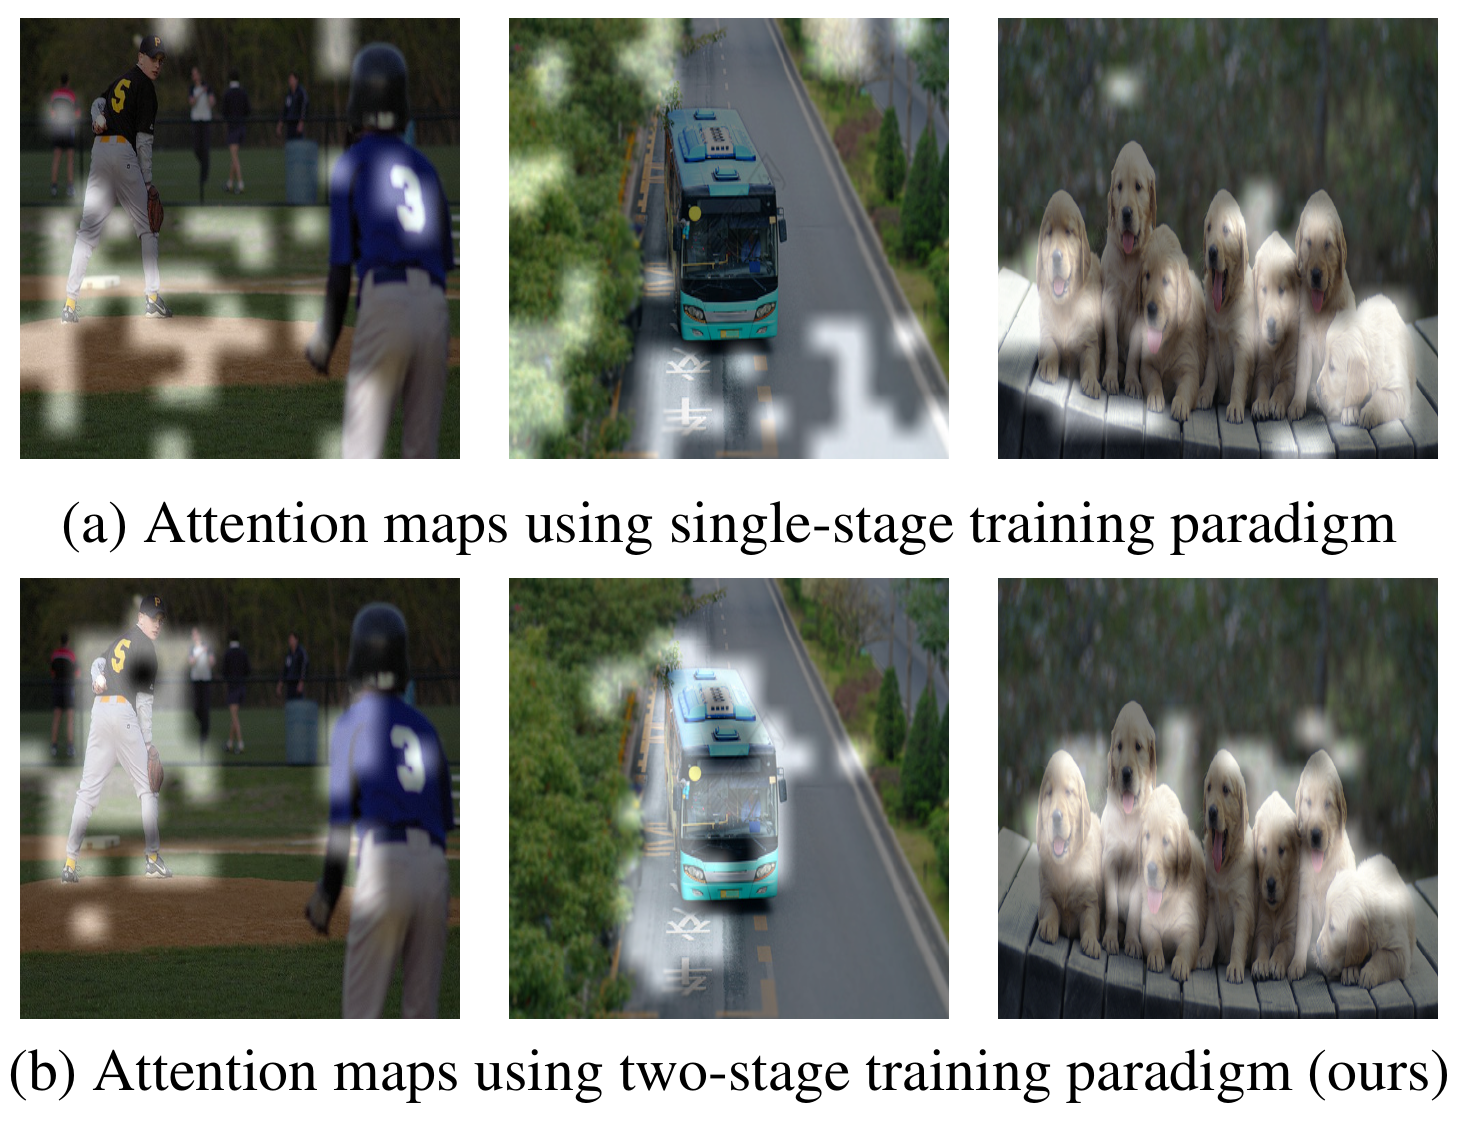
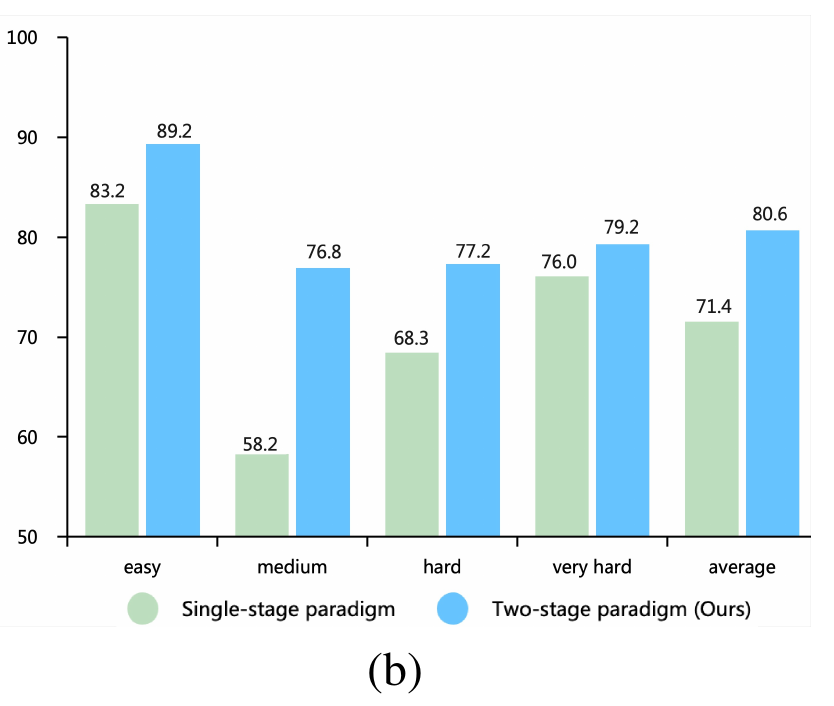
論文: 二段階学習は 4 つの難易度グループすべてで勝利し、平均 80.6% 対 71.4% と 9.2 ポイントの利得となる。一段階学習はすべてのモジュールを即座に更新し、二段階学習はまずバックボーンを固定し、その後に共同でファインチューニングする。
解釈: 制御された成功率比較は、この学習順序を支持している。アテンションマップは、より明瞭な画像テキストのフォーカスを示唆する。図 2 では Evo-1 と OpenVLA も比較されているが、バックボーンやサイズが異なるため、その比較だけで二段階学習の因果効果を立証することはできない。同一アーキテクチャでのアブレーションの方が直接的である。
注意: 一般的な視覚質問応答、言語理解、意味的忘却についての包括的な定量評価はない。意味保持は局所的な可視化とタスクの証拠に基づいており、すべての事前学習知識が保持されることの証明ではない。
何を持ち帰るべきか
Evo-1 は、コンパクトに切り詰められたネイティブなマルチモーダルバックボーン、安定したクロスアテンションコンディショニング、共同ファインチューニング前のアラインメントを組み合わせている。この 0.77B の組み合わせは、報告されたシミュレーションおよび実機タスクで良好な性能を示す。flow-matching の行動エキスパートは依然としてターゲットタスクのデモを必要とする。
結論は証拠の範囲内にとどめるべきである:RoboTwin は 4 つの選択タスクをカバーし、実世界での缶スタッキングは 50% の成功にとどまり、汎化は 1 つのタスクに対するいくつかの変化を対象としている。効率は RTX 4090d の測定に依存し、学習には 8 枚の A100 が用いられている。この論文は、小型 VLA におけるアーキテクチャと学習設計の価値を示すものであり、より大きなモデルの普遍的な代替や任意のロボットへの直接デプロイを示すものではない。