GR00T N1:デュアルシステムアーキテクチャはいかに汎用ヒューマノイド制御を支えるか
GR00T N1:汎用ヒューマノイドロボットのためのオープンな基盤モデル
- ヒューマノイドロボット
- デュアルシステムアーキテクチャ
- データピラミッド
- フローマッチング
GR00T N1.7:適応とファインチューニング
このリーディングでは元の GR00T N1 論文を扱います。GR00T N1.7(nvidia/GR00T-N1.7-3B)を実際に扱うには、既存の reBot コースに従ってください:
- ロボットのエンボディメントと GR00T アーキテクチャ
- reBot VLA データセットの準備
- reBot Arm 向けに GR00T N1.7 をファインチューニングする
- ファインチューニング済みモデルをロボットにデプロイする
以下で議論する N1 の実験設定は、元の論文に属するものです。バージョン固有の学習およびデプロイ設定には N1.7 のチュートリアルを使用してください。
前提知識
ACT から GR00T N1 へ:学習ループは同じ
すでに LeRobot + ACT を使ったことがあれば、このワークフローには見覚えがあるはずです:
Human teleoperation
    ↓
Collect camera / state / action data
    ↓
Organize an episode dataset
    ↓
Train a policy
    ↓
Observation → Action chunk → On-robot execution
GR00T N1 も同じ問いに答えます:
ロボットが見ているもの、その現在の状態、そしてユーザーの要求が与えられたとき、次にどのように動くべきか?
ACT は通常、デモから 1 つのロボットとタスクファミリーを学習します。GR00T N1 は、特定の実ロボットに適応する前に、複数のロボット、人間の動画、合成データから一般的な事前知識を獲得しようとします。
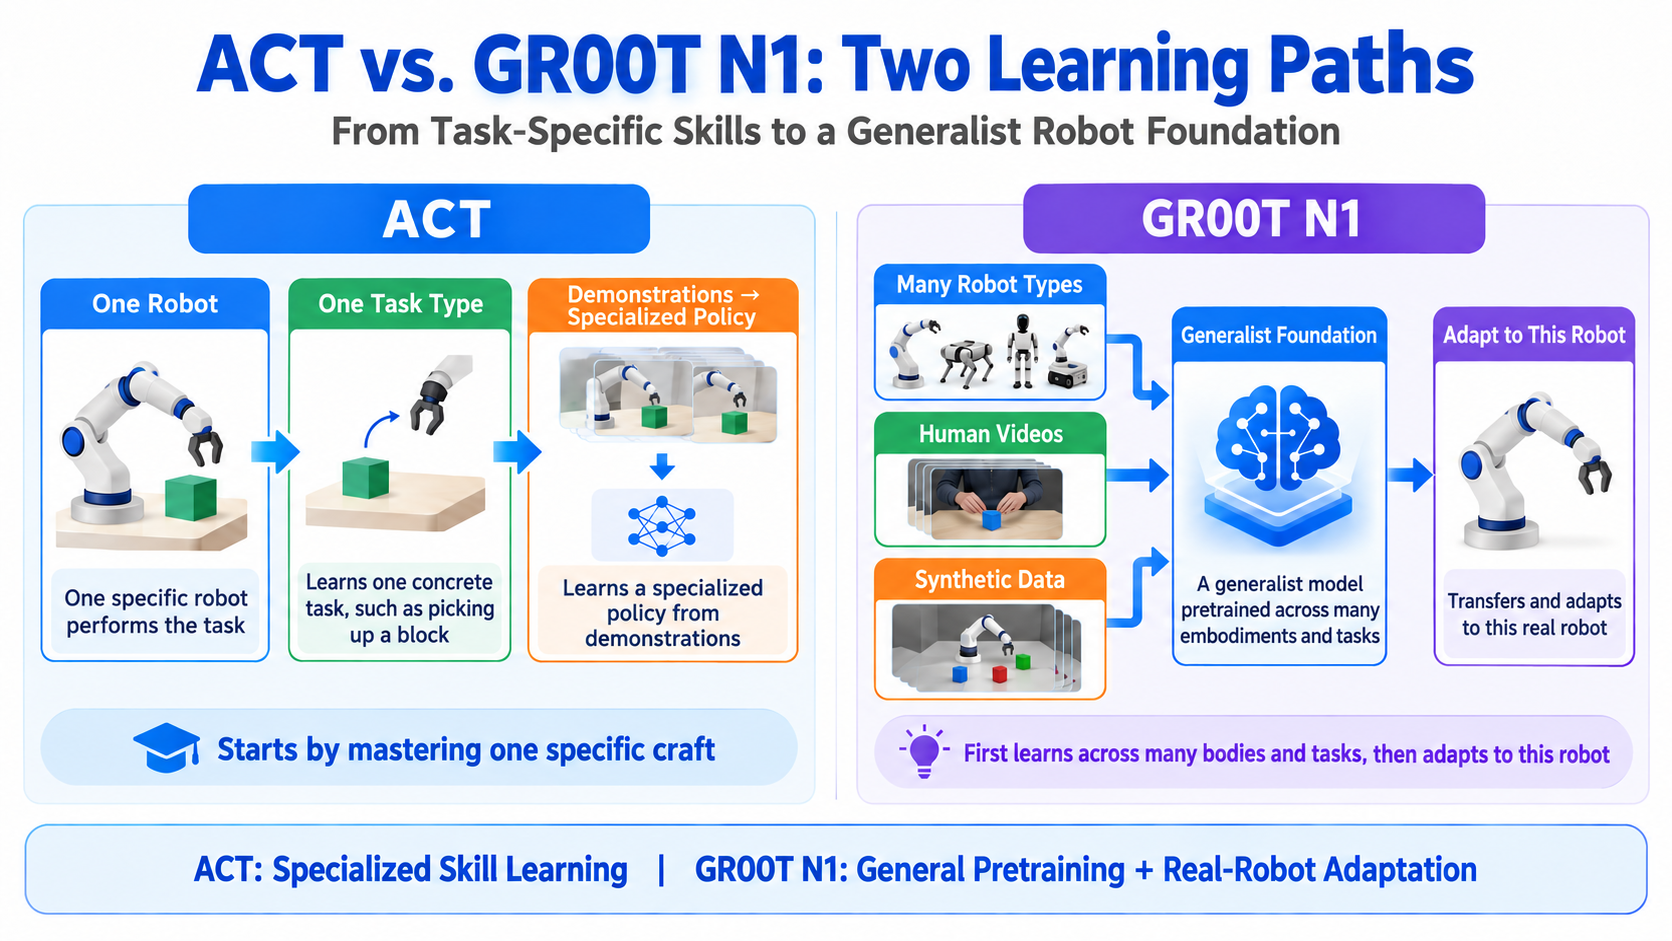
ACT は 1 つの具体的なスキルから始めますが、GR00T N1 はまず複数のボディとタスクにまたがる基盤を学習し、そのうえで現在のロボットの使い方を学びます。
観測、状態、アクション、そしてエンボディメント
ACT で導入した 3 つの用語は、その意味を保ったままです:
-
観測(Observation): 頭部、手首、マルチビュー RGB 画像などの外部センサー情報。
-
状態(State): 関節角度、グリッパ開度、エンドエフェクタ姿勢、腰や首の状態など、ロボットの構成。
-
アクション(Action): 関節目標値、増分、エンドエフェクタ姿勢、グリッパコマンドなどになりうる要求制御量。
エンボディメント(Embodiment) は見た目以上のものを含みます。ボディと制御の定義を組み合わせた概念です:
Robot structure
+ Sensors
+ State definition
+ Action definition
+ Control frequency and mode
= One embodiment
単腕の Franka、両腕システム、GR-1 ヒューマノイドでは、状態/アクションの次元が異なります。これらのボディ間で 1 つのモデルを共有することが中心的な課題です。
VLA、アクションチャンク、フローマッチング
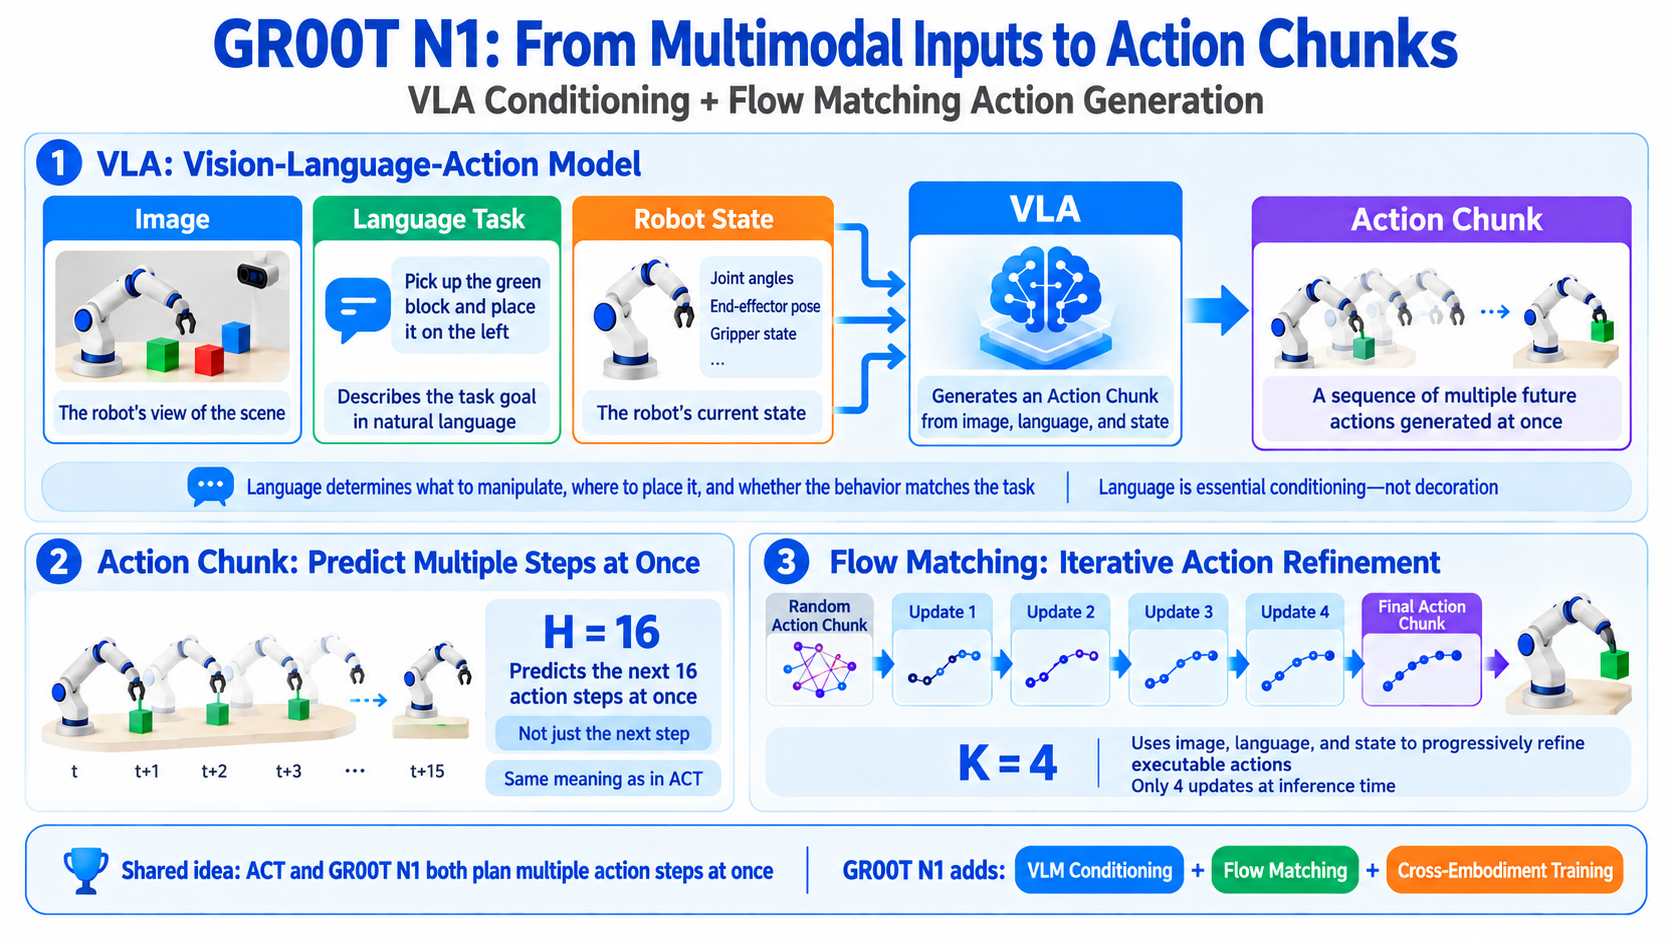
VLA は、視覚ポリシーの入力にタスク言語を追加したものです。言語は、どの物体を操作するか、どこへ運ぶべきか、振る舞いが要求と一致しているかを特定するものであり、装飾的なコンテキストではありません。
アクションチャンク は ACT と同様に、1 ステップのアクションではなく短い未来のシーケンスを予測します。GR00T N1 では H = 16 に設定されています。
フローマッチング は、画像・言語・状態による条件付けのもとで、ランダムなアクションを実行可能なチャンクへと洗練していくものと理解できます。この論文では推論更新回数として K = 4 のみを使用しています。
要約(Abstract)
汎用ロボットには、有能なボディと知的なモデルの両方が必要です。ヒューマノイドは人間環境に適しているため有望ですが、新しい状況の理解、現実世界のばらつきへの対処、新しいタスクの迅速な学習には、大規模で多様なデータで学習された基盤モデルが必要です。
GR00T N1 は、デュアルシステム VLA アーキテクチャを備えたヒューマノイド向けのオープンな基盤モデルです。ビジョン・言語モジュールである System 2 が画像と言語指示を解釈し、拡散 Transformer である System 1 がリアルタイムに滑らかなアクションを生成します。これらのモジュールは密接に接続され、エンドツーエンドで共同学習されます。
学習には、実ロボットの軌跡、人間の動画、合成データを混在させます。GR00T N1 は、複数のエンボディメントにまたがるシミュレーションベンチマークにおいて、比較対象の模倣学習ベースラインを上回り、Fourier GR-1 ヒューマノイド上で言語条件付きの両腕タスクを効率的に学習します。
論文は次の 3 つのアイデアで構成されています:
-
デュアルシステム VLA: 1 つのコンポーネントが解釈し、もう 1 つが行動する。
-
異種データ: 人間の動画、シミュレーション、生成動画をロボットデモと並行して利用する。
-
エンボディメントをまたぐ共有: 異なるボディに完全に独立したモデルを与えるのではなく、中核能力を共有させる。
序論と関連研究
ハードウェア、モデル、データ、そしてデータアイランド
序論では、必要な 3 つの要素が挙げられています:
-
ハードウェア: 物理的な能力を決定します。人間環境は人の身体に合わせて設計されているため、ヒューマノイドは魅力的です。
-
モデル: 1 つの固定された振る舞いではなく、オープンエンドなタスクを扱える必要があります。
-
データ: 環境、物体、タスク、ボディへの露出を決定します。
言語モデルやビジョンモデルはインターネットから学習できますが、ロボティクスにはそれに相当する「アクションのインターネット」が存在しません。実データの収集は高コストで時間がかかり、ロボットは関節、センサー、制御がそれぞれ異なります。
データセットをまとめても、データアイランド が残ることがあります。ファイルは同じデータベースを共有していても、意味やアクション空間を共有していないのです。
そのため論文では、ポリシーをどう設計するかだけでなく、その学習コーパスをどう統一するかも問います。
データピラミッド
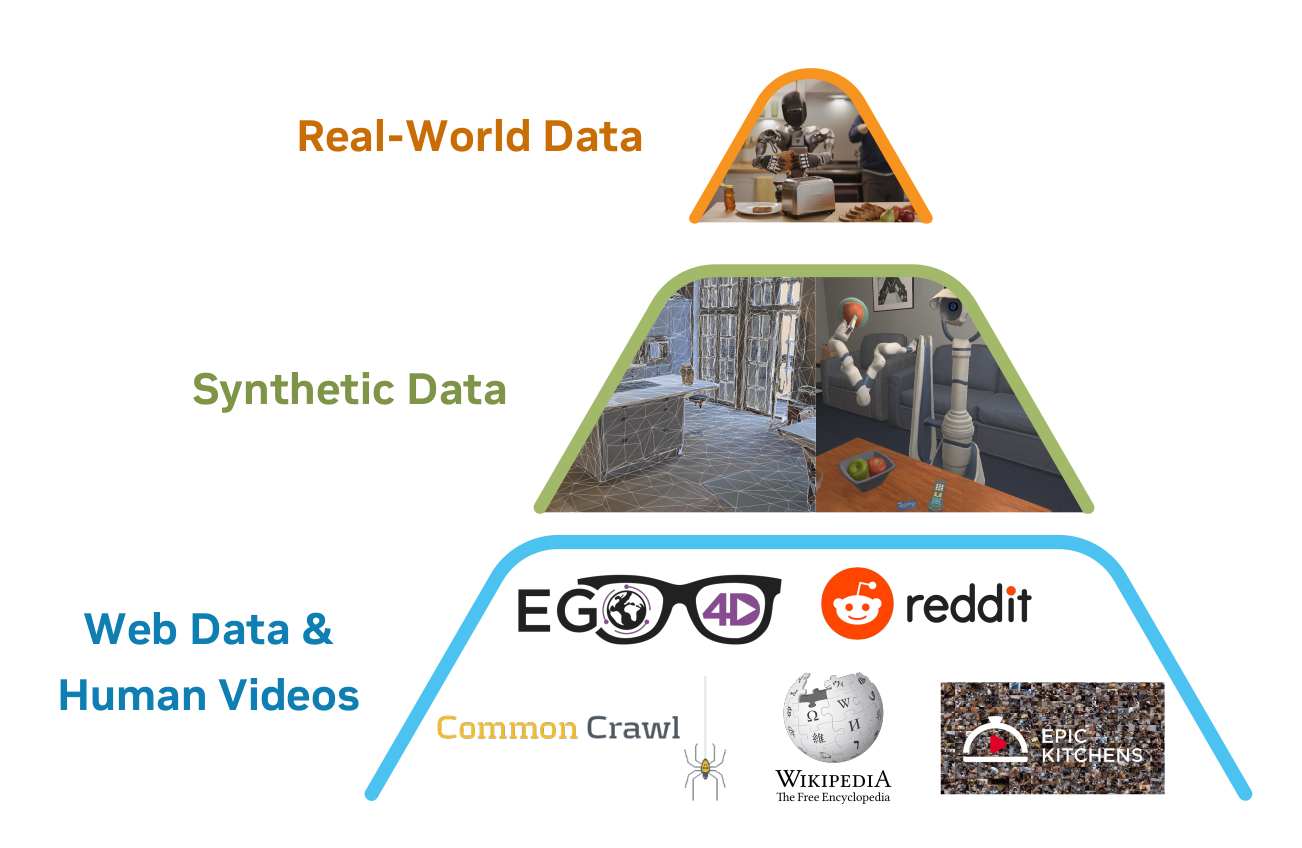
| レベル | データ | 相対量 | ロボットとの関係 |
|---|---|---|---|
| 底部 | Web データ + 人間の動画 | 最大 | 直接のロボットコマンドなしに豊かなアクション概念を提供。 |
| 中間 | シミュレーション + ニューラルトラジェクトリ | 大 | スケーラブルで制御可能だが、シミュレーションや生成に由来するバイアスがある。 |
| 上部 | 実世界のロボットデータ | 最小 | 実行に最も近く、収集コストが最も高い。 |
上に行くほど量は減りますが、対象エンボディメントへの特異性は増します。
人間の動画:どのようなアクションやタスクが存在するか シミュレーション/生成:それらのタスクがどのように変化しうるか 実ロボットデータ:このボディがそれらをどう実行すべきか
GR00T N1 アーキテクチャ
System 2 は理解し、System 1 は行動する
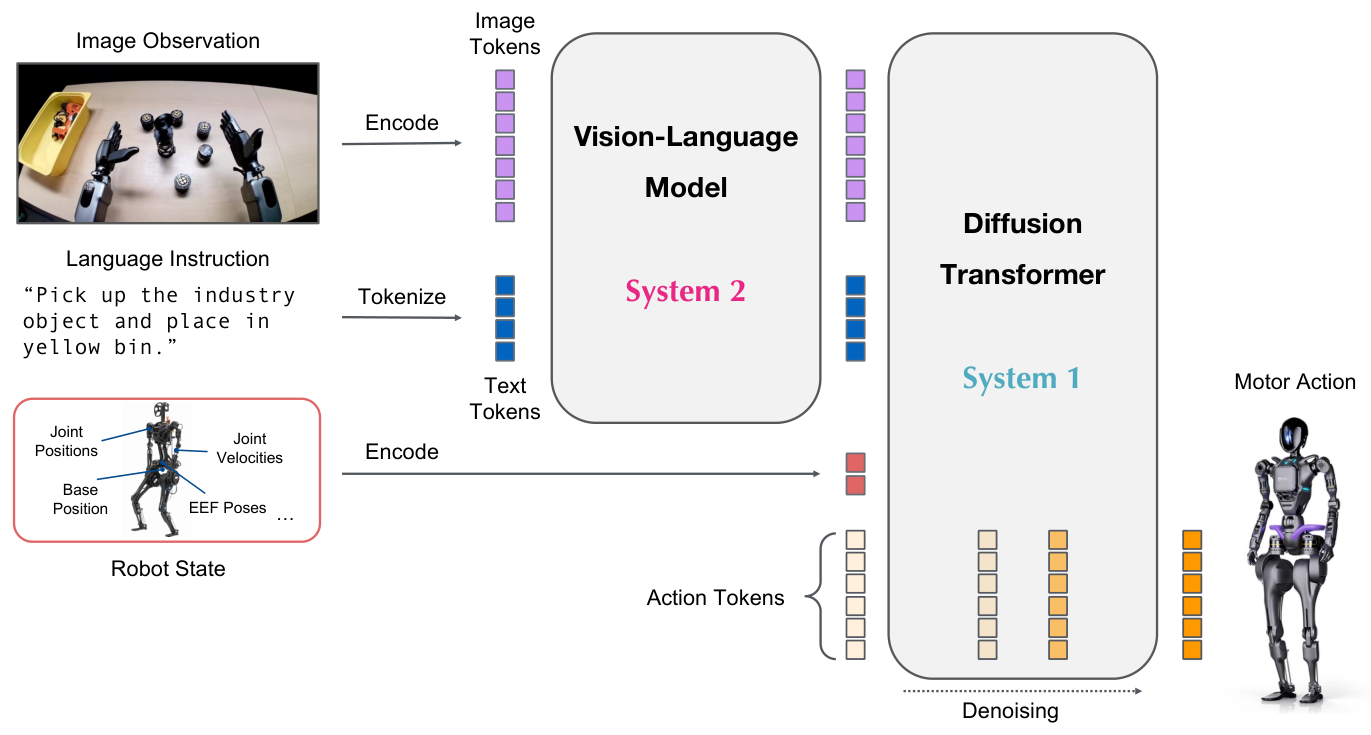
このアーキテクチャは、認知科学のデュアルシステムの比喩を借りています:
-
System 2:Eagle-2 VLM。画像、言語、タスクを解釈します。
-
System 1:拡散 Transformer(DiT)。連続アクションを高速に生成します。
これらは独立したプログラムではありません。クロスアテンションによって密接に結合され、学習も共同で最適化されます。
Eagle-2 は言語モデルと画像エンコーダを含みます。画像は 224 × 224 で入力され、フレームごとに 64 トークンを生成します。著者らは最終特徴ではなく、中間のレイヤー 12 の VLM 特徴を使用しており、自身の実験では速度と下流タスクの成功率が向上したと報告しています。
System 2 は NVIDIA L40 上で約 10 Hz で動作する一方、アクションシステムはより高いレートでクローズドループ制御を出力できます。高レベルの解釈はミリ秒ごとに再計算する必要はありませんが、モーションは連続でなければなりません。
異なるロボットを 1 つの DiT に接続する
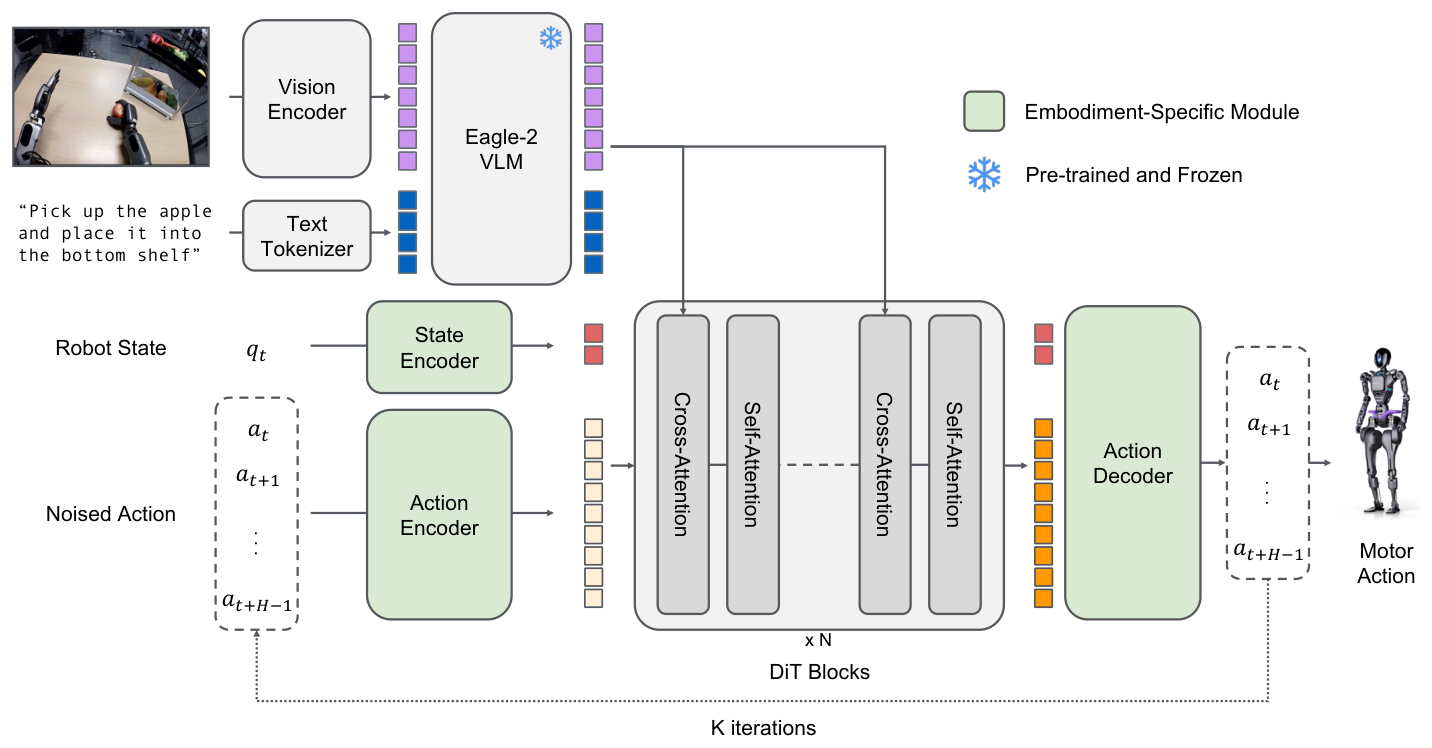
モジュールには 2 種類あります:
-
共有コア: VLM と DiT が、ロボット間で視覚・言語・行動の知識を共有します。
-
エンボディメント固有インターフェース: 状態エンコーダ、アクションエンコーダ、アクションデコーダが、プラットフォームごとの次元と制御セマンティクスを共有特徴との間で変換します。
| モジュール | 機能 | なぜエンボディメント固有なのか? |
|---|---|---|
| 状態エンコーダ | 現在の状態をトークンとしてエンコード。 | 状態の項目や次元が異なるため。 |
| アクションエンコーダ | ノイズを含むアクションと生成時刻をエンコード。 | アクションの次元が異なるため。 |
| アクションデコーダ | DiT の特徴を制御信号に変換。 | 関節、エンドエフェクタ、グリッパの制御モードが異なるため。 |
コメント: クロスロボット学習とは、ベクトルを同じ長さにするためにゼロ埋めすることではありません。各値がどの関節・姿勢・コマンドを表すのかが分からなければ、次元を揃えても意味がありません。
フロー・マッチングによるアクションチャンク
時刻 t において、1つのアクションではなくシーケンスを予測します:
A_t = [a_t, a_(t+1), ..., a_(t+H-1)]
H = 16
学習は、実際のチャンク A_t、ガウス雑音 ε、フロー時間 τ から始まり、次を構成します:
A_t^τ = τ A_t + (1 - τ) ε
-
τ=0付近では、チャンクは雑音に近い見た目になります。 -
τ=1付近では、実際のアクションに近い見た目になります。
DiT は視覚・言語特徴、状態特徴、およびノイズの入ったアクションを読み取り、更新方向を学習します。論文では損失を次のように記述しています:
L_fm(θ)
= E_τ [ || V_θ(φ_t, A_t^τ, q_t) - (ε - A_t) ||² ]
ここで φ_t は VLM 特徴、q_t はロボット状態特徴を表します。
推論時には実際の将来アクションがないため、ノイズから開始し、前進オイラー法による 4 回の更新を行います:
A_t^0 ~ N(0, I)

A_t^(τ+1/K)
= A_t^τ + (1/K) V_θ(φ_t, A_t^τ, q_t)

K = 4
GR00T-N1-2B は合計 22 億パラメータを持ち、そのうち約 13.4 億が VLM に含まれます。L40 上では、16 ステップのチャンク生成に約 63.9 ms かかります。
データと学習
ロボットアクションのない動画の利用
ロボット軌跡は、画像・状態・アクションを直接教師します。人間や生成動画には画像は含まれますが、ロボット関節コマンドは含まれません。
GR00T N1 は 2 つの方法でアクションに似た教師信号を追加します。
潜在アクションは、正確な関節角度ではなく視覚変化から離散的な行動コードを学習します。例えば、左に動かす、把持する、押すといった概念です。
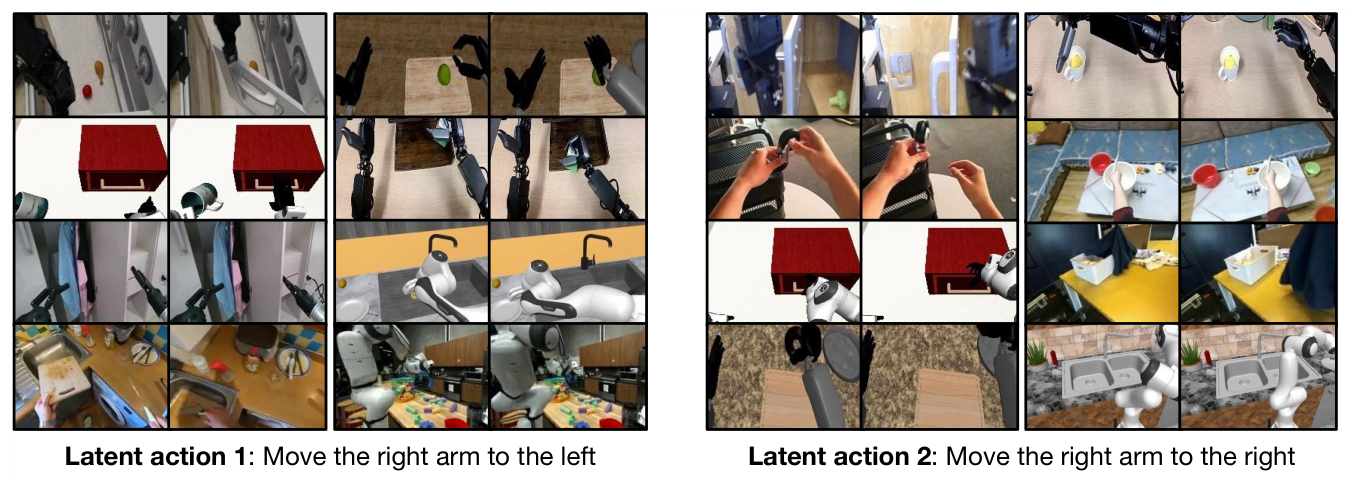
これらはエンボディメントをまたいで適用できます。人の手とロボットグリッパは関節構造が異なりますが、どちらも画像内で物体を左に動かすことができます。
逆動力学モデル (IDM) は、観測間のアクションを推定します:
Observation_t + Observation_(t+1)
                  ↓
                 IDM
                  ↓
          Pseudo Action Label
潜在アクションは単位のない行動語彙に似ており、IDM の出力は疑似アクションラベルに似ています。どちらも動画を完全な物理デモにするわけではありませんが、画像のみのデータを事前学習に利用可能にします。
ニューラルトラジェクトリとシミュレーション:少ないデモから多様性を得る
動画生成は実際のロボット画像から開始し、言語プロンプトを変化させてタスク・物体位置・軌跡を合成します。これらが ニューラルトラジェクトリ です。
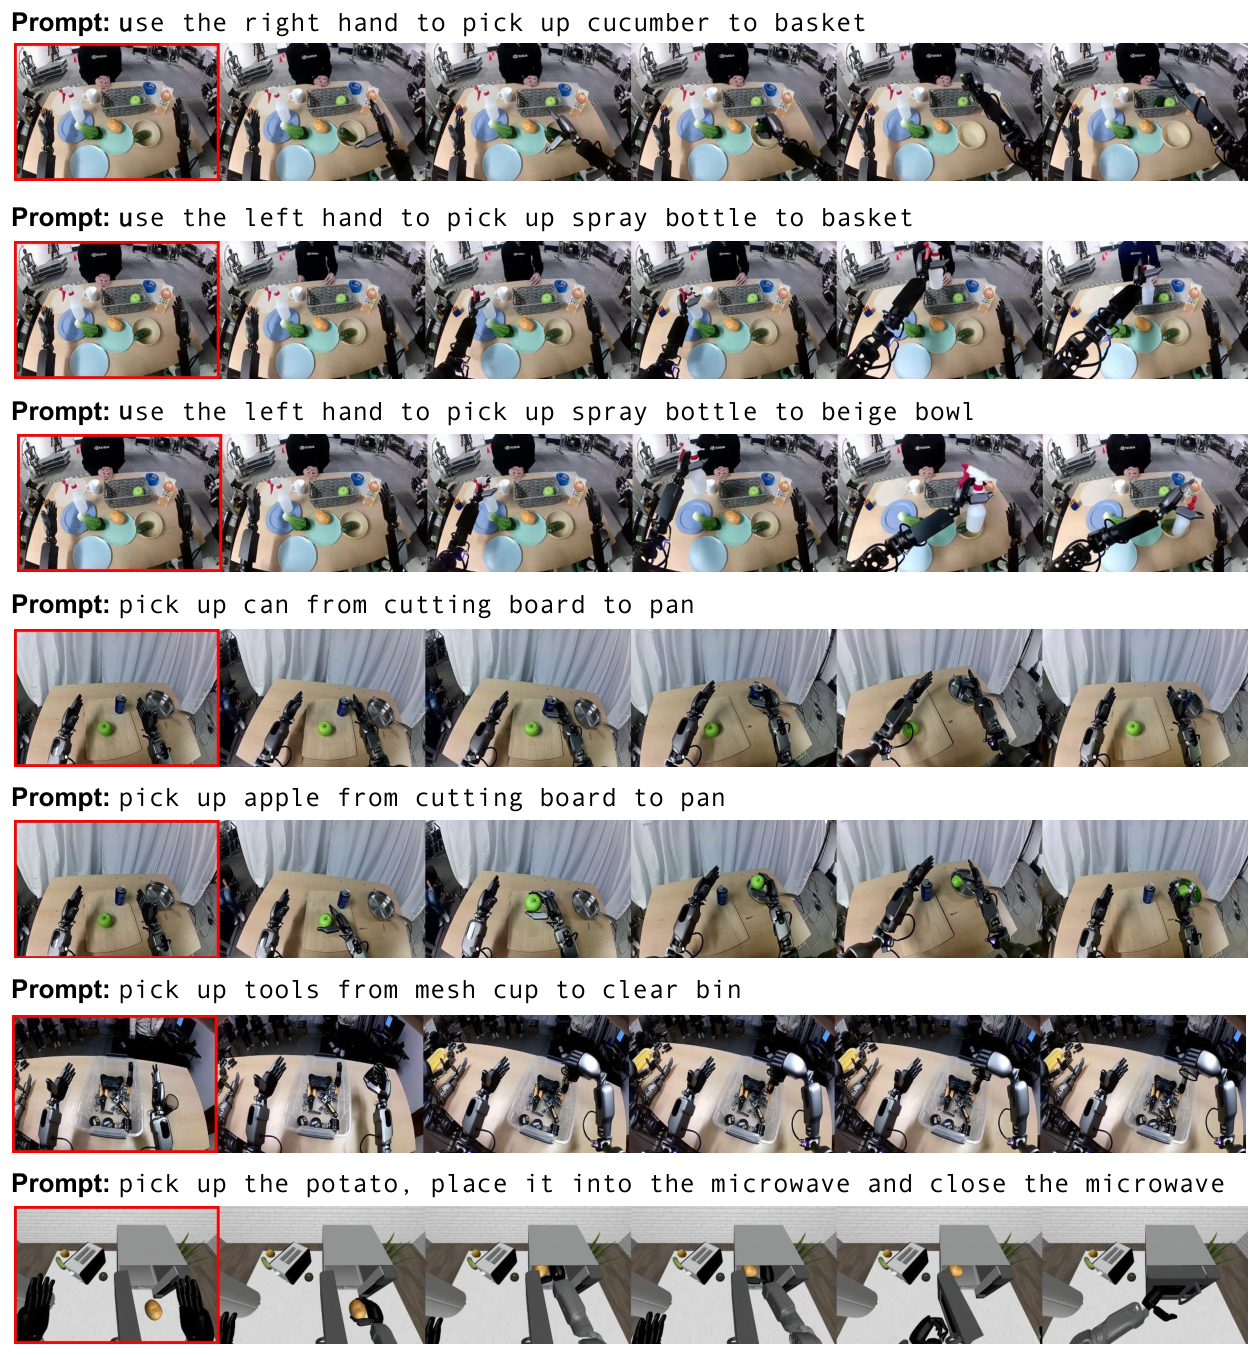
著者らは、88.4 時間の内部テレオペレーションを 827.3 時間の生成動画へと、ほぼ 10 倍に拡張しています。生成では、物体を物理的に不可能な動きで移動させたり、接触を歪めたり、ロボットを変形させたりすることがあるため、潜在アクションや IDM による教師付けの前に、言語モデルとルールベースのフィルタで低品質サンプルを除去します。
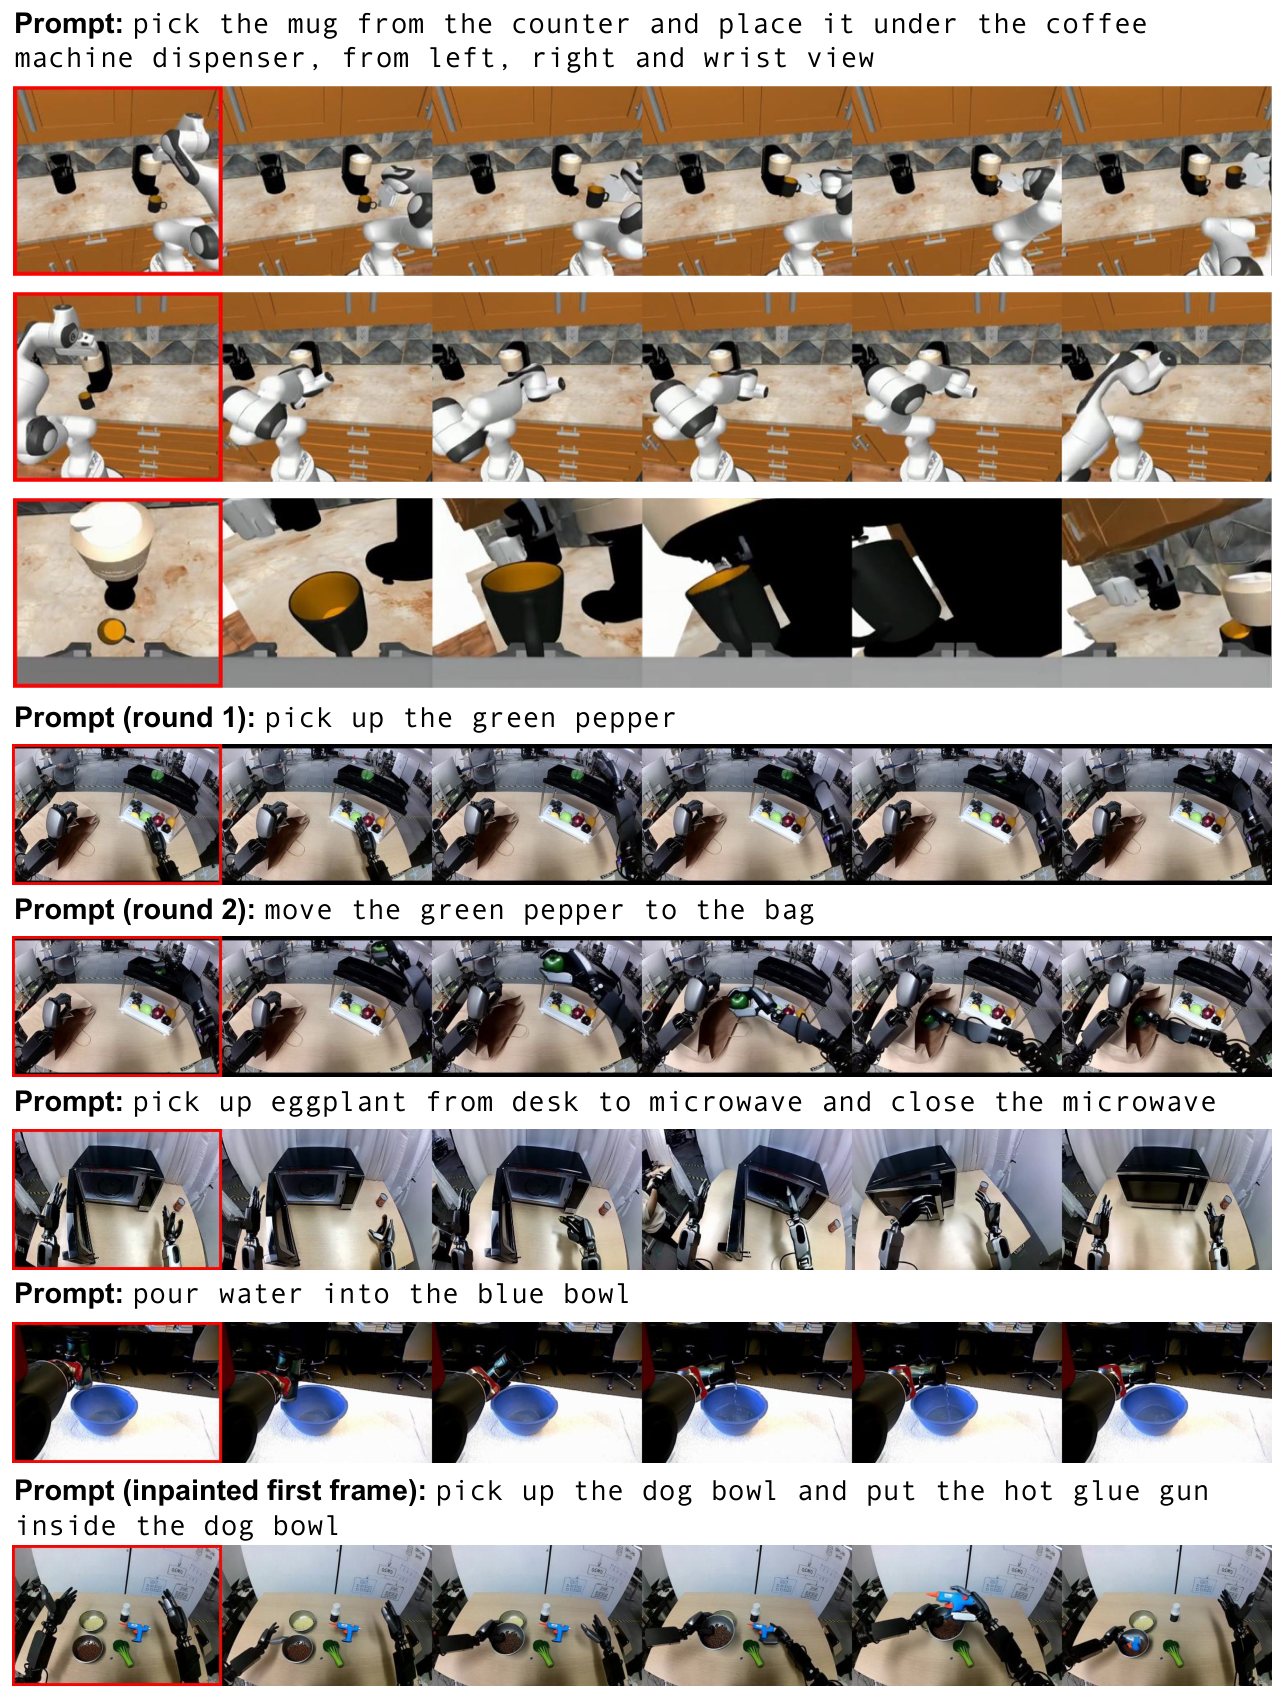
一方シミュレーションは物理エンジン内で実行されます。DexMimicGen のような手法は、物体中心のデモを新しいシーンへリターゲットし、約 78 万本、約 6,500 時間分のシミュレーショントラジェクトリを生成します。
違い:
-
ニューラルトラジェクトリは視覚的・意味的多様性を提供しますが、物理的な信頼性は限定的です。
-
シミュレーションは正確なアクションと物理相互作用を提供しますが、シミュレーションと実機のギャップは残ります。
事前学習とポストトレーニング
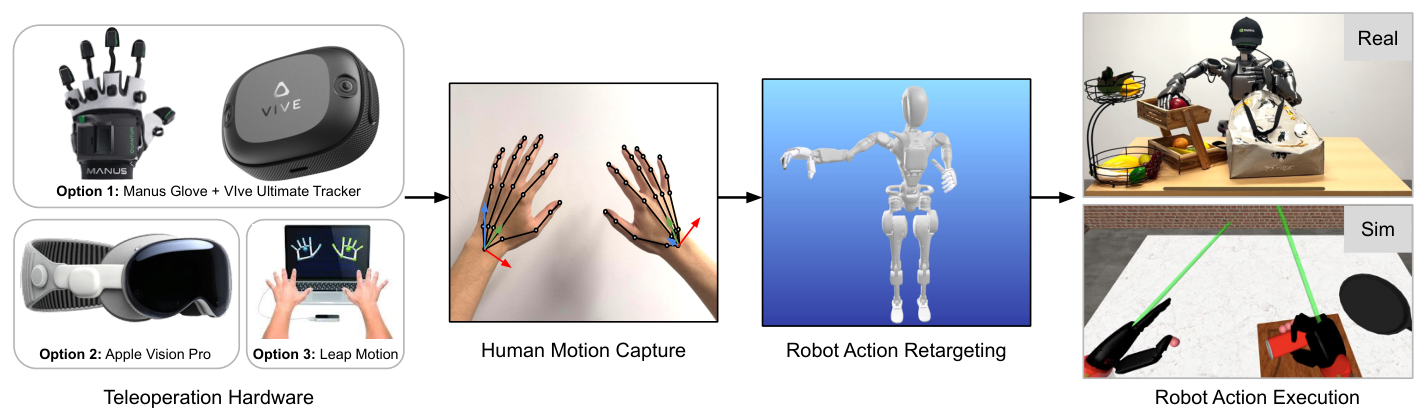
テレオペレーションデータは Manus、VIVE、Apple Vision Pro、Leap Motion などのデバイスから取得され、ロボットへリターゲットされます。
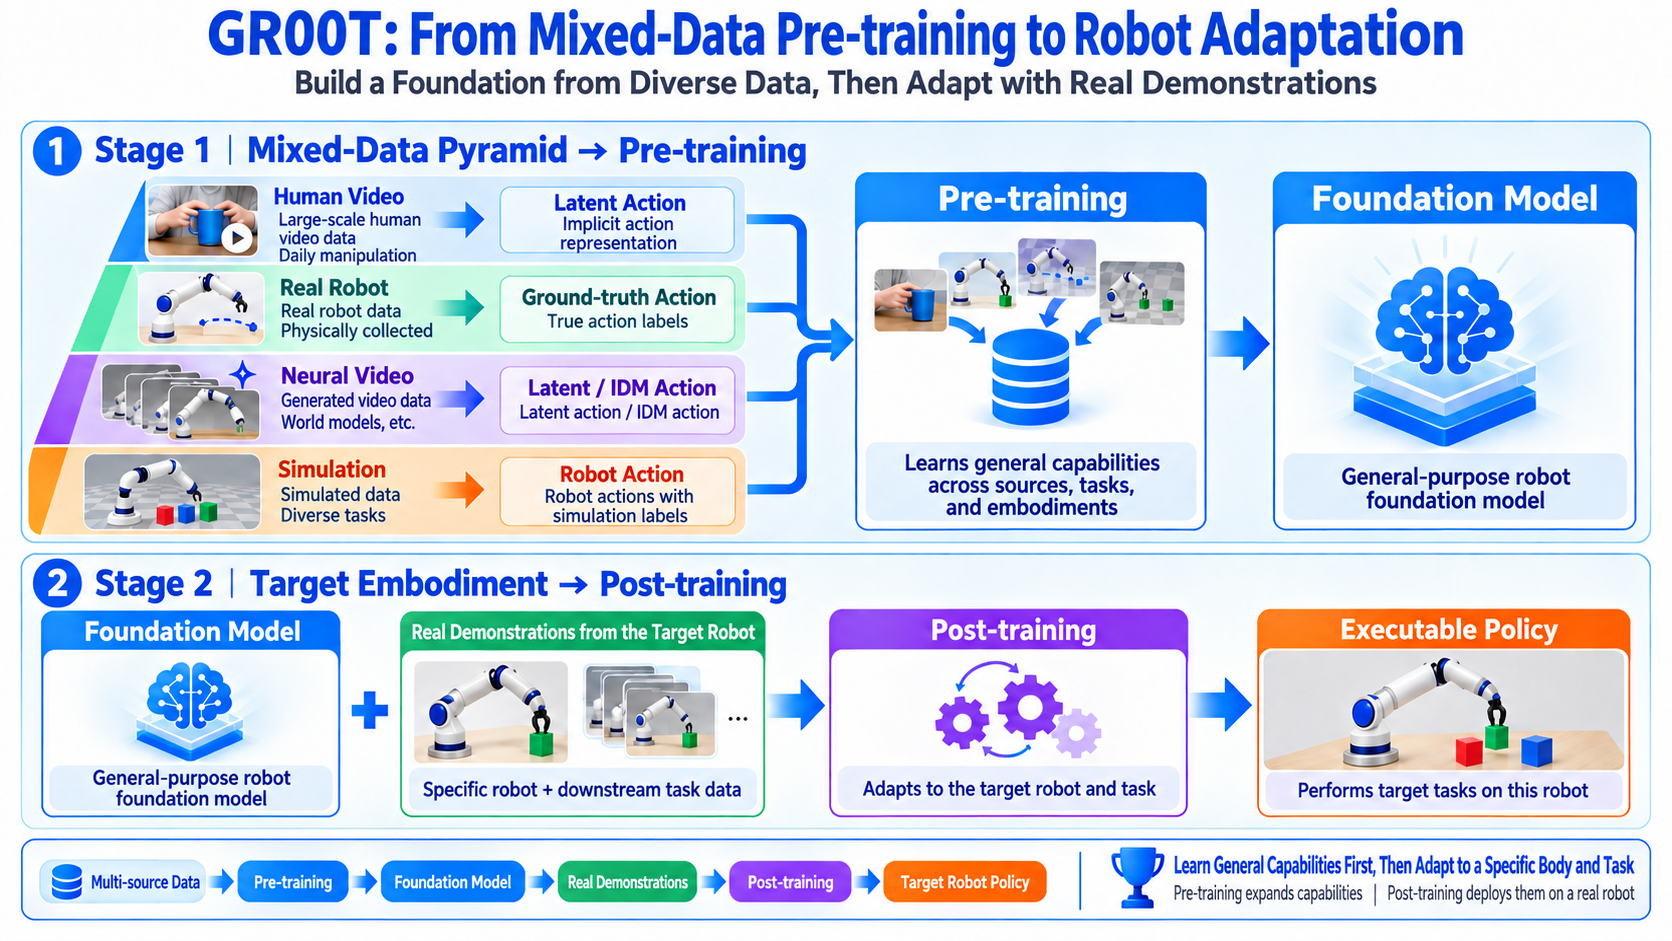
ポストトレーニングは、ゼロからの学習でも、任意のロボットを即座にゼロショット制御することでもありません。基盤モデルを、対象のカメラ構成・状態・アクションインターフェース・タスクに適応させるプロセスです。
| 設定 | 事前学習 | ポストトレーニング |
|---|---|---|
| バッチサイズ | 16,384 | 128 または 1,024 |
| 勾配ステップ数 | 200,000 | 20,000-60,000 |
| 主なデータ | 複数のエンボディメント | 1 つのエンボディメント / タスク |
| 目的 | 一般的な事前知識 | 特定のボディとタスクへの適応 |
GR00T-N1-2B の事前学習には、約 50,000 H100 GPU 時間が使用されています。データセットは合計 8,375.7 時間、5 億 9,290 万フレームです。
一文で言うと: 事前学習は多様な世界と身体の経験を与え、ポストトレーニングはこの特定のロボットの使い方をモデルに教えます。
実験と結果
効果はどのように検証されるか?
シミュレーションと実機テストでは、学習タスクへの単なる当てはまりではなく、事前学習による事前知識と、限られたデータでの適応が検証されます。
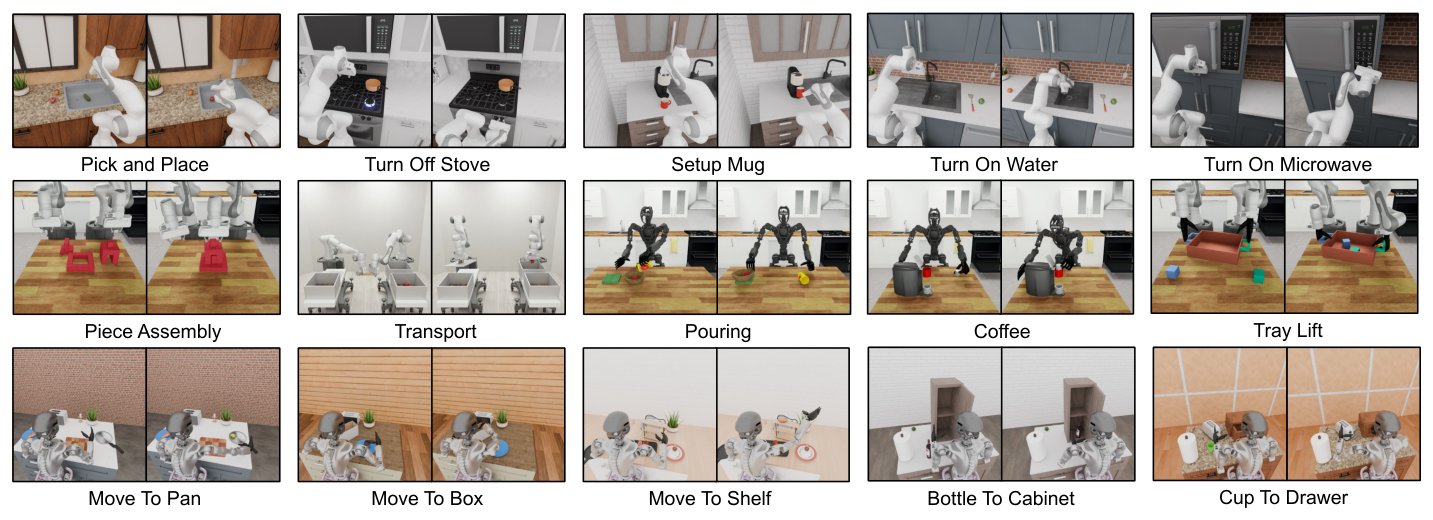
シミュレーションベンチマークには次が含まれます:
-
RoboCasa Kitchen: 24 個のキッチンタスク。
-
DexMimicGen Cross-Embodiment Suite: 9 個のクロスロボット操作タスク。
-
GR-1 Tabletop: 24 個のヒューマノイド卓上タスク。
実機 GR-1 テストには、ピックアンドプレース、可動物体、産業用マニピュレーション、マルチロボット協調が含まれます。
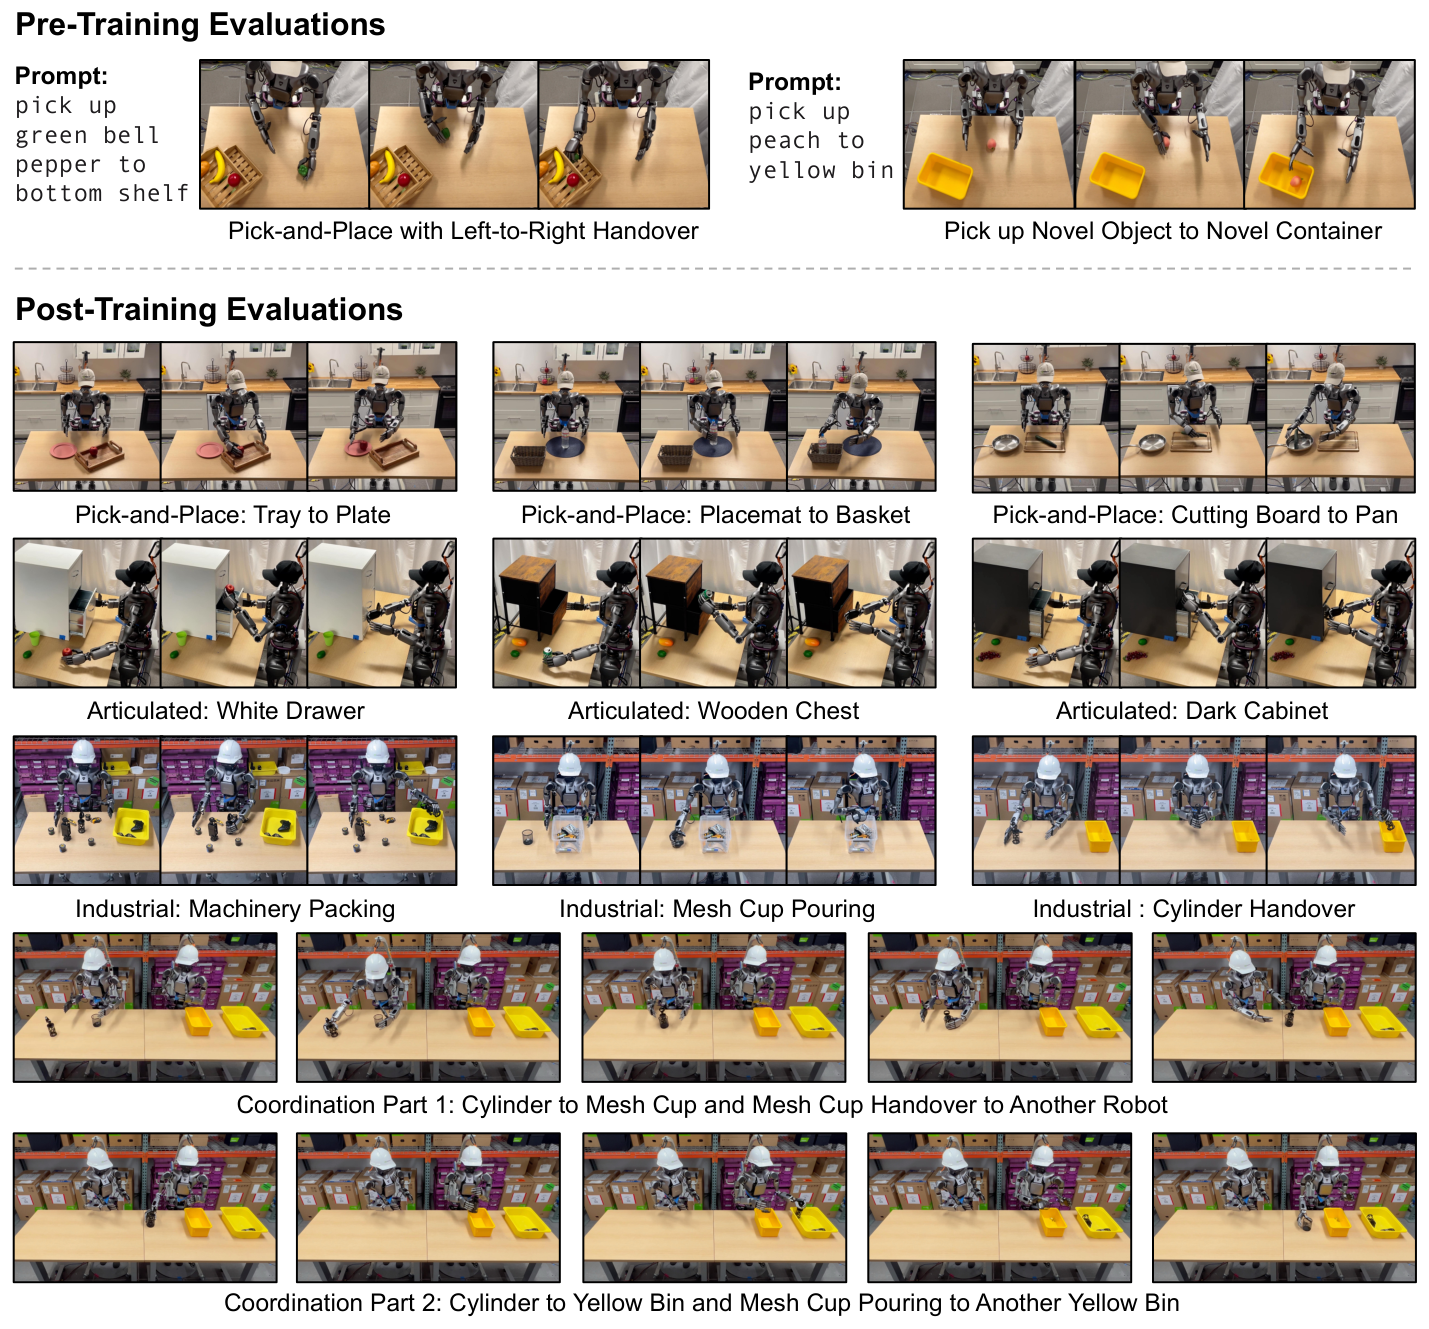
主な比較対象は BC-Transformer と Diffusion Policy です。GR00T N1 は、サイズやアーキテクチャだけでなく、異種エンボディメントをまたぐ事前学習という点でも異なるため、結果にはデータと学習手法の影響も反映されています。
少ないデータでも事前知識は役立つか?
シミュレーションでのポストトレーニングでは、タスクごとに 30、100、300 デモを使用します。主な傾向は次の通りです:
-
タスクデータが少ないほど、事前知識の効果が大きくなります。
-
データが増えると、専用の Diffusion Policy が差を縮めますが、GR00T N1 は依然として高いデータ効率を保ちます。
-
設定によっては、タスクデータのおよそ 10% で、全データで学習した Diffusion Policy に近づく場合もあります。
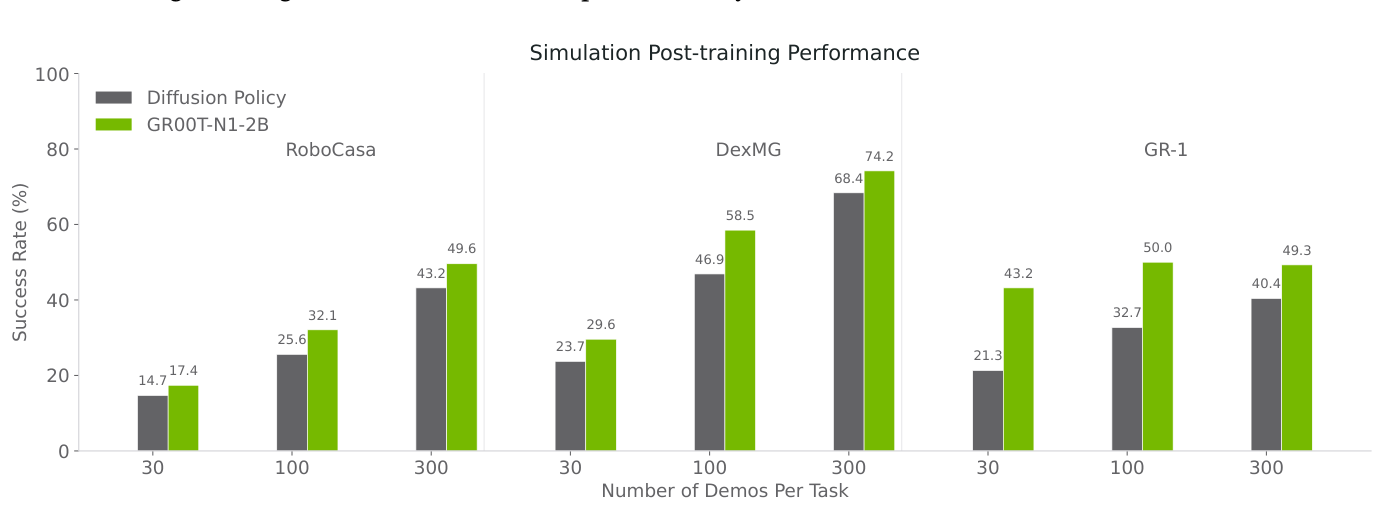
実務的な含意は次の通りです:
基盤モデルの価値は、データが全く不要になることではなく、手元のデータが限られているときに、事前学習済みの初期状態から効果的に学習できることにあります。
ニューラルトラジェクトリは実機挙動を改善するか?
アブレーションでは、実データのみ、潜在アクションでラベル付けした生成動画、IDM 疑似アクション付き生成動画を比較します。
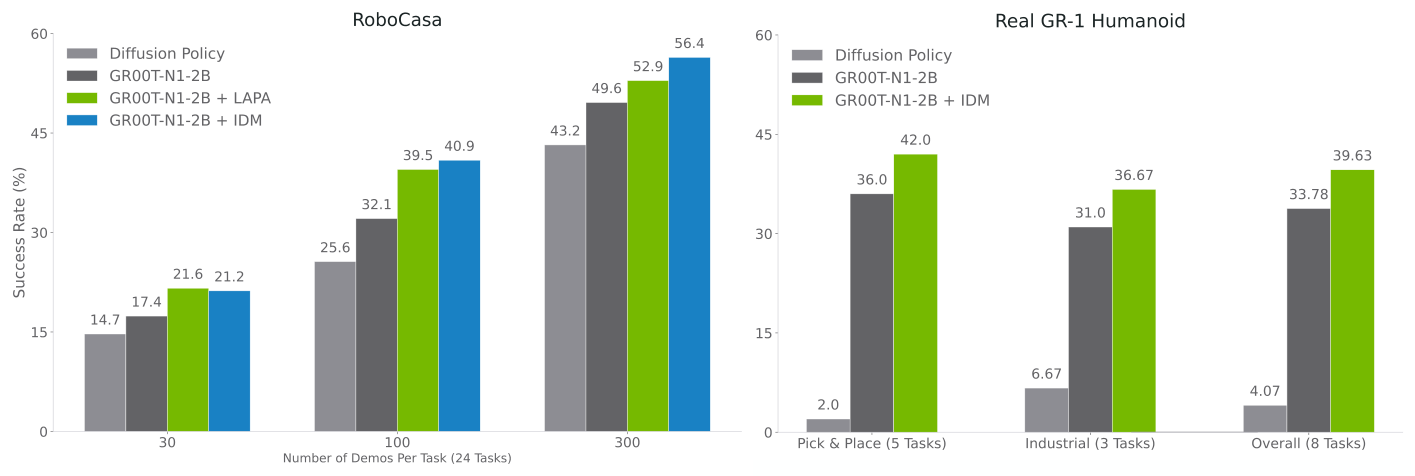
合成トラジェクトリは一部のタスクを改善し、IDM はしばしば潜在コードよりも実際のアクション空間に直接結びつきます。ただし、生成を増やせば自動的に良くなるわけではありません。物理的な誤りや疑似ラベルのバイアスも学習に入り込むためです。
著者らはまた、事前学習済みモデルで自発的な左手から右手へのハンドオーバーが観察される一方で、狭いタスクへのポストトレーニング後にはそれが失われる場合があることも報告しています。
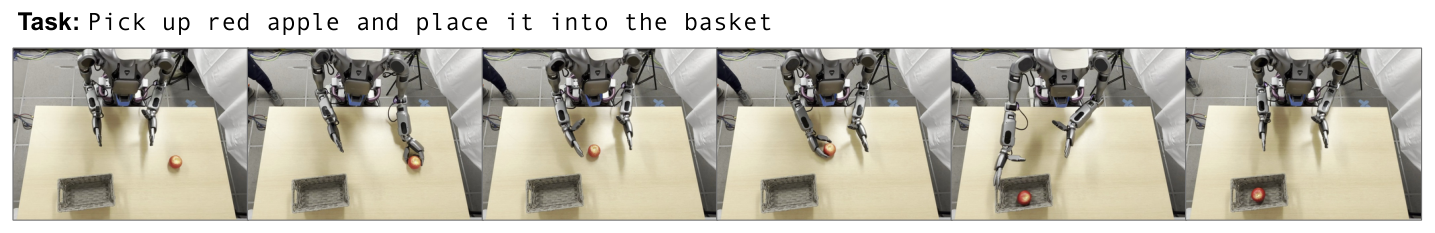
これは 破滅的忘却 (catastrophic forgetting) を示しています。焦点を絞ったファインチューニングは、対象タスクのスコアを上げる一方で、より広い事前学習済み能力を上書きしてしまうことがあります。
制約、実務的含意、およびまとめ
まだ解決されていないことは?
-
主に短い卓上タスク。 長時間のナビゲーション、全身運動、複数ジョイントの同時計画は今後の課題です。
-
空間推論の制約。 物体を認識できても、正確な 3D 位置や接触、力の理解ができるとは限りません。
-
合成データにおける物理的不整合。 もっともらしく見える動画であっても、実行可能な動きであるとは限りません。
-
ポストトレーニング中の忘却。 適応は、対象タスクの成功だけでなく、汎化能力の保持についても評価されるべきです。
LeRobot 実務との接続
エンジニアリング付録では、LeRobot データセット形式を拡張しています。数値を保存するだけでは不十分であり、その意味を定義する必要があります。
| 内容 | 指定すべき情報 |
|---|---|
| 動画 | カメラ名、視点、解像度、フレームレート、時間整合。 |
| 状態 | 各次元が表す関節または姿勢。 |
| アクション | 絶対または増分ターゲット、関節またはエンドエフェクタ制御。 |
| 言語 | 各エピソードに対応する指示文。 |
| 回転 | 回転行列、オイラー角、クォータニオン、または 6D 表現。 |
modality.json はこれらのセマンティクスを追加し、モデルが「7 番目の数値の意味を理解しているか」を扱えるようにします。単に「ファイルを開けるかどうか」だけではありません。
ACT データセットを持つ読者にとって、追加で考慮すべき点は次の通りです:
| 段階 | ACT の実務 | 追加の foundation-VLA に関する考慮事項 |
|---|---|---|
| 収集 | カメラ・状態・アクションを整合させる。 | 安定した言語アノテーション。 |
| データ | 1 台のロボット内での一貫性。 | エンボディメントをまたいだ意味的一貫性。 |
| 学習 | デモからポリシーを学習。 | 基盤チェックポイントをポストトレーニング。 |
| 推論 | 画像 + 状態 → アクションチャンク | 画像 + 言語 + 状態 → アクションチャンク |
| 評価 | 実機での成功率 | 成功率、汎化、および事前学習済み能力の保持 |