LBM と MultiTask DiT:マルチタスク事前学習はロボットの学習にどう役立つか
マルチタスク巧緻操作のための Large Behavior Model を丁寧に検証する
- Diffusion Transformer
- マルチタスク事前学習
- データ効率
- 厳密な評価
複数タスクのデモンストレーションは、ロボットが新しいタスクをより少ないデータで学習し、環境変化に対処するのに役立つのでしょうか?この論文ではポリシーアーキテクチャを固定し、事前学習の利点を測定するために統制された実験を行います。
TRI LBM 論文は、diffusion 目的関数を用いたマルチタスク事前学習を研究しています。LeRobot MultiTask DiT はこの手法に着想を得たオープンソース実装であり、flow matching にも対応しています。Boston Dynamics Atlas ブログは全身制御への応用を説明しています。これらはプラットフォーム、データセット、学習レシピが異なるため、モデルサイズ、アクション空間、結果はそれぞれの情報源の文脈で解釈する必要があります。
前提知識:デモンストレーションからアクションチャンクへ
学習と推論
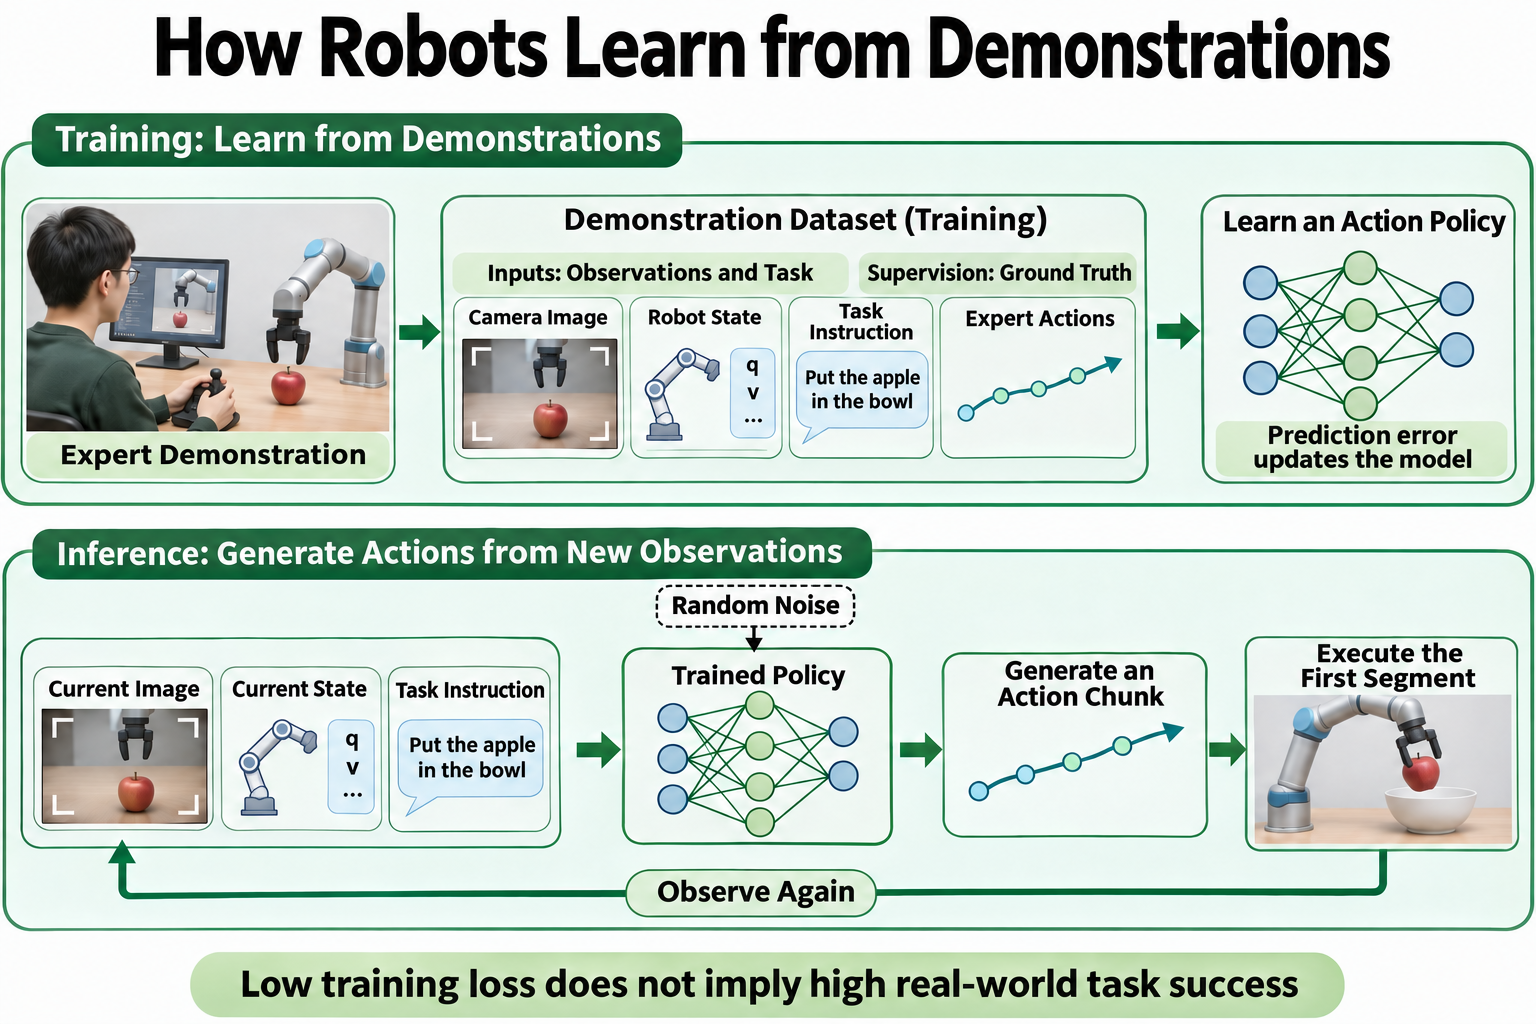
論文と LeRobot 実装に基づく説明図です。この例は学習ワークフローを説明します。
Behavior cloning は、専門家の行動を教師信号として用い、画像、固有感覚状態、タスク指示に条件付けされた行動を学習します。学習時には専門家の将来の行動が与えられ、推論時には観測と指示からアクションチャンクを生成します。
ここでの Large Behavior Model (LBM) は、マルチタスクのデモンストレーションで学習された視覚運動ポリシーです。Contrastive Language–Image Pre-training (CLIP) の画像エンコーダとテキストエンコーダが画像と指示を条件付け特徴に変換し、タスク言語によってアクション生成を誘導できるようにします。
アクションチャンクと生成モデル
アクションチャンクは複数の制御ステップをまとめて予測します。あるセグメントを実行した後、ポリシーは再度観測し、次のチャンクを予測します。デフォルトでは、LeRobot はアクションキューが空になったときに新しいチャンクを生成し、キューにあるセグメントをオープンループで実行します。これは ACT のオーバーラップした予測と時間的アンサンブルとは異なります。Action Window and Execution Segment を参照してください。
あるシーンには複数の妥当な軌道が存在し得ますが、その平均は不適切な場合があります。diffusion 生成モデルは軌道に対する条件付き分布を学習し、観測による条件付けの下でランダムノイズから行動を生成します。
diffusion 時間はノイズ除去の進行度を表し、ロボットの物理的な運動を表すものではありません。以下では、 は物理時間、 は離散的なノイズ除去ステップを表します。
要約:事前学習の価値
要約の概要
模倣学習は複雑な操作タスクを解くことができますが、大規模ロボットモデルの実際の利点を信頼性高く評価することは依然として難しい課題です。著者らは Diffusion Policy をマルチタスクデータに拡張し、シミュレーションではランダムシードを揃えた自動スコアリングで、実機ではポリシー順序をランダム化したブラインドテストで、単一タスクポリシーと比較します。
マルチタスク事前学習の後にファインチューニングを行うことで、新しいタスクに必要なデモンストレーション数を減らしつつ、成功率とロバスト性を向上できます。評価された設定の範囲内では、より大きく多様な事前学習データセットほど、一般的により大きな利点をもたらします。
コメント
- コアアーキテクチャを固定することで、事前学習の効果とモデルサイズの影響を切り分けやすくしています。
- データ効率に関する知見はタスク固有のファインチューニングに関するものであり、ゼロショット学習についてではありません。
- 初期条件、試行順序、スコアリングが統制され、結果に対して統計的な分析が行われています。
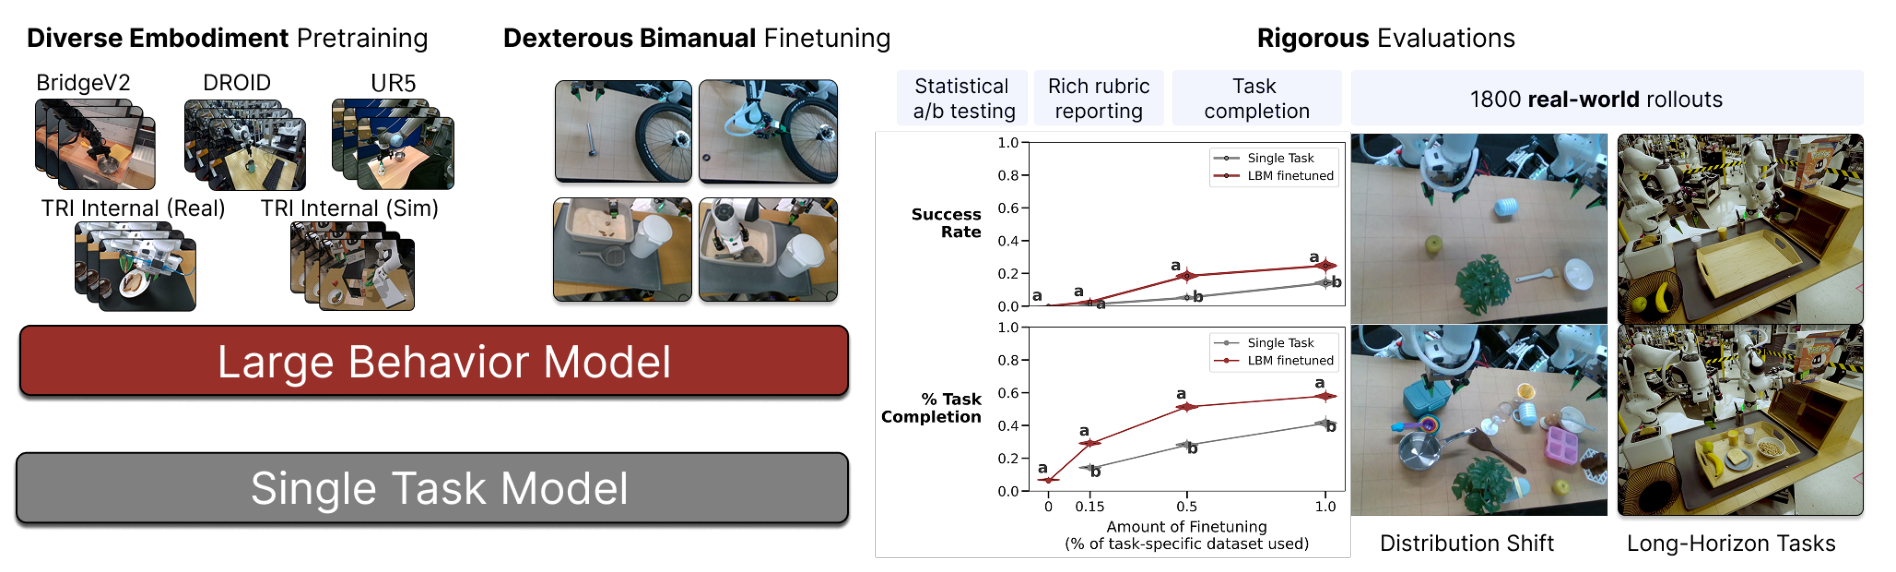
元の図 1(PDF 2 ページ)。左:事前学習とそれに続くファインチューニング vs 単一タスク学習。右:実機試行と統計的比較。
序論と関連研究
序論の 3 つの段落
第 1 段落:ハードウェア能力と自律性のギャップがデモンストレーションからの学習を動機付ける。ロボットハードウェアは多様な振る舞いを実現できますが、信頼できる自律性はしばしば単純なタスクや構造化された環境に限られます。Behavior cloning はタスク固有のプログラミングをデモンストレーションに置き換えます。接触の多い操作、変形物体、両手協調における進展は、汎用的な操作の研究を後押ししています。
第 2 段落:脆い単一タスクポリシーが事前学習に関する疑問を投げかける。単一タスクの Behavior cloning は、学習分布の外では苦戦します。LBM はマルチタスクのデモンストレーションを用いて経験を広げますが、観測される成功のどれだけがマルチタスク事前学習に由来するのかは依然として不明瞭です。この疑問が統制された評価を動機付けています。
第 3 段落:著者らは実験規模を定め、3 つの発見を述べる。モデルは約 1,700 時間分のデモンストレーションで学習され、シミュレーションと、およそ 1,800 回の統制された実機試行で評価されます。3 つの発見は次の通りです:同等の性能に到達するために必要なターゲットタスクのデモンストレーション数は、ファインチューニングの方が少なくて済むこと;ターゲットタスクデータ量が同じ場合、タスク全体で集約するとファインチューニング済みモデルの方が性能が高いこと;そして、展開時の条件が学習時と異なるほど、これらの利点が大きくなることです。以下のセクションでは、その証拠と適用範囲を検討します。
関連研究
| 分野 | 先行研究 | 本論文の焦点 |
|---|---|---|
| 汎用ロボットポリシーと VLA | マルチタスクデータ、事前学習済み表現、アクション生成によって能力を拡張 | 固定アーキテクチャで事前学習の利点を定量化 |
| 大規模ロボットデータセット | テレオペレーション、公開データセット、シミュレーション、ハンドヘルドデバイスによってデータを拡張 | 観測とアクションを標準化し、データ規模と多様性を研究 |
| ロボット評価 | シミュレーションベンチマーク、物理オブジェクトセット、遠隔ロボット、成功指標 | ブラインド試行、ランダム化された順序、シーンリセット、マイルストーンスコアリングでポリシーを比較 |
この論文は VLA アーキテクチャ間の体系的な比較を提供しておらず、DiT が常に VLA を上回ることを示しているわけではありません。
中核手法:条件付き Diffusion Transformer
アーキテクチャ
直感:画像は物体の位置を特定し、指示はタスクを指定し、固有感覚はロボットの現在の構成を記述します。ネットワークはこのコンテキストをエンコードし、ノイズの多いアクションチャンクをシーンに適した軌道へと反復的に洗練します。
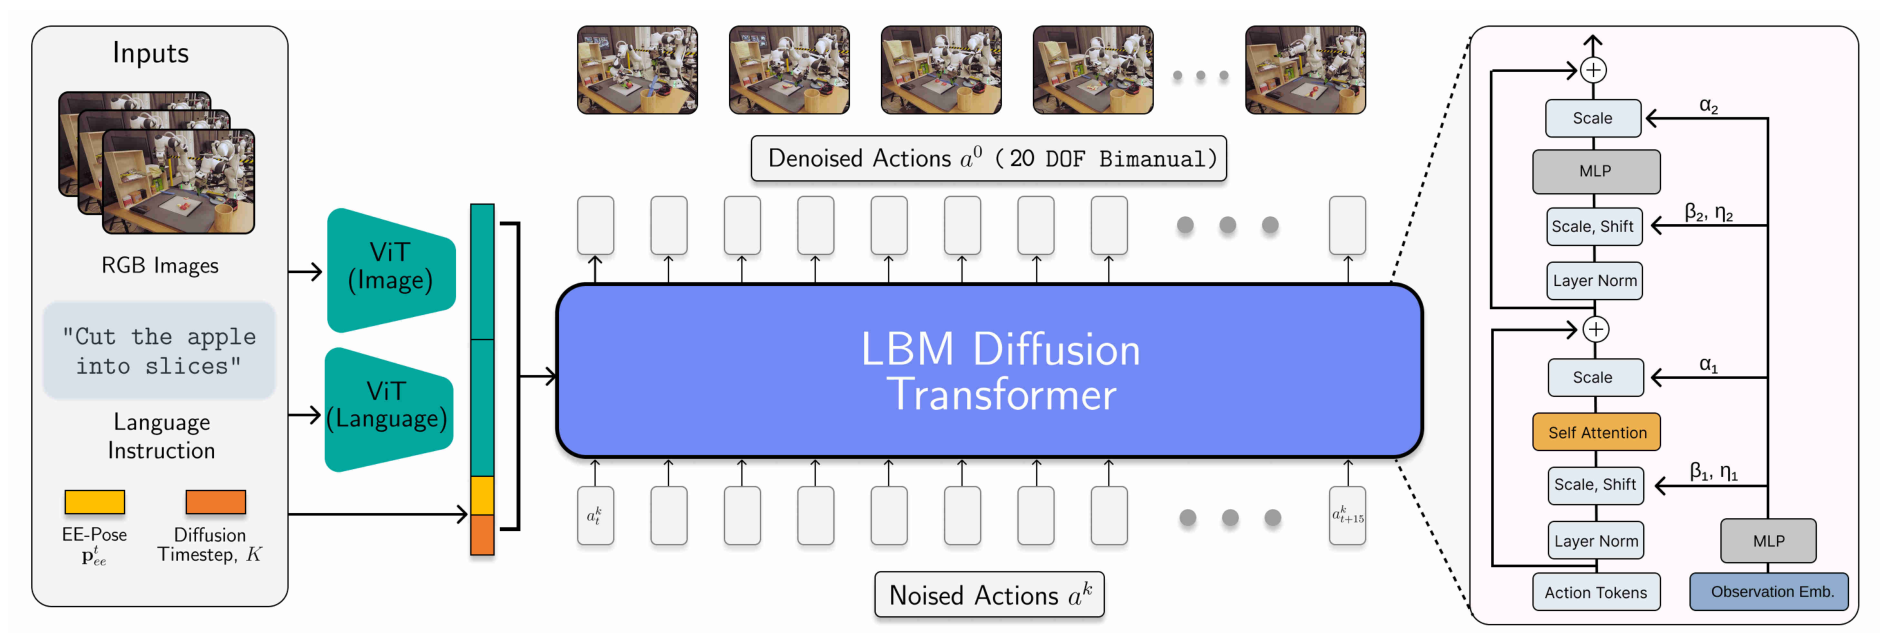
元の図 9(PDF 12 ページ)。左が観測エンコーディング、中央がアクションのノイズ除去、右が Transformer の条件付けモジュールです。
ビジョンエンコーダは各画像を分類用の CLS トークンで要約します。その重みは学習中に更新され、カメラ間で共有されます。テキストエンコーダは固定長の指示表現を生成します。バックボーンは凍結され、その後段の射影のみが学習されます。Diffusion Transformer (DiT) はアクション系列に沿って自己注意を適用し、チャンク全体のノイズを予測します。ここでのトークンは特徴単位であり、連続ベクトルである場合もあります。
観測とアクションの次元
この論文では、最大 6 つの RGB ビューを持つ 2 つの観測フレームを使用し、欠けているカメラはゼロ埋めします。固有感覚には、ベースに対するエンドエフェクタの姿勢と、もう一方のエンドエフェクタに対する姿勢、さらにグリッパ幅が含まれ、関節角ベクトルではありません。
アクション軌道は現在の観測に対して相対的に表現されます(論文のセクション IV-D1 および IV-D2)。各ハンドのアクションは 3 つの並進成分、6 次元の回転表現、1 つのグリッパー開口幅から構成されます。したがって両腕アクションの次元は次のようになります:
は 1 制御ステップあたりのアクション次元です。ネットワークは 16 ステップを出力し、 のサンプル(320 個の値)を生成します。6D 回転表現は回転行列の最初の 2 行を用いるものであり、6 つの回転関節を表すものではありません。これら 20 次元の出力は単一アームの関節コントローラを直接駆動することはできません。
論文では 2 フレームにわたって 6,732 個の観測特徴を連結し、隠れ次元 768 の DiT ブロックを 8 層用いています。LeRobot はカメラ数、状態次元、および設定からコンディショニング次元を計算します。
拡散トレーニング:ノイズ予測
をクリーンなアクションチャンク、 を視覚・言語・状態コンテキストとします。トレーニングではノイズレベル とガウスノイズ をサンプリングします。以下の標準的なdenoising diffusion probabilistic model (DDPM) の定式化は目的を説明するものです:ノイズレベルに応じてアクションにノイズを混合し、その加えたノイズを予測します。
ここで はチャンク長、 はアクション次元、 はノイズスケジュールにおける累積信号保持係数、 は DiT によるノイズ予測です。期待値はサンプル、ノイズ、デノイジングレベルにわたって取られます。論文の式 (2) はノイズ予測損失を与え、ノイズ付加を と書いています。ここでは、標準的な DDPM の定式化によって LeRobot の add_noise パスを説明しており、論文の式を項ごとに展開したものではありません。
説明用の例: 正規化されたアクション値が 、、ノイズが のとき、ノイズ付き入力は になります。ネットワークは と観測コンテキストを受け取り、ターゲットはノイズ です。このスカラー例は 1 要素を示したものであり、モデルはチャンク全体に対するノイズをまとめて予測します。
DiT による観測コンディショニングの利用方法
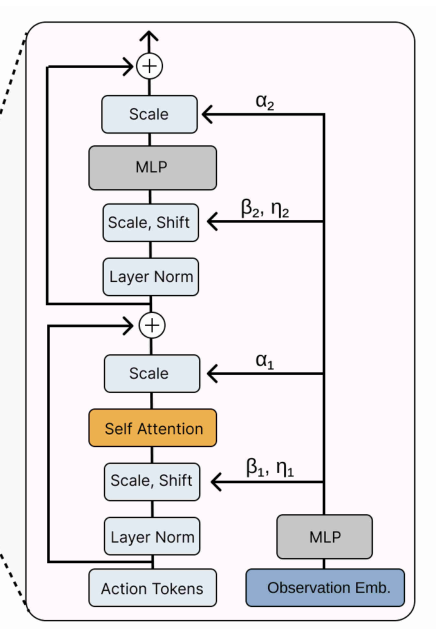
射影されたアクションベクトルは長さ のトークン列を形成します。自己注意は制御ステップ間を結びつけ、adaptive layer normalization (adaLN) はシーンとタスクから特徴ごとのスケールとシフトを生成することでアクション特徴を条件付けします。この変調は次のように書けます:
は隠れアクション特徴、 は視覚・テキスト・状態・デノイジングステップのコンディショニングを組み合わせたものを表します。 は layer normalization、 と は予測されたスケール調整とシフト、 は要素ごとの積を表します。これらのパラメータはアクション系列全体にブロードキャストされ、一方でアテンションがアクション間の関係をモデル化します。LeRobot はアテンションおよび multilayer perceptron (MLP) の残差分岐に対するゲートも予測します。
説明用の例: 正規化された特徴が 、スケール調整が 、シフトが の場合、 になります。条件が変われば異なるスケールとシフトが得られます。これらはロボットに直接送られるコマンドではなく、内部の特徴パラメータです。
アーキテクチャ: 符号化された観測は固定長のコンディショニングベクトルに連結され、adaLN を通じてアクション特徴を変調します。著者らの解釈: ファインチューニングなしで性能が一貫しないことは、小さな言語エンコーダによる言語ガイダンスの弱さを部分的に反映している可能性があります。論文ではコンディショニングの圧縮をアブレーションで切り分けておらず、圧縮そのものが言語能力を制限しているとまでは示していません。 元の図 9(PDF 12 ページ)の右側の詳細。コンディショニング埋め込みがアテンションおよび MLP 分岐のスケール、シフト、ゲートを生成します。図 9:コンディショニングモジュールの拡大図
推論:デノイジングと実行
推論時には、ポリシーが現在の観測をエンコードし、同じ DiT を繰り返し適用してランダムなアクションチャンクをデノイズします。論文では denoising diffusion implicit model (DDIM) サンプリングを使用しており、学習済みノイズ予測器がチャンクを反復的に更新します。選択したプレフィックスを実行した後、ポリシーは新しい観測から別のチャンクを生成します。
制御周波数、チャンク長、サンプリングステップは別物です。 論文では 16 ステップのアクションを生成し、そのうち 8 ステップを実行した後に再計画します。1 つのチャンクを生成するには複数回の DiT 評価が必要です。報告されている 10 Hz のポリシーループは、1 秒あたり 10 個の新しいチャンクを生成することや、他のハードウェアでのレイテンシを保証するものではありません。
トレーニング:事前学習とファインチューニング
ロボットとデモデータ
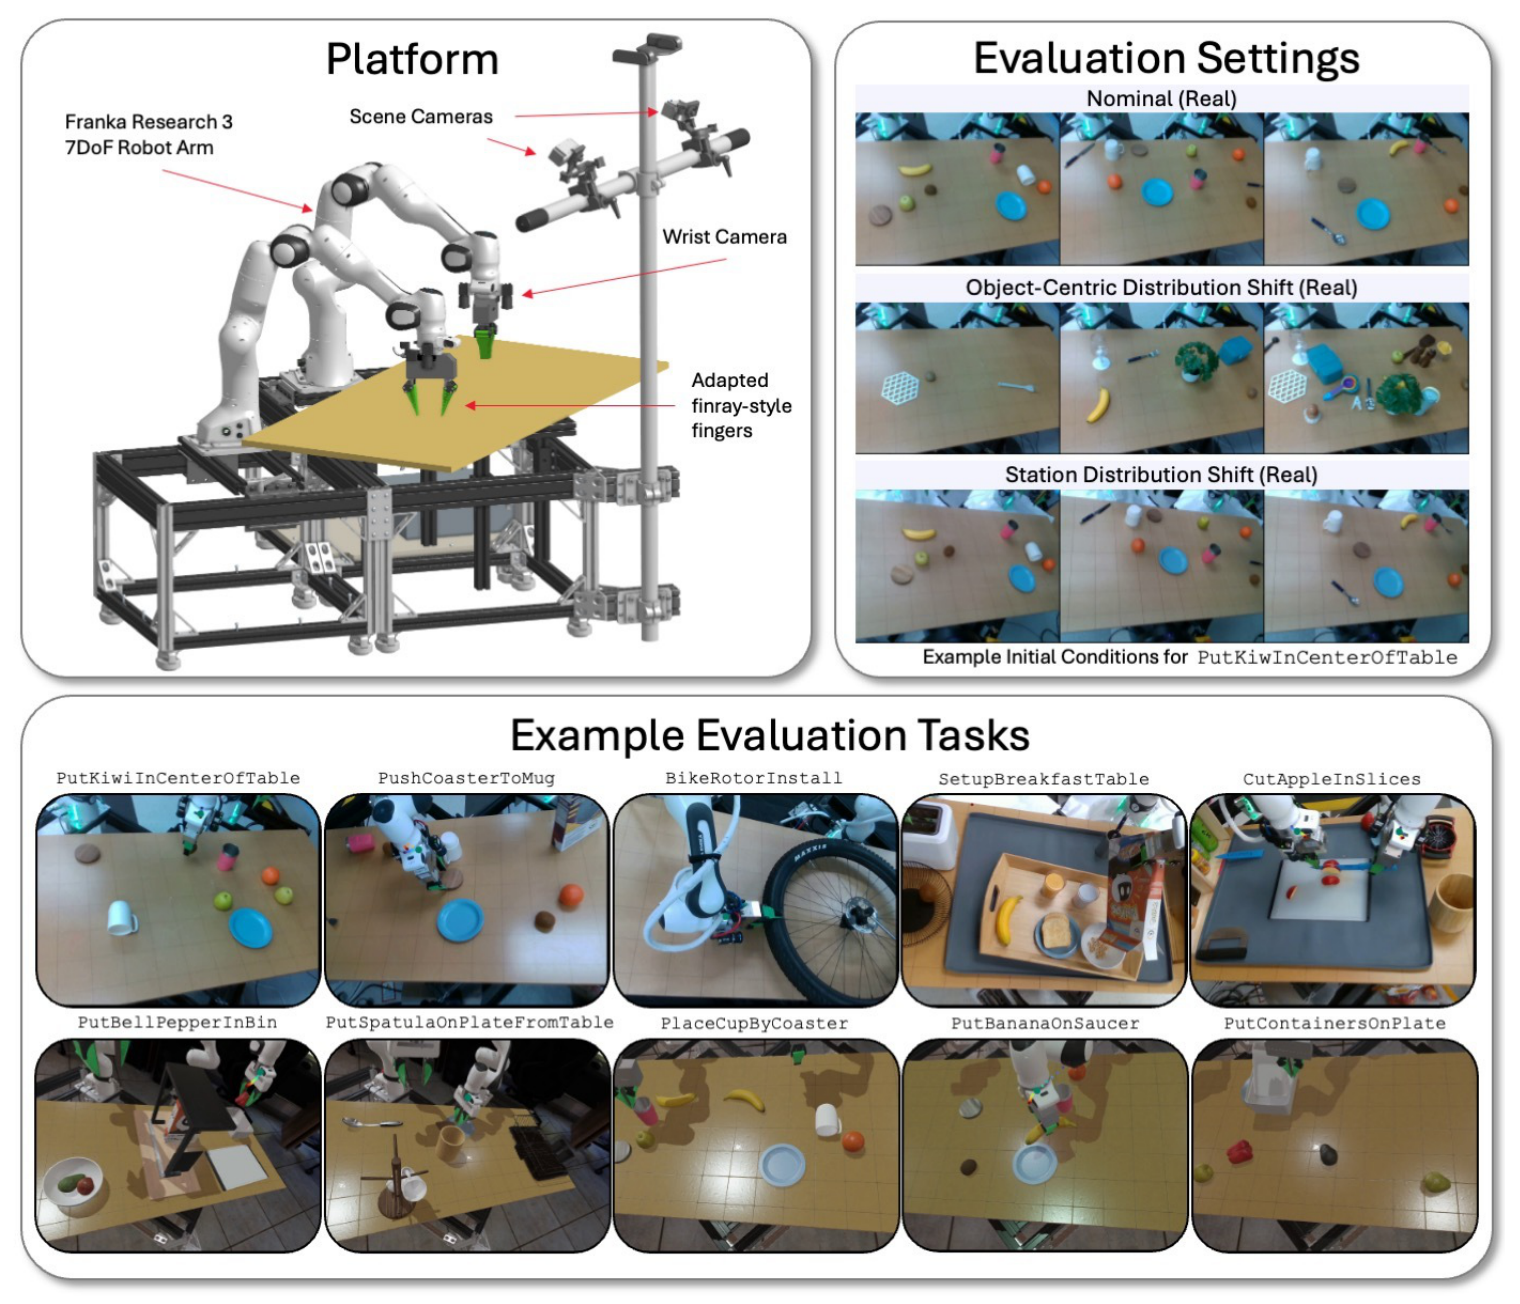
元の図 10(PDF 14 ページ)。左上:アームとカメラ。右上:環境の変化。下:配置およびマルチステップの巧緻マニピュレーションタスク。
論文では、平行グリッパーとカスタムのフィンレイ型フィンガーを備えた 2 台の Franka FR3 アームを使用します。新しいプラットフォームには 2 台のシーンカメラと各手首あたり 2 台のカメラがあり、合計 6 つの RGB ビューを提供します。データはハードウェア世代をまたいでおり、実世界での評価には新しいプラットフォームが用いられます。微分逆運動学と関節インピーダンス制御によりエンドエフェクタの目標を追従し、衝突回避は下位レベルのコントローラが処理します。エンドツーエンド学習であっても、これらの実行インターフェースに依存しています。
| データソース | 報告スケール | 役割 |
|---|---|---|
| TRI-Ramen-Real | 468 時間;362 タスク;46,063 デモ | 内部の実世界両腕ロボットデータ |
| TRI-Ramen-Sim | 45 時間;41 タスク;7,348 デモ | 実機プラットフォームに対応するシミュレーションデータ |
| TRI-Ramen-UMI | 32 時間;129 タスク;10,851 デモ | ハンドヘルドデバイスで研究室外で収集されたマニピュレーション |
| OXE-Ramen | 約 1,150 時間 | 公開 Open X-Embodiment データのキュレートされた標準化サブセット |
最初の 3 つのソースは合計で約 545 時間、532 タスク、64,262 デモになります。OXE-Ramen を含めると約 1,695 時間になります。532 タスクという数は内部で収集されたデータのみを対象としています。
データの整合と正規化
データソース間で座標系、姿勢単位、グリッパー開口幅、画像処理を一貫させる必要があります。論文では、片腕データを欠損しているアームをゼロ埋めし、左右をランダムに入れ替えることで両腕フォーマットに変換します。重み付きサンプリングにより、大規模なソースがバッチを支配しないようにします。
より遠い将来のアクションは、一般により広い範囲にまたがります。論文では特徴次元、相対タイムステップ、データソースごとに分位点を個別に計算します。2〜98 パーセンタイルの区間を に写像し、 にクリップします。6D 回転表現はこのスケーリングから除外されます。
LeRobot との違い: ピン留めされたバージョンは、状態とアクションに対してはデフォルトで MIN_MAX、画像に対しては MEAN_STD を用います。論文のソース別・タイムステップ別の分位点正規化を自動的に再現することはありません。このような前処理の違いも結果に影響します。
トレーニング設定
| ステージ | 初期化とデータ | 学習率 | グローバルバッチサイズ | トレーニングステップ数 |
|---|---|---|---|---|
| マルチタスク事前学習 | 全データ混合;CLIP で事前学習されたビジョンおよびテキストエンコーダ | 3e-4 | 2,560 | 48,000 |
| 実世界タスクのファインチューニング | LBM の重みとターゲットタスクのデモ | 2e-5 | 320 | 30,000 |
| シミュレーションタスクのファインチューニング | LBM の重みとターゲットタスクのデモ | 2e-5 | 320 | 10,000 |
| 実世界単一タスクベースライン | ロボットのマルチタスク事前学習なし;同じ CLIP 初期化 | 2e-5 | 320 | 100,000 |
| シミュレーション単一タスクベースライン | 同じ初期化;ターゲットタスクのデモのみ | 2e-5 | 320 | 25,000 |
ビジョンエンコーダには、他の学習可能コンポーネントの 10 分の 1 の学習率が用いられます。トレーニング画像は 256×342(高さ × 幅)にリサイズされ、224×224 にランダムクロップされ、色変換が適用されます。推論時にはセンタークロップを使用します。
「from scratch」でのトレーニングとは、ロボットのマルチタスク事前学習なしを意味し、CLIP 初期化は保持されます。単一タスクベースラインにはターゲットタスクに対するより多くのトレーニングステップが与えられます。
評価手法
タスク分割とスコアリング
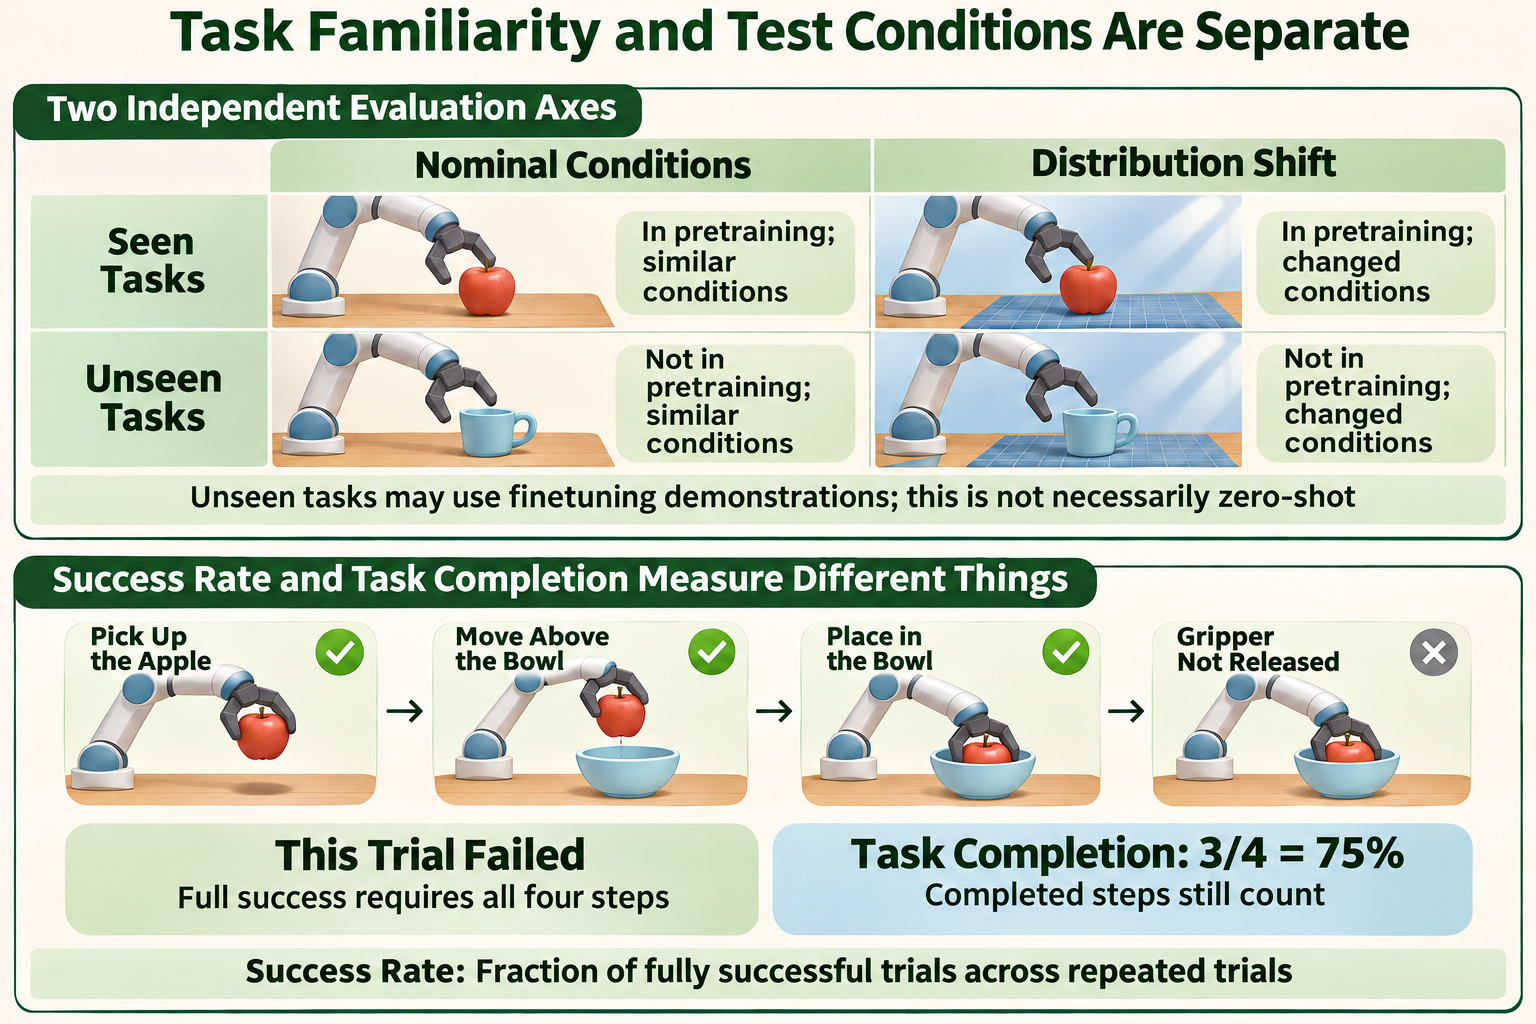
論文に基づく説明図。4 段階のリンゴ配置ルーブリックは指標を説明するためのものであり、評価されたタスクの記録ではありません。
上段のパネルは、既知/未知タスクと分布シフトを分けて示しています。未知タスクであっても、ファインチューニング用のデモが提供されている場合があります。分布シフトとは、ディストラクタ、物体の組み合わせ、ロボットステーションなどテスト条件の変化を指します。
下段のパネルでは 4 つのマイルストーンを用いて、成功率 (SR) と タスク完了度 (TC) を区別します。リンゴがボウルに到達したもののグリッパーがまだ離していない場合、4 つのマイルストーンのうち 3 つが完了していることになります:TC は 75% ですが、その試行は成功とはみなされません。これはスコアリングの説明用の例です。
は試行回数を表し、 は完全に成功した試行回数を表します。 はマイルストーンの数であり、 は試行 がマイルストーン を達成したかどうかを示します。
盲検化、ランダム化、およびリセット
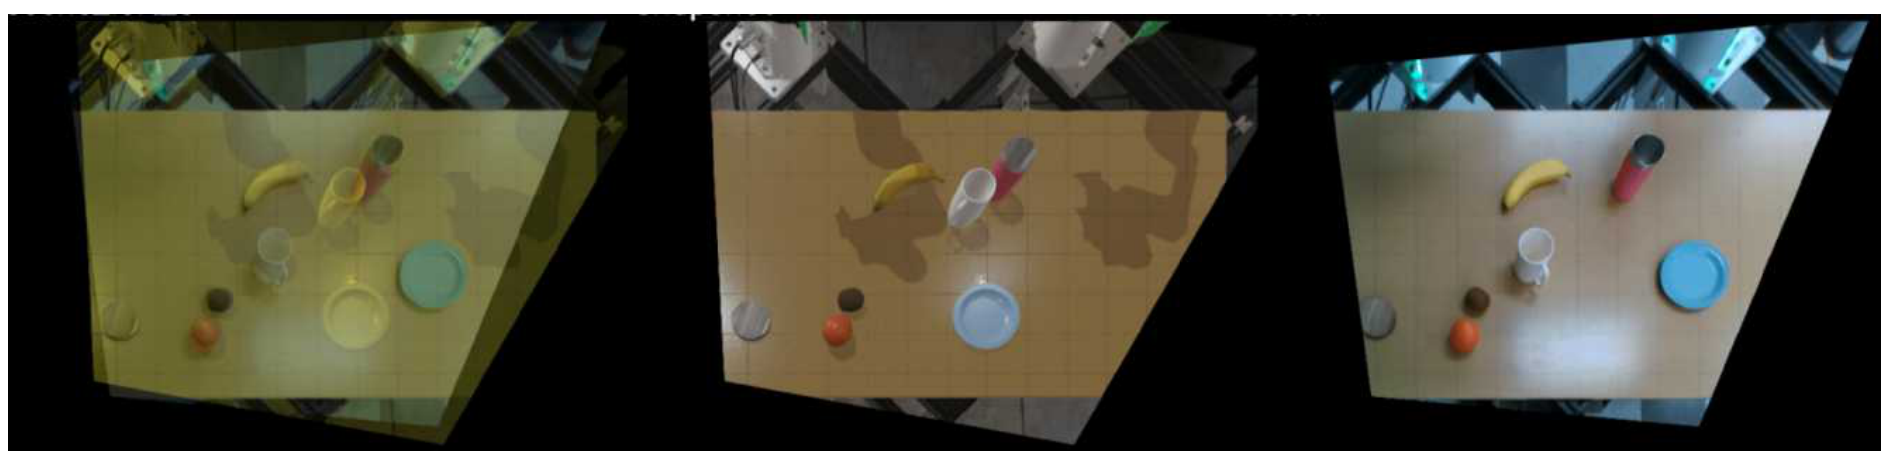
元の図 8(PDF 11 ページ)。左:ターゲットシーンと現在のシーンのオーバーレイがリセットを支援する。中央:ターゲットシーン。右:現在のシーン。
評価者はポリシーの識別情報に対して盲検化されています。ポリシーは一致した初期条件からランダムな順序で実行され、各ロールアウト後にリセットを行うことで、順序、照明、配置のバイアスを低減します。シミュレーションでは一致した乱数シードを使用し、実世界でのリセットには画像オーバーレイを用います。テストの初期状態は、個々の訓練デモンストレーションを単純に再生したものではありません。
実世界での評価には、既知タスク 3 個と未知タスク 5 個が含まれ、シミュレーションには既知タスク 16 個と未知タスク 8 個が含まれます。各タスク–ポリシー–条件の組み合わせは、実世界では 50 回、シミュレーションでは 200 回のロールアウトが予定されています。いくつかのシミュレーションの組み合わせは、欠損データのため 200 回未満となっています。解析は、およそ 1,800 回の実世界ロールアウトと 47,000 回超のシミュレーションロールアウトを対象としています。
バイオリンプロットと統計的比較
SR のバイオリンプロットは、成功/失敗の結果から推定された真の成功確率に対するベイズ事後分布を示します。個々のタスクの TC プロットは主に経験的な完了分布を示しますが、一部の集約プロットやデータ効率プロットは、代わりに平均完了度に対する事後分布を示します。これらは異なる量を表しています。
論文では、統計的比較を要約するためにCompact Letter Display (CLD) を使用しています。共通の文字を持たないグループ同士は有意に異なります。文字を共有している場合は、性能が等しいことを意味するのではなく、有意な差が検出されなかったことを意味します。文字はキャプション、統計検定、および比較範囲と合わせて解釈してください。
結果と制約
未知タスクにおける完了度
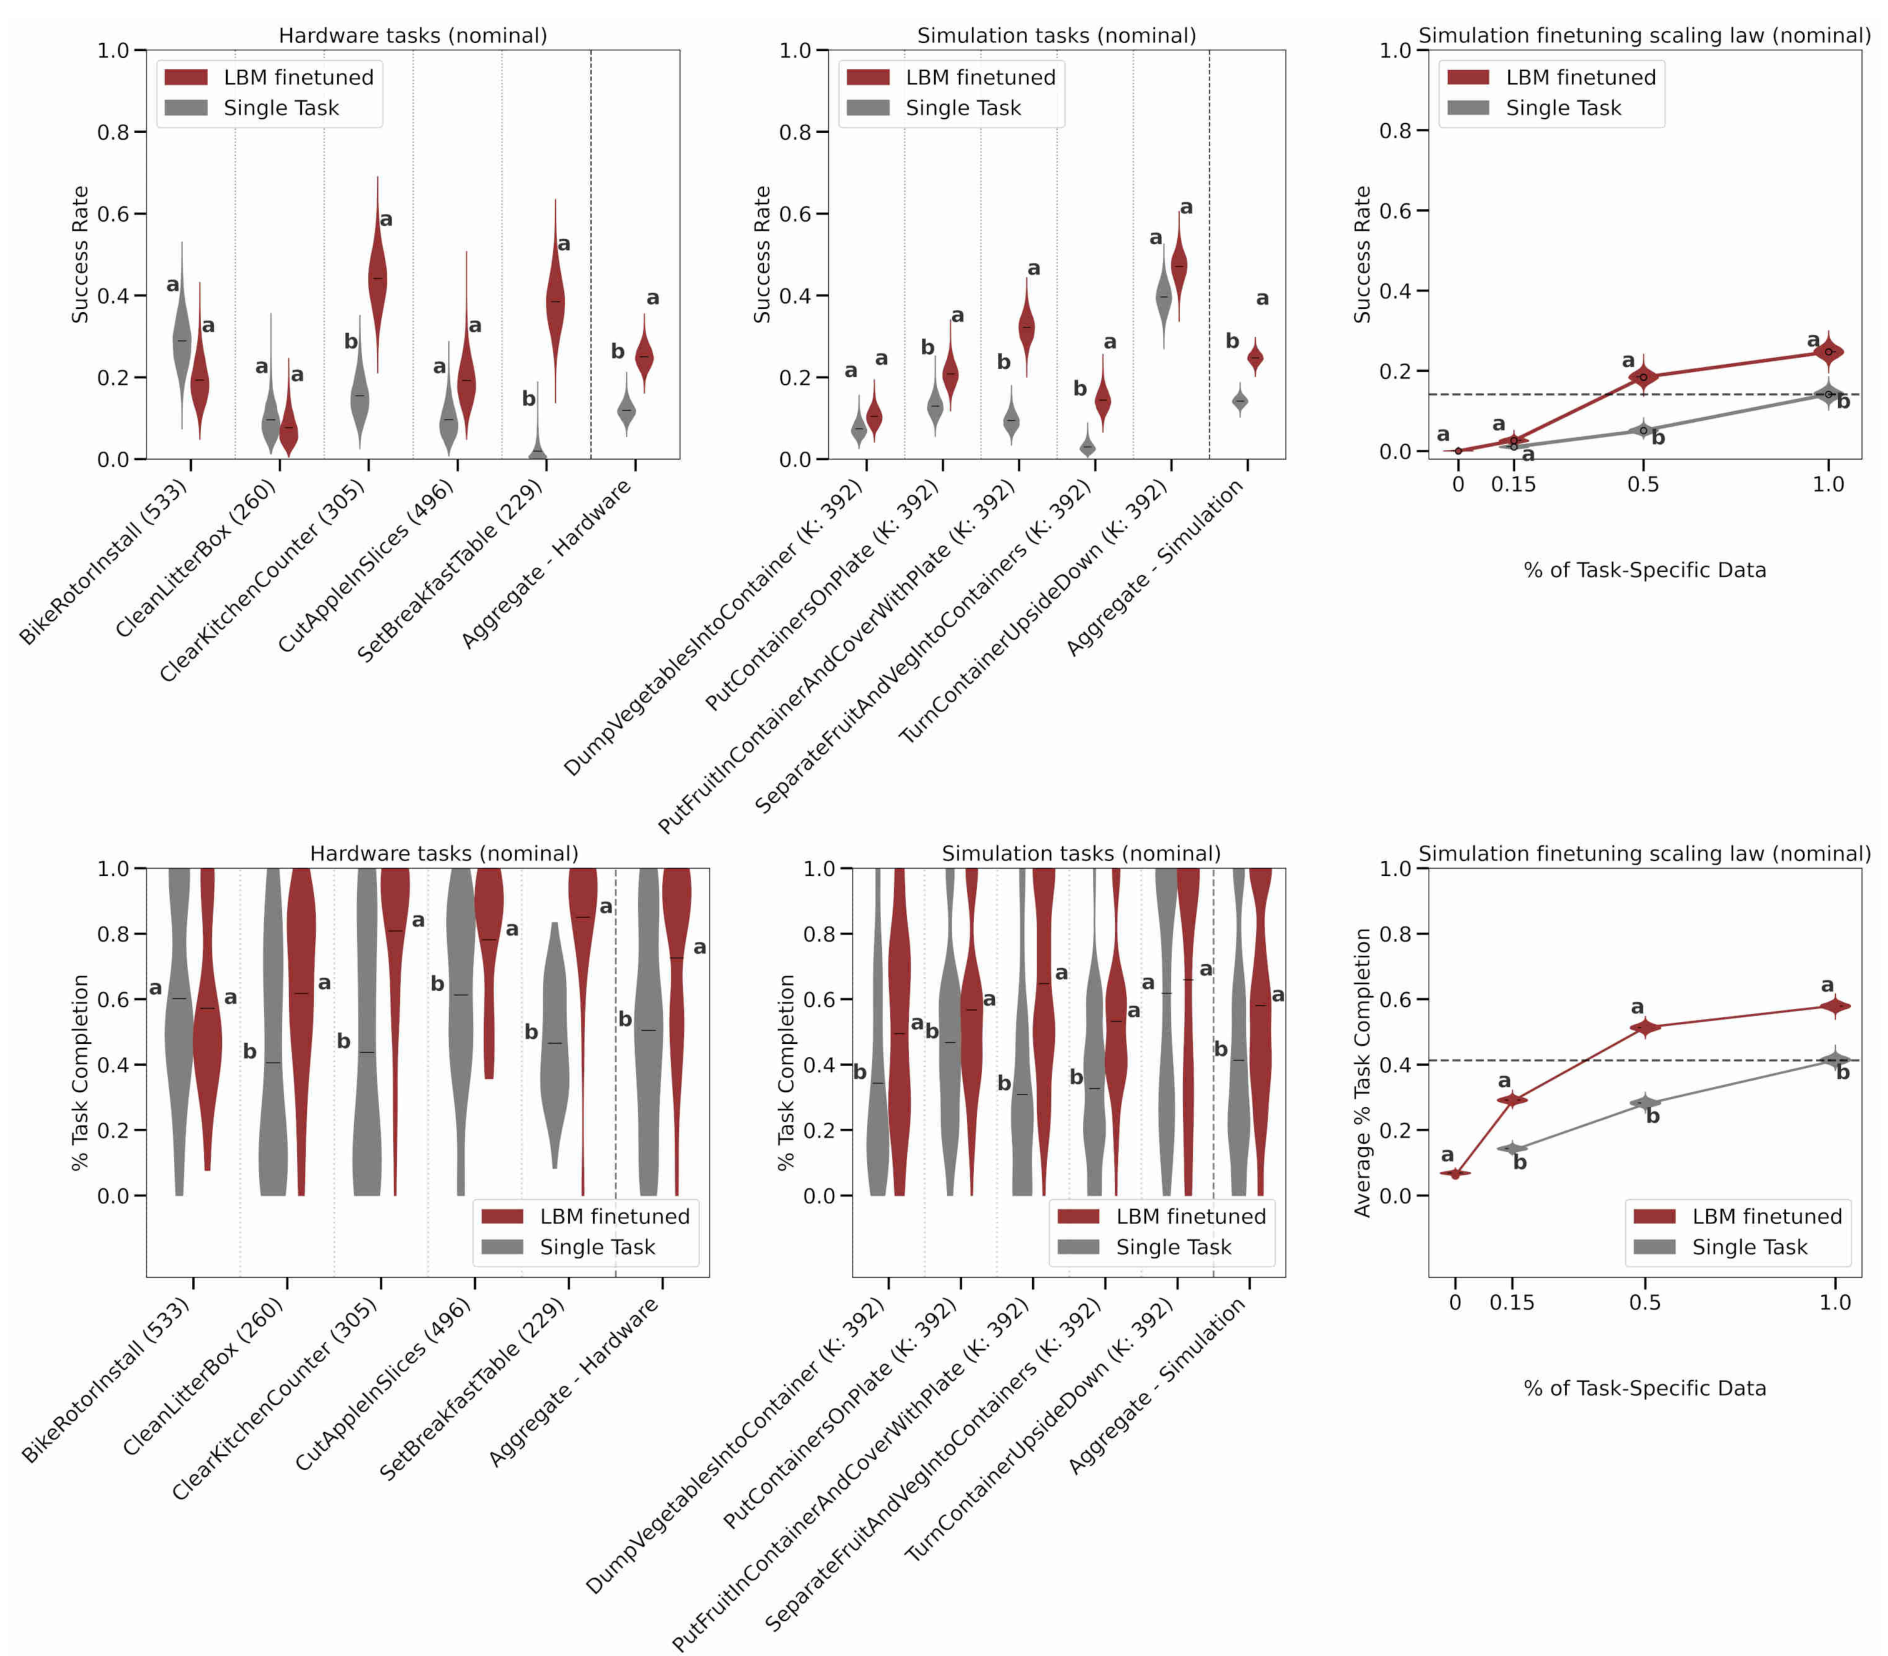
元の図 4(PDF 7 ページ)。標準条件下の未知タスク。上段:SR。下段:TC。列:実世界タスク、シミュレーションタスク、およびシミュレーションのデータ効率。赤:事前学習およびファインチューニング済み LBM。灰色:単一タスクベースライン。
複雑なタスクで完全成功を達成することは依然として困難ですが、ファインチューニングされた LBM は一般により多くのマイルストーンを達成します。複雑な未知の実世界タスク 5 個のうち、TC は 4 個で単一タスクベースラインより有意に高く、一方 SR が有意に高いのは 2 個のみです。
集約的な利得はより一貫していますが、個々の差の中には有意でないものやベースラインに有利なものもあります。ポリシーが開始時に不活性のままであったり、誤ったタスクを試みたりする場合があるため、個々の結果や失敗事例も重要です。
ロバスト性:テスト条件が変化しても利得は維持されるか?
シミュレーションにおける分布シフトは、主に見た目を変化させます:未知の環境ライティングマップ、異なる照明およびカメラパラメータ、変更された物体やテーブルのテクスチャや色などです。一部のシーンにはディストラクタも含まれます。著者らは、これらの変化の下で事前学習後にファインチューニングされた LBM と単一タスクベースラインを比較し、事前学習による利得が維持されるかどうかを検証します。
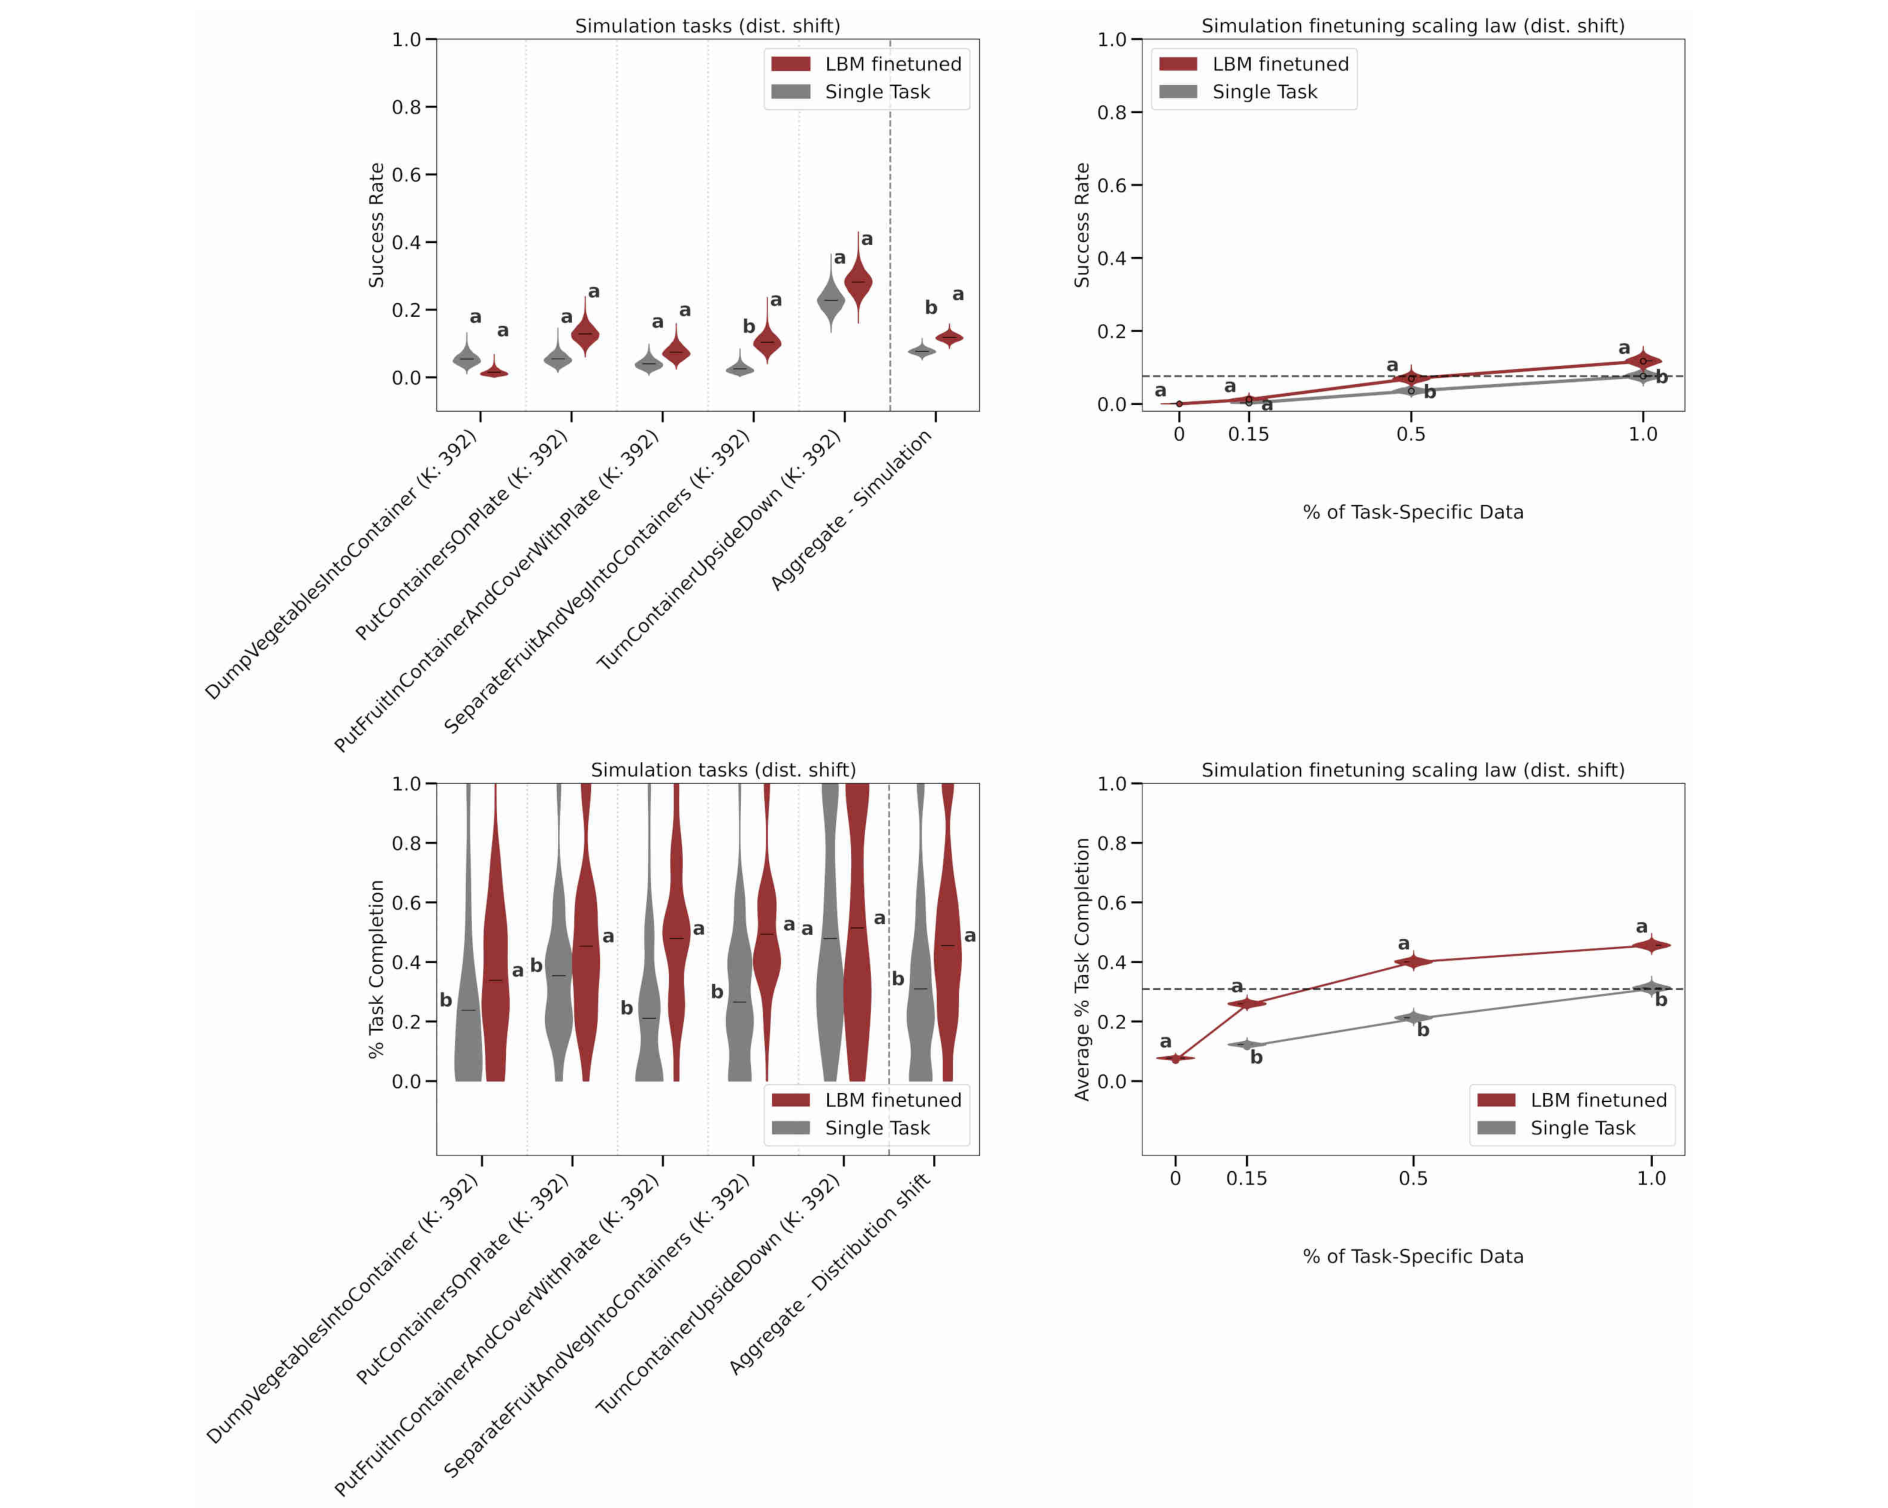
元の図 6(PDF 9 ページ)。上段:SR。下段:TC。左:個々のタスクと集約結果。右:ターゲットタスクデータの割合を変化させた場合。赤:事前学習およびファインチューニング済み LBM。灰色:単一タスクベースライン。図 4 のシミュレーションパネルと比較せよ。図 6 には実世界の結果は含まれていない。
分布シフト下の複雑な未知シミュレーションタスク 5 個では、TC は 4 個のタスクでベースラインより有意に高い一方、SR が有意に高いのは 1 個のみです。既知のシミュレーションタスクでは、標準条件下では 16 個中 3 個だった「SR が有意に高いタスク数」が、分布シフト下では 16 個中 10 個に増加し、集約した成功率の差も拡大します(セクション III-A および図 2)。
これらの結果は、テストされたシフトに対するファインチューニング済み LBM のロバスト性が高いことを支持していますが、多くのタスクでは変更後に絶対的な性能が低下していることも示しています。より多くのマイルストーンを達成しても、完全成功は依然としてまれである可能性があります。また、シミュレーションにおける見た目の変化は、実世界のステーションや物体の変化とは異なります。
新しいタスクにおけるデータ効率
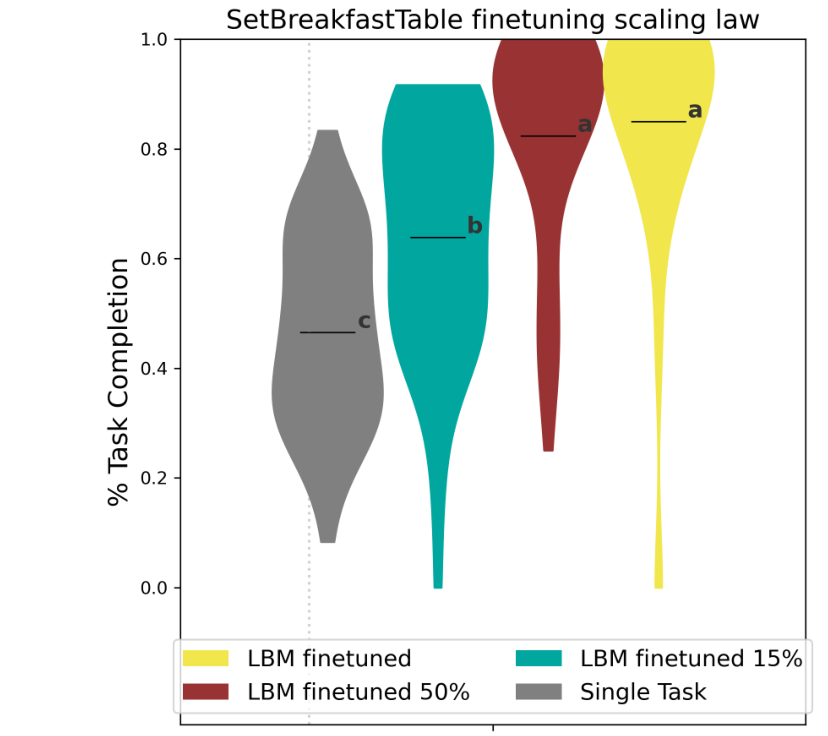
元の図 5(PDF 8 ページ)。実世界でのデータ効率:縦軸は TC。各グループは、異なるデータ割合でファインチューニングされた LBM と、ターゲットタスクデータすべてで訓練された単一タスクベースラインを比較している。
実世界のSetBreakfastTable タスクでは、ターゲットタスクデータの 15% でファインチューニングされた LBM が、すべてのターゲットタスクデータで訓練された単一タスクベースラインよりも有意に高いTC を達成しています。この結果は成功率ではなく完了度に関するものです。
複雑なシミュレーションタスクに対する集約曲線の補間から、ゼロから訓練するのに必要なデータ量の 30% 未満で同等の性能を達成し得ることが示唆されます。この結果と、実世界での 15% の結果は別々の実験から得られたものであり、いずれもすべてのタスクに共通する固定的なデータ節約率を確立するものではありません。
事前学習データの規模と多様性
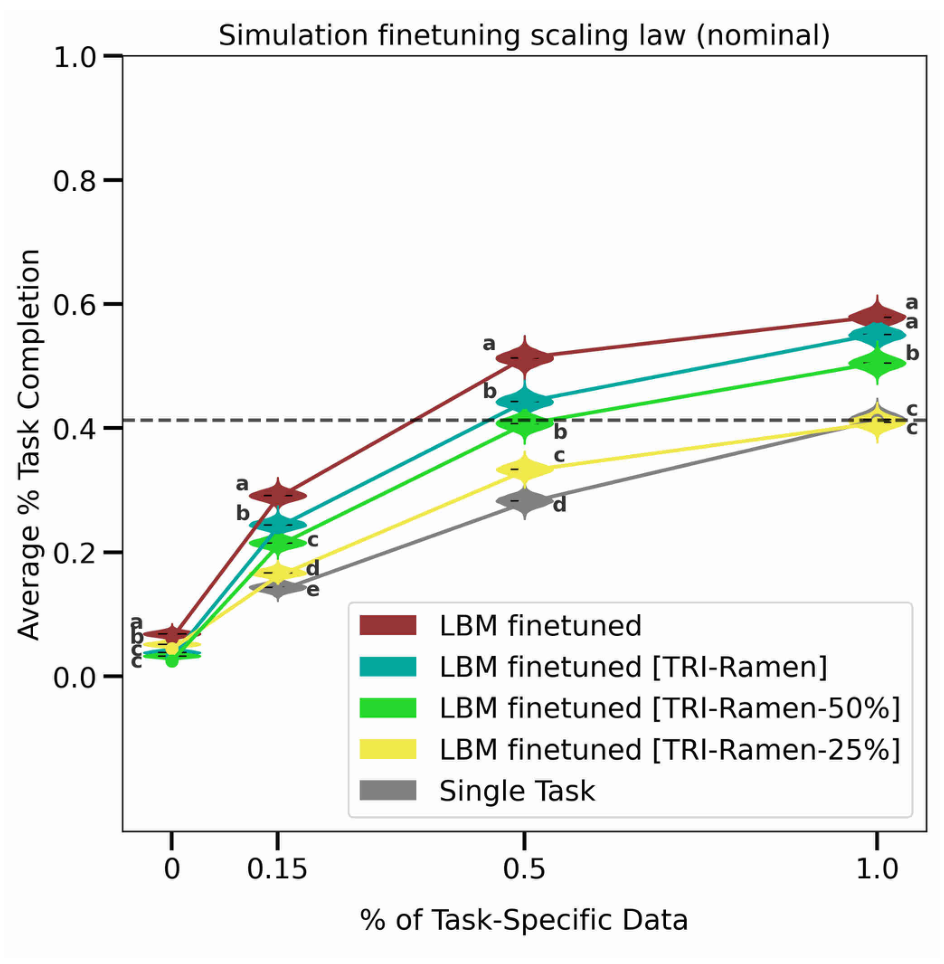
元の図 7(PDF 10 ページ)。横軸:ファインチューニングデータの割合。縦軸:未知シミュレーションタスク 5 個にわたる平均 TC。曲線は異なる事前学習ミックスに対応する。
同じファインチューニングデータ割合であれば、より多様な事前学習データの方が一般に性能が高く、特にターゲットタスクデータが乏しい場合に顕著です。横軸はファインチューニングデータを変化させています。これらの限定的なサブセット実験からは、普遍的なスケーリング則や、モデルパラメータ数の増加による利点は確立されていません。
制約事項
- ファインチューニングなしでの利得は一貫しない。 事前学習済み LBM は単一タスクポリシーを一貫して上回るわけではなく、著者らはその一因として、小さな言語エンコーダによる言語ガイダンスの限界を示唆しています。
- 実験範囲が限定的である。 特定の両腕プラットフォームでの結果は、単腕ロボットや任意の家庭環境に直接一般化できるわけではありません。
- 学習時のランダム性は十分に評価されていない。 バイオリンプロットは主に固定チェックポイントに対する評価の不確実性を捉えており、独立した学習実行間のばらつきを捉えているわけではありません。
- 事前学習には正規化バグが含まれていた。 一部のデータは別ソースのパラメータを使用しており、主要な実験はすべて再実行されたわけではありません。修正後の補足実験では、テストされたシミュレーション分布シフト下で性能が向上しました。
- 静止フレームのフィルタリングは効果が一様ではない。 初期の低動作セグメントを除去すると、一部の単一タスクシミュレーションポリシーでは性能が向上しましたが、一部の事前学習済みモデルでは誤ったタスクを選択する頻度が増加しました。そのため、一律には適用されませんでした。
LeRobot における実装と応用
以下の比較では、コミット f5c9bc0 を使用します(ソースへのリンクは下記)。LeRobot MultiTask DiT は LBM の条件付き DiT 手法に従いますが、その設定、前処理、および学習結果は別個に解釈する必要があります。
設定の比較
| コンポーネント | TRI 論文 | 固定された LeRobot デフォルト |
|---|---|---|
| 目的 | 拡散ノイズ予測;DDIM サンプリング | diffusion; flow_matching もサポート |
| 画像およびテキストのバックボーン | CLIP;ビジョンは学習可能、テキストは固定 | 同様の手法;デフォルトは openai/clip-vit-base-patch16 |
| DiT のサイズ | 8 層;隠れ次元 768 | 6 層;隠れ次元 512;アテンションヘッド 8 個 |
| 観測履歴 | 2 フレーム | n_obs_steps=2 |
| アクション出力 | 20 次元のステップを 16 ステップ | horizon=32; アクション次元はデータセットから取得 |
| 実行セグメント | 再計画前に 8 ステップ実行 | n_action_steps=24; 観測オフセットを用いてスライスし、その後キューに投入 |
| カメラ | 6 ビューに標準化;欠損ビューはゼロ埋め | カウントは入力特徴量から推定;デフォルトでビジョンエンコーダを共有 |
| 正規化 | ソース、相対タイムステップ、および特徴次元ごとの分位点 | 状態とアクション:MIN_MAX; 画像:MEAN_STD |
デフォルトでは、num_inference_steps=None は num_train_timesteps=100 にフォールバックし、100 ステップのノイズ除去を行います。回転位置埋め込み(RoPE)はデフォルトで有効です。学習可能な絶対位置埋め込みもサポートされており、このバージョンでは両方を同時に使用できます。
パラメータ数は、カメラ数、層数、および隠れ次元に依存します。Boston Dynamics のブログにある 4.5 億パラメータ、48 ステップの予測ホライズン、24 ステップの実行セグメントという記述は Atlas の設定を表しており、すべての LeRobot 設定に当てはまるわけではありません。
アクションウィンドウと実行セグメント
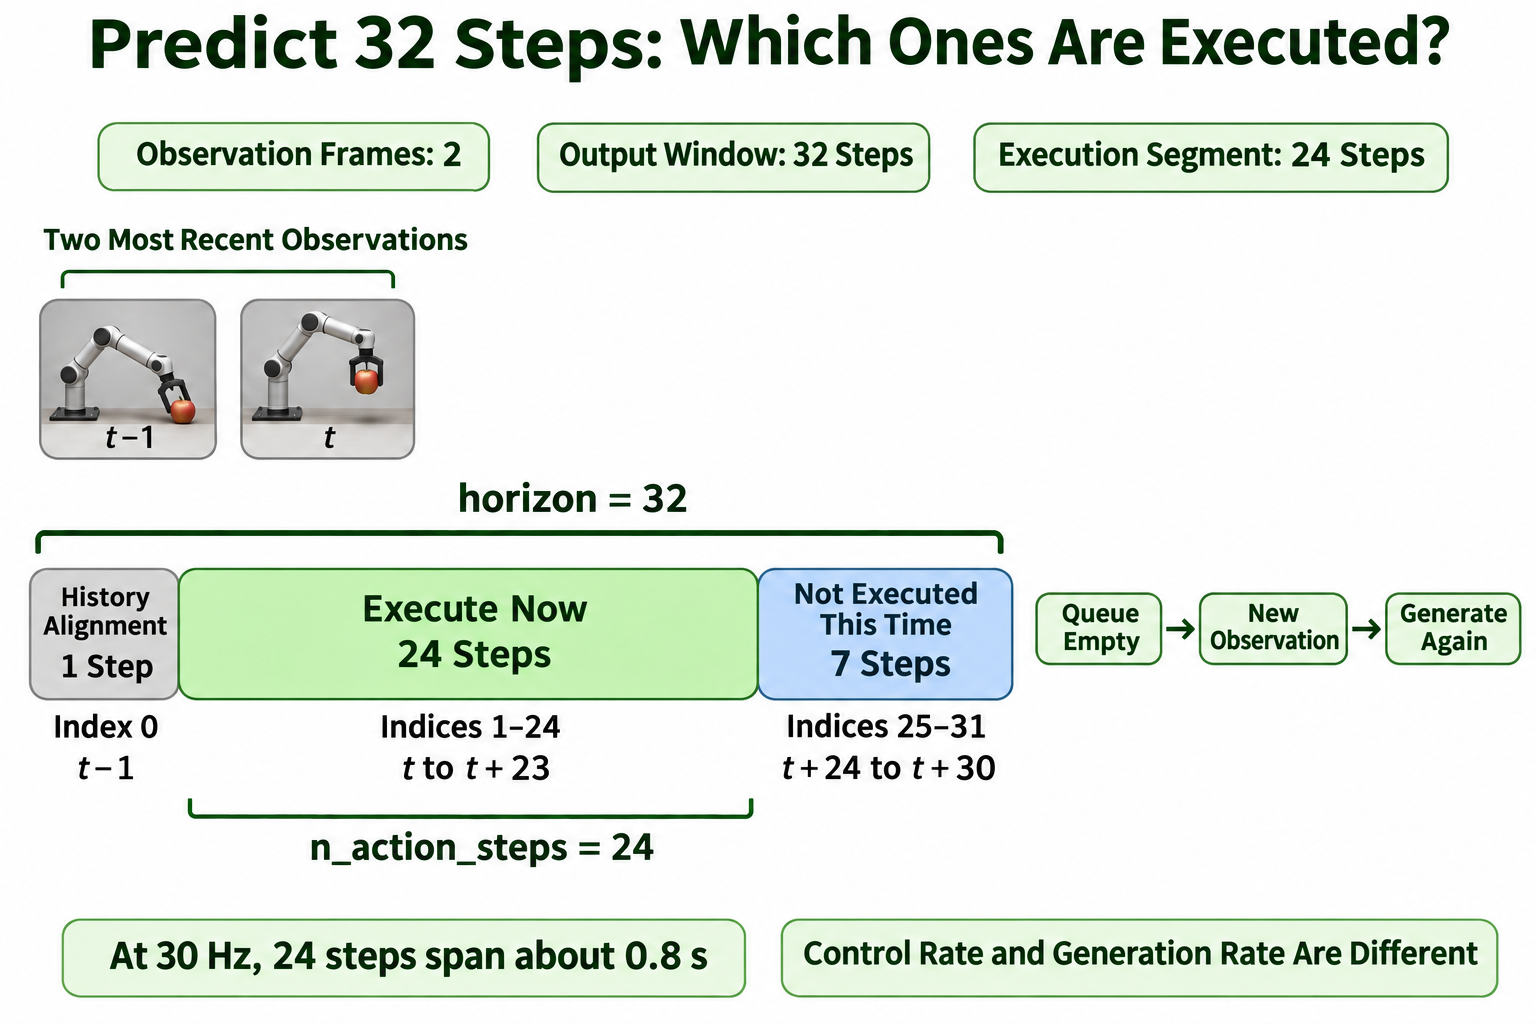
固定された LeRobot 実装におけるアクションスライシングに基づく解説図。32 ステップのウィンドウと 24 ステップの実行セグメントは、このバージョンのデフォルトである。
観測フレームが 2 枚の場合、アクションウィンドウは から始まります。_generate_actions はインデックス 1:25 を取り、 から までの 24 個のアクションを実行キューに配置します。ウィンドウ長 、観測数 、実行長 は次を満たす必要があります:
、、 の場合、これは となります。
デモンストレーションのサンプリングとアクション実行の両方が 30 Hz で動作する場合、24 ステップは図示された 0.8 秒に相当します。10 Hz の場合、それらはおよそ 2.4 秒にわたります。より短い実行セグメントは新しい観測をより早く取り込めますが、より頻繁な生成が必要になります。実際のタイミングは推論および通信レイテンシにも依存し、ウィンドウパラメータは制御周波数を決定しません。
学習の初期化と論文の結論
LeRobot は、画像およびテキストエンコーダを事前学習済み CLIP 重みから初期化し、あなた自身のロボットデモンストレーションに対してアクションポリシーを学習できます。これは TRI のロボットマルチタスク事前学習の経験を提供するものではありません。論文における転移の利点を検証するには、ターゲットタスクのデータ、アクションインターフェース、およびテスト条件を揃えたうえで、単一タスク学習とマルチタスク事前学習+ファインチューニングを比較する必要があります。
reBot または SO-ARM101 への適用にあたっては、まずデータセットの状態、アクション、カメラ、タイムスタンプ、およびタスク指示を確認し、そのうえで単一タスク制御パイプラインを検証してください。
結論の解釈
この論文は、固定されたポリシーアーキテクチャと制御された評価を用いて、マルチタスク事前学習の利点を検証しています。評価されたタスクにおいては、事前学習に続くファインチューニングにより、総合的な性能が向上し、同等の性能を得るために必要なターゲットタスクのデモンストレーション数が削減されます。いくつかの利点は、テスト条件が変化したときにより顕著になります。
結果は、多様なデモンストレーションに対する事前学習を、明確な制約のもとで支持しています。利得はタスクとファインチューニング条件に依存し、完了率の向上が必ずしも完全な成功を意味するわけではなく、ファインチューニングを行わないモデルが単一タスクポリシーを一貫して上回るわけでもありません。その貢献を理解するには、アクション生成、実験的な比較、および証拠の範囲を結び付けて考える必要があります。
参考文献
- TRI LBM Team. A Careful Examination of Large Behavior Models for Multitask Dexterous Manipulation, 2025.
- TRI. LBM project page.
- Hugging Face. Multitask DiT Policy.
- Hugging Face / Bryson Jones. Pinned configuration、model、および processor。
- Boston Dynamics. Large Behavior Models and Atlas Find New Footing。Atlas に対する DiT とフローマッチング。
- Bryson Jones. Dissecting and Open-Sourcing Multitask Diffusion Transformer Policy。オープンソース実装の作者によるアーキテクチャと実装に関するノート。