π0: Flow Matching はどのようにビジョンと言語をロボットアクションへ結びつけるか
π0: 汎用ロボット制御のための Vision-Language-Action Flow モデル
- ロボット基盤モデル
- アクションエキスパート
- フローマッチング
- クロスエンボディメント学習
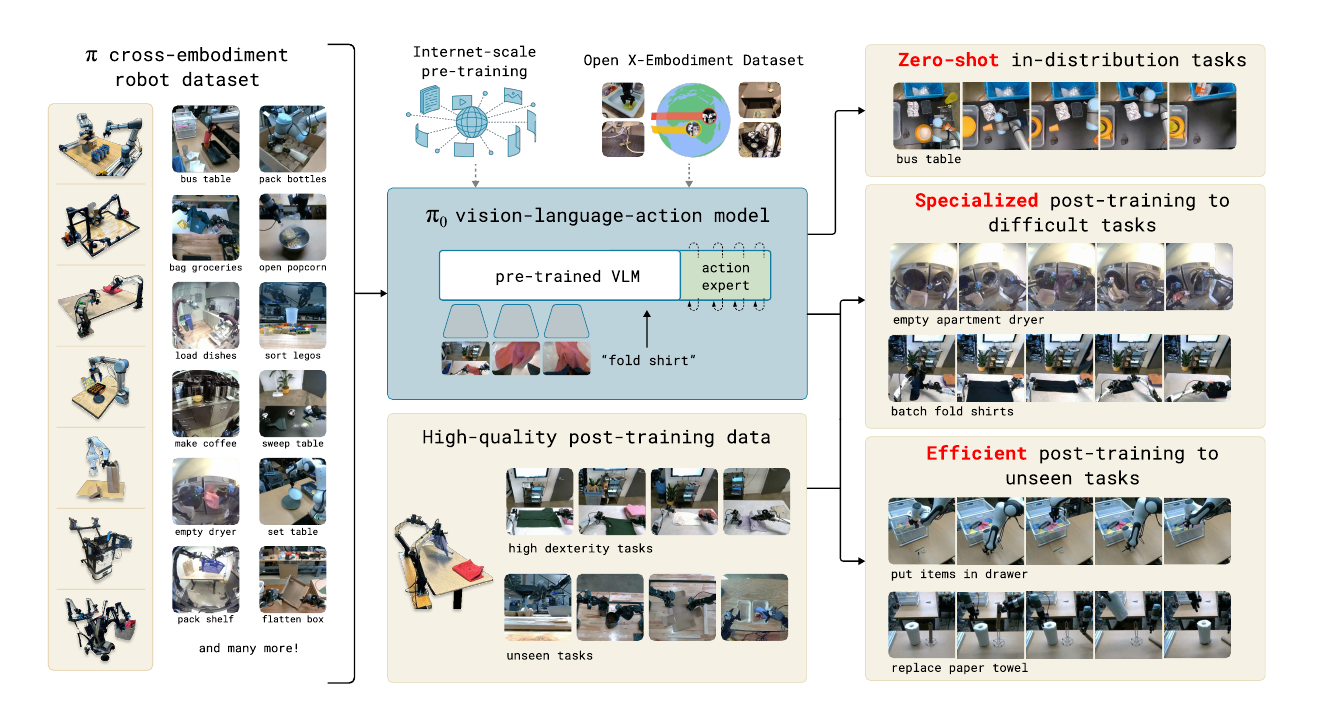
π0 は、意味的バックボーンとして事前学習済みの PaliGemma ビジョン・言語モデルを用い、およそ 3 億パラメータのアクションエキスパートを追加します。条件付きフローマッチングによって連続アクションチャンクを生成し、大規模なクロスロボット事前学習と高品質なタスクポストトレーニングによって、同一モデルを単腕・双腕・モバイルシステムへ適応させます。
前提知識
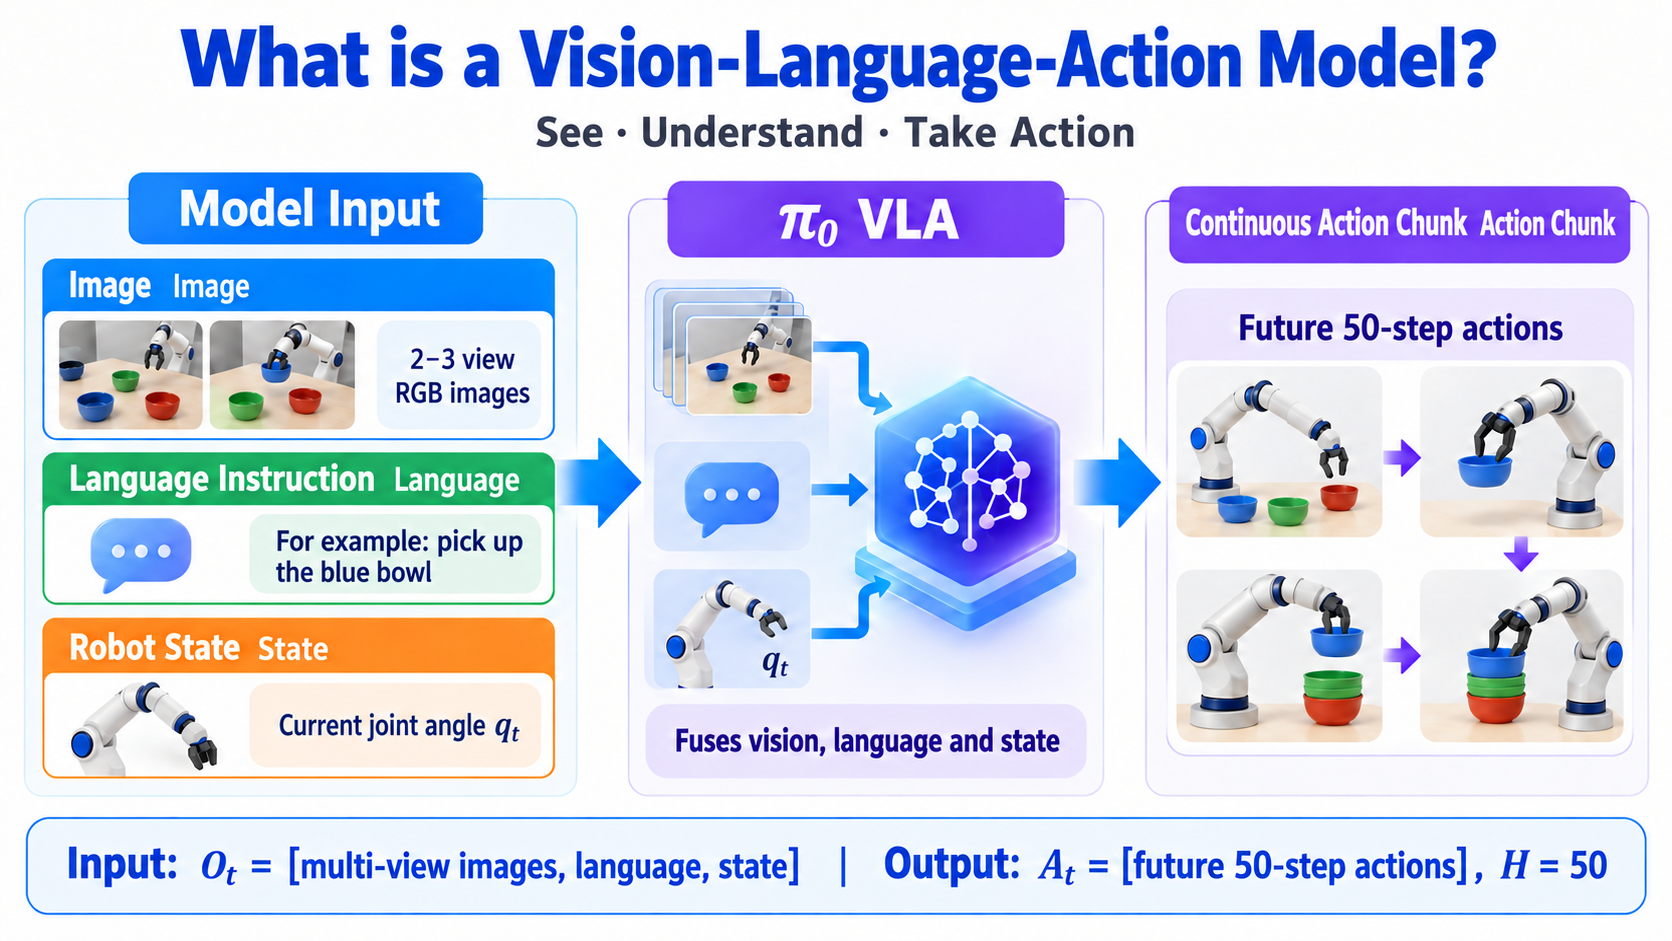
Vision-Language-Action モデルとは?
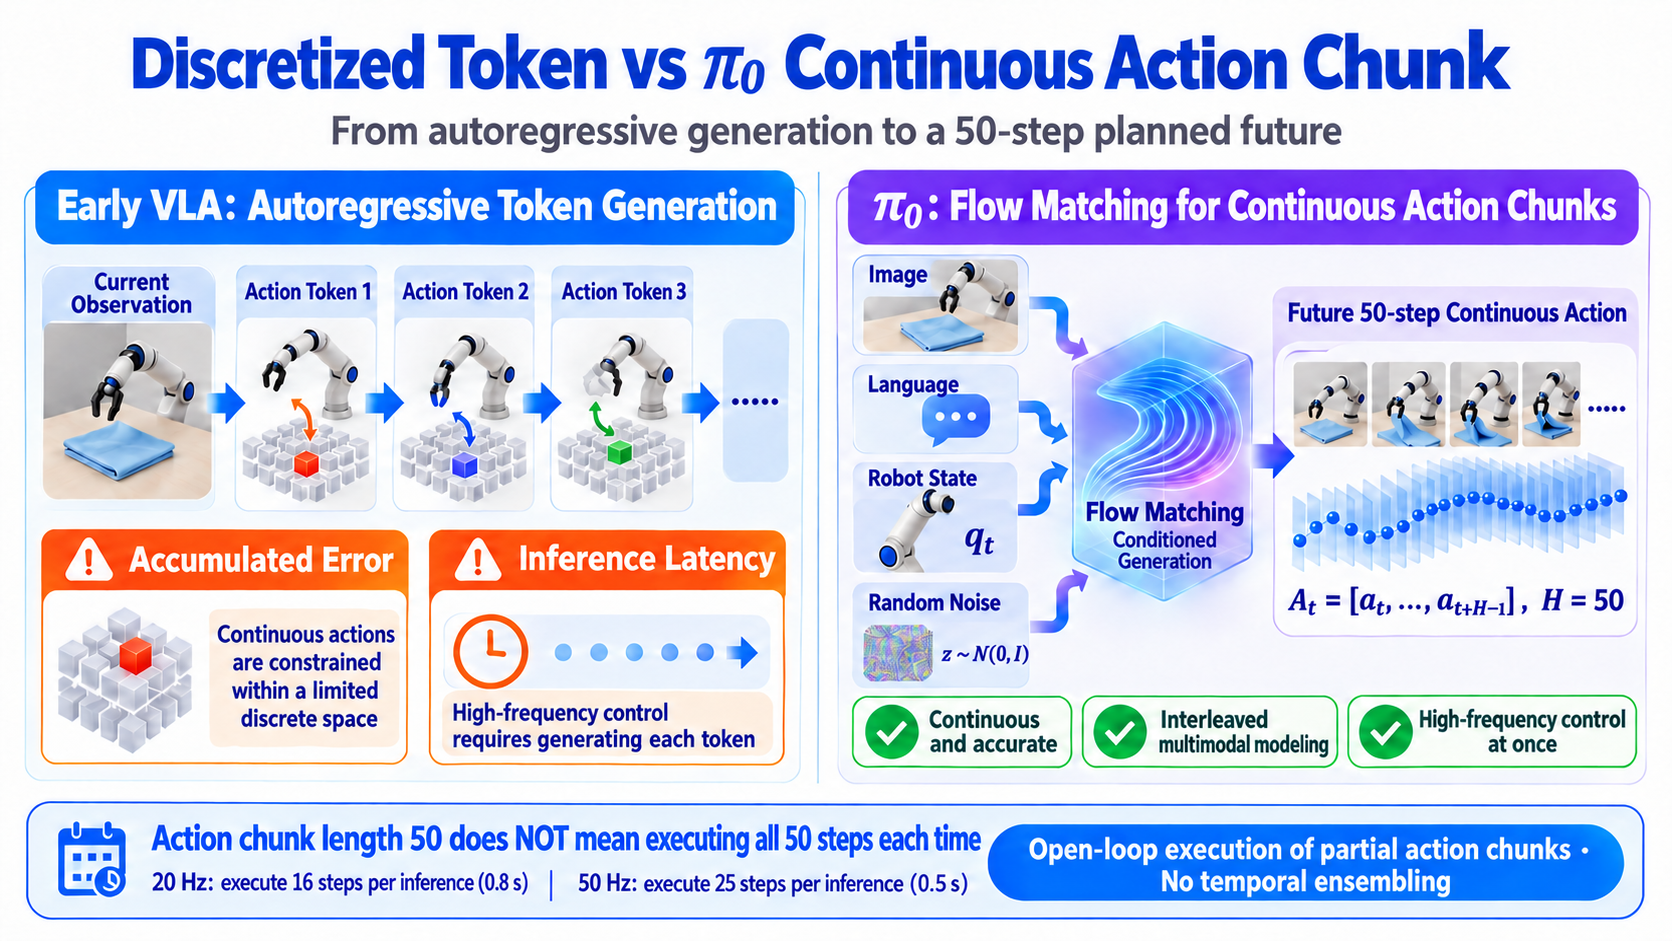
自回帰離散アクションと連続チャンク
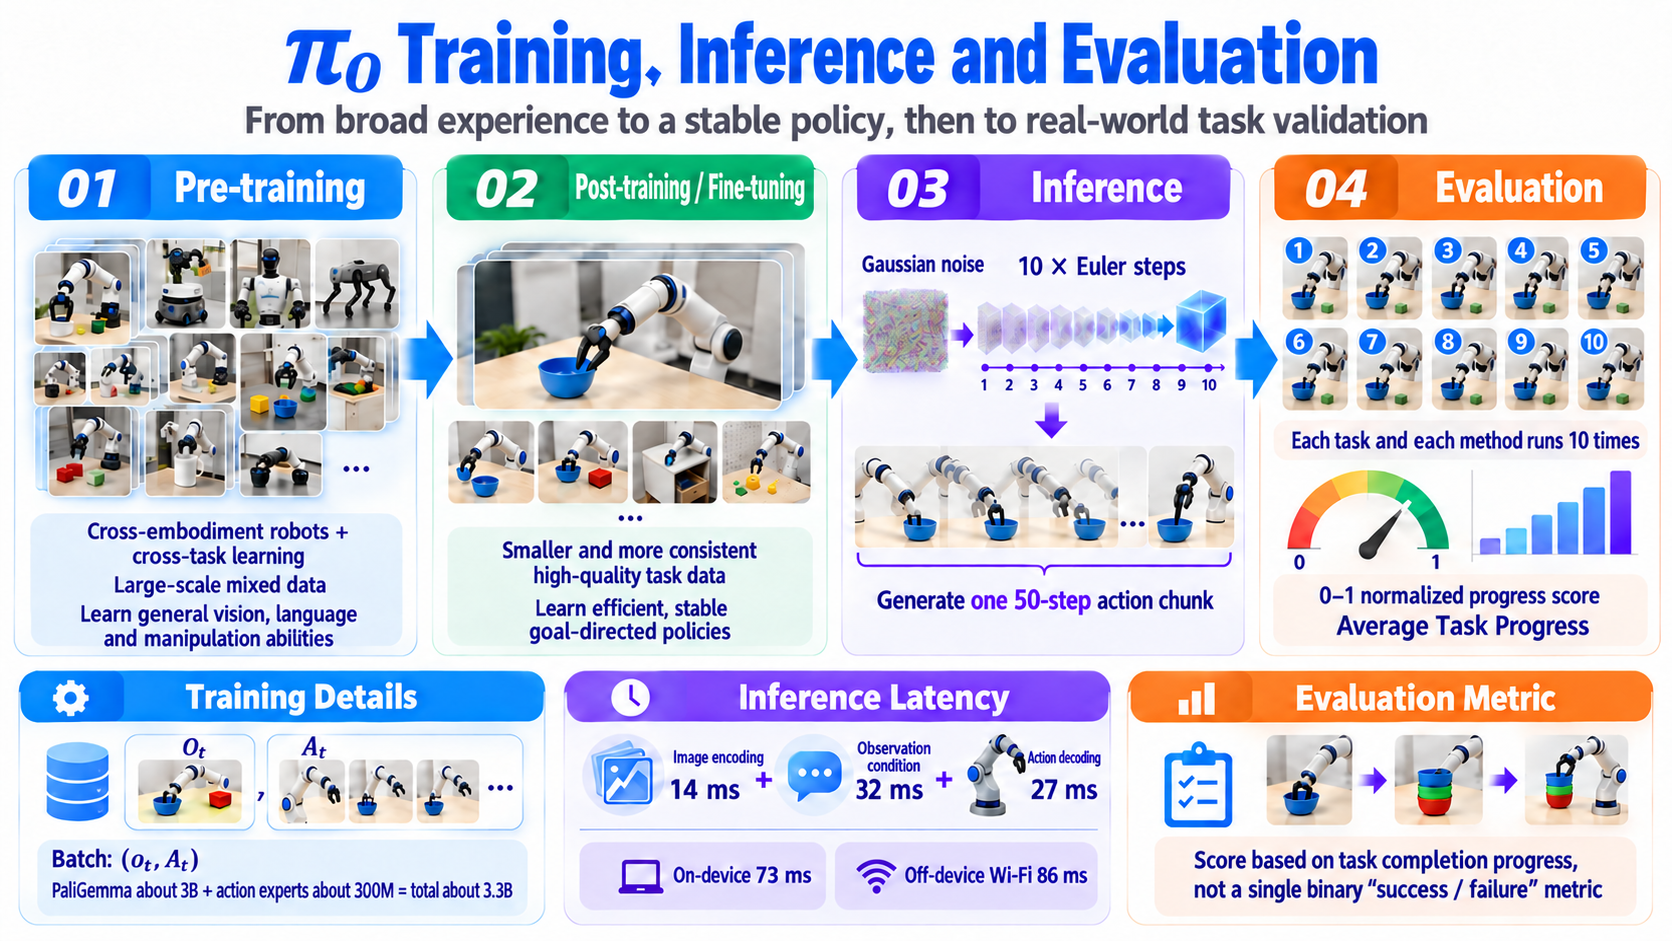
学習・推論・評価
要約
翻訳
ロボット学習は、柔軟で汎用的かつ巧緻なシステムと、AI の根本的な問いへの洞察を約束する。一方で、実システムに必要な汎用性を達成するには、データ、汎化、ロバスト性の面で依然として大きな障害が存在する。
本論文は、複雑で巧緻なタスクに対して、汎用ロボットポリシー、すなわちロボット基盤モデルがどのようにこれらの課題に取り組めるかを問う。インターネットスケールのデータから意味知識を継承する、事前学習済み VLM 上に構築されたフローマッチングアーキテクチャを導入し、その後、多様な単腕・双腕・モバイルマニピュレーションプラットフォーム上で学習を行う。
評価は 3 つの設定を対象とする:直接プロンプト、ヒトまたは高レベル VLM ポリシーからの言語指示の追従、新しいスキルへのファインチューニング。タスクには、洗濯物の折りたたみ、テーブルの片付け、段ボール箱の組み立てなどが含まれる。
コメント
-
アーキテクチャは問題の一部にすぎない。 本論文は 3 つのボトルネックを特定する:十分なデータスケール、連続かつ高頻度のアクションを表現できるアーキテクチャ、そして適切な事前学習/ポストトレーニングのレシピである。
-
VLM は理解を、アクションエキスパートは制御を担う。 PaliGemma は画像と言語のセマンティクスを処理し、エキスパートはロボット状態、ノイズを含むアクション、連続出力を処理する。
-
フローマッチングは自回帰的なアクショントークン生成に置き換わる。 モデルは連続チャンク全体をノイズから並列に生成する。
-
クロスエンボディメントデータが中核となる。 アームとモバイルベースでは状態空間とアクション空間が異なる。パディングとマスク付き画像スロットによって、共通の学習インターフェースを提供する。
-
事前学習とポストトレーニングは役割が異なる。 広範な事前学習には、通常とは異なる状態やリカバリ挙動が含まれ、ポストトレーニングは一貫性があり流暢な成功を重視する。両者を組み合わせることで、適応性と実行品質を両立させる。
序論
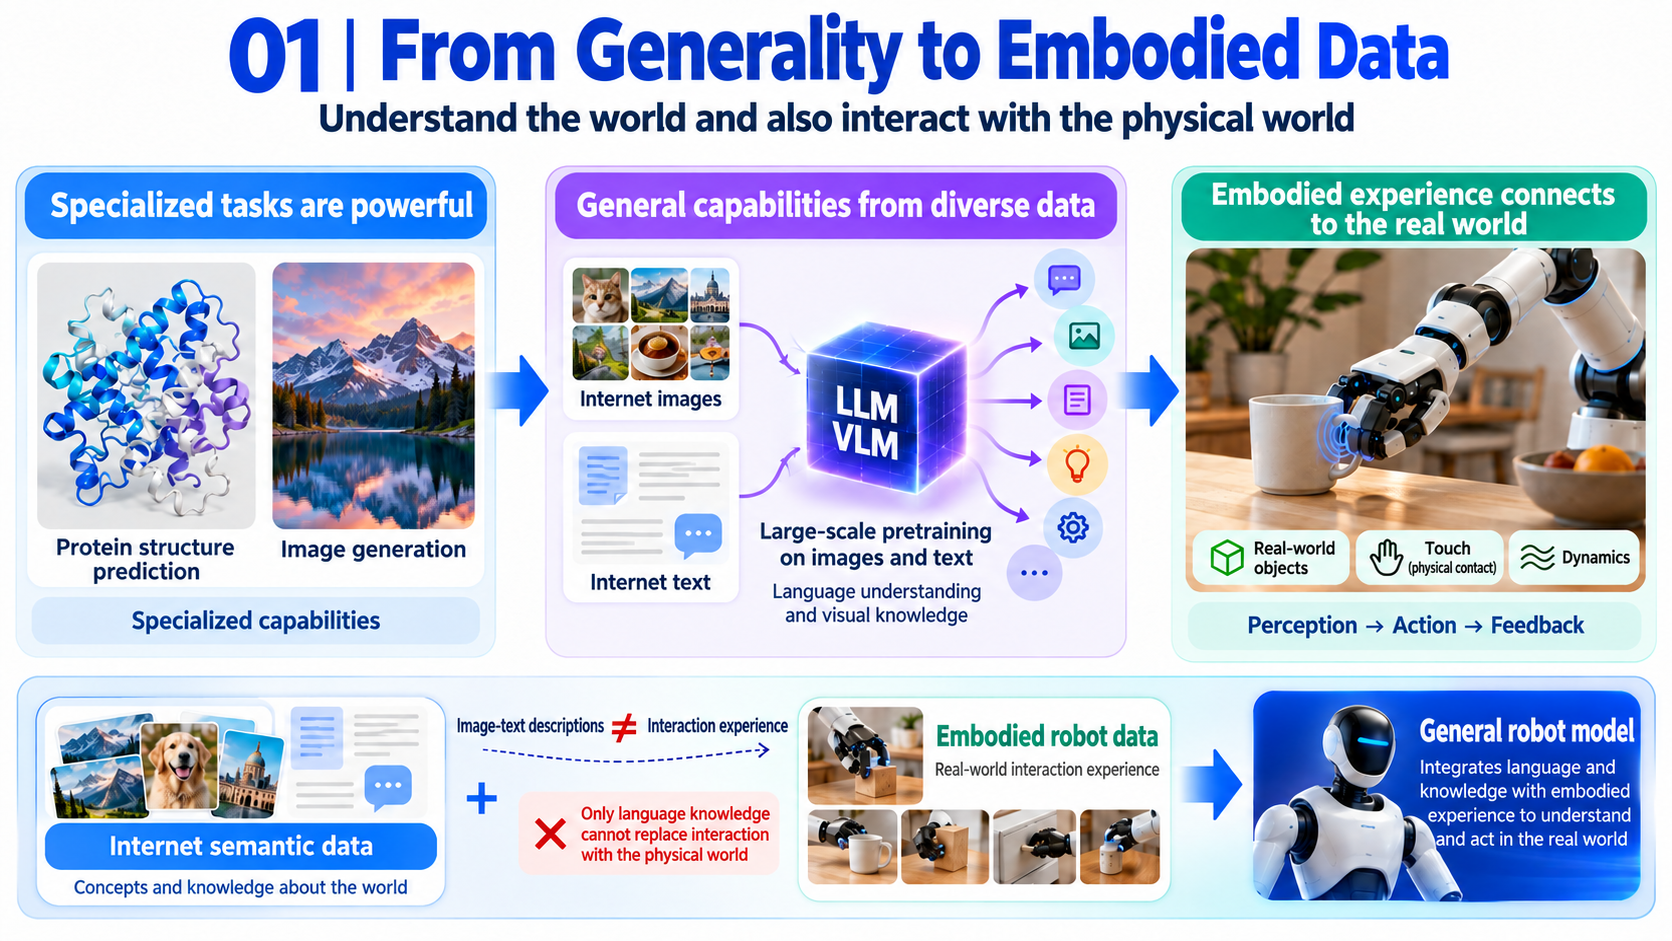
第 1 段落:汎用性には物理的経験が必要
-
主張: AI はタンパク質構造予測や画像生成のような専門的タスクでは優れているが、環境、制約、言語、予期せぬ事象にまたがる汎用性では人間の方がはるかに勝っている。LLM や VLM は多様な事前学習の恩恵を受けるが、それ自体として物理的インタラクションの経験を獲得するわけではない。
-
引き継がれる問題: 画像とテキストの記述は、物体との接触やダイナミクスの経験の代わりにはならない。
-
手法へのつなぎ: 汎用ロボットモデルには、インターネット上のセマンティクスと物理ロボットのデータの両方が必要である。
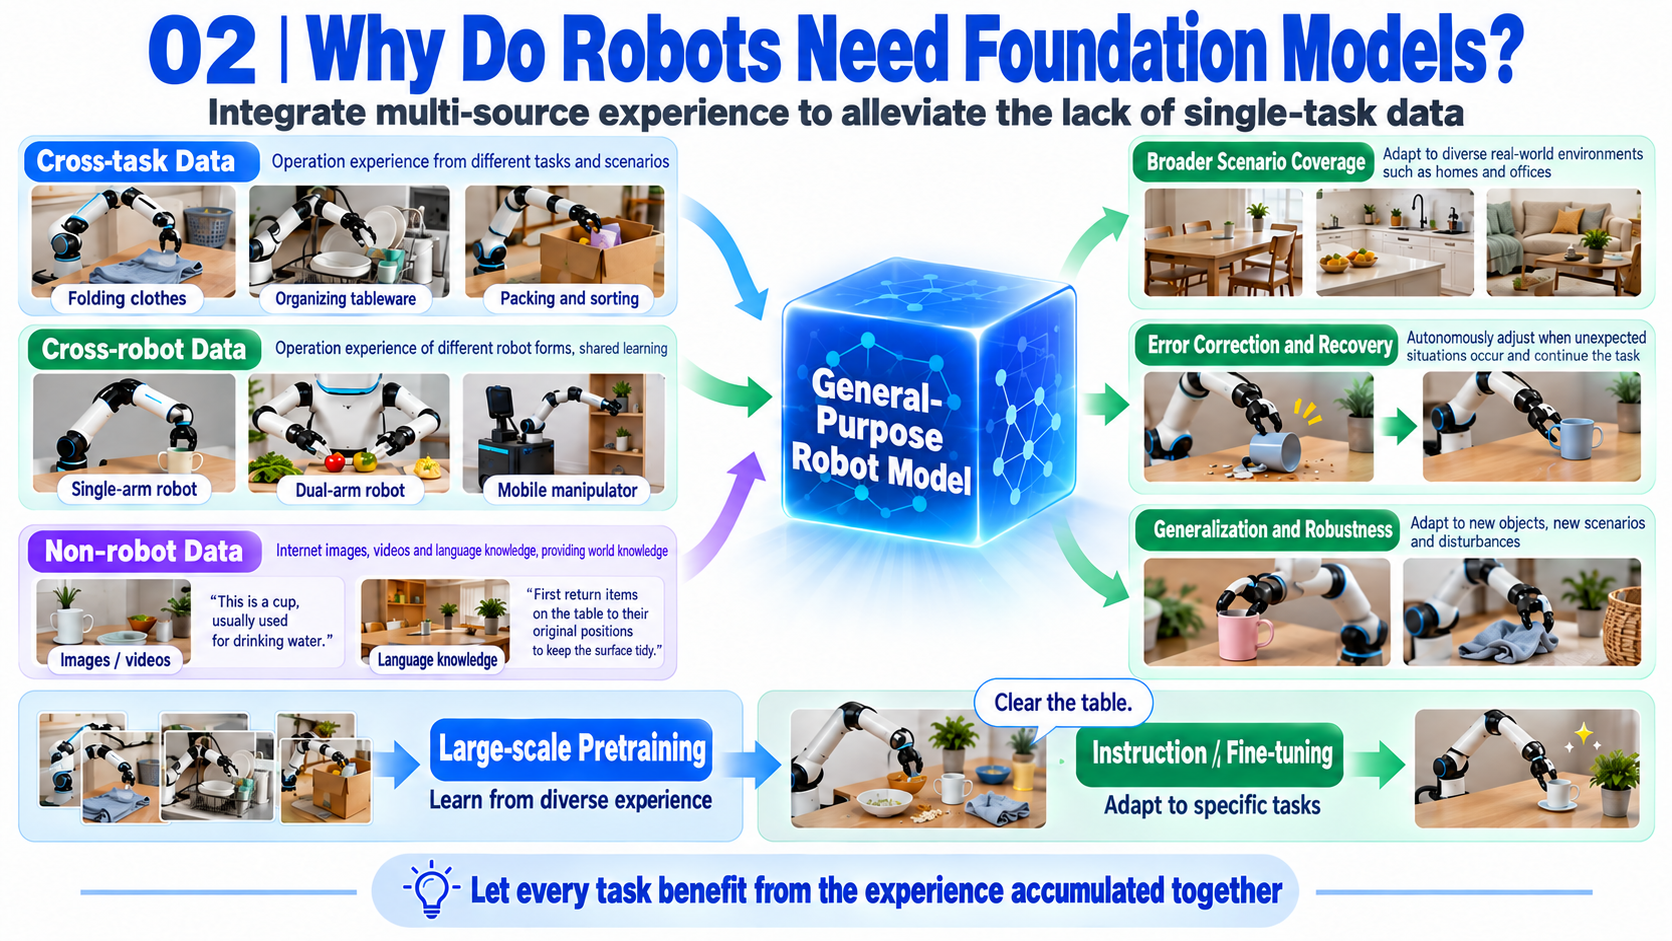
第 2 段落:なぜ基盤モデルがロボティクスに適しているのか
-
主張: 汎用モデルは、他のタスクやロボット、さらには非ロボットソースからもデータを集約し、単一タスクにおけるデータ不足を緩和する。多様性は、より多くのシーン、エラー、リカバリをカバーでき、ロバスト性の向上にもつながる。
-
引き継がれる問題: 1 台のロボットと 1 つのタスクだけでは、失敗状態を十分にカバーできるだけのデータを供給できないことが多い。
-
手法へのつなぎ: 広く事前学習し、その後は各タスクをゼロから学習するのではなく、プロンプトやファインチューニングで対応する。
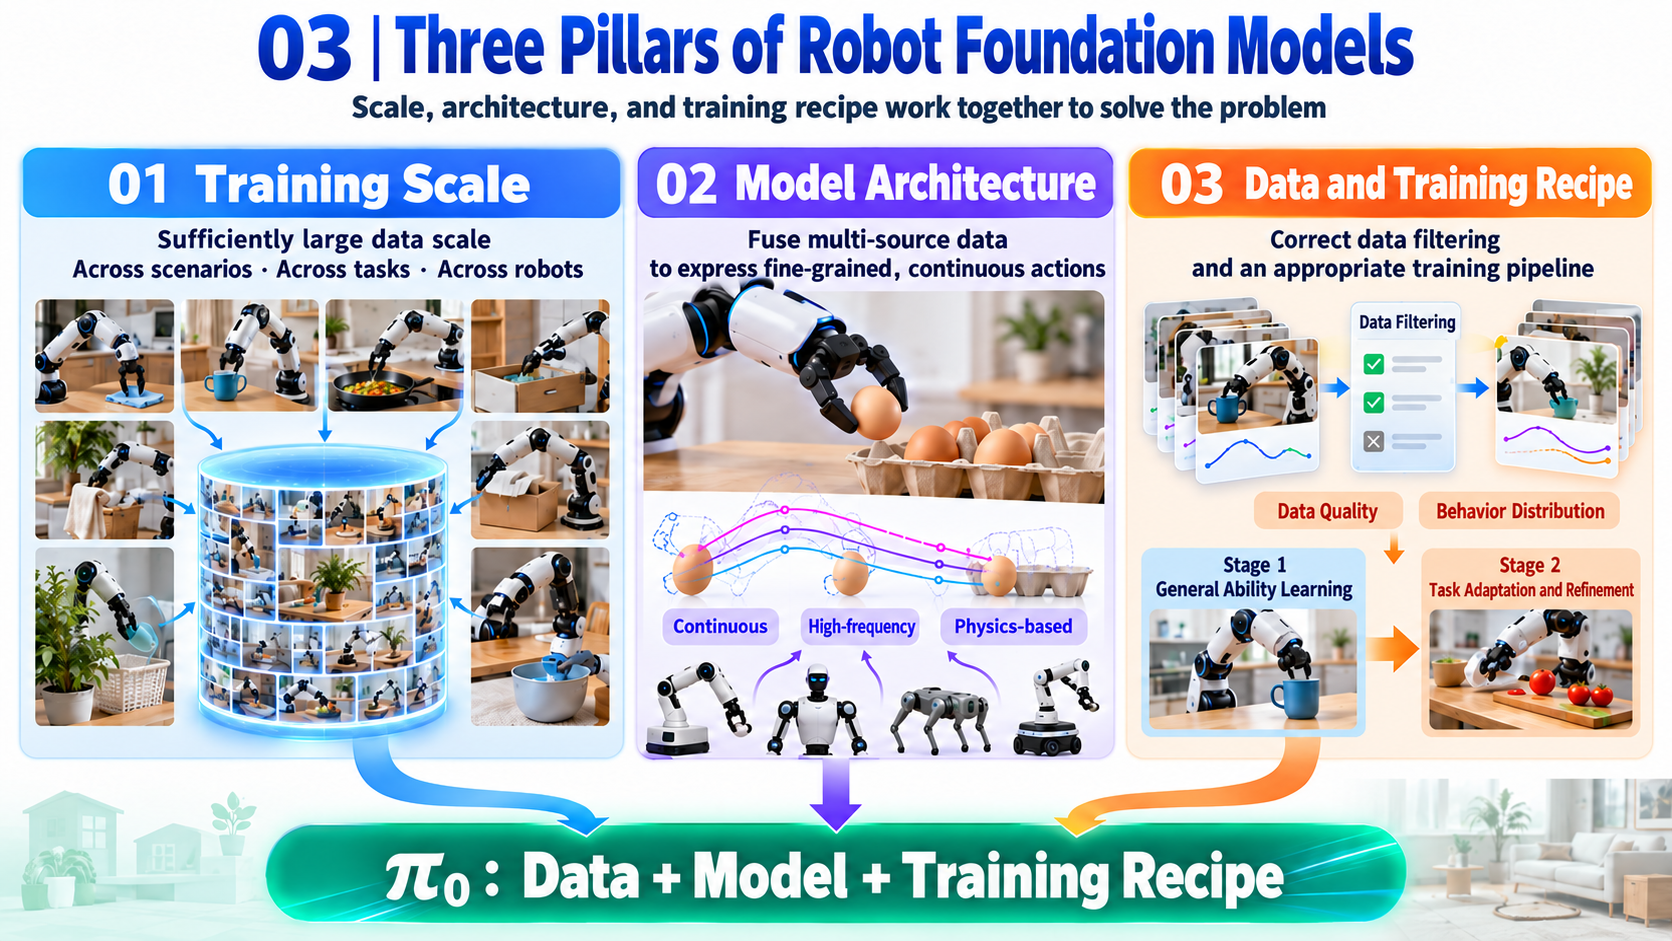
第 3 段落:3 つのボトルネック
-
主張: 汎用ポリシーには、十分なスケール、異種データを統合し精密なアクションを表現できるアーキテクチャ、そして適切なデータ選択と学習レシピが必要である。
-
引き継がれる問題: 言語モデルの手法を、そのまま連続かつ高頻度でプラットフォーム依存な制御にコピーすることはできない。
-
手法へのつなぎ: π0 はデータ、アーキテクチャ、学習をそれぞれ個別に扱う。
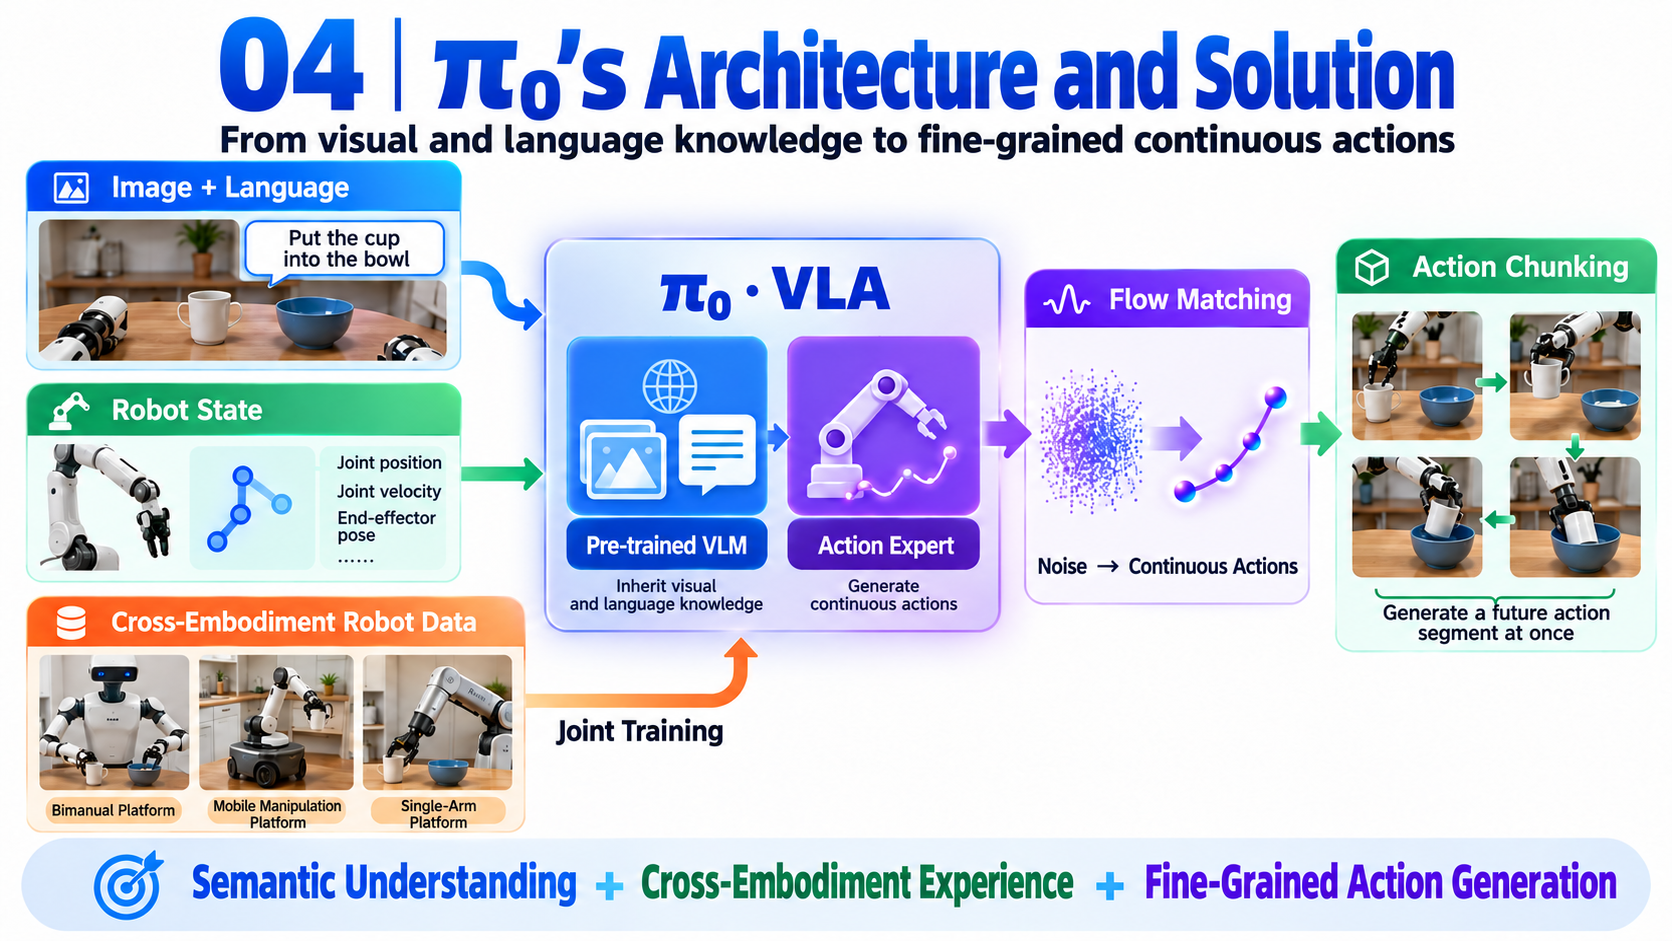
第 4 段落:アーキテクチャ上の解答
-
主張: VLM から初期化し、複数のエンボディメントをまたいで共同学習し、連続制御のためにアクションチャンクとフローマッチングを用い、バックボーンをアクションジェネレータへ拡張するアクションエキスパートを追加する。
-
引き継がれる問題: ロボットごとにアクション空間が異なり、離散自回帰は速度と精度の両立に苦戦する。
-
手法へのつなぎ: セクション 5 と 6 で、クロスエンボディメントデータセットとアクションエキスパートを展開する。
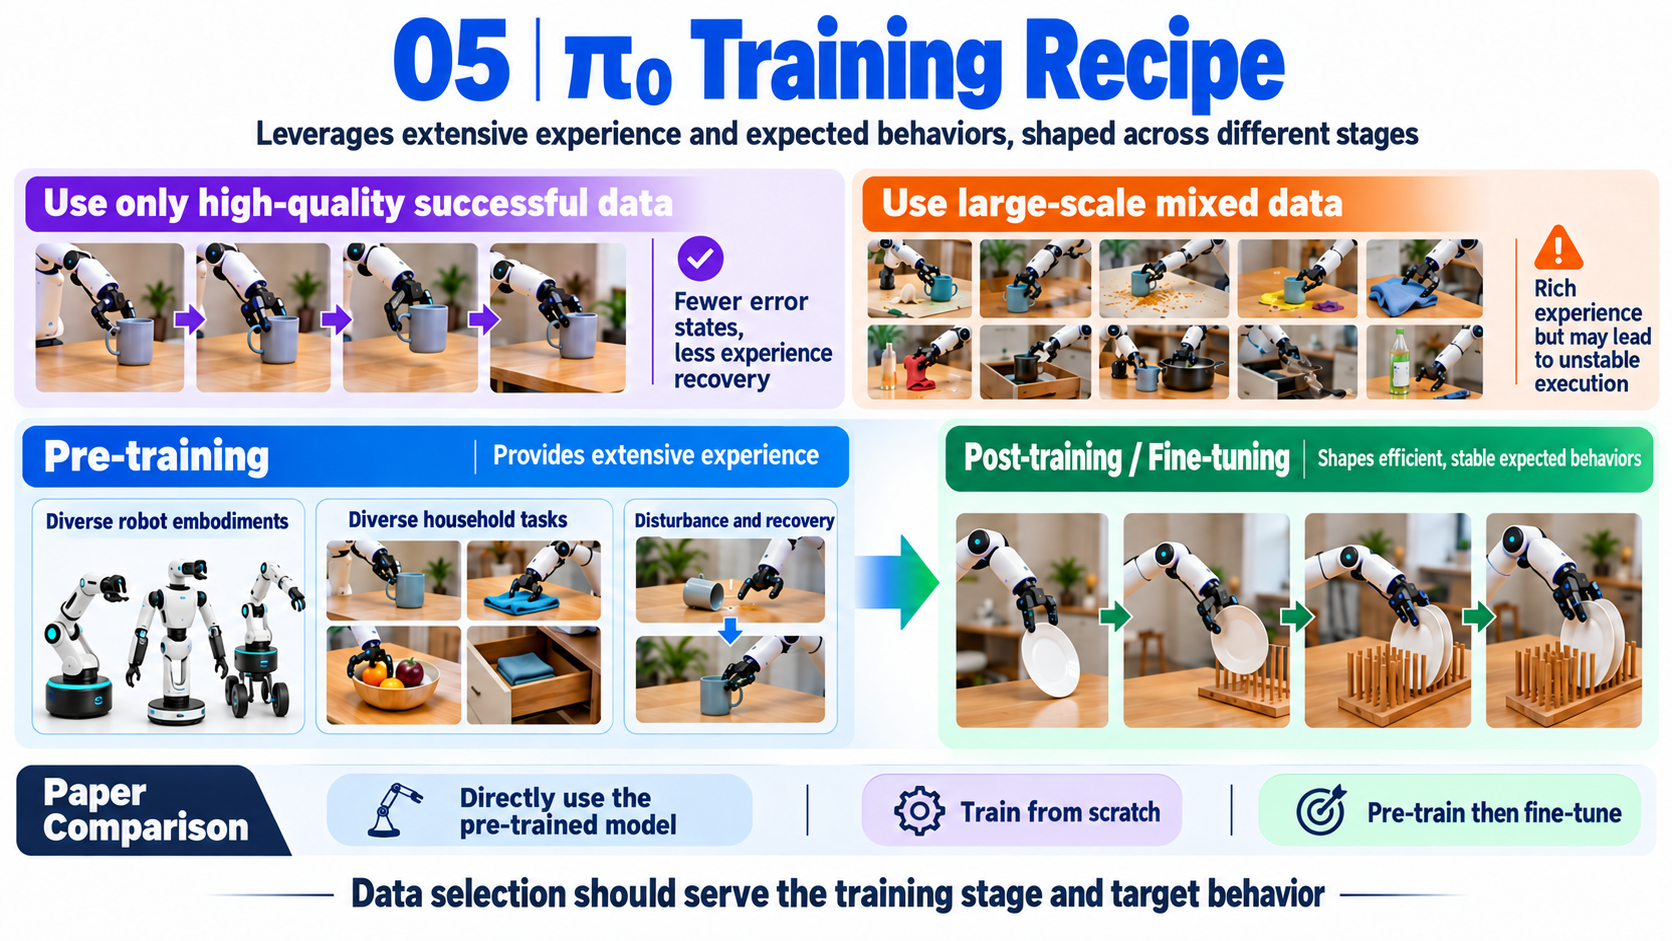
第 5 段落:学習レシピ
-
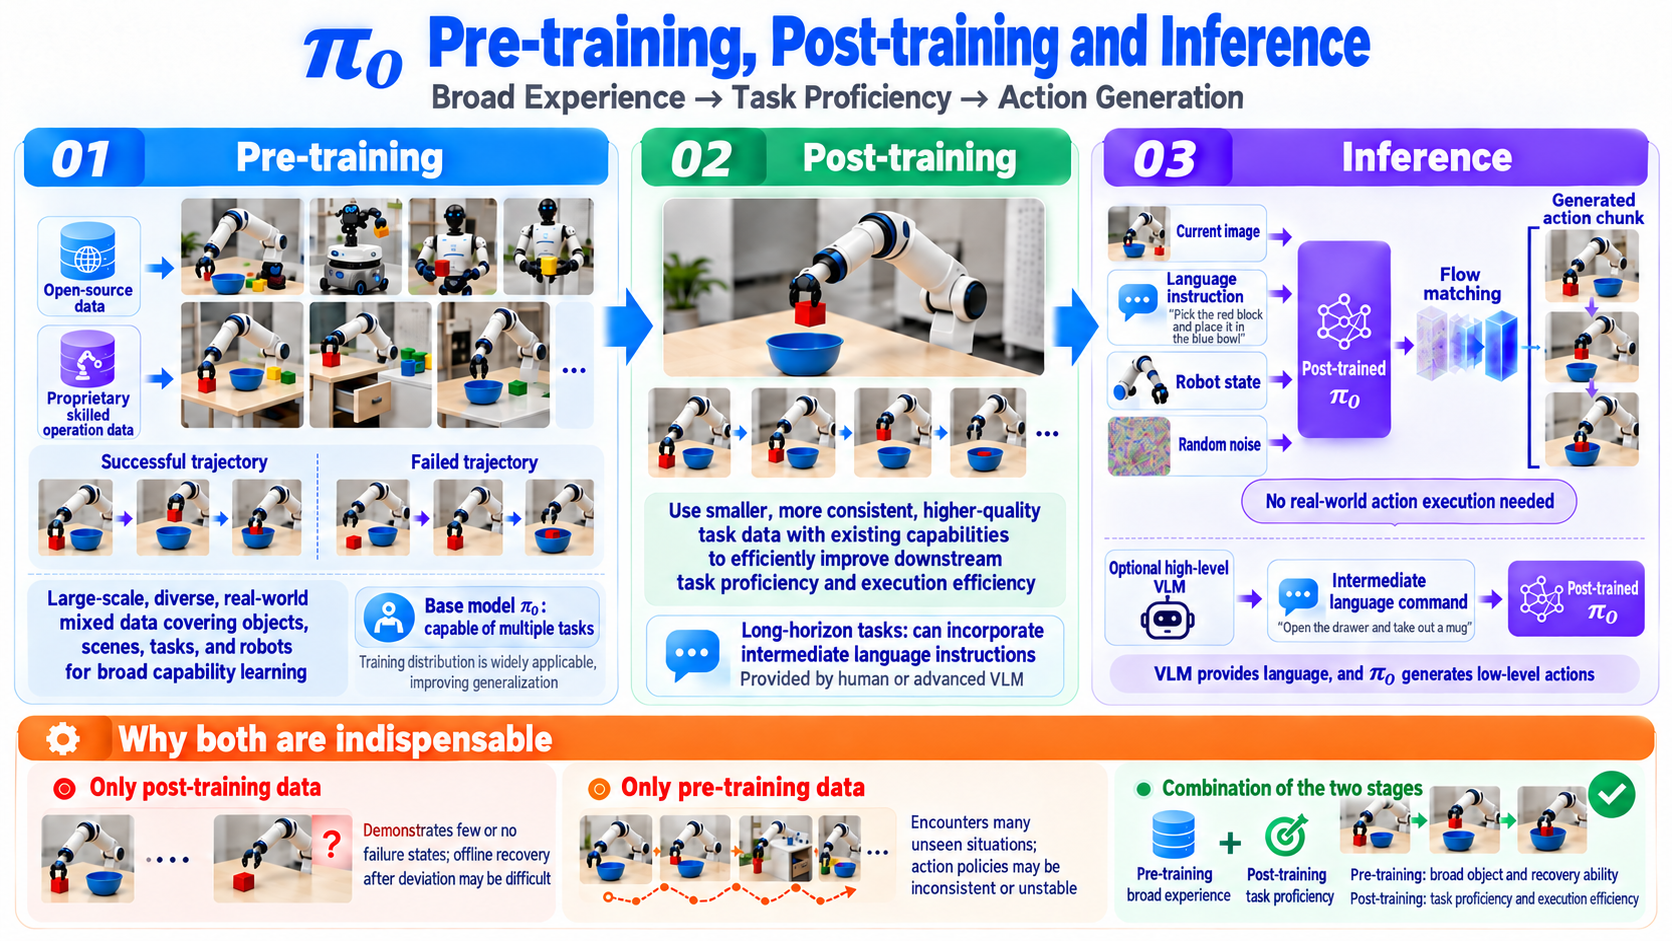
主張: 事前学習とポストトレーニングは役割分担している。洗練された成功例だけで学習すると、失敗やリカバリの経験がほとんど得られない。一方で、広範だが質の低いデータだけでは効率的な実行が得られない可能性がある。事前学習は経験を広げ、ポストトレーニングは望ましい振る舞いを形成する。
-
引き継がれる問題: 「クリーンなデータほど常に良い」というのは、ロボット学習のすべての段階に当てはまる普遍的なルールではない。
-
実験へのつなぎ: 事前学習済みモデルの直接利用、ゼロからの学習、事前学習後のファインチューニングを比較する。
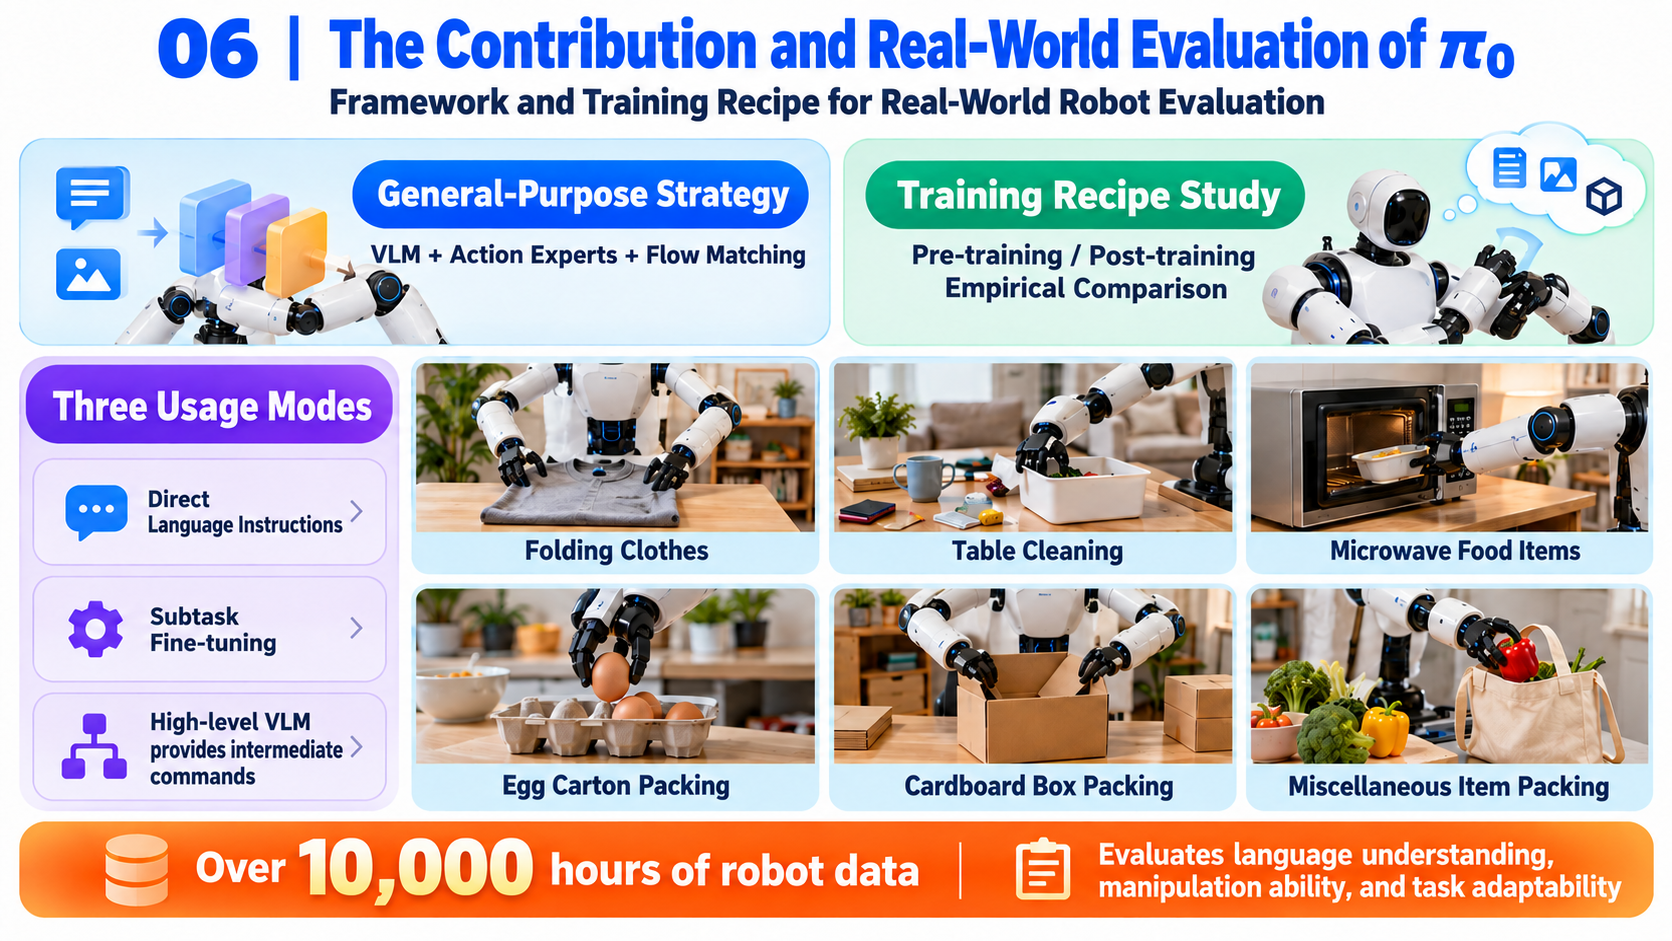
第 6 段落:貢献と評価範囲
-
主張: 貢献は、VLM ベースのフローマッチング汎用アーキテクチャと、事前学習/ポストトレーニングレシピの実証的検討を含む。ポリシーは、言語プロンプティング、下流タスクへのファインチューニング、高レベル VLM からの中間指示に対応する。
-
引き継がれる問題: アーキテクチャと学習の両方について、実ロボット上でのエビデンスが必要である。
-
実験へのつなぎ: 1 万時間を超えるロボットデータに基づき、洗濯物の折りたたみ、テーブルの片付け、電子レンジへの積み込み、卵パック詰め、箱の組み立て、買い物袋詰めなどの評価を行う。
関連研究
-
VLA: RT-2、OpenVLA、Octo は、視覚と言語の表現をロボット制御へ転移する。多くは離散自回帰アクショントークンを用いる。π0 は事前学習済み VLM を保持しつつ、条件付きフローマッチングによって連続かつ高頻度のチャンクを生成する。
-
Diffusion/flow モデルとマルチモーダル Transformer: Diffusion Policy はマルチモーダルな連続アクションをモデル化し、Transfusion は離散トークンと連続生成目的を組み合わせる。π0 は関連するアイデアを VLA に適用し、画像・言語と状態・アクションの重みがアテンションを通じて相互作用する。
-
大規模ロボット学習: 以前のデータセットは、より単純な把持や押し動かしに焦点を当てることが多かった。OXE、Bridge、DROID はタスクとロボットのカバレッジを広げた。π0 は 1 万時間超の内部データ、主に巧緻な双腕行動と、2 段階の事前学習/ポストトレーニングレシピを追加する。
-
巧みなマニピュレーション: ACT と Diffusion Policy は、小規模なデータセットから精密なタスクを学習できますが、通常はタスクやロボットに特化しています。これに対して π0 は、まず複数のエンボディメントにまたがって事前学習を行い、その後、プロンプトやさまざまなデータ規模での高品質なポストトレーニングを用います。
クロスエンボディメントなシステムとデータ
設計目標とコンポーネント
π0 は、単一のアームに結びついたコントローラではなく、クロスエンボディメントなモデル兼データシステムです。その目標は次のとおりです:
-
単腕、両腕、モバイルマニピュレーションロボット間でデータを共有する。
-
言語、視覚観測、ロボット状態、連続アクションをまとめて処理する。
-
カバーされているタスクを直接実行するか、ポストトレーニングによって難しい/新しいタスクを学習する。
-
最大 50 Hz で巧みな制御をサポートする。
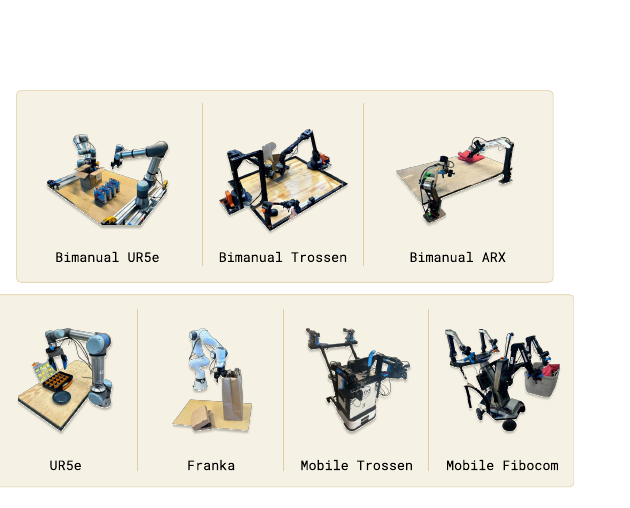
| プラットフォームカテゴリ | 画像入力 | 状態 / アクション空間 |
|---|---|---|
| 単腕 UR5e | 手首 + 肩、2 ビュー | 7D 状態、7D アクション |
| 両腕 UR5e | 3 ビュー | 14D 状態、14D アクション |
| 単腕 Franka | 2 ビュー | 8D 状態、8D アクション |
| 両腕 Trossen | 2 つの手首 + ベース、3 ビュー | 14D 状態、14D アクション |
| 両腕 ARX / AgileX | 2 つの手首 + ベース、3 ビュー | 14D 状態、14D アクション |
| モバイル Trossen / モバイル ARX | 2 つの手首 + ベース、3 ビュー | 14D 状態、16D アクション;非ホロノミックベース制御が 2 次元追加 |
| モバイル Fibocom | 2 本のアーム + 全方向移動ベース | 14D 状態、17D アクション;ベース用の 2 次元の並進と 1 次元の回転制御 |
注意: 運動学的に類似したプラットフォームは構成カテゴリにグループ化されています。7 つの構成は 7 台の物理ロボットを意味するわけではなく、OXE に 7 種類のロボットしかないという意味でもありません。内部の巧みなデータは 7 つの構成をカバーし、追加された OXE データは 22 種類のロボットをカバーします。
クロスエンボディメントな学習と制御
全体的なワークフローは次のとおりです:
Multi-platform teleoperation + open robot data + internet image-text pre-training
                         ↓
          Weighted cross-embodiment data mixture
                         ↓
      Joint training of PaliGemma + π0 action expert
                         ↓
             Generalist π0 base policy
                  ↙                 ↘
        Direct language prompting        High-quality task post-training
                  ↘                 ↙
           Continuous action chunks across platforms
2 種類のアラインメントによって、異なるロボットを 1 つのモデルに収めます:
-
状態/アクションのアラインメント: 最大 18 次元までパディングします。より小さなロボットは末尾のゼロを使用します。18 次元あれば、2 つの 6 自由度アーム、2 つのグリッパ、モバイルベース、昇降可能な胴体を表現できます。
-
画像のアラインメント: 3 つの画像スロットを確保し、1 台または 2 台のカメラしか持たないロボットでは存在しないビューをマスクします。
言語ラベルには、完全なタスクと短いセグメントが含まれ、典型的には約 2 秒です。「ナプキンを拾う」「それをゴミ箱に捨てる」といったセグメント指示により、高レベルの VLM がテーブル片付けのような長いタスクを分解し、その物理的な実行を π0 が担当できます。
論文: サンプル数が のタスク–ロボットグループには重み が与えられます。このサブリニアな指数により、大量にサンプリングされた洗濯タスクのような非常に大きなグループの支配が抑えられます。
センサー、収集方法、および能力
データ構成
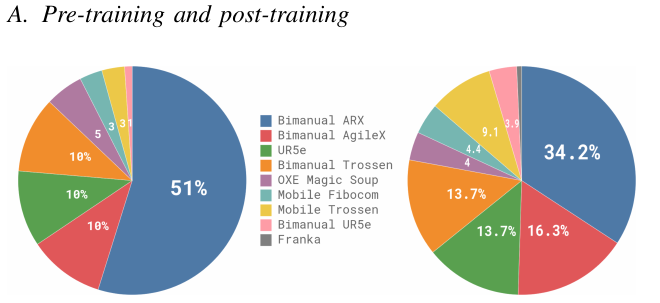
-
内部データは 903M タイムステップを含み、そのうち 106M が単腕ロボット、797M が両腕ロボットからのものです。
-
68 の大まかなタスクと 7 つのロボット構成をカバーしています。
-
オープンデータは混合全体の 9.1% で、OXE、Bridge v2、DROID を含みます。
-
オープンデータセットは通常、1 台または 2 台のカメラと 2–10 Hz の制御を持ちますが、対象物や環境の多様性は広範です。
-
論文では、ロボットデモンストレーションの合計を 10,000 時間超と要約しています。
-
タスクのポストトレーニングは、単純なタスクで約 5 時間から、最も難しいタスクでは 100 時間以上に及びます。
直接プロンプティング
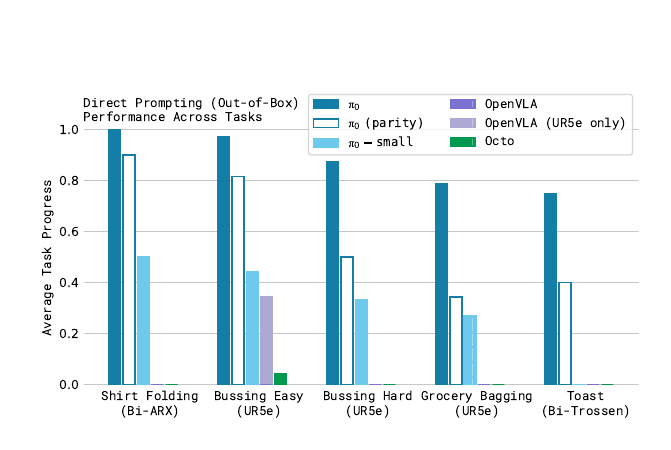
論文では、シャツ折りたたみ、簡単および難しいテーブル片付け、食料品の袋詰め、トースターからトーストを取り出すタスクについて、π0、OpenVLA、Octo、および VLM 初期化なしの π0-small を比較しています:
-
700k ステップで学習した完全な π0 は、5 つすべてのタスクで平均進捗が最も高くなります。
-
ベースラインと同程度の更新回数を持つ 160k ステップの π0 パリティモデルでも、依然としてそれらを上回ります。
-
π0-small は通常 OpenVLA と Octo を上回り、連続チャンクアーキテクチャ自体の価値を裏付けています。
-
完全な π0 は π0-small を大きく上回り、セマンティクスとタスク間制御に対する VLM 事前学習の利点を裏付けています。
注意: OpenVLA と Octo は、完全な π0 と同じエポック数では学習されていません。パリティ比較は計算資源の公平性を部分的には扱っていますが、フルモデルの比較は厳密には計算量が一致していません。
新しいタスクでのポストトレーニング
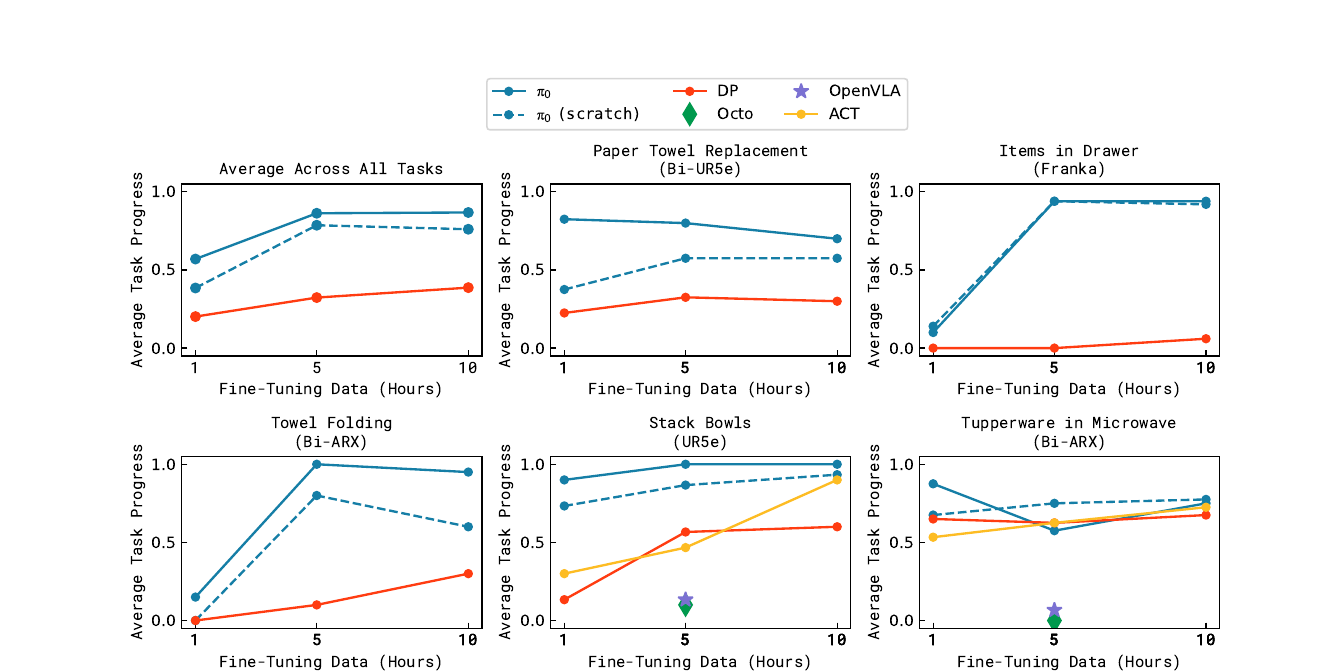
新しいタスクには、ボウル積み重ね、タオル折りたたみ、食品コンテナを電子レンジに入れる、ペーパータオルロールの交換、Franka での引き出しへの積み込みが含まれます。各手法はタスクごとに 10 試行の平均で評価されます:
-
π0 は、ゼロからの学習や他の手法と比べて、全体的にも個々のタスクのほとんどでも上回ります。
-
事前学習タスクに似ているタオル折りたたみとボウル積み重ねでは、より少ないデータで大きな進捗に到達します。
-
いくつかのタスクでは、事前学習によって、ゼロからの学習と比べて性能がほぼ 2 倍になります。
-
利得はすべてのデータスケールで単調に増加するわけではありません。電子レンジへの積み込みでは、5 時間設定はベースラインに近い一方、1 時間設定ではより大きな優位性が見られます。
複雑な長時間タスク
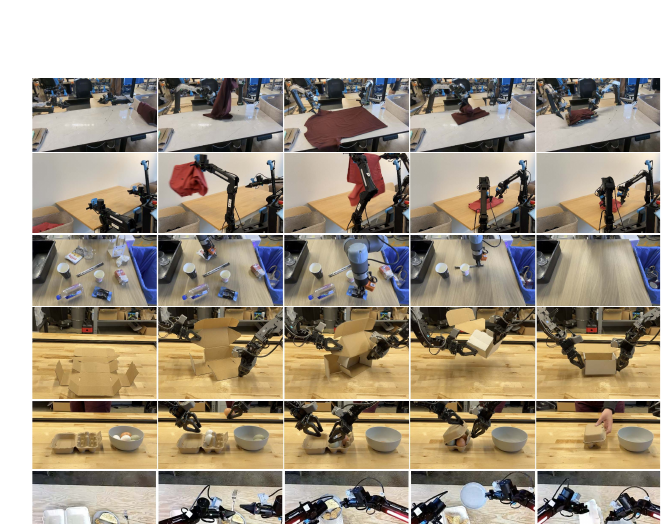
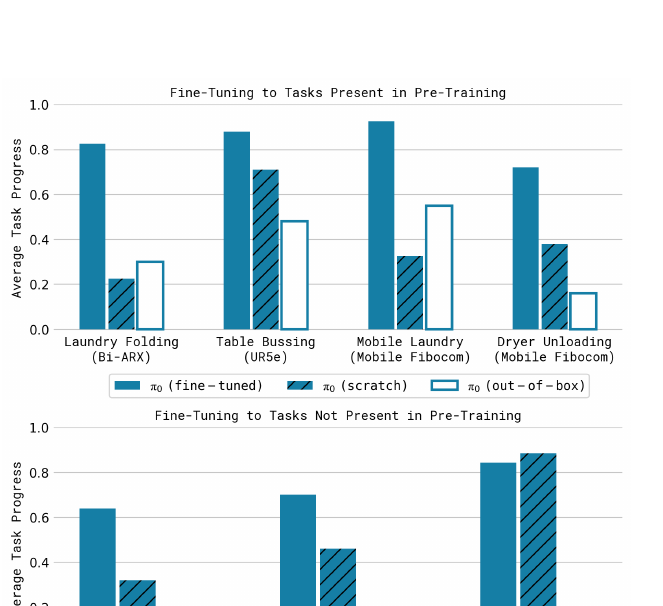
これらのタスクは約 5〜20 分続き、数十回の把持、積み重ね、広げる動作、折りたたみ動作を組み合わせます。事前学習とポストトレーニングを組み合わせることで、図示されたすべてのタスクで最大スコアの半分を超え、一般にゼロからの学習や事前学習ポリシーの直接利用よりも優れた結果となります。特に難しいタスクでその利点が顕著です。
エビデンスの限界: すべてのタスクが確実に解けているわけではありません。著者らはまだ、理想的な事前学習の混合比や、新しいタスクにどれだけ、どのような種類のデータが必要かを把握していません。自動運転、ナビゲーション、脚ロボットの運動といった、より遠いドメインへの転移は未検証です。「ジェネラリスト」という表現は、ここで研究されたタスクとマニピュレーションプラットフォームを指しており、任意のロボットや環境を意味するものではありません。
π0: Action Expert と Conditional Flow Matching を備えた VLA
アクションチャンク化: 将来 50 ステップを生成
π0 は のみではなく、アクションチャンクをモデル化します:
チャンク化は次の 2 つのニーズに対応します:
-
高頻度出力の効率: 1 回の推論で、各アクション次元ごとにトークンを自己回帰的にデコードすることなく、50 個の制御点を生成します。
-
軌道の一貫性: チャンク全体をまとめてモデル化することで、連続アクション間の依存関係を表現します。
の場合、これは単一ステップ予測に帰着します。大きな を完全なオープンループで実行すると、新しい観測への反応が遅くなります。π0 は を予測しますが、再度観測する前に 16 または 25 ステップだけ実行し、推論オーバーヘッドとフィードバック頻度のバランスを取ります。
18 次元へのパディングは学習インターフェースです。各ロボットのコントローラには、そのロボットに有効な次元だけが送られます。
Conditional Flow Matching: ノイズから連続アクションへ
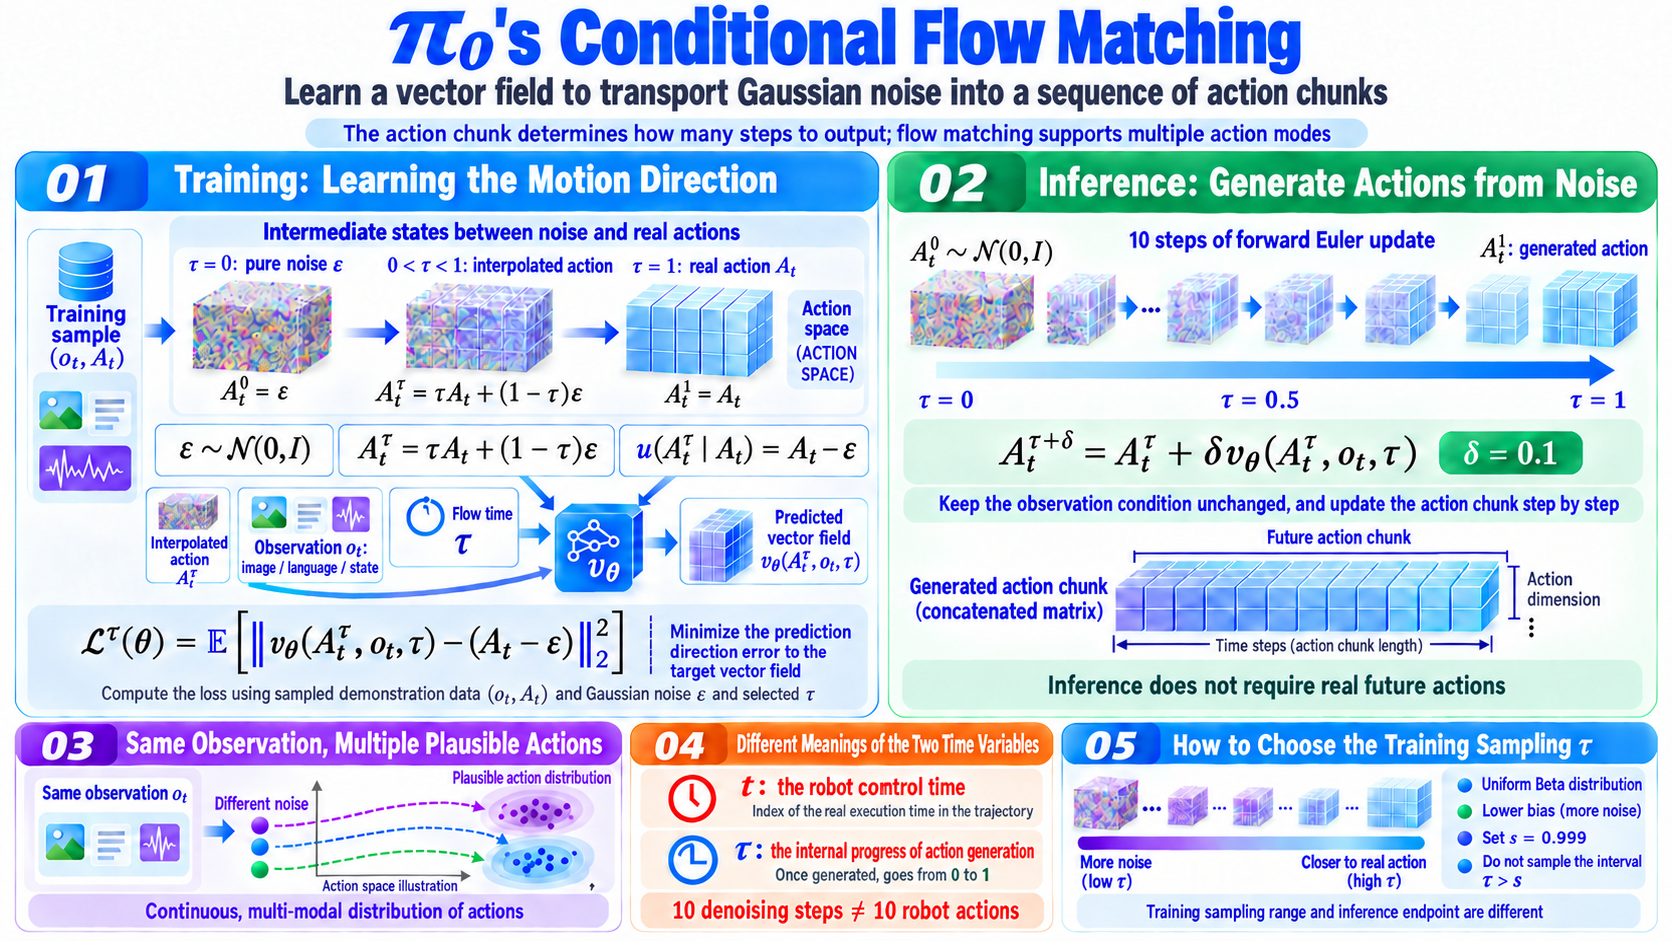
プラットフォーム差を消さない共有インターフェース
ロボットはカメラ台数、状態次元数、アクション次元数とその意味が異なります。π0 は固定サイズのスロットを使用します:
-
最大 3 枚の画像で、欠けているビューはマスクします。
-
状態とアクションは 18 次元までパディングします。
-
画像、言語、状態、デモンストレーションされたアクションに条件付けられた Transformer が、ロボットとタスクの組み合わせにまたがる関係を学習します。
これは、アクション次元 がすべてのロボットで同じ物理量を意味することを強制するものではありません。固定インターフェースを提供しつつ、モデルが観測、状態分布、データからプラットフォーム固有の振る舞いを学習します。
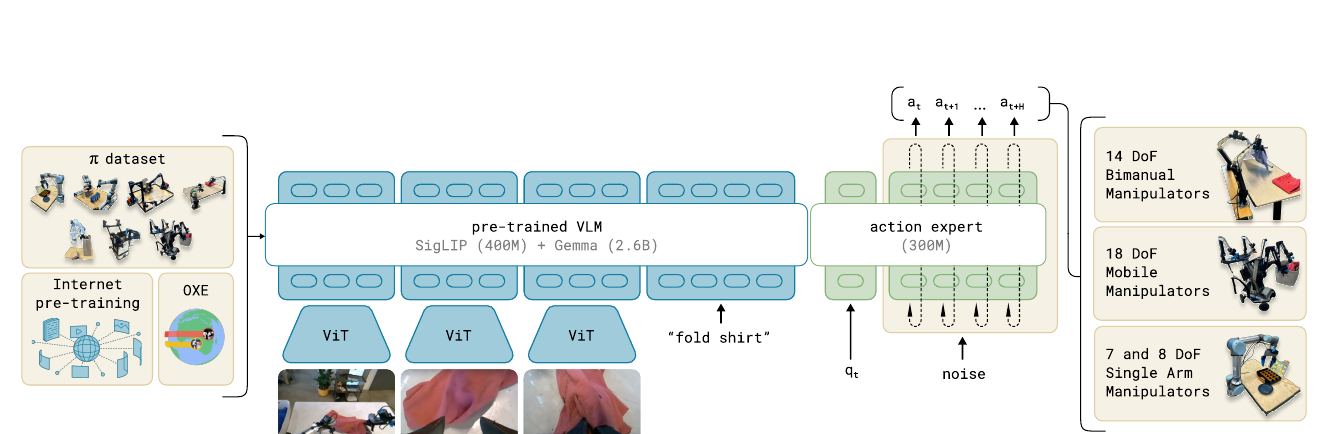
2 つのエキスパートが異なるモダリティを処理します:
-
VLM バックボーン: 画像と言語トークンを処理し、PaliGemma のインターネット規模の事前学習を継承します。
-
Action Expert: ロボット状態 とノイズ付きチャンク を処理し、連続制御に特化します。
重みは分離されていますが、Transformer の自己注意を通じて情報をやり取りします。そのため、VLM 全体をアクション専用ネットワークに変換することなく、アクションは言語や画像に依存できるようになります。
事前学習とポストトレーニングの統合
完全な π0 ネットワーク
画像と言語の入力
PaliGemma の SigLIP エンコーダは各 RGB 画像を視覚トークンに変換し、トークナイズされた指示はそれらとともに大きな VLM エキスパートに入力されます。アーキテクチャ図では、おおよそ 4 億の SigLIP パラメータと 26 億の Gemma パラメータが要約されています。
注意: PDF には、統一された入力画像解像度や、画像ごとの正確な視覚トークン数は記載されていません。ここでは、それらの次元を一般的な PaliGemma 構成から推測していません。
ロボット状態
状態 は線形射影によって Transformer の埋め込み幅に変換され、アクションエキスパートに別個の状態ブロックとして与えられます。
ノイズ付きアクションとフロー時間
チャンクには 個のアクショントークンがあります。各ノイズ付きアクション は、MLP を通じて正弦波フロー時間エンコーディング と結合されます:
これらの埋め込みがアクションエキスパートに入力されます。ネットワークは 50 個のアクション位置の出力を読み取り、それらを線形射影してベクトル場 に変換します。
最大アクションテンソルは です。各ロボットの有効な次元のみが使用され、パディングはアクチュエータには送られません。
デュアルエキスパート Transformer
-
PaliGemma バックボーン:約 30 億パラメータ。
-
追加のアクションエキスパート:約 3 億。
-
合計:約 33 億。
-
VLM エキスパート:幅 2048、18 層、MLP 幅 16,384。
-
アクションエキスパート:幅 1024、MLP 幅 4096。これにより、10 回のフローマッチング順伝播の計算コストを削減します。
エキスパートは別々の重みを使用しますが、それぞれのトークンは各層の自己注意機構内で相互作用します。これは 2 分岐の mixture of experts に類似しており、画像/言語トークンは VLM の重みに、状態/アクショントークンはアクションエキスパートの重みにルーティングされます。
ブロックアテンションマスク
入力シーケンスには 3 つのブロックがあります:
[Images, language] → [Robot state] → [Noisy action chunk]
アテンションは各ブロック内では双方向です。前のブロックは後のブロックを読むことができず、後のブロックは前のコンテキストを読むことができます。これにより、PaliGemma の事前学習分布からの変化を抑えつつ、画像、言語、および状態のキー/バリューを 10 回の積分ステップにわたって固定してキャッシュし、アクションのサフィックスのみを再計算できるようにします。
学習損失
条件付きフローマッチングは、デモンストレーションされたアクションとノイズから構成される予測ベクトル場とターゲットベクトル場の間の平均二乗誤差を最小化します。これは、単一の一意なアクションを回帰するのではなく、ノイズからもっともらしい連続アクションの分布への条件付き輸送を学習します。
完全なデータフロー
Training:
Multi-view images + language + robot state + demonstrated 50-step actions
→ Sample ε and τ; construct a noisy chunk
→ Images/language enter the VLM; state/actions enter the action expert
→ Predict the action vector field
→ Compute flow-matching loss against the target field

Inference:
Multi-view images + language + robot state + random action noise
→ Cache the observation prefix
→ Run ten Euler integration steps with the action expert
→ Obtain a 50-step continuous chunk
→ Execute 16 or 25 steps, depending on platform
→ Observe again and generate the next chunk

In one sentence:
PaliGemma interprets what is visible and what the user wants; the expert turns that understanding into continuous high-frequency control.
Chunking provides efficient, coherent trajectories; flow matching models continuous multimodal actions.
Cross-embodiment pre-training supplies broad experience, and high-quality post-training shapes skilled, stable task execution.