π0.5: 共同学習はどのようにオープンワールド汎化を支えるか
π0.5: オープンワールド汎化を備えた Vision-Language-Action モデル
- オープンワールド汎化
- 異種データ
- 階層型制御
- 共同学習
前提知識
ロボットはどのようにデモから学習するか
説明: 模倣学習では、人間の操作を記録したデータを用いて、ある指示のもとで特定のシーン内をどのように動くかを学習します。
VLA は画像、タスク文、ロボット状態を受け取り、制御行動を出力します。「皿をシンクに入れて」の場合、画像は皿の位置を特定し、状態はアームを記述し、指示は目標を定義し、行動は把持と配置を制御します。
π0.5 はさらに、「皿を持ち上げる」のような短いサブタスクも予測し、それに基づいて行動生成を行います。
直接行動からサブタスク選択へ
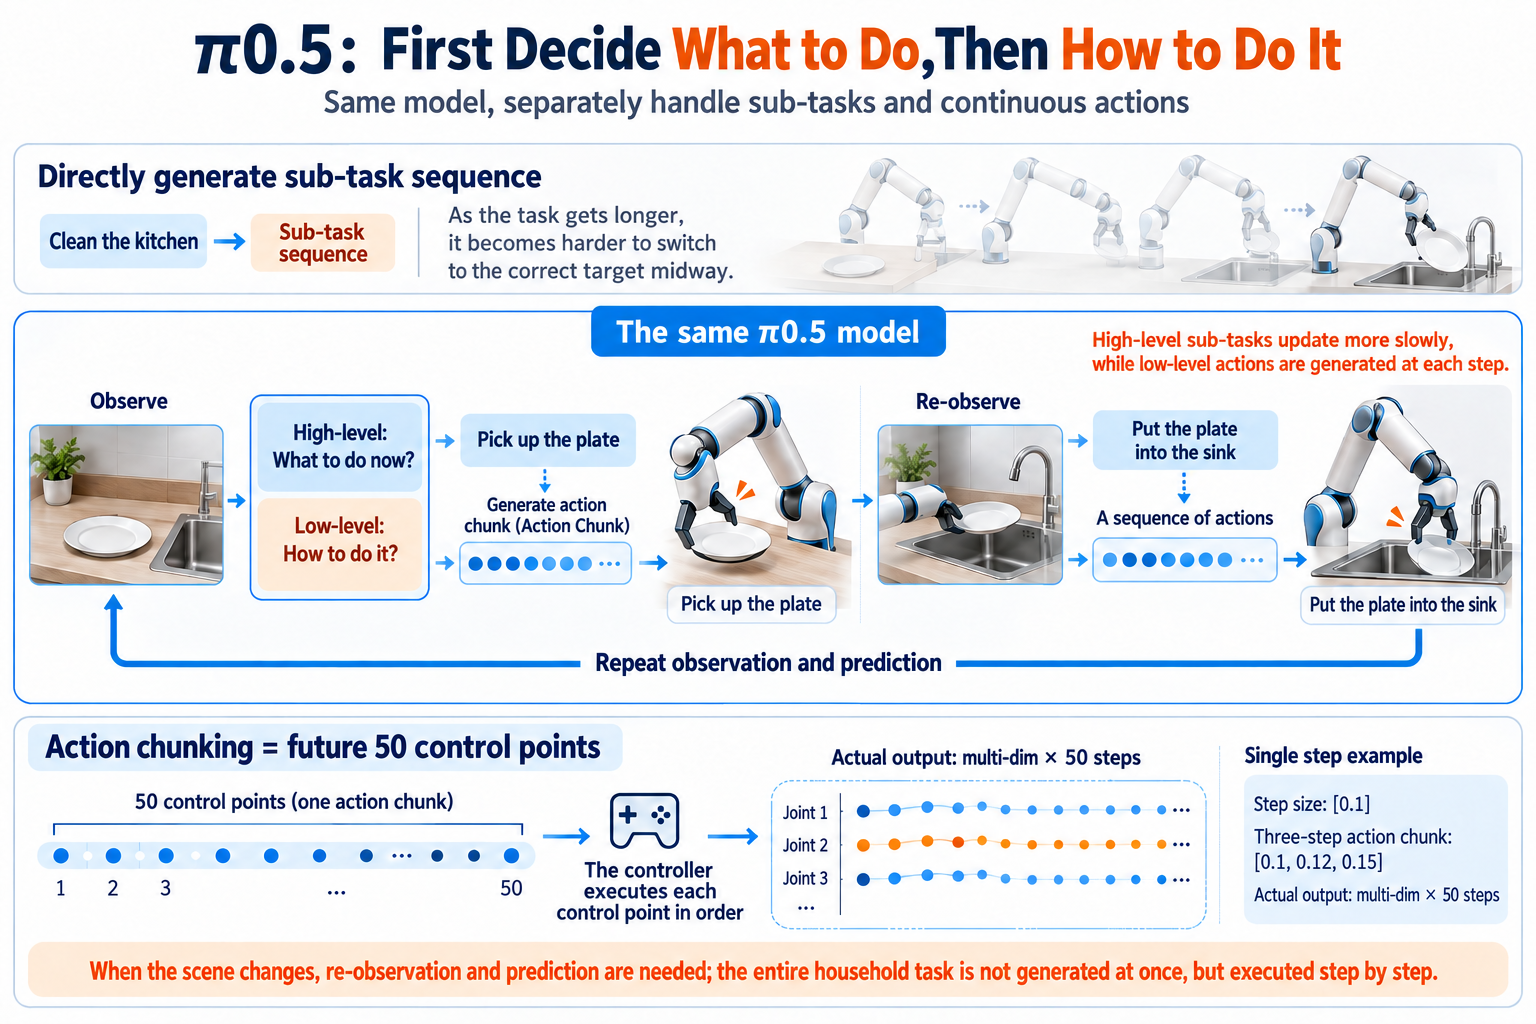
「キッチンを片付ける」を関節の動きに直接マッピングすると、「何をするか」と「どう動くか」の決定が混ざってしまいます。タスクが長くなるほど、遷移は難しくなります。
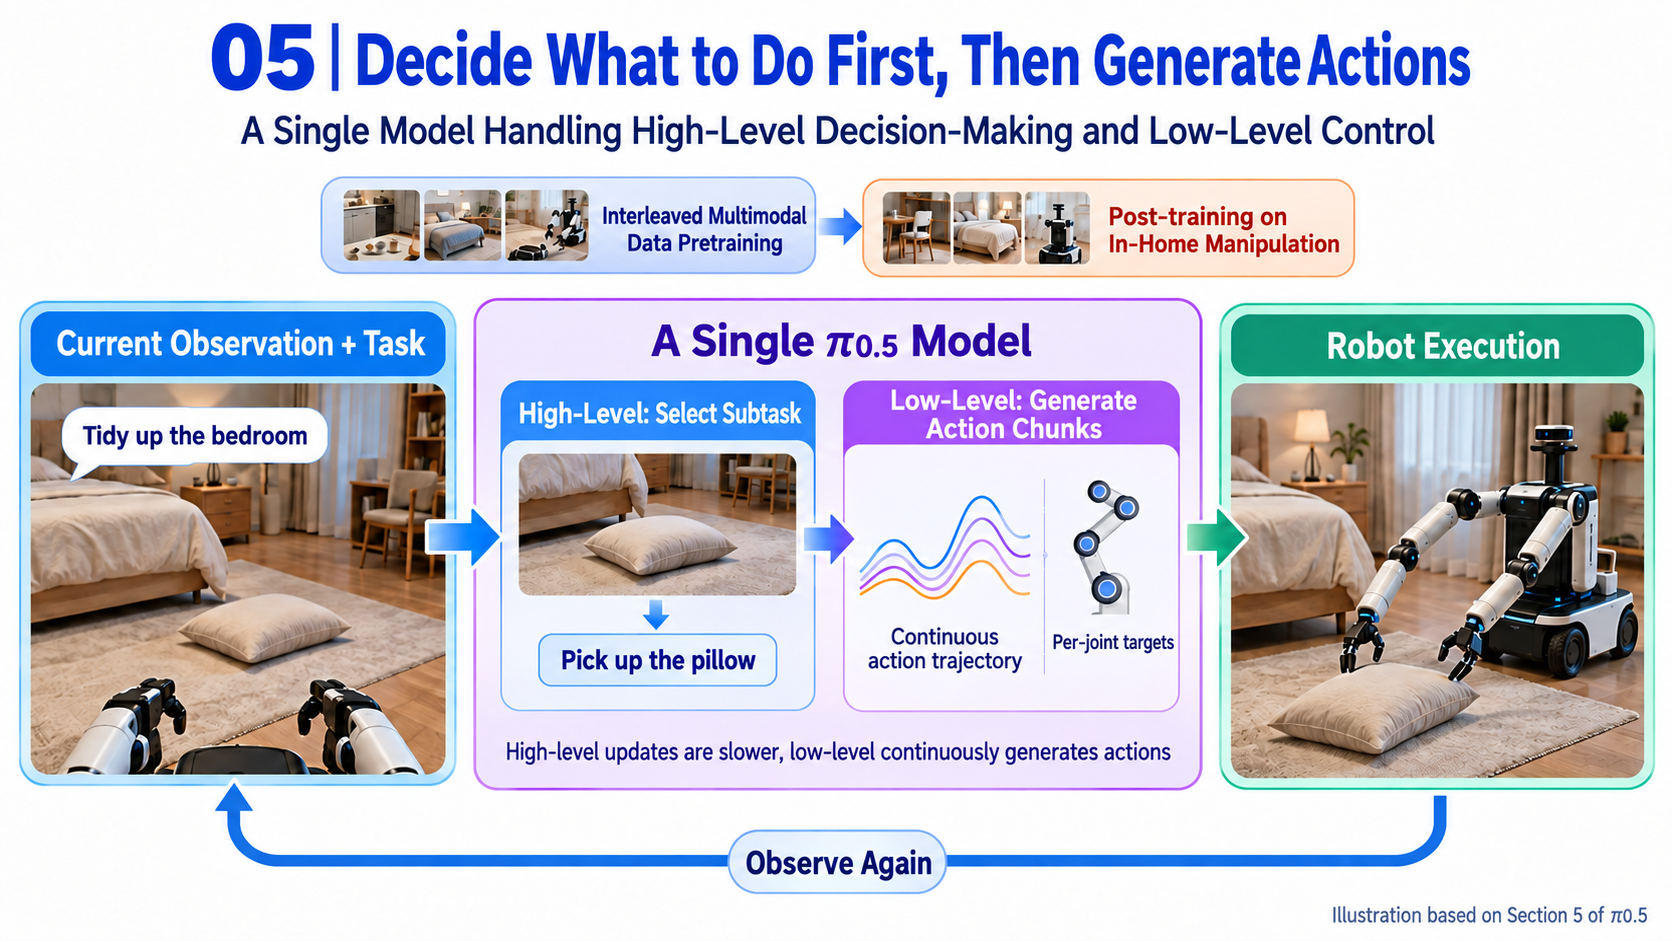
π0.5 は同じモデルの中でこれらの決定を分離します。まず現在のサブタスクを選択し、その後に連続行動を生成します。例えば次のようになります:
Clean the kitchen → Pick up the plate → Grasping action chunk
Observe again → Put the plate in the sink → Transport action chunk
論文: 各予測は将来の 50 ステップ分の制御点、すなわちアクションチャンクをカバーします。高レベルのサブタスクはよりゆっくり更新され、低レベルはそれに条件付けられたチャンクを生成し、コントローラが制御点を順に実行します。
例: ある関節は単一ステップの目標 [0.1] を持つ場合もあれば、3 ステップのチャンク [0.1, 0.12, 0.15] を持つ場合もあります。実際の出力は多次元で 50 ステップ長です。ロボットは依然として新しい観測と予測を必要とし、家事タスク全体が一度に生成されて盲目的に実行されるわけではありません。
学習、推論、評価
| 段階 | 何が起こるか |
|---|---|
| 学習 | デモ、サブタスクアノテーション、画像テキストデータからテキストと行動の出力を学習し、その後、家庭内モバイルマニピュレーション向けに適応させる。 |
| 推論 | 現在の画像と全体の指示からサブタスクを選択し、そのサブタスクと状態から連続行動を生成する。 |
| 評価 | ホールドアウトされた部屋で実行し、完了したステップをスコア付けする。別途、要求された物体と目的地が選択されているかをテストする。 |
学習誤差が低いことは、家庭内作業の成功を保証しません。それには実機ロボットでの試行が必要です。
要約
翻訳
実用的なロボットは、研究室の外で実際のタスクをこなさなければなりません。VLA は強力な直接制御能力を示していますが、未知の実環境への適応は依然として未解決の課題です。
π0 を基盤として、π0.5 は異種タスクと異種ソースに対する共同学習によって適応性を高めます。複数のロボット、高レベルの意味予測、Web データを用います。サンプルは、画像、指示、物体検出、サブタスク予測、低レベル行動を組み合わせたものです。
実験は、これらの知識ソース間の転移が汎化に重要であることを示唆しています。著者らは、まったく見たことのない家で長時間かつ巧みなキッチンおよび寝室の片付けを行う、エンドツーエンド学習システムを記述し、この能力の組み合わせを備えた最初のシステムだと主張しています。
コメント
-
中心的な問いは、別の家でもロボットが動作するかどうかです。 学習用の部屋で皿を持ち上げることと、皿を見つけ、次のステップを選び、見慣れないキッチンのシンクに置くことは異なります。
-
ソースは異なる目的を持ちます。 他のロボットはマニピュレーション経験を提供し、画像テキストデータは物体やシーンの知識を提供し、サブタスクアノテーションはタスクの構成方法を教えます。
-
「最初」というのは著者の主張です。 その表現を、あらゆる家事タスクを解決した証拠として受け取るのではなく、評価範囲や比較内容を見て判断すべきです。
序論
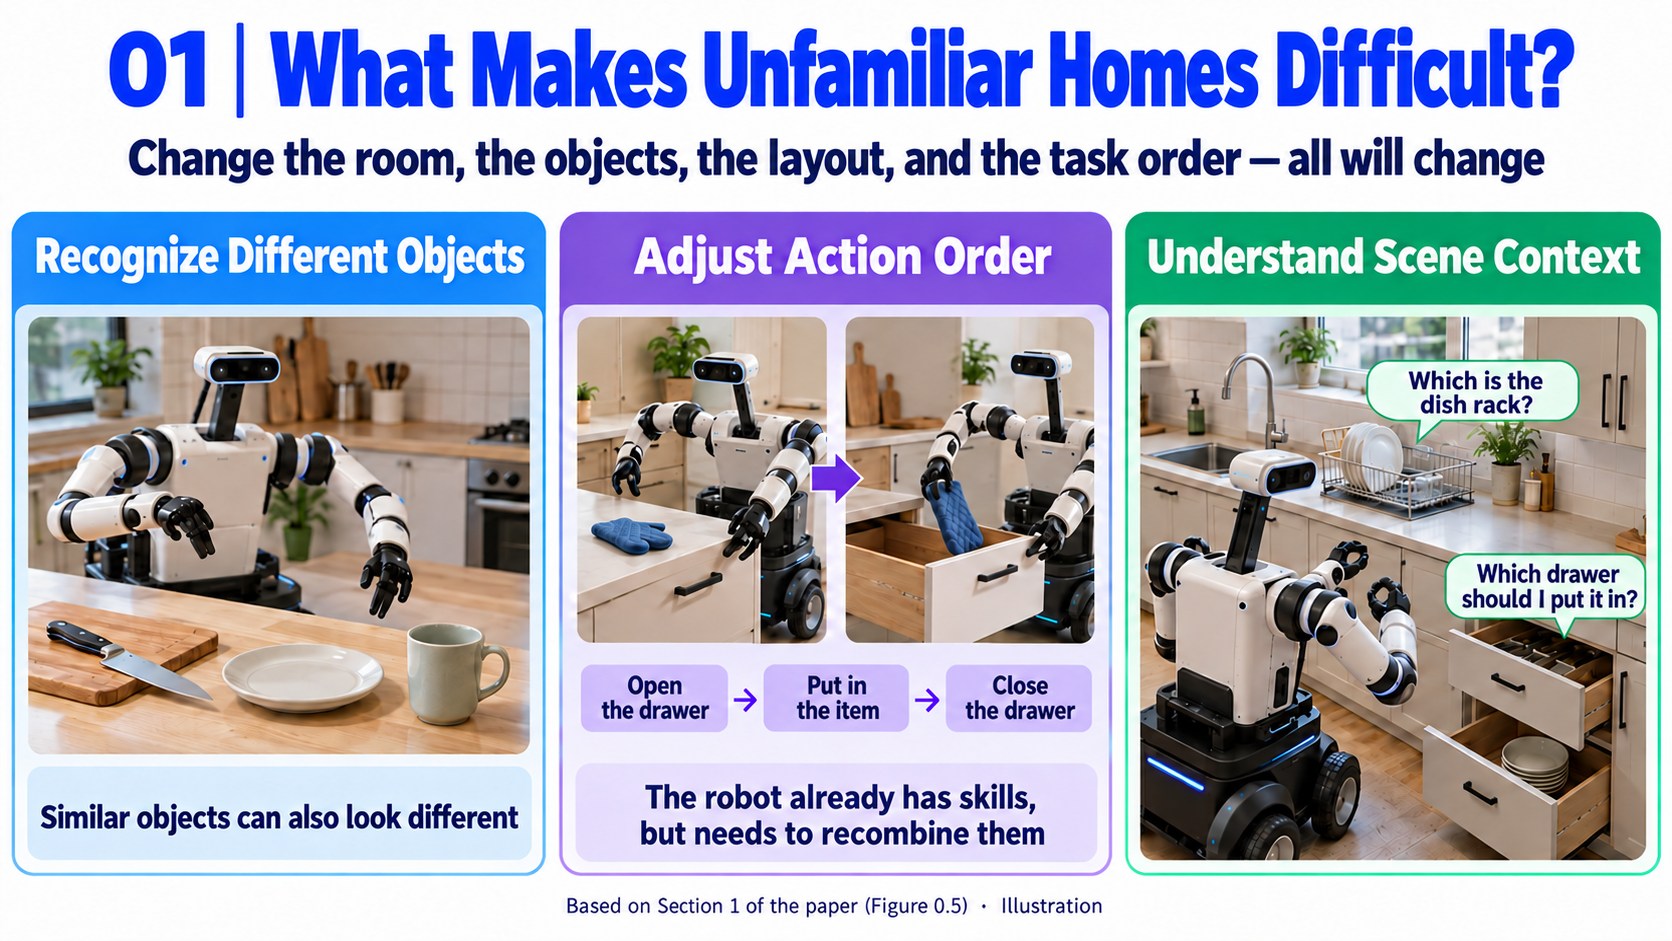
第 1 段落: 不慣れな環境は難しい
-
内容: 研究室の外では、ロボットは異なる物体、スキルの順序付け、シーンの用途に直面します。
-
問題: 固定されたシーンでの成功だけでは、現実世界には不十分です。
-
前提: 学習レシピは、複数レベルの能力をカバーする必要があります。
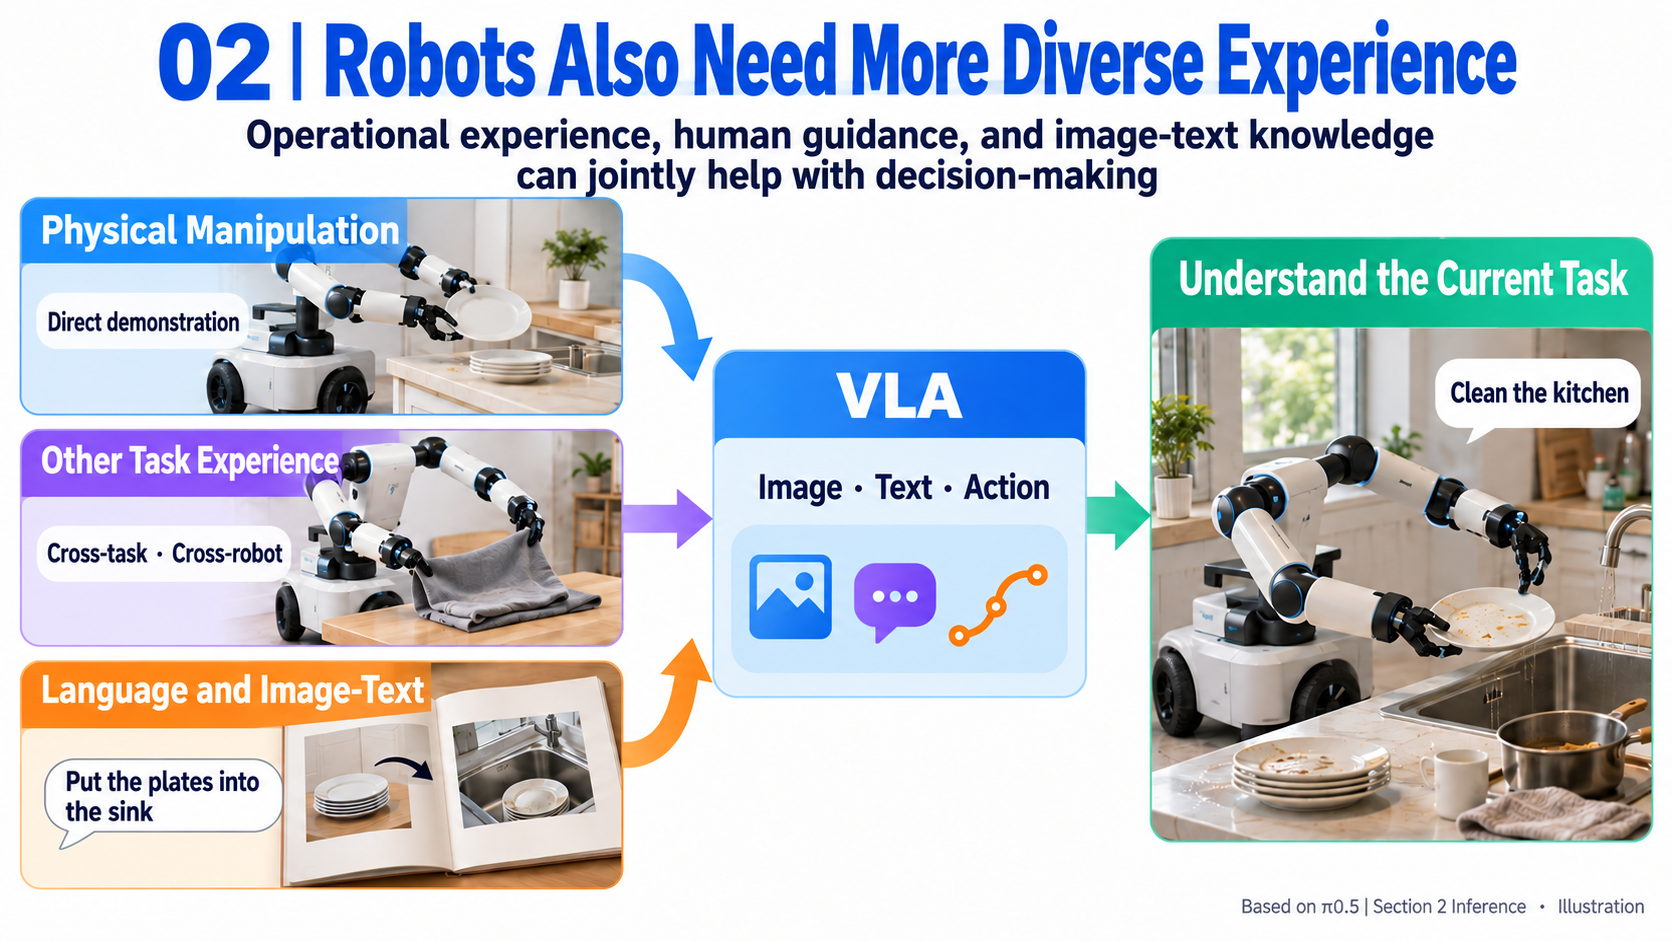
第 2 段落: なぜ異なる経験を使うのか?
-
内容: 人は直接の経験、他者から得た知識、他のタスクからの教訓を組み合わせます。ロボットも複数のソースを使うべきです。
-
問題: 対象ロボットのデモだけでは、あらゆる現実世界の状況を網羅できません。
-
前提: VLA は画像、テキスト、行動のための共通インターフェースを提供します。
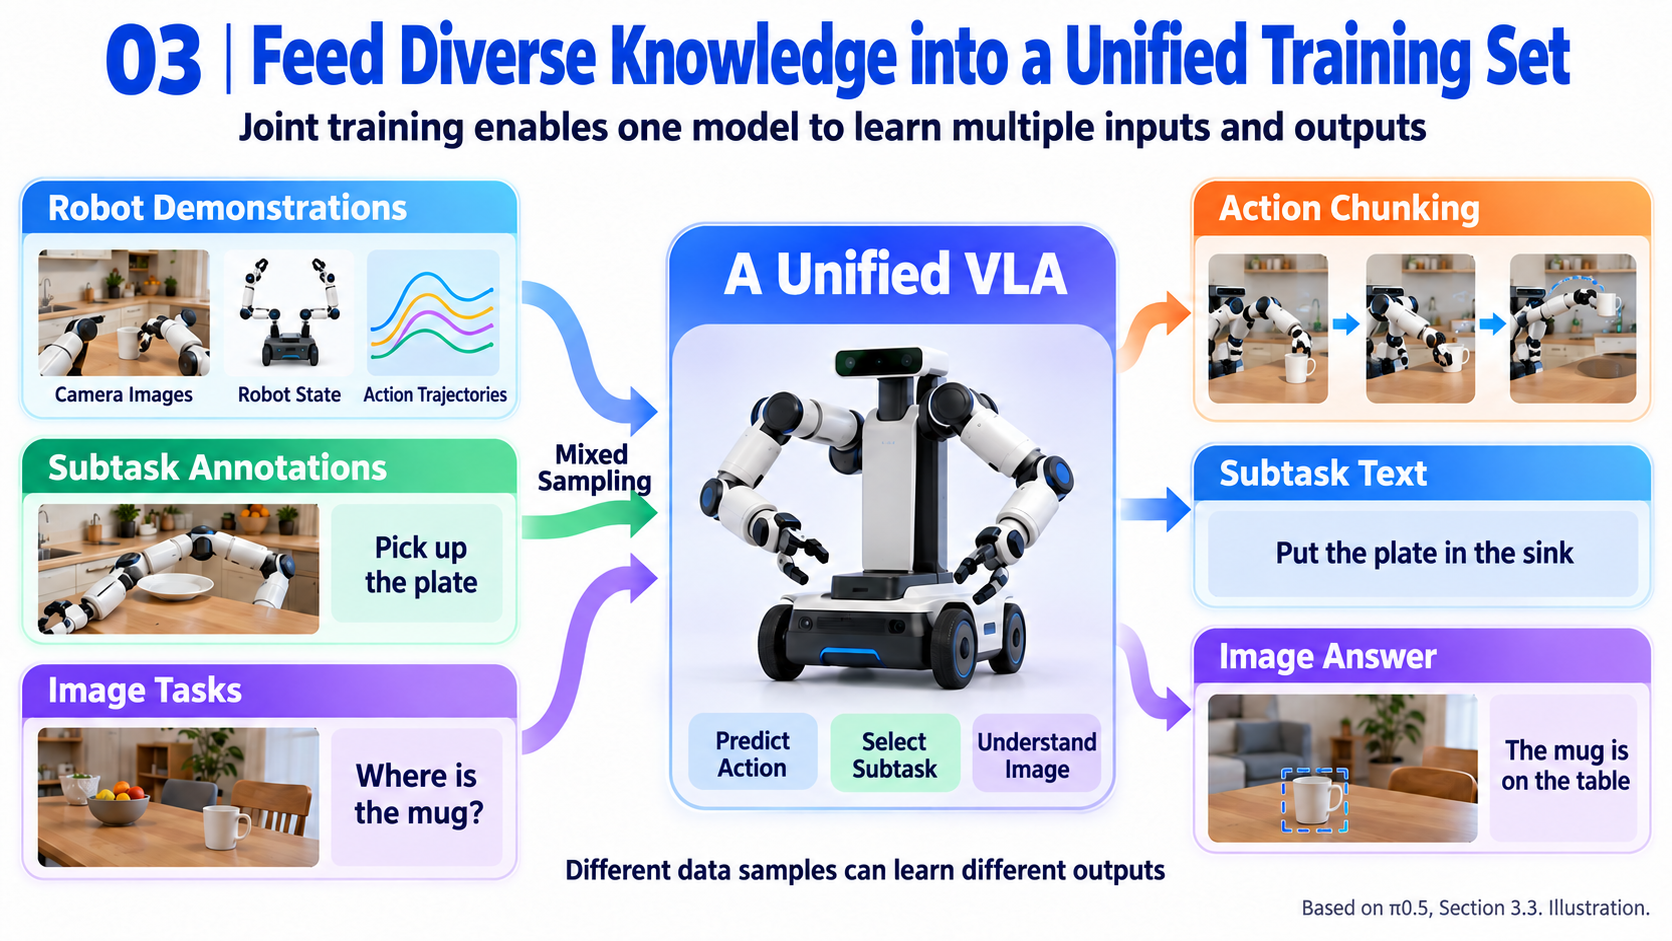
第 3 段落: 共同学習フレームワーク
-
内容: 著者らは、異なる種類とソースの知識に対して VLA を共同学習することを提案します。
-
問題: これまでの動機付けを、具体的な研究アプローチに落とし込むこと。
-
前提: π0.5 とそのデータ構成を紹介します。
第 4 段落: データレシピ
-
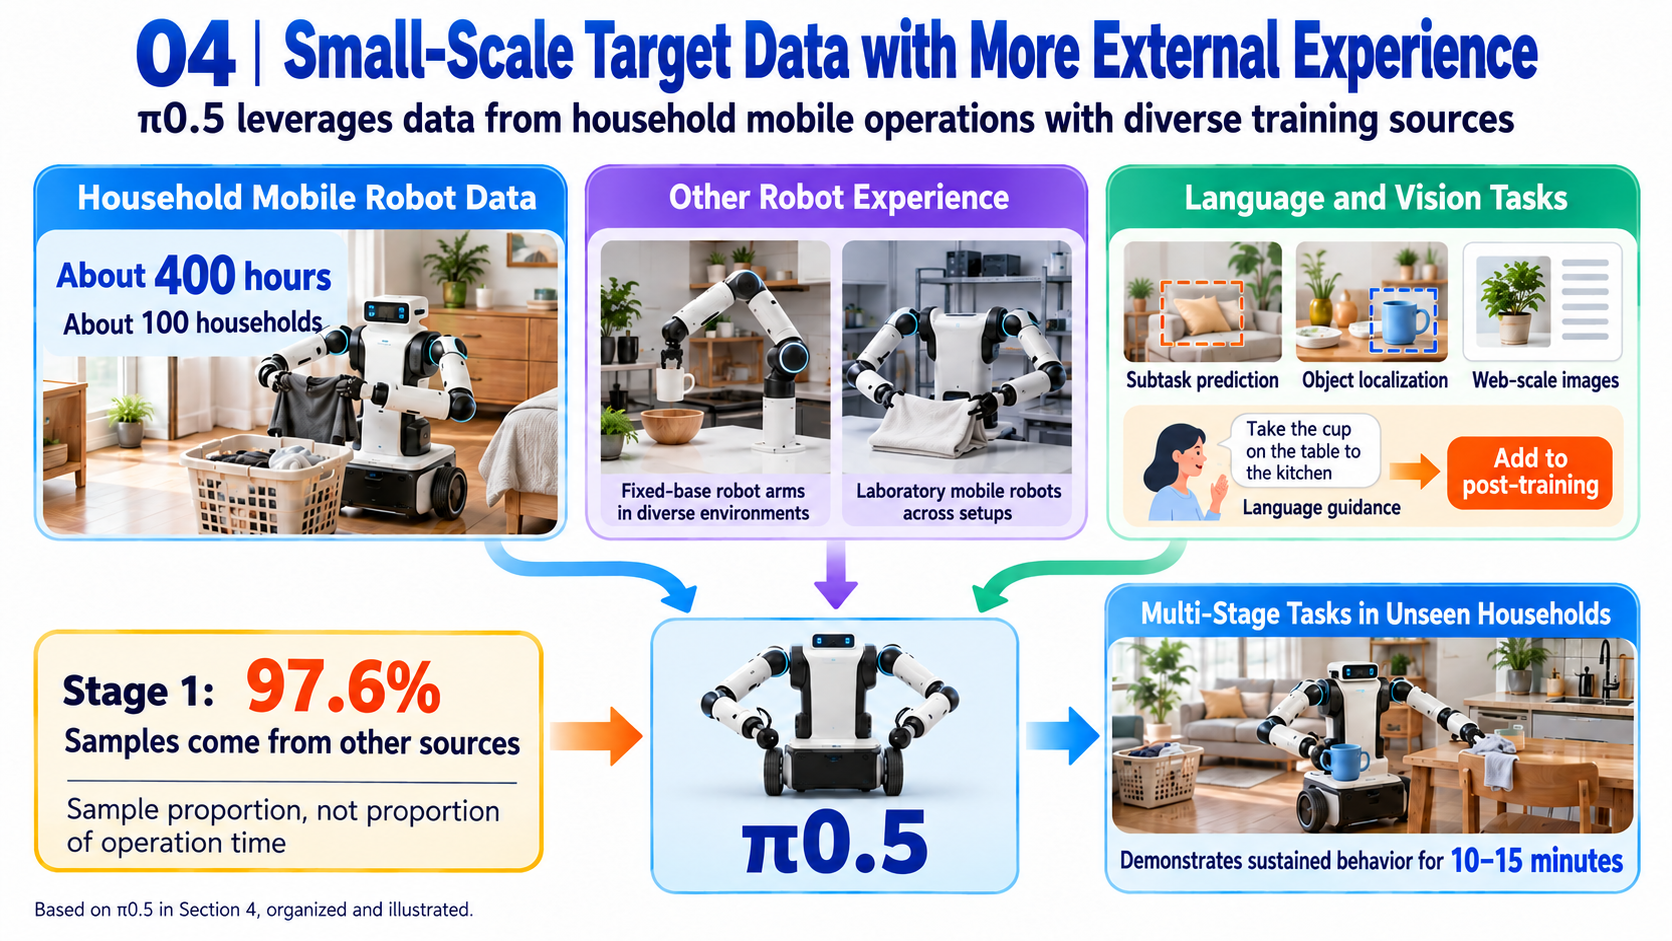
内容: π0 を拡張し、約 400 時間の家庭内モバイルロボットデータに加えて、他のロボットや画像テキストタスクを用います。ステージ 1 では、学習サンプルの 97.6% が対象の家庭内モバイルマニピュレーションデータ以外から来ています。
-
問題: これらのソースはどのように協調して対象ロボットを助けられるのか?
-
前提: 見慣れない家で 10〜15 分の振る舞いを実演し、その後ソースをアブレーションします。97.6% という数字は時間ではなくサンプルの比率です。
第 5 段落: 階層的実行
-
内容: 異種データでの事前学習の後、モバイルマニピュレーション向けにポストトレーニングします。同じモデルがサブタスクを選択し行動を生成しますが、高レベルの更新はより低頻度です。
-
問題: 長いタスクには、正しい次のステップの選択と精密な実行の両方が必要です。
-
前提: 異なるソースがどのようにシーン判断と制御を支えるかを説明します。
第 6 段落: 貢献と検証
-
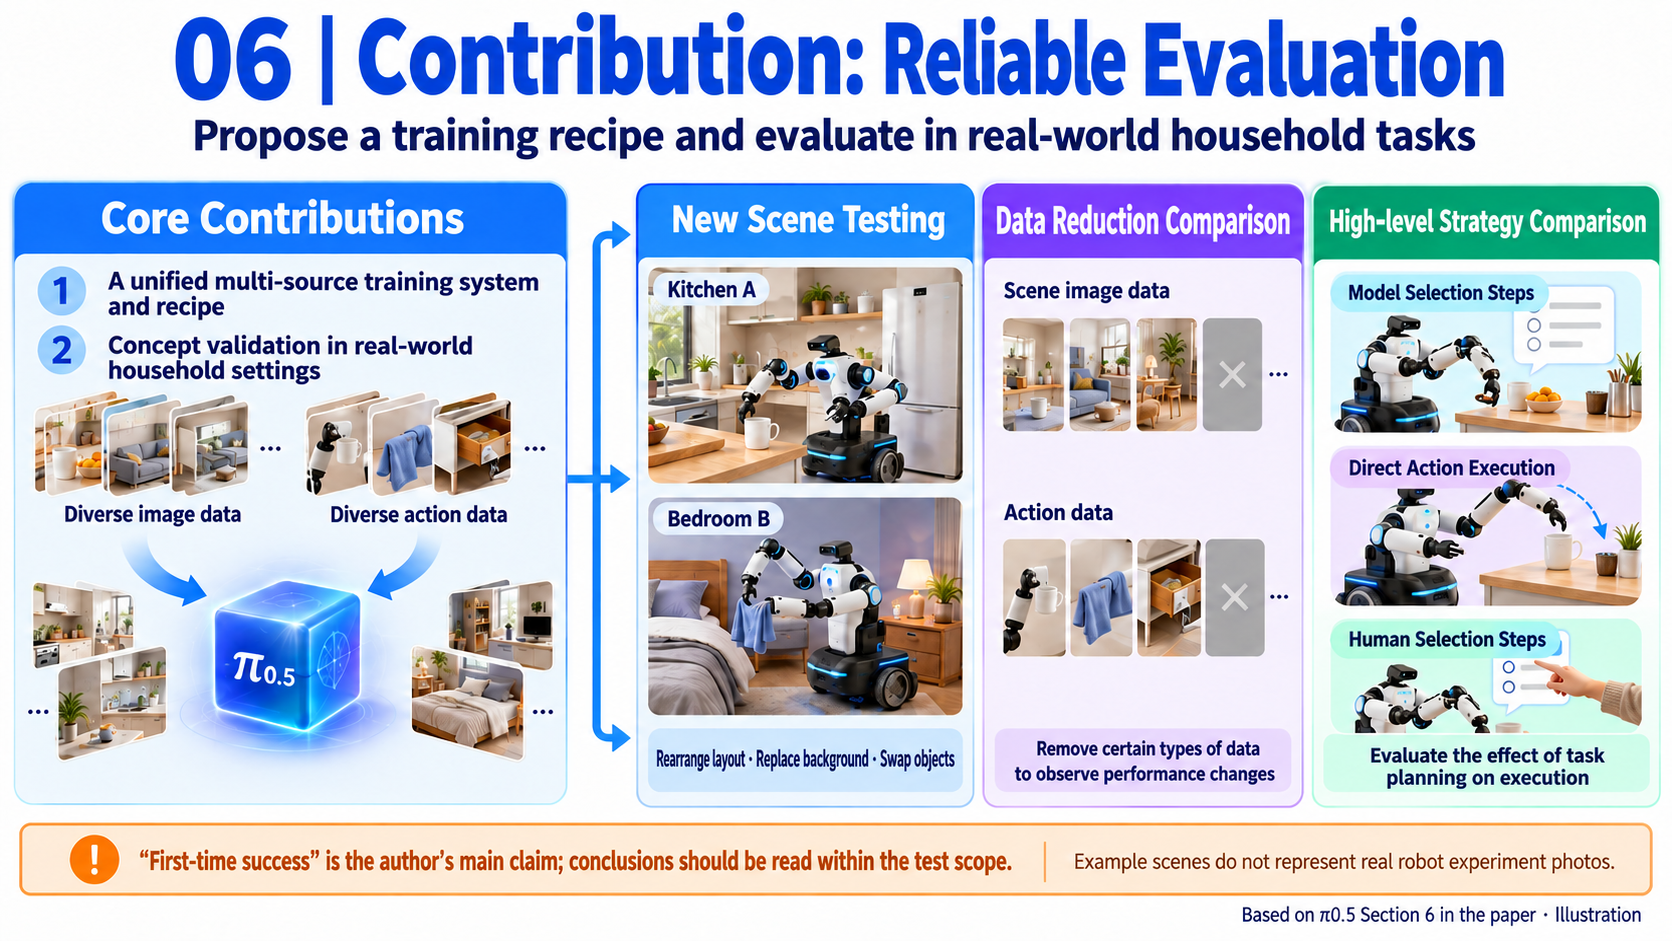
内容: 貢献は、未知の家での概念実証を伴う π0.5 システムとその学習レシピです。
-
問題: 実験によって、共同学習が実際に適応性を向上させるかどうかを示す必要があります。
-
前提: 新しいシーンでテストし、データソースを削除し、高レベルポリシーを比較します。「最初」という表現はあくまで著者の主張にとどまります。
関連研究
-
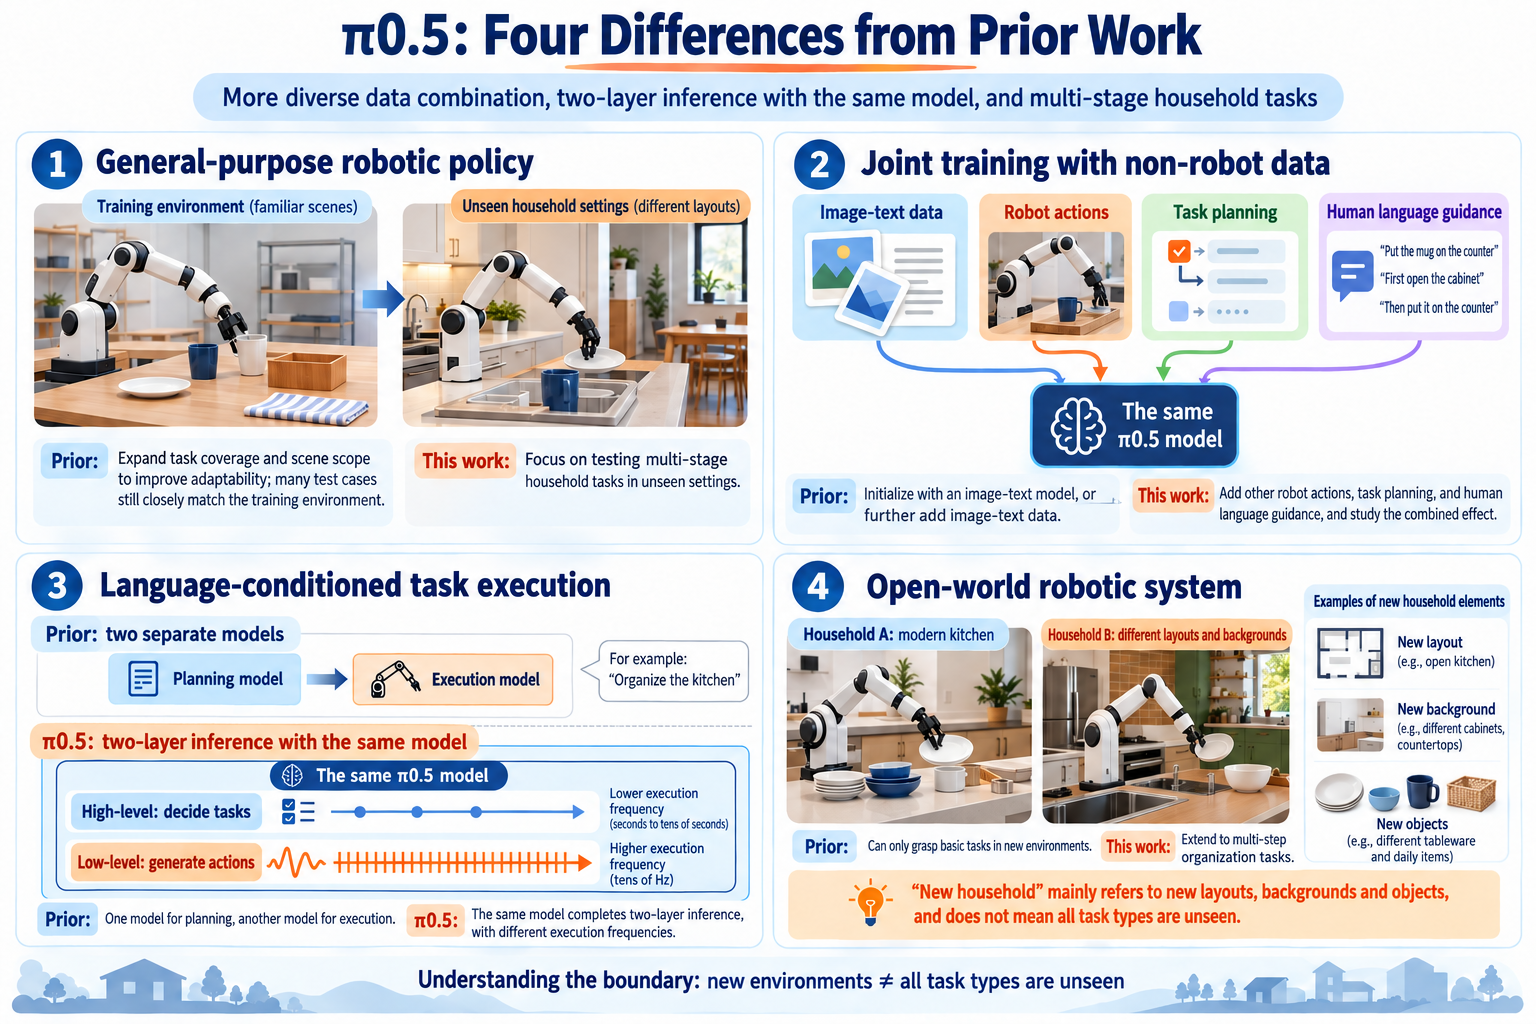
汎用ロボットポリシー: 先行研究はタスクとシーンのカバレッジを広げていますが、多くのテストは依然として学習条件に近い設定にとどまります。本論文は、見慣れない家でのマルチステージ家庭内タスクを強調しています。
-
非ロボットデータとの共同学習: 先行研究では、画像テキストデータから初期化したり、そのデータで学習を継続したりします。本研究では、他ロボットの行動、サブタスク予測、人間の言語によるガイダンスを組み合わせて評価します。
-
言語ベースのタスク構成: 一般的な設計では、計画モデルと実行モデルを分けます。π0.5 は両レベルに同じモデルを用いますが、実行頻度は異なります。
-
オープンワールドシステム: 先行ロボットは、新しい環境での把持などの基本タスクを実行します。本研究はマルチステップの片付けへと拡張します。新しい家とは、まったく新しいタスクカテゴリではなく、主に新しいレイアウト、背景、物体を意味します。
ロボットおよびデータプラットフォーム
目標と構成要素
論文: 2 台の移動型両腕プラットフォームを使用し、さまざまな家庭を片付けて掃除できる 1 つのモデルを目指しています。
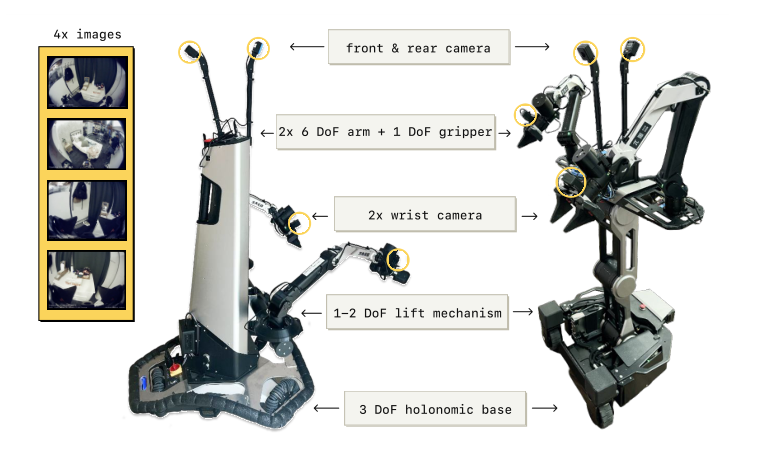
| コンポーネント | 構成と役割 |
|---|---|
| アームとグリッパ | 各アームにつき 6 自由度の動作と 1 つのグリッパ制御、合計 14 次元。 |
| 移動ベース | 並進 2 次元と回転 1 次元の速度、合計 3 次元。 |
| リフト機構 | 高さまたは前後調整のための 1 または 2 次元。 |
| 状態と行動 | プラットフォームに応じて 18 または 19 次元。 |
| カメラ | 4 つの RGB ビュー:前方、後方、2 つの手首。 |
出力はアーム、グリッパ、リフトの目標位置と、ベースの速度です。単純な PD コントローラがそれらを追従し、報告されているシステムには追加の軌道計画や衝突検出モジュールはありません。
説明: アームは操作を行い、移動とリフトは到達範囲を広げます。ハードウェアだけではタスク能力は確立されず、実験によって示されます。
操作と記録の接続
デモでは画像、状態、行動を記録します。複数ステップのタスクには、人間によるサブタスクと物体位置のアノテーションも付与されます。学習後には言語デモが追加され、専門家が次の指示を選び、すでに学習済みの低レベルポリシーがそれを実行します。
Expert selects “pick up the pillow” → Low-level policy executes → Record the images and chosen instruction
説明: これらの記録は、関節がどう動くかだけでなく、「次に何をするか」を直接教師ありします。低レベルポリシーがすでにサブタスクを実行できることを前提としています。運用時には、モデルが自分でステップを選択します。
センサ、収集方法、および能力
高レベルの判断には 4 つすべてのビューを使用し、低レベルの行動には前方ビューと 2 つの手首ビューを使用します。制御ターゲットは 50 Hz で実行されますが、これはフルモデルを 1 秒間に 50 回再実行することを意味しません。
約 400 時間の移動ロボットによるデモは、およそ 100 軒の家庭から収集されています。その他のソースには、据え置き型の家庭用アーム、研究室のロボット、OXE が含まれます。画像解像度、ソースごとのサンプリングレート、デモの長さは一様には指定されておらず、50 Hz の制御レートではそれらの空白を埋められません。
デモされた行動には、洗濯物の回収、食器の配置、引き出しの整理、ベッドメイキング、タオル掛けなどがあります。定量的な実家庭テストは、未知の 3 軒の家を対象に、引き出しへの収納、洗濯物をカゴへ入れるタスク、食器をシンクへ運ぶタスクに焦点を当てており、統制比較にはベッドメイキングも含まれます。
異種データの共同学習と階層的行動
まず現在のサブタスクを選ぶ
「寝室を片付けて」と言われても、今どれをつかむべきかは指定されていません。モデルはシーンを観察し、次のステップを選び、その選択に条件づけて行動生成を行う必要があります。
この関係は 2 つの条件付き関係で要約されます:
Current images + state + overall task → Subtask s
Current images + state + subtask s → Action chunk A
ここで s は「枕を拾う」のようなテキストで、A は制御シーケンスです。論文の因数分解では、低レベルの行動は全体の指示ではなくサブタスクに依存します。
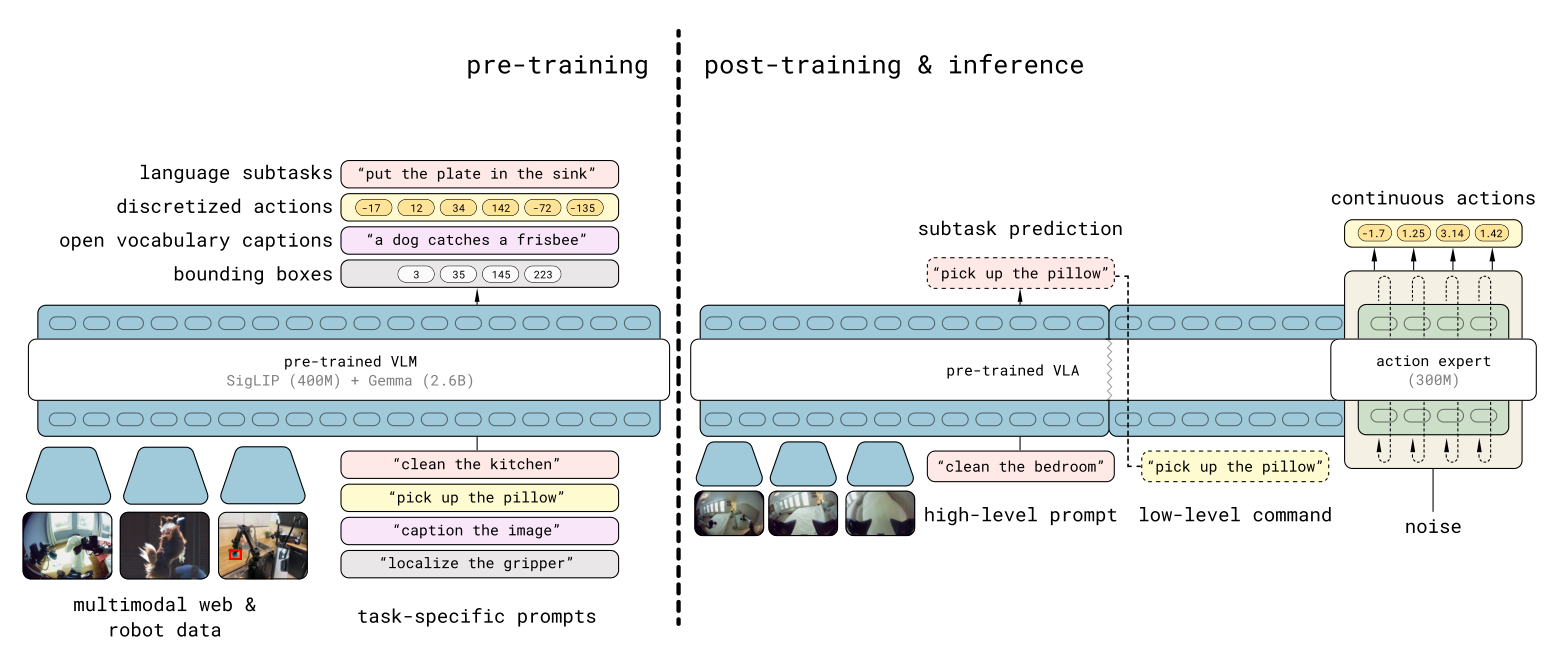
床にある枕は「拾う」という指示を促し、その後に「ベッドの頭側に置く」が続くかもしれません。高レベルの選択が誤っていると、動きが正確でも誤ったタスクを実行してしまいます。引き出しを何度も開け閉めするのが観測された失敗例の 1 つです。
学習には符号化された行動、実行には連続行動
モデルには効率的な学習とタイムリーで精密な制御が必要なため、各段階で異なる表現を使用します。
-
事前学習: FAST が連続行動を離散シンボルに圧縮し、テキストとともに次トークン予測で学習します。
-
事後学習: テキストと離散行動の予測を維持しつつ、flow matching で学習された行動エキスパートを追加します。
-
実行: サブタスクのテキストを自己回帰的に生成し、その後ランダム初期化から 10 回の更新で連続チャンクを得ます。
将来 50 ステップ分で各ステップ 18 制御の場合、コントローラが最終的に必要とするのはテキストではなく 50 × 18 の数値配列です。符号化された学習の後に連続制御を行うことは、段階間の重要な違いです。
説明: チャンク長は予測ホライズンを制御し、更新回数は内部の洗練度を制御します。単一ステップ予測にはチャンク内の計画性がなく、長いホライズンではシーン変化が増えます。論文では 50 個の制御点と 10 回の更新を使用していますが、すべてのロボットに対してそれが最適であることを体系的に示してはいません。
チャンクをまとめて生成しても、フィードバックの必要性はなくなりません。論文は、すべてのプラットフォームに共通する実行割合を示しておらず、ACT 風の時間的アンサンブル化が中核メカニズムというわけでもありません。
各データソースがもたらすもの
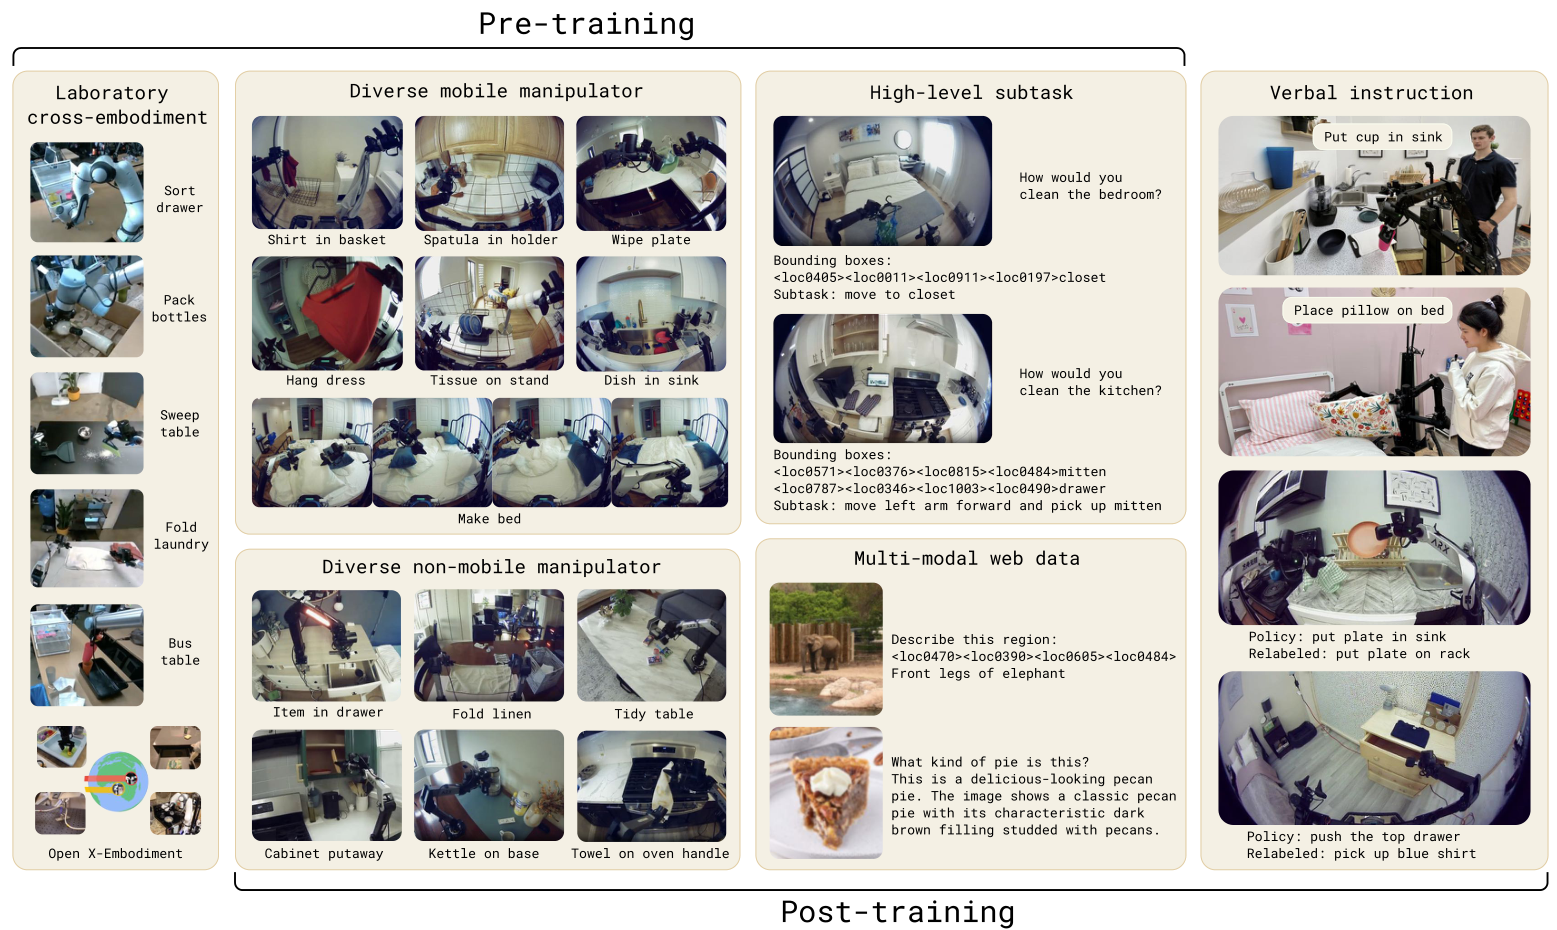
| データ | 学習機会 |
|---|---|
| 家庭内移動ロボットのデータ | 実際の家庭で、移動、リフト、両腕操作を組み合わせる。 |
| 環境をまたぐ据え置きアーム | より多くの家庭、物体、操作シーン。 |
| ロボット間をまたぐ研究室データ | より多くのスキルとタスク。 |
| サブタスクのアノテーション | 次のステップを選び、関連する物体を特定する。 |
| Web の画像テキストデータ | 認識、シーン理解、言語能力を維持する。 |
| 専門家による言語デモ | 既存の低レベルポリシーを多段階タスクで誘導する。 |
これらのソースは 1 つのモデルを学習させるために使われ、実行時にデータセットを切り替えながら動くわけではありません。サンプルごとに要求される出力は異なり、画像と質問と回答のペアには、ロボット行動をでっち上げる必要はありません。
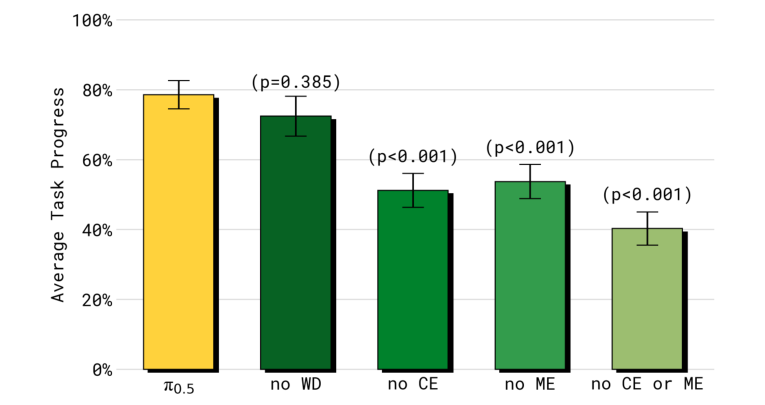
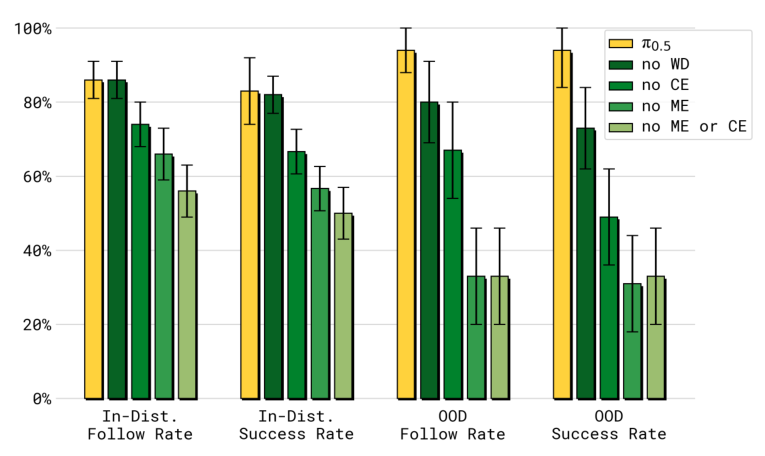
エビデンスの境界: 他ロボットのデータを除くと、統制された家庭内タスクでの性能が低下します。Web データを除いても、そのテスト群では統計的に有意な低下は見られませんが、未知の物体に対する指示追従や高レベル判断は悪化します。すべてのテストにおいて、各ソースが同じ重要度というわけではありません。
2 段階の学習をつなぐ
事前学習: PaliGemma から開始し、ロボット行動、サブタスク、物体位置、画像テキストタスクを 280,000 ステップにわたって混合します。この段階では連続エキスパートの学習損失は使用しません。
各データセットの各次元について 1 パーセンタイルと 99 パーセンタイルを用いて行動を [−1, 1] に正規化し、次元数の少ないロボットは 0 でパディングします。指示内の制御モードタグによって、関節ターゲットとエンドエフェクタターゲットを区別します。
事後学習: ランダム初期化された約 3 億パラメータの行動エキスパートを追加し、80,000 ステップ学習します。成功しタイムアウトしていない家庭内移動ロボットと据え置きアームのデモを保持し、ロボット間をまたぐ研究室の行動データは除去します。関連するサブタスクと Web データを保持し、専門家による言語デモを追加します。
目的関数は次のように要約できます:
総損失 = トークン予測損失 + 10 × 連続行動損失。
第 1 項はテキストと FAST トークンに対するクロスエントロピーで、第 2 項は行動更新方向の二乗誤差です。その重みは事後学習中は 10、事前学習中は 0 です。アテンションによって行動表現を分離し、連続エキスパートが FAST の行動解答を読めないようにします。
flow matching の学習では、実際の行動 A に標準ガウス雑音 ε を混ぜます:noisy action = τA + (1−τ)ε、ここで τ は 0 と 1 の間です。式 (1) ではターゲットを ε−A と書きます。A=0.6、ε=−0.2、τ=0.5 の場合、入力は 0.2、ターゲットは −0.8 です。これはベクトル場の符号規約であり、ロボットを後退させるコマンドではありません。
τ は内部の生成進行度であり、ε と A は正規化された 50 × d の配列で、d は行動の次元数です。これは秒数ではありません。このスカラー例は式を説明するためのものであり、学習では完全な配列を使用します。推論は雑音から開始し、真の A を必要としません。
ネットワーク全体、実験、および限界
論文: 画像は視覚特徴になり、指示と状態は VLM に入力されます。π0 と異なり、π0.5 は状態をテキストトークンとして離散化します。バックボーンはサブタスクを予測し、観測特徴をより小さなエキスパートに供給し、エキスパートはノイズの入った入力から連続行動を生成します。
| 入力またはモジュール | 形状または処理 |
|---|---|
| 画像 | 高レベルビュー 4 つ、低レベルビュー 3 つ;視覚特徴列としてエンコード。 |
| 全体指示、サブタスク、状態 | 視覚特徴とともに観測プレフィックスを構成するトークン列。 |
| VLM バックボーン | 幅 2048、18 層;テキストと、事前学習中は FAST トークンを予測。 |
| 行動エキスパート | 幅 1024、18 層、約 3 億パラメータ;ノイズの入った 50 × d 行動を線形埋め込み。 |
| 生成進行度 τ | 別途エンコードされエキスパート層に注入;アテンションが観測プレフィックスを読む。 |
| 連続出力 | 50 × d の更新に射影し直し、10 回の更新で 1 チャンクを生成。 |
エキスパートは観測と自分自身の行動特徴は読みますが、FAST トークンは読みません。バックボーンはエキスパートの特徴を読みません。アテンションによって観測情報を共有しつつ、幅 2048 と 1024 を直接足し合わせることはありません。論文は、すべてのデータセットに共通する視覚シーケンス長や最大行動次元を一貫しては指定していません。
注意: 図 3 では Gemma を 2.6B とラベル付けしていますが、付録 E では「2B VLM」と呼んでいます。検証可能な層数と幅のみを保持し、正確な総パラメータ数をでっち上げることはしません。
付録では50個の制御点が示されています。端点を含む慣習では H=49 と書きますが、「50ステップ」と表現した方が混乱を避けられます。2つのプラットフォームは、クロスロボット学習のためのパディング付きで 50 × 18 または 50 × 19 の配列を出力します。
Training: heterogeneous data → backbone predicts text / action tokens
          post-training adds noisy actions → expert learns continuous updates

Inference: observations + overall task → subtask text
           observations + subtask + random actions → ten updates → continuous chunk → execute and observe again
実験で注意すべき3点:
-
一般に、より多くの訓練ロケーションが有利です。 比較には 3、12、22、53、82、104 のロケーションが使われます。104ロケーションのモデルは、これらのタスクにおいて評価設定を見たことのあるモデルに近づきますが、これはすべての新しい家庭に対する保証ではありません。
-
アクション訓練だけを変えるより、完全なレシピの方が優れています。 同じロボットデータセットと類似のステップ数で、π0.5 は π0 および π0-FAST+Flow を上回ります。FAST 単体ではこの向上を説明できません。サブタスクや画像-テキストの共同学習も異なっています。
-
高レベル推論は有用であり、高レベル訓練データも重要です。 訓練データを完全に保持したまま、推論時の明示的なサブタスク選択のみを省いたバリアントが2番手となります。言語デモや Web データを除くと性能が低下します。行動前にサブタスクを言語化することだけが説明のすべてではありません。
主要な図の多くはタスク完了スコアを報告しており、タスク全体の成功率ではありません。通常、ポリシー1つあたりタスク1つにつき約10回の試行、あるいは4つの制御タスク全体でおよそ40回の試行があります。一部の中止された試行は除外されています。Dishes-to-sink では最大8ポイントがあり、ピックとプレースに対して個別に与えられます。スコアが半分だからといって、試行の半分が完全に成功したことを意味するわけではありません。
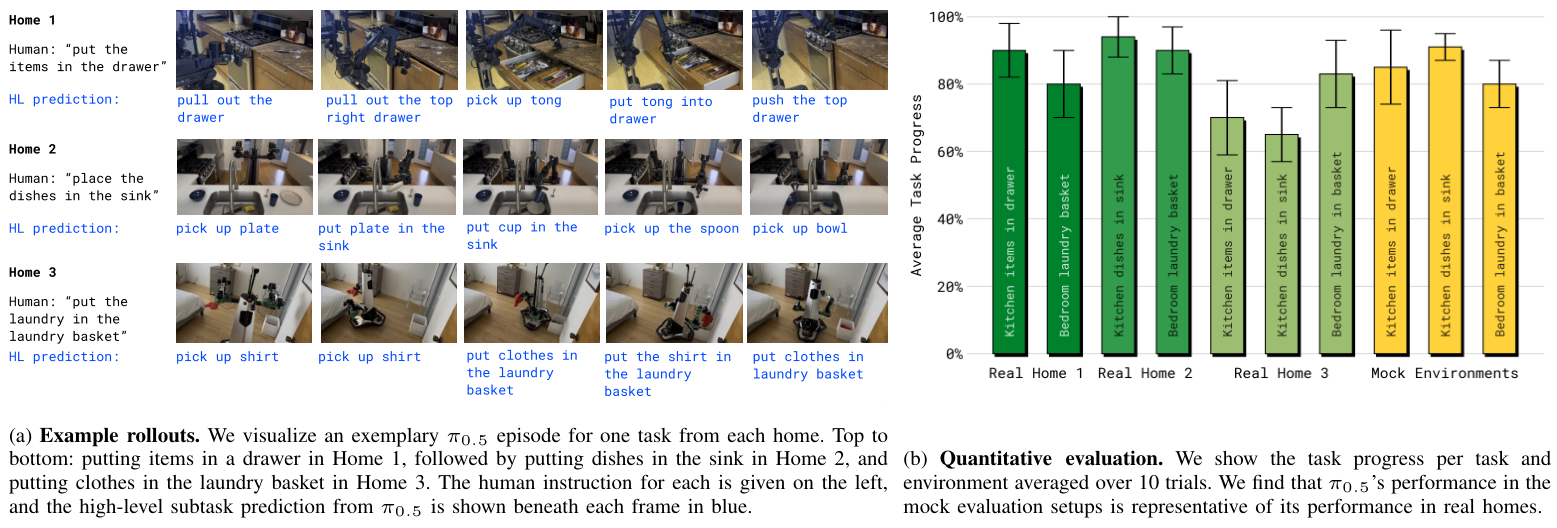
論文では 10〜15 分の振る舞いが実演されていますが、多くの定量評価された実家庭タスクは約 2〜5 分で終了します。これらを混同しないでください。見慣れない取っ手、開けにくいドア、オクルージョン、繰り返される高レベルの意思決定、複雑な嗜好、部屋をまたぐ記憶といった課題は依然として残っています。この研究は、新しい家庭環境で有用な振る舞いを検証するものであり、家庭内のあらゆる雑事を確実に完遂できることを示すものではありません。
参照箇所:要約と序論;セクション II、IV-A〜IV-E、V-A〜V-E、VI;図 3、5、7〜13;付録 B および E。本ガイドはプロジェクト固有のハードウェア転移に関する前提を追加していません。
π0 と π0.5 の比較
主な変更点
説明: π0 はロボットやタスクをまたいだ汎用的で巧みな制御を研究しています。π0.5 はこれを拡張し、見慣れない家庭環境の理解や、多段階の家事作業の整理に踏み込みます。
| 項目 | π0 | π0.5 |
|---|---|---|
| 焦点 | ロボットやタスクをまたいだ汎用マニピュレーション。 | 新しい物体やレイアウトを含む、新しい家庭での多段階マニピュレーション。 |
| データ | VLM による初期化、おもにポリシー学習のためのクロスロボットデモとラベル付き言語。 | 行動、サブタスク、ローカライゼーション、Web データに対する共同学習を継続し、ポストトレーニングで専門家による言語デモを追加。 |
| アクション訓練 | 事前学習とポストトレーニングの両方で連続値の専門家。 | 事前学習では FAST トークンを使用し、ポストトレーニングで専門家を追加して両方の表現を保持。 |
| 実行されるアクション | 連続値の flow-matching チャンク。 | 実行も連続値の flow-matching チャンクであり、FAST は主に訓練を改善。 |
| 長いタスクの構成 | 明示的な意味的プランニングが必要な場合、人間または外部の高レベル VLM からの指示に従う。 | 同じモデルが全体タスクからサブタスクを選択し、そのサブタスクのアクションを生成。 |
| 状態入力 | 連続状態をアクション専門家に射影。 | 状態を VLM 内でトークンとして離散化。 |
| ポストトレーニングの目標 | よりクリーンで一貫したデモによりタスク熟達度を向上。 | 家庭内モバイルマニピュレーションに向けて、アクション実行とサブタスク選択の両方を適応。 |
どちらも PaliGemma と、およそ 3 億パラメータのアクション専門家を使用し、50 個の制御点と 10 回のフロー更新を持ちます。π0.5 は主に訓練レシピとタスク構成を変更しており、その性能向上は単にモデルを大きくしたりチャンクを長くしたことによるものではありません。
例:皿をシンクに入れる
π0:
Images + state + “put the plate in the sink” → continuous chunk → execute
A person or external high-level model can supply intermediate instructions for an explicitly decomposed kitchen-cleaning task.

π0.5:
Images + state + “clean the kitchen” → model selects “pick up the plate”
Images + state + “pick up the plate” → continuous chunk → execute and observe again
Then select another subtask, such as “put the plate in the sink,” from the updated scene.
注意: ここでは実行経路を比較しています。元の π0 も長いタスクを実演しており、単一ステップの操作に限定されているわけではありません。π0.5 は同一モデル内に明示的なサブタスク選択を追加しています。
実験は何を裏付けているか?
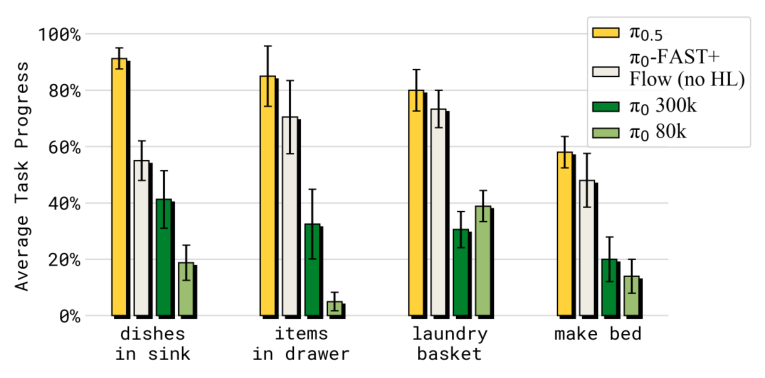
論文: 同じロボットデータセットと類似のステップ数のもとで、π0.5 の完全なレシピは、テストされた見慣れない制御された家庭環境において π0 および π0-FAST+Flow を上回ります。後者はすでに FAST と flow matching を組み合わせていますが、ロボットアクションデータのみを使用し、高レベル推論を欠いています。アクション訓練だけを変更しても、完全な π0.5 に匹敵することはできません。
注意: これらは π0.5 論文内で再訓練されたベースラインであり、別々の出版物からスコアをつなぎ合わせたものではありません。これらのタスクと条件における改善を裏付けるものであり、あらゆる場面で一定の利得があることを示すものではありません。
データの範囲を慎重に比較してください。π0 の「1万時間超」はロボットデモ全体を指す一方で、π0.5 の「約400時間」は家庭内モバイルマニピュレーションのみに言及しており、他ロボットや画像-テキストデータの多くを含みません。これらの数値は、π0.5 が常により少ない総データで普遍的に勝ることを示してはいません。
比較元:π0(2410.24164v4)のセクション III〜V および高レベル指示実験;π0.5(2504.16054v1)のセクション IV、V-D、V-E、図 12、および付録 E。