FAST と π0-FAST:効率的なアクショントークナイゼーションはどのようにロボット学習を加速するか
FAST: Efficient Action Tokenization for Vision-Language-Action Models
- アクショントークナイゼーション
- DCT
- BPE 圧縮
- 自己回帰ポリシー
π0 との関係: 論文タイトルは FAST であり、π0-FAST はそれを用いて学習されたポリシーです。FAST はトークナイゼーション手法、FAST+ は事前学習済みの汎用アクショントークナイザ、π0-FAST はこの表現を用いる自己回帰型 VLA です。π0 と同様に PaliGemma バックボーン手法を共有しますが、アクション生成を変更しており、π0 のフローマッチングエキスパートに単に圧縮前処理を追加しただけのものではありません。
読書ソース: 元の PDF のセクション I–VII と付録 A–E を、先行する π0 ディープダイブと同じ構成に従って読みます。ページ番号は 19 ページの PDF の物理ページを指し、そこから図を抜粋しています。追加の導出や数値例は、論文への帰属ではなく解説として明示します。
前提知識
VLA とアクショントークナイゼーション
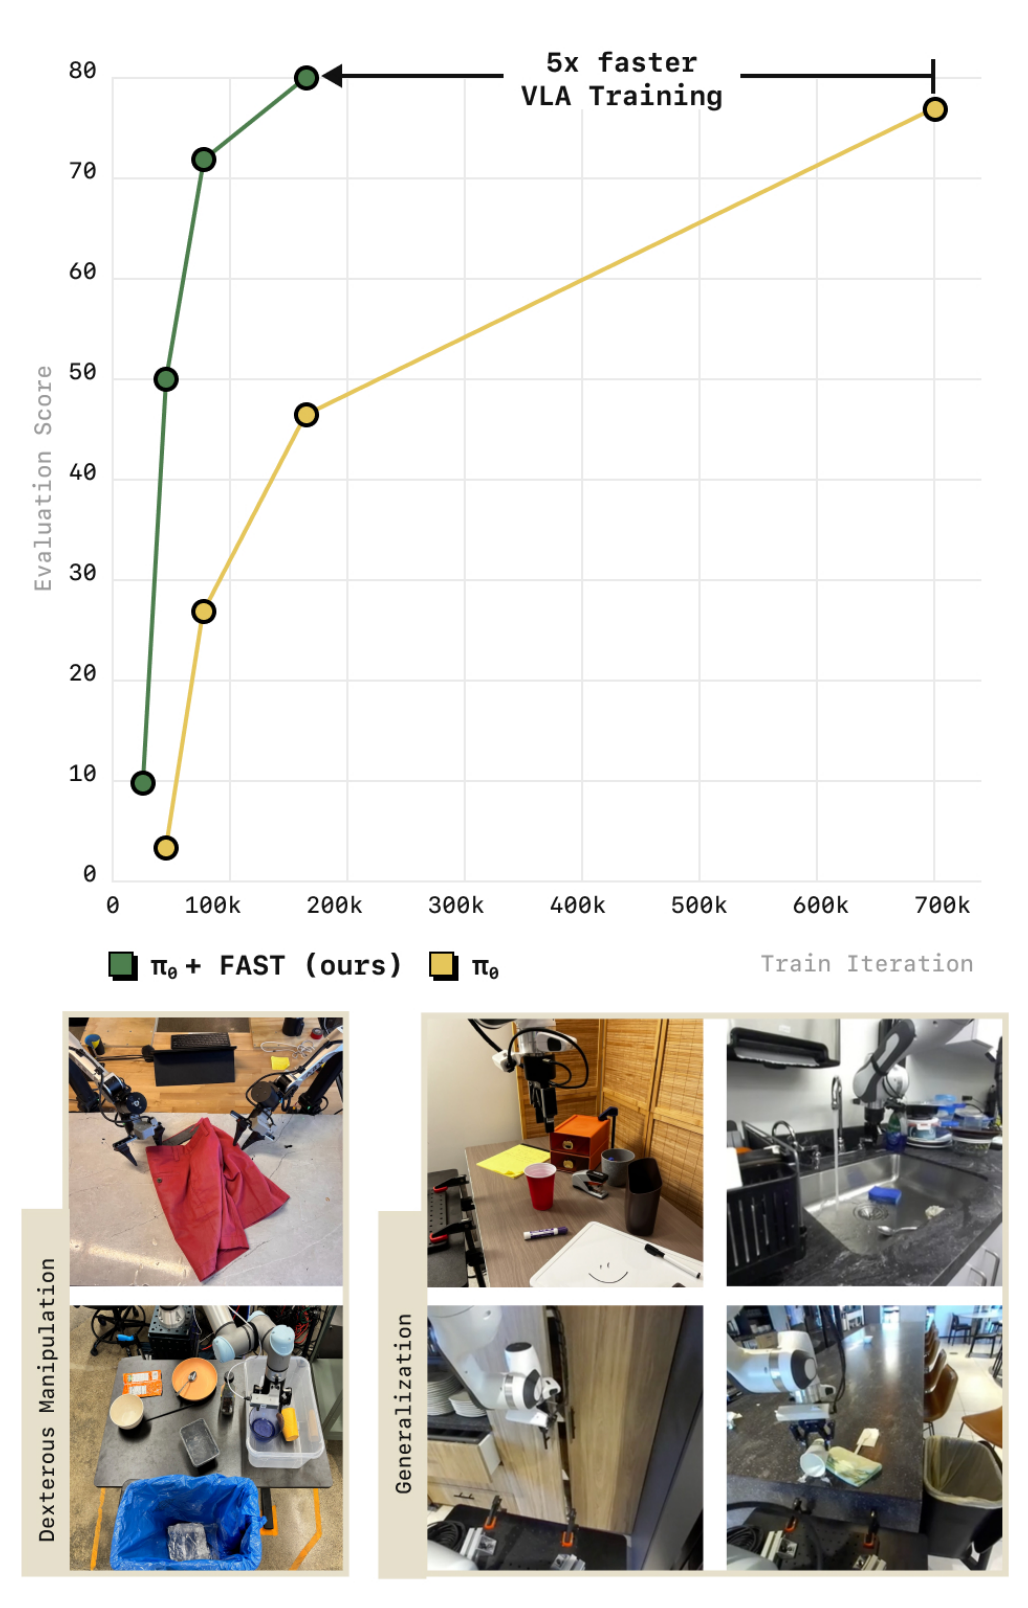
説明: VLA は、可視シーンと言語タスクをロボット制御に変換します。T シャツ折りたたみでは、画像がシャツとグリッパの位置を特定し、言語が目的を定義し、状態がアームを記述し、モデルが将来のアームおよびグリッパのアクションを予測します。
この論文ではアクションチャンク化を用います。1 ステップだけでなく、将来の ステップを予測します。次のように定義します:
ここで はロボット制御時間、 は 次元アクション、 はホライズンです。 はビュー の画像、 はカメラ数、 は指示文、 は固有感覚です。ポリシーは を学習し、 はネットワークパラメータを表します。
論文: チャンクは主に 1 秒 長です。したがって は制御レートに依存し、15 Hz では 15、20 Hz では 20、50 Hz では 50 になります。ここではすべてのデータセットで π0 の であると仮定しないでください。
アクショントークナイゼーションは、連続チャンクを離散記号に写像します:
はトークナイザ、 はアクショントークン ID、 は語彙サイズ、 は圧縮後の系列長です。同じ形状のチャンクでも異なる を生成し得る点は、同じ長さの文でもサブワード数が異なり得るのと同様です。
注意: トークン ID は関節角ではありません。1 つの FAST トークンが 1 タイムステップ、1 関節、あるいは 1 つの完結したアクションに対応している必要はありません。まず系列を生成し、その後で連続チャンクにデコードします。
ポイントワイズビニング、π0 フローマッチング、FAST
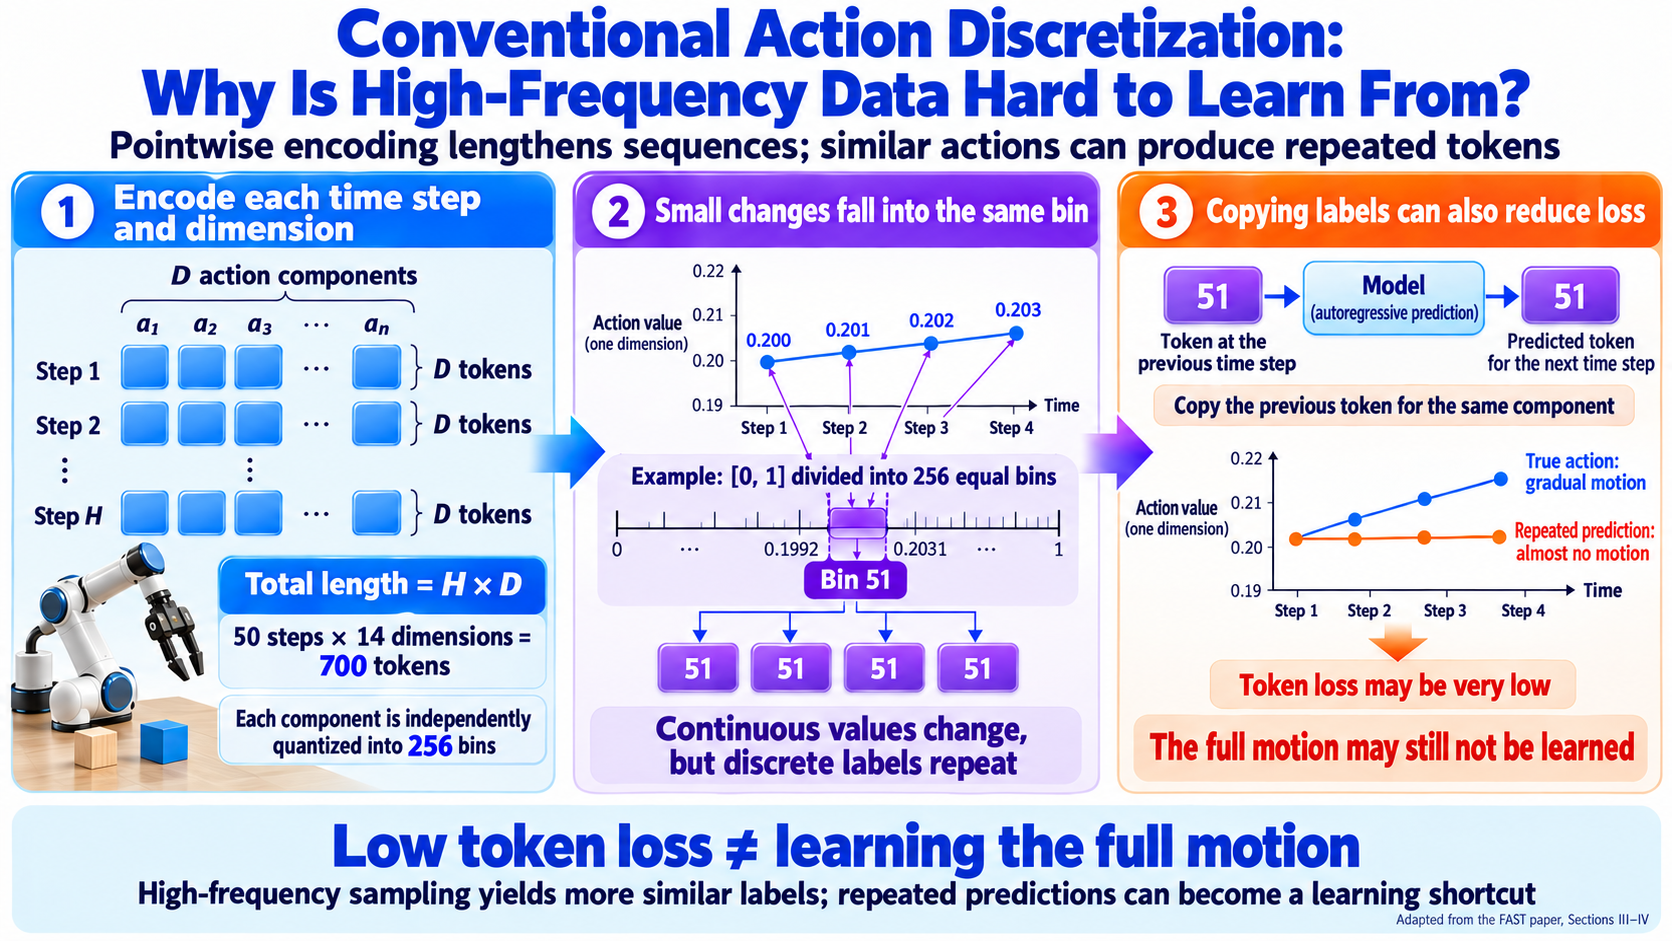
従来のビニングは、各タイムステップと各アクション次元を独立に量子化します。論文で議論されている一般的な設定では、256 個の一様ビンを用います:
D action components at step 1 → D tokens
D action components at step 2 → D tokens
……
D action components at step H → D tokens
Total: H × D tokens
その結果、高レートデータでは、隣接する値が非常に類似した長い系列が生成されます。繰り返しトークンをコピーするだけで、全体の動きを学習しなくても損失を減らせてしまいます。
最小例: 値 はすべて 1 つの粗いビンに入るかもしれません。前のトークンを繰り返すだけで多くのラベルを正しく予測できますが、着実に変化する軌道を表現できません。
FAST は次を用います:
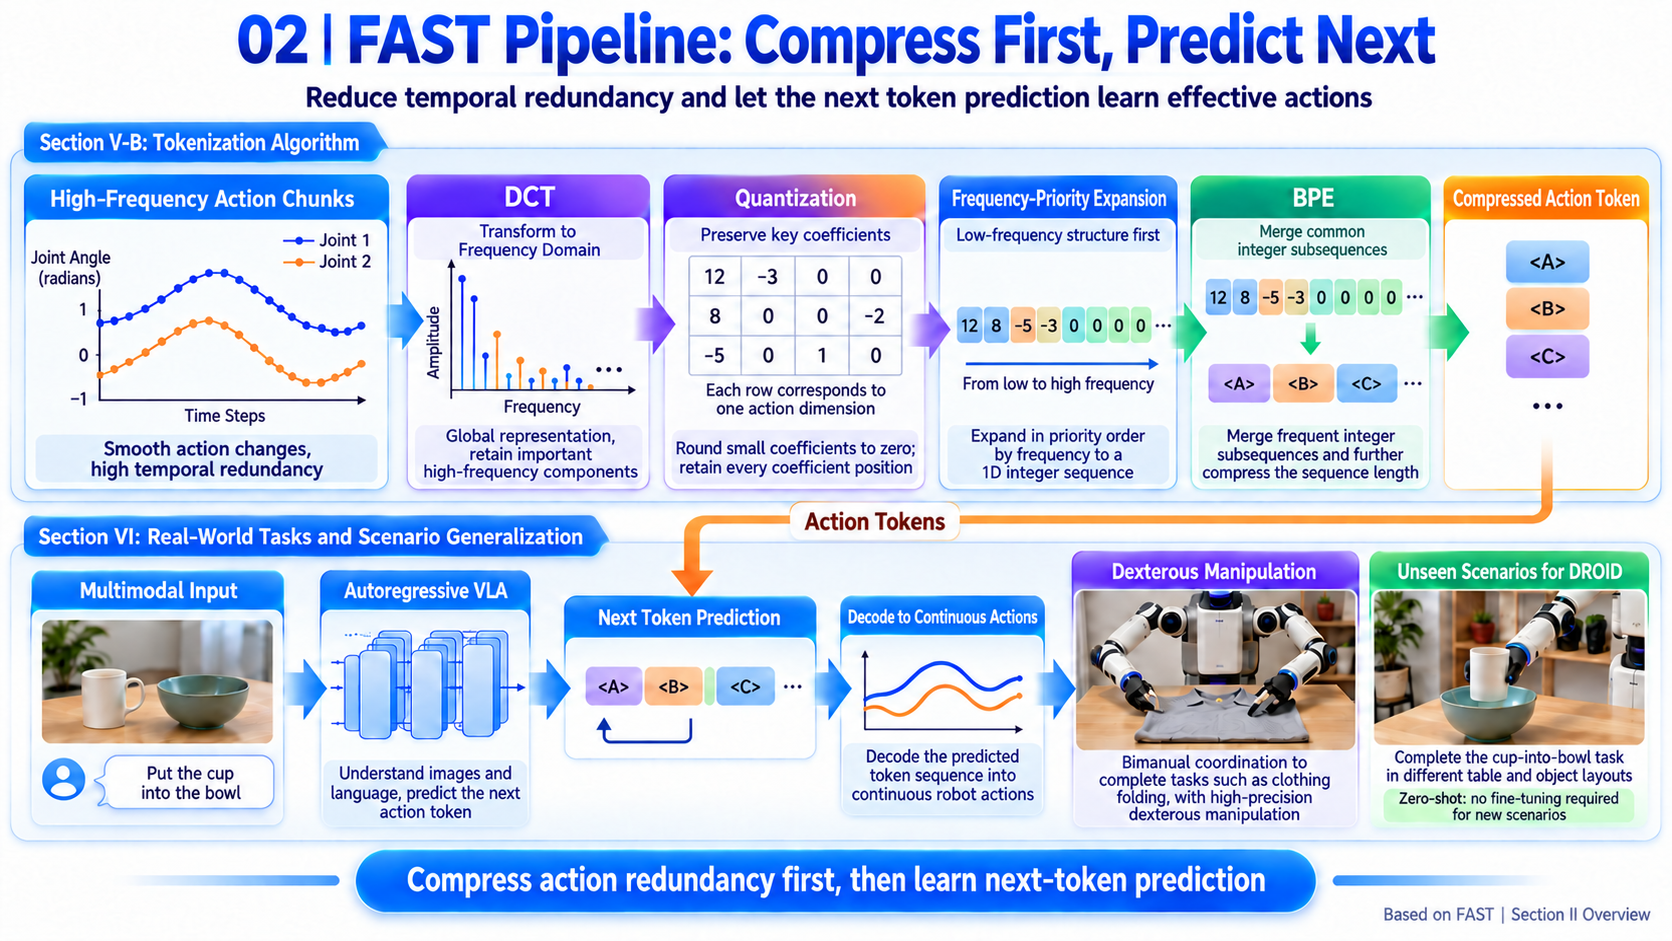
Continuous chunk → frequency coefficients → quantization → frequency-first flattening → BPE
          → fewer action tokens → autoregressive VLA prediction → continuous-chunk decoding
離散コサイン変換(DCT)は、軌道を異なる周波数のコサイン成分として表現します。バイトペアエンコーディング(BPE)は、よく現れる整数部分列をマージします。この圧縮された軌道表現を予測することで、冗長な教師信号を取り除きます。
| 観点 | ポイントワイズ自己回帰 VLA | 元の π0 | π0-FAST |
|---|---|---|---|
| 表現 | 各タイムステップ・各次元ごとの離散値 | 連続チャンク | チャンクに対する圧縮離散トークン |
| 目的関数 | 次トークン予測 | 条件付きフローマッチング | 次トークン予測 |
| 生成 | 個のトークンを逐次生成 | エキスパートで完全なチャンクを反復的に更新 | 圧縮トークン 個を生成し、その後デコード |
| 高レートデータ | トークン数と繰り返しが増加 | 連続生成により次元ごとのデコードを回避 | 時間的冗長性を圧縮し出力を短縮 |
| 主な制約 | 高レートの巧緻動作は学習が難しい場合がある | 専用の連続エキスパートが必要 | ロッシー量子化;自己回帰推論は依然として遅い可能性がある |
論文: 表 I では、1 秒・50 Hz・14 次元の T シャツチャンクを、700 個のポイントワイズトークンから平均 53 個の FAST トークンに削減しています。デコード後も 50 × 14 個のアクションが得られるため、ロボット制御が「1 秒あたり 53 トークン」になるわけではありません。
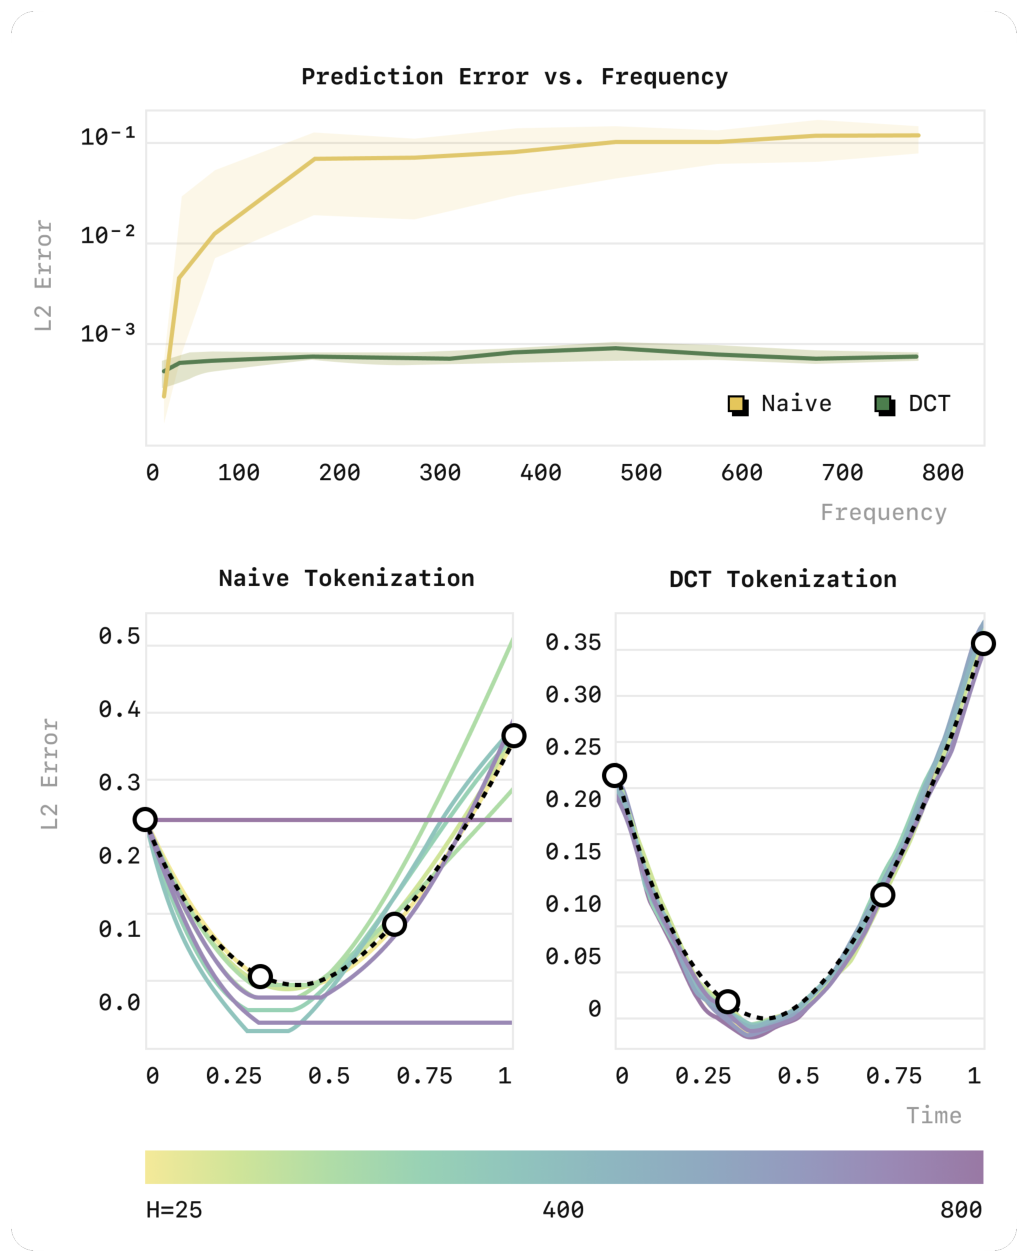
図 2:同じ 3 次スプラインを、異なるサンプリング密度で予測した結果。黄色がポイントワイズビニング、緑が DCT。下のカラースケールは、サンプル数 が 25 から 800 に増えるにつれて、淡い黄色から紫に変化します。元の図 3(PDF 3 ページ目)から引用。
図の読み方: 4 つの入力点が、密度を変えながら同種の補間ターゲットを定義しています。ポイントワイズトークナイゼーションの誤差は増大し、最終的にはほぼ一定予測に近づきますが、DCT の誤差は低く抑えられます。学習が失敗する原因は、タスクが難しいからではなく表現のせいである場合があります。25–800 の値は 1 シーケンスあたりの合成サンプル数であり、実際のロボット制御周波数ではありません。
学習・推論・評価
| 段階 | 入力と処理 | 出力と評価指標 |
|---|---|---|
| トークナイザ学習 | アクションを正規化し、DCT と量子化を適用し、整数列から BPE を学習する。 | エンコード/デコード規則、圧縮率と再構成誤差。 |
| ポリシー学習 | 画像・言語・状態に条件付けし、将来のデモアクションを FAST ラベルとしてエンコードする。 | 交差エントロピー最適化と VLA の重み。 |
| ポリシー推論 | トークンを生成し、BPE を逆適用し、量子化を元に戻し、逆 DCT を適用する。 | コントローラ用の連続チャンク。 |
| ロボット評価 | 指定されたタスクと初期条件を実行する。 | タスク成功率または正規化された進捗。 |
論文: 評価には、6 つの実機ロボットタスク/設定と 1 つのシミュレーションベンチマークに加え、エンボディメントをまたいだオフライン FAST+ 圧縮テストが含まれます。ヒューマノイドデータを圧縮することは、ヒューマノイドポリシーを学習し物理的に検証することと同じではありません。
注意: トークン損失、再構成誤差、タスクスコアは別物です。重要な発見として、ラベルが反復的でも学習損失は低くなり得る一方で、軌道やロボット挙動は依然として悪いままになり得ることが示されています。
要約
翻訳
Transformer ベースの VLA を含む自己回帰系列モデルは、複雑で汎化可能なロボット挙動を表現できますが、離散予測を連続アクションに写像するトークナイザが必要です。著者らは、単純な次元ごと・タイムステップごとのビニングは、高周波の巧緻データに対して性能が低いことを見出しました。
彼らは Frequency-space Action Sequence Tokenization(FAST)を提案し、DCT ベースの圧縮を用いて、標準的な離散化が破綻する高周波の巧緻タスクを自己回帰 VLA が学習できるようにします。
FAST+ は 100 万本の実機ロボットアクションシーケンスで学習された汎用トークナイザであり、異なるアクション空間や制御周波数にまたがってブラックボックストークナイザとして利用できます。
π0 VLA 手法と組み合わせることで、FAST は 1 万時間のロボットデータまでスケールし、拡散モデル型 VLA と同等の性能を達成しつつ、学習時間を最大 5 倍短縮します。
コメント
-
動機: 高レートのアクションには繰り返し情報が含まれます。ポイントワイズトークンは、新しい動きの教師信号がほとんどないラベルの予測に計算資源を費やしてしまいます。
-
中核となる変更点: ポリシーを学習する前に、学習ターゲットの表現を変更します。FAST は、実行周波数を下げたり制御点を捨てたりすることなく、軌道情報を圧縮します。
-
なぜ機能しうるのか: DCT は軌道の形状情報を集中させ、量子化は圧縮しやすい係数を生成し、BPE はよく現れる組み合わせを短くします。これら 3 つすべてが最終的なトークンに寄与します。
-
「universal」の意味: FAST+ はデータセット固有の BPE 語彙を再学習することを避けますが、依然として互換性のある正規化、次元数、ホライズンが必要です。100 万の学習サンプルは主に 1 秒のチャンクであり、100 万の完全なタスクエピソードではありません。
-
「5 倍」の範囲: 大規模なポリシー実験では、必要な GPU 時間を最大およそ 5 倍まで削減します。これは推論の高速化ではありません。v1 では、π0-FAST の 1 チャンクあたり約 750 ms と報告されており、π0 は通常 100 ms 未満です。
序論
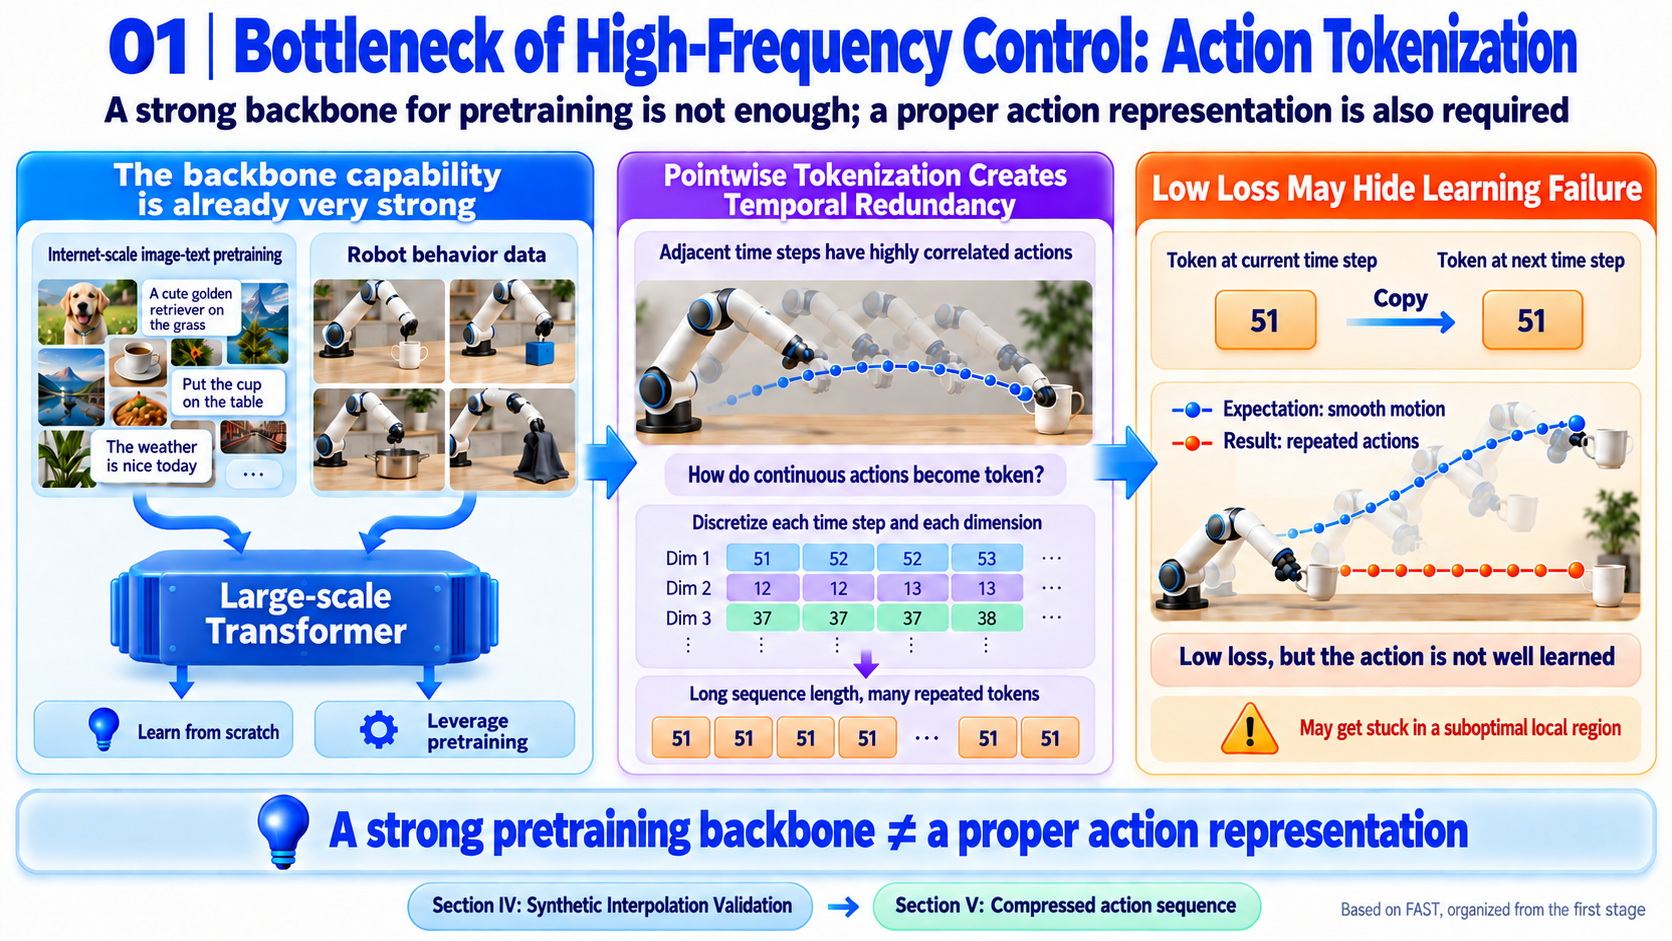
第 1 段落: トークナイゼーションのボトルネックを特定する
-
主なポイント: 大規模 Transformer はロボットの振る舞いをゼロから学習したり、画像‐テキストの事前学習を利用したりできますが、行動はトークン化されなければなりません。ポイントごとのビニングは、高レートで巧緻なタスクにおいては苦戦します。なぜなら、相関した直近の値をコピーするだけで損失を低く抑えられ、学習が悪い局所最適に閉じ込められうるからです。
-
問題: 強力なバックボーンがあっても、有用な行動学習が保証されるわけではありません。ターゲット表現が教師信号を制限しうるためです。
-
設定: セクション IV では合成補間を用いてサンプリング密度を調べ、セクション V では圧縮を提案します。
第 2 段落: まず圧縮し、その後予測する
-
主なポイント: 言語のトークナイゼーションから着想を得て、FAST は連続ロボット信号に DCT を用います。標準的な次トークン予測により、これまで失敗していたタスクを学習し、未知の設定で言語を通じて利用される DROID ポリシーをサポートします。
-
問題: 時間的冗長性が障害であるなら、ネットワーク容量を増やすだけでなく、ラベル側の冗長性を減らすべきです。
-
設定: セクション V-B でアルゴリズムを示し、セクション VI で実タスクと DROID の汎化を評価します。
第 3 段落: ユニバーサルなトークナイゼーションと大規模ポリシー
-
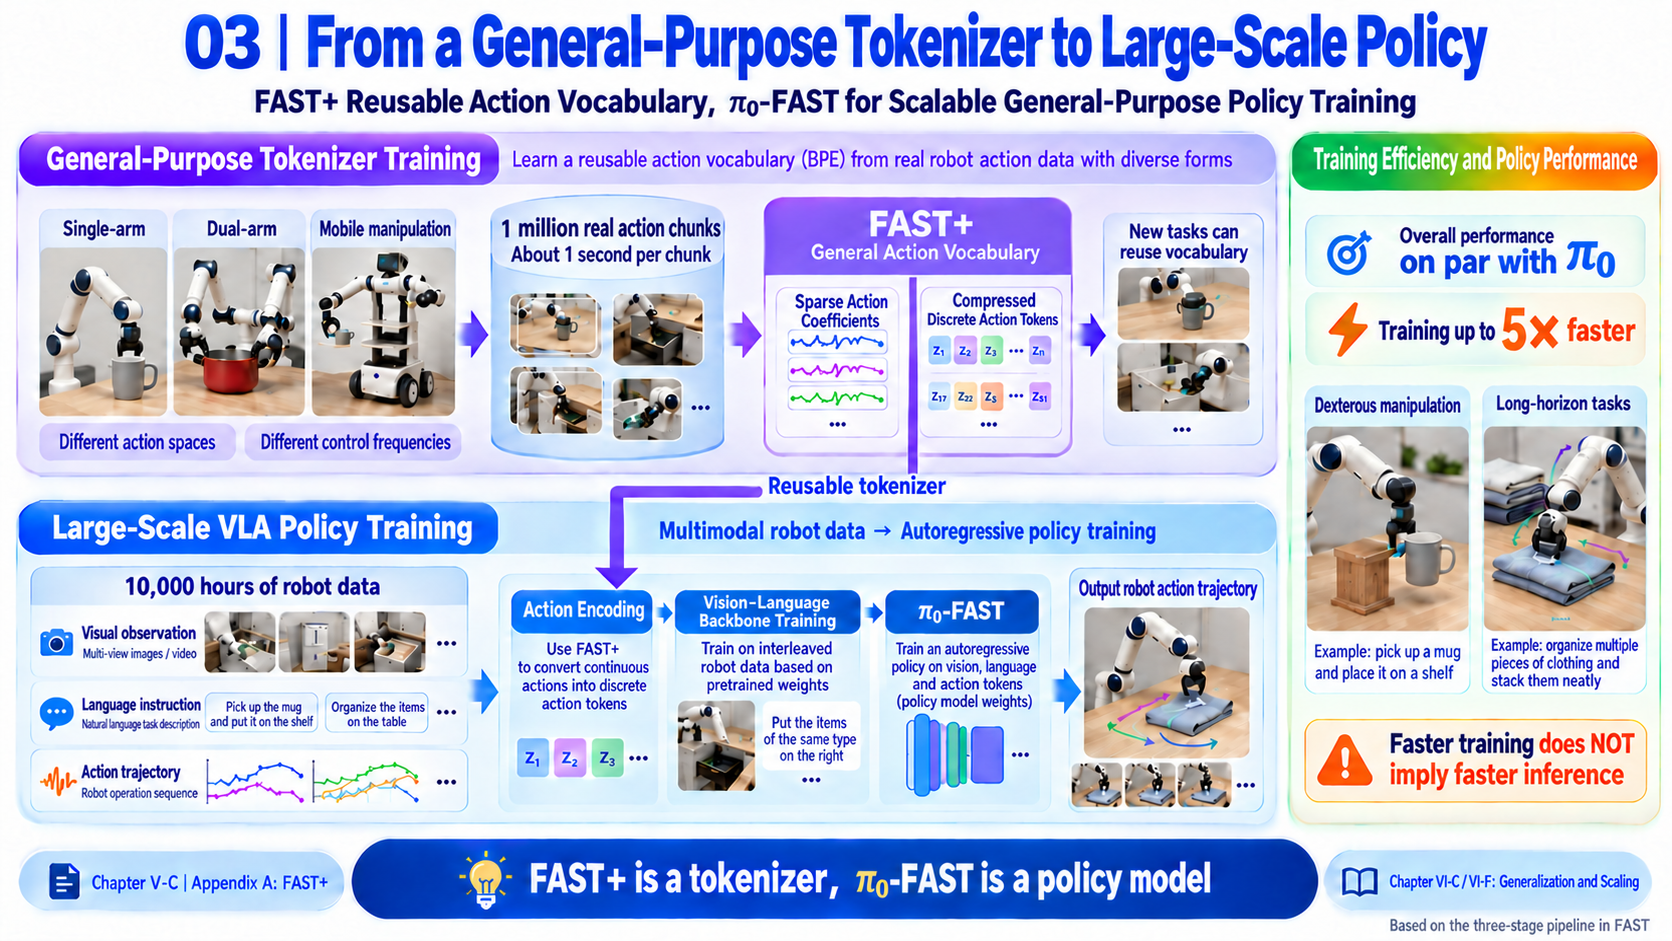
主なポイント: FAST+ は、単腕・両腕・モバイル、および多様な制御インターフェースと周波数をカバーする 100 万本のシーケンスから語彙を学習します。π0-FAST は、拡散型の比較手法よりも少ない学習時間で、自己回帰を 1 万時間規模までスケールさせます。
-
問題: ロボットごとにトークナイザを再学習するとオーバーヘッドが増え、手法は個々のデータセットを超えてスケールしなければなりません。
-
設定: セクション V-C と付録 A で FAST+ を説明し、VI-C でユニバーサリティを、VI-F で大規模ポリシーをテストします。
注意: 序論には 3 つの主要な段落があり、最初の段落は 1–2 ページにまたがっています。ページ区切りや図のキャプションは追加の段落ではありません。「最初の」DROID 結果に関する主張は、出版時点での著者らの評価を反映したものであり、その後の研究を網羅的に調査したものではありません。
関連研究
-
テキスト、画像、音声のトークナイゼーション: テキスト BPE は頻出部分列をマージし、他のモダリティでは学習された量子化や周波数表現が用いられます。FAST は、この表現と圧縮の原則を連続行動チャンクに適用します。DCT は解析的であり、学習されるのは BPE 語彙だけです。
-
VLA: RT-2 と OpenVLA は画像‐テキストの知識を制御へ転移しますが、一般的にポイントごとの行動ビンを用います。FAST は出力を変更し、自己回帰バックボーンが高レートの巧緻な動作を学習できるようにします。連続フローの π0 が重要な比較対象です。
-
行動表現: セマンティックなサブタスクやキーポイントは、手作りのコントローラに依存する場合があります。ビニングは制御を直接表現しますが、時間的冗長性があります。回帰ヘッドや拡散ヘッドは出力メカニズムを変更します。FAST は離散シーケンス予測を保持します。学習された圧縮との比較には有限スカラー量子化(FSQ)を用います。FAST はニューラルエンコーダを必要とせず、テストされた高忠実度再構成と巧緻なタスクにおいてはより良い性能を示しますが、あらゆる学習トークナイザより優れているとは限りません。
π0-FAST ポリシーシステムと実験プラットフォーム
目標と構成要素
FAST は行動処理の手法であり、新しいテレオペレーションハードウェアではありません。このシステムのセクションでは、トークナイゼーション、VLA、制御、評価がどのように組み合わさるかを説明します。
目標は、高レートの行動を細かな軌道を保ったまま圧縮し、自己回帰 VLM の学習を再利用し、多様な行動空間をサポートし、トークナイザの学習と再利用を容易にし、具現化をまたいでスケールさせることです。
| コンポーネント | 論文での構成 | 役割 |
|---|---|---|
| FAST / FAST+ | DCT、量子化、周波数優先のフラット化、BPE | チャンクを予測しやすい記号としてエンコードし、デコードする。 |
| π0-FAST バックボーン | PaliGemma-3B | 画像と言語をエンコードし、自己回帰的に行動トークンを生成する。 |
| バックボーン転移の比較 | Prismatic 7B ベースの OpenVLA | 利点が PaliGemma を超えても成り立つかをテストする。 |
| 画像 | 2 または 3 枚の ビュー | 各腕につき 1 つの手首ビューに加え、1 つの外部ビュー。 |
| プロプリオセプション | 256 ビンへの離散化後、整数テキストトークナイゼーション | 現在のロボット状態を与える。 |
| 実行 | プラットフォーム固有の低レベルコントローラ | デコードされた連続値を関節、グリッパ、その他の制御へ送る。 |
論文: すべてのポリシー重みはファインチューニングされています。各画像は個別にエンコードされ、その後ビジュアルトークンが連結されます。画像サイズとテキスト状態エンコーディングは、π0 から類推するのではなく、付録 C で指定されています。
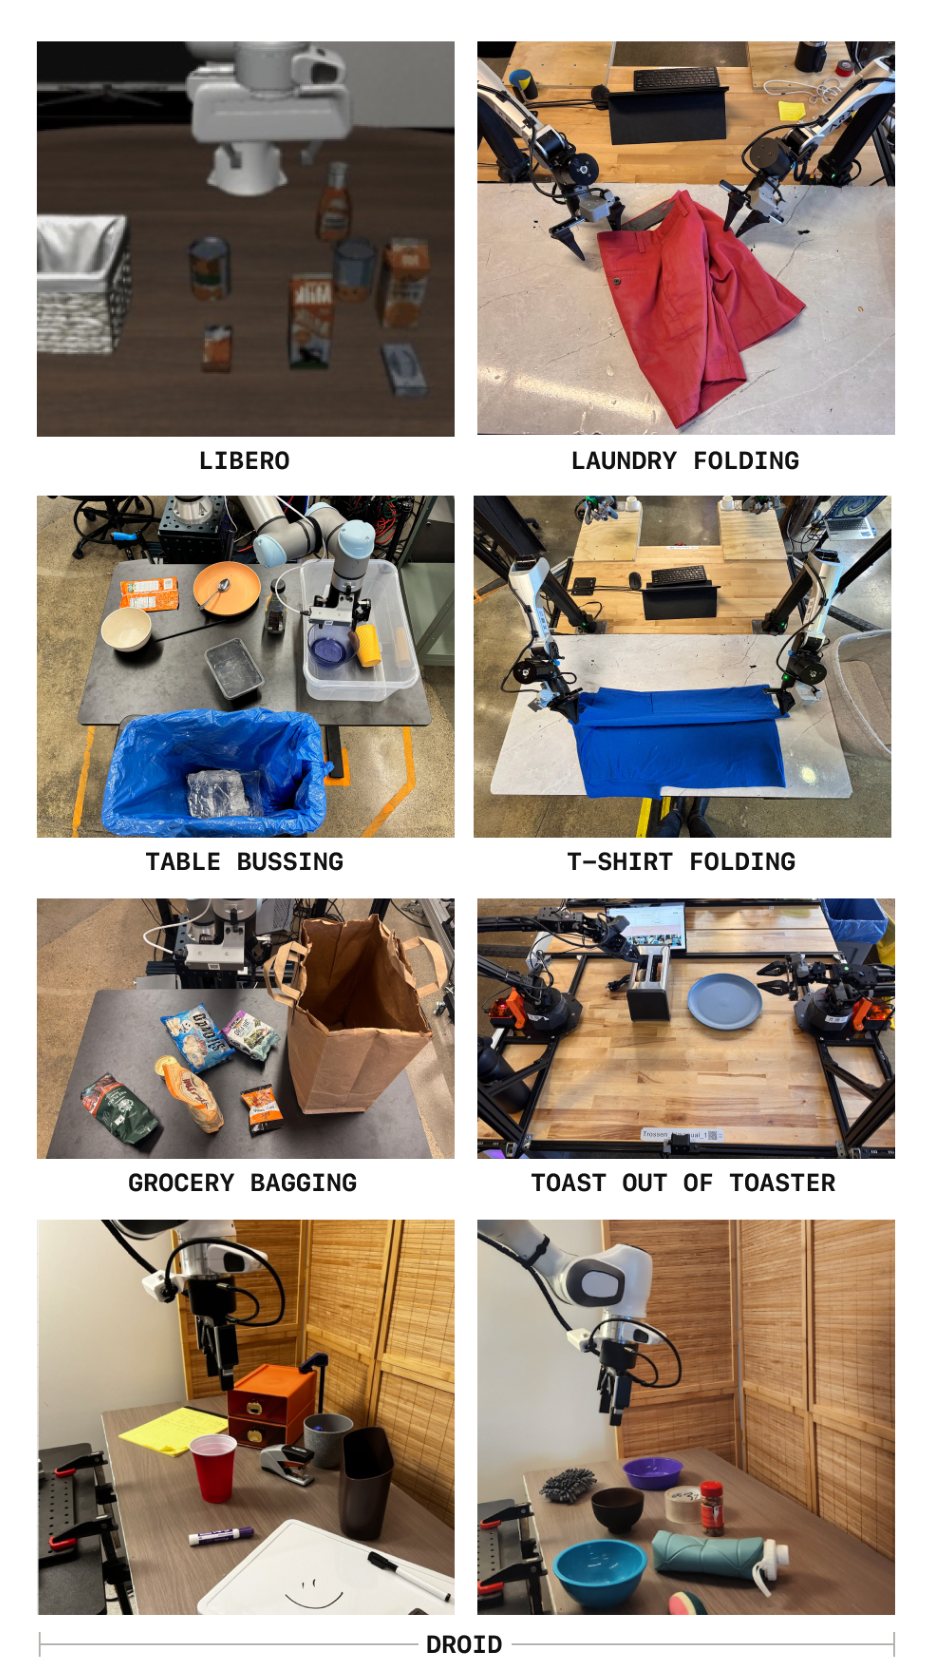
| タスク / 設定 | プラットフォームと制御レート | テストされる能力 |
|---|---|---|
| LIBERO | シミュレーション | 空間、物体、目標、および長期ホライズンの汎化。 |
| テーブル片付け | 単一 UR5/UR5e、20 Hz | 12 個の物体を把持、分類、収納する。 |
| T シャツ折りたたみ | 両腕 ARX、50 Hz | 平らなシャツを正確に把持して折りたたむ。 |
| 食料品袋詰め | 単一 UR5/UR5e、20 Hz | 袋がつぶれたり破れたりしないように 7 個の物体を袋詰めする。 |
| トースターからトーストを取り出す | 両腕 Trossen Viper-X、50 Hz | 2 枚のトーストを取り出して皿に載せる。 |
| 洗濯物折りたたみ | 両腕 ARX、50 Hz | バスケットから衣類を取り出し、広げ、折りたたみ、積み重ねる。 |
| DROID ゼロショット卓上タスク | Franka のデータとデプロイ、15 Hz | 新しいシーンで、配置、拭き取り、引き出し操作などのタスクについて言語指示に従う。 |
注意: 高い制御周波数とは、1 秒あたりの制御点が多いことを意味します。DCT における高周波数とは、軌道に沿った急速な変化を意味します。滑らかな 50 Hz の動きでも、低周波数係数が支配的でありえます。どちらもモデル全体の推論レートそのものではありません。
エンコーディング、予測、実行の接続
全体のワークフローは次のとおりです。
Demonstrations → one-second future chunks → normalization and FAST → action-token labels
Current images + language + state → VLM prefix → learn action-token prediction
                                      ↓ after training
New observations → autoregressive tokens → FAST decoding → continuous chunk → execute
                                                                  ↓
                                                          observe and predict again
FAST は行動ターゲットのみをエンコードし、画像を解釈したり、現在のプロプリオセプションに DCT を適用したりはしません。学習時には、モデルは真値の直前の行動トークンを見ますが、推論時には自分で生成したトークンを見ます。
論文: 行動シンボルは VLM 語彙の中であまり使われないスロットを置き換え、π0 型のフローエキスパートなしで離散出力を再利用します。OpenVLA の実験でも、複数画像入力とチャンク出力は変更されます。自己回帰バックボーンとの互換性は、既存のあらゆるロボットコードベースが一切の適応なしで済むことを意味するわけではありません。
実行タイミング: DROID は 15 ステップを予測し、観測を更新する前に 8 または 15 ステップをオープンループで実行します。15 Hz では、これは約 0.53 秒または 1 秒分の制御点をカバーしますが、推論や通信を含む総ウォールクロックサイクルではありません。v1 は、すべてのプラットフォームに共通する 1 つの実行長を特定してはいません。
根拠: チャンクは軌道の一貫性を保ち、圧縮によって高レートのラベルが学習可能になり、自己回帰出力によって事前学習された画像‐テキスト重みが直接関与できます。コントローラが受け取るのは BPE ID ではなく連続値です。
データ、能力、および結果
データセット規模と構成
| 用途 | 範囲 | 区別点 |
|---|---|---|
| FAST+ トークナイザ学習 | 約 100 万本の 1 秒実行動チャンク | VLA の視覚理解ではなく BPE を学習する。 |
| FAST+ カバレッジ | 単腕、両腕、モバイル;関節、ワールド座標系エンドエフェクタ、カメラ座標系エンドエフェクタ制御;多様な周波数 | 1 台のロボットが複数の行動パラメタ化を提供しうる。 |
| 大規模ポリシー | π0 ミックスチャ: 内部 903M タイムステップで、オープンデータには 9.1% のミックスチャサンプリング重み | オープンソースには Bridge v2、DROID、OXE が含まれる。9.1% は生データ量の比率ではない。 |
| DROID 特化ポリシー | 7.5 万の成功エピソード、約 2100 万サンプル | 軽いフィルタリングと、全ゼロのアイドル行動の除去を行うが、ポリシー学習は依然として必要。 |
| DROID 学習 | バッチ 256、24 万イテレーション、約 3 エポック | 付録 D では、この構成で 8 基の H100 による約 4 日間と報告されている。 |
論文: FAST+ の学習では、行動を 32 次元にパディングします。これはトークナイザ用データを揃えるためであり、すべてのポリシーの出力サイズを揃えるためではなく、π0 の 18 次元インターフェースとも異なります。新しいプラットフォームでは、依然として有効な行動次元を定義する必要があります。
DROID は 1 つの外部カメラ画像と 1 つの手首カメラ画像を使用します。学習では、カメラキャリブレーション情報なしで、利用可能な 2 台の外部カメラと 3 種類の言語アノテーションの中からエピソードごとにランダムに選択します。制御は関節速度と絶対グリッパ位置です。新しい視点でのデプロイでも、座標系や制御インターフェースの設定が不要になるわけではありません。
圧縮:トークン数を減らしてもアクションの時間範囲は同じ
これらの 1 秒の結果は Table I を再現したものです。圧縮率は、同程度の再構成誤差における平均 FAST トークン数で割った、ポイントごとのトークン数です。
| Dataset / task | Dimension | Rate and horizon | Pointwise tokens | Average FAST tokens | Compression |
|---|---|---|---|---|---|
| BridgeV2 | 7 | 5 Hz, 5 steps | 35 | 20 | 1.75 |
| DROID | 7 | 15 Hz, 15 steps | 105 | 29 | 3.6 |
| Table bussing | 7 | 20 Hz, 20 steps | 140 | 28 | 5.0 |
| T-shirt folding | 14 | 50 Hz, 50 steps | 700 | 53 | 13.2 |
解釈: 制御点を増やしても、新しい動きの情報が比例して増えるとは限りません。ここでの経験的な観察としては、1 秒あたり片腕あたり約 30 トークンですが、これは固定長という意味ではありません。
バージョン確認: 付録の Table III では、8 次元の DROID Joint や table bussing など、次元数の異なるオフラインデータセットを使用している一方で、Table I では 7 次元として列挙されています。異なるパラメータ化を 1 つの仕様に統合するのではなく、Table I の表記をそのまま採用しています。
評価:成功と進捗は別物
| Task | Evaluation |
|---|---|
| LIBERO | エピソード単位の二値成功判定。約 27 万サンプルを用いて 4 つのスイートを合同で 4 万イテレーション学習。 |
| Table bussing | 12 個の物体のうち、ゴミ箱または収納コンテナに正しく配置された割合。 |
| T-shirt folding | 5 枚の既知のシャツに対する、人手による折りたたみ成功判定。 |
| Grocery bagging | 7 個の物体のうち、袋に入れられた割合。 |
| Toast removal | 1 枚取り出すごとに 1 点、皿に盛り付けるごとに 1 点、合計 4 点を付与し、その後正規化。 |
| Laundry folding | カゴの中のランダムな 5 着について、人手による衣類の折りたたみと積み重ねの評価。 |
| DROID quantitative tests | ポリシーごとに 44 試行を行い、正しい把持や目的地などタスク固有の進捗ポイントを評価。 |
バージョン確認: 本文では LIBERO の 4 番目のスイートを Libero-10 と呼び、付録では Libero-Long と呼んでいます。ここでは長時間ホライズンのスイートとして記述されています。付録 E では DROID タスク数を 16 としている一方、Table II には 17 個の名前が列挙されていますが、試行回数の合計は依然として 44 です。この不一致は、黙って解消するのではなく、そのまま保持しています。
証拠の境界: Berkeley、Stanford、Washington 大学でのデプロイは、成功率が報告されていない追加の定性的デモです。ゼロショットとは、新しいデプロイ環境に対して追加学習を行っていないという意味であり、DROID 自体を学習していないという意味ではありません。FAST+ の語彙学習には実際の評価タスクからのデータも含まれているため、Figure 6 はトークナイザとポリシーの両方がすべてのタスクに完全に不慣れな状況を示しているわけではありません。
トークナイザの比較
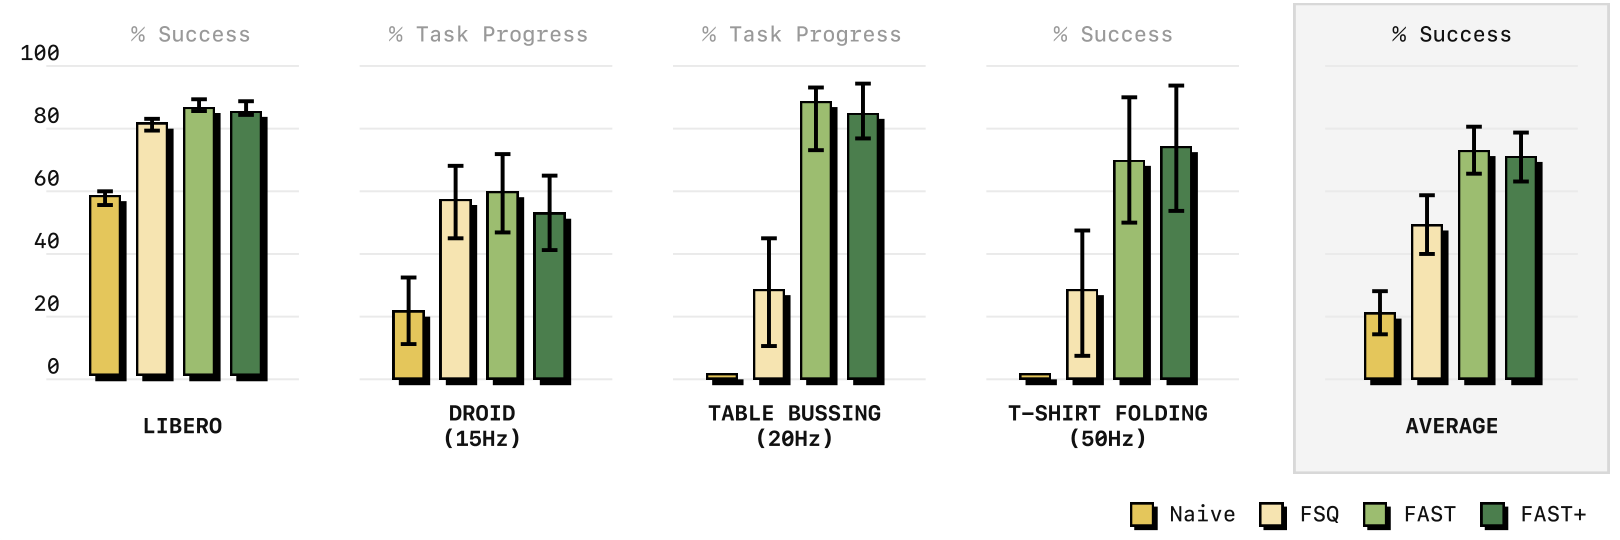
20 Hz の table bussing と 50 Hz の T-shirt folding において、ポイントごとのビニングはほとんど進歩が見られない一方で、FAST と FAST+ は有用なポリシーを学習します。FSQ は圧縮の有用性を裏付けるものの、これらの巧緻なタスクでは一般に FAST に劣ります。Universal FAST+ はデータセット固有の FAST にかなり近く、デフォルトとしての利用を支持する結果です。
注意: この図は異なるタスクのスコアを平均しているため、一様な平均成功率ではありません。また、誤差バーが、似たような棒グラフ間の小さな差についての結論を制限します。
単一データセットでの π0 との比較
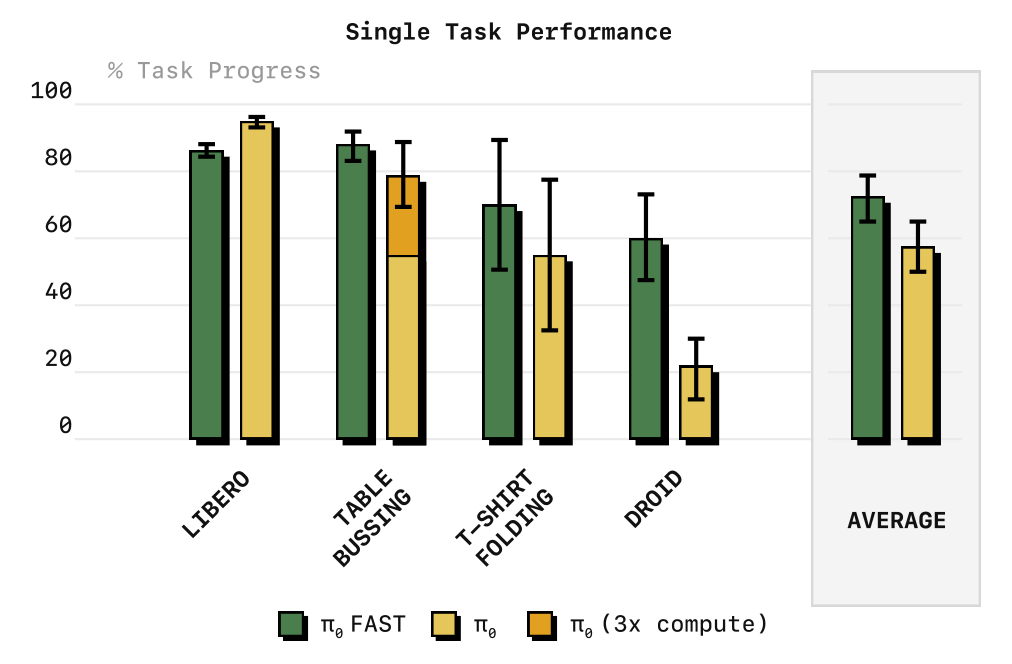
-
LIBERO や T-shirt folding のような小規模データセットでは、著者らは性能を同程度と判断しています。
-
大規模な table-bussing データでは、FAST はより早く高い性能に到達し、π0 はそれに近づくまでに約 3 倍のステップ数を要します。
-
DROID では、π0-FAST は言語により確実に従う一方で、flow-matching π0 はしばしばそれを無視します。論文ではその根本原因は特定されていません。
説明: Teacher forcing では、学習中に出力位置ごとの損失を並列に計算しますが、自己回帰推論は依然として逐次的です。より高速な学習とより低速な推論が同時に成り立ち得ます。これらの結果は、自己回帰モデルの普遍的な優位性を示すものではありません。
大規模ジェネラリストと計算量を揃えた比較
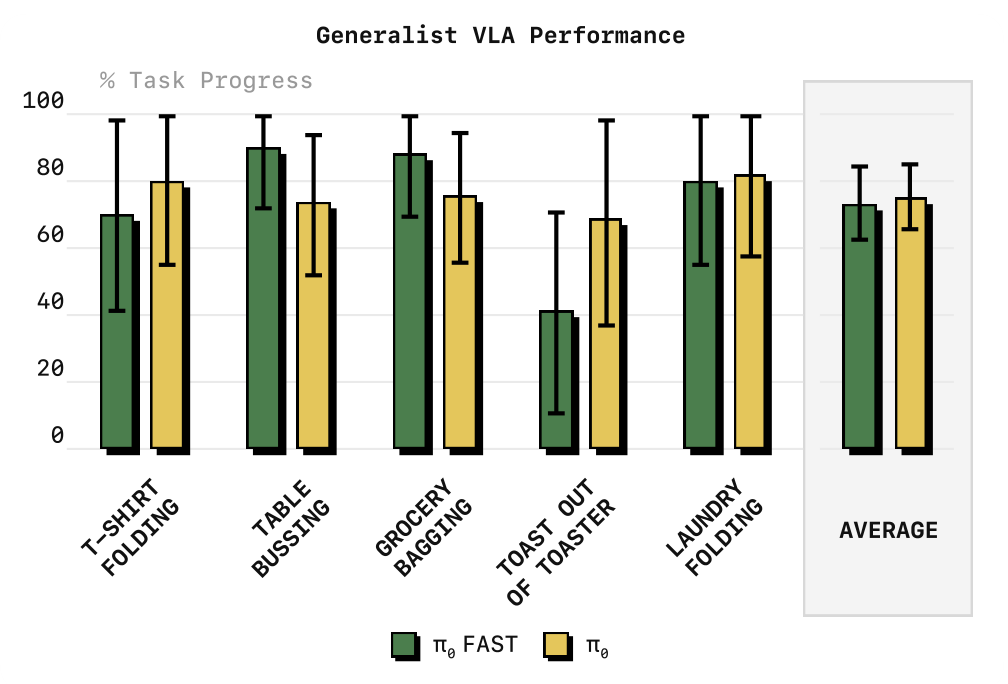
π0-FAST は、folding、bussing、bagging、toast、laundry 全体で見ると π0 と同程度の性能を示します。個々のタスクではばらつきがあり、toast については FAST の普遍的な優位性を主張できる結果ではありません。評価された π0-FAST は、GPU 時間が π0 の約 5 分の 1 です。
注意: VI-F はゼロショット比較を大まかに説明していますが、付録 E では、大規模事前学習後に laundry に対して高品質なタスク微調整を行っていると明記されています。bagging と toast では事前学習済みモデルをそのまま使用しています。Figure 6 のすべてのタスクが、タスク固有の微調整なしというわけではありません。
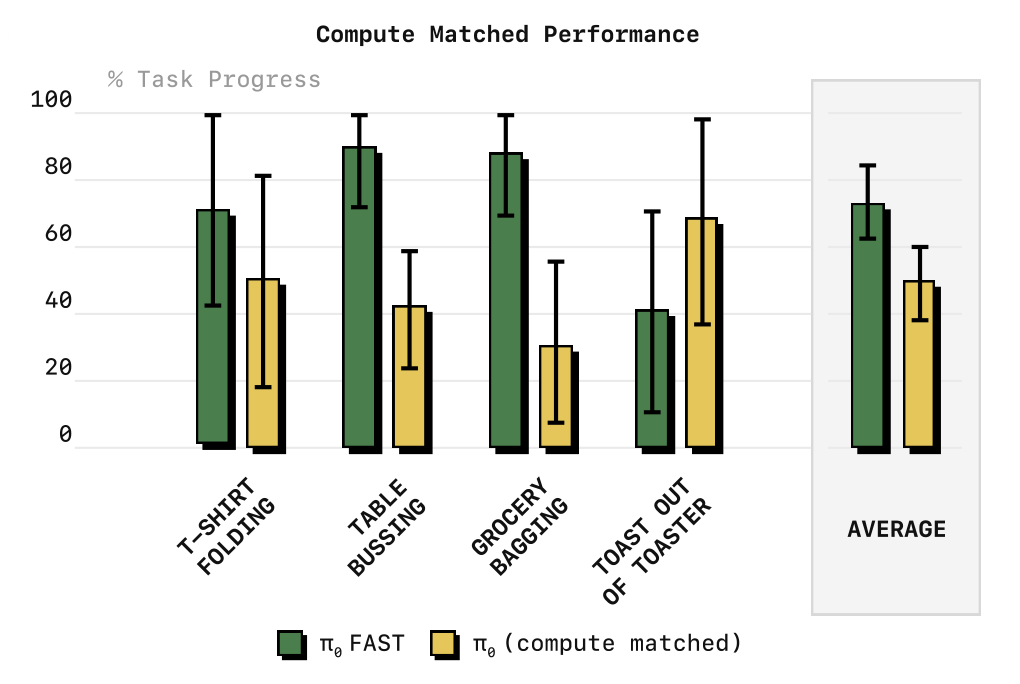
計算量を揃えた比較は、より直接的に高速な収束を裏付けます:FAST は全体平均が高く、bussing / bagging で明確な利得がある一方で、toast では依然として遅れを取っています。これは、あらゆるタスクで最終的な能力がより強いというよりも、学習効率の高さを示す証拠です。
デプロイの境界: RTX 4090 上では、VI-E によると、1 秒チャンクあたり π0 は通常 100 ms 未満、π0-FAST は約 750 ms です。FAST は完全な言語バックボーンを通しておよそ 30〜60 トークンをデコードし、π0 はより小さい 300M のエキスパートを主に 10 回の flow 更新で繰り返し使用します。静的なタスクではこのレイテンシを許容できますが、動的タスクや推論の最適化は今後の課題として残ります。
周波数空間トークナイゼーションと自己回帰ポリシーモデリング
メカニズム 1:DCT で軌道を表現する
問題設定と直感
滑らかな軌道では、隣り合う制御点は互いに似ています。独立したターゲットは、サンプリングレートとともに増加しますが、情報量はあまり増えません。DCT は代わりに、どの余弦波形がどの振幅で組み合わさって軌道を形成しているかを記述します。
少数の低周波係数で滑らかな大域的形状を表現できることが多く、高周波数は急激な変化や細部を表します。DCT 自体は高周波数を捨てたり、固定のローパスフィルタを課したりはしません。 完全な DCT と逆 DCT は可逆であり、損失は量子化によって導入されます。
形式的な表現
説明: この論文では、各アクション次元に対して独立に DCT を適用します。以下では説明のために直交正規化された DCT-II の慣習を用いていますが、この疑似コードがその正規化を指定していると主張するものではありません。
正規化されたチャンク に対して:
はチャンク内の時間インデックス、 はアクション次元、 は周波数です。 は係数行列です。 は定数成分であり、 が大きくなるほど変化が速くなります。DCT は関節間ではなく時間方向に作用します。
対応する逆変換は次のとおりです:
各時刻は複数の周波数に依存し、1 つの周波数係数は通常チャンク全体に影響します。
最小の数値例
説明: とし、正規化されたアクションの例を次のようにします:
一定の第 1 次元は、1 つの非ゼロな定数係数だけで表現できます。増加する第 2 次元は、主に定数成分と第 1 の変動成分で表され、最高周波数係数は小さくなります。依然として 4 つのタイムステップと 2 つの次元がありますが、変わるのは座標表現だけです。
なぜ有効か: 滑らかな動きの高密度サンプリングは、重要な周波数を必ずしも増やさずに似た点を追加します。共有情報を集中させることで、より少数の情報量の高いトークンへの圧縮が可能になります。
スケールと限界: チャンクは通常およそ 1 秒です。 では時間的な冗長性はなく、チャンクが短いと圧縮は制限され、長いチャンクはホライズンを伸ばす一方で、オープンループで実行する場合にはフィードバックを遅らせます。急な接触やグリッパの切り替えには高い周波数が必要になる場合があり、少数の低周波だけではすべてのアクションを正確に表現できないことがあります。
メカニズム 2:量子化、周波数優先の並べ替え、そして BPE
DCT だけでは不十分な理由
DCT は依然として 個の実数係数を生成します。各係数を個別にトークン化しても系列は短くならず、ゼロ付近の係数はラベルの繰り返しを生みます。そのため FAST は量子化と BPE を追加します。
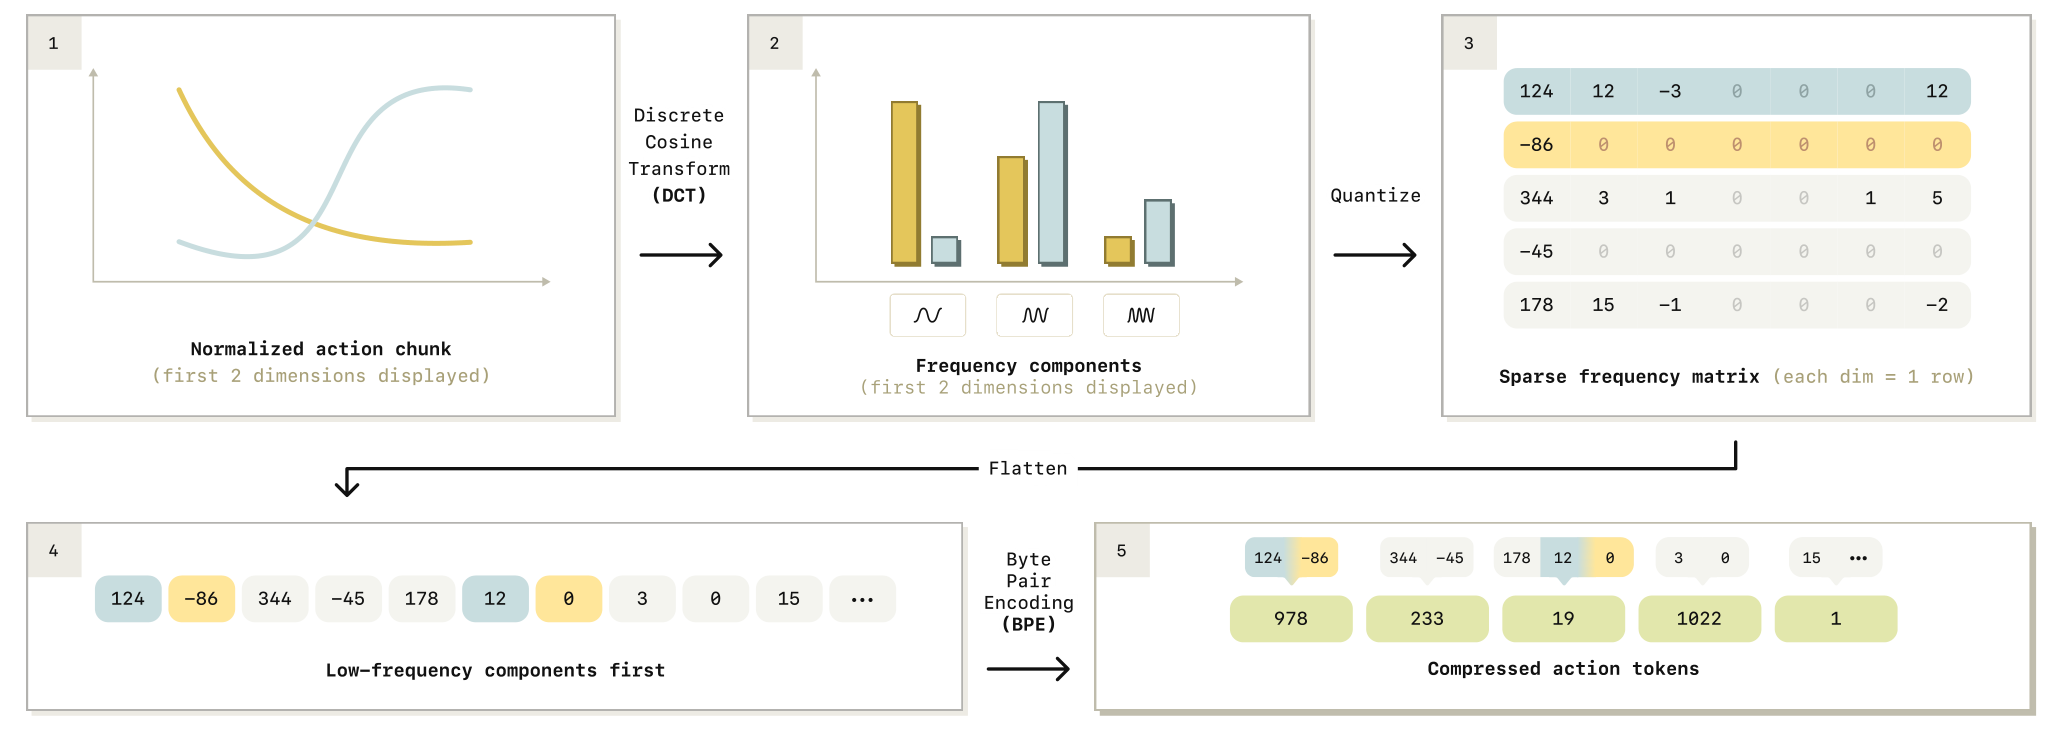
次元ごとのパーセンタイル正規化
論文: 学習データの各次元について、1 パーセンタイルと 99 パーセンタイルをそれぞれ と に写像し、スケール差と外れ値の影響を抑えます。
説明: 非退化な次元について:
と はそれぞれ 1 パーセンタイルと 99 パーセンタイルであり、 は物理的なアクション成分、 はその無次元の正規化値です。ある関節で の場合、物理アクション はそれぞれ に写像されます。
注意: パーセンタイルへの写像は、すべての値を に押し込むものではありません。クリッピングや のような退化ケースについては実装に従ってください。v1 ではそれらの詳細は示されていません。推論時に各予測チャンクごとにパーセンタイルを再計算するのではなく、デプロイ用に学習時の統計量を保存しておきます。
スケーリングと丸め込みによる圧縮可能な整数の生成
は整数行列、 はスケール、 は再構成された係数です。 を大きくするとグリッドが細かくなり、通常は再構成精度が向上しますが、トークン数が増える可能性があります。小さい値では小さな係数がより多くゼロになり、誤差が大きくなる代わりにより強く圧縮されます。
論文: データセット固有の実験では と語彙 を使用しており、テストした範囲では感度は限定的でした。これは任意のアクション空間に対する普遍的な設定ではありません。
の例を続けます:
最高周波数の はゼロになり、 は になります。最初の 2 つの周波数だけを残すようなルールはありません。十分に大きな係数であれば非ゼロのまま残り得ます。
説明: 通常の丸め込みでは となります。これは 1 つの係数の誤差を拘束するものであり、物理的な関節誤差を直接拘束するものではありません。関節誤差は逆変換、アクションスケール、およびクリッピングにも依存します。
周波数優先の並び替えは大域的な形状を優先する
BPE の前に、FAST は係数を周波数の低い順に並べ、その中でアクション次元順に並べます:
には 個の整数が含まれます。例では:
Frequency 0, two dimensions: 4, 3
Frequency 1, two dimensions: 0, -2
Frequency 2, two dimensions: 0, 0
Frequency 3, two dimensions: 0, 0
Flattened: 4, 3, 0, -2, 0, 0, 0, 0
論文: 周波数優先の並び替えは、次元優先の並び替えよりも安定したロールアウトをもたらします。これは、まず大域的な低周波の形状を予測するためです。元の 行列ではこれを列優先と呼びますが、このガイドの の規約では行優先になります。重要なのは行/列というラベルではなく、意味的な並び順です。
BPE は共通の整数部分列をマージする
BPE は頻出する隣接シンボルの組み合わせを学習し、それらを有限の語彙に追加します。例示的な語彙では、 や を 1 つのトークンにマージし、8 個の整数からなる例を短くできます。
説明: 実際のマージルールと ID は学習データに依存し、ここでの例は論文の語彙そのものではありません。トークンは次元や隣接する周波数をまたぐことができ、デコード時に整数列へ展開されます。
重要な違い: 係数の丸め込みはロスありですが、BPE は量子化された整数列に対してロスレスです。ゼロの位置は削除されず、保持されたまま圧縮されます。そうでなければ、逆変換でそれらの周波数や次元の位置情報が失われてしまいます。
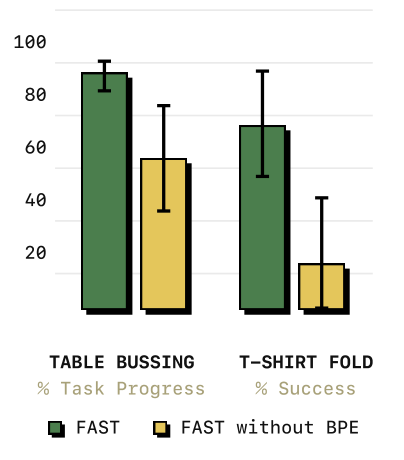
アブレーションの読み方: BPE がなくても、DCT は依然として情報を集中させ、ポイントワイズなビニングより優れていますが、繰り返されるゼロトークンが教師信号を希釈し、デコードステップを増やします。実タスクの両方で性能が低下しており、DCT と BPE がそれぞれ独立に貢献していることを裏付けています。
デモンストレーションのモデリングと FAST+ のエンボディメント間での再利用
1 つの観測に複数の妥当なアクションが存在し得る
人はシャツのどちらの端をつかんでもよく、異なる広げ方をするかもしれません。単純な平均二乗回帰では、複数の妥当な選択肢を無効な中間経路へと平均してしまう可能性があります。π0 は連続分布をモデル化し、π0-FAST は圧縮トークン上の確率をモデル化します。
自己回帰的な因数分解:
は FAST シーケンスであり、 はトークン より前の接頭辞です。各ステップでは物理的なアクション値を平均するのではなく、語彙上の確率を予測します。完全なシーケンスをデコードすると軌道になります。
注意: FAST には π0 のような CVAE エンコーダ、ノイズ付きガウスアクションチャンク、フロー時間入力はありません。このセクションでは、ACT や π0 のモジュールを取り込まずにデモンストレーションのモデリングを説明します。カバレッジは依然としてデータ、量子化の忠実度、および学習に依存します。
高レートのラベルの繰り返しが学習を弱める理由
説明: 隣接する値がほとんど変化しない場合、次のトークンの条件付きエントロピーは低くなり得ます:
はランダムなアクショントークンであり、 は条件付きエントロピーで、ホライズン とは別物です。予測しやすい接頭辞が次のラベルの多くを説明してしまうため、繰り返しが多くても、画像やタスクへの依存が十分でなくても高いスコアを得られてしまいます。
この情報論的な観点は、合成データと高レートの結果を説明するものであり、すべてのビニングされたポリシーが失敗することや、トークン数が少ないほど常に良いことの証明ではありません。強い圧縮損失は依然として誤った挙動を生み出し得ます。
FAST+ によるユニバーサルな語彙
FAST の解析的ステップはデータセット間で転移可能ですが、データセット固有の BPE 語彙は必ずしもそうではありません。FAST+ は、約 100 万個のエンボディメント横断チャンクから、より広いカバレッジを学習します:
Multiple robots, action spaces, and control rates
→ Normalize for each data configuration
→ Pad training actions to 32 dimensions
→ DCT, quantization, frequency-first flattening
→ Train BPE on the pooled integer sequences
→ Reusable FAST+ tokenizer
語彙が学習するのは、共通する係数パターンやゼロであり、カメラのセマンティクスやロボットの完全な運動学コントローラではありません。新しいポリシーは依然として、何をすべきかを学ぶために画像、言語、状態、アクションのデータを必要とします。ユニバーサルなトークナイズとジェネラリスト制御は、異なるレベルの話です。
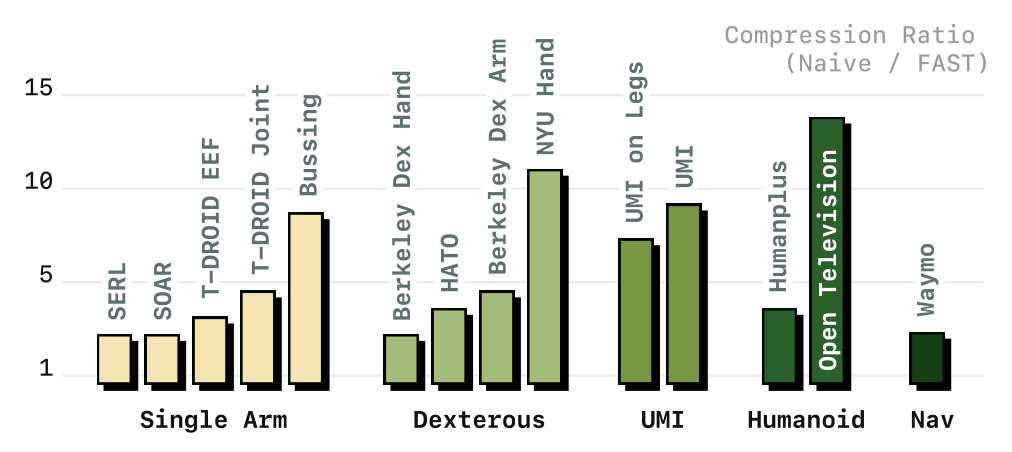
図の読み方: FAST+ は多様な形状、次元、周波数を圧縮します。VI-C ではテストを未観測データと呼んでいますが、表 III には学習時にも名前が挙がるプラットフォーム/タスクのバージョンが含まれています。したがって「未観測」は論文のデータ分割レベルで維持されており、すべてのロボットカテゴリにまで拡張されているわけではありません。
境界: 図 10 はオフライン圧縮であり、ヒューマノイド歩行、巧緻なハンド、あるいは自動運転ポリシーの成功を示すものではありません。セクション VII では、物理ポリシーは主に固定マニピュレータで検証されていると述べています。表 III には 40 次元のヒューマノイドデータが含まれているため、32 次元の学習用パディングは本手法にとっての数学的な最大値ではありません。
トークナイザの学習、エンコード、およびデコード
トークナイザの学習
サンプルインデックス を持つデモンストレーションチャンク に対して:
-
各データ構成について、次元ごとのパーセンタイル統計量を計算して保存します。
-
に正規化し、各次元ごとに時間方向へ独立に DCT を適用します。
-
固定の を用いて整数 に量子化します。
-
周波数優先の順序でフラット化して を得ます。
-
すべての整数列に対して固定サイズの BPE を学習し、語彙とマージルール を得ます。
論文: BPE は学習される唯一のトークナイザ構成要素です。特定の語彙の学習には通常数分しかかからず、VLA に必要な数日以上の時間は不要です。DCT と量子化にはニューラルウェイトがなく、別個の VQ エンコーダ/デコーダも必要ありません。
エンコード:将来のデモンストレーションをラベルに変換する
完全なエンコードは次のとおりです:
は正規化、 は周波数優先のフラット化、 は固定された BPE ルールです。DCT は各次元ごとに時間方向へ作用します。エンコードには実際の将来アクションが必要なため、デプロイ時に将来の知識を仮定するのではなく、学習用ラベルを生成します。
注意: アルゴリズム 1 は DCT から始まり、明示的な正規化を省略していますが、V-B では本文中で正規化を明記しています。このガイドは完全なパイプラインに従います。丸め込みは厳密には可逆ではないため、デコードは量子化前アクションの近似を再構成します。
デコード:予測を実行可能なアクションに変換する
を生成した後:
は生成されたトークン数であり、 は係数行列を再構成し、 は対応する逆変換です。最終的な は連続値です。デプロイ時には依然として目標とする が必要であり、可変長トークンは制御インターフェースの定義を置き換えるものではありません。
前述の線形正規化に対して、逆正規化は次のようになります:
説明: の例を逆変換すると、おおよそ次のようになります:
元の第 2 次元は であり、再構成では増加する形状が小さな誤差とともに保持されています。BPE デコードは に変更を加えません。誤差を生むのは量子化です。これらは正規化された値であり、ラジアンやミリメートルそのものではありません。
圧縮と再構成を合わせて確認する
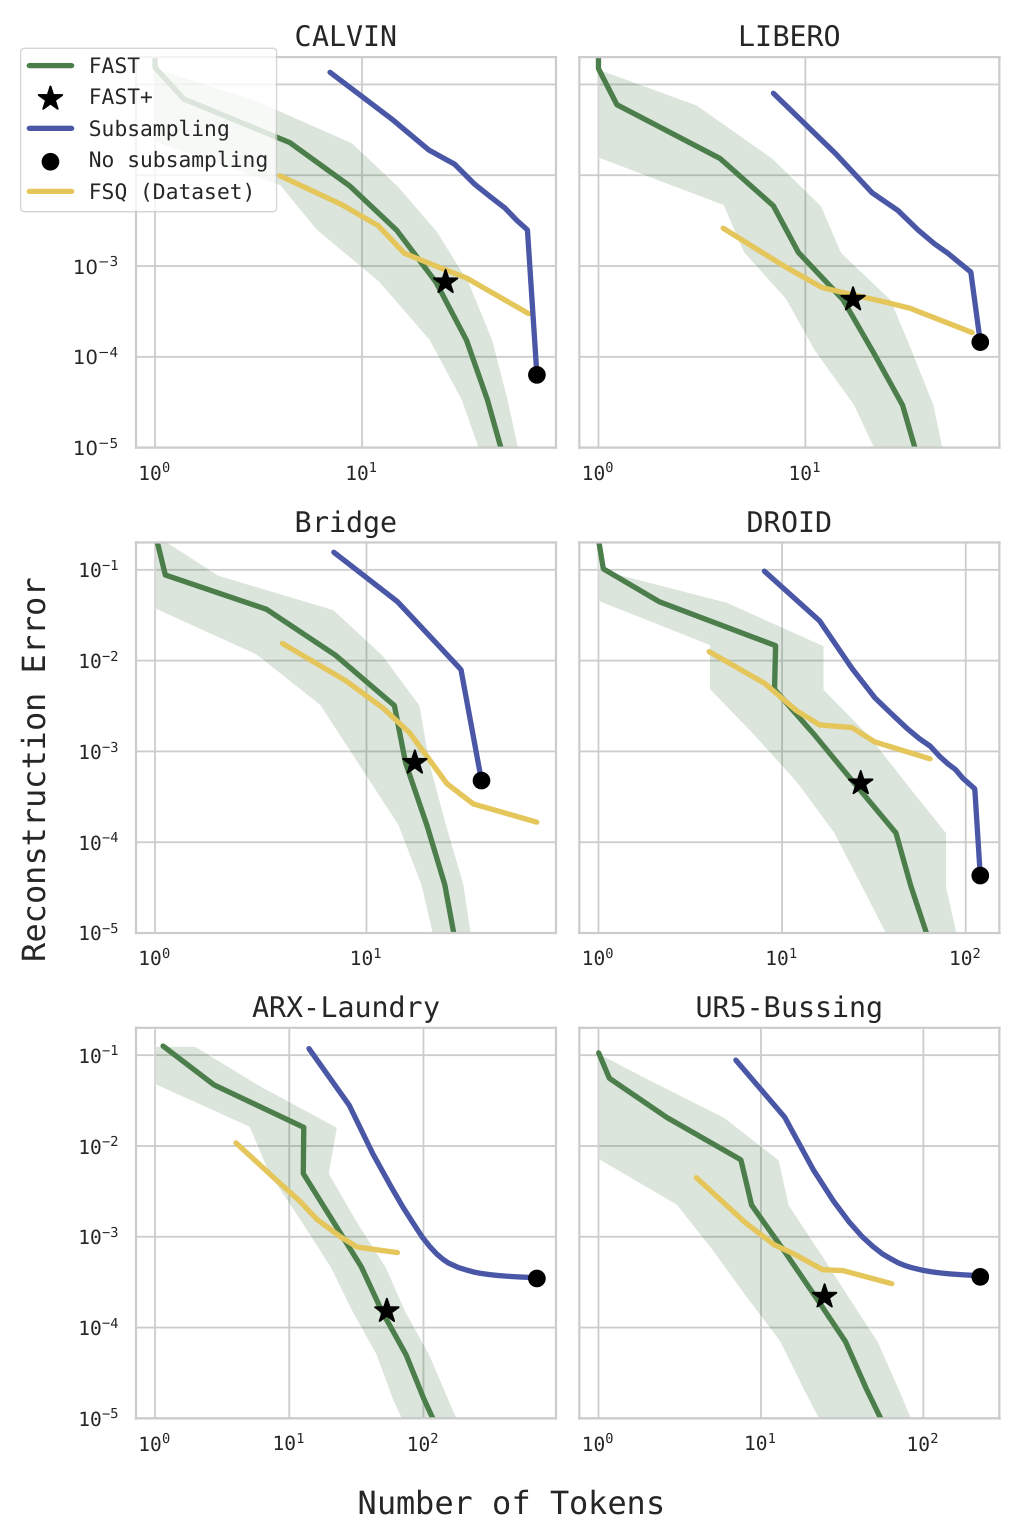
図の読み方: 学習された FSQ は、低精度かつごく少数のトークンでも有効になり得ます。より高い精度では、FAST の誤差はトークン数とともにより大きく減少し、テストされた精密制御タスクにより適しています。最も短いシーケンスが、自動的に最良の軌道表現になるわけではありません。
制約: 量子化スケールが非常に小さいと係数が消えてほぼ一定の動きになり得ます。スケールを大きくすると忠実度は向上しますが、圧縮可能なゼロが減り、より複雑な整数が増えます。大きな語彙はより多くの組み合わせを表現できますが、出力スロットを多く消費します。テストされた範囲は、性能が単調に向上することを示すものではありません。
エンジニアリング上の注意: 予測されたトークンや展開後の長さが不正になる場合があります。実行前にチャンク形状、有効次元、および制御制限を確認してください。v1 は修復方法を完全には規定していないため、パディングや切り詰めを論文で文書化された実装として提示してはなりません。
完全な π0-FAST ネットワーク
入力と形状
各予測は次の条件に基づきます:
-
2 枚または 3 枚の の RGB 画像。
-
自然言語による指示 。
-
プラットフォーム依存の次元を持つ固有感覚 。
-
学習時のみ、FAST の教師あり信号として用いる将来の実際の行動 。
表 I のシャツ設定では を用い、 個のラベルになります。DROID 設定では を用い、 になります。実際のデータセット版に対して有効な行動空間を使用してください。
π0 との違い: π0 は状態とノイズを含む行動を連続的にエキスパートへ射影します。FAST v1 は現在の状態を 256 段階にビニングし、その整数をテキストとしてトークン化する一方で,将来の行動には FAST を用います。状態は高レートで長く出力されるものではなく現在の条件に過ぎないため,著者らはそこでの単純なビニングで十分と見なしています。
1 つのバックボーンでの画像とテキスト特徴
事前学習済みエンコーダがカメラごとに視覚トークンを生成し,タスクと状態の文字列がテキストトークンを生成します。これらを合わせて観測プレフィックスを構成します。PaliGemma-3B が主なバックボーンであり,比較として OpenVLA/Prismatic 7B への転移も行われます。
説明: 画像あたり 個のトークン,言語/状態トークンをそれぞれ 個とすると,プレフィックス長は次のようになります:
はカメラ数, はプレフィックス長であり,いくつかのセパレータ/特殊トークンは無視しています。埋め込み幅を とすると,表現は になります。これは次元を説明するものであり,v1 の完全な仕様ではありません。視覚トークン数,幅,セパレータ,位置エンコーディングなどはすべてが与えられているわけではありません。
行動サフィックスとアテンション
FAST は提示された行動を 個のトークンとしてエンコードし,それらをあまり使われない VLM スロットにマッピングして,観測プレフィックスの後ろに予測サフィックスとして与えます。
説明: トークン の予測は観測と,それ以前の 個の行動トークンのみを用い,将来のラベルは決して用いません。これは因果的オートリグレッションであり,CVAE エンコーダや連続フロー型デコーダは使いません。
バックボーンの隠れ状態は語彙ロジットと分類確率になります。 はデータセット固有の実験における行動語彙であり,言語全体の語彙ではありません。
ポリシー学習損失
説明: 標準的な負の対数尤度が,述べられている次トークン目的を表現します:
はオートリグレッシブ損失, はポリシーの重み,期待値はデモンストレーションにわたる平均を表します。 はサンプルごとに異なります。v1 はトークンの平均化や終端記号の扱いを完全には規定していません。
Teacher forcing では学習中に真値の を用います。因果マスクにより,1 回のフォワードパスで全位置の損失を計算できる一方で,推論時は生成済みプレフィックスに依存し,逐次的に進行します。ターゲットを短くするとオーバーヘッドは減りますが,推論の逐次依存性は残ります。
論文の設定: 線形ウォームアップ 1,000 ステップの後,学習率は 。AdamW(),重み減衰なし,勾配クリッピング 1,指数移動平均係数 0.999。ポリシーの全重みをファインチューニングします。
サンプリングと連続出力
ほとんどのタスクでは greedy decoding を使用します。両手によるシャツ折りたたみ,トーストの取り出し,洗濯物のタスクでは温度 0.7 を用いており,これが初期姿勢付近のほぼ静止した挙動から抜け出すのに役立つと著者らは述べています。
説明: ロジット と温度 に対して:
は候補をインデックスし, はサンプリング確率です。このガイドでは,温度をオプティマイザの と区別するために を用いていますが,論文では温度を と書いています。これは量子化スケール とは異なります。
FAST はトークンをデータセットの物理単位での にデコードします。DROID は関節速度と絶対グリッパ位置を用い,他のタスクはそれぞれのプラットフォーム設定を用います。コントローラは有効な行動を実行し,その後,新しい観測から次のチャンクを生成します。
アブレーション: OpenVLA にマルチ画像入力と 1 秒チャンクを追加した後,ビニングを FAST+ に置き換えるとシャツ折りたたみが大幅に改善します。利点は π0 バックボーンを超えて広がりますが,このテストはすべての VLM に対して同等の改善を示すものではありません。
π0 と比較した完全なフロー
Training:
Demonstration images + task language + current state + real next-second actions
→ Encode images as visual tokens
→ Tokenize language and discretized state text as the observation prefix
→ Normalize actions; DCT; quantize; frequency-first flatten; BPE
→ Map action tokens to VLM output slots
→ Compute teacher-forced next-token cross-entropy
→ Fine-tune all policy weights to obtain π0-FAST

Inference:
Current images + task language + state
→ Construct observation prefix
→ Greedily decode or sample action tokens at the specified temperature
→ Reverse BPE and restore integer coefficient ordering
→ Dequantize, inverse DCT, denormalize
→ Obtain an H × D continuous chunk
→ Execute the configured steps with the low-level controller
→ Observe and predict again

In one sentence:
The VLM selects actions from the scene and task;
DCT concentrates shared information from densely sampled trajectories;
quantization and BPE turn coefficients into shorter token sequences;
autoregressive training models their conditional distribution, and FAST decoding restores continuous control.
The main benefits are action representation and training efficiency; v1 inference latency remains a major limitation.