SmolVLA: 軽量モデルはどのようにロボット動作を効率的に学習するのか
SmolVLA: 手頃で効率的なロボティクスのためのビジョン・言語・アクションモデル
- 軽量VLA
- コミュニティデータ
- フローマッチング
- 非同期推論
前提知識
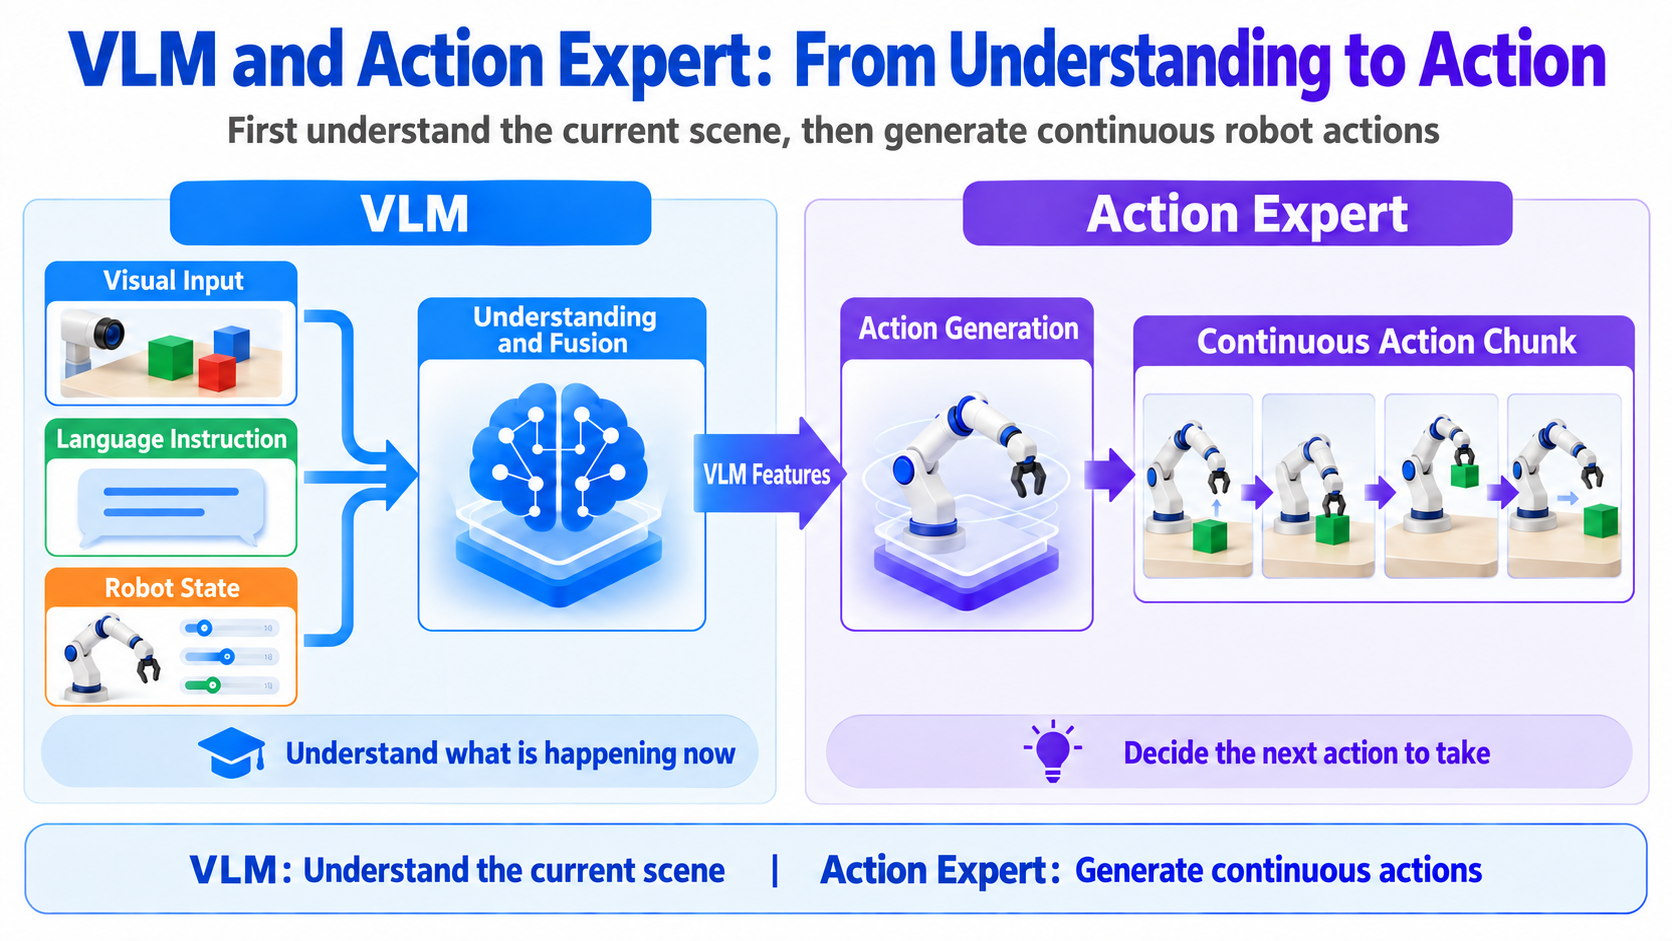
VLMとVLA
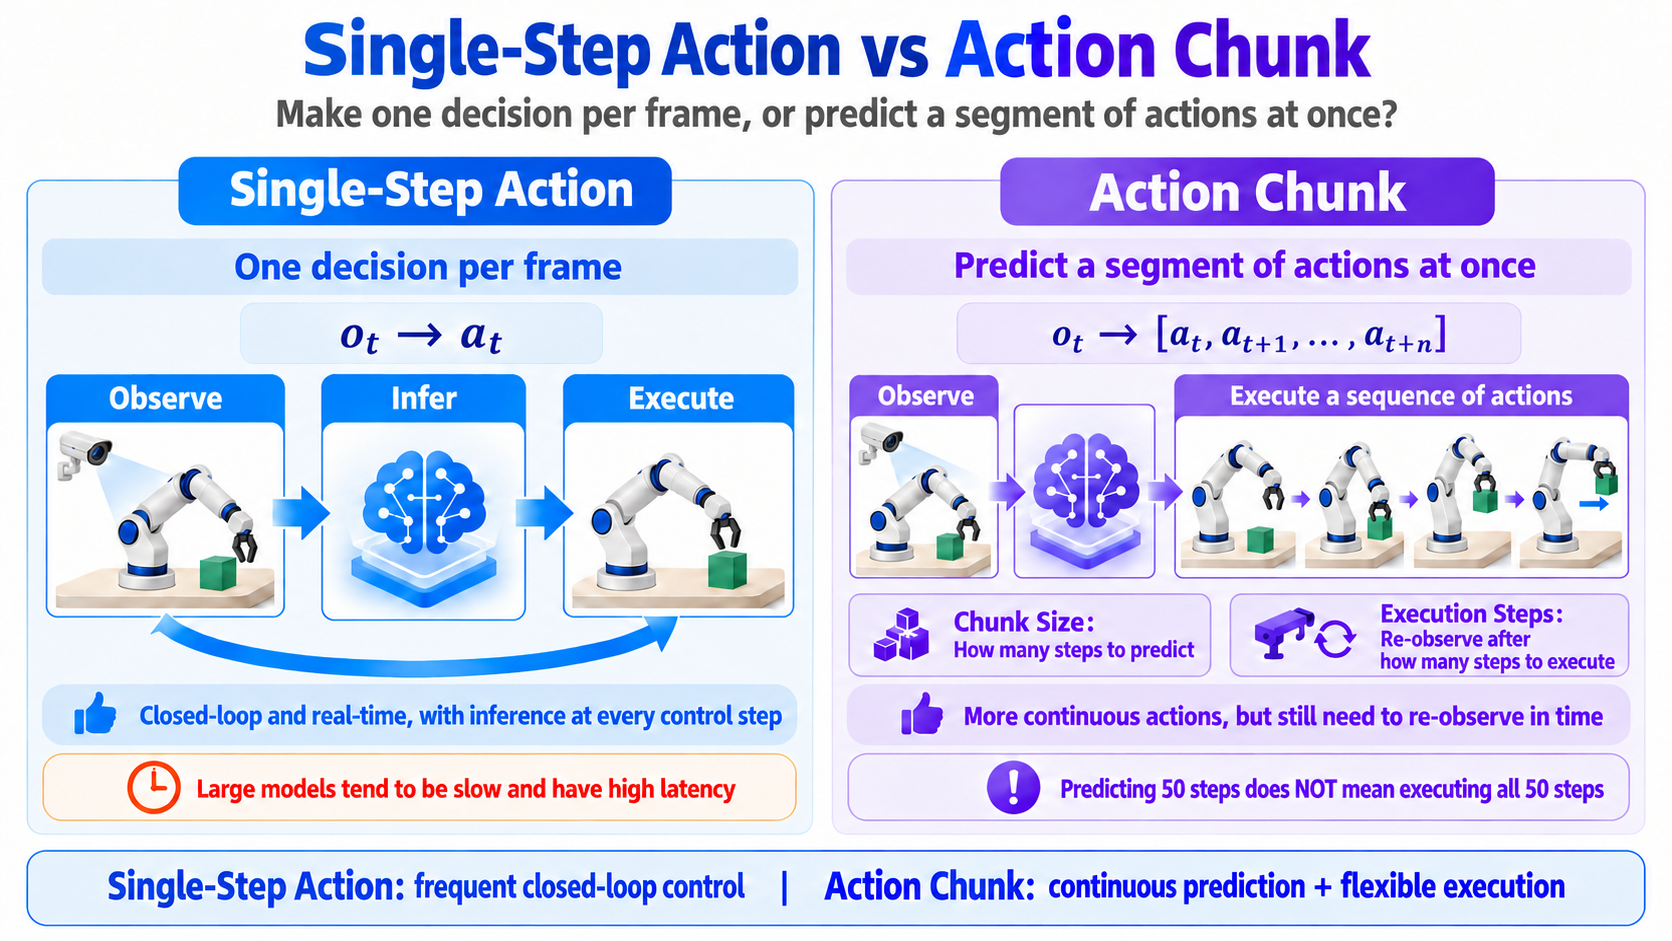
単一ステップ動作とアクションチャンク
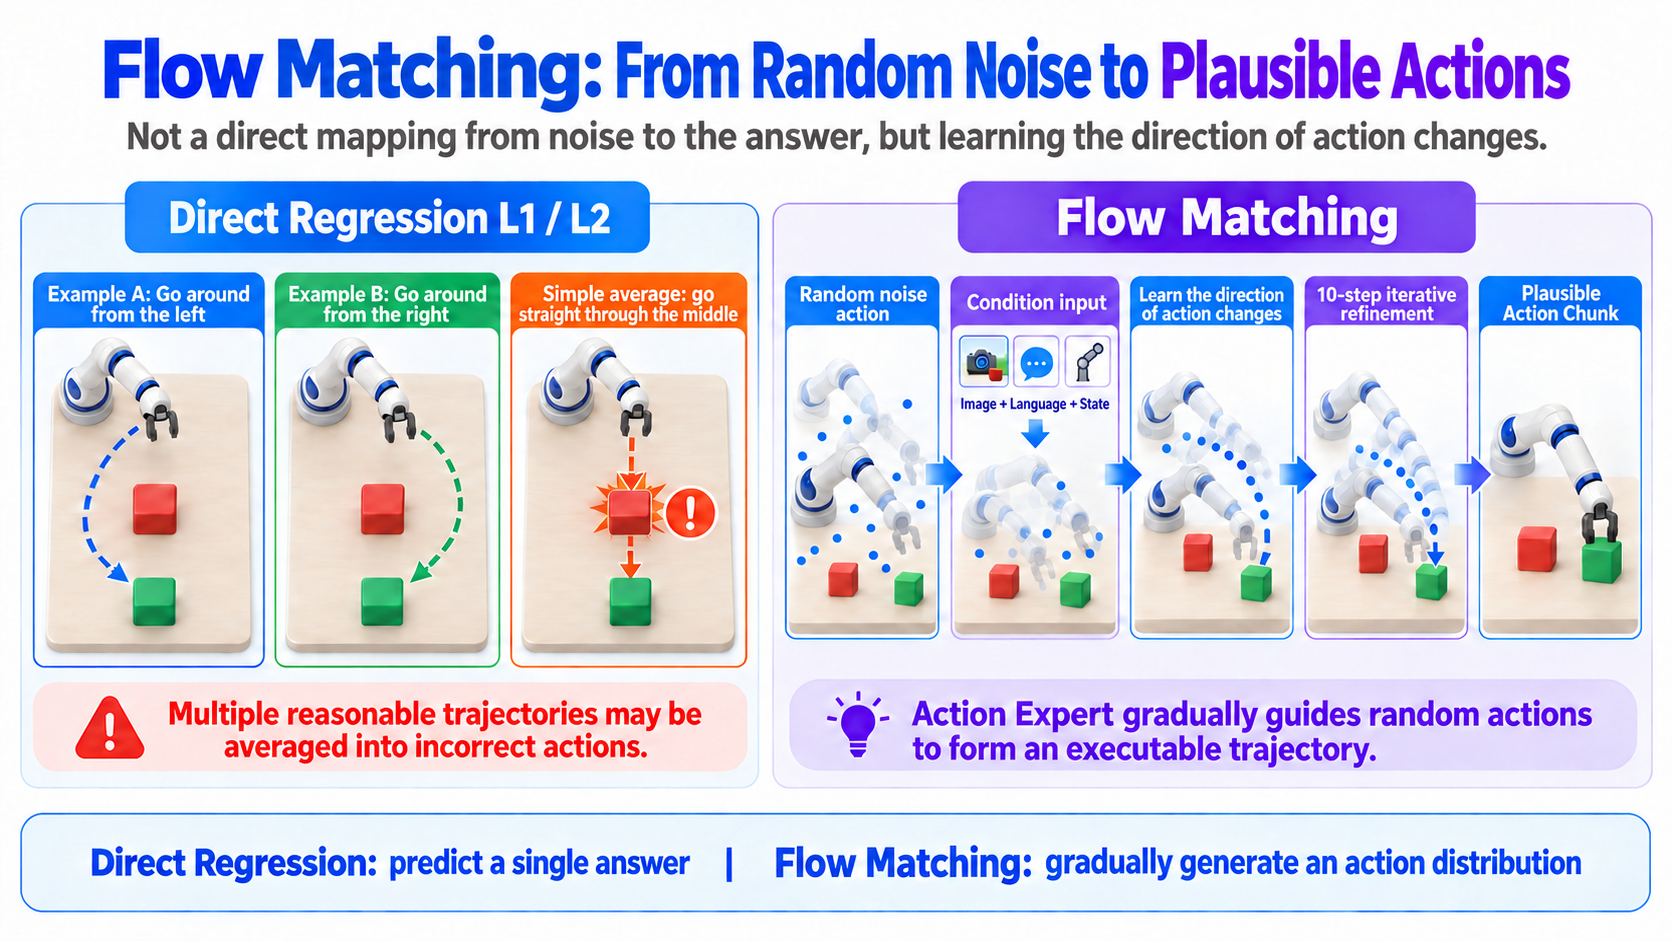
フローマッチングとは?
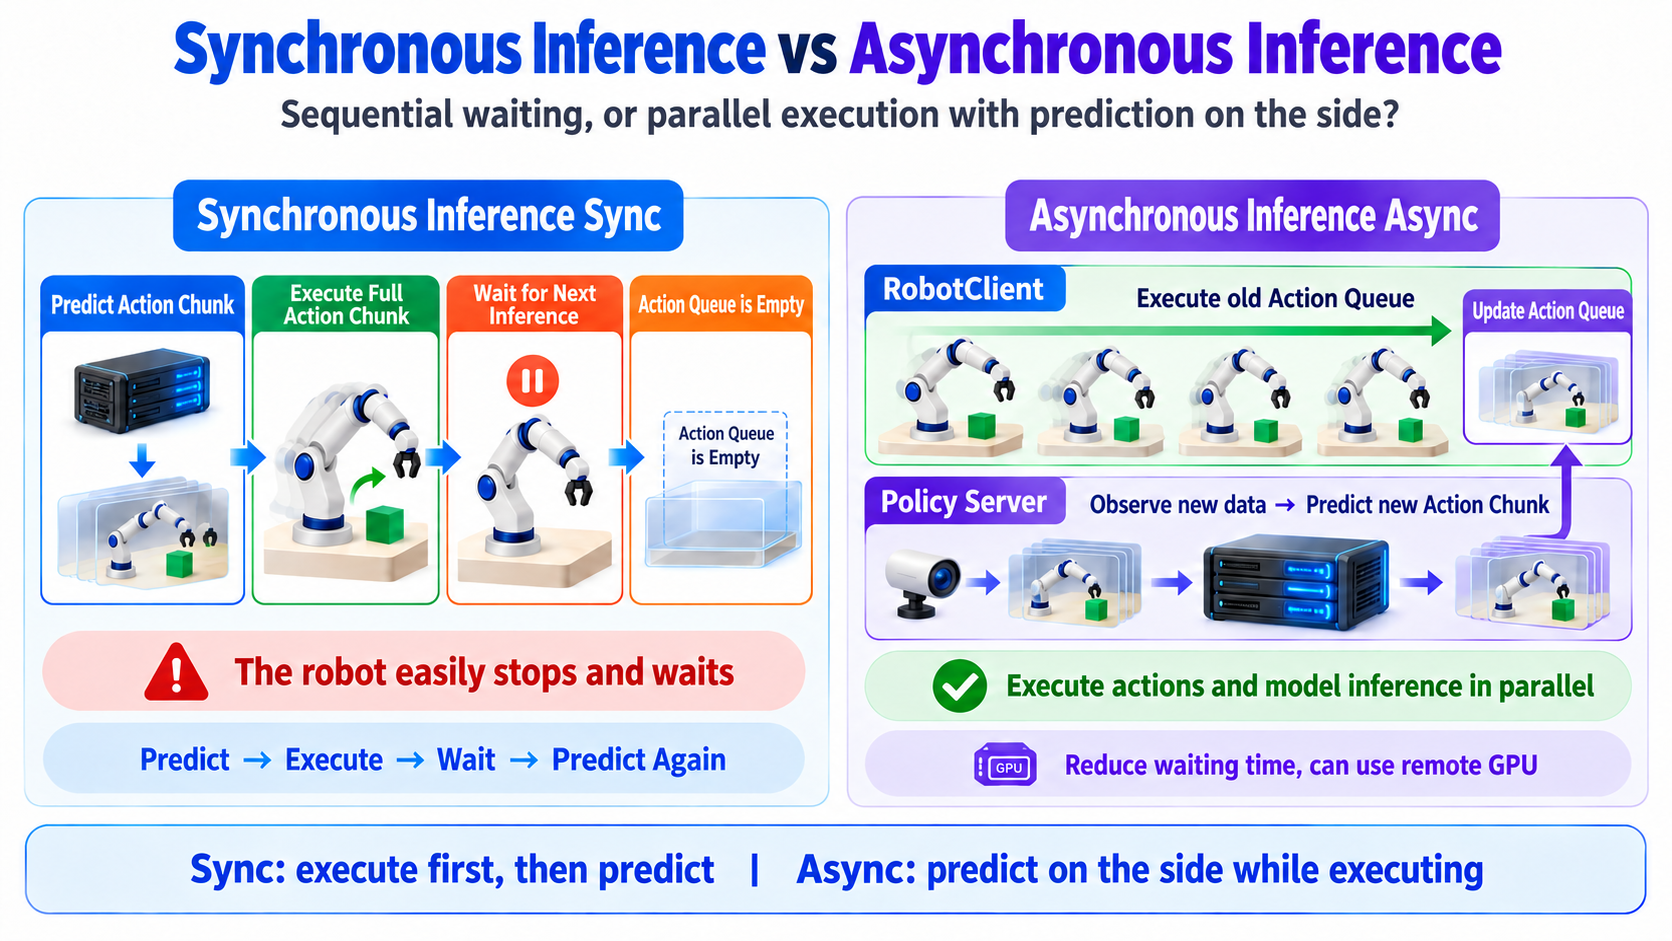
同期推論と非同期推論
要約
事前学習済みビジョン・言語モデルは、大規模なマルチモーダルデータセットから豊富な視覚と言語の知識を獲得しており、ロボットポリシーの有用な基盤となります。最近の研究では、ポリシーをゼロから学習する代わりに、自然言語の指示からロボットを認識・制御できるようVLMをVLAへと適応させています。
しかし、多くのVLAはパラメータ数が数十億規模で、学習コストが高く、実機ロボットへのデプロイも困難です。また、主に学術・産業のデータセットに依存しており、低コストなロボットコミュニティからの増え続ける公開データは十分に活用されていません。
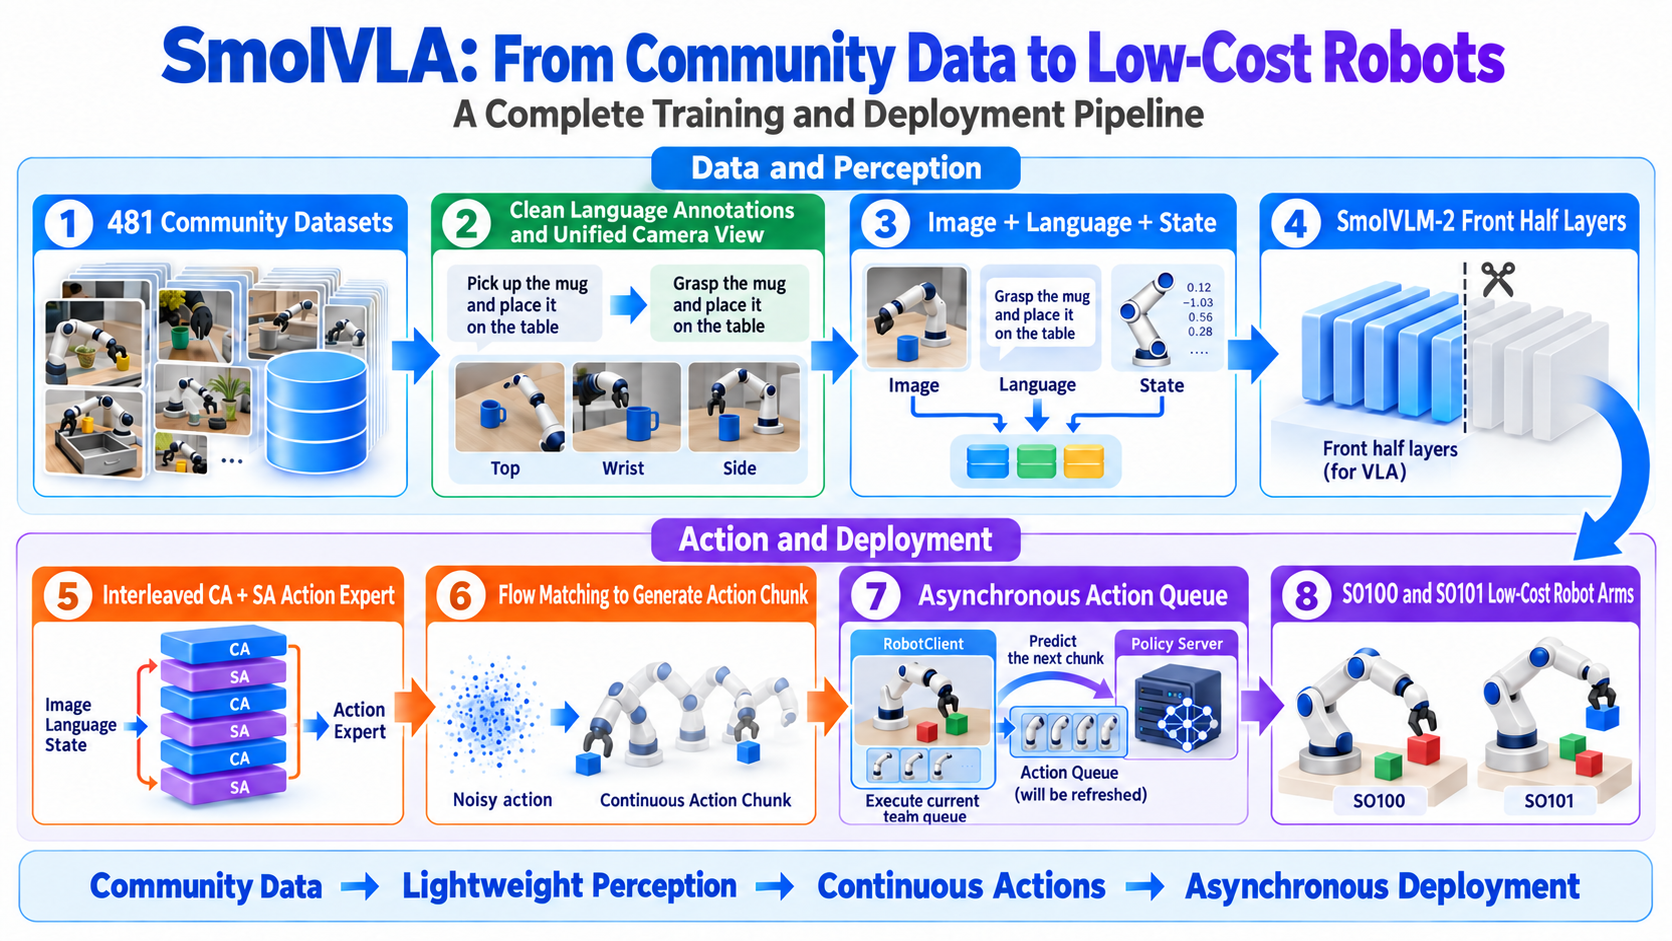
SmolVLAは、小型で効率的な、コミュニティデータ駆動のVLAです。競争力のある性能を維持しつつ、学習と推論のコストを削減します。1枚のGPUで学習でき、コンシューマー向けGPUや、さらにはCPU上にもデプロイ可能です。
この論文では、知覚と動作予測を実行から分離する非同期推論スタックも導入しています。ロボットは現在のチャンクを実行しながら、次のチャンクを予測します。その小ささにもかかわらず、SmolVLAはおよそ10倍大きいVLAと競合します。著者らはシミュレーションおよび実機ロボットタスクで評価を行い、コード、事前学習済みモデル、学習データを公開しています。
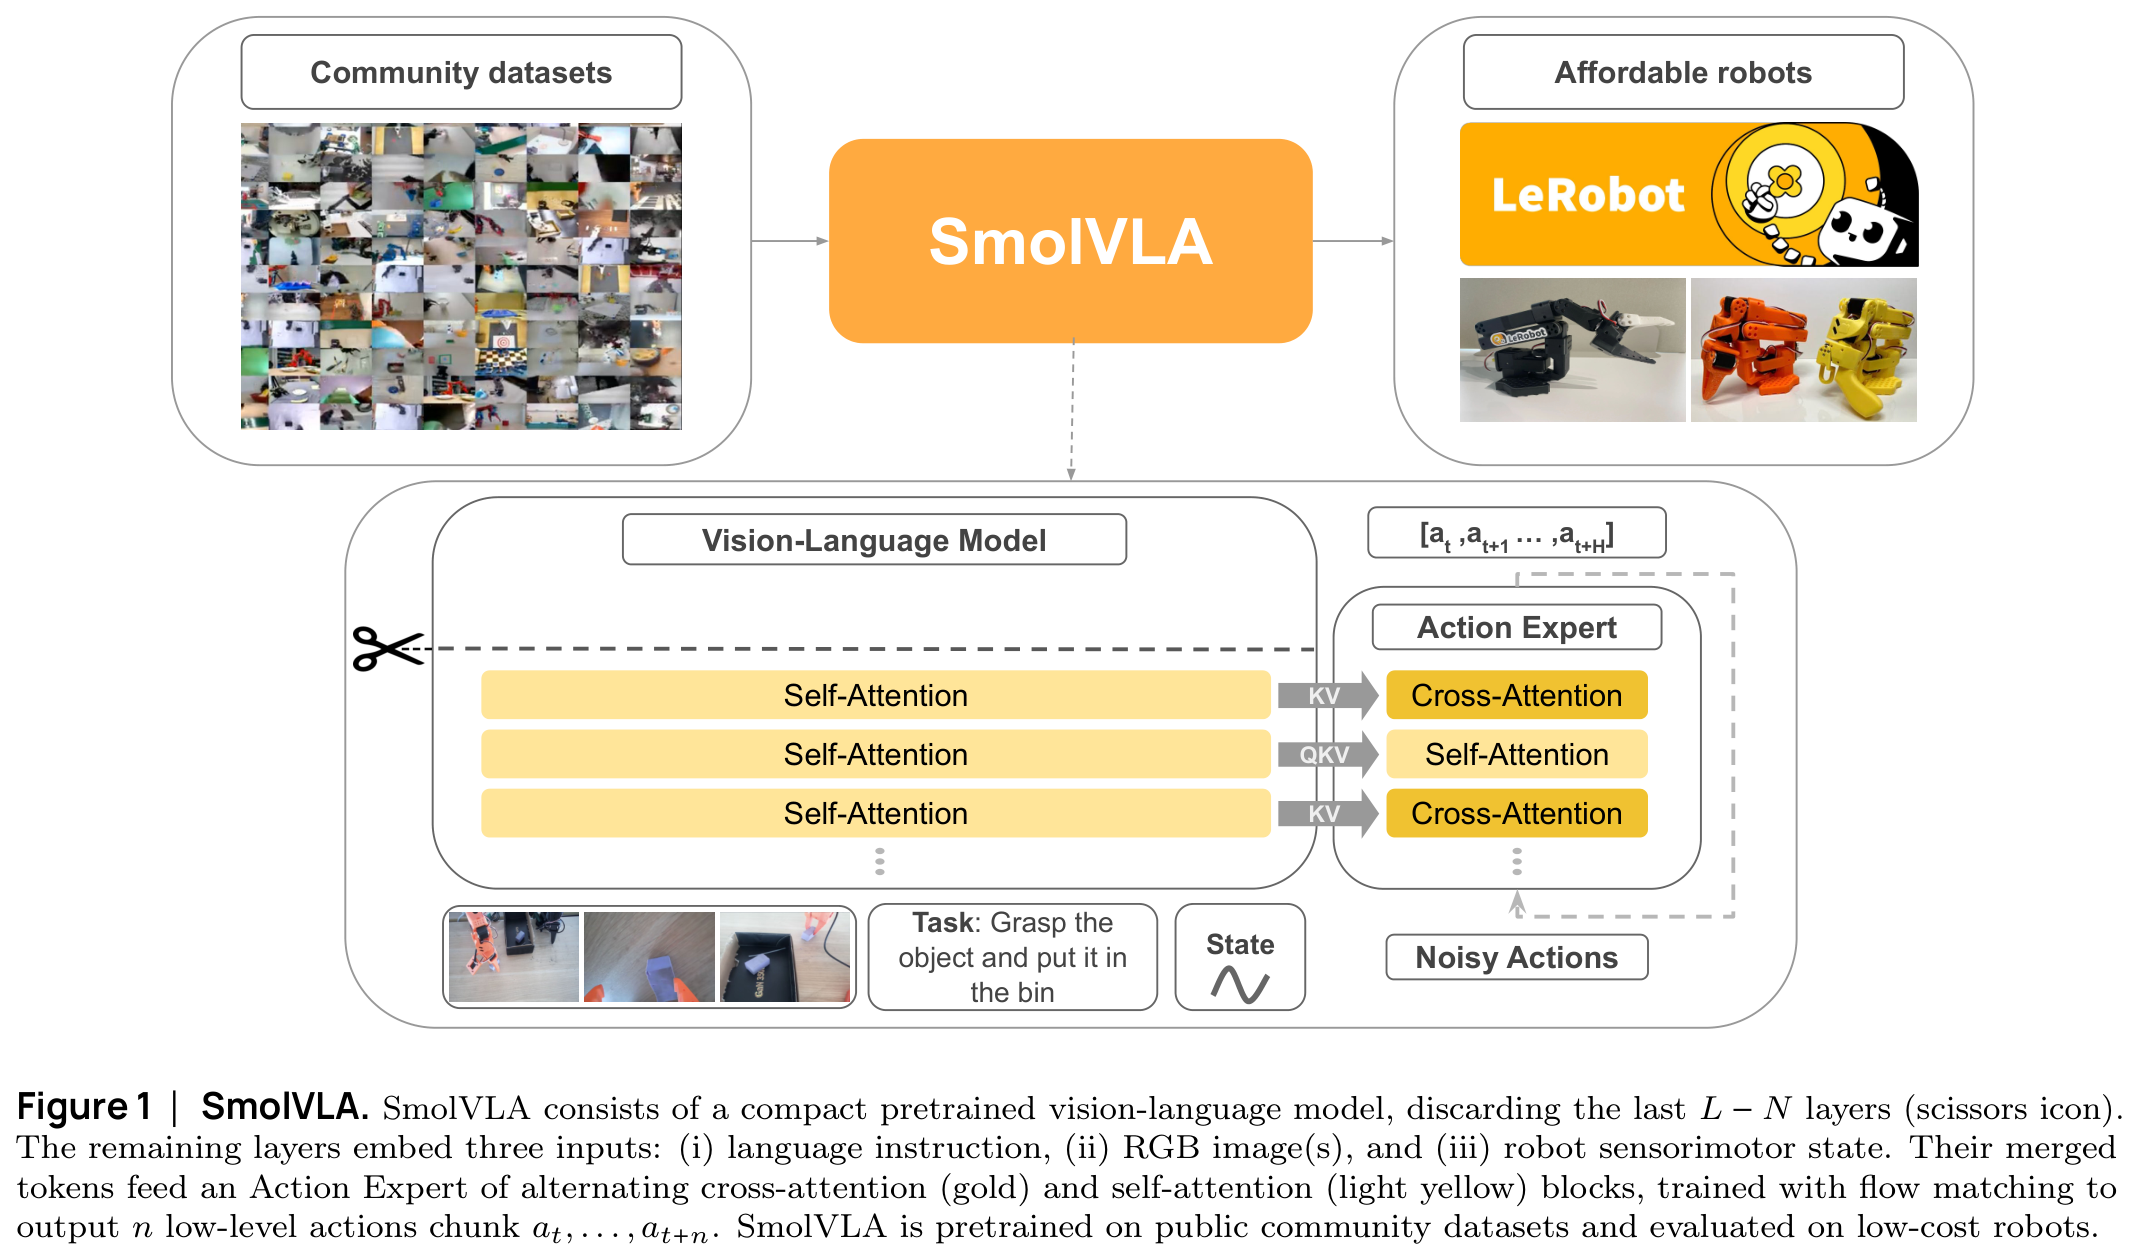
SmolVLAの軽量アーキテクチャとネットワーク全体像
全体的なデータフロー
- SmolVLAはVLMとアクションエキスパートから構成されます。
Multi-view RGB images
Language instruction
Robot state
      ↓
    VLM
      ↓
Scene-conditioning features
      ↓
Action Expert + Noisy Actions
      ↓
Flow Matching
      ↓
Action Chunk
- VLMは環境を解釈し、アクションエキスパートはその表現を連続値のアクションへと変換します。言語モデルは、関節角度を直接指定するのではなく、条件付けの特徴量を提供します。
画像・言語・状態がVLMに入る仕組み
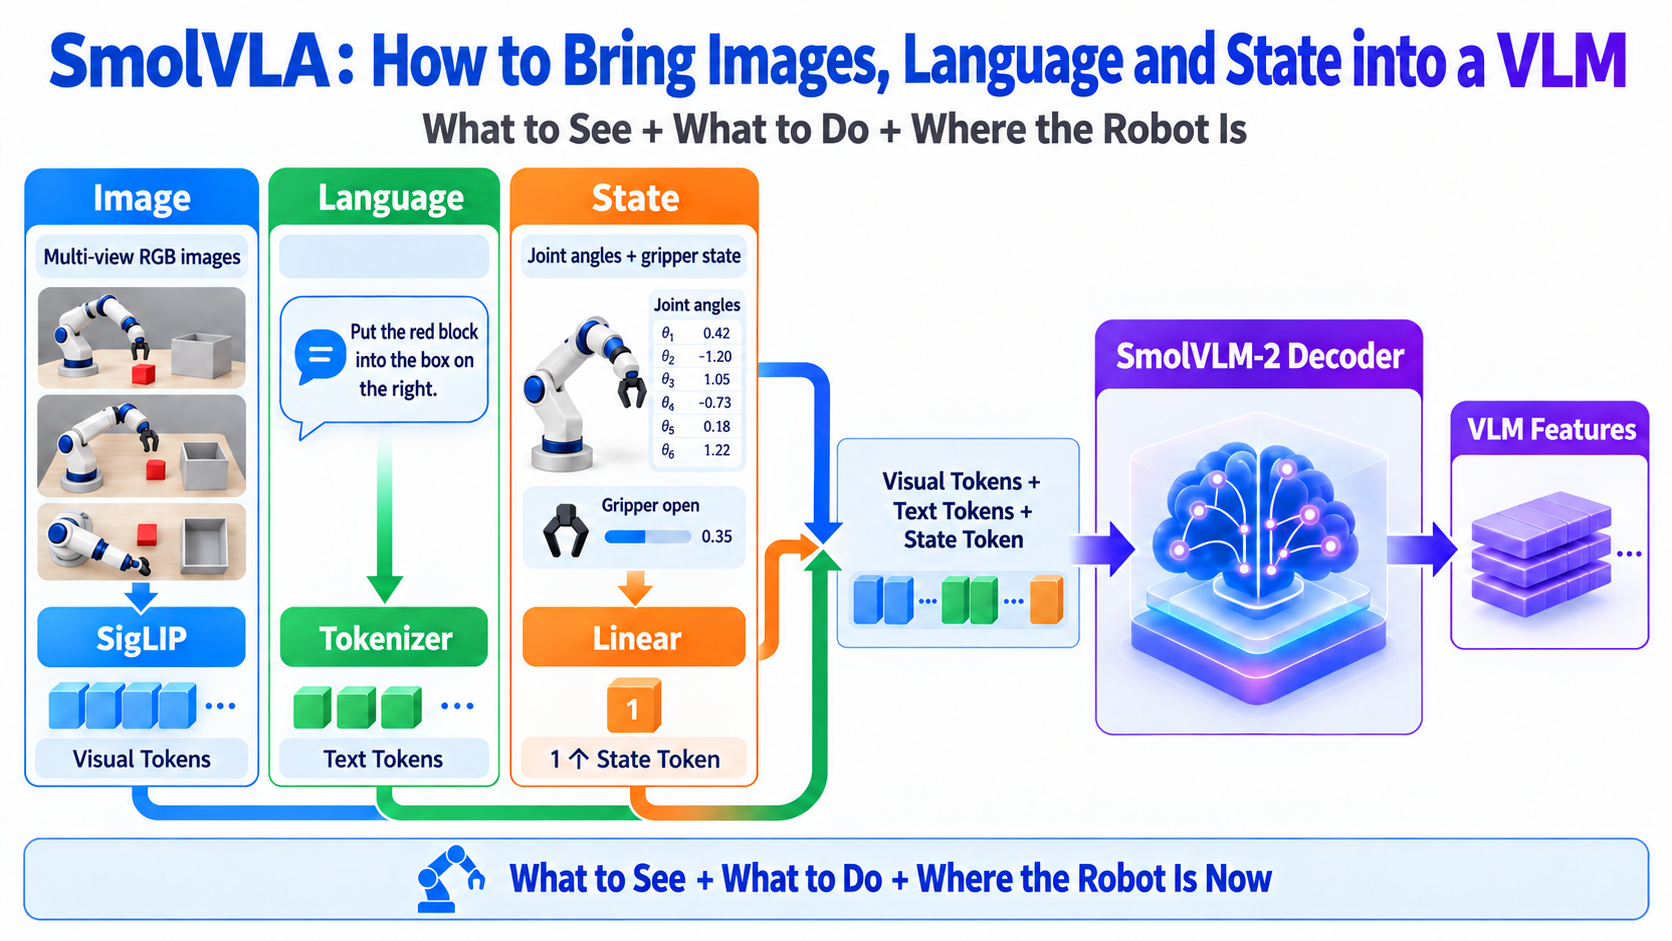
なぜフレームごとに64個のビジュアルトークンだけを保持するのか?
-
高解像度画像は多数のビジュアルトークンを生成します。トークン数が増えるとアテンション計算が増大し、推論が遅くなります。
-
SmolVLM-2は画像タイル分割をサポートしており、複数の局所画像領域をエンコードできます。SmolVLAは速度を優先してタイル分割を無効にし、グローバル画像を保持しつつ、ピクセルシャッフルを用いて各フレームを64個のビジュアルトークンに制限します。
-
これにより小さな物体のディテールや細かなテクスチャは犠牲になる可能性がありますが、計算量は大幅に削減されます。
なぜVLMの前半だけを使うのか?
-
層数LのVLMに対して、SmolVLAは層Nで特徴量を抽出し、残りのL−N層を破棄します。
-
著者らは、
N = L/2が速度と性能のバランスを取ると見出しました。メインモデルでは最初の16層の言語モデル層を使用します。
Full VLM: Layer 1 → 2 → ... → L

SmolVLA:Layer 1 → 2 → ... → N → Action Expert
                               × Remaining layers are not computed
- これは交互の層をスキップするのではなく、前半をそのまま保持する形です。アブレーションの結果から、バックボーンをより小さなVLMに置き換えるよりも有利であることが多いと示唆されています。保持された層が、大きなモデルの幅と表現能力を維持するためです。
アクションエキスパートがアクションを生成する仕組み
-
アクションエキスパートは次の入力を受け取ります:
-
VLMからの条件付け特徴量。
-
ノイズを加えたアクションチャンク。
-
-
これがクロスアテンションと因果的自己注意を交互に適用します。
クロスアテンションは現在のタスクを読み取る
- アクショントークンはクエリとして機能し、VLM特徴量からキーとバリューを読み取って、次の問いに答えます:
What is visible now?
What does the instruction request?
What is the robot's current configuration?
自己注意はアクション同士を関連付ける
- アクショントークン間の自己注意により、将来のシーケンスが一貫したものになります。例えば「接近 → グリッパーを閉じる → 持ち上げる → 運ぶ → 置く」といった流れです。
なぜ因果マスクを使うのか?
-
マスクにより、アクションiはそれ以前のアクショントークンには注意を向けられますが、それ以降のトークンには向けられません。
-
論文のアブレーションでは、双方向アテンションは性能が劣ることが示されています。著者らは、将来のアクションの情報漏れを防ぐことで、より適切な時間構造の学習に役立つと示唆しています。
-
最終的な構造は次のとおりです:
VLM Features ───────┐
                    ↓
Noisy Actions → Cross-Attention
                    ↓
              Self-Attention
                    ↓
              Cross-Attention
                    ↓
              Self-Attention
                    ↓
               Action Chunk
SmolVLAにおけるフローマッチング
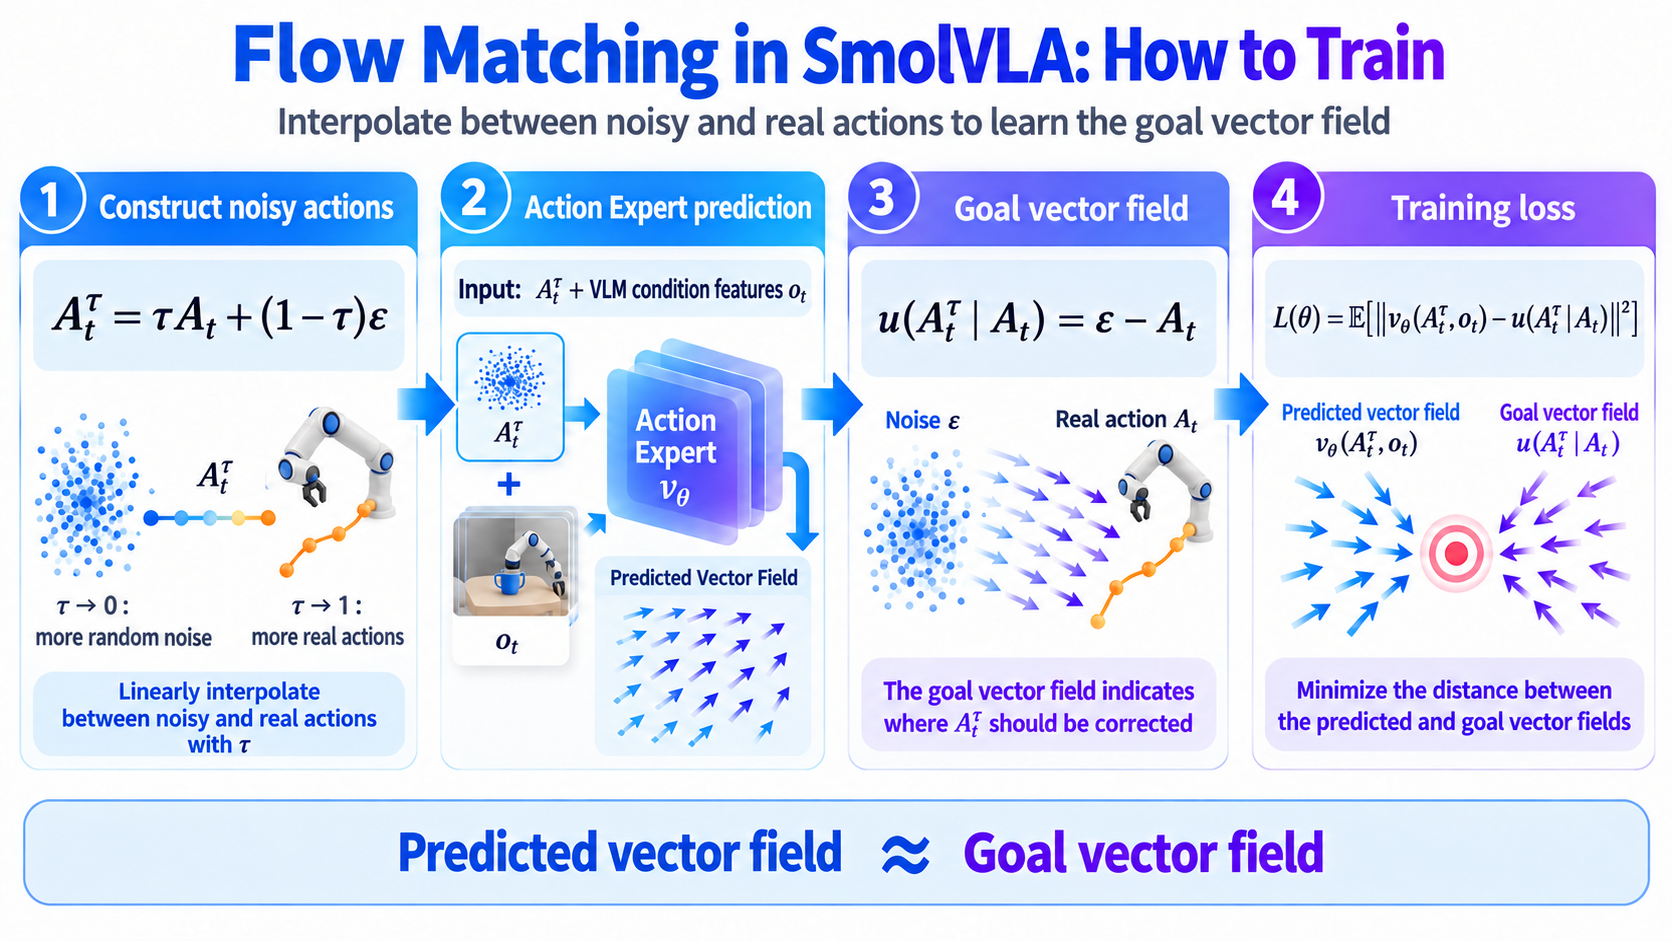
学習と推論のワークフロー全体
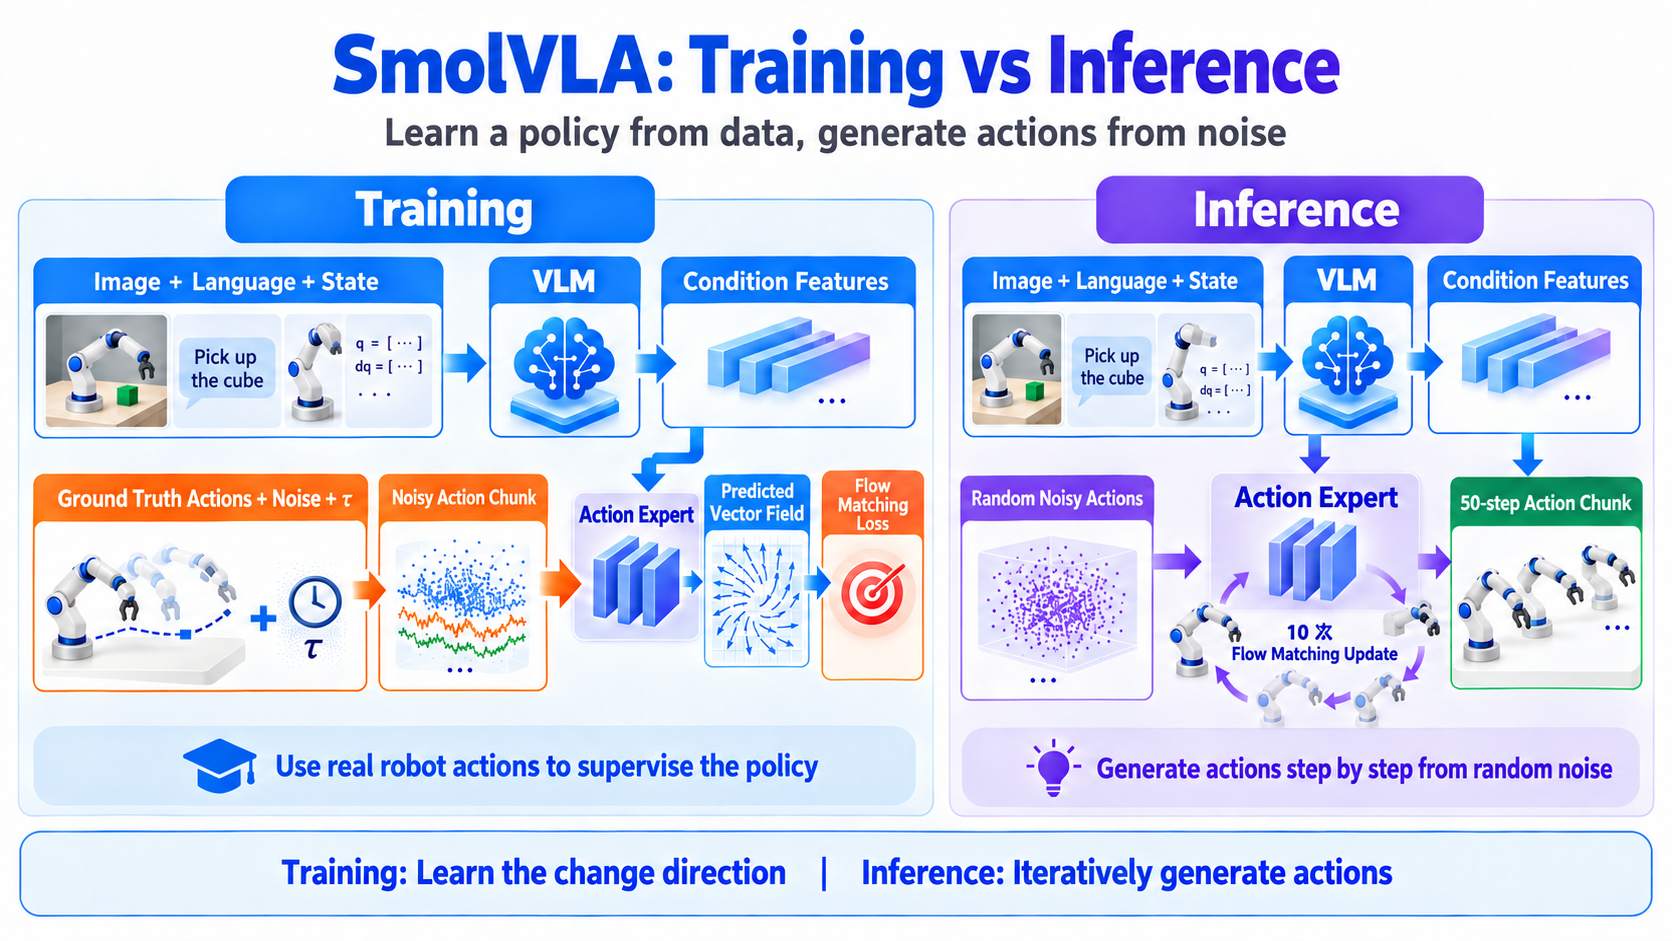
- メインモデルは約4億5千万パラメータを持ち、そのうちおよそ1億がアクションエキスパートです。学習時にはVLMを凍結し、アクションエキスパートのみを学習します。
コミュニティデータによる事前学習
なぜロボットデータは「島」を形成するのか
-
インターネット上のテキストや画像と異なり、ロボットのデモンストレーションには物理ハードウェアとテレオペレーションが必要です。データセットは次の点で異なる場合があります:
-
ロボット構造。
-
制御周波数。
-
関節の定義。
-
カメラの台数と配置。
-
タスク記述。
-
ファイル形式。
-
-
こうした分断されたコレクションは「データアイランド」です。ファイルを単に連結しただけでは、事前学習に有用な形にはなりません。
どれくらいのコミュニティデータが使われているか
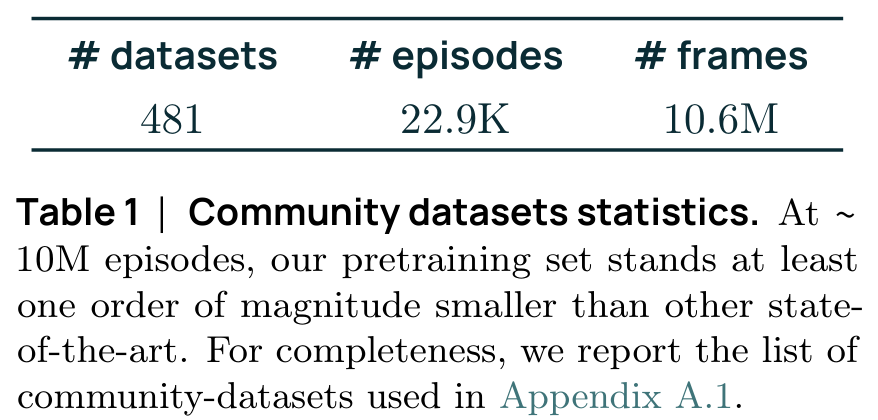
-
選定では、ロボットの種類、エピソード数、全体的な品質、フレームのカバレッジを考慮します。
-
これは、多くの大規模VLAが使用するデータ量のおよそ1桁少ない規模です。慎重にクリーンアップされたコミュニティデータであっても、小規模スケールで意味のある事前学習効果をもたらせることを示すのが狙いです。
VLMでタスク言語をクリーンアップする
コミュニティのタスクラベルはしばしば曖昧で、例えば次のようなものです:
task desc
Hold
Up
人間であれば動画からタスクを推測できるかもしれませんが、そのようなラベルではVLAに目標の安定した記述を与えられません。
著者らはQwen2.5-VL-3B-Instructを用いて、より良い記述を生成します:
-
データセットから代表的な画像をサンプリングする。
-
元のタスクラベルを与える。
-
動詞で始まる、短く完結した文を要求する。
Vague original label + representative images
             ↓
     Qwen2.5-VL-3B
             ↓
Clear action-oriented instruction
カメラ視点を標準化する
-
コミュニティデータセット間ではカメラ名がさまざまです。
images.laptopは、あるデータセットでは俯瞰カメラを指し、別のデータセットでは手首カメラを指すかもしれません。 -
名前を固定的な意味として扱うと、同じ入力スロットに対して異なる視点を繰り返し割り当てることになり、学習を混乱させます。
-
著者らは、次の優先順位でカメラを標準的な順序に手動でマッピングします:
Top → Wrist → Side
- そのうえで、一貫した名前にリネームします:
OBS_IMAGE_1
OBS_IMAGE_2
OBS_IMAGE_3
- 要求されるものを超える余分なビューは破棄されます。
非同期推論
同期チャンクの問題点
- モデルに観測
o_tからアクションチャンクを予測させます:
A_t = [a_t, a_t+1, ... , a_t+n]
-
計算効率の良い同期システムでは、再度観測と予測を行う前に
A_tをすべて実行します。これにより 2 つの問題が生じます:-
チャンクの実行中に新しい画像を一切使わないため、オープンループの区間が生じる。
-
チャンクを使い切ると、ロボットは推論を待つことになる。
-
RobotClient と PolicyServer
- SmolVLA は 2 つの役割を分離しています:
| Component | Responsibility |
|---|---|
| RobotClient | 画像の取得、状態の読み取り、アクションキューの維持、およびアクションの実行。 |
| PolicyServer | 観測を受け取り、SmolVLA を実行し、新しいアクションチャンクを返す。 |
- RobotClient は現在のキューが空になる前に新しいアクションを要求し、推論を非同期にトリガーします。
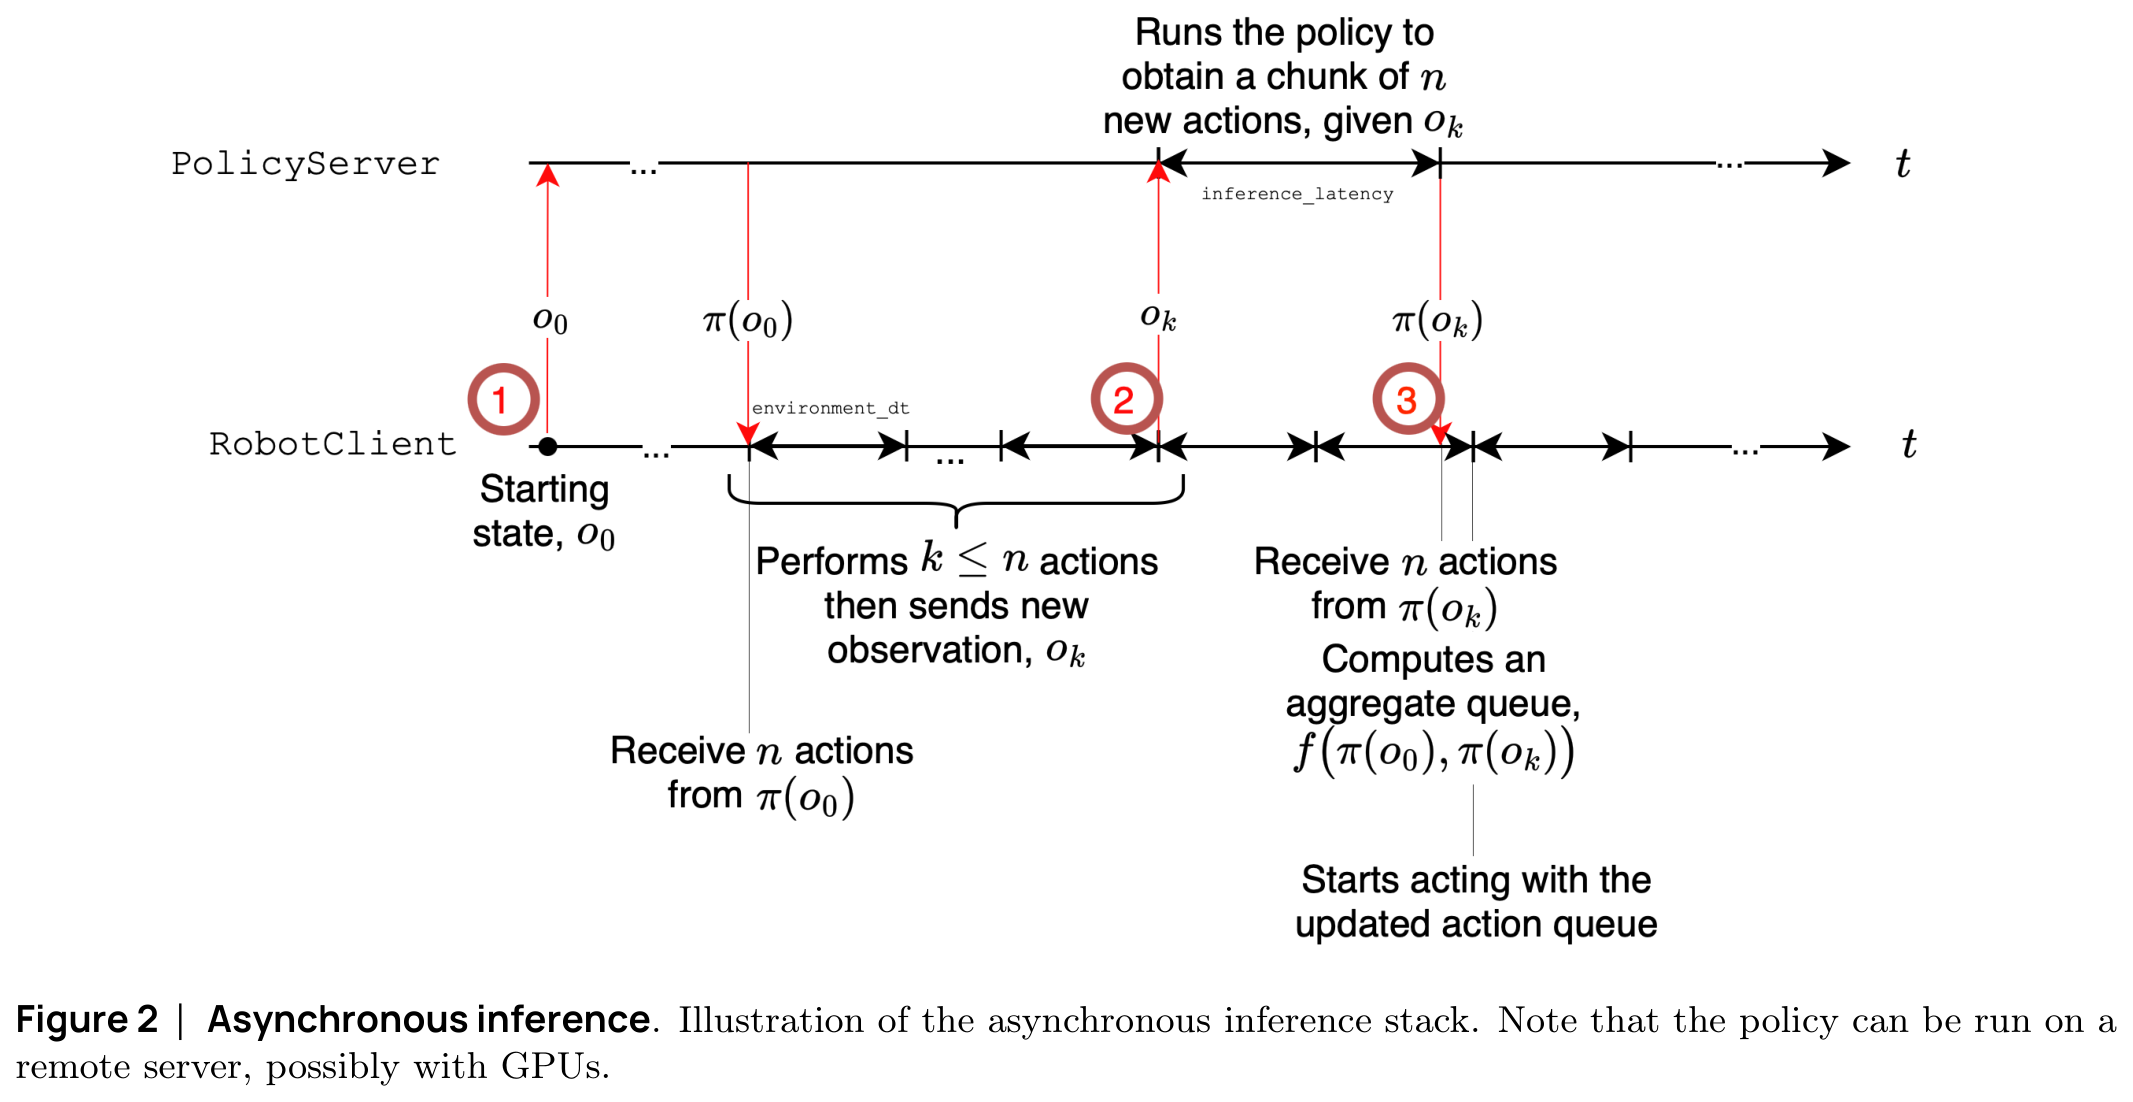
- シーケンスは次のとおりです:
Robot executes the old chunk
        ↓
Queue falls below the threshold
        ↓
Capture a new observation and request PolicyServer asynchronously
        ↓
Robot continues executing the old queue
        ↓
New chunk arrives
        ↓
Merge or update the action queue
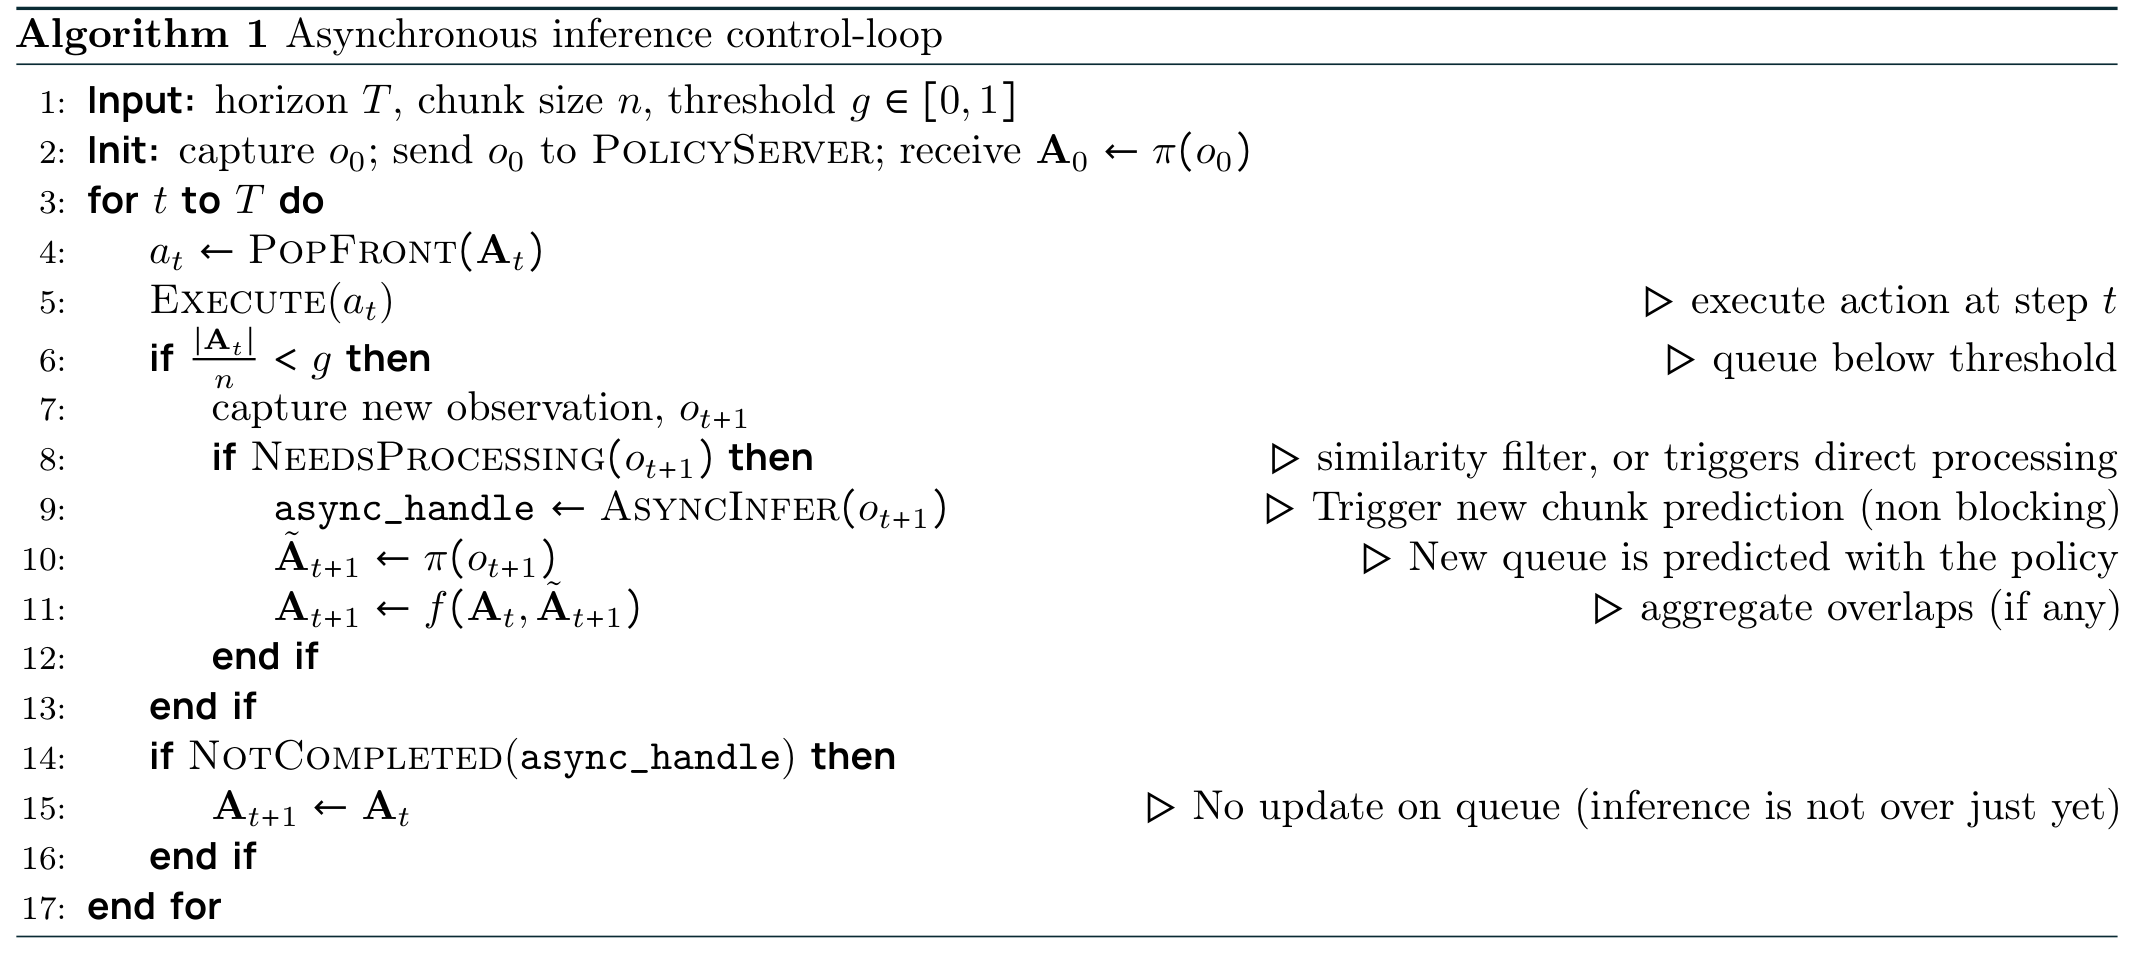
予測タイミングを制御するしきい値 g
- 論文では
g ∈ [0,1]を使用しています。残りのアクションの割合がgを下回ると、RobotClient は別のチャンクを要求します:
|A_t| / n < g
g = 0
- キューが空になるまで待つため、同期推論に近くなり、一時停止が発生するリスクが高まります。
g = 1
- ほぼ毎制御サイクルで新しいアクションを要求し、応答性を最大化しますが、計算コストも最大になります。
0 < g < 1
- 論文では
g = 0.7によるトレードオフを示しています:古いキューの一部を消費したら、次のチャンクを早めに要求します。これにより、モデルを毎ステップ実行することなくギャップを減らせます。
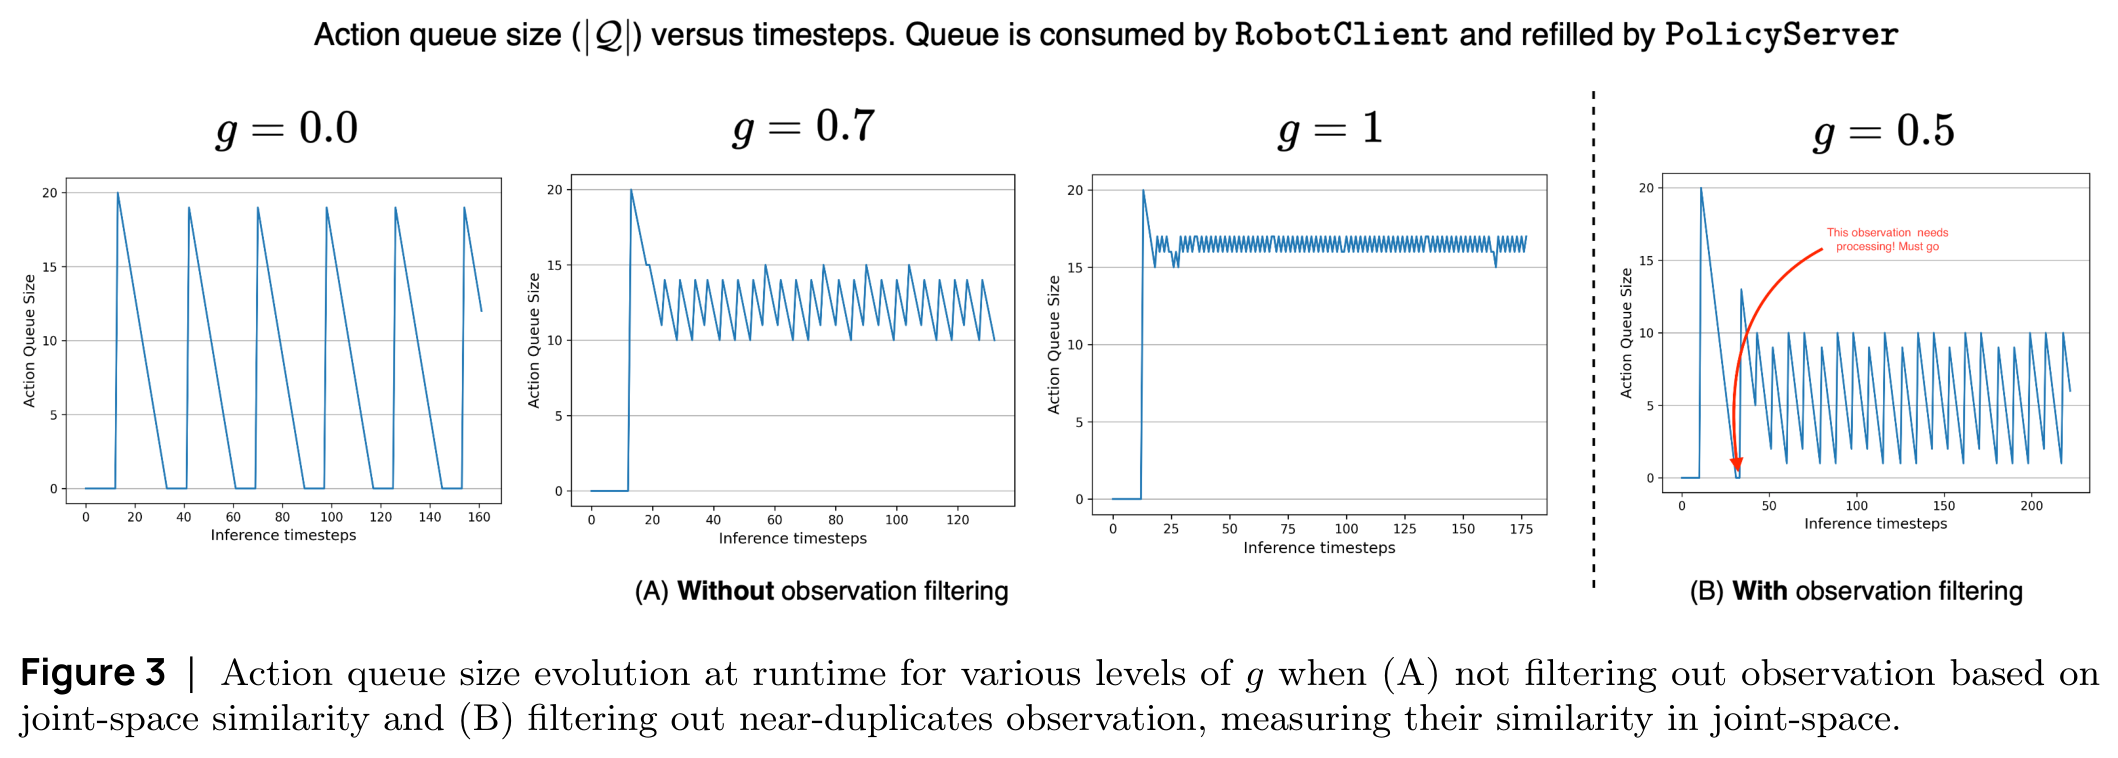
- 実質的に、
gは推論時間を予約する役割を果たします。モデルが遅い場合やネットワーク遅延が大きい場合は、より早いタイミングで要求する必要があります。
なぜ繰り返し観測をフィルタするのか?
-
アームがほとんど動かない場合、連続する観測はほぼ同一になることがあります。それらをすべて送ると計算資源を浪費し、ほぼ同一のチャンクを繰り返しマージしてしまう可能性があります。
-
著者らはジョイント空間距離を用いて観測を比較し、その距離が
ε未満のときは近い重複としてスキップします。 -
しかしキューが空の場合は、たとえ類似していても最新の観測を必ず処理しなければなりません。そうしないと、ロボットが無期限に停止したままになる可能性があります。
実験設定
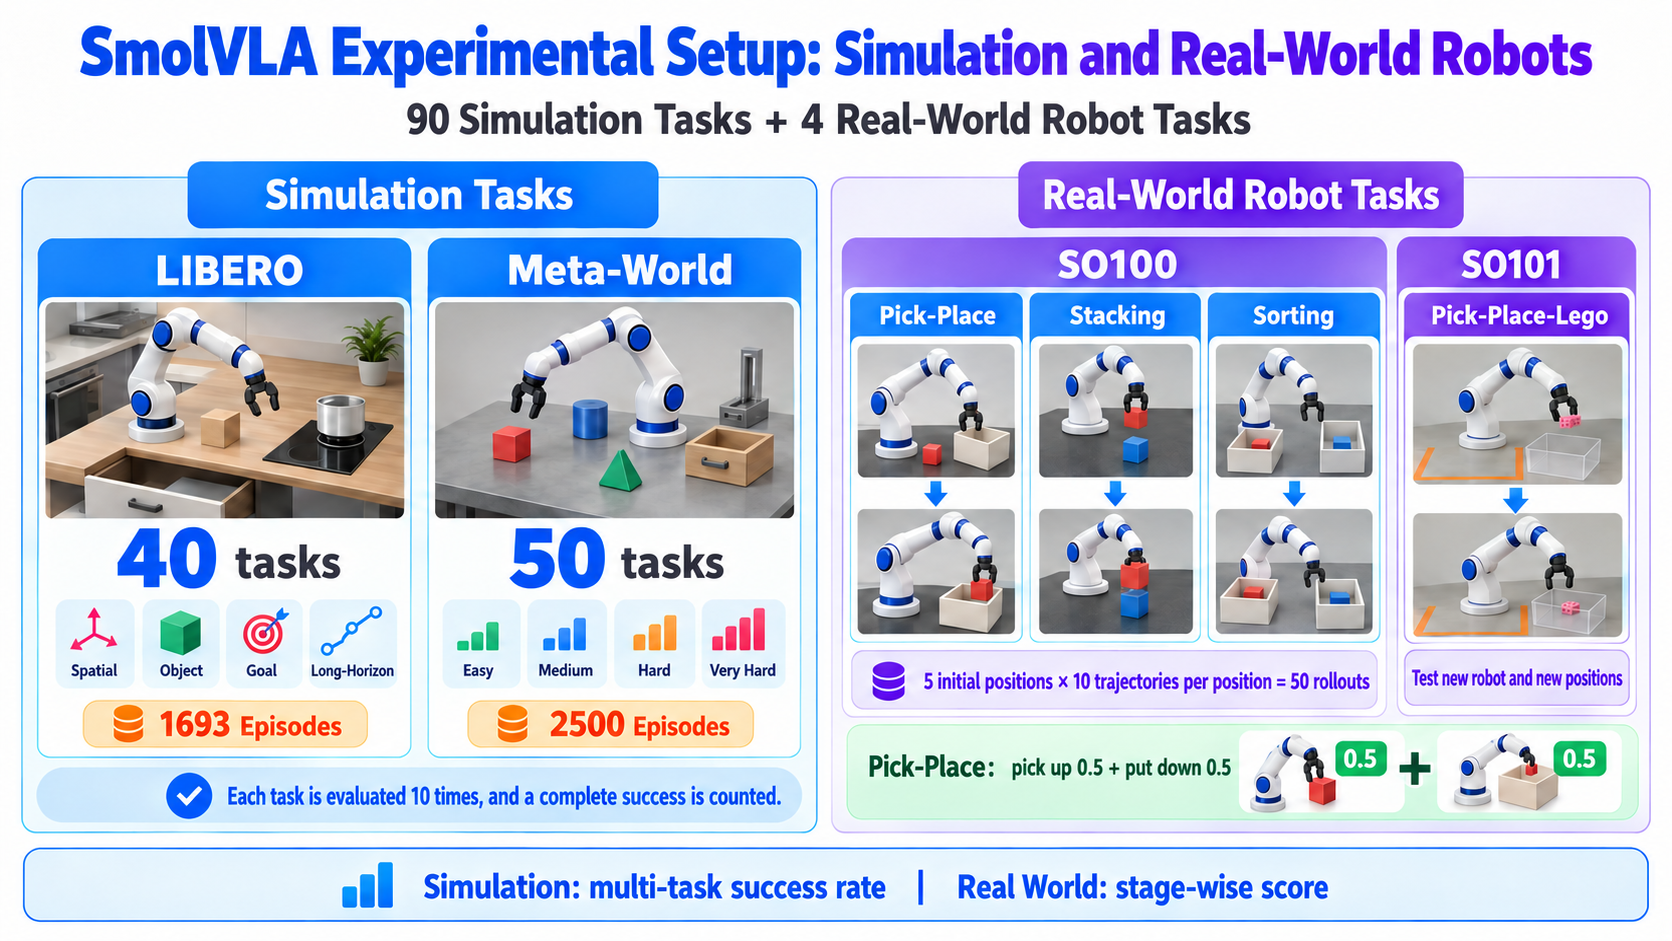
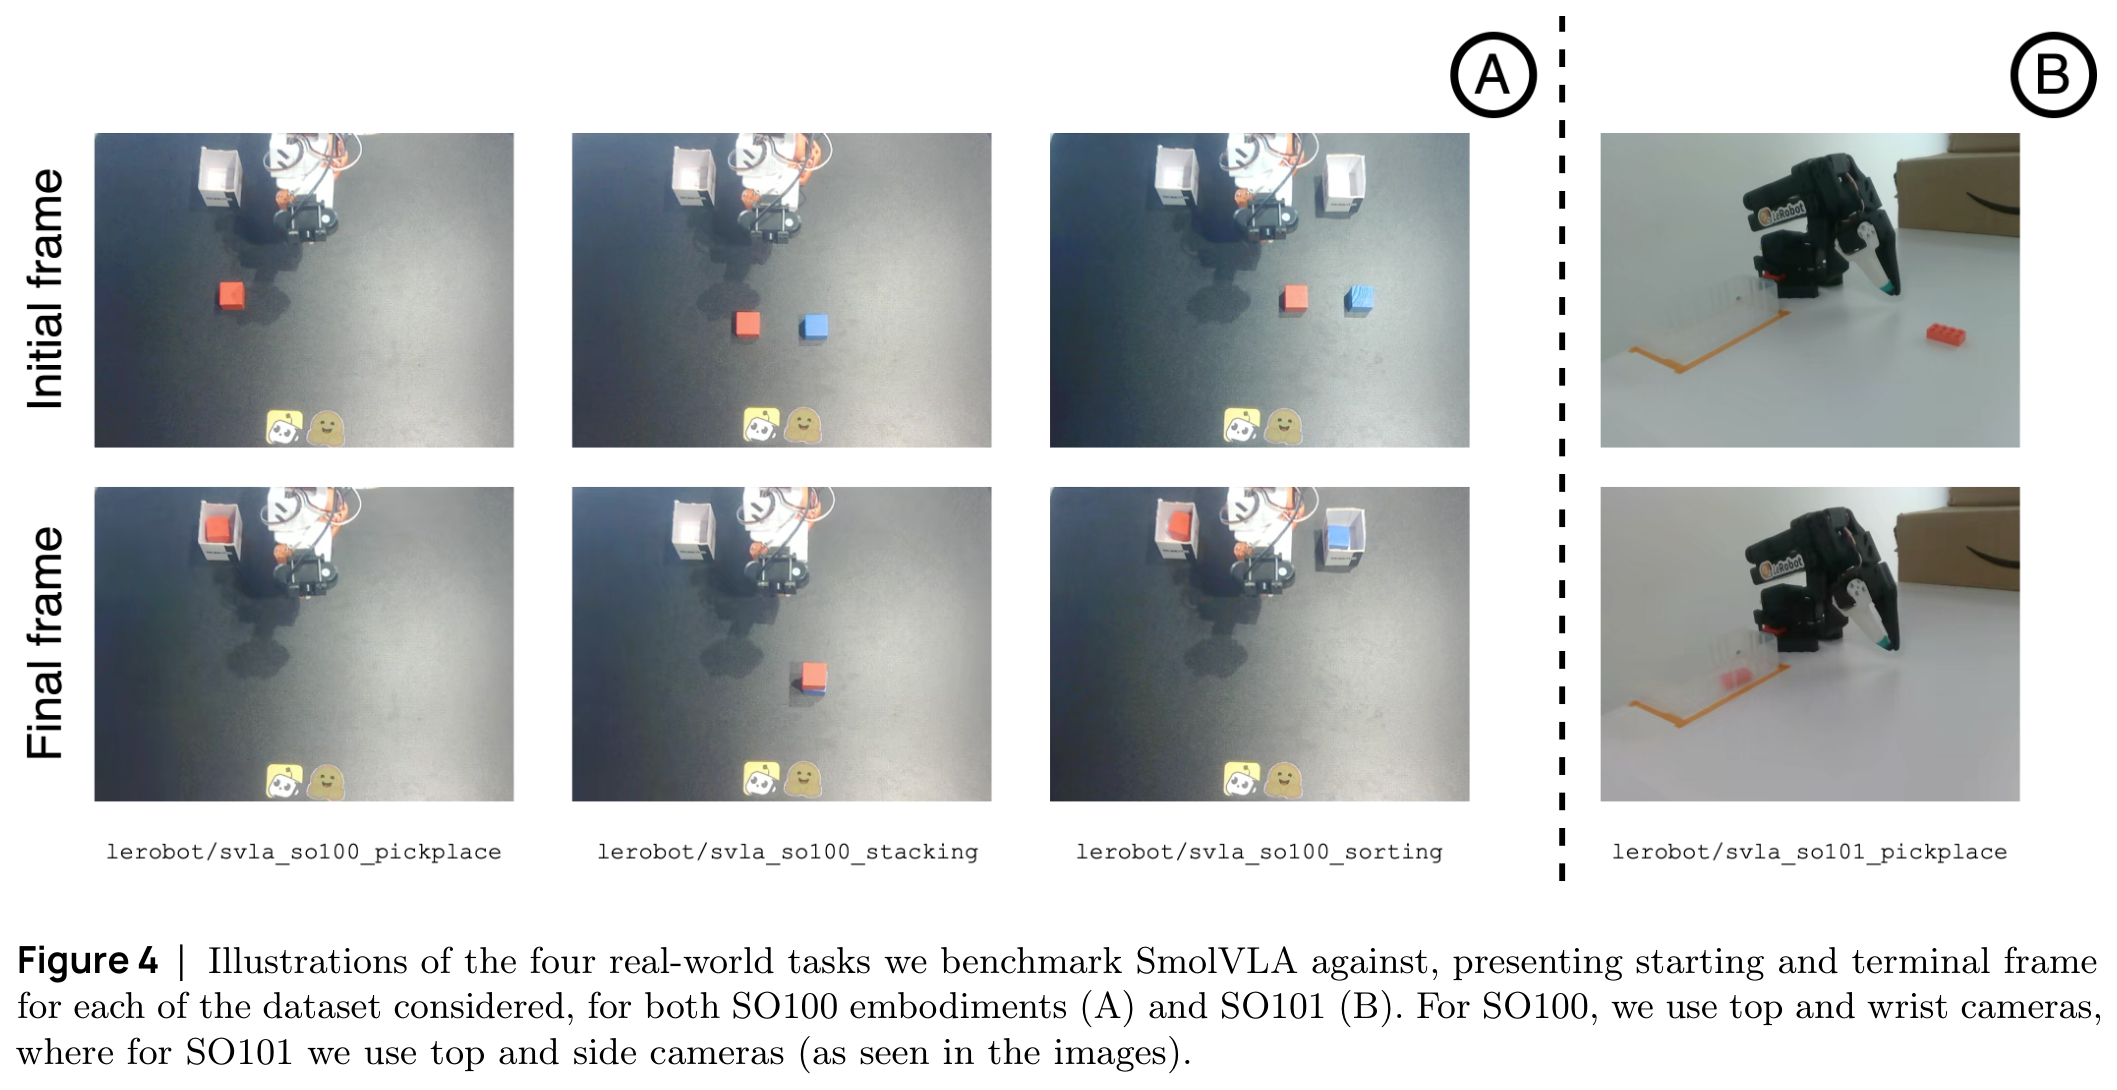
学習設定
| Item | Setting |
|---|---|
| Image resolution | 512 × 512 |
| Pre-training steps | 200K |
| Global Batch Size | 256 |
| Optimizer | AdamW |
| Learning rate | 1e-4 から 2.5e-6 まで減衰 |
| Action Chunk Size | 50 |
| Flow Matching Steps | 10 |
| Main-model parameters | 450M |
| Action-expert parameters | 約 100M |
| Total project compute | 約 30K GPU 時間 |
- 事前学習では、より大きなバッチサイズを得るために 4 枚の GPU を使用していますが、モデル自体は 1 枚の GPU でも学習可能であると述べられています。
結果
シミュレーション
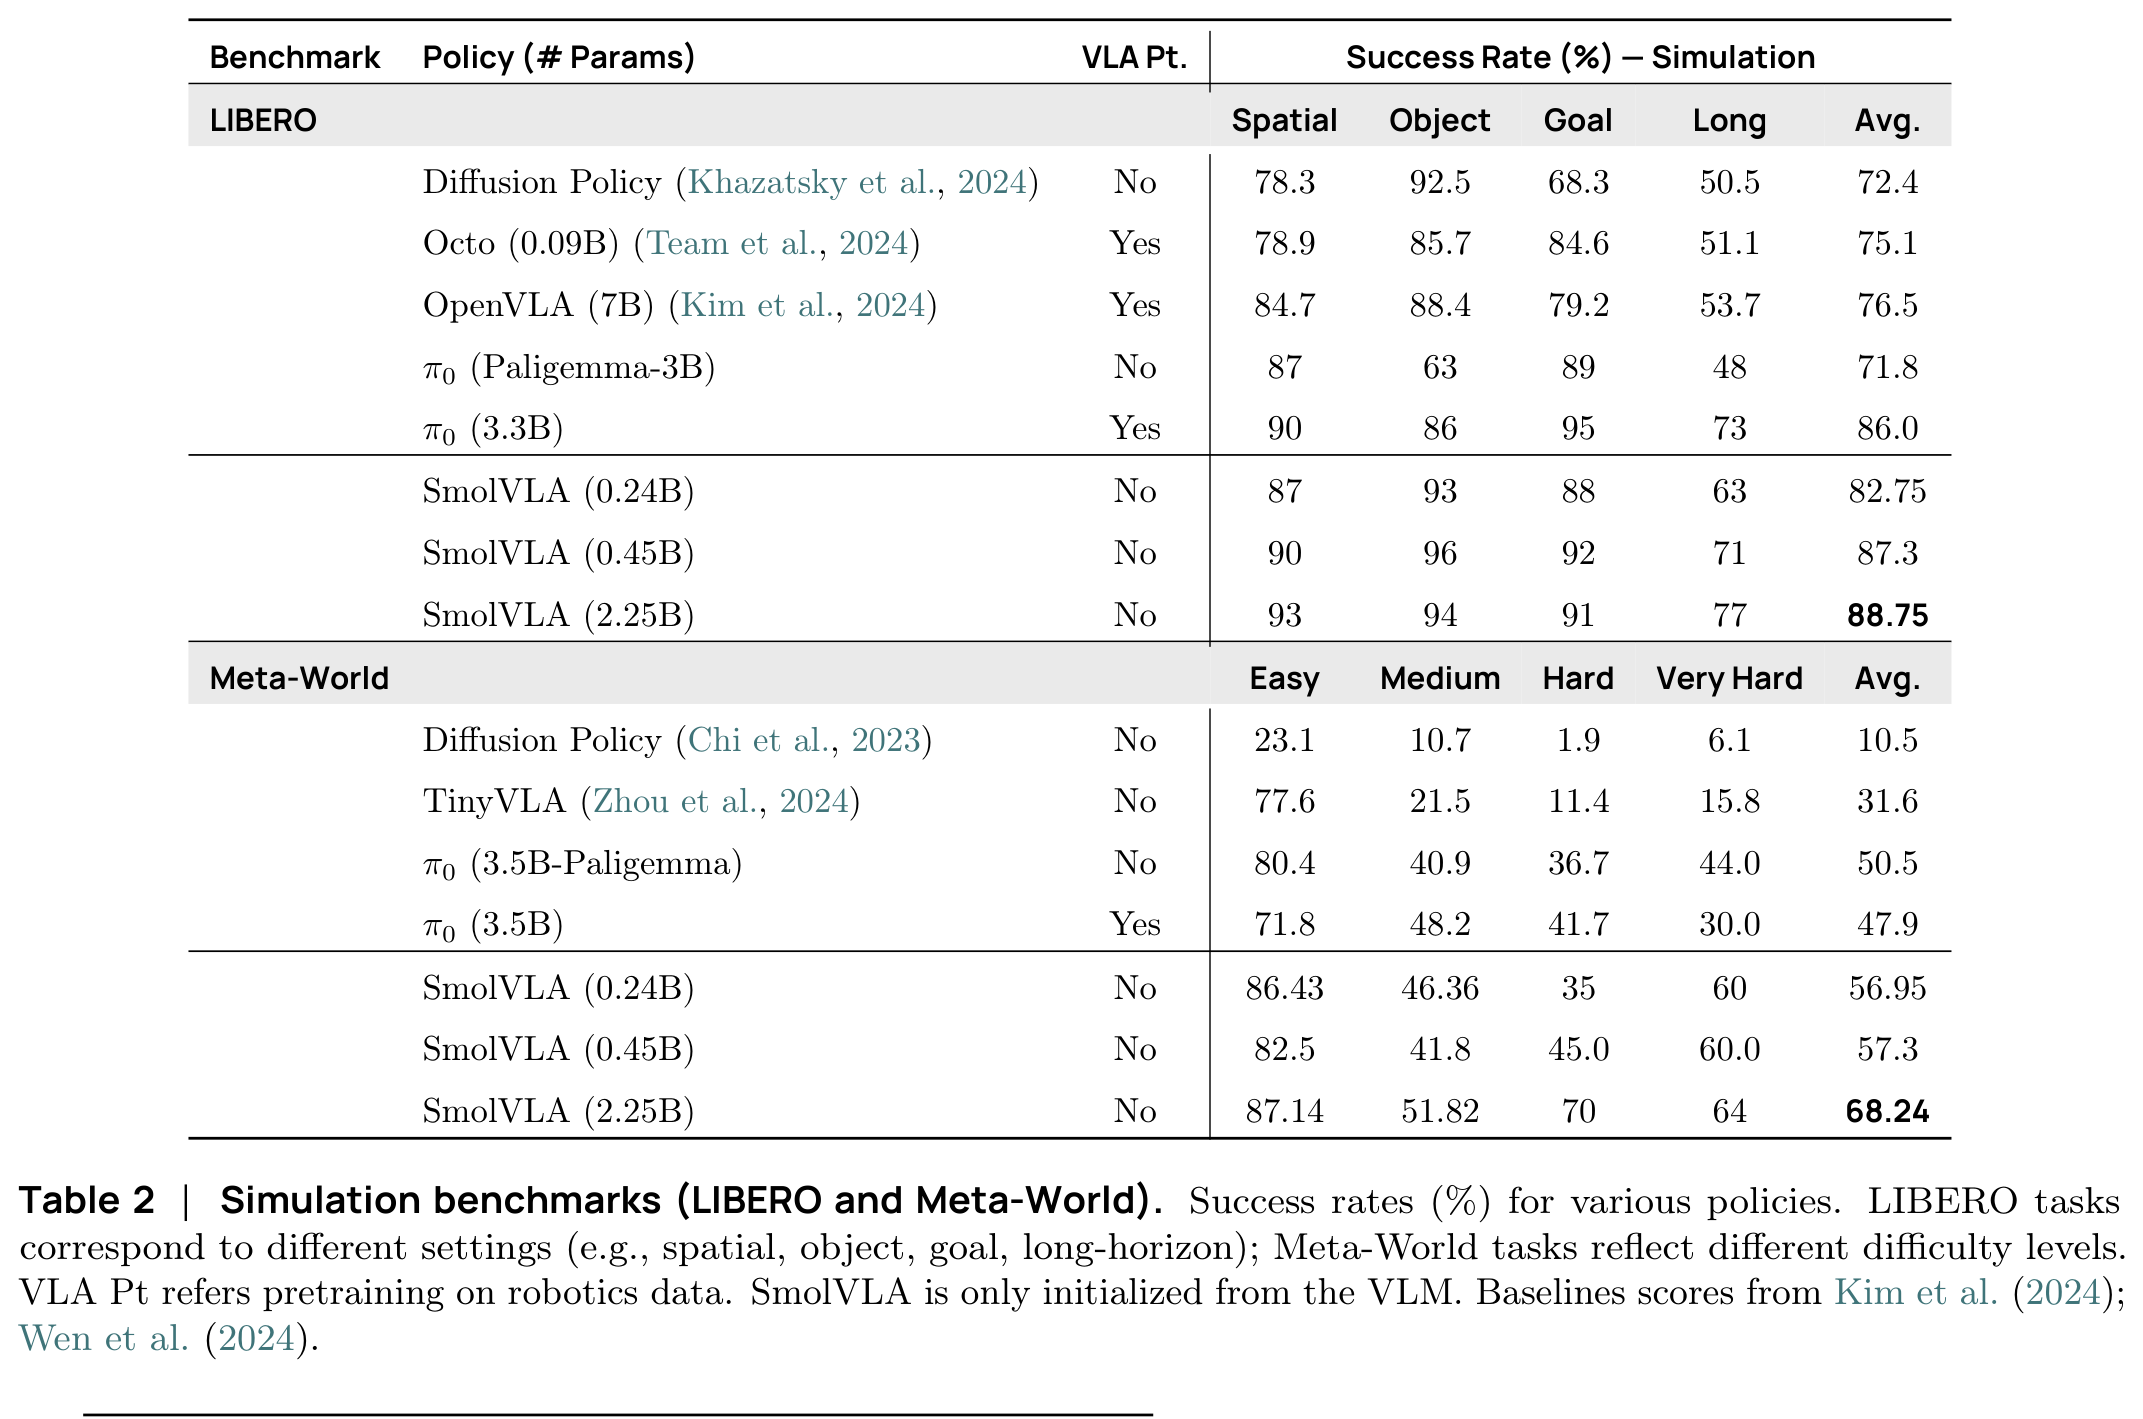
LIBERO において:
-
0.45B の SmolVLA は、3.3B の π0 や 7B の OpenVLA よりも平均成功率が高くなっています。2.25B へのスケーリングにより性能はさらに向上しますが、0.45B からの上昇幅は小さくなります。
-
Meta-World では、0.45B モデルの平均成功率は 57.3、2.25B では 68.24 です。性能はモデルサイズだけで決まるわけではなく、アーキテクチャ、データ、学習目的も重要です。
SO100 実機ロボットでの結果
-
π0 は最も簡単なピックアンドプレースタスクで 100 に到達しますが、SmolVLA は積み上げや仕分けで大幅に優れており、全体平均でも最良の結果を達成しています。
-
SmolVLA のパラメータ数は π0 のおよそ 7 分の 1 です。
SO101 への転移結果
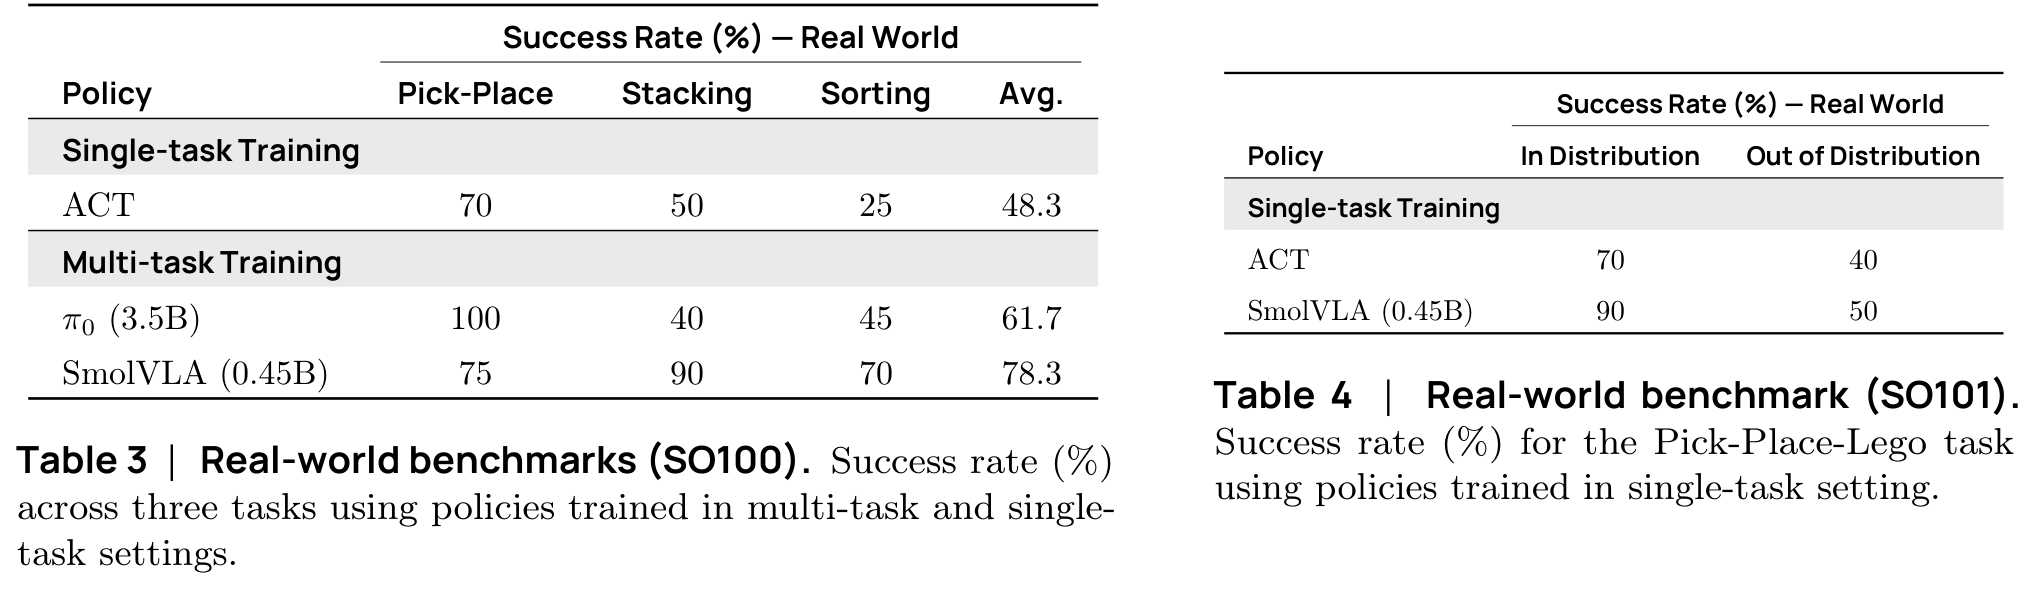
- コミュニティ事前学習では主に SO100 データを使用し、SO101 データは用いていません。SO101 タスクでファインチューニングした後も、SmolVLA は ACT を上回り、別プラットフォームへの適応を示しています。
コミュニティ事前学習の貢献
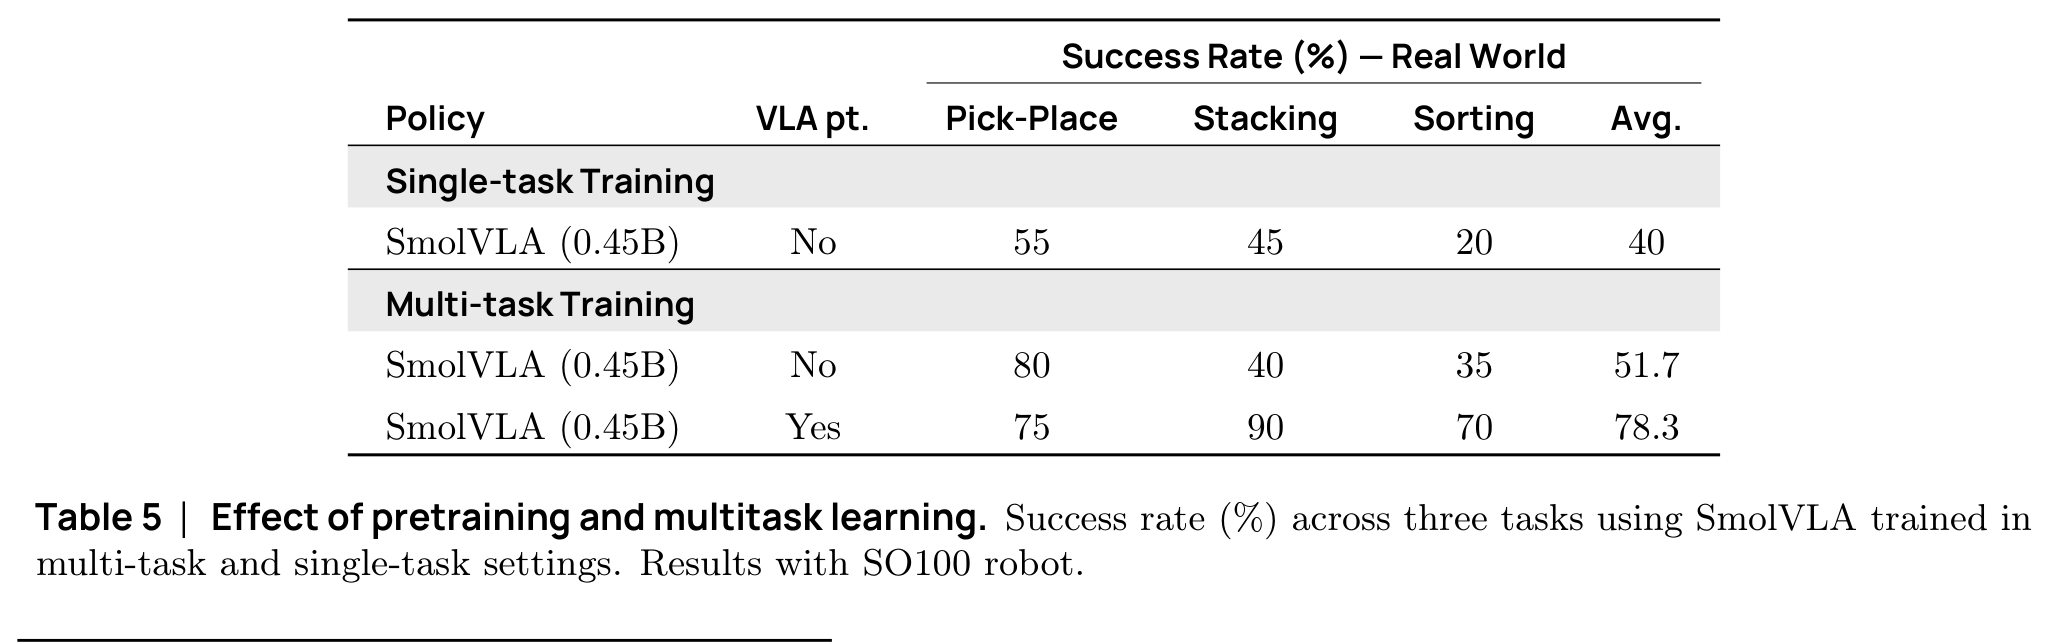
-
シングルタスク学習からマルチタスク学習に移行すると、平均成功率は 40.0 から 51.7 に上昇します。
-
コミュニティ事前学習を追加すると、78.3 まで上昇します。
-
重要な結論として、単にパラメータ数を増やすよりも、事前学習データの方が重要になり得ることが示されています。
同期推論と非同期推論
| Inference | Pick-Place | Stacking | Sorting | Average |
|---|---|---|---|---|
| Sync | 75 | 90 | 70 | 78.3 |
| Async | 80 | 90 | 50 | 73.3 |
-
非同期化はすべてのタスクを改善するわけではありません。仕分けでは 70 から 50 に低下しています。非同期推論を普遍的により高精度だと表現すべきではありません。
-
主な利点は速度とスループットです:
Average completion time: 13.75 seconds → 9.70 seconds
Tasks completed in a fixed time: 9 → 19
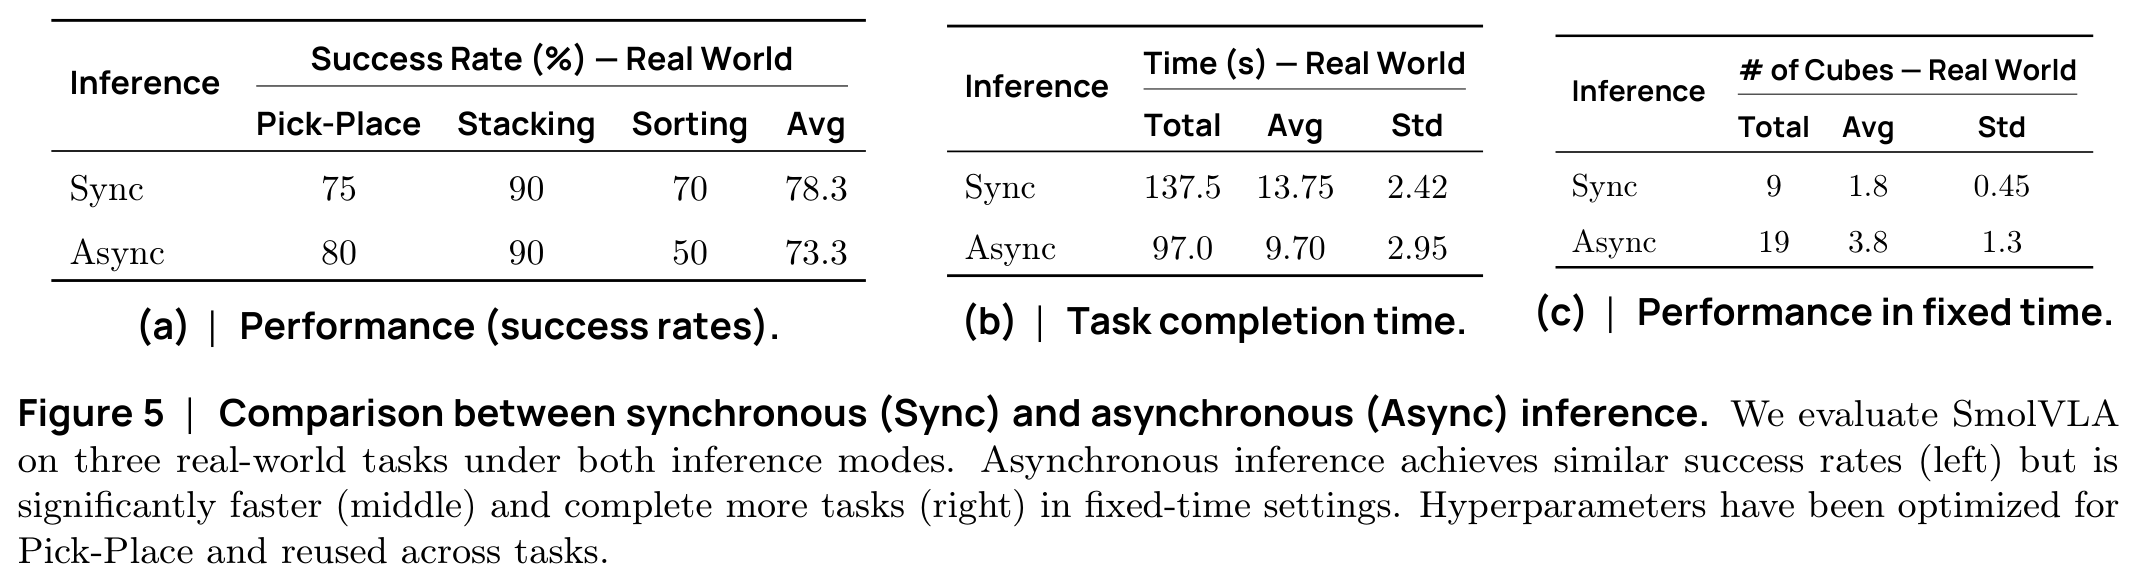
- 平均成功率が同程度であっても、非同期推論はピックアンドプレースを約 30% 高速に完了し、一定時間内に完了するタスク数を 2 倍以上にします。
アブレーション
クロスアテンションとセルフアテンション
| Attention | LIBERO average success |
|---|---|
| Cross-Attention | 79.0 |
| Self-Attention | 74.5 |
| Alternating CA + SA | 85.5 |
- VLM 特徴だけを読む、あるいはアクション間の関係だけをモデル化するのでは不十分です。両者を交互に用いるのが最も良く、タスク条件付けと時間的一貫性という補完的な役割を裏付けています。
因果アテンションと双方向アテンション
| Mask | LIBERO average success |
|---|---|
| Bidirectional | 67.5 |
| Causal | 74.5 |
- アクショントークンが将来のアクションを見ることを防ぐと、この実験では性能が向上し、明示的な時間方向が有用であることが示唆されます。
Flow Matching と直接回帰
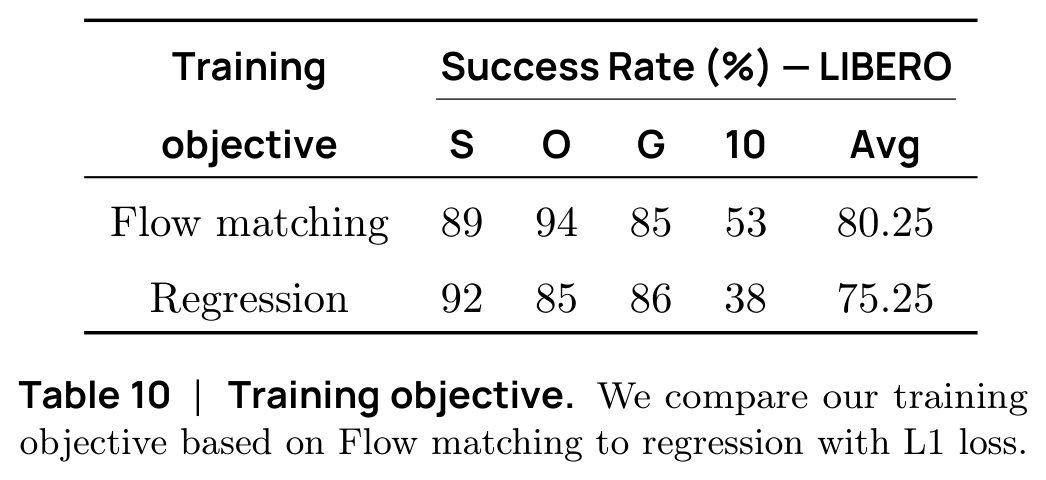
-
Flow matching の主な利点は長期タスクで現れ、成功率は 38 から 53 に増加します。
-
これは、生成的目的の方が複雑で多峰性なアクション分布をより良くモデル化できるという著者らの見解を支持しています。
状態はどこに入力すべきか?
著者らは次を比較しています:
-
サフィックス:状態を直接 Action Expert に入力する。
-
プレフィックス:状態をまず VLM に入力する。
クロスアテンションありの場合、プレフィックスは平均成功率 80.3 に達し、サフィックスは 73.3 です。そのため最終モデルでは、画像と言語と並んで状態を VLM に供給します。
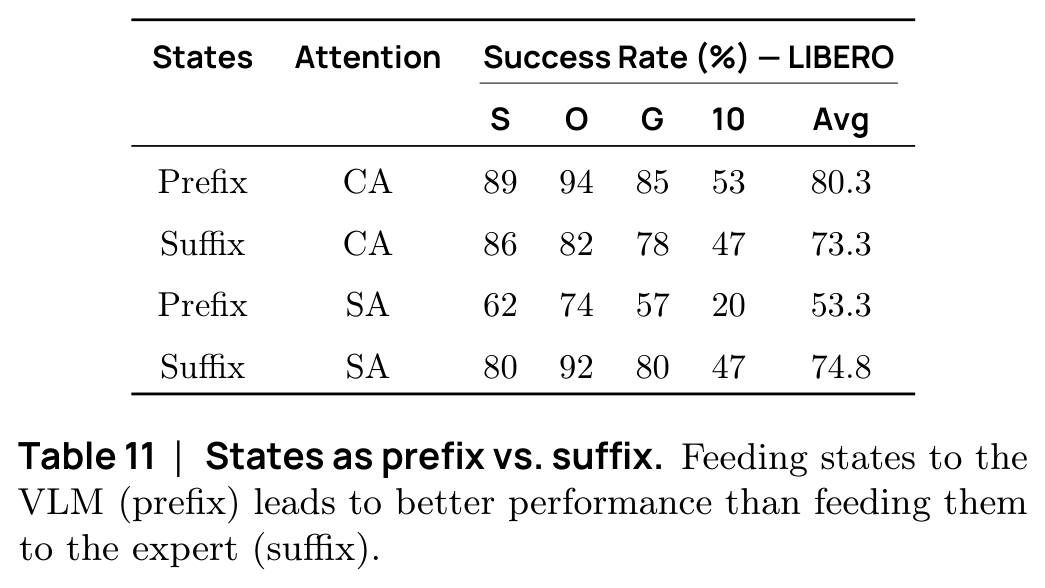
純粋なセルフアテンション変種では同じ傾向は見られません。支持される結論は、プレフィックス状態が、選択された VLM 条件付き設計においてより良く機能するというものであり、あらゆるアテンションアーキテクチャに対して普遍的に優れているという意味ではありません。
アクションチャンクはどれくらい長くすべきか?
-
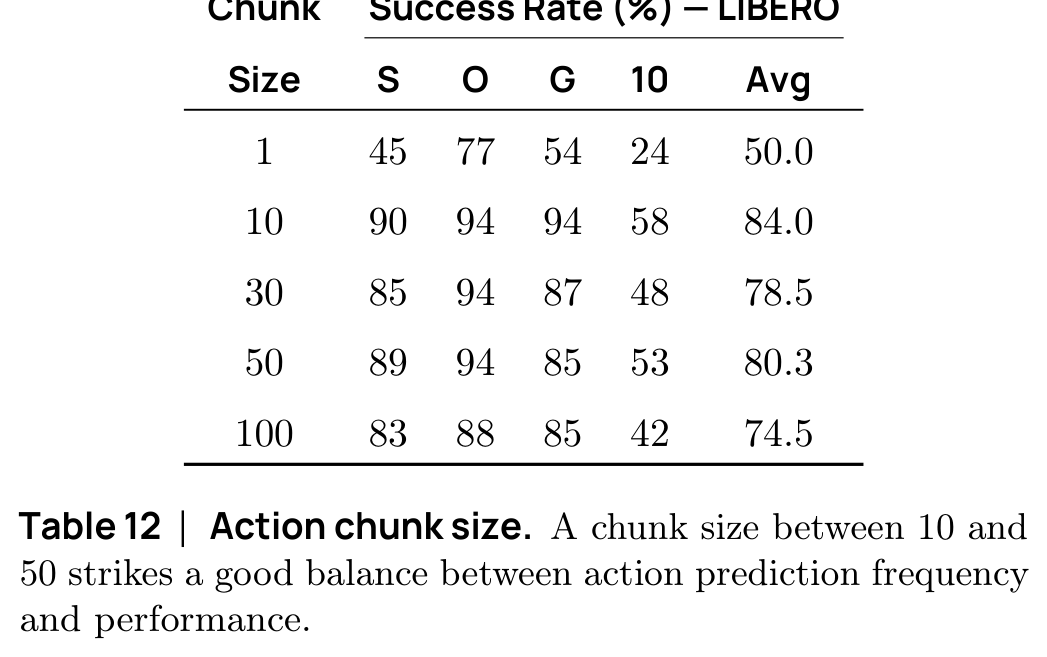
非常に短いチャンクではシーケンス構造を十分に活用できません。非常に長いチャンクは予測が難しくなり、過度に長いオープンループ実行を助長する可能性があります。
-
論文では、長ければ長いほど常に良いとみなすのではなく、10〜50 が有用なバランスであるとしています。
50 ステップを予測しても 50 ステップ実行するとは限らない
-
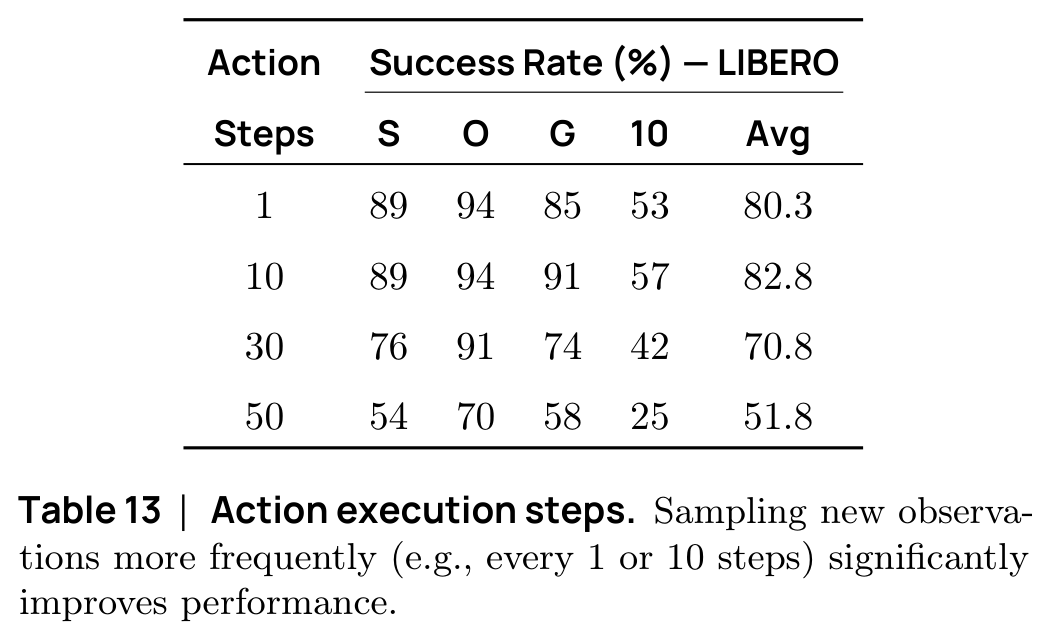
モデルは 50 ステップを予測しても、そのうち 10 ステップだけを実行して再度観測することができ、シーケンスの一貫性と環境からのフィードバックを両立させます。
-
観測する前に 50 ステップすべてを実行すると、平均成功率は 51.8 にとどまります。
-
これは非同期推論の動機付けとなります:ロボットにモデルの待ち時間を強いずに頻繁に観測することです。
制約事項
-
具現化の多様性が限られている。 コミュニティ事前学習は主に SO100 に基づいています。SO101 への転移はファインチューニングによって示されていますが、広範なクロスエンボディメント事前学習ではありません。
-
データ規模が限られている。 SmolVLA は約 23,000 軌跡を使用しているのに対し、OpenVLA などのモデルは最大で 100 万近くを使用できます。より大規模なコミュニティデータスケールでの効率性は、今後の検証が必要です。
-
バックボーンの適合性は未解決。 SmolVLM-2 の事前学習の多くは文書や OCR に関するものです。空間的関係、アフォーダンス、物理的インタラクションに対して理想的かどうかは、まだ明らかではありません。
-
実タスクは比較的短いまま。 ピック、プレース、スタック、ソートは真に長期の行動を網羅しておらず、階層型ポリシーや多段階プランニングが必要になる可能性があります。
-
主に模倣学習。 性能は依然としてデモのカバレッジに制約されます。著者らは、長期タスクや巧緻なマニピュレーションを改善するために、強化学習との併用を提案しています。
まとめ