VLA-JEPA: 動画から潜在アクションを学習する
VLA-JEPA: 潜在ワールドモデルによって Vision-Language-Action モデルを強化する
- 人間動画による事前学習
- 潜在ワールドモデル
- Flow-matching アクションヘッド
- 摂動に対するロバスト性
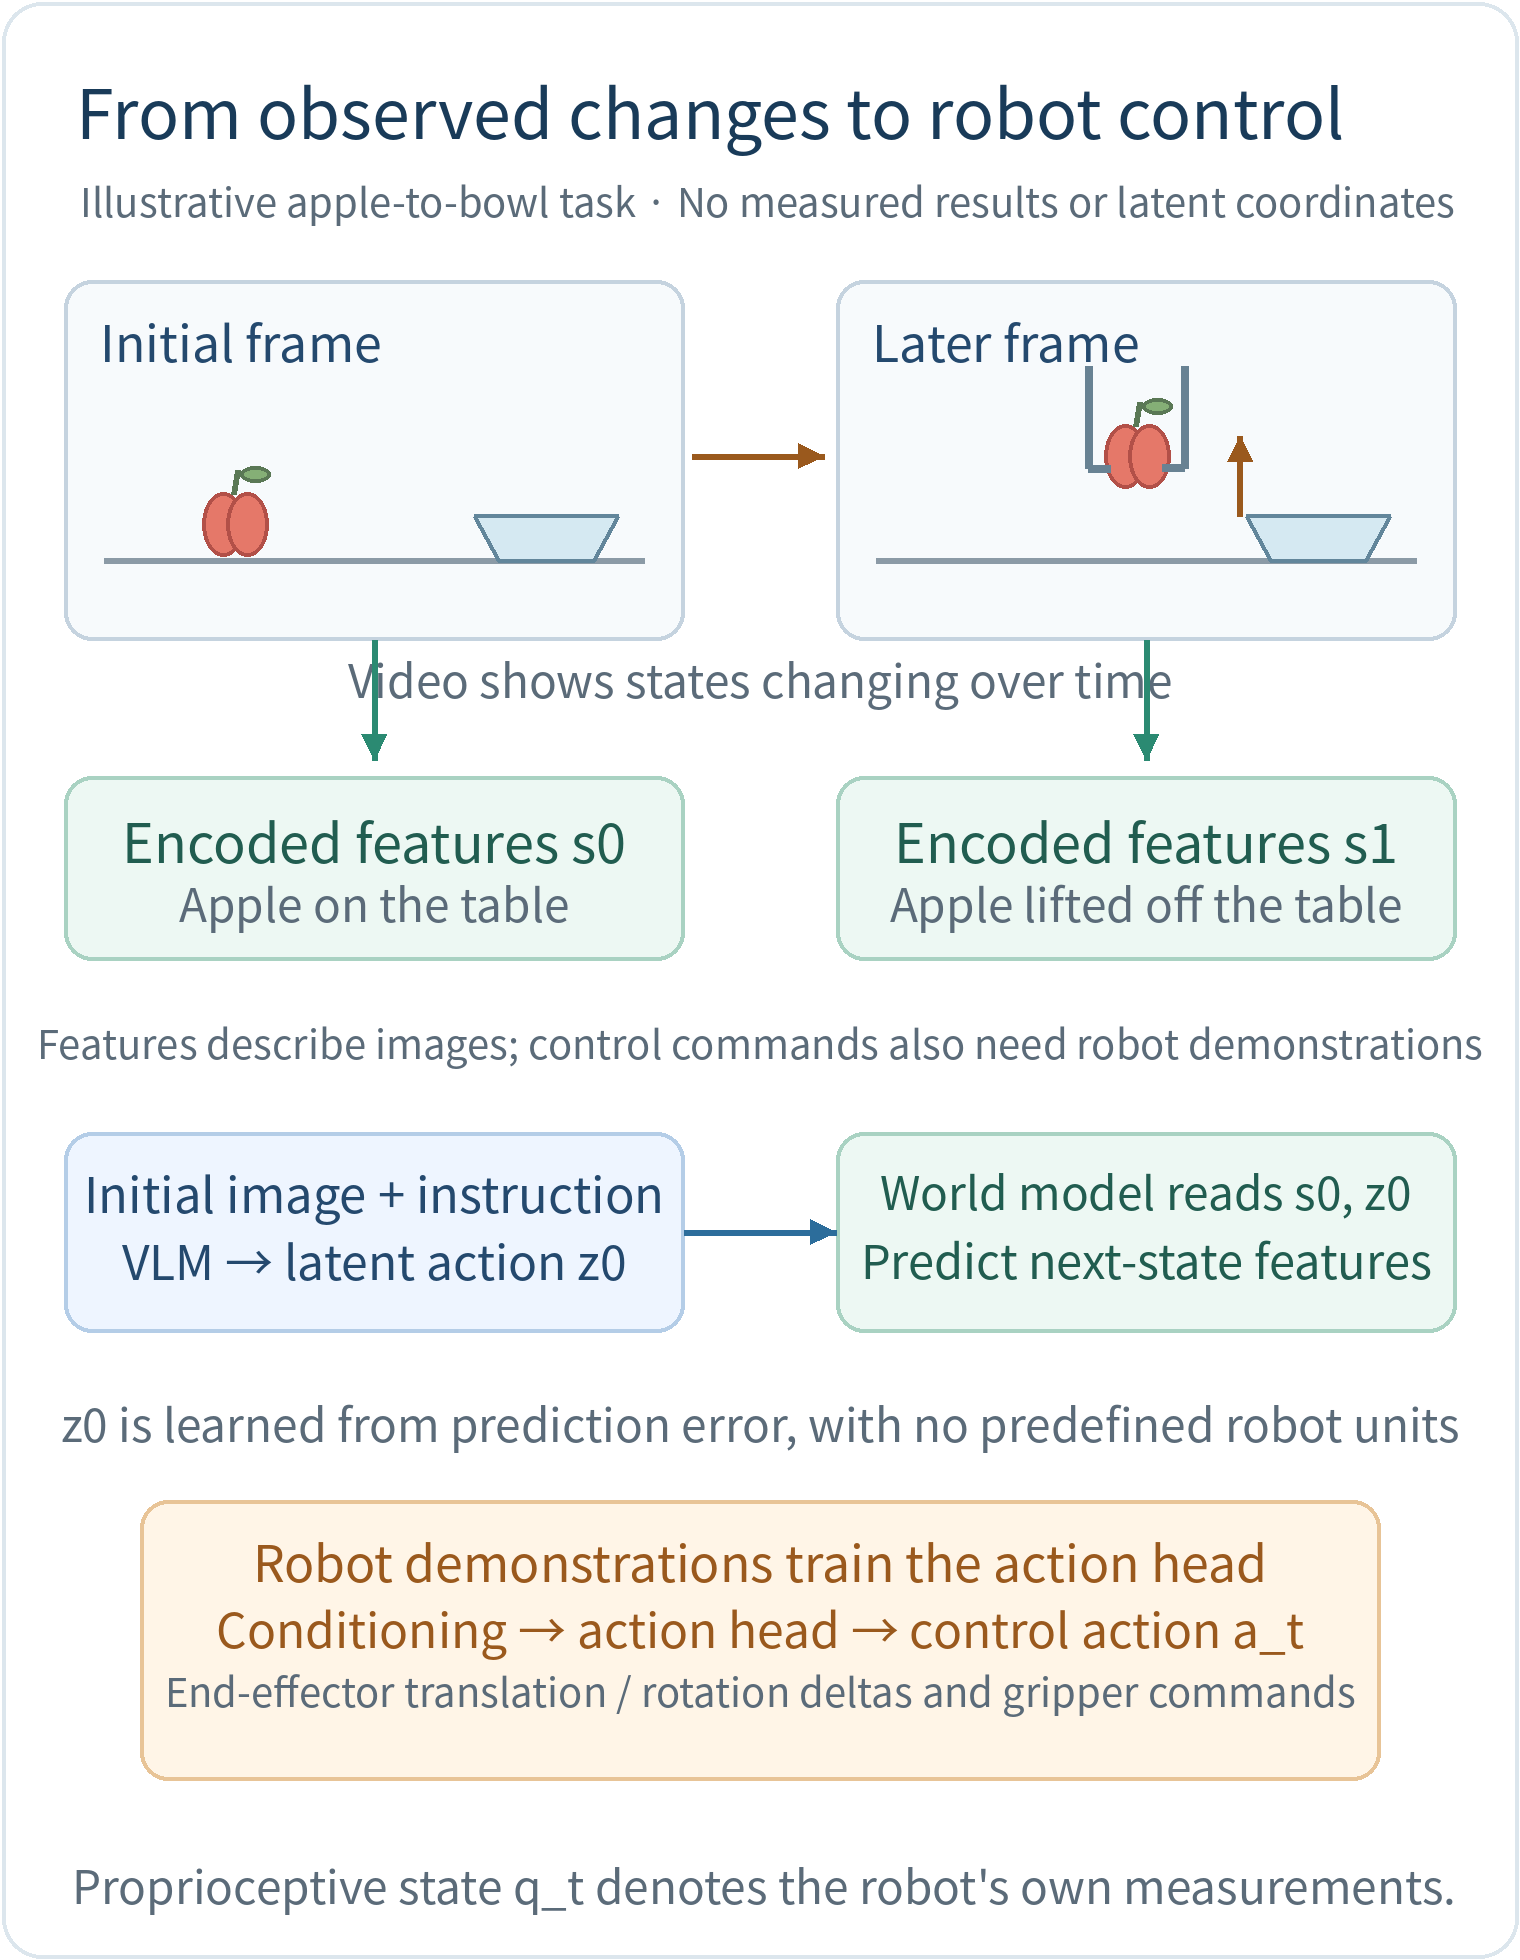
人間の動画は、リンゴをボウルに入れる方法を示しますが、特定のロボット向けの制御コマンドは含みません。VLA-JEPA はまず動画から物体がどのように変化するかを学習し、その後ロボットのデモからどのように行動するかを学習します。 ワールドモデルが、この 2 種類の学習信号を結び付けます。
前提知識
重要なのは 3 つの量です。リンゴをボウルに入れることを考えてみましょう:
- ワールド状態特徴 は、ビデオエンコーダによって抽出された、シーンと物体状態を表します。
- 潜在アクション は、リンゴがテーブルからボウルの上へ移動するなど、状態変化の予測に役立つ隠れ特徴です。あらかじめ決められた物理単位は持ちません。
- ロボットアクション は、エンドエフェクタの並進・回転やグリッパコマンドなど、コントローラに送られる値を含みます。
JEPA(Joint-Embedding Predictive Architecture)は将来の特徴を予測します。すべてのピクセルを再構成することなく、予測された特徴と実際の将来画像からエンコードされた特徴を比較します。VLA-JEPA はこの目的関数を用いて、Vision-Language モデル(VLM)に操作に関連する変化を教えます。
要約
言い換え: インターネット動画は、Vision-Language-Action モデル(VLA)におけるロボットデータ不足の問題を緩和するのに役立ちます。しかし既存の潜在アクション手法は、見た目の変化や無関係な動き、あるいは将来画像からのショートカットを学習してしまう可能性があります。VLA-JEPA は現在の観測と言語から潜在アクションを生成し、その後将来の状態特徴を予測します。将来画像は、潜在アクションを生成する VLM に直接入力されることなく教師信号を提供します。動画とロボットデータの共同事前学習に続いて下流タスクへの適応を行うことで、シミュレーションと実機の両方で競争力のある結果が得られます。
読書メモ: アクションラベルが欠如しているのは人間動画に対してです。動画は「変化」を教え、ロボットのデモは依然として制御値を教えます。アブレーションでは、すべてのタスクで一貫した性能向上というよりも、摂動に対するロバスト性の向上がより明確に示されています。
序論と関連研究
まずデータの問題から始めます。 ロボットのデモは高価である一方、人間の動画は豊富に存在します。そこで著者らは、動画から得た経験をロボット学習へ転移することを目指します(論文のセクション 1)。しかし動画を増やすだけでは不十分です。ピクセル予測は、制御に有用な変化ではなく、テクスチャや照明、カメラの動きに注目してしまう可能性があります。
次に教師信号を検討します。 潜在アクション抽出器が現在と将来の画像の両方を見ると、将来の答えをそのまま符号化してしまうかもしれません。潜在アクションを抽出してから、別途ポリシーを整合させることは、学習ステージを増やすことにもなります。著者らは予測対象と情報源の両方を変更します:将来の特徴を予測し、潜在アクションは初期観測からのみ生成します。
セクション 2 では 2 つの主なグループが論じられます。RT シリーズのようにアクションラベル付きデモに依存する VLA と、LAPA、UniVLA、MotoGPT のように、ロボット制御に結び付ける前に動画から潜在アクションを抽出する手法です。VLA-JEPA はこれとは異なり、状態予測誤差によって潜在アクションを生成する VLM を直接学習させ、同じバックボーンをロボットアクションの教師信号でも学習させます。 これにより、下流でのファインチューニングを前提としつつも、統一された事前学習プロセスが形成されます。
VLA-JEPA はどのように動画からアクションを学習するか
全体のネットワーク
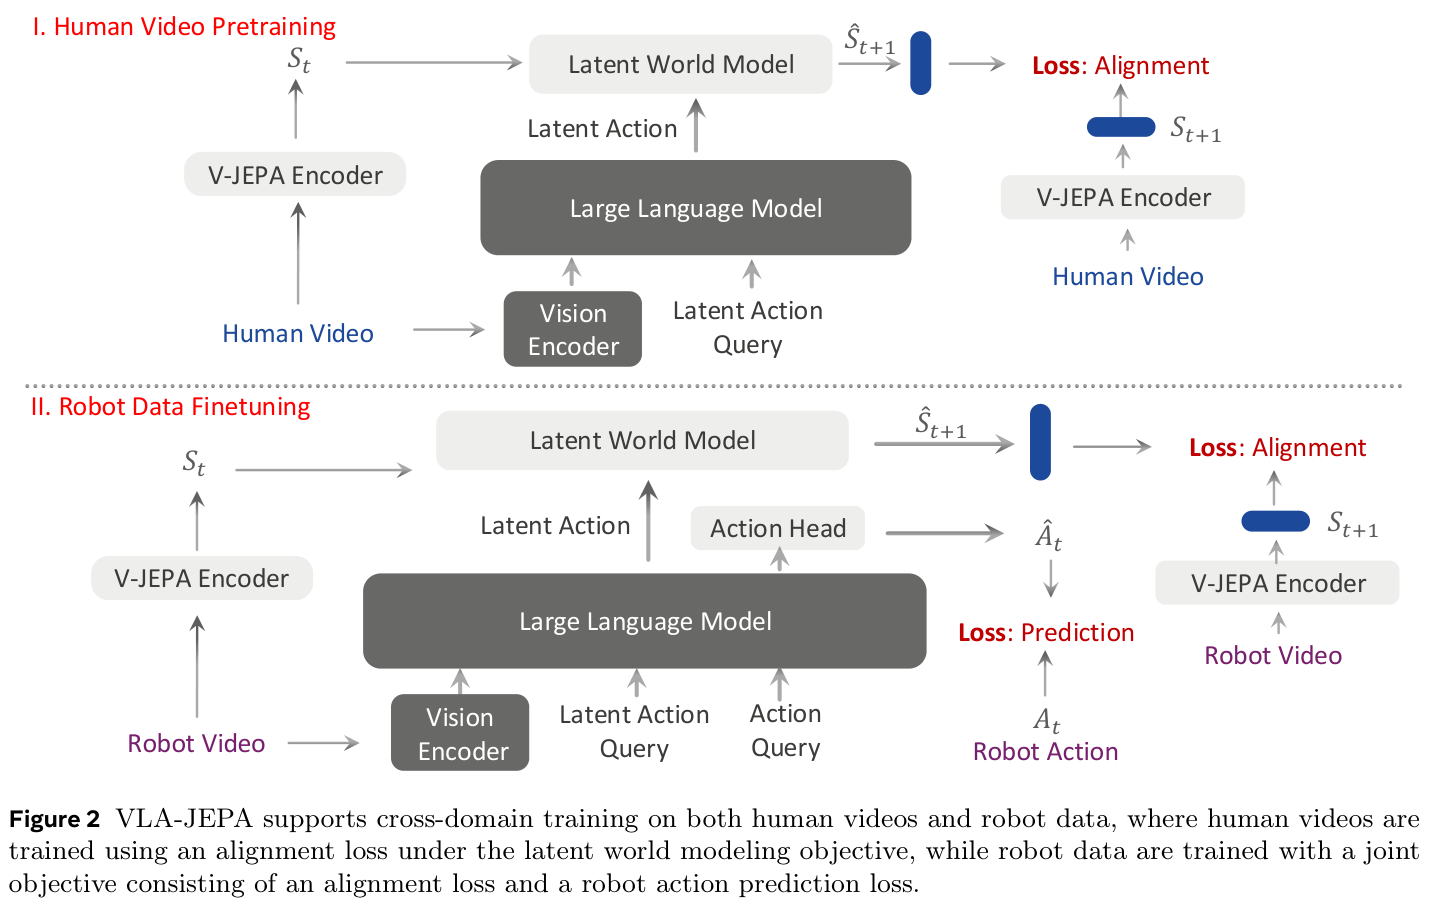
4 つのモジュールそれぞれに役割があります。Qwen3-VL-2B は現在の画像と言語指示を読み取り、潜在アクションとアクション条件付けを生成します。凍結された V-JEPA2 は動画を状態特徴へとエンコードします。ワールドモデル は後続の状態を予測し、アクションヘッド はロボット制御シーケンスを生成します。
上側の経路は人間動画で状態予測を学習します。下側の経路はロボットデータで状態予測とアクション生成を学習します。両者は VLM を共有しており、動画からの経験が後の制御に影響を与えられるようになっています。
状態予測を通じた潜在アクションの学習
固定エンコーダ が各ビューから特徴を抽出し、それらを特徴次元方向に連結します(論文の式 (1)):
は、時刻位置 におけるビュー の画像です。表 5 のインターフェースでは、2 つの の特徴配列が になります。ビジュアルトークン数は変わらず、各トークンが 2 つのビューを結合します。
学習可能な潜在アクションクエリが、最初の画像と言語の後に続きます。それらの VLM 特徴が になります。ワールドモデル は、過去の状態と潜在アクションから次の状態を予測します。式 (2)–(3) は次のように短く書けます:
は指示文であり、 は学習可能なクエリトークンです。すべての潜在アクションは、それぞれの将来画像ではなく同じ初期観測を用います。学習では teacher forcing を使用します。たとえば の予測には真の履歴 を使えますが、 の予測に 自身を入力として使うことはできません。
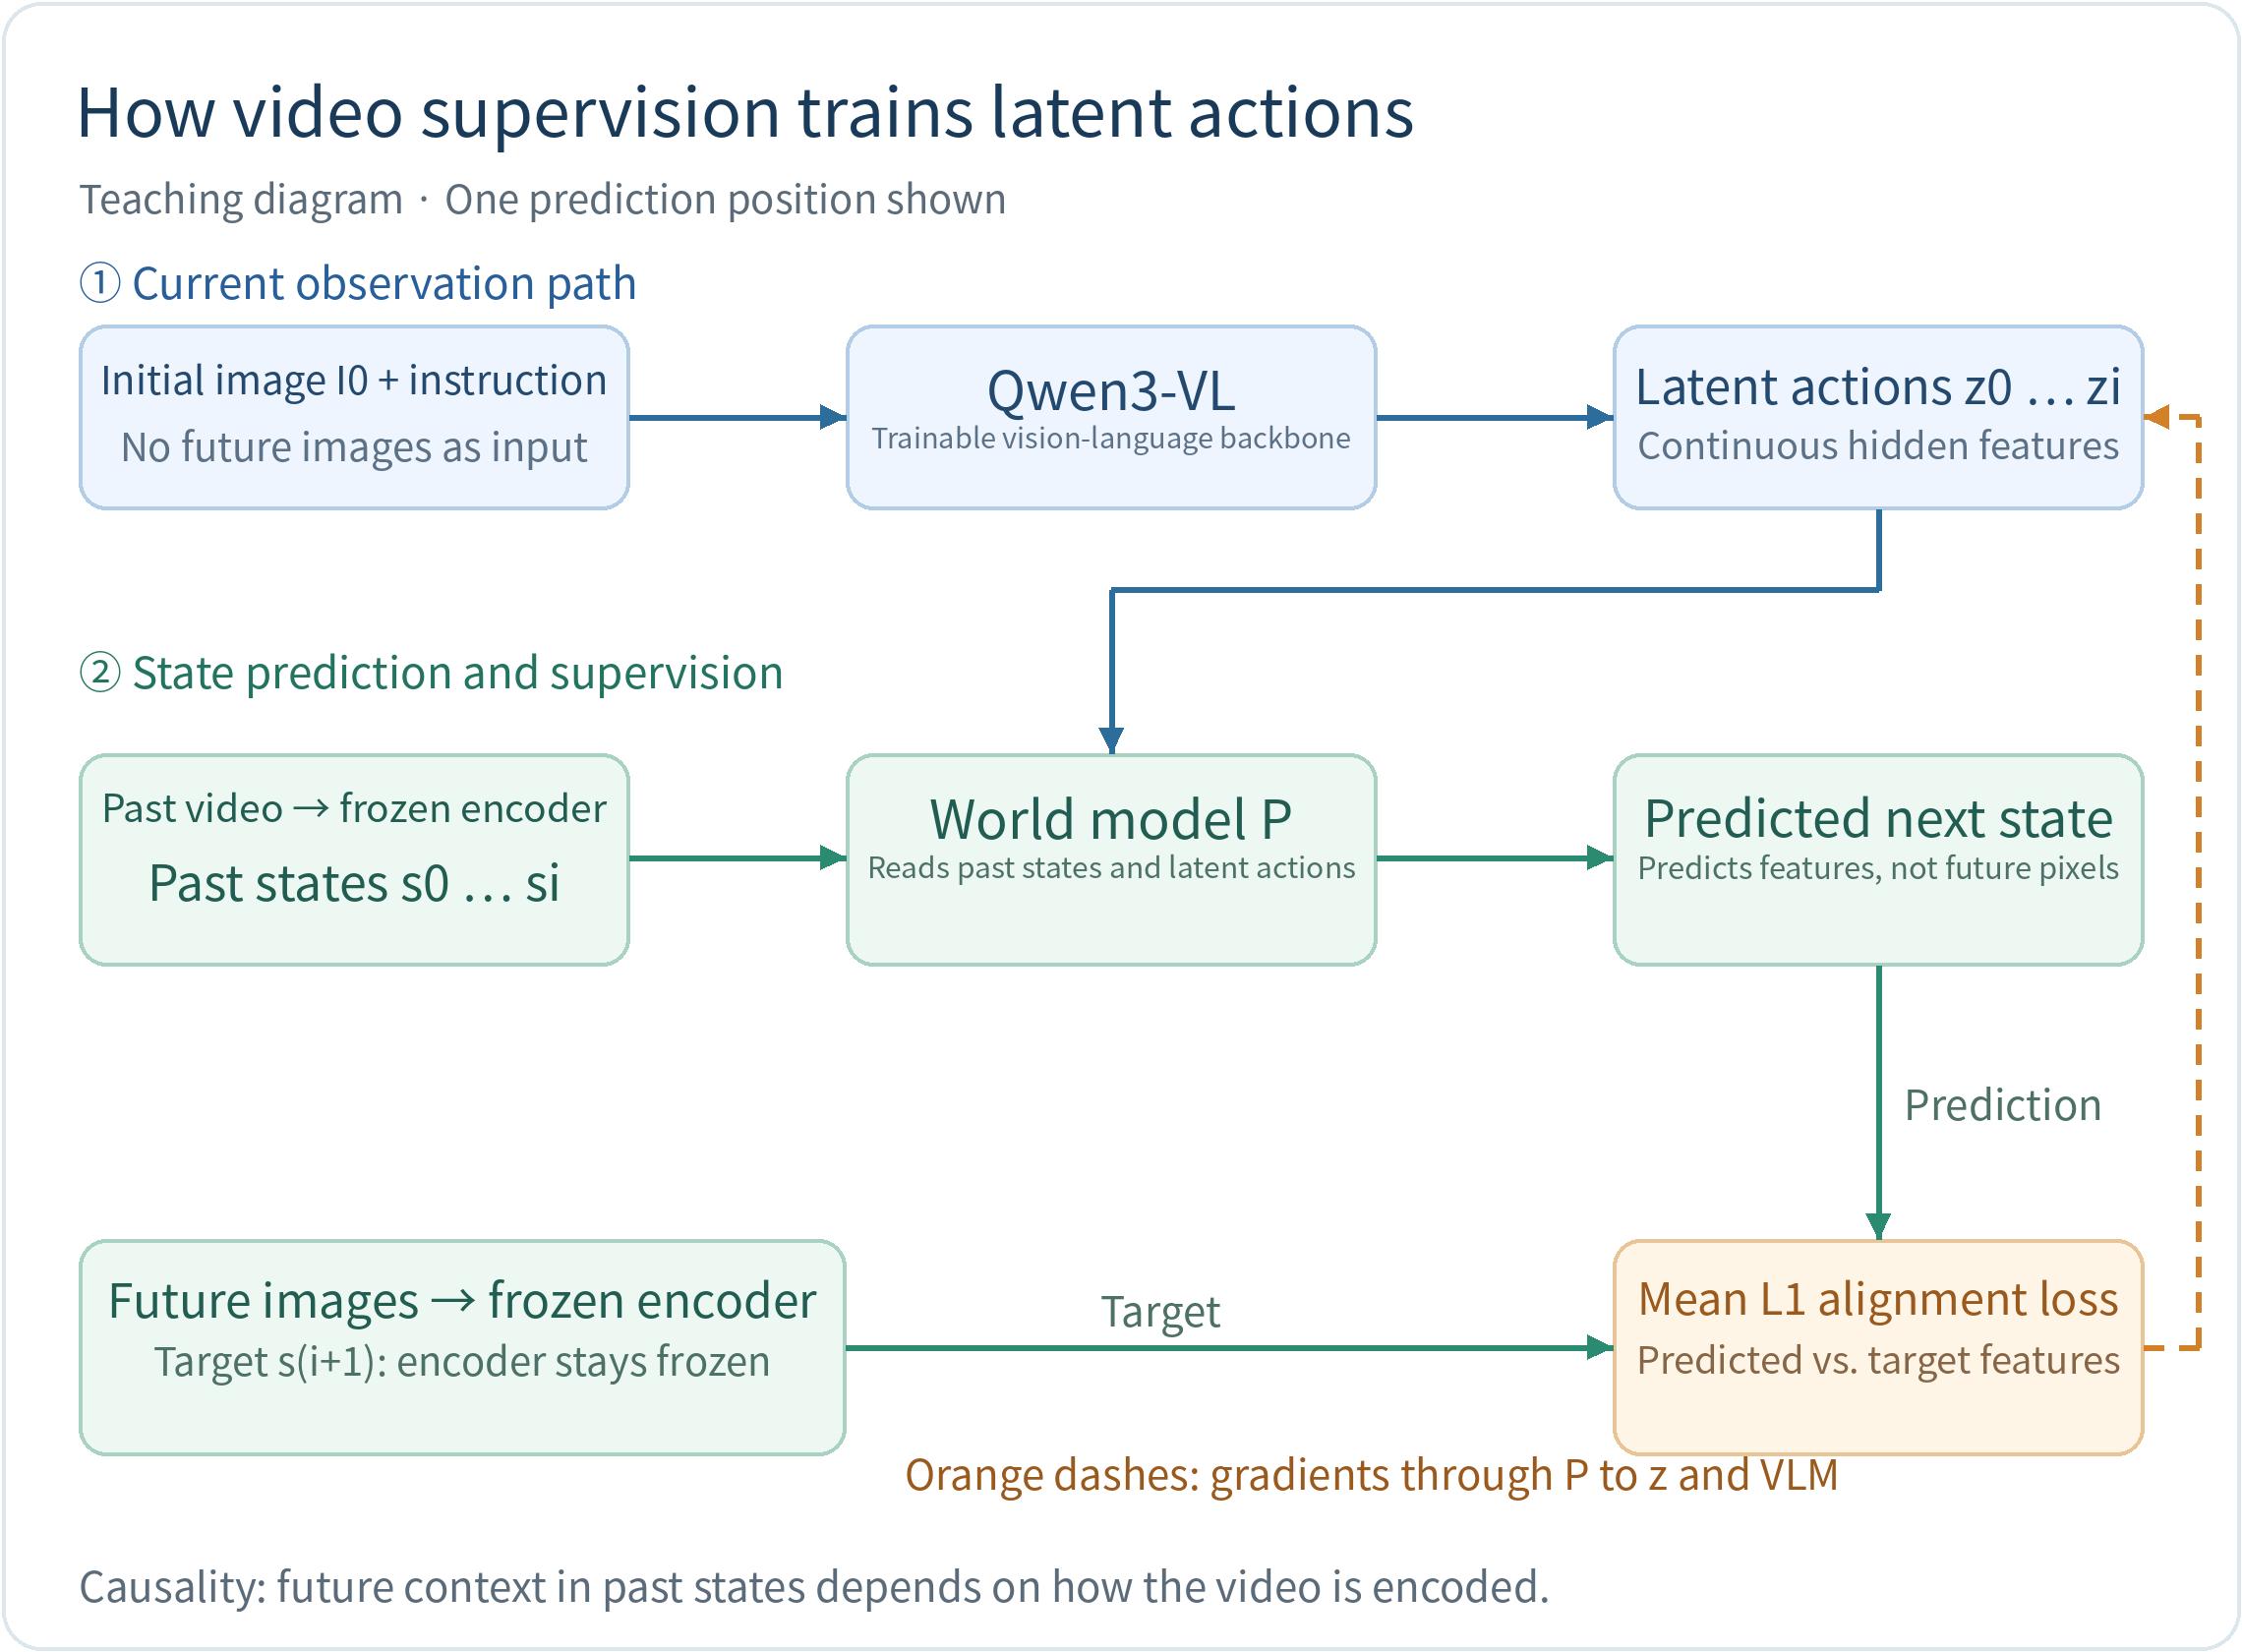
重要なつながりは勾配の経路です。 将来画像は固定エンコーダを通ってターゲットを形成します。予測誤差はワールドモデルを通って VLM へと伝播し、潜在アクションが変化の予測に有用な情報を運ぶよう促します。例えばリンゴがテーブルから離れることを予測するには、潜在アクションが、その遷移を説明できるようになっていなければなりません。すべての隠れ特徴に対して手作業で意味ラベルを付ける必要はありません。
著者による実装では平均 L1 誤差を用いています。以下は実装された損失を展開したものであり、式 (5) 自体は誤差ノルムを特定していません:
はターゲット特徴をまとめたもので、 は要素数、 は勾配停止(stop-gradient)を表します。エンコーダは固定されたままです。説明用の例として、ターゲットが 、予測が のとき、平均誤差は になります。
これにより、将来画像が VLM に入力される経路が制限されます。予測器の時間的マスクだけでは、ビデオエンコーダの履歴特徴の厳密な因果性は保証されません。
潜在アクションからロボットアクションへ
状態特徴は、依然として制御との結び付きが必要です。2 つ目のアクションクエリ集合が潜在アクションクエリの後に続き、先行する画像・言語・潜在アクションを読み取って条件付け を形成します(式 (6))。その後、DiT(Diffusion Transformer)アクションヘッドが連続アクションシーケンスを生成します。
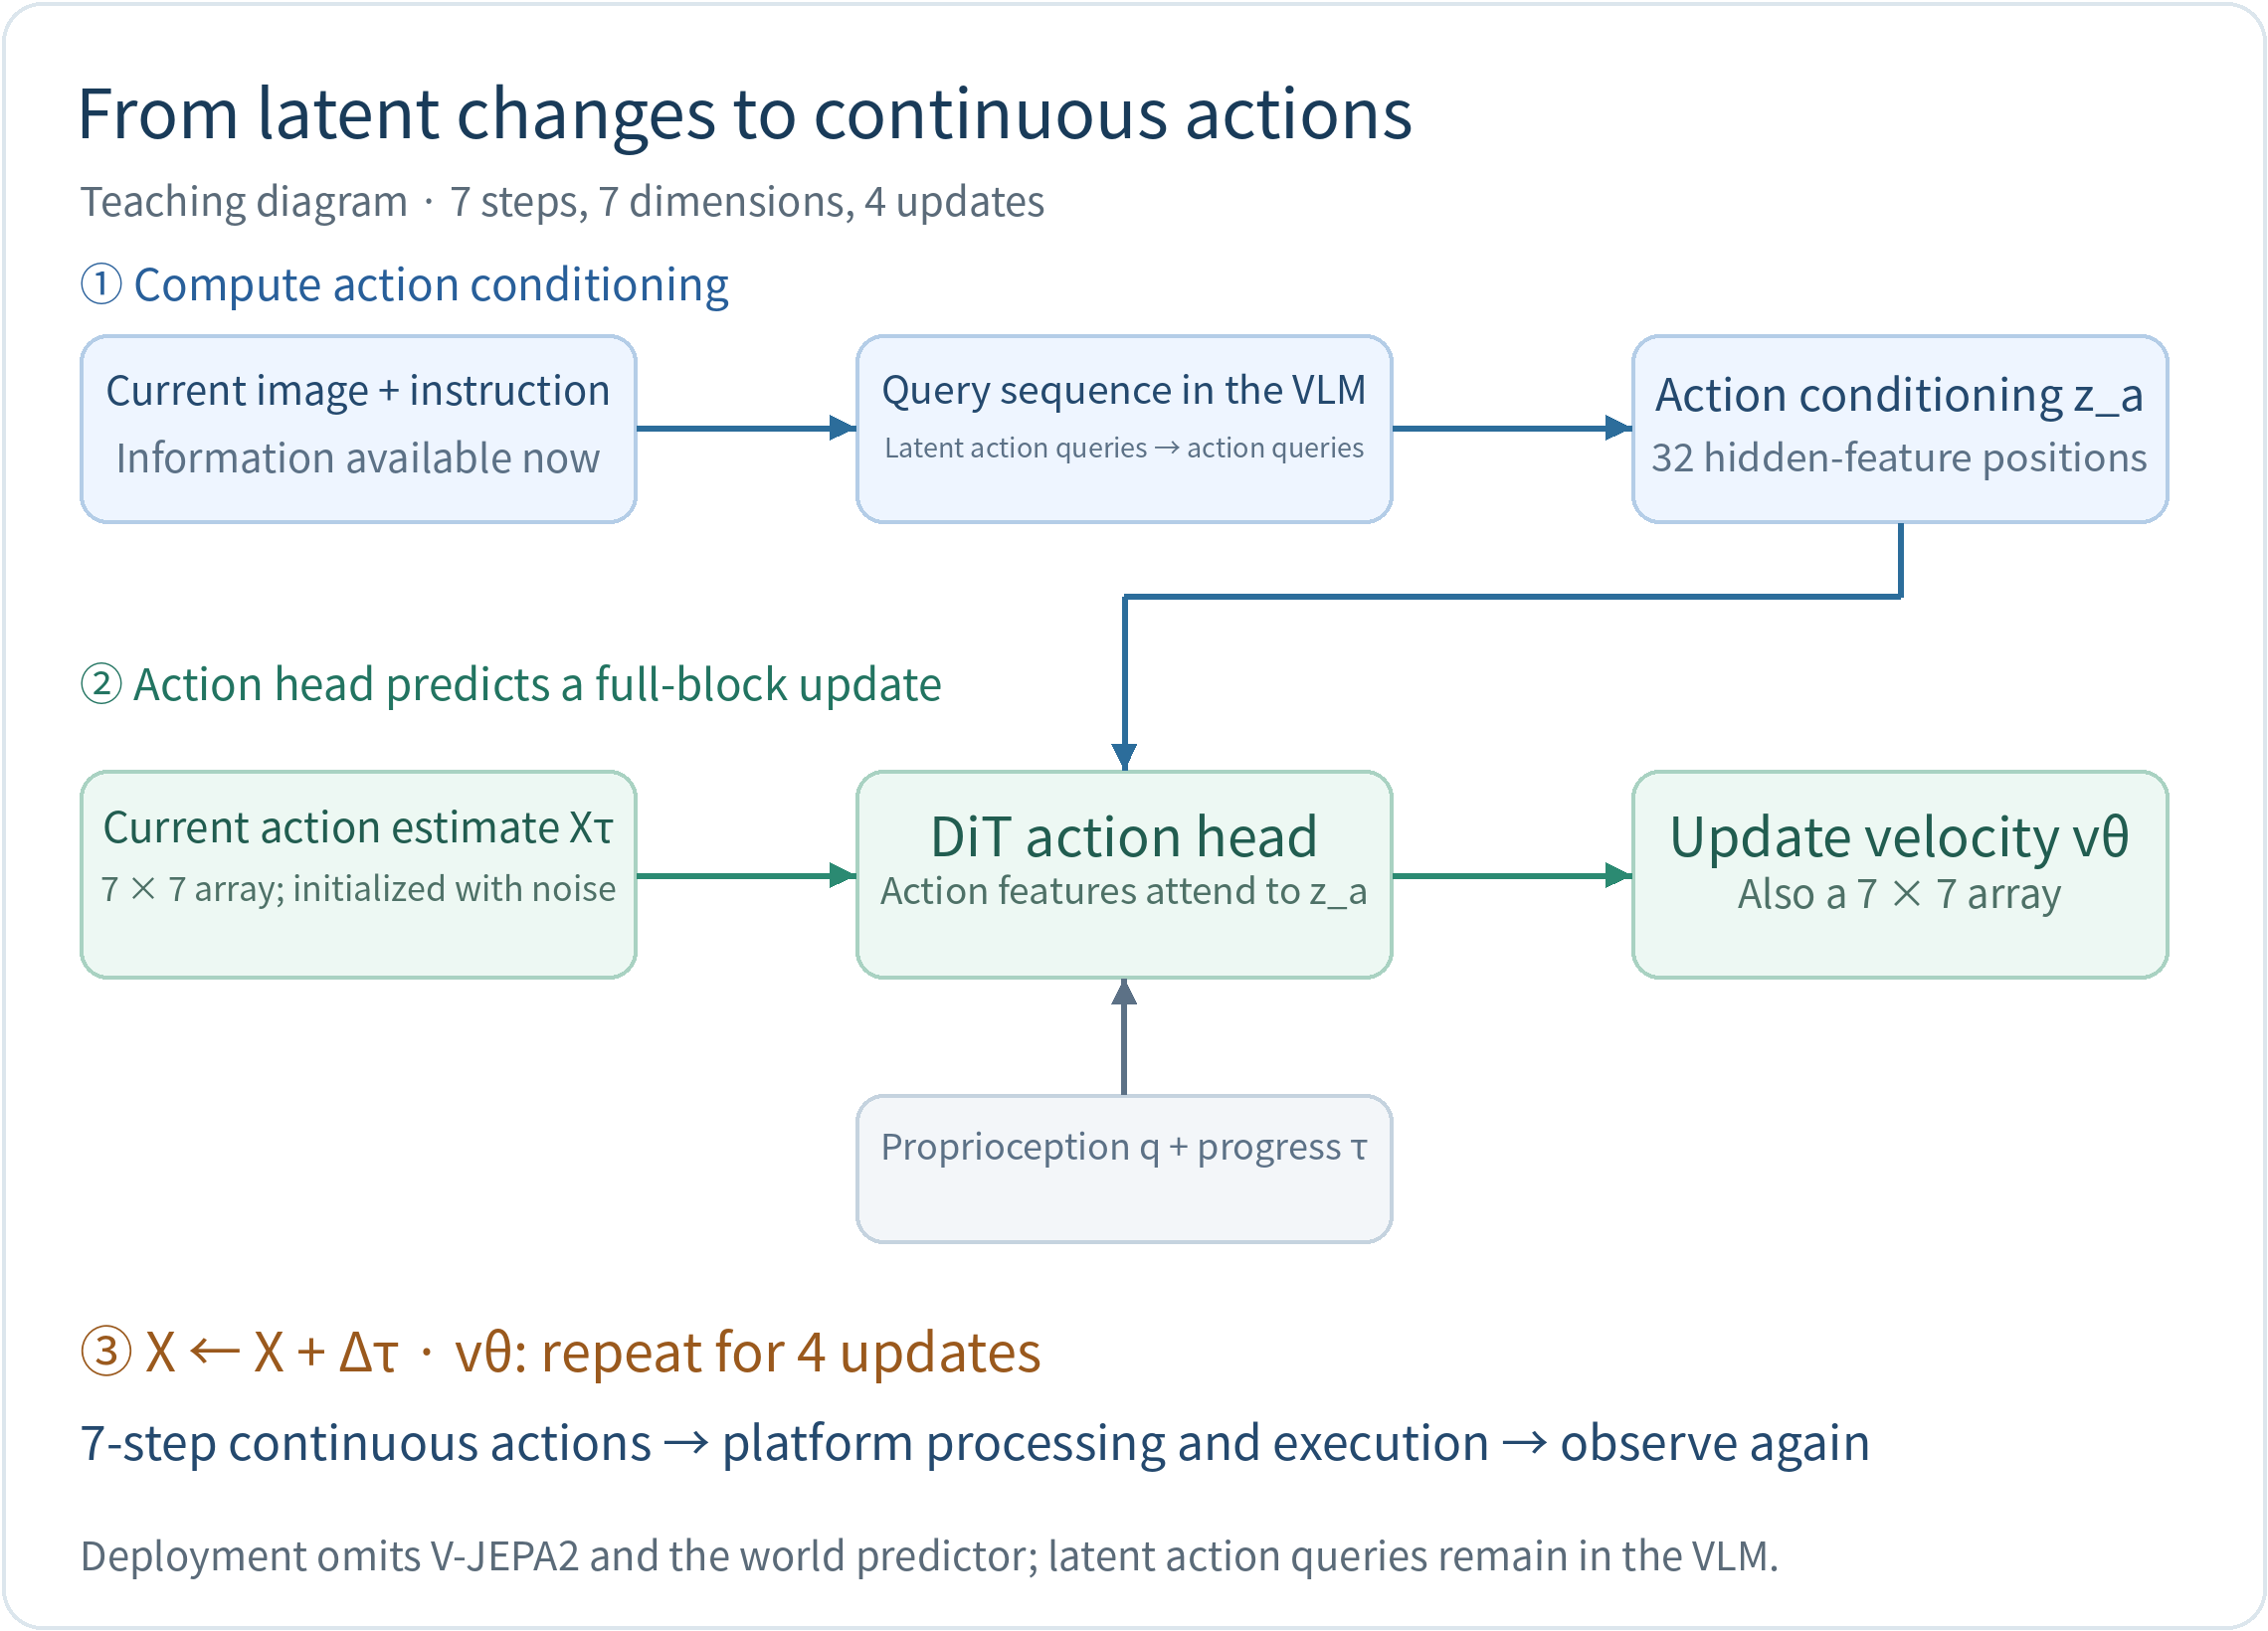
このヘッドは conditional flow matching を用います。提示されたアクションチャンク を、同じ形状のガウス雑音 と混合し、雑音からアクションへ向かう方向を学習します。式 (7)–(8) は次のように書けます:
は生成の進行度であり、ロボットの時間とは異なります。 はアクションチャンクと同じ形状の更新量を返します。1 要素の場合、、、 なら、中間値は 0.2、ターゲット方向は 0.8 になります。0.5 を予測した場合、二乗誤差は 0.09 です。
推論は新たな雑音から開始し、予測された方向に従います。公開実装では Euler 更新を用いています:
4回の更新によって のアクションチャンクが生成されます:7つの制御ステップがあり、それぞれに7つの値があります。これら4回の更新はロボットの4ステップを表すのではなく、アクションヘッド内部で行われます。実装では、アクションヘッドに固有感覚状態と生成進行度も与えられ、ヘッドはクロスアテンションを通じて を読み取ります。論文では一様な時間サンプリングを用いていますが、固定実装ではBetaサンプリングを使用しており、これは学習設定上の違いです。
学習と推論
共同事前学習では、およそ 220,000本のSomething-Something-v2人間動画 と 76,000軌跡のDROIDロボットデータ を使用します。人間動画は状態予測のための画像と言語を提供します。ロボットデータはさらに、共同最適化(式 (9))のためのアクションラベルも提供します:
は2つの損失の重みを表します。著者実装と固定されたLeRobot版の両方で0.1が使用されています。50,000ステップの事前学習後、そのチェックポイントから分岐して、シミュレーション学習(30,000ステップ)とハードウェア微調整(20,000ステップ)がそれぞれ継続されます。
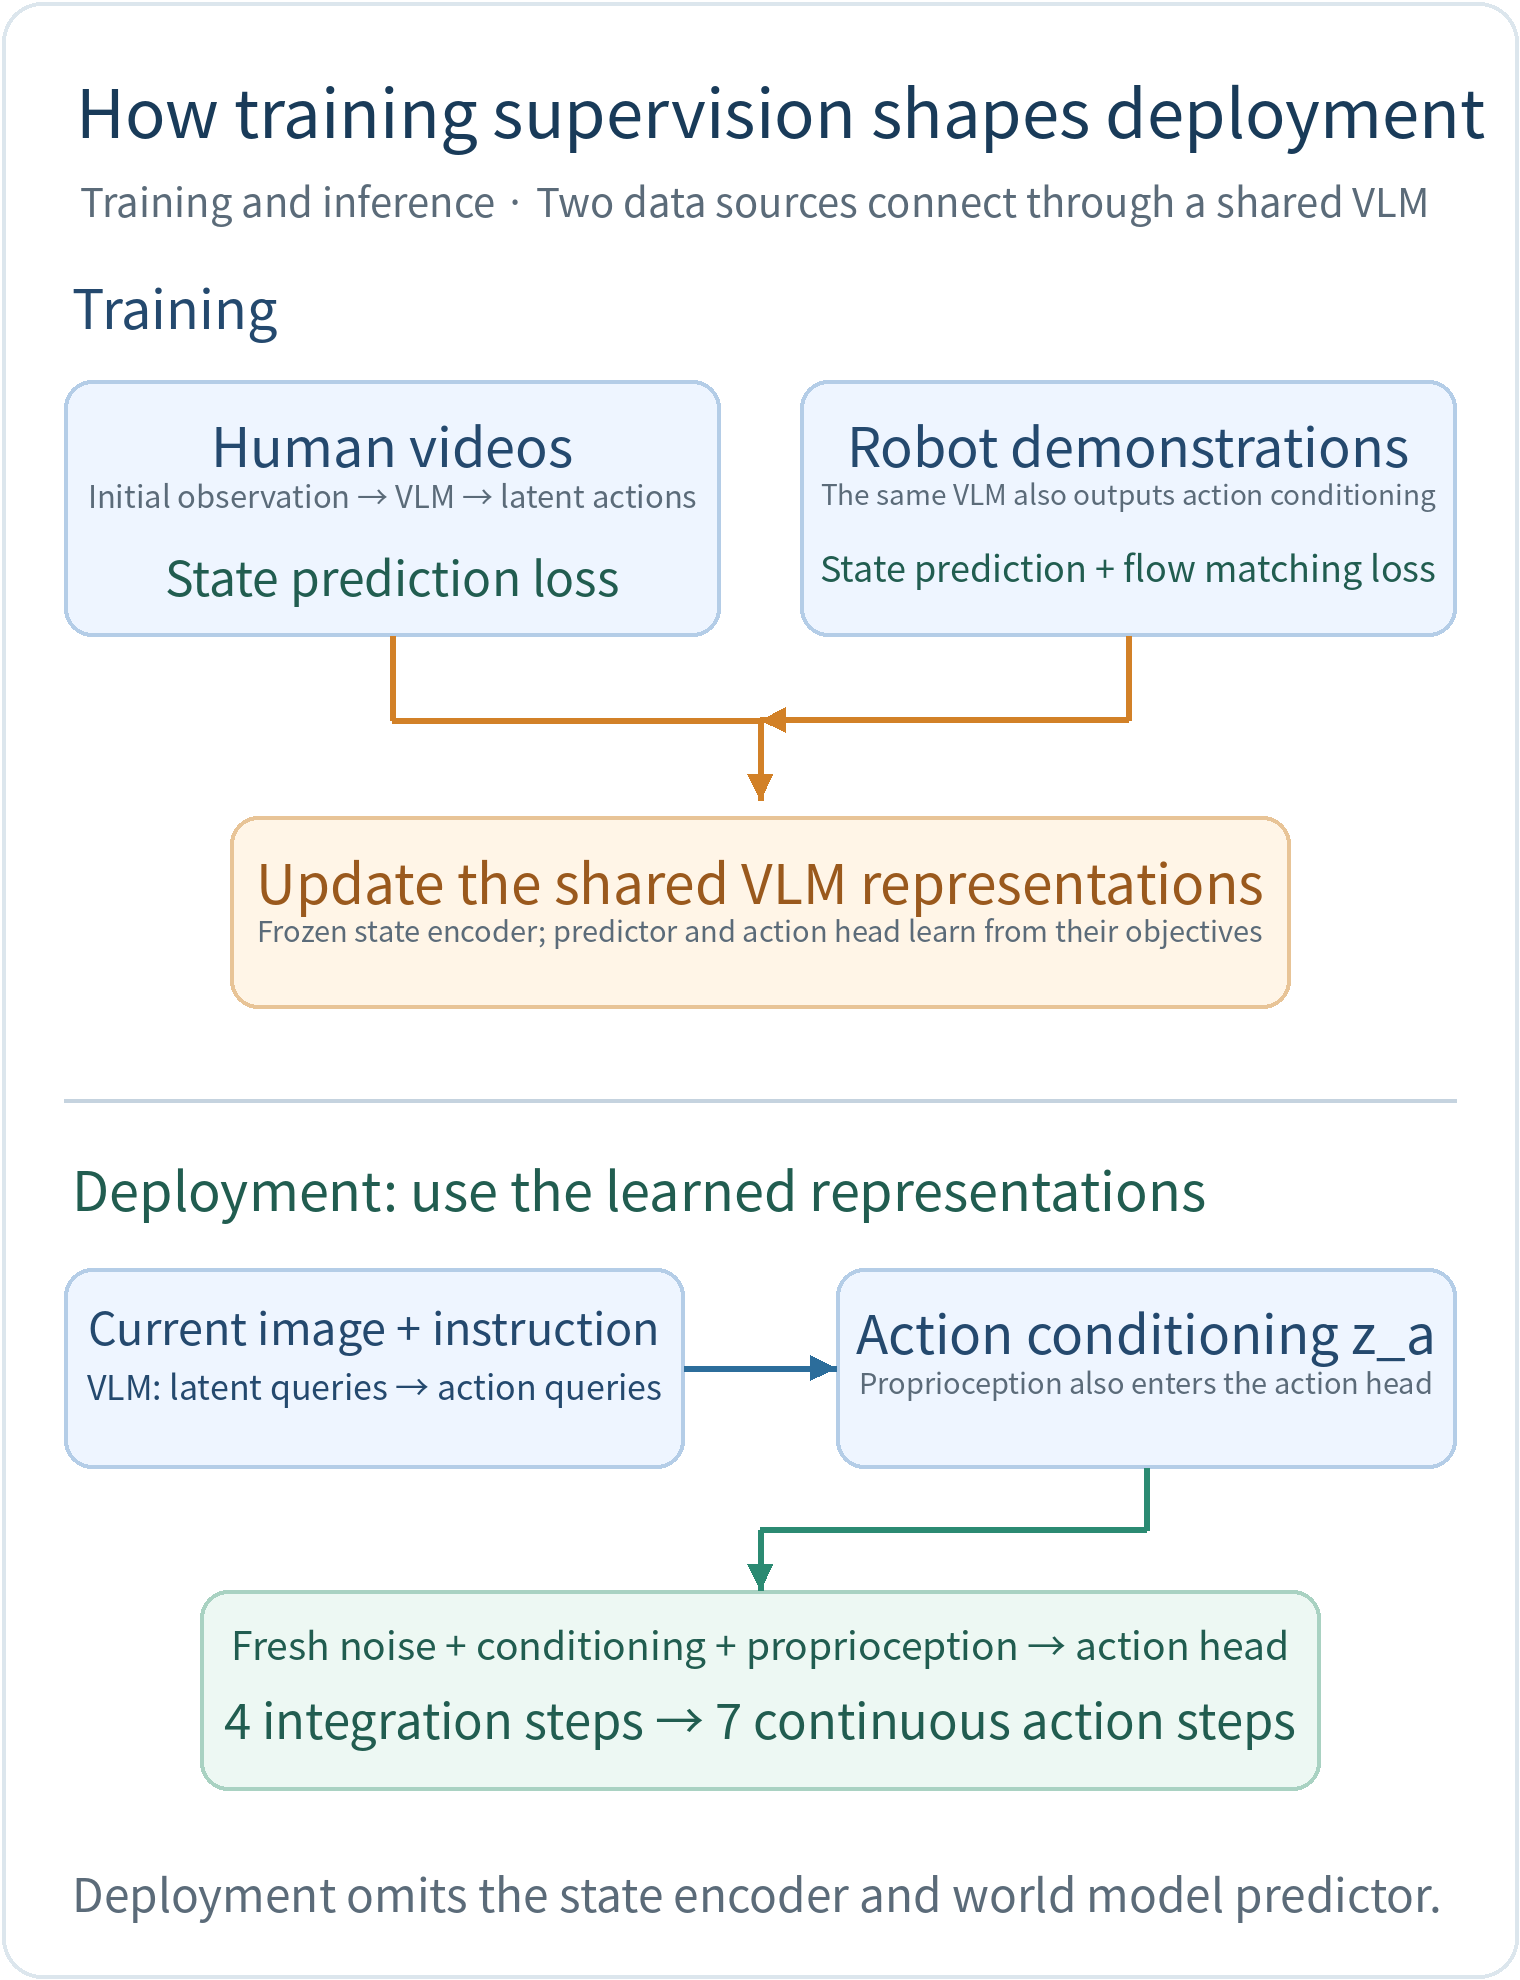
学習中は、ビデオエンコーダが履歴とターゲットを供給し、ワールドモデル誤差がVLMを学習させ、ロボットデモが制御の教師信号を追加します。運用時には、現在の画像、指示、およびアクションヘッドが必要とする状態入力だけで十分です。潜在アクションの計算とアクションヘッドは残りますが、ビデオエンコーダとワールドモデル予測器は省かれます。コントローラがアクションを実行し、その後の新たな観測が次の予測を支えます。
したがってワールドモデルは主に学習時の教師として機能します。運用時にアクションを選ぶために将来の動画を探索することなく、変化を説明する表現を促します。
実験結果
標準タスクと摂動
LIBEROのファインチューニングにはエキスパートデモが用いられます。4つのスイートにはそれぞれ10個のタスクが含まれ、各タスクは50回評価されます:合計2,000試行です。表1は完全な手法を比較し、最後の2行に人間動画のアブレーションを含みます:
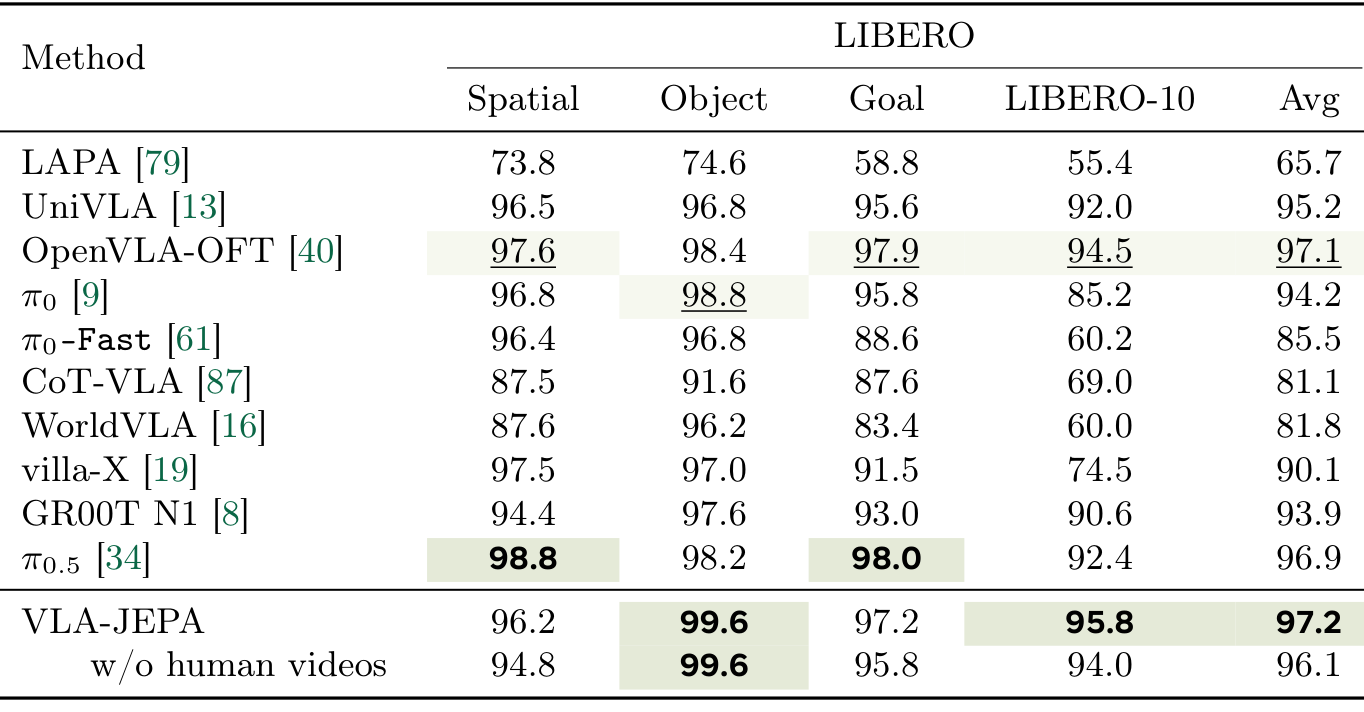
平均成功率は 97.2% であり、人間動画なしの 96.1% と比べて高くなっています。完全なモデルは掲載された手法の中で最高ですが、OpenVLA-OFTの97.1%に近い値です。メインの表には独立した学習実行間の誤差バーがないため、小さな差異を過大評価すべきではありません。
LIBERO-Plusは、元のLIBERO学習データを保持したまま、7種類の摂動を追加します:
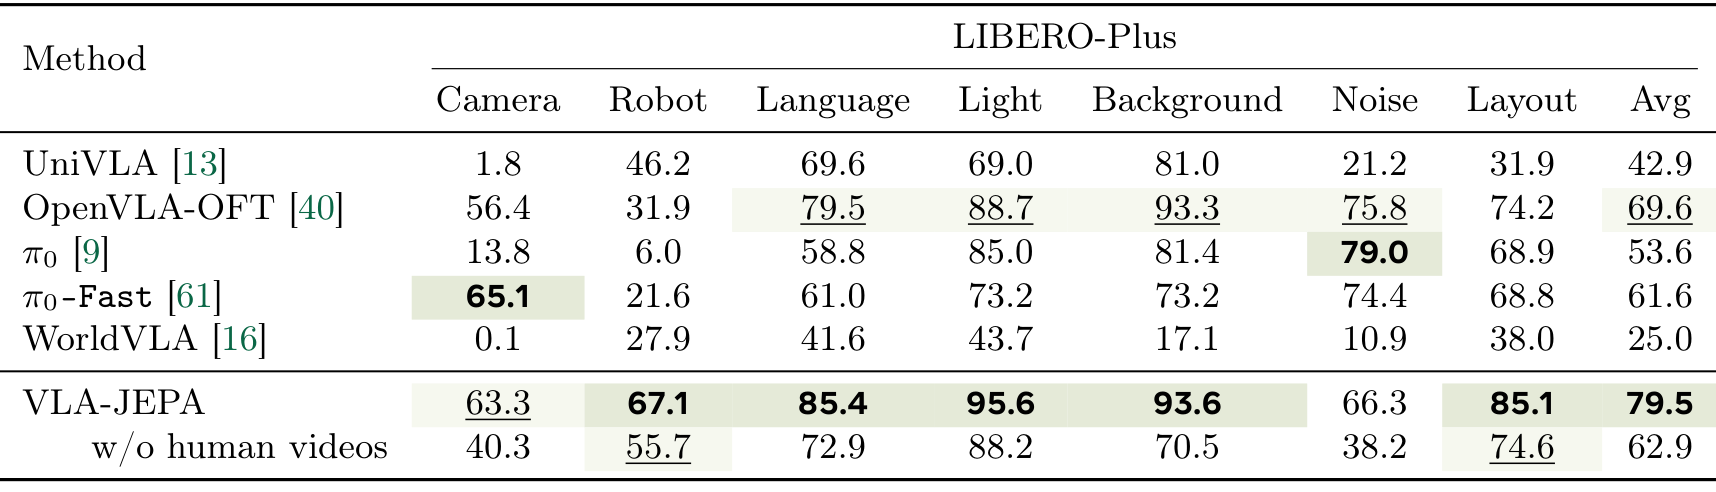
人間動画により平均成功率は 62.9% から79.5%へ 上昇し、7つすべてのカテゴリで改善が見られます。この16.6ポイントの向上は、標準タスクでの1.1ポイントの向上よりも大きく、摂動下での利点をより明確に示しています。
転移とハードウェア性能
SimplerEnvは、実ロボットの学習データからシミュレーションへの転移を評価します:
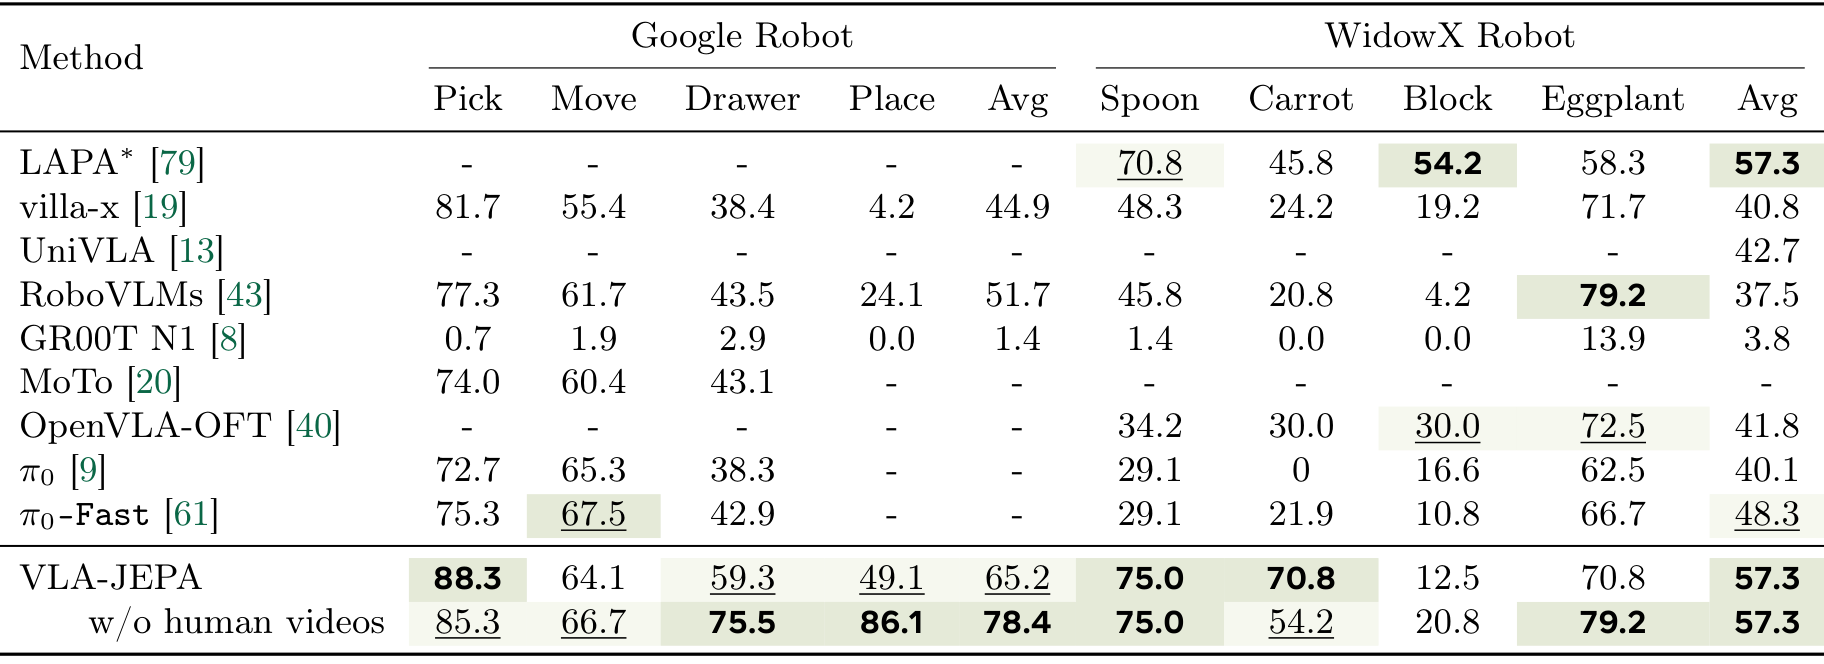
利点は普遍的ではありません。人間動画を追加すると、Google Robotの平均成功率は 78.4% から65.2%へ 低下し、WidowXは 57.3% のままです。動画経験は、特定の制御タスクに対するロボットデモを代替するものではありません。一部のベースライン平均値とテキストでの順位付けには不整合があるため、ここでの結論はモデルアブレーションに基づいています。
ハードウェアテストでは、Franka Research 3、Robotiqグリッパ、3台のD435カメラを使用し、タスクごとに10回の試行を行います。図4に結果が示されています:
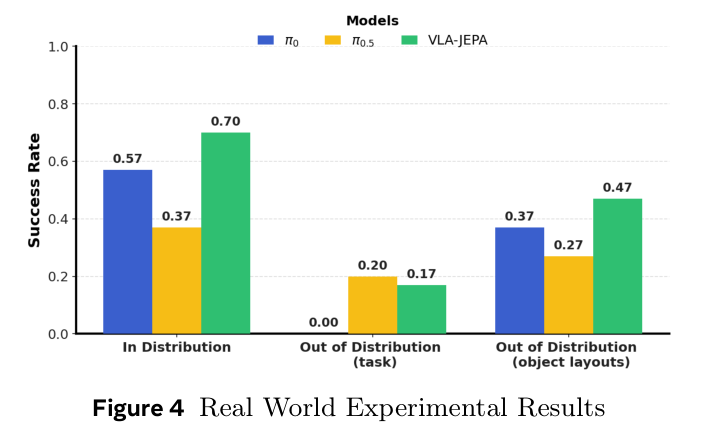
VLA-JEPAは、分布内条件で 0.70、レイアウト変更後で 0.47 に達し、2つのベースラインを上回ります。未知タスクでのスコアは 0.17 であり、π0.5の 0.20 を下回ります。3つのモデルのいずれも、未知の棚の最上段にブドウを置くタスクを完了できず、VLA-JEPAは依然として誤った物体を選択してしまうことがあります。
これらの実験は、全体としての手法の競争力と、摂動に対するロバスト性における人間動画の貢献を裏付けています。一方で、JEPA目的、情報アクセス、学習ステージの効果を個別に切り分けてはいません。
結論
VLA-JEPAは、動画中の状態変化をロボット表現の教師信号へと変換します。 潜在アクションが変化を説明し、アクションヘッドが制御値を生成し、ロボットデモが両者を結びつけます。この教師設計により、テストされた摂動下での性能が向上しますが、信頼できる実行と未知タスクへの汎化は依然として未解決の課題です。
参考文献
- VLA-JEPA paper v2 および paper PDF。イントロダクションと関連研究:セクション1–2;手法:セクション3;実験:セクション4;設定とハードウェアプロトコル:付録A–B。
- 著者プロジェクトページ および モデルリポジトリ。
- コミット ec90777 時点の著者コード: model and losses、pretraining configuration。
- コミット f5c9bc0 時点のLeRobot: model、action head、および configuration。実装上の違いはデータフローと学習の詳細を補足するものであり、論文結果の情報源ではありません。