WALL-OSS: ビジョン・言語理解はどのようにエンボディドアクションへとつながるのか
VLM をエンボディド空間へと点火する
- アクションセマンティクス
- 連続制御
- Uni-CoT
- エンボディド QA
前提知識:ゴールと実行を結びつける
VLM から VLA へ
説明: VLM は画像と言語を解釈し、VLA はさらに数値制御を生成します。この論文では、口頭の回答をそのままモーターに送るのではなく、デモ、視覚 QA、プロセス注釈から写像を学習します。
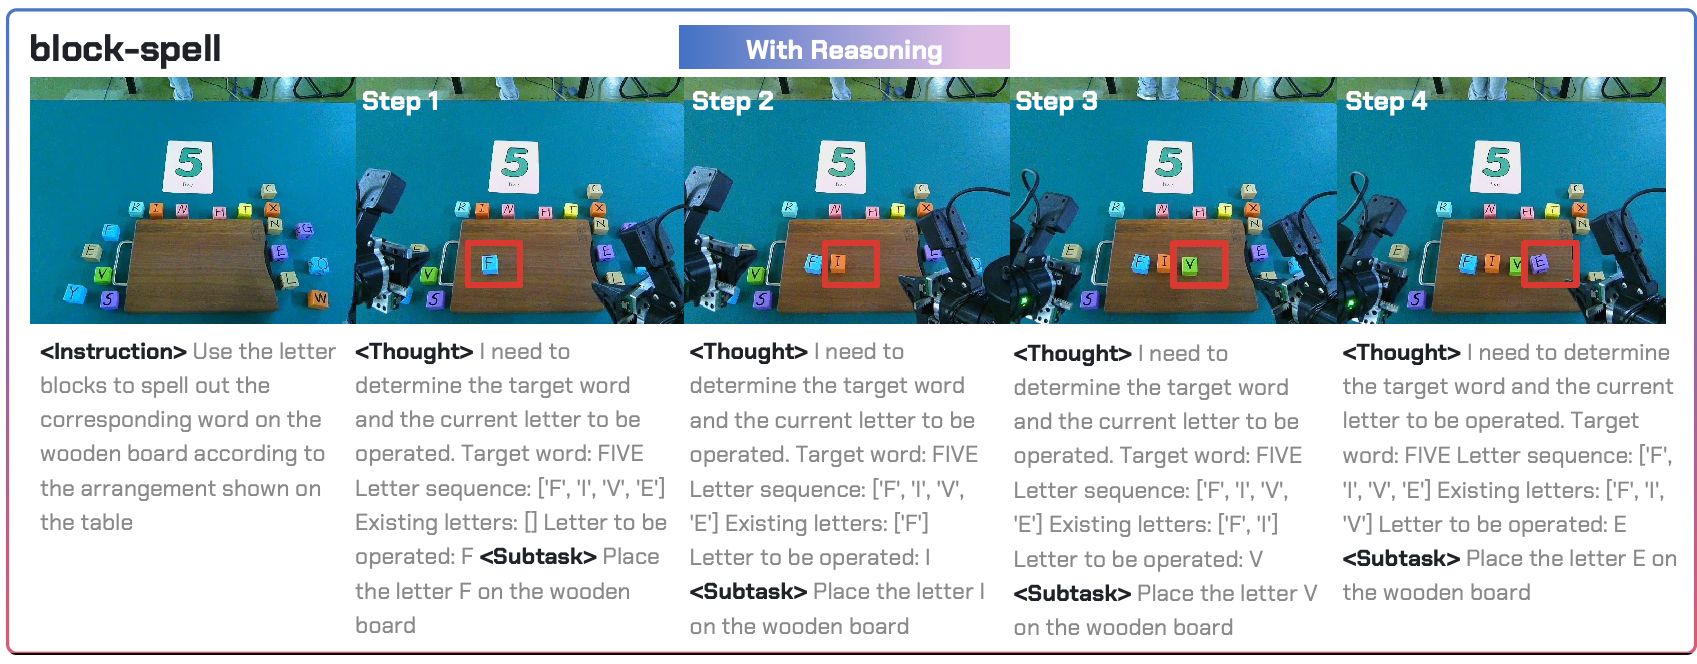
文字ブロック課題では、ゴールの認識、文字順序の選択、ブロックの位置特定と配置が必要です。「FIVE と綴れ」と答えることは理解の部分だけを完了したに過ぎません。
| 概念 | 直感的な意味 | 本論文での例 |
|---|---|---|
| 観測 | シーンに関する外部情報 | 一人称視点およびアーム搭載カメラの画像。 |
| ロボット状態 | ロボットの数値的な構成 | 図 3 の連続分岐に入る状態。フィールドや次元は報告されていない。 |
| アクション | 制御インターフェースに対する数値ターゲット | T ステップ・d 次元の軌道。位置はソース間でメートル、角度はラジアンに正規化される。 |
| Visual question answering (VQA) | 画像からテキスト質問に答える | ブロックの位置特定、シーンの記述、サブタスクの予測。 |
| Chain of thought (CoT) | 明示的な中間推論 | ゴールは FIVE。F と I は配置済みで、次は V。 |
注意: 図 3 の状態入力は、本文が条件付けをビジョンとインストラクションと略記しているからといって省略してはなりません。プラットフォームには単腕、双腕、モバイル、車輪型ヒューマノイドが含まれており、自由度数、カメラ数、アクション仕様を 1 つに仮定して共有することはできません。
直接アクションとクロスレベル意思決定
直接ポリシーは画像とインストラクションをアクションに写像し、階層パイプラインはコントローラの前に別個のプランナを用います。WALL-OSS は「インストラクション → 推論 → サブタスク → 連続アクション」を 1 つのモデルで学習し、不必要な中間レベルをスキップできるようにします。
Direct: image + “spell FIVE” → action sequence
Full: image + instruction → goal/progress reasoning → “place V third” → actions

Illustrative timeline:
First decision: empty board → place F
Later decision: F is present → place I
Next decision: F and I are present → place V
説明: サブタスクは現在のゴールを明確にし、反復アクションやステージの混乱を減らすことができます。正しい推論には、依然として正確な低レベル実行が必要です。このタイムラインは進行を説明するものであり、報告された固定の再計画スケジュールではありません。
離散アクションモデリング (DAM) は数値軌道をトークンとして符号化し、連続アクションモデリング (CAM) は数値軌道を直接生成します。これは表現/目的関数の違いであり、単ステップ制御とマルチステップ制御の別名ではありません。
学習・推論・評価
| 段階 | 操作 | 結果 |
|---|---|---|
| 学習 | 視覚 QA、デモされたアクション、限定的な推論/サブタスク注釈を用いてテキストとアクションの目的を最適化する。 | パラメータ。損失は教師信号への適合度を測る。 |
| 推論 | 連続経路用に画像、インストラクション、状態を読み取り、任意で推論、サブタスク、アクションを生成する。 | 制御に送られる軌道。 |
| 評価 | 指定タスクを実行し、エンボディド VQA を手動で評価する。 | QA 品質、進捗、成功、またはインストラクションの正確さを個別に解釈する。 |
完全な制御レート、推論レイテンシ、実行スケジューリングは報告されていません。「高頻度アクション」や「非同期制御」という表現だけではリアルタイム性能は確立されず、損失はタスク成功を意味しません。
要約:翻訳とコメント
翻訳
言語とビジョンは進歩しているものの、VLM の空間的およびエンボディドな理解は依然として限定的です。物理的インタラクションへと進むことで、モダリティ、事前学習分布、目的関数のミスマッチが露呈し、アクションの理解と生成は汎用知能に向けた大きな課題となります。
私たちは WALL-OSS を紹介します。これは大規模マルチモーダル事前学習を用いて、(1) エンボディドな特徴に敏感なビジョン・言語理解、(2) 強力な言語–アクション結合、(3) ロバストなマニピュレーションを実現するエンドツーエンドのエンボディド基盤モデルです。密結合アーキテクチャと複数戦略のトレーニングカリキュラムにより Unified Cross-Level CoT を実現し、インストラクション推論、サブゴール分解、きめ細かなアクション合成を 1 つの微分可能な枠組みに統一します。
著者らは、ベースラインと比較して強力なインストラクションフォロー、推論、長時間地平マニピュレーションを報告しており、VLM からエンボディド基盤モデルへのスケーラブルな道筋を提示しています。
コメント
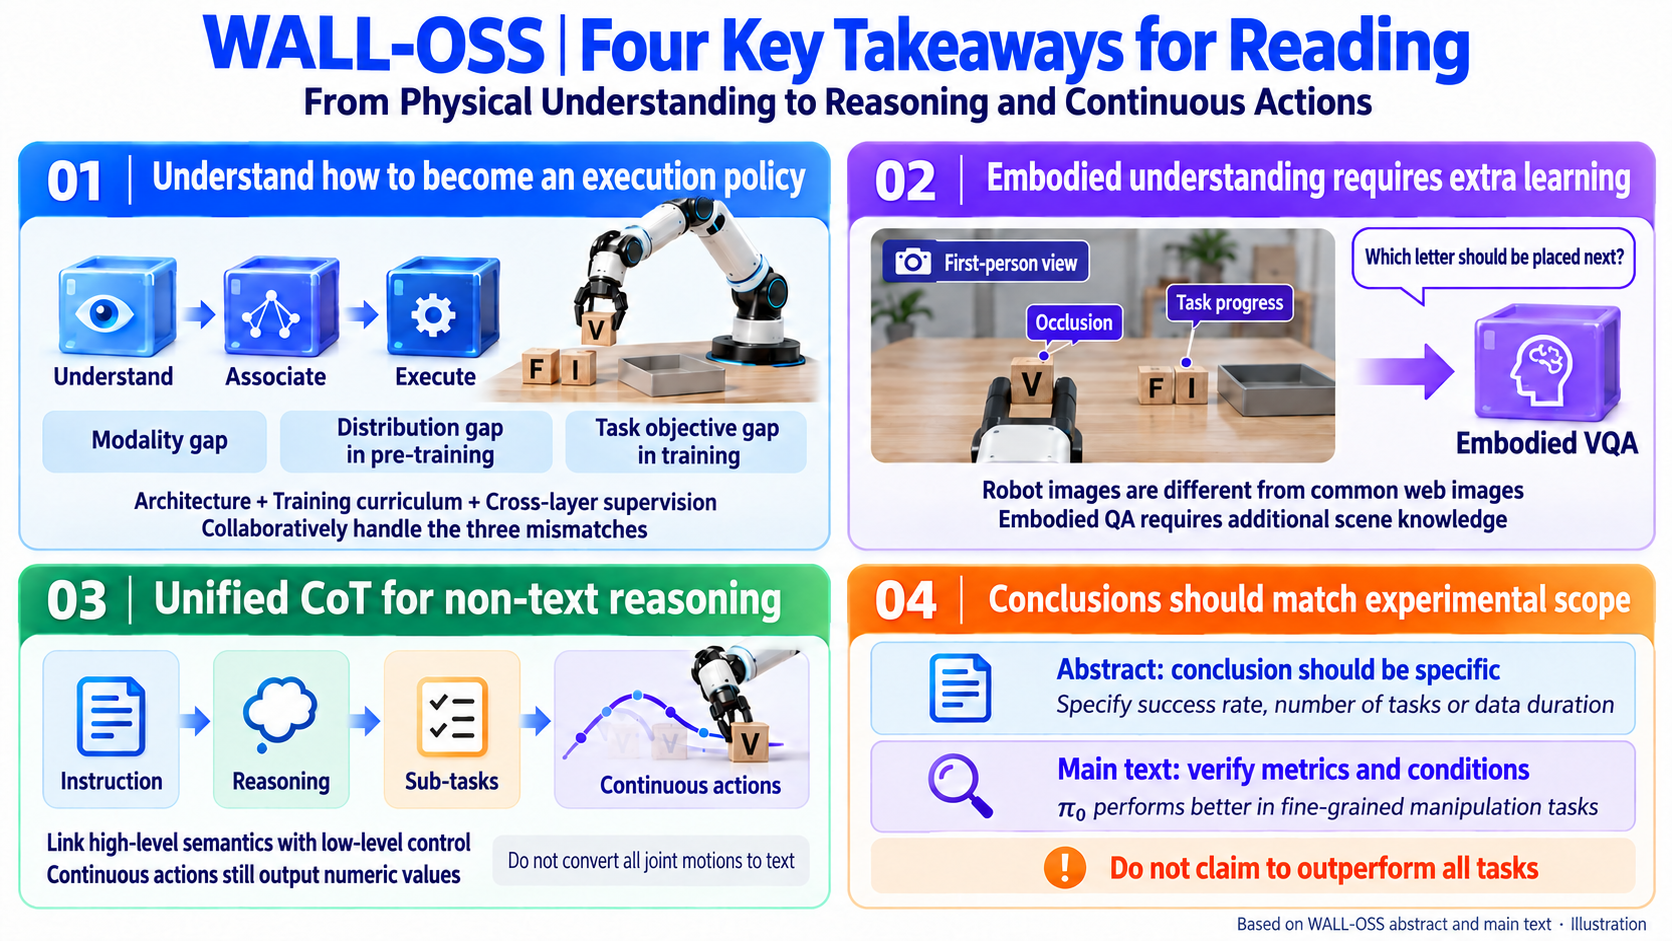
序論と関連研究:3 つのミスマッチ
序論の 8 つの主要パラグラフ
これらは 1〜3 ページに対応します。3 つのパラグラフには Gap の小見出しがあり、パラグラフ 7 は 2〜3 ページにまたがります。図 1 のキャプションは序論本文には数えません。
パラグラフ 1:目的地。 言語/ビジョンモデルはマルチモーダル入力を理解しますが、物理的フィードバックと実行可能なアクションを欠いており、アクションの理解と生成を動機づけます。
パラグラフ 2:なぜ VLM から転移するのか? 画像–テキストデータは豊富ですが、ペアになったロボットデータは乏しく不均質です。事前学習された事前分布は、ゼロからの学習ではなく転移を動機づけますが、それ自体は有効性を証明しません。
パラグラフ 3:転移のジレンマ。 直接的なアクションヘッドのファインチューニングは事前学習パラメータをドリフトさせる可能性があり、強い分離はセマンティクスと制御の結合を弱めるかもしれません。ここから 3 つのギャップが動機づけられます。
パラグラフ 4:モダリティとデータスケールのギャップ。 テキストと圧縮ビジョンは広範にアラインされていますが、アクションは連続的な時空間信号であり、高レベルインストラクションはサブタスクを省略します。プランナ/コントローラの誤りや 3D アプローチの議論は、あらゆる代替案を実験的に否定するのではなく、本研究を動機づけるものです。
パラグラフ 5:分布ギャップ。 一人称視点、魚眼画像、自己オクルージョンはインターネット画像と異なります。空間的グラウンディングと進捗評価にはエンボディドな教師信号が必要です。図 1 はこれを示すものであり、大規模ベンチマークではありません。
パラグラフ 6:目的関数ギャップ。 テキストは離散的な次トークン予測を用い、連続アクションには diffusion やフローマッチングが適しています。単に目的関数を結合するだけではセマンティクスと制御を強く結びつけられない可能性があり、離散から連続へのトレーニングを動機づけます。
パラグラフ 7:提案される応答。 結合されたエキスパートと段階的トレーニングは目的関数に対処し、エンボディド QA と離散事前分布は分布に対処し、統一 CoT はセマンティクスをレベルをまたいだ細かなアクションへと結びつけます。
パラグラフ 8:貢献と公開リソース。 この論文は固定された番号付き 3 項目の貢献リストを提示してはいません。アーキテクチャ結合とカリキュラム設計、インストラクションフォロー、構成的推論、長時間地平制御に関する実験、そしてセマンティクスとセンサモータ間ギャップをまたぐより広い道筋を要約し、トレーニングコードとチェックポイントの公開を告知します。「最先端」や「理論的洞察」といった表現は著者の主張であり、その証拠は個々の実験と公開された形式的記述を通じて評価されます。
3 つの関連研究分野と本研究の違い
-
言語・ビジョン・マニピュレーションの基盤: 既存の VLA はアクショントークンまたは連続ヘッドを用います。WALL-OSS はまず言語出力空間で離散アクション事前分布を学習し、その後フローマッチングを静的ルーティングで最適化します。ACT を離散手法と大まかに同一視しているからといって、ACT を FAST/BPE トークナイザと見なしてよいという意味ではありません。
-
マルチモーダル/ロボットの共同学習: 先行手法は理解を維持し転移を改善するために画像、動画、ロボットデータを用います。本研究では、エンボディドな教師信号によってインストラクション、推論、サブタスク、アクションを統一し、ドリフトを抑えるためにクォータと段階的カリキュラムを導入します。
-
推論と分解: 分離されたプランナは学習を単純化しますが、インターフェース誤差や累積誤差を生む可能性があります。Uni-CoT は 1 つのモデルでレベルをまたぐ写像を学習し、中間推論を任意とします。パイプラインに対する普遍的な優位性には、依然として証拠が必要です。
中核となる手法:連続制御に先立つアクション意味論
共有アテンションと分離された特徴処理
問題: 行動を強く条件付けしながら視覚と言語の知識を保持するには、完全共有パラメータと独立パラメータの間でトレードオフが生じる。直感: 共有アテンションで情報をやり取りし、その後で特徴カテゴリごとに別々のフィードフォワードネットワークで処理する。
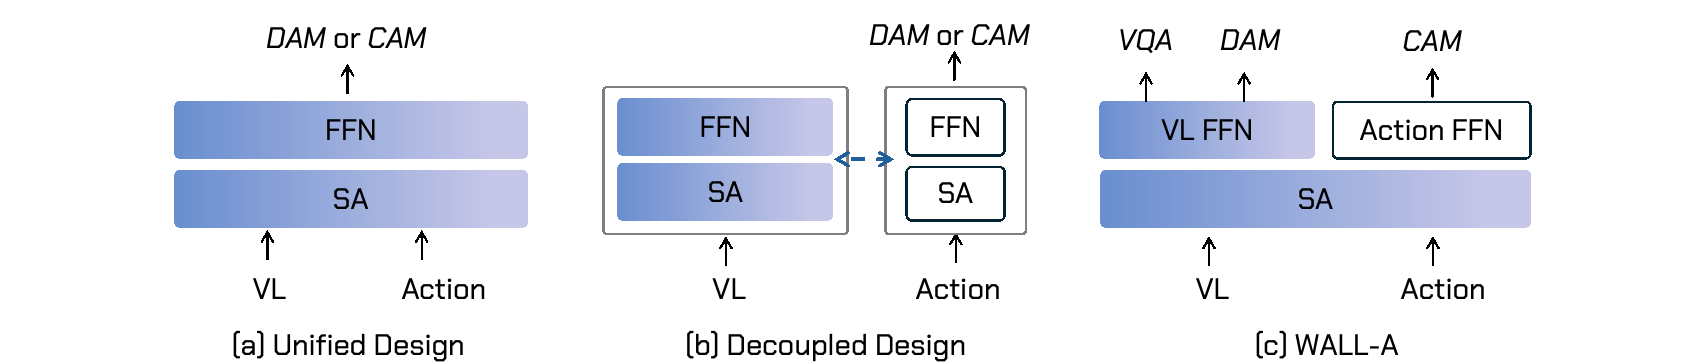
論文: Qwen2.5-VL-3B がバックボーンである。Mixture-of-Experts 設計により、視覚と言語の特徴は静的に vision-language FFN へ、行動の特徴は action FFN へルーティングされる。自己注意によりモダリティ間の情報が交換され、FFN が処理を専門化する。
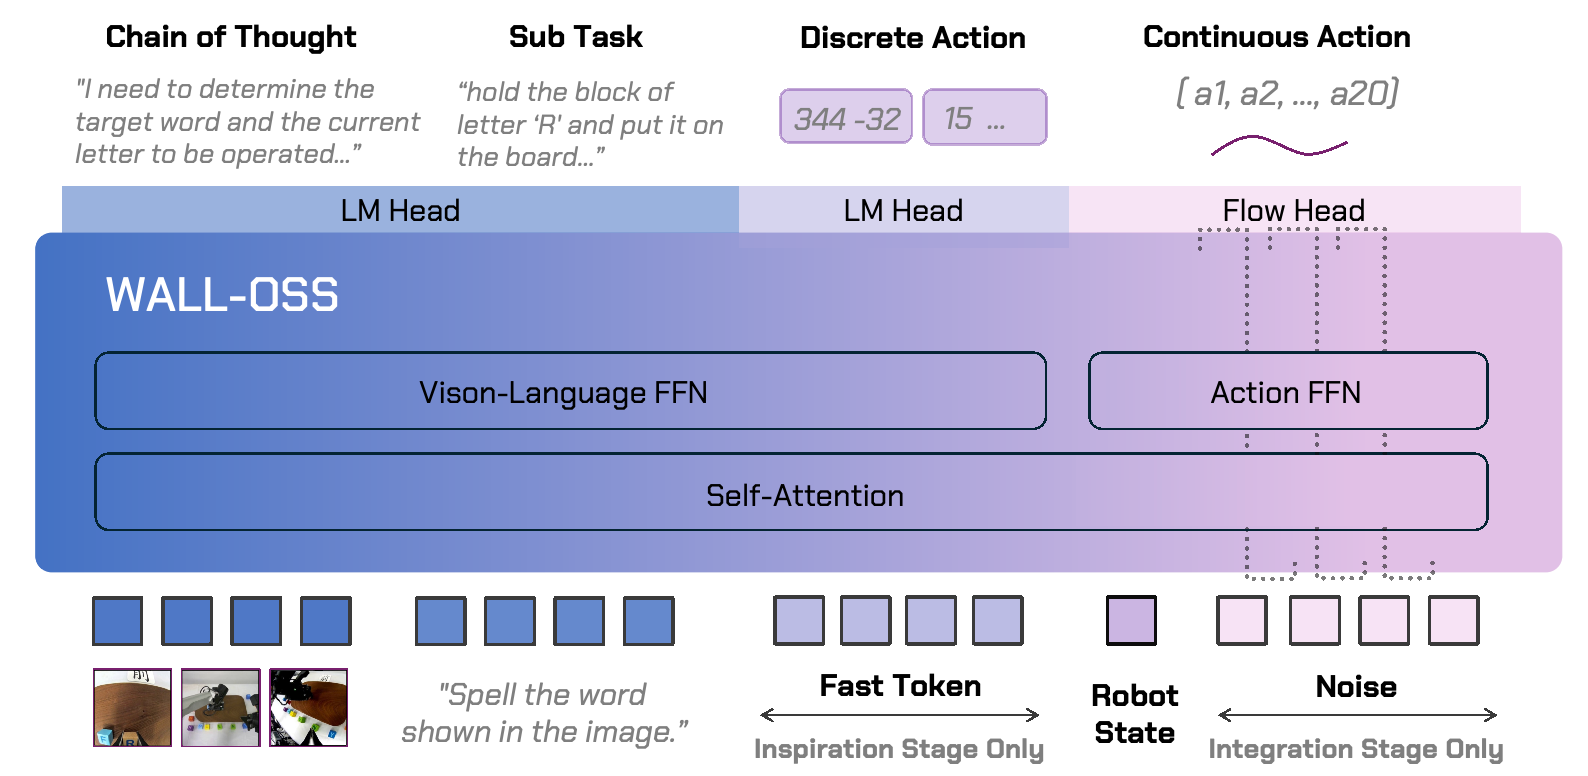
| 経路 | 入力と処理 | 出力と形状 |
|---|---|---|
| 画像/言語 | 自己視点/アーム視点と指示 → エンコーディング → 共有アテンションと VL FFN | 特徴 h。トークン数と隠れ次元幅は未公表。 |
| テキスト | 視覚と言語の条件 → LM ヘッド | 語彙確率を持つ推論/サブタスクトークン。 |
| 離散行動 | デモ → FAST;プレフィックスから後続トークンを予測 | K 個の行動トークン。K は軌道ステップ数 T とは異なる。 |
| 連続行動 | 画像テキスト特徴、ロボット状態、同形状ノイズ、進捗 → アテンション → action FFN とフローヘッド | T × d の速度場;積分により同形状の軌道が得られる。 |
これは静的ルーティングの説明用形式化であり、論文の追加アルゴリズムではない:
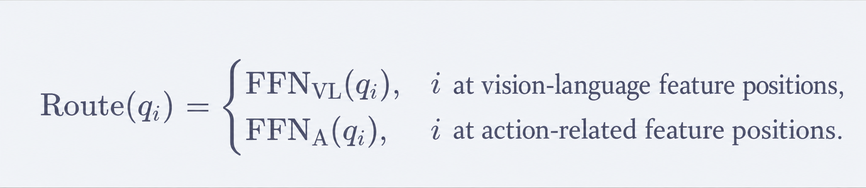
qᵢ は位置 i におけるアテンション後の特徴で、幅は D である。両方の分岐は下流表現の互換性を必要とするが、幅や射影は報告されていない。i は系列インデックス、D は単位を持たない特徴数である。学習された softmax/top-k ゲーティングとは異なり、この分岐は新たに推定されたエキスパート確率ではなく、特徴カテゴリによって選択される。
最小例: [image, image, instruction, action, action] の場合、最初の 3 つの位置を VL FFN に、最後の 2 つを action FFN にルーティングしつつ、共有アテンションは両者を依然として接続する。これは未指定の状態エンコーディングやルーティングを埋めるものではない。
次元の境界: 例として T=3, d=2 のチャンクには 6 個の値が含まれ、B=4 のとき形状は 4 × 3 × 2 となる。これらの数は頻度ではない。図 3 の (a₁,…,a₂₀) は模式図であり、普遍的な 20 ステップ地平線を確認するものではない。完全な行動インターフェース、パディング幅、総パラメータ数は未指定であり、「3B」はバックボーンを指し、モデル全体を指すわけではない。
インスピレーション:離散行動とエンボディド QA
問題: VLM はロボットとシーンの知識や、テキストと軌道の対応関係を欠いている。直感: エンボディド QA と離散デモコードの両方において、なじみのある系列予測を用いることで、共通の学習インターフェースを作る。
ページ 5 の方程式(記号の衝突を避けるために名称を変更):
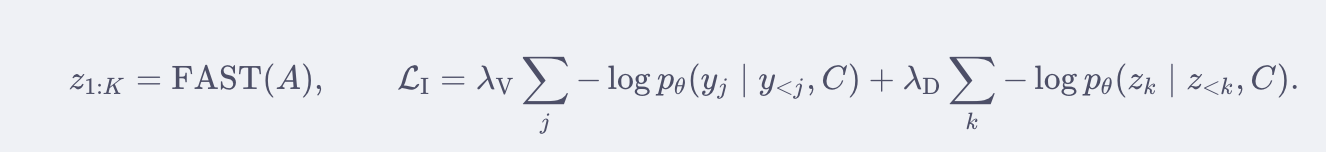
A∈ℝᵀˣᵈ は提示された軌道であり、C=(V,L) は視覚と指示を含む。yⱼ はテキストトークン j、zₖ は行動トークン k、<j/<k は既存のプレフィックスである。θ は VL 経路をパラメータ化し、pθ は次トークン確率である。λᵥ と λᴅ は単位を持たない重みである。K は符号化長であり、固定の報告値ではない。
FAST は効率的な行動トークナイゼーション手法である。図では離散コサイン変換 (DCT) → 量子化 → バイトペアエンコーディング (BPE) が示されている。説明: 軌道を時間領域から周波数係数へ変換し、それを量子化してトークンへ圧縮する。これは各関節角度に単純に単語を割り当てるわけではない。論文は FAST の設定、量子化精度、語彙サイズを報告しておらず、他論文のデフォルトを補完的に挿入してはならない。
最小例: 正しいテキスト/行動トークンがそれぞれ 0.8 と 0.5 の確率を受け取り、重みが 1 の場合、その損失は −ln(0.8)−ln(0.5)≈0.916 となる。これは配置誤差を直接測るのではなく、正しい系列を報いる。
正解の QA と FAST シーケンスが再利用された VLM 経路を教師付けし、この段階で推論、サブタスク、離散行動を出力できる。離散的な教師信号が事前分布を構築し、最終的な運用では連続生成へ移行し、必ずしも最初に FAST トークンを予測するとは限らない。
注意: テキストではマスクドモデリング、画像/動画のコントラスト学習、指示追従、時間的/因果的モデリングに言及しているが、方程式には明示的にテキストと離散行動項のみが示されている。他の損失、重み、スケジュールは完全には特定されていない。
統合:ノイズから連続行動を生成する
問題: 離散的な事前分布は意味を整合させるが、実行には連続値が必要である。直感: 行動にノイズを加える経路に沿った方向を学習し、その後ノイズから逆向きに積分する。これは flow matching である。
ページ 5 の方程式(方向を保ったまま進捗 τ に名称変更):
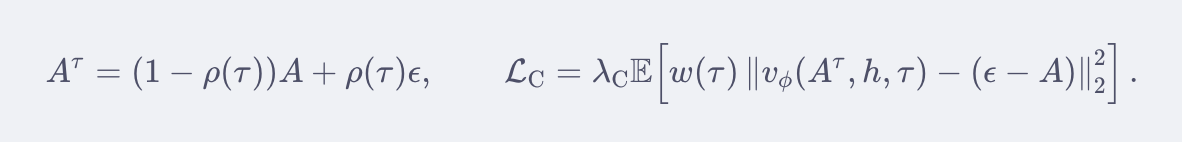
A はクリーンな行動、ε は同形状のガウスノイズ、A^τ はノイズが加わった T × d 配列である。h は VL エンコーディング、φ は連続経路のパラメータ、vφ は場である。τ は単位を持たない生成進捗、ρ はスケジュール、w は重み関数、λᴄ は損失重みである。期待値はデータ、ノイズ、時間にわたって取られる。場の「速度」は生成空間における方向であり、自動的にモータ速度を意味するわけではない。
最小例: 正規化単位において A=0.6, ε=−0.2, 例示的な線形 ρ(τ)=τ を τ=0.5 で用いると A^τ=0.2 となり、ターゲットは ε−A=−0.8 となる。−0.7 を予測すると、重み 1 のとき二乗誤差は 0.01 となる。物理単位にはデータセットのデコード規則が必要である。
方向が重要: この線形例では τ=0 がクリーン、τ=1 がノイズである。ロボット上でノイズ付加方向を実行するのではなく、1 から 0 に向かって積分することで生成する。
これは逆向きオイラー更新の説明用例であり、論文で指定されたソルバではない:
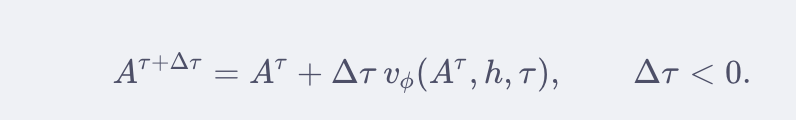
Δτ は単位を持たない。0.2 から開始し、方向 −0.8、Δτ=−0.1 とすると 0.28 となり、0.6 に近づく。配列全体が同時に更新され、1 回の内部更新が 1 ロボットステップに対応するわけではない。
注意: 一般の非線形 ρ では経路の導関数に ρ′(τ) が現れるが、論文では直接 ε−A と書かれている。この例は線形経路に限定されており、未公開のスケジュール、時間分布、ソルバ、反復回数を推定してはいけない。また、この方程式は図 3 のロボット状態を省略しているが、それは状態が存在しないことを意味しない。
2 つの主なステージと 2 つの統合フェーズ
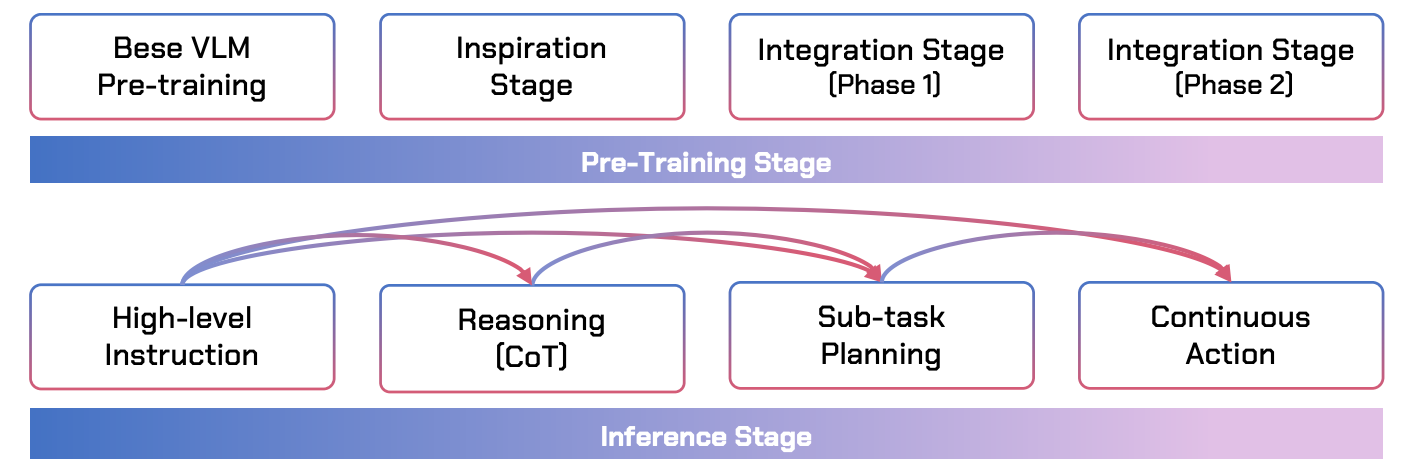
論文: 既存の VLM 事前学習の後、WALL-OSS は Inspiration と Integration を用いる。Integration には凍結フェーズと解凍フェーズがあり、元のバックボーン事前学習は新たに設計された第 3 のステージではない。
| ステージ | 教師信号/出力 | 更新 | 目的 |
|---|---|---|---|
| Inspiration | エンボディド VQA、テキスト/サブタスク/CoT、FAST トークン | VLM 経路を再利用/学習する。完全な凍結の詳細は未指定。 | ロボットとシーンの理解、および行動意味論。 |
| Integration フェーズ 1 | 連続 flow matching | VLM を凍結し、連続行動経路/フローヘッドを学習する。正確な境界は未指定。 | 新しい分岐に確立された事前分布を利用させる。 |
| Integration フェーズ 2 | 連続 flow matching とジョイント最適化 | VLM を解凍し、θ と φ を更新する。 | 視覚、言語、行動をさらに整合させる。 |
例: フェーズ 1 では行動誤差が連続分岐のみを更新し、フェーズ 2 ではバックボーンも更新できる。凍結は永続的な分離ではなく、解凍はそれまでの学習を破棄するものではない。
これらのステージは、独立したロボットモデルをつなぎ合わせるのではなく、表現、目的関数、学習可能パラメータを切り替える。セクション 4 はソースの混合とクォータを説明し、セクション 5 は下流の行動/VQA の混合を報告している。v1 は完全なレシピ、ステップ、目的関数の重みを提示しておらず、図 4 だけでは学習を再現できない。
Uni-CoT:完全な推論か直接実行か
問題: 類似した画像が異なる進捗を表すことがあり、別個のプランナーは制御から切り離されうる。直感: 1 つのモデルの中でレベルをまたぐ関係を学習し、中間推論を含まないサンプルも取り込むことで、複雑な振る舞いと直接的な振る舞いの両方をサポートする。
ページ 6 の目的関数(ノイズとの記号衝突を避けるため名称変更):
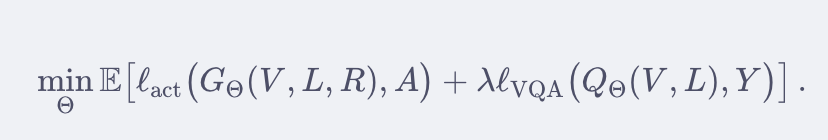
Θ は統一モデルのパラメータを含み、G は行動を予測し、Q はエンボディドな回答を予測する。V は視覚、L は指示、R は任意の推論、A∈ℝᵀˣᵈ は目標行動、Y は QA ラベル、λ は単位を持たないバランス係数である。行動損失はそのステージの目的関数に従い、VQA 損失は回答を評価する。G の内部ノイズ/時間条件付けはここでは抽象化されている。
著者らはこれを path-drop と呼んでいる:推論付きの完全パスと、R なしの直接パスの両方を学習する。例:「FIVE を綴れ」という 1 つのサンプルでは「F と I が存在し、次に V」といったものがあり、別のサンプルでは画像とタスクのみが与えられる。行動損失 0.2 と QA 損失 0.4 を λ=0.5 で重み付けすると 0.4 になる。ドロップ率、サンプリングアルゴリズム、および推論時の選択ルールは報告されていない。
長期ホライズンのファインチューニングでは、行動の前にサブタスクを生成する;色と言葉のタスクやスペリングタスクも CoT を用いる。論文はインタリーブについては述べているが、完全な推論呼び出しタイミング、非同期スケジューリング、コストについては説明していない。オプションの推論は、公表された難易度分類器を確立するものではない。
注意: エンドツーエンドの共有学習はアーキテクチャ上の主張である。結合損失は、行動の勾配がサンプリングされた離散テキストをどのように通過するかを示しておらず、したがって生成されたすべての単語を通じた微分を証明してはいない。これは共有された多目的学習を確立するものであり、すべての勾配の詳細を示すものではない。
完全な学習と推論
Training:
  Images + instructions + QA/process labels → VL path → text, reasoning, subtask supervision
  Inspiration: demonstrations → FAST → discrete next-token loss
  Integration: actions + noise + progress → noisy actions
               VL context + state + noisy actions → continuous path → field loss
               freeze VLM first, then unfreeze for joint updates
  Uni-CoT: learn cross-level mappings with and without intermediate reasoning

Inference:
  Current images + task → VL representation
  Generate or skip CoT/subtasks according to the task path; use generated text as context
  VL context + state + fresh noise → continuous field → integration → trajectory
  Decode to the platform interface and execute; later observations condition the next decision
説明: アーキテクチャは情報を接続し、離散ステージは事前分布を確立し、連続ステージは値を生成し、Uni-CoT は目標と進捗を結び付ける。実行長とオーバーラップのブレンディングは未指定である。ACT の時間アンサンブルや CVAE を WALL-OSS のメカニズムに追加してはならない。
データとプラットフォーム:理解と実行
3 つのソース
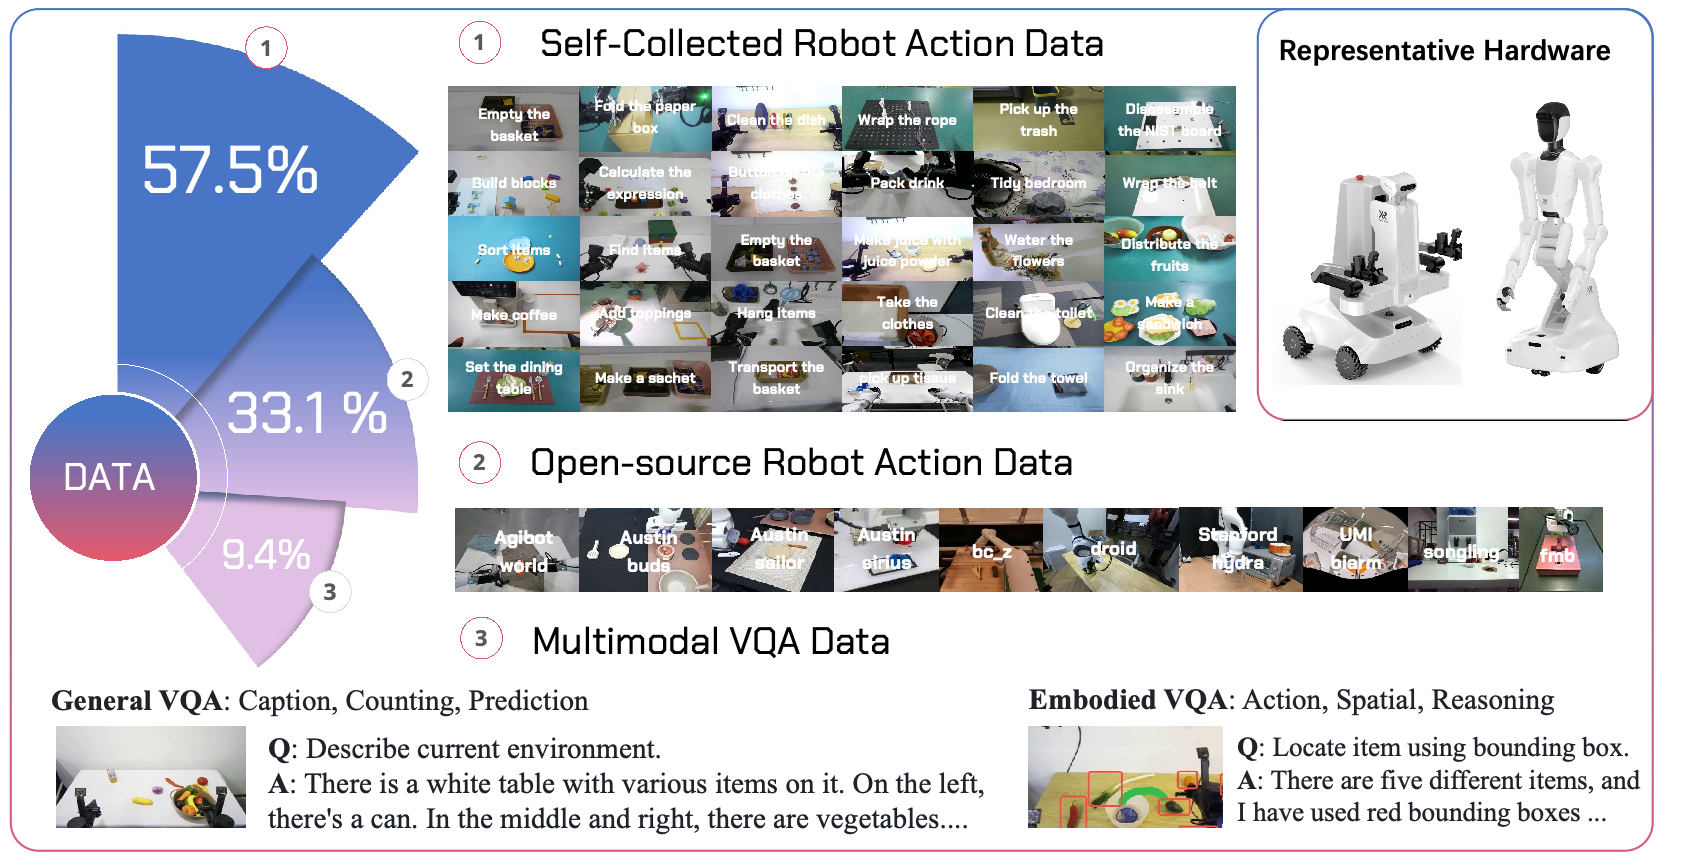
| ソース | 図 5 の構成比 | 内容と役割 |
|---|---|---|
| 内部ロボット行動 | 57.5% | 日常的なマニピュレーション、複雑な軌道、およびプロセスラベル。キッチン、衣類/収納、モバイルなピックアンドプレース、組み立てを含む。 |
| オープンロボット行動 | 33.1% | DROID、BC-Z、BridgeData V2 など。多様なプラットフォーム、シーン、スタイル。完全な一覧は表 1。 |
| マルチモーダル VQA | 9.4% | 一般的な QA により画像と言語のスキルを維持し、エンボディド QA により空間、時間、進捗、アフォーダンスを追加する。 |
注意: 構成比は合計 100% だが、その分母(時間、サンプル数、あるいはミキシング重み)が不明なため、時間数は推定されていない。セクション 4 ではまず 10,000 時間超と述べ、4.4 では数万時間超と述べている。v1 にはこれを解決する統一的な内訳がない。
内部データには、精度/汎化を重視した短い明示的指示タスクと、分解と進捗追跡を要する暗黙的ステップを含む長いタスクが含まれる。アノテーションはモデルと人手チェックを組み合わせて行う。品質管理には、同期タイムスタンプ、外れ値/アイドル/低品質のフィルタリング、ルール/手動レビュー、照明/背景の拡張が含まれる。
エンボディド VQA は、プランニング、空間/時間的推論、属性、認知、アフォーダンスをカバーする。ラベルにはボックス、ポイント、オプションのマスク、自然言語 QA が含まれる。<point>[x,y]</point> は 3D 把持ターゲットではなく 2D 画像上の位置であり、座標の正規化は一貫して指定されていない。
クロスプラットフォーム整合と欠落情報
論文: ソースには、テーブルトップアーム、モバイルマウント、車輪型両腕ロボットおよびヒューマノイドロボットが含まれ、エゴ視点/外部視点/アーム視点を持つ。位置はメートル、角度はラジアンで表現される。最大自由度テンプレートにマスク/プレースホルダを用いて欠損関節を扱い、カメラキャリブレーション、タイムスタンプ、チャネル、アクショングリッドを整合させる。
説明: 共通インターフェースがあっても、自由度が同一になるわけでも、ポリシーが適応なしに相互に置き換え可能になるわけでもない。パディングは物理的制御として実行してはならない。
v1 は、完全なプラットフォームモデル、カメラ台数/解像度、制御/収集レート、統一された次元、タスク継続時間、GPU 構成、バッチサイズ、学習率、各ステージのステップ数を報告していない。ハードウェア写真からそれらの仕様を補うことはできない。
著者らは、シーン、物体、タスク、エンボディメントごとの層化された検証/テスト分割を説明しており、長い/まれなスキルのオーバーサンプリングとクォータ混合を行っている。完全な件数、サンプリング温度、重複排除は未公表であり、厳密な再現性を制限している。
実験:理解、推論、行動
タスク、ファインチューニング、および評価条件
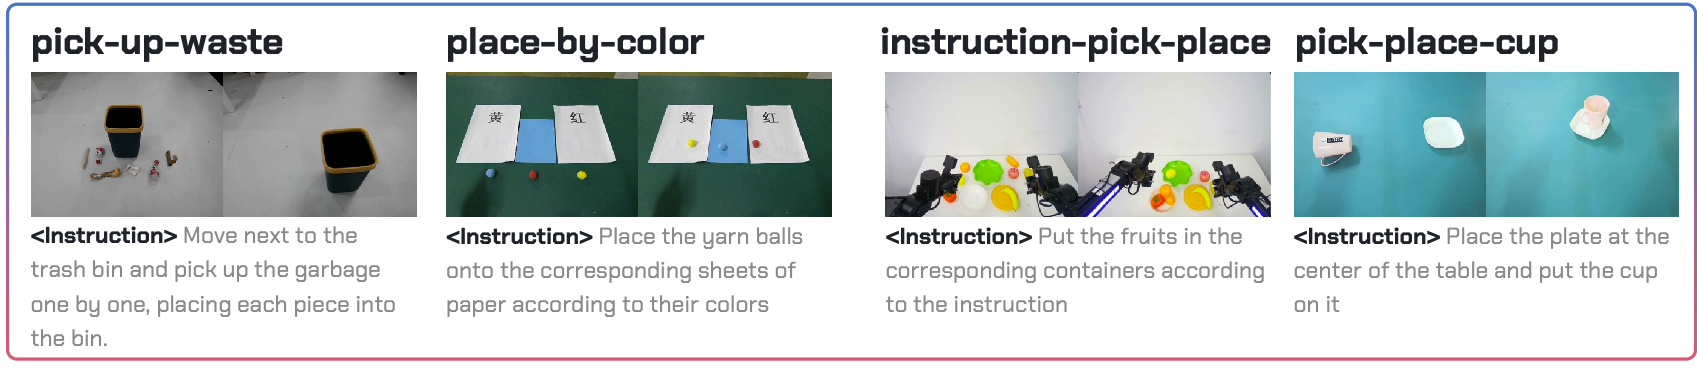
| タスク | 主なテスト | 5.1.1 におけるデモ数 | 事前学習/ファインチューニングの境界 |
|---|---|---|---|
| Instruction-Pick-Place | 言語から物体と目的地を選択。 | タスクのファインチューニングなし | ロボット事前学習後のゼロショットタスク評価。 |
| Place-by-Color | 色または色名の直接マッチング。 | 500 エピソード | 事前学習には含まれていないと記載。 |
| Block-Spell | 単語を認識/計算し、文字を配置。 | 1,600 エピソード | タスクのファインチューニングであり、ゼロショットスペリングではない。 |
| Set-Table | 2 人分の皿、ナイフ、フォークを配置。 | 1,500 エピソード | 事前学習には含まれていないと記載され、その後ファインチューニング。 |
| Tidy-Bedroom | 衣類を集め、枕を整える。 | 1,000 エピソード | 事前学習には含まれていないと記載され、その後ファインチューニング。 |
| Collect-Waste | ゴミ箱へ移動し、拾って廃棄。 | 900 エピソード | 結果セクションでは代わりに 1,000 デモと述べている。 |
| Pick-Place-Cup | カップ/皿の構成を調整して配置。 | 500 エピソード | 逆さカップ、取っ手の向き、皿位置のバリエーション。 |
注意: セクション 5.1 では 6 つのマニピュレーションタスクと述べている一方で、5.1.1 と図 6 では 7 つを列挙している。図 7 は 6 つのファインチューニング済みタスクを要約しており、ゼロショットの指示追従は本文中で別扱いになっている。事前学習で未観測であることは、ファインチューニングでも未観測であることを意味せず、ゴミタスクの件数の矛盾は解消されていない。
ベースラインは π0 と Diffusion Policy (DP) である。フラット学習は高レベル指示を直接行動に写像し、GPT4-Subtask はアノテーションされたサブタスクで学習し、推論時に GPT-4 を呼び出す。フラットな Block-Spell の進捗はほぼゼロであるため、図 7 では GPT-サブタスクのベースラインを用いている。棒グラフはすべて同一の指示設定を共有しているわけではない。
著者らはタスク監督が等しいと述べているが、WALL-OSS はさらに VQA を共同学習している:サブタスク以外の QA サンプリングは 1:15、サブタスクは 1:100 と記載されている。単位と比率の順序が不十分なため、フレーム比率を推定できない。タスク監督が等しいことは、全体のデータ量や計算量が同一であることを意味しない。
独立した第三者が、環境、初期状態、スコアリング文書を用いてブラインド評価を行い、VQA は手動で判定される。試行回数、完全なスコアリングルール、誤差バー、信頼区間は完全には公開されていない。ブラインドテストはバイアスを減らすが、統計に取って代わるものではない。
エンボディド VQA:グラウンディングで最大の向上
表 2、11 ページ:
| カテゴリ | Qwen2.5-VL-3B | WALL-OSS | パーセンテージポイントの増加 |
|---|---|---|---|
| 物体グラウンディング | 46.1% | 91.6% | +45.5 |
| シーンキャプション | 57.7% | 87.6% | +29.9 |
| 行動プランニング | 59.8% | 69.0% | +9.2 |
解釈: 最大の改善は、物体の位置特定とロボットシーンの記述に見られる。プランニングの改善は小さく、どちらのモデルも進捗を誤判断しうる。この表はエンボディドな理解を支持するものであり、一般 QA の完全な保持や 91.6% の把持成功率を示すものではない。
ゼロショット指示:進捗は成功率ではない
11–12 ページ: タスクファインチューニングなしでは、Instruction-Pick-Place の平均進捗は、既知の物体/コンテナ指示で 85%、新しい物体で 61% となる。著者らは、多くの失敗を、誤った意味的ターゲットの選択ではなく、小さな姿勢誤差に起因するとしている。
注意: ゼロショットとは、タスク固有のファインチューニングを除外することであり、ロボット/マルチモーダル事前学習を除外することではない。これらは完全成功の割合ではなく、平均進捗スコアである。図 7 は本文で引用されているにもかかわらず、この 2 つのグループを別々には示しておらず、したがって数値は文章に帰属される。
精度と長期ホライズン:タスク依存の向上
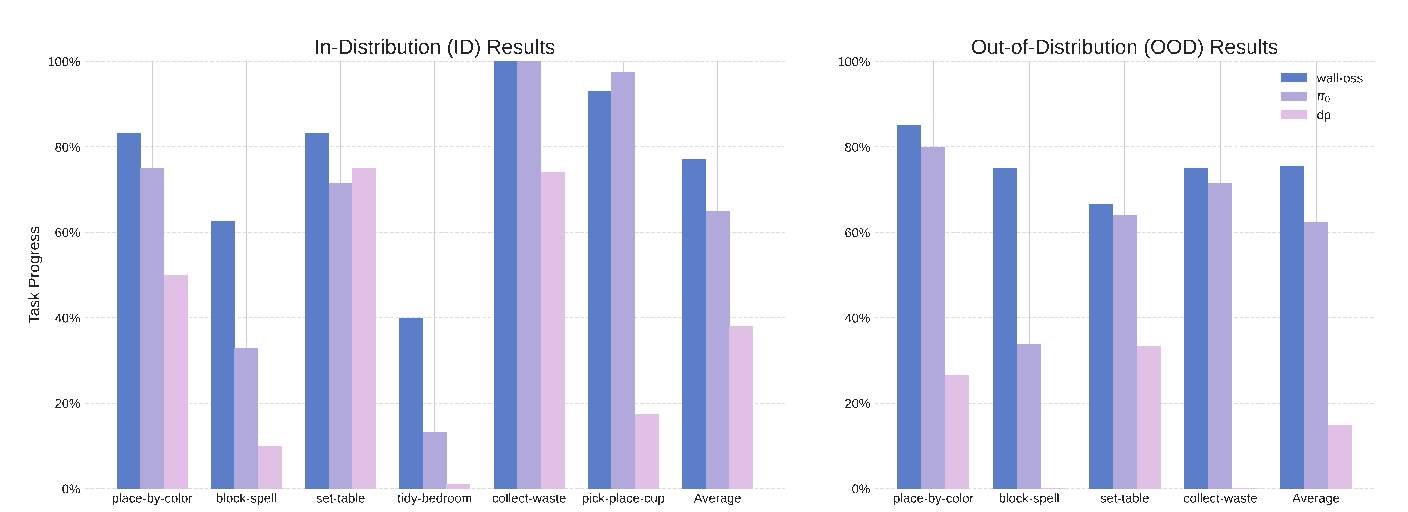
図の解釈: WALL-OSS は、スペリング、テーブルセッティング、寝室の片付けにおいて、示されたベースラインを上回る。ID のゴミタスクの棒と π0 はどちらも上限に達しており、カップ配置では π0 の方が高い。棒グラフの正確な値は印字されておらず、視覚的にも推定していない。
12 ページの成功率報告: ID のゴミ収集は、WALL-OSS と π0 が 100%、DP が 80%。カップ配置は、両方の事前学習済みモデルで 90% 超、DP は 20% 未満である。新しいゴミシーンでは、DP は 80% からゼロに落ちる一方、両方の事前学習済みモデルは 80% 超を維持すると報告されている。
注意: 文章中の成功率と図 7 のタスク進捗はラベルが異なり、直接置き換え可能ではない。図中では、DP の ID ゴミ進捗と WALL-OSS の OOD ゴミ進捗は、おおよそ 4 分の 3 に見える。v1 はその関係を説明しておらず、結合された平均成功率は推定していない。
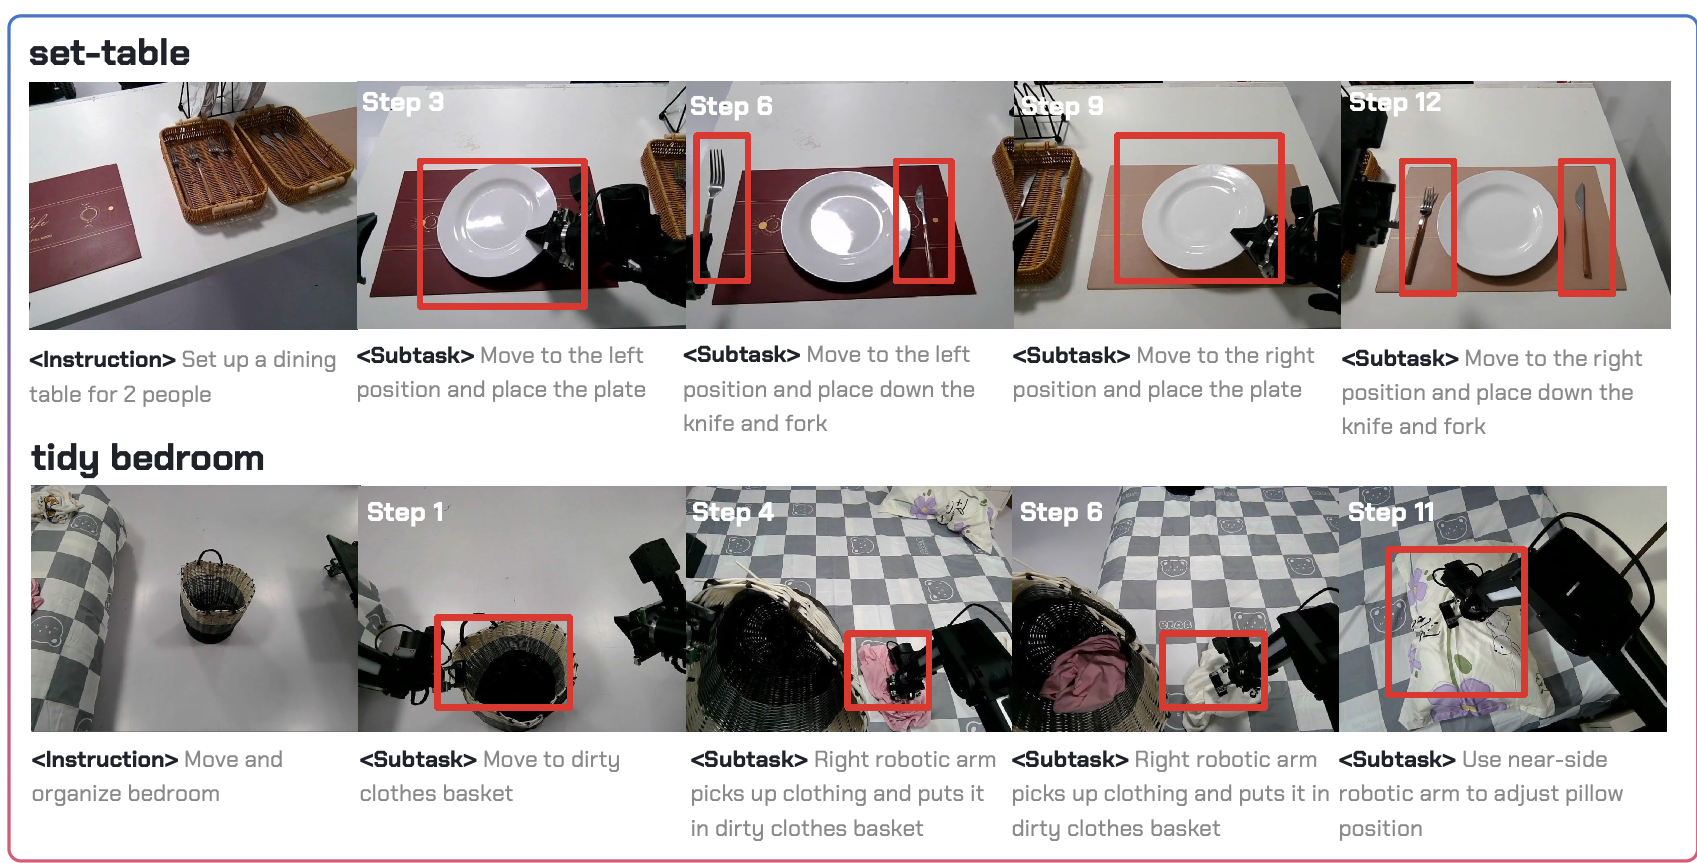
論文: テーブルセッティングと寝室の片付けは5ステージを超え、平均所要時間はそれぞれ3分と5分を超えています。ファインチューニングではアクション/サブタスクを結合しており、長時間タスクの学習データのうちサブタスクにラベル付けされているのはわずか1%です。推論時には行動する前にサブタスクを生成します。ベースラインは食器を繰り返し置いたり、もう一方のテーブルセッティングを見落としたり、衣類が視界から外れるとループしたりします。
解釈: これらの観察結果は、明示的な進捗とサブタスクの有効性を支持しています。3分/5分は推論レイテンシではなくタスクの所要時間です。事前学習モデルがDPを上回っていることは、この設定における事前学習の有効性を示しますが、初期化、サイズ、アーキテクチャも異なっています。
推論と共同学習:きめ細かな指示
CoT は直接的な視覚的色マッチングにはほとんど寄与しませんが、色名が書かれた紙の上にボールを置く場合には役立ちます。Block-Spell はまず答えを認識または計算し、その後で文字を配置します。13ページには、学習フレームの1%が CoT/サブインストラクションを教師ありしていると記載されています。これは長時間タスクにおける「学習データの1%」とは単位が異なり、エピソードの1%として書き換えられてはいません。
表3(14ページ):指示された文字/数字ブロックを選択する精度。
| ブロック種別 | WALL-OSS マルチモーダル共同学習 | WALL-OSS アクションのみ | π0 アクションのみ |
|---|---|---|---|
| 文字 | 87% | 26% | 9% |
| 数字 | 95% | 80% | 35% |
マルチモーダル・ファインチューニングは、アクション、CoT/サブタスク、および2Dグラウンディングを組み合わせています。アクションのみの WALL-OSS はサブタスクから制御を学習します。これは下流のファインチューニングを変化させますが、すべてのマルチモーダル事前学習を取り除くわけではありません。
解釈: WALL-OSS 内では、文字の精度は 87−26=61 ポイント、数字の精度は 95−80=15 ポイント向上しており、精密なターゲットに対するマルチモーダルな教師ありを継続することを支持しています。複数の目的が同時に変化するため、グラウンディング、CoT、サブタスクは個別には切り離されていません。指標は単語全体の綴り成功ではなく、ターゲット選択の精度です。
結論と境界
主な教訓: 後付けでアクションヘッドを取り付けるのではなく、身体性を伴う理解を加え、離散から連続への学習を通じてセマンティックな事前知識を構築し、目標、推論、進捗、実行を1つのモデルの中で結び付けることです。グラウンディングと精密ターゲット選択には明確な定量的裏付けがあり、推論と長時間タスクも比較対象のベースラインより改善しています。
次の境界を守ってください:
-
精度で一様に最良というわけではない。 セクション6.1では、細かなマニピュレーションにおいては π0 の方が依然として優れていることが認められており、全体としての主張があらゆる指標で一位であると解釈されてはなりません。
-
すべてのコンポーネントが分離されているわけではない。 表3はマルチモーダル・ファインチューニングを組み合わせた効果を支持していますが、v1 には Inspiration、静的ルーティング、path-drop について完全に独立したアブレーションがありません。
-
統計と再現性の詳細は限定的。 タスク数、所要時間、デモ数、指標がまちまちであり、試行回数や信頼区間は不完全です。そうした不一致は、推測で埋め合わされるのではなく、明示的に指摘されています。
-
リアルタイム性と広範な転移には検証が必要。 非同期性とクロスプラットフォーム学習については説明されていますが、レイテンシ、レート、インターフェース、転移テストが完全ではないため、特定ハードウェアでのタイミングや、適応不要の転移は保証されません。
-
3D と動画は今後の方向性にとどまる。 予測フレーム、3D 知覚、世界モデル化は提案されているものの、現時点の WALL-OSS の構成要素や、一般的な Physical AI の解決策として実証されているわけではありません。
製品固有の転移設定は追加されていません。別のロボットには、この論文の結果とは切り離して、独自のカメラ/状態インターフェース、単位、寸法、制御サイクル、安全な実行設定が必要です。