16.1 3つの重要な設定:バッチサイズ、学習率、ステップ数
16.1 3つの重要な設定:バッチサイズ、学習率、ステップ数
ターミナルで nvidia-smi を実行して GPU と VRAM を確認します。コンシューマ向け GPU(例:3050)でも学習は可能です。
バッチサイズ
VRAM に余裕があれば、収束を速めるためにバッチサイズを増やして構いませんが、利用可能な VRAM を超えて無理に増やさないでください。
| 設定 | シナリオ |
|---|---|
| VRAM 8 GB 以下 | 学習可能。小さいバッチサイズを使用:8 GB → バッチサイズ 4、4 GB → バッチサイズ 2。 |
| VRAM 12 GB 以上 | 余裕ゾーン。デフォルトのバッチサイズを使用。VRAM が大きい場合はバッチサイズ=16 に設定 |
| 統合 GPU のみ / NVIDIA GPU なし | クラウドサーバーで学習 |
学習率(Learning Rate)
各更新ごとの「一歩の大きさ」です。ACT にはプリセットが用意されています:AdamW オプティマイザ、学習率 1e-5、weight decay 1e-4、ビジュアルバックボーンは 1e-5。ポリシーのプリセットはデフォルトで有効(use_policy_training_preset)なので、これらの値は自動的に適用され、何も記述する必要はありません。ステップが大きすぎると loss が振動したり発散したりし、小さすぎると学習時間が 2 倍になります。最初の学習では触らないでください — 元論文と豊富な実践からチューニングされた値です。
- バッチサイズやステップ数を変更しても、学習率を調整する必要はありません。
- 学習済みチェックポイントからのファインチューニング/再開の場合は、学習率を
1e-6〜3e-6(3〜10倍小さく)に下げます。 - 学習 loss がほとんど下がらず(横ばい)、それでも LR を上げる前に、まずステップ数/データを増やしてから
2e-5を試してください。
次のコードを追加し、両方を同じ値にそろえて変更します:
--policy.optimizer_lr=1e-6 \
--policy.optimizer_lr_backbone=1e-6
学習ステップ数(Training Steps)
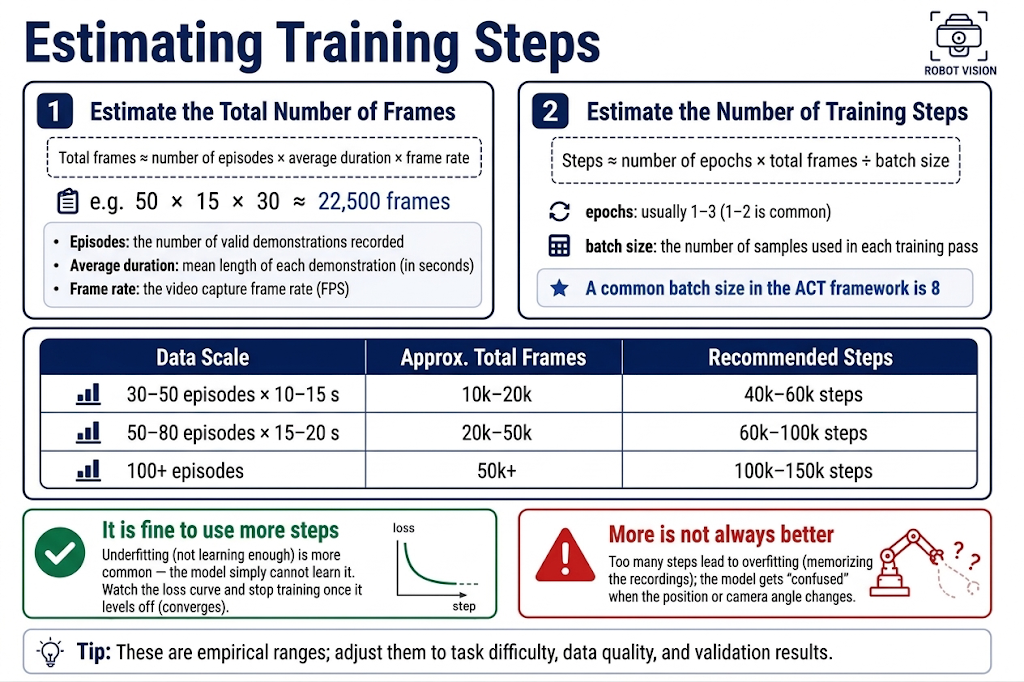
50 エピソードの場合、以下のステップ数の説明を読みたくなければ、80,000(50 エピソード)でそのまま実行して構いません。
ステップ数は比例してスケールします:バッチサイズが半分になると、1 ステップあたりに見るサンプル数も半分になります。同じ回数(エポック数)だけモデルにデータを見せるには、ステップ数を 2 倍にする必要があります。例:デフォルトはバッチサイズ=8、ステップ数=80000;バッチサイズ=4 → ステップ数=160000;バッチサイズ=2 → ステップ数×4;バッチサイズ=16 → ステップ数÷2。
ステップ数を多めに設定しても構いません。学習中はいつでも Ctrl+C で停止でき、loss などの指標を見て止めるかどうかを判断できます。これまでに生成されたモデルは自動的に保存されます。
- 総フレーム数 ≈ 収録した動画の総長さ。
- epoch(1 周) = 生徒が録画を最初から最後まで 1 回通して見ること。
- steps = 生徒が合計で何個の区間を見たか。
16.2 チェックポイントの保存と管理
16.2 チェックポイントの保存と管理
手動で保存する必要はありません:20,000 ステップごとに(save_freq)チェックポイントが保存され、最後に最終チェックポイントも保存されます。そのため、ステップ数を大きく設定しても問題ありません。途中のステップ数のモデルを選び、学習不足または過学習のものは捨てることができます。
outputs/train/act_grab_cube_v1/
├── train_config.json              ← Full config for this run (needed to resume)
└── checkpoints/
    ├── 0020000/pretrained_model/  ← Model archive at each step count
    ├── 0040000/pretrained_model/
    ├── ...
    └── last/pretrained_model/     ← Last checkpoint, used in Chapter 17
- ディスク使用量: 各チェックポイントは完全なモデル重みファイルであり、数十個たまると容量を消費します。学習が安定してきたら、初期/中期のチェックポイントは削除し、
lastだけ残して構いません。 - 推論時には、
--policy.pathをcheckpoints/last/pretrained_modelに指定します。
16.3 学習を開始する
16.3 学習を開始する
すべてのチェックが完了したら、学習を開始します(conda の lerobot 環境内):
lerobot-train \
    --dataset.repo_id=seeed_rebot_b601_rs/test \
    --policy.type=act \
    --output_dir=outputs/train/act_rebot_test \
    --job_name=act_rebot_test \
    --policy.device=cuda \
    --wandb.enable=false \
    --policy.push_to_hub=false \
    --steps=100000
RTX 50 シリーズ GPU を使用する場合は、--dataset.video_backend=pyav を追加して、torchvision preview での API 欠如による問題を回避してください。
VRAM が不足している場合や、一度により多く設定したい場合は、--batch_size を追加してバッチサイズを指定します。
パラメータの補足:
| パラメータ | 意味 |
|---|---|
--dataset.repo_id | 第13章で作成したデータセット名(ローカル名をそのまま使用。Hub の場合は ${HF_USER}/xxx) |
--policy.type=act | ポリシーの種類。diffusion や smolvla なども使用可能。このステージでは ACT を使用 |
--output_dir | すべての学習出力を保存するディレクトリ |
--job_name | この実行の名前。ログ内で実行を区別するために使用 |
--policy.device=cuda | GPU で学習 |
--wandb.enable=false | wandb のオンラインダッシュボードを無効化(必要なら登録して有効化可能。必須ではない) |
--policy.push_to_hub=false | まだ Hub にアップロードしない。第17章で評価が十分になってから実施 |
--steps | 学習ステップ数 |
--batch_size | バッチサイズ |
時間の目安:コンシューマ向け GPU で 100k ステップの場合、GPU やバッチサイズにもよりますが、通常は数時間程度かかります。
16.4 Loss と GPU 状態のモニタリング
16.4 Loss と GPU 状態のモニタリング
Enter キーを押すと、ターミナルに学習ログが流れ始めます。LeRobot は 200 ステップごとに(--log_freq で制御)サマリー行を出力し、次のような形式になります:
step: 10000 smpl: 80K ep: 35.6 loss: 1.832 grdn: 12.4 lr: 1.0e-05 updt_s: 0.21 data_s: 0.003 eta: 3:42:10
各フィールドごとに説明します(フィールド名はバージョンによって多少異なる場合があります):
| フィールド | 意味 | 注目ポイント |
|---|---|---|
step | 現在のステップ数 | --steps と比較して進捗を確認 |
ep | 学習済みエポック数 | 「録画を何回見たか」に対応 |
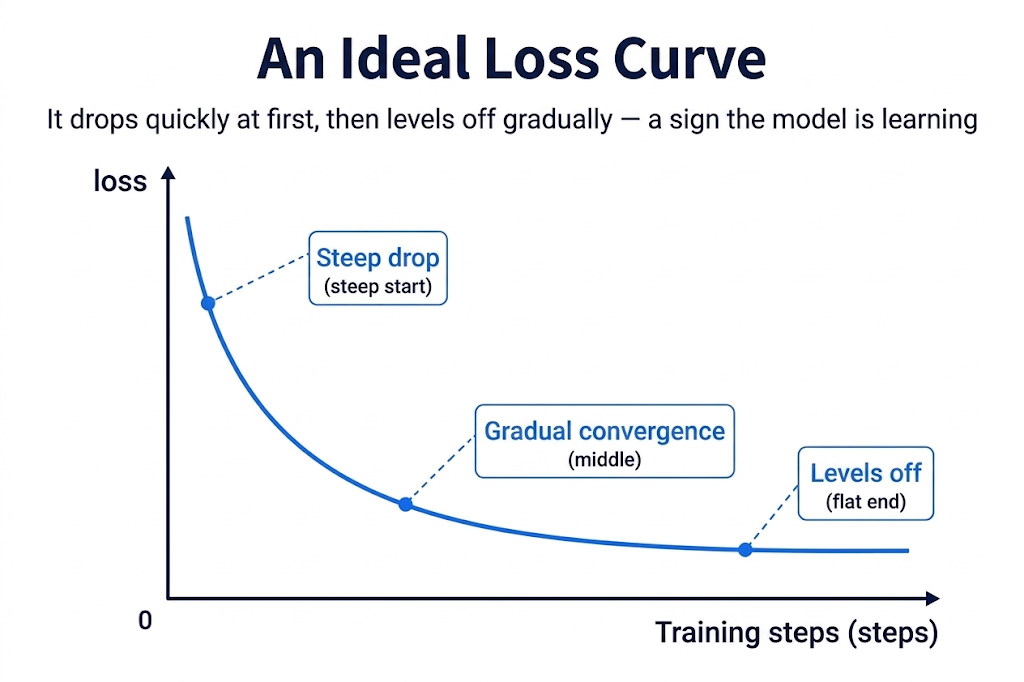
loss | 学習 loss | 序盤は急激に下がり、その後はゆるやかに下がり、後半は小さく揺れながら低い水準で横ばいになるのが正常 |
grdn | 勾配ノルム | 突然数百〜数千に跳ね上がると学習が不安定な兆候 |
lr | 現在の学習率 | 期待した値になっているか確認 |
updt_s / data_s | 1 ステップあたりの更新/データ読み込み時間 | data_s が大きい場合はデータ読み込みがボトルネック |
eta | 残り時間の推定値 | ご飯や睡眠に行くかどうかの判断材料 |
これらの指標の正常な傾向を、3 つのカテゴリに分けて説明します:
- 下がり続けるべきもの —
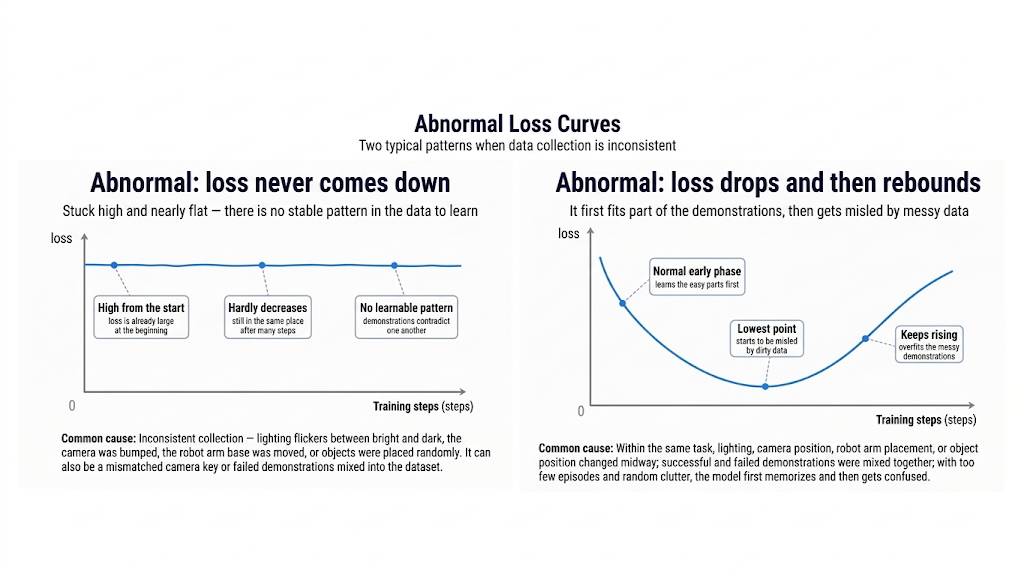
loss。 低下には 3 つのフェーズがあります:序盤の急激な低下、中盤のゆるやかな低下、後半の低い水準での小さな変動と全体としての横ばい。この「最初は速く、その後ゆっくり、最後は平坦」というカーブが健全な収束カーブです。注意すべき異常な形は 2 つ:まったく下がらない(データ/設定の問題 — カメラキーなどを確認)、下がったあとに跳ね返って上がる(学習の発散 — LR を半分にして再学習)。 - 全体として収束しつつ揺らぎが許容範囲に収まるべきもの —
grdn(勾配ノルム)。 全体の傾向は loss とともに下がって安定しますが、スパイク自体は正常です。たまにスパイクしてすぐ戻るのは問題ありませんが、波が来るたびにどんどん大きくなるような連続的な増幅は危険で、発散の前兆です。その場合は上記と同様に LR を下げて対処します。 - 一定であるべきもの —
lr、updt_s、data_s、GPU 使用率。lrは設定した値のまま推移し、確認用です。1 ステップあたりの時間(updt_s/data_s)と、watch -n 1 nvidia-smiで見る GPU 使用率はいずれも安定しているべきです。使用率が常に低い、または大きく変動する場合は、GPU がデータ待ちになっており、ボトルネックは GPU ではなくデータ読み込みです。
16.5 中断した学習を再開する
16.5 中断した学習を再開する
学習中に電源やネットワーク、ターミナルが途中で切れても、最初からやり直す必要はありません。少なくとも 1 つチェックポイントが保存されていれば(つまり 20,000 ステップを超えて学習が進んでいれば)再開できます:
lerobot-train \
    --config_path=outputs/train/act_rebot_test/train_config.json \
    --resume=true
- 再開時は保存済み設定を使用: 再開学習では
train_config.jsonに保存された設定が使われ、コマンドラインパラメータは無視されます。パラメータ(ステップ数やバッチサイズなど)を変更したい場合は、新しい実行を開始し、resume は使わないでください。 - 最新のチェックポイントから継続: オプティマイザの状態とステップ数が復元され、loss カーブは途切れずに続きます。