18. マルチモーダル学習と VLA の基礎
Seeed Physical AI Beginner's Course の第18章 — vision/language/action、 VLM と VLA の違い、ACT と VLA の違い、言語条件付きタスク、単一タスク vs マルチタスク vs 汎化、連続アクション vs アクショントークン、そして VLA の能力と限界について解説します。
このステージで必要なハードウェア
このステージのために準備するものです。各ステージの完全な一覧は 第3章 にあります。
メイン制御ユニット
| 品目 | 購入 | 数量 |
|---|---|---|
| reComputer Robotics J4012 | 🛒 | 1 |
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
デスクトップまたはノート PC も必要です:Ubuntu 22.04、GTX 4080 以上で 12GB 以上の VRAM、16GB 以上の RAM。
このステージ用
| 品目 | 購入 | 数量 |
|---|---|---|
| reBot Arm B601 DM/RS | 🛒 | 1 |
| reBot Arm 102 Leader Arm | 🛒 | 1 |
| 720P Monocular Wrist Camera | 🛒 | 2 |
| Wrist Camera Mount | 🛒 | 1 |
| Hikvision Camera Overhead Mount | 🛒 | 1 |
前の章では、reBot Arm 上で ACT (Action Chunking with Transformers) のようなポリシーを使い、「画像を見て関節アクションを出力する」模倣学習を行いました。このような手法は通常、単一タスク 用に学習されます。つまり、モデルは「赤いキューブを箱に入れる」という 1 つの行動だけを学習し、タスクを切り替えるにはデータを取り直して再学習する必要があります。
本章では、VLA (Vision-Language-Action) の中核となる考え方を紹介します。ロボットが単に「見る」だけでなく、自然言語の指示を「理解」し、複数のタスク間で 1 つのポリシーネットワークを共有できるようにするというものです。
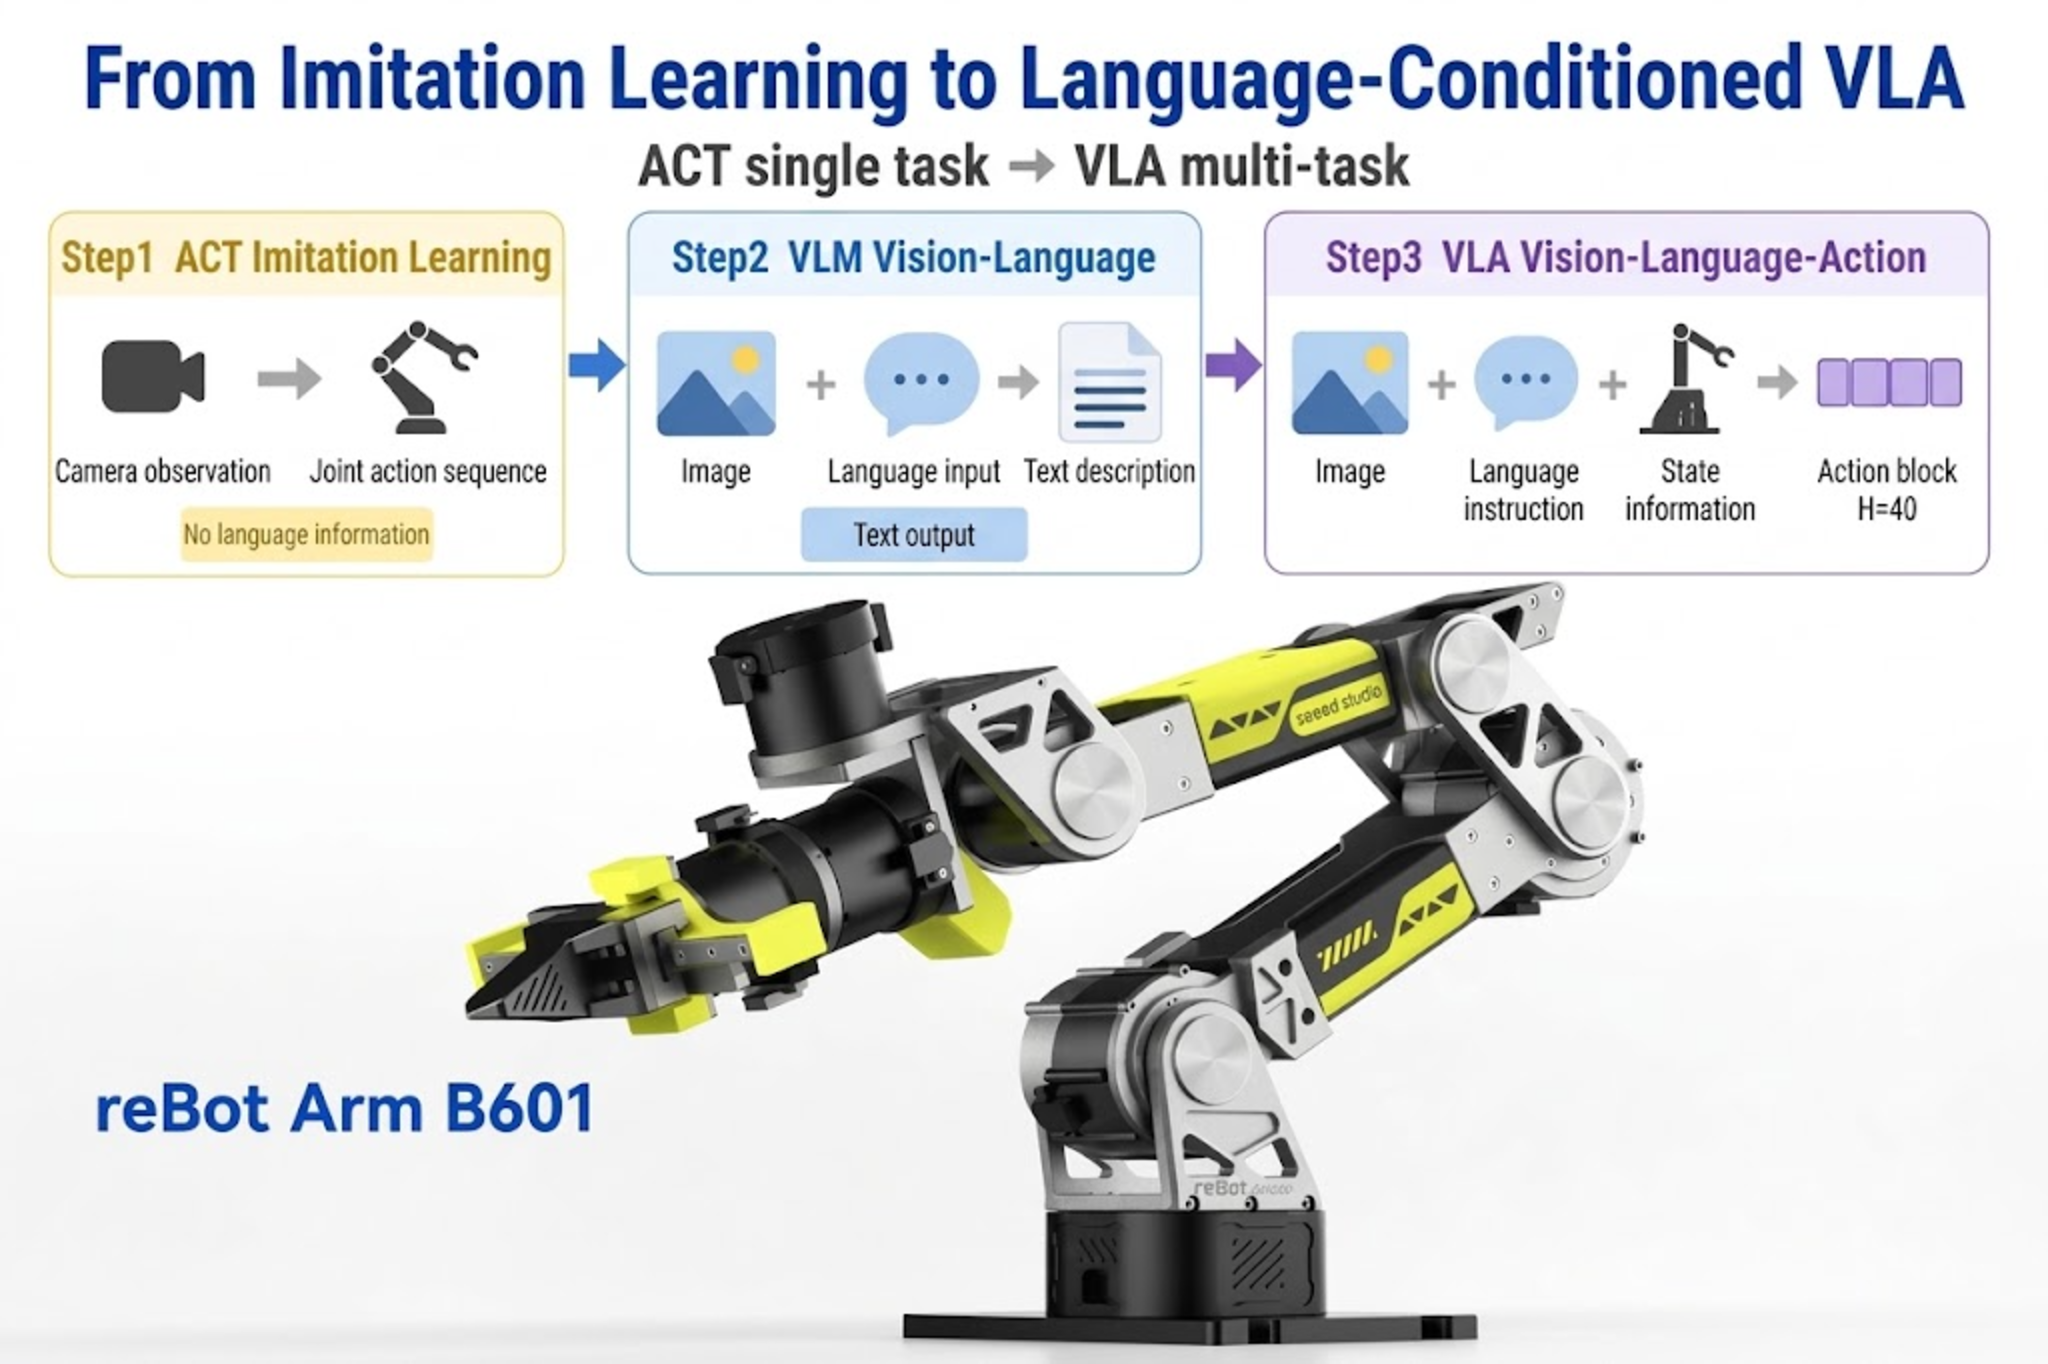
18.1 マルチモーダルモデル
18.1 マルチモーダルモデルとは?
マルチモーダルモデルは、画像、テキスト、ロボットの状態といった複数種類の情報を 1 つの統一された判断に融合します。VLA の文脈では、以下の 3 つのモダリティを組み合わせてロボットアクションへとデコードします。
18.2 Vision、Language、Action
18.2 Vision、Language、Action
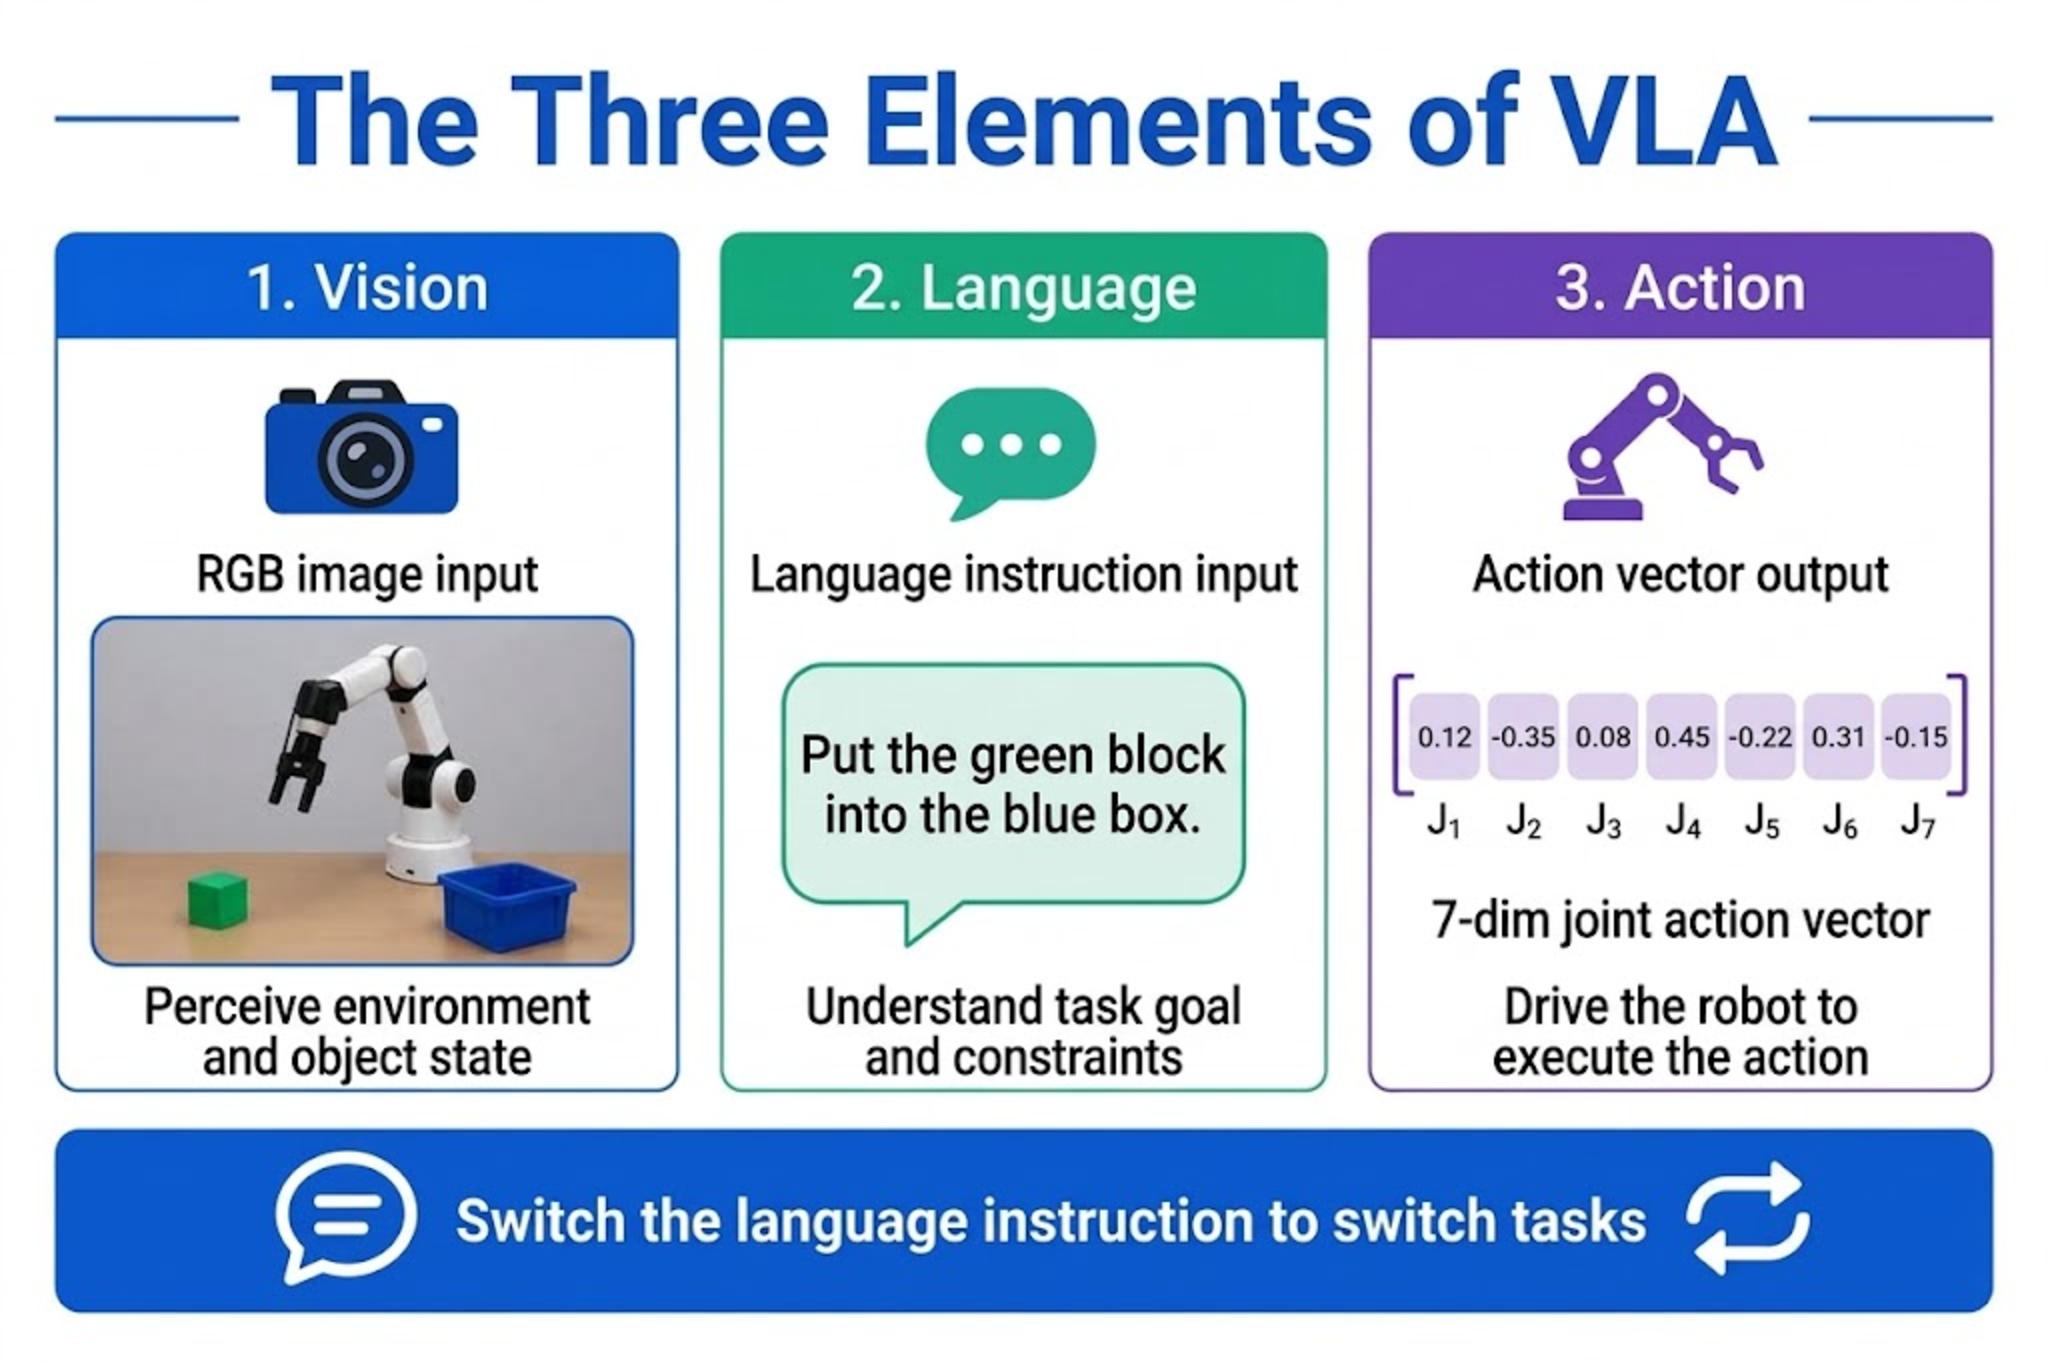
VLA フレームワークでは、3 つのモダリティにはそれぞれ明確な役割分担があります:
| モダリティ | 意味 | reBot Arm における典型的なソース |
|---|---|---|
| Vision | 外部カメラや手首カメラで取得した RGB 画像 | 前方カメラ、手首の RealSense / USB カメラ |
| Language | タスクの自然言語による記述 | 「ドライバーを工具箱に入れて」 |
| Action | ロボットが実行すべき制御コマンド | 各関節の目標角度、グリッパの開閉幅 |
State は通常、Action とペアで現れます。State は「ロボットが今どこにいるか」を表し、Action は「次にどこへ行くか」を表します。LeRobot のデータセットでは、observation.state と action フィールドに保存され、GR00T ではさらに meta/modality.json によって single_arm や gripper といったサブキーに分割されます。
VLA と純粋な Vision ポリシーとの大きな違いは、言語が条件変数になる ことです。学習時には、各デモ軌道がタスク記述と結び付けられます。推論時には、(データのカバー範囲内であれば)ユーザーはモデルの重みを変えずに、指示テキストを変えるだけで動作を切り替えられます。
18.3 VLM と VLA の違い
18.3 VLM と VLA の違い
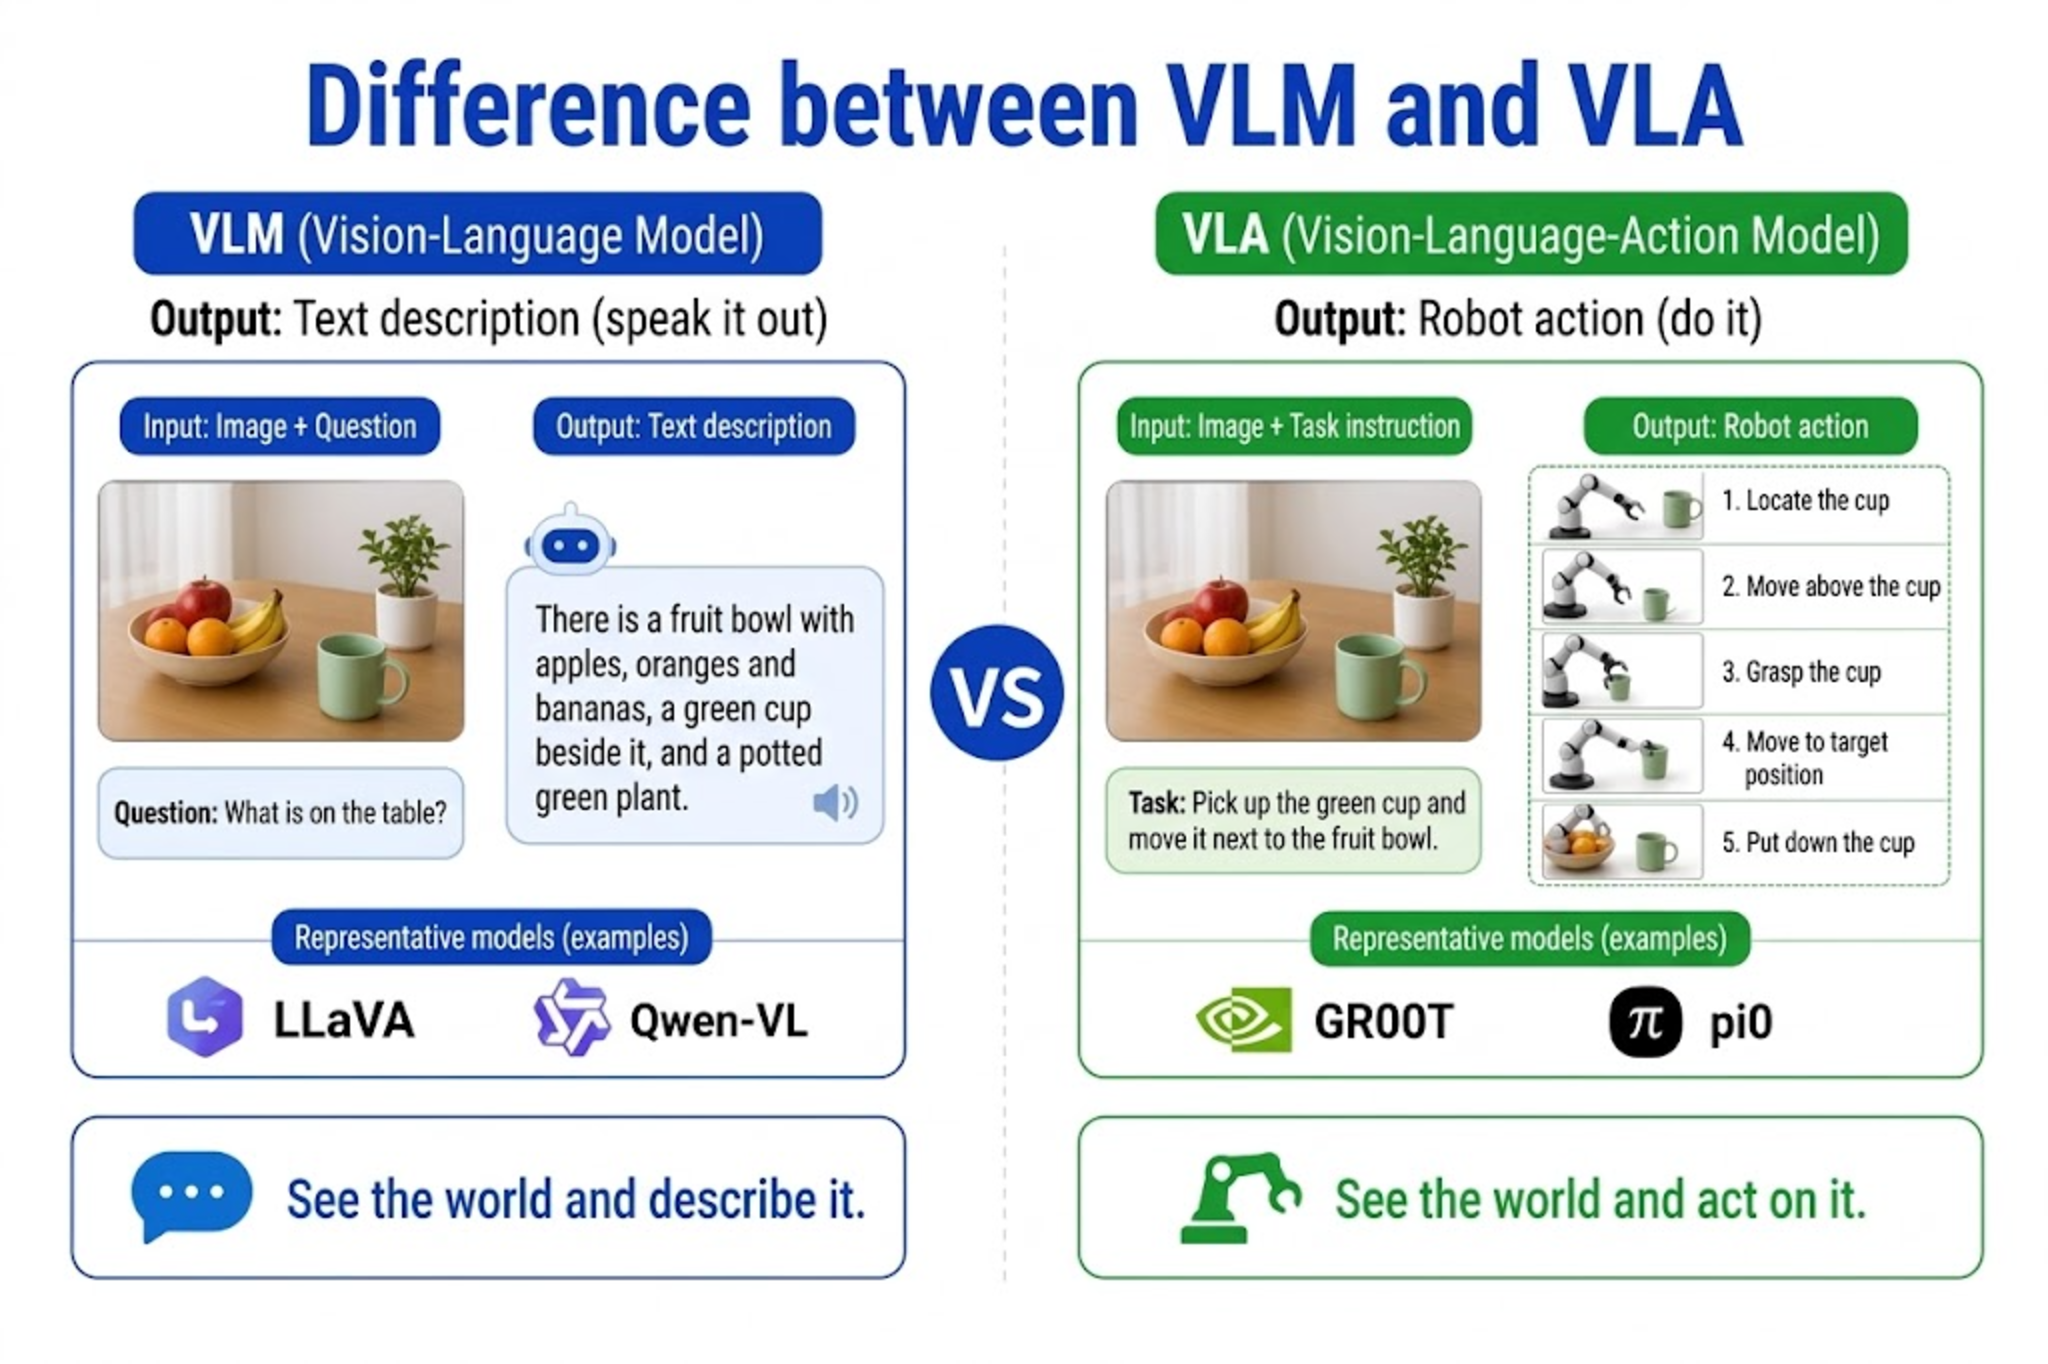
| 観点 | VLM (Vision-Language Model) | VLA (Vision-Language-Action) |
|---|---|---|
| 出力 | テキスト、記述、推論結果 | ロボットのアクション列 |
| 典型的な用途 | 画像 QA、シーン理解、キャプション生成 | 把持、配置、ドアの開閉などのマニピュレーション |
| 代表的なモデル | LLaVA、Qwen-VL、Cosmos-Reason2 | GR00T、pi0、OpenVLA |
| ロボットとの関係 | 計画を支援できるが、モーターを直接駆動しない | 制御コマンドをエンドツーエンドで出力する |
簡単に言えば、VLM は「世界を理解して語る」役割、VLA は「世界を理解して行動する」役割 を担っていると考えられます。
Isaac GR00T N1.7 はアーキテクチャ的に VLM の能力を再利用しています。バックボーンは Cosmos-Reason2-2B(Qwen3-VL アーキテクチャに基づき、N1.6 の Eagle バックボーンを置き換えたもの)で、画像と言語のエンコードを担当し、その後段に Diffusion Transformer (DiT) アクションヘッド を接続して、意味表現を連続アクションチャンクへとデコードします。したがって GR00T は VLA であると同時に、強力な VLM 表現能力も内包しています。
18.4 ACT と VLA の違い
18.4 ACT と VLA の違い
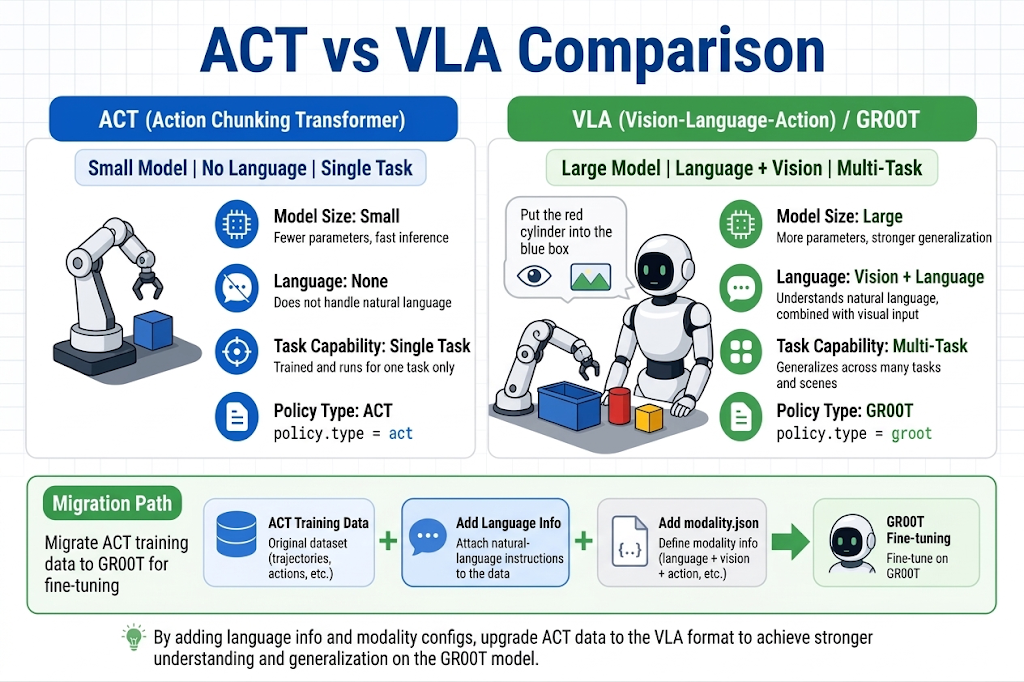
前の章で扱った ACT と、本章で扱う VLA は、どちらも模倣学習(Behavior Cloning)ファミリーに属しますが、設計目標が異なります:
| 観点 | ACT | VLA(GR00T を例とする) |
|---|---|---|
| タスク条件 | 通常は 言語なし、暗黙の単一タスク | 言語 + Vision による明示的なマルチタスク |
| モデル規模 | 小さい(数千万パラメータ規模) | 大きい(数十億パラメータのファウンデーションモデル) |
| 学習方法 | ゼロから学習、または軽いファインチューニング | ファウンデーションモデルの事前学習 + 下流タスクのファインチューニング |
| アクション表現 | アクションチャンク | アクションチャンク + Flow Matching によるノイズ除去 |
| 汎化性能 | 分布内では良好だが、タスク切り替え時は再学習が必要 | 言語条件付けによりゼロショット/少数ショット転移をサポート |
| LeRobot のポリシー種別 | act | groot |
ACT の中核技術は Action Chunking です。複数ステップ先のアクションをまとめて予測することで、1 ステップずつ推論する際の誤差蓄積を抑えます。GR00T もアクションチャンクを予測しますが、ウィンドウ長はバージョンによって異なります:
- N1.5 / N1.6:
action_horizon = 16 - N1.7:
action_horizonが 16 から 40 に拡張され、それに伴い事前学習された汎用 state/action 空間の最大次元も拡張されます(reBot では実際には 7 次元しか使わず、残りの次元は自動的にゼロ埋めされます) - LeRobot の
grootポリシー: ソースのデフォルトはchunk_size=50、n_action_steps=50
このチュートリアルでは、公式の N1.7 ファインチューニング例に従い、学習時に chunk_size=40 を使用して事前学習済みのアクションウィンドウと整合させます。16 のままにしておかないでください — ウィンドウが合わないとファインチューニング結果が悪化します。action_horizon は学習時に Diffusion ヘッドへ書き込まれ、推論時に勝手に大きくすることはできません。
移行パス: すでに reBot Arm 用の ACT データセット(LeRobot v2 形式)を持っている場合、第20章では言語アノテーションとモダリティ設定を追加するだけで GR00T のファインチューニングに利用でき、すべてのデモを取り直す必要はありません。
18.5 言語条件付きロボットタスク
18.5 言語条件付きロボットタスク
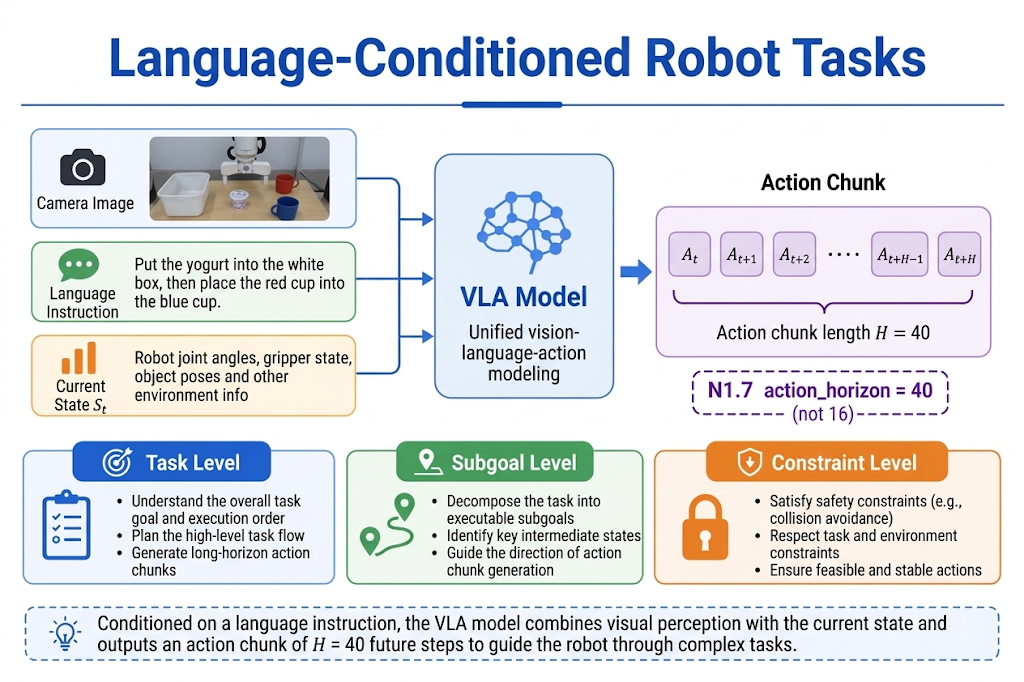
言語条件付きタスクの標準的な形は次のとおりです:
Input: image I_t + language instruction L + current state S_t
Output: actions A_{t:t+H} (action chunk for the next H steps)
指示の粒度 はさまざまです:
- タスクレベル: 「赤いキューブを青い箱に入れる」(軌道全体で 1 文を共有)
- サブゴールレベル: 「まず物体に近づく」→「次にグリッパを閉じる」(分割アノテーション。上級シナリオ)
- 制約レベル: 「そっと置く」「障害物を避ける」(アクションの実行方法を修飾する)
LeRobot のデータセットでは、言語は通常 meta/tasks.jsonl または annotation フィールドに書き込まれます。GR00T はこれを modality.json 内の annotation キーを通じて読み取ります。よくある形式は次の 2 つです:
| キー名 | 代表的なデータセット | reBot 推奨 |
|---|---|---|
human.task_description | SO-100、cube_to_bowl、その他の単純なデスクトップタスク | 推奨:第 20 章の例と一貫させる |
human.action.task_description | LIBERO、SimplerEnv、その他のシミュレーションベンチマーク | データがこれらのベンチマーク由来の場合のみ使用 |
どちらのキーも有効ですが、データセット内の実際のフィールドと一致している必要があります。学習と推論の間で混在させないでください。
実践的なアドバイス(reBot Arm):
- 各デモを記録するとき、タスクを中国語または英語で、1 つの短い動詞始まりの文で記述します。
- 類似タスクでは表現を統一して保ちます。例えば一貫して「put X on Y」を使う、など。
- 1 つのデータポイントに複数の言い回しが対応しないようにします。特に初期のファインチューニング段階では、一貫性が高いほど望ましいです。
18.6 単一タスク、マルチタスク、および汎化
18.6 単一タスク、マルチタスク、および汎化
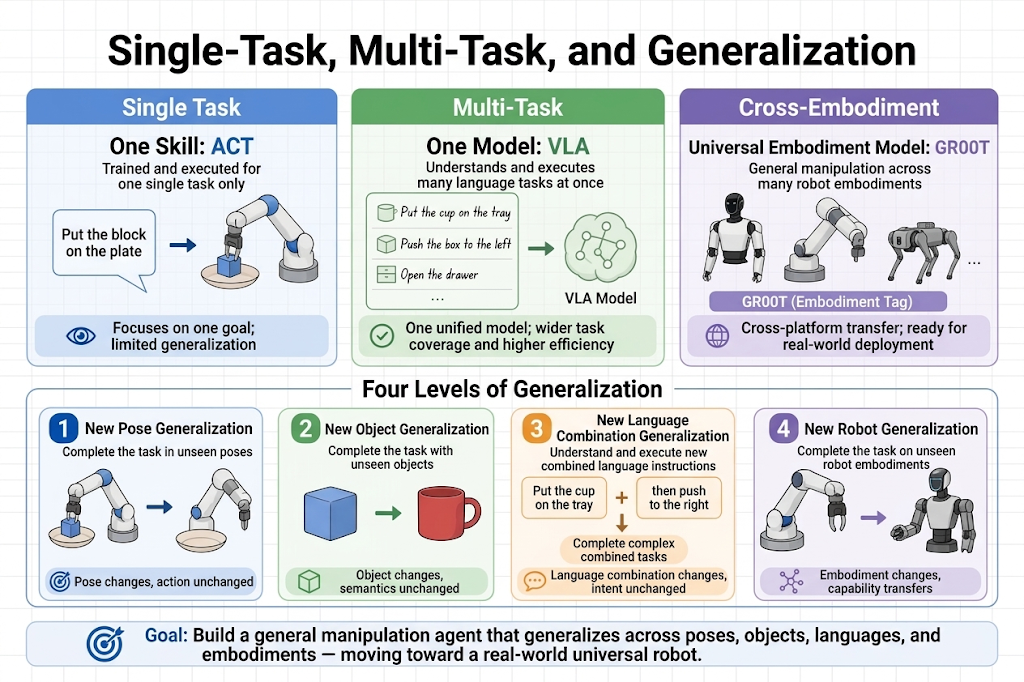
| 学習パラダイム | 説明 | 適したシナリオ |
|---|---|---|
| 単一タスク | 1 つのスキルだけを学習する | ACT のデフォルト;データが少なく、目的が明確な場合 |
| マルチタスク | 同じモデルが複数のスキルを学習し、言語で区別する | VLA ファインチューニング;デスクトップの片付け、仕分けなど |
| クロスエンボディメント汎化 | 異なるロボットが 1 つの基盤モデルを共有する | GR00T 事前学習;embodiment_tag によって適応 |
VLA における「汎化」にはいくつかのレベルがあります — 混同しないでください:
- 同じタスクで新しい初期姿勢: キューブの位置が変わっても把持できる — ACT でも通常は可能です。
- 新しい物体、新しい容器: 視覚的汎化に依存する — 学習データに十分な多様性が必要です。
- 新しい言語指示の組み合わせ: 「put A on B」が未出でも、文パターンが馴染みである — これは VLA の言語条件付けの強みです。
- 新しいロボットエンボディメント: アームを切り替えても依然として利用可能 — GR00T のエンボディメント射影層と少量のファインチューニングデータが必要です。
reBot Arm ユーザーにとって現実的な期待値は:ファインチューニング後、すでに収集した複数の言語タスクの間を切り替えられるというものです。まったく新しい物体や、まったく新しい文パターンに対しては、追加のデモデータが依然として必要です。
18.7 連続アクションとアクショントークン
18.7 連続アクションとアクショントークン
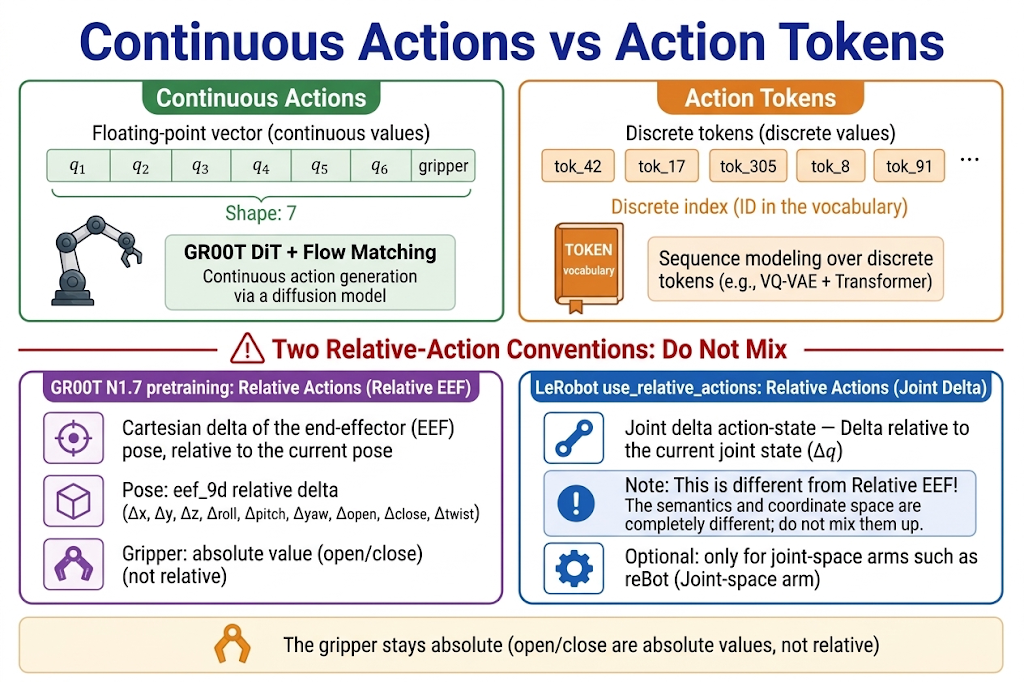
ロボット制御コマンドには、主流の表現が 2 種類あります:
連続アクション
浮動小数点ベクトルを直接出力します。例:6 関節角度 + 1 つのグリッパー開閉値:
action = [q1, q2, q3, q4, q5, q6, gripper] # shape: (7,)
- 利点: 高精度で、実際のモーターインターフェースと整合的。
- 欠点: 高次元空間での回帰が難しい。
- GR00T の採用方式: DiT + Flow Matching により連続空間でノイズ除去し、アクションチャンクを出力。
アクショントークン(離散化アクション)
連続値を離散シンボルに量子化し、言語モデルが次のトークンを予測するような形にします:
action_tokens = [tok_42, tok_17, tok_89, ...]
- 利点: 自回帰型 LLM アーキテクチャを再利用できる;pi0-FAST など一部の VLA が採用。
- 欠点: 量子化誤差が生じ、語彙設計が複雑。
相対アクション vs. 絶対アクション:
- GR00T N1.7 事前学習の中核は Relative EEF(相対エンドエフェクタ)アクション空間です:アクションは、関節角度の増分ではなく、現在のエンドエフェクタ姿勢に対するデカルト増分として表現されます。エンドエフェクタ増分は、異なるロボット(さらには人間の動画)間でも意味がより一貫しており、これが N1.7 のクロスエンボディメント汎化の鍵となります。公式コードではアクショングループごとに設定されており:
eef_9dは相対エンドエフェクタ、joint_positionは相対関節、gripper_positionは絶対値のままです。 - LeRobot の
--policy.use_relative_actions=trueはフレームワークレベルのスイッチであり、関節次元に対してaction - stateの相対変換を適用します。これは論文中の Relative EEF と同じではなく、また「N1.7 のデフォルト推奨」でもありません。reBot Arm が関節空間(NON_EEF)で動作する場合、このスイッチはあくまで任意の LeRobot 前処理ステップに過ぎません。「GR00T の事前学習設計と一貫している」と説明しないでください。 - グリッパーなどの非関節量は、一般に
relative_exclude_jointsを用いて絶対制御を維持します。相対関節軌道はより滑らかになりますが、長時間の実行ではドリフトする可能性があります。
18.8 VLA の能力と限界
18.8 VLA の能力と限界
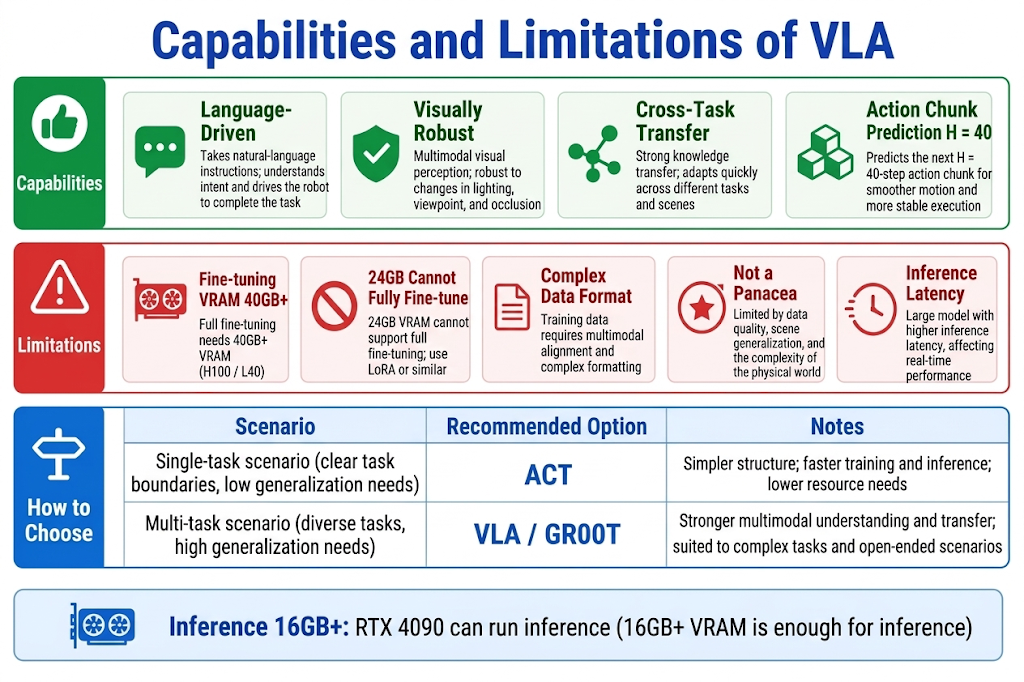
能力
- 言語駆動: 1 つのモデルで多くのタスクを扱い、指示を変えることで挙動を切り替えられます。
- 視覚ロバスト性: 大規模事前学習により、小規模な ACT より優れたシーン理解を実現します。
- タスク間転移: 類似した文パターンや類似した物体間で表現を共有できます。
- アクションチャンク予測: 1 回の推論で複数ステップを出力し、RTC 推論ポリシーと組み合わせてリアルタイム制御に適します。
限界
- 高い計算資源要求: N1.7-3B はファインチューニングに 40 GB 以上の VRAM を推奨します(H100 / L40;projector + DiT ヘッドのみを学習してもピークは約 35 GB;公式のシミュレーションファインチューニングチュートリアルでは 48 GB 以上が必要)。推論には 16 GB 以上で十分です(RTX 4090 で推論可能)。24 GB カードでのフルファインチューニングは、LoRA / PEFT などの効率的なファインチューニングを使わない限り、基本的に現実的ではありません。
- より複雑なデータ形式: 標準的な LeRobot フィールドに加え、
modality.jsonとエンボディメントタグが必要です。 - 万能薬ではない: 学習セットでカバーされていない物体、指示、作業台レイアウトでは失敗する可能性があります。
- レイテンシ: 大規模モデルの推論は ACT より遅いため、
n_action_stepsと RTC パラメータを適切に設定する必要があります。 - シミュレーションから実機へのギャップ: 事前学習データはヒューマノイド/特定プラットフォームが中心であり、デスクトップアームには十分なファインチューニングが必要です。
ACT を選ぶべきとき、VLA を選ぶべきとき
| シナリオ | 推奨 |
|---|---|
| 単一の反復タスク、エッジデバイス、低レイテンシ | ACT |
| マルチタスク、言語インタラクション、GPU とアノテーションに投資する意思がある | VLA / GR00T |
| すでに ACT データがあり、マルチタスクへ拡張したい | 既存の LeRobot データに言語を追加 -> GR00T ファインチューニング |
18.9 本章のまとめ
18.9 本章のまとめ
- マルチモーダルモデルは、視覚・言語・状態を統合して意思決定を行います。
- VLA は VLM の上にアクション出力を追加し、言語条件付きマニピュレーションを実現します。
- ACT は軽量な単一タスク向けソリューションであり、GR00T は大規模事前学習 + ファインチューニングによる VLA ソリューションです。
- N1.7 の事前学習は Relative EEF と
action_horizon=40を使用しており、LeRobot における関節相対アクションは別個の任意の前処理ステップです — この 2 つを混同しないでください。 - 次章では、一般的な VLA をこの特定のエンボディメントである reBot Arm にどのように適用するかを紹介します。