19. ロボットのエンボディメントと GR00T システムアーキテクチャ
Seeed Physical AI Beginner's Course の第19章では、エンボディメントとは何か、 関節/状態/アクションの定義、カメラと言語のモダリティ、観測ウィンドウとアクション ウィンドウ、ファウンデーションモデルのファインチューニング、LeRobot スタック、そして GR00T における reBot Arm の位置付けについて説明します。
GR00T はクロスエンボディメントなファウンデーションモデルであり、複数のロボットデータセットで事前学習され、Embodiment Tags と Modality configuration を通じて異なるハードウェアを区別します。本章では、LeRobot + GR00T スタックの中で reBot Arm がどこに位置し、推論時に各コンポーネントがどのように連携するかを説明します。
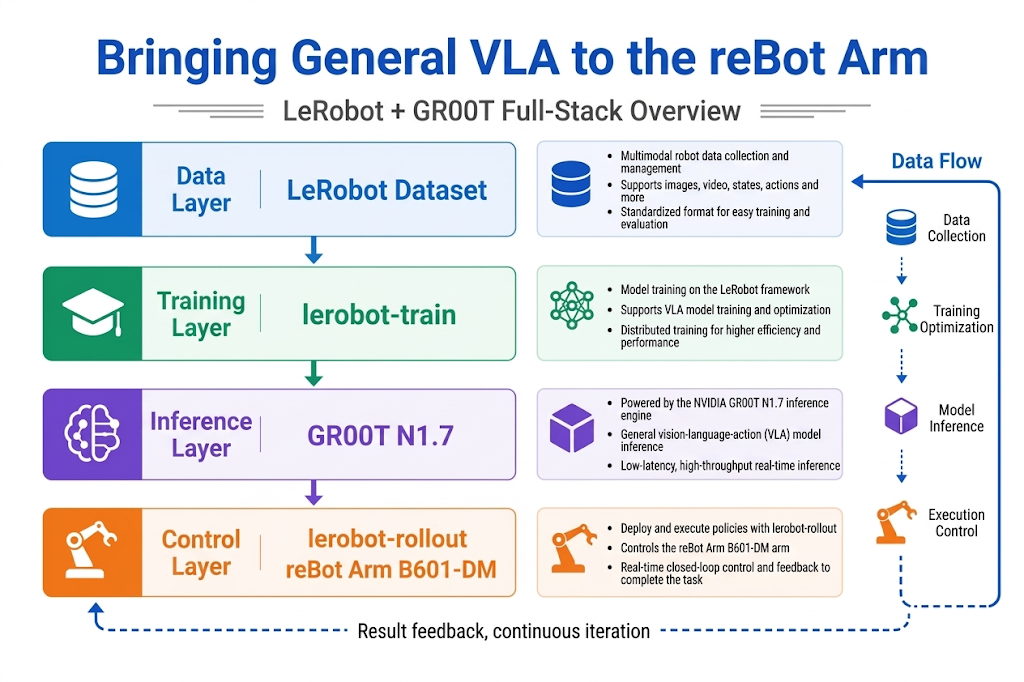
19.1 ロボットのエンボディメントとは?
19.1 ロボットのエンボディメントとは?
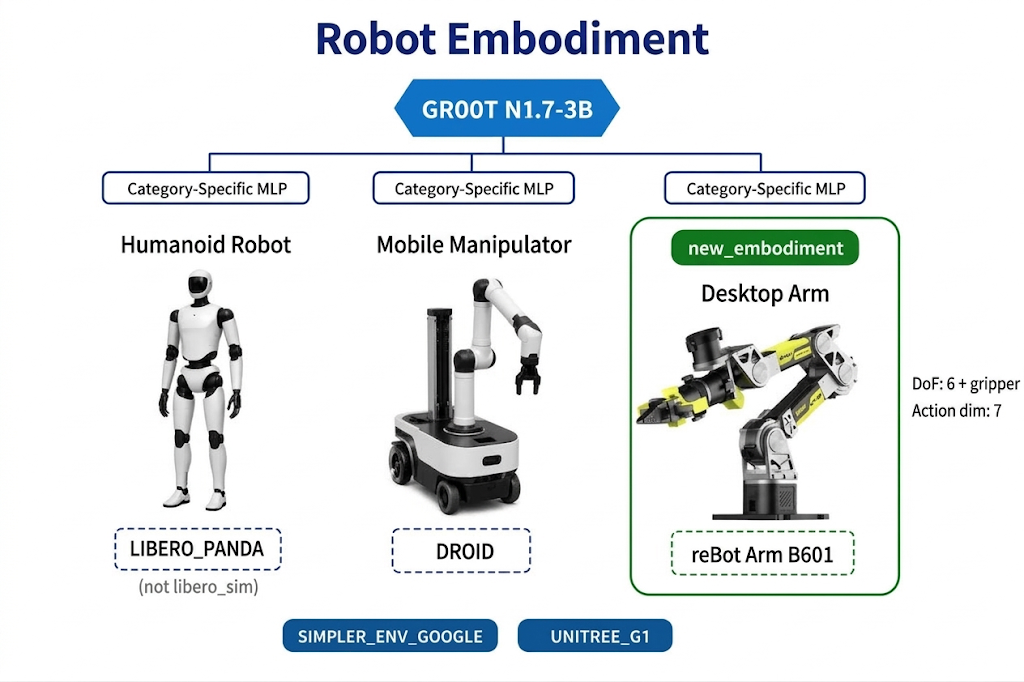
Embodiment は、ロボットの「物理的および制御上のアイデンティティ」を表し、次の内容を含みます:
- 自由度(DoF)の数と関節の並び順
- 関節リミット、ギア比、制御モード(位置/トルク)
- カメラの数、取り付け位置、解像度
- アクション空間の定義(関節空間 vs. エンドエフェクタのデカルト空間)
- グリッパーの種類と開閉範囲
同じ GR00T ファウンデーションモデルであっても、SO-101 の 6 次元関節ベクトルを reBot Arm にそのまま適用することはできません。内部では、モデルは Category-Specific MLP(エンボディメントごとの射影層) を用いて、次元の異なる状態/アクションを共有潜在空間に写像し、そこから各エンボディメントのアクション次元へ写し戻します。
LeRobot / GR00T では、エンボディメントは embodiment_tag によって指定されます。公式の事前学習タグ(EmbodimentTag)には次のものがあります:
LIBERO_PANDA,DROID,SIMPLER_ENV_GOOGLE,UNITREE_G1,OXE_WIDOWXなど- 新しいハードウェア:
new_embodiment/NEW_EMBODIMENT(reBot Arm のファインチューニング時に使用)
libero_sim という公式タグは存在しません。事前学習タグを reBot のデータに適用しないでください。
--policy.embodiment_tag=new_embodiment
これは GR00T に対して、「現在のデータは学習時に見たことのない新しいロボットから来ているので、ファインチューニングには new-embodiment の射影層を使用すること」と伝えます。
19.2 ロボットの関節・状態・アクションの定義
19.2 ロボットの関節・状態・アクションの定義
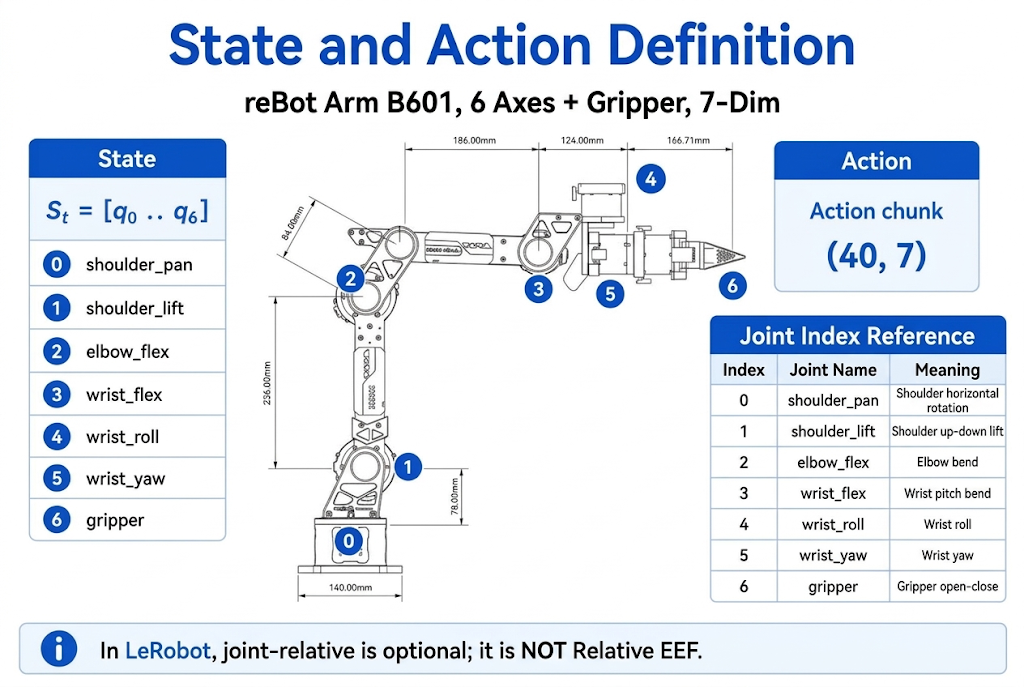
reBot Arm B601(6 軸 + グリッパー)を例にとります:
関節と状態
状態(観測状態) はポリシーへの入力の 1 つであり、ロボットの現在の構成を表します:
observation.state = [q1, q2, q3, q4, q5, q6, gripper_pos]
                     └──────── 6 joint angles ─────┘  └ gripper ┘
- 単位:関節角は通常ラジアン(rad)または度(deg)で表されますが、データセット内で一貫している必要があります。
- 並び順:記録スクリプト、
modality.json、推論クライアントと完全に一致していなければなりません。 meta/modality.jsonでは、次のように分割できます:state.single_arm-> インデックス 0-5state.gripper-> インデックス 6
アクション
アクションはポリシーの出力であり、ローレベルコントローラによって実行されます:
action = [target_q1, ..., target_q6, target_gripper]
GR00T N1.7 は、一度に H ステップ分のアクションチャンクを出力します(事前学習では action_horizon=40;LeRobot の groot はデフォルトで chunk_size=50)。本チュートリアルでは N1.7 に合わせて H=40 を使用します:
action_chunk.shape = (40, 7) # 40 steps x 7 dimensions
制御ループは通常、チャンクから 1 行を取り出し、毎ステップまたは k ステップごとにモーターへ送信します。LeRobot の rollout では、n_action_steps によって 1 回の推論で実行するステップ数を制御します。
19.3 カメラモダリティ
19.3 カメラモダリティ
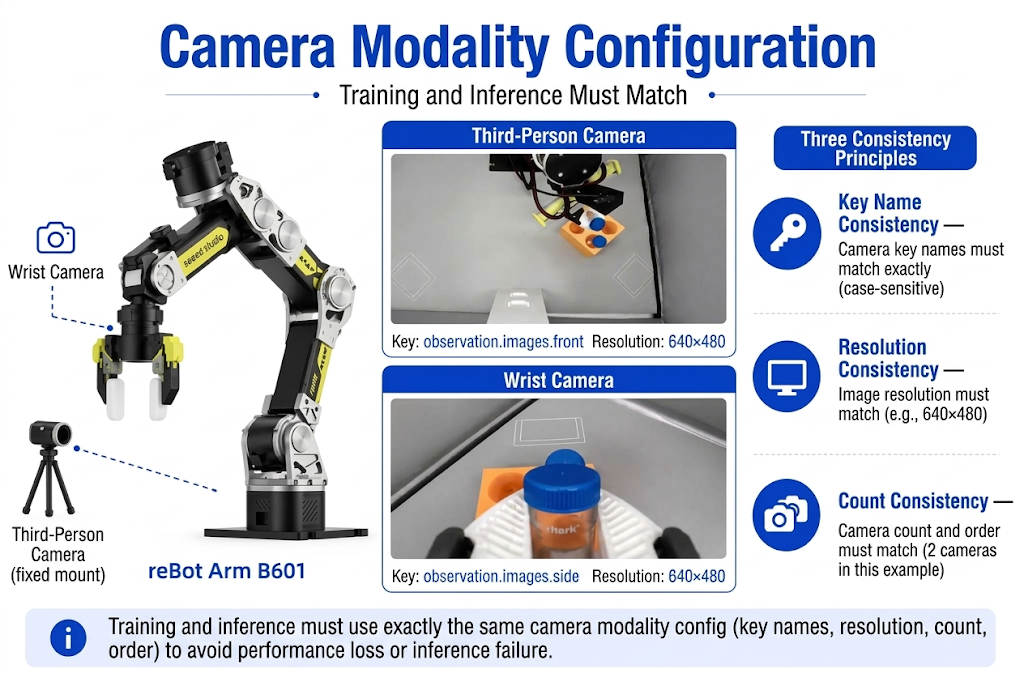
GR00T は、視覚を主、言語を補助、状態を補完として利用します。カメラ構成は学習データと厳密に一致していなければなりません。
一般的なカメラレイアウト(reBot Arm)
| キー名(例) | 位置 | 目的 |
|---|---|---|
front | ブラケットに取り付けられた広視野カメラ | シーン全体、ターゲット物体の位置特定 |
side / wrist | 手首カメラ | 近接での狙い付け、遮蔽されたシーン |
LeRobot のデータセットでは、動画は observation.images.<camera_name> として保存され、meta/modality.json の video フィールドで各カメラの解像度とインデックスが宣言されます。
注意事項
- カメラのキー名、数、解像度は、学習と推論の間で同一でなければなりません。
- GR00T のバックボーンはネイティブなアスペクト比をサポートしますが、640x480 もしくはデータセットで合意した解像度に統一することを推奨します。
- ファインチューニング時には、ロバスト性向上のために
dataset.image_transforms(明るさ・コントラストのジッタ)を有効にしてください。 lerobot-find-cameras opencvを使ってローカルのカメラインデックスを確認します。
19.4 言語モダリティ
19.4 言語モダリティ
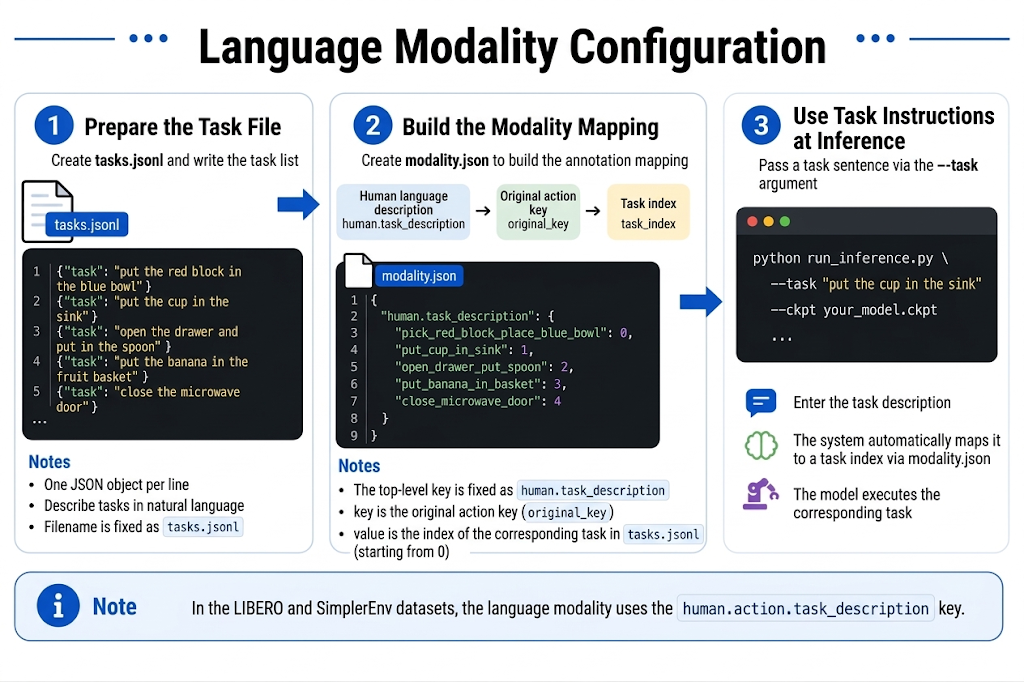
GR00T パイプラインにおいて、言語は条件付け入力として機能し、画像トークンとともに VLM バックボーンへ入力されます。
データ側
- LeRobot:
meta/tasks.jsonlまたはエピソード単位のアノテーション - GR00T 拡張:
meta/modality.json->annotationフィールド
modality.json の例(reBot のデスクトップタスクでは human.task_description を使用):
{
  "annotation": {
    "human.task_description": {
      "original_key": "task_index"
    }
  }
}
データが LIBERO / SimplerEnv 由来の場合は、代わりに human.action.task_description を使用します。キー名は第20章の完全な modality.json と一致していなければなりません。
推論側
lerobot-rollout を実行する際は、--task で渡します:
--task="place the red cube on the blue tray"
この文字列はエンコードされ、現在の画像と状態とともにモデルへ入力されます。学習データと似た言語スタイルと文型を使用してください。
19.5 観測ウィンドウとアクションウィンドウ
19.5 観測ウィンドウとアクションウィンドウ
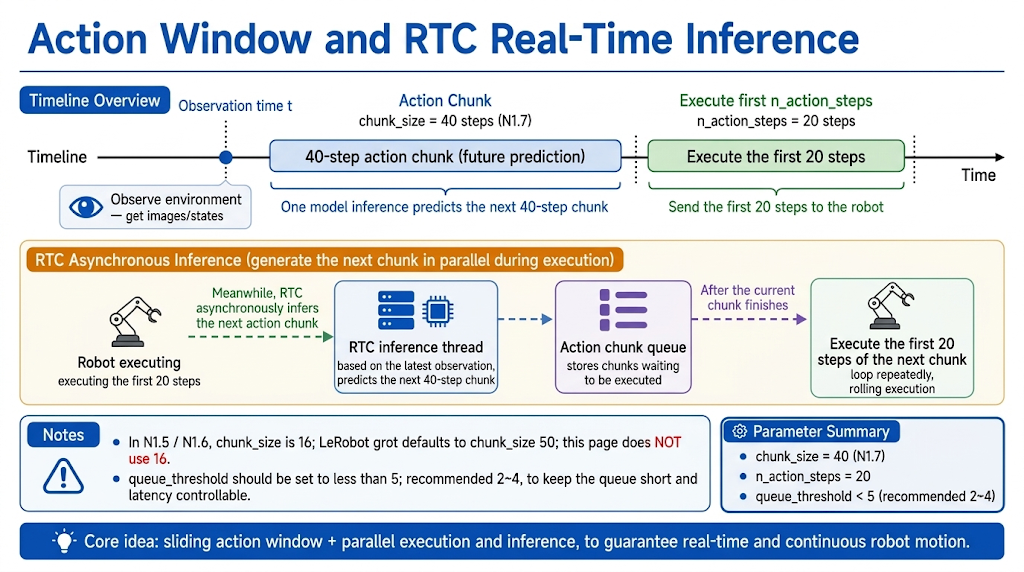
VLA の推論は「1 フレームを見て 1 アクションを出力する」というものではなく、時間次元のサンプリング設計を伴います:
Time axis ─────────────────────────────────────────────►

Observation window:  [t-k ... t-1, t]     ← historical image frames (optional)
State:              S_t
Language:           L
Action prediction window:    [A_t, A_{t+1}, ... A_{t+H-1}]
                              └── H = chunk_size / action_horizon
| パラメータ | 典型値(N1.7) | 意味 |
|---|---|---|
chunk_size / action_horizon | 40(N1.7 に合わせる;LeRobot の groot ソースのデフォルトは 50;N1.5/N1.6 は 16) | 1 回の推論で予測されるアクションステップ数 |
n_action_steps | 8-40 | 1 回の推論で実際に実行されるステップ数。chunk_size 以下でなければならない |
n_obs_steps | 1 | 使用する過去の画像フレーム数 |
RTC(Real-Time Chunking): 推論時間が制御周期に近づく場合、LeRobot は RTC ポリシーをサポートしており、現在のチャンクを実行しながら非同期に次のチャンクを計算することで、一時停止を減らします。rollout では --inference.type=rtc を指定して有効化します。queue_threshold は、アクションキューに残っているステップ数がどれくらい少なくなったら新しい推論をトリガーするかを示し、2〜5 を推奨します。0 に設定すると毎回再推論となり、ジッタが増えがちです。
19.6 ファウンデーションモデルとファインチューニング
19.6 ファウンデーションモデルとファインチューニング
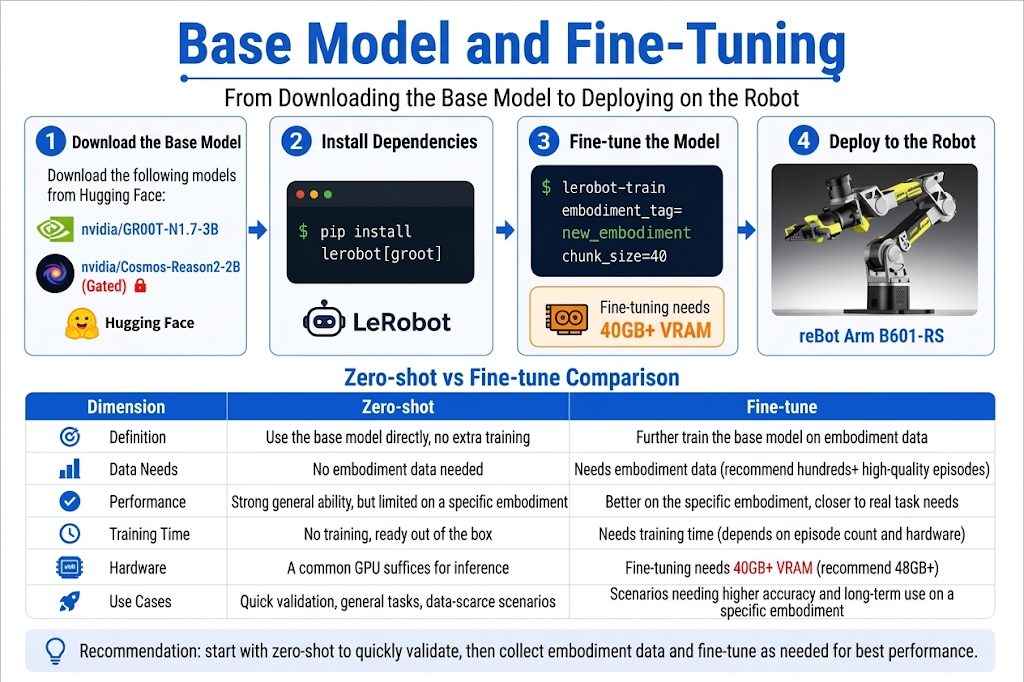
ファウンデーションモデル
NVIDIA GR00T N1.7-3B は、大規模なマルチエンボディメントデータで事前学習されており、汎用的な視覚・言語・アクション能力を備えています。Hugging Face から入手できます:
nvidia/GR00T-N1.7-3B
LeRobot は GR00T サポートをインストールします:
pip install "lerobot[groot]"
# or from source:
pip install -e ".[groot]"
詳細については LeRobot インストールドキュメント を参照してください。
ファインチューニング
reBot Arm における典型的なワークフロー:
- LeRobot v2 データセットと
meta/modality.jsonを準備する(第 20 章)。 embodiment_tag=new_embodimentを指定する。lerobot-train --policy.type=grootで学習を開始する(第 21 章)。- チェックポイントを Hugging Face Hub にプッシュするか、
outputs/にローカル保存する。
ファインチューニング中:
- VLM バックボーン は Cosmos-Reason2-2B。デフォルトのファインチューニングでは多くの場合 LLM を凍結し、プロジェクタ + DiT ヘッドの学習に集中する(ピーク約 35 GB)。
- DiT アクションヘッド と エンボディメント射影層 は reBot の状態/アクション次元に適応する。
- データ量の推奨:タスクごとに少なくとも 50 回の成功デモ、マルチタスクの場合はさらに多く。
- VRAM:ファインチューニングには 40 GB 以上。24 GB カードの場合は LoRA/PEFT を使用するか、推論のみにする。
ゼロショット vs. ファインチューニング
| 手法 | 説明 |
|---|---|
| ゼロショット | GR00T-N1.7-3B をそのまま使用する。タスクが事前学習済みエンボディメントと極めて類似している場合にのみ動作する可能性がある |
| ファインチューニング | reBot Arm の推奨ルート。少量のデスクトップ操作データでも成功率を大きく向上できる |
19.7 GR00T システムアーキテクチャ(LeRobot スタック)
19.7 GR00T システムアーキテクチャ(LeRobot スタック)
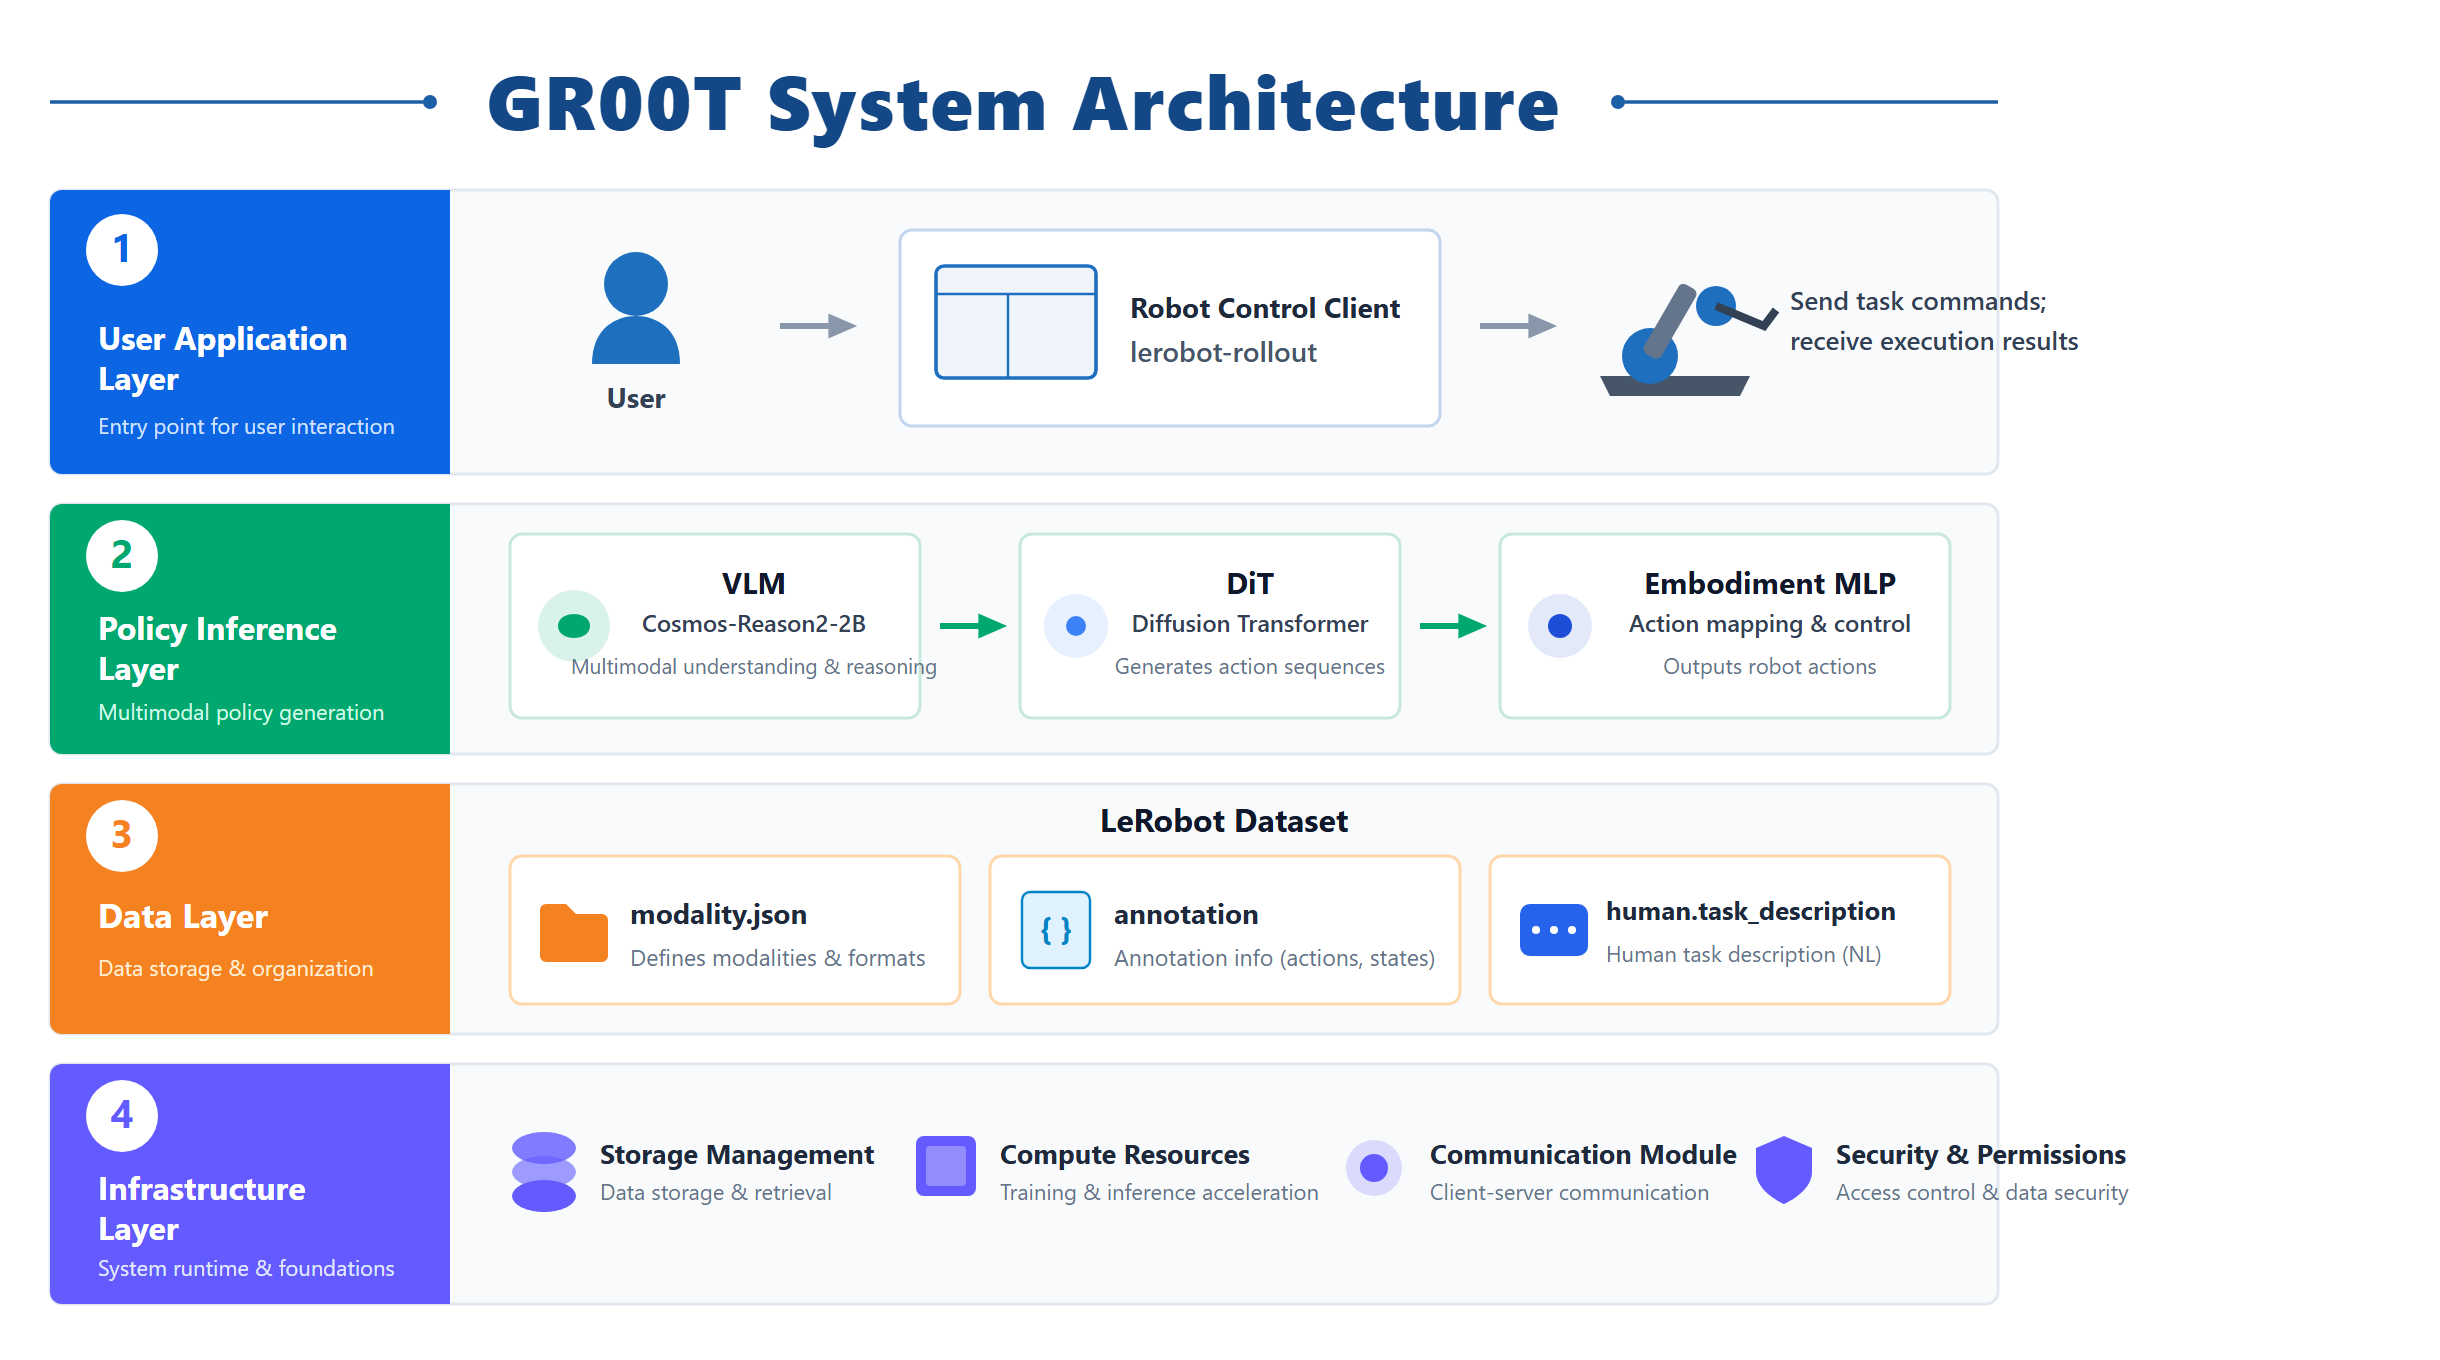
LeRobot をベースとした reBot GR00T システムは、4 つのレイヤに分けることができます:
┌────────────────────────────────────────────────────────────┐
│                    User / Application Layer                 │
│         Natural language task  +  start rollout / teach UI  │
└────────────────────────────┬───────────────────────────────┘
                             │
┌────────────────────────────▼───────────────────────────────┐
│              Robot Control Client (LeRobot Rollout)         │
│  - Capture camera images, read joint state                  │
│  - Send observation to policy, receive action chunk        │
│  - Execute actions via reBot driver (serial/CAN)            │
│  lerobot-rollout --policy.type=groot --robot.type=...      │
└────────────────────────────┬───────────────────────────────┘
                             │ observation / action
┌────────────────────────────▼───────────────────────────────┐
│              Policy Inference (GR00T N1.7)                 │
│  ┌──────────────┐  ┌─────────────┐  ┌──────────────────┐ │
│  │ VLM Backbone │→ │  DiT Head   │→ │ Embodiment MLP   │ │
│  │ Cosmos-Reason2-2B │  │ Flow Match  │  │ decode to 7-DoF  │ │
│  └──────────────┘  └─────────────┘  └──────────────────┘ │
│  Can be in the same process as rollout, or split into a     │
│  separate GPU inference service (advanced deployment)       │
└────────────────────────────┬───────────────────────────────┘
                             │
┌────────────────────────────▼───────────────────────────────┐
│              Data and Training Layer (LeRobot Dataset v2)   │
│  episodes / videos / meta/modality.json / tasks.jsonl      │
│  lerobot-train / lerobot-record / lerobot-replay           │
└────────────────────────────────────────────────────────────┘
内部モデルのデータフロー(簡略版)
- 画像 -> VLM ビジュアルエンコーダ -> ビジュアルトークン
- 言語指示 -> テキストトークナイザ -> 言語トークン
- 状態 -> エンボディメントエンコーディング MLP -> 状態トークン
- マルチモーダルトークンの融合 -> DiT による反復的ノイズ除去 -> アクション潜在変数
- エンボディメントデコーディング MLP ->
action_chunk (H x action_dim)
19.8 GR00T 推論サーバーとロボット制御クライアント
19.8 GR00T 推論サーバーとロボット制御クライアント
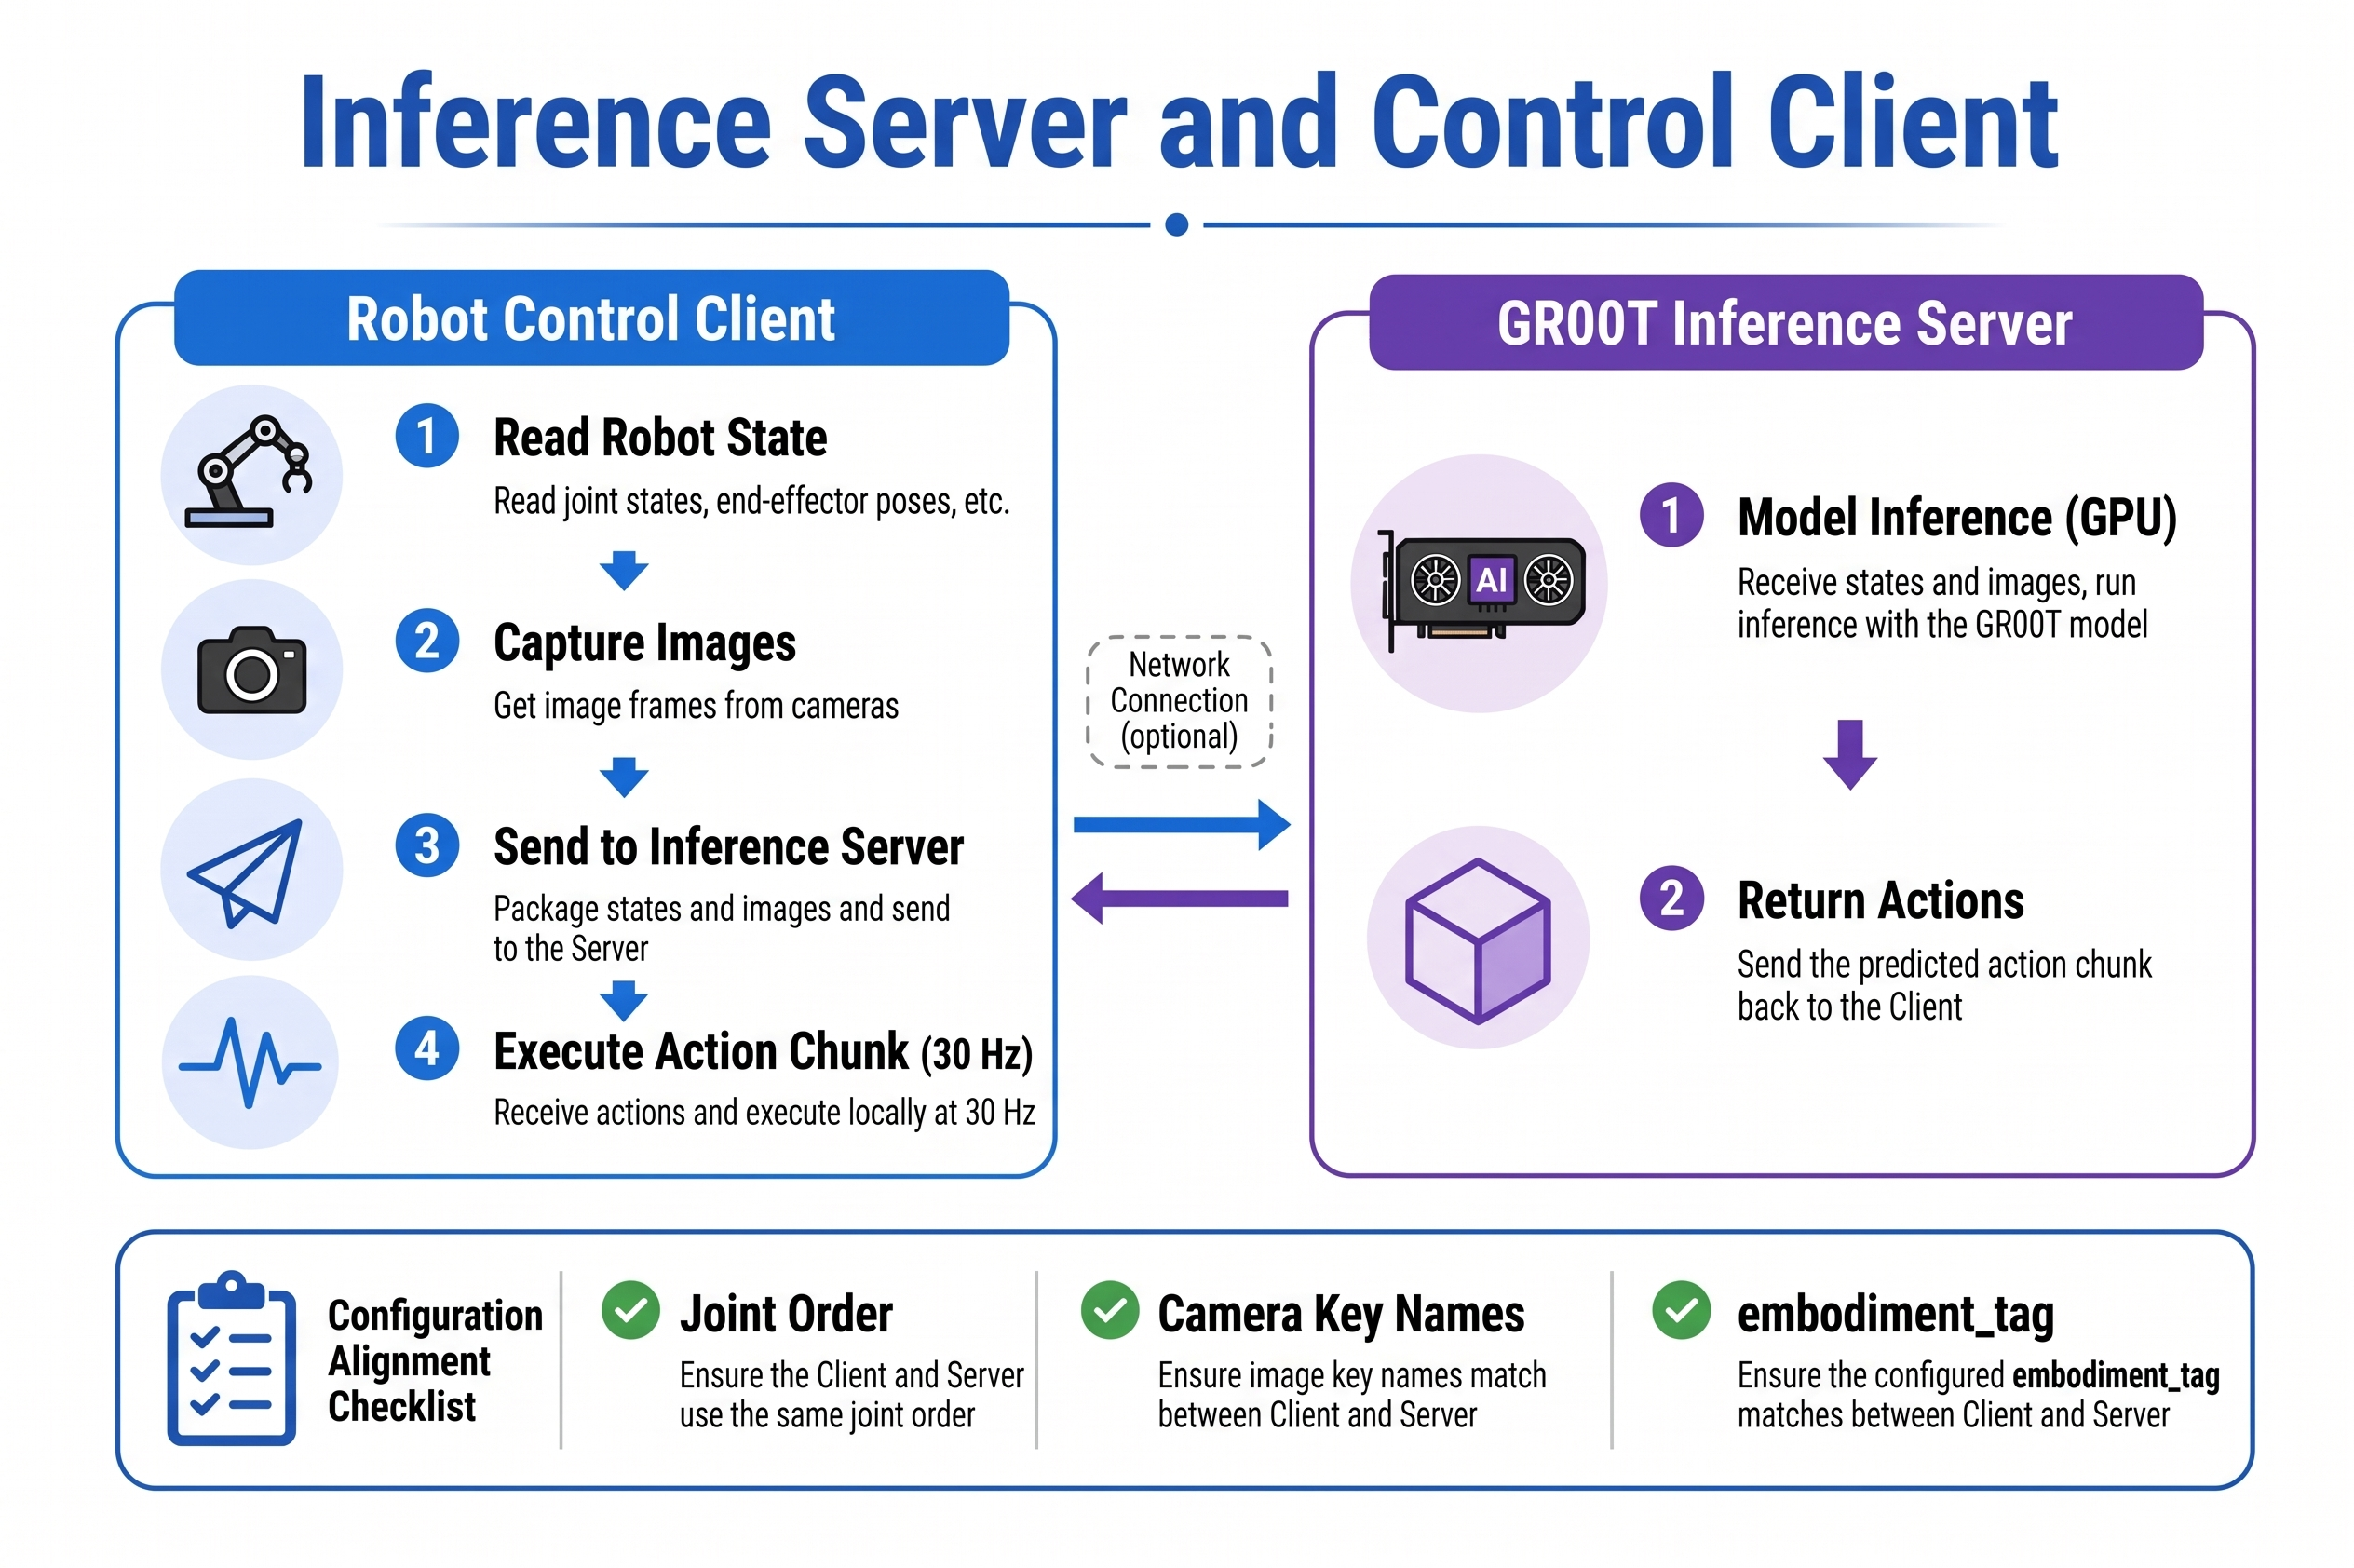
開発ボード上でシステムを動かす際には、重い計算処理 と リアルタイム制御 を分離するのが一般的です:
ロボット制御クライアント
役割:
- 一定の周波数(例:30 Hz)で reBot Arm の関節状態を読み取る
- カメラから最新の画像を取得する
{images, state, task}を推論側に送信するaction_chunkを受信し、n_action_stepsに従ってアクションをモータにステップダウンして送る- 安全リミットと非常停止(e-stop)を監視する
LeRobot では、これは reBot の robot.type、port、can_adapter、およびカメラ辞書 cameras で設定された lerobot-rollout に対応します。RS は can0 + socketcan を使用し、DM は /dev/ttyACM0 + damiao を使用します。
GR00T 推論サーバー(オプション)
GPU がデスクトップマシンにあり、アームが現場にある場合、ポリシーをスタンドアロンのサービスとしてデプロイできます:
- クライアントは観測 JSON / テンソルをネットワーク越しに送信する
- サーバーは
policy.pathとbase_model_pathをロードし、アクションチャンクを返す - アーム側の計算負荷を軽減する
LeRobot はデフォルトでは推論とロールアウトを 同一プロセス内 で実行します(--device=cuda)。これは単一マシンでのデバッグに適しています。本番環境では、Isaac GR00T リポジトリのデプロイ例を参照し、推論を HTTP/gRPC サービスとしてラップしてください。コアのモデルインターフェースは LeRobot の groot ポリシーと一貫しています。
統合チェックリスト
| チェック項目 | 説明 |
|---|---|
| 関節順序 | dataset = modality.json = rollout driver |
| 角度単位 | rad と deg を混在させないこと |
| カメラキー名 | front、wrist などが学習時と一致していること |
embodiment_tag | ファインチューニングと推論の両方で new_embodiment を使用する |
base_model_path | 推論時には、通常 nvidia/GR00T-N1.7-3B を設定ベースとして引き続き必要 |
| チャンクと RTC | n_action_steps ≤ chunk_size;RTC キューしきい値 ≤ 5 |
19.9 GR00T における reBot Arm の位置づけ
19.9 GR00T における reBot Arm の位置づけ
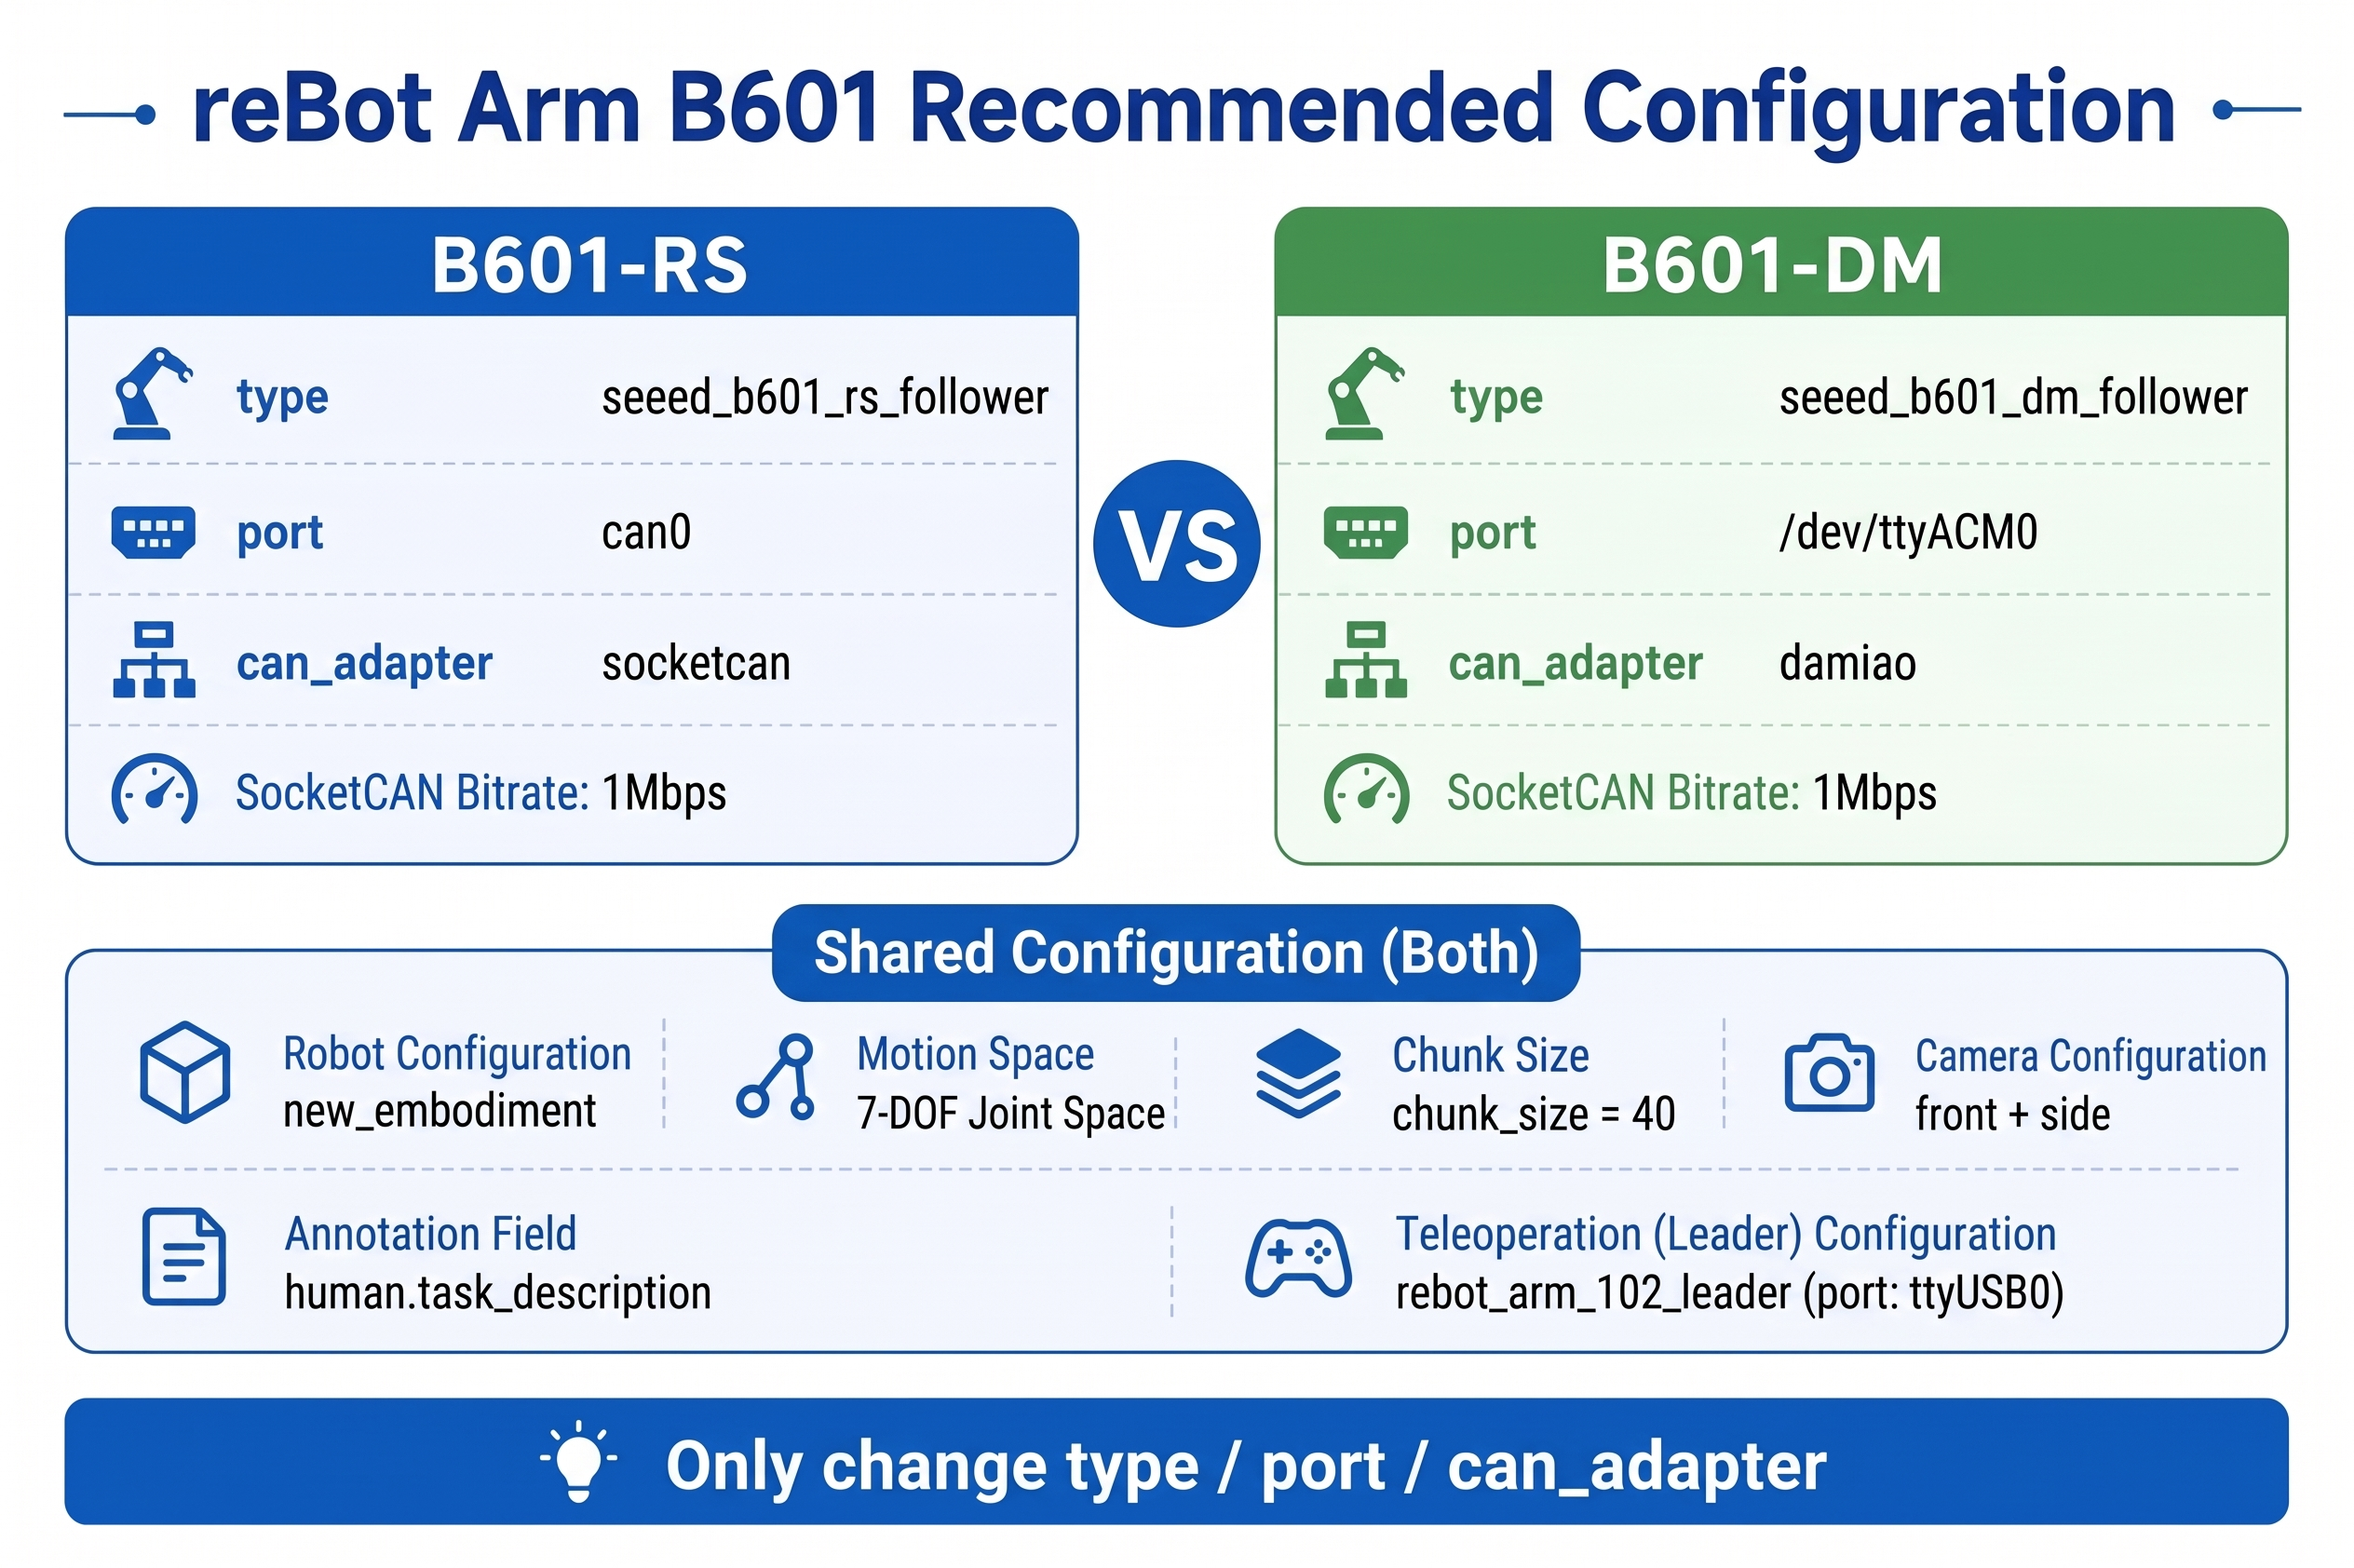
| 項目 | reBot Arm B601 推奨構成 |
|---|---|
embodiment_tag | new_embodiment |
| state キー | single_arm (6) + gripper (1) |
| action キー | state と整合、7 次元 |
| action タイプ | 関節空間 NON_EEF。LeRobot ではオプションで use_relative_actions=true(関節相対であり、Relative EEF ではない) |
| アクションウィンドウ | 学習時 chunk_size=40(N1.7 の action_horizon と整合) |
| カメラ | 少なくとも 1 ストリーム;front + wrist / side の併用を推奨 |
| 言語 | エピソードごとに 1 つのタスク記述;アノテーションには human.task_description を使用 |
| 制御インターフェース | 下表参照:RS は SocketCAN、DM は Damiao シリアルを使用 |
B601-RS と B601-DM のドライバの違い(LeRobot コマンドで変更するのはこの 3 つのみ):
| バージョン | robot.type | robot.port | robot.can_adapter | 参考 |
|---|---|---|---|---|
| B601-RS | seeed_b601_rs_follower | can0 | socketcan | B601-RS LeRobot Wiki |
| B601-DM | seeed_b601_dm_follower | /dev/ttyACM0 | damiao | B601-DM LeRobot Wiki |
どちらも 6 軸 + グリッパの 7 次元 state/action であり、テレオペ側は常に --teleop.type=rebot_arm_102_leader --teleop.port=/dev/ttyUSB0 を使用します。RS を使用する前に、次のように CAN を設定してください:sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up。
第 20 章では、既存の模倣学習データを上記フォーマットに整理する手順をステップバイステップで説明します。第 21 章では、これを基に lerobot-train ファインチューニングを完了します。
19.10 章のまとめ
19.10 章のまとめ
- エンボディメント はロボットの物理的および制御インターフェースを定義します。reBot Arm は
new_embodimentとして GR00T に参加します(LIBERO_PANDAやDROIDのような事前学習タグは使用しないでください)。 - State / Action は、データセット、モダリティ設定、および推論クライアント間で厳密に一貫していなければなりません。
- ビジョンと言語 は VLA の 2 つの条件モダリティであり、reBot のアノテーションでは
human.task_descriptionを使用します。 - アクションウィンドウ: N1.7 の
action_horizon=40は RTC と合わせて、リアルタイム性能を決定します。 - モデルバリアント: B601-RS(SocketCAN)と B601-DM(Damiao シリアル)は、
type/port/can_adapterのみが異なります。 - LeRobot はデータ、トレーニング、およびロールアウトのための統一ツールチェーンを提供し、GR00T は事前学習済み VLA 機能を提供します。
- 次の章では実践に入り、reBot VLA データセットの準備を行います。