20. reBot VLA データセットの準備
Seeed Physical AI Beginner's Course 第20章 — 前提条件、LeRobot データセットの確認、 言語タスク記述の追加、state/action/camera キーの設定、 meta/modality.json の作成、embodiment タグの設定、関節順序と次元の検証、 およびマルチタスク構成について説明します。
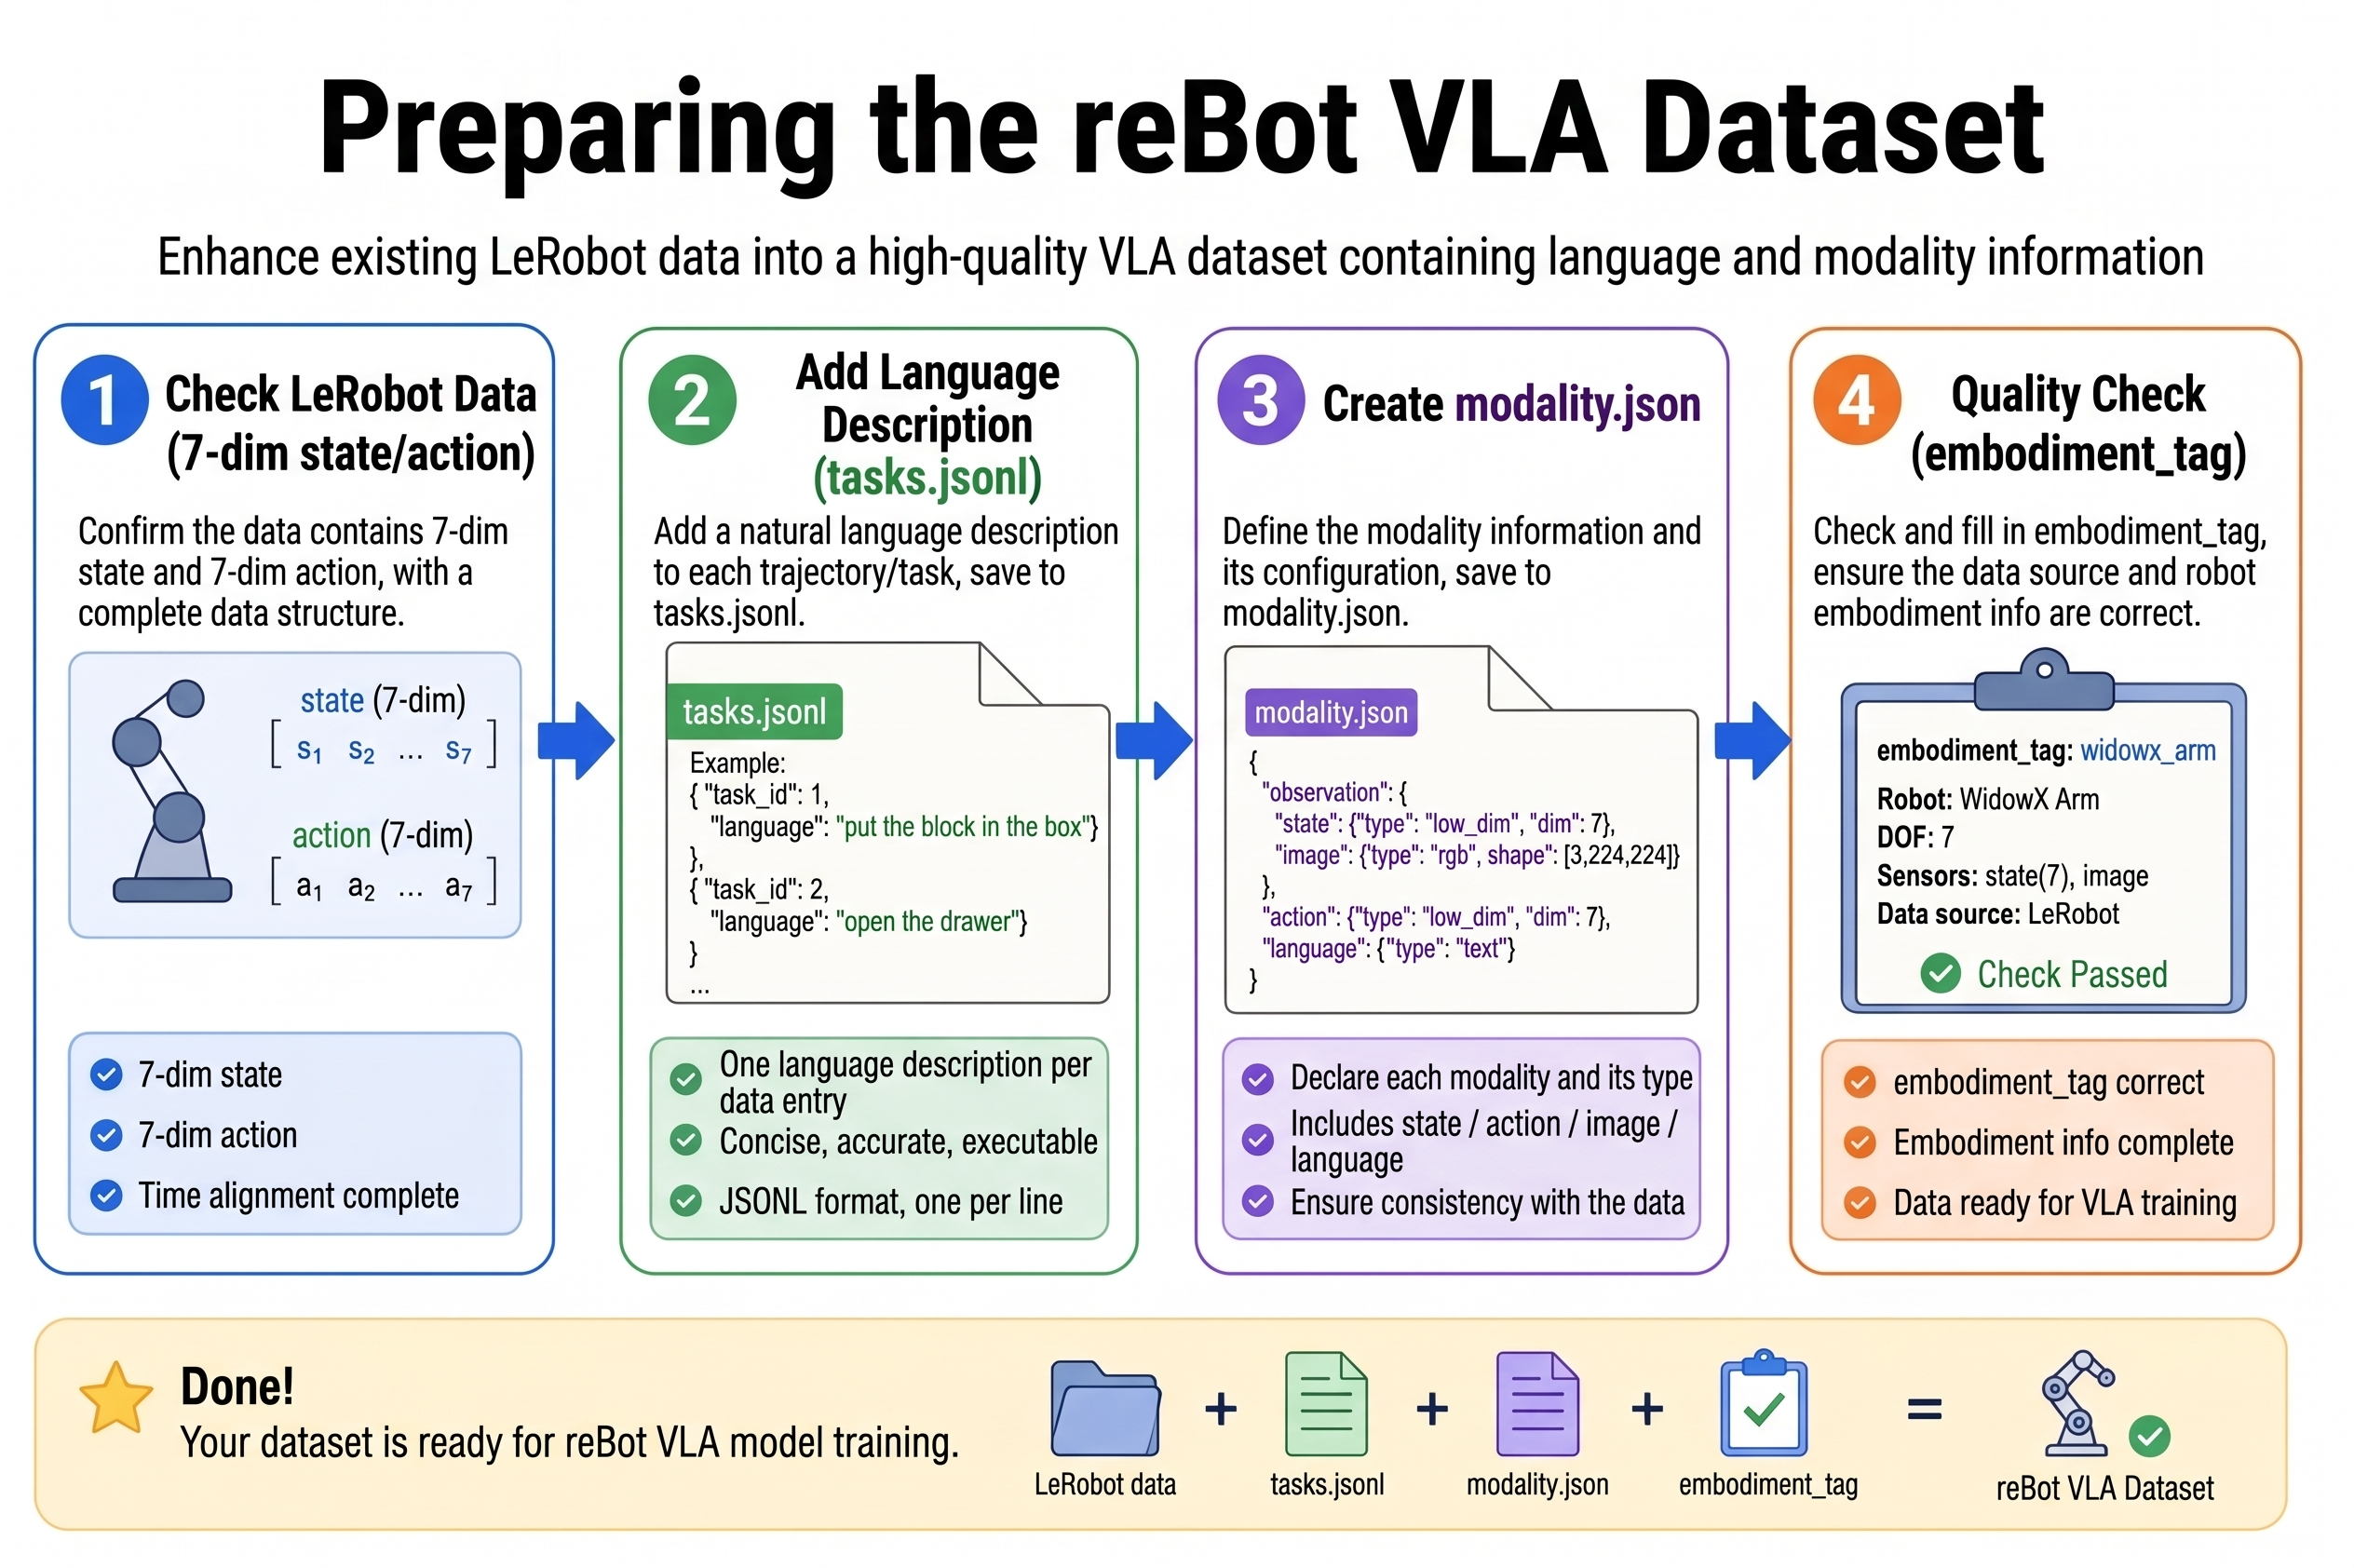
GR00T は LeRobot 上で LeRobotDataset v2/v3 形式 を使用し、さらに state、action、video、annotation の意味的な分割を記述するために meta/modality.json を必要とします。本章では、すでに reBot Arm 上で lerobot-record を用いて ACT データを収集済みであることを前提とし、次にそれを VLA 学習用データへとアップグレードしていきます。
20.1 前提条件
20.1 前提条件
| 項目 | 要件 |
|---|---|
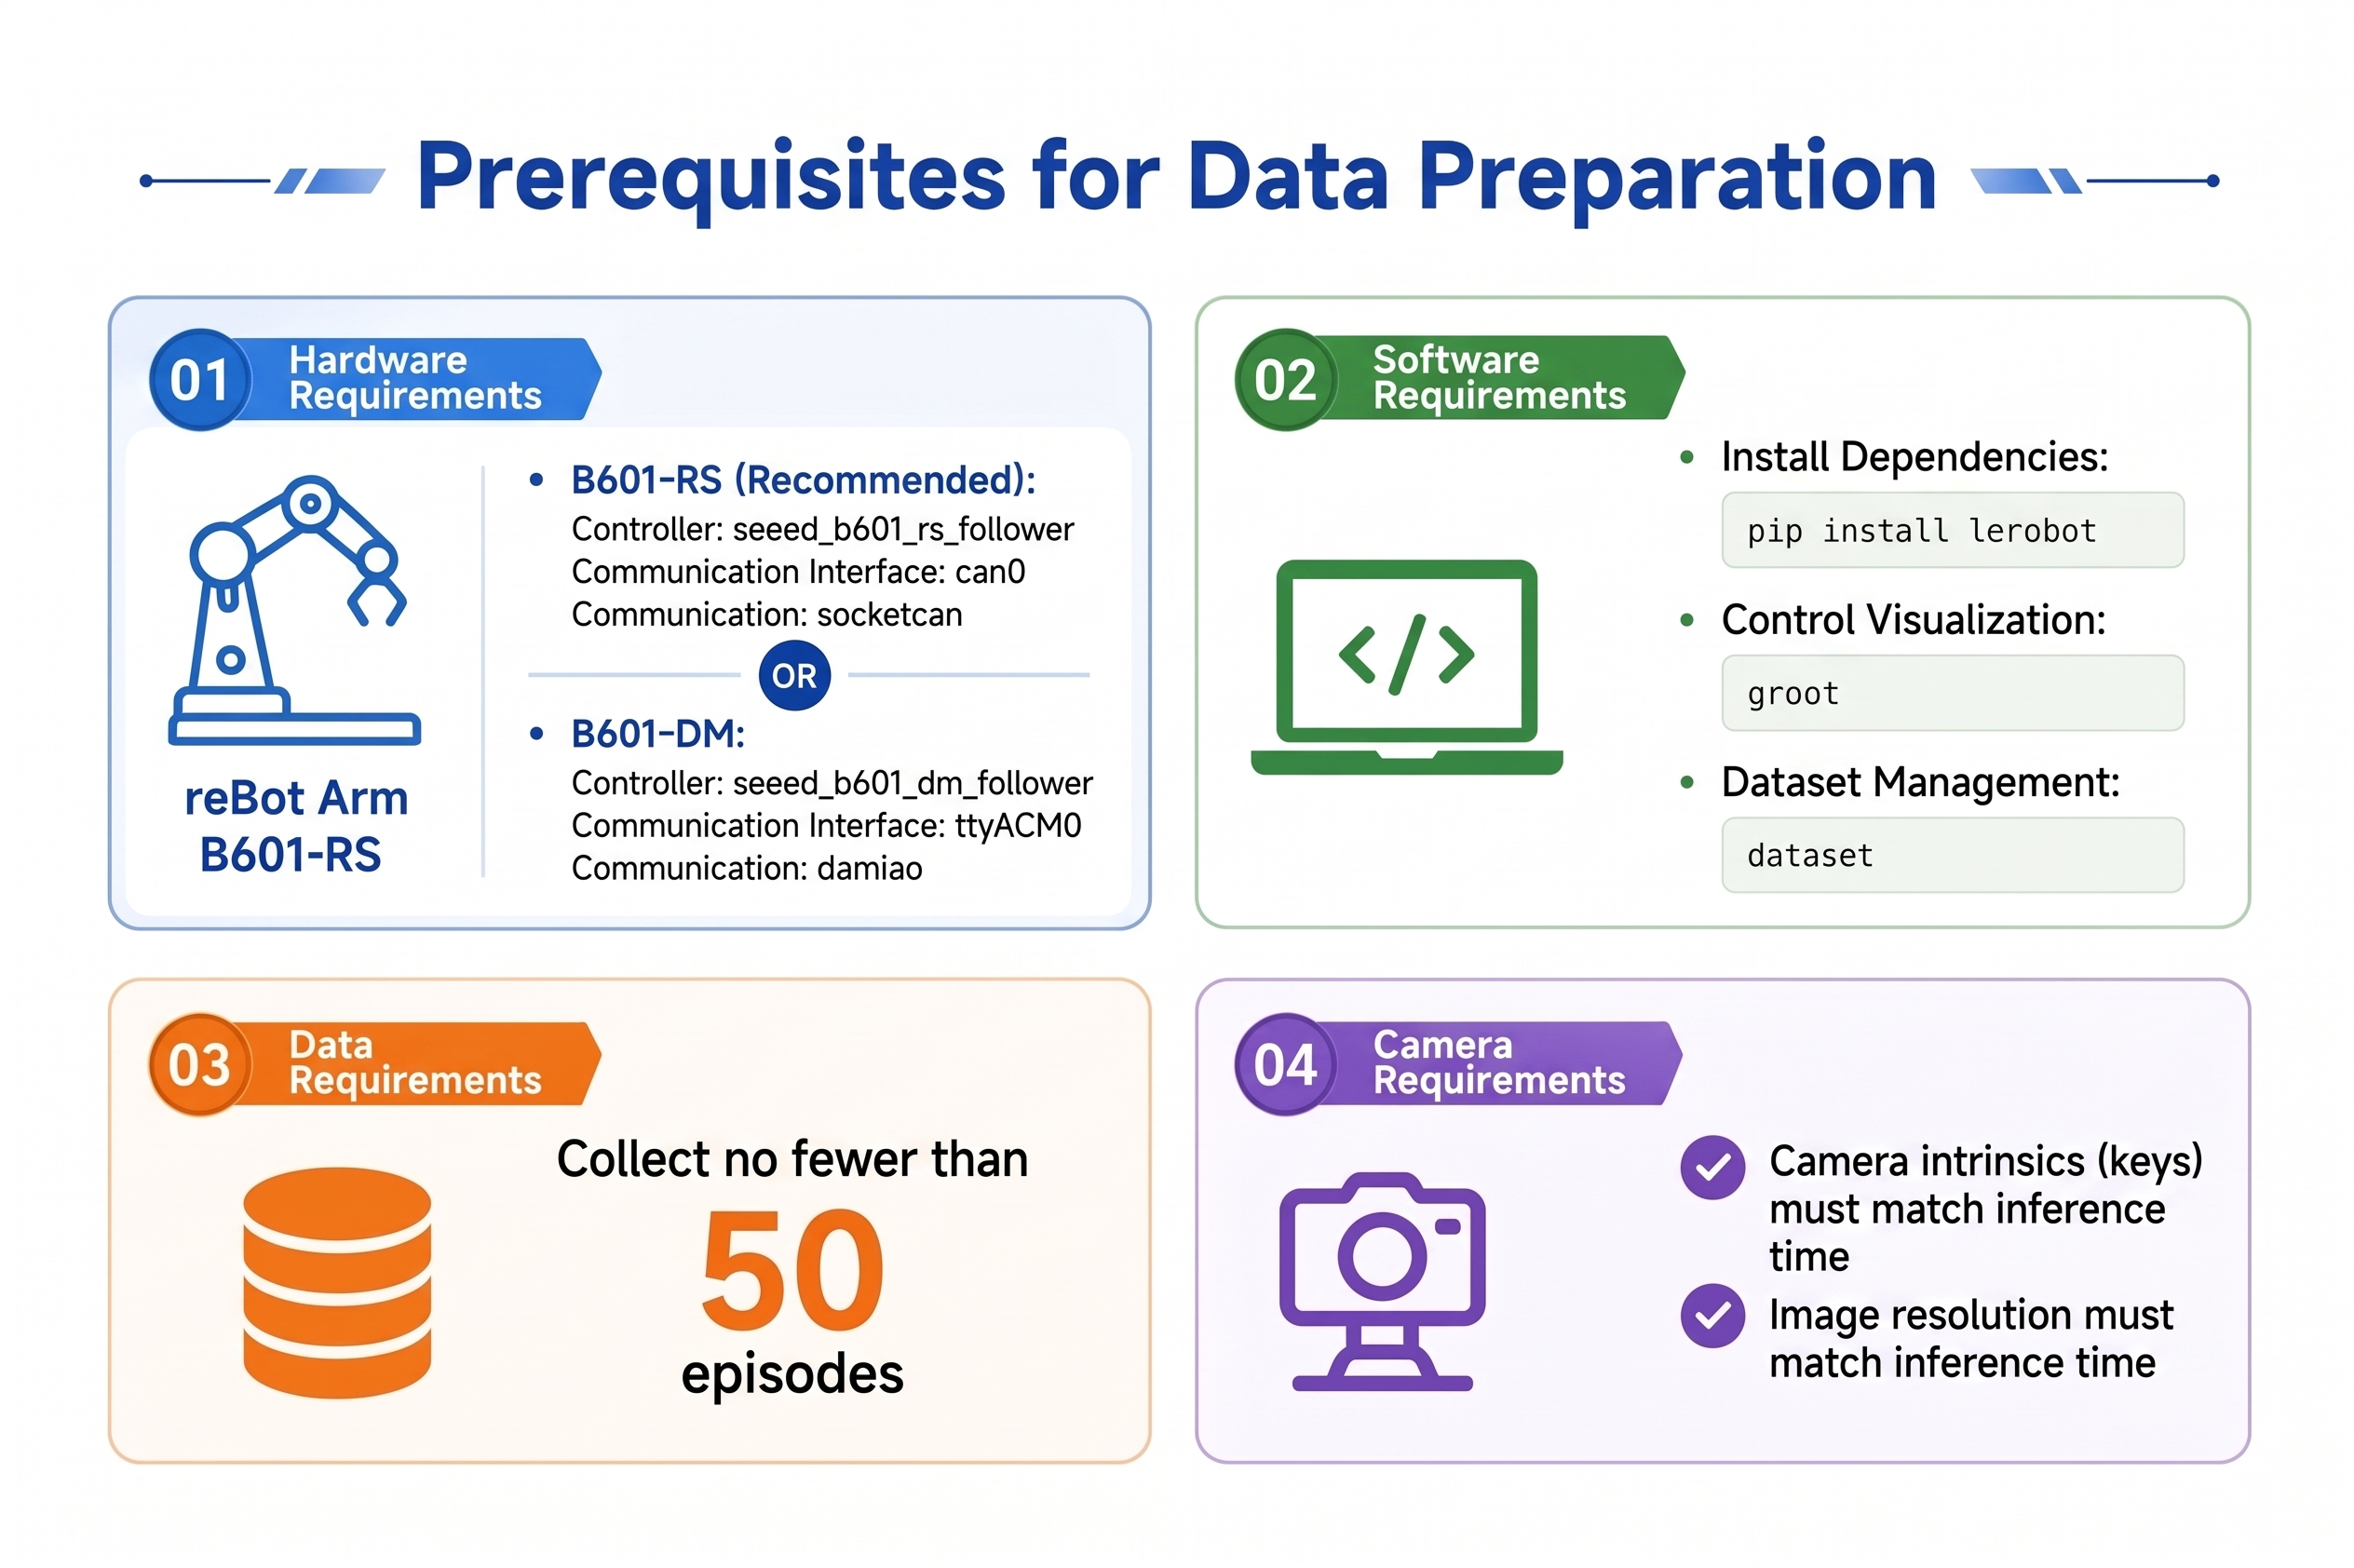
| ハードウェア | reBot Arm B601-RS または B601-DM がキャリブレーション済み(下表を参照) |
| ソフトウェア | LeRobot がインストール済み;推奨 pip install "lerobot[groot,training]" |
| データ | 1 つのタスクにつき少なくとも 50 個の成功デモ;マルチタスクの場合はタスクごとに 30 以上 |
| カメラ | 学習と推論で 同じキー名・解像度・台数 を使用すること |
モデルバリアントの参照(以降のすべての lerobot-record / lerobot-rollout で変更するのはこの 3 つのみ):
| バージョン | robot.type | robot.port | robot.can_adapter | Wiki |
|---|---|---|---|---|
| B601-RS | seeed_b601_rs_follower | can0 | socketcan | LeRobot 入門 |
| B601-DM | seeed_b601_dm_follower | /dev/ttyACM0 | damiao | LeRobot 入門 |
RS を使用する前に、CAN を設定します:sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up。テレオペ側は常に rebot_arm_102_leader であり、一般的にはポート /dev/ttyUSB0 に接続されています。
参考ドキュメント:
20.2 LeRobot データセットの確認
20.2 LeRobot データセットの確認
データセットのディレクトリ構造
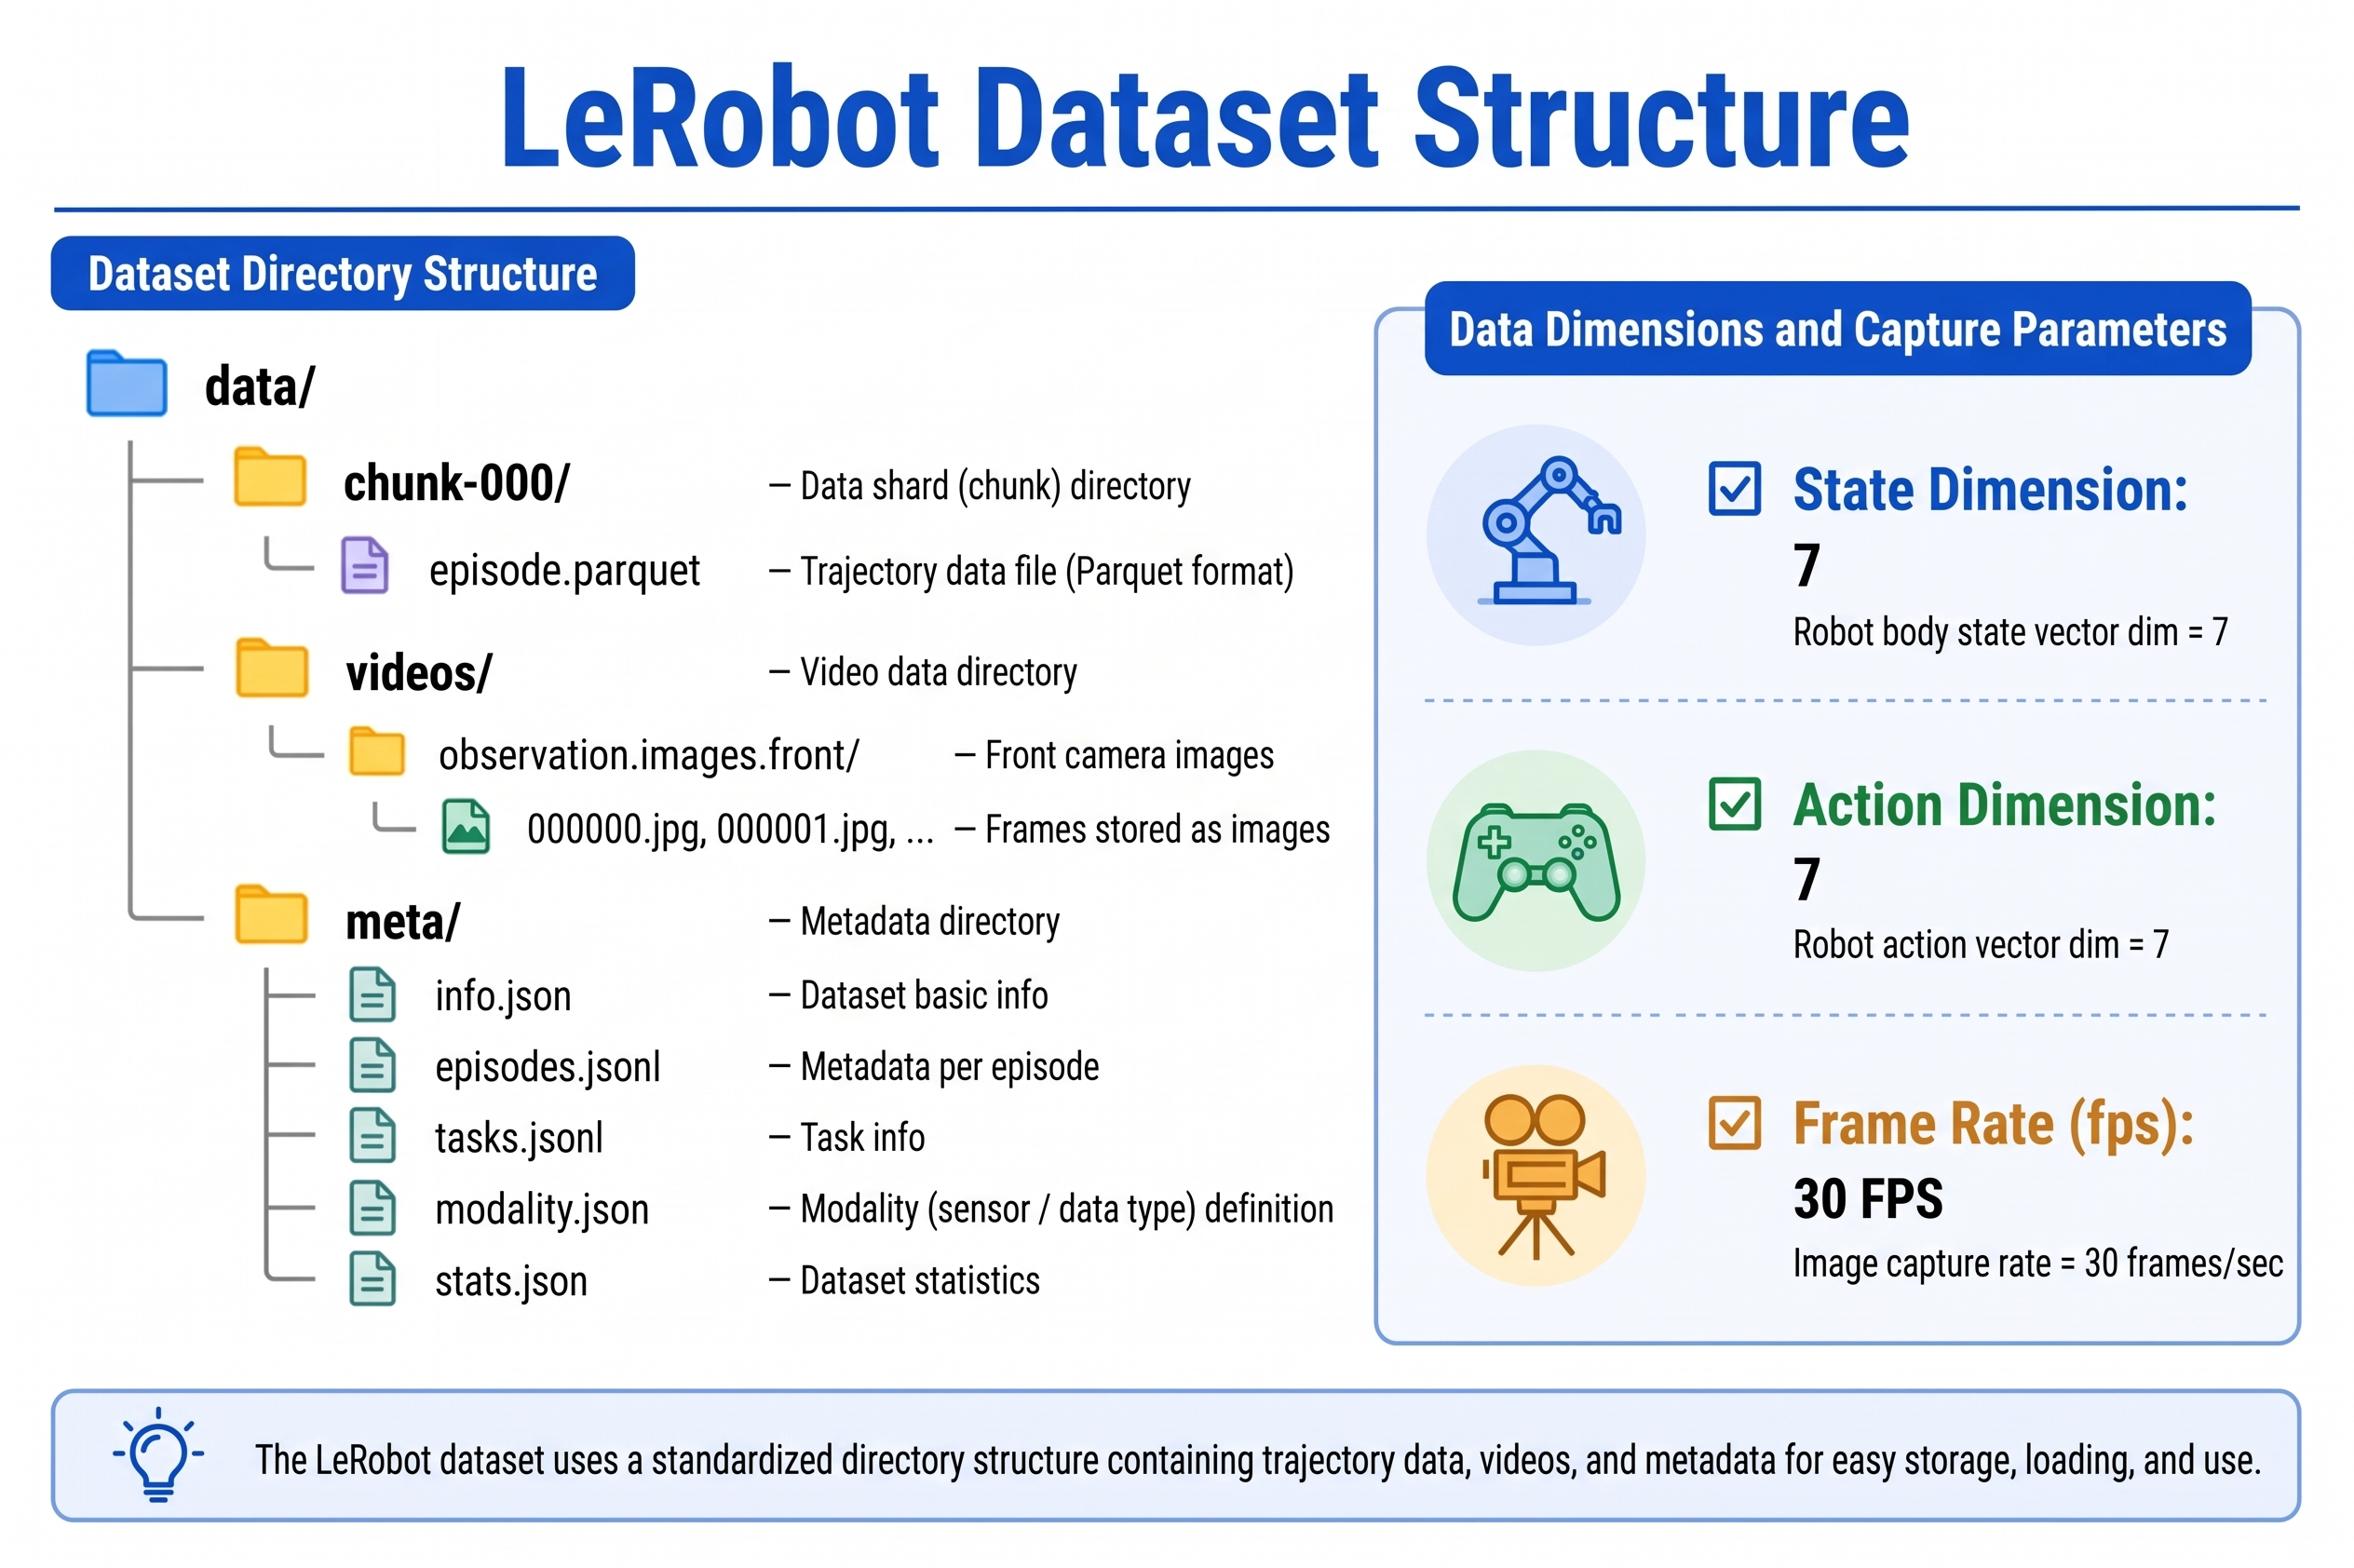
ローカルデータセットはデフォルトで次の場所にあります:
~/.cache/huggingface/lerobot/<repo_id>/
├── data/
│   └── chunk-000/
│       └── episode_*.parquet
├── videos/
│   └── chunk-000/
│       └── observation.images.<camera_name>/
├── meta/
│   ├── info.json
│   ├── episodes.jsonl
│   ├── tasks.jsonl          ← language task descriptions
│   ├── stats.json
│   └── modality.json        ← required by GR00T, create or verify manually
Python による簡易チェック
from lerobot.datasets.lerobot_dataset import LeRobotDataset

dataset = LeRobotDataset("seeed_rebot_b601_rs/pick_cube")  # RS example; for DM use seeed_rebot_b601_dm/pick_cube
print(dataset)
print("Feature keys:", dataset.features.keys())
print("Frame 0 state shape:", dataset[0]["observation.state"].shape)
print("Frame 0 action shape:", dataset[0]["action"].shape)
必須チェックリスト
| チェック項目 | 期待される値(reBot B601-RS / B601-DM 単腕) |
|---|---|
observation.state の次元 | (7,) - 6 関節 + 1 グリッパ |
action の次元 | (7,) - state と整合していること |
| ビデオキー | 例:observation.images.front、observation.images.side |
| FPS | 通常は 30 |
tasks.jsonl | すべての task_index に対応する言語記述があること |
| 失敗エピソード | 学習を汚染しないよう削除または除外マークを付ける |
state/action が 7 次元でない場合、記録時のロボット設定が誤っていたことを意味します;lerobot-record に戻ってトラブルシュートしてください。次元を埋めるために modality.json を無理に編集しないでください。
20.3 言語タスク記述の追加
20.3 言語タスク記述の追加
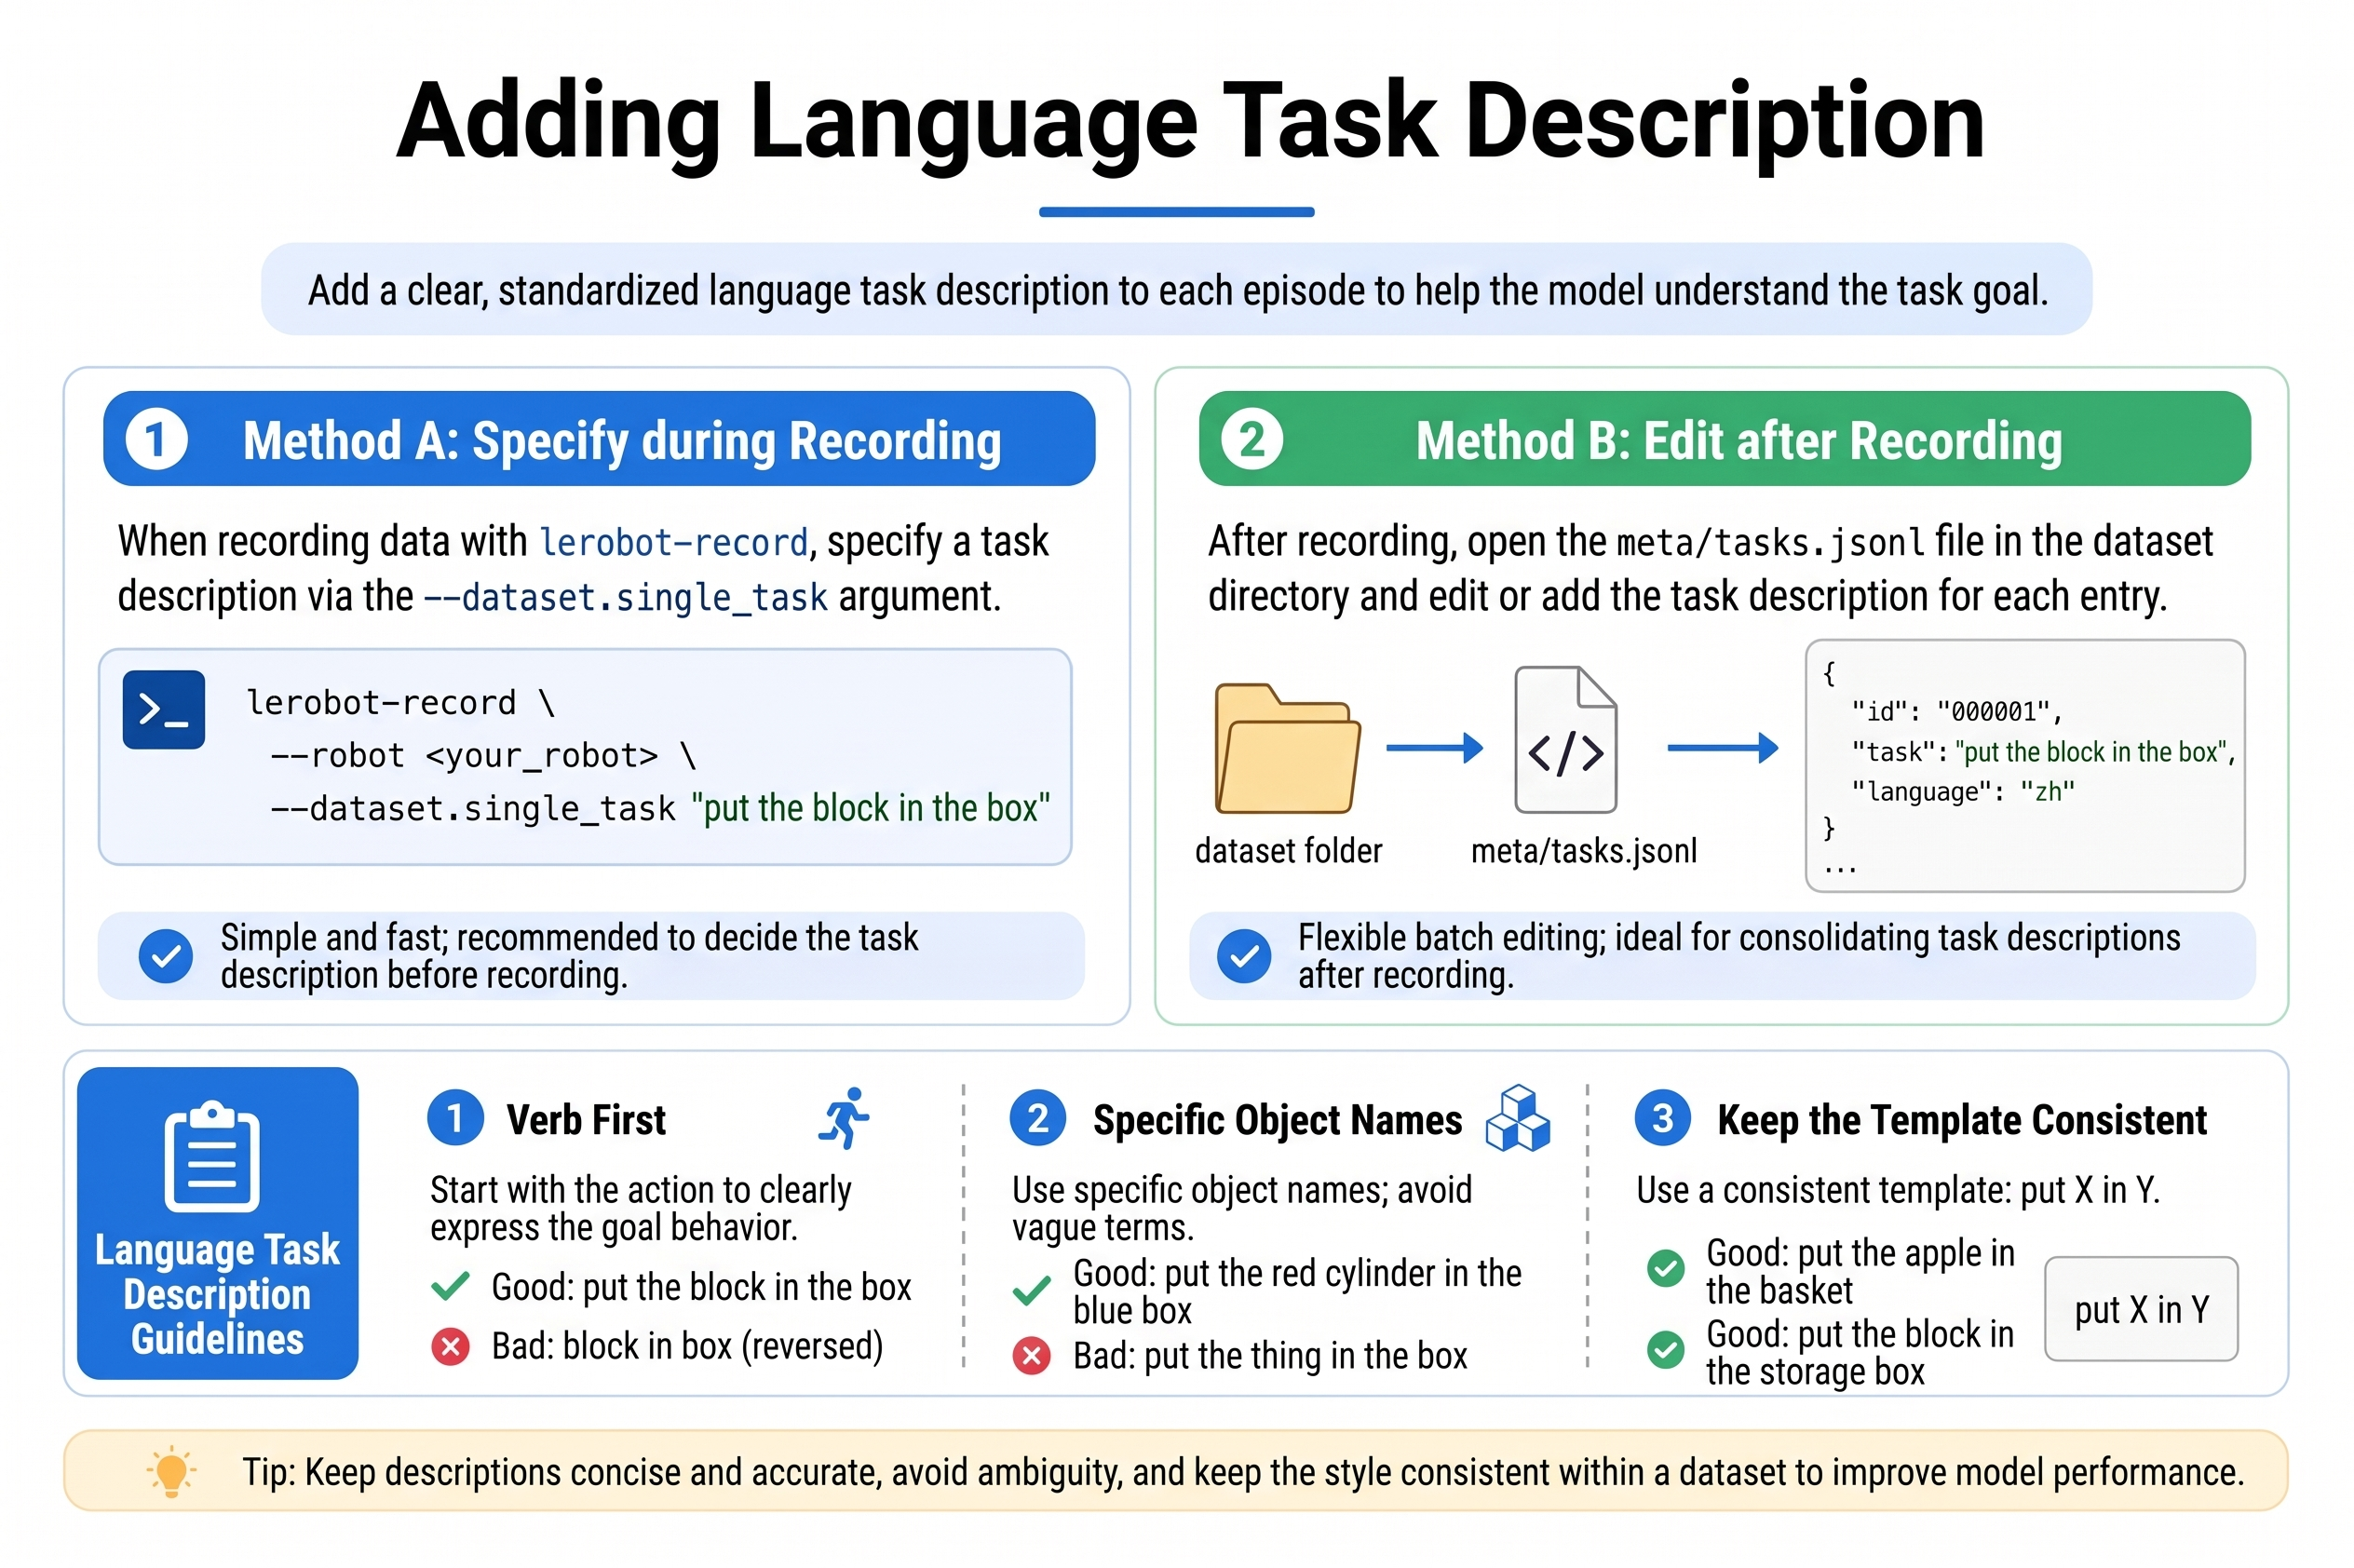
VLA 学習には、言語条件付けが必須です。方法は 2 つあります:
方法 A:記録時に直接書き込む(推奨)
各エピソードは --dataset.single_task 付きで記録します。以下では B601-RS を例に示します(Wiki)。DM ユーザーは type / port / can_adapter を seeed_b601_dm_follower、/dev/ttyACM0、damiao に置き換えてください。
# RS: bring up CAN first
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"}}" \
  --teleop.type=rebot_arm_102_leader \
  --teleop.port=/dev/ttyUSB0 \
  --teleop.id=rebot_arm_102_leader \
  --display_data=true \
  --dataset.repo_id=${HF_USER}/rebot_vla_pick_cube \
  --dataset.num_episodes=50 \
  --dataset.single_task="put the black cube on the blue tray" \
  --dataset.push_to_hub=false \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=20
方法 B:meta/tasks.jsonl を後から埋める
既存の ACT データに言語が含まれていない場合は、meta/tasks.jsonl を編集します:
{"task_index": 0, "task": "put the black cube on the blue tray"}
{"task_index": 1, "task": "put the screwdriver into the toolbox"}
マルチタスクデータセットでは、異なるエピソードが task_index フィールドを通じて異なる記述に関連付けられます。同じタスクのすべてのエピソードは同じ task_index を共有する必要があります。
言語アノテーションのガイドライン
- 動詞を先頭に、目標動作を記述する:"grasp..."、"place..."、"push..." など。
- 物体名を具体的に書く:「黒いキューブ」は「物体」よりも良い。
- **文型を統一する:**マルチタスクでは常に同じテンプレートを使う(例:常に「X を Y の上に置く」)。
- 中国語でも英語でも構いません が、学習と推論の間で言語は一貫させてください。
- 1 つのデータポイントに対して複数の言い回しを避ける(特に初期のファインチューニング段階)。
20.4 State キーと Action キーの設定
20.4 State キーと Action キーの設定
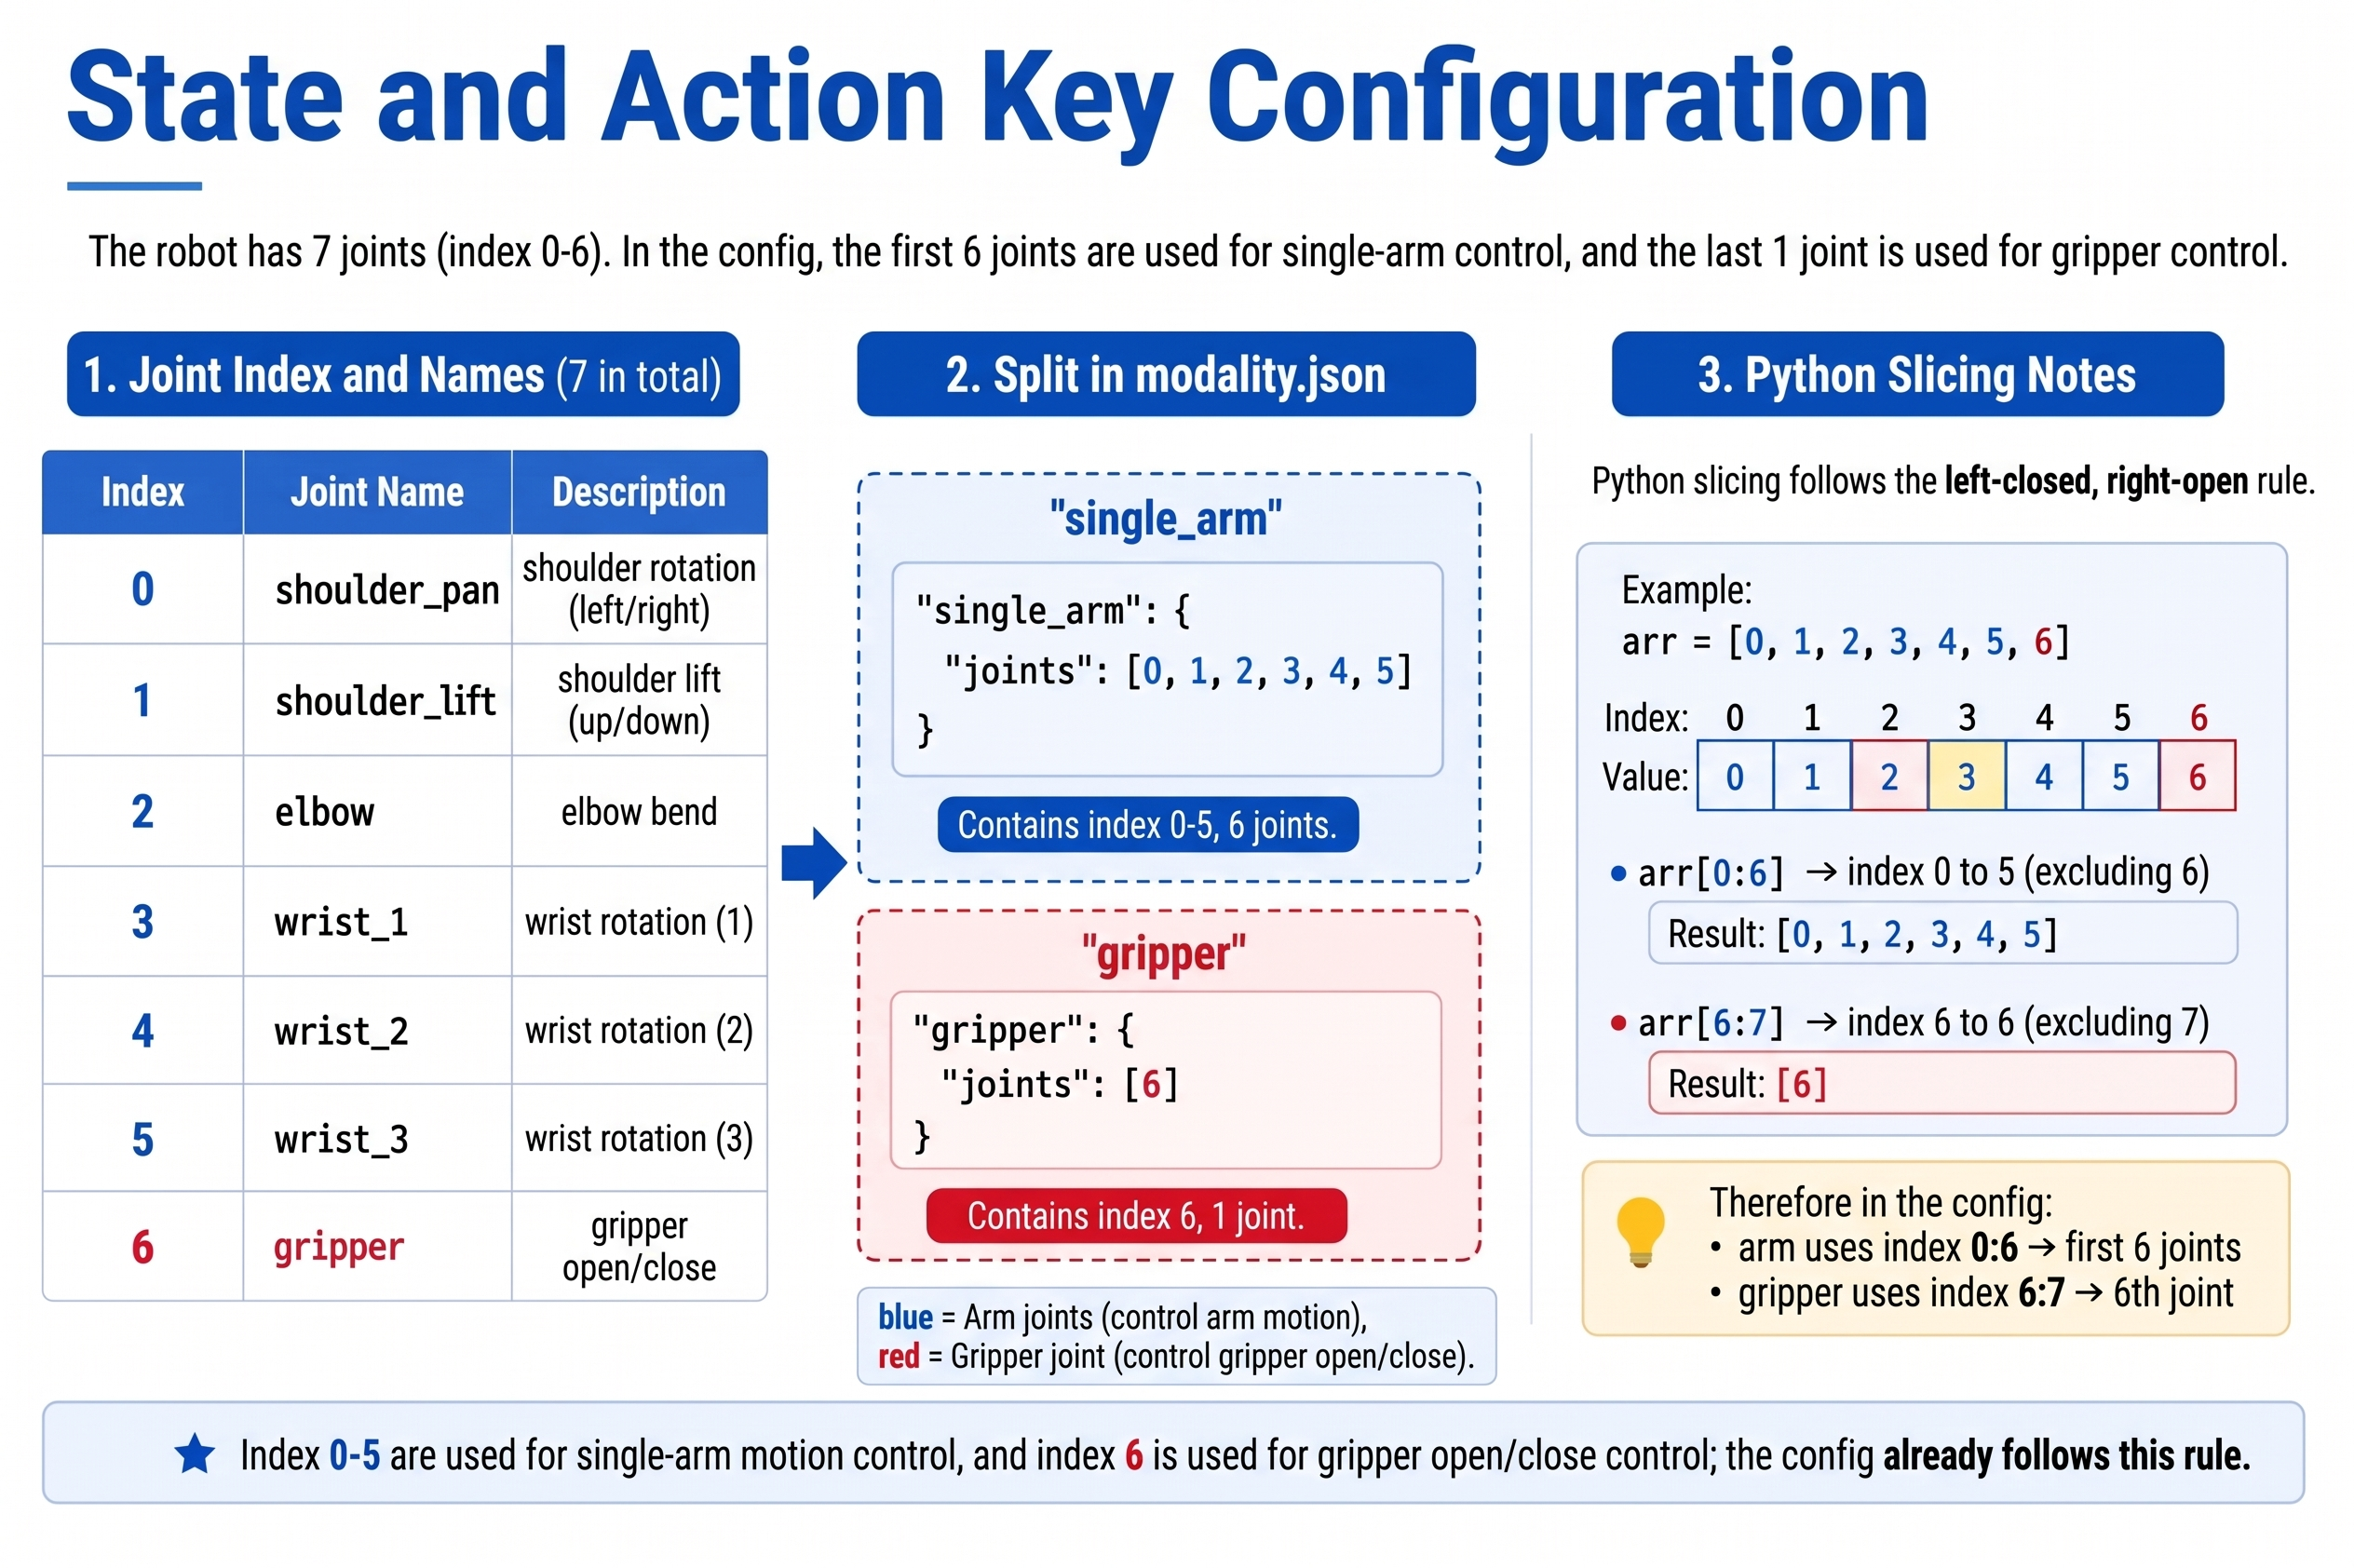
reBot Arm B601-RS / B601-DM の 7 次元ベクトルは、以下の関節順序で連結されています(LeRobot ドライバと一致):
| インデックス | キー名(セマンティクス) | 意味 |
|---|---|---|
| 0 | shoulder_pan | 肩の回転 |
| 1 | shoulder_lift | 肩のリフト |
| 2 | elbow_flex | 肘の屈曲 |
| 3 | wrist_flex | 手首の屈曲 |
| 4 | wrist_yaw | 手首のヨー |
| 5 | wrist_roll | 手首のロール |
| 6 | gripper | グリッパの開閉 |
GR00T の modality.json では、上記 7 次元を 2 つの意味的キーに分割します:
single_arm: インデックス 0-5(6 関節)gripper: インデックス 6(グリッパ)
Python のスライスは半開区間です:"end": 6 はインデックス 5 までを意味し、"start": 6, "end": 7 はインデックス 6 を意味します。
20.5 カメラキーの設定
20.5 カメラキーの設定
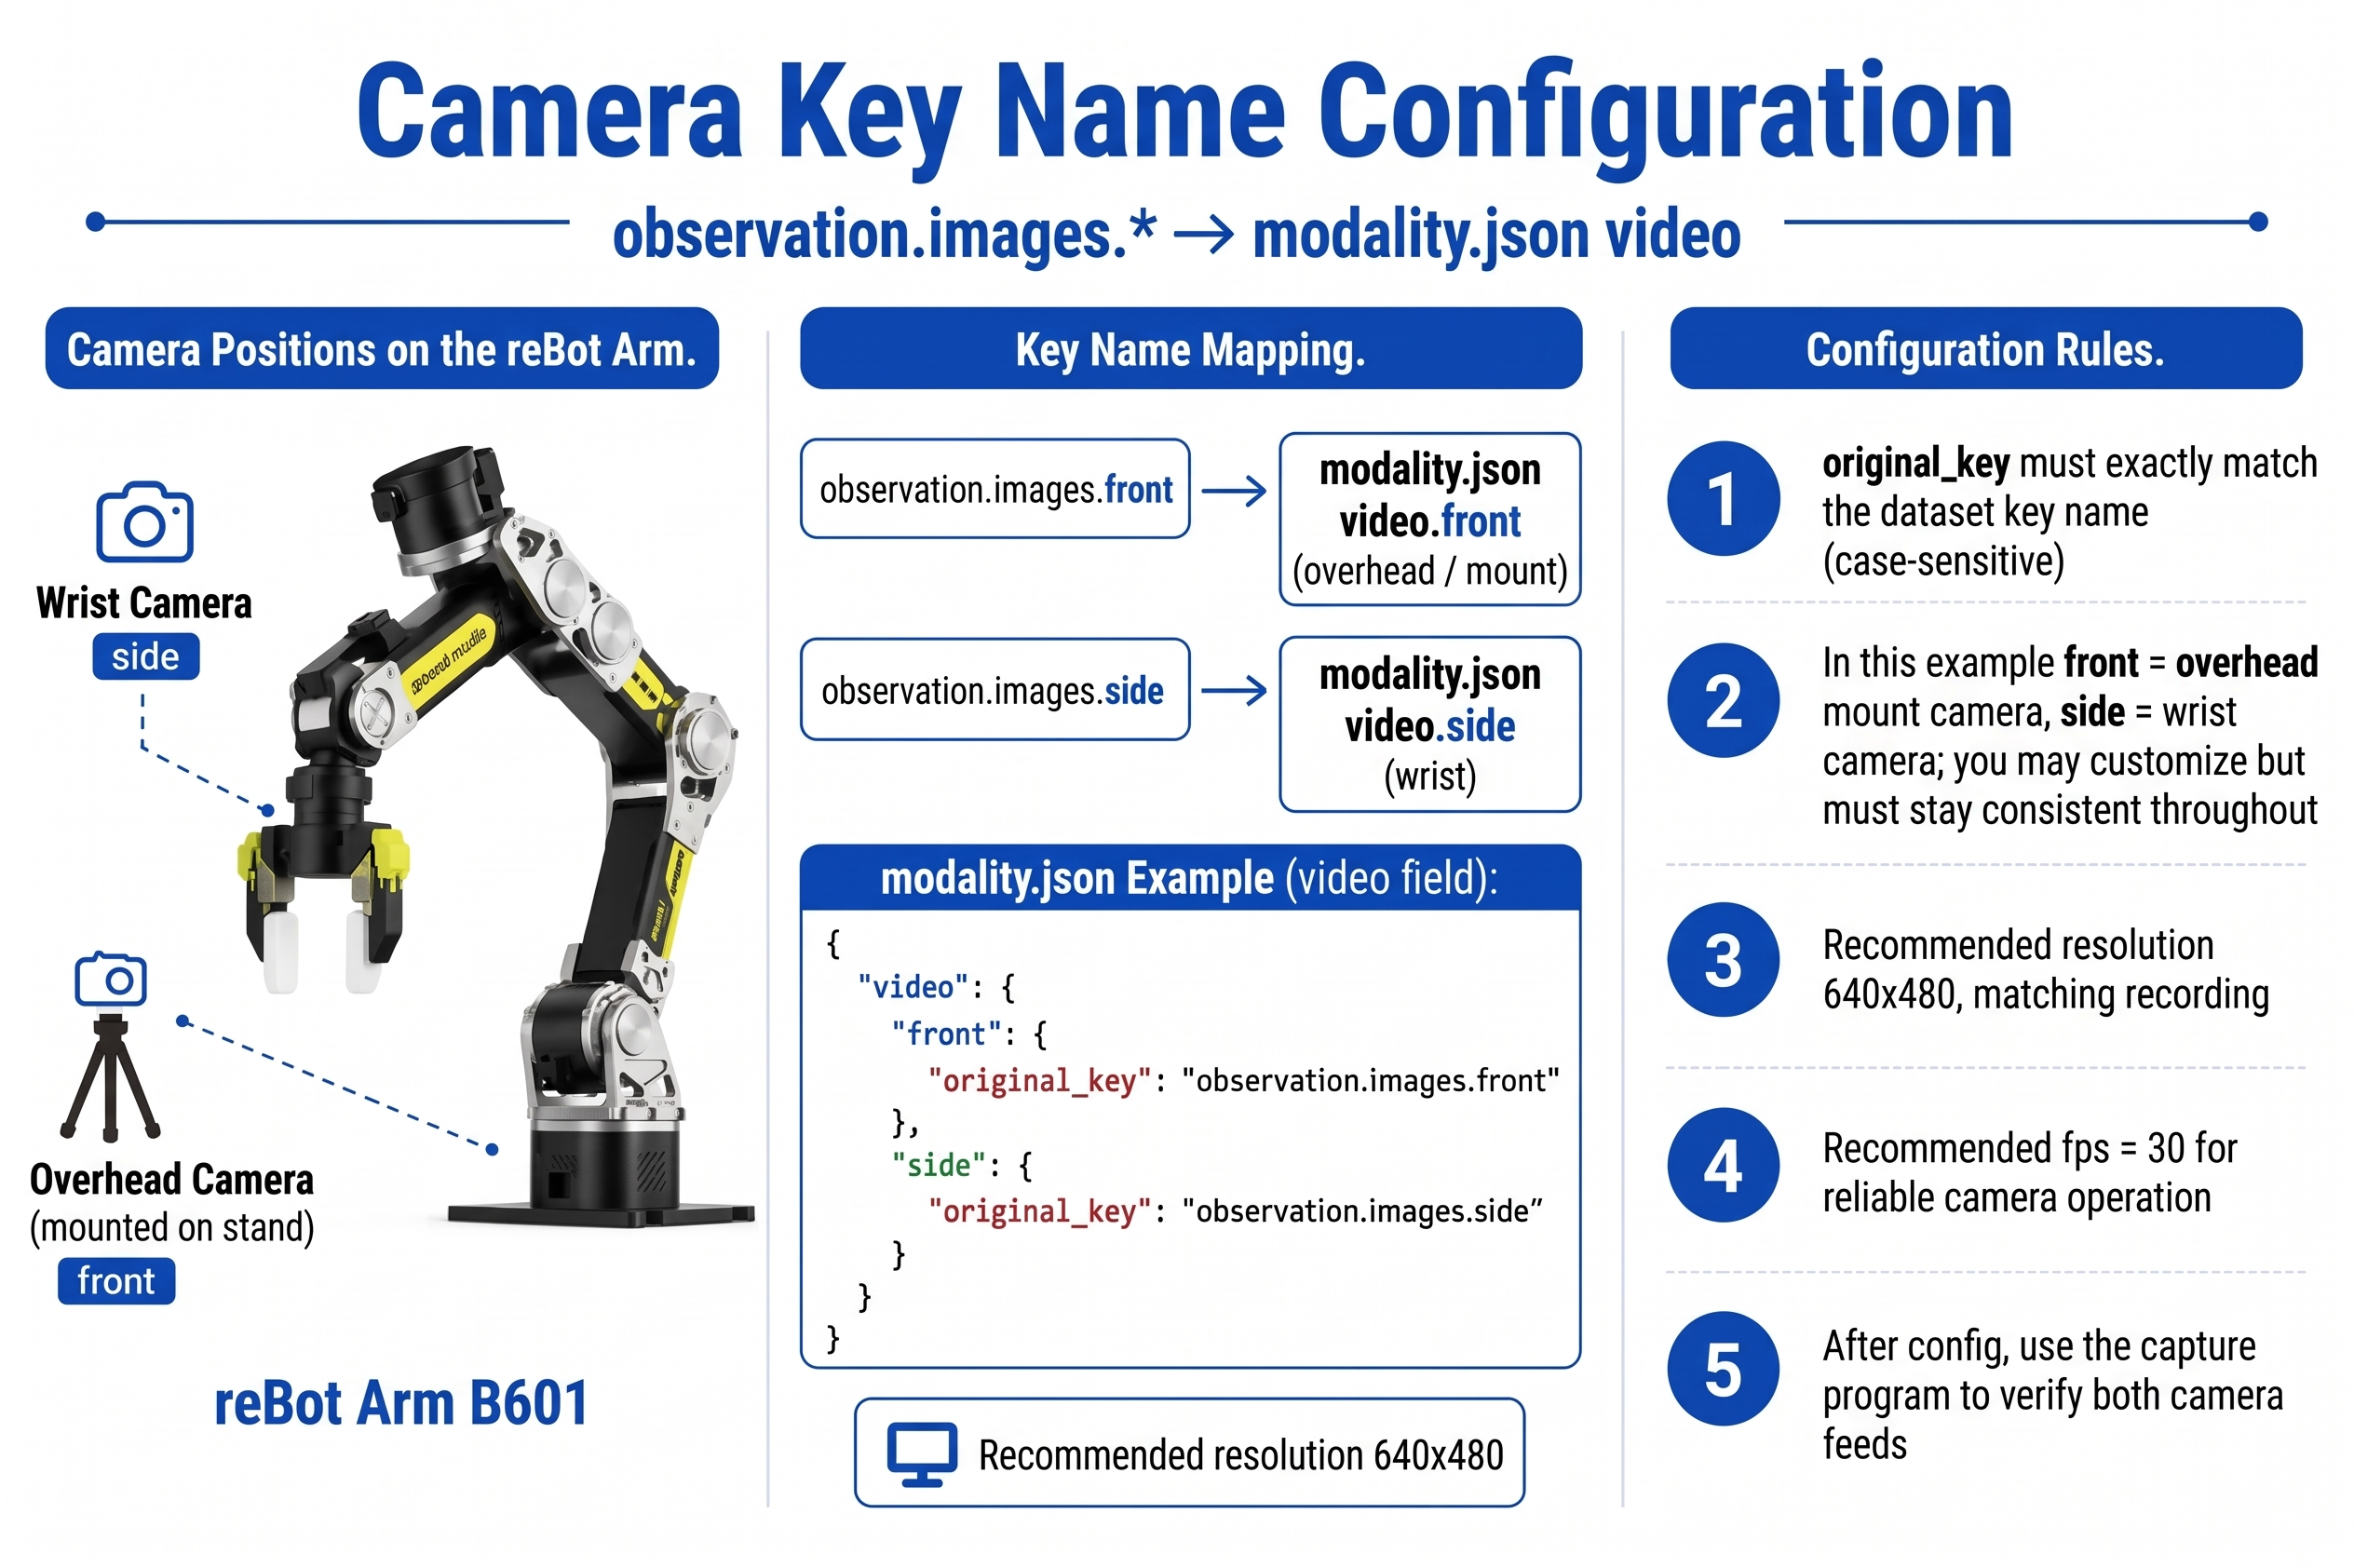
GR00T は、modality.json の video フィールドを通じて、データセット内の元のカメラキーを標準キー名にマッピングします。
一般的な reBot のカメラレイアウト
データセットキー(original_key) | Modality 標準キー | 推奨用途 |
|---|---|---|
observation.images.front | front | ブラケット取り付けの広角ビュー |
observation.images.side | side | 手首のクローズアップ |
例:記録時のカメラキーが front と side の場合:
"video": {
  "front": {
    "original_key": "observation.images.front"
  },
  "side": {
    "original_key": "observation.images.side"
  }
}
重要な原則:
original_keyは、データセット内の実際のキーと完全に一致している必要があります。- モダリティの左側にある標準キー(
front、side)は、学習と推論の両方で一貫して使用されます。 - 単一カメラでも学習は可能ですが、通常は 2 台のカメラの方が性能が良くなります。
- 推奨解像度は録画パラメータと同じ 640x480 で統一します。
ローカルカメラのインデックスを確認します:
lerobot-find-cameras opencv
20.6 meta/modality.json の作成
20.6 meta/modality.json の作成
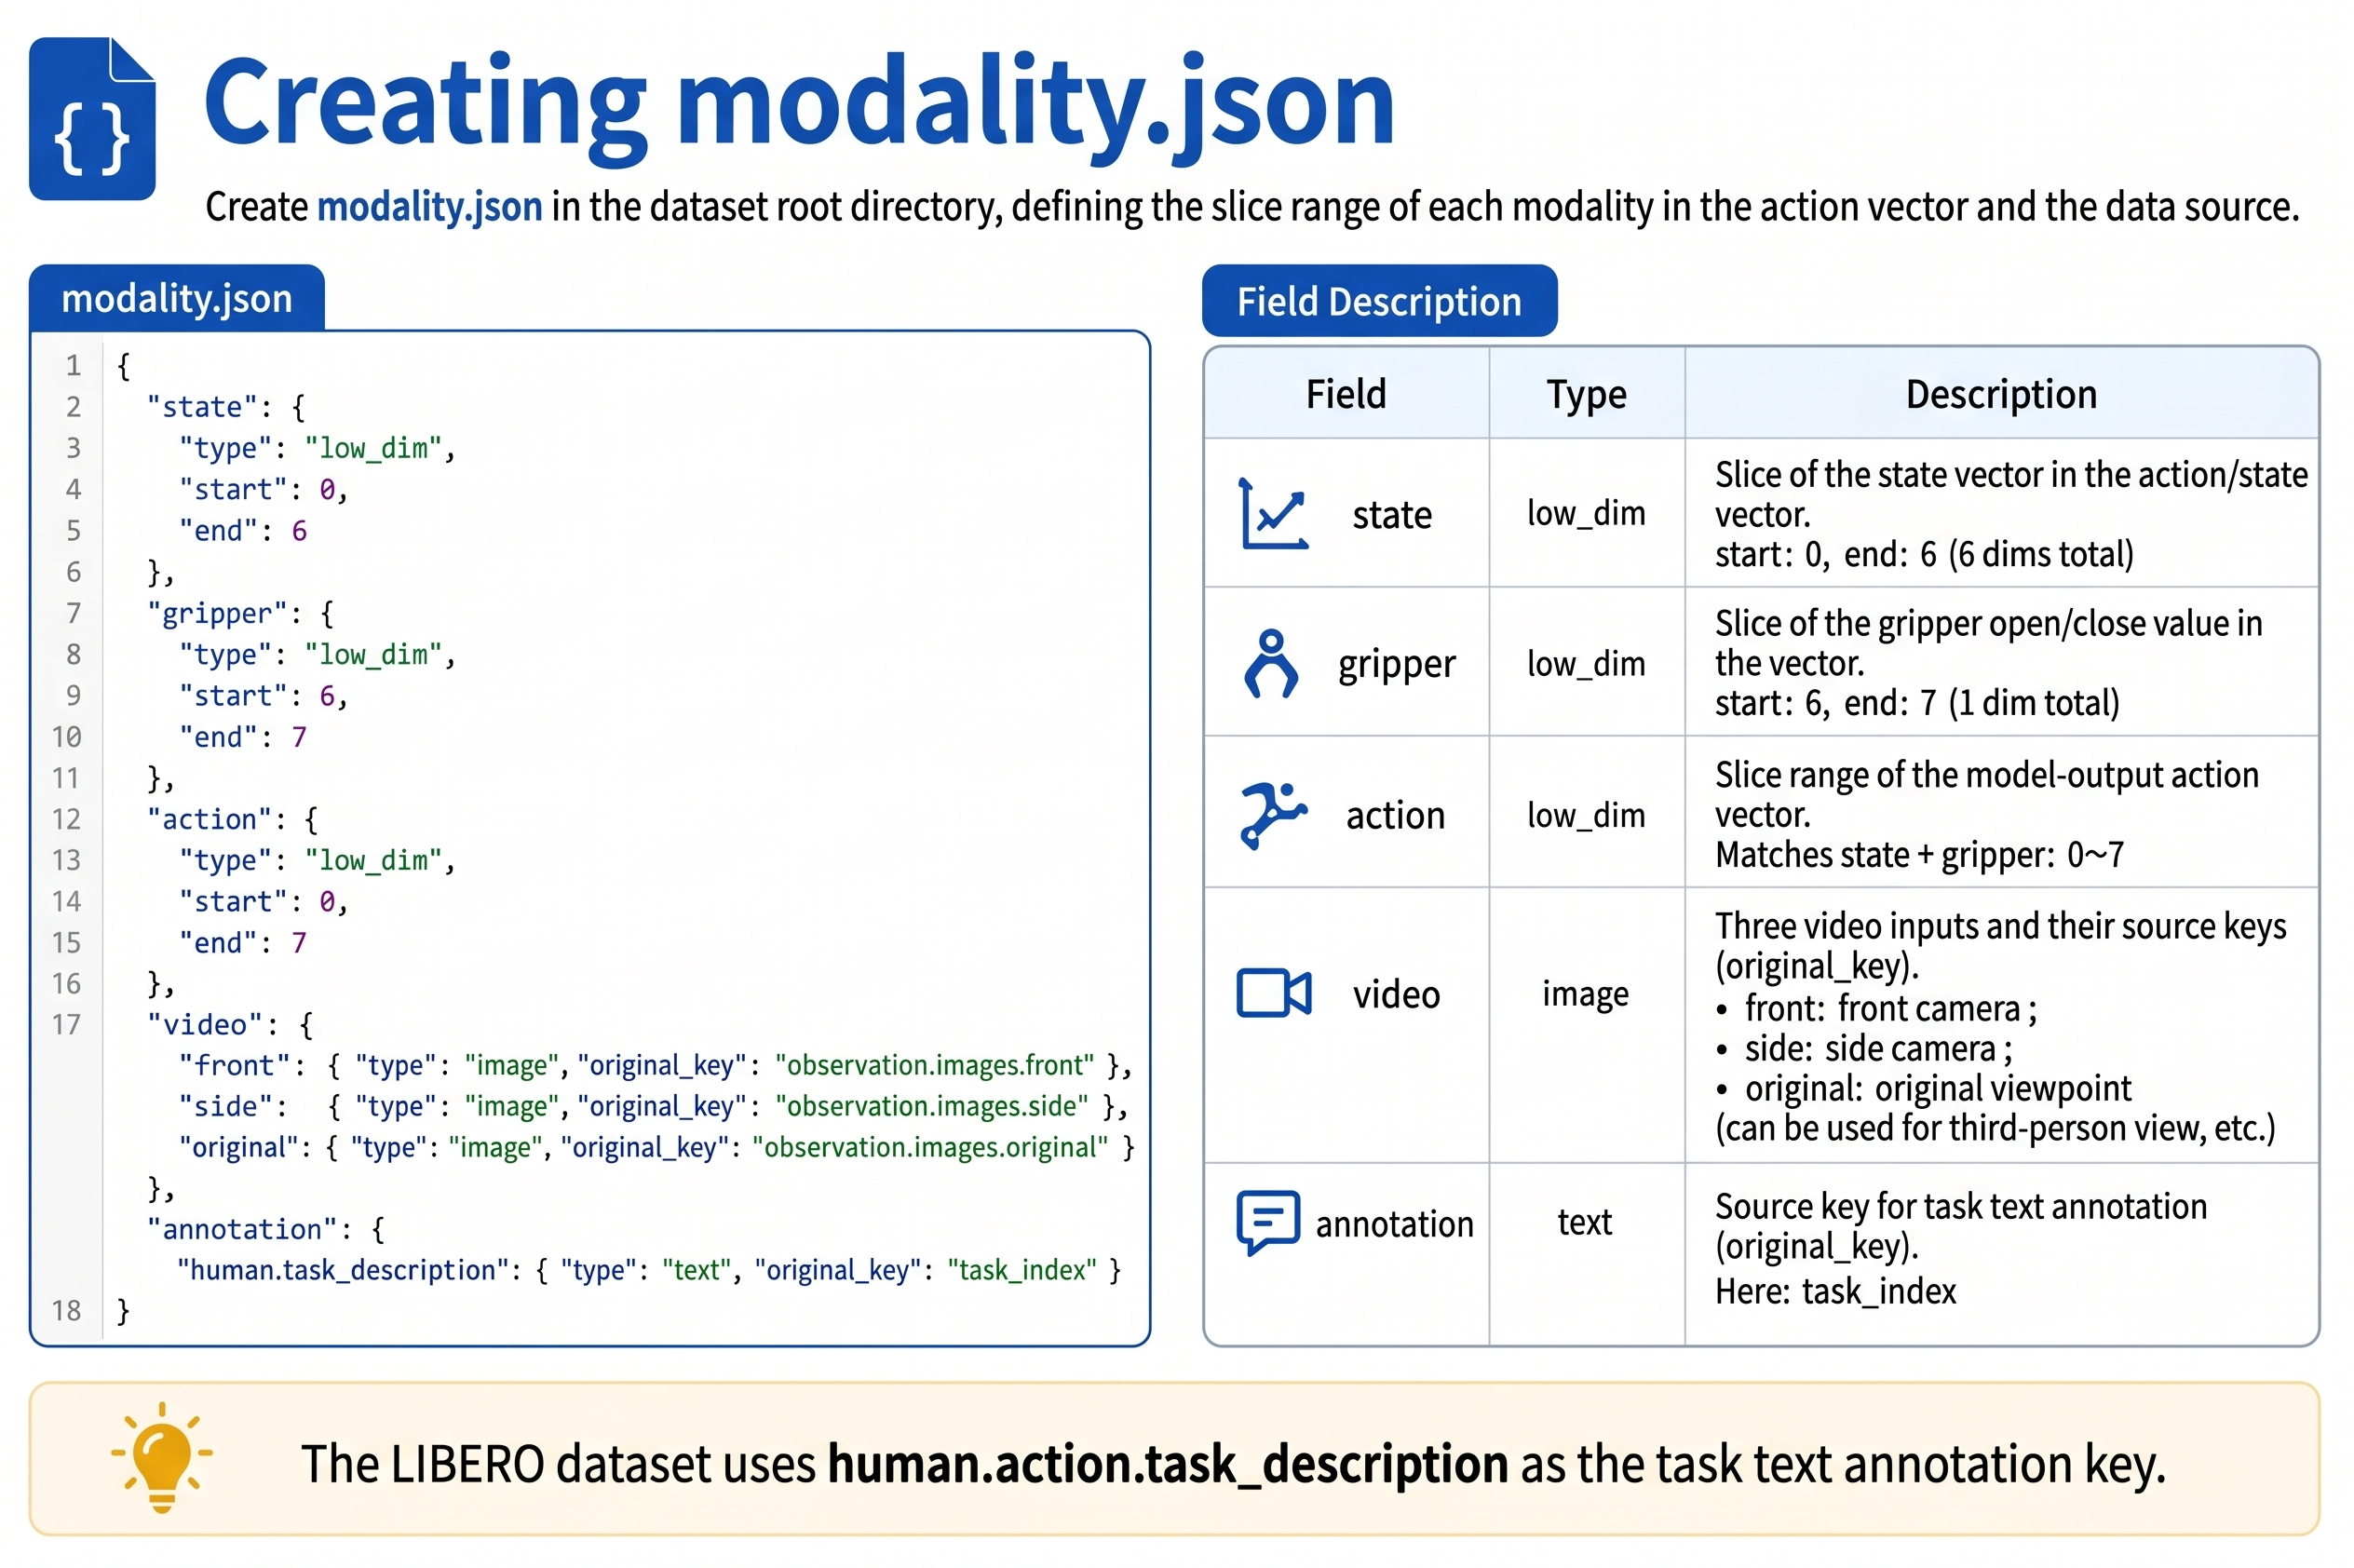
データセットの meta/ ディレクトリに modality.json を作成します。以下は reBot Arm B601 単腕 7 次元関節空間 の完全な例です(RS / DM でも同一です):
{
  "state": {
    "single_arm": {
      "start": 0,
      "end": 6
    },
    "gripper": {
      "start": 6,
      "end": 7
    }
  },
  "action": {
    "single_arm": {
      "start": 0,
      "end": 6
    },
    "gripper": {
      "start": 6,
      "end": 7
    }
  },
  "video": {
    "front": {
      "original_key": "observation.images.front"
    },
    "side": {
      "original_key": "observation.images.side"
    }
  },
  "annotation": {
    "human.task_description": {
      "original_key": "task_index"
    }
  }
}
フィールドの説明
| フィールド | 目的 |
|---|---|
state / action | 連結ベクトル内の各セグメントのインデックス範囲を定義します |
video | LeRobot の動画キーを GR00T の標準カメラ名にマッピングします |
annotation | task_index を tasks.jsonl と関連付けます。reBot は human.task_description を使用し、LIBERO / SimplerEnv は human.action.task_description を使用します |
データセットにタスクが 1 つしかなく、task_index フィールドがない場合は、まず lerobot-record が tasks.jsonl を書き出していることを確認してください。そうでないと GR00T は言語条件を読み取れません。
20.7 Embodiment タグの設定
20.7 Embodiment タグの設定
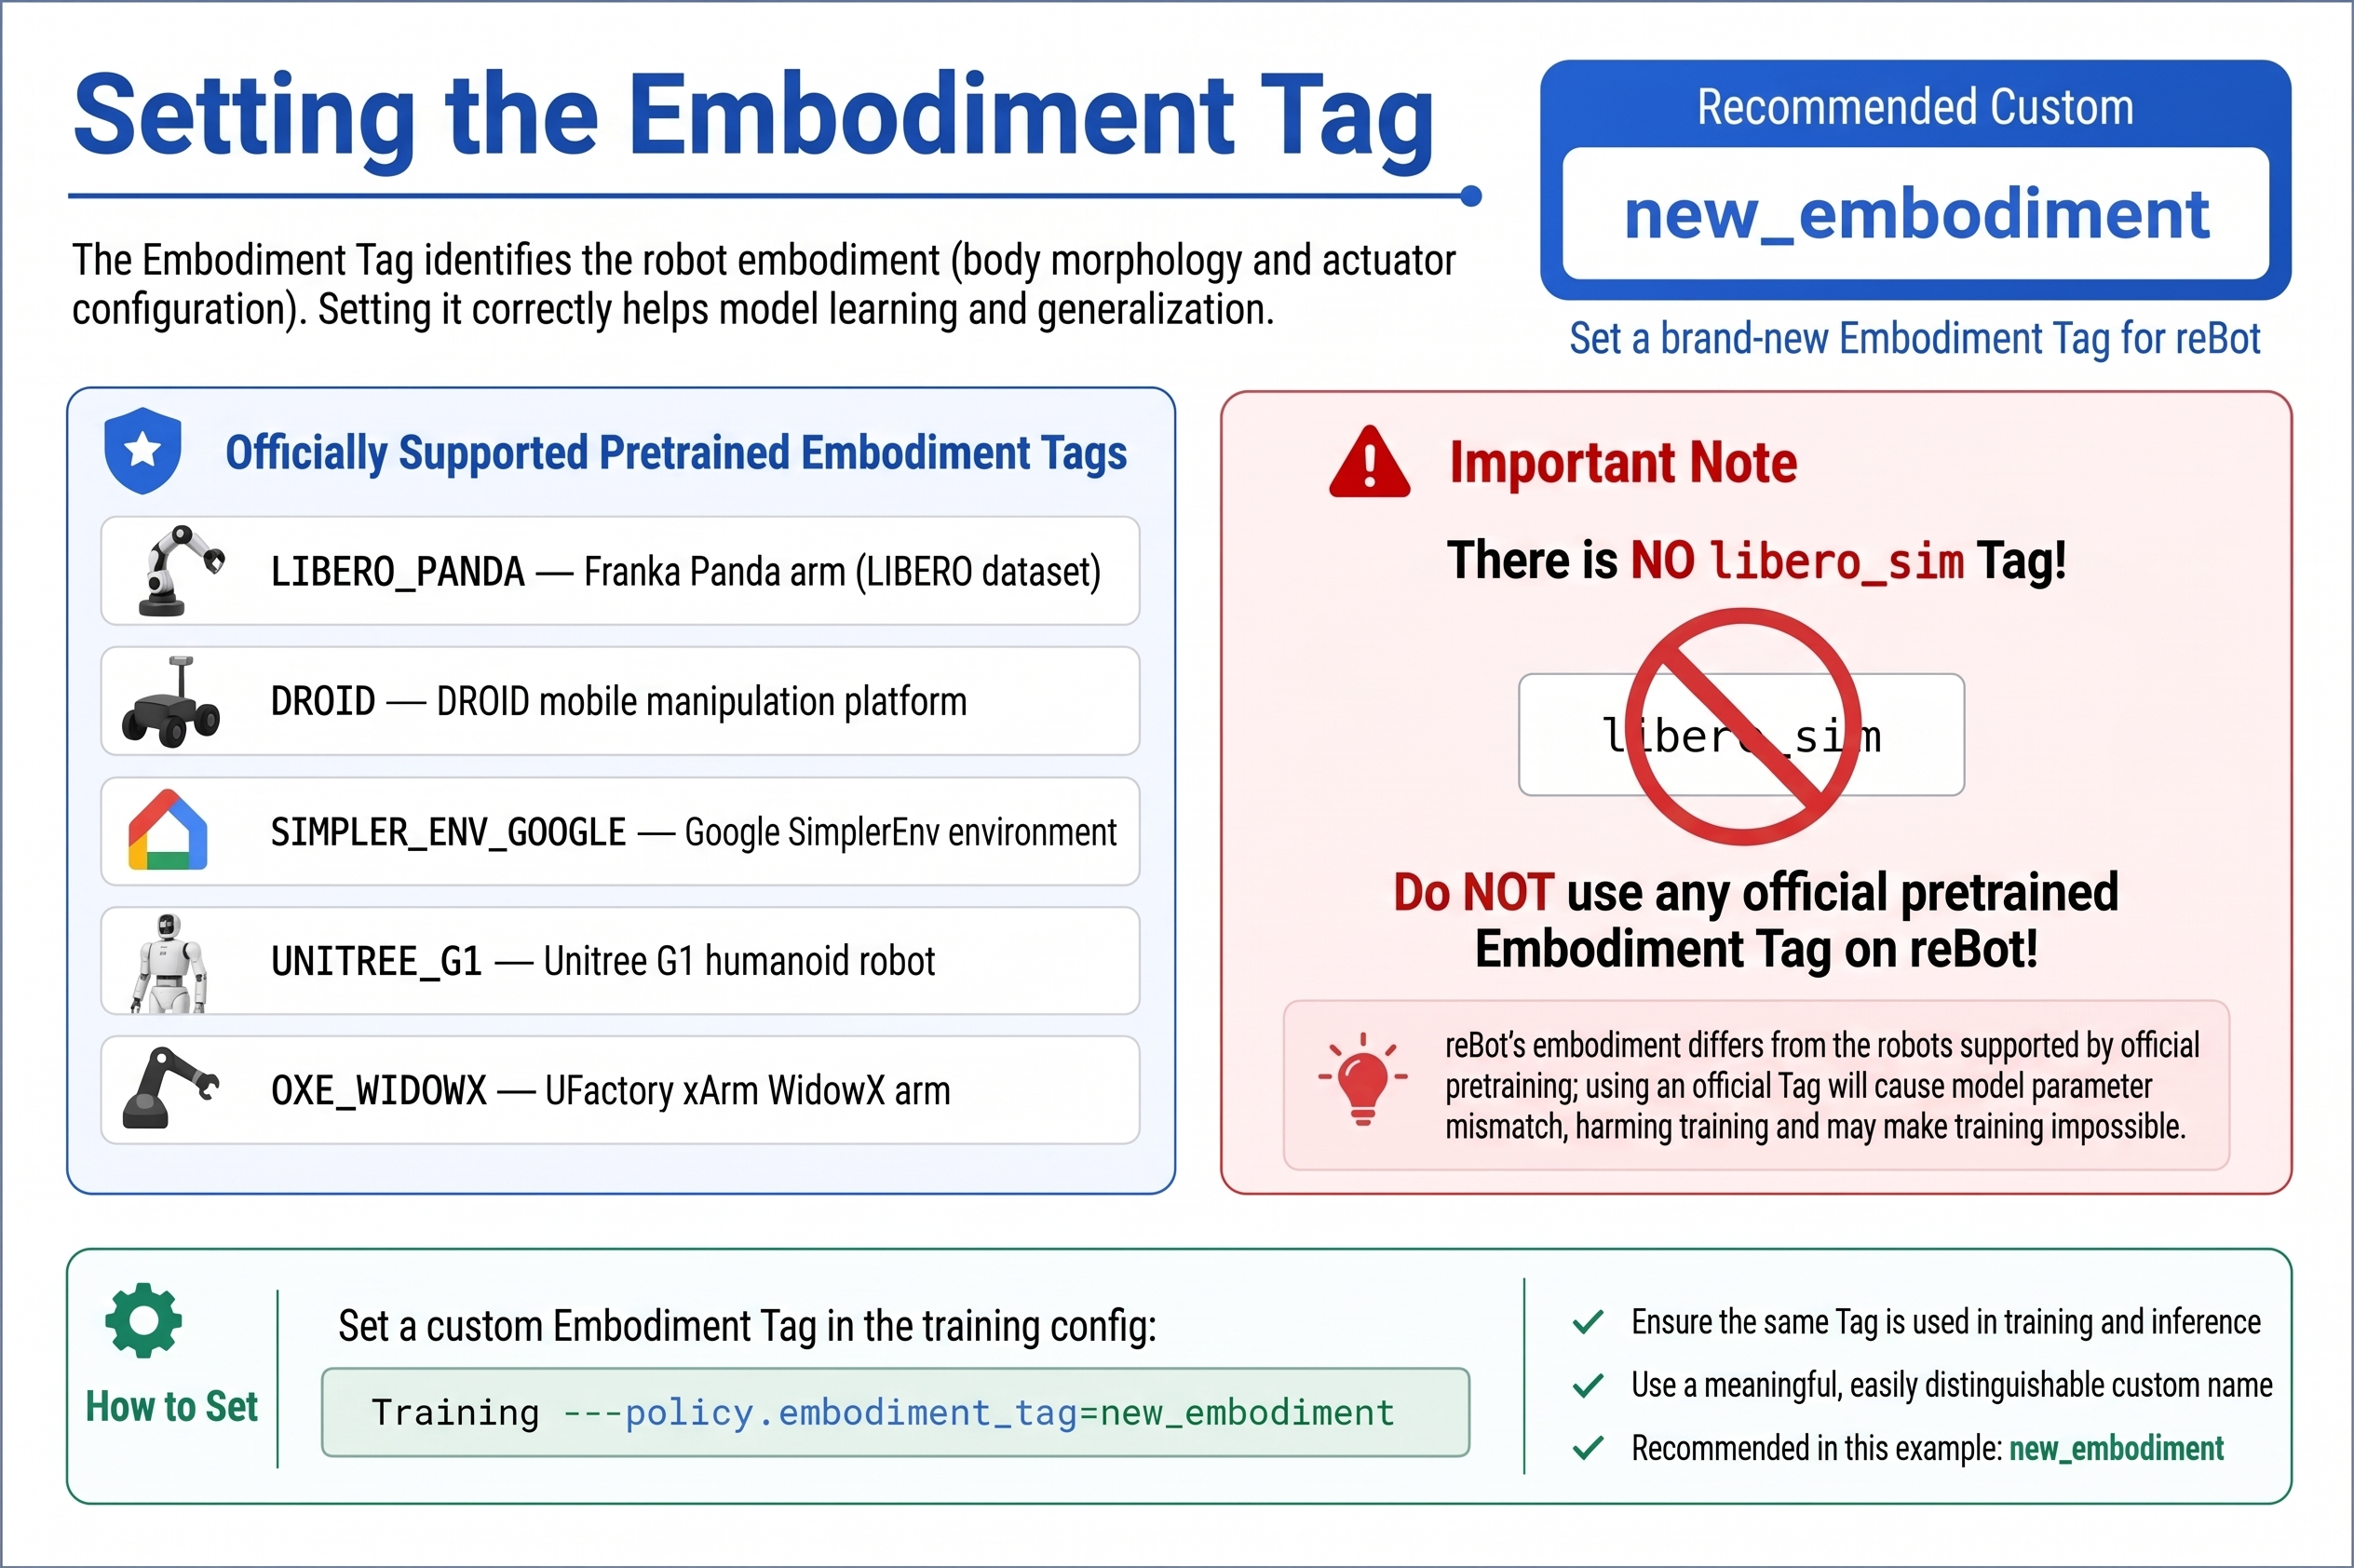
reBot Arm のようなカスタムロボットでは、学習と推論の両方で同じ設定を使用します:
embodiment_tag = new_embodiment
意味:
- GR00T に対して、事前学習済みヒューマノイドの state/action 次元を再利用せず、new-embodiment 射影レイヤを使用するよう指示します。
- LeRobot の学習パラメータ:
--policy.embodiment_tag=new_embodiment。 - ファインチューニングされたチェックポイントには対応するモダリティ設定が保存され、推論時に自動的に読み込まれます。
reBot のデータに対して LIBERO_PANDA、DROID、SIMPLER_ENV_GOOGLE などの事前学習タグを使用しないでください。これらの state/action の次元と意味は reBot と一致しません。また、libero_sim という公式タグも存在しません。
20.8 関節順序とデータ次元の確認
20.8 関節順序とデータ次元の確認
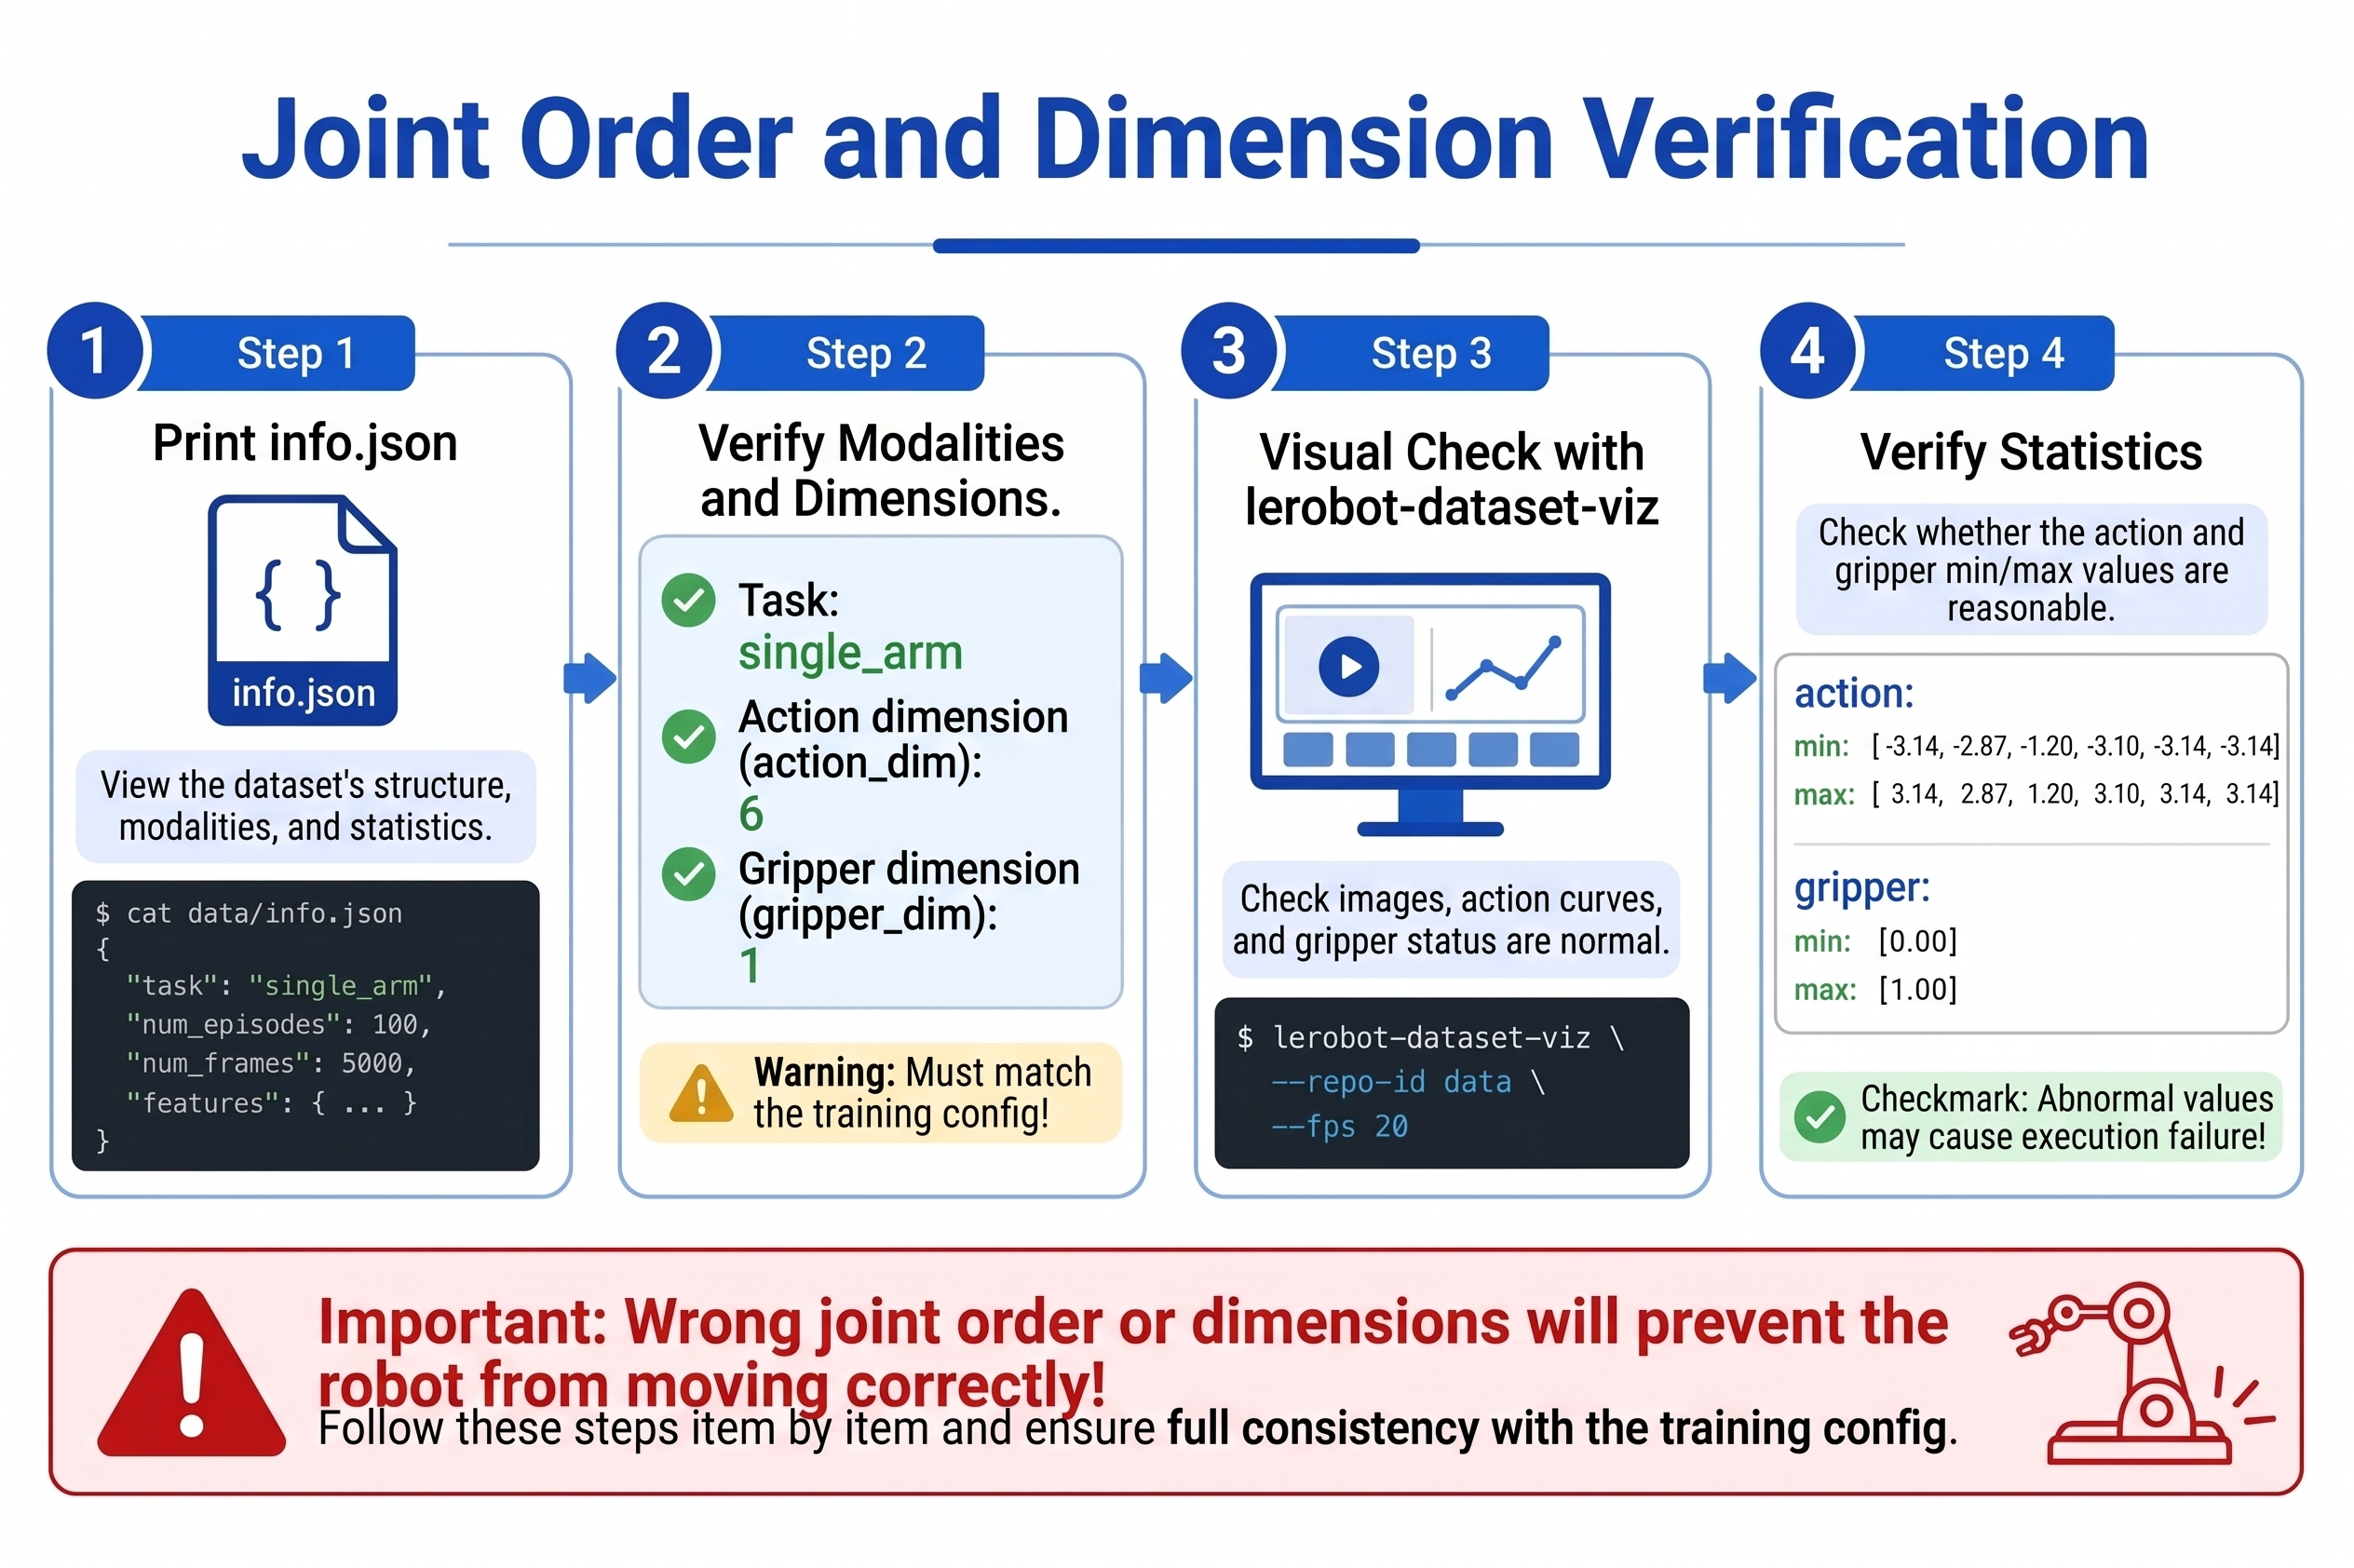
これは「学習損失は減少しているのに、実機ロボットがまったく動かない」という最も一般的な原因です。以下を項目ごとに確認してください:
ステップ 1:データセットのメタ情報を出力
import json
from pathlib import Path

meta_dir = Path.home() / ".cache/huggingface/lerobot/seeed_rebot_b601_rs/pick_cube/meta"
print(json.dumps(json.loads((meta_dir / "info.json").read_text()), indent=2))
print((meta_dir / "modality.json").read_text())
ステップ 2:モダリティのスライスを検証
import numpy as np
from lerobot.datasets.lerobot_dataset import LeRobotDataset

ds = LeRobotDataset("seeed_rebot_b601_rs/pick_cube")
s = ds[0]["observation.state"].numpy()
mod = json.loads((meta_dir / "modality.json").read_text())

arm = s[mod["state"]["single_arm"]["start"]:mod["state"]["single_arm"]["end"]]
grip = s[mod["state"]["gripper"]["start"]:mod["state"]["gripper"]["end"]]
print("single_arm:", arm.shape)  # expect (6,)
print("gripper:", grip.shape)    # expect (1,)
ステップ 3:データを可視化
lerobot-dataset-viz --repo_id=seeed_rebot_b601_rs/pick_cube --episode-index=0
観察ポイント:
- 画像は関節の動きと同期していますか?
- グリッパーの開閉に応じて
gripper次元は変化していますか? - 言語記述は視覚内容と一致していますか?
ステップ 4:統計的チェック
print(ds.meta.stats["observation.state"])
print(ds.meta.stats["action"])
ある次元で min == max(変動なし)となっている場合、その関節はデータ中で動いていません。学習から除外するか、データを取り直すことを検討してください。
20.9 マルチタスクデータセットの構成
20.9 マルチタスクデータセットの構成
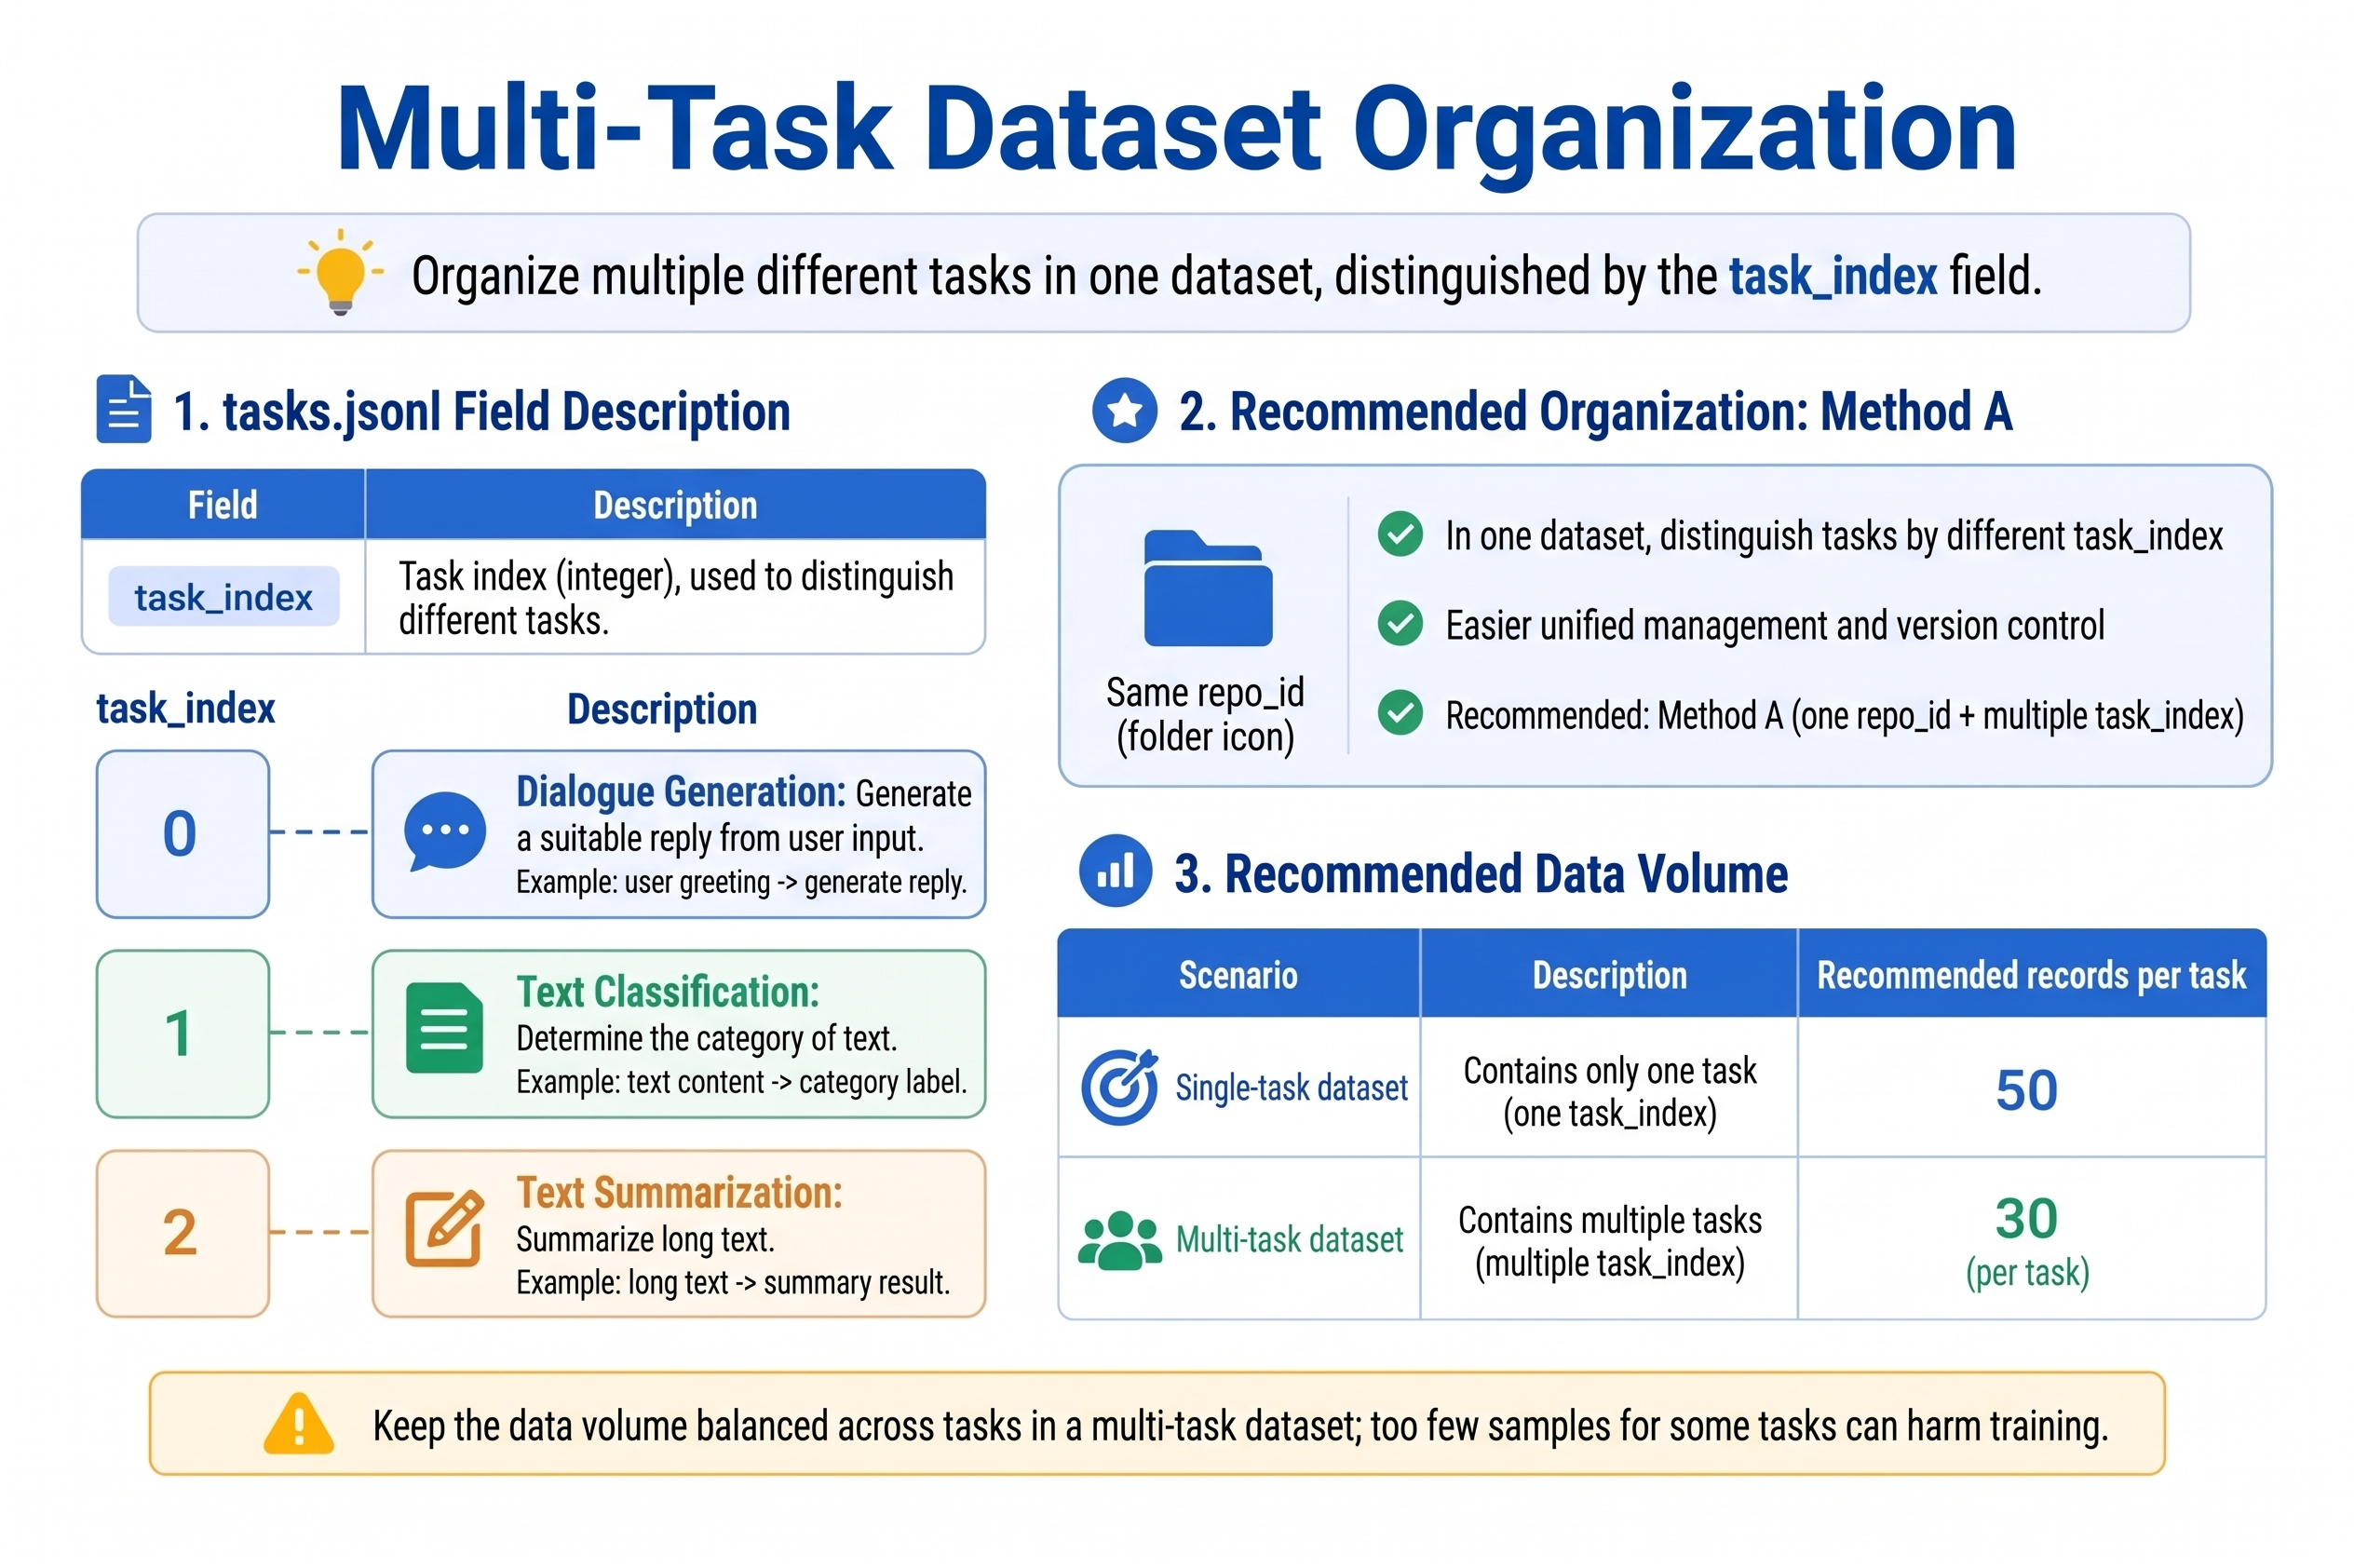
「1 つのモデルで複数の言語タスクを学習する」ために、次の 2 つのアプローチを推奨します:
方法 A:同一 repo_id、複数の task_index(推奨)
{"task_index": 0, "task": "put the black cube on the blue tray"}
{"task_index": 1, "task": "put the screwdriver into the toolbox"}
{"task_index": 2, "task": "push the red cup to the left side of the table"}
記録中に --dataset.single_task を切り替えるか、バッチごとに記録して同じデータセットにマージします。
方法 B:複数データセットのマージ
LeRobot は(バージョンに依存しますが)マルチデータセット学習をサポートしています。より簡単な方法は、記録時に 1 つの repo_id を使用し、task_index でタスクを区別することです。
データ量の推奨
| シナリオ | 推奨 |
|---|---|
| シングルタスク入門 | 50 エピソード |
| シングルタスク安定運用 | 100〜200 エピソード |
| マルチタスク(3 タスク) | 各タスク 30 エピソード以上 |
| 位置の汎化 | 位置バリアントごとに 10 エピソード以上 |
20.10 データ品質チェックリスト
20.10 データ品質チェックリスト
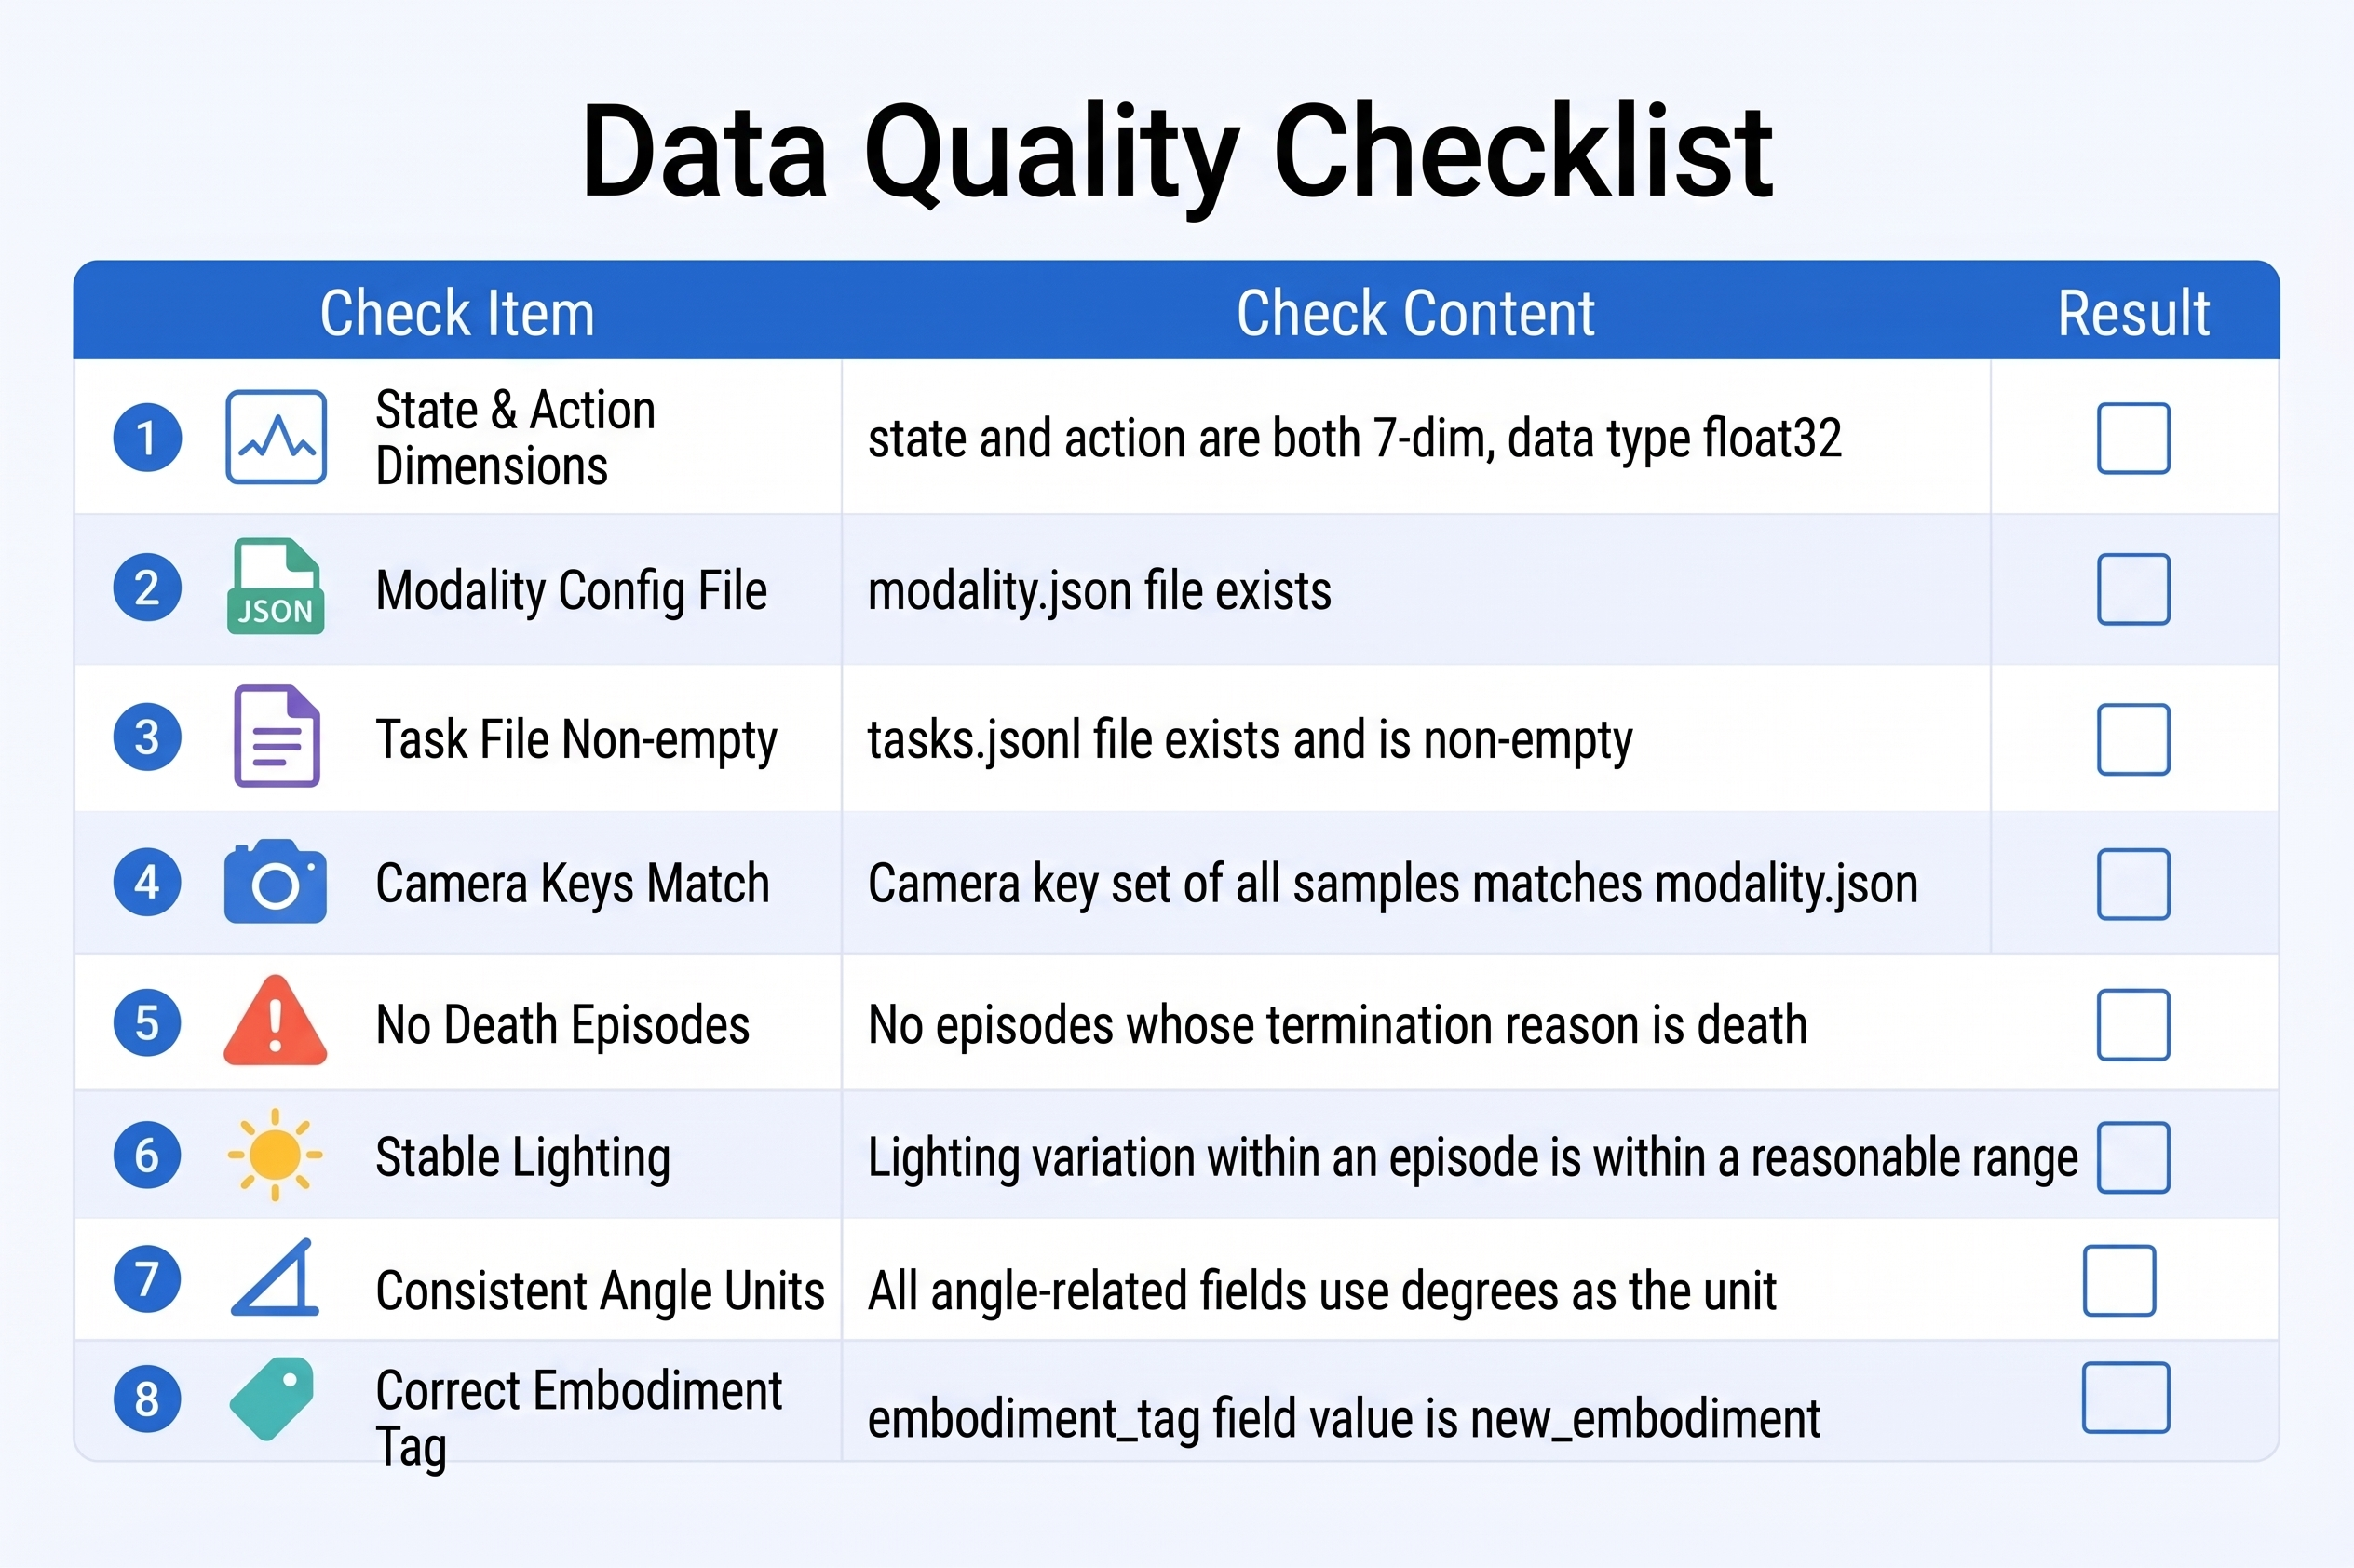
Hub にアップロードする前、または学習を開始する前に、次を確認してください:
-
observation.stateとactionがどちらも 7 次元 float32 である -
meta/modality.jsonが存在し、インデックスのスライスが正しい -
meta/tasks.jsonl内のすべてのtask_indexに空でない説明がある - カメラキー名が
modality.jsonとデータセット間で一致している - 全ゼロ / アイドル状態のみの無駄なエピソードがない
- カメラが固定され、物体が画角内にあり、照明が安定している
- 角度の単位が統一されている(reBot の低レベルモーター API は度数法を使用し、LeRobot ドライバは内部でラジアンに変換します。データセットと学習/推論では一貫性を保つ必要があります)
-
embodiment_tagにnew_embodimentを使用する計画である
Hugging Face Hub へのプッシュ(任意)
huggingface-cli login
lerobot-record ... --dataset.push_to_hub=true
# or upload manually
huggingface-cli upload ${HF_USER}/rebot_vla_pick_cube ~/.cache/huggingface/lerobot/seeed_rebot_b601_rs/pick_cube
20.11 この章のまとめ
20.11 この章のまとめ
- GR00T には標準的な LeRobot データ +
meta/modality.jsonが必要です。 - reBot の 7 次元ベクトルは
single_arm(6)+gripper(1)に分割されます。RS / DM も次元は同じで、異なるのはドライバパラメータだけです。 - 言語は
tasks.jsonl+annotation.human.task_descriptionを通じて接続されます。 - カメラキー名は、記録・モダリティ・推論の間で整合している必要があります。
- 次の章では、準備したデータを使って
lerobot-train --policy.type=grootを開始します。