22. GR00T 推論と実ロボットデプロイ
Seeed Physical AI Beginner's Course の第22章では、エンドツーエンドループ、 推論と制御の分離、単一マシン vs 分散構成、カメラ/状態/言語入力、 アクションチャンク出力、レイテンシ、アクションバッファリングと RTC、安全制限、評価、 そしてステージプロジェクトについて扱います。
第21章ではファインチューニングと基本的な実ロボットコマンドを扱いました。本章では推論デプロイにフォーカスします。推論側と制御側をどのように分離するか、単一マシンと分散構成のどちらを選ぶか、入力/出力をどう整合させるか、さらにレイテンシ、非同期バッファリング、安全制限、タスク評価について解説します。最後に、ステージプロジェクト「試験管を左側のラックに置く」を通してパイプライン全体を一通り実行します。
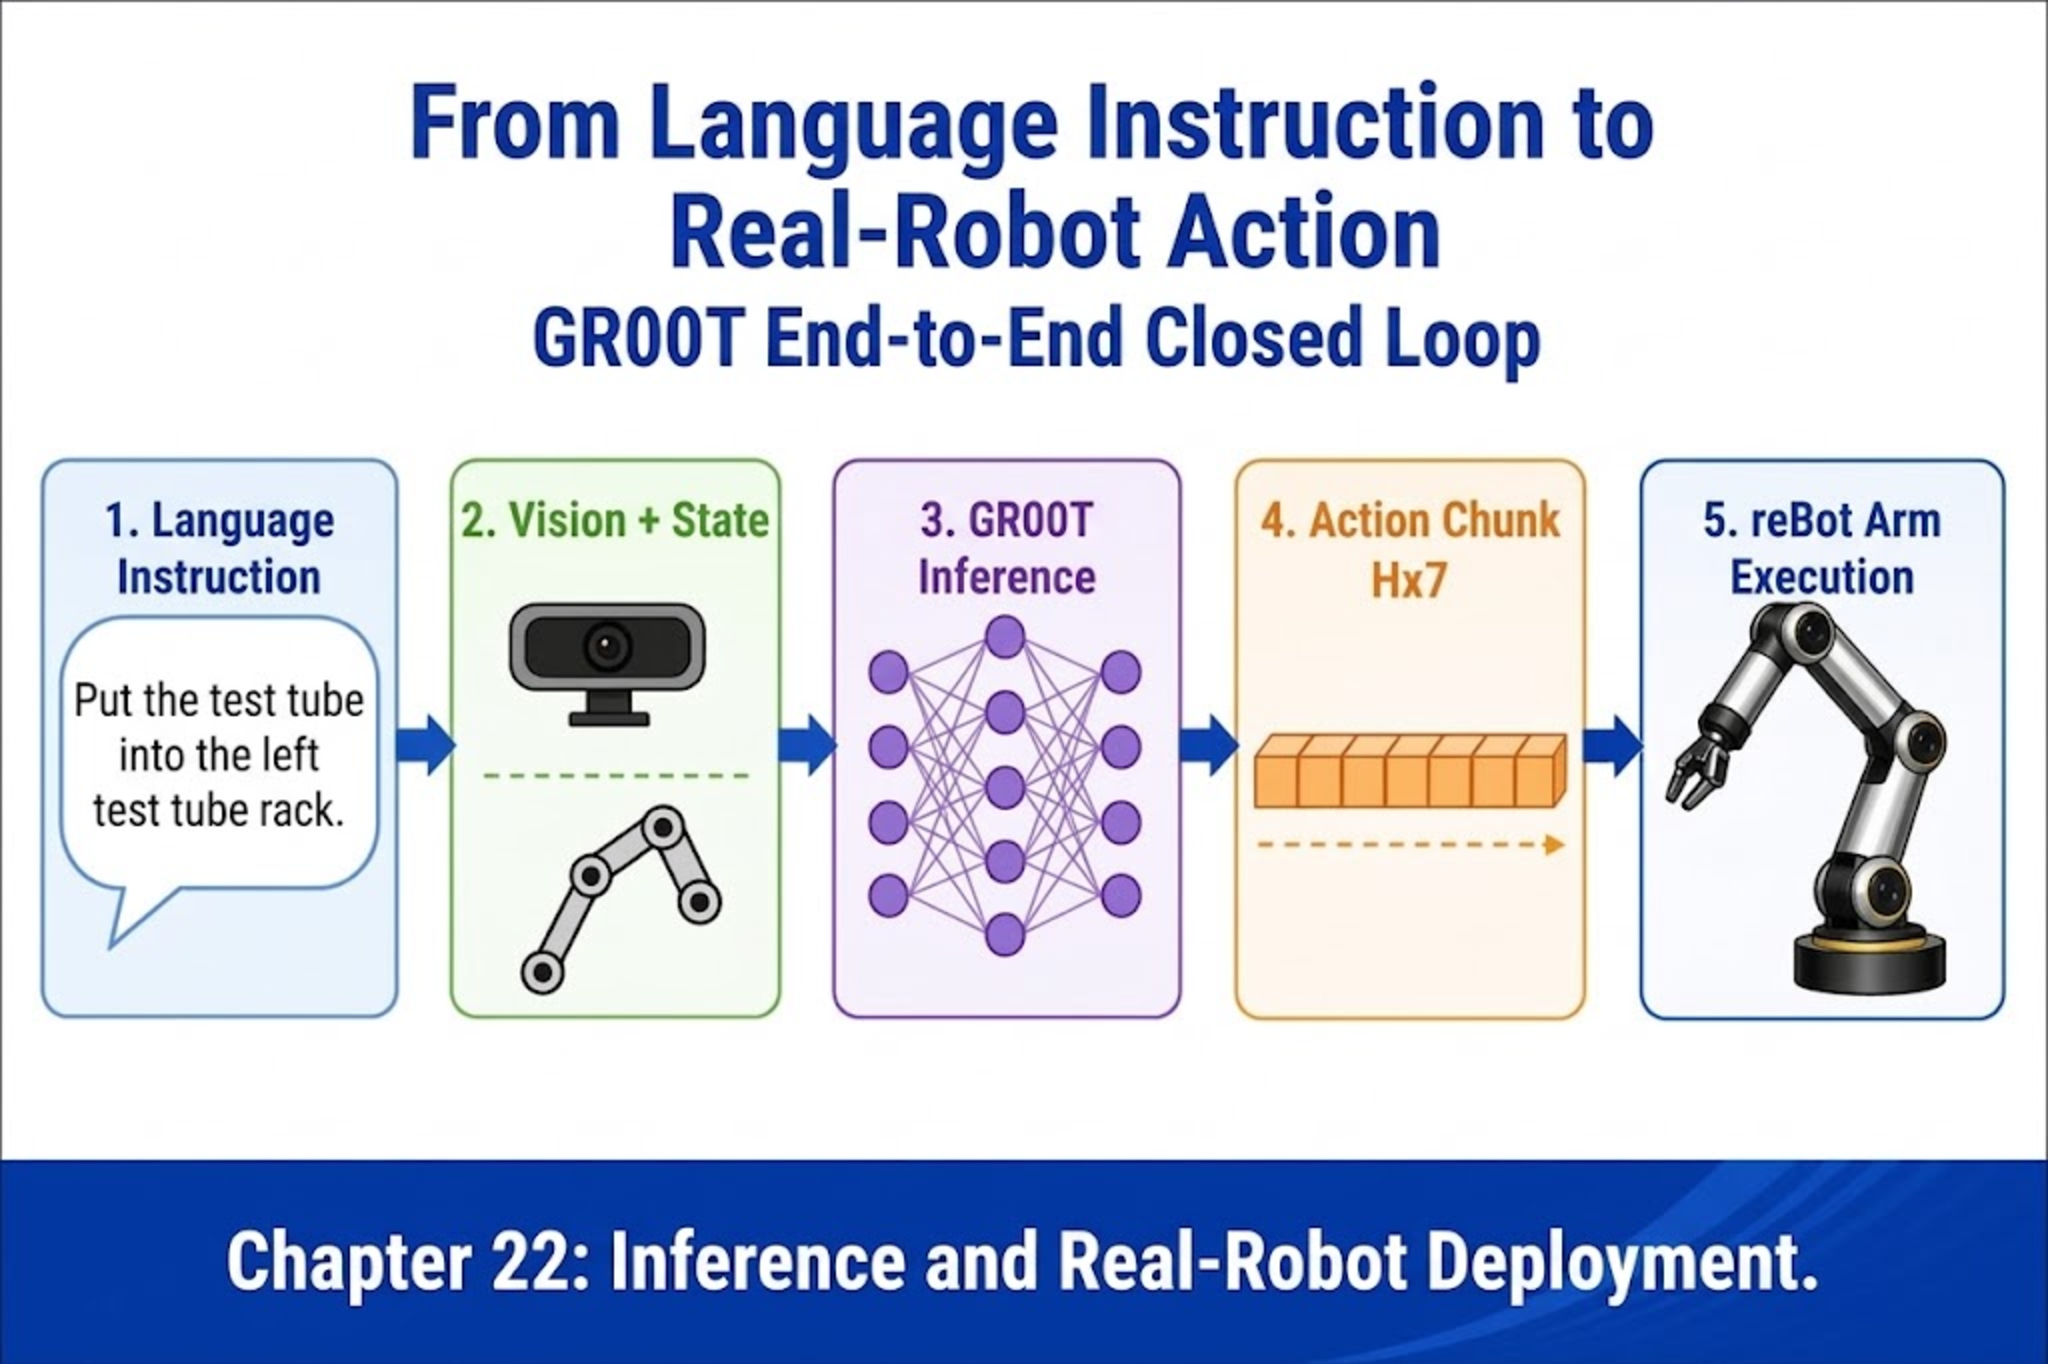
22.1 エンドツーエンドループはどのような形か?
22.1 エンドツーエンドループはどのような形か?
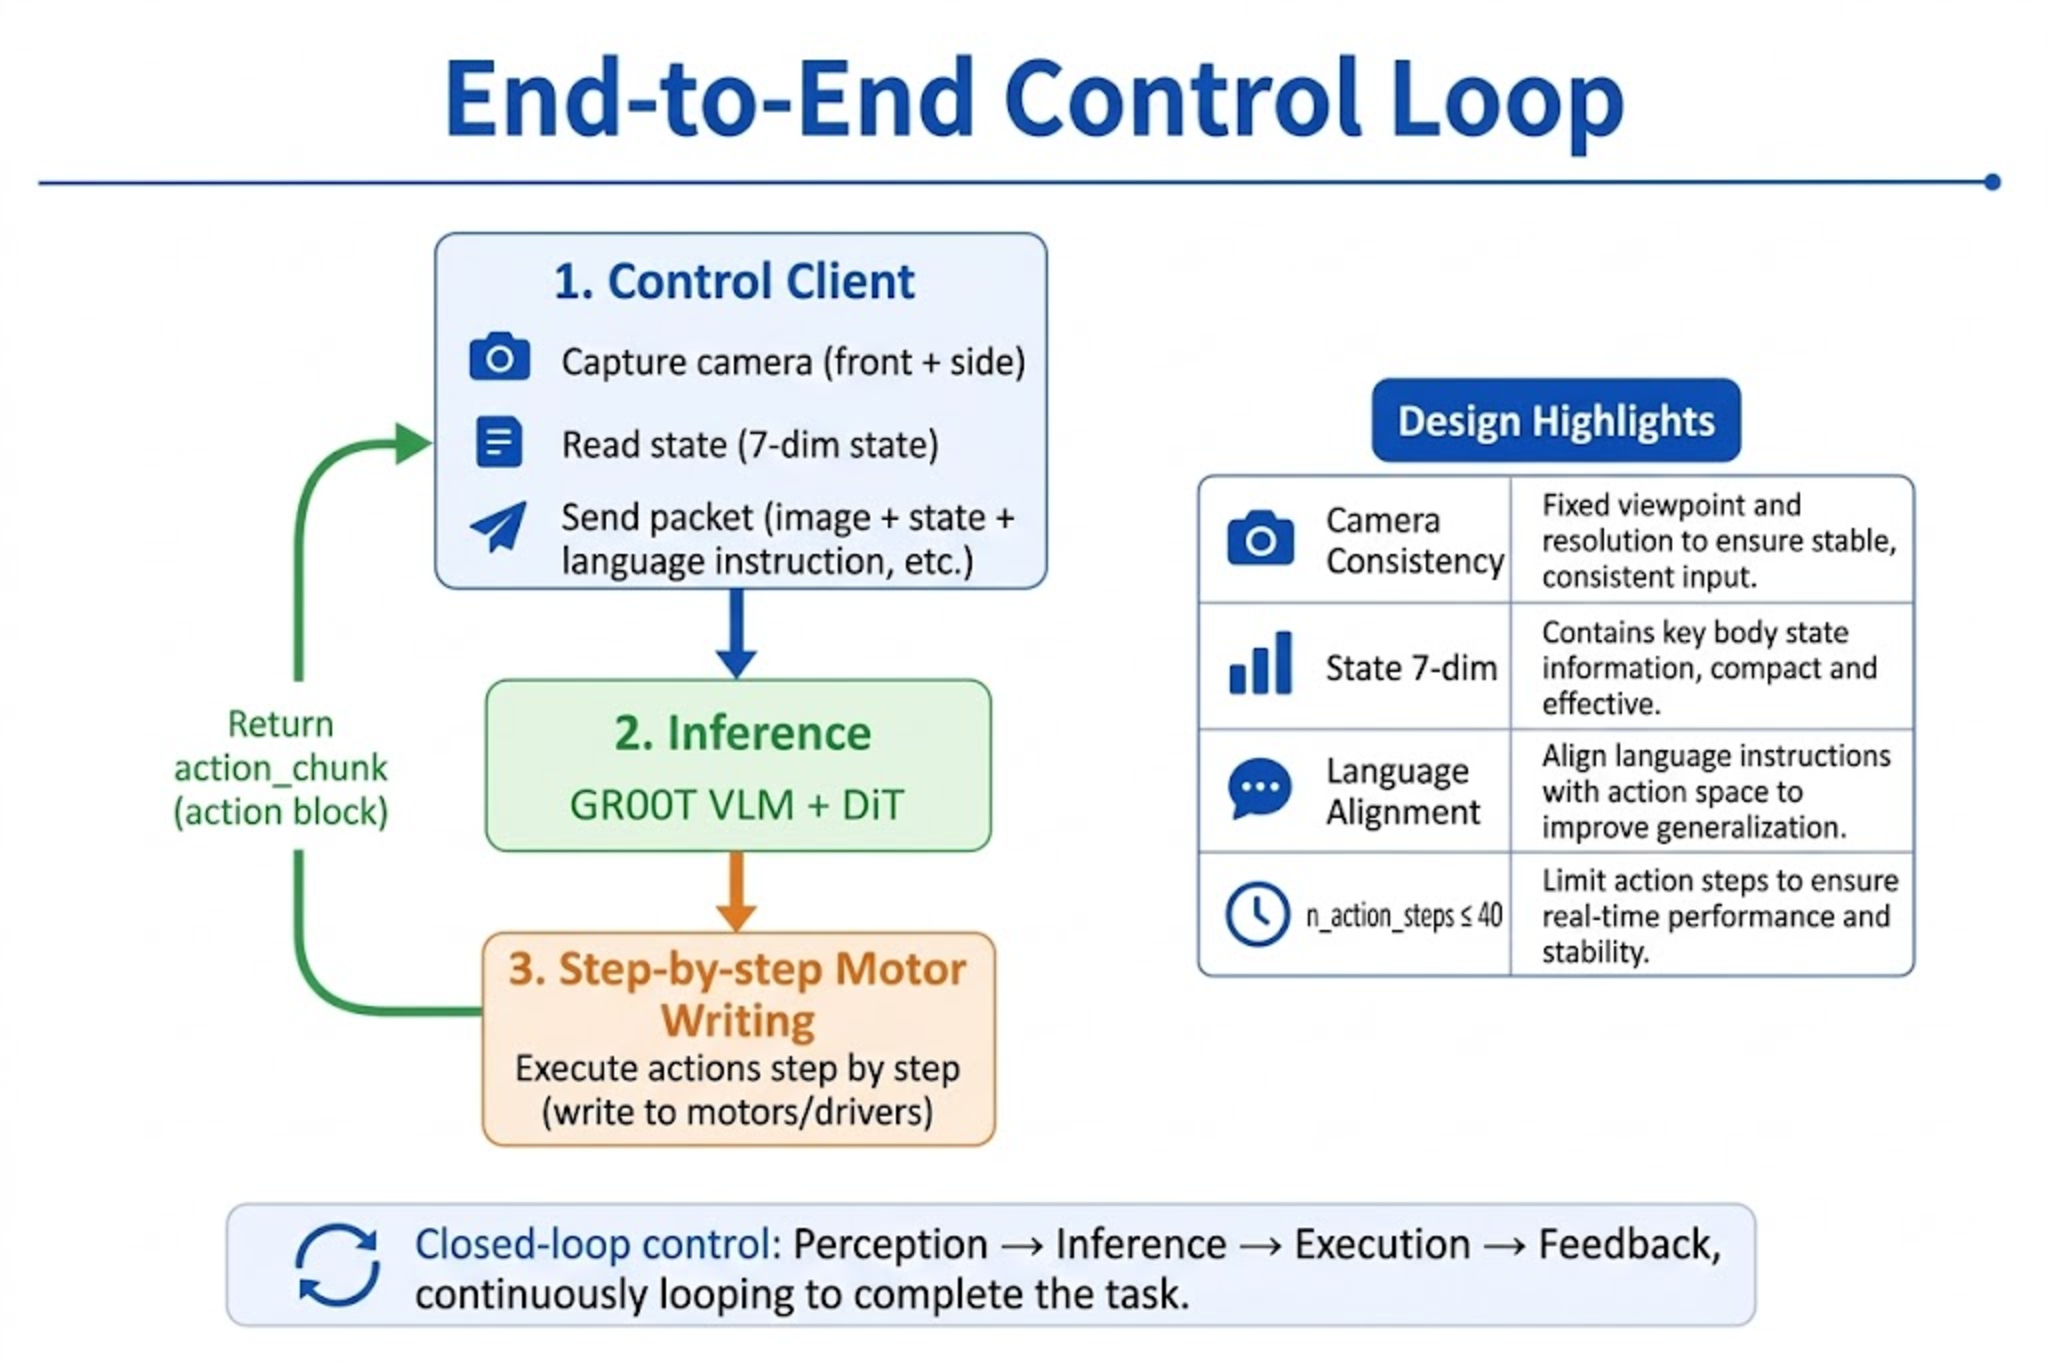
うまくいった VLA 実ロボットエピソードは、固定周波数の制御ループとして抽象化できます:
User language instruction L (e.g. place the test tube into the left rack)
        |
        v
+---------------------------------------+
|  Control Client (Robot Control)        |
|  1. Capture cameras: front + side      |
|  2. Read joint state (7-dim)          |
|  3. Pack observation -> send to infer |
+-------------------+-------------------+
                    |  images + state + task
                    v
+---------------------------------------+
|  Inference side (GR00T Policy/Server)|
|  VLM + DiT -> action_chunk (H x 7)    |
+-------------------+-------------------+
                    |  action chunk
                    v
+---------------------------------------+
|  Control side executes                |
|  Write motors step by n_action_steps  |
|  (optional RTC: async prefetch next)  |
+---------------------------------------+
| ステージ | 主要な制約 |
|---|---|
| カメラ | キー名、解像度、台数が学習時と一致(front ブラケット広角ビュー / side 手首) |
| 状態 | 7 次元の順序が modality.json と一致;角度単位が学習と推論で一貫している |
| 言語 | --task 文のパターンが学習アノテーションに近い |
| アクション | n_action_steps ≤ 学習時の chunk_size(N1.7 では一般的に 40) |
22.2 推論側と制御側の分離
22.2 推論側と制御側の分離
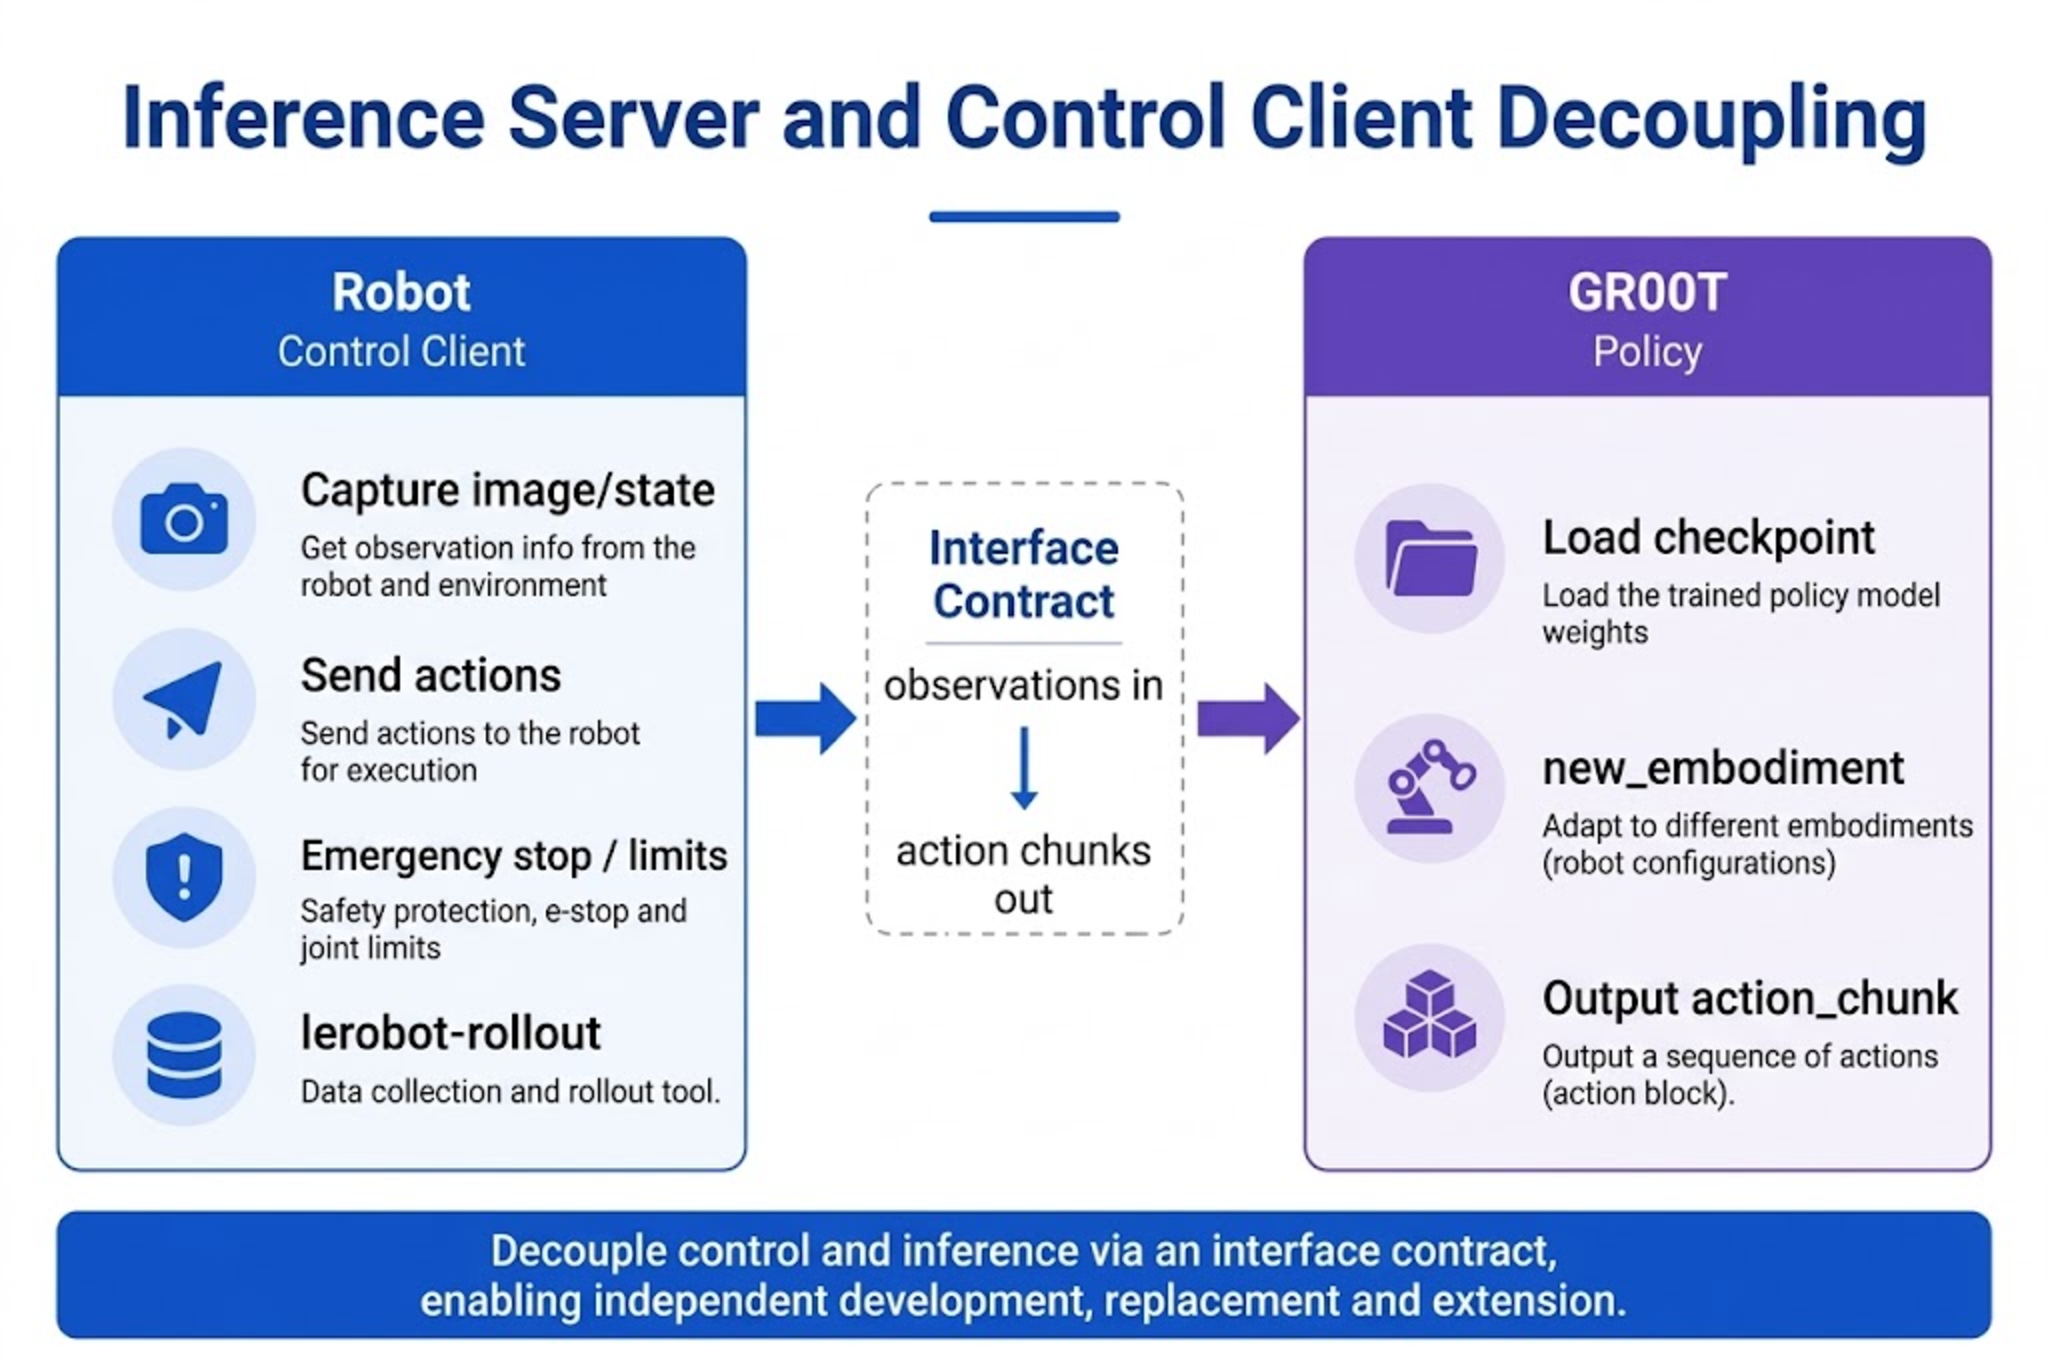
システムを 2 つの側に分割することで、リアルタイム制御と重い計算が互いに足を引っ張らないようにします:
制御側の責務
- 一定の周波数(例:30 Hz)で画像と関節状態を取得する
- 観測パケット
{images, state, task}を組み立てる action_chunkを受け取り、reBot ドライバへ 1 ステップずつ送出する- 非常停止、ソフトリミット、タイムアウト保護を実行する
対応するツール:lerobot-rollout / lerobot-record(--policy.path 付き)。
推論側の責務
policy.path(ファインチューニング済みチェックポイント)とbase_model_path=nvidia/GR00T-N1.7-3Bをロードするembodiment_tag=new_embodimentを用いて reBot のアクション空間をデコードする- 形状がおおよそ
(H, 7)のアクションチャンクを返す(H は学習時のchunk_sizeで決まる)
対応する形態:デフォルトではプロセス内の groot ポリシー。発展的な使い方としては、Isaac GR00T リポジトリのデプロイ例を参照しつつ、スタンドアロンの HTTP/gRPC サービスとすることもできます。
分離の原則: 制御側はモデル内部構造を意識せず、推論側はモータを直接操作しません。インターフェースの契約は「観測を入力し、アクションチャンクを出力する」だけです。
22.3 単一マシン vs 分散デプロイ
22.3 単一マシン vs 分散デプロイ
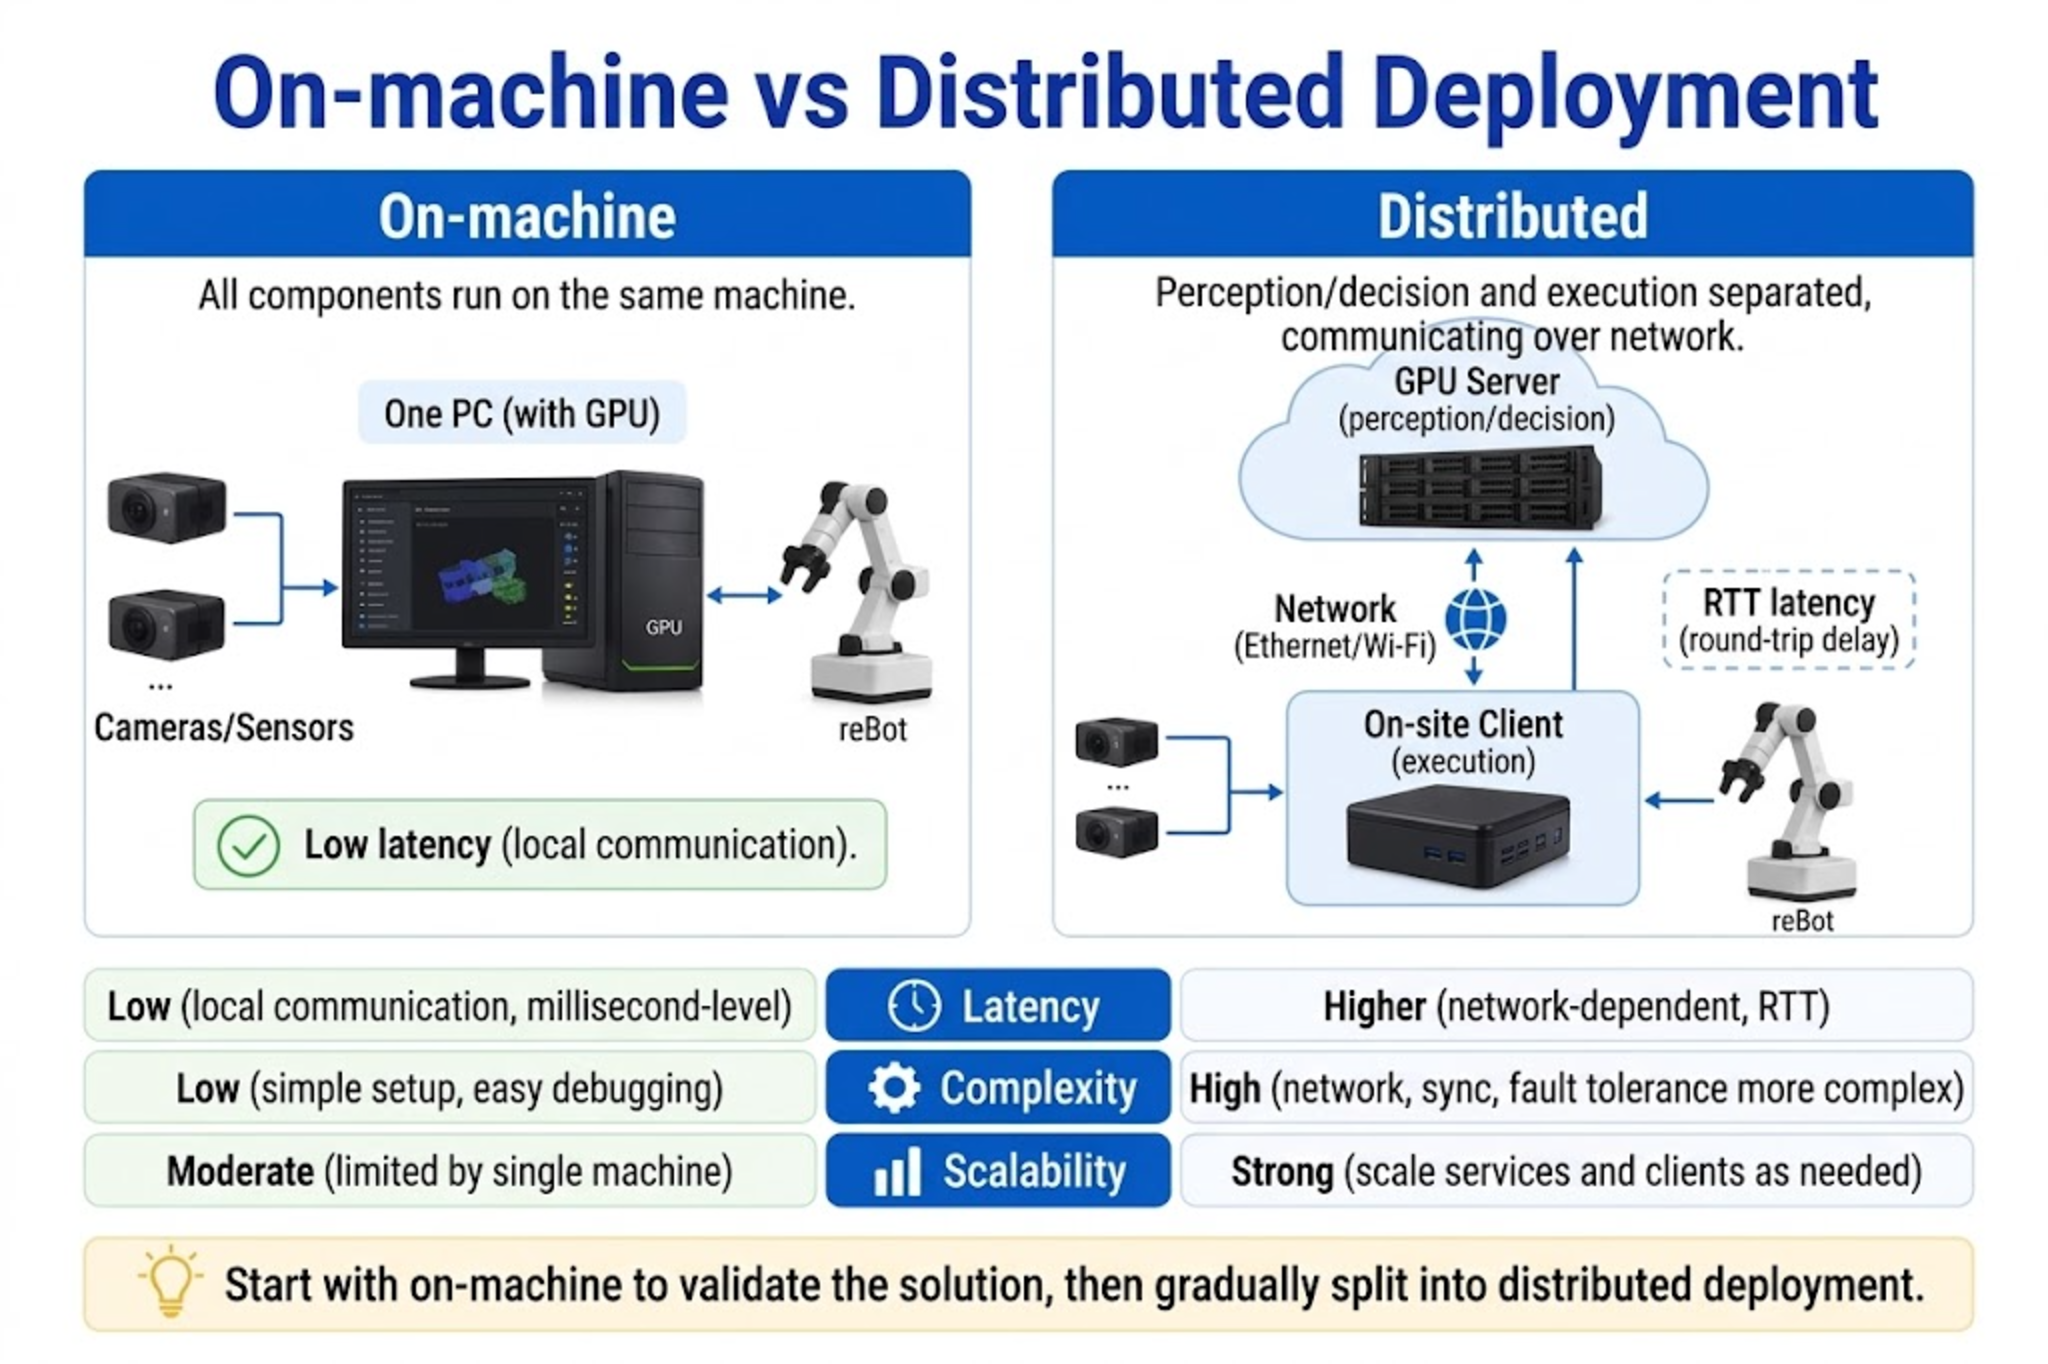
単一マシンデプロイ(初心者に推奨)
GPU ワークステーションがカメラ、CAN/シリアル、アームに同時接続します:
lerobot-rollout \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --device=cuda \
  --robot.type=seeed_b601_rs_follower \
  ...
長所:ネットワーク往復がなく、統合デバッグが簡単。短所:GPU ホストを現場に置く必要がある。
分散デプロイ(上級)
| ノード | 配置 |
|---|---|
| GPU マシン | 推論サーバー(GR00T をロード) |
| 現場 / IPC | 制御クライアント(カメラ + reBot ドライバ) |
適したシナリオ:研究室の GPU と本番アームが分かれている場合、複数アームで 1 つの推論プールを共有する場合。
| 比較項目 | 単一マシン | 分散 |
|---|---|---|
| レイテンシ | 主に推論時間 | 推論 + ネットワーク RTT |
| 複雑さ | 低い | シリアライズ、タイムアウト、再接続の取り決めが必要 |
| スケーラビリティ | 1 マシン 1 アーム | 1 サービス 複数クライアント |
選択のアドバイス: まず単一マシンでステージプロジェクトを動かし、成功率を確認してから分散構成に分割しましょう。
22.4 カメラ、状態、言語入力
22.4 カメラ、状態、言語入力
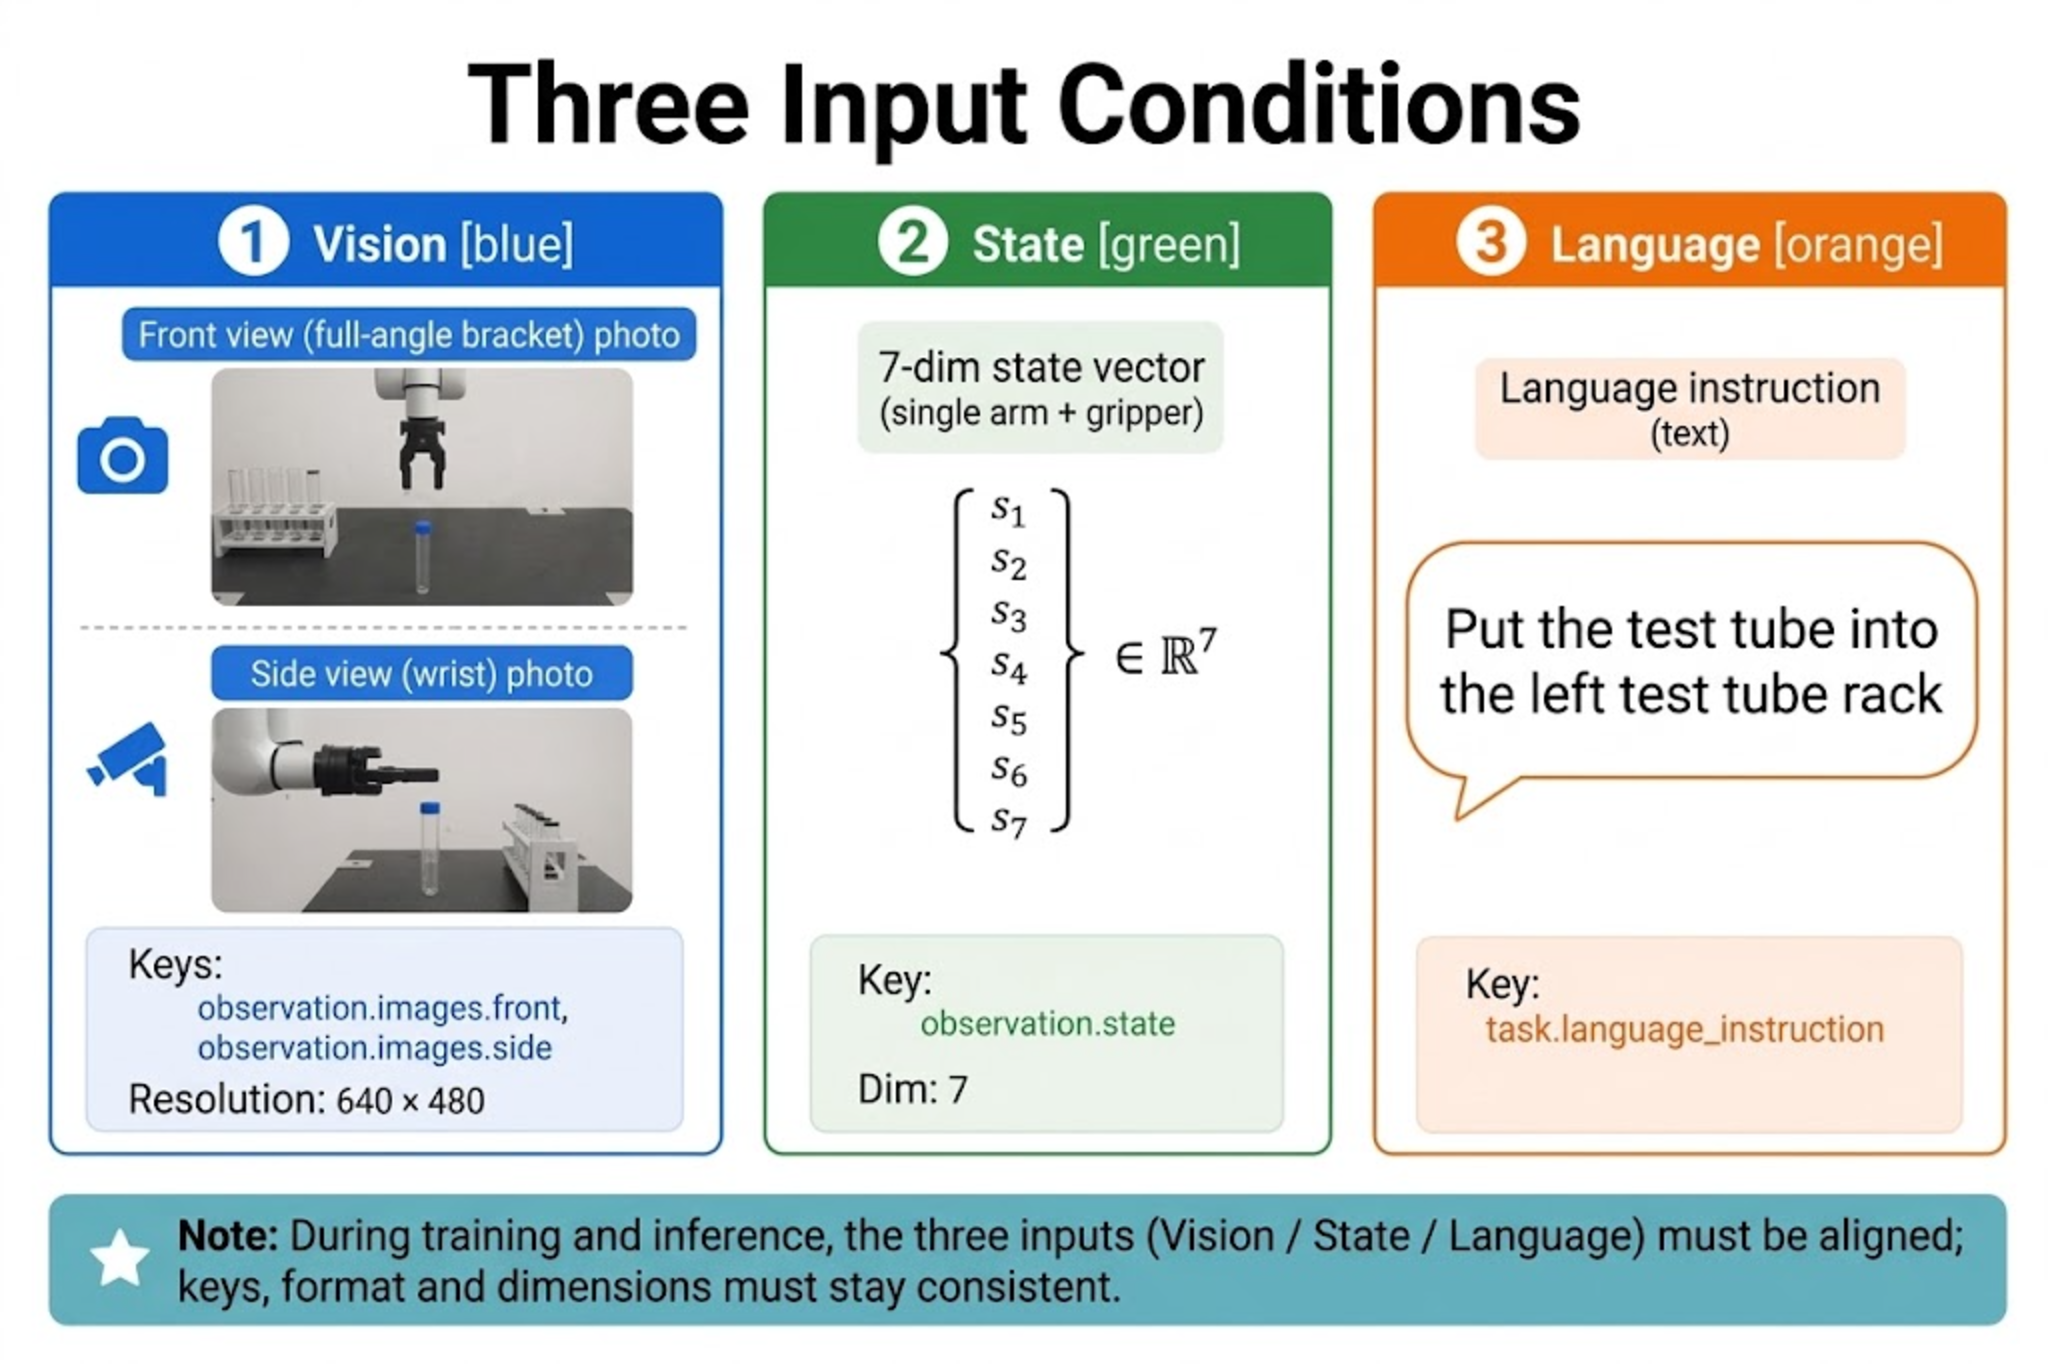
各推論呼び出しには 3 つの条件付き入力が必要であり、いずれも必須(または学習時に宣言した内容と一貫)です:
1. カメラ(ビジョン)
| キー名 | 取り付け位置 | 目的 |
|---|---|---|
observation.images.front -> front | ブラケット広角ビュー | シーンとターゲットの位置特定 |
observation.images.side -> side | 手首 | クローズアップでの狙い付け、把持/配置 |
推奨解像度は 640x480。学習と推論で一致させる必要があります。
2. 状態
reBot Arm:single_arm 6 次元 + gripper 1 次元 = 7 次元で、第19/20章と同じ順序です。制御側は、推論に送信する前に各制御サイクルで最新の関節角度を読み取ります。
3. 言語
--task / dataset.single_task 経由で注入します。例:
Place the test tube into the left rack.
要件:
- 学習時の
tasks.jsonl/human.task_descriptionと同じ言語・文体であること。 - オブジェクト参照が明確であること(「左側のラック」が視覚的に区別できる必要がある)。
- 学習で一度も見ていないような複雑な複合指示に、いきなり切り替えないこと。
22.5 アクションチャンク出力
22.5 アクションチャンク出力
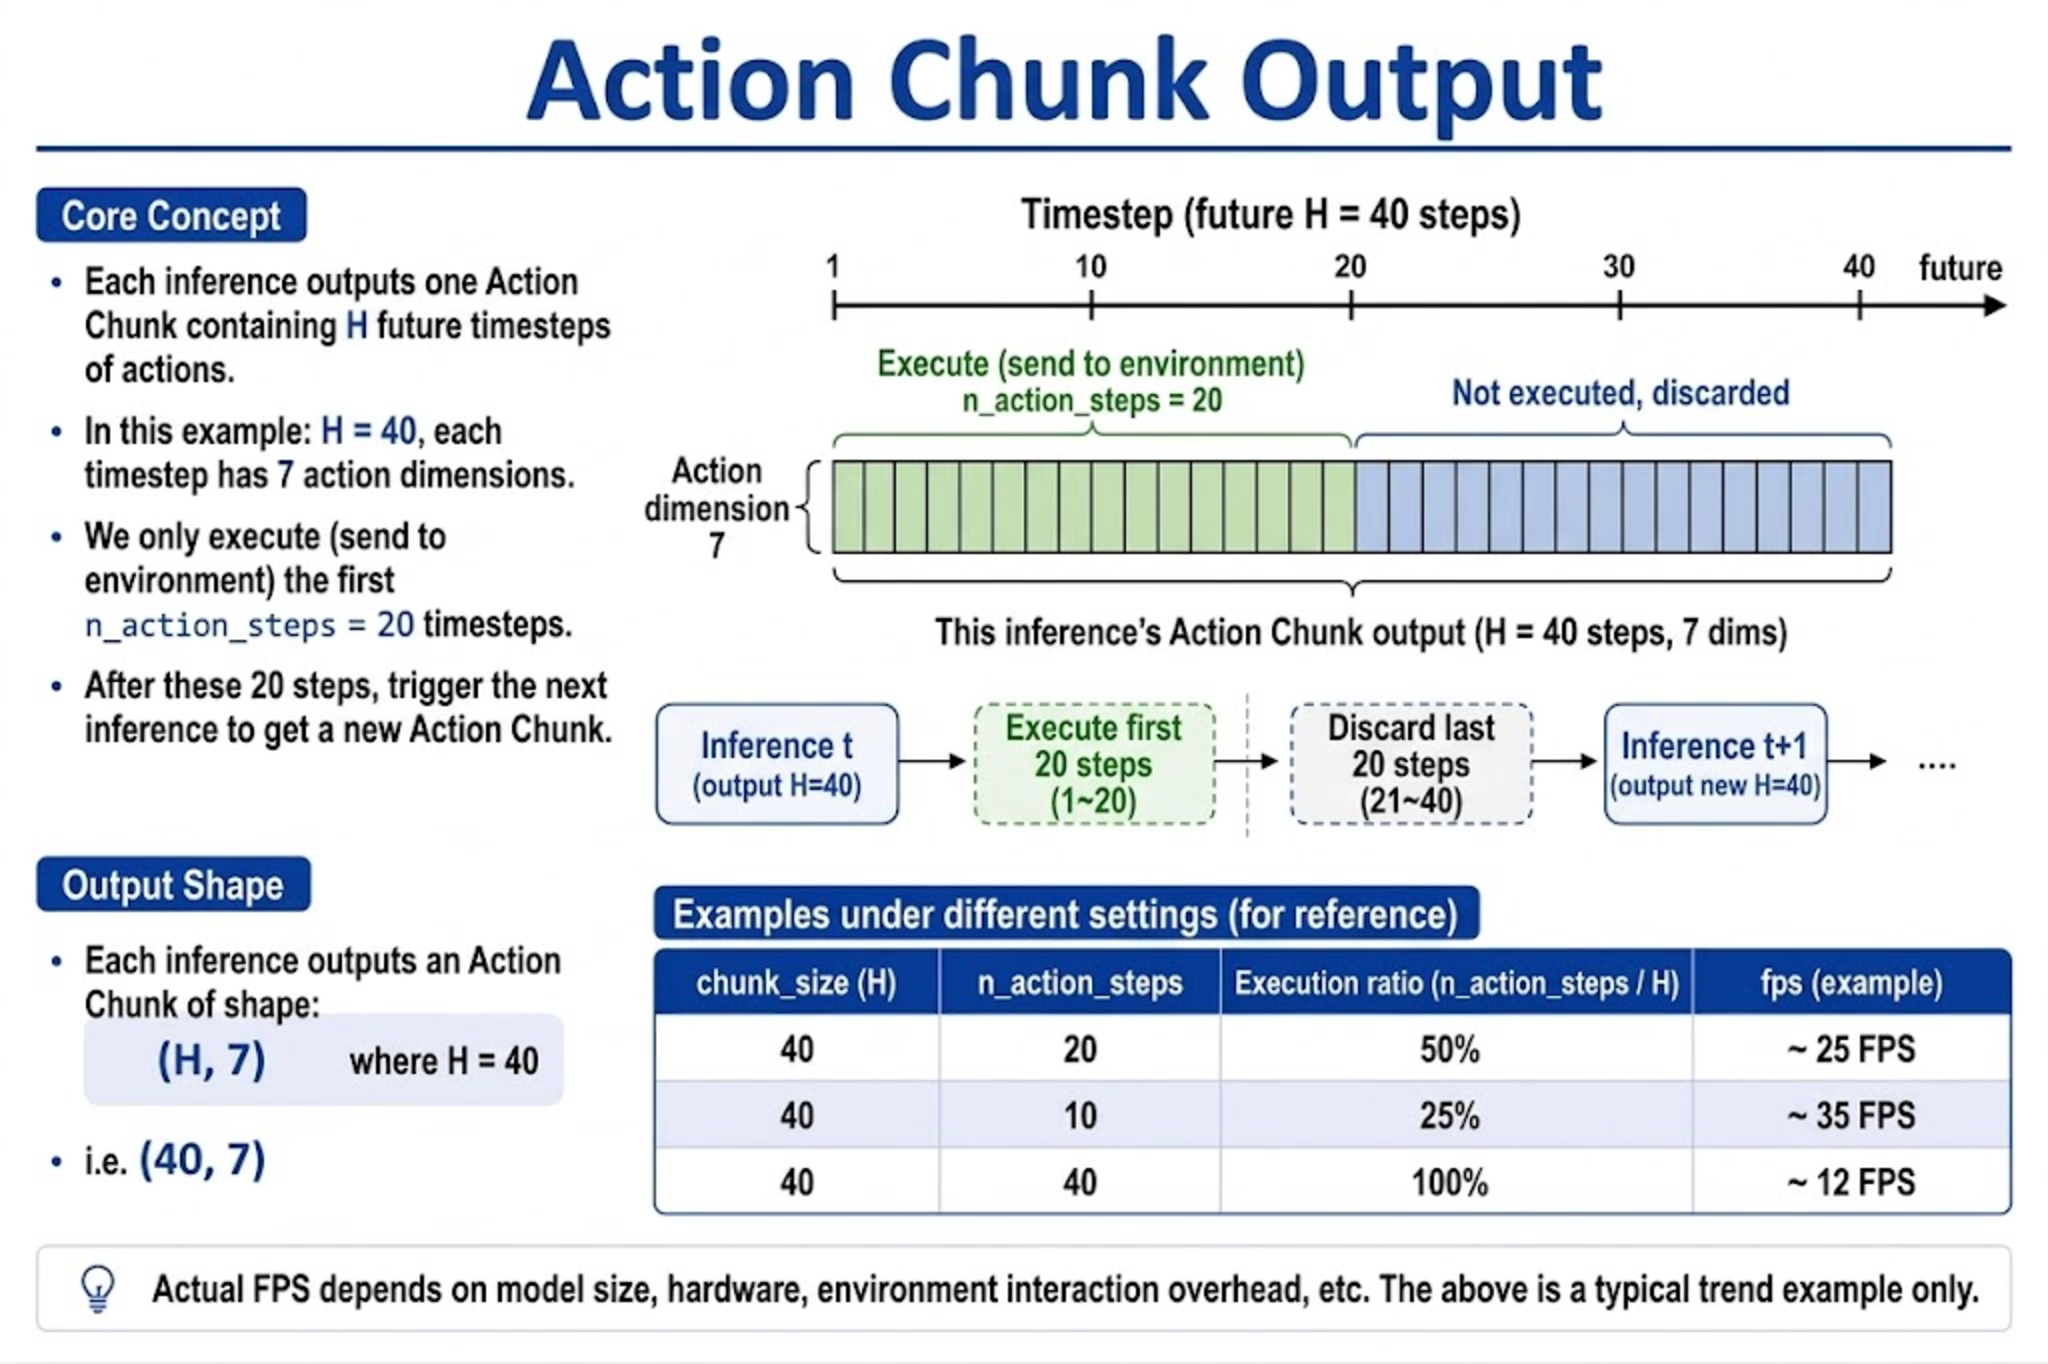
単一の GR00T 推論は、瞬間的な関節コマンドではなく、アクションチャンクを出力します:
action_chunk.shape ~= (H, 7)
H = chunk_size / action_horizon   # N1.7 fine-tuning commonly 40
each row 7-dim = 6 joints + gripper
制御側での実行戦略:
| パラメータ | 推奨値 | 説明 |
|---|---|---|
chunk_size | 学習時は 40 | モデルがどれだけ先まで予測できるかを決める;推論時にむやみに大きくしない |
n_action_steps | まずは 20 から | このラウンドで実際に実行するステップ数。chunk_size 以下でなければならない |
| 実行周波数 | 記録時の fps に近く(例:30 Hz) | 速すぎても遅すぎても学習分布から外れてしまう |
相対アクション(use_relative_actions)を有効にしている場合、制御側は学習時と同じルールで絶対関節コマンドに復元する必要があります。グリッパーは通常、相対から除外されます。
22.6 ネットワークと推論レイテンシ
22.6 ネットワークと推論レイテンシ
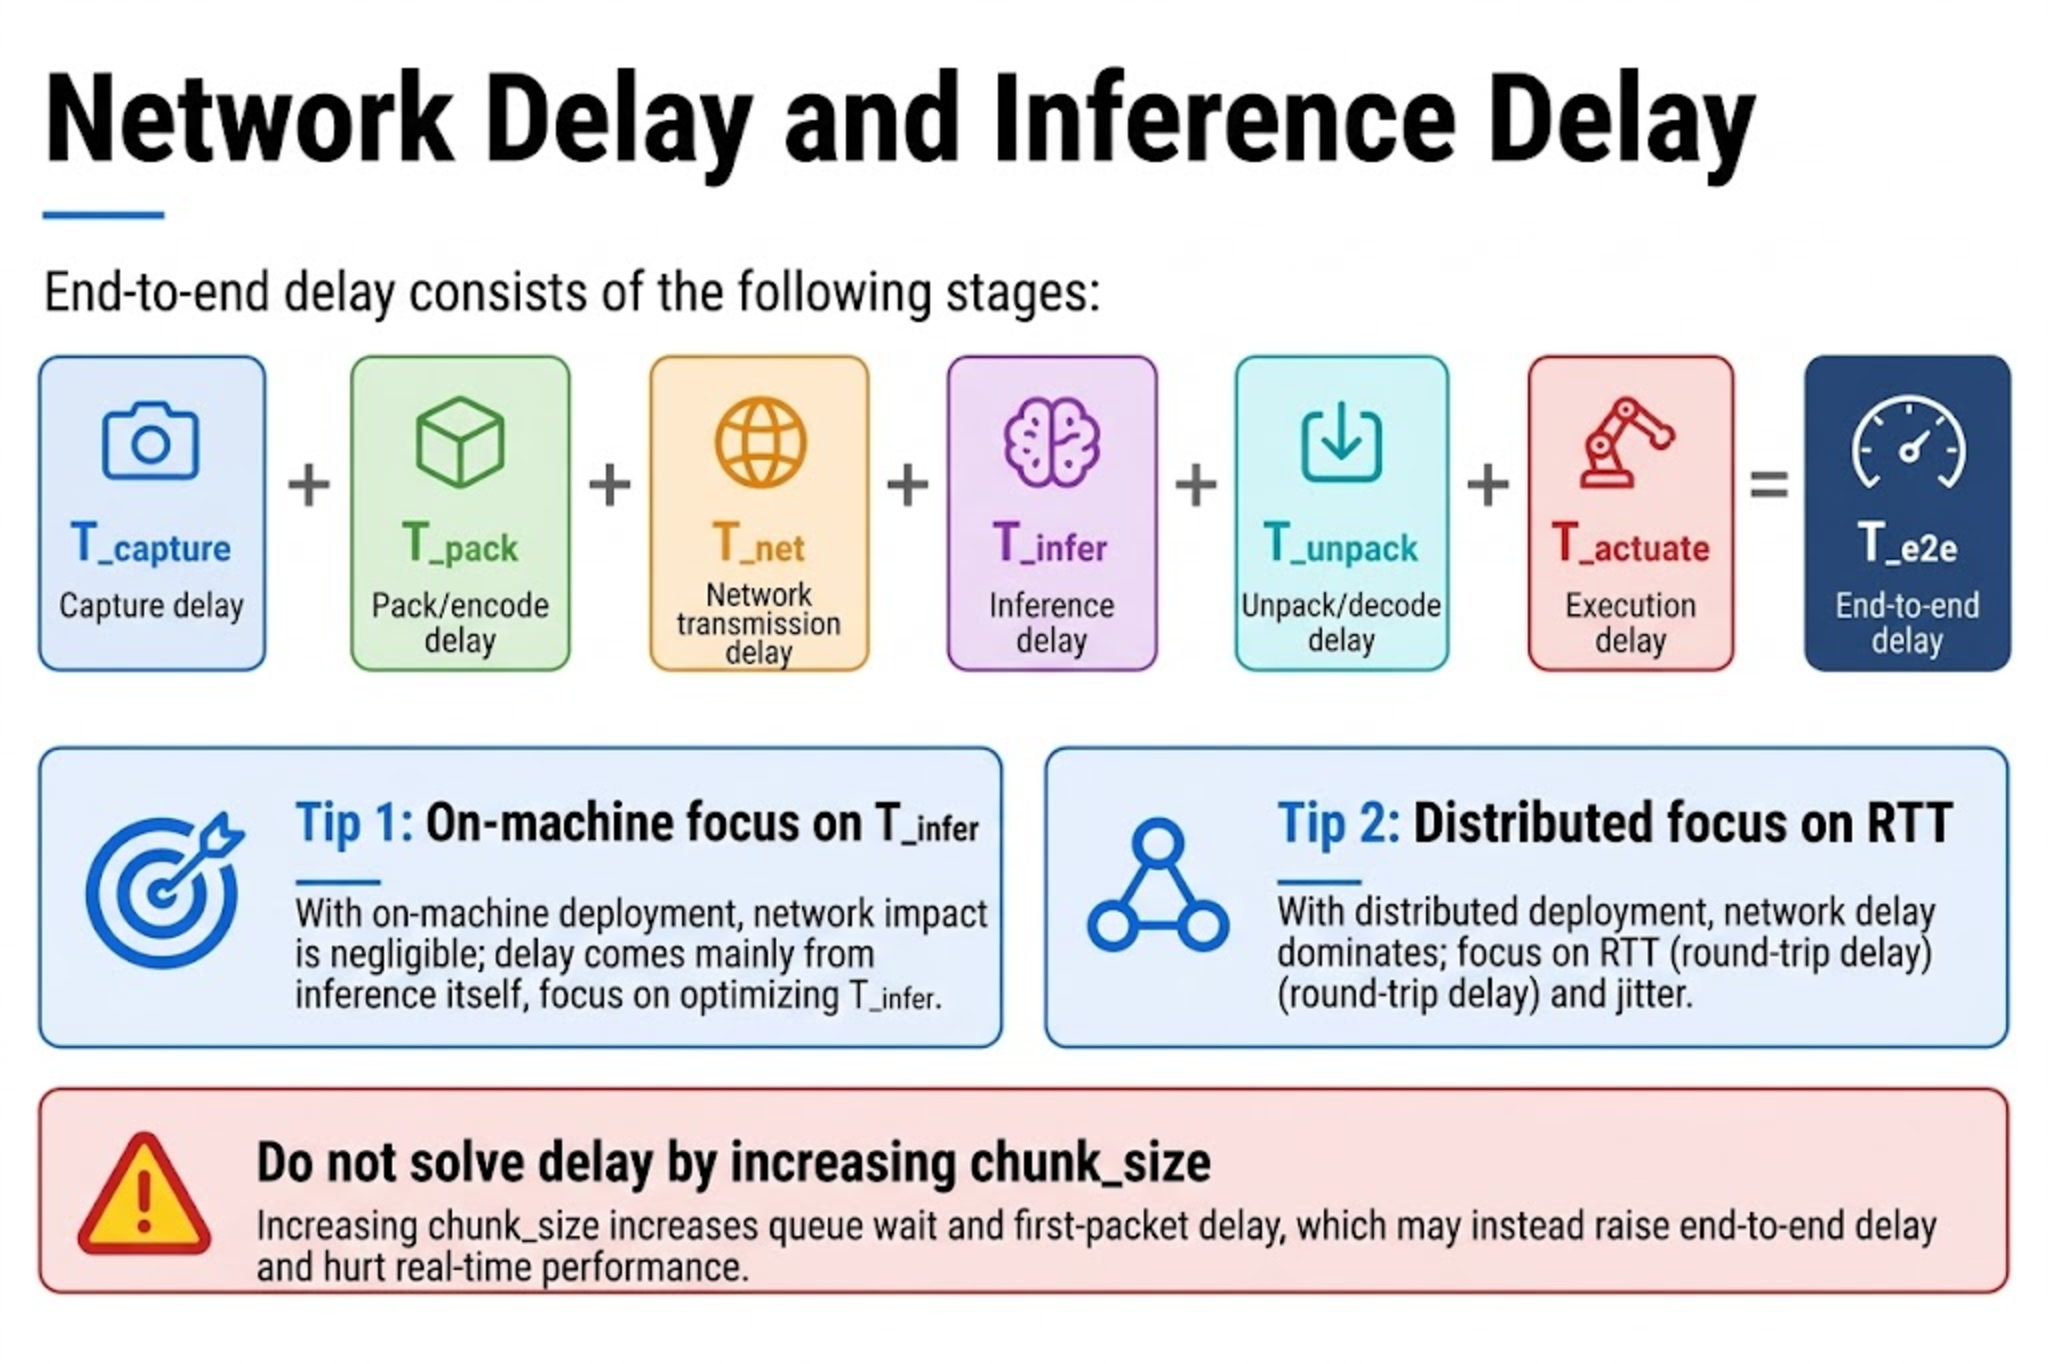
エンドツーエンドのレイテンシはおおよそ次のようになります:
T_e2e ~= T_capture + T_pack + T_net + T_infer + T_unpack + T_actuate
| コンポーネント | 典型的な要因 | 軽減策 |
|---|---|---|
T_capture | カメラ露光/USB | MJPG、固定解像度、余計な前処理を避ける |
T_infer | VLM + DiT | bf16、batch=1、Flash Attention |
T_net | 分散構成での RTT | ギガビット、同一データセンター、観測の圧縮 |
T_actuate | CAN/シリアル書き込みサイクル | 制御周波数を学習時に近づける |
経験則:
- 単一マシン: ボトルネックは通常
T_inferなので、より小さいn_action_stepsと RTC を使ってスタールを隠します。 - 分散: RTT が不安定な場合は、まず同期デバッグのために RTC をオフにし、その後徐々に非同期を有効にします。
- レイテンシを「
chunk_sizeを大きくする」ことで解決しないでください — ウィンドウは学習時に固定されています。
22.7 アクションバッファリングと非同期推論
22.7 アクションバッファリングと非同期推論
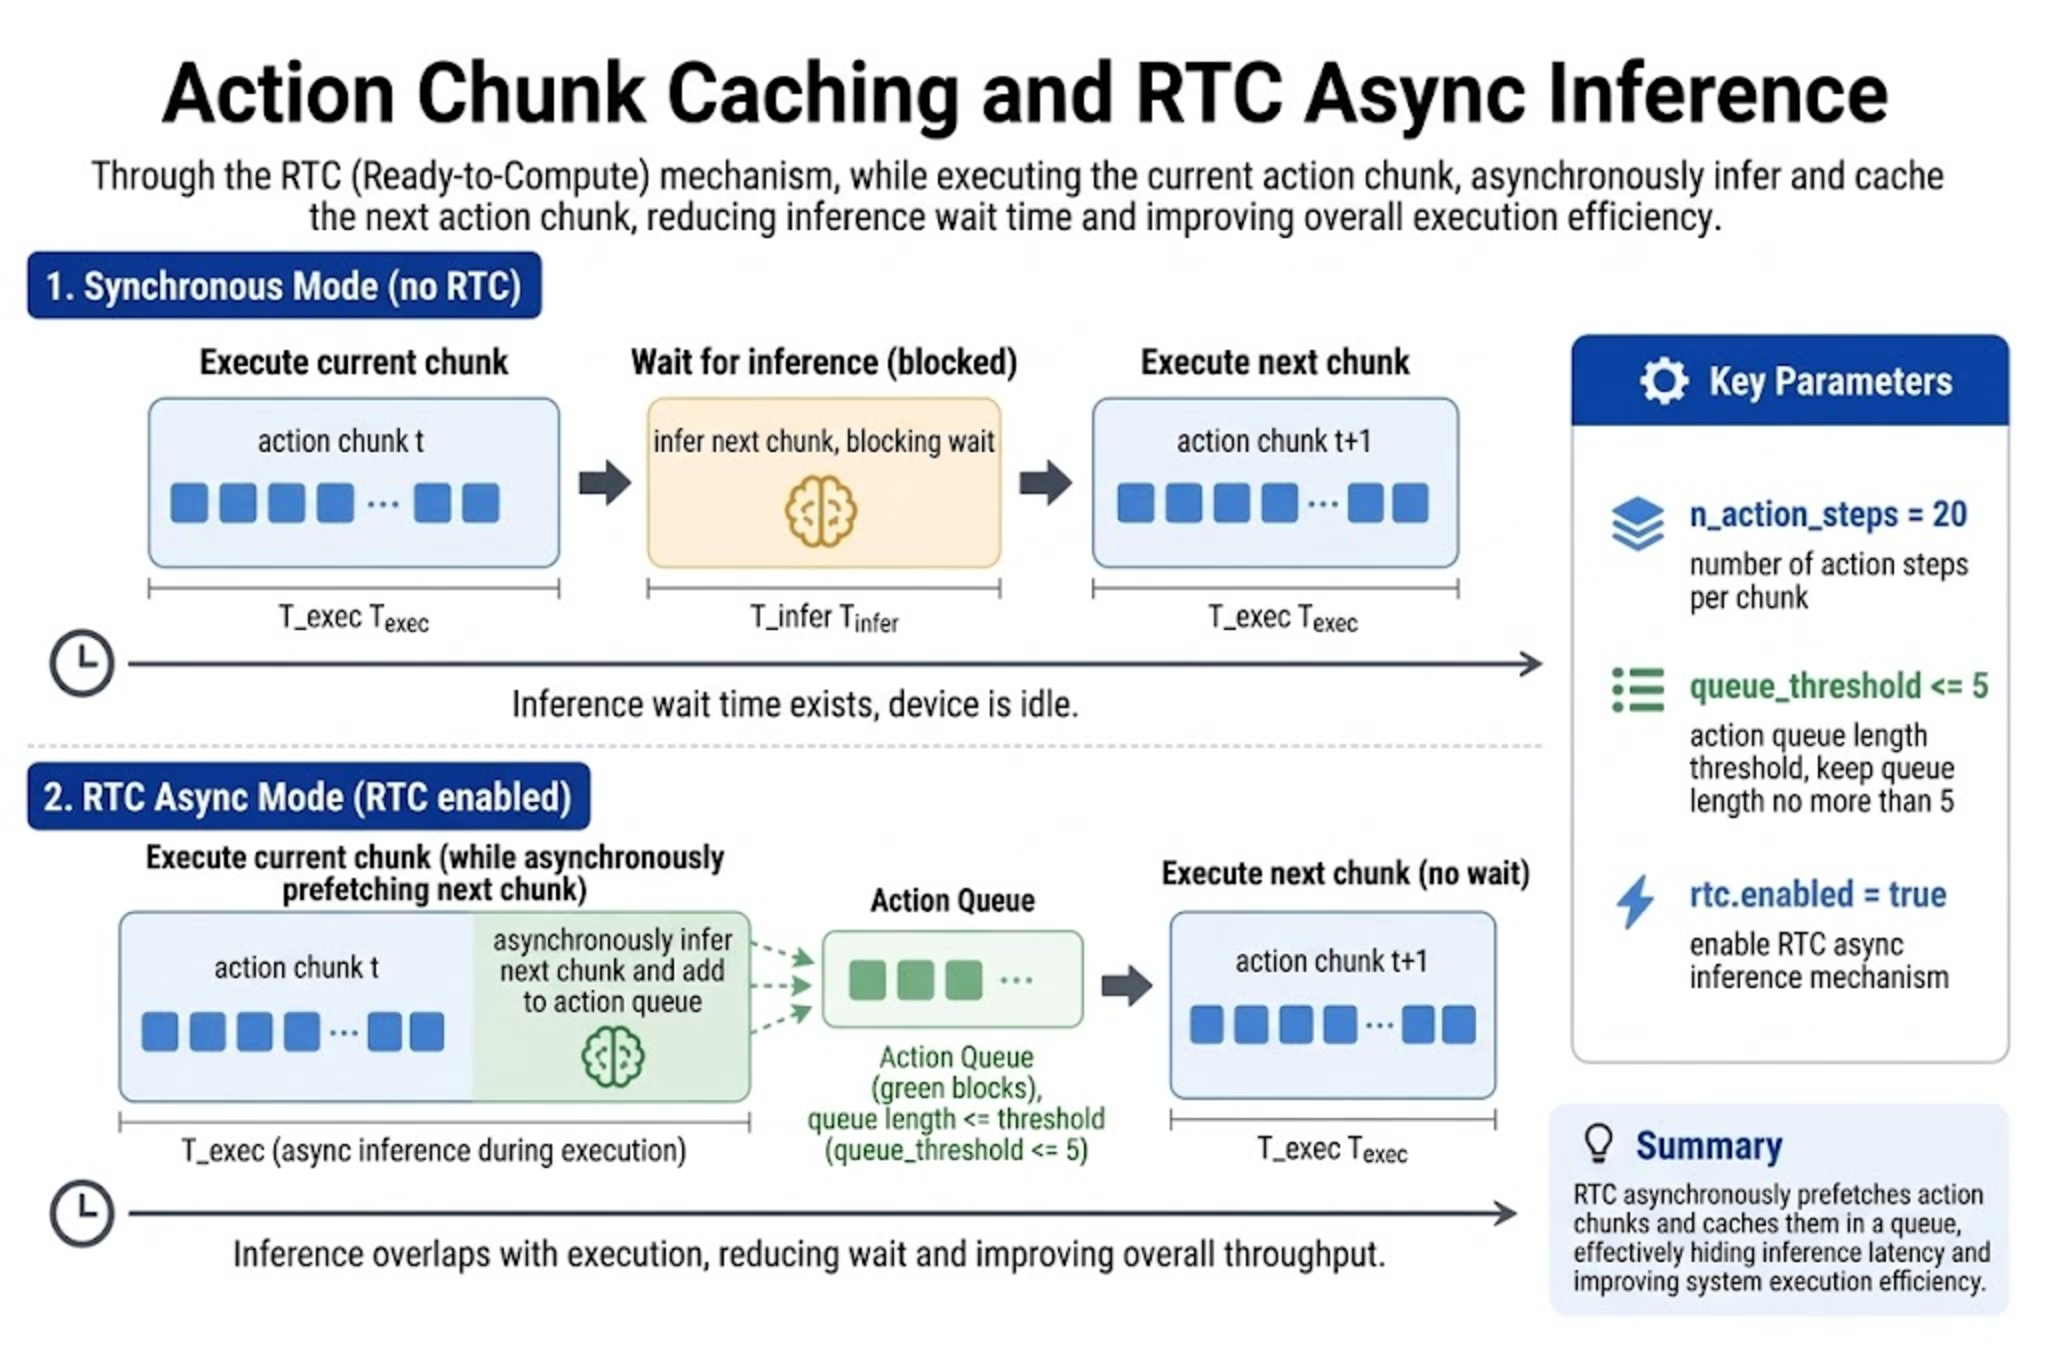
アクションキュー
制御側は、受信した action_chunk をキューに書き込み、制御サイクルごとにポップします。キューが空になる前に次のチャンクが到着しない場合、アームは一時停止するか最後のアクションを再利用します — これはまさに非同期推論が回避する状況です。
RTC(Real-Time Chunking)
現在のチャンクを実行している間、バックエンドは最新の観測値を用いて次のチャンクを要求します:
lerobot-rollout \
  ... \
  --policy.n_action_steps=20 \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=0
| パラメータ | 推奨値 |
|---|---|
n_action_steps / execution_horizon | まずは 20 から開始し、その後ジッタに合わせて調整 |
queue_threshold | 5 以下を推奨;大きすぎると古いアクションが溜まる |
ジッタ/ビクつきが現れた場合は、まず --inference.rtc.enabled=false を設定して同期パスが健全か確認し、その後 RTC を有効にします。
22.8 実機ロボットの安全リミット
22.8 実機ロボットの安全リミット
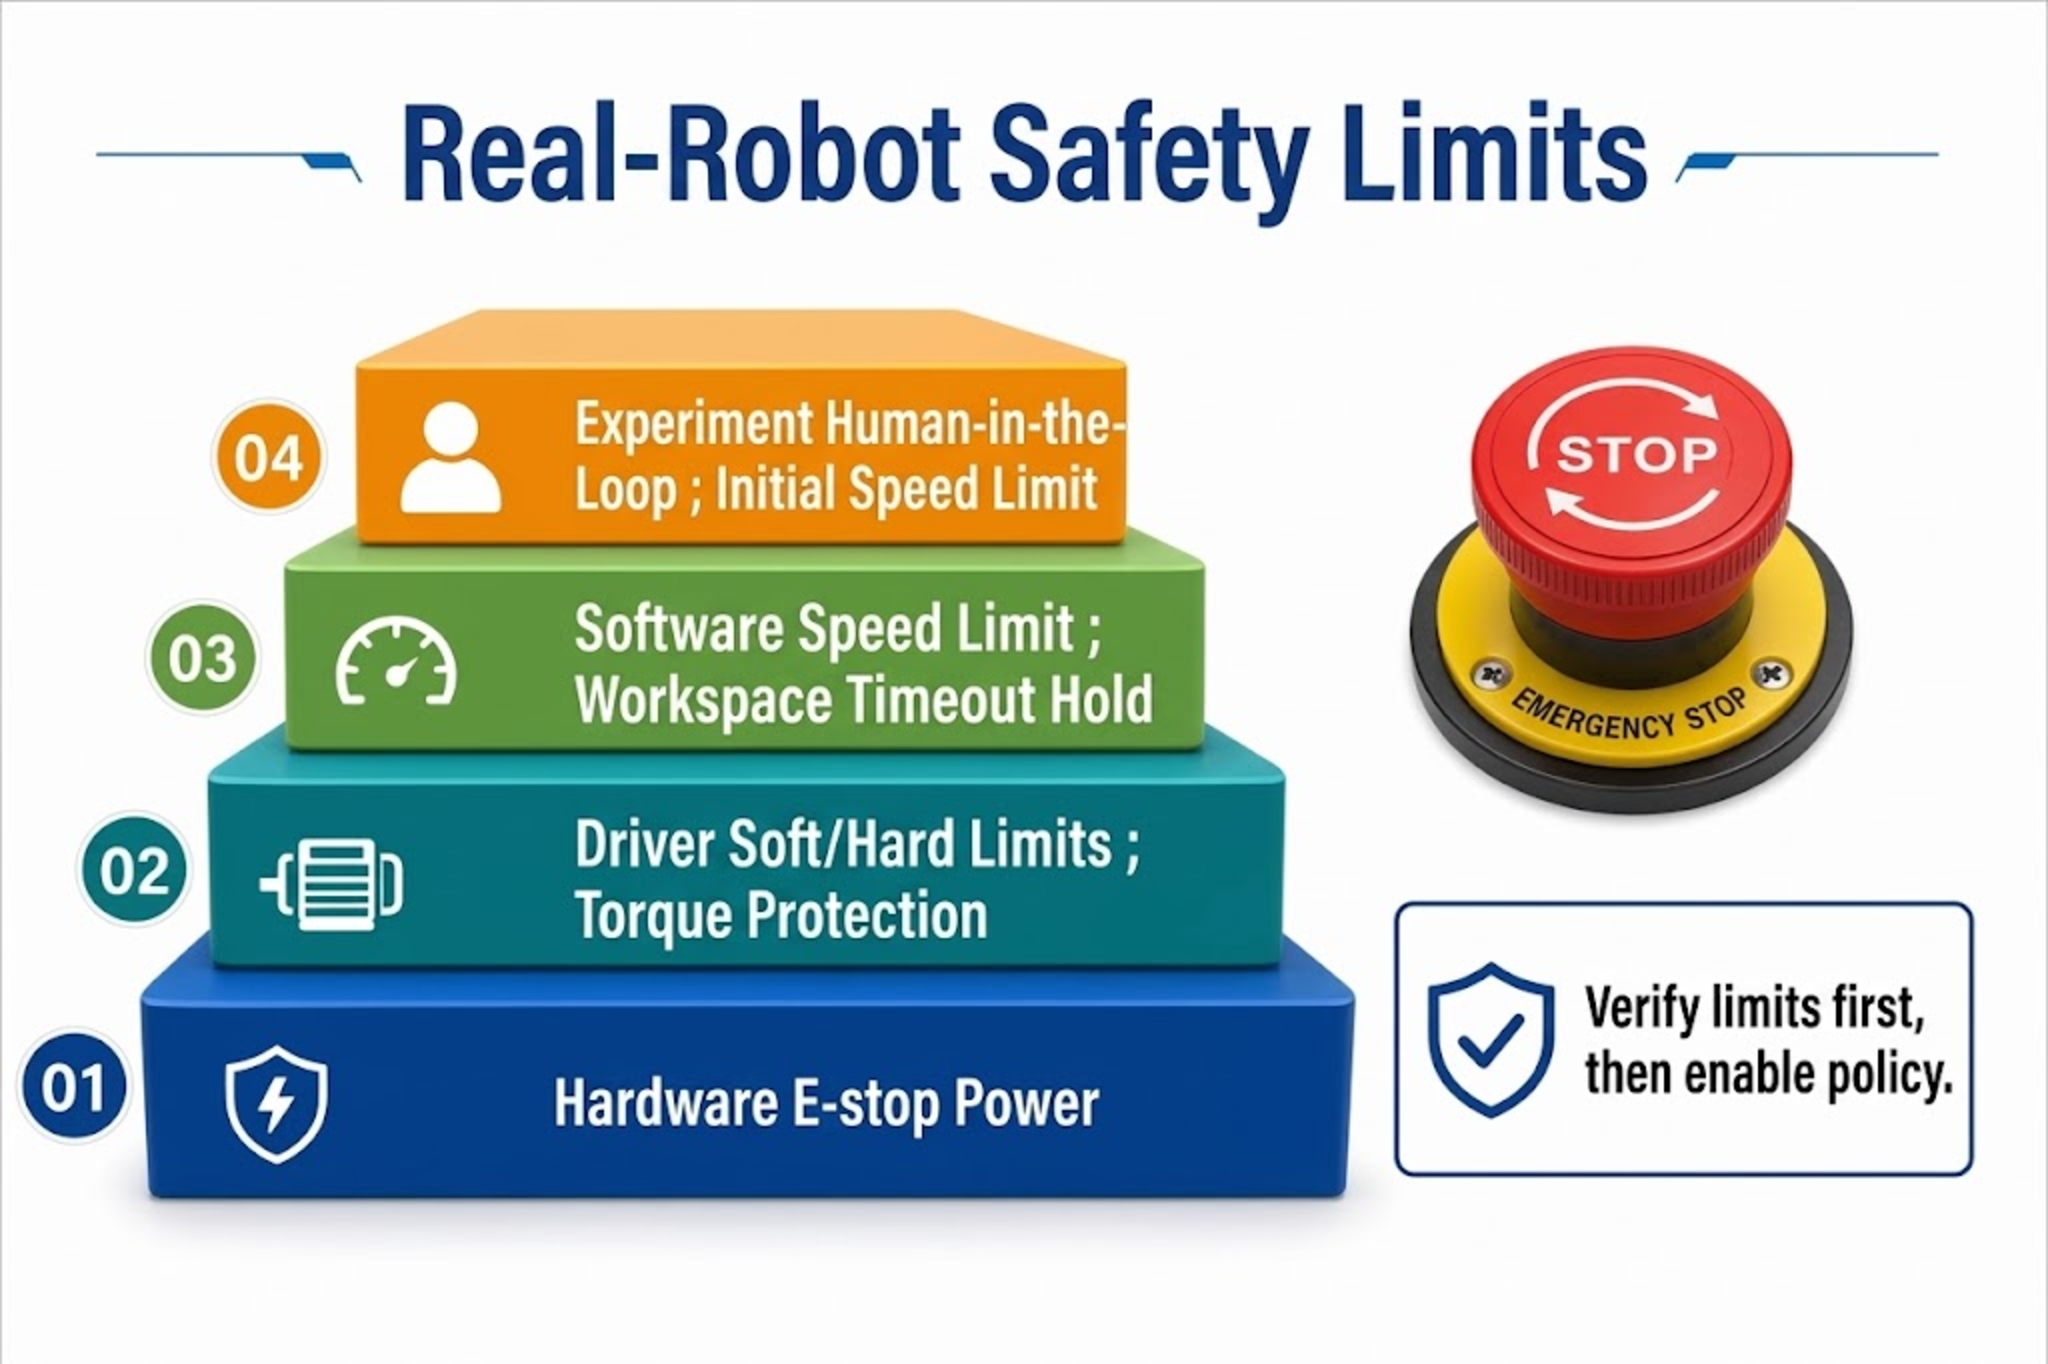
VLA の出力には物理的な保証が一切ないため、安全性は必ず制御レイヤで強制する必要があります:
| レイヤ | 対策 |
|---|---|
| ハードウェア | 非常停止ボタン、電源遮断、ケーブルが絡まないようなケーブルマネジメント |
| ドライバ/ファームウェア | 関節のソフト/ハードリミット、電流/トルク保護 |
| ソフトウェア制御 | 速度/加速度クリッピング、ワークスペースボックス、タイムアウト時にホールドまたは安全姿勢への移動 |
| 実験フロー | 最初の推論ではゲイン/速度を下げる、人間がループに入る、テーブルから無関係な障害物を取り除く |
デバッグチェックリスト:
- ポリシーをロードする前に、マニュアル/テレオペでリミットが有効に機能していることを確認する。
- ポリシーロールアウト時は、まず短い
--durationを使って暴走がないことを確認する。 - 異常な動きがあれば即座に非常停止し、現在の
task、カメラフレーム、状態を記録し、その後データとモダリティを確認する。
22.9 VLA タスク評価
22.9 VLA タスク評価
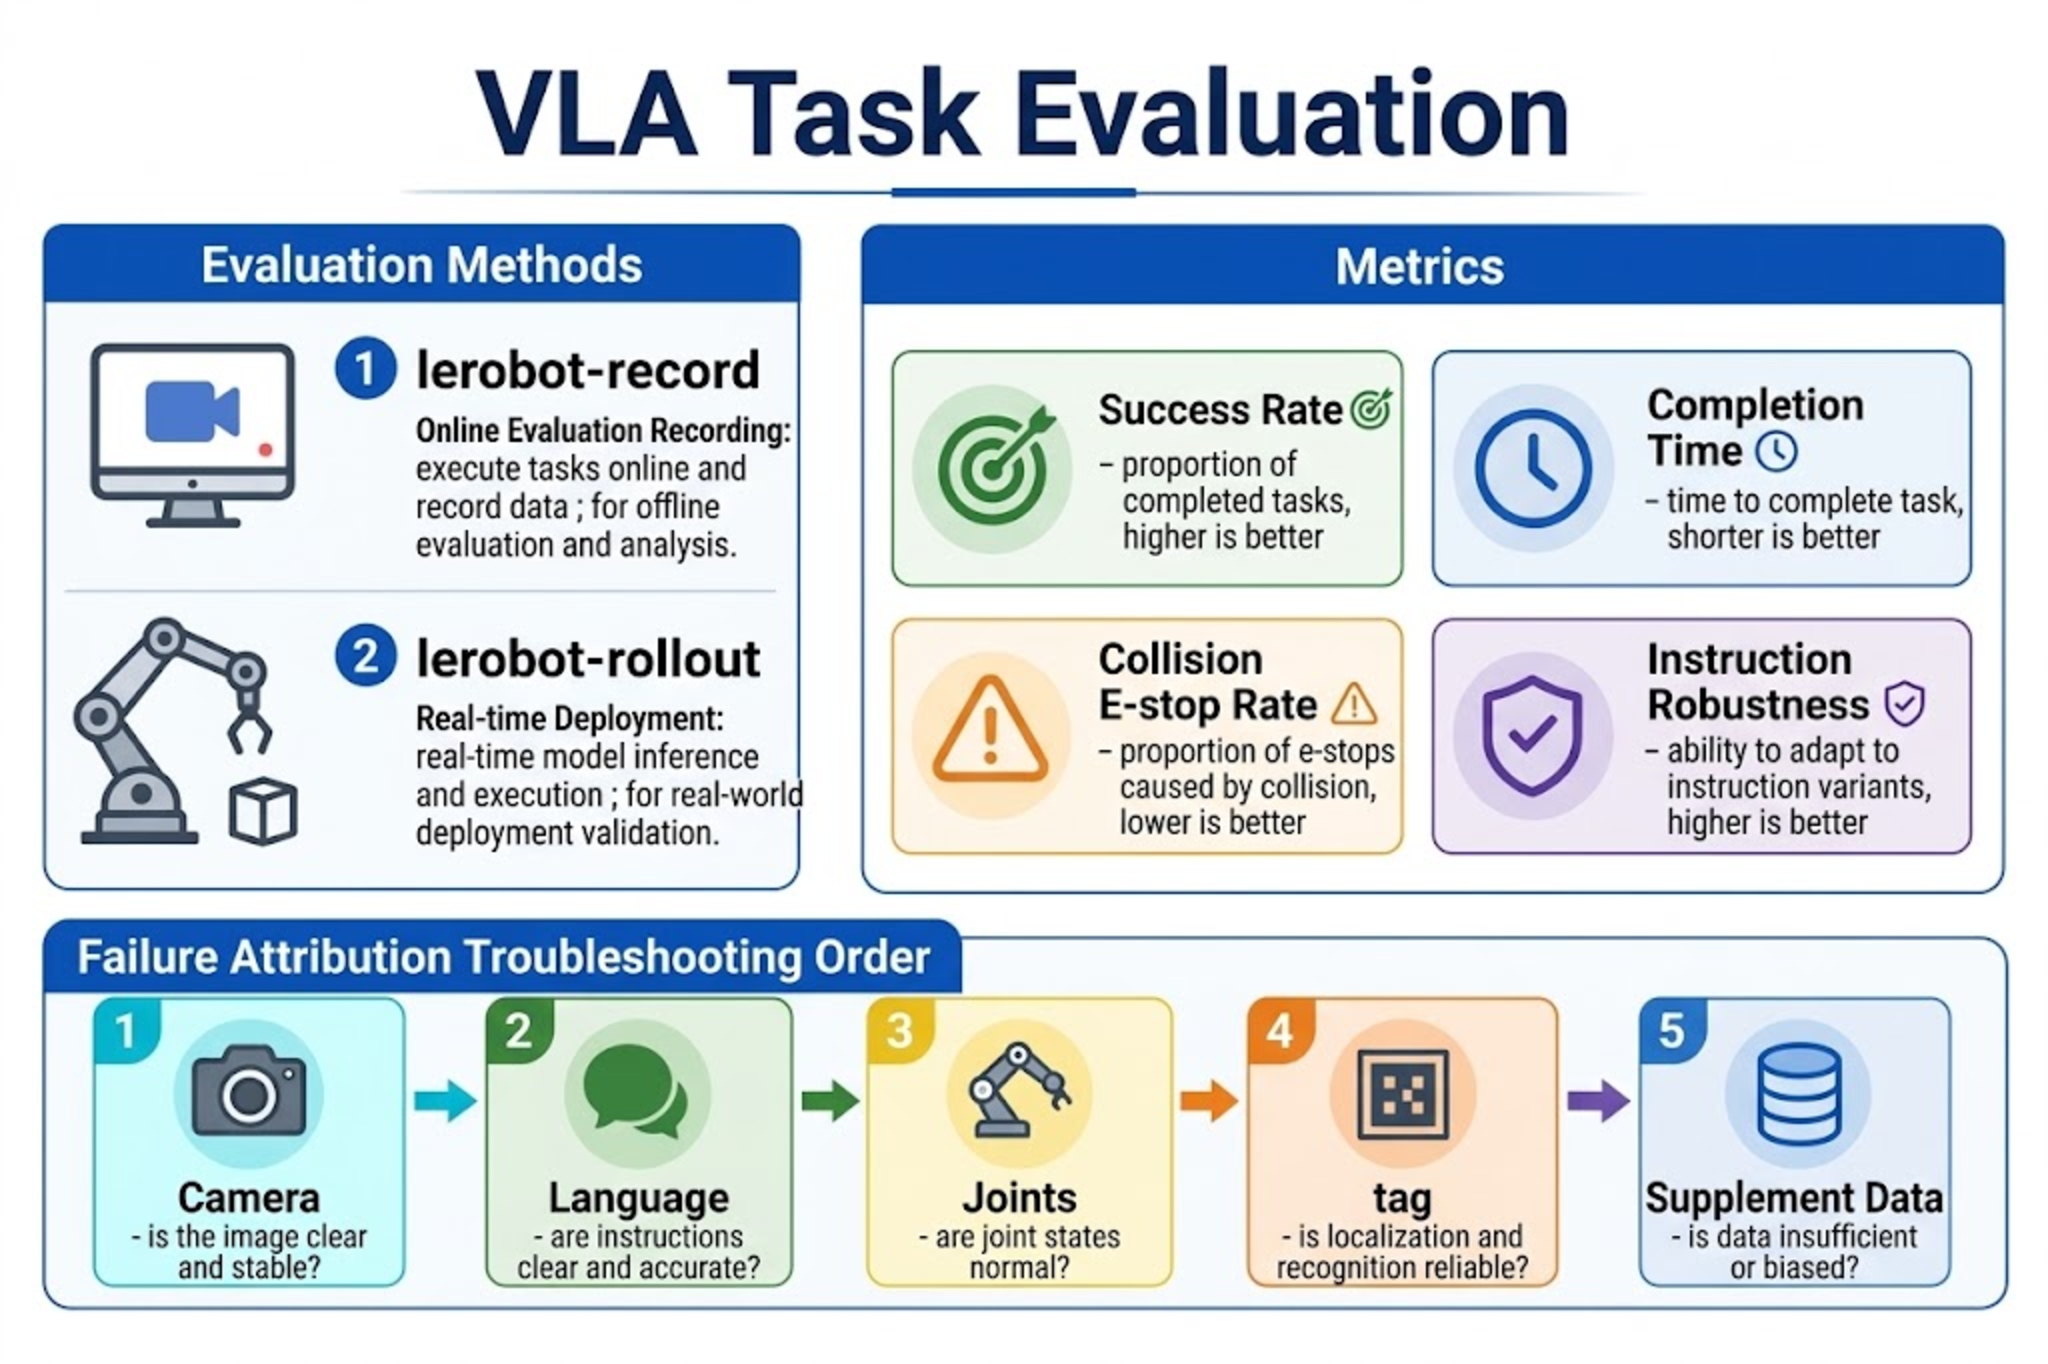
評価方法
| 方法 | ツール | 目的 |
|---|---|---|
| オンライン評価記録 | lerobot-record + --policy.path | 失敗/成功エピソードを保存してリプレイする |
| リアルタイムデプロイ | lerobot-rollout | レイテンシ、RTC、長期安定性をテストする |
推奨メトリクス
| 指標 | 説明 |
|---|---|
| 成功率 | 固定された初期条件と指示の下での成功数/総試行数(20 回以上を推奨) |
| 完了時間 | 開始から配置完了までの秒数 |
| 衝突/非常停止率 | タスクと無関係な衝突や手動介入の比率 |
| 指示のロバスト性 | 同じタスクに対して指示文を少し言い換えても成功するか(学習分布の範囲内に限る) |
失敗要因の切り分け順序
- カメラのキー名/解像度は学習時と一貫しているか?
- 言語文のパターンがアノテーションから逸脱していないか?
- 関節の順序と単位。
embodiment_tag、相対アクションスイッチ。- データカバレッジ不足 -> 第 20 章に戻ってデータを追加収集。
22.10 ステージプロジェクト:試験管を左側ラックに置く
22.10 ステージプロジェクト:試験管を左側ラックに置く
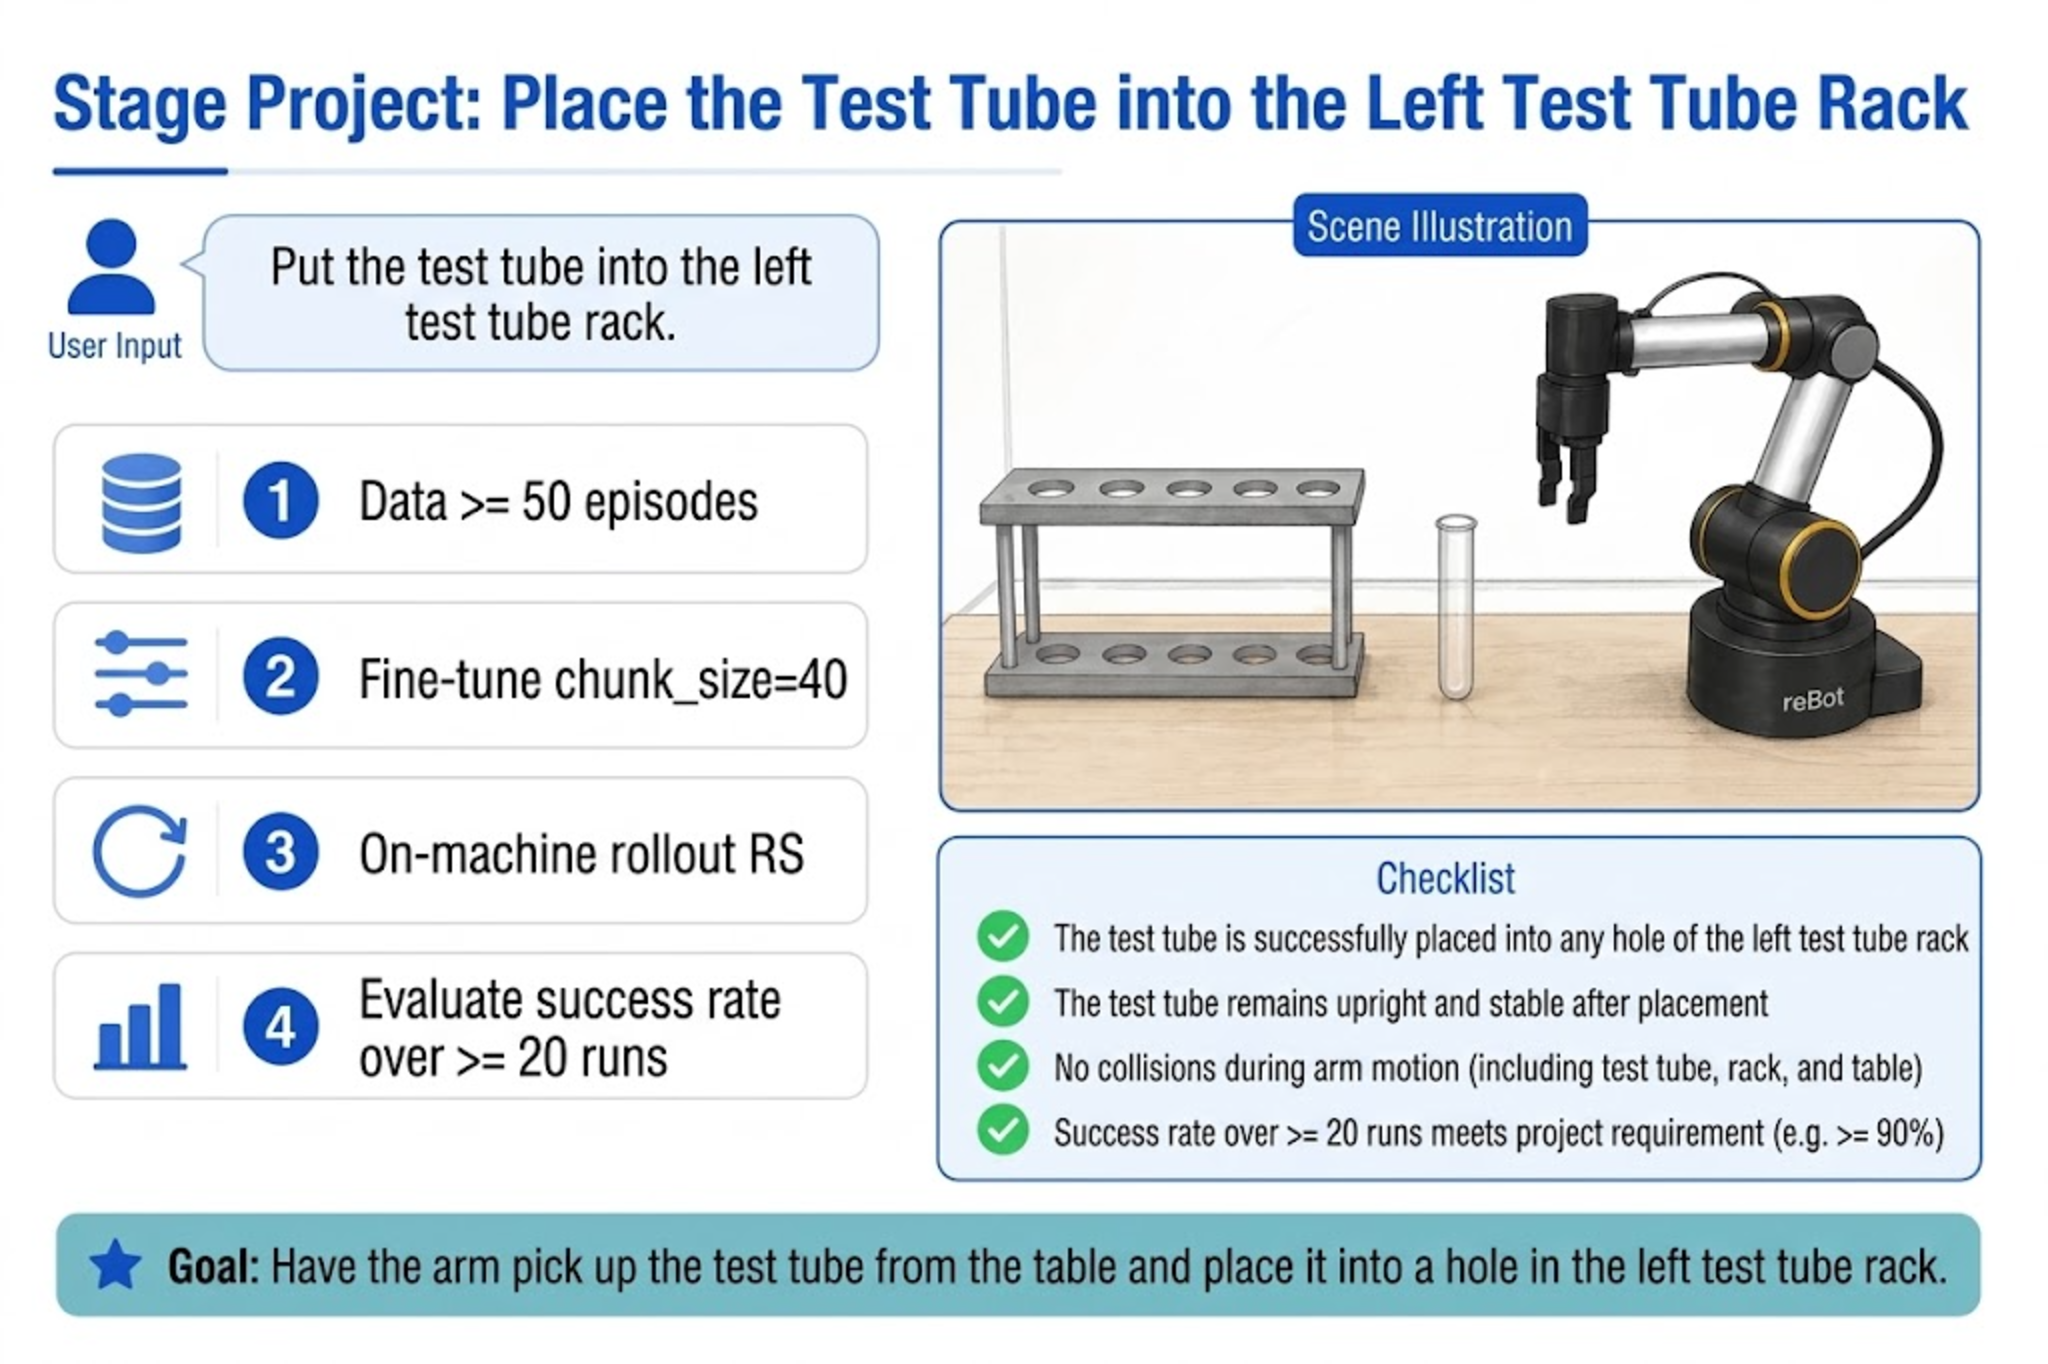
プロジェクト目標
| 項目 | 内容 |
|---|---|
| ユーザー入力 | Place the test tube into the left rack. |
| システム入力 | 広角ビューの front + 手首の side + 現在の 7 次元状態 |
| 期待される出力 | アームが試験管の把持 -> 左側ラックへの移動 -> 配置 -> グリッパー解放を完了する |
実装ステップ
-
データ(まだこのタスクをカバーしていない場合)
- 50 回以上の成功デモを収集し、上記の文パターンで一貫してアノテーションする。
meta/modality.jsonを記述する(front/side、single_arm+gripper、human.task_description)。
-
ファインチューニング(第 21 章)
embodiment_tag=new_embodiment,chunk_size=40。checkpoints/last/pretrained_modelを取得する。
-
単一マシンでのデプロイ推論(B601-RS の例;DM の場合は
type/port/can_adapterを変更)
export MODEL_PATH="outputs/train/${REPO_ID}/checkpoints/last/pretrained_model"

# RS CAN
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-rollout \
  --strategy.type=base \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --policy.n_action_steps=20 \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"}}" \
  --task="Place the test tube into the left rack." \
  --duration=90 \
  --device=cuda \
  --display_data=true \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=0
- 評価
- テーブルレイアウトを固定し、20 回以上繰り返して成功率を記録する。
- 失敗エピソードを
lerobot-recordでアーカイブし、誤りが位置決め、把持、配置のどこにあるかを分析する。
受け入れ基準
- 指示 "Place the test tube into the left rack." が与えられたとき、タスクをエンドツーエンドで実行できる。
-
front/sideが学習と一致しており、mean is infinityタイプのキーエラーがない。 - 非常停止とソフトリミットが機能し、異常動作時に手動で動きを遮断できる。
- 成功率を記録し、次のステップがデータ追加か
n_action_steps/ RTC の調整かを判断する。
22.11 章のまとめ
22.11 章のまとめ
- デカップリング: 制御側は取得と実行を担当し、推論側は VLA のフォワードパスを担当します;インターフェースは観測 -> Action Chunk です。
- デプロイ: まず単一マシンから始め、必要に応じて分散に移行します;分散ではネットワークレイテンシに特別な注意が必要です。
- 入力: カメラ + 状態 + 言語は学習時と厳密に整合している必要があります。
- 出力: アクションチャンクは
n_action_stepsで消費し、RTC はキューを使って推論時間をマスクします。 - 安全性: リミット、非常停止、速度クリッピングは制御レイヤで強制されます。
- 評価: 成功率 + 失敗要因の切り分け;ステージプロジェクトは「言語 -> 実機ロボットアクション」のクローズドループを検証します。
これで、VLA の理論、データ、ファインチューニングから GR00T 実機ロボットデプロイ までのフルパスを完了しました。今後の反復では、学習ステップを闇雲に増やすのではなく、失敗シナリオのデータ収集を優先してください。