27. ロボットビジョンと3D認識
Seeed Physical AI Beginner's Course の第27章 — ロボットがピクセルから3Dを得る方法:ロボットビジョンパイプライン、RGB-Dセンシング、深度マップ、ステレオ / 構造化光 / TOF深度カメラ、内部パラメータと外部パラメータを持つピンホールカメラモデル、ピクセルから3Dへの変換と点群。
このステージで必要なハードウェア
このステージのために準備するもの。すべてのステージの完全な一覧は第3章にあります。
メイン制御ユニット
| 項目 | 購入 | 数量 |
|---|---|---|
| reComputer Robotics J4012 | 🛒 | 1 |
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
デスクトップまたはノートPCも必要です:Ubuntu 22.04、GTX 4080 以上で 12GB 以上のVRAM、16GB以上のRAM。
このステージ用
| 項目 | 購入 | 数量 |
|---|---|---|
| reBot Arm B601 DM/RS | 🛒 | 1 |
| Realsense 435i または Orbbec Gemini2 深度カメラ または Realsense 405 ステレオカメラ | 🛒 | 1 |
| カメラリストマウント | 🛒 | 1 |
27.1 章の概要
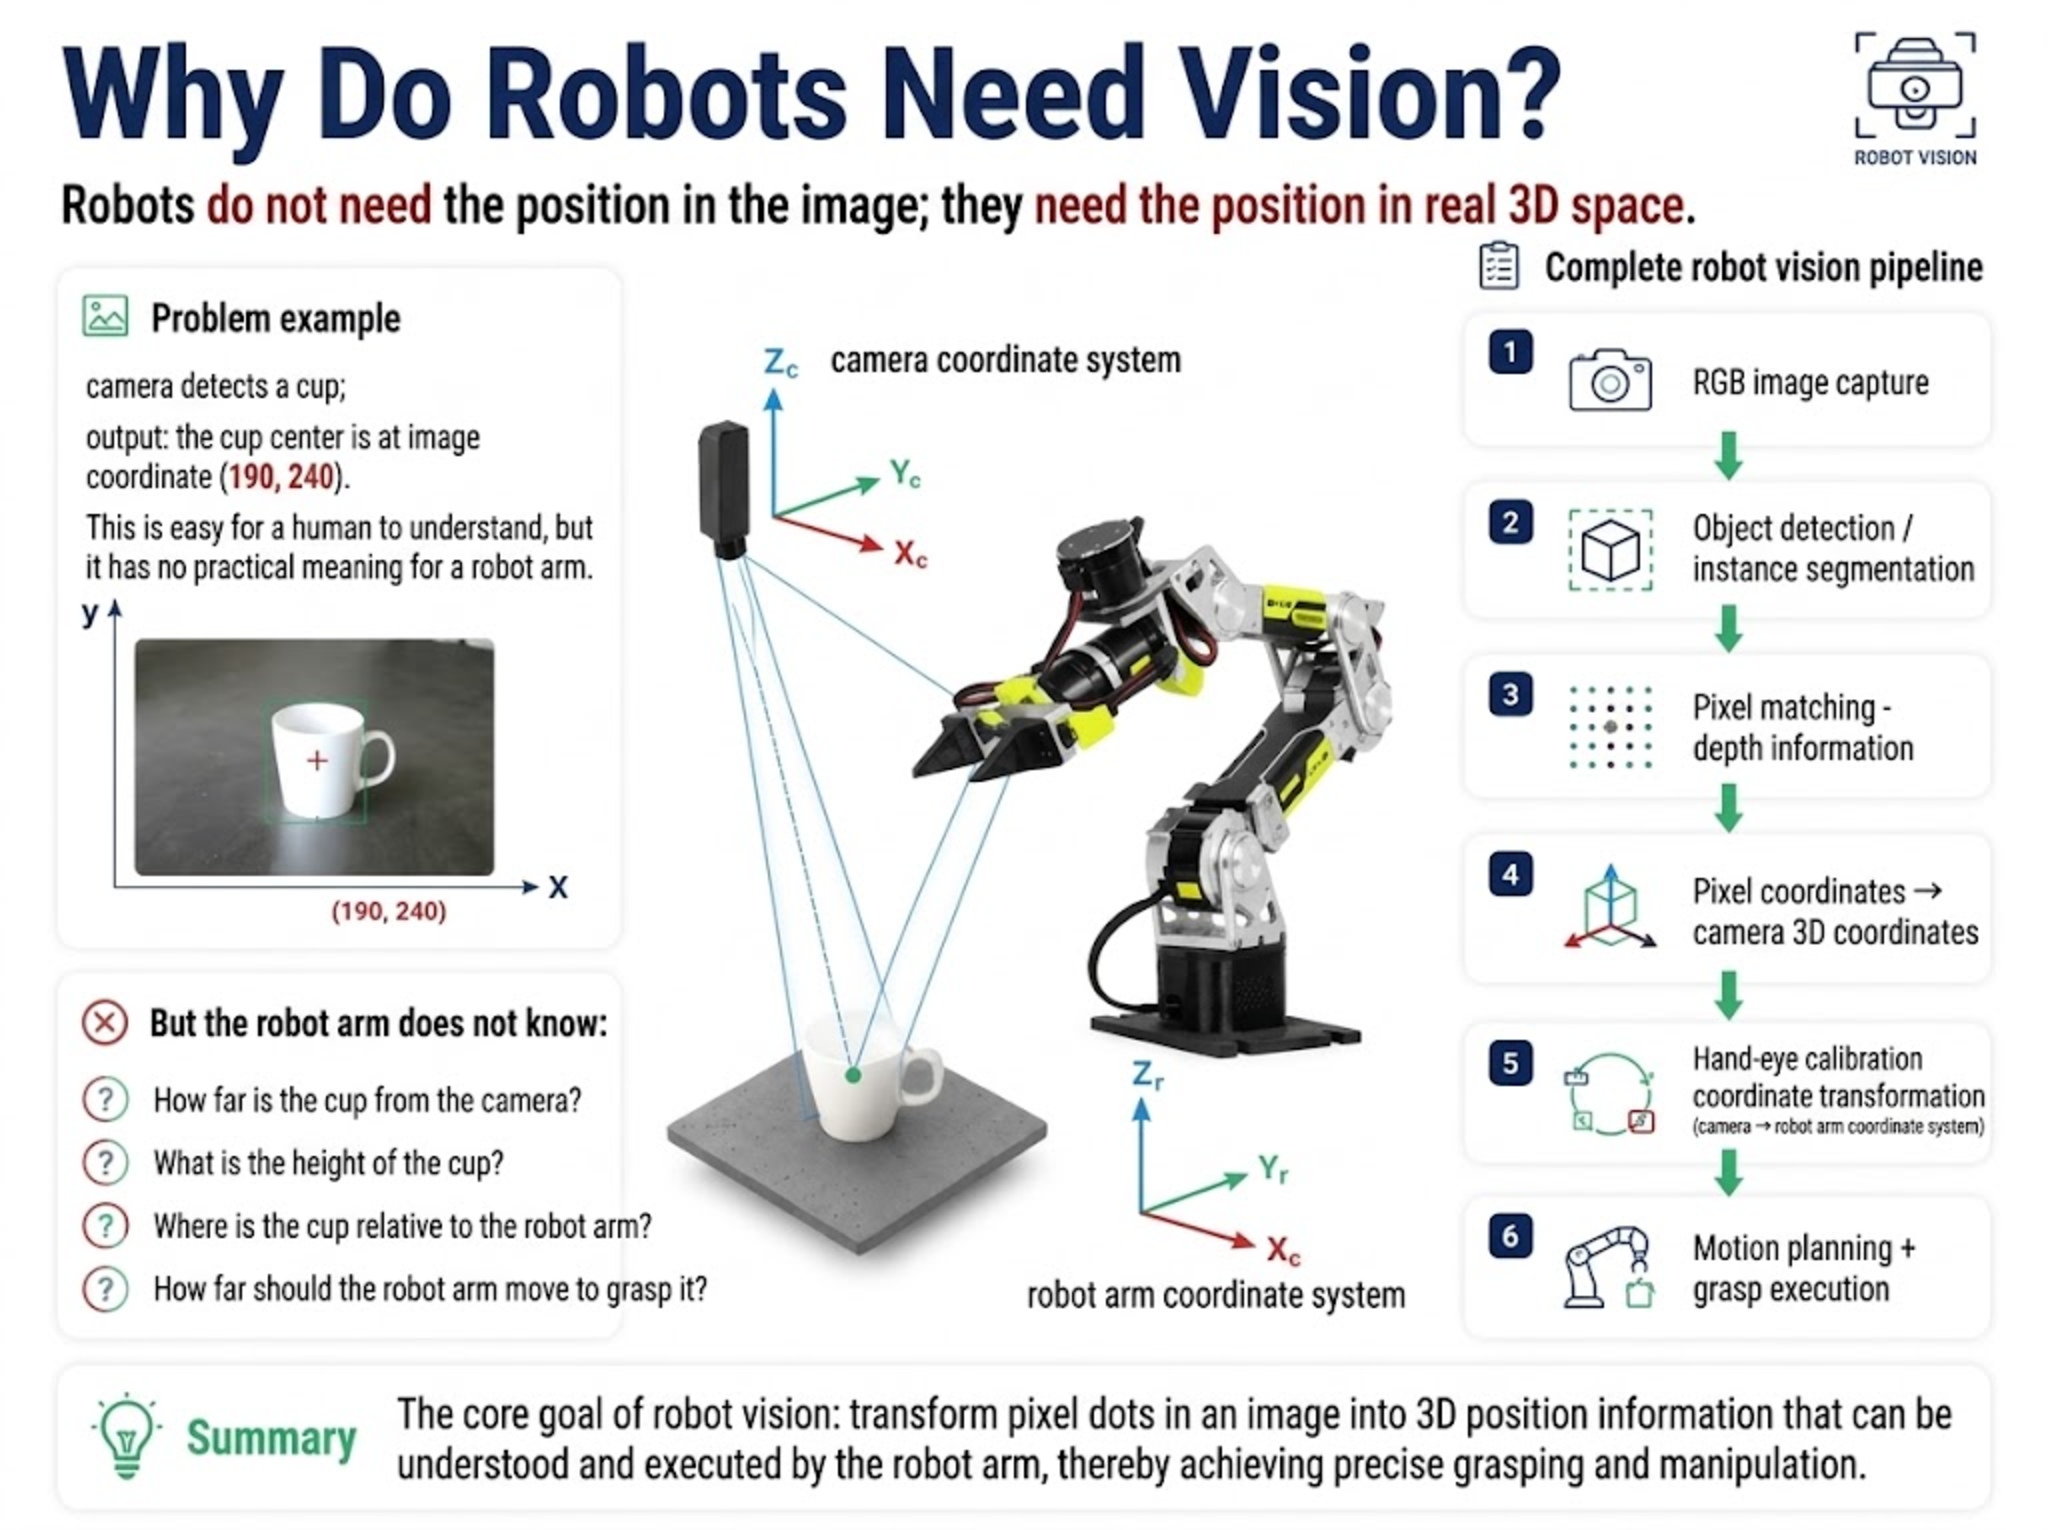
ロボットビジョンは、ロボットが外部環境を知覚するための重要な手段です。ロボットアームにとって、「物体が画像のどこにあるか」を知るだけでは不十分であり、ロボットが本当に必要としているのは、実際の三次元空間における物体の位置です。
例えば:カメラがコップを検出し、「コップの中心は画像座標 (190, 240) にある」と出力したとします。これは人間には理解しやすいですが、ロボットアームにとっては実際の意味を持ちません。
なぜならアームは次のことを知らないからです:
- コップがカメラからどれくらい離れているか
- コップの高さがどれくらいか
- コップがアームに対してどこにあるか
- つかむためにアームをどれだけ動かせばよいか
したがってロボットビジョンは、次のような完全なプロセスを完了する必要があります:
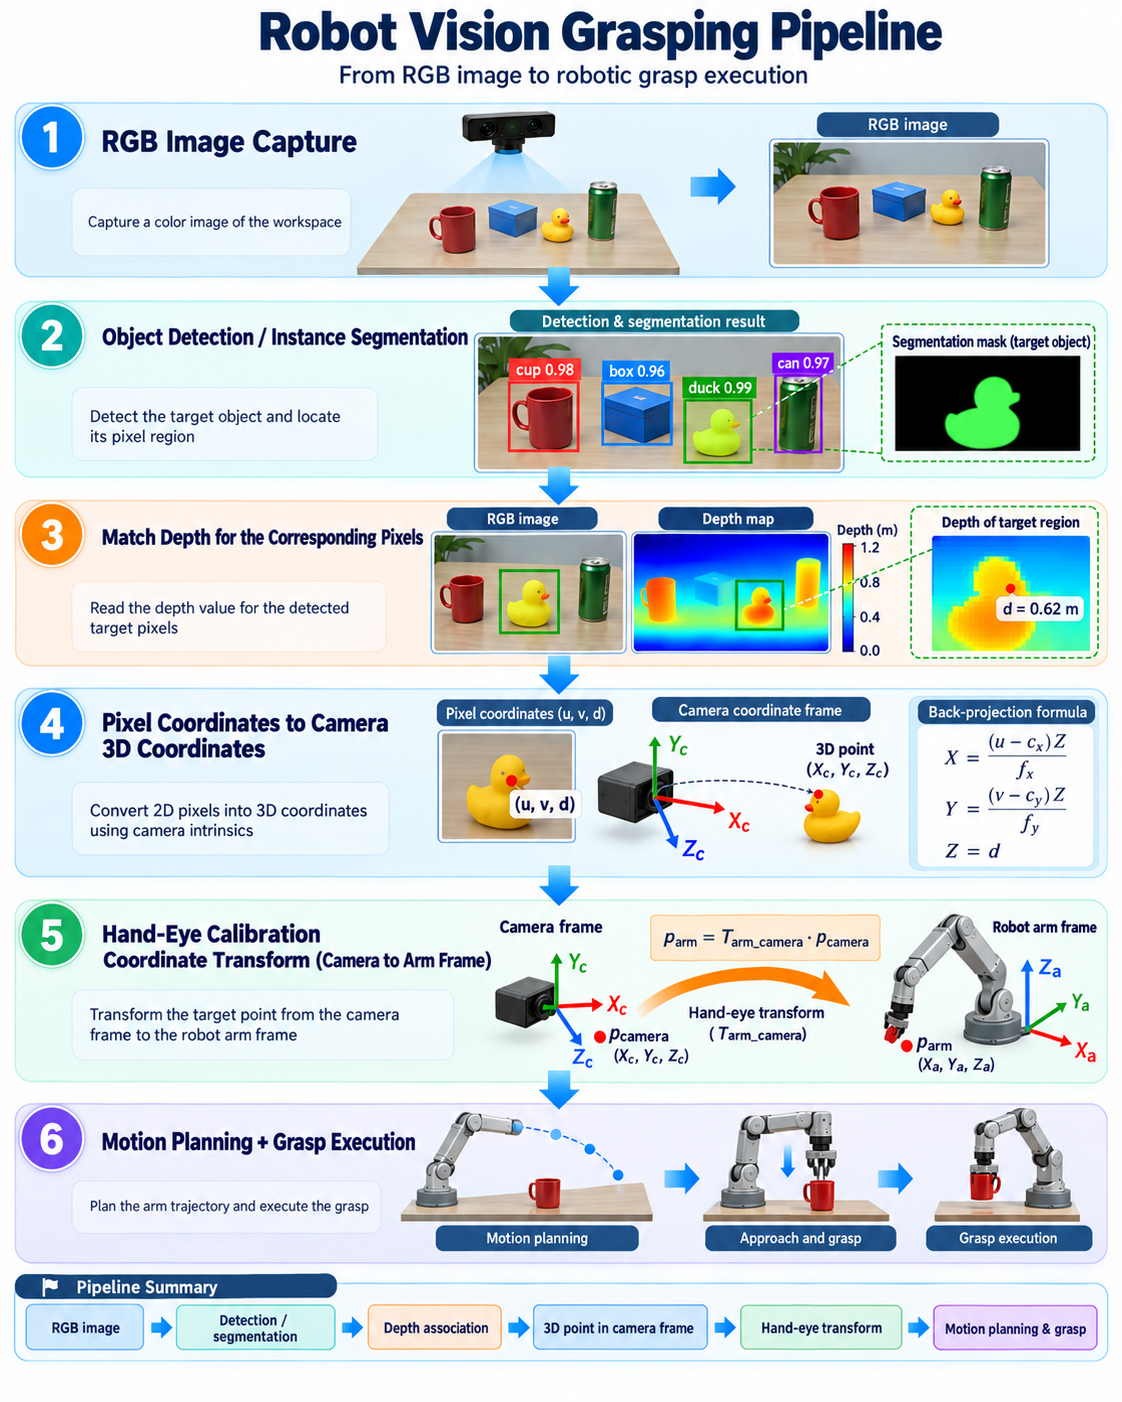
27.2 ロボットビジョンシステムの概要
ロボットビジョンとは
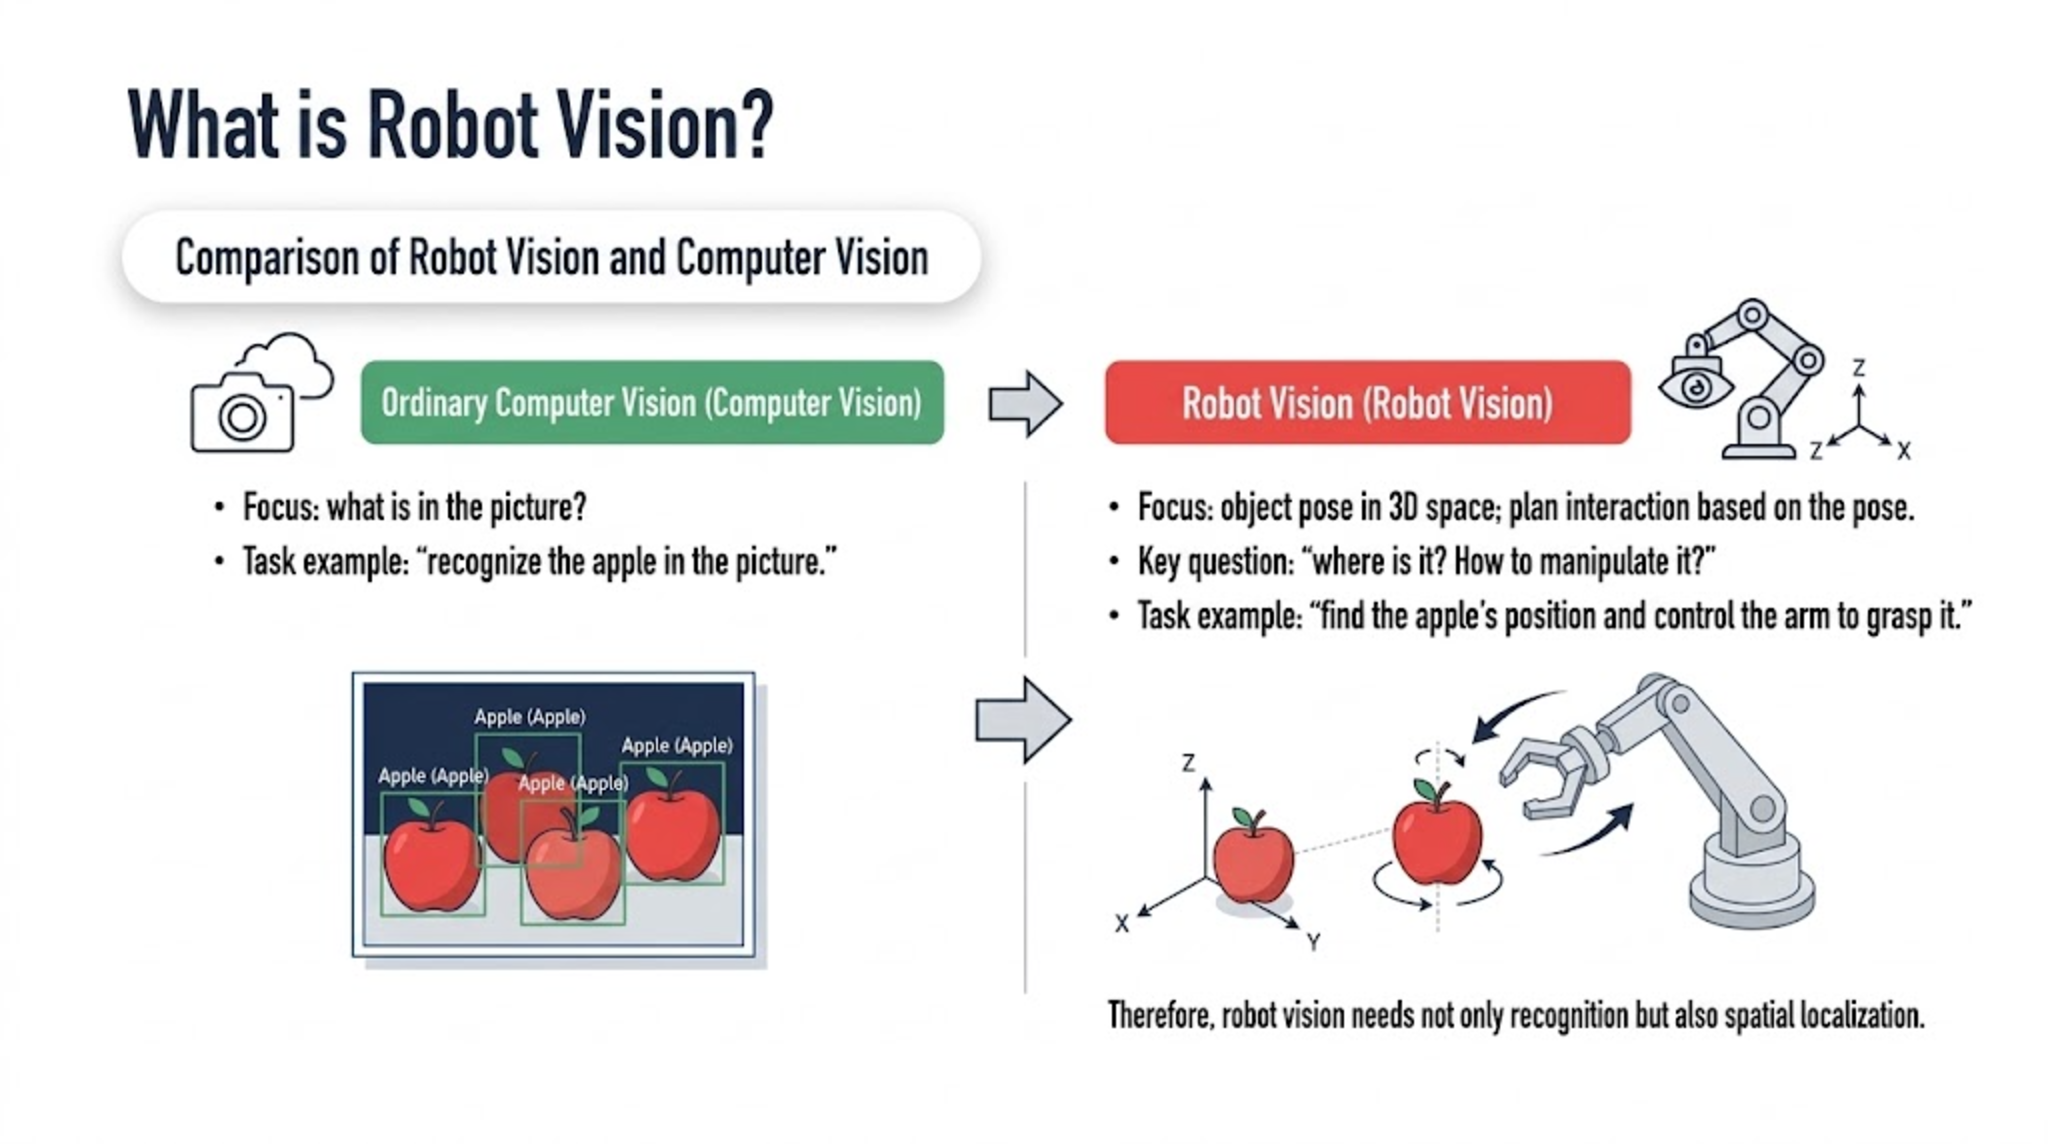
ロボットビジョンとは、ロボットがカメラなどのセンサーを用いて環境情報を取得し、アルゴリズムによってそれを理解することで、位置推定、認識、把持などのタスクを完了することを指します。通常のコンピュータビジョンとは異なり:
- 通常のコンピュータビジョンは「画像の中に何が写っているか」を問います。
- ロボットビジョンは主に2つの問題に焦点を当てます:3D空間における物体の姿勢と、その姿勢からロボットの動作を計画してインタラクションを完了すること、つまり「これはどこにあるのか?ロボットはどのように操作すべきか?」ということです。
例えば:
- コンピュータビジョンタスク:「画像の中のリンゴを認識する」。
- ロボットビジョンタスク:「リンゴの位置を見つけ、アームを制御してそれをつかむ」。
したがってロボットビジョンには、認識だけでなく空間的な位置推定も必要です。
アームのビジュアル把持パイプライン
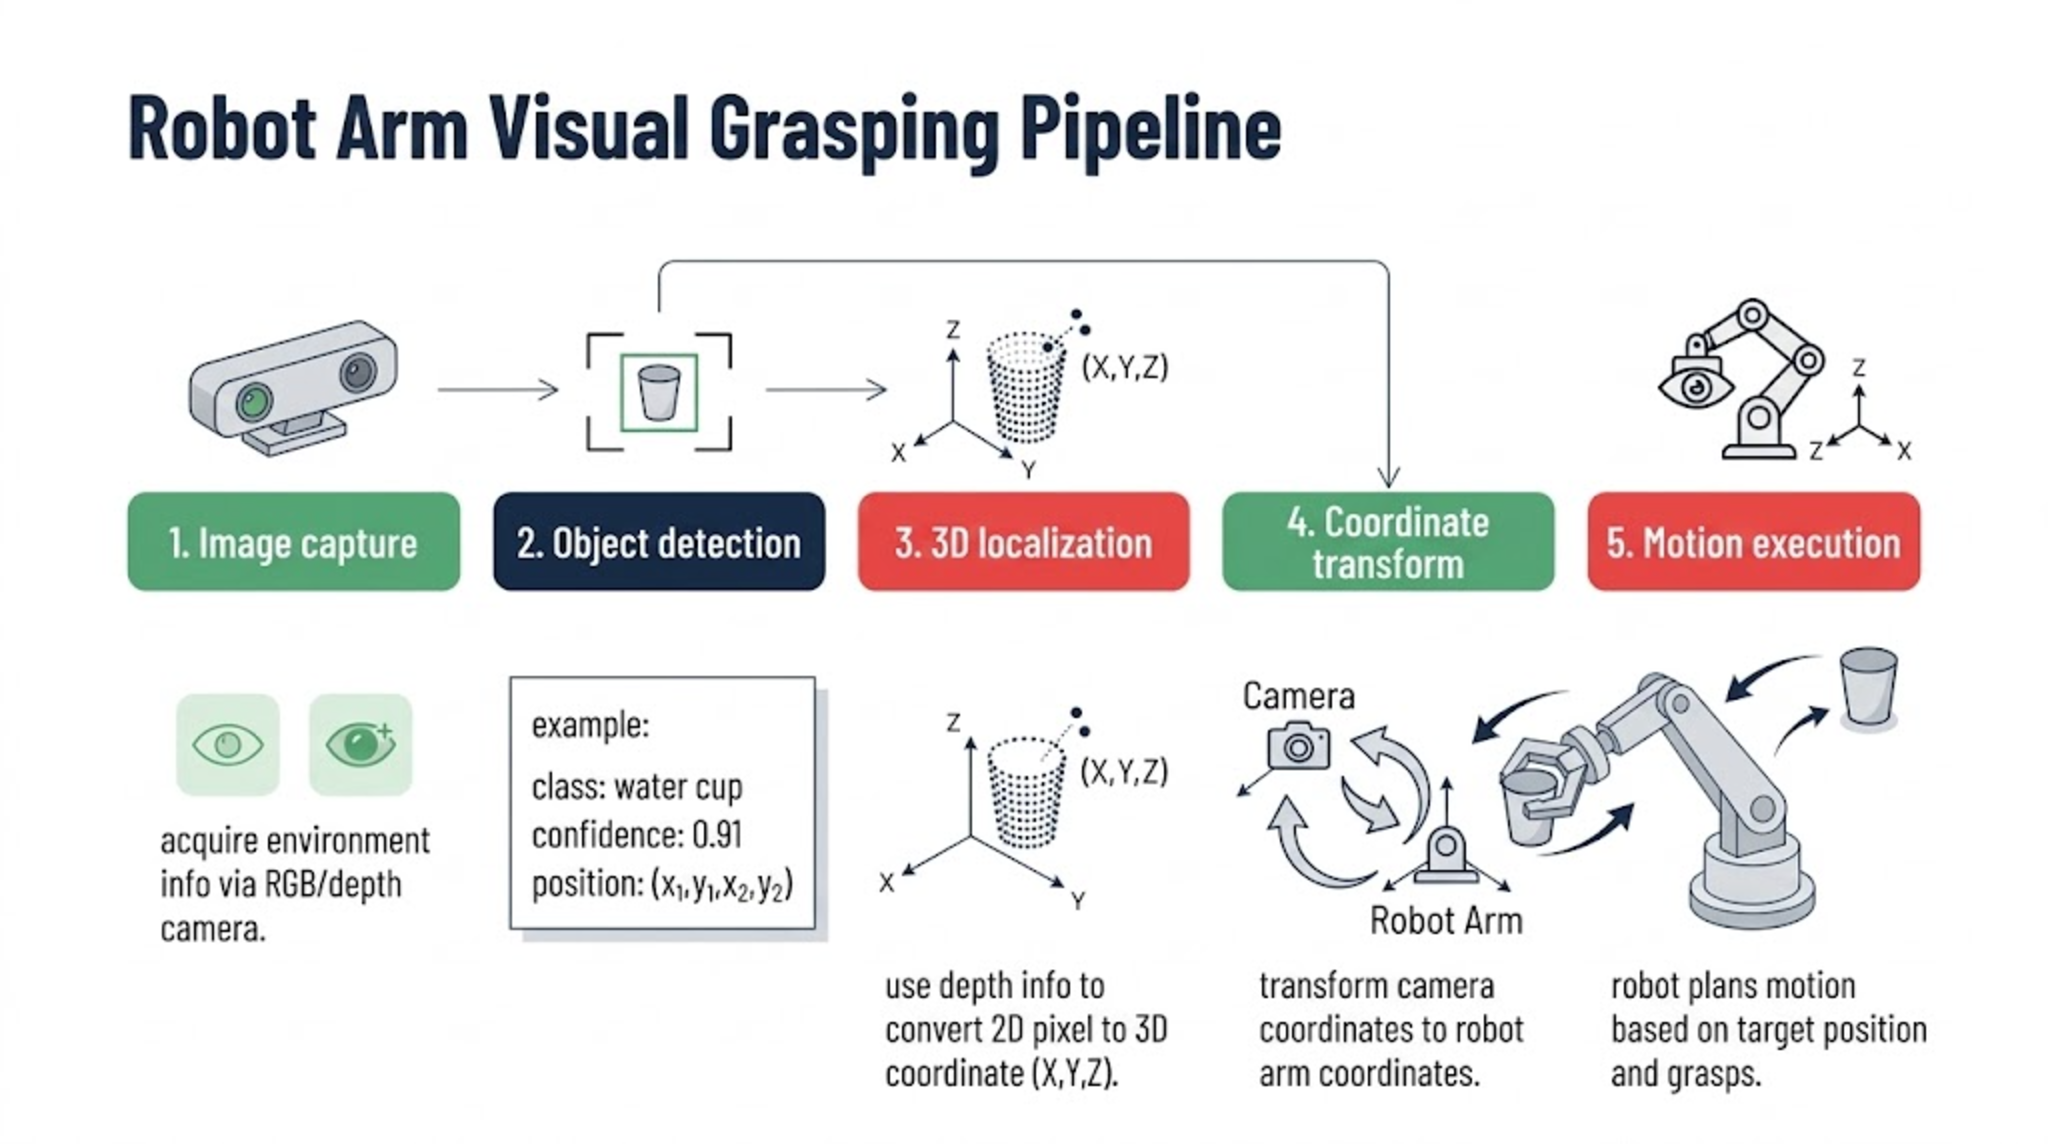
完全なビジュアル把持システムは通常、次の要素を含みます:
- ステップ1:画像取得
- RGBカメラまたは深度カメラを通じて環境情報を取得する。
- ステップ2:物体検出
- ターゲット物体を見つけ、分類し、その位置を取得する
- 例えば:
- クラス:水のコップ
- 確信度:0.91
- 位置:(x1,y1,x2,y2)
- ステップ3:3D位置推定
- 深度情報を用いて2Dピクセルを3D座標に変換する。
- ステップ4:座標変換
- カメラ座標をアーム座標に変換する。
- ステップ5:動作実行
- ロボットがターゲット位置から動作を計画し、把持を実行する。
RGB画像と物体検出
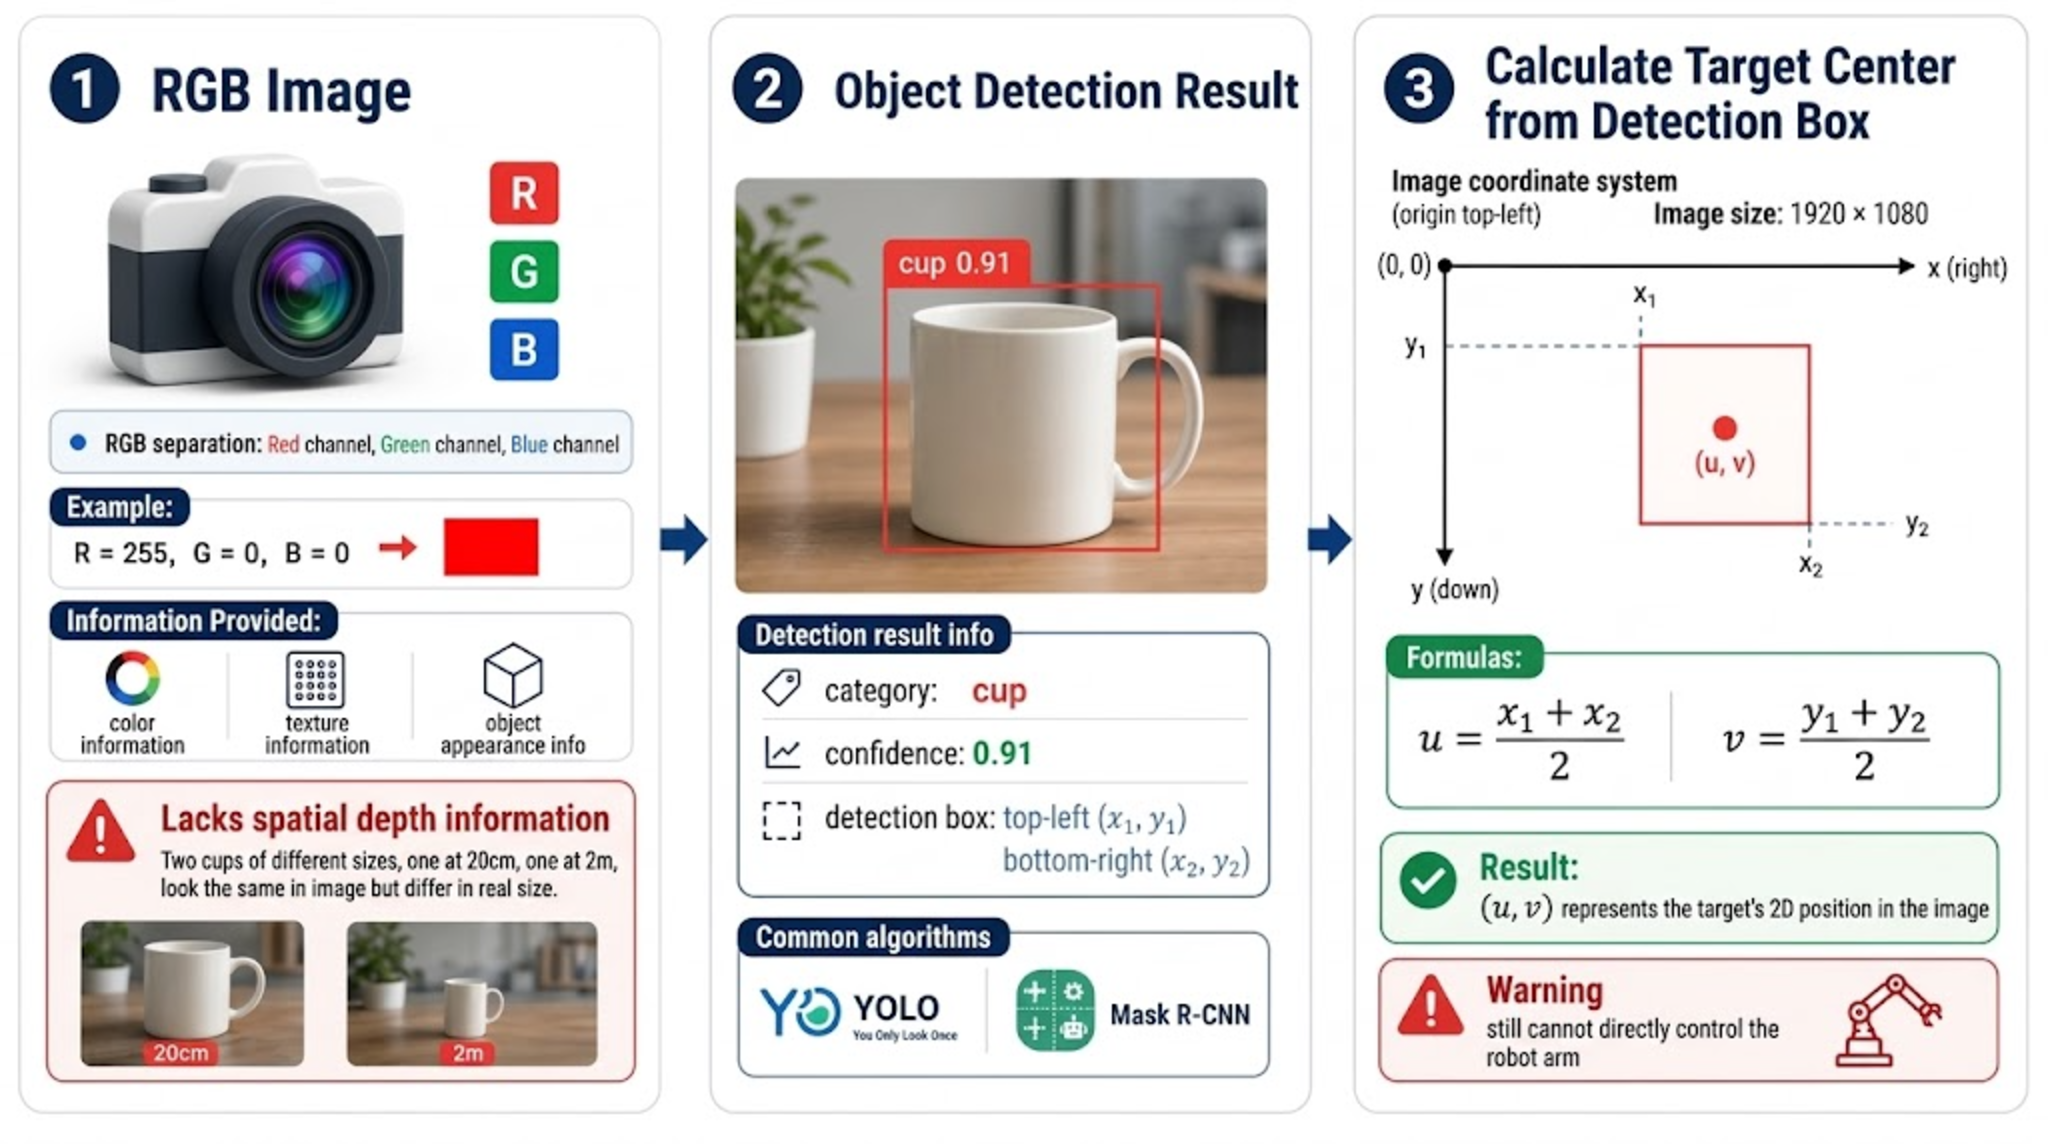
(1) RGB画像
RGB画像は、ロボットが使用する最も一般的な視覚データです。RGBは次を表します:
- R:Red(赤)
- G:Green(緑)
- B:Blue(青)
各ピクセルは3つの値で構成されます:, , 。
RGB画像は主に、色情報、テクスチャ情報、物体の外観情報を提供します。しかしRGB画像には重要な問題があります:空間的な距離情報が欠けていることです。
- 例えば:2つのコップがあり、1つはカメラから20cm、もう1つは2m離れているとします。同じ大きさであれば、2D画像では非常によく似て見えるかもしれません。RGBはロボットに「コップが画像のどこにあるか」だけを伝えることができますが、「コップが自分からどれくらい離れているか」は伝えられません。
(2) 物体検出の結果
ロボットは通常、画像全体を直接使うのではなく、まず物体検出を実行します。
検出アルゴリズム(YOLO, Mask R-CNN)は次のような出力を行います:
| フィールド | 意味 |
|---|---|
| Class | cup — コップが検出された |
| Confidence | 0.91 — モデルがそのクラスであると91%確信している |
| Bounding box | 左上 (x1, y1)、右下 (x2, y2) |
(3) ボックスからターゲット中心を計算する
ロボットは通常、ターゲットの中心を必要とします。コンピュータが見る画像は本質的にピクセルのグリッドです。1920x1080の画像では、各ピクセルにはそれぞれ座標があります:左上は (0,0)、右下は (1920,1080)、xは右方向に増加し、yは下方向に増加します。したがって検出出力の (u,v) は本質的に画像座標です。次のように計算します:
結果:(u,v)。この点が画像内におけるターゲットの2D位置です。しかしこれだけではアームを直接制御することはできません。
27.3 ロボットが深度情報を必要とする理由
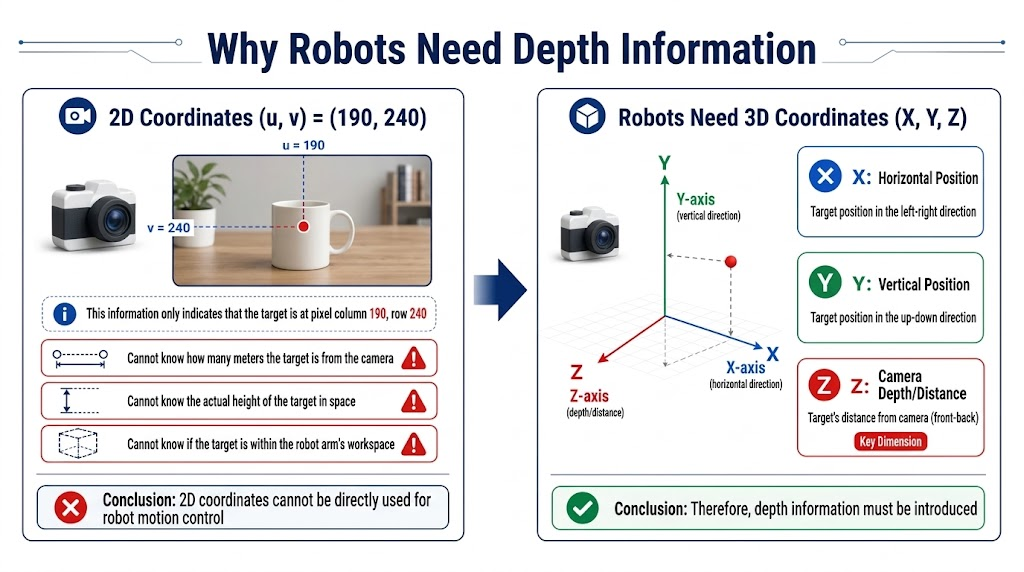
ターゲット中心が次のようであると仮定します:
(u,v)=(190,240)
これは単に「ターゲットが画像の190列目、240行目にある」ということを示しているだけです。
しかしロボットは、ターゲットがカメラからどれくらい離れているか、その空間的な高さ、アームの作業空間内にあるかどうかを知りません。したがって、2D座標だけではロボットの動作を直接駆動することはできません。
ロボットには物体の3D座標が必要です:x は水平方向の位置、Y は垂直方向の位置、Z はカメラからの深度です。したがって深度情報が必要になります。
27.4 深度マップとRGB-Dデータ
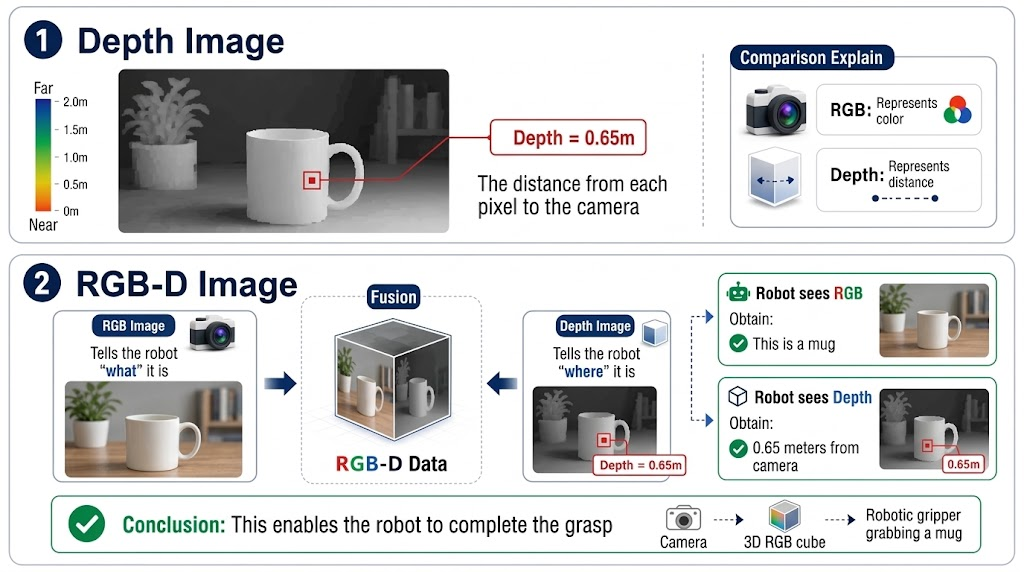
深度マップ
深度マップは、「各ピクセルがカメラからどれくらい離れているか」を表します。
例えば:あるピクセルの Depth=0.65 m。
意味:その位置はカメラから約65cm離れているということです。RGB(色を表す)とは異なり、Depthは距離を表します。
RGB-D画像
RGB画像とDepth画像を融合してRGB-Dデータを得ます。RGB-Dには次の情報が含まれます:
- RGB部分:ロボットに「それが何であるか」を教える
- Depth部分:ロボットに「それがどこにあるか」を教える
例えば:
- ロボットはRGB画像を見て「これはコップだ」と知り、Depth画像を見て「コップはカメラから0.65mの位置にある」と知ります。そうして初めてロボットは把持することができます。
27.5 深度カメラの原理
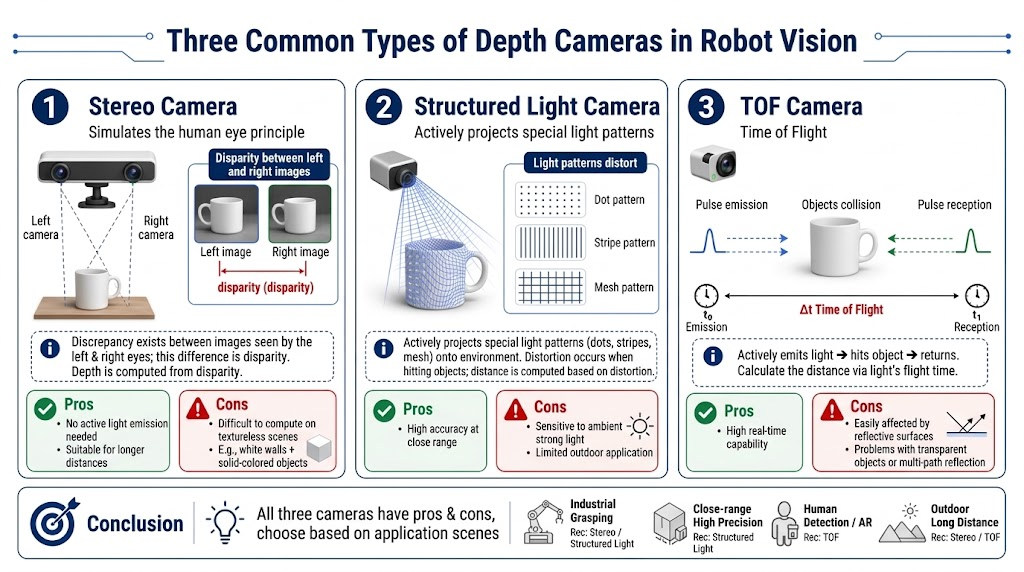
ロボットビジョンで一般的な深度カメラは、ステレオカメラ、構造化光カメラ、TOFカメラの3種類です。
| カメラ | 原理 | 長所 | 短所 |
|---|---|---|---|
| ステレオ | 人間の目を模倣:2台のカメラで、同じ物体が左右の視野のどこに現れるかを比較し、その視差から深度を求める | アクティブな照明を必要とせず、長距離でも動作する | テクスチャのない物体ではうまく機能しない — 白い壁や単色の物体は、両方のカメラにほとんど同じように見える |
| 構造化光 | 既知のパターン(ドットマトリクス、ストライプ、グリッド)を能動的に投影し、そのパターンが物体上でどのように変形するかを読み取る | 近距離で高精度 | 強い光や屋外環境の影響を受けやすい |
| TOF (Time Of Flight) | 光を照射し、その反射を待って往復時間を計測する | リアルタイム性が高い | 反射面、透明な物体、多重反射の影響を受ける |
27.6 カメラ座標モデルと内部パラメータ
座標系
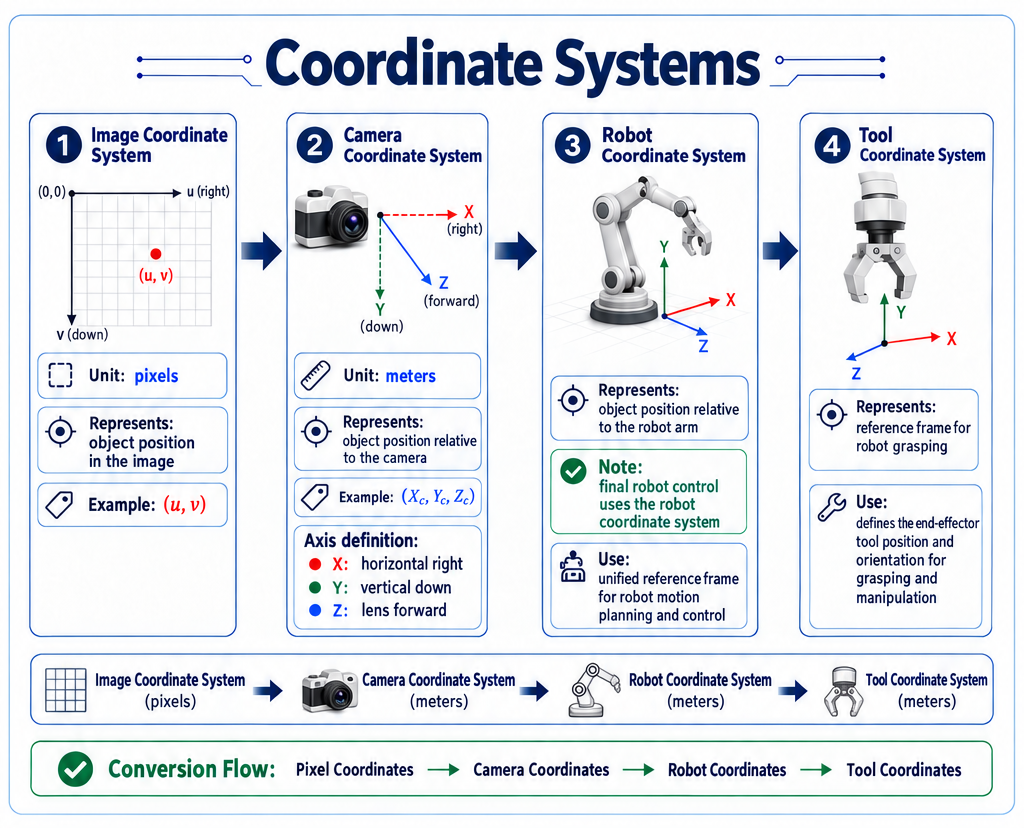
ロボットビジョンでは、4つの座標系が関係します:
| Frame | Unit | Meaning | Example |
|---|---|---|---|
| Image frame | Pixels | 物体が画像のどこにあるか | (u, v) |
| Camera frame | Meters | 物体がカメラに対してどこにあるか | (Xc, Yc, Zc) — X は右向き、Y は下向き、Z はレンズの外側方向 |
| Robot frame | Meters | 物体がアームに対してどこにあるか。アームは最終的にロボット座標で制御される | — |
| Tool frame (end gripper frame) | Meters | アームが把持を実行する際に用いる座標系 | — |
カメラ内部パラメータ(Intrinsics)
なぜ内部パラメータが必要なのでしょうか?
- 2D画像は実空間そのものではないからです。カメラは3D空間を2D画像へ投影します。これを投影と呼び、その投影を記述するのが内部パラメータです。内部パラメータがあれば、2Dピクセルから3D空間を逆算できます。つまり、カメラがどのように画像を生成しているかを表すものです。
| Parameter | Meaning |
|---|---|
fx, fy | x および y 方向の焦点距離(ピクセル) |
cx, cy | x および y 方向の主点 — 画像中心(ピクセル) |
k1, k2, k3, p1, p2 | 歪み係数 |
- レンズ歪みにより、画像端付近のピクセル位置はずれます。歪み補正を行わないと、(u,v) ピクセル座標自体に誤差が生じ、3D変換もずれてしまいます。実務では、まず画像を歪み補正してから、そのピクセル座標を使用します。
27.7 ピクセルから3D座標への変換
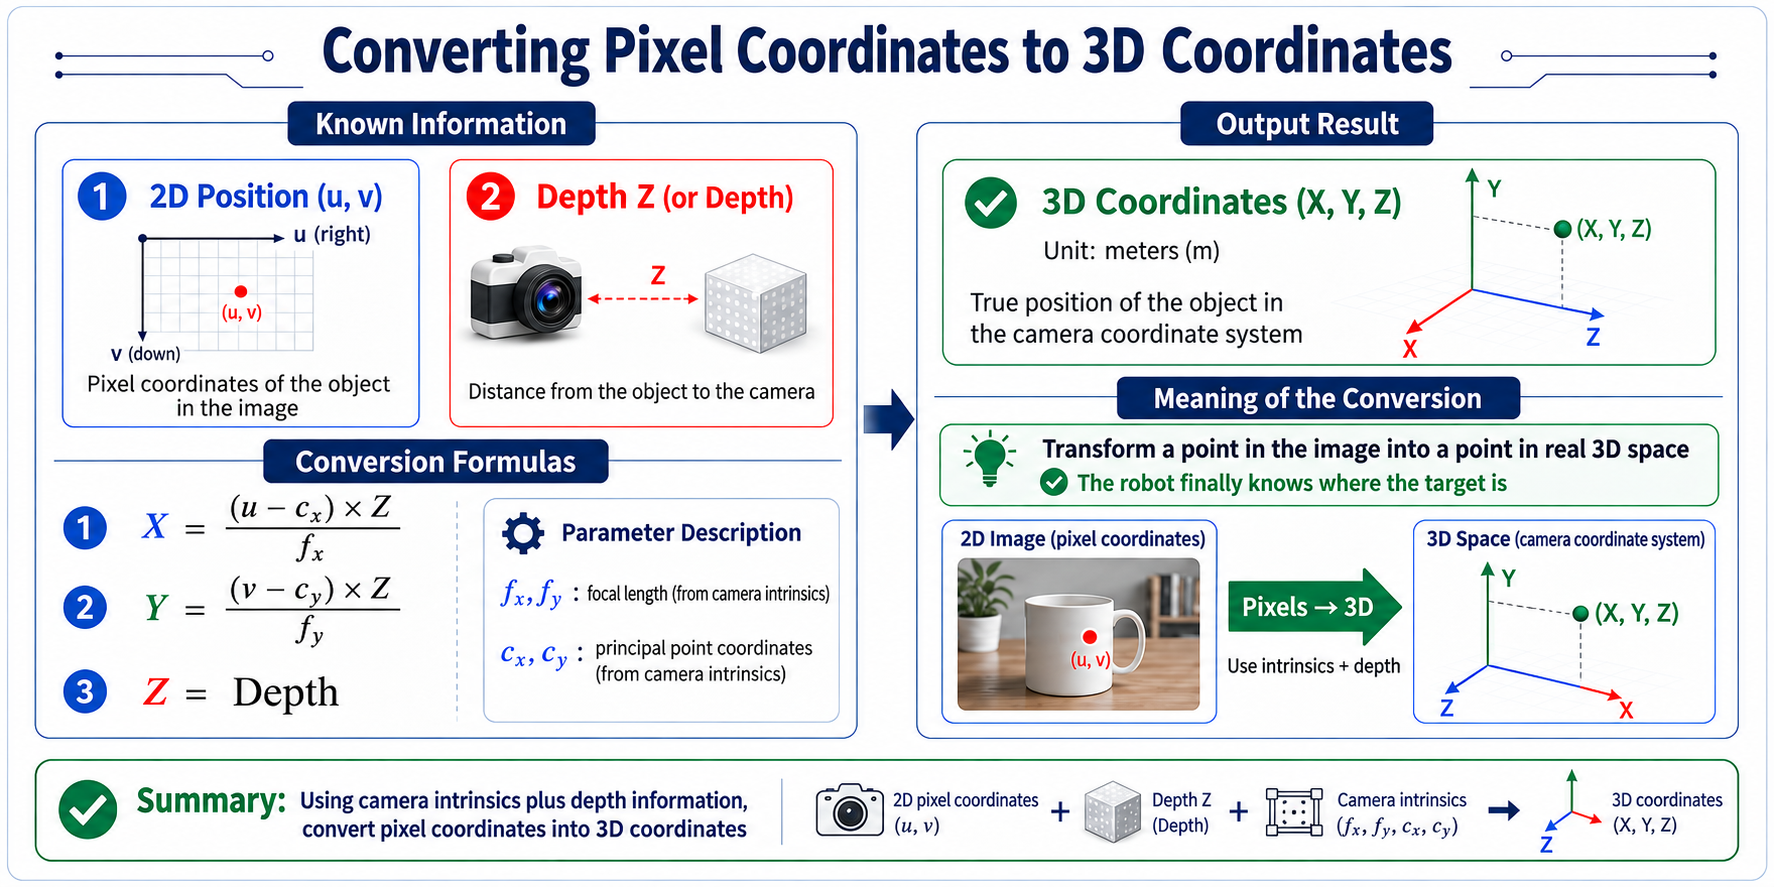
対象物について、次の情報が与えられているとします:
- 2D 位置: (u,v)
- Depth: Z
内部パラメータを用いて、対象物の次を求めます:
- (X,Y,Z)
式:
意味:画像上の1点を実空間上の1点に変換し、最終的にロボットがターゲットの位置を把握できるようにすることです。
27.8 カメラ外部パラメータと座標変換
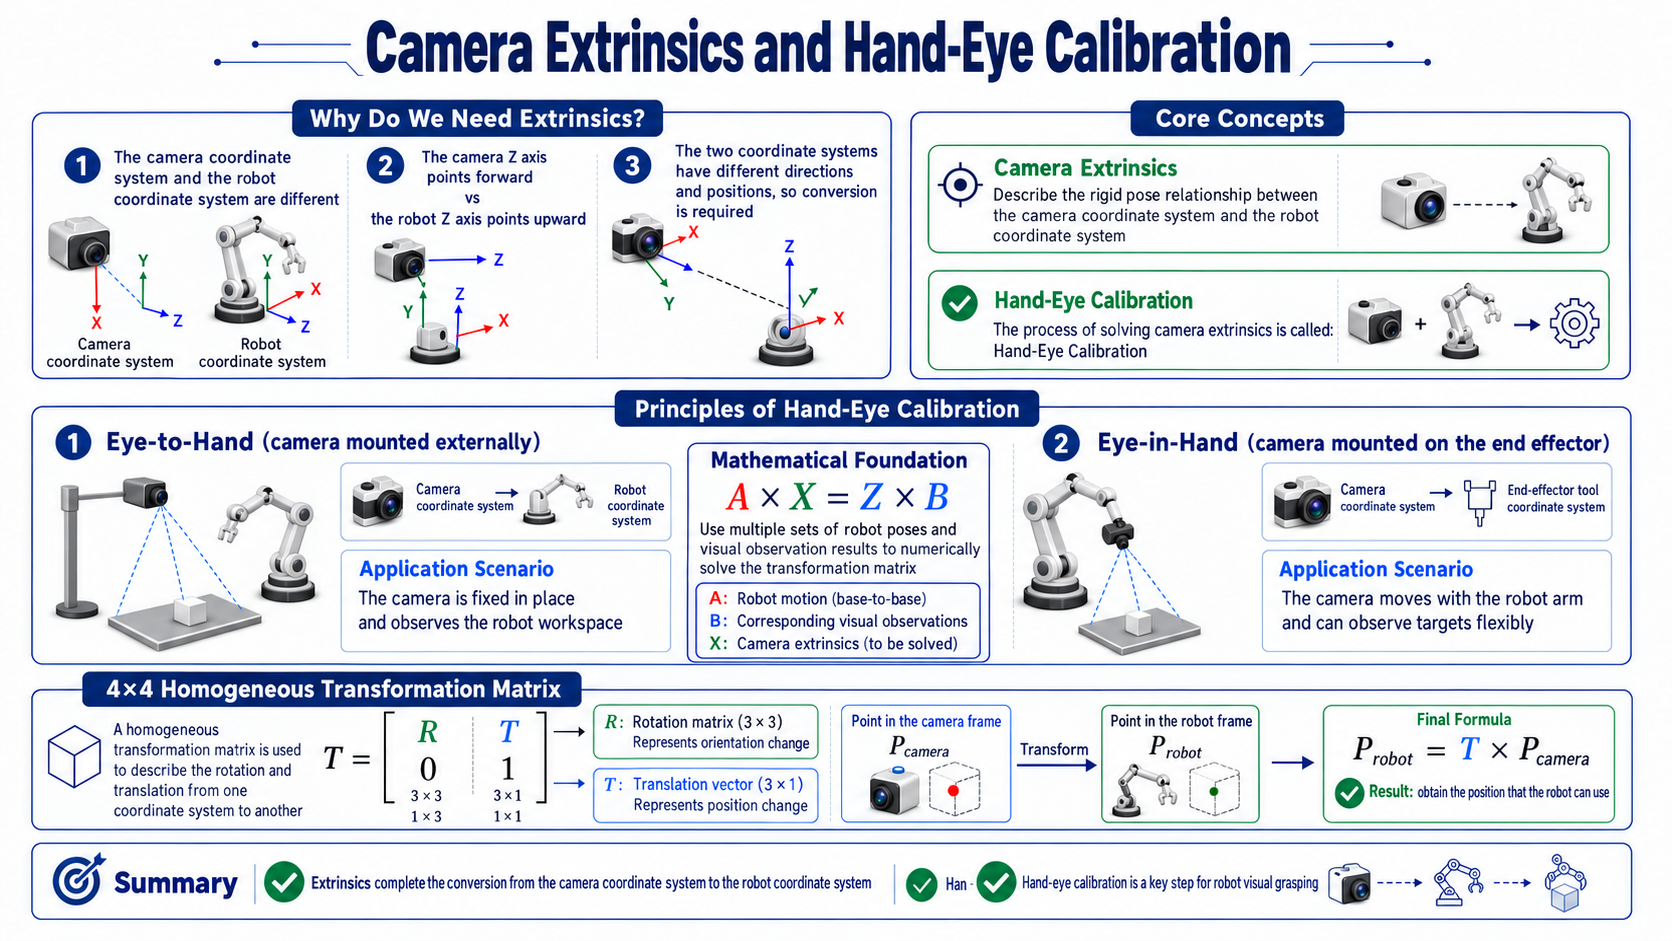
なぜ外部パラメータが必要なのでしょうか?
- カメラ座標系とロボット座標系は異なるからです。例えば、カメラのZ軸は前方を向きますが、ロボットのZ軸は上向きです。両者は姿勢(向き)と位置の両方が異なるため、座標変換が必要になります。カメラ外部パラメータは、カメラ座標系とロボット座標系の間の剛体姿勢関係を表し、それを求めることをハンドアイキャリブレーションと呼びます。
ハンドアイキャリブレーションの原理
- Eye-to-Hand:カメラ座標系からアームベース座標系への変換を求める
- Eye-in-Hand:カメラ座標系からアームのエンドツール座標系への変換を求める
- 数学的基礎は であり、複数組のアーム姿勢と視覚観測を収集し、それらから数値的に変換 X を解きます。
キャリブレーション行列
キャリブレーション誤差と把持点、同次変換 X
- ロボットは通常、座標変換を表すのに 4x4 行列を使用します。
- この行列には次が含まれます:
- 回転行列 R:姿勢の変化を表す。
- 並進ベクトル T:位置の変化を表す。
- 最終的に: により、ロボットが利用できる位置が得られます。
27.9 点群
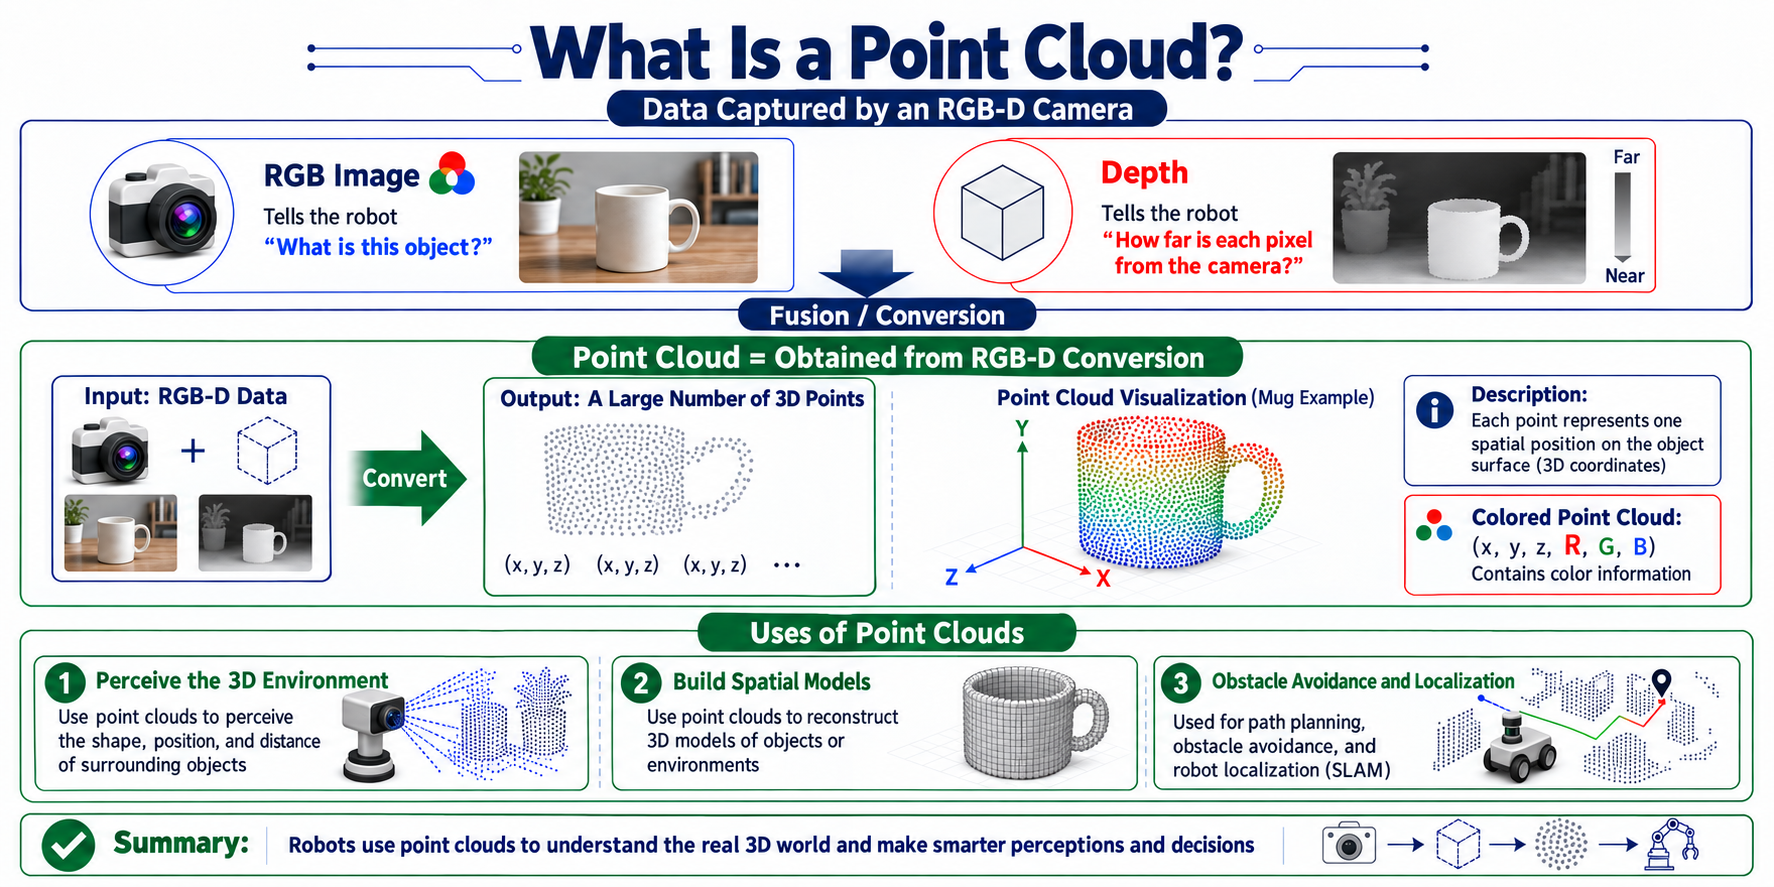
点群とは?
- RGB-D カメラのデータには通常、次が含まれます
- RGB 画像:ロボットに「これは何か?」を教える
- Depth:ロボットに各ピクセルがカメラからどれくらい離れているかを教える
- 点群は、RGB-D を変換することで得られます:
点群の用途
- ロボットは点群を用いて3D環境を知覚し、空間モデルを構築し、障害物を回避し、自己位置推定を行うことができます。