14. ACT モデルとアクションチャンキング
ACT の入出力、ResNet と Transformer の内部構造、アテンションの直観、CVAE、アクションチャンクとアクションホライズンの違い、誤差蓄積への 2 つの防御、ACT の能力限界を理解します。
14.1 行動クローニングから ACT へ
14.1 行動クローニングから ACT へ:「良いモデル」が必要なだけ
第 8 章で行動クローニングを学びました:テレオペレーションのデモをデータセットに録り、モデルに「見たものをそのままやる」を学ばせる。残った疑問 — このデータに見合うモデルとは何か?実運用可能なポリシーモデルは少なくとも 3 つのハードルを越える必要があります:
- 画像を理解できる;
- 首尾一貫考えられる;
- 誤差蓄積に耐えられる。
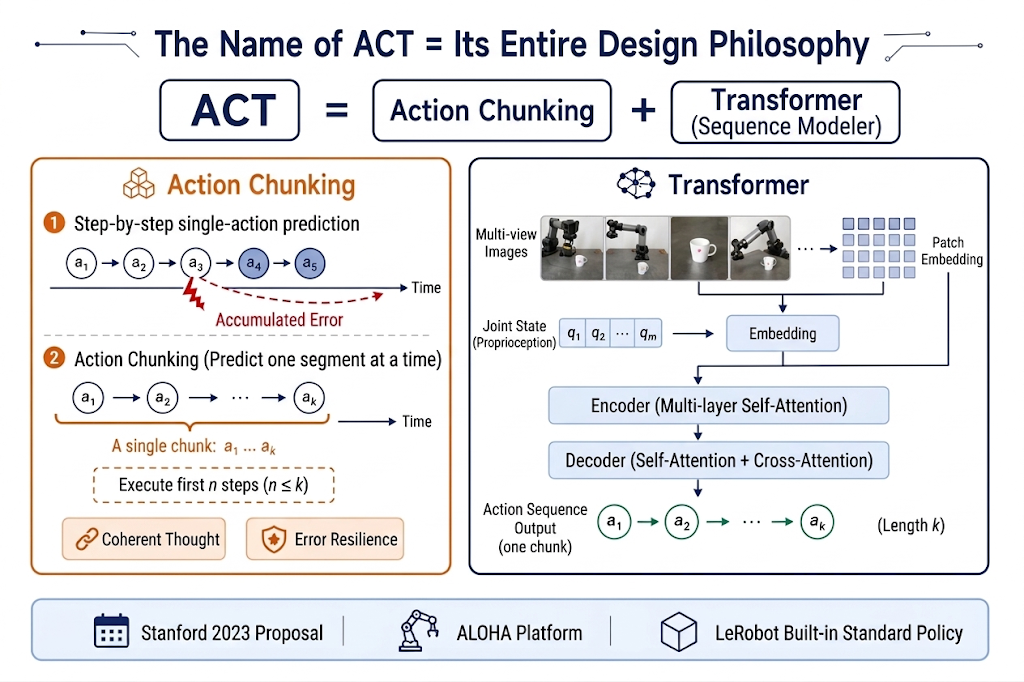
ACT(Action Chunking with Transformers) はこの 3 つのハードルを越えるために作られたポリシーモデルです。スタンフォードチームが 2023 年に提案し、低価格デュアルアームプラットフォーム ALOHA での蓋開け・袋密封などの精密作業で一躍有名になり、その後 Mobile ALOHA がエビ調理などの複雑タスクを披露しました。現在は LeRobot の標準ポリシーの 1 つとして組み込まれ — このステージであなたが訓練・展開するモデルです。
ACT という名前はそのまま設計思想のすべてです:Action Chunking + Transformer(系列モデラー)。本章の残りでこの 2 つの言葉を紐解きます。
14.2 ACT の入出力
14.2 ACT の入出力:まず両端を見る
モデルを理解する最も確実な方法は「インターフェース」から見ること — 何を食べ、何を出すか。
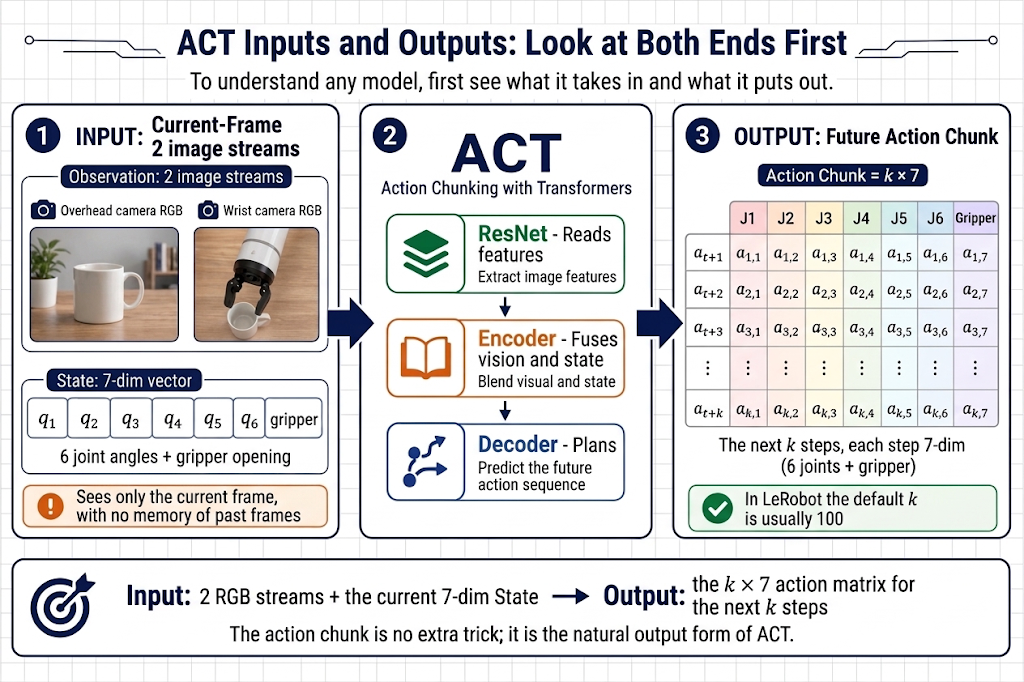
入力:現在の観測
推論時、ACT は 2 種類の情報を含む 1 フレームの観測を受け取ります:
| 入力 | SO-ARM では | 次元 |
|---|---|---|
| 画像(観測) | 前面 + 側面の RGB 2 路 | 2 × 画像 |
| 関節状態(状態) | 5 関節角 + グリッパ開度 | 6 次元ベクトル |
ACT はシングルフレームであることに注意:過去フレームを覚えません。毎回の意思決定は「今見ているもの + 関節の現在地」だけに基づきます。
出力:短い未来窓のアクションチャンク
ACT の出力は次の 1 アクションではなく、アクション列のブロック(Action Chunk)そのものです:
入力:2 画像ストリーム + 6 次元関節状態(現在フレーム)
出力:これからの k ステップ分のアクション列。各ステップ 6 次元(5 関節 + グリッパ)
      すなわち k × 6 のアクション行列
LeRobot の ACT デフォルト設定では k(チャンクサイズ)は通常 100 — 1 回の推論で将来約 100 ステップ分の完全なアクション計画が出ます。これは第 8 章で残した伏線の答えです:アクションチャンクは抽象的な最適化テクニックではなく、ACT の自然な出力形式なのです。
14.3 ACT の内部構造
14.3 ACT の内部構造:1 つの生産ライン上の 3 つの作業場
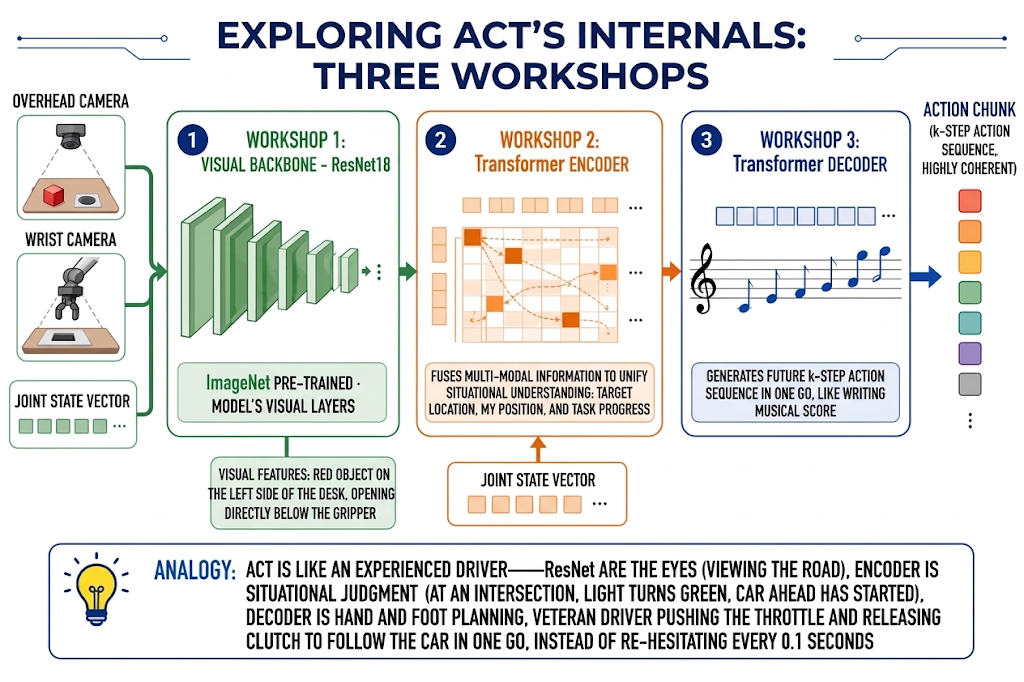
作業場 1:視覚バックボーン(ResNet)— ピクセルから特徴へ
前面と側面の画像はそれぞれ ResNet18(ImageNet 事前学習済み CNN)を通り、視覚特徴の集合へ圧縮されます。ResNet はモデルの「視覚野」のようなもの:生ピクセルはモデルにとって無意味で、「テーブルの左に赤い物体がある」「グリッパの真下に隙間がある」といった構造化情報を抽出します。
作業場 2:Transformer エンコーダ — 「現在」を理解する
視覚特徴 + 関節状態ベクトルが合流して Transformer エンコーダに入ります。エンコーダの仕事は複数のストリームを現在の状況への統一的理解へ融合することです:「ターゲットはどこ、自分はどこ、タスクはどこまで進んでいるか」。
作業場 3:Transformer デコーダ — 「未来」を計画する
デコーダはエンコーダの理解を受け取り、次の k ステップのアクション列を一息に生成します。1 個ずつ吐き出すのではなく、楽譜を書くように「未来の動き」全体を一気に書き上げます — アクションチャンクが内部で極めて首尾一貫している根本理由です。
14.4 Transformer とは
14.4 Transformer とは:アテンションの直観
ACT の作業場 2 と 3 はどちらも Transformer ですが、Transformer とは何でしょうか?
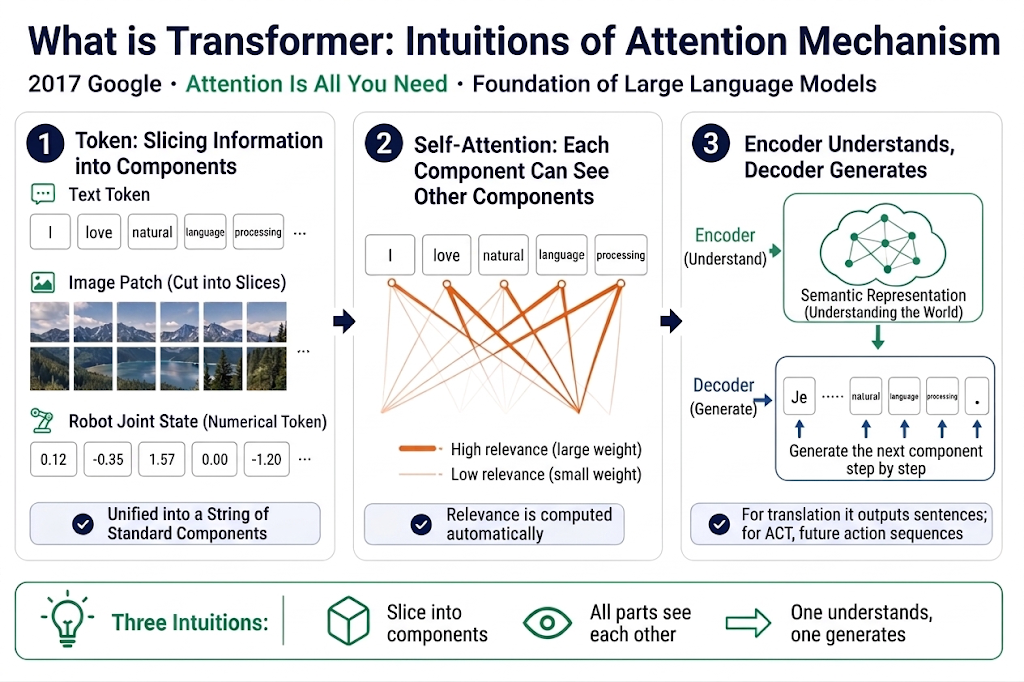
Google が 2017 年に機械翻訳用に提案したもので、論文タイトルは「Attention Is All You Need」。のちに大規模言語モデルの基盤アーキテクチャとなります。数式は不要 — 3 つの直観で十分です:
- トークン:情報を「部品」に切る。 Transformer は生の文や生ピクセルを直接処理せず、まず標準化された部品(トークン)に切ります — 文は単語に、画像はパッチに、関節状態ベクトルも 1 トークンにできます。すべての情報が「部品の列」に統一されると、同じ仕組みで全部処理できます;
- 自己アテンション:どの部品も他のすべての部品を「見られる」。 これが Transformer の核心です。各部品を処理する際、他のすべての部品との関連度を計算し、最も関連の強いものから情報を吸収します — 「何を見るか」は人が決めず、モデルが学びます;
- エンコーダとデコーダ:片方は理解し、片方は生成する。 エンコーダは入力部品列を「現在の状況の理解」へ融合します。デコーダはその理解から新しい出力部品列を生成します — 翻訳では目標言語の文、ACT では未来のアクション列です。
14.5 Transformer は ACT でどう使われるか
14.5 Transformer は ACT でどう使われるか
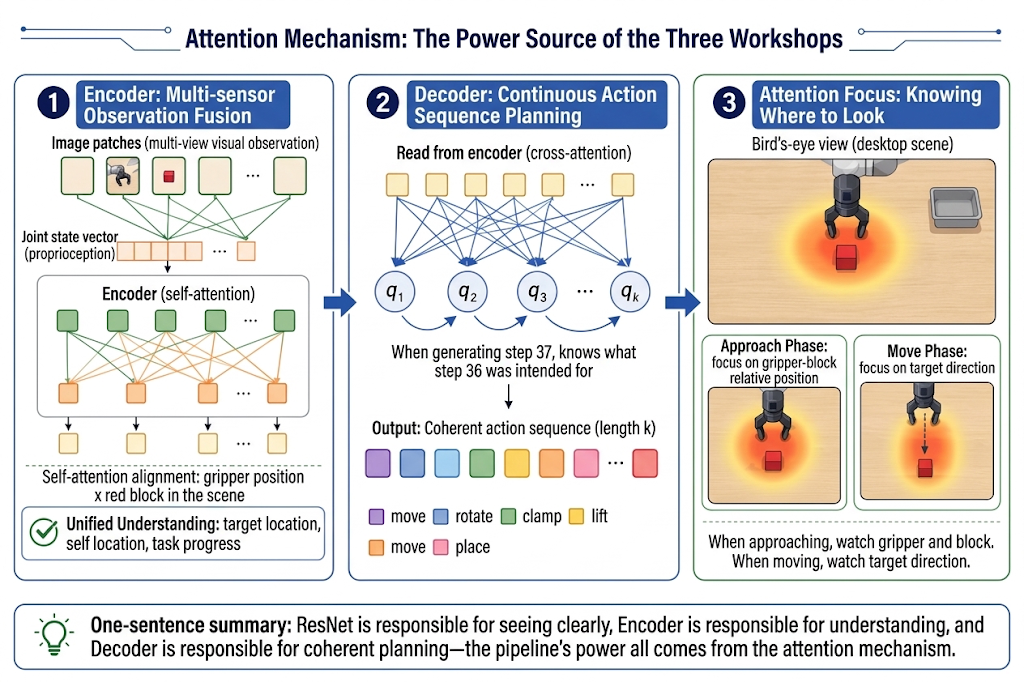
- エンコーダで:複数観測の融合。 2 画像(ResNet 経由)の視覚特徴パッチと関節状態ベクトルがすべてトークンとしてエンコーダに入ります。自己アテンションがそれらを整列 — 「グリッパの現在位置」と「映像の中の赤いブロック」が「ターゲットはどこ、自分はどこ、進捗はどの辺」という統一理解へ結ばれます;
- デコーダで:アクション列全体を一括計画。 デコーダは未来の k ステップに対応する k 個のクエリベクトルを使います。これらのクエリはエンコーダの理解から情報を引きつつ、自己アテンションでお互いも調整 — 37 ステップ目のアクションは 36 ステップ目の意図を「知っている」。アクションブロック全体が有機的な全体であり、100 個の独立した判断ではありません;
- アテンションの焦点:「どこを見るか」を知る。 各アクションを生成するとき、モデルは現在のアクションに最も relevant な画像領域へ自動でフォーカスします — 接近中はグリッパと物体の相対位置、移動中は目標方向 — 全領域を均等扱いしません。
一言でまとめると:ResNet が「はっきり見て」、Transformer エンコーダが「ちゃんと理解して」、Transformer デコーダが「一貫して計画する」 — 駆動力はすべてアテンションです。
14.6 CVAE とは
14.6 CVAE とは
CVAE(条件付き変分オートエンコーダ)。LeRobot の ACT は実際これを使って訓練しますが、lerobot-train --policy.type=act のコマンドラインには現れません。
防ぐべき罠:平均化ミス
CVAEの役割は人間を単一の正解に還元することではなく、こう認めることです:現在の観測を与えるとアクションには複数のスタイルがありえます。訓練時はまず今回がどのスタイルかを見極め、そのアクション列を再現します。
論文の比較実験(シミュレーションタスク):
- デモがスクリプト式(やり方が 1 通りだけ)なら、CVAE を外しても成功率はほぼ変わりません;
- 人間のデータでは、外すと成功率が約 35% から 2% へ落ちます。
つまり CVAE は式を飾るためではなく、「人がやり方を切り替え、手が震える」データに耐えるためのものです。
「条件付き」の意味は:生成するアクションは今見ているものに基づかなければならない — テーブルの上にブロックがあろうとペンがあろうと、でっち上げはできません。CVAE は「見えたものをもとに、次の動きを組み立てる」のです。
14.7 アクションチャンク vs. アクションホライズン
14.7 アクションチャンク vs. アクションホライズン
本章で最も正確に区別すべき 2 概念です。独立に調整できる 2 つのパラメータです:
- アクションチャンク(Action Chunk):モデルが1 回の順伝播で予測するアクション列の長さ。出力行列の行数 k。LeRobot の ACT のデフォルトは 100;
- アクションホライズン(Action Horizon):100 ステップを予測した後、再観測・再予測までに実際に開ループで実行するステップ数。
関係はこうです:予測チャンクは長くてよいが、毎回信頼するのは先頭の小さな一部分だけ。
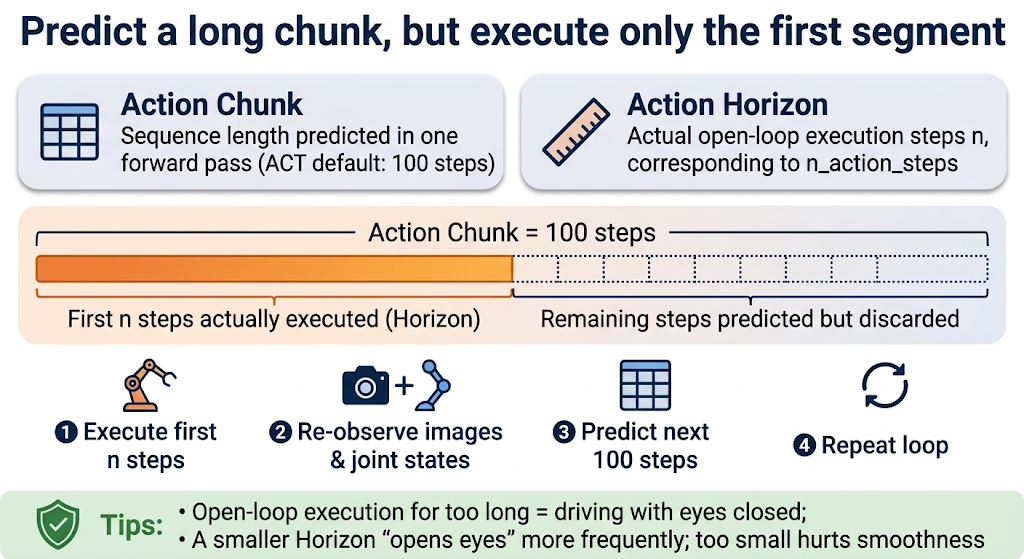
なぜ 100 ステップ全部を実行しないのか?予測は遠いほど当てになりません — 環境は変わり、物は弾かれ、後半ではモデルの「想定状況」が現実から既にズレているからです。開ループ実行が長すぎる = 目を閉じて運転するのと同じ。 ホライズンが小さいほどモデルは頻繁に「目を開けて再確認」し、外乱に頑健になります。ただし小さすぎるとチャンキングの滑らかさが失われます。
カーナビを使う運転のようなものです。ナビ(モデル)はルート全体(チャンク)を一気に計算しますが、ハンドルを固定する人はいません — 数 km ごとに実況交通(再観測)を確認し、ナビはそれに応じて再計画(再予測)します。「古いルートを信じて走り続ける距離」がホライズンです。
14.8 アクションの連続性と誤差蓄積:ACT の 2 つの防御
14.8 アクションの連続性と誤差蓄積:ACT の 2 つの防御
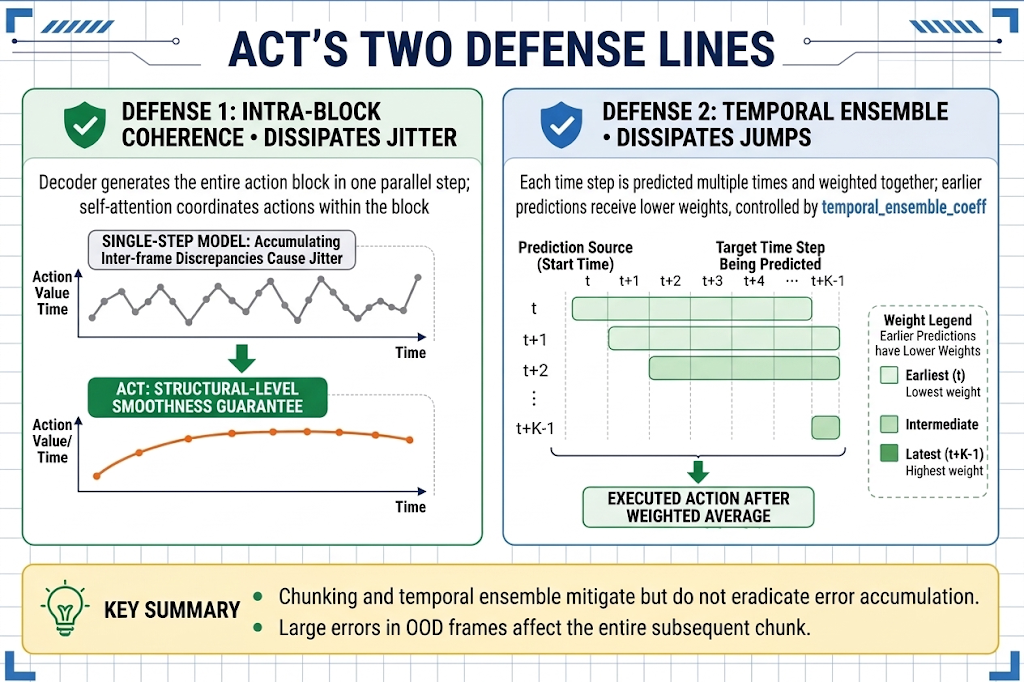
第 8 章は実機安定性に 2 つの脅威を残しました:アクションの震えと誤差蓄積。ACT が構造的な方法でどう対処するか見てみましょう。
- 防御 1:チャンク内の一貫性が震えを修正する。
- 防御 2:時間的アンサンブルが不連続を修正する。
14.9 ACT に向くタスクは?
14.9 ACT に向くタスクは?
ACT の設計特性から、その「快適ゾーン」は明確です — SO-ARM はちょうどその中にいます:
| 向くタスク | 理由 |
|---|---|
| テーブルトップ操作(把持・配置・整理・抜き差し) | ACT はこの種のタスクから生まれた。データ要件とモデル規模が合う |
| 単一〜少数タスク | 行動クローニングはタスク固有の写像を学ぶ。タスクが増えるほどデータが必要 |
| 短いタスク(数秒〜1 分程度) | 誤差は時間とともに蓄積。短いほど安定 |
| 視覚情報が十分なシーン | 前面 + 側面の双眼カメラがキー情報をカバーするシーン |
| 資源の限られたハードウェア | ACT はパラメータが比較的少なく、コンシューマ GPU で訓練・推論可能。CPU でも推論できる |
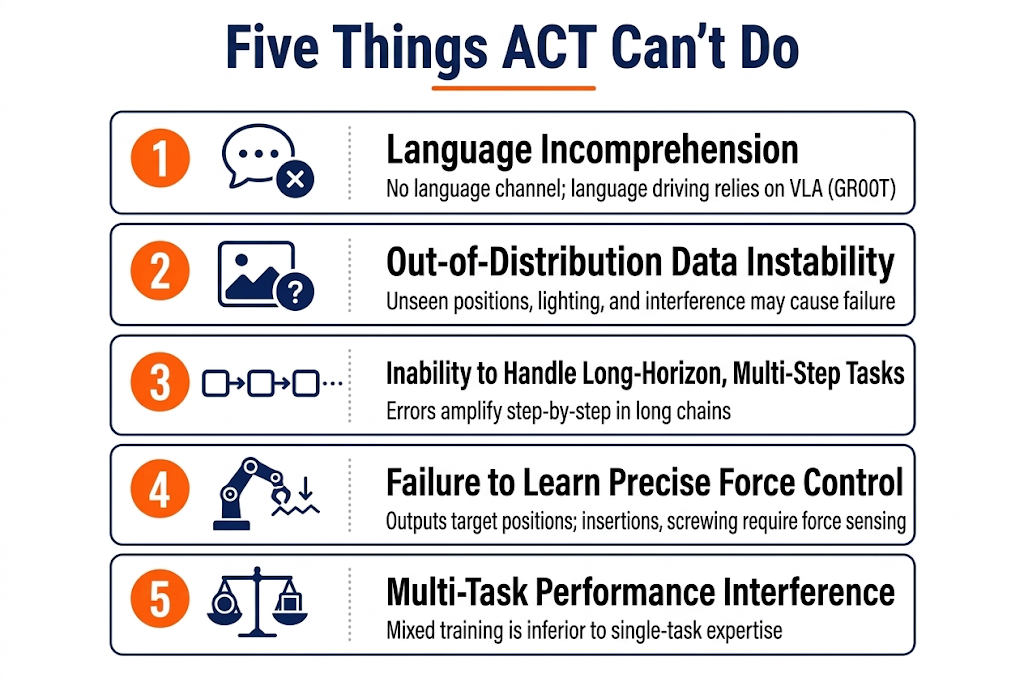
14.10 ACT の能力限界
14.10 ACT の能力限界
同じくらい重要なのは、できないことを知ることです: