このステージで必要なハードウェア
各ステージの完全な一覧は 第 3 章 にあります。
主制御デバイス
| 項目 | 購入 | 数量 |
|---|---|---|
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
デスクトップまたはノート PC も必要です:Ubuntu 22.04、12GB 以上 VRAM の GPU、16GB 以上メモリ(GR00T ファインチューニングには約 25GB VRAM — 18.8 参照)。
このステージ用
| 項目 | 購入 | 数量 |
|---|---|---|
| SO-ARM101 キット(リーダー + フォロワー) | 🛒 | 1 |
| 32 × 32 mm USB カメラ | - | 2 |
これまでの章で、あなたは SO-ARM 上で ACT(Action Chunking with Transformers) などのポリシーを使い、「画像を見て関節アクションを出力する」模倣学習を完遂しました。この種の手法は通常単一タスク向けに訓練されます:モデルは「赤いブロックを箱に入れる」という 1 つの振る舞いだけを学び、タスクを切り替えるには再収集と再訓練が必要です。
本章は VLA(Vision-Language-Action) の核心思想を導入します:ロボットに「見る」だけでなく自然言語の指示を「理解」させ、1 つのポリシーネットワークで複数タスクを共有させることです。
18.1 マルチモーダルモデルとは
18.1 マルチモーダルモデルとは?
マルチモーダルモデルは複数種類の情報 — 画像・テキスト・ロボット状態 — を 1 つの統一判断へ融合します。VLA の文脈では、以下の 3 モダリティが融合され、ロボットアクションへデコードされます。
18.2 視覚、言語、アクション
18.2 視覚、言語、アクション
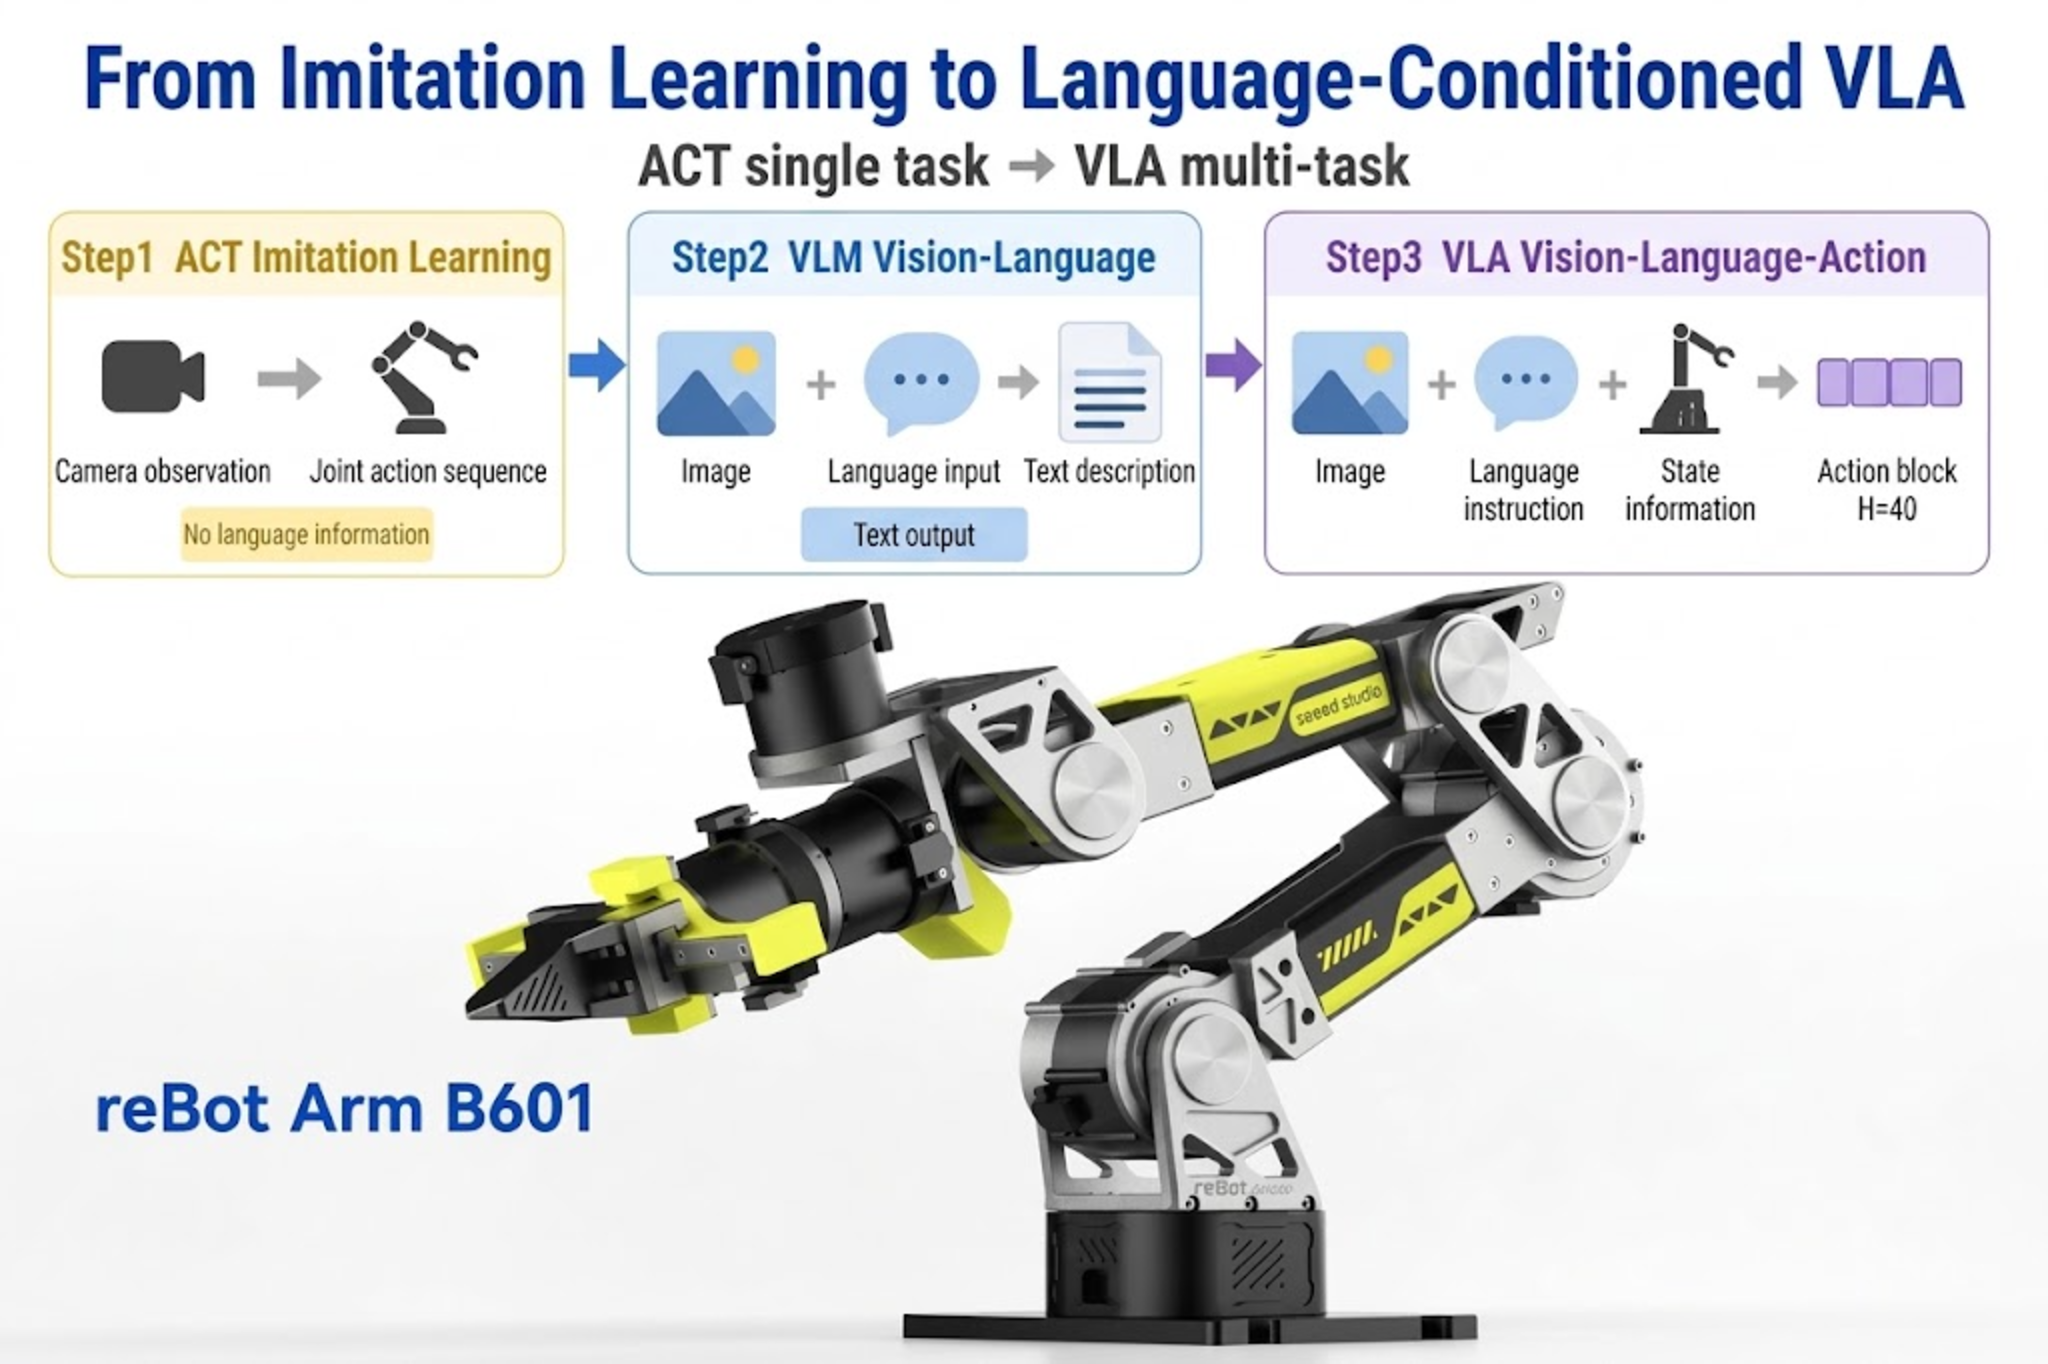
VLA フレームワークでは、3 つのモダリティが明確に分担します:
| モダリティ | 意味 | SO-ARM での典型的なソース |
|---|---|---|
| 視覚 | 外部カメラが撮影する RGB 画像 | 前面と側面の USB カメラ |
| 言語 | タスクの自然言語記述 | 「ドライバーを工具箱に入れて」 |
| アクション | ロボットが実行すべき制御コマンド | 5 関節の目標角 + グリッパ開閉幅 |
状態は通常アクションと対で現れます:状態は「ロボットが今どこにいるか」、アクションは「次にどこへ行くか」を表します。LeRobot データセットでは observation.state と action フィールドに保存され、GR00T では meta/modality.json を通じて state.single_arm や state.gripper などのサブキーへさらに分割されます。
VLA と純視覚ポリシーの決定的な違い:言語が条件変数になること。 訓練時、すべてのデモ軌跡にタスク記述が結び付けられ、推論時はユーザーが指示文だけを変えれば(データカバー範囲内で)モデルの重みを変える必要がありません。
18.3 VLM と VLA の違い
18.3 VLM と VLA の違い
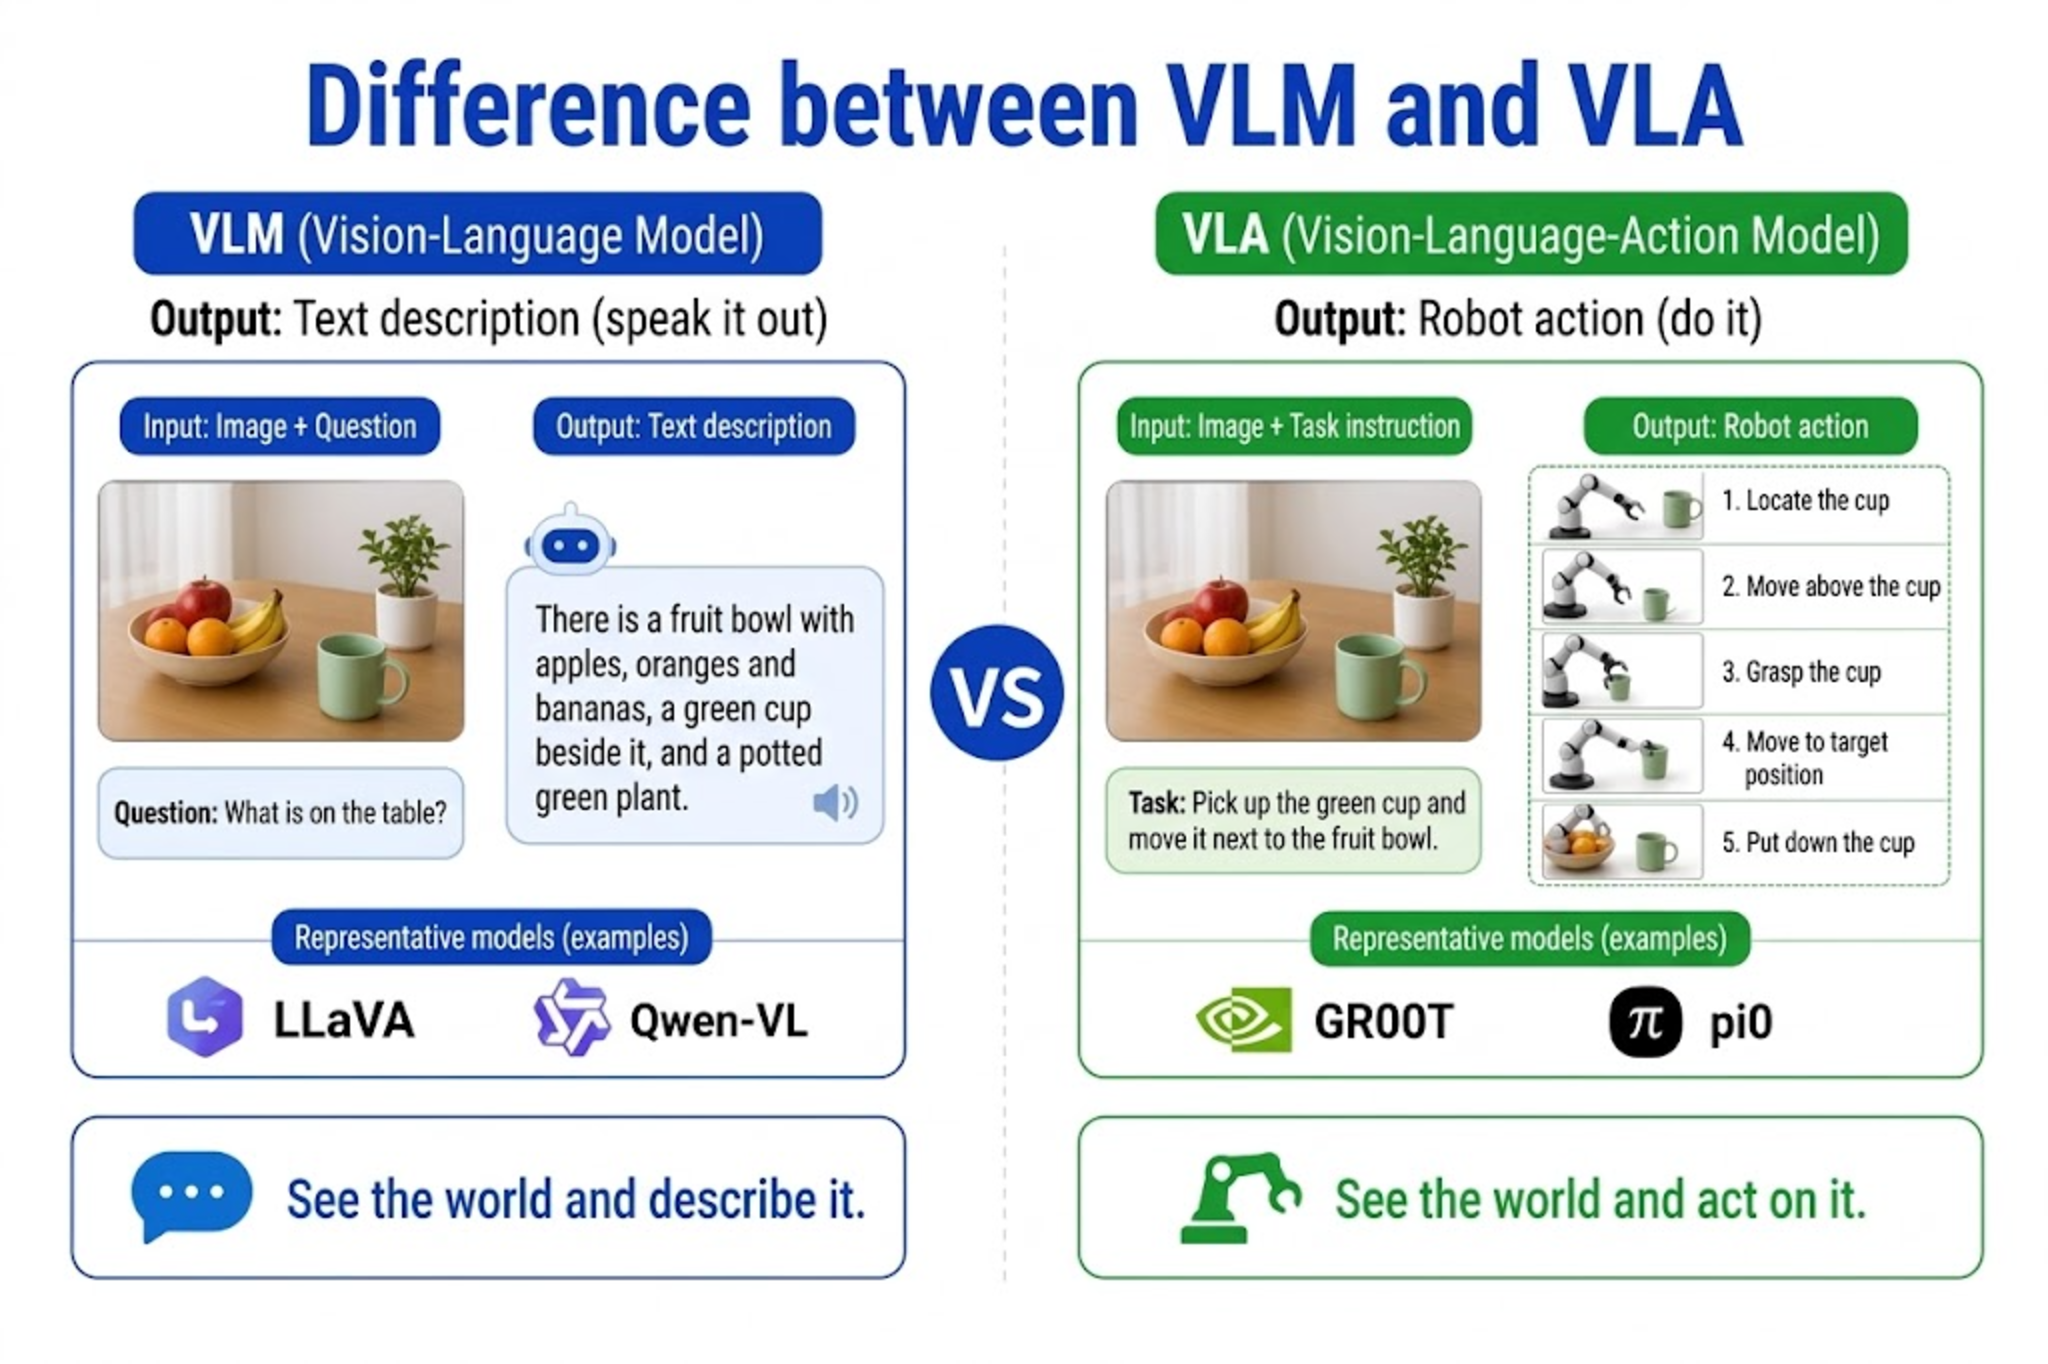
| 側面 | VLM(Vision-Language Model) | VLA(Vision-Language-Action) |
|---|---|---|
| 出力 | テキスト、記述、推論結果 | ロボットのアクション列 |
| 典型的用途 | 画像 QA、シーン理解、キャプション生成 | 把持・配置・開閉などの操作 |
| 代表モデル | LLaVA、Qwen-VL、Cosmos-Reason | GR00T、pi0、OpenVLA |
| ロボットとの関係 | 計画を支援できるがモーターを直接駆動しない | エンドツーエンドで制御コマンドを出力 |
簡単に言えば:VLM は「世界を理解して語る」を、VLA は「世界を理解して行動する」を担当します。
Isaac GR00T はアーキテクチャ上 VLM 能力を再利用しています:VLM バックボーンが画像と言語をエンコードし、その後に拡散 Transformer(DiT)アクションヘッドが意味表現を連続アクションチャンクへデコードします。よって GR00T は VLA であると同時に、強力な VLM 表現能力を内包しています。
18.4 ACT と VLA の違い
18.4 ACT と VLA の違い
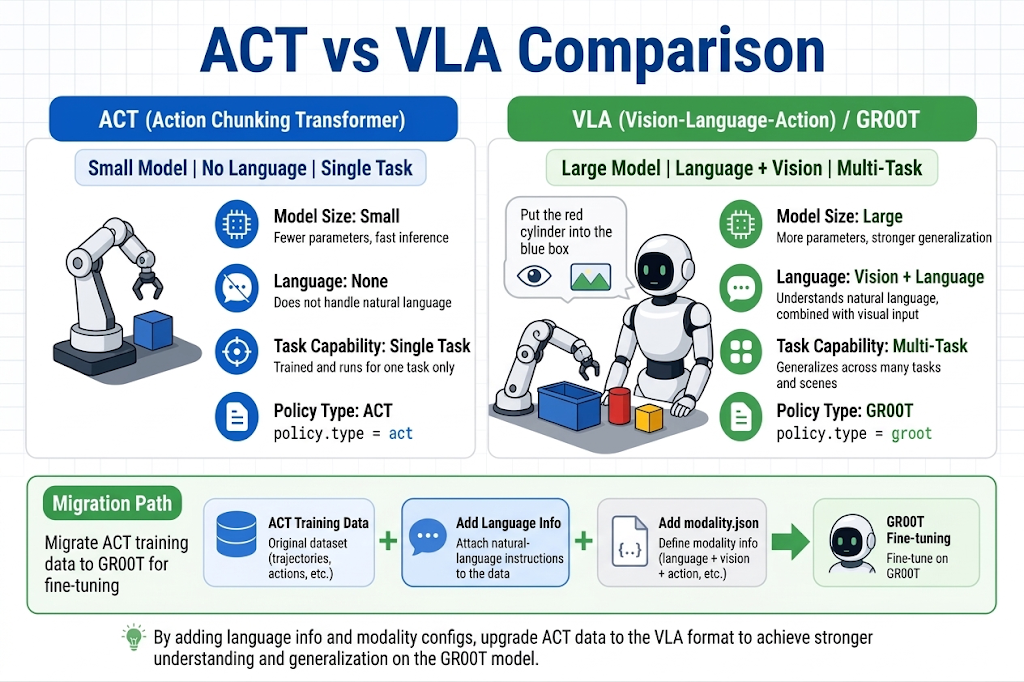
これまでの ACT と本章の VLA はどちらも模倣学習(行動クローニング)ファミリーですが、設計目標が異なります:
| 側面 | ACT | VLA(例:GR00T) |
|---|---|---|
| タスク条件 | 通常言語なし、暗黙の単一タスク | 言語 + 視覚、明示的マルチタスク |
| モデル規模 | 小さい(数千万パラメータ) | 大きい(数十億パラメータの基盤モデル) |
| 訓練方式 | ゼロから、または軽量微調整 | 基盤モデルの事前学習 + 下流微調整 |
| アクション表現 | アクションチャンク | アクションチャンク + Flow Matching デノイズ |
| 汎化 | 分布内では良好。タスク切り替えには再訓練 | 言語条件がゼロ/フューショット転移を支援 |
| LeRobot ポリシータイプ | act | groot |
ACT の核心技術はアクションチャンキングです:一度に複数ステップのアクションを予測し、ステップごと推論の誤差蓄積を減らします。GR00T もアクションチャンクを予測します(窓長はバージョンにより — N1.5 は action_horizon = 16)。
移行パス:SO-ARM の ACT データセット(LeRobot 形式)が既にあるなら、第 20 章で言語アノテーションと Modality 設定を追加するだけで GR00T 微調整に使えます。デモの再収集は不要です。
GR00T N1.5 は公式サポートの so100_dualcam データ設定と new_embodiment タグで SO-ARM 上で動きます — SO-ARM は GR00T エコシステムで最も良くサポートされた低価格本体の 1 つで、NVIDIA が SO101 微調整ガイド を公開しています。
18.5 言語条件ロボットタスク
18.5 言語条件ロボットタスク
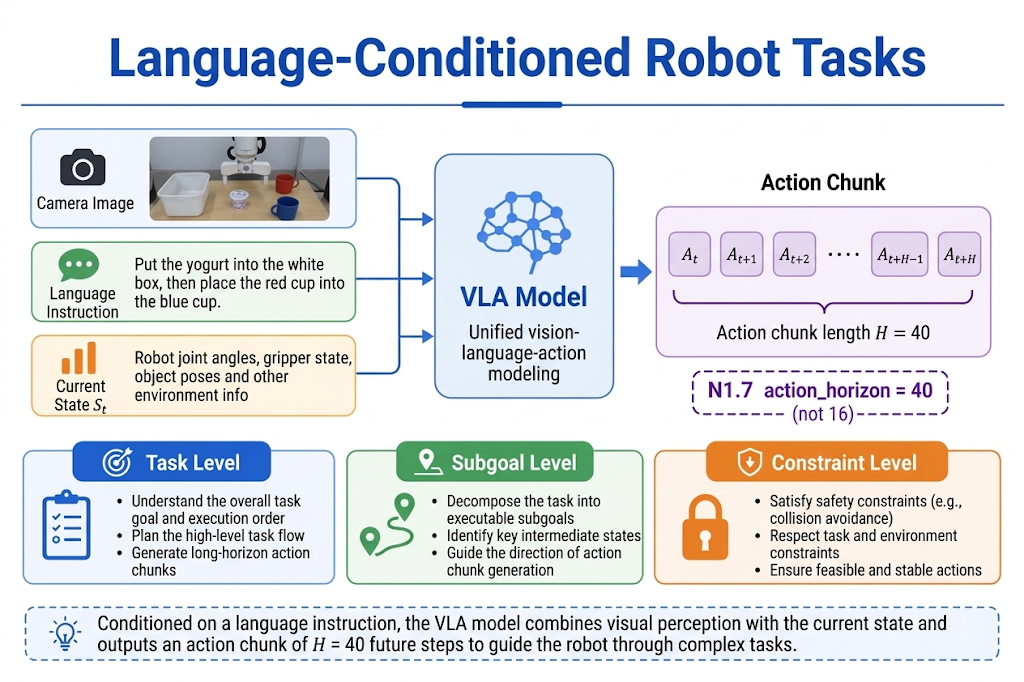
言語条件タスクの標準形:
入力:画像 I_t + 言語指示 L + 現在状態 S_t
出力:アクション A_{t:t+H}(これからの H ステップのアクションチャンク)
指示の粒度には複数あります:
- タスクレベル:「赤いブロックを青い箱に入れて」(軌跡全体で 1 文を共有)
- サブゴールレベル:「まず物体に接近」 -> 「次にグリッパを閉じる」(区分アノテーション、上級向け)
- 制約レベル:「そっと置く」「障害物を避ける」(アクションの実行方法を修飾)
LeRobot データセットでは、言語は通常 meta/tasks.jsonl か annotation フィールドに書かれます。GR00T は modality.json の annotation キーで読み込み、2 つの一般的な形式があります:
| キー名 | 典型的データセット | SO-ARM 推奨 |
|---|---|---|
human.task_description | SO-100 / SO101、cube_to_bowl などの単純なデスクトップタスク | 推奨:第 20 章の例と一致 |
human.action.task_description | LIBERO、SimplerEnv などのシミュレーションベンチマーク | これらのベンチマーク由来のデータでのみ使用 |
どちらのキーも有効ですが、データセット内の実際のフィールドと一致させる必要があります。訓練と推論で混用しないでください。
実践的アドバイス(SO-ARM):
- 各デモ録画時、動詞で始まる短い 1 文でタスクを記述(中国語・英語どちらでも可);
- 似たタスクは表現を統一(例:常に「X を Y に置く」);
- 1 つのデータに複数の言い方を対応させない。微調整初期は一貫しているほど良いです。
18.6 単一タスク・マルチタスク・汎化
18.6 単一タスク・マルチタスク・汎化
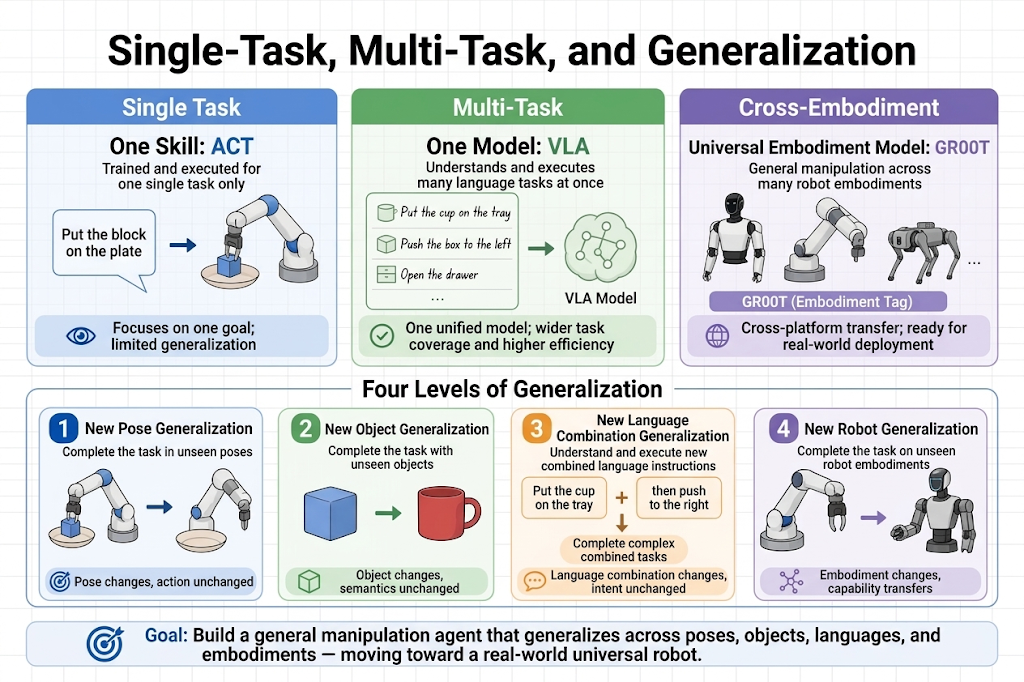
| 訓練パラダイム | 説明 | 適するシナリオ |
|---|---|---|
| 単一タスク | 1 つのスキルだけ学ぶ | ACT のデフォルト。データが少なく目標が明確 |
| マルチタスク | 同じモデルが複数スキルを言語で区別して学ぶ | VLA 微調整。デスク整理・仕分けなど |
| クロスエンボディメント汎化 | 異なるロボットが基盤モデルを共有 | GR00T の事前学習。embodiment_tag で適応 |
VLA における「汎化」には複数レベルがあります — 混同しないように:
- 同じタスク、新しい初期姿勢:物体位置が変わっても把持できる — ACT でも通常可能;
- 新しい物体・容器:視覚汎化に依存 — 訓練データに十分な多様性が必要;
- 新しい言語指示の組み合わせ:未見の「A を B に置く」だが文型が既知 — VLA の言語条件の利点;
- 新しいロボット本体:アームを替えても使える — GR00T の本体投影層と少量の微調整データが必要。
SO-ARM ユーザーへの現実的期待は:微調整後、収集済みの複数の言語タスク間を切り替えられる。全く新しい物体や文型には、追加のデモデータが依然として必要です。
18.7 連続アクションとアクショントークン
18.7 連続アクションとアクショントークン
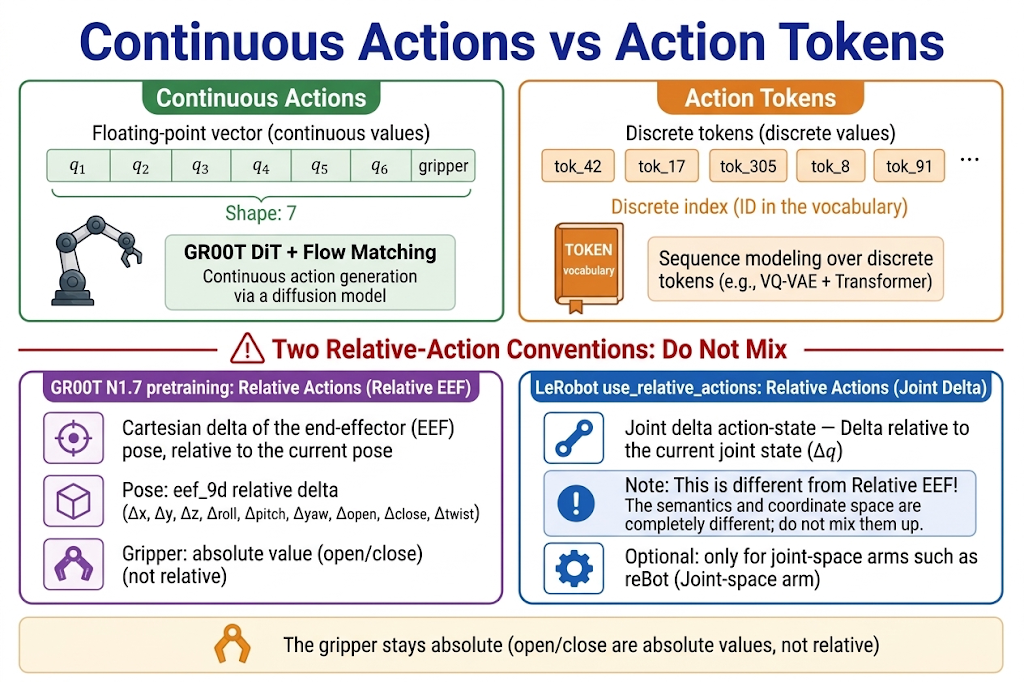
ロボット制御コマンドには 2 つの主流表現があります:
連続アクション
浮動小数点ベクトルを直接出力。例:5 関節角 + 1 グリッパ開閉値:
action = [q1, q2, q3, q4, q5, gripper] # shape: (6,)
- 利点:精度が高く、実際のモーターインターフェースと一致;
- 欠点:高次元空間の回帰は難しい;
- GR00T の方式:DiT + Flow Matching で連続空間をデノイズし、アクションチャンクを出力。
アクショントークン(離散化アクション)
連続値を離散シンボルへ量子化し、言語モデルが次トークンを予測するように扱います:
action_tokens = [tok_42, tok_17, tok_89, ...]
- 利点:自己回帰 LLM アーキテクチャを再利用可能。pi0-FAST など一部の VLA が採用;
- 欠点:量子化損失、語彙設計の複雑さ。
相対 vs 絶対アクション:GR00T の事前学習アクション空間は、本体グループごとに相対アクション(現在状態に対する増分)や絶対関節位置を使い分け、グリッパは絶対のままです。相対軌跡は滑らかですが長期実行でドリフトしうる。SO-ARM 微調整では主に so100_dualcam のデフォルトに頼ります — 要点は 1 つ:理解していないアクション空間変換を手書きしないことです。
18.8 VLA の能力と限界
18.8 VLA の能力と限界
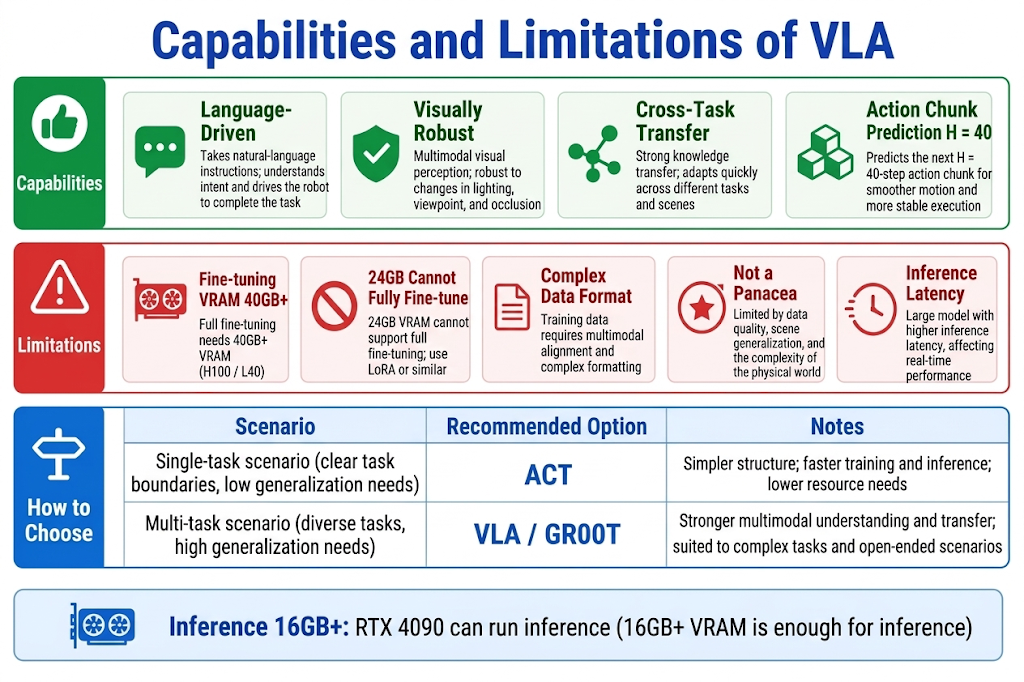
能力
- 言語駆動:1 つのモデルで多タスク。指示を変えれば振る舞いが変わる;
- 視覚頑健性:大規模事前学習が小さな ACT より強いシーン理解をもたらす;
- クロスタスク転移:似た文型・似た物体の間で表現を共有できる;
- アクションチャンク予測:1 回の推論で複数ステップを出力し、リアルタイム制御に適する。
限界
- 計算需要が高い:GR00T N1.5-3B の微調整には約 25GB VRAM(Ampere 以降 — 例:RTX 4090 / A6000。V100 は非対応)。
--no-tune_diffusion_modelで削減可能。推論はより軽く、Jetson AGX Thor で動きます(第 21 章)— 第 22 章は GPU すら不要です; - より複雑なデータ形式:標準 LeRobot フィールドに加え、
modality.jsonと本体タグが必要; - 万能薬ではない:訓練セットがカバーしない物体・指示・作業レイアウトでは失敗しえます;
- レイテンシ:大モデルの推論は ACT より遅い。アクション窓と推論パラメータを適切に設定;
- シミュレーションと実機のギャップ:事前学習データは特定プラットフォーム中心。デスクトップアームには十分な微調整が必要。
ACT を選ぶとき、VLA を選ぶとき?
| シナリオ | 推奨 |
|---|---|
| 単一の反復タスク、エッジデバイス、低遅延 | ACT |
| マルチタスク、言語インタラクション、GPU とアノテーションに投資可能 | VLA / GR00T |
| ACT データが既にあり、マルチタスクへ拡張したい | 既存 LeRobot データに言語を追加 -> GR00T 微調整(第 20 章) |
| 訓練 GPU が全くない | SenseCraft Robotics のノーコード VLA(第 22 章) |
18.9 本章のまとめ
18.9 本章のまとめ
- マルチモーダルモデルは視覚・言語・状態を統一判断へ融合します;
- VLA は VLM の上にアクション出力を加え、言語条件の操作を可能にします;
- ACT は軽量な単一タスク解、GR00T は大規模事前学習 + 微調整の VLA 解です;
- SO-ARM は
so100_dualcam+new_embodimentで GR00T エコシステムの公式サポートを受けられます; - 次章は、汎用 VLA をSO-ARM という特定の本体に落とす方法を説明します。