このステージで必要なハードウェア
各ステージの完全な一覧は 第 3 章 にあります。
主制御デバイス
| 項目 | 購入 | 数量 |
|---|---|---|
| reComputer Robotics J4012 | 🛒 | 1 |
デスクトップまたはノート PC も必要です:Ubuntu 22.04、CUDA 12+、訓練には 12GB 以上 VRAM の NVIDIA GPU と 16GB 以上のメモリ。
このステージ用
| 項目 | 購入 | 数量 |
|---|---|---|
| SO-ARM101 キット(リーダー + フォロワー) | 🛒 | 1 |
| 32 × 32 mm USB カメラ | - | 2 |
| マウスパッド / デスクマット | - | 1 |
8.1 ロボットアームはなぜ学習を必要とするのか?
8.1 ロボットアームはなぜ学習を必要とするのか?
ステージ 2 で、あなたは SO-ARM のすべてのサーボを読み書きできるようになりました:関節位置の取得、目標角度の送信、グリッパの開閉。それなら — アームがテーブル上のブロックを自動で拾うプログラムを書けばいい、と思うのは自然です。
そこでそんなプログラムを書きます。研究室の初デモでは絶好調。しかし翌日、状況は変わっていました — そしてこれらの変化に対応するうちに「if」文がどんどん増え、最後には誰も保守できない特例カタログになります。
これが従来型プログラム制御の根本ジレンマです:現実の世界は連続的に変化するのに、if-else は離散的である。 世界のすべての状態を列挙することはできません。
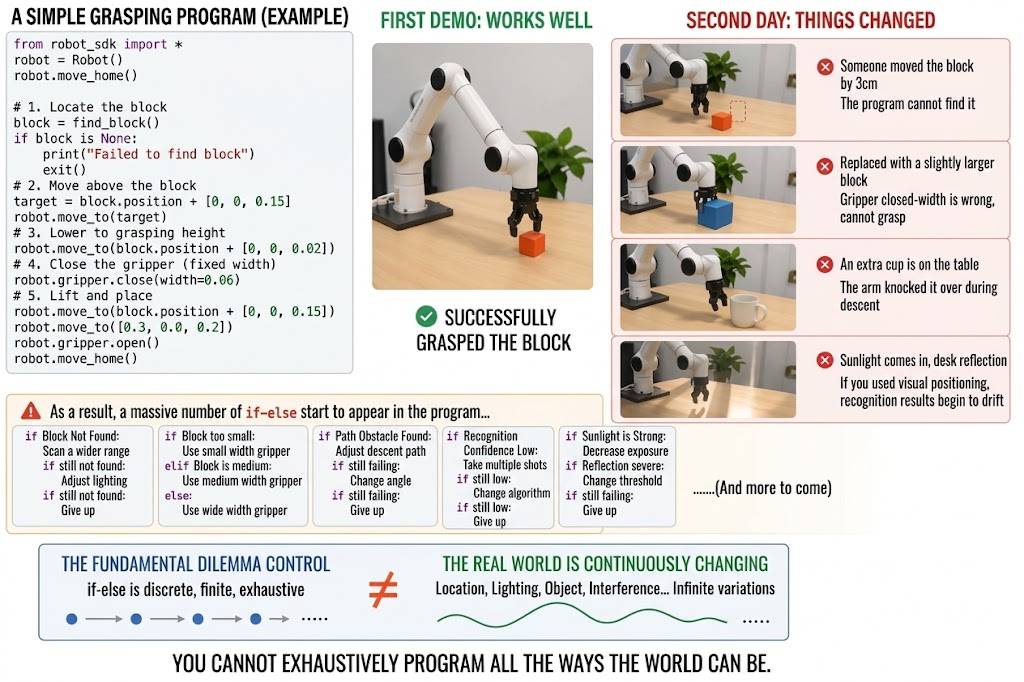
ロボットアームにこの形でスキルを身につけさせることこそ、Robot Learning が解決しようとする問題です。 そして本ステージで扱う模倣学習は、最も成熟し、実機への展開が最も容易なアプローチです。
8.2 ルールベース制御 vs. 学習ベース制御
8.2 ルールベース制御 vs. 学習ベース制御
先に進む前に、2 つの制御アプローチを並べてはっきり見ておきましょう。
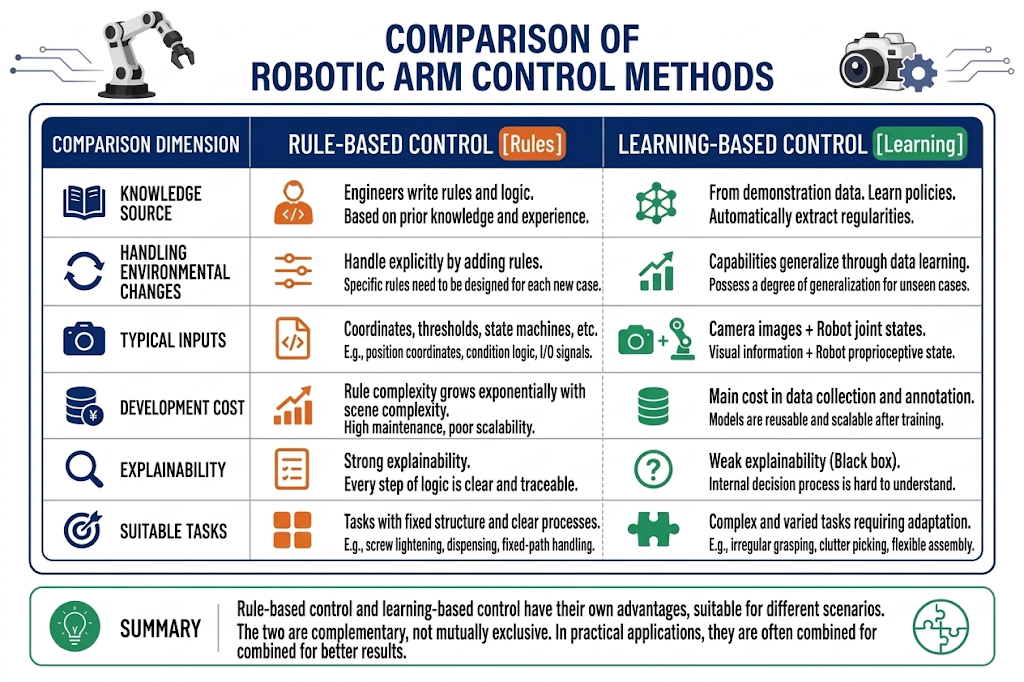
本コースのステージ 3・4 は「学習ベース制御」の道を進みます。ただし覚えておいてください:将来も学習システムには多くのルールが残ります — 関節限界や安全速度制約など。学習とルールは相補的です。
8.3 模倣学習と行動クローニング
8.3 模倣学習と行動クローニング
模倣学習とは
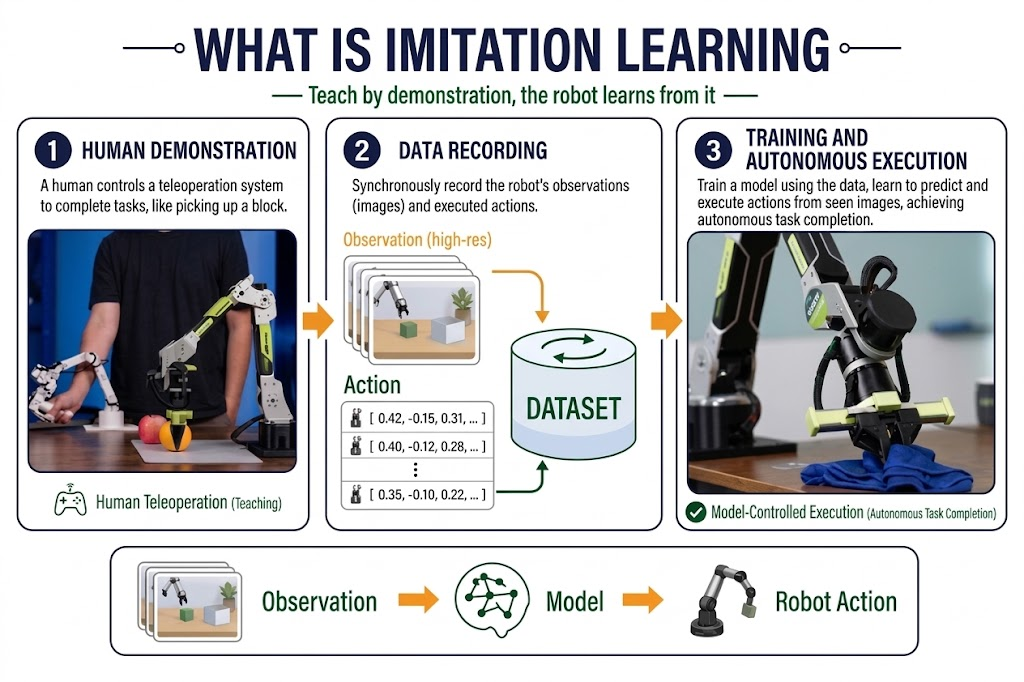
行動クローニングとは
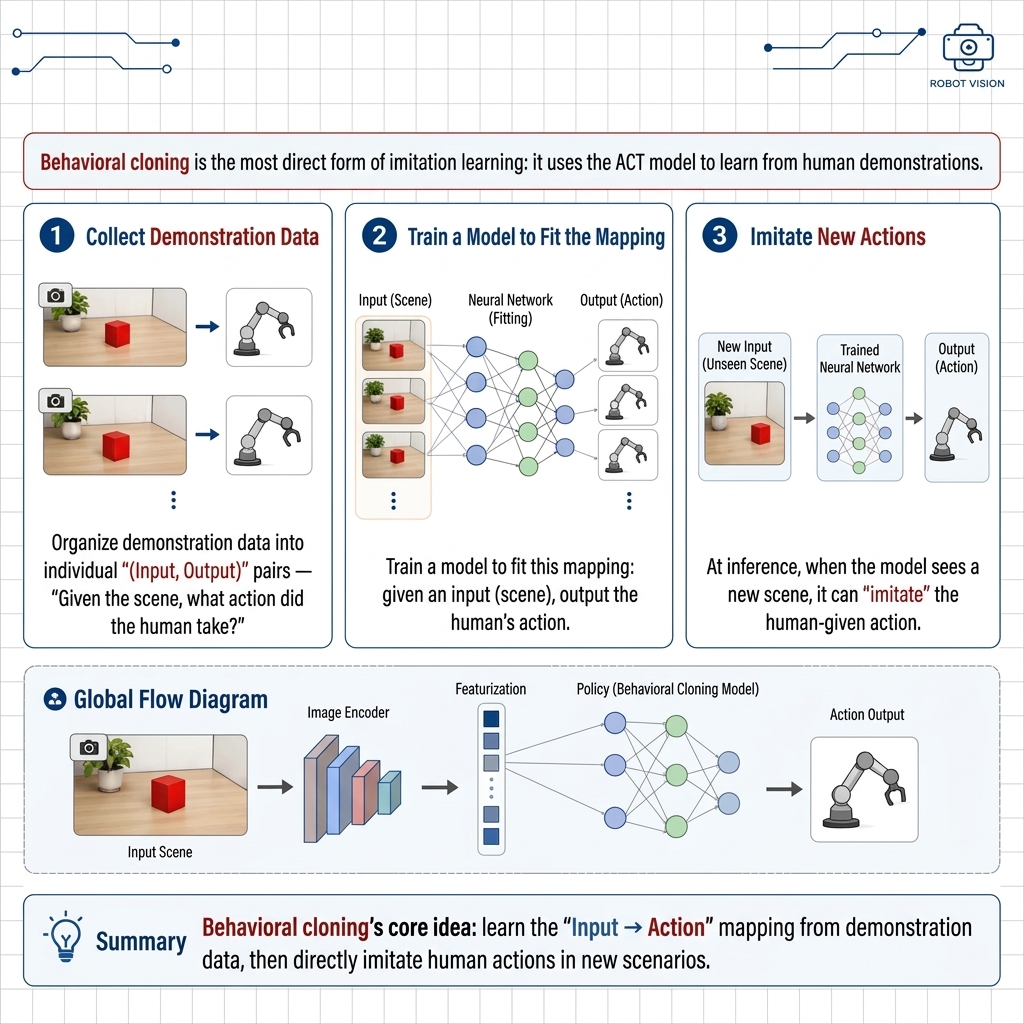
8.4 観測・状態・アクション
8.4 観測・状態・アクション
模倣学習のすべてのデータは 3 つの概念に分類できます。これらの言葉は以降のすべての章に登場するので、ここで正確な直観を作ってください。
- 観測(Observation):ロボットが「見る」世界;
- 状態(State):ロボット「自身」の状況;
- アクション(Action):ロボットが「これからすること」。
SO-ARM に具体化すると:観測は 2 台のカメラ画像、状態はフォロワーの 6 つの関節読み取り値(5 関節 + グリッパ)、アクションは次に送る 6 つの目標関節値です。
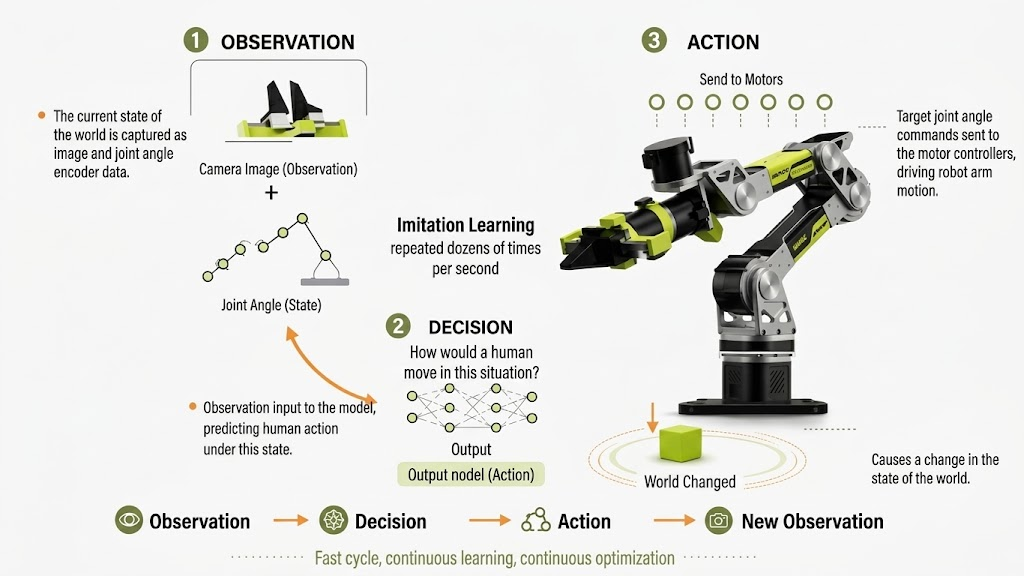
8.5 単発アクション vs. アクションチャンク
8.5 単発アクション vs. アクションチャンク
- 単発アクション:フレームごとに 1 回の意思決定;
- アクションチャンク:一度にアクションの列を予測。
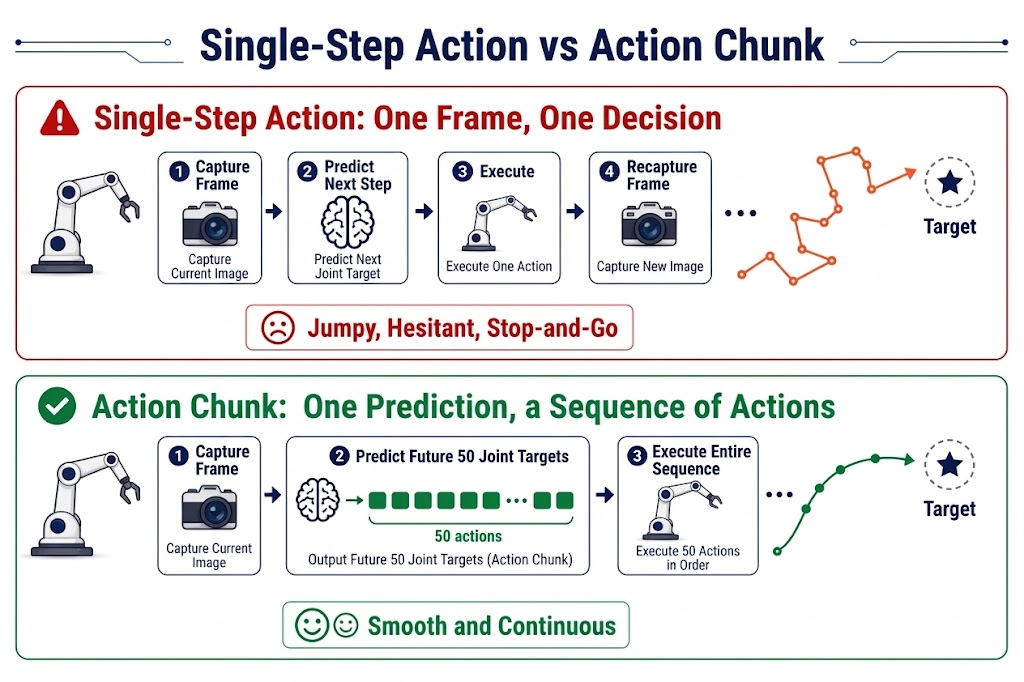
もちろん、チャンクが長いほど良いわけではありません。遠くまで予測すると、実行中に環境が変わる(例:物が弾かれる)のに、アームはまだ「古い」アクションを実行し続ける可能性があります。実システムは折衷案を使います:短い区間だけ開ループで実行し、再観測・再予測します。
8.6 データ分布とモデルの汎化
8.6 データ分布とモデルの汎化
これは全章で最も重要でありながら、初学者が最も見落としがちな節で、実践の成否を左右します。まずこの一文を覚えてください:
模倣学習モデルはデータにあることしか学べず、データがカバーする範囲でしか機能できない。
- 訓練時にモデルが見たすべての(観測, アクション)ペアがデータ分布を構成します。推論時、アームが遭遇する画像と状態がこの分布内にあればモデルは概ね良好に動作し、分布を外れた途端、出力は根拠を失い挙動が予測不能になります。
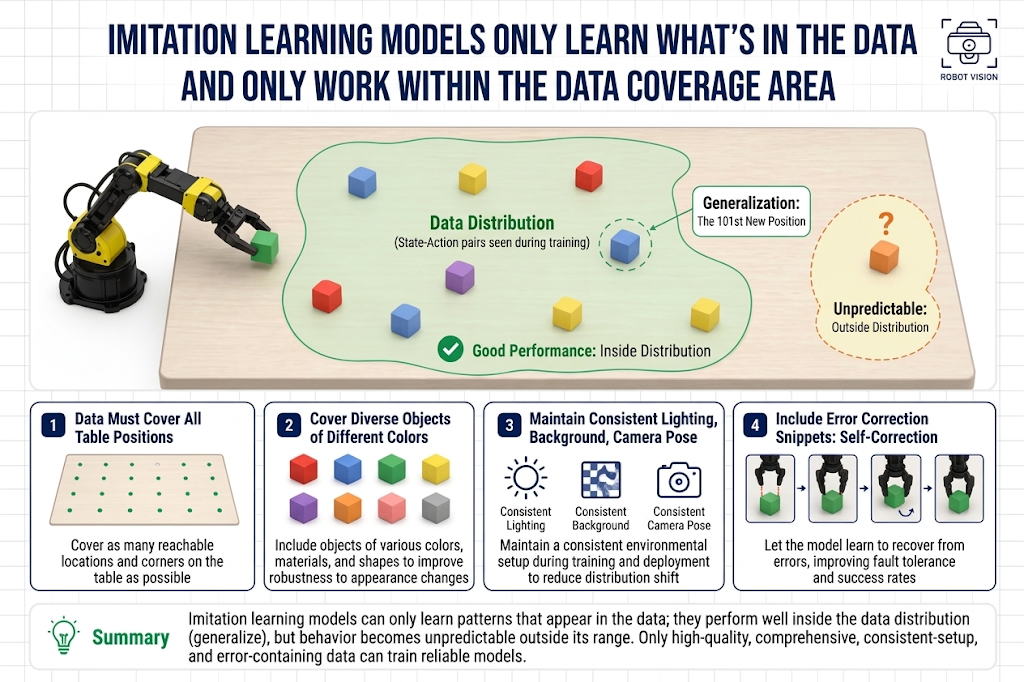
ここから非常に実践的な帰結がいくつも導けます:
- テーブル上のどこにでもブロックを掴ませたいなら、データはテーブル全体をカバーする必要があります — 中央だけで採れば、モデルは中央しか掴みません;
- 違う色の物体を掴ませたいなら、データに違う色が含まれていなければなりません — 新しい色は、モデルにとって未知の世界です;
- 光照・背景・カメラ位置はできるだけ採集時と同じに — 午後に採ったデータで訓練したモデルは、夜の室内光で完全に失敗するかもしれません。
そして汎化とは、データから学んだパターンを、分布内でまだ個別には見ていない状況に適用する能力です。例えば訓練で 100 か所のブロック位置を見て、推論で 101 か所目(まだテーブル上)にブロックが現れても掴める — それが汎化です。汎化は魔法ではなく、データの多様性から来ます:カバーが豊かで連続であるほど分布内の「隙間」が小さくなり、汎化は良くなります。
模倣学習の上限は、データ採集が完了した瞬間にほぼ決まります。訓練はその上限に近づくだけです。
8.7 訓練・推論・評価
8.7 訓練・推論・評価
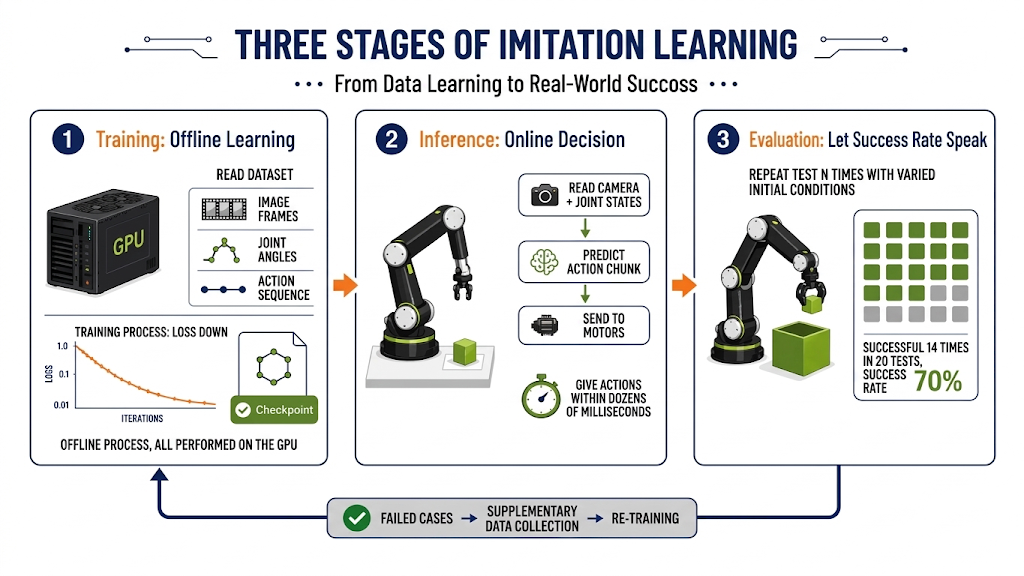
訓練:オフライン学習
訓練はデータ採集完了後に行われ、オフラインなプロセスです:アームは電源を切って脇に置けます。すべての作業は GPU 上で行われます。
- 入力:採集済みデータセット(画像・状態・アクションの時系列);
- 過程:モデルがデータを繰り返し読み、内部パラメータを調整し、予測アクションを人間のデモに近づけていきます;
- 出力:訓練済みモデルファイル。
訓練の質は主に Loss で観察します:Loss が下がるほど、予測アクションが人間のデモに近づいています。
推論:オンライン意思決定
推論はモデルを実機に展開してリアルタイムで動かすプロセスです:カメラと関節状態を読む → モデルがアクションチャンクを予測 → サーボへ送って実行。推論にはリアルタイム性が要求されます — 数十ミリ秒以内に出力しないとアームがカクつきます。
評価:成功率で判定
モデルは訓練され、Loss は低い — 本当に仕事ができるでしょうか?そうとは限りません。
Loss が低いのはモデルが「人間っぽい」だけで、「タスクを完了できる」わけではありません。 信頼できる評価方法は実機テストだけです:
- 明確な成功基準を設定(例:「ブロックが箱に入っている」);
- 初期条件を変え(ブロック位置、光照)、N 回繰り返す;
- タスク成功率を計算 — 例:20 回中 14 回成功 = 成功率 70%。
評価で見つかった失敗ケースは終点ではなく、次のデータ採集への入力です — 失敗した場所に追加データを採り、再訓練する。これがデータイテレーションのループであり、実プロジェクトの日常です。
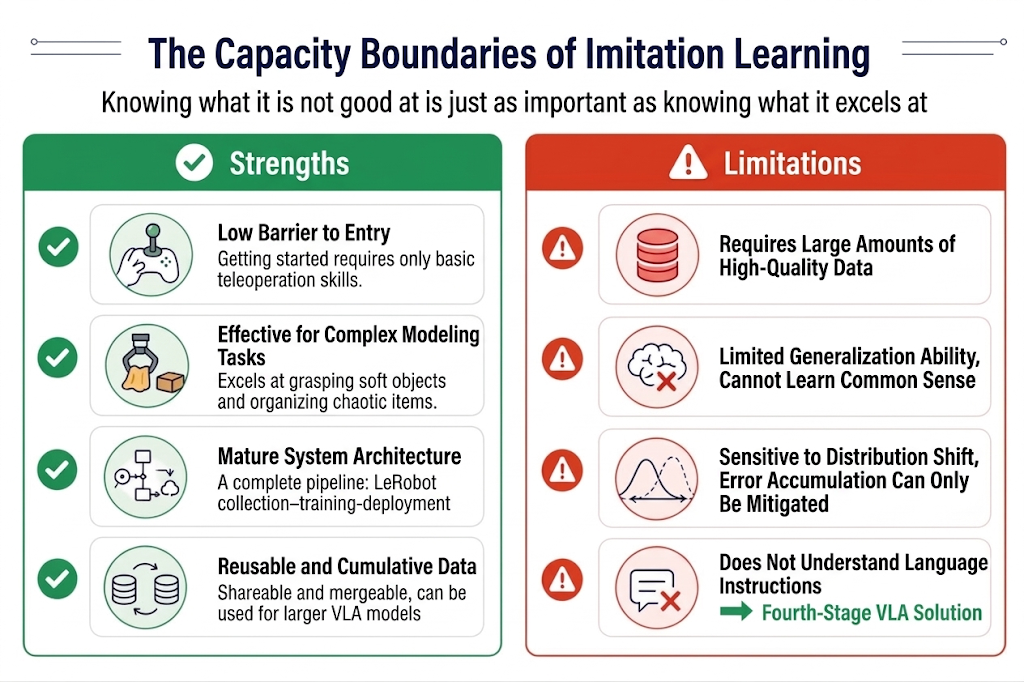
8.8 模倣学習の利点と限界
8.8 模倣学習の利点と限界