reSpeaker Clip ローカル文字起こし:選定・導入・実測データ
Clip 1 台はこのホストにのみペアリングでき、スマートフォンアプリと同時には使えません。AI 要約でクラウドサービスを使う場合、文字起こしのテキストはそのサービスに送られます(録音は送られません)。
このソリューションでできること
reSpeaker Clip で録音した面談、診察、店頭での会話を、Bluetooth で自社の reComputer ホストに同期して文字起こしします。各発話にタイムスタンプと話者ラベルが付き、中国語・英語・日本語に対応します。録音は現場の外に出ず、結果はホストの Web ページで確認でき、MQTT と HTTP で自社システムにも取り込めます。店頭カウンター、インタビューや会議、診察室や法務など、録音を外に出せない場所向けです。
- デプロイパッケージ(Docker Compose と設定):github.com/suharvest/sensecraft-solutions
- 音声エンジンのソース:github.com/Seeed-Solution/openvoicestream
- 選定と導入:リファレンス設計ページ
録音は現場に
録音は Bluetooth で Clip からホストへ同期し、文字起こしもホストで完結。クラウドを経由しません。
26 秒の録音を 1.2 秒で
reComputer J40 シリーズで 2 人の中国語録音を実測(「性能と実測データ」参照)。
誰が話したかがわかる
各発話にタイムスタンプと話者ラベル。行をクリックするとその位置から再生します。
自社システムに連携
文字起こし完了時に MQTT で通知し、プログラムが HTTP で全文を取得します。
実機の画面
ホストの結果ページです。文字起こしを話者ごとに区切り、各発話にタイムスタンプを付けます。右側は AI 要約欄(今回はオフ)です。
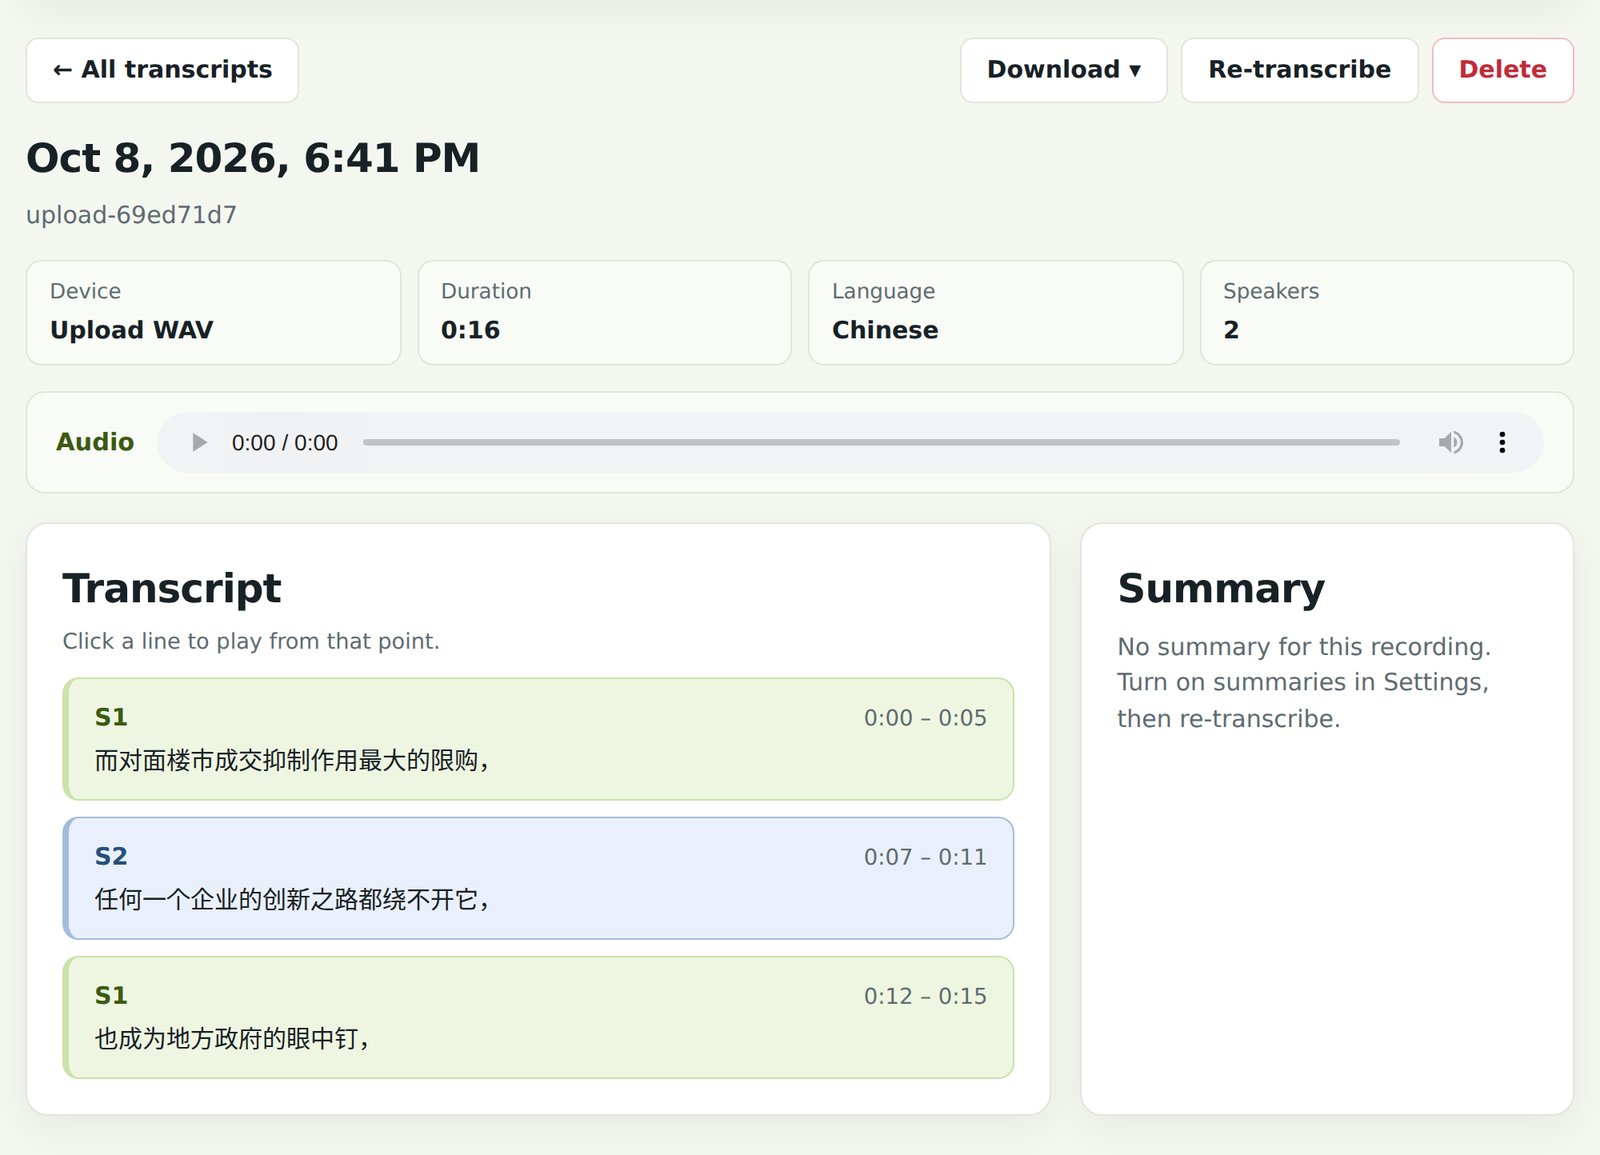
この 16 秒の録音は AISHELL-1 の 2 人の話者をつなげたもので、WAV でアップロードし、1.2 秒で文字起こしされました。1 行目に余分な文字が 1 つ入っています。
必要なハードウェア
現場に必要なのは reSpeaker Clip と文字起こしホスト 1 台です。
① reSpeaker Clip:身に着けるレコーダー。録音は Bluetooth でホストへ同期します。製品ページ
② 文字起こしホスト:現場の規模とバッジ台数に応じて 4 段階から選択。
| 文字起こしホスト | 単一対話の処理時間 (30秒・中国語2人対話) | 交代時一括同期の処理能力 (バッジ10台分を一括送信) | 選ぶ場面 | |
|---|---|---|---|---|
 | reComputer J40 シリーズ(J4012) Jetson Orin NX 16GB、JetPack 6.2 | 1.2 秒 | 約 3.5 秒で完了 (最大待ち時間 < 3.5 秒) | 10〜50 台のバッジを運用する推奨構成。16GB 統合メモリにより、ローカル 8B LLM による対話要約・コンプライアンス監査も同居可能 |
 | reComputer J30 シリーズ(J3011) Jetson Orin Nano 8GB、JetPack 6.2 | 1.3 秒 | 約 4.1 秒で完了 (最大待ち時間 < 4.1 秒) | 5〜20 台向けの主流コスト重視構成。体感は J40 と同等、VRAM 専有量はわずか 486 MB |
 | reComputer RK3588 シリーズ(8 GB) RK3588 3-Core NPU | 3.0 秒 | 約 14.5 秒で完了 (3 並列パイプライン) | 5〜15 台向けの中規模ワークステーション。3 つの独立 NPU コアで 3 つの Worker を真の並列稼働 |
 | reComputer RK3576 シリーズ(8 GB) オンボード NPU | 4.6 秒 | 約 46 秒で完了 (単一 Worker 順次処理) | 1〜3 台向けの低コスト構成。ピーク RSS わずか 442 MB(W4A16)、個人クリニックやカウンセリング室の順次処理に最適 |
- Jetson シリーズ:JetPack 6.2 が必須、空きディスク 15 GB 以上。
- RK3576:8 GB メモリ版を選択。W4A16 量子化重みを使用し、メモリ専有量は約 442 MB。ホストに Bluetooth が必要です。
- オプションの Wi-Fi 高速同期:ホストが Clip のホットスポットに接続して録音をダウンロードします。ホスト自体が Wi-Fi でネット接続している場合は USB 無線アダプターを追加します。
現場への導入
1. Clip が戻る場所にホストを置く
Clip はホストの Bluetooth 範囲内でのみ同期するため、スタッフが返却・充電する場所にホストを置きます。初回は音声認識モデル(Jetson 約 1.8 GB、RK3576 約 155 MB)のダウンロードにネット接続が必要で、その後の文字起こしにネットは不要です。
2. ソフトウェアの導入:3 ステップ
機器ごとの手順はリファレンス設計ページにあります。ここでは流れだけを示します。
- 文字起こしサービスのデプロイ:録音言語を選び、アクセストークンを設定します。要約を使う場合は OpenAI 互換サービスのアドレスを入力します。
- Clip のペアリング:ホストとペアリングすると、以降の録音は自動で同期されます。
- 確認:8631 番ポートの結果ページを開き、WAV をアップロードするか録音を同期して、話者ごとに分かれた文字起こしを確認します。
インターフェース
結果ページと API はホストの 8631 番ポートにあり、未認証のリクエストには 401 を返します。完了通知はホスト上の MQTT ブローカーから送られます。
- 結果を見るだけ:結果ページを開き、ID やデバイスで絞り込み、ダウンロード・再文字起こし・削除ができます。
- 自動で取り込む:完了通知を購読し、ID で HTTP から全文を取得してチケットや顧客記録に書き込みます。
- 音声を追加:アップロード API で WAV を送ると、同じ処理を通ります。
| トピック / ポート | 内容 |
|---|---|
HTTP 8631 / | 結果ページ:文字起こし一覧と詳細 |
HTTP 8631 POST /v1/transcribe | WAV をアップロードして文字起こし |
HTTP 8631 /healthz | サービスの準備状態 |
MQTT clip-pt/<host-id>/transcript/<transcript-id>/ready | 文字起こし完了通知 |
性能と実測データ
音声認識モデルにはアリババ達摩院の SenseVoice-Small(中国語、広東語、英語、日本語、韓国語対応、句読点・感情富テキスト出力)+ CAM++ 話者分離 + Silero VAD を採用しています。
1. 単一バッジの即時対話書き起こし(30 秒対話)
録音を WAV としてホストにアップロードし、アップロードから文字起こしおよび話者分離完了までを計測しました。Clip からの Bluetooth 同期時間は含みません。
| 機器と型番 | 言語とサンプル | 音声長 | 処理総時間 | 話者 / 区間 | 現場での体感 |
|---|---|---|---|---|---|
| reComputer J40 シリーズ(Orin NX 16GB) | 中国語 2 人長文対話(FLEURS-A) | 30.5 秒 | 1.17 秒(実測) | 2 人 / 4 区間(実測) | 175 倍リアルタイム、対話終了直後に文字化 |
| reComputer J40 シリーズ | 中国語 2 人接客対話(FLEURS-B) | 26.1 秒 | 1.21 秒(実測) | 2 人 / 5 区間(実測) | 瞬時完了、話者 S1 / S2 を分離表示 |
| reComputer J40 シリーズ | 中国語 2 人問診(AISHELL-1) | 16.5 秒 | 1.17 秒(実測) | 2 人 / 3 区間(実測) | 待ち時間ゼロ |
| reComputer J30 シリーズ(Orin Nano 8GB) | 中国語 2 人接客対話(FLEURS-B) | 26.1 秒 | 1.32 秒(実測) | 2 人 / 5 区間(実测) | 主流構成、J40 と同等の快適性 |
| reComputer J40 シリーズ | 日本語接客対話(FLEURS) | 34.0 秒 | 1.71 秒(実測) | 2 区間(実測) | 多言語迅速処理、接客振り返りに最適 |
| reComputer J40 シリーズ | 英語 2 文(LibriSpeech) | 6.3 秒 | 1.24 秒(実測) | 2 人 / 2 区間(実測) | 高速レスポンス |
| reComputer RK3588 シリーズ(8 GB) | 中国語 2 人長文対話(FLEURS-A) | 30.5 秒 | 3.0 秒(実測) | 2 人 / 4 区間(実測) | 10 倍リアルタイム、複数コア並列処理 |
| reComputer RK3576 シリーズ(8 GB) | 中国語 2 人長文対话(FLEURS-A) | 30.5 秒 | 4.61 秒(実測) | 2 人 / 4 区間(実測) | 5 秒以内で完了、非緊急アーカイブ向け |
| reComputer RK3576 シリーズ | 中国語 2 人接客対話(FLEURS-B) | 26.1 秒 | 4.67 秒(実測) | 2 人 / 5 区間(実測) | 単一 Worker 安定稼働 |
2. 交代時の集中同期・並行処理(バッジ 10 台・計 10 分の音声一括アップロード)
現場で最も負荷のかかるシーンは交代時のバッジ返却です。各機器の並行処理機構と最大待ち時間:
| 機器選定 | 推奨バッジ数 | 10台分処理総時間 | 最大待ち時間(キュー遅延) | スケジューリングと信頼性機構 | 推奨現場 |
|---|---|---|---|---|---|
| reComputer J40 シリーズ (Orin NX 16GB) | 10 〜 50 台 | 約 3.5 秒 | < 3.5 秒(待ち時間ほぼゼロ) | 超リアルタイム・ミリ秒単位キュー消化:単一コンテキスト CUDA Graph ロックでメモリ溢れや 429 エラーを完全防止 | 大型スーパー、チェーン店、行政窓口 |
| reComputer J30 シリーズ (Orin Nano 8GB) | 5 〜 20 台 | 約 4.1 秒 | < 4.1 秒(待ち時間ほぼゼロ) | 同上、GPU スループット 29.5 QPS、VRAM 使用量わずか 486 MB | スタッフ 8〜15 名の標準店舗・専門店 |
| reComputer RK3588 シリーズ (RK3588 8GB) | 5 〜 15 台 | 約 14.5 秒 | 約 5.0 秒(3 並列パイプライン) | ハードウェア真の並行処理:3 つの独立 NPU コアで 3 つの Worker を並行稼働 | 中規模ワークステーション、分散窓口 |
| reComputer RK3576 シリーズ (RK3576 8GB) | 1 〜 3 台 | 約 46 秒 | 約 46 秒(順次処理) | 単一 Worker 軽量運用:メモリピークわずか 442 MB(W4A16)、順次キュー処理 | 個人クリニック、相談室、小型窓口 |
なぜ Jetson ではマルチプロセス並行ではなく「単一コンテキスト排他ロック」を採用するのか:
Orin Nano / NX の実測では、SenseVoice TensorRT FP16 + CUDA Graph により単一ストリームで既に GPU 演算能力(GR3D 98%、推論時間わずか 30〜33 ms、175 倍超リアルタイム)をフル活用しています。並行コンテキストを無理に多重起動すると、200〜300 MB の余分な VRAM を消費する上に CPU エンキューの競合が発生し、1 ストリームあたりの遅延が 135 ms まで悪化します。単一コンテキストのキューロックにより、同時に送信された音声チャンクをミリ秒単位で高速消化することで、数十台の並行接続を受け入れながらメモリ枯渇や 429 エラーを完全に防止しています。
3. 各プラットフォームのリソース使用量比較
| プラットフォーム | モデル形式・精度 | 重み・エンジンサイズ | ピークメモリ / VRAM | Worker 構成 |
|---|---|---|---|---|
| reComputer J40 シリーズ | TensorRT 10.3 FP16 | 470 MB Engine | 483 MB VRAM / 1.1 GB RAM | 単一コンテキストキューロック(OOM 防止) |
| reComputer J30 シリーズ | TensorRT 10.3 FP16 | 469 MB Engine | 486 MB VRAM / 1.1 GB RAM | 単一コンテキストキューロック(高安定性) |
| reComputer RK3588 シリーズ | RKNPU2 FP16 | 505 MB RKNN | 約 1.2 GB RAM / Worker | 3 独立ハードウェアコアで 3 Worker 稼働 |
| reComputer RK3576 シリーズ | RKNPU2 W4A16 | 155 MB RKNN | ピーク RSS 442 MB(実測) | 単一 Worker(8 GB メモリ枠に最適) |
4. 実機の Clip
reSpeaker Clip 1 台から Bluetooth で録音セッション 3 件をダウンロードし、16 kHz の WAV に組み立てて reComputer J40 シリーズで文字起こししました。SenseVoice の認識は 534 ms、話者分離は 706 ms です(実測)。
- 再現手順:性能および同時実行ベンチマークはリポジトリの
benchmarks/eval_transcription.pyに配置されています。python3 benchmarks/eval_transcription.py --device j40 --batch 10を実行して検証できます。
5. モデルとランタイム
| 機器 | 音声認識 | 話者分離 | ランタイム |
|---|---|---|---|
| reComputer J40 / J30 シリーズ | SenseVoice-Small(富テキスト) | CAM++ | TensorRT 10.3 FP16、GPU |
| reComputer RK3588 シリーズ | SenseVoice-Small(多言語) | CAM++ | RKNPU2 FP16、NPU、3 Worker |
| reComputer RK3576 シリーズ | SenseVoice-Small(多言語) | CAM++ | RKNPU2 W4A16、NPU、1 Worker |
結果に影響するパラメーター:
- 録音言語:導入時に選び、Clip の録音とアップロードした WAV の両方に適用します。「自動」ではモデルが判定します。
- 想定話者数:既定は 0(自動)。人数がわかっている場合は指定すると分離が安定します。
- AI 要約:既定はオフ。オンにすると文字起こしのテキストを設定したサービスに送ります。
6. 既知の制限と選定の境界条件
- 交代時の一括同期台数と選定の目安:RK3576 は 8 GB システムメモリの制限から SenseVoice Worker を 1 つのみ稼働(RSS 442MB)させるため、10 台のバッジが一括返却されると約 45 秒の待ち時間が発生します。5 台以上のバッジを交代時に一括同期する場合は reComputer J30 または J40 シリーズを強く推奨します。
- 文頭の語の欠落:SenseVoice は VAD の音声区間検出の影響で、長尺音声の冒頭の単語を欠落させることがあります。
- 複数話者の重複発話:2 人以上が同時に話した場合、話者分離(Diarization)の精度が低下し、発話が細切れになったり同一話者として統合されることがあります。
- 環境ノイズと装着距離:店舗内アナウンスなどの大音量ノイズ環境では遠方の音声が過剰に抑制されるため、工牌は胸元(口元から 20〜40 cm)に装着してください。
データと素材の出典
- FLEURS(Conneau et al., 2022):huggingface.co/datasets/google/fleurs、cmn_hans_cn dev セット、CC BY 4.0。
- AISHELL-1(Bu et al., 2017):openslr.org/33、Apache 2.0。
- LibriSpeech:openslr.org/12、CC BY 4.0(英語サンプル)。