小売音声文字起こし:構築・導入・実測結果
これは参考実装であり、認証済みの文字起こし製品やコンプライアンスツールではありません。話者ラベルはクラスタリング結果で、個人を特定するものではありません。
2つのモードはどちらも結果を小売バックエンドに書き込みます。違いはASRを実行する場所で、デバイスが文字起こしをしてテキストJSONだけをアップロードするか、Clipの音声をスマートフォン経由でアップロードしてサーバーでASRを行うかです。
- デバイス上の文字起こし:ボックスがASRを実行し、最終テキストJSONを小売バックエンドにアップロードします。WAVは任意でローカルに保存できます。
- サーバースタック:arm64ホストに、保存前の匿名化、MySQL、MinIO、管理コンソール、対象者単位のエクスポートと完全削除のエンドポイントを追加します。音声はエッジ収集端末のマイクアレイ、または既存のスマートフォンアプリから入力します。
デバイス上のプリセットで始めた現場は、アレイ、ホスト、認識器を変えずに後からサーバースタックへ移行できます。
このソリューションでできること
プリセット:デバイス上の文字起こし
カウンター上のマイクアレイが会話を拾い、隣の小型ボックスが音声を文字に変換して、最終的な文字起こしJSONを小売バックエンドにアップロードし、保存・表示します。ClipモードではSenseCraft Voice Appがgateway経由で音声をvoice-serviceに渡し、voice-serviceがOpenVoiceStreamでASRを行い、結果を同じバックエンドに書き込みます。
向いている現場:録音を建物の外に出せない単独店舗やパイロット店舗、上り回線が不安定な現場、第三者による音声処理を調達規定で禁止している場合、クラウド移行の前に現場で音声経路と認識品質を検証したい場合です。
- 構成の選択と導入:参考設計ページ
マイクは挿すだけで使える
reSpeaker XVF3800は標準のUSBオーディオデバイスとして接続されます。エコーキャンセル、ビームフォーミング、ノイズ抑制はアレイ内蔵のDSPで行い、ホストのCPUは使いません。
音声を店舗の外に出さない構成が可能
デバイス上の文字起こしではテキストJSONだけをアップロードします。WAVはファイル出力を有効にしたときだけ書き込まれ、無効にするとデバイスにはテキストだけが残ります。
保存前に匿名化、対象者単位で削除
サーバースタックはデータベースへの書き込み前に氏名と電話番号をプレースホルダーに置き換えます。対象者単位の削除は残留件数を返し、対象者単位のエクスポートも可能です。
既存アプリや業務システムと接続
reSpeaker ClipとSenseCraft Voice Appで音声を直接アップロードできます。BI、CRM、チケットシステムはHTTPで匿名化済みテキストを読み取り、削除とエクスポートを呼び出せます。
プリセット:サーバースタック
音声が入ると、匿名化済みの文字起こしがデータベースに書き込まれます。保存済みの内容は対象者単位で削除でき、残留件数が返ります。パッケージはバージョン固定のDocker composeで、認識、声紋、匿名化と保存を担うサービス、MySQL、MinIO、管理コンソール、および音声入力用のWebSocket ASRエンドポイントで構成されます。
収集経路は2つあります。デバイス側文字起こしアップロードモードでは、エッジボックスのreSpeaker XVF3800アレイが音声を収集し、音声区間検出を行い、OpenVoiceStreamでローカルに文字起こしをしたうえで、アプリがテキストJSONだけを小売バックエンドにアップロードします。WAVは任意でデバイスに残せます。Clipモードでは、reSpeaker Clipの音声をSenseCraft Voice Appが受け取ってバックエンドにアップロードし、voice-serviceがOpenVoiceStreamを呼び出して結果を保存します。アプリは導入ホストの.envにあるoperator keyを使い、データベース認証情報とJWTシークレットは導入処理で自動生成されます。
利用場面:店頭で従業員と顧客が会話し、運営側は何を聞かれたかを知りたいが、誰が聞いたかは残したくない場合。削除要求に対して、データベース行、オブジェクト、声紋が削除されたことを示す必要がある場合。既存アプリで音声を収集していて、後段の処理が欠けている場合。音声を現場外に出さないことが条件のパイロット。
コンソールに表示される内容
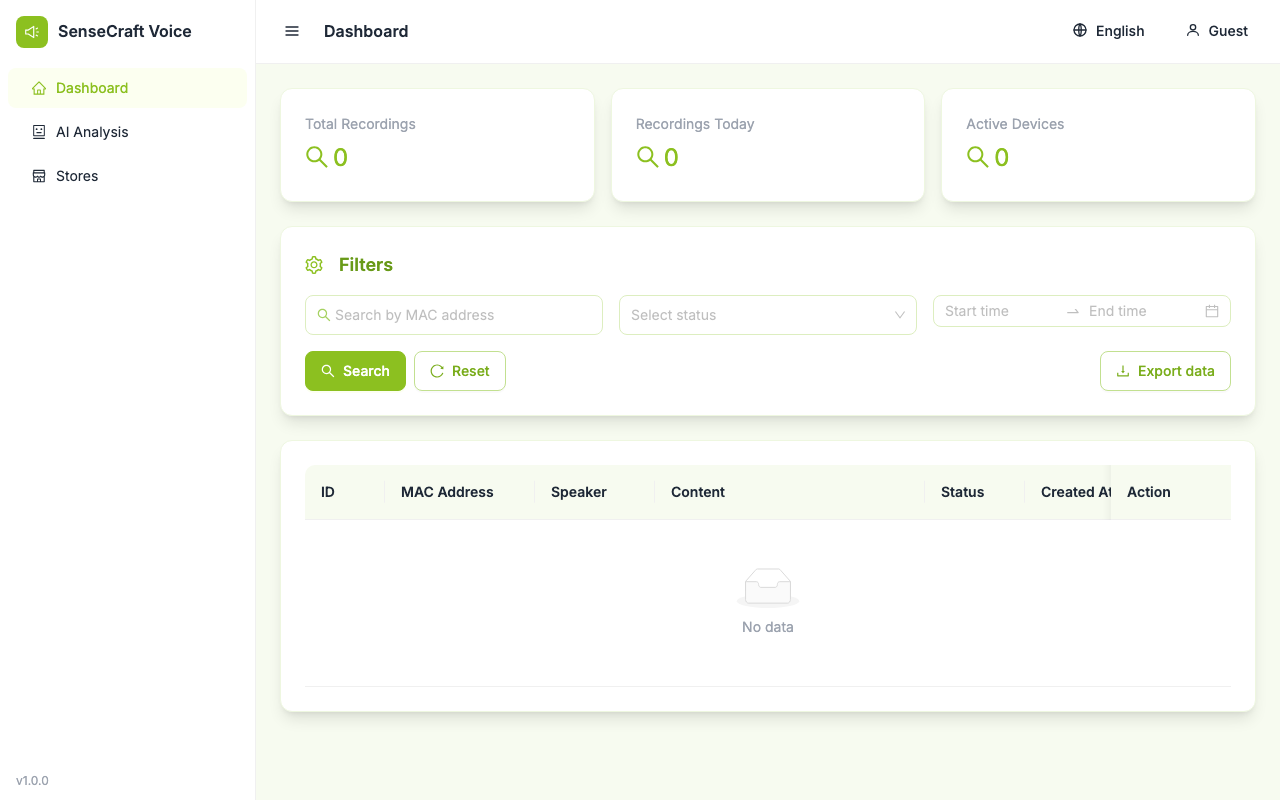
サーバースタックプリセットでは、管理コンソールにサインインすると、録音一覧に各発話の文字起こし、長さ、送信元デバイスが時系列で表示されます。
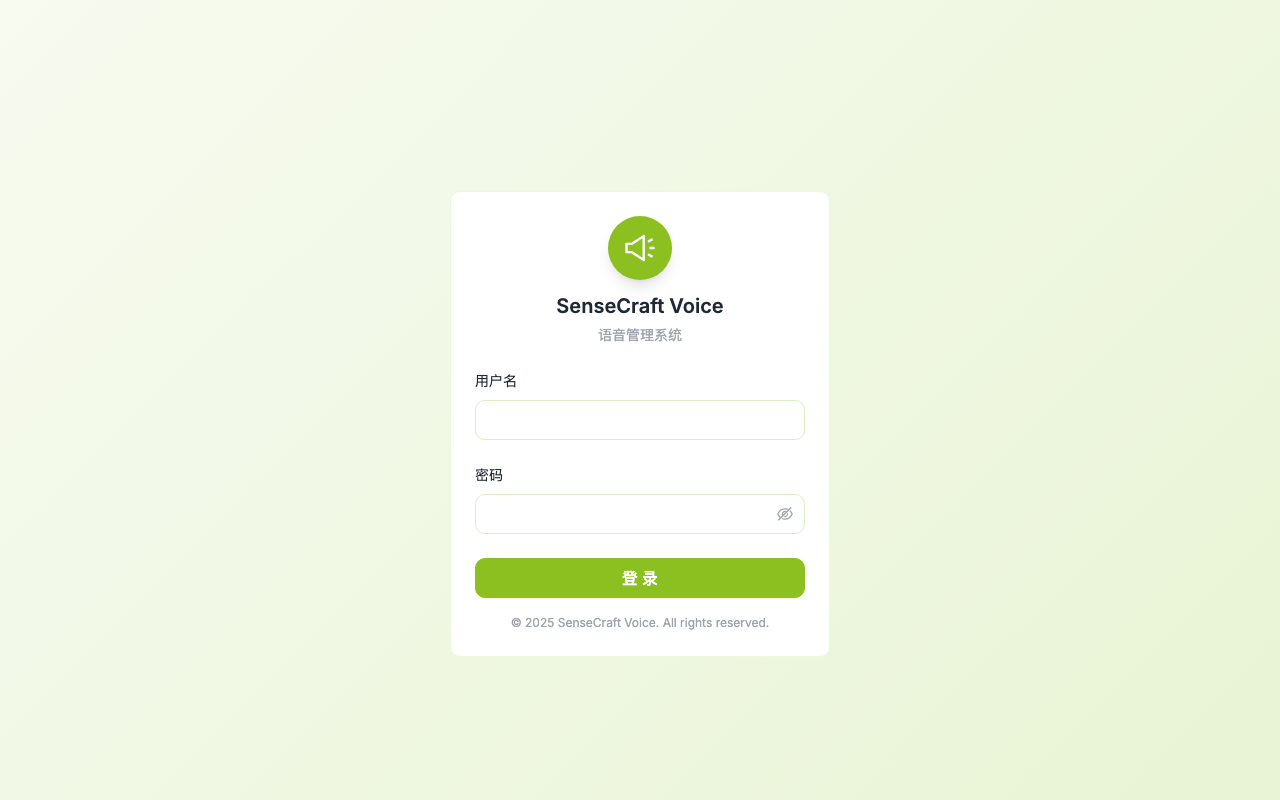
一覧のテキストは匿名化済みです。氏名と電話番号は保存前にプレースホルダーに置き換えられ、原文は保存されません。
必要な機器
プリセット:デバイス上の文字起こし
話者エリアごとに機器2台と書き込み可能なディレクトリが必要です。
① マイクアレイ:USBホストポートにreSpeaker XVF3800を1台接続します。エコーキャンセル、ビームフォーミング、ノイズ抑制はアレイ内蔵のXMOS DSPで行われ、ホストは16 kHzモノラル音声を1本受け取ります。前処理にホストのCPUは使いません。アレイは標準のUSBオーディオデバイスとして認識されます。
② 文字起こしホスト:実測データの有無と、句読点と話者ラベルを認識と同時に有効にできるかが決まります。
| ホスト | ASRの実行場所 | 選ぶ条件 | |
|---|---|---|---|
 | reRouter CM4 CPUのみのボックス、BCM2711、4コア、4 GB | Cortex-A72 4コア、Paraformerストリーミング | 予算を優先し、最初の現場をパイロットとする場合 |
 | reComputer RK3576-30 6 TOPS NPU、8 GB | RK3576 NPU、SenseVoice RKNN fp16 | 実測データのあるホストが必要な場合、または句読点と話者ラベルを同時に使う場合 |
カバー範囲。 1台のアレイで1つの話者エリアをカバーします。定常的な背景騒音が70 dB以下であれば、XVF3800のビームフォーミングは3 m以内の話者をカバーします。複数アレイのモードはなく、2つ目のカウンターには2台目のアレイと2台目のボックスが必要です。
このほか、空きUSBホストポート、文字起こし結果(と任意の音声)を保存する書き込み可能なディレクトリ(composeでコンテナログのサイズを制限し、モデルは名前付きボリュームに置くため、使用とともに増えるのは文字起こしディレクトリだけです)、バックエンドへのアップロードと初回起動時のモデルダウンロード用のネットワークが必要です。
プリセット:サーバースタック
必要なのは最大2点で、スタックを動かすホストと、エッジ収集経路で使うマイクアレイです。
① スタックホスト:Dockerをインストールし、20 GBの空きがある任意のarm64 Linuxホスト。固定イメージはarm64のみで、同梱の認識イメージはRK3576 NPU向けのビルドです。RKNN NPUのないホストでは対応する認識イメージに差し替えが必要です。
| ホスト | 役割 | 選ぶ条件 | |
|---|---|---|---|
| — | reComputer RK3576-30(SKU 100052518) | スタックホスト。エッジ収集経路では収集端末も兼ねる | 同梱イメージがこのボード向けにビルドされており、認識はNPUで動作 |
| — | reRouter CM4(SKU 110110110) | 収集端末のみ | 手元にCM4がある場合。認識はCPUで動作し、この経路向けの固定イメージはパッケージに含まれないため自分で用意する |
② マイクアレイ(エッジ収集経路のみ):reSpeaker XVF3800 USB 4-Mic Array(SKU 101991441)。ノイズ抑制、エコーキャンセル、ビームフォーミングはアレイのDSPで行われ、ホストはUSB経由で16 kHzモノラル音声を1本受け取ります。
**スタックホスト1台は、まず1–2本で始めてください。**ASR単体の同時実行容量は「性能と実測データ」の5機種同時実行表にあります。
その他の前提:収集端末からスタックホストのASRポートに到達できること。トークンがURLクエリパラメータで送られる場合があるため、信頼できないネットワークを経由するときは前段にTLS終端を置きます。
選定における制約・非推奨条件
- 音声並行チャンネル上限:reComputer RK3576 は最大 12 チャンネルの同時書き起こしに対応します。16 窓口以上ある店舗では 2 台目の追加または Jetson 構成への拡張が必要です。
- 個人情報の保護:既定では数字のマスキングは無効です。金融取引や個人情報保護の要件がある場合は、サーバー構成でマスキングを明示的に有効化してください。
現場への導入
プリセット:デバイス上の文字起こし
先にアレイを配置し、その後で2つのコンテナを起動します。
前半 — アレイの配置
話者はアレイから3 m以内、定常的な背景騒音は70 dB以下(通常の会話程度)にします。この範囲を超えるとアレイのノイズ抑制で話者を分離できなくなり、認識誤りが増えます。ホストを変えても改善しません。
アレイはカウンター上で話者エリアに向けて置き、パーティションの裏や庇の下には置かないでください。ボックスのUSBホストポートに接続するため、両者はケーブル長の範囲内に置きます。
後半 — ソフトウェアの起動
機器ごとの手順は参考設計ページにあります。流れは次のとおりです。
- 構成を選ぶ:ページでは2点を尋ねます。文字起こしに何を含めるか(テキストのみ / 句読点付き / 話者ラベルも)と、稼働前に実測データのあるホストが必要かどうかです。ホストとアレイはこの2つの回答から決まります。
- パッケージを導入:どちらのプリセットも同じ2つのコンテナ(音声サービスと音声クライアント)を使います。プリセットの切り替えで変わるのはイメージタグとprofileで、出力形式は変わりません。
- デバイス入力項目を設定:出力ディレクトリ、WAVを残すか、句読点復元と声紋ベクトルを有効にするか。後の2つはそれぞれモデルを1つ読み込むため、4 GBのCPUのみのボードで両方を有効にすると余裕が少なくなります。
- 確認:短いWAVを
POST /asrに送ります。正しいテキストが返り、backendフィールドに実際のランタイムが示されれば経路は正常です。その後、ポート8090のローカルWebページにリアルタイムの文字起こし、マイクの状態、声紋登録リストが表示されます。
所要時間:モデルのダウンロード後、1回の導入で約40分です。モデルボリュームが準備済みの場合、RK3576での再起動から正常状態までは実測で約25 sです。
プリセット:サーバースタック
2つのプリセットはいずれも中級向けで、所要時間は約60分、最後は手動の受入確認です。機器ごとの操作は参考設計ページにあり、現場の条件に合わせて構成を選ぶと対応するアプリケーションパッケージをダウンロードできます。
サーバースタック + スマートフォンアプリ:arm64ホストにスタック一式を導入し(ステップ1)、http://<導入デバイスIP>:18621とホストの.envにあるoperator keyをアプリに設定し(ステップ2)、管理コンソールを開き(ステップ3)、受入確認を行います(ステップ4)。ClipモードではSenseCraft Voice AppがClipの音声を受け取り、対応する音声ファイルをPOST http://<stt-host>:18621/v1/audio/transcriptionsにアップロードします。バックエンドが文字起こし、匿名化、保存、表示を行います。
サーバースタック + エッジ収集端末:収集端末を導入します(ステップ1)。固定composeは1つの単位なので、収集端末にスタック一式が含まれます。管理コンソールを開き(ステップ2)、受入確認を行います(ステップ3)。
手動の受入確認で確かめること。 保存されたテキストが匿名化されていること、削除後に何も残らないことです。誰かがアプリまたはマイクアレイに向かって電話番号を含む文を1つ話します。次に、保存された行を読み(番号がプレースホルダーで表示されること)、その対象者に対して削除エンドポイントを呼び出して返される残留件数を確認し、エクスポートを確認します。
店舗に入る前の準備:デバイスファミリーを選び、デバイスとSSHアクセスを用意します。導入処理でデータベース認証情報、JWTシークレット、operator keyが自動生成されます。operator keyは導入ディレクトリの.envにOPERATOR_TOKENとして保存され、アプリではhttp://<導入デバイスIP>:18621と組み合わせて使います。
利用できるインターフェース
プリセット:デバイス上の文字起こし
デバイスモードは最終的な文字起こしJSONを作成して小売バックエンドにアップロードします。Clipモードはスマートフォンとgateway経由で音声をvoice-serviceに渡します。導入時にクライアントのバックエンドURLとアクセスキーを入力し、内部データベースとJWTシークレットは自動生成されます。
- テキストだけが必要:JSONファイルを読みます。
<出力ディレクトリ>/cache/asr/に、区切られた発話ごとに1ファイルが作られ、文字起こし、タイムスタンプ、言語、声紋照合が有効な場合は話者ラベルを含みます。 - リアルタイムでテキストを受け取る:8621のWebSocketに接続します。16 kHzモノラルのPCMフレームを送り、空フレームで1発話を終えます。各結果には文字起こし、句読点、192次元のCAM++ベクトルが含まれます。
- ファイル全体を送る:WAVを8621に
POSTします。導入ガイドの受入確認で呼び出すのはこのエンドポイントです。
インターフェースとペイロード一覧
| インターフェース / ポート | 内容 | デバイス外に出るか |
|---|---|---|
<出力ディレクトリ>/cache/asr/<id>.json | {"id","text","lang","start_ms","end_ms","speaker"}、区切られた発話ごとに1ファイル | いいえ |
<出力ディレクトリ>/voice/*.wav | 16 kHzモノラルのWAVクリップ。ファイル出力が有効なときのみ書き込み | いいえ |
ws://<デバイスIP>:8621/asr/stream?vad=none&punctuate=true&speaker_embedding=true | ストリーミングASR:PCMを入力し、文字起こし、句読点、192次元CAM++ベクトルを出力 | いいえ |
POST http://<デバイスIP>:8621/asr | ファイル全体の文字起こし。例:{"text":"这个多少钱","backend":"rk:sensevoice_rknn"} | いいえ |
http://<デバイスIP>:8090/ | ローカルWebページ:リアルタイムの文字起こし、マイクの状態、声紋登録リスト。店舗LAN内からのみアクセス可能 | いいえ |
speakerフィールドは声紋照合を有効にしたときだけ出力されます。 ローカル登録リスト内のクラスタラベルであり、個人を特定するものではありません。オフラインエンドポイントの応答にあるbackendフィールドは実際に処理したランタイムを示すため、SenseVoiceがNPUで動いたかCPUにフォールバックしたかを区別できます。
プリセット:サーバースタック
データはすべてスタックホストのHTTPまたはWebSocketエンドポイントから読み取ります。トークンは.envのname:role:token形式のエントリ(VOICE_API_TOKENS、ASR_API_TOKENS)で、ロールによってアクセスできるルートが決まります。
- SenseCraft Voice App:reSpeaker Clipの音声をアプリが対応形式に変換し、
POST /v1/audio/transcriptionsでアップロードします。文字起こしJSONはスマートフォンに返ります。 - PCMストリーミングクライアント:8080のWebSocket、operatorロール。生のPCMバイナリフレームを送り、JSONメッセージを受け取ります。
- BIまたはCRMシステム:8081の
GET /api/v1/recordings、viewerロール。読み取るテキストは匿名化済みで、原文を返すエンドポイントはありません。 - プライバシーまたはチケットの処理フロー:8081の
POST /api/v1/privacy/eraseとGET /api/v1/privacy/export、adminロール。 - 人による確認:3000の管理コンソール。
インターフェースとペイロード一覧
| インターフェース | ポート | パス | ロール | 内容 |
|---|---|---|---|---|
| WebSocket | 8080 | /ws?token=<operator> | operator | クライアント→サーバー:生のPCMバイナリフレーム、16 kHz、モノラル、符号付き16ビットリトルエンディアン、1件≤ 2 MiB。サーバー→クライアント:JSON、typeはconnection、vad、final、error |
| HTTP | 8081 | /api/v1/recordings | operator(POST)、viewer(GET) | 文字起こしの登録と照会。匿名化は挿入前に実施 |
| HTTP | 8081 | /api/v1/privacy/erase | admin | 対象者 / デバイス / セッション単位の完全削除 |
| HTTP | 8081 | /api/v1/privacy/export | admin | 匿名化済みテキストJSONと音声マニフェスト |
| HTTP | 3000 | / | viewer以上 | 管理コンソール:録音、キーワード、デバイス、エクスポート、削除 |
| HTTP | 8621 | /health | — | OpenVoiceStreamのヘルスチェック。オーケストレーションの死活監視用 |
finalメッセージの例:
{"type":"final","text":"我想找[[NAME]]咨询一下","timestamp":1757030400000,
 "textLength":12,"wordCount":2,"sessionID":"a1b2","audioID":"c3d4",
 "speaker":{"identified":true,"speaker_id":"spk-7","speaker_name":"staff-a","confidence":0.83}}
3つのフィールドの意味:
textは匿名化済みのテキストです。 データベースには[[NAME]]のようなプレースホルダーがそのまま保存され、原文はどこにも書き込まれず、暗号化したコピーもありません。- 既定の導入では
speaker.identifiedはfalseです。 声紋照合が必要な場合は声紋profileを選びます。導入完了後にエンドポイントとkeyが渡されます。 - トークンはヘッダーでも送れます。
X-API-TokenとAuthorization: Bearerのどちらにも対応しています。?token=クエリパラメータは、カスタムヘッダーを設定できないブラウザのWebSocketクライアント向けです。
認証では2種類の失敗を区別します。認証情報がない場合は401、ロールが不足している場合は403を返すため、連携側はトークンを替えるべきかロールを変えるべきかを判断できます。ルールを設定していないルートには少なくともviewerが必要で、新しいエンドポイントは既定で公開されません。ロールのない旧トークンはviewerに格下げされます。
性能と実測データ
プリセット:デバイス上の文字起こし
ランタイムと主要パラメータ
OpenVoiceStream音声サービスのリポジトリは公開されていないため、GitHubリンクはありません。
| ホスト | 認識モデル | 精度 | ランタイム | モデルをデバイスに届ける方法 |
|---|---|---|---|---|
| reRouter CM4 | Paraformerストリーミング | CPU | 4基のCortex-A72コア上のONNX / sherpa-onnx | 導入時に選んだミラーから初回起動時にダウンロード |
| reComputer RK3576シリーズ | SenseVoice | fp16 | 6 TOPS NPU上のRKNN | 同上。.rknnはこのSoC向けにコンパイル |
CT-Transformerの句読点とCAM++の声紋は、どちらのホストでもsherpa-onnxでCPU上で動作します。4 GBのCPUのみのボードで両方を有効にすると、認識と同じCPUコアとメモリを奪い合います。
vad(ストリームURLのパラメータ):発話をどこで区切るか。vad=noneは区切りを呼び出し側に任せます。下表の実測はこの設定です。punctuate=true:CT-Transformerを読み込み、句読点付きの文を返します。speaker_embedding=true:CAM++を読み込み、固定しきい値でローカル登録リストと照合してspeakerラベルを出力します。照合はヒューリスティックで、登録手順、生体検知、信頼度の保証はありません。入退室管理、決済、個人に関する判定には使わないでください。
reComputer RK3576シリーズの実測
| 指標 | 値 | 条件 |
|---|---|---|
| オフライン文字起こしの遅延 | 3.0 sの音声 → ウォーム状態で約780 ms(RTF 0.26) | SenseVoice RKNN fp16をNPUで実行。POST /asr、コンテナはウォーム状態 |
| メモリ使用量 | コンテナRSS 1.71 GiB | ASR + 句読点 + 声紋をすべて読み込み |
| 再起動から正常稼働まで | 約25 s | モデルボリュームは取得済み |
| 短い発話の文字起こし | 短い発話5件(中国語3 + 英語2)すべてが"backend":"rk:sensevoice_rknn"と正しいテキストを返却。p50 678 ms、p95 810 ms(n=5、HTTPオーバーヘッドを含む) | このパッケージのcomposeとrk3576-sensevoiceプロファイルを変更せずに使用、ファイル入力 |
| ストリーミング認識精度 ▲ | 中国語CER 9.4%、英語WER 34.6% | bench/perf/corpus shortセット(中国語5 + 英語5)、Paraformer hybrid RKNNエンコーダー + RKNNデコーダー、/asr/streamのリアルタイム経路 |
| 発話終了から最終結果まで ▲ | 326 ms / 347 ms(中国語 / 英語の平均) | 同じ実行、/asr/streamで500 msのprepareリードあり |
| 声紋ベクトル | RTF 0.09–0.13(1 s → 125 ms、3 s → 255 ms、5 s → 428 ms) | CAM++をsherpa-onnxでCPU実行、2スレッド。10人のクラスタリングは1.45 ms |
| 声紋ベクトル、A72同等 * | RTF約0.10(1 s → 114 ms、3 s → 303 ms、5 s → 508 ms)、コールドロード1.66 s | reComputer R10シリーズ(Cortex-A72、4コア)、reRouter内のCM4と同世代のSoC。CAM++をsherpa-onnxでCPU実行 |
再現:assets/docker/docker-compose.local-rk3576.yml(ファイル先頭の記録)、openvoicestream/docs/perf/paraformer-rk3576-streaming-ab-20260608.md、openvoicestream/docs/specs/diarization-capability.md
▲ この2行はParaformerストリーミングプロファイルのデータで、ここで導入するSenseVoiceプロファイルではありません。この遅延を現在の経路の遅延とみなさないでください。現在の経路の発話終了から最終結果までは、サーバースタック節の5機種同時実行表を参照してください。
* 別のボードで、SoCは同世代のため換算値です。A72コアでの声紋ベクトルのCPUコストを示します。
既知の性能低下
- 収音範囲外。 話者が約3 mより遠い場合、または定常騒音が約70 dBを超える場合、アレイは話者を分離できず、認識誤りが増えます。上記のパラメータを調整しても改善しません。
- Paraformerストリーミングプロファイルでは英語が中国語より弱くなります。 同じshortセットで英語WER 34.6%、中国語CER 9.4%です。
プリセット:サーバースタック
ASRの容量と遅延:5機種の比較
| デバイスファミリー | モデル | 推奨同時本数 | p50 / p95 |
|---|---|---|---|
| reComputer J4012 | SenseVoice | 48 | 505 / 789 ms |
| reComputer J3011 | SenseVoice | 32 | 167 / 293 ms |
| reComputer RK3576 | SenseVoice | 12 | 583 / 1067 ms |
| reComputer RK3588 | SenseVoice | 8 | 659 / 902 ms |
| reComputer R2000シリーズ | SenseVoice | 6 | 625 / 1173 ms |
| reComputer J4012 | Whisper base | 16 | 584 / 1177 ms |
| reComputer J3011 | Whisper base | 8 | 492 / 837 ms |
| reComputer RK3576 | Whisper base | 2 | 809 / 1380 ms |
| reComputer RK3588 | Whisper base | 4 | 655 / 1380 ms |
| reComputer R2000シリーズ | Whisper base | 16 | 752 / 1465 ms |
条件:各音声は4秒以下。SenseVoiceはJetsonで200本、RKで100本、WhisperはJetson/RKで72本、R2000で100本の同時実行用コーパスを使用。p50 / p95はASRの発話終了から最終結果までの時間で、VAD、声紋、句読点、アップロード、匿名化、保存は含みません。ASR単体の容量です。
精度(同時実行用とは別の100件のコーパス):中国語aggregate CER 4.82%。英語WERはJ4012 7.62%、J3011 7.62%、RK3576 8.51%、RK3588 7.50%、R2000シリーズ8.39%です。
再現:openvoicestream/bench/asr_bench/build_unified_report.py
既知の制約
- 原文は保存されません。 携帯電話番号、身分証番号、氏名、住所はMySQLへの書き込み前に種類付きのプレースホルダーに置き換えられます。マスクするのは信頼度0.85以上のエンティティだけで、しきい値未満はマスクせず確認キューに記録します。
- 匿名化スコアはテキストレベルです。 中国語・英語の書かれたテキスト114件のゴールドセットでprecision 0.98、recall 0.95。スコアは書かれたテキストで算出したもので、ASR出力では文字起こしの誤りでエンティティの境界がずれます。再現:
tools/pii_eval.py - 読み上げた数字列には抜けがあります。
cn_mobile_spokenルールは中国語数詞で読み上げた11桁の携帯電話番号(「幺」を含む)に対応します。身分証番号、固定電話番号、その他の中国語数詞で読み上げた数字の識別子には対応していません。 - 音声は匿名化されません。 既定の保存期間は24時間で、導入時に6時間または1時間を選べます。エクスポートは匿名化済みテキストのJSONと音声マニフェストで、音声そのものは含みません。
- 対象者単位の削除後、3か所の残留は0件(データベース、オブジェクトストレージ、ローカル音声)。対象者のSHA-256だけを持つトゥームストーンと監査記録が残ります。再現:
assets/tools/delete_proof.sh - 外部送信の分析は既定で無効です。
c4-cloud-analyticsコンテナはcloud-analyticsプロファイルを選んだときだけ起動します。
次のステップ
- reComputer RK3576 でサーバースタックの保存までの全経路を測定します。同時実行 1 / 2 / 4 / 8 / 16 本と、発話終了 → 匿名化 → 保存の遅延(p50 / p95 / p99)です。
- サーバースタックでの中国語・英語の文字起こし精度(WER)と、1 / 10 / 60 / 240 分および 24 時間の連続収録を測定します。
- 声紋コンテナのイメージをビルドし、その後に話者誤り率を測定します。
データと素材の出典
プリセット:デバイス上の文字起こし
- 認識・句読点・エンドポイント検出・声紋モデル:認識はSenseVoiceとParaformer、句読点はCT-Transformer、声紋はCAM++、エンドポイント検出はSilero VADを使います。各モデルは上流のライセンスに従います。商用導入の前に、使用するモデルのライセンスを確認してください。モデルは導入時に選んだミラーから初回起動時にダウンロードされます。
- テストコーパス:精度の行は
bench/perf/corpusshortセット(中国語5 + 英語5)、短い発話の文字起こしの行は短い発話5件(中国語3 + 英語2)を使っています。どちらもパッケージには含まれません。 - 性能データの出典:
openvoicestream/docs/perf/paraformer-rk3576-streaming-ab-20260608.md、openvoicestream/docs/specs/diarization-capability.md、openvoicestream/docs/perf-test-runbook.md。OpenVoiceStreamリポジトリは公開されていないため、これらの文書に公開リンクはありません。 - アーキテクチャ図:承認済みの製品ステッカーカタログから生成しています。マイクのノードは汎用の役割記号で、XVF3800の実際の筐体ではありません。
プリセット:サーバースタック
- PIIゴールドセット:precisionとrecallの算出に使った中国語・英語の114サンプル。パッケージには含まれません。
- 匿名化の辞書:『百家姓』と中国の省級行政区リストで、どちらもパブリックドメインです。匿名化に第三者のモデルは使いません。
- スタック内のサービス:
sensecraft-asr-service、sensecraft-voice-client、sensecraft-voice-service、sensecraft-voice-webはSeeedが所有し、認識にはOpenVoiceStreamを使います。MySQLはGPLv2 + FOSS例外で取得し、MinIOの現行版はAGPLv3です。オブジェクトストレージを商用製品に組み込む前に、このライセンスを確認してください。 - 参考設計ページのアーキテクチャ図は、このリポジトリの構造化IRからレンダリングしています。