Implantar TensorRT-Model-Connect no Jetson AGX Orin
Este wiki mostra como executar o NVIDIA TensorRT-Model-Connect (TRTMC) em um Seeed reComputer com Jetson AGX Orin. Depois que o runtime nativo é construído, o caminho é curto: começar de um checkpoint do Hugging Face, produzir um TensorRT .bundle no dispositivo e executar geração de texto. Não há host x86 separado nem etapa de exportação ONNX.
O passo a passo usa Qwen3-4B-Instruct-2507 em FP16. Esse modelo é um transformer denso, então o TensorRT pode usar um mecanismo de prefill em lote. A mesma página também registra a memória de conversão no AGX Orin 64GB, além das duas cargas de trabalho em que o TRTMC é mais rápido que o llama.cpp CUDA: prefill longo no Qwen3-4B e decodificação gananciosa no Qwen3-0.6B.
TensorRT-Model-Connect é um preview público. As APIs, a cobertura de modelos e o fluxo de build ainda podem mudar. A própria orientação da NVIDIA é usar o TRTMC quando você quiser testar rapidamente modelos compatíveis e começar com o TensorRT Edge-LLM quando precisar de um runtime de LLM/VLM voltado para produção no Jetson.
O que é TensorRT-Model-Connect?
TensorRT-Model-Connect é um conjunto de implementações de referência por família de modelos em cima do NVIDIA TensorRT. Um builder específico da família lê um snapshot do Hugging Face, constrói engines TensorRT e grava um .bundle versionado. O mesmo bundle pode ser executado a partir do CLI trtmc ou de APIs nativas de tarefa em C++, como geração de texto.
A diferença prática no Jetson é o caminho de conversão. O TensorRT Edge-LLM ainda espera que você quantize e exporte ONNX em uma máquina Linux x86 com uma GPU dedicada, depois copie esses arquivos ONNX para o dispositivo para geração das engines. O TRTMC constrói o bundle de engines no próprio Jetson.
flowchart LR
  subgraph EdgeLLM["TensorRT Edge-LLM"]
    A1["Hugging Face checkpoint"] --> A2["Quantize + ONNX export on x86 GPU"]
    A2 --> A3["Copy ONNX to Jetson"]
    A3 --> A4["Build engine on Jetson"]
    A4 --> A5["llm_inference"]
  end
  subgraph TRTMC["TensorRT-Model-Connect"]
    B1["Hugging Face checkpoint"] --> B2["python -m tensorrt_model_connect build"]
    B2 --> B3[".bundle on Jetson"]
    B3 --> B4["trtmc run"]
  end
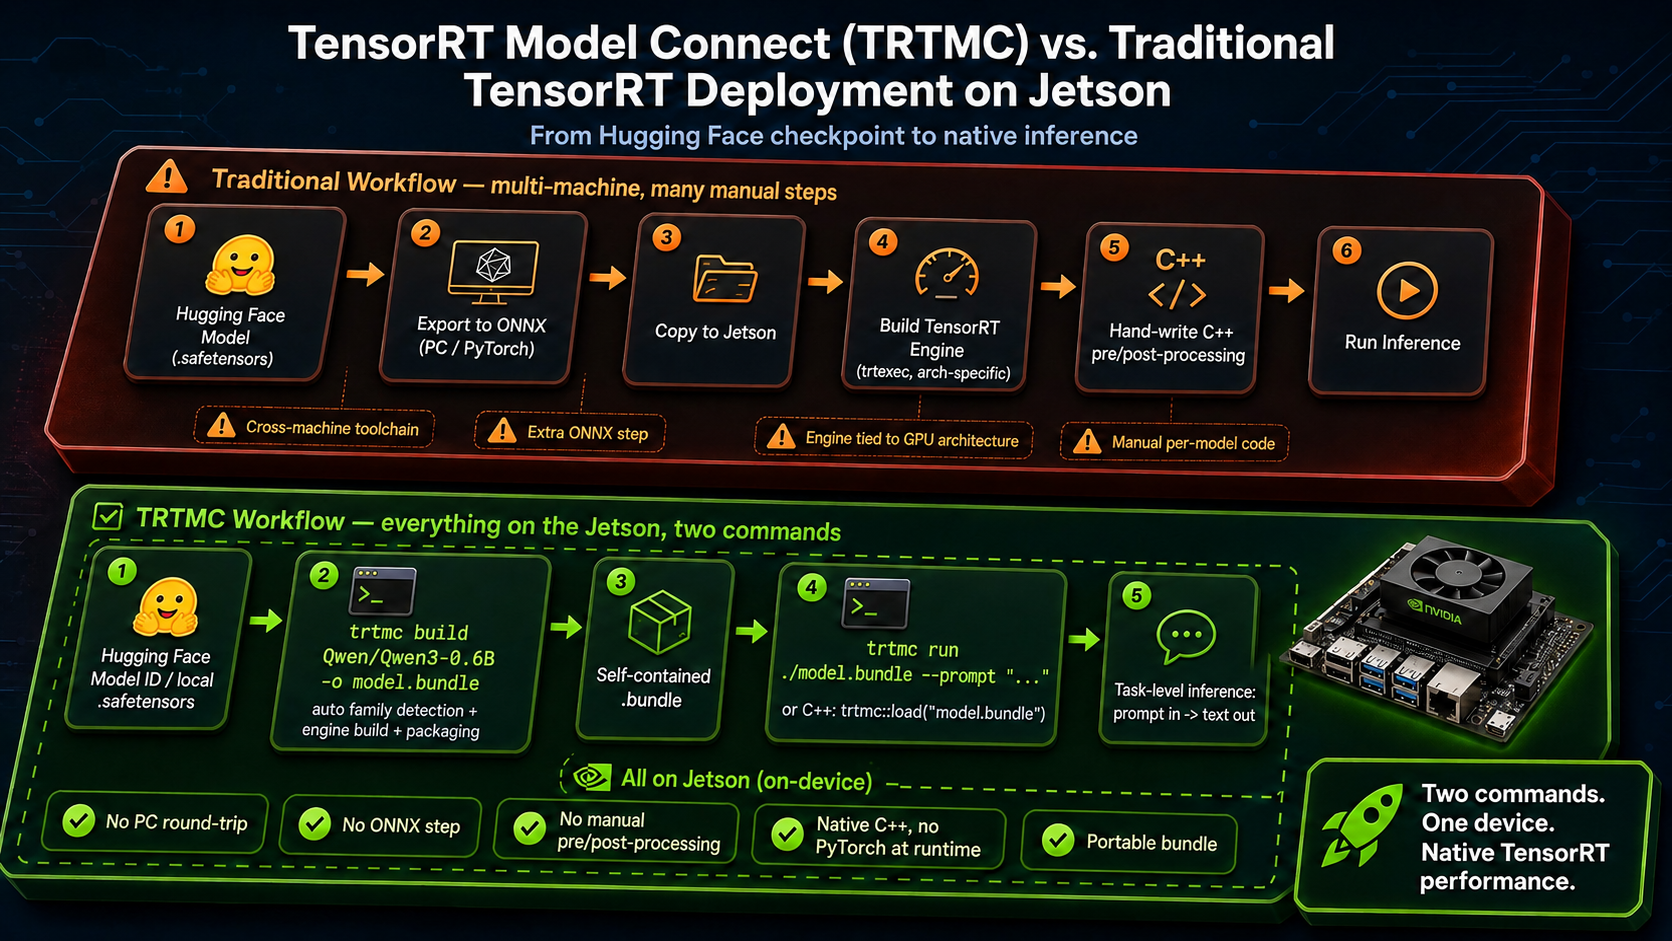
Por que esse caminho é mais fácil no Jetson
| Tópico | TensorRT Edge-LLM | TensorRT-Model-Connect |
|---|---|---|
| Onde a conversão é executada | Exportação ONNX em um host Linux x86 com uma GPU NVIDIA, depois build da engine no Jetson | Snapshot do Hugging Face para .bundle no Jetson |
| Arquivos intermediários | Grafos ONNX, muitas vezes dezenas de gigabytes, copiados para o dispositivo | Nenhum. O .bundle é o artefato |
| Comandos após a configuração | Exportar, copiar, construir a engine e então executar llm_inference | python -m tensorrt_model_connect build e trtmc run |
| Memória do host durante a conversão | Documentação do fornecedor: a exportação ONNX em FP8 pode precisar de cerca de 18–20× o tamanho do modelo em RAM de CPU na máquina x86 | Medido no AGX Orin 64GB para Qwen3-4B FP16: cerca de 30,6 GB usados no host, pico de 41 GB no contêiner |
| Melhor uso | Implantação de LLM/VLM em produção no Jetson | Testar rapidamente um modelo compatível na mesma máquina que irá executá-lo |
A linha de memória não é uma comparação de mesmo modelo. Os números publicados de exportação ONNX do Edge-LLM explicam por que esse pipeline geralmente sai do Jetson e ocupa uma workstation com muita RAM. Os números do TRTMC abaixo são o que realmente observamos ao construir o Qwen3-4B FP16 no AGX Orin 64GB.
Hardware
Este tutorial foi reproduzido no reComputer Classic J5012 com Jetson AGX Orin 64GB. A conversão do Qwen3-4B FP16 atingiu pico em torno de 41 GB dentro do contêiner, então 64 GB de memória unificada é o alvo prático. O J5011 (32GB) é da mesma família de produtos, mas essa conversão provavelmente vai causar thrash ou falhar lá.


Pré-requisitos
Prepare o seguinte no Jetson:
- reComputer Classic J5012 ou outro sistema Jetson AGX Orin 64GB
- JetPack 7.2 / Ubuntu 24.04 / L4T R39.2
- Docker com o runtime NVIDIA (
docker infodeve listarnvidiaem Runtimes) - Cerca de 40 GB de espaço livre em disco para a imagem de desenvolvimento, snapshot do Hugging Face e
.bundle - Acesso de rede ao GitHub, Hugging Face e
nvcr.io - Opcional para a seção de benchmark:
nvpmodelMAXN ejetson_clocks
A pilha de software verificada foi:
| Item | Versão |
|---|---|
| Dispositivo | Jetson AGX Orin 64GB |
| SO | Ubuntu 24.04.4 LTS, kernel 6.8.12-tegra |
| L4T | R39.2 |
| CUDA na imagem TRTMC | 13.3.1 |
| TensorRT na imagem TRTMC | 11.1.0.106 (TensorRT 26.07) |
| SM da GPU | 87 (Orin) |
| Modo de energia | MAXN, GPU 1300 MHz |
Se docker ps retornar permission denied, adicione seu usuário ao grupo docker e faça login novamente:
sudo usermod -aG docker $USER
1. Clonar o TensorRT-Model-Connect
git clone https://github.com/NVIDIA/TensorRT-Model-Connect.git
cd TensorRT-Model-Connect
O caminho oficial de primeiros passos é Build from Source mais Quick Start. Os comandos abaixo seguem esse caminho, com flags específicas para Jetson preenchidas.
2. Construir o contêiner de desenvolvimento
No AGX Orin a capacidade de computação é 8.7, então TRTMC_SM=87. Imagens Docker para Jetson também precisam de --runtime nvidia.
GPU=0
SM="$(
  nvidia-smi -i "$GPU" \
    --query-gpu=compute_cap \
    --format=csv,noheader,nounits |
  tr -d '.[:space:]'
)"
IMAGE="trtmc-quickstart"

docker build \
  -f Dockerfile.dev.aarch64 \
  -t "$IMAGE" \
  requirements

SOURCE_DIR="$(git rev-parse --show-toplevel)"

docker run --rm -it \
  --runtime nvidia \
  --gpus "device=${GPU}" \
  --ipc=host \
  --network host \
  --mount "type=bind,source=${SOURCE_DIR},target=/src" \
  --workdir /src \
  --env TRTMC_SM="$SM" \
  "$IMAGE" \
  bash
Mantenha os comandos restantes dentro deste contêiner. A imagem já fixa o TensorRT 11.1, um venv Python 3.12 e os headers nativos usados pelo build da família Qwen. Se nvidia-smi estiver ausente no seu Jetson, defina SM=87 manualmente.
Se o snapshot do Hugging Face e o bundle forem ficar em um SSD externo, faça também o bind-mount desse disco, por exemplo -v /path/to/data:/out.
3. Construir o runtime nativo
Execute estes comandos no contêiner:
python -m pip install --no-deps -e . -C py-only=true

TRTMC_BUILD_DIR="build-sm${TRTMC_SM}"

cmake -S . -B "$TRTMC_BUILD_DIR" -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_CUDA_ARCHITECTURES="${TRTMC_SM}-real" \
  -DTRTMC_BUILD_BACKEND_RTX=OFF \
  -DTRTMC_BUILD_TESTS=OFF \
  -DTRTMC_BUILD_EXAMPLES=OFF

cmake --build "$TRTMC_BUILD_DIR" --parallel "$(nproc)" --target \
  trtmc \
  trtmc_backend_trt \
  trtmc_model_qwen

export PATH="$PWD/$TRTMC_BUILD_DIR:$PATH"
trtmc procura bibliotecas nativas em --runtime-root. Aponte esse argumento para o diretório de build do CMake, que deve conter libtrtmc_core.so, libtrtmc_runtime.so, libtrtmc_backend_trt.so e libtrtmc_model_qwen.so.
4. Gerar o bundle Qwen3-4B no Jetson
Esta é a etapa de conversão que antes exigia uma máquina x86 com GPU. Fixe --max-sequence-length. A configuração do Hugging Face para este checkpoint anuncia um contexto de 262.144 tokens, e deixar esse padrão ativo irá esgotar a memória durante a geração dos engines.
python -m tensorrt_model_connect build Qwen/Qwen3-4B-Instruct-2507 \
  --precision fp16 \
  --backend trt \
  --max-sequence-length 2048 \
  --max-batch-size 1 \
  --tensor-parallel-size 1 \
  --output qwen3-4b-instruct-2507.bundle \
  --verbose
Um diretório de snapshot local pode substituir o ID do modelo. O builder faz o download do checkpoint, permite que a família Qwen o reivindique e grava um .bundle que já contém os engines TensorRT.
Na unidade J5012 verificada, Qwen3-4B FP16 com max_sequence_length=2048 produziu a seguinte pegada de conversão. O caminho público de dispositivo único FP16 do Qwen grava engines divididos (engine.plan + prefill.plan); os números abaixo foram obtidos de um build com perfil duplo, em que prefill e decode compartilham um único plan com dois perfis de otimização.
| Métrica | Valor medido |
|---|---|
| Precisão / layout | FP16, perfil duplo |
| Comprimento máximo de sequência | 2048 |
| Geração do engine | 128,1 s |
| Pesos TensorRT | 7,49 GiB |
| Memória de ativação do prefill | 633 MiB |
| Memória de ativação do decode | 12 MiB |
| Pico do alocador TensorRT na GPU | 7.674 MiB |
| Uso de host, pico | 30.640 MB |
| Memória do contêiner, pico | 41,09 GiB |
| RSS do Python, pico | 24,7 GB |
.bundle final | 7,6 GiB |
Esses picos de host/contêiner são o motivo pelo qual este wiki recomenda AGX Orin 64GB. Você está convertendo no dispositivo de borda, mas ainda precisa de memória unificada suficiente para o TensorRT construir os engines.
Inspecione o bundle antes de executá-lo:
trtmc inspect ./qwen3-4b-instruct-2507.bundle
trtmc inspect imprime JSON. Procure por family: qwen, task: text_generation e uma lista de seções que inclua engine.plan mais arquivos de tokenizer. Um build FP16 dividido também lista prefill.plan. Ainda não há nenhum grafo ONNX no bundle.
5. Executar inferência
trtmc run ./qwen3-4b-instruct-2507.bundle \
  --runtime-root "$PWD/build-sm${TRTMC_SM}" \
  --prompt "What is the capital of France? Answer in one word." \
  --use-chat-template true \
  --enable-thinking false \
  --max-new-tokens 32
Uma execução bem-sucedida imprime uma conclusão curta como Paris. O mesmo bundle pode ser carregado a partir de C++ com trtmc::load_task(bundle, runtime_root) e a interface ITextGeneration; consulte a C++ Task API.
Desempenho de inferência vs llama.cpp
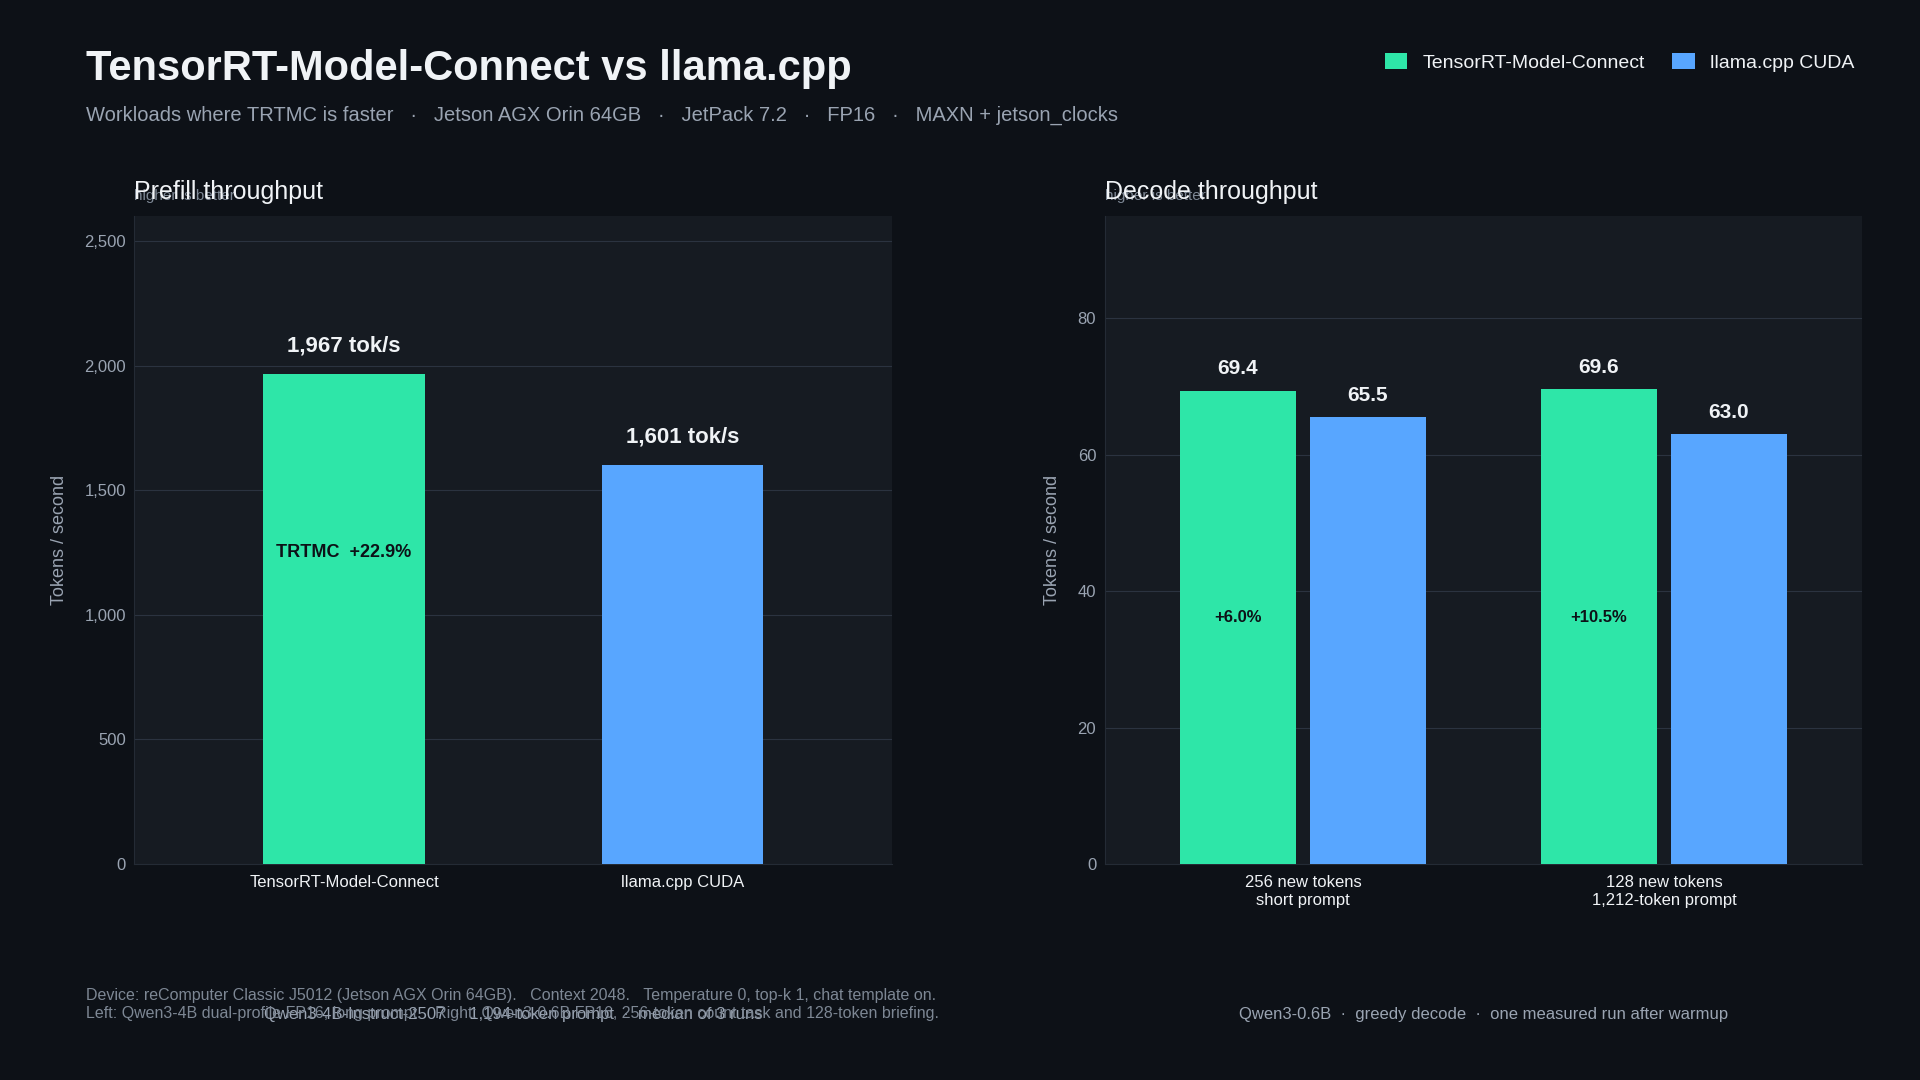
A conveniência da conversão é apenas metade da história. No mesmo J5012 comparamos TRTMC FP16 com llama.cpp CUDA + flash-attention FP16, ambos com contexto 2048. O gráfico e a tabela abaixo mantêm apenas as cargas de trabalho em que o TRTMC é mais rápido.
| Carga de trabalho | TensorRT-Model-Connect | llama.cpp CUDA | Vantagem do TRTMC |
|---|---|---|---|
| Qwen3-4B-Instruct-2507 prefill longo | 1.967 tok/s · 606,9 ms / 1.194 tok | 1.601 tok/s · 743,2 ms / 1.190 tok | +22,9% |
| Qwen3-0.6B decode, 256 novos tokens | 69,4 tok/s | 65,5 tok/s | +6,0% |
| Qwen3-0.6B decode após um prompt de 1.212 tokens | 69,6 tok/s | 63,0 tok/s | +10,5% |
O resultado de prefill 4B é a mediana de três execuções medidas após um aquecimento. Os resultados de decode 0.6B são de uma execução medida após aquecimento, com o modelo mantido carregado durante toda a requisição para que o cache KV seja preenchido uma vez e então muitos tokens sejam gerados.
Use um transformer Qwen3 denso para esta comparação. Modelos híbridos Mamba como o NVIDIA Nano-9B atualmente fazem prefill token a token no TRTMC, portanto são uma forma ruim de avaliar o throughput do TensorRT.
Reproduzir as cargas de trabalho mais rápidas
Trave os clocks primeiro e depois mantenha o modelo carregado durante toda a requisição. Relate as linhas de temporização do engine, não o tempo de parede do processo. O tempo de parede do processo inclui desserialização do TensorRT / carregamento GGUF e irá ocultar a diferença.
sudo nvpmodel -m 0   # MAXN; confirm with nvpmodel -q
sudo jetson_clocks
llama.cpp nesta placa foi compilado com CUDA e flash-attention, depois executado com todas as camadas na GPU:
cmake -S llama.cpp -B llama.cpp/build-cuda \
  -DGGML_CUDA=ON -DGGML_CUDA_FA=ON -DGGML_NATIVE=ON \
  -DCMAKE_BUILD_TYPE=Release -DCMAKE_CUDA_ARCHITECTURES=87-real
cmake --build llama.cpp/build-cuda -j
1. Qwen3-4B prefill longo
Esta é a carga de trabalho em que um engine de prefill em lote do TensorRT ajuda. Gere o bundle FP16 da seção 4 com --max-sequence-length 2048, converta o mesmo snapshot para GGUF F16 e então alimente ambos os runtimes com o mesmo prompt longo.
Configuração compartilhada para esta linha:
- Modelo:
Qwen/Qwen3-4B-Instruct-2507, FP16, contexto 2048 - Prompt: cerca de 6.000 caracteres de contexto mais uma pergunta sobre Paris com 70 palavras (1.190–1.194 tokens após o template de chat)
- Decode: 64 novos tokens, ganancioso (
temperature=0,top-k=1) - TRTMC: bundle com perfil duplo, template de chat ligado, thinking desligado
- llama.cpp:
GGML_CUDA=ON,GGML_CUDA_FA=ON,-ngl 99 -c 2048 -b 512 -ub 512 -fa on --jinja - Aquecimento 1 + 3 medidos; use a mediana
Converta o mesmo snapshot do Hugging Face para GGUF F16 para o llama.cpp:
python3 convert_hf_to_gguf.py Qwen3-4B-Instruct-2507 \
  --outfile Qwen3-4B-Instruct-2507-F16.gguf \
  --outtype f16
Escreva o prompt longo e então execute o TRTMC. Leia [trtmc-perf] Prefill (ou a temporização do engine qwen prefill).
python3 - <<'PY'
from pathlib import Path
filler = (
    "Transit planners track on-time performance, bus bunching, depot energy use, "
    "and spare-ratio policy across a dense coastal city. Housing staff compare "
    "permit latency, vacancy, and school-capacity constraints. Emergency managers "
    "rehearse flood gates, hospital diversion, and radio fallback. "
)
question = (
    "Write a 70-word factual paragraph about Paris. Include the Seine, the Louvre, "
    "and why it became the capital of France. Do not use bullet points. "
    "Do not stop after one word."
)
body = "Use the background notes only as context. Ignore them if they are not needed.\n\n"
while len(body) < 6000:
    body += filler
Path("qwen3-4b-long-prompt.txt").write_text(body[:6000] + "\n\n" + question)
print("wrote qwen3-4b-long-prompt.txt", 6000 + 2 + len(question), "chars")
PY

PROMPT="$(cat qwen3-4b-long-prompt.txt)"

trtmc run ./qwen3-4b-instruct-2507.bundle \
  --runtime-root "$PWD/build-sm${TRTMC_SM}" \
  --prompt "$PROMPT" \
  --use-chat-template true \
  --enable-thinking false \
  --temperature 0 \
  --top-k 1 \
  --max-new-tokens 64
Mesmo prompt no llama.cpp. Leia a linha prompt eval time / Prompt: tok/s, não o tempo de vida do processo.
llama-completion \
  -m Qwen3-4B-Instruct-2507-F16.gguf \
  -ngl 99 -c 2048 -b 512 -ub 512 -fa on \
  --jinja --temp 0 --top-k 1 -n 64 \
  --no-warmup --simple-io --no-display-prompt \
  --prompt "$PROMPT"
Na unidade J5012 verificada isso é 1.967 tok/s vs 1.601 tok/s de prefill.
2. Qwen3-0.6B decode ganancioso
Decode é o segundo ponto em que o TRTMC lidera, assim que você pede uma conclusão longa em uma única requisição. Gere um bundle 0.6B FP16 da mesma forma que o Qwen3-4B, ainda fixando --max-sequence-length 2048. O bundle medido usou um engine dividido de prefill/decode com linhas de cache KV=2048.
python -m tensorrt_model_connect build Qwen/Qwen3-0.6B \
  --precision fp16 \
  --backend trt \
  --max-sequence-length 2048 \
  --max-batch-size 1 \
  --tensor-parallel-size 1 \
  --output qwen3-0.6b.bundle \
  --verbose
Converta o mesmo snapshot para GGUF F16 para o llama.cpp e então execute dois casos de decode. O llama-cli desta placa precisa de -st (single-turn) e não aceita --prompt-file; passe --prompt em vez disso.
python3 convert_hf_to_gguf.py Qwen3-0.6B \
  --outfile Qwen3-0.6B-F16.gguf \
  --outtype f16
Prompt curto, 256 novos tokens:
COUNT_PROMPT='Count from 1 to 220. Write only integers separated by spaces. Do not add commentary. Continue until 220.'

trtmc run ./qwen3-0.6b.bundle \
  --runtime-root "$PWD/build-sm${TRTMC_SM}" \
  --prompt "$COUNT_PROMPT" \
  --use-chat-template true \
  --enable-thinking false \
  --temperature 0 \
  --top-k 1 \
  --max-new-tokens 256

llama-cli -st --simple-io \
  -m Qwen3-0.6B-F16.gguf \
  -ngl 99 -c 2048 \
  --temp 0 --top-k 1 -n 256 \
  --prompt "$COUNT_PROMPT"
Prompt longo, 128 novos tokens. O prompt medido tinha 1.212 tokens após o template de chat: notas sobre alcançar órbita e depois um pedido de um briefing de 180 palavras.
python3 - <<'PY'
from pathlib import Path
note = (
    "Low Earth orbit is a crowded working neighborhood for satellites, space stations, "
    "and visiting spacecraft. Reaching it requires a launcher that can fight gravity, "
    "thinning air, and the need for horizontal speed of about 7.8 kilometers per second. "
    "A typical rocket uses staged chemical propulsion. The first stage produces high "
    "thrust to clear the dense atmosphere. Upper stages ignite in thinner air to add "
    "delta-v. Guidance computers fly a gravity turn, then a circularization burn. "
)
text = "Read the notes below. Then write a detailed 180-word briefing on how rockets reach orbit. Keep writing until the briefing is complete.\n\n"
while text.count(" ") < 900:
    text += note
Path("qwen3-06b-long-prompt.txt").write_text(text)
print("wrote", len(text), "chars")
PY

LONG_PROMPT="$(cat qwen3-06b-long-prompt.txt)"

trtmc run ./qwen3-0.6b.bundle \
  --runtime-root "$PWD/build-sm${TRTMC_SM}" \
  --prompt "$LONG_PROMPT" \
  --use-chat-template true \
  --enable-thinking false \
  --temperature 0 \
  --top-k 1 \
  --max-new-tokens 128

llama-cli -st --simple-io \
  -m Qwen3-0.6B-F16.gguf \
  -ngl 99 -c 2048 \
  --temp 0 --top-k 1 -n 128 \
  --prompt "$LONG_PROMPT"
Leia TRTMC qwen decoder / [trtmc-perf] Decode, e llama.cpp eval time / Generation: tok/s. No J5012 verificado isso é 69,4 vs 65,5 tok/s para 256 novos tokens, e 69,6 vs 63,0 tok/s após o prompt de 1.212 tokens.
O que os números significam
- Menos máquinas. Você não precisa de uma workstation x86 com GPU apenas para exportar ONNX. O Jetson que irá servir o modelo também pode construí-lo.
- Menos RAM de conversão no host do que o caminho Edge-LLM FP8 ONNX. A documentação do Edge-LLM indica RAM de CPU de até cerca de 20× o tamanho do modelo para exportação FP8 ONNX. A compilação Qwen3-4B FP16 TRTMC ficou em torno de 31 GB usados no host / 41 GB no contêiner no Orin 64GB.
- Prefill longo mais rápido no Qwen3-4B do que no llama.cpp FP16, que é a carga de trabalho em que um engine TensorRT em lote ajuda.
- Decode ganancioso mais rápido no Qwen3-0.6B quando toda a conclusão é executada em uma única requisição (256 novos tokens, ou 128 novos tokens após um prompt longo).
- Um artefato reutilizável. O
.bundleé o que você copia, inspeciona e executa. Não há uma árvore ONNX paralela para manter em sincronia.
Solução de problemas
| Problema | O que verificar |
|---|---|
| O contêiner não consegue ver a GPU | Use --runtime nvidia e confirme que docker info lista o runtime nvidia |
| A compilação do engine fica sem memória | Fixe --max-sequence-length 2048, use AGX Orin 64GB e feche outros usuários da GPU |
trtmc run não consegue carregar bibliotecas | Passe --runtime-root para o diretório de build do CMake; a CLI não procura DSOs em PATH nem no diretório atual |
| Falha no download do Hugging Face | Coloque um snapshot local em disco e passe esse diretório para build em vez do ID do modelo |
| O decode parece bom, mas o prefill é lento | Confirme que você está em um transformer denso com um engine de prefill em lote / dual-profile, não em um grafo híbrido Mamba |
| TRTMC parece mais lento que llama.cpp | Compare o tempo do engine ([trtmc-perf], qwen decoder, llama.cpp eval time), não o tempo de parede do processo. Mantenha o modelo carregado e gere muitos tokens em uma única requisição |
llama-cli apresenta erros em --prompt-file ou espera por stdin | Use -st --simple-io --prompt "..." |
nvidia-smi está ausente no Jetson | Defina SM=87 para AGX Orin |
Recursos
- Repositório TensorRT-Model-Connect
- Documentação do TensorRT-Model-Connect
- Implantar TensorRT Edge-LLM no JetPack 6.2
- Introdução ao reComputer Classic J501
- Qwen3-4B-Instruct-2507
- Qwen3-0.6B
Suporte técnico e discussão sobre o produto
Obrigado por escolher nossos produtos! Estamos aqui para oferecer diferentes tipos de suporte para garantir que sua experiência com nossos produtos seja a mais tranquila possível. Oferecemos vários canais de comunicação para atender a diferentes preferências e necessidades.