Criar um Movimento Personalizado do Microduck
Este capítulo apresenta o fluxo de trabalho do projeto para construir um novo movimento. O exemplo usa um comportamento baseado em fases de reverência (Bow), mas o mesmo processo se aplica a acenar com a cabeça, agachar, alongar, habilidades de recuperação e outros movimentos do robô.
Entender o Contrato da Policy
Todas as policies hot-swappable do Microduck compartilham a mesma interface:
- Observação do ator de 61 dimensões: 48 valores de propriocepção mais o bloco de comando de 13 dimensões
[twist(3), head_pose(4), body_pose(6)]. - Saída de ação de 14 dimensões para as juntas de servo ativas.
- Slots de comando não utilizados continuam presentes e são preenchidos com zeros.
- As juntas passivas de roda e folga usam a convenção de nomenclatura
passive_*e não devem ser selecionadas como juntas atuadas. - Os IDs das juntas devem ser resolvidos pelos helpers do projeto em vez de codificados diretamente.
- A exportação ONNX deve passar por
scripts/export.pypara que o normalizador de observação seja incluído.
Quebrar esse contrato pode produzir uma policy que funciona em um viewer, mas não pode ser trocada ou implantada corretamente.
Selecionar o Template Mais Próximo
| Movimento desejado | Template recomendado |
|---|---|
| Movimento de velocidade contínua | microduck_velocity_env_cfg.py |
| Recuperação a partir de um estado específico | microduck_standup_env_cfg.py |
| Transição de comando de dois estados | microduck_sitstand_env_cfg.py |
| Movimento lento baseado em fases | microduck_ground_pick_env_cfg.py |
| Manobra dinâmica rápida | microduck_roulade_env_cfg.py |
| Movimento com rolos | microduck_velocity_rollers_env_cfg.py |
Para uma reverência, a tarefa de ground-pick é um ponto de partida útil porque já implementa comandos de fase, descida, manutenção, subida, rastreamento de pose e recuperação.
Copiar o Template
cd ~/microduck-jetson/microduck_rl

cp src/mjlab_microduck/tasks/microduck_ground_pick_env_cfg.py \
  src/mjlab_microduck/tasks/microduck_bow_env_cfg.py
Faça backup do registro de tarefas e das funções MDP compartilhadas antes de editar:
cp src/mjlab_microduck/tasks/__init__.py \
  src/mjlab_microduck/tasks/__init__.py.bak

cp src/mjlab_microduck/tasks/mdp.py \
  src/mjlab_microduck/tasks/mdp.py.bak
Projetar a Linha do Tempo do Movimento
Uma reverência simples pode usar uma fase normalizada de 0.0 a 1.0:
| Fase | Comportamento |
|---|---|
0.00–0.25 | Descer em direção à pose de reverência |
0.25–0.55 | Manter a reverência |
0.55–0.85 | Retornar à pose inicial |
0.85–1.00 | Estabilizar em pé |
Use interpolação suave em vez de alternar diretamente entre duas poses. Mudanças bruscas de alvo frequentemente causam altas taxas de ação, impactos ou gradientes de recompensa instáveis.
Definir uma Pose Alvo
Crie um mapeamento de nomes de juntas em microduck_bow_env_cfg.py. Comece com ângulos conservadores e inspecione-os com o Viewer antes do treinamento.
BOW_POSE = {
    "left_hip_pitch": -0.20,
    "left_knee": 0.30,
    "left_ankle": -0.10,
    "neck_pitch": 0.35,
    "head_pitch": 0.20,
    "right_hip_pitch": -0.20,
    "right_knee": 0.30,
    "right_ankle": -0.10,
}
Os valores acima são apenas um ponto de partida. Confirme os nomes e sinais reais das juntas na configuração do robô.
Construir a Recompensa
Uma recompensa útil para movimento personalizado geralmente combina:
- Rastreamento de pose alvo condicionado à fase.
- Uma recompensa de resultado da tarefa, como abaixar a cabeça durante a reverência.
- Recompensas de ficar em pé e de recuperação perto do final da sequência.
- Termos de contato dos pés e estabilidade lateral.
- Penalidades de limite de junta, colisão, taxa de ação e impacto.
Reutilize as recompensas do template e as funções compartilhadas em src/mjlab_microduck/tasks/mdp.py sempre que possível. Adicione uma nova função apenas quando a medição desejada ainda não existir.
Verifique a convenção de sinal antes de atribuir um peso. Uma função que já retorna uma penalidade negativa normalmente usa um peso positivo apenas quando isso corresponde à convenção do projeto. Inspecione as configurações de tarefas próximas e confirme a métrica ponderada no TensorBoard.
Registrar a Nova Tarefa
Importe a nova configuração em src/mjlab_microduck/tasks/__init__.py e registre um novo ID seguindo as entradas existentes:
register_mjlab_task(
    task_id="Mjlab-Bow-Flat-MicroDuck",
    env_cfg=microduck_bow_env_cfg,
    play_env_cfg=microduck_bow_play_env_cfg,
    rl_cfg=microduck_bow_rl_cfg,
)
Use exatamente os nomes chamáveis implementados no seu novo módulo e espelhe a assinatura atual do registro.
Confirme o registro:
uv run --no-sync list-envs | grep Mjlab-Bow
Inspecionar Antes do Treinamento
Inicie uma policy aleatória para verificar o modelo, estado de reset, sensores, gerenciador de comandos e configuração de termos:
export DISPLAY=:0
export MUJOCO_GL=glfw

uv run --no-sync play Mjlab-Bow-Flat-MicroDuck \
  --agent random \
  --num-envs 1 \
  --viewer native
Procure por contatos inválidos, penetração no spawn, erros de direção de junta, término imediato, valores NaN e poses alvo impossíveis.
Executar um Smoke Test
export MUJOCO_GL=egl

uv run --no-sync train Mjlab-Bow-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
Só inicie uma execução longa de treinamento depois que isso for concluído sem exceções ou NaNs.
Treinar em Etapas
Um currículo prático é:
- Descoberta do movimento: estado de spawn fácil, recompensa de pose ampla, perturbação mínima.
- Conclusão do movimento: fortalecer os termos de manutenção e recuperação; adicionar recompensas baseadas em resultado.
- Robustez: aumentar a diversidade de spawn, randomização de atrito, empurrões externos e variantes de folga.
Exemplo de execução longa:
uv run --no-sync train Mjlab-Bow-Flat-MicroDuck \
  --env.scene.num-envs 2048 \
  --agent.logger tensorboard \
  --agent.max_iterations 2000
Observe a recompensa principal da tarefa em vez de apenas a recompensa total. Uma policy pode melhorar métricas de regularização e ainda assim nunca completar o movimento pretendido.
Visualizar e Exportar
export DISPLAY=:0
export MUJOCO_GL=glfw

uv run --no-sync play Mjlab-Bow-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --num-envs 1 \
  --viewer native
Exporte o checkpoint aceito:
uv run --no-sync python3 scripts/export.py \
  Mjlab-Bow-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --onnx-file bow.onnx
Para adicionar disparo por teclado, estenda scripts/infer_policy.py usando os padrões existentes de troca de policy de sentar/levantar, ground-pick, roulade e chute. Escreva no slot de comando esperado pela nova policy e mantenha o layout de observação de 61 dimensões inalterado.
Exemplo Verificado: Equilíbrio em Uma Perna
A tarefa personalizada a seguir foi implementada e passou no smoke test no sistema de referência Jetson. O movimento transfere o peso do robô para o pé esquerdo, levanta o pé direito, mantém a pose de equilíbrio em uma perna e depois retorna à pose normal de pé com dois pés.
O ID de tarefa registrado é:
Mjlab-OneLegBalance-Flat-MicroDuck
Linha do Tempo do Movimento
A tarefa usa um comando de fase cíclica de seis segundos:
| Fase normalizada | Comportamento |
|---|---|
0.00–0.30 | Transferir o peso para o pé esquerdo e levantar a perna direita |
0.30–0.58 | Manter a pose de equilíbrio em uma perna |
0.58–0.78 | Abaixar o pé direito e retornar à posição em pé |
0.78–1.00 | Estabilizar na pose inicial com dois pés |
Esses limites são definidos em microduck_one_leg_balance_env_cfg.py:
BALANCE_PERIOD = 6.0
LIFT_END = 0.30
HOLD_END = 0.58
RETURN_END = 0.78
Definir a Pose Alvo
O alvo é expresso com nomes de juntas em vez de índices brutos de juntas do MuJoCo. Isso mantém a intenção legível e evita mudanças acidentais de índice quando o modelo do robô muda.
ONE_LEG_POSE = {
    "left_hip_roll": -0.25,
    "left_hip_pitch": -0.40,
    "left_knee": -0.05,
    "left_ankle": 0.45,
    "right_hip_roll": -0.10,
    "right_hip_pitch": 0.95,
    "right_knee": -1.25,
    "right_ankle": 0.30,
    "neck_pitch": 0.30,
    "head_pitch": 0.30,
    "head_roll": -0.10,
}
A perna esquerda permanece próxima de sua configuração em pé. O quadril e o joelho direitos dobram a perna de balanço para a frente, enquanto a pequena inclinação da cabeça ajuda a comunicar o lado de suporte pretendido.
Construir a Recompensa de Equilíbrio
O exemplo combina cinco objetivos específicos da tarefa:
| Recompensa | Finalidade |
|---|---|
one_leg_pose | Rastrear a pose de junta interpolada de em pé para equilíbrio |
support_foot_grounded | Manter o pé esquerdo de suporte em contato com o terreno |
swing_foot_airborne | Impedir que o pé direito permaneça no chão durante a fase de manutenção |
swing_foot_height | Rastrear a folga desejada do pé direito acima do terreno |
com_over_support | Mover o centro de massa horizontal sobre o pé esquerdo de suporte |
A tarefa também mantém termos de limite de junta, autocontato, velocidade angular, taxa de ação, atuador, encoder, atrito, massa, inércia e randomização do centro de massa herdados do ambiente de treinamento do Microduck.
Duas pequenas medições reutilizáveis foram adicionadas a src/mjlab_microduck/tasks/mdp.py:
phase_single_foot_airborne_reward()limita a recompensa de pé direito no ar à fase de equilíbrio ativa.phase_site_height_track()interpola a altura alvo do pé direito entre os estados em pé e levantado.
As funções existentes phase_pose_track(), phase_pose_track_l1(), single_foot_grounded_reward(), e com_over_support_foot() são reutilizadas diretamente.
Registrar a Tarefa
Mjlab-OneLegBalance-Flat-MicroDuck é o ID de tarefa usado pelo registro de tarefas do MJLab. Não é um nome de arquivo e não é passado para make_microduck_one_leg_balance_env_cfg() como argumento de função. O lançador de linha de comando usa essa string para localizar o ambiente, a configuração de execução, a configuração de RL e o runner registrados em src/mjlab_microduck/tasks/__init__.py.
O caminho de definição e registro é:
| Item | Localização | Finalidade |
|---|---|---|
| Configuração do ambiente | src/mjlab_microduck/tasks/microduck_one_leg_balance_env_cfg.py | Define a pose de uma perna, o tempo de fase, recompensas, cena e make_microduck_one_leg_balance_env_cfg() |
| Configuração de RL | src/mjlab_microduck/tasks/microduck_one_leg_balance_env_cfg.py | Define MicroduckOneLegBalanceRlCfg e os hiperparâmetros de treinamento |
| Registro da tarefa | src/mjlab_microduck/tasks/__init__.py | Vincula o ID de tarefa à configuração de ambiente e de RL |
| Ponto de entrada da CLI | uv run --no-sync train <task-id> | Procura a tarefa registrada e inicia o treinamento |
A relação é:
Mjlab-OneLegBalance-Flat-MicroDuck
        ↓ task_id lookup
register_mjlab_task(...)
        ↓
make_microduck_one_leg_balance_env_cfg()
+ MicroduckOneLegBalanceRlCfg
+ MicroduckOnPolicyRunner
Portanto, este é o comando completo usado para selecionar a tarefa personalizada:
cd ~/microduck-jetson/microduck_rl
uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
Se list-envs não mostrar a tarefa, verifique se o novo arquivo de configuração existe e se tanto a sua importação quanto a chamada de register_mjlab_task() estão presentes em src/mjlab_microduck/tasks/__init__.py. O ID de tarefa no comando deve corresponder exatamente à string task_id, incluindo maiúsculas, minúsculas e hifens.
Adicione a importação e o registro da configuração de tarefa em src/mjlab_microduck/tasks/__init__.py:
from .microduck_one_leg_balance_env_cfg import (
    make_microduck_one_leg_balance_env_cfg,
    MicroduckOneLegBalanceRlCfg,
)

register_mjlab_task(
    task_id="Mjlab-OneLegBalance-Flat-MicroDuck",
    env_cfg=make_microduck_one_leg_balance_env_cfg(),
    play_env_cfg=make_microduck_one_leg_balance_env_cfg(play=True),
    rl_cfg=MicroduckOneLegBalanceRlCfg,
    runner_cls=MicroduckOnPolicyRunner,
)
Confirme que o MJLab descobre a nova tarefa:
cd ~/microduck-jetson/microduck_rl
uv run --no-sync list-envs | grep OneLegBalance
Saída esperada:
Mjlab-OneLegBalance-Flat-MicroDuck
Editar e Capturar a Pose no MuJoCo
O exemplo inclui scripts/one_leg_pose_editor.py. Ele desativa a gravidade e fixa a base flutuante para que os alvos das juntas individuais possam ser ajustados com segurança antes do treinamento.
Execute-o diretamente a partir de um terminal na área de trabalho do Jetson:
cd ~/microduck-jetson/microduck_rl
uv run --no-sync python scripts/one_leg_pose_editor.py
Expanda o painel Control no lado direito da janela do MuJoCo e ajuste os controles deslizantes das juntas. Fechar a janela imprime no terminal o dicionário final nomeado ONE_LEG_POSE. Os botões Save XML e Save MJB do MuJoCo salvam arquivos de modelo; eles não salvam o dicionário Python de pose alvo usado por esta tarefa.
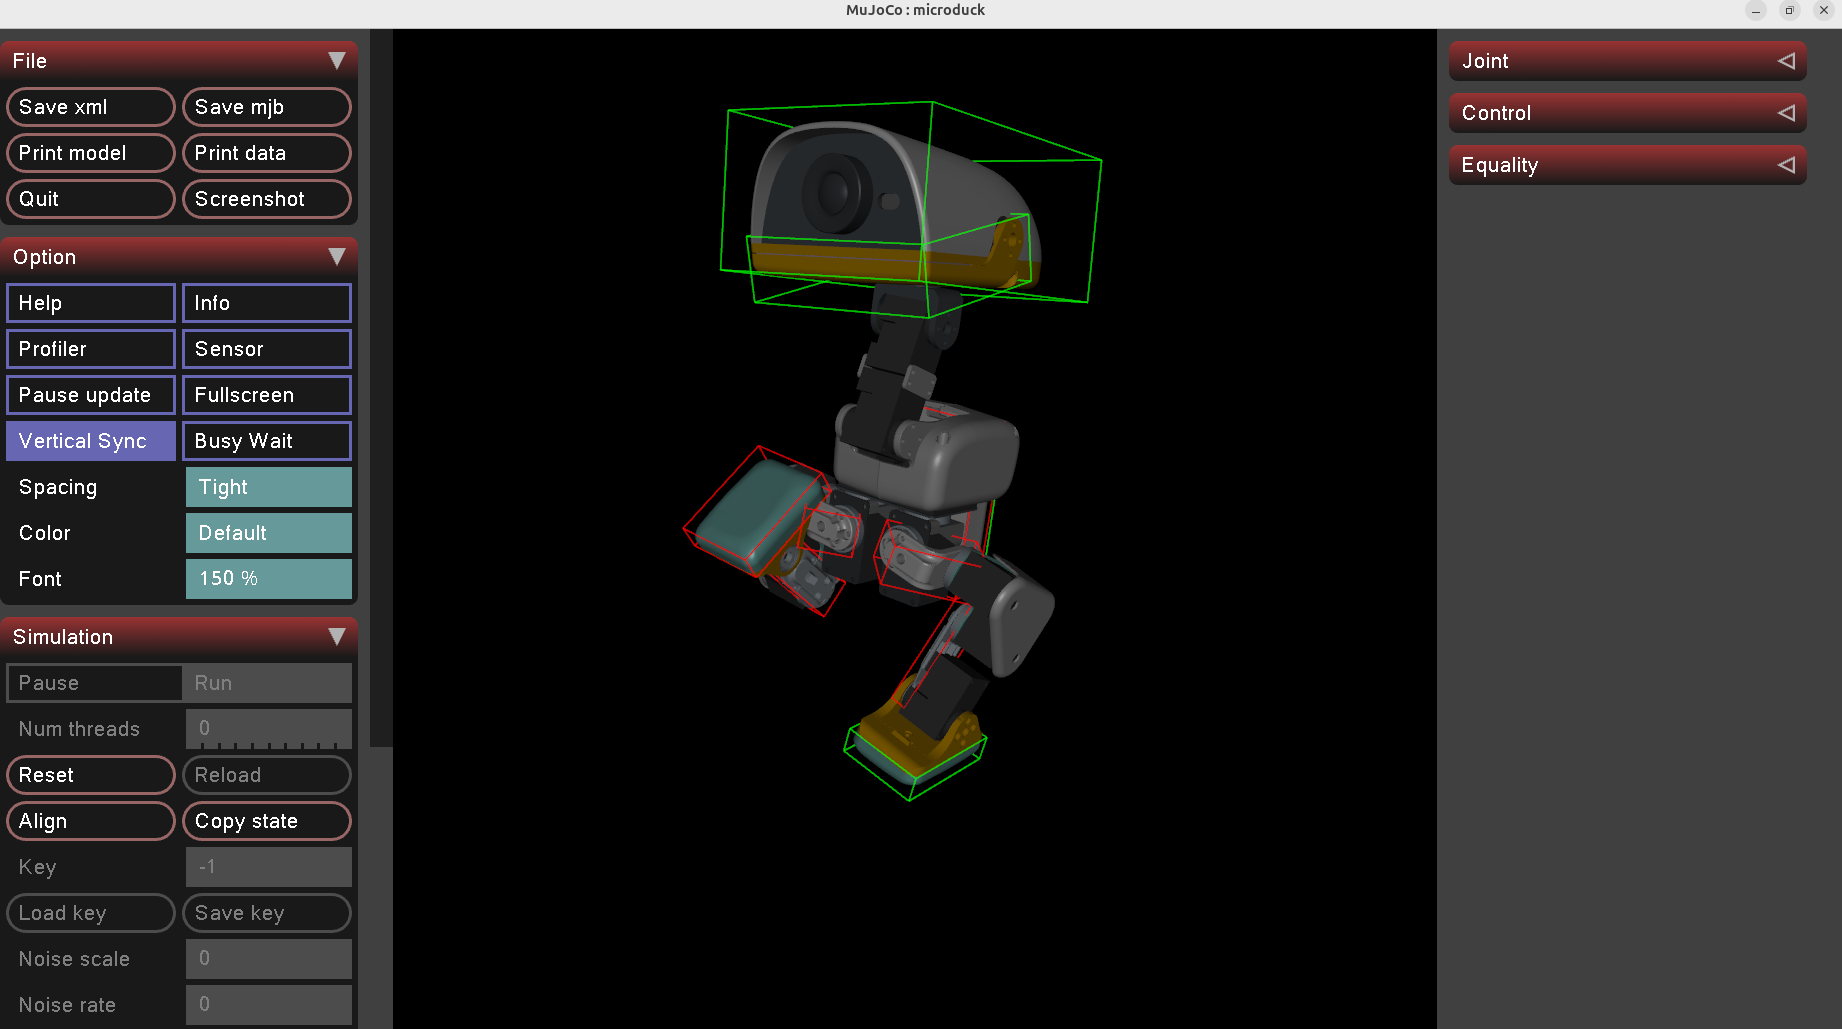
Se o editor for iniciado via SSH e deva aparecer no monitor conectado localmente ao Jetson, exporte primeiro a sessão de desktop ativa. A sessão do Jetson verificada usou DISPLAY=:1:
cd ~/microduck-jetson/microduck_rl

export DISPLAY=:1
export XAUTHORITY=/run/user/1000/gdm/Xauthority
export XDG_RUNTIME_DIR=/run/user/1000
export DBUS_SESSION_BUS_ADDRESS=unix:path=/run/user/1000/bus

~/.local/bin/uv run --no-sync python scripts/one_leg_pose_editor.py
O número de display pode mudar após reinicialização ou quando a sessão de desktop muda. A partir de um terminal aberto diretamente na área de trabalho do Jetson, echo $DISPLAY mostra o valor ativo.
Executar os Smoke Tests Verificados
Comece com 64 ambientes e cinco iterações:
cd ~/microduck-jetson/microduck_rl

export MUJOCO_GL=egl

uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
A tarefa também foi testada com 4096 ambientes paralelos em um Jetson de 16 GB:
uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 4096 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
O smoke test com 4096 ambientes foi concluído sem erro de falta de memória ou término por NaN e atingiu aproximadamente 4.6k steps/s. A observação do ator permaneceu 61-dimensional e a saída de ação permaneceu 14-dimensional.
Em um Jetson Orin NX de 8 GB ou Jetson Orin Nano, comece com --env.scene.num-envs 1024. Aumente-o somente depois de verificar a memória disponível com jtop.
Abrir o Visualizador de Treinamento
Para visualizar um ambiente enquanto a tarefa personalizada treina, execute o seguinte comando a partir da área de trabalho do Jetson:
cd ~/microduck-jetson/microduck_rl

uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 1 \
  --agent.logger tensorboard \
  --agent.max_iterations 1000 \
  --env.viewer.distance 0.55 \
  --env.viewer.azimuth 145 \
  --env.viewer.elevation -12
O editor de pose mostra o alvo pretendido imediatamente. O visualizador de treinamento inicialmente mostra uma política não treinada, portanto o comportamento estável em uma perna só aparece apenas depois que a política aprendeu a sequência de transferência, elevação, sustentação e recuperação.
Iniciar uma Execução Completa de Treinamento
Para o sistema de referência de 16 GB, use o seguinte ponto de partida:
uv run --no-sync train Mjlab-OneLegBalance-Flat-MicroDuck \
  --env.scene.num-envs 4096 \
  --agent.logger tensorboard \
  --agent.max_iterations 20000
Os smoke tests confirmam que a configuração da tarefa, termos de recompensa, sensores, backend CUDA e grande contagem de ambientes paralelos funcionam corretamente. Eles, por si só, não provam a convergência da política. Avalie checkpoints salvos no MuJoCo e ajuste a pose, pesos de recompensa, tempo de fase ou currículo se o robô levantar o pé sem transferir seu centro de massa, pular ou falhar em retornar à posição em pé.
Checklist de Desenvolvimento
- O layout de observação permanece 61D.
- A saída da política permanece 14D.
- As juntas passivas são excluídas das ações e observações de servo.
- O evento de inicialização BAM e a randomização de domínio permanecem ativos onde necessário.
- A tarefa aparece em
list-envs. - A inspeção com o Viewer de política aleatória é bem-sucedida.
- O smoke test com 64 ambientes é bem-sucedido.
- As principais métricas da tarefa melhoram no TensorBoard.
- O checkpoint PT final se comporta corretamente no MuJoCo.
- O ONNX é exportado com o script do projeto e ensaiado antes da implantação no robô.