Benchmark de Visão Industrial 4K no Jetson Orin Nano e Orin NX
Executar YOLO em uma única imagem mede apenas uma pequena parte de um sistema industrial de vídeo. Uma aplicação em produção precisa decodificar múltiplos fluxos, mover e redimensionar quadros, executar inferência, codificar gravações e entregar pré-visualizações utilizáveis enquanto compartilha memória e energia.
Este projeto instrumenta essa carga de trabalho completa em Jetson Orin Nano 8GB e Jetson Orin NX 16GB. Quatro clipes industriais H.264 4K nativos alimentam um detector YOLOv8n FP16 em TensorRT, um ramo de gravação H.264 e um painel de controle no navegador. As medições mostram onde a codificação na CPU, o agendamento de quadros e o resfriamento afetam o resultado.
O Orin Nano não possui hardware NVENC. Seu ramo de gravação usa emulação x264 na CPU, produzindo quadros H.264 reais como substituto da funcionalidade NVENC. Os dados de desempenho são medidos a partir do trabalho concluído. O Orin NX usa seu codificador NVENC em hardware.
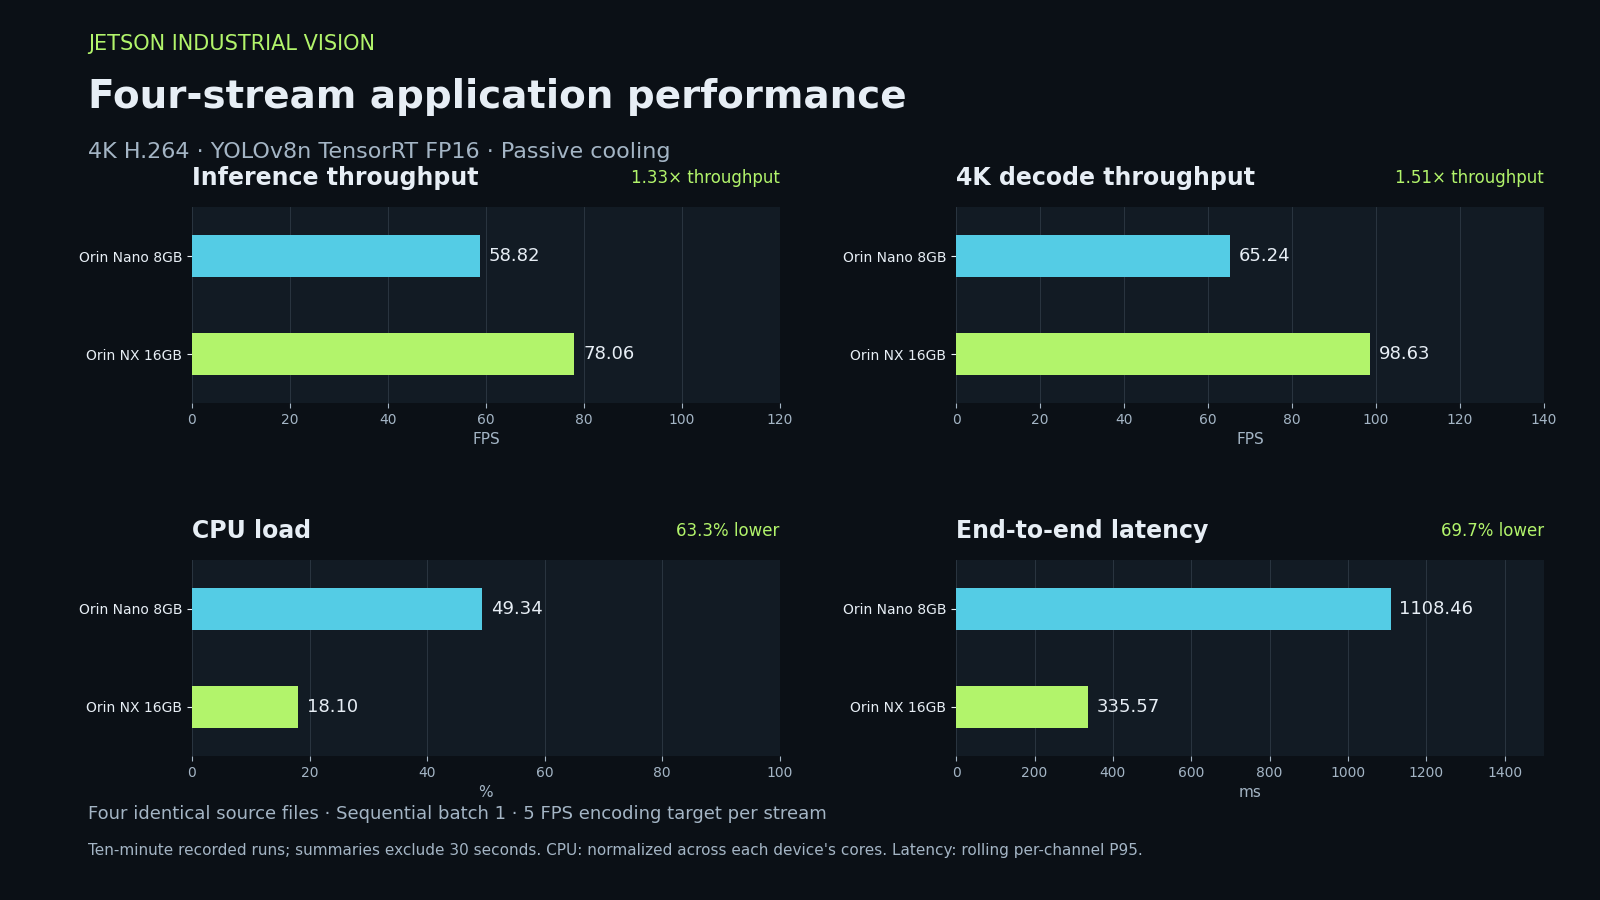
Com os mesmos quatro arquivos de origem, inferência sequencial e alvo de gravação, o Orin NX entrega 1,33× a taxa de inferência, 63,3% menor carga de CPU normalizada e 69,7% menor latência ponta a ponta nessas execuções de aplicação gravadas.
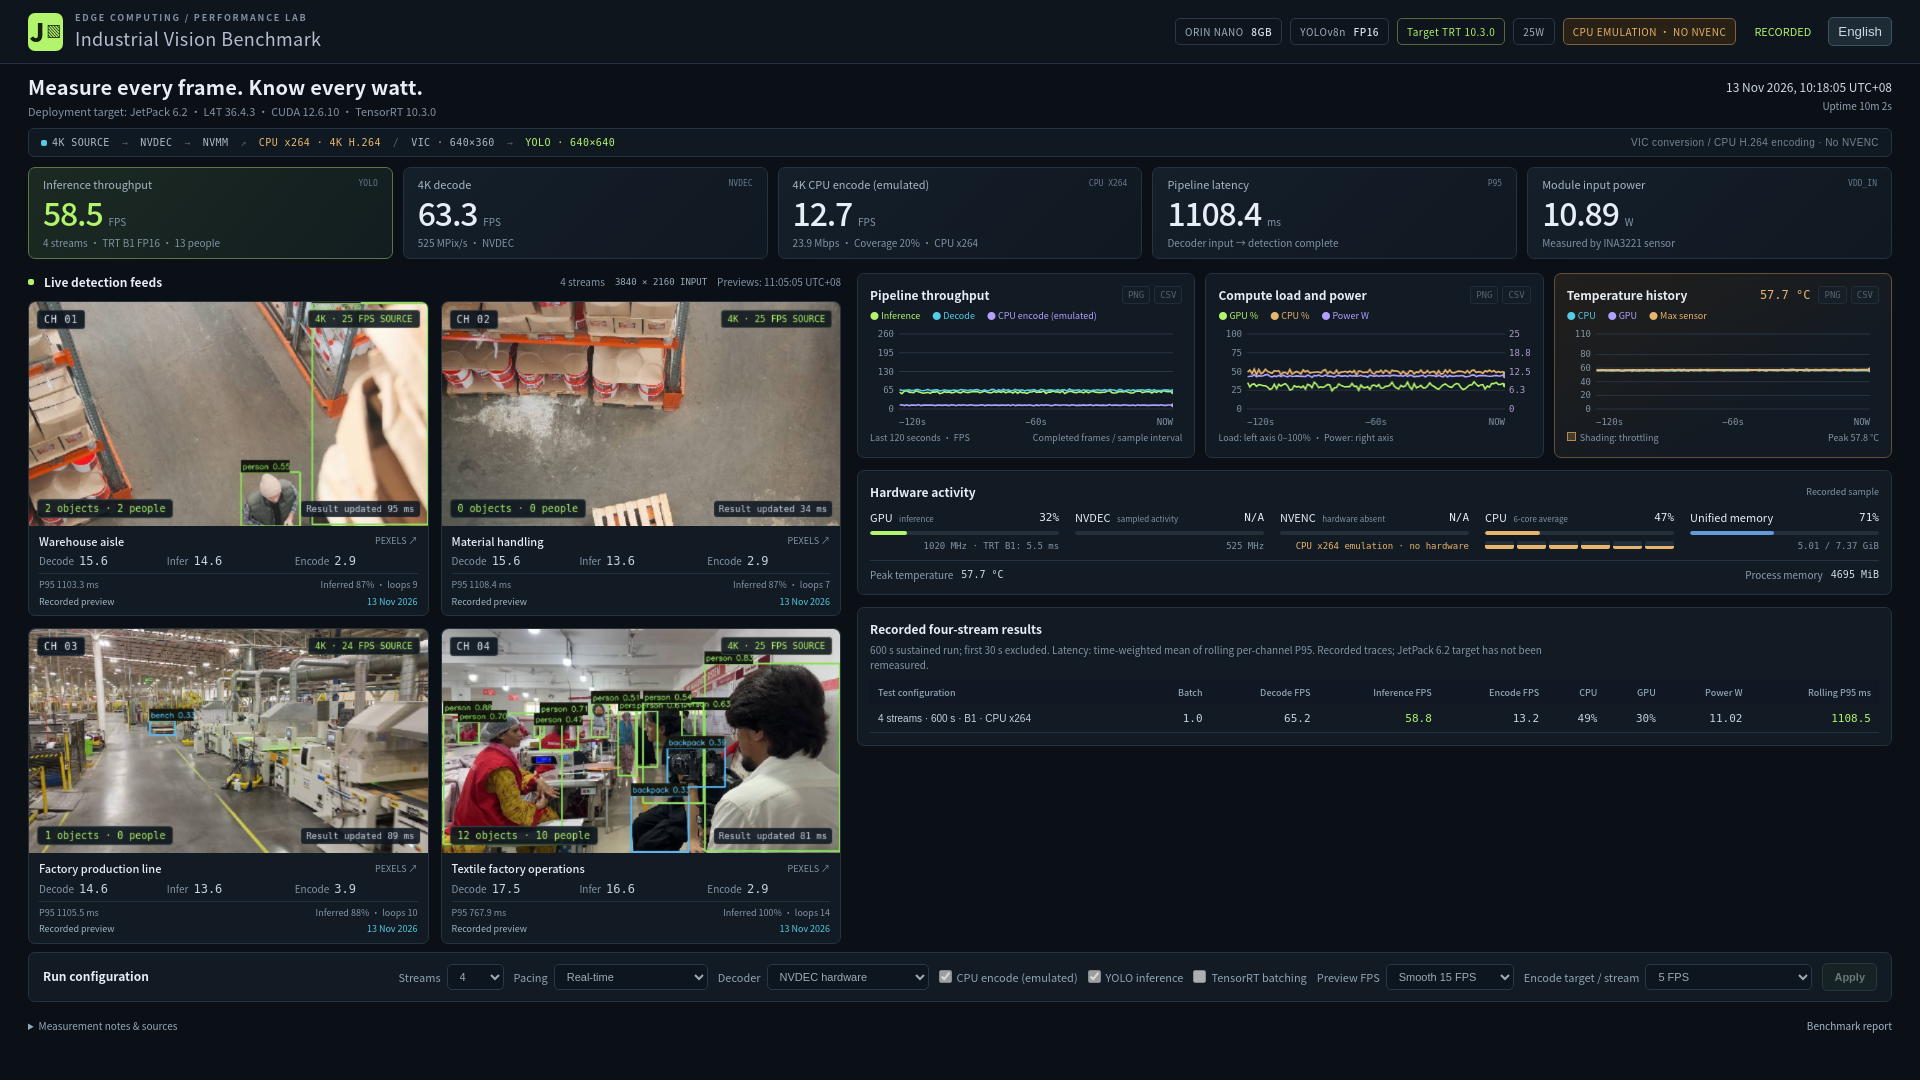
Jetson Orin Nano 8GB — emulação x264 na CPU
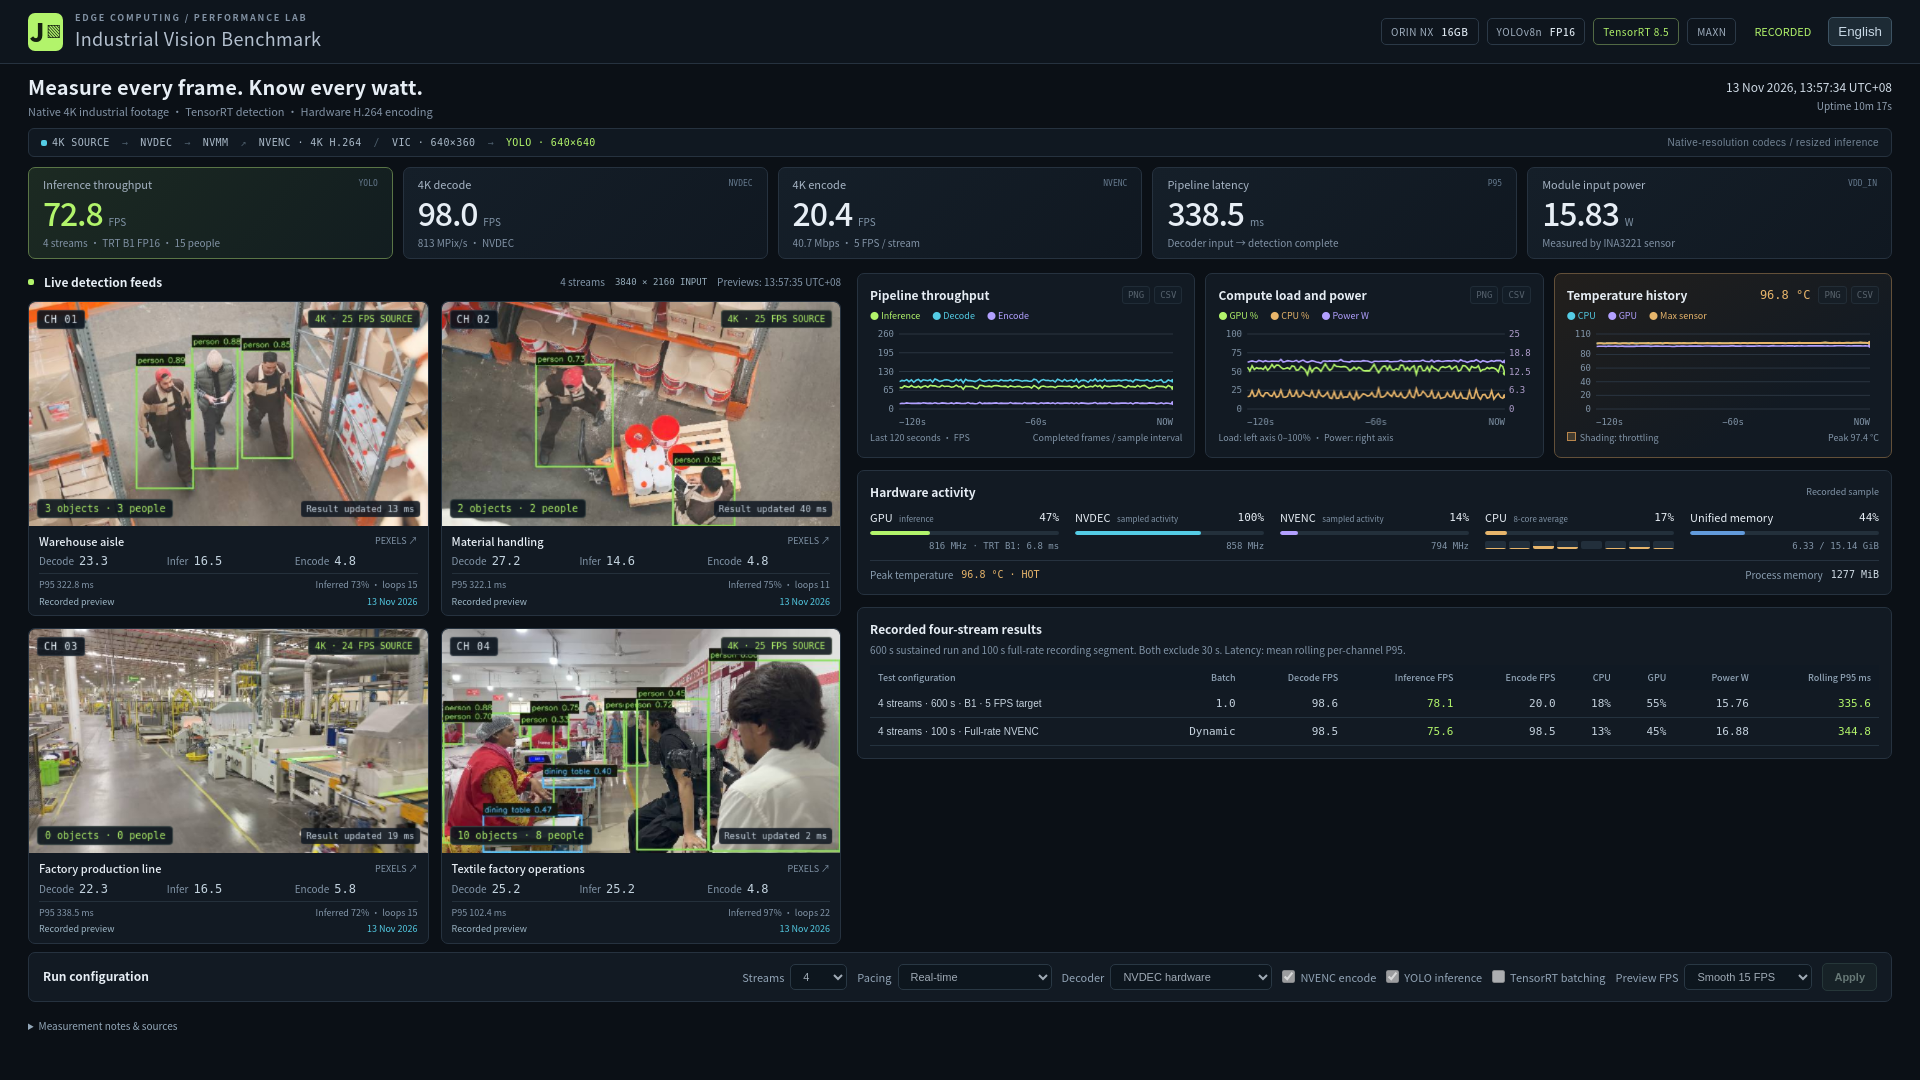
Jetson Orin NX 16GB — NVENC em hardware
Plataformas de teste e carga de trabalho
| Configuração | Jetson Orin Nano 8GB | Jetson Orin NX 16GB |
|---|---|---|
| Identificação do módulo | Orin Nano 8GB | Orin NX 16GB |
| Alvo de implantação JetPack | 6.2 | 5.1.3 |
| Jetson Linux | L4T 36.4.3 | L4T 35.5 |
| CUDA | 12.6.10 | 11.4 |
| TensorRT | 10.3.0 | 8.5.2 |
| Modo de energia configurado | 25W | MAXN |
| Limites de frequência em tempo de execução | DVFS padrão | CPU 1,50 GHz; GPU 816 MHz |
| Normalização da CPU | Média entre seis núcleos | Média entre oito núcleos |
| Decodificador de vídeo | NVDEC | NVDEC |
| Codificador H.264 | Emulação x264 na CPU; sem NVENC | NVENC em hardware |
| Configuração de inferência | Lote sequencial 1, FP16 | Lote sequencial 1, FP16 |
| Resfriamento durante a execução reportada | Resfriamento passivo | Resfriamento passivo |
As versões de software acima descrevem os alvos de implantação. O alvo Nano segue a pilha de software JetPack 6.2; seus rastros de benchmark gravados anteriormente não foram repetidos nesta imagem de destino. O modo de energia é o orçamento de energia configurado do módulo; a potência média medida de entrada do módulo Nano é 11,02 W durante a execução gravada.
O modelo é YOLOv8n com entrada letterboxed de 640×640, limiar de confiança 0,30 e limiar de IoU 0,45. A decodificação e a codificação mantêm a resolução nativa 3840×2160. “Análises 4K” descreve o pipeline de vídeo; o detector em si consome imagens redimensionadas.
Os quatro clipes ativos cobrem atividades de armazém e fábrica:
| Canal | Cena | Taxa de quadros nativa | Fonte |
|---|---|---|---|
| 1 | Corredor de armazém | 25 FPS | Men Working in a Warehouse |
| 2 | Manuseio de material | 25 FPS | Video of Man Loading Cart |
| 3 | Linha de produção de fábrica | 24 FPS | Wide View of Modern Factory Production Line |
| 4 | Operações em fábrica têxtil | 25 FPS | Documentary Filming Inside Textile Factory |
Juntas, as fontes contêm 99 quadros por segundo de mídia. Os clipes são repetidos em loop para a carga de trabalho e são cobertos pela Licença Pexels. Este experimento usa H.264 em todo o fluxo.
Arquitetura do pipeline
Os quadros decodificados permanecem em NVMM antes de ramificar para gravação e inferência:
3840×2160 H.264 → NVDEC → NVMM
                           ├─ Recording
                           │    NX:   hardware NVENC → 4K H.264
                           │    Nano: VIC → CPU-accessible I420 → x264 → 4K H.264
                           │
                           └─ VIC resize to 640×360
                                → CPU letterbox/preprocessing to 640×640
                                → TensorRT FP16 YOLOv8n
                                → CPU class-aware NMS
                                → detection results

Independent 640×360 JPEG preview worker → browser
Latest completed detections → preview overlays
O codificador Nano usa o preset ultrafast do x264, ajuste zerolatency, duas threads por fluxo, threading fatiado, sem quadros B e alvo de 10.000 kbit/s. Uma fila de gravação limitada descarta quadros antigos sob pressão, permitindo que a inferência continue. Quadros codificados e bytes de saída são contados após a conclusão da codificação real.
A conversão VIC e a inferência TensorRT não fornecem codificação de bitstream H.264 na GPU. A atividade NVENC no Nano é reportada como indisponível; nenhum valor de utilização de hardware é inventado para o codificador ausente.
A execução sustentada no Nano seleciona um alvo de tempo de mídia de codificação de 5 FPS por fluxo. Isso reduz o trabalho de gravação antes da conversão para memória da CPU. Essa configuração não garante 20 quadros concluídos por segundo de relógio de parede: o progresso real de entrada e a capacidade do codificador ainda determinam a taxa de saída. O painel relata tanto o FPS realmente codificado quanto a cobertura de codificação.
O que foi medido
Os quatro arquivos de vídeo no NX foram verificados em relação à referência Nano com SHA256. Ambas as execuções sustentadas usam quatro fluxos, pacing pela fonte, lote sequencial TensorRT 1, alvo de tempo de mídia de gravação de 5 FPS por fluxo, geração de pré-visualização a 15 FPS e dez minutos de coleta. Os resumos excluem os primeiros 30 segundos. Estas são medições de sistema implantado com diferentes backends de codificador e pontos de operação, em vez de uma comparação isolada de GPU.
- Execução sustentada no Nano: 13 de novembro de 2026, 10:08:04–10:18:04 UTC+08, 582 amostras ao longo de 599,83 segundos.
- Execução sustentada no NX: 13 de novembro de 2026, 13:47:26 UTC+08 a 13 de novembro de 2026, 13:57:27 UTC+08, 582 amostras ao longo de 599,86 segundos. Os limites de frequência de CPU/GPU estão listados acima. O Visual Hub foi pausado durante a coleta e restaurado depois.
- Segmento de gravação em taxa cheia no NX: os primeiros 99,72 segundos de uma captura separada, com o limite de gravação removido e batching dinâmico de inferência habilitado. A captura planejada de 150 segundos foi interrompida na proteção de medição de 99°C; este curto segmento de capacidade exclui seus primeiros 30 segundos e mantém o pacing pela fonte e os mesmos limites de frequência.
A geração de pré-visualização no backend permanece habilitada durante a coleta; um cliente adicional de pré-visualização no navegador é aberto apenas após o término da medição sustentada.
As contagens de throughput consideram quadros concluídos, em vez de FPS solicitado. Ambos os resumos sustentados usam diferenças de contadores e energia integrada do módulo:
Throughput (FPS)       = completed frames / elapsed seconds
Average module power  = integrated module energy / elapsed seconds
Encoding coverage     = encoded frames / decoded frames
As legendas das curvas mostram os valores finais amostrados; as tabelas de resumo usam deltas de contadores após o aquecimento.
A energia vem do trilho module VDD_IN do INA3221. Ela exclui periféricos alimentados separadamente e não é a energia na tomada. A carga de CPU é normalizada entre os núcleos de cada módulo. As porcentagens de atividade NVDEC/NVENC representam a fração de amostras de contador não zero a 20 Hz, em vez de uma medição calibrada de utilização de hardware.
Resultados com quatro fluxos
| Métrica | Orin Nano 8GB | Orin NX 16GB |
|---|---|---|
| Throughput agregado de decodificação | 65,24 FPS | 98,63 FPS |
| Throughput agregado de inferência | 58,82 FPS | 78,06 FPS |
| Throughput agregado de codificação H.264 | 13,24 FPS, x264 na CPU | 20,00 FPS, NVENC |
| Carga de CPU | 49,34% | 18,10% |
| Carga de GPU | 30,49% | 54,68% |
| Latência ponta a ponta, média móvel P95 | 1108,46 ms | 335,57 ms |
| Potência de entrada do módulo | 11,02 W | 15,76 W |
| Temperatura máxima medida | 58,19°C | 97,38°C |
| Amostras com thermal throttling | 0 | 0 |
Throughput e pressão de codificação
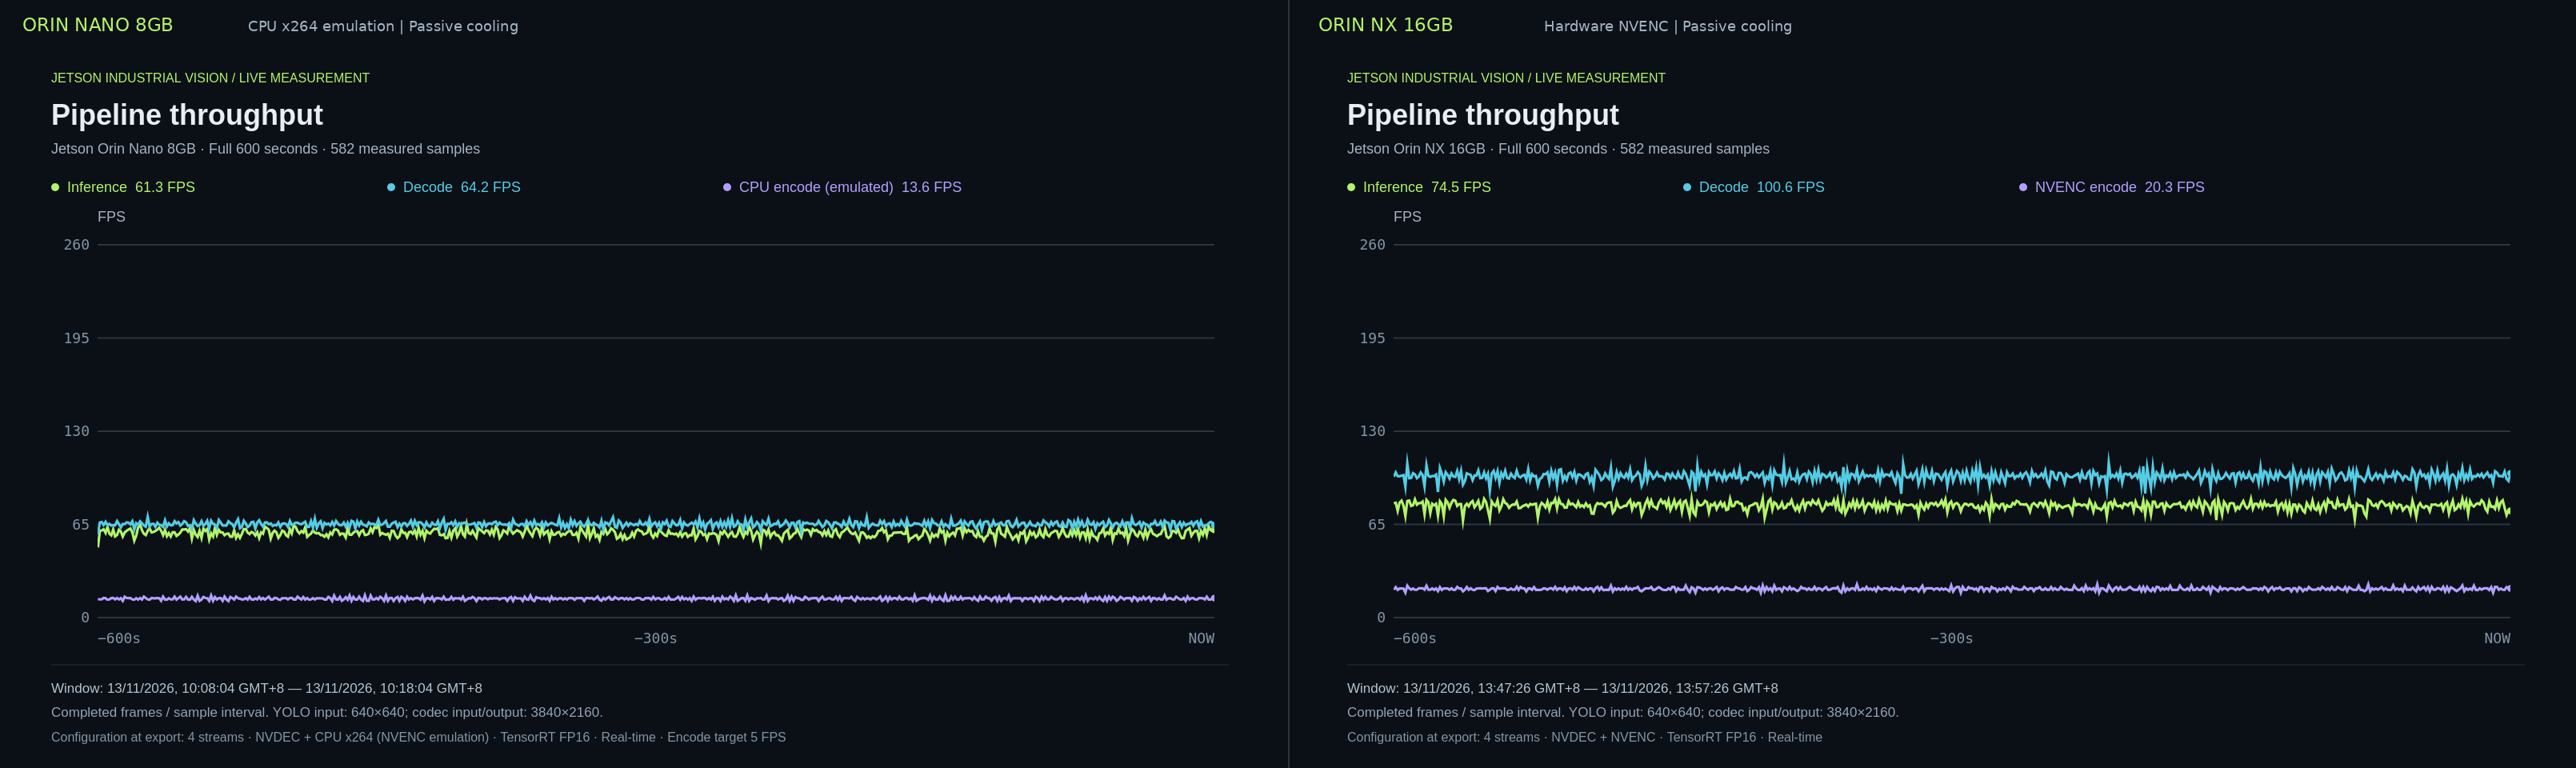
Curvas individuais: Throughput do Nano · Throughput do NX.
O NX sustenta 78,06 FPS de inferência e 98,63 FPS de decodificação com os mesmos quatro arquivos de origem. O Nano completa 58,82 FPS de inferência e 65,24 FPS de decodificação. Ambos usam o alvo de gravação de 5 FPS por fluxo; as taxas de gravação realmente concluídas são 20,00 e 13,24 FPS, respectivamente.
Gravação NVENC em taxa cheia
Remover o limite de gravação no NX produz 98,51 FPS agregados de codificação H.264 4K enquanto a inferência continua em 75,63 FPS. O throughput de decodificação é 98,51 FPS, a carga de CPU normalizada é 12,79% e a potência do módulo é 16,88 W. Este curto segmento de capacidade usa batching dinâmico de inferência e gravação na taxa da fonte; não é um resultado de resistência de dez minutos.
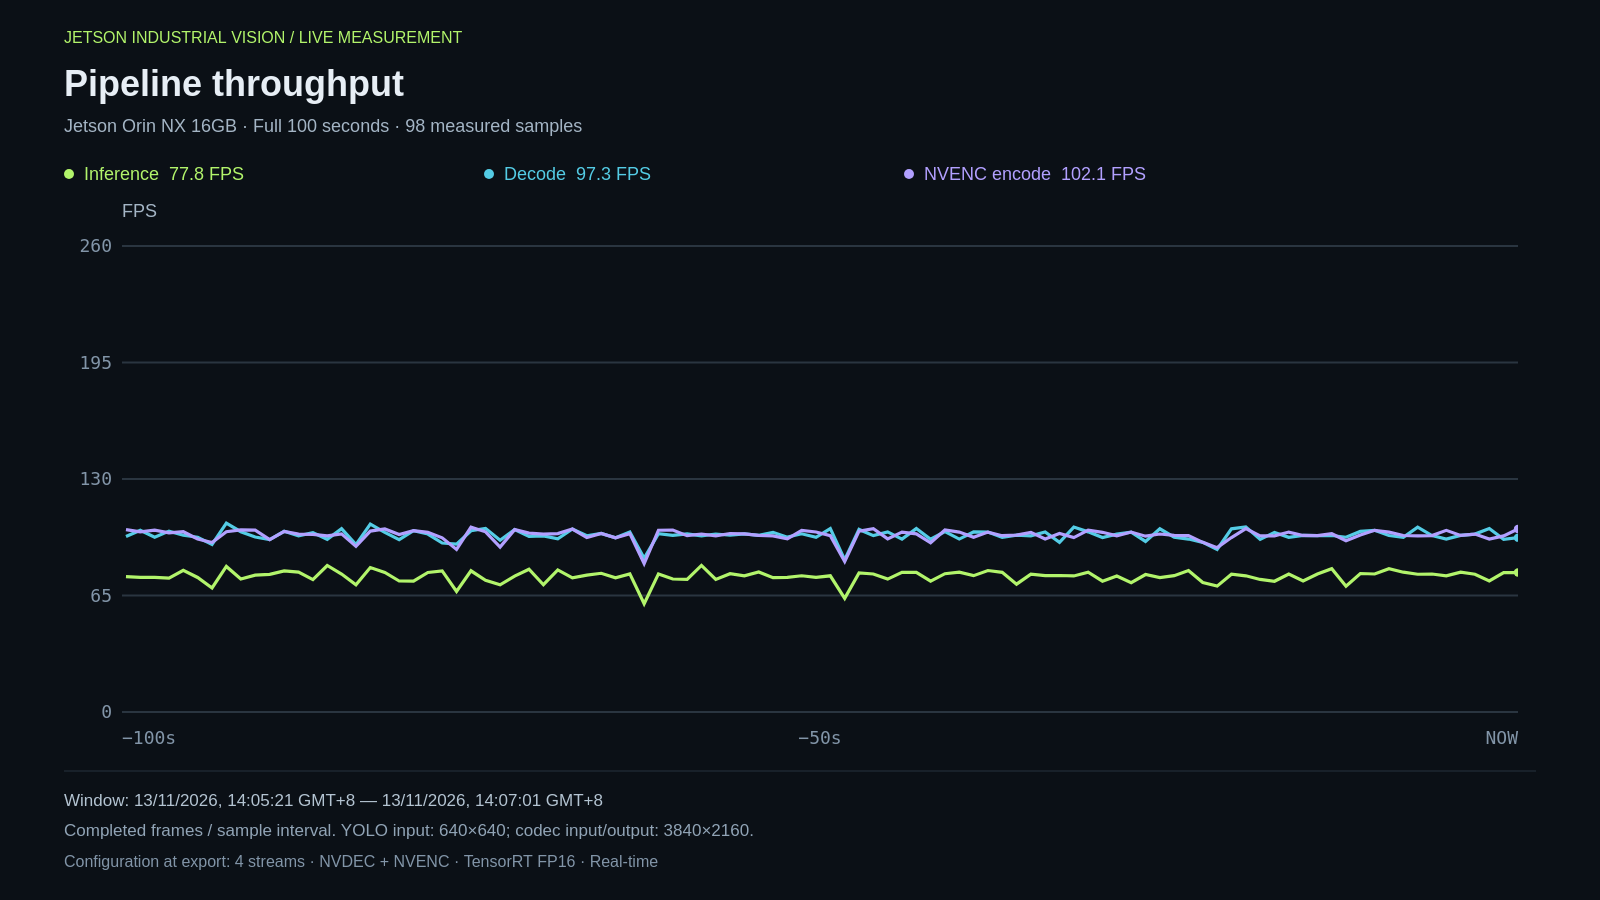
O NVENC por hardware permite que o ramo de gravação lide com a carga de trabalho 4K na taxa de origem enquanto compartilha o sistema com a detecção. A substituição x264 em CPU no Nano exige um orçamento de gravação explícito para preservar o restante da aplicação.
Carga de computação e consumo de energia
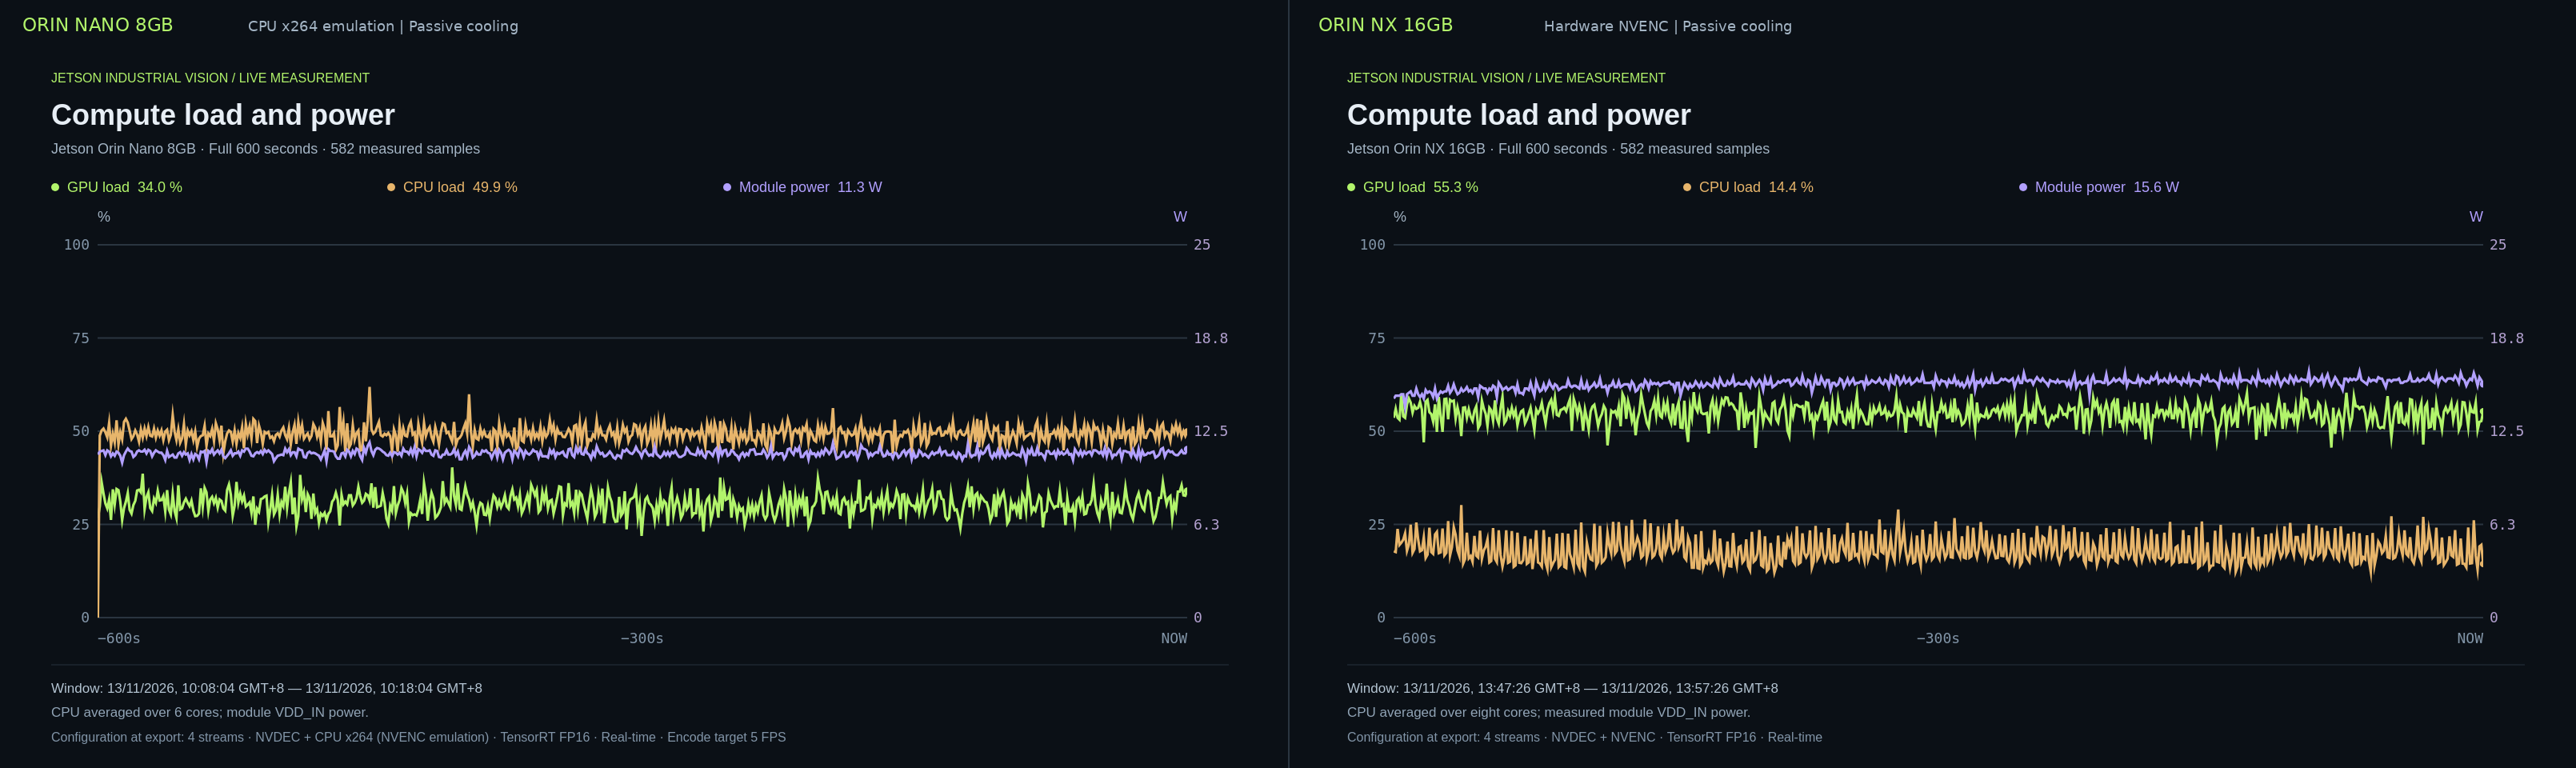
Curvas individuais: Carga e consumo do Nano · Carga e consumo do NX.
No Nano, o x264 compartilha recursos de CPU com pré-processamento, pós-processamento, geração de pré-visualização e threads da aplicação. A carga da GPU sozinha, portanto, não consegue explicar a capacidade do pipeline. O NVENC por hardware no NX lida com o ramo de gravação independentemente da codificação de bitstream na CPU, embora decodificação, tráfego de memória e limites térmicos ainda afetem a aplicação.
Temperatura e resfriamento
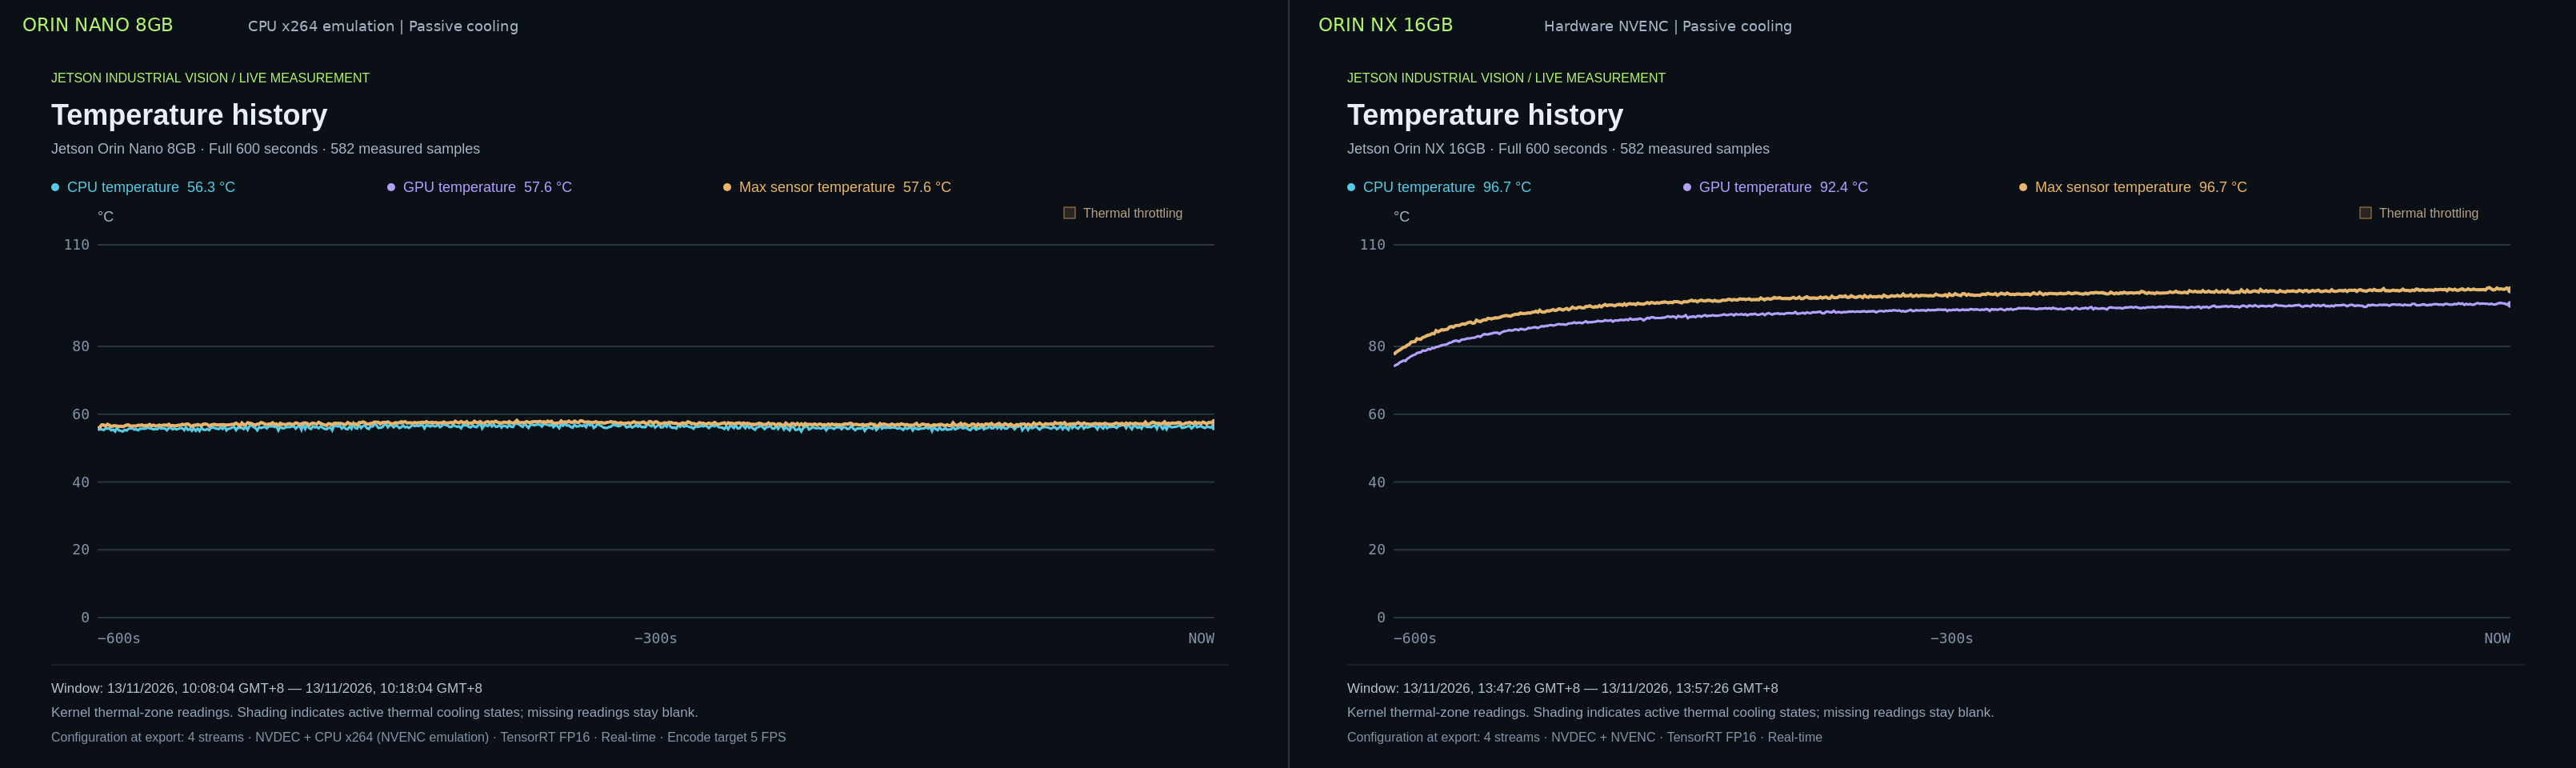
Curvas individuais: Temperatura do Nano · Temperatura do NX.
O Nano atingiu um máximo de 58,19°C. A execução sustentada do NX atingiu o pico de 97,38°C e registrou 0 eventos de thermal throttling amostrados. Uma captura preliminar irrestrita em MAXN foi interrompida em 99°C; o resultado sustentado, portanto, usa os limites de CPU/GPU listados acima. As proteções térmicas por hardware permanecem ativas.
Ambos os dispositivos usam resfriamento passivo. A temperatura ambiente e os conjuntos de resfriamento equivalentes não foram controlados, portanto essas sessões não estabelecem uma vantagem térmica entre módulos.
Latência de ponta a ponta
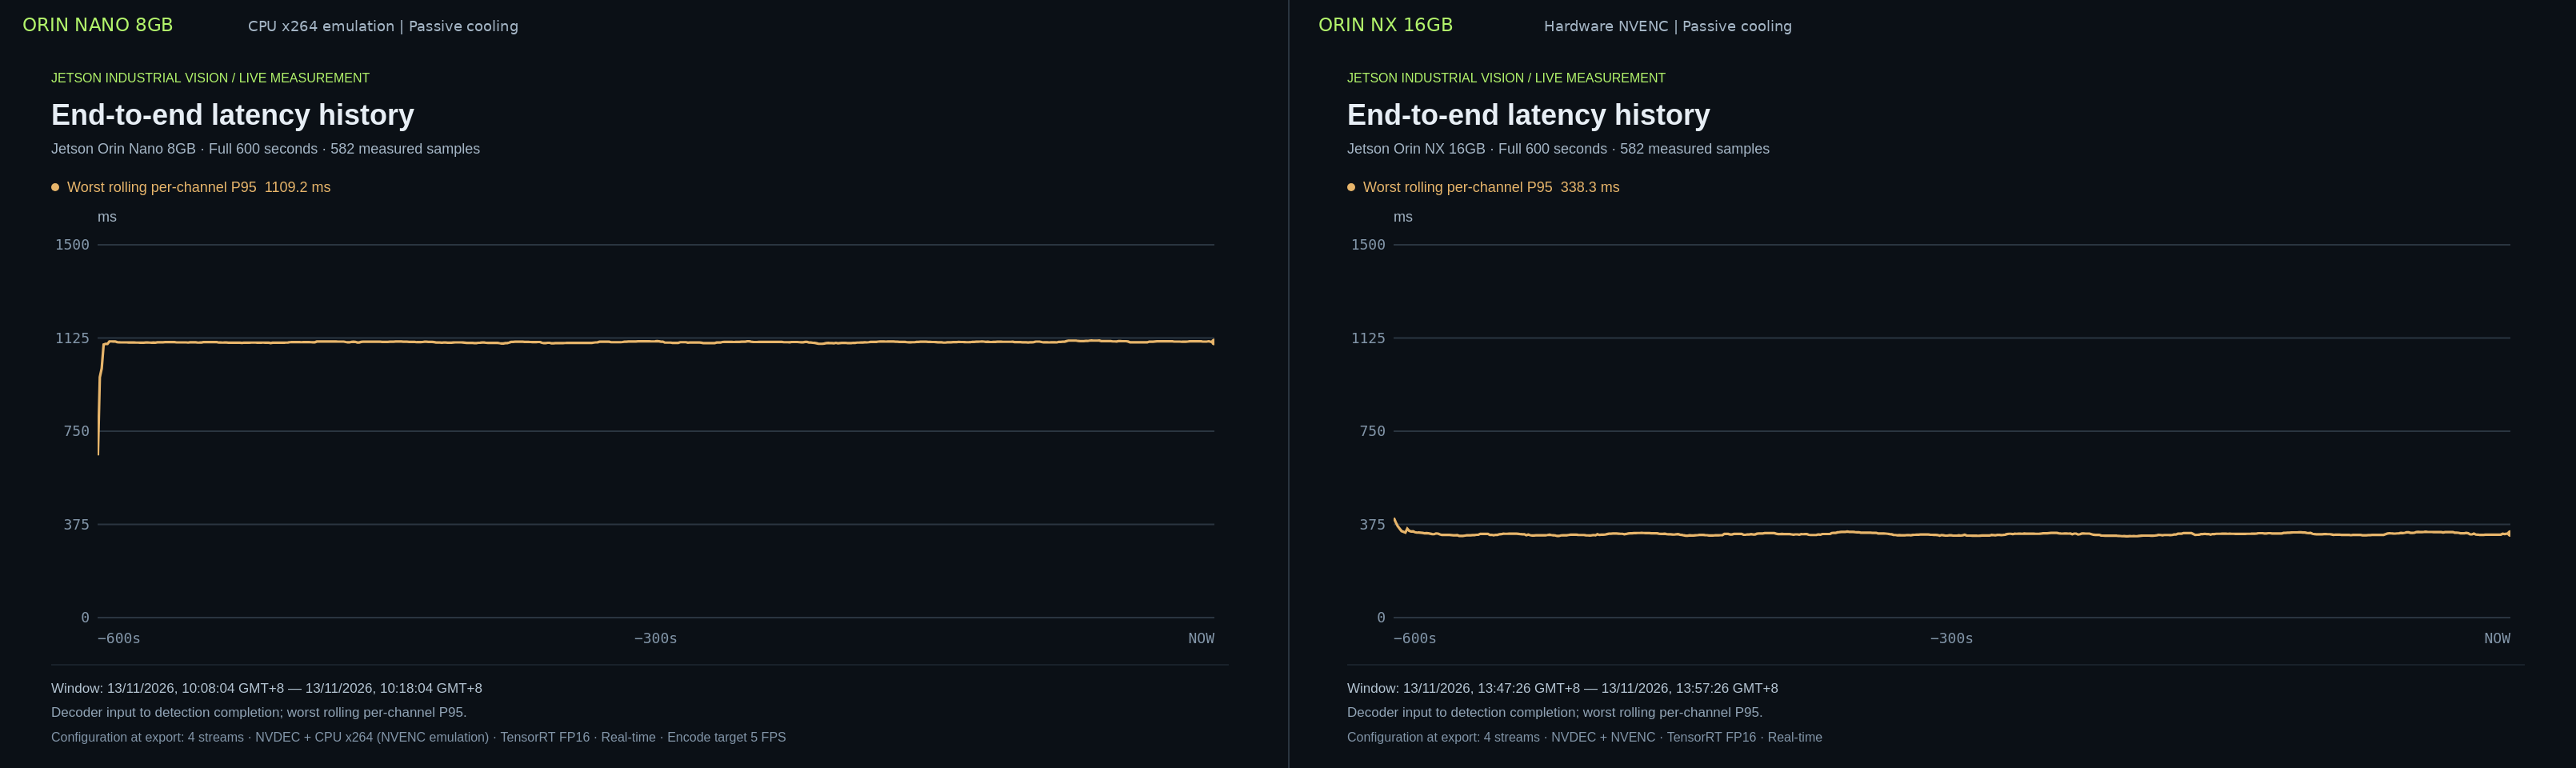
Curvas individuais: Latência do Nano · Latência do NX.
Ambas as curvas mostram o pior P95 móvel por canal, medido da entrada do decodificador até a conclusão do pós-processamento de detecção. As médias ponderadas pelo tempo após o aquecimento são 1108,46 ms para o Nano e 335,57 ms para o NX, uma redução de 69,7% nessa estatística registrada.
Estas são medições de latência do pipeline completo, não tempos de execução isolados do TensorRT ou um P95 recalculado sobre cada quadro na execução de dez minutos. Ambas as curvas e ambos os valores de resumo usam a mesma estatística móvel.
Comportamento de memória
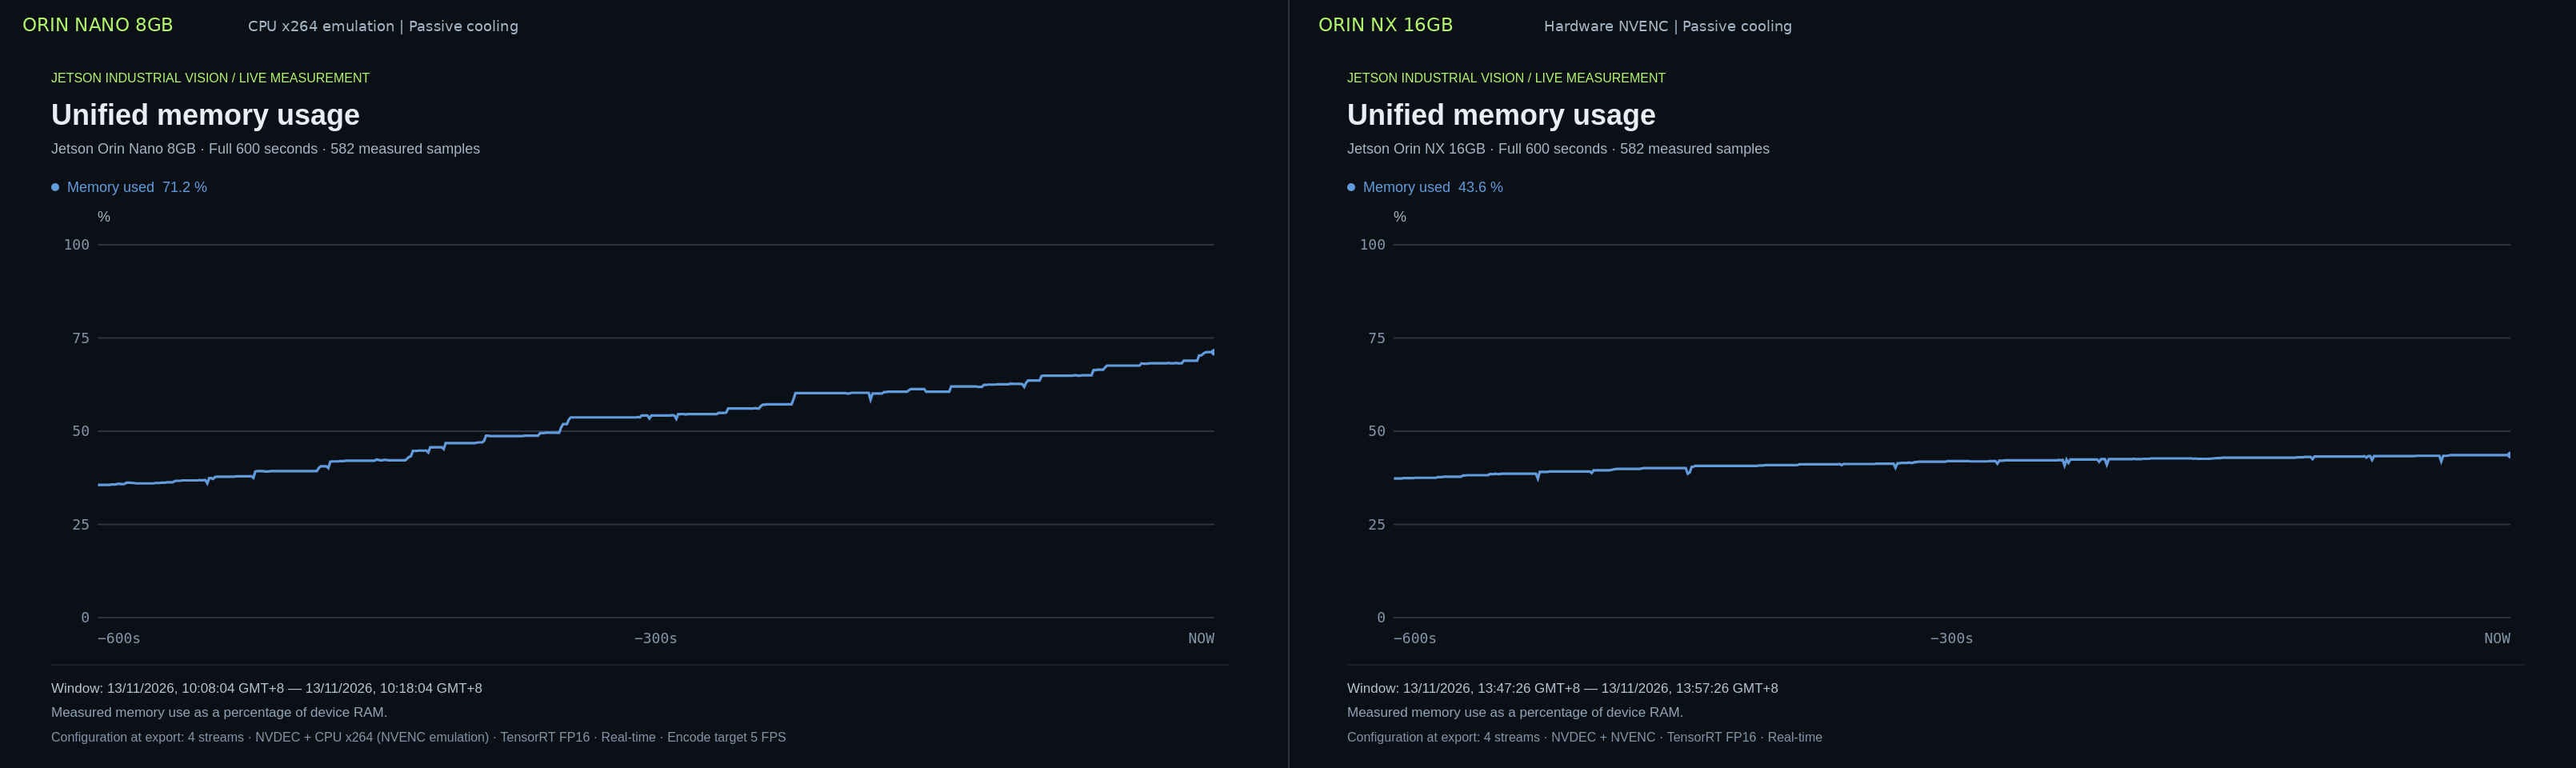
Curvas individuais: Memória do Nano · Memória do NX.
As curvas mostram o uso real de memória do dispositivo como porcentagem da RAM disponível de cada dispositivo. O Nano sobe de 35,6% para 71,2% durante a execução; o RSS da aplicação sobe de aproximadamente 2.108 MiB para 4.695 MiB. A memória do NX sobe de 37,3% para 43,6% na nova execução sustentada, com o RSS da aplicação terminando em 1277 MiB. O maior crescimento no Nano permanece não resolvido nesta medição. Dez minutos de temperatura e throughput aceitáveis não estabelecem estabilidade de memória para operação contínua.
Pré-visualizações de detecção e comportamento do dashboard
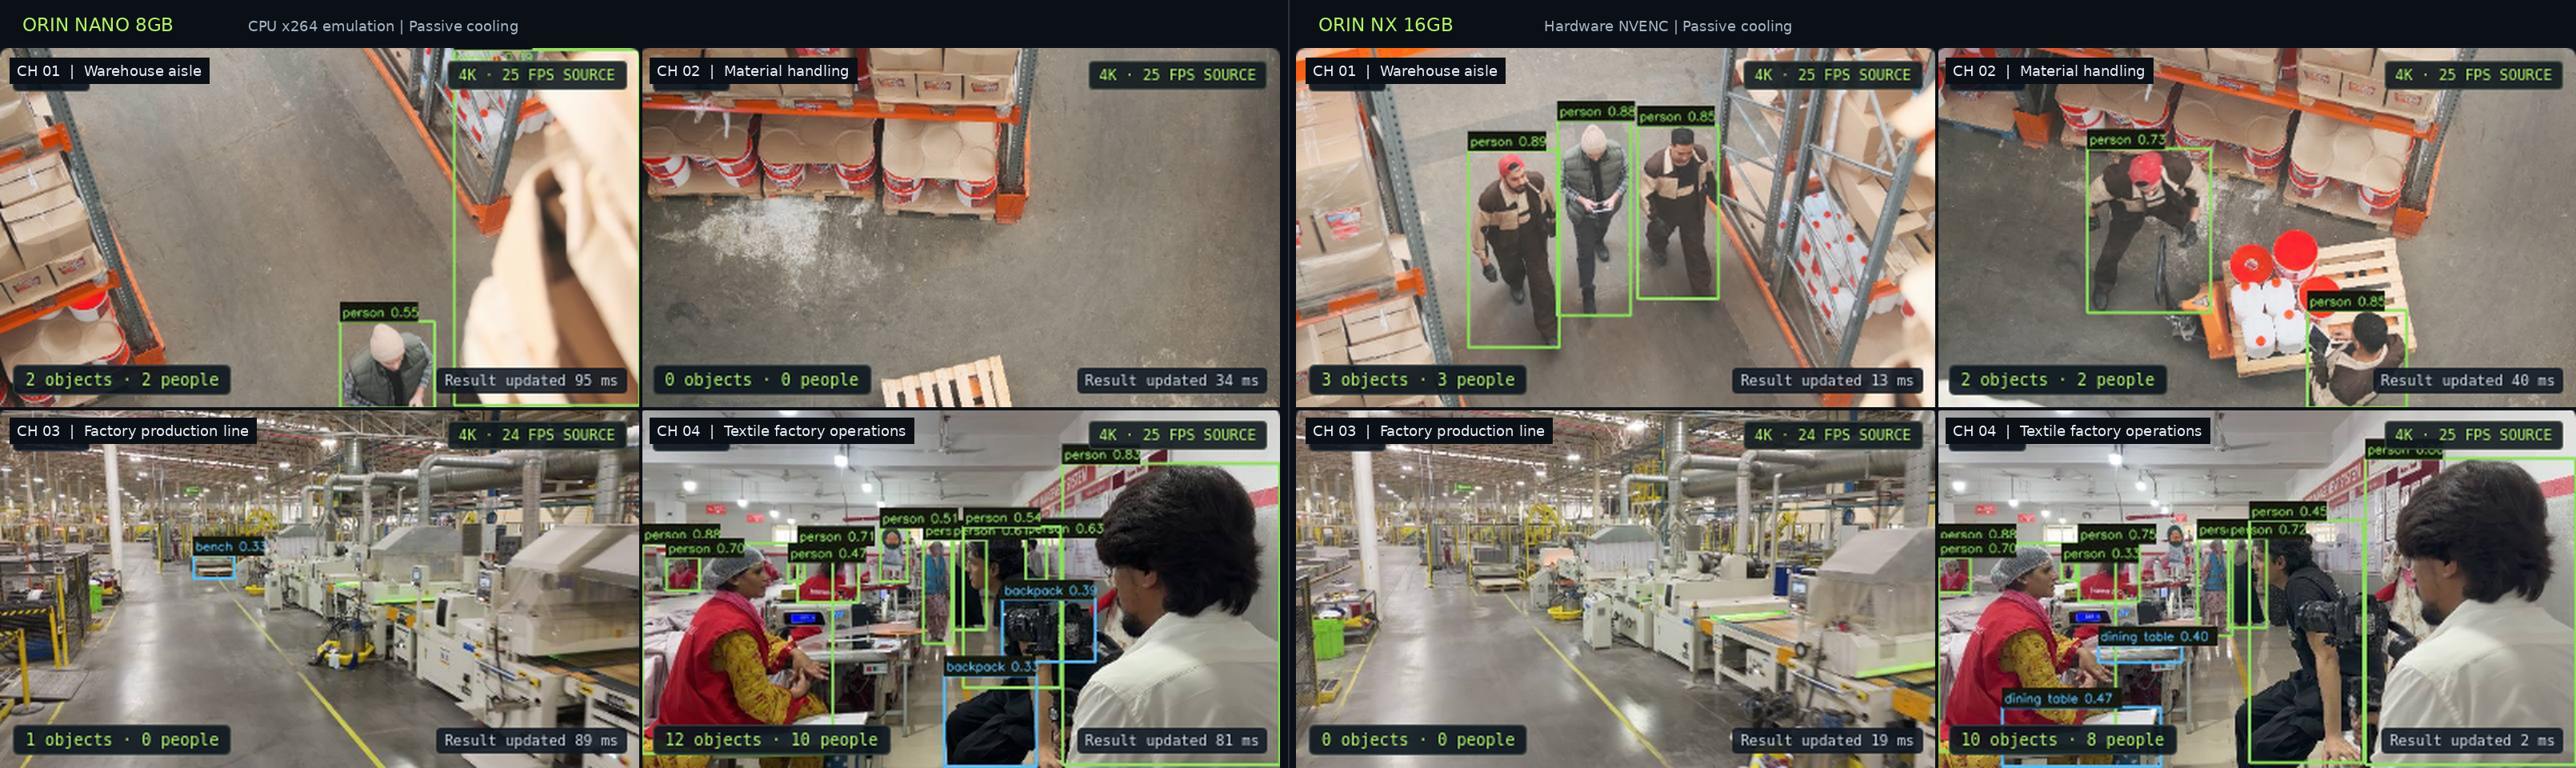
Pré-visualizações individuais: Detecções do Nano · Detecções do NX.
O navegador usa pré-visualizações JPEG independentes de 640×360 com uma meta selecionável de 5 ou 15 FPS. Cada canal tem uma solicitação de quadro pendente, desenha novos quadros e evita acumular uma fila de quadros antigos. FPS de pré-visualização gerado, FPS de exibição no navegador, FPS de inferência e FPS de codificação de vídeo são relatados separadamente.
As bounding boxes usam o resultado de detecção concluído mais recente. A sobreposição mostra a idade da sua atualização e oculta as caixas após 300 ms sem um novo resultado. Consequentemente, uma imagem suave no navegador não significa que cada quadro exibido tenha sido inferido, e essas sobreposições não são rastreamento de objetos.
Ambas as figuras do dashboard renderizam telemetria registrada e os resumos da execução concluída. A telemetria do Nano é de 13 de novembro às 10:18:04 UTC+08; seus pixels de pré-visualização foram capturados separadamente às 11:05:05. A telemetria e os pixels de pré-visualização do NX foram capturados após a execução sustentada às 13:57:34 UTC+08. Valores instantâneos do dashboard podem diferir das médias da janela, e as cenas de pré-visualização não são sincronizadas entre dispositivos.
YOLOv8n usa classes genéricas COCO80. Essas pré-visualizações demonstram detecção de pessoas e objetos em cenas industriais; não é reivindicado nenhum benchmark de EPI, detecção de defeitos ou precisão industrial.
Reproduzindo a abordagem de medição
Antes de escolher um backend de gravação, inspecione a identidade real do módulo e o software instalado. Uma string de modelo de device tree da placa-carregadora sozinha pode ser insuficiente para distinguir módulos. A identidade do Orin Nano 8GB usada aqui foi verificada a partir da EEPROM do módulo.
Verificações úteis em uma instalação Jetson incluem:
cat /etc/nv_tegra_release
/usr/local/cuda/bin/nvcc --version
python3 -c "import tensorrt as trt; print(trt.__version__)"
sudo nvpmodel -q
gst-inspect-1.0 nvv4l2decoder
gst-inspect-1.0 nvv4l2h264enc
gst-inspect-1.0 x264enc
No Nano, um plugin NVENC ausente não deve ser relatado como um codificador por hardware funcional. Verifique o codec e as dimensões de saída de forma independente e conte quadros codificados concluídos em vez de quadros enviados para uma fila. Engines TensorRT devem ser construídas para o módulo de destino e a pilha de software.
Para uma execução reproduzível, mantenha os arquivos de origem e seus checksums, configurações de modelo, modo de energia, estado de resfriamento, alvo do codificador, política de pacing, configurações de pré-visualização e carimbos de tempo de medição. Inicie o monitoramento antes da carga de trabalho e distinga um teste curto de capacidade de uma execução sustentada. Mantenha contadores por canal para que o throughput agregado não possa ocultar uma câmera parada.
O dashboard serve os assets de frontend e a API de medição a partir do mesmo backend. Cada curva pode ser exportada de forma independente. Isso torna possível inspecionar throughput junto com consumo de energia, temperatura, latência e memória em vez de selecionar um único valor de FPS favorável.
Escolhas práticas de implantação
- Para gravação 4K multi-stream em taxa total, reserve orçamento para o codificador. O ramo NVENC por hardware do NX atingiu 98,51 FPS codificados em sua execução de gravação na taxa de origem. A substituição x264 em CPU no Nano exige um orçamento de taxa de gravação e cobertura visível de quadros.
- Ajuste o pipeline completo. Uma suíte curta anterior no Nano mediu 56,82 FPS de inferência com inferência sequencial versus 51,70 FPS com batching sob sua configuração de codificador limitada. O tamanho do batch sozinho não previu o throughput da aplicação.
- Trate resfriamento e memória como restrições de operação. O ponto de operação sustentado do NX usa limites explícitos de frequência; o registro do Nano contém crescimento de memória. Monitore temperatura, throttling e memória durante execuções de maior resistência.
- Meça frescor separadamente da suavidade de exibição. O FPS do navegador descreve a apresentação. A latência de decodificador para detecção descreve quando o resultado se torna disponível para uma aplicação.
Recursos relacionados
Suporte técnico e discussão de produtos
Para dúvidas técnicas e discussões de implementação, visite o Fórum Seeed Studio ou as discussões da Wiki.